PolyOCR-Venus:面向文本中心视觉智能的统一OCR基础模型 PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
蚂蚁集团推出统一OCR基础模型家族PolyOCR,用数据引擎加CGPO后训练在五大基准达到SOTA
前置知识
GRPO(组相对策略优化)
一种免价值网络的强化学习算法:对同一输入采样一组(本文为 $G=8$ 个)回答,用验证器给每个回答打标量奖励,再在组内做标准化得到优势 $A_i=(r_i-\bar{r})/(\mathrm{std}(r)+\epsilon)$,以组内相对好坏替代绝对奖励信号驱动策略更新。
CGPO 的优化主干就是验证器驱动的 GRPO,且论文动机中的等奖励退化问题(组内奖励全相同导致优势为零)正是 GRPO 的固有缺陷,不理解 GRPO 无法理解 CGPO 为何要补充蒸馏。
On-policy 蒸馏与反向 KL
知识蒸馏的一种:不是让学生模仿教师独立生成的轨迹,而是在学生自己生成的前缀上查询教师分布,最小化反向 KL 散度 $D_{KL}(p_\theta\|p_T)$,逐 token 提供密集监督。on-policy 保证教师评估的是学生实际会访问的状态分布。
CGPO 用 token 级 on-policy 蒸馏弥补 GRPO 奖励信号稀疏的问题;理解反向 KL 的方向性(学生向教师靠拢、防模式平均)才能看懂蒸馏项的设计。
OCR 任务谱系与评测指标
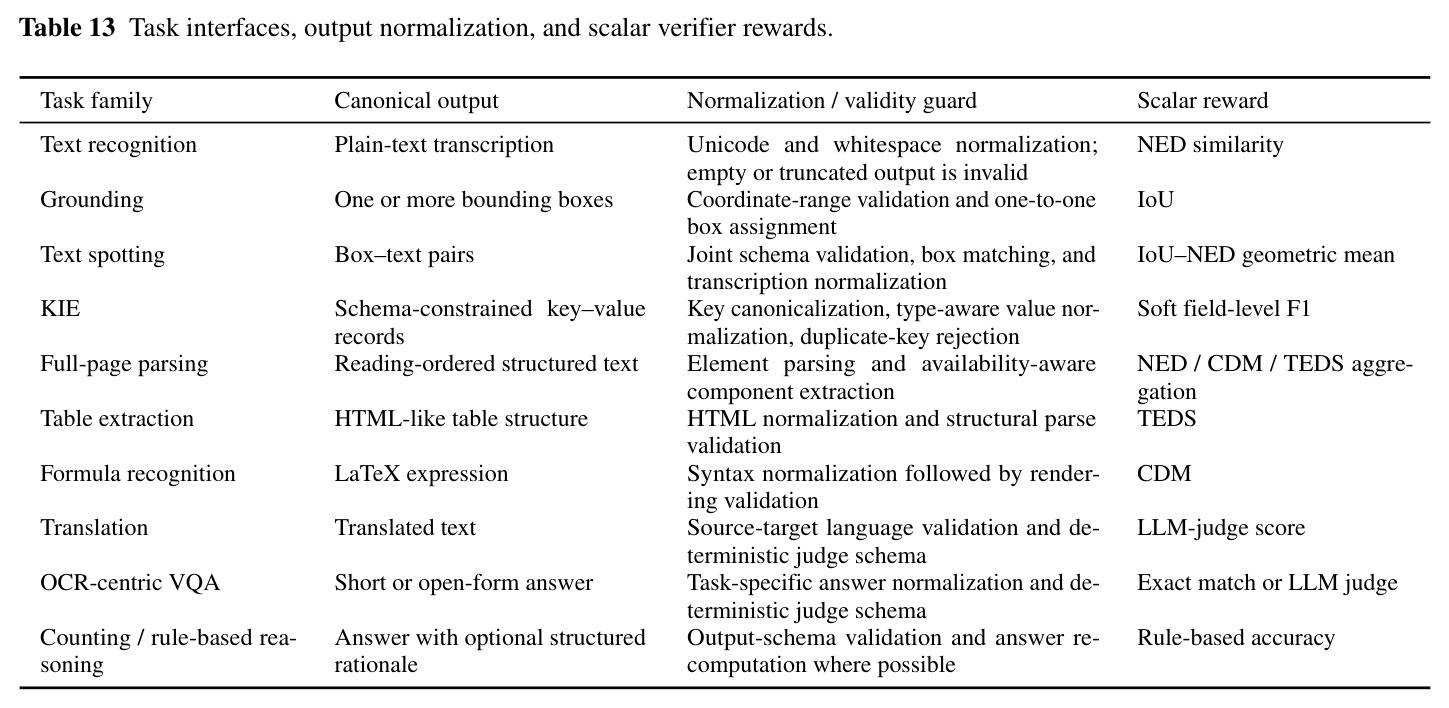
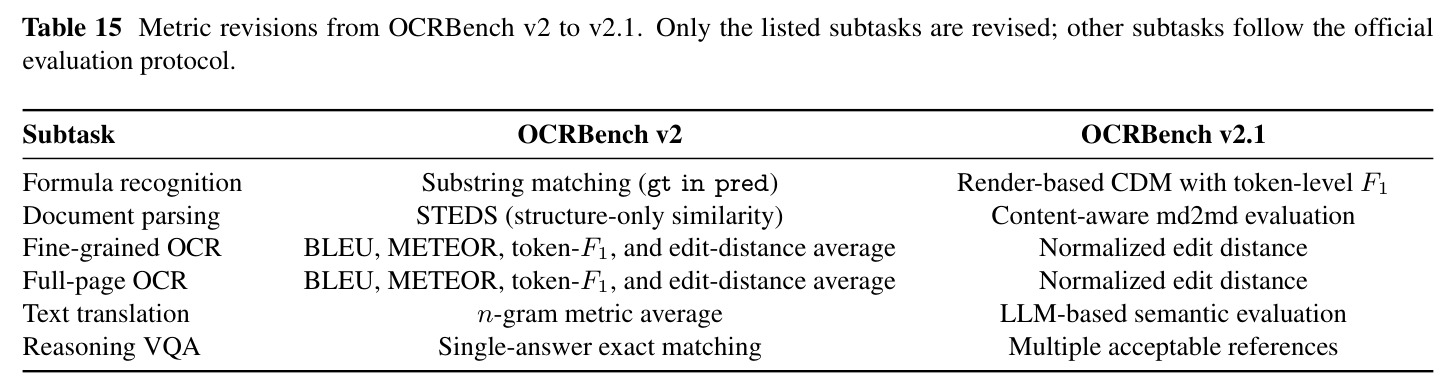
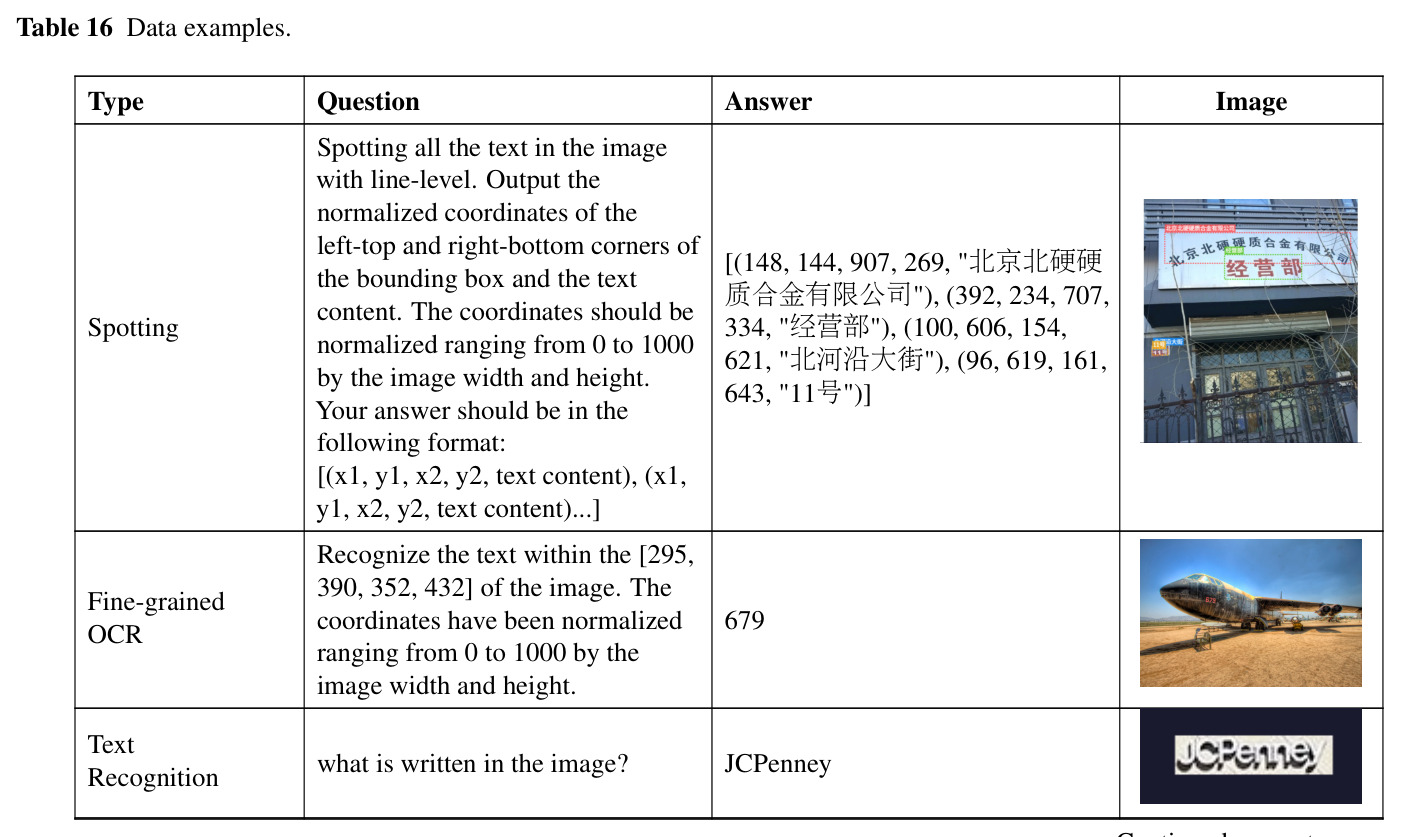
OCR 已从单纯转写扩展为多任务体系:文本识别/全页转写用归一化编辑距离 NED,定位/spotting 用 IoU,公式用渲染后比对的 CDM,表格用树编辑距离相似度 TEDS,信息抽取用字段级 F1,开放式 VQA 与翻译用 LLM 打分。各任务输出格式从纯文本、坐标到 HTML/JSON/LaTeX 各异。
论文的一切设计(数据引擎、验证器奖励、OCRBench v2.1 指标修订)都围绕这套任务与指标体系展开,不熟悉这些指标就读不懂实验表。
多任务学习中的任务干扰与灾难性遗忘
多任务混训时,不同任务的梯度方向可能冲突(负迁移),数据量大的任务会主导优化使稀缺能力欠学习;若按顺序训练各任务,旧任务能力又会随参数更新衰退(灾难性遗忘)。GradNorm、PCGrad、课程学习等都是缓解手段。
统一 OCR 模型要同时覆盖识别、解析、推理等异构任务,这正是任务干扰与遗忘的高发场景,是论文设计课程 SFT 与能力感知优化的直接动机。
胜出概率与离线校准
Vargha–Delaney 式胜出概率 $p_{win}$ 表示教师随机采样得分大于学生的频率(平局记 0.5),$p_{win}>0.5$ 说明教师优势可复现。校准指用留出生成集拟合一个单调映射(如 affine-sigmoid $\sigma(ax+b)$),把有限 rollout 估计出的统计量映射为对独立样本上真实质量的可靠预测。
CGPO 的路由系数 $\alpha(x)$ 完全建立在教师质量与胜出概率两个校准量之上,这是本文区别于既有 RL+蒸馏工作的关键统计工具。
研究动机
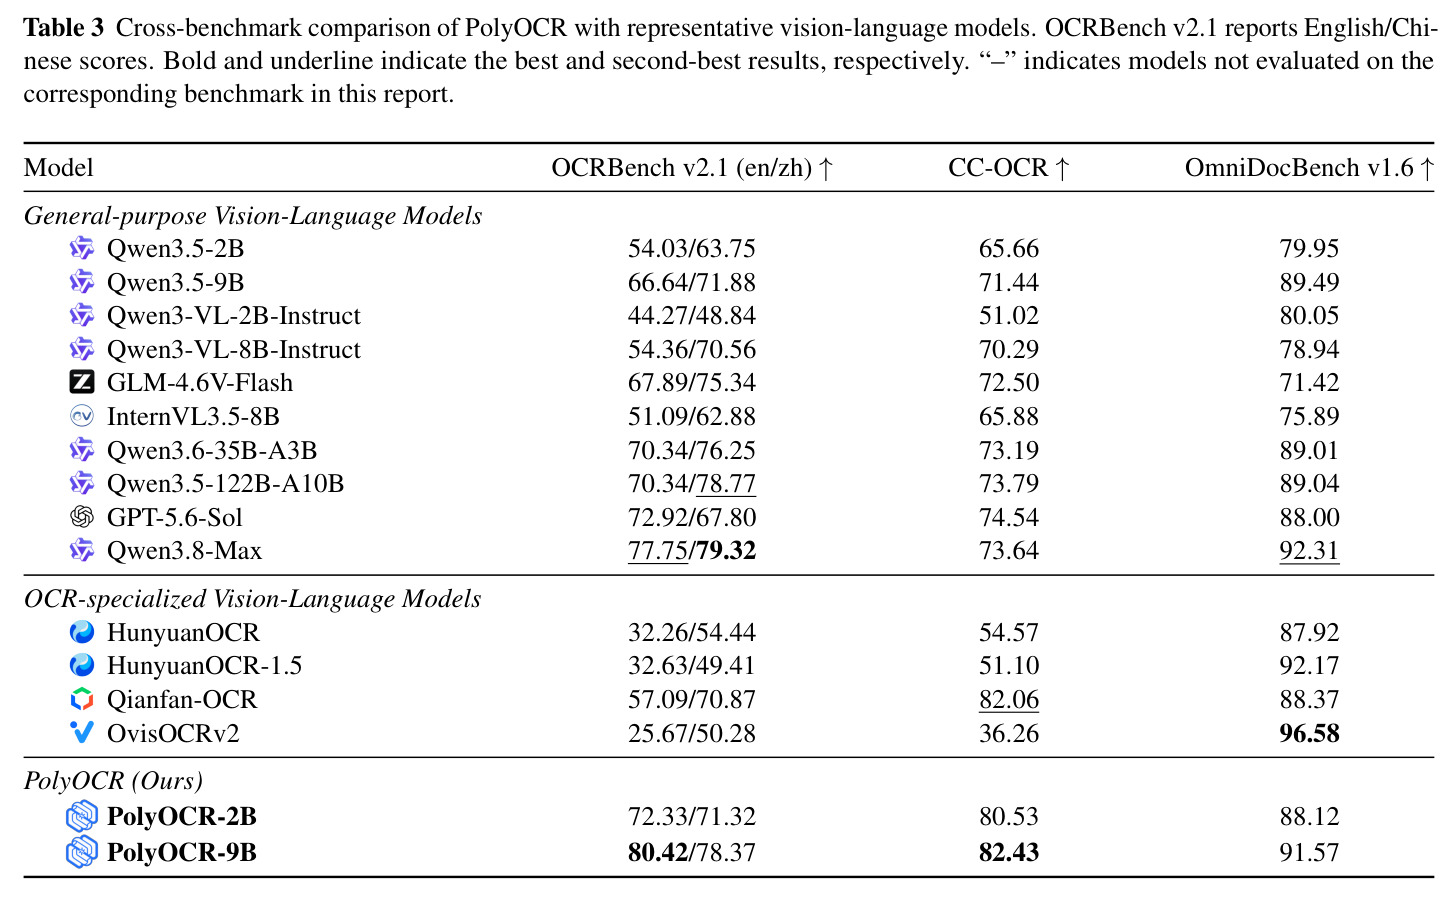
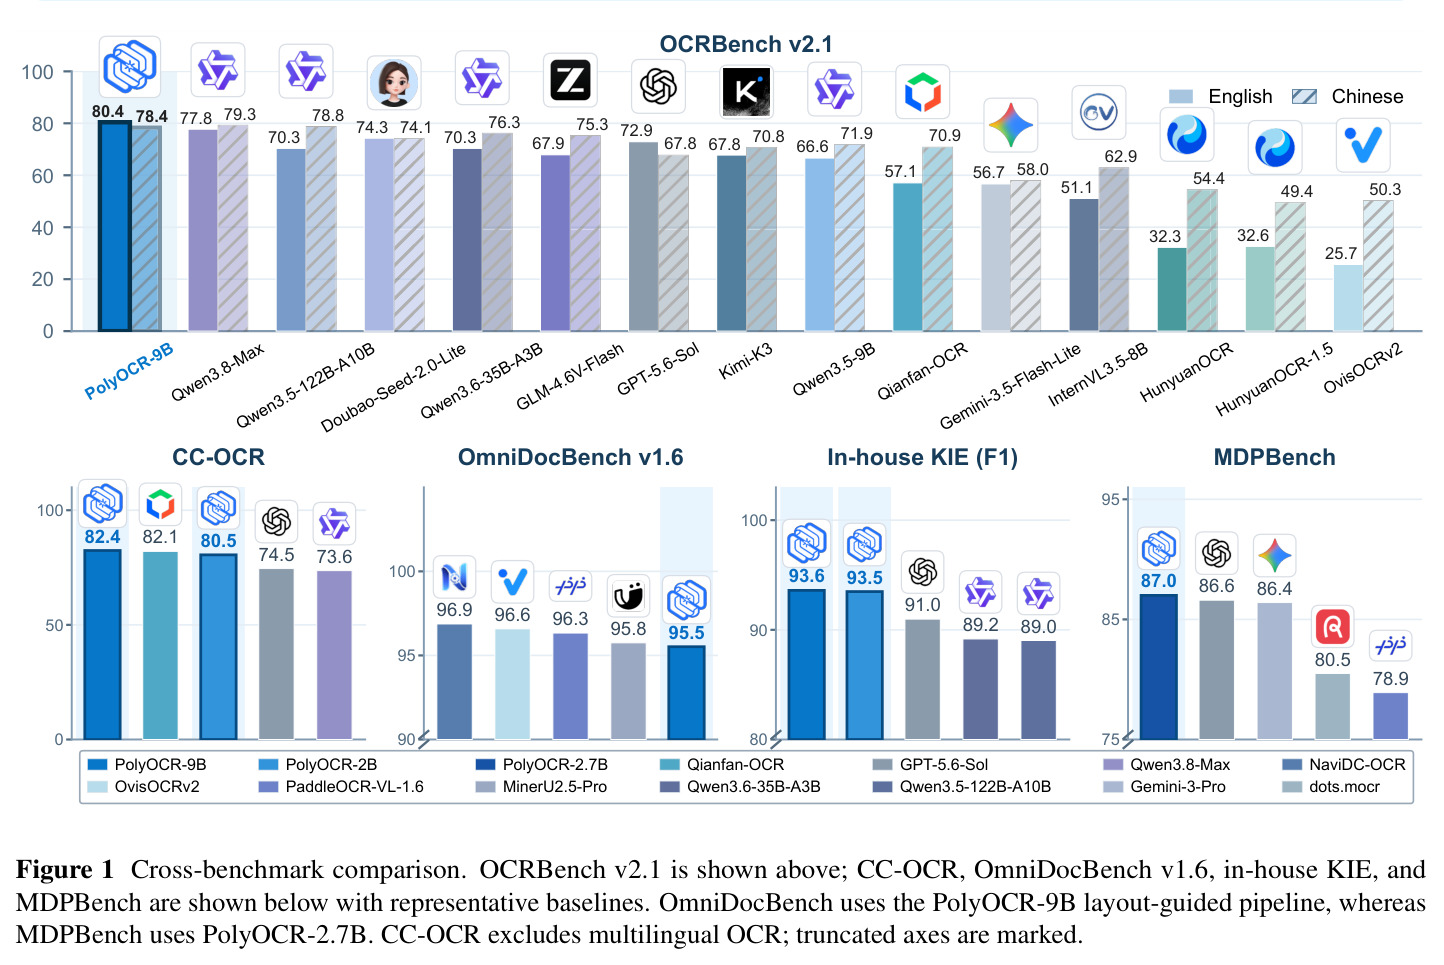
现有 OCR 能力呈碎片化格局,两条路线各有硬伤。专用系统(场景文本识别、文档解析、表格理解、结构化抽取等)任务表述、架构、监督格式和输出协议高度特化,能力割裂、知识难迁移;通用 MLLM 的 OCR 能力只是大规模多模态预训练的副产品,缺乏对细粒度文本任务的系统优化,表现参差——在 OCRBench v2 上专用模型 HunyuanOCR-1.5 英文总分仅 32.63、OvisOCRv2 仅 25.67,通用旗舰 Qwen3.8-Max 也只拿到 77.75/79.32,且各能力维度极不均衡。即便想训练统一模型,任务间在视觉复杂度、输出结构、监督粒度、优化目标上差异巨大:固定采样或静态损失会让优势任务淹没稀缺能力,多任务混训中正迁移与任务干扰共存,顺序训练又引发灾难性遗忘。
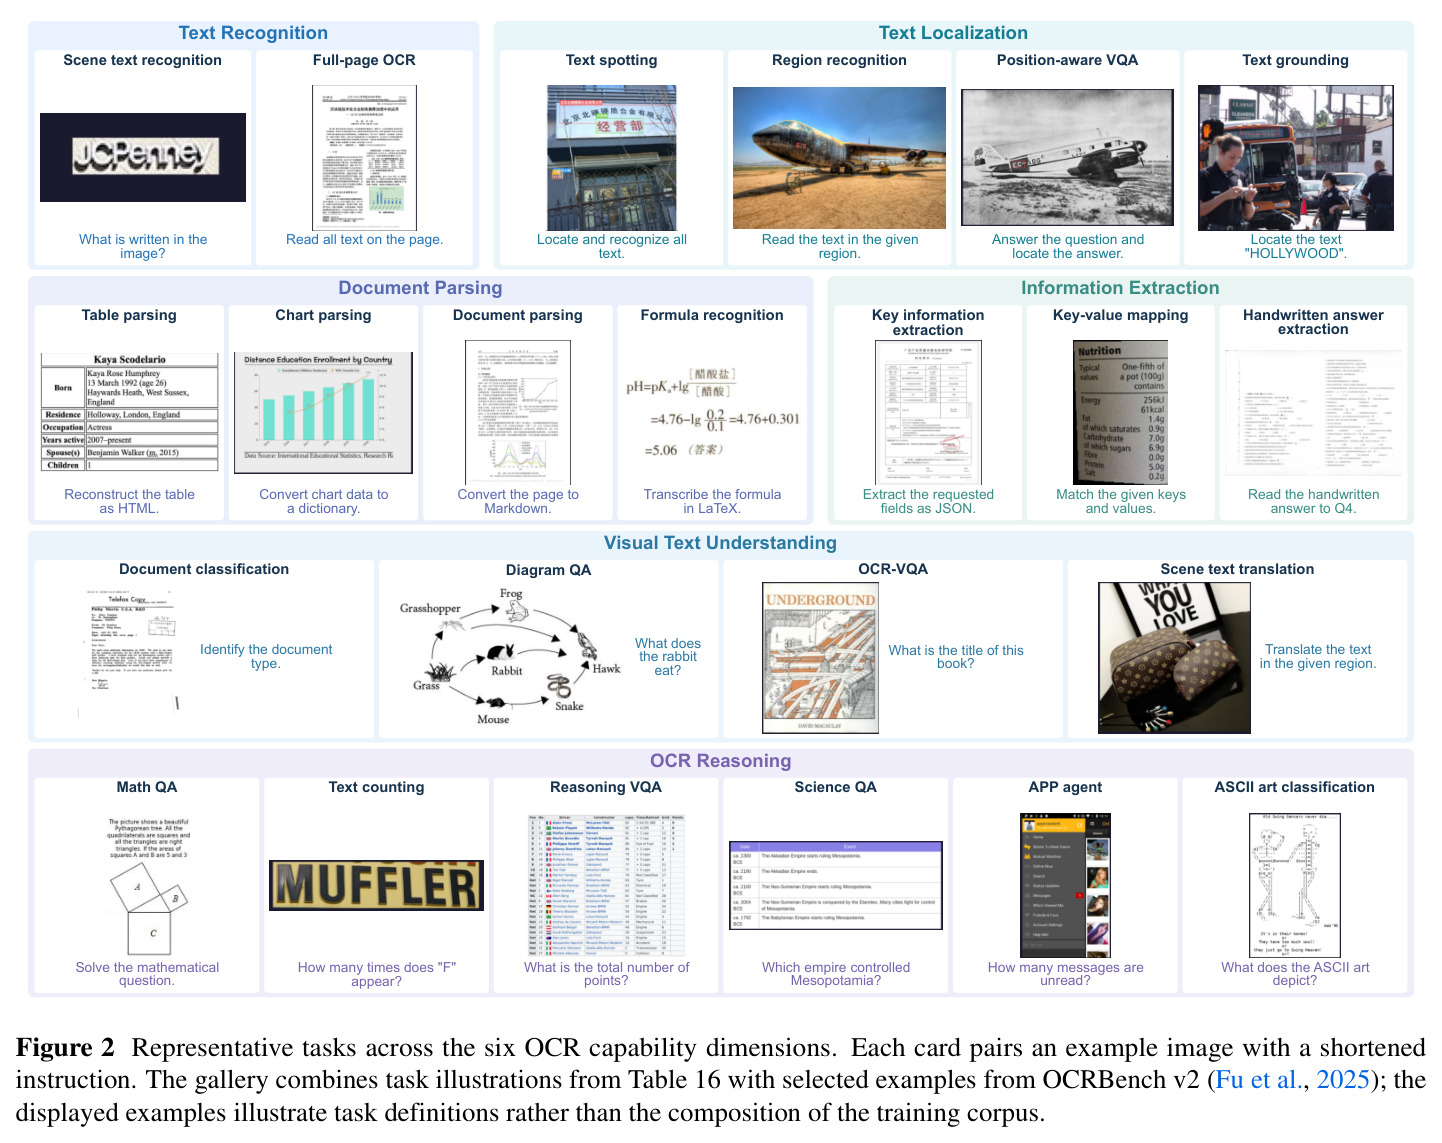
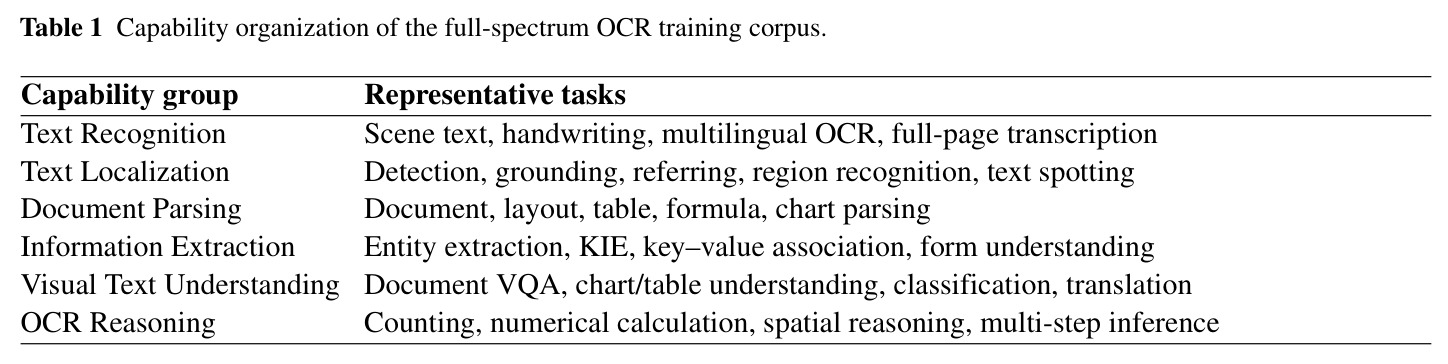
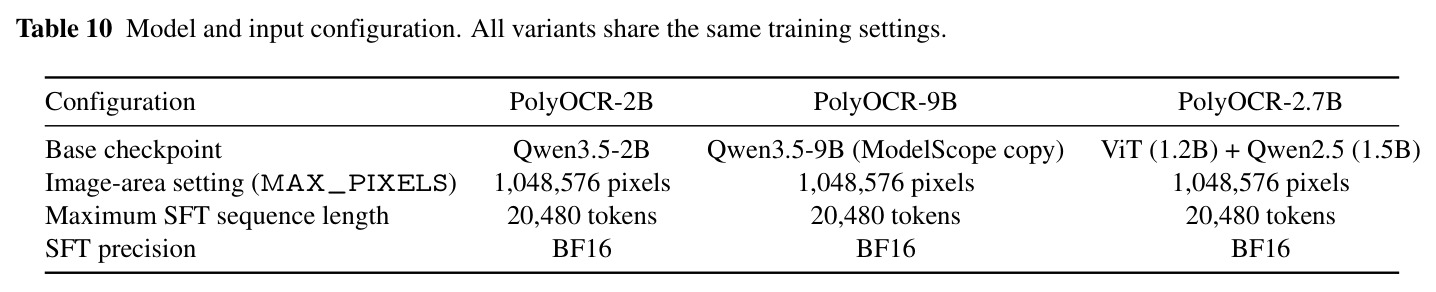
本文的目标是构建覆盖『识别—定位—解析—抽取—理解—推理』全谱系的统一 OCR 基础模型家族:基于 Qwen3.5 的 PolyOCR-2B 与 PolyOCR-9B 通用版,外加面向 21 个语言/文字组的专用多语言解析版 PolyOCR-2.7B(1.2B ViT + 1.5B Qwen2.5)。让转写文本、空间坐标、结构化记录、表格 HTML、公式 LaTeX、翻译等异构输出都通过同一指令跟随自回归接口生成;配套建成约 6000 万质量受控训练实例,并提出能随师生能力边界动态调配监督信号的后训练方法,目标是在 OCRBench v2.1、CC-OCR、OmniDocBench v1.6、MDPBench 与自建 KIE 基准上全面达到 SOTA 或高度竞争力。
与已有工作不同的是,本文的独特切入是不满足于『把任务堆进一个模型』,而是显式建模后训练中教师与学生的能力关系。作者用例子揭示 GRPO 的等奖励退化:一份归一化后 1000 字的金融文档,金额 $18{,}650$ 被全部 8 个 rollout 错写成 $18{,}850$,页面级编辑相似度奖励 $1-1/1000=0.999$ 完全相同,组内优势全为零,策略梯度无法纠正那一位错误数字;而固定权重的 on-policy 蒸馏又会继承教师错误、与学生进步脱节。CGPO 把『教师何时值得听』变成可用验证器分数离线校准、在线逐样本路由的统计决策。此外还贡献 OCRBench v2.1,把评测基准本身当作可审计修订的对象(人工复核 24.5% 样本)。
核心方法
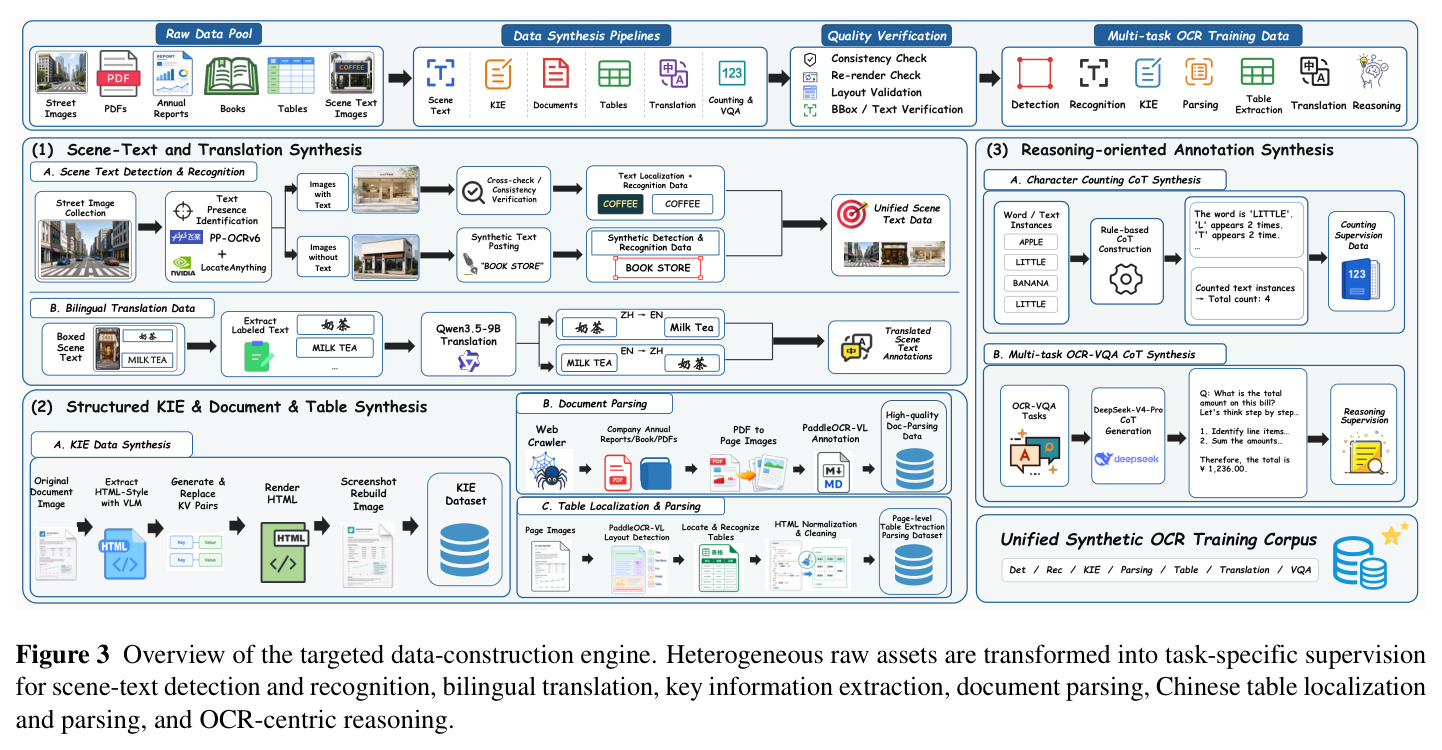
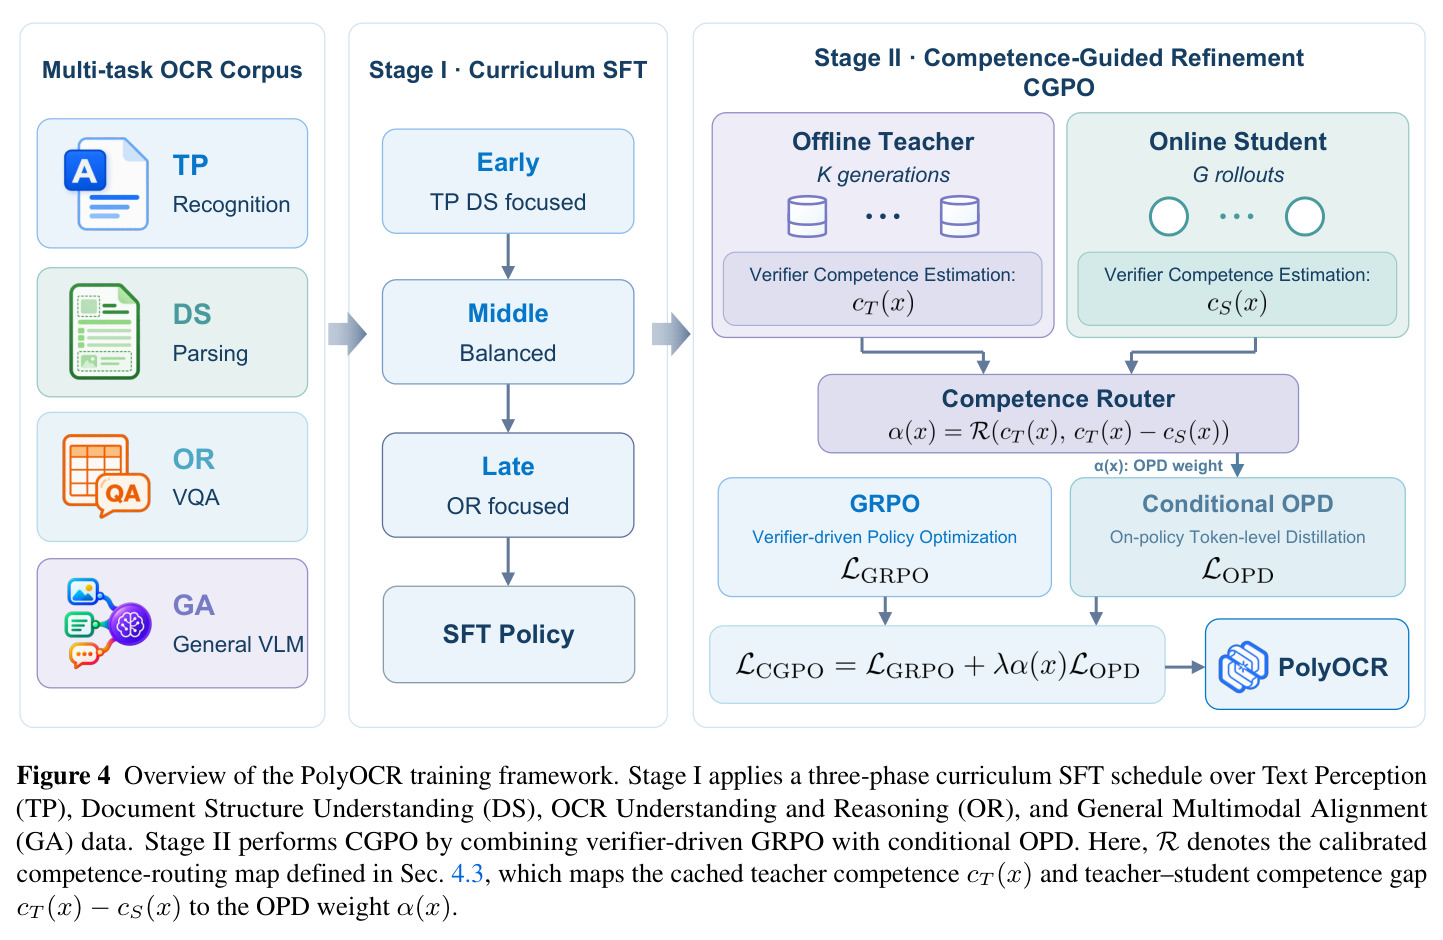
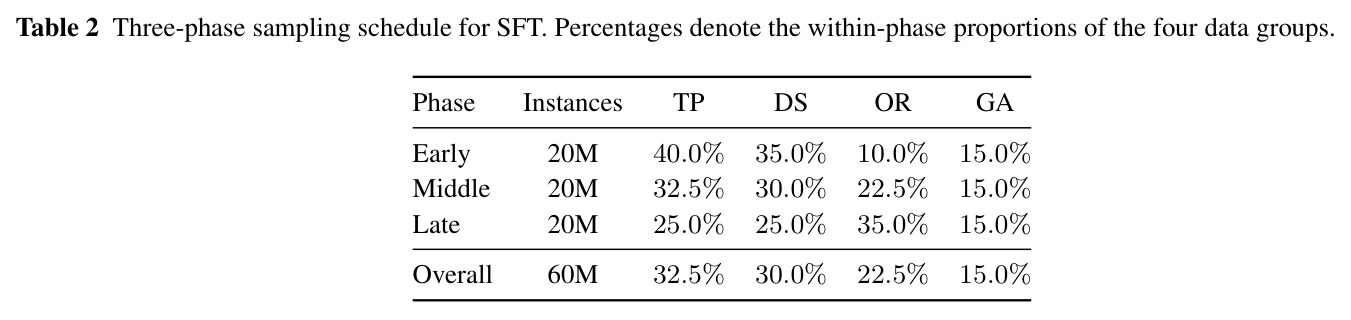
直觉上,OCR 基础模型 = 统一接口 + 均衡数据 + 会『看人下菜』的后训练。技术路线分三步。第一步数据引擎:先全谱系收集公开与内部数据,按文本识别、文本定位、文档解析、信息抽取、视觉文本理解、OCR 推理六个能力维度组织;再对稀缺能力(空间定位的双语翻译、模板化 KIE、中文文档与表格解析、推理类监督)做定向合成,用双标注器交叉验证、HTML 模板重渲染、双解析器一致性加 LLM 仲裁等三重质量控制,最终产出约 6000 万实例。第二步训练:Stage I 做三阶段课程 SFT(每阶段 2000 万实例,TP/DS/OR/GA 配比从 40/35/10/15 漂移到 25/25/35/15);Stage II 引入 CGPO,把验证器 GRPO 与条件化 on-policy 蒸馏结合,蒸馏权重逐样本由教师可靠性与师生能力差决定。第三步评测:修订出 OCRBench v2.1 并在五个基准上用统一推理配置对比。
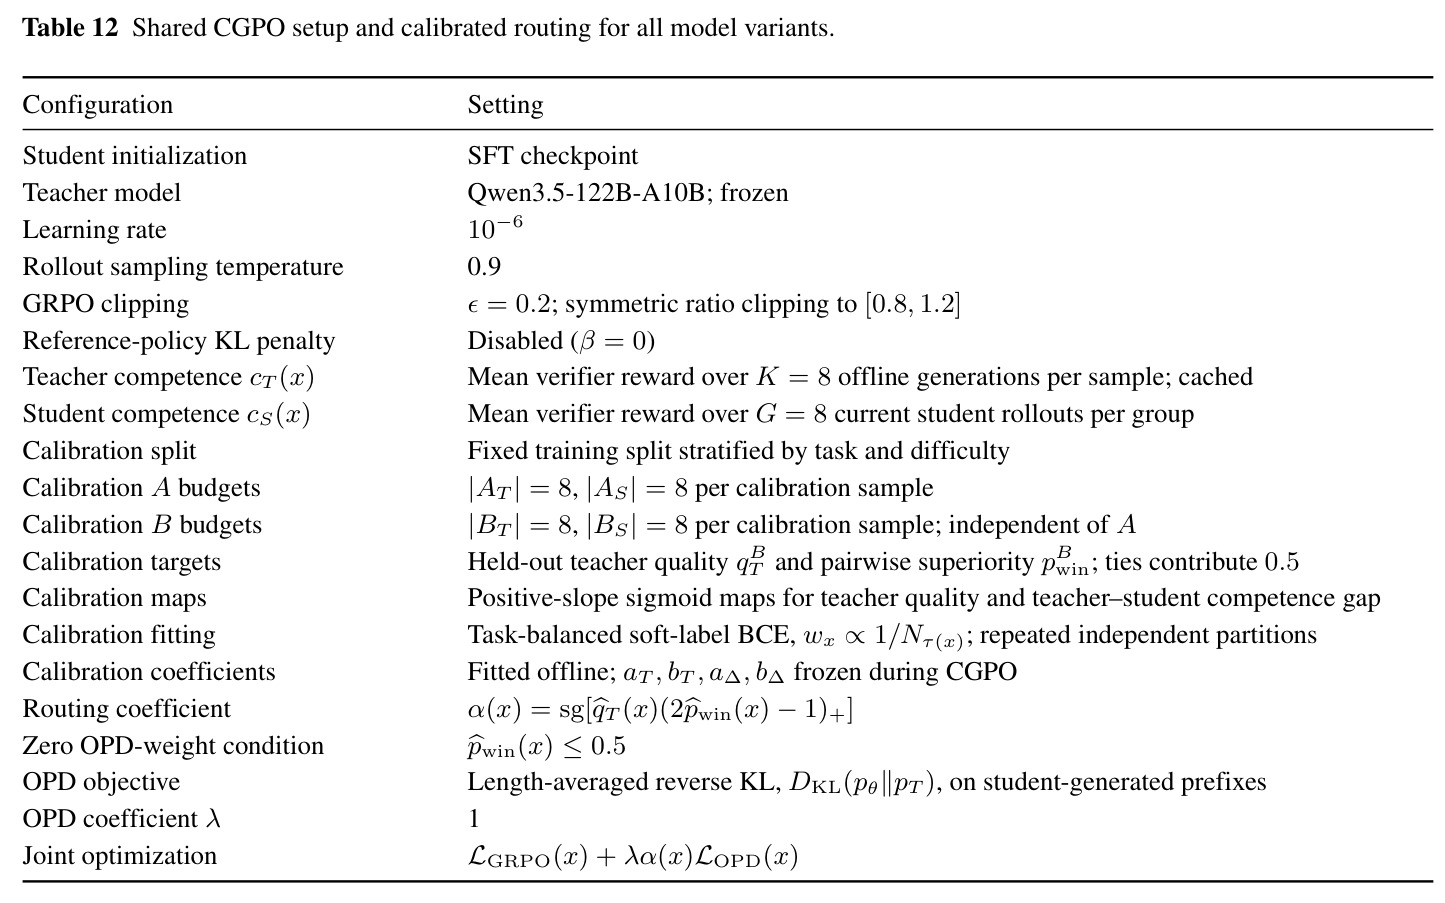
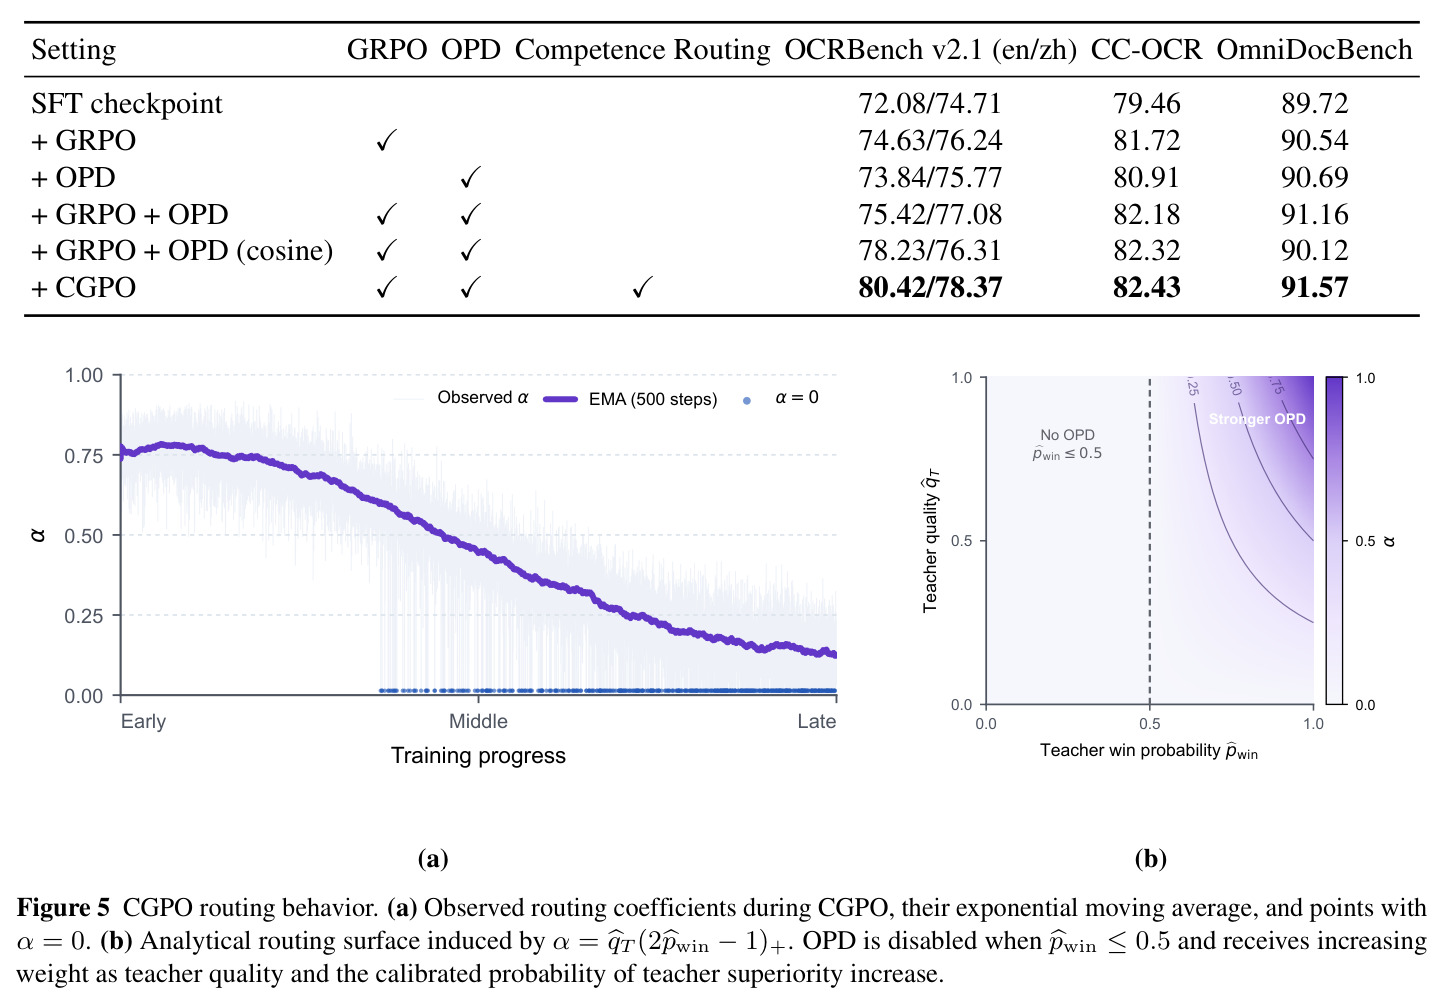
核心创新是 CGPO 的样本级能力路由。与 olmOCR 2(纯 GRPO)、Infinity-Parser2(多任务 RL)、OvisOCR2(固定权重量化蒸馏)不同,CGPO 保留始终开启的 GRPO 作主干,只在教师『确实更强且强得可复现』的样本上叠加蒸馏。具体地:教师离线对每个样本采 $K=8$ 个回答、用任务验证器打分并缓存为教师能力 $c_T(x)$;学生在线采 $G=8$ 个 rollout 得 $c_S(x)$,能力差 $\Delta(x)=c_T(x)-c_S(x)$。路由系数 $\alpha(x)=\mathrm{sg}\big[\hat{q}_T(x)\,(2\hat{p}_{win}(x)-1)_+\big]$,其中 $\hat{q}_T$ 与 $\hat{p}_{win}$ 是经留出生成集校准的教师质量与胜出概率(平局记 0.5),$(z)_+=\max(z,0)$。教师不比学生好时 $\alpha=0$,目标退化为纯 GRPO;总损失为 $\mathcal{L}=\mathcal{L}_{GRPO}+\lambda\,\alpha(x)\,\mathcal{L}_{OPD}$,OPD 项是学生前缀上的反向 KL。
方法步骤详情
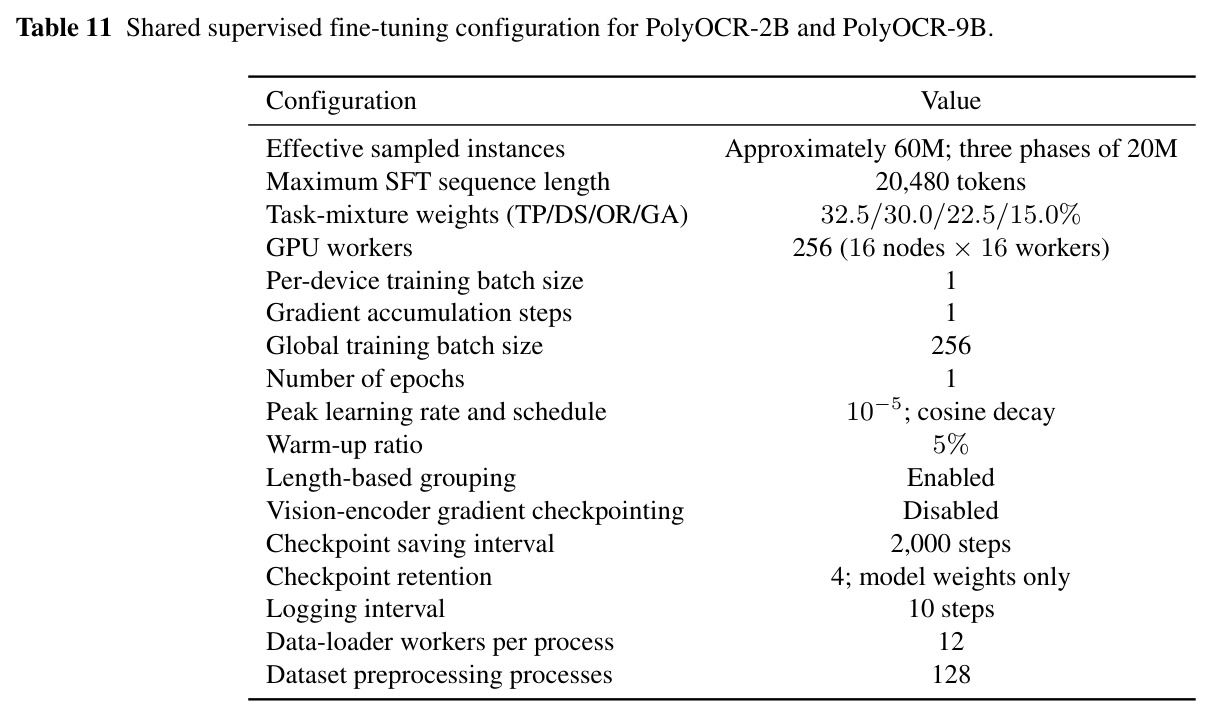
流程如下。(1) 数据引擎:含字真实图像用 PP-OCRv6 与 LocateAnything 双标注器交叉验证(空间重叠+转写一致),分歧样本交人工标注;无字图像渲染文本(控制语言、字体、透视、模糊、压缩);翻译数据由 Qwen3.5-9B 生成并经语言一致性、数字与实体保持等过滤;KIE 由 VLM 把文档重建为 HTML/CSS、语言模型替换键值后重渲染并过滤溢出/重叠;文档与表格页先做视觉特征 k-means 聚类加复杂度分层采样,再用 PaddleOCR-VL 与 MinerU2.5-Pro 双解析、以输出一致性(表格用 TEDS)筛选,低一致样本由 Qwen3.5 仲裁修复;计数 CoT 用确定性模板从已验证标注生成,复杂 VQA CoT 由 DeepSeek-V4-Pro 生成并做一致性校验。(2) Stage I SFT:ms-swift + DeepSpeed ZeRO-2,256 卡 BF16、flash_attention_3,序列上限 20480 token,学习率 $10^{-5}$ cosine 衰减、batch 256、1 epoch,冻结视觉编码器与对齐器、全参微调语言模型。(3) Stage II CGPO:学习率 $10^{-6}$,冻结教师 Qwen3.5-122B-A10B;先在任务与难度分层校准集上以任务平衡软标签 BCE 离线拟合 $a_T,b_T,a_\Delta,b_\Delta$;训练时每步执行『取缓存 $c_T$ → 在线估 $c_S$ 与 $\Delta$ → 算 $\alpha$ → GRPO 加权反向 KL 更新』,$\beta=0$(无参考策略 KL)、$\lambda=1$。
技术新颖性
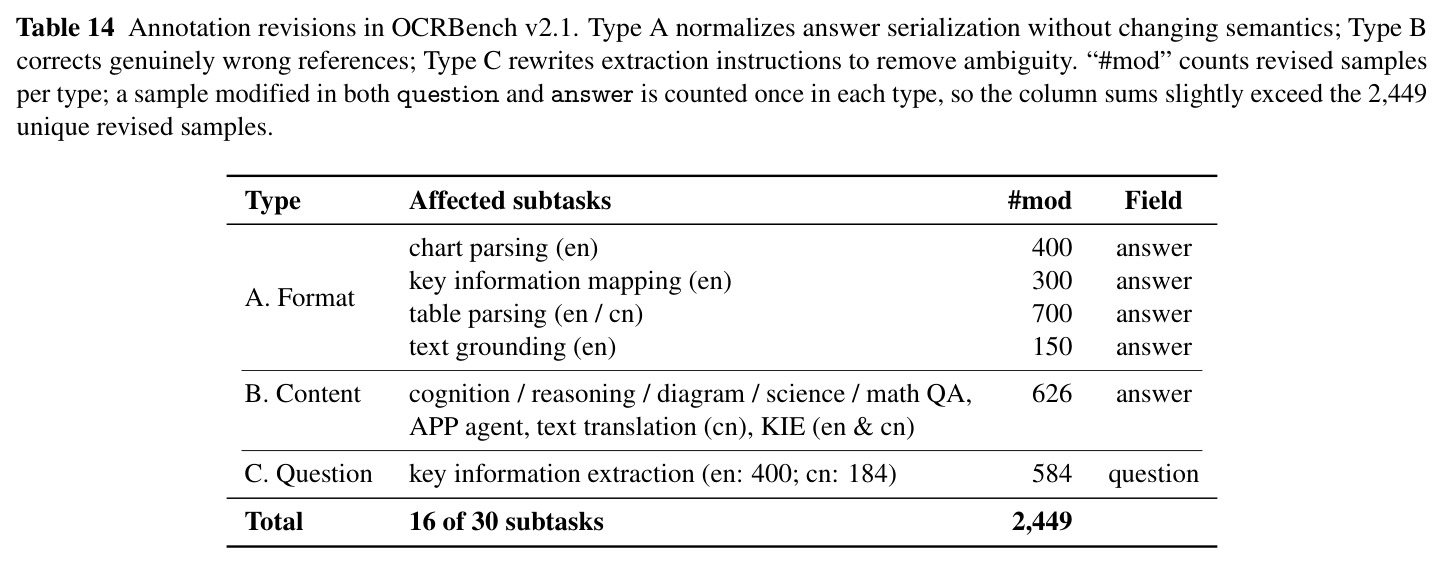
新颖性有三层。(1) 优化信号层面:把『是否蒸馏』从超参数或固定时间表升级为逐样本统计决策——师生用同一参考答案和同一验证器打分,使能力差可度量;在留出生成集上显式估计教师质量与胜出概率并用 soft-BCE 校准单调映射,比 GKD(无条件 on-policy 蒸馏)、SCOPE 与 Reward-Gated OPD(按轨迹路由)更稳健,且路由带停梯度不会污染策略梯度。(2) 数据层面:六能力维度 × 三条合成流水线 × 三类验证(一致性、结构、溯源)的系统化引擎,把定位翻译、中文表格『定位+解析』联合任务等稀缺能力做成可控监督,总量约 6000 万。(3) 评测层面:OCRBench v2.1 是少见的『修订评测协议』实践——公式识别从子串匹配改为渲染级 CDM($\mathrm{F1}=2PR/(P+R)$,在渲染视觉 token 上匹配)、文档解析改内容感知 md2md、翻译改 LLM judge、584 条 KIE 指令统一重写,使指标真正对齐任务语义。
实验结果
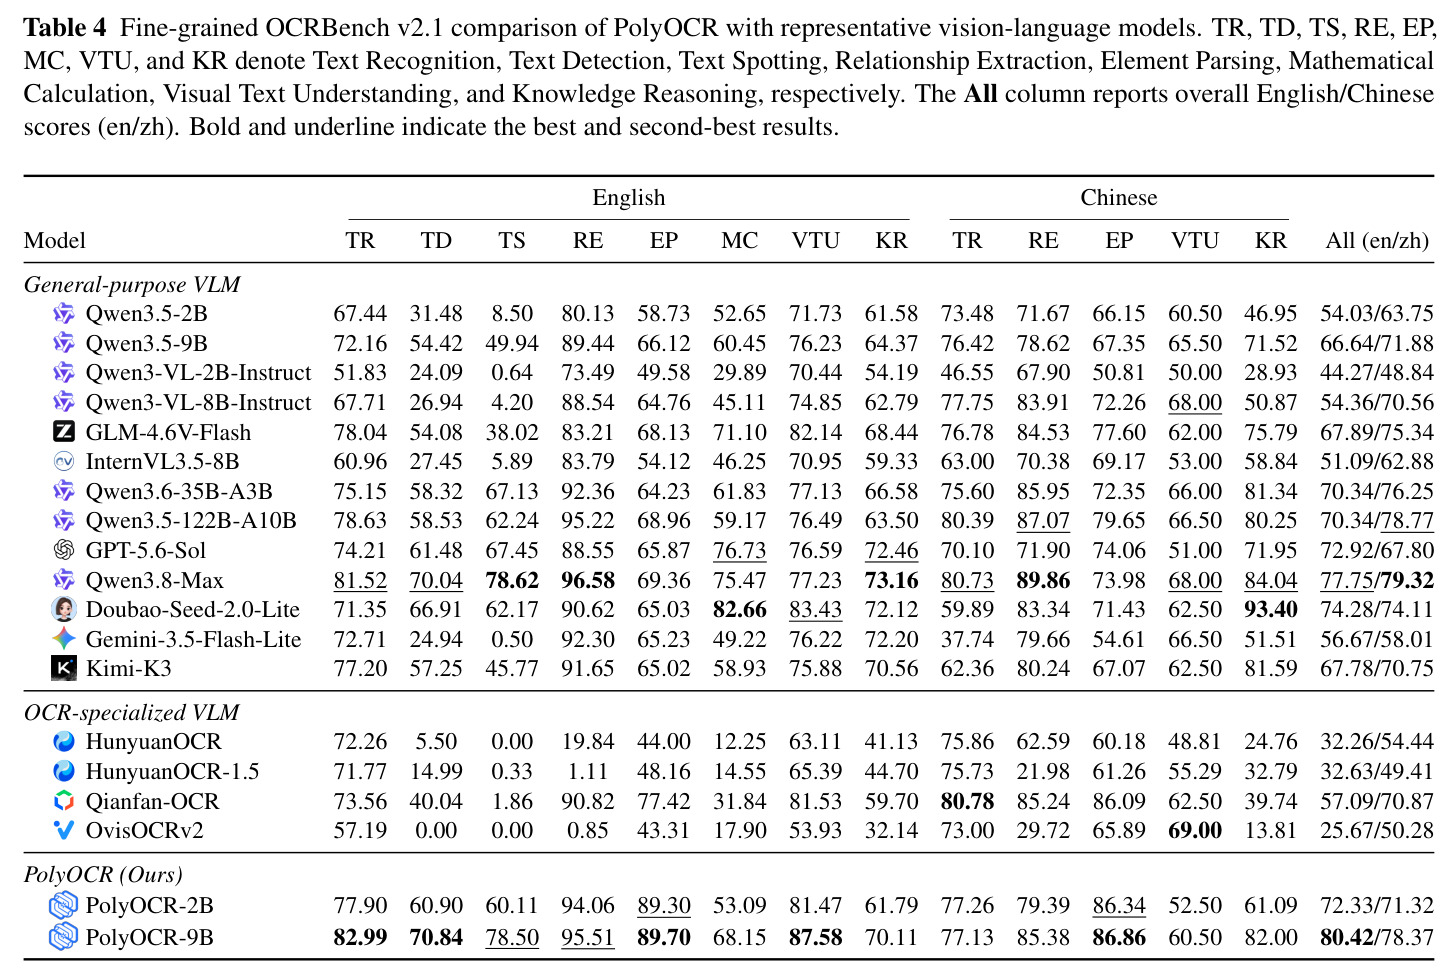
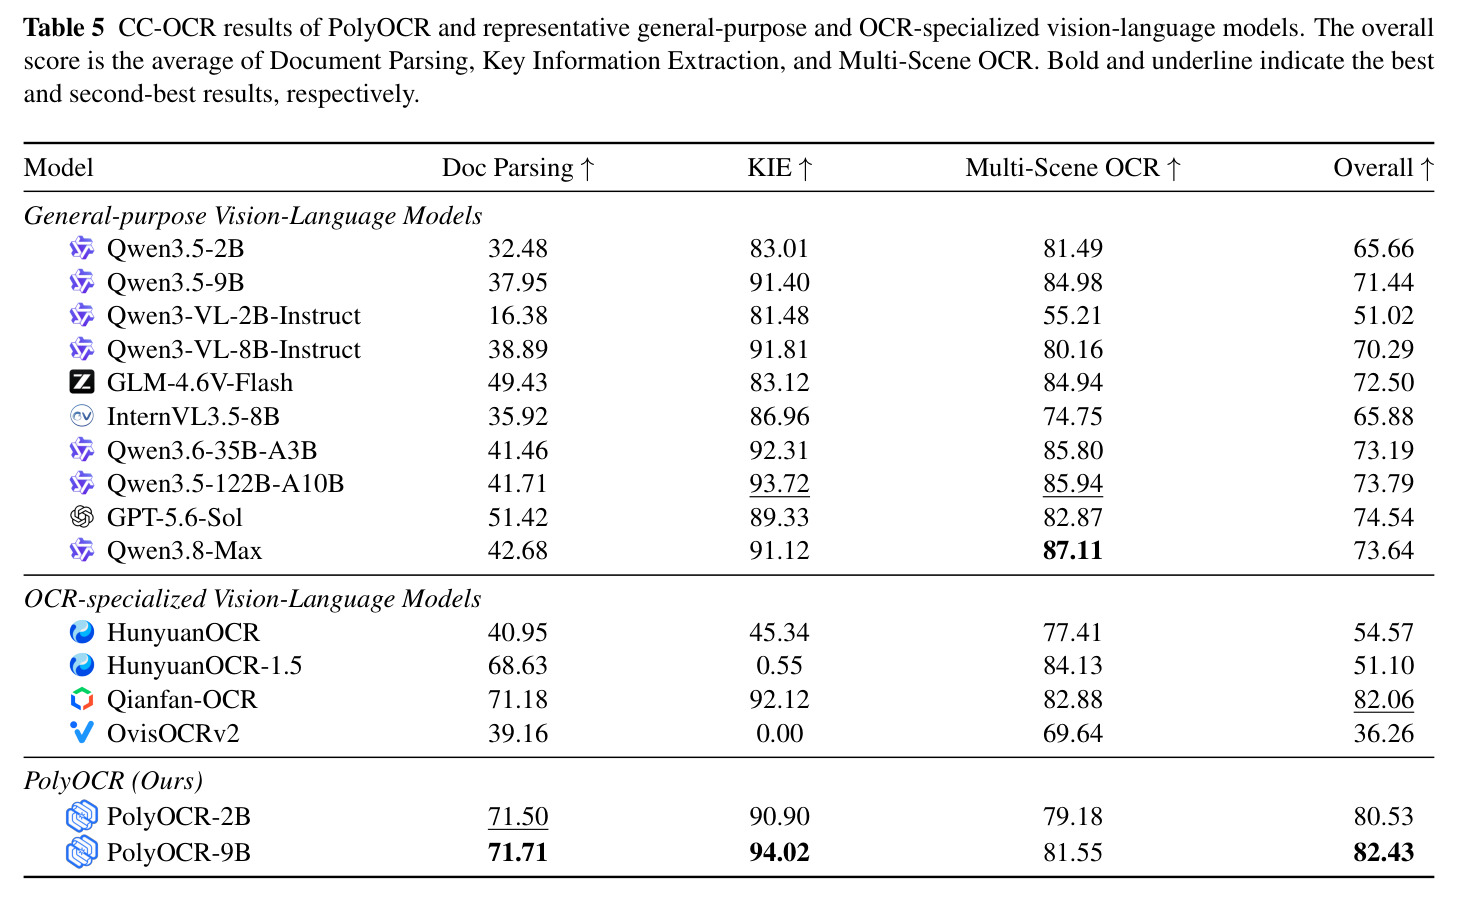
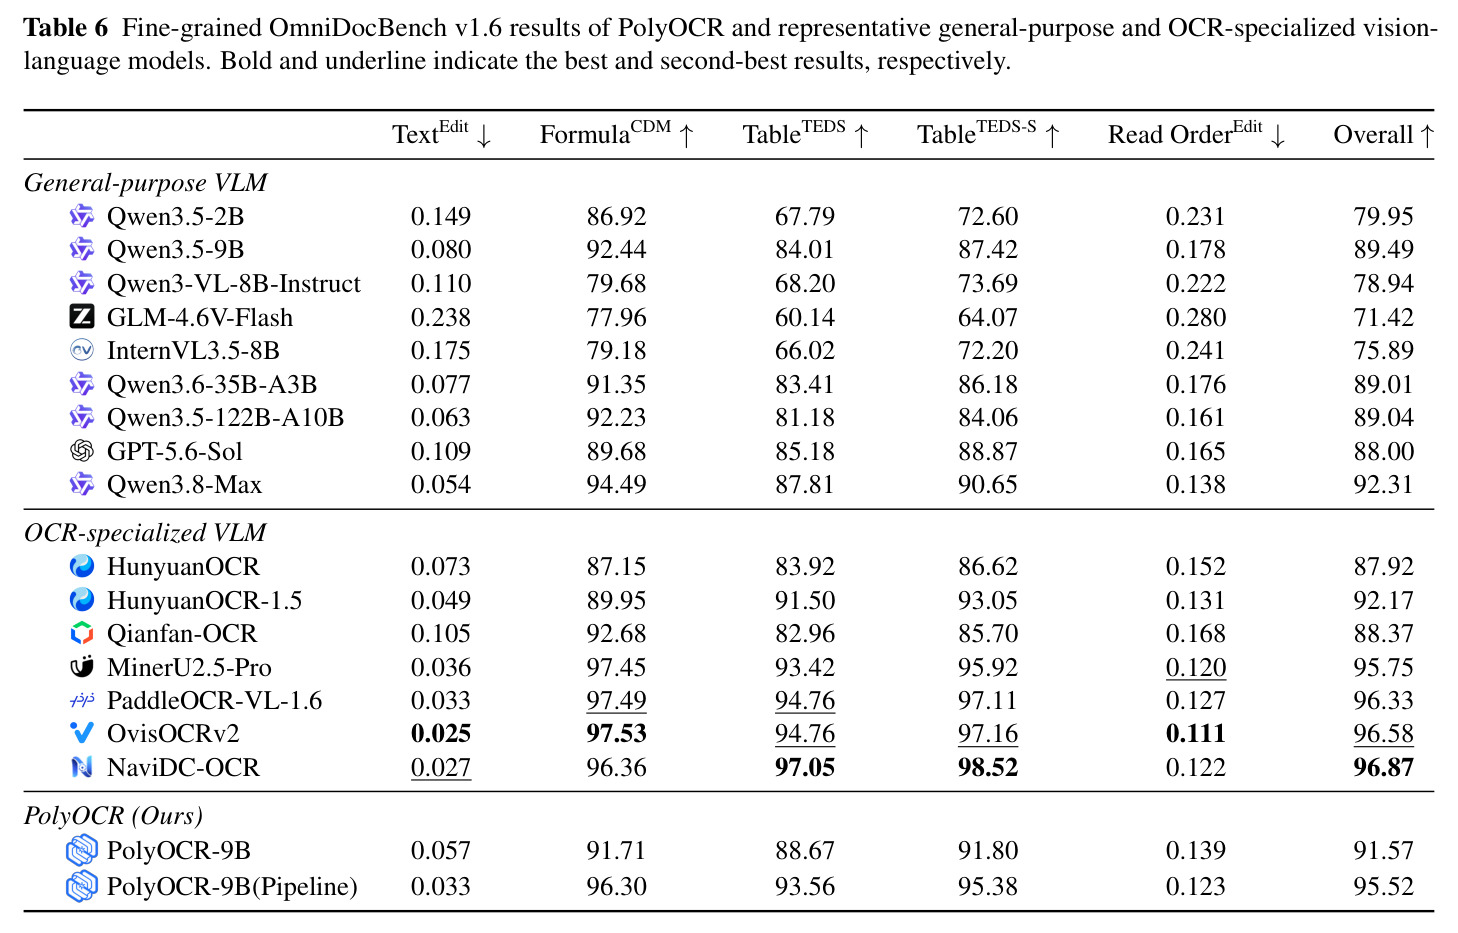
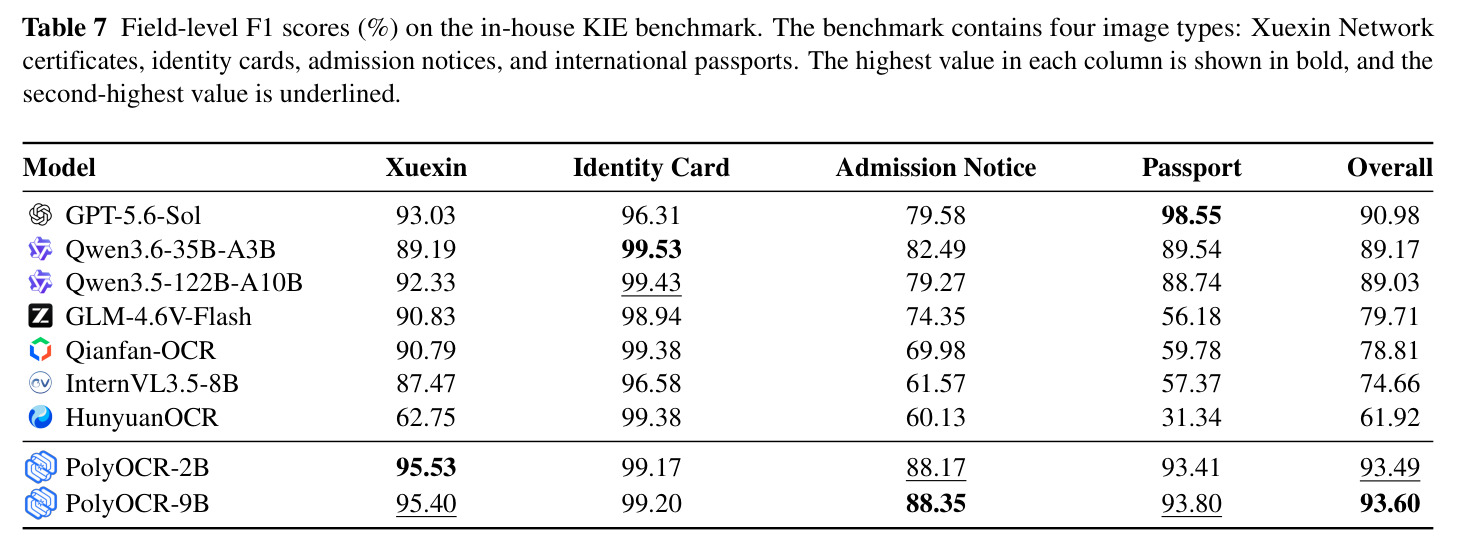
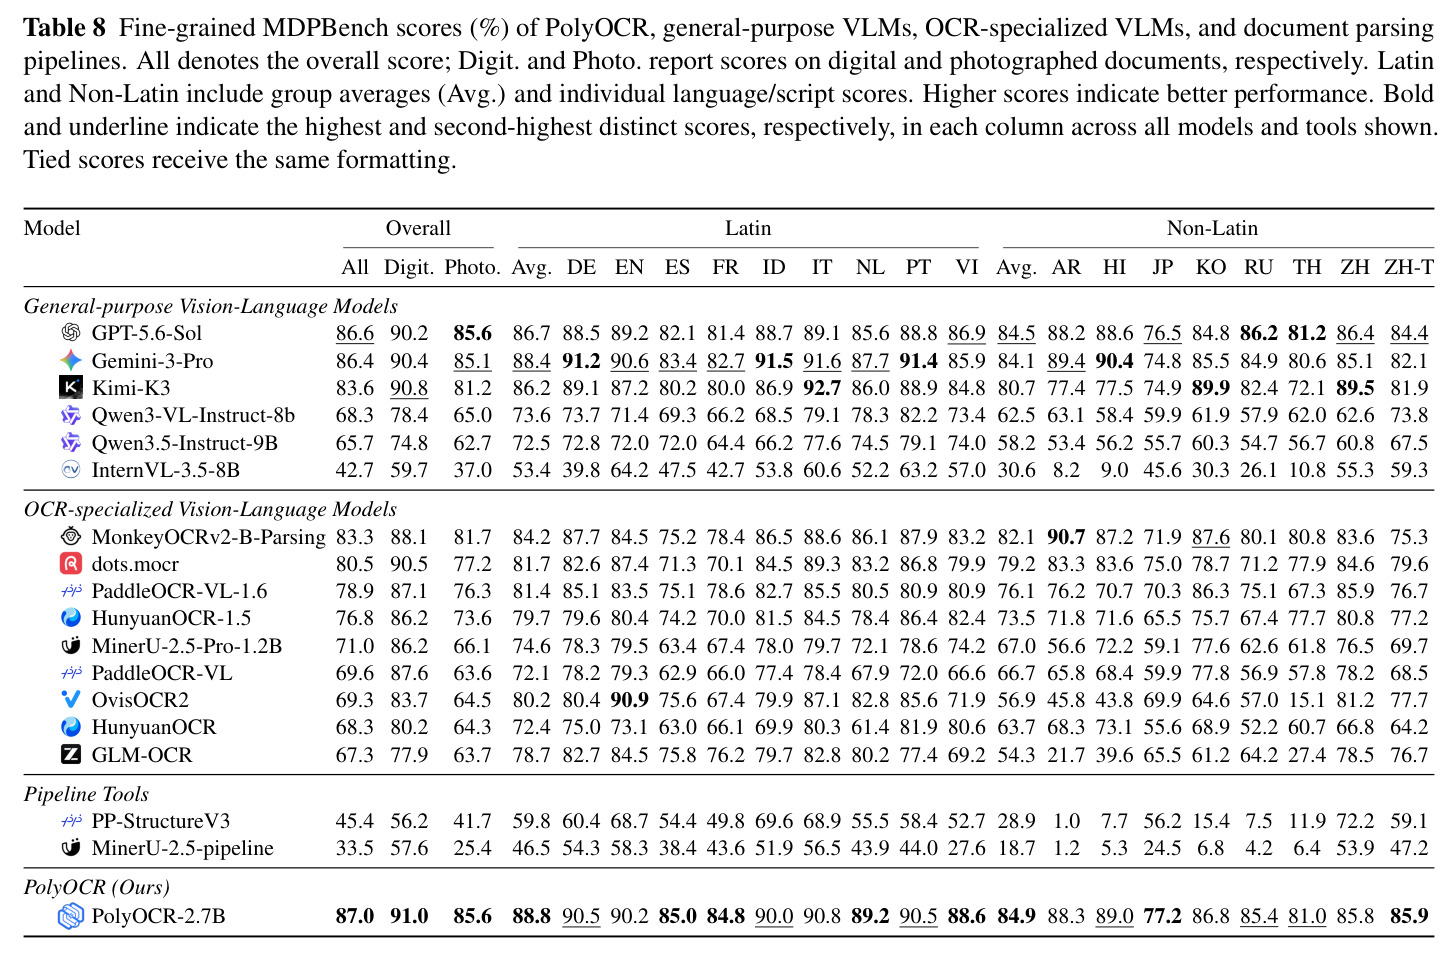
逐项看。① OCRBench v2.1:PolyOCR-9B 英文 80.42 / 中文 78.37,英文超最强通用旗舰 Qwen3.8-Max(77.75)2.67 分;2B 版也达 72.33/71.32,超过多数更大的模型。13 个语言分组中 9B 拿 5 项第一:英文文本识别 82.99、文本检测 70.84、元素解析 89.70、视觉文本理解 87.58、中文元素解析 86.86,另有英文 spotting 78.50 与关系抽取 95.51 两项第二。② CC-OCR:9B 总分 82.43 居首(Doc Parsing 71.71、KIE 94.02 均第一),超 Qianfan-OCR 82.06 与 GPT-5.6-Sol 74.54。③ OmniDocBench v1.6:整页直推 91.57,叠加 PP-DocLayoutV3 版面引导流水线升至 95.52,公式 CDM 91.71→96.30、表格 TEDS 88.67→93.56。④ 自建 KIE 基准:9B 总体 F1 93.60% 第一,超 GPT-5.6-Sol 90.98%、Qwen3.6-35B-A3B 89.17%;录取通知书 88.35% 最佳。⑤ MDPBench:PolyOCR-2.7B 总体 87.0% 领先(数字版 91.0%、拍照 85.6%),17 个语言组中 6 组第一、12 组前二,比最强专用基线 MonkeyOCRv2-B-Parsing 高 3.7 分。⑥ CGPO 消融:从 SFT 检查点(72.08/74.71、79.46、89.72)出发,固定权重 GRPO+OPD 得 75.42/77.08、82.18、91.16,cosine 衰减得 78.23/76.31、82.32、90.12,CGPO 达 80.42/78.37、82.43、91.57,较 cosine 分别 +2.19/+2.06/+0.11/+1.45,证明样本级路由优于步数调度。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OCRBench v2.1(英文) | 综合得分 | 80.42(PolyOCR-9B) | 77.75(Qwen3.8-Max,最强基线) | +2.67 |
| OCRBench v2.1(中文) | 综合得分 | 78.37(PolyOCR-9B,第二) | 79.32(Qwen3.8-Max) | -0.95(略落后最强基线) |
| CC-OCR | 三轨道平均(Doc Parsing/KIE/Multi-Scene) | 82.43 | 82.06(Qianfan-OCR,最强专用);74.54(GPT-5.6-Sol,最强通用) | +0.37;对最强通用 +7.89 |
| OmniDocBench v1.6 | 综合得分 | 91.57(直推);95.52(版面引导流水线) | 96.58(OvisOCRv2)/ 96.87(NaviDC-OCR)专用最强;92.31(Qwen3.8-Max)通用最强 | 直推超多数通用模型;流水线版仍落后专用 SOTA 约 1.05 |
| 自建 KIE 基准 | 字段级 F1(%) | 93.60(PolyOCR-9B) | 90.98(GPT-5.6-Sol) | +2.62 |
| MDPBench 多语言文档解析 | 总体得分(%) | 87.0(PolyOCR-2.7B) | 86.6(GPT-5.6-Sol);83.3(MonkeyOCRv2-B-Parsing,最强专用) | +0.4;对最强专用 +3.7 |
| CGPO 消融(CC-OCR) | 总体得分 | 82.43 | 82.18(固定权重 GRPO+OPD);82.32(cosine 衰减 OPD) | +0.25;+0.11 |
局限与改进
作者承认的短板:中文侧仍不敌最强通用模型——OCRBench v2.1 中文 78.37 低于 Qwen3.8-Max 的 79.32,中文文本识别(77.13)与中文视觉文本理解(60.50)也非最优;数学计算 68.15 明显落后 Doubao-Seed-2.0-Lite 的 82.66。OmniDocBench 纯直推 91.57 仍低于 OvisOCRv2(96.58)、NaviDC-OCR(96.87)等专用系统,需要外挂 PP-DocLayoutV3 流水线才能逼近第一梯队。我的补充观察:其一,CGPO 的收益上限受教师钳制,教师 Qwen3.5-122B-A10B 并非 OCR 专项最强,在其 $\hat{q}_T$ 低的任务上 CGPO 实际退化为纯 GRPO;其二,OCRBench v2.1 修改协议后与原 v2 榜单不可直接比较,且 KIE 与 MDPBench 含自建成分,跨论文可比性受限;其三,路由依赖 8 次 rollout 的经验统计,极端难度样本的 $\Delta(x)$ 估计方差大;其四,『单一统一模型』叙事与 OmniDocBench 最佳成绩依赖外挂流水线的部署形态之间存在张力。
独立分析的弱点
弱点一:教师天花板。CGPO 用 $\hat{q}_T(x)$ 显式抑制不可靠教师的蒸馏权重,当 122B-A10B 级通用教师在长尾场景(手写公式、少数民族文字、极端模糊照片)本身不可靠时,样本只剩稀疏的 GRPO 信号,前述『18,650』式等奖励退化依然无解。改进方向:多教师池按任务/样本路由,或对教师不可靠样本引入确定性合成参照提供密集奖励。弱点二:验证器仍以表面匹配为主,NED/TEDS/IoU 无法惩罚语义级幻觉(金额对但币种错、表格结构对但行列语义错),而 LLM judge(Gemini-3.5-Flash-Lite)自身噪声会经奖励进入策略。改进:对高价值字段加规则重算与交叉一致性二次校验。弱点三:$\alpha$ 作用于整条序列的 KL,粒度太粗——教师可能在表格结构上可靠、在某一个单元格上错误。改进:把路由下沉到 token/span 级。弱点四:约 6000 万合成数据的质量以 PaddleOCR-VL 与 MinerU2.5-Pro 的输出一致性为代理,两解析器若共享系统性偏差(同类渲染伪影、相近训练分布)会『一致地错』,该风险在论文中未被量化。
未来方向
作者提出的方向:继续夯实细粒度文本感知、定位与识别等基础能力,向文本抽取之外的语义理解与推理延伸,提升真实复杂环境下的泛化与鲁棒性。基于成果可延伸的工作:(1) 多教师 + 课程式教师退役——随学生能力增长自动切换更强教师或逐步关闭蒸馏,使 CGPO 的『能力边界跟踪』从单教师扩展为教师序列;(2) 路由粒度从样本级下沉到 token/片段级,仅对教师可靠片段施加 KL 监督;(3) 把 OCRBench v2.1 的指标修订方法论(渲染级 CDM、md2md、多参考答案)推广到社区其他文档基准,缓解『指标与任务语义错位』这一普遍问题;(4) 将外挂版面流水线改为端到端联合训练,消除 PP-DocLayoutV3 与解析模型之间的误差边界;(5) 数据引擎开放为在线飞轮,用 CGPO 路由信号(低 $c_S$ 高价值样本)反向指导新数据的定向合成,形成『训练-评测-造数』闭环。
复现评估
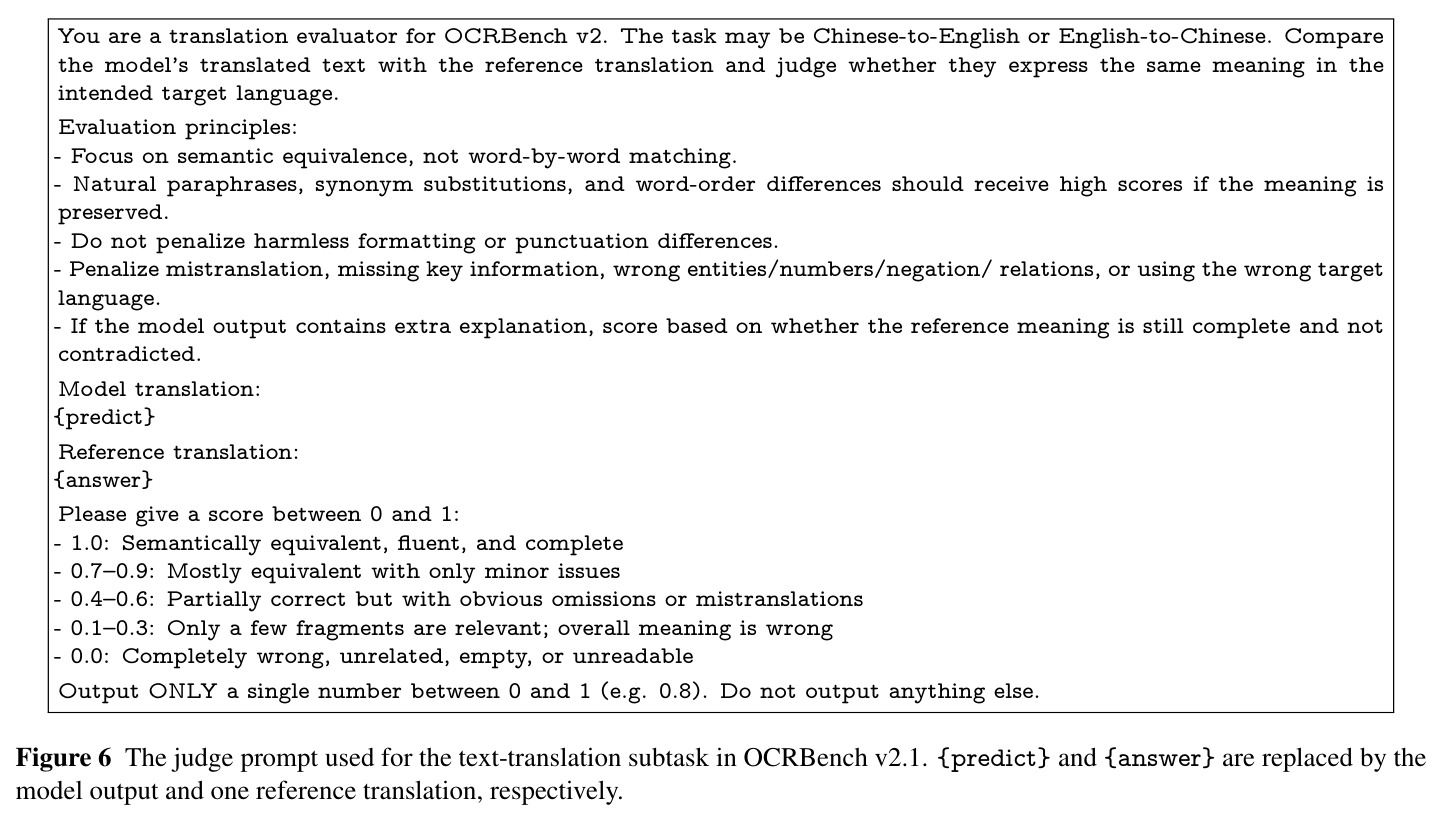
复现条件较好但门槛不低。利好:代码与模型开源(GitHub: inclusionAI/PolyOCR-Venus),附录配置极详尽——SFT 用 ms-swift + DeepSpeed ZeRO-2、256 GPU(16 节点×16 卡)、BF16、flash_attention_3、序列 20480、lr $10^{-5}$、batch 256、1 epoch;CGPO 全套超参(温度 0.9、裁剪 $\epsilon=0.2$、$\beta=0$、$\lambda=1$、$K=G=8$、校准集 A/B 划分与拟合方式)完整列出;验证器归一化规则、LLM judge 提示词(Figure 6)承诺随模型发布,OCRBench v2.1 修订标注与评测代码也计划开源。障碍:约 6000 万训练实例、自建 KIE 基准与 MDPBench 部分数据为内部资产,外部无法完整复现数据引擎;CGPO 需 122B-A10B 教师做 $K=8$ 离线推理与在线前缀打分,训练需千卡级算力;第三方须用修订协议重评所有对比模型才能对齐 OCRBench v2.1 数字。总体判断:推理与 2B/2.7B 微调可在单机 8 卡级复现,全量训练复现需大规模集群,评测复现中等难度。
论文图表
同一 SFT 检查点下六种后训练配置对比:SFT 72.08/74.71、79.46、89.72 → +GRPO 74.63/76.24、81.72、90.54 → +OPD 73.84/75.77、80.91、90.69 → GRPO+OPD 固定 75.42/77.08、82.18、91.16 → cosine 衰减 78.23/76.31、82.32、90.12 → CGPO 80.42/78.37、82.43、91.57
CGPO 有效性的直接证据:逐样本路由全面优于固定权重与步数调度,且 cosine 版中文反而退化(76.31),凸显能力路由的必要性