分解偏旁再奖励:面向中文文本精确渲染的细粒度检测 Decompose Radicals, Then Reward: Fine-Grained Inspection for Accurate Chinese Text Rendering
用表意文字描述序列构造部件级细粒度奖励,提升文生图模型中文汉字渲染的结构准确性
前置知识
IDS(表意文字描述序列)
Unicode 定义的一种用线性序列描述汉字二维结构的形式语言,由结构操作符(⿰ 左右、⿱ 上下、⿴ 包围等)和部件(偏旁、独体字)递归组成,如“明”写作 ⿰日月。任何汉字都可被序列化为一串 token,天然适合序列到序列建模。
这是本文的核心表示:奖励的细粒度完全取决于 IDS 分解的质量,理解它才能明白“部分结构信用”从何而来。
GRPO(组相对策略优化)
一种强化学习后训练算法:对同一提示采样一组输出,用组内奖励的相对优势替代价值网络来更新策略,无需训练 critic。在扩散模型上结合流匹配采样即 Flow-GRPO。
IDSpect 正是作为 GRPO 的奖励函数被使用的,不熟悉该框架就无法理解奖励如何反过来塑造生成器的行为。
OCR 奖励
用 OCR 模型识别生成图像中的文字,将识别串与目标串比较(如归一化编辑相似度)作为强化学习奖励,是文生图文字渲染优化的常见做法,但它把每个字符当作原子符号整体评判。
本文的全部动机来自 OCR 奖励的原子性缺陷,理解它才能看清 IDS 结构分支到底补上了哪一块信号。
Token 级 F1 与编辑距离
F1 是精确率与召回率的调和平均,这里逐 token 统计 IDS 预测与目标序列的匹配数;编辑距离 Lev 衡量两字符串之间最小的插入/删除/替换操作次数,除以长度归一化后可作为相似度使用。
论文的两个奖励分支分别建立在归一化编辑相似度与 token 级 F1 之上,公式 (1)(2) 的含义依赖这两个概念。
研究动机
文生图模型在渲染中文文本时仍频繁出错:汉字是可复用部件按左右、上下、包围等空间关系构成的二维组合体,一个部件或空间关系出错就会导致整字崩坏。现有基于 OCR 的强化学习奖励把图像解码成文字串后与目标串整体比较,把每个汉字当作原子符号,带来两类失败。其一,部分修复得不到回报——把写错的字的某个部件修对,只要 OCR 仍识别不出该字,奖励纹丝不动;其二,语言先验造成假阳性——如图1所示,对同一个畸形字形,全局 MLLM OCR 借助上下文把它“脑补”成正确的目标字,局部贡献高达 1.00,而结构感知评估器 TextPecker 把异常字形整体折叠成“#”,得 0.00,正确与错误的内部结构从此再无区分。原子化反馈让模型只学会生成“看起来像目标”的字形,而非忠实再现其内部结构。
本文的目标是本文的目标是构造一个细粒度、目标条件化的组合式奖励 IDSpect:把目标文本确定性地分解为 IDS(表意文字描述序列)token 序列,再用专家 IDS 识别器从生成图像的文本裁剪中读出视觉 IDS 预测,与目标序列逐 token 对齐比较,从而在整字仍被 OCR 判错时,也能为部件和空间关系的部分修复给出连续的部分得分。该结构奖励与整字语义奖励按 $R=\lambda r_{sem}+(1-\lambda)r_{ids}$ 融合,用于指导 Qwen-Image 的 GRPO 后训练,在不修改生成器结构、不增加推理时成本的前提下同时提升结构质量与语义对齐。作者希望在 LongText-Bench 和 GenTextEval-Bench 上超越通用 OCR 奖励与 TextPecker 奖励,验证“分解偏旁再奖励”路线的有效性。
与已有工作不同的是,独特切入点在于表示的迁移方向。此前中文 OCR 研究用偏旁、笔画和 IDS 识别生僻字或未见字——分解只是识别的中间手段;本文反过来把 IDS 识别器当作奖励模型,用其结构化输出去优化生成器,分解成为评估与优化的语言。此外,与 TextPecker 只做整字级异常检测、把错字粗糙地折叠为“#”不同,IDSpect 定量衡量“目标字内部结构已完成多少匹配”,奖励是连续的细粒度信用而非 0/1 判断。作者还通过消融发现结构参照的选择至关重要:以 OCR 预测为参照的逐裁剪一致性(Sem. 仅 0.901)会放过与请求文本不符的结构,因此本文坚持以目标文本的规范 IDS 为参照(Sem. 0.911),把结构奖励锚定在用户真正想要的输出上。
核心方法
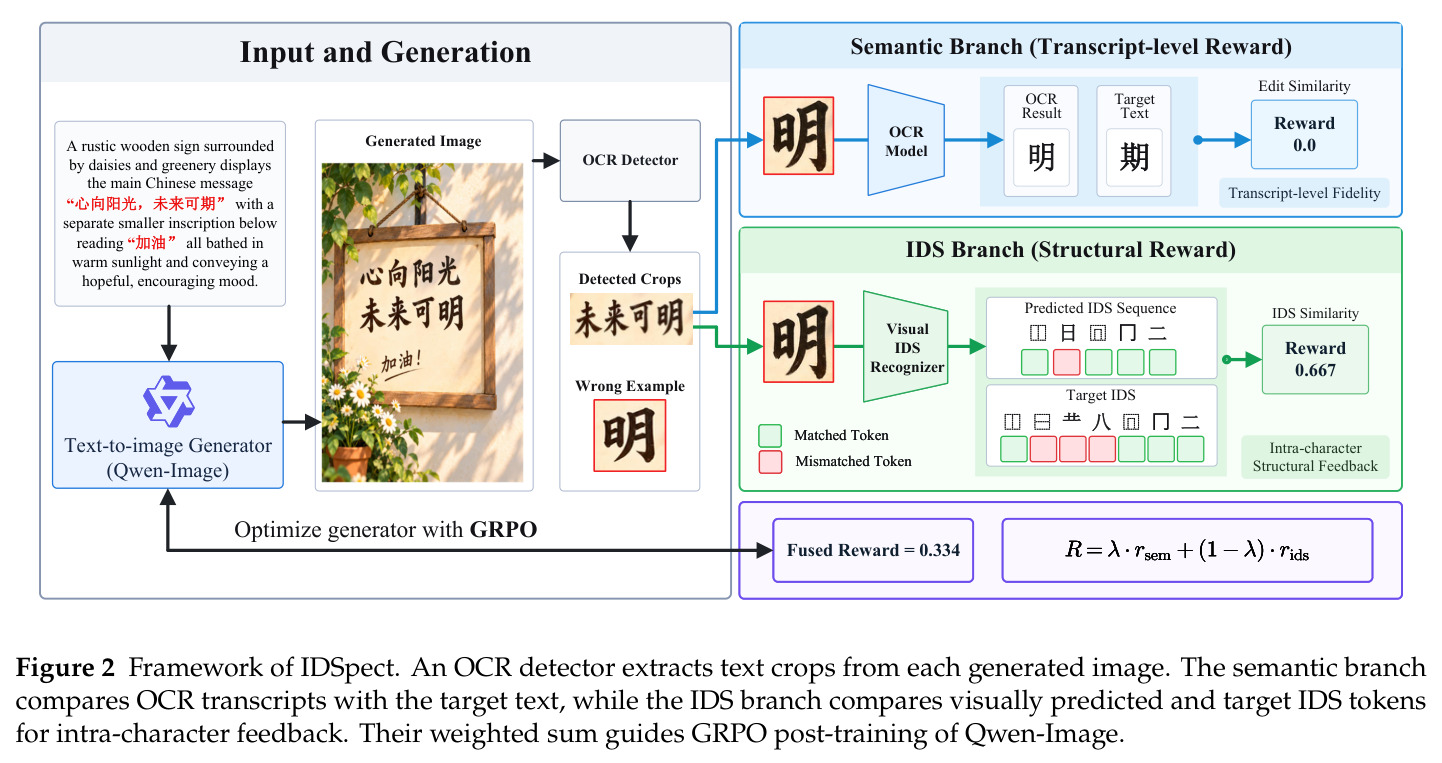
直觉:与其问“这个字识别对了吗”,不如问“这个字的部件和空间关系画对了多少”。技术路线分两支。训练阶段,先用 UnionST 渲染引擎构建 IDSynth-1M——100 万张字符频率均衡的合成文本图,训练专家 IDS 识别器 $f_{ids}$:SVTRv2 视觉编码器 + NRTR 风格 Transformer 解码器,自回归地把文本图像直接转录成 IDS token 序列,而非先识别字符再做符号分解。后训练阶段,OCR 检测器从生成图像中裁出 $K$ 个文本区域,语义分支比较 OCR 转录与目标文本的编辑相似度,结构分支把每个裁剪的视觉 IDS 预测与目标的确定性 IDS 序列做裁剪级对齐并计算 token 级 F1;二者按 $R=\lambda r_{sem}+(1-\lambda)r_{ids}$($\lambda=0.5$)融合,驱动 Flow-GRPO 后训练 Qwen-Image 的 LoRA 适配器,两个奖励分支在训练后被丢弃,生成器推理零额外开销。
核心创新是把整字奖励拆成部件级、空间关系级的可加信用,关键有三。一是目标 IDS 确定性:由 BabelStone 词表(Unicode 16.0)对 GB 18030–2022 覆盖的全部汉字递归分解得到,深度封顶 10,使比较不依赖任何识别器的主观判断。二是裁剪级对齐:检测裁剪的顺序任意,作者用半全局编辑对齐生成候选目标 span,经非极大值抑制去重,再做全局指派让每个裁剪至多对应一个目标 span,且每个目标位置只能被精确匹配记功一次,使奖励对裁剪顺序鲁棒。三是均衡数据 IDSynth-1M:随机组合字符切断“先认高频字、再背其标准 IDS”的语言捷径,迫使模型从视觉证据预测部件。图1中,对畸形字形 IDSpect 给出 0.22 的部分得分,而专家 OCR、MLLM OCR、TextPecker 分别是 0.00、1.00(假阳性)、0.00,部分信用优势一目了然。
方法步骤详情
第一步,构词表:用 BabelStone(Unicode 16.0)递归分解 GB 18030–2022 汉字,$D(y)=D(c_1)\oplus\cdots\oplus D(c_M)$ 即目标 IDS 序列,深度封顶 10。第二步,造数据训识别器:均匀采样随机文本、UnionST 渲染 100 万张图配 IDS 标签(解码上限 100 token),训练 $f_{ids}$(SVTRv2 编码器 + NRTR 式解码器,直接输出部件与空间操作符)。第三步,算奖励:OCR 检测器出 $K$ 个裁剪,$f_{ids}$ 逐裁剪预测 $\hat{s}_k$;与目标 $s=D(y)$ 半全局对齐、NMS 去重、全局指派得 $A^\star$,$r_{ids}=\frac{2C(A^\star)}{|D(y)|+\sum_k|\hat{s}_k|}$($C$ 为唯一记功 token 数);$r_{sem}$ 目标串出现于识别串时取 1,否则 $1-\min\{\mathrm{Lev}(\bar{\hat{y}},\bar{y}),|\bar{y}|\}/|\bar{y}|$。第四步,融合:$R=\lambda r_{sem}+(1-\lambda)r_{ids}$($\lambda=0.5$),Flow-GRPO 训 LoRA(秩 64、$\alpha=128$、lr $3\times10^{-4}$),奖励训练后丢弃。
技术新颖性
新颖性体现在三个层面。表示层面:把奖励信号从“整字类别”升维到“部件+空间操作符的序列”,使同属识别失败的不同结构错误获得可区分、可渐进的信用,这是对 OCR 原子奖励的根本改造,而非像 TextPecker 那样只在整字级叠加异常标记。机制层面:目标条件化的裁剪级对齐(半全局对齐 + NMS + 全局指派 + 唯一记功)解决了检测顺序不定、裁剪覆盖范围不一的难题,消融显示它比直接拼接高 0.025 Sem.、比字符级匹配高 0.012 Sem.。训练层面:IDSynth-1M 的均衡字符采样直接回应了“识别器可能走语言捷径”这一深层风险——随机文本让语言先验无法兜底,保证 IDS 预测真正建立在视觉部件证据之上。此外,奖励仅在训练期使用,生成器结构与推理成本完全不变,是一个干净的外挂式改进。
实验结果
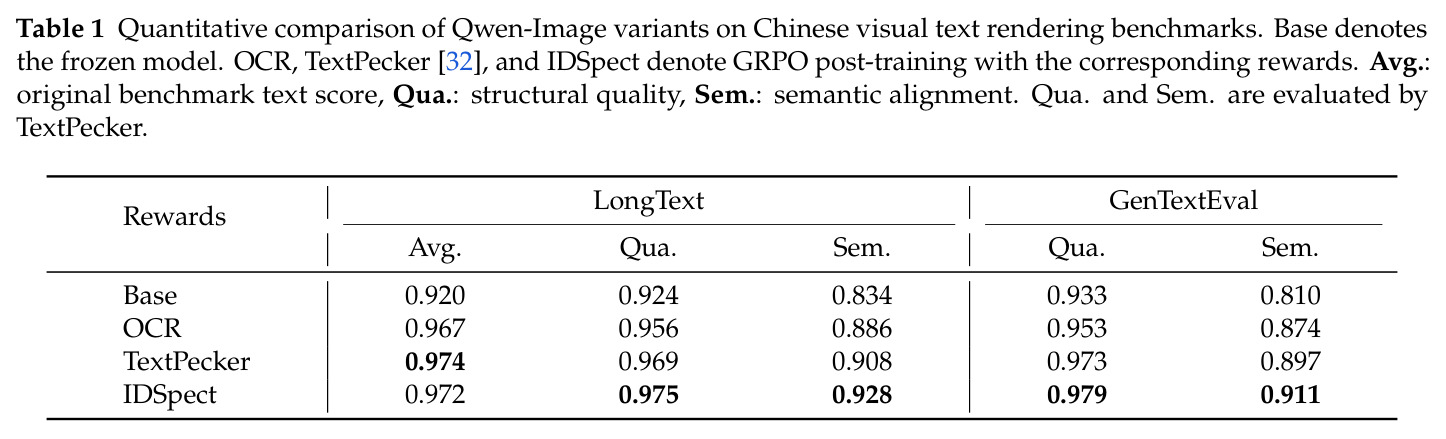
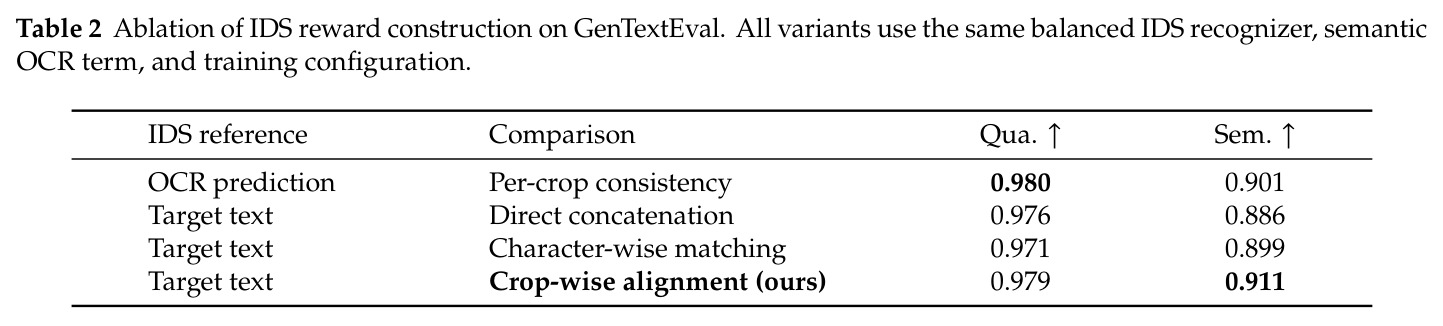
主实验(表1)比较冻结基座、OCR 奖励、TextPecker 与 IDSpect。OCR 奖励已大幅提升(LongText Avg. 0.920→0.967,Sem. 0.834→0.886),TextPecker 进一步到 Avg. 0.974。IDSpect 在 LongText 取最高 Qua. 0.975、Sem. 0.928(较 OCR +0.019、+0.042;较 TextPecker +0.006、+0.020),Avg. 0.972 与其相当;GenTextEval 上 Qua. 0.979、Sem. 0.911 均最高,较 OCR +0.026、+0.037,较 TextPecker +0.006、+0.014。消融(表2):以 OCR 预测为参照的逐裁剪一致性 Qua. 最高(0.980)但 Sem. 仅 0.901,说明结构与 OCR 一致≠与请求文本一致;直接拼接(Sem. 0.886,怕裁剪乱序)与字符级匹配(0.899,丢字间顺序)均低于裁剪级对齐的 0.911,证明对齐策略本身贡献显著。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 中文视觉文本渲染(LongText-Bench) | 结构质量 Qua.(TextPecker 评估) | 0.975 | 冻结基座 0.924;OCR 奖励 0.956;TextPecker 0.969 | 较 OCR 奖励 +0.019,较 TextPecker +0.006 |
| 中文视觉文本渲染(LongText-Bench) | 语义对齐 Sem.(TextPecker 评估) | 0.928 | 冻结基座 0.834;OCR 奖励 0.886;TextPecker 0.908 | 较 OCR 奖励 +0.042,较 TextPecker +0.020 |
| 中文视觉文本渲染(LongText-Bench) | 基准原文得分 Avg. | 0.972 | 冻结基座 0.920;OCR 奖励 0.967;TextPecker 0.974 | 较 OCR 奖励 +0.005,较 TextPecker 略低 0.002(相当) |
| 中文视觉文本渲染(GenTextEval-Bench) | 结构质量 Qua.(TextPecker 评估) | 0.979 | 冻结基座 0.933;OCR 奖励 0.953;TextPecker 0.973 | 较 OCR 奖励 +0.026,较 TextPecker +0.006 |
| 中文视觉文本渲染(GenTextEval-Bench) | 语义对齐 Sem.(TextPecker 评估) | 0.911 | 冻结基座 0.810;OCR 奖励 0.874;TextPecker 0.897 | 较 OCR 奖励 +0.037,较 TextPecker +0.014 |
| IDS 奖励构建消融(GenTextEval) | 语义对齐 Sem. | 裁剪级对齐 0.911(Qua. 0.979) | 逐裁剪一致性 0.901;直接拼接 0.886;字符级匹配 0.899 | 较直接拼接 +0.025,较字符级匹配 +0.012,较逐裁剪一致性 +0.010 |
局限与改进
作者承认的局限主要在结论中:当前框架的字符覆盖范围有限,且未扩展到日文、韩文等多语言文字,留待未来工作。我的补充观察:其一,在最强基线之上的收益幅度不大(GenTextEval 上较 TextPecker 仅 +0.006 Qua.、+0.014 Sem.),LongText 的 Avg. 甚至略低(0.972 对 0.974),存在基准趋近饱和的迹象;其二,Qua. 与 Sem. 均由 TextPecker 协议评估,而 TextPecker 又是被比较的基线之一,裁判与选手存在循环性风险;其三,整条流水线依赖 OCR 检测器的裁剪质量,漏检或切分错误的字形根本进入不了结构奖励;其四,需要额外训练百万级合成数据的 IDS 识别器,工程与算力门槛高于直接使用现成 OCR;其五,$\lambda=0.5$ 全程固定,语义与结构奖励的权重权衡未做敏感性分析;其六,评测集中在常规印刷体长文本场景,对手写体、艺术字体、低分辨率等退化条件未检验。
独立分析的弱点
独立弱点分析:第一,IDS 词表与部件粒度固定于 Unicode 词表,极端草书或美术字连部件都难以辨认,$f_{ids}$ 预测可能整体崩溃,可引入笔画级或视觉 patch 级的兜底奖励形成层级退让。第二,奖励基于 token F1,“部件对但位置放错”与“部件完全画错”可能同分,若把对齐目标换成结构树编辑距离可更精准区分空间关系错误。第三,IDSynth-1M 是合成渲染图,与真实生成图像存在风格域差距,可能造成奖励误判,可用模型自身生成的数据做域适应微调。第四,唯一记功约束假设每个目标位置只值得一次信用,但重复字符(如“谢谢”“的……的”)可能出现多处部分正确,按匹配质量软分配会更公平。第五,TextPecker 既是基线又是评估裁判,对 IDSpect 存在指标偏向风险,应补充人工评测或多裁判交叉验证。第六,只在 Qwen-Image 上验证,对 SD3、Flux 等其他生成器的泛化性未知,且 $\lambda$ 的最优值可能与生成器相关。
未来方向
作者提出的方向:扩展到更广的汉字覆盖范围(生僻字、异体字),并推广到日文、韩文等同样使用部件组合的书写系统——IDS 思想天然适配这些语言的字符分解体系。基于本文成果可延伸的方向:其一,把结构奖励从字符级推广到行级、版式级,奖励多文本区域的空间布局与语义一致性,直接呼应文中多区域提示词的应用场景;其二,探索 $\lambda$ 的自适应调度,例如训练早期侧重结构信用、后期侧重语义保真;其三,将 $f_{ids}$ 的中间表示用于推理时引导(如结构条件注入或 classifier-free 式引导),而不只充当训练期奖励;其四,构建包含真实手写与艺术字形的 IDS 评测基准,检验奖励在域外字形上的判别力;其五,把“确定性分解 + 部分信用”的范式迁移到公式、乐谱、化学结构式等其他具有组合结构的视觉内容渲染任务,这些任务的奖励设计面临与中文渲染同构的原子化困境。
复现评估
复现评估:论文未提及开源代码、模型权重或 IDSynth-1M 数据集,完整复现需自行拼装组件——Qwen-Image 基座、Flow-Factory 框架 + Flow-GRPO 后训练(LoRA 秩 $r=64$、$\alpha=128$、学习率 $3\times10^{-4}$、权重衰减 $10^{-4}$,均为主流公开配置)、SVTRv2 与 NRTR 的公开实现改造成 IDS 解码头、UnionST 渲染引擎与 BabelStone Unicode 16.0 词表(后者公开可得)。主要成本在两处:渲染 100 万张均衡合成图并训练 $f_{ids}$ 属中等规模(单机多卡数天量级);对扩散模型做 GRPO 组采样后训练最昂贵,每步需采样多个图像并过 OCR + IDS 双分支打分,通常需多机多卡数周。评估需接入 LongText-Bench、GenTextEval-Bench 与 TextPecker 评估协议。总体判断:算法与超参描述充分、具备复现可行性,但工程复杂度高,缺乏官方代码是明显门槛,复现难度评级为高。
论文图表
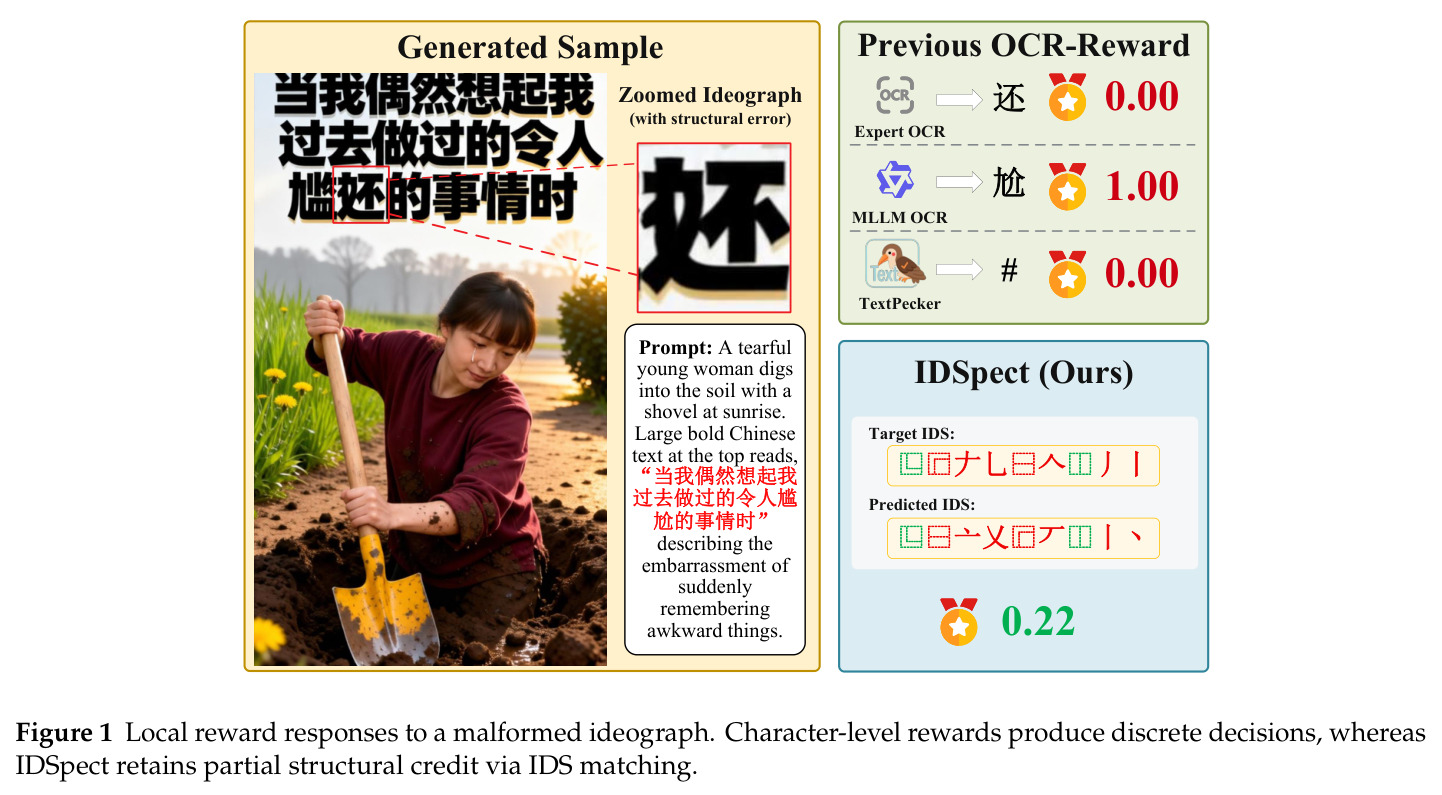
同一张生成图像中,针对一个结构畸形的汉字,四种评估机制给出截然不同的局部得分:专家 OCR 模型按局部外观给出 0.00,全局 MLLM OCR 借助语言上下文把畸形字形误判为目标字、给出假阳性 1.00,TextPecker 把异常字形折叠为“#”得 0.00,而 IDSpect 通过与目标 IDS(⿺⿸𠂇乚⿱𠆢⿰丿丨)逐 token 对比,对已匹配的部件保留部分信用、对错误部分惩罚,给出 0.22。
这张图一图道尽全文动机:直观展示 OCR 奖励的 0/1 离散性、MLLM 的语言先验假阳性、TextPecker 的粗糙折叠,以及 IDSpect 部分信用如何解决这三种缺陷,是理解论文核心卖点的入口。