教师是方向而非终点:在线策略蒸馏中RL诱导表征残差的外推(RIDE) The Teacher Is a Direction, Not a Destination: Extrapolating RL-Induced Representation Residuals in On-Policy Distillation
RIDE在表征空间沿RL诱导残差外推蒸馏目标,让学生稳定超越RL教师
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
学生自己采样轨迹,冻结教师在学生实际访问的每个前缀上给出下一词分布监督,逐 token 最小化反向 KL 散度 $D_{KL}(\pi_\theta \| \pi_T)$,更新中 $-r_t$ 充当稠密的逐 token 优势。相比在教师样本上训练,它减少曝光偏差、信号更稠密,是 LLM 后训练的标准阶段。
RIDE是OPD的表征空间版本,且与表征匹配方法OPRD只差一个目标项($\lambda=1$ 时严格退化回OPRD),理解OPD的目标结构才能看清本文的对照实验设计与贡献归因。
语言模型头(LM head)与各向异性奇异谱
LM head 是把隐藏状态映射到词表 logits 的线性矩阵 $W_{\text{head}} \in \mathbb{R}^{|V| \times d}$,奇异值高度不均(本文测得 71.70 到 1.78),表征变化沿不同奇异方向被放大的程度差异巨大,输出空间损失只能看到被 head 放大的分量。
论文的核心论据是head对各向异性的衰减:输出空间外推在head投影之后测量方向,512个最弱方向携带残差79.8%的隐藏态能量却只留下30.0%的logit能量,这是RIDE改在表征空间做外推的直接动机。
隐式奖励视角:蒸馏即 KL 约束强化学习
在局部 KL 中加减参考策略的对数概率,可把 OPD 改写为以 $\log \pi_T - \log \pi_{\text{ref}}$ 为隐式奖励的 KL 正则 RL;把该奖励权重放大 $\lambda$ 倍后,最优分布是教师与参考策略对数概率的 $\lambda$ 与 $1-\lambda$ 仿射组合,即输出空间外推(ExOPD)。
RIDE继承了“外推隐式奖励”这一思想,只是把它搬到表征空间;论文证明共享线性head下输出空间目标恰是RIDE目标经head的投影(式8),两个空间的关系是全文理论主线。
隐藏状态与残差流
第 $l$ 层在位置 $t$ 的残差流状态 $h^{(l)}_t \in \mathbb{R}^d$ 是 token 在该深度的内部表示。表征工程与 steering 文献表明行为方向在此空间近似线性、可加性操控,故“沿某方向外推隐藏态”是良定义且有效的操作。
RIDE的残差 $\Delta^{(l)}_t = h^{(l)}_{T,t} - h^{(l)}_{B,t}$ 就定义在这些逐层逐位置的向量上,线性方向结构是该残差可以被直接外推($\lambda>1$)的前提假设。
任务算术与模型外推
task arithmetic(Ilharco et al., 2023)等工作发现“微调模型减去其初始化”得到的权重差方向可以加权外推以增强相应能力;后续工作把外推搬到logit空间或沿RL轨迹进行。这些方法的共同前提是:模型相对检查点的位移是一个结构化、可复用的方向。
RIDE共享“RL诱导的变化是可用方向”这一前提,但独特之处在于:在隐藏状态空间、逐层、在head之前、且在学生自己的on-policy上下文上测量该方向。
研究动机
标准OPD把教师当作学习的终点,但实践中常需要学生超过教师——典型场景是把一次昂贵RL运行的成果蒸馏回基座模型,或合并共享基座的RL领域专家。广义OPD(ExOPD)通过在输出空间放大隐式奖励 $\log\pi_T - \log\pi_B$ 实现超越,但存在两个结构性问题。其一,LM head对各向异性衰减:512个最弱奇异方向携带教师-基座残差79.8%的隐藏态能量,投影到logit后只剩30.0%的能量,即输出空间目标只以很小的权重监督大部分残差,且完全不约束更低的层。其二,逐token的log-ratio奖励有长度偏差、易过优化,用一个全局系数放大它会等比例放大极端奖励:文献报告大系数下训练不稳甚至近确定性输出坍缩,本文实验中ExOPD在教师偏离基座很小的三对模型上(2.8–6.0分)连未训练学生都不如,Qwen3-4B上低14.1分。
本文的目标是在“同初始化蒸馏”设定下(teacher = RL(base),student 从 base 初始化,三者共享架构、tokenizer 与语言模型头),找到一个能完整、逐层、逐位置测量“RL 到底改变了什么”的信号空间,并沿该方向外推监督目标,使学生稳定地接近乃至超过 RL 教师;同时避免输出空间外推的两个已知缺陷——head 对残差能量的各向异性衰减、以及外推系数放大采样噪声导致的不稳定——让外推系数增大时训练依然平稳、格式分不崩、响应长度不失控。
与已有工作不同的是,已有的超越教师的工作要么在输出空间放大采样得到的log-ratio奖励(ExOPD及其变体),要么在参数空间或logit空间沿微调位移外推。本文的独特切入是:RL带来的变化可以直接以隐藏状态差的形式、在head之前、在学生自己访问的上下文上逐层测量——$\Delta^{(l)}_t = h^{(l)}_{T,t} - h^{(l)}_{B,t}$ 只需两次确定性前向,无需采样估计。标题即观点:“教师是方向而非终点”。理论上,本文证明输出空间外推目标恰是表征空间目标经head的投影,且外推会把采样噪声按 $(\lambda-1)^2$ 放大,而表征空间梯度条件方差恒为零——这解释了为什么该换空间。
核心方法
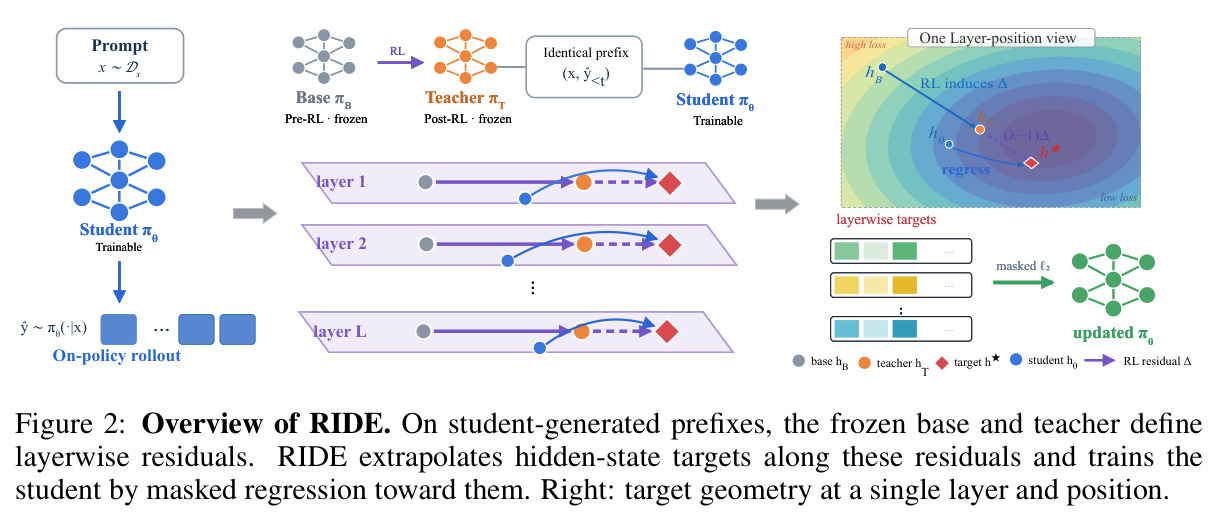
直觉:一次RL训练送给我们的不只是终点(RL后的教师),还有方向(教师相对基座的位移);从同一基座出发的学生完全可以沿这个方向走得更远。技术路线分四步:在同初始化设定下,学生从基座 $\pi_B$ 初始化并采样自己的轨迹;在学生生成的每个前缀 $(x, \hat{y}_{<t})$ 上,把冻结的教师 $\pi_T$ 与基座 $\pi_B$ 在完全相同的token上各做一次前向,逐层逐位置计算RL诱导残差 $\Delta^{(l)}_t = h^{(l)}_{T,t} - h^{(l)}_{B,t}$;沿该残差把目标放到教师之外:$h^{\star(l)}_t = h^{(l)}_{T,t} + (\lambda-1)\Delta^{(l)}_t = \lambda h^{(l)}_{T,t} + (1-\lambda) h^{(l)}_{B,t}$;最后用维度归一化的平方误差 $\frac{1}{d}\|h^{(l)}_{\theta,t} - \text{sg}(h^{\star(l)}_t)\|^2$ 对学生的隐藏态做掩码回归,监督所有 $L$ 层与最后 $k=2000$ 个响应位置(学生-教师分歧集中处)。由于目标每次rollout都重算,方向不是固定偏移,而是“RL在学生当前上下文上造成的改变”。
核心创新是把“奖励外推”从输出空间搬到表征空间。与ExOPD的本质区别有两点:第一,残差在head之前测量——head是线性的,故有恒等式 $W_{\text{head}}(\tilde{h}_T + (\lambda-1)\tilde{\Delta}) = \lambda z_T + (1-\lambda)z_B$(式8),即输出空间目标只是RIDE目标经head的投影;反之不成立,因为logit目标对head放大最少的方向约束极弱(恰是残差集中的方向),且对最后一层以下的层毫无约束。第二,目标是确定性计算(两次前向之差)而非从单个采样token估计的log-ratio,因此给定rollout后梯度条件方差为零,$\lambda$ 只改变目的地而不放大噪声(命题4.1)。与OPRD的关系同样关键:RIDE只改了目标,$\lambda=1$ 精确恢复OPRD,收益可完全归因于残差项。优化解释(命题4.2):固定rollout下,回归等价于最大化线性方向奖励 $(\lambda-1)\langle h - h_T, \Delta\rangle$ 减去以教师为中心的二次惩罚 $\frac{1}{2}\|h - h_T\|^2$——$\lambda-1$ 权衡“沿RL方向走多远”与“离教师多近”。
方法步骤详情
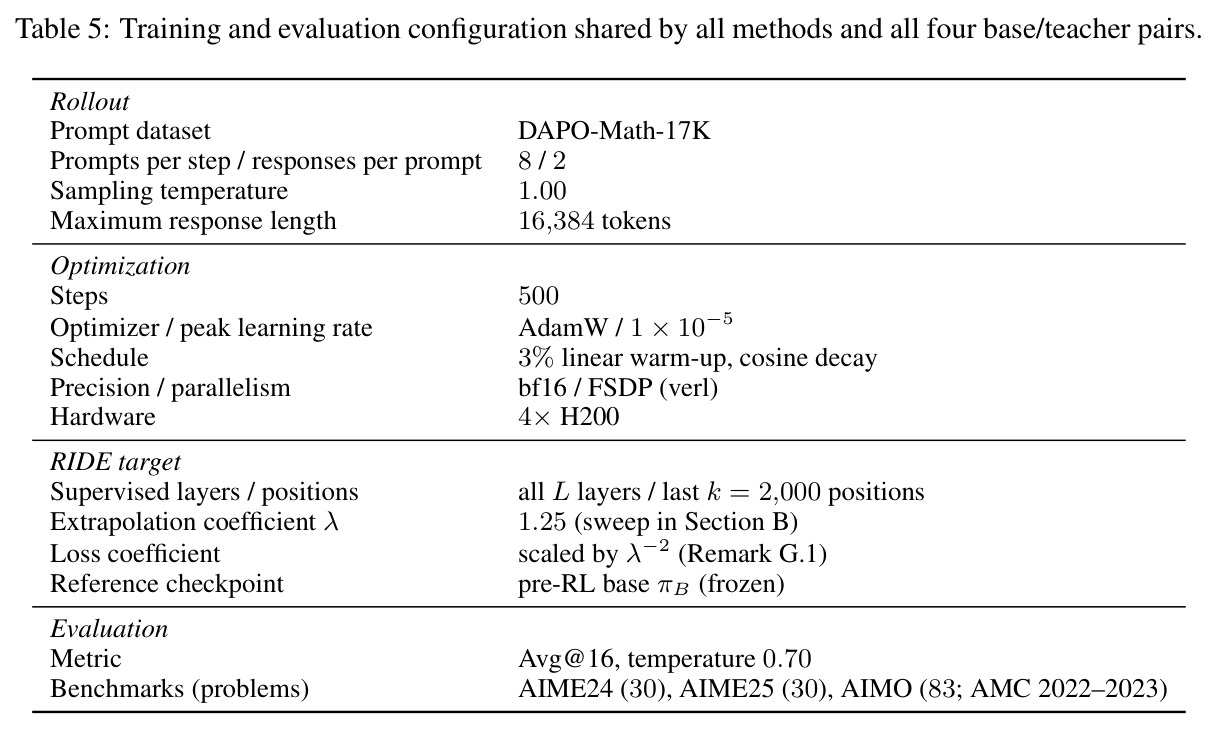
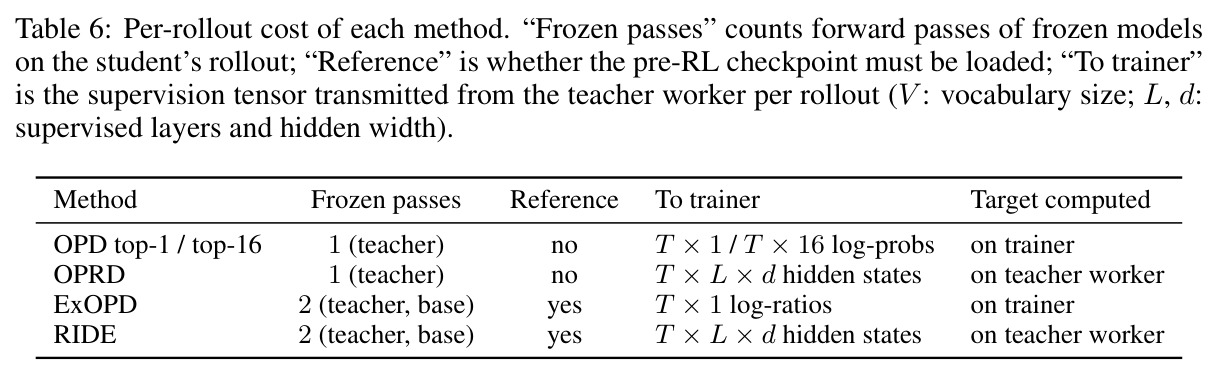
第一步,初始化与采样:学生 $\pi_\theta$ 从基座 $\pi_B$ 初始化,从DAPO-Math-17K抽取prompt(每步8条、每条2个响应,温度1.0,最长16384 token),采样rollout $\hat{y} \sim \pi_\theta(\cdot|x)$。第二步,残差计算:托管教师的worker额外加载冻结基座,对学生前缀上每个监督位置做两次前向,得到 $h^{(l)}_{T,t}$ 与 $h^{(l)}_{B,t}$ 并相减得 $\Delta^{(l)}_t$——相同token保证残差只反映RL对该上下文的改变而非轨迹差异。第三步,目标构造与传输:按式(6)原地构造 $h^{\star(l)}_t$,只向trainer传输一个 $T \times L \times d$ 的隐藏态张量,通信量与OPRD完全相同(表6)。第四步,损失与优化:计算 $\mathcal{L}_\lambda = \mathbb{E}\big[\frac{1}{|L_{\text{layer}}|}\sum_l \frac{1}{M}\sum_t m_t \frac{1}{d}\|h^{(l)}_{\theta,t} - \text{sg}(h^{\star(l)}_t)\|^2\big]$;因损失未归一化、初始损失随 $\lambda$ 放大 $\lambda^2$ 倍,loss系数统一乘 $\lambda^{-2}$(Remark G.1)以对齐有效步长。第五步,训练500步(AdamW,峰值学习率 $10^{-5}$,3%线性warmup+余弦衰减,bf16,FSDP,4×H200)。当 $\lambda=1$ 或未提供基座时,流程严格退化为OPRD。
技术新颖性
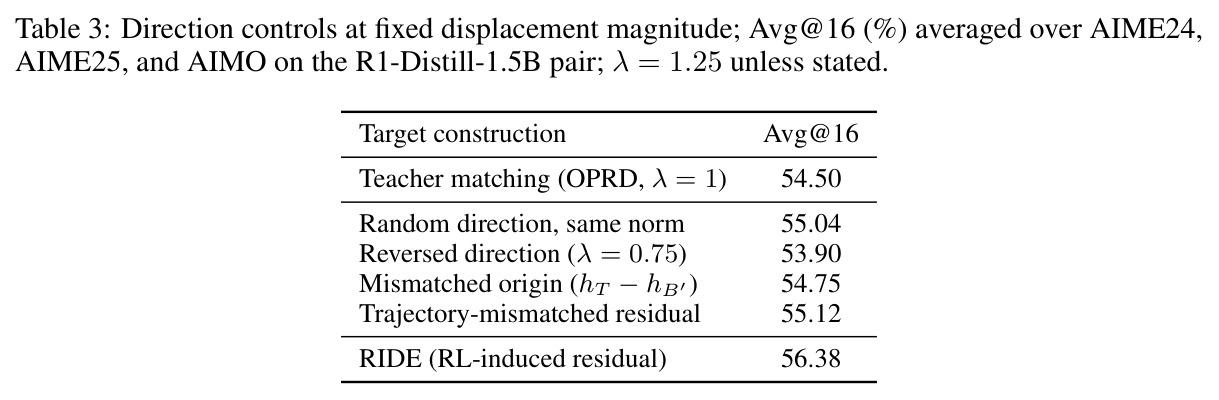
新颖性体现在三个层面。概念上,本文首次提出“RL诱导表征残差”这一可测量对象:同前缀、逐层、head之前、由两次确定性前向相减得到的向量,把“RL更新小而结构化、跨run一致”(Mukherjee等;Zhu等;Shenfeld等)与“行为方向在隐藏态空间近似线性”(steering文献)两条已知线索连接成一个可操作的训练信号。理论上,式(8)证明输出空间外推目标是RIDE目标的head投影(共享head下相对误差仅 $6.5\times10^{-7}$,教师head漂移仅1.65%支持该假设);命题4.1证明外推下输出空间优势的条件方差按 $\text{Var}[\ell] + (\lambda-1)^2\text{Var}[\rho] - 2(\lambda-1)\text{Cov}[\ell,\rho]$ 增长、而RIDE梯度条件方差严格为零;命题4.2给出奖励-惩罚闭式解释。实证上,方向控制消融(表3)排除了“位移幅度”“正则化”“loss尺度”等替代解释:固定幅度只换方向的所有对照都落在OPRD一个点以内,唯有真残差方向带来1.88分的提升。
实验结果
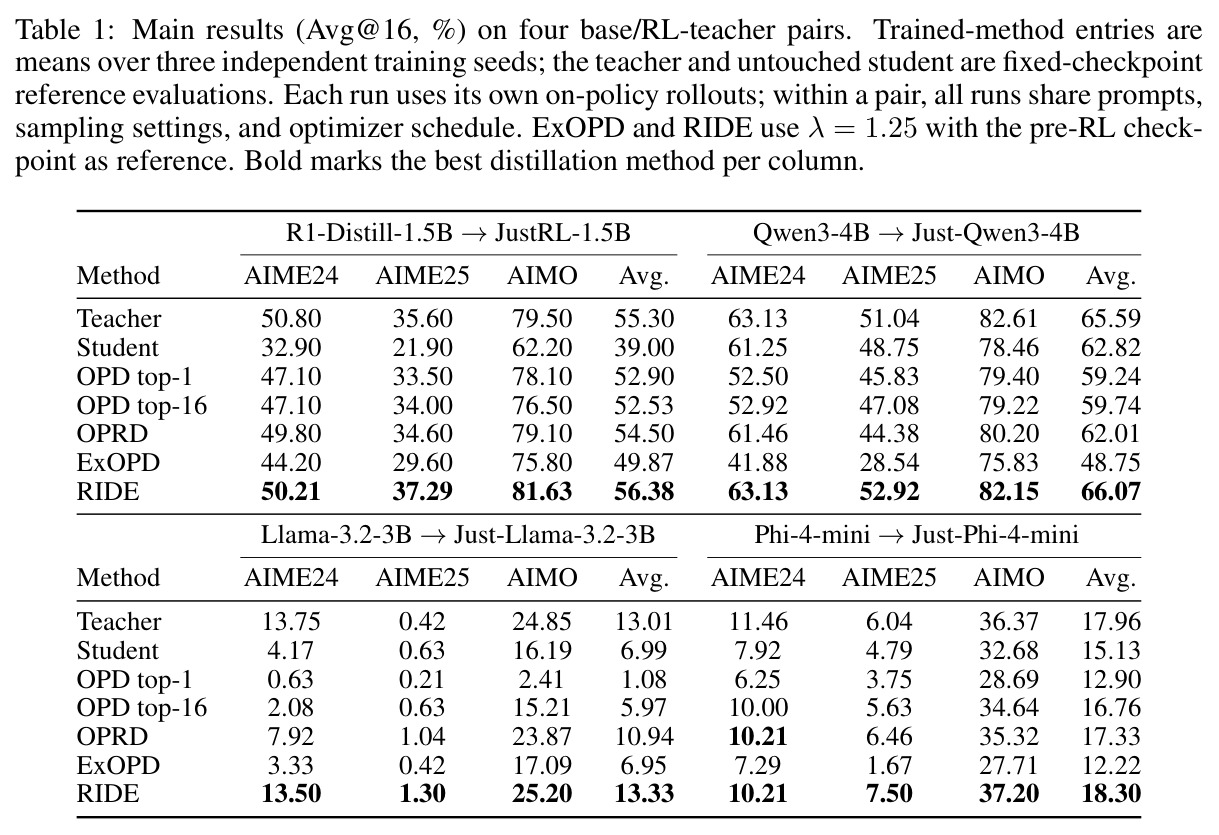
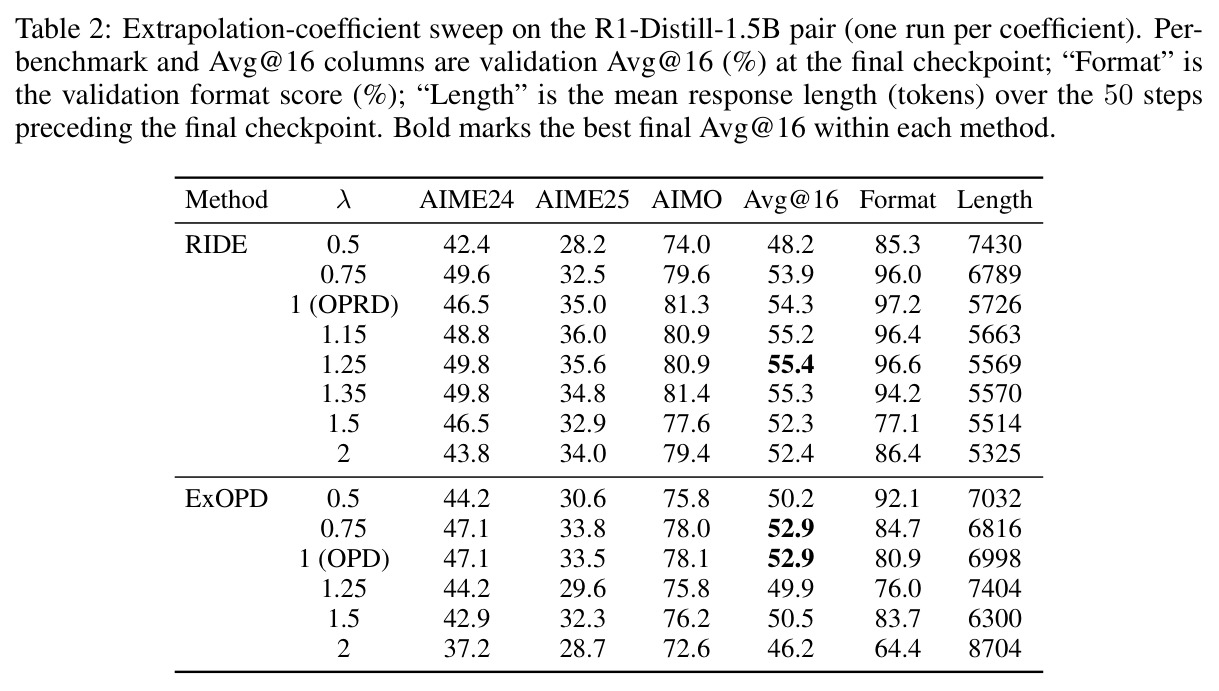
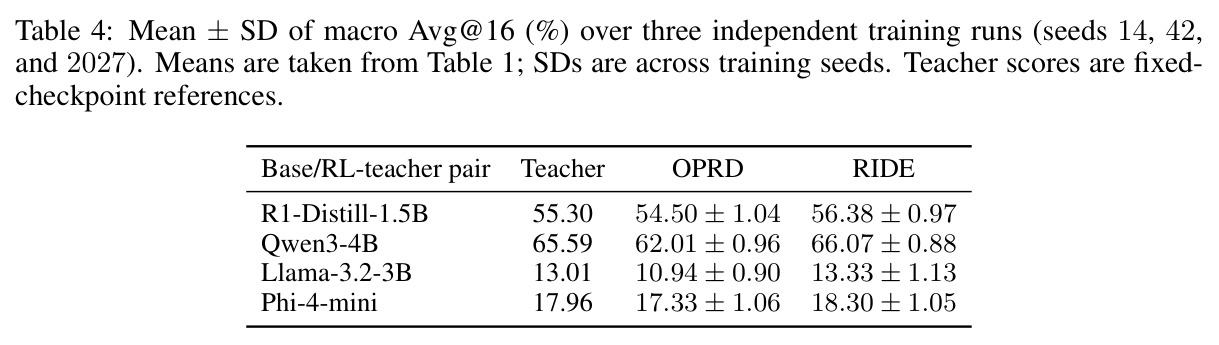
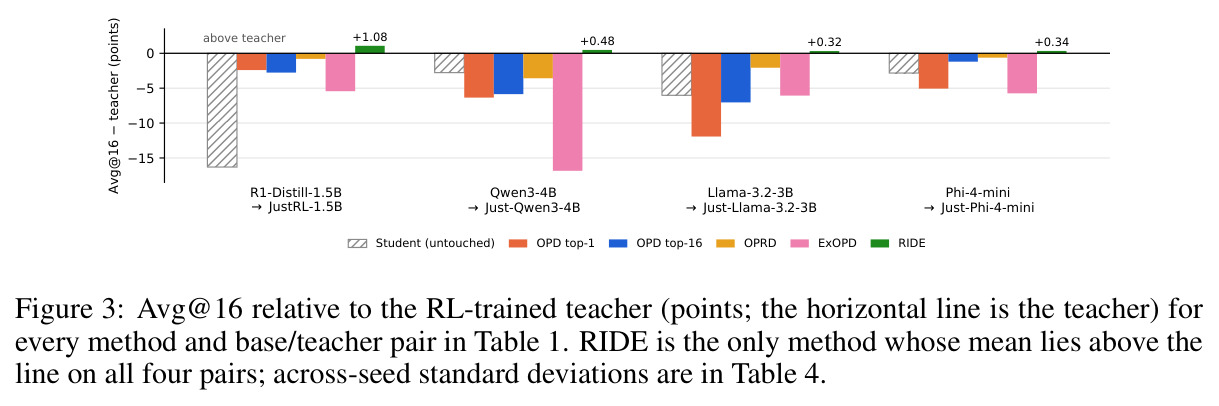
主实验(表1,Avg@16,三种子均值,评估AIME24/AIME25/AIMO)逐对分析:R1-Distill-1.5B→JustRL-1.5B(RL使教师偏离基座16.3分),RIDE得56.38,超过教师55.30达+1.08,比OPRD 54.50高1.88,而OPD top-1只有52.90、ExOPD跌至49.87;Qwen3-4B对,RIDE 66.07超教师65.59(+0.48),比OPRD 62.01高4.06,ExOPD崩至48.75(比未训练学生62.82低14.1分);Llama-3.2-3B对(AIME接近评测地板,结论主要靠AIMO),RIDE 13.33 vs 教师13.01(+0.32)、OPRD 10.94、OPD top-1仅1.08;Phi-4-mini对,RIDE 18.30 vs 教师17.96(+0.34)、OPRD 17.33。RIDE是唯一在全部四对上均值都越过教师线的方法,比ExOPD平均高9.1分;跨种子标准差0.88–1.13,作者诚实指出其中三对的超教师幅度在一个标准差之内。系数扫描(表2、图4):RIDE从λ=0.5的48.2升至λ=1.25的峰值55.4,[1.15,1.35]全区间超OPRD(54.3),λ>1.35后优雅退化(λ=2仍52.4),且λ≥1使响应缩短到5.3–5.7k token、格式分94–97%;ExOPD则在λ≤1最佳(52.9),任何λ>1都受损(λ=2跌至46.2、格式分从92%跌到64%、响应拉长到8700 token)。机制分析(图5):残差的归一化head增益仅0.59;512个最弱方向携带79.8%隐藏态能量(各向同性期望33.3%)、获得73.0%表征损失梯度却只获48.6%输出KL梯度;学生更新与残差余弦0.954、沿残差投影1.69超过目标系数1.25(学生会继续越过目标);9152个前缀上ExOPD条件方差从λ=1到λ=2增长12.6倍(拟合 $0.0096-0.0421(\lambda-1)+0.153(\lambda-1)^2$,最小值在λ≈1.14),RIDE梯度对方差严格为零。方向消融(表3):随机方向55.04、反向53.90、错配原点54.75、错配轨迹55.12,全部与OPRD 54.50相差不到1分,唯有真残差RIDE 56.38。
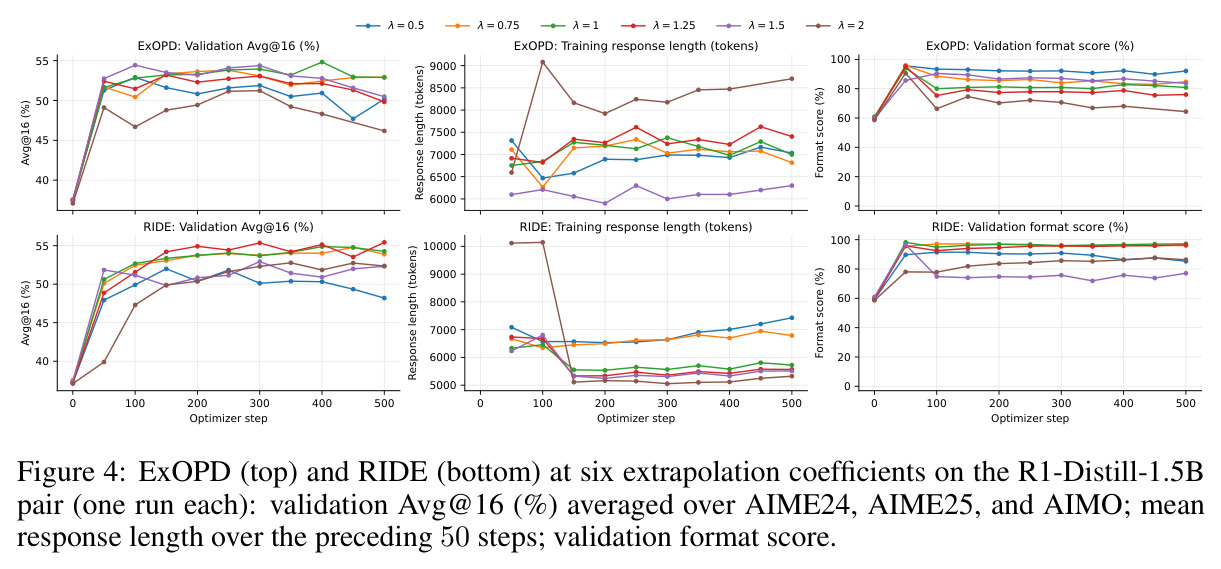
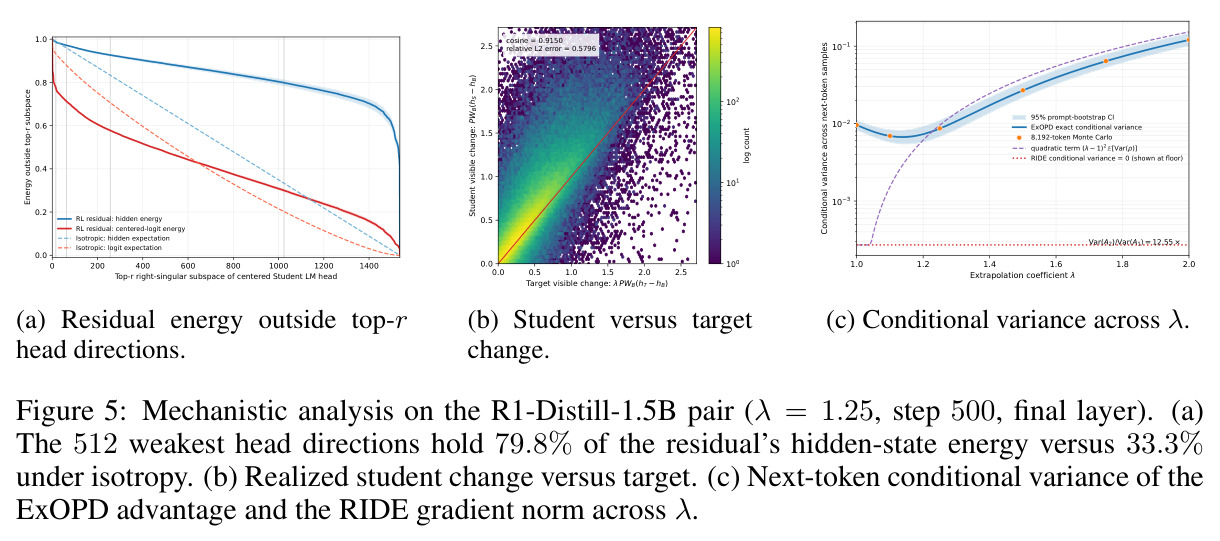
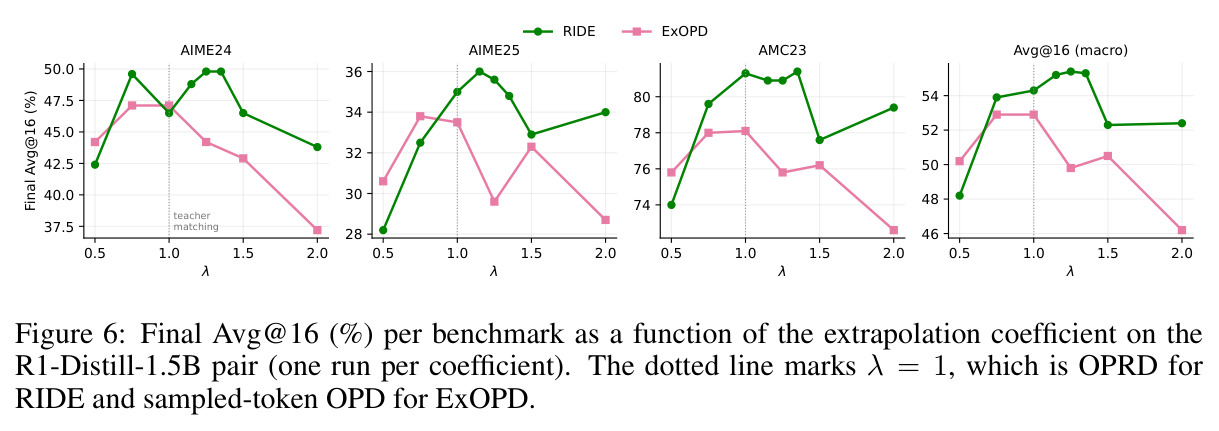
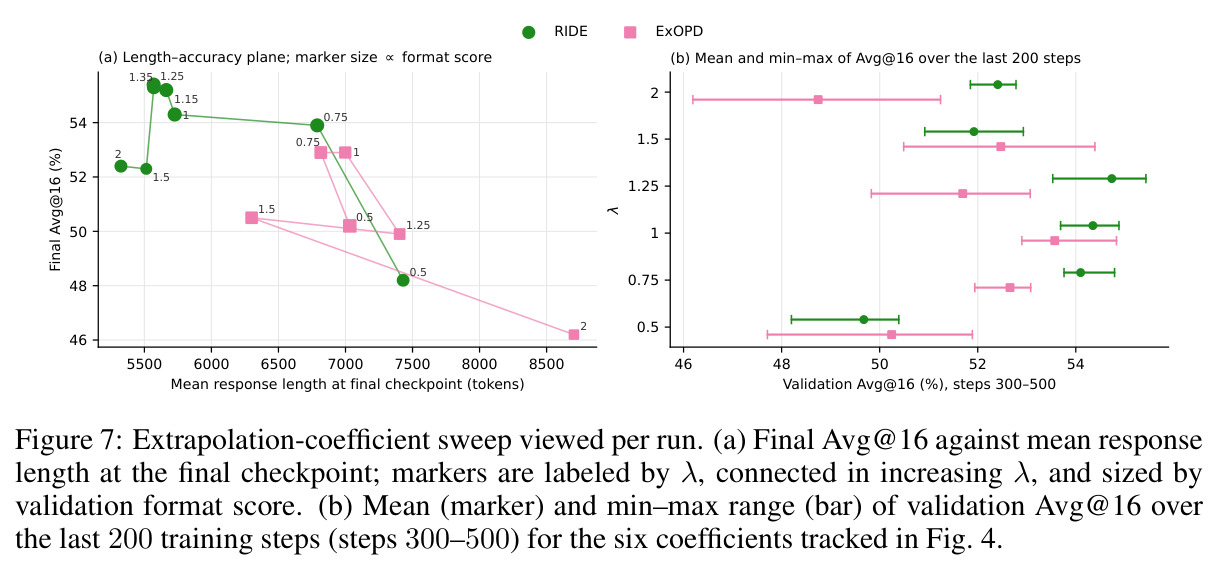
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(R1-Distill-1.5B → JustRL-1.5B) | Avg@16 (%),AIME24/AIME25/AIMO三基准宏平均 | RIDE 56.38 ± 0.97 | 教师 55.30;OPRD 54.50 ± 1.04;OPD top-1 52.90;ExOPD 49.87 | 超教师 +1.08,比OPRD +1.88,比ExOPD +6.51 |
| 数学推理(Qwen3-4B → Just-Qwen3-4B) | Avg@16 (%),三基准宏平均 | RIDE 66.07 ± 0.88 | 教师 65.59;OPRD 62.01 ± 0.96;未训练学生 62.82;ExOPD 48.75 | 超教师 +0.48,比OPRD +4.06,比ExOPD +17.32 |
| 数学推理(Llama-3.2-3B → Just-Llama-3.2-3B) | Avg@16 (%),三基准宏平均 | RIDE 13.33 ± 1.13 | 教师 13.01;OPRD 10.94 ± 0.90;OPD top-1 1.08;ExOPD 6.95 | 超教师 +0.32,比OPRD +2.39,比ExOPD +6.38 |
| 数学推理(Phi-4-mini → Just-Phi-4-mini) | Avg@16 (%),三基准宏平均 | RIDE 18.30 ± 1.05 | 教师 17.96;OPRD 17.33 ± 1.06;OPD top-16 16.76;ExOPD 12.22 | 超教师 +0.34,比OPRD +0.97,比ExOPD +6.08 |
| 外推系数扫描(R1-Distill-1.5B,单种子) | 最终验证 Avg@16 (%) | RIDE λ=1.25 达 55.4([1.15,1.35]区间均超OPRD的54.3) | ExOPD 同系数下 λ=1.25 仅 49.9,λ=2 崩至 46.2 | 同一λ=1.25下RIDE比ExOPD高5.5分,且RIDE退化平缓(λ=2仍52.4)而ExOPD崩溃 |
局限与改进
作者承认的局限:RIDE要求pre-RL检查点与共享表征空间,只适用于同初始化蒸馏设定;只用单一全局 $\lambda$,没有逐层或逐位置的自适应;评估仅覆盖数学推理和JustRL一种RL配方;三个种子下方差0.88–1.13,四对中三对的超教师幅度在一个标准差之内,超越教师的统计证据并不强;用无人产生过的隐藏态目标训练出的学生,其校准与安全行为未评估,且外推原则上可能放大教师从RL带来的偏差。我的补充观察:评测集很小(AIME24/25各30题、AIMO 83题),Avg@16虽缓解但仍可能受随机性影响;Llama-3.2-3B对的AIME25教师得分只有0.42%、接近地板,该对的结论几乎完全依赖AIMO一个基准;λ=1.25是在R1-Distill对上扫出的最优值,其他三对是否同为最优未验证;教师偏离基座很小时(Phi-4-mini仅+0.97 vs OPRD)RIDE的相对收益也缩小,说明方向信息量本身制约方法上限;训练需要4×H200并对每个rollout多做一次基座前向,规模放大后的成本未讨论。
独立分析的弱点
第一,对pre-RL检查点的硬依赖:现实中大量教师(闭源RL模型、第三方API)拿不到基座或基座不同源,RIDE直接不可用,改进方向是用参数空间近似(如从可得的权重差用task arithmetic构造伪残差)或研究无基座的自我外推。第二,单一全局λ过于粗糙:残差范数与信噪比逐层差异很大(作者自己的诊断日志就按层记录 $\|\Delta\|_2/\|h_T\|_2$),按head奇异值或残差能量自适应加权(逐层λ、或对弱方向加upweight)应能进一步提升。第三,线性外推假设有边界:λ>1.35即开始退化说明残差方向只在有限范围内有效,可探索分段/非线性外推或范数保持的外推形式。第四,泛化范围窄:只在数学推理、JustRL配方、1.5B–4B规模上验证,代码生成、指令跟随、RLHF偏好优化等其他RL产物是否同样产生可外推的表征残差是未知数。第五,学生只被监督隐藏态、其输出分布无人真正“产生过”,校准与格式稳定性需要显式评估(λ=1.5时RIDE格式分也跌到77.1%,说明高系数下仍有格式压力)。第六,教师移动小时方向信号本身弱(Phi-4-mini增益最小),可与课程式采样结合,优先在残差大的上下文上施加外推。
未来方向
作者明确提出的方向:放松同初始化与共享表征空间的约束、研究隐藏态目标训练出的学生的安全性与校准。基于本文成果可自然延伸的方向包括:(1) 逐层/逐位置自适应系数,用残差范数比或head奇异谱调制 $\lambda^{(l)}$;(2) 把RIDE与权重空间外推(task arithmetic)及logit空间方法做系统性组合,三者分别在参数、隐藏态、输出层面利用同一方向;(3) 跨架构蒸馏的代理空间——把不同宽度的隐藏态投影到共享低维子空间后再外推;(4) 迭代式RIDE:学生超越教师后作为新“基座”,与更新的RL教师继续构造残差,形成多轮自我提升循环;(5) 理论层面刻画何种RL配方产生的残差是“好方向”,并与RL's razor等关于RL更新低秩结构的理论对接;(6) 将残差方向作为RL训练本身的结构正则(约束策略不偏离可用方向),加速RL收敛;(7) 多教师场景:不同RL专家相对同一基座的残差可在激活空间做融合与外推,类比模型合并的表征版本。
复现评估
复现条件较好。开源方面:项目页为 github.com/xixixixixxxx/RIDE,作者承诺发表后放出训练代码、RL教师检查点与评估脚本;全部基座检查点与JustRL-DeepSeek-1.5B教师已公开,其余三个教师可用公开的JustRL配方对公开基座复现;数据全部公开(训练用DAPO-Math-17K,评测用AIME24 30题、AIME25 30题、AIMO 83题)。配置方面:表5给出完整超参(AdamW峰值学习率 $10^{-5}$、500步、每步8 prompt×2响应、温度1.0、最长16384 token、监督所有层最后 $k=2000$ 位置、$\lambda=1.25$、loss乘 $\lambda^{-2}$、bf16/FSDP/verl),表6给出各方法每rollout开销——RIDE比OPRD只多一次冻结基座前向、通信量不变($T\times L\times d$ 隐藏态张量),附录G还描述了目标在teacher worker上原构造的实现细节。算力方面:4×H200训练500步,对1.5B–4B模型属于中等规模门槛。统计方面:三个种子(14/42/2027)及标准差齐全,附录A给出全部证明,附录E/F给出诊断的采样协议与置信区间。总体评估:复现难度中等偏低,主要成本是H200级GPU与verl框架的工程经验;消融中的错配原点控制还需额外下载Qwen2.5-Math-1.5B-Instruct。
论文图表
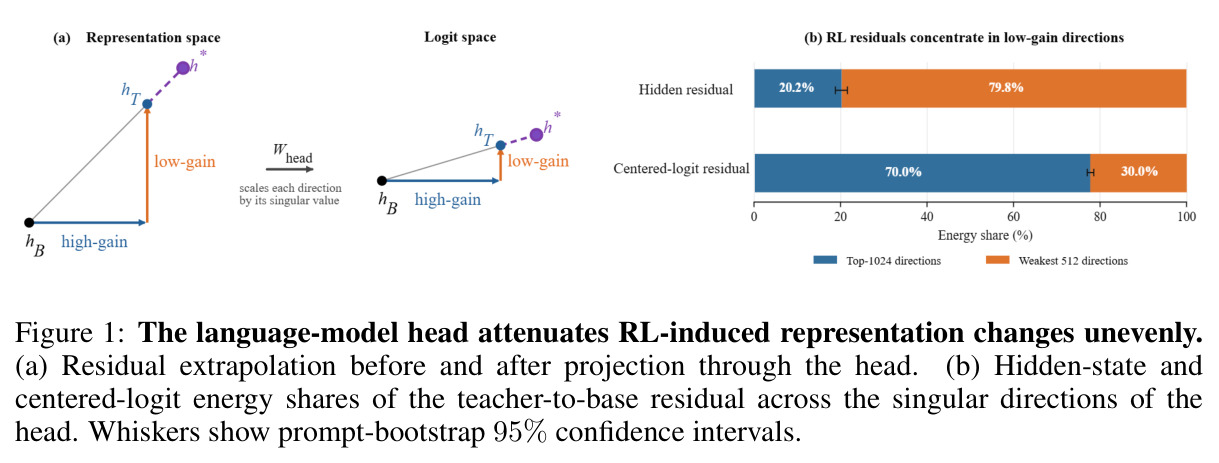
面板(a)示意残差外推目标在经过LM head投影前后的对比:head之前的完整位移到达logits后大幅缩水。面板(b)按head的奇异方向统计教师-基座残差的能量占比:512个最弱方向承载79.8%的隐藏态能量,但只保留30.0%的centered-logit能量(各向同性期望远低于前者),误差棒为prompt-bootstrap 95%置信区间。
这是全文动机的核心量化证据:输出空间目标只能以约三分之一的权重“看到”RL残差的大部分能量,且对更低层毫无约束——直接论证了为什么外推必须在head之前的表征空间进行。