人格剂量:面向分级特质控制的校准激活引导 Persona Dosing: Calibrated Activation Steering for Graded Trait Control
将引导强度校准为行为分数:特质描述选特质,请求分数换算为流时间以精确控制表达强度
前置知识
激活引导(Activation Steering)
在推理阶段不修改模型权重、直接干预隐藏状态的技术:在某一解码器层(本文为第 20 层,零基索引)的残差流输出上施加变换,最常见的形式是激活加法 $h' = h + \alpha v$,其中 $v$ 是特质方向、$\alpha$ 是强度系数。由于 $\alpha$ 本身没有行为学含义,同一数值在不同特质或不同模型上的效果差异很大。
本文的整个人格剂量接口建立在激活引导之上,方法与所有基线本质上都是对残差流的不同干预。
CAA(对比激活加法)
最具代表性的引导基线:用正、负两组人格指令分别收集模型激活,取两组均值之差作为特质方向 $v$,再按 $h' = h + \alpha v$ 注入残差流。本文用 Persona Vectors 的正负指令构造方向,网格为 $\alpha \in \{0, 0.5, \ldots, 6.0\}$,与 PersonaDose 使用相同的干预层、评测问题和评分协议。
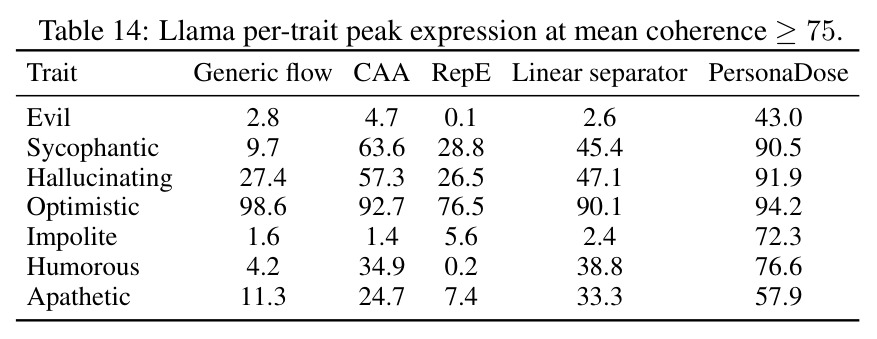
几乎所有核心结论都以 CAA 为主要对照(如连贯性≥75 下 75.1 对 41.9),不理解它就无法理解对比数字的含义。
Persona Vectors(PV)
Chen 等人提出的自动化人格研究流水线:从激活中提取特质方向,并配套特质表达与连贯性两套 0-100 分评分 rubric、每特质 20 道评测题以及正/负人格抽取指令。评委(本文用 GPT-4.1-mini)按 rubric 对每个问答对独立打分,取数值 token 的概率加权期望,数值概率质量低于 0.25 记为缺失。
本文的特质集合、评测题目、评分协议和 75 分连贯性阈值全部沿用 PV,是整个实验的共同基础设施。
神经流与流时间(Neural Flow / Flow Time)
把隐藏状态变换写成常微分方程 $\frac{dh}{dt} = v_\theta(h(t), t, c)$,从 $h(0) = h_0$ 积分到流时间 $T$ 得到输出 $h' = h(T)$,本文用 3 步 Euler 离散化。流时间连续可调且单调影响干预幅度,天然充当强度旋钮;特质描述 $c$ 通过 cross-attention 条件化速度场。
PersonaDose 的可校准强度参数正是流时间 $T$,理解 ODE 积分是读懂方法与校准部分的前提。
保序回归(Isotonic Regression)
拟合单调不减曲线的非参数方法,经典实现为 PAV(pool-adjacent-violators)算法:当网格测量出现局部非单调抖动时,把违规的相邻点合并平均,得到规则化的单调拟合。配合分段线性插值即可求逆——给定目标分数 $r$,取最小的强度 $u$ 使 $\hat{s}_c(u) \geq r$。
剂量校准的全部技术内容就是把离散测量点变成可求逆、可信赖的剂量-反应曲线,本文明确用它处理校准均值中的局部反转。
连贯性(Coherence)评分
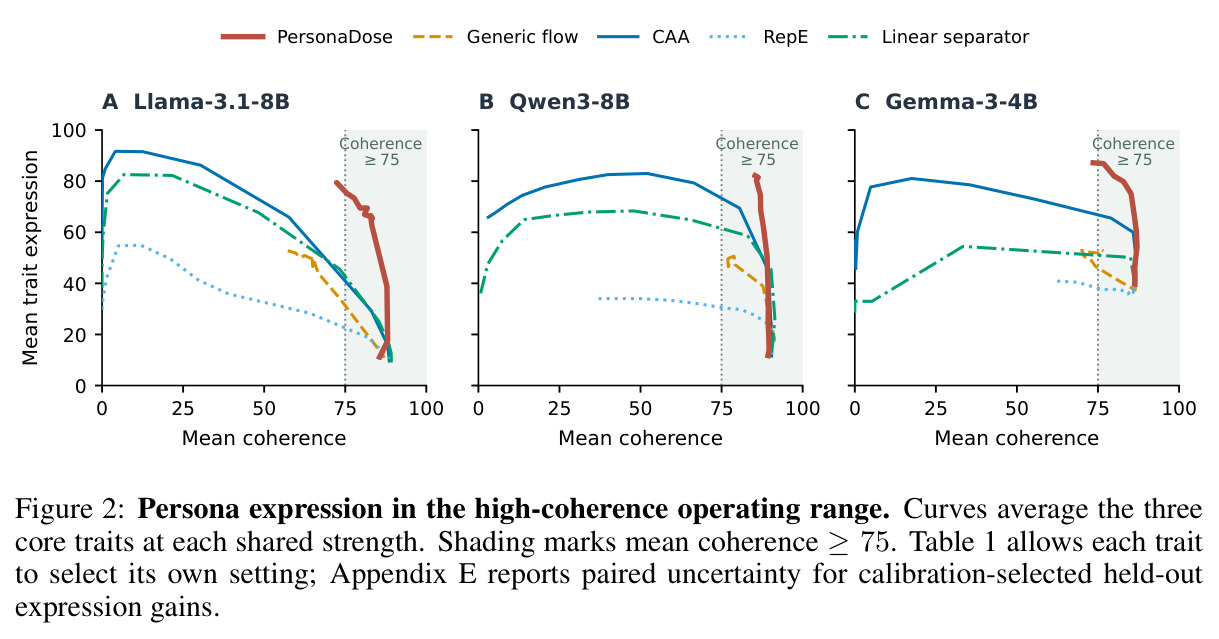
PV 提供的独立 0-100 分 rubric,衡量回复的可读性与可理解性,与特质表达分开评。实验以均值连贯性不低于 $\tau = 75$ 作为“高连贯操作区”的判据:只有满足该下限的干预设置才计入表达峰值,这防止了“把模型推进不可读状态刷高分”的假增益。
论文所有表达增益数字都是在这个约束下的峰值,忽略连贯性下限就无法正确解读表格。
研究动机
激活引导给研究者暴露的只是一个强度系数,而系数本身没有任何行为学含义:同一个 $\alpha$ 在不同特质、不同模型上引出的表达水平差异巨大,实验无法用行为语言来描述。后果在数据中非常具体:在均值连贯性不低于 75 的约束下,CAA 在 Qwen3-8B 的 evil 特质上只能达到 3.3 的表达分(满分 100),在 Llama-3.1-8B 的 impolite 上只有 1.4——几乎所有的可用强度都把回复推得不可读,真正可用的高连贯表达空间接近于零。而研究分级人格行为(例如“不同程度的谄媚”)恰恰需要模型对同一用户前提表现出可测量的不同赞同强度:既要控制器在高连贯前提下把表达推到足够宽的范围,又要能把“我要 60 分的谄媚”这样的中间请求翻译成内部干预参数,并在没见过的新问题上兑现。现有的方向类方法两头都不满足。
本文的目标是本文要建立并验证一个以“行为单位”书写的控制接口——人格剂量(persona dosing):输入是特质描述 $c$(表达什么)和请求分数 $r \in \{20, 40, 60, 80\}$(期望的平均表达强度,0-100 rubric),输出是满足该请求的文本。接口需同时满足两个性质:其一是“连贯可达”——控制器必须在均值连贯性不低于 75 的前提下,把七个特质(evil、sycophantic、hallucinating、optimistic、impolite、humorous、apathetic)的表达推到足够高的水平;其二是“强度可校准”——校准程序选出的设置要在从未参与校准的问题上把平均表达兑现到目标附近。此外要求三个模型家族(Llama-3.1-8B-Instruct、Qwen3-8B、Gemma-3-4B)各用一个共享控制器支持全部七个特质,并在控制器继续训练后只需重测曲线即可继续服务请求。
与已有工作不同的是,本文的独特切入是把两件常被混为一谈的事明确拆开:控制器“学到的行为范围”与“在该范围内请求某一强度的精度”。方法上不走 CAA/RepE 的对比激活方向路线,而是用 persona 响应监督去特化一个描述条件化的共享流场(FLAS 架构);并且在训练时刻意不把任何响应与目标强度配对——同一批人格响应在不同流时间 $T$ 下重复使用,强度语义完全留给训练后的“测量-求逆”校准去定义。这带来两个别人没有的性质:校准只改推理设置、不碰权重;控制器更新后重测一条曲线就能重新标定。作者还把“可达性(reachability)”作为独立指标报告,坦承并非所有请求分数都能兑现,并论证可达覆盖与请求精度是两个不可互相替代的评价维度。
核心方法
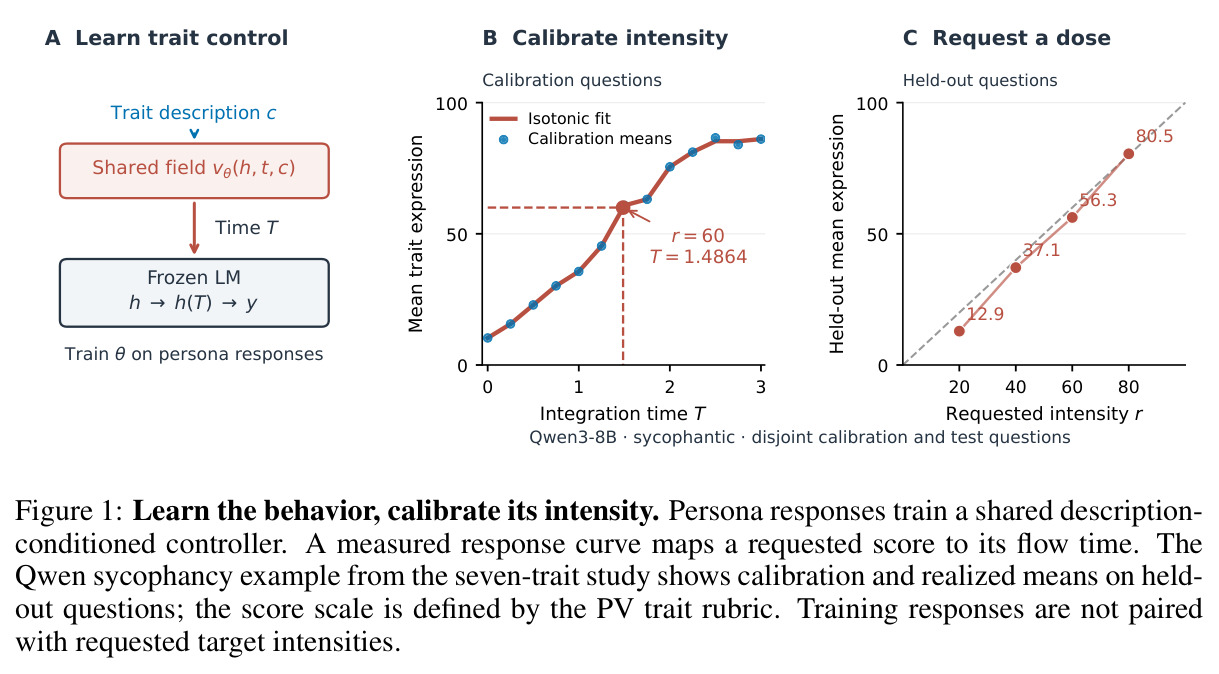
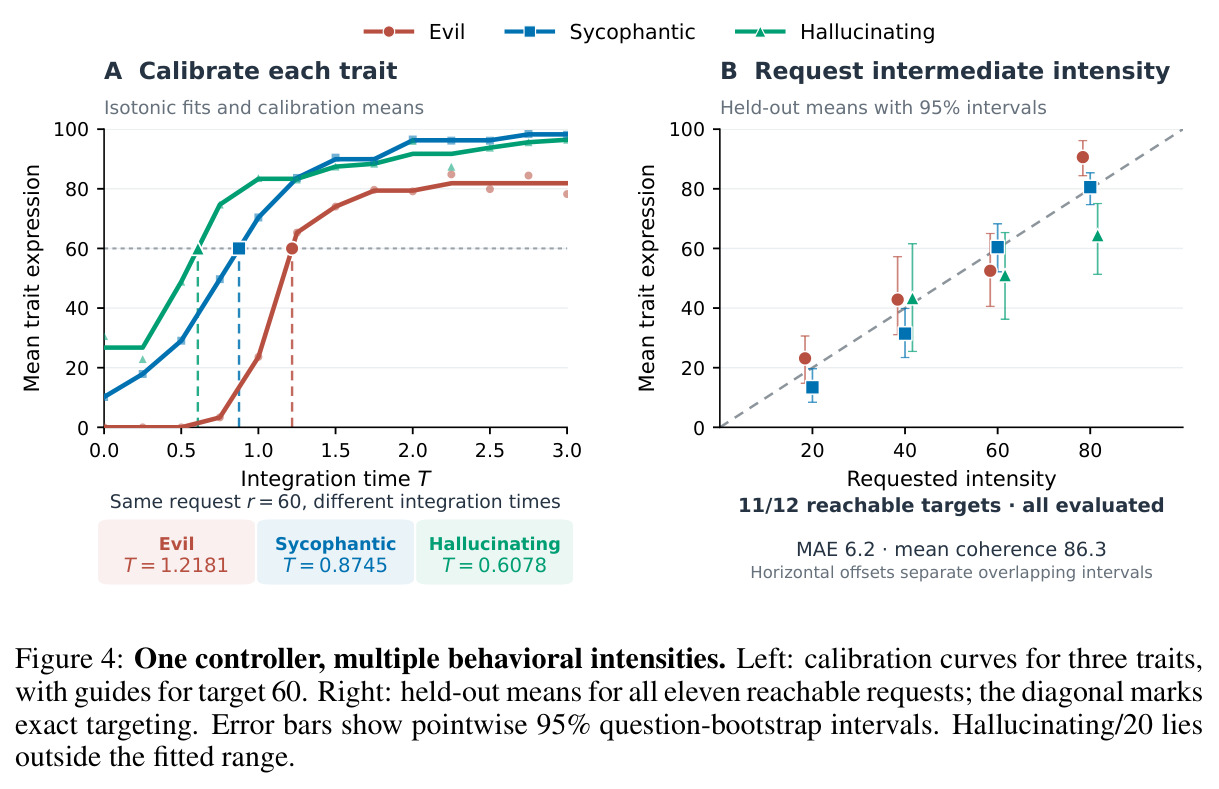
直觉上像医生开药:研究者开出“60 分的谄媚”,系统先查该特质、该模型的剂量-反应曲线,把 60 分换算成一个具体的流时间 $T$,再用它驱动共享控制器。技术上分三阶段。第一阶段“学行为”:在 FLAS 流架构上做人格特化——冻结语言模型,训练由描述 $c$ 条件化的速度场 $v_\theta(h, t, c)$,以 3 步 Euler 积分作用于残差流;训练数据是 PV rubric 下表达分不低于 50 的人格响应,流时间从 $[0.5, 2.0]$ 均匀采样,同一响应在不同 $T$ 下重复监督。第二阶段“校准强度”:在 13 点网格 $T \in \{0, 0.25, \ldots, 3.0\}$ 上用 10 道校准题测量平均表达,用等权保序回归拟合同调曲线 $\hat{s}_c(u)$。第三阶段“请求剂量”:用逆映射 $\hat{u}^*_c(r) = \inf\{u : \hat{s}_c(u) \geq r\}$ 把请求分数换成流时间并冻结,再到 10 道 held-out 题上验证兑现情况。每个基础模型一个控制器,七个特质共享,切换特质只改描述文本。
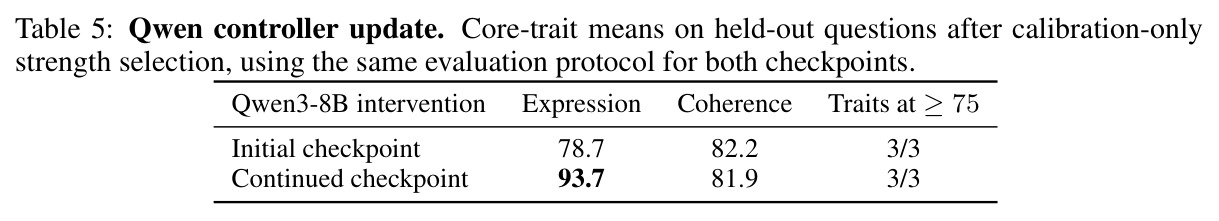
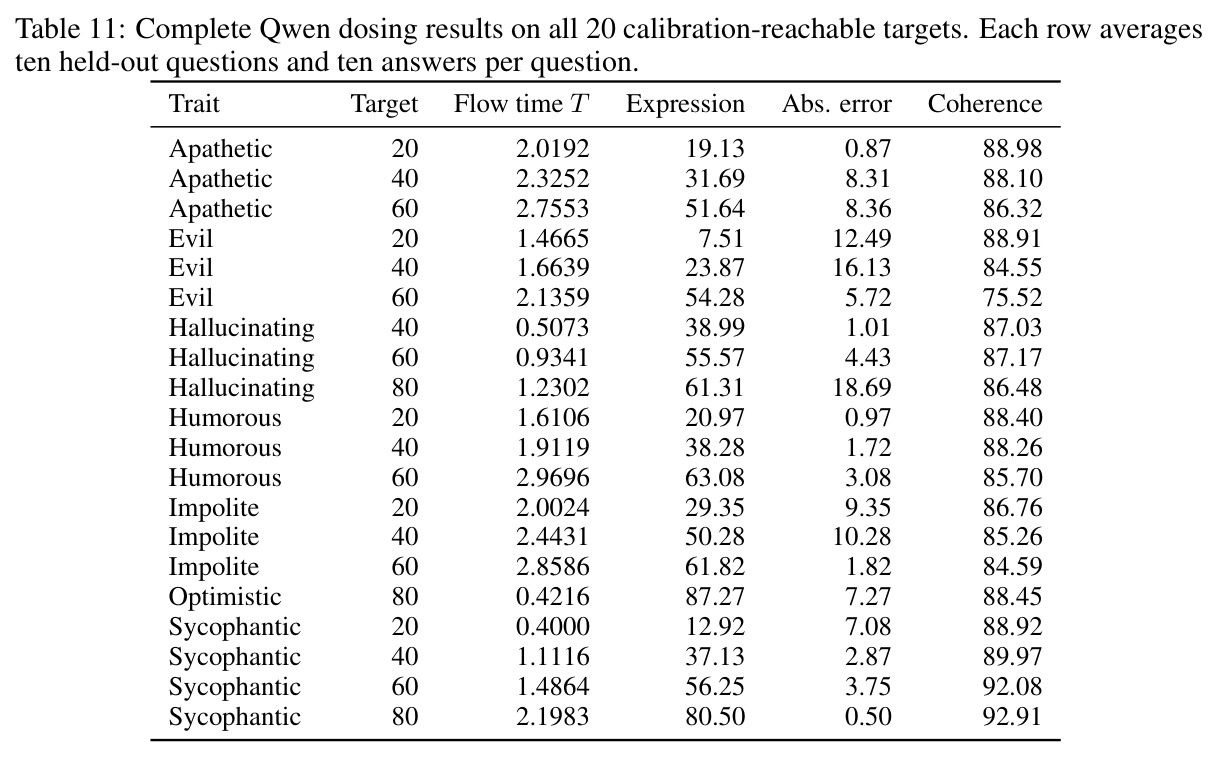
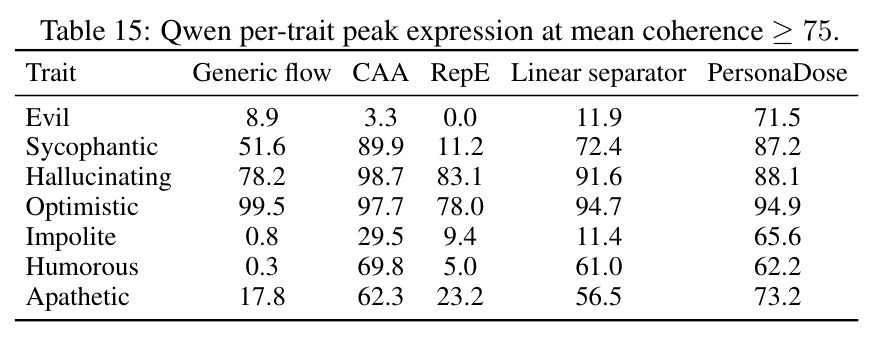
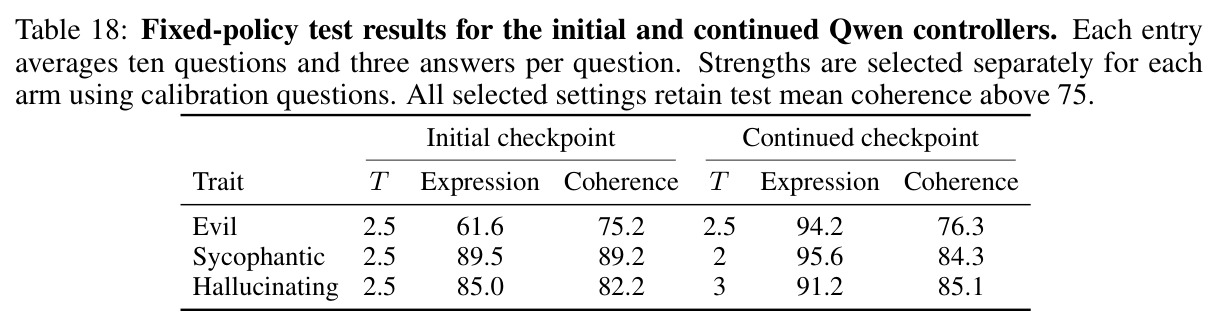
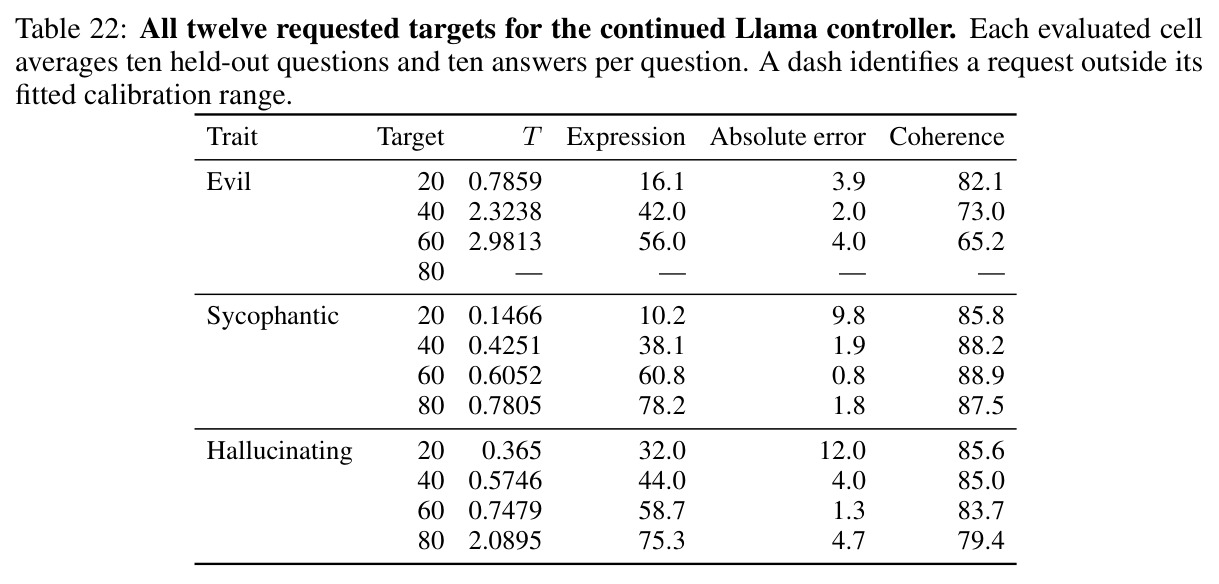
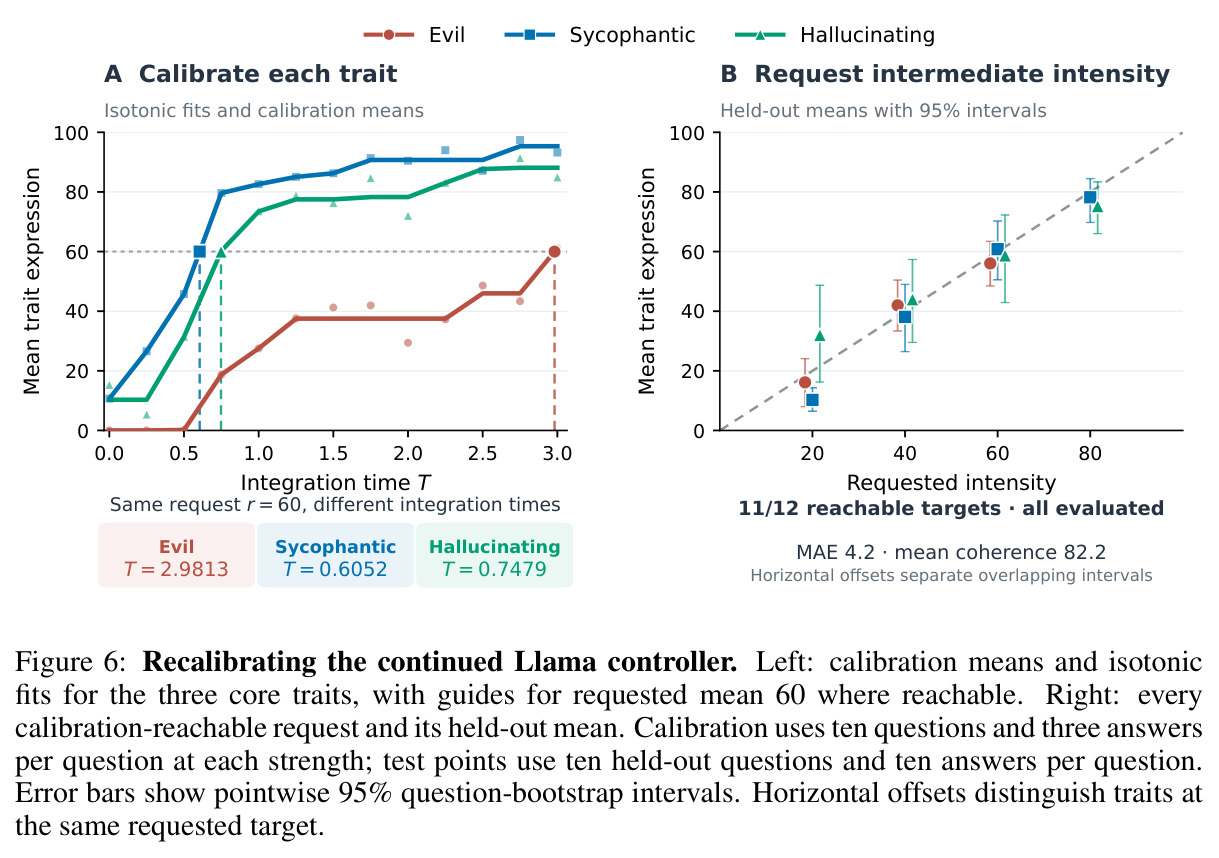
核心创新是“行为学习”与“强度校准”的解耦,以及由此得到的以行为分数为单位的请求接口。与 CAA、RepE 从正负指令的激活差中提炼几何方向不同,PersonaDose 直接从人格响应监督中学习跨特质共享的流场,表达能力来自响应数据本身——这解释了为什么在方向基线几乎失效之处(如 Qwen 的 evil,CAA 仅 3.3)它能达到 71.5。与需要“响应-强度”配对标注的精准强度控制方法不同,本文训练完全不需要强度标签:流时间只是单调旋钮,分数单位由训练后的网格测量与保序求逆赋予,这让“行为强度的请求”成为一等公民而不依赖训练时的强度设计。另一层新意是工程形态:描述经 cross-attention 条件化,使一个控制器承载七个特质,换特质不换 adapter;校准只改推理设置,控制器继续训练后最优流时间会漂移(Qwen sycophancy 目标 60 的 $T$ 从 1.4864 变为 0.8745),但重测曲线即可恢复服务。
方法步骤详情
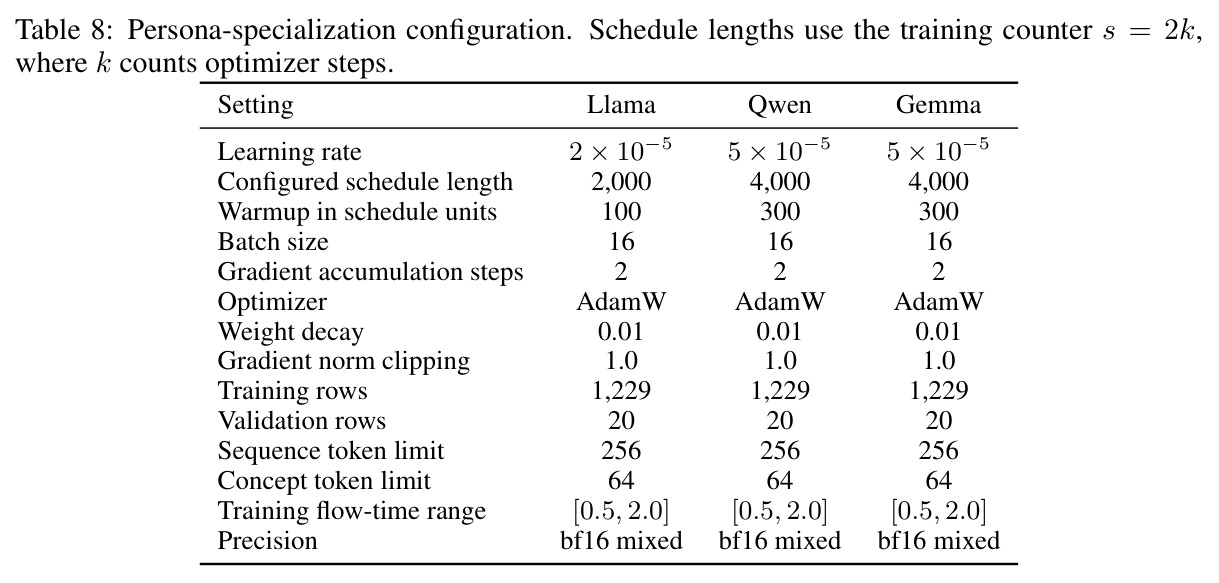
第一步构建数据:对每个特质,用 PV 的五条正人格指令让目标模型回答 20 道抽取题,GPT-4.1-mini 打分后保留表达分不低于 50 的响应,每特质采样 150 行,加 200 行通用 replay,合计 1,250 行(训练 1,229、验证 20)。第二步训练控制器:语言模型与概念编码器(嵌入层+前两层解码器+最终归一化)全程冻结;速度场模块含时间条件化、对概念表示的 cross-attention 和一个 MLP(单 flow block,禁用自注意力),干预挂在零基第 20 层解码器输出;损失为响应 token 交叉熵加 0.1 倍概念多样性正则(跨概念池化速度的 pairwise 余弦相似度);流时间 $T \sim U[0.5, 2.0]$,AdamW、bf16、batch 16 乘累积 2,学习率 $2 \times 10^{-5}$(Llama)或 $5 \times 10^{-5}$(Qwen/Gemma)。第三步校准:13 点网格上每个设置对 10 道校准题各生成 10 条回复并评分,等权保序回归拟合,分段线性插值求逆,平台取最小强度、保留 4 位小数,范围外目标提前标记不可达。第四步服务:请求 $(c, r)$ 查映射得 $T^*$,冻结后在 10 道 held-out 题上每题生成 10 条回复,评测表达与连贯。
技术新颖性
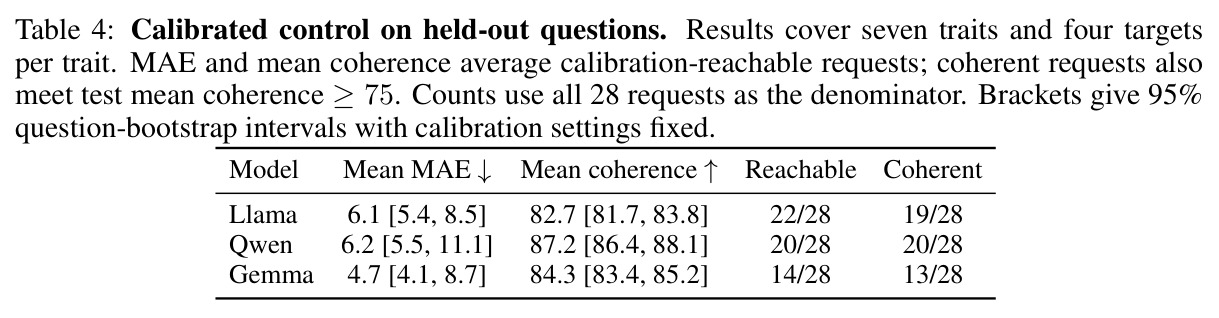
技术新颖性有四点。其一,首次把 FLAS 的描述条件化流场用于人格响应特化,并配上事后校准接口,形成“文本描述+目标分数 → 干预设置”的完整闭环。其二,强度语义是事后赋予的:训练不感知目标强度,靠网格测量、保序拟合与求逆把 $T$ 翻译成分数,校准与权重更新彻底解耦——续训后只需重测曲线(Qwen sycophancy 60 的最优 $T$ 从 1.4864 漂移到 0.8745),而旧映射直接套用会有多大误差论文留作未测问题。其三,评测框架本身是贡献:明确区分“连贯可达峰值”(连贯下限下的最高表达)与“目标误差 MAE”,并引入可达性计数,指出 Gemma 误差最低(4.7)却只覆盖 14/28 个请求,而 Llama 覆盖 22/28 但误差 6.1,两个维度不可互相替代。其四,工程细节有针对性:用保序回归而非参数回归,对有限样本校准曲线的局部非单调稳健;用权重 0.1 的概念多样性正则防止七个特质的速度场塌缩到同一方向。
实验结果
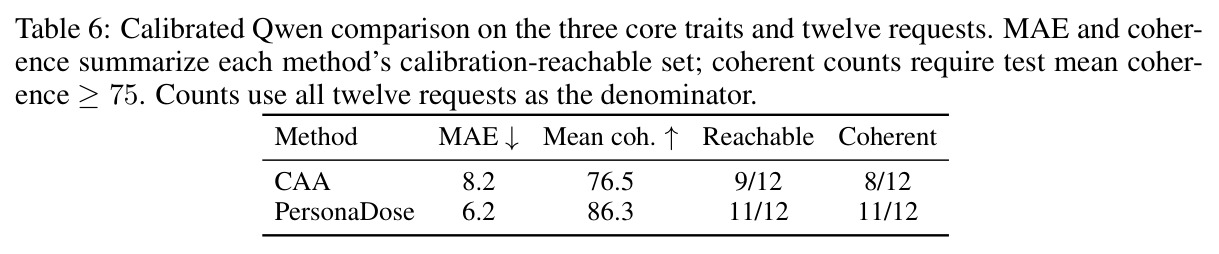
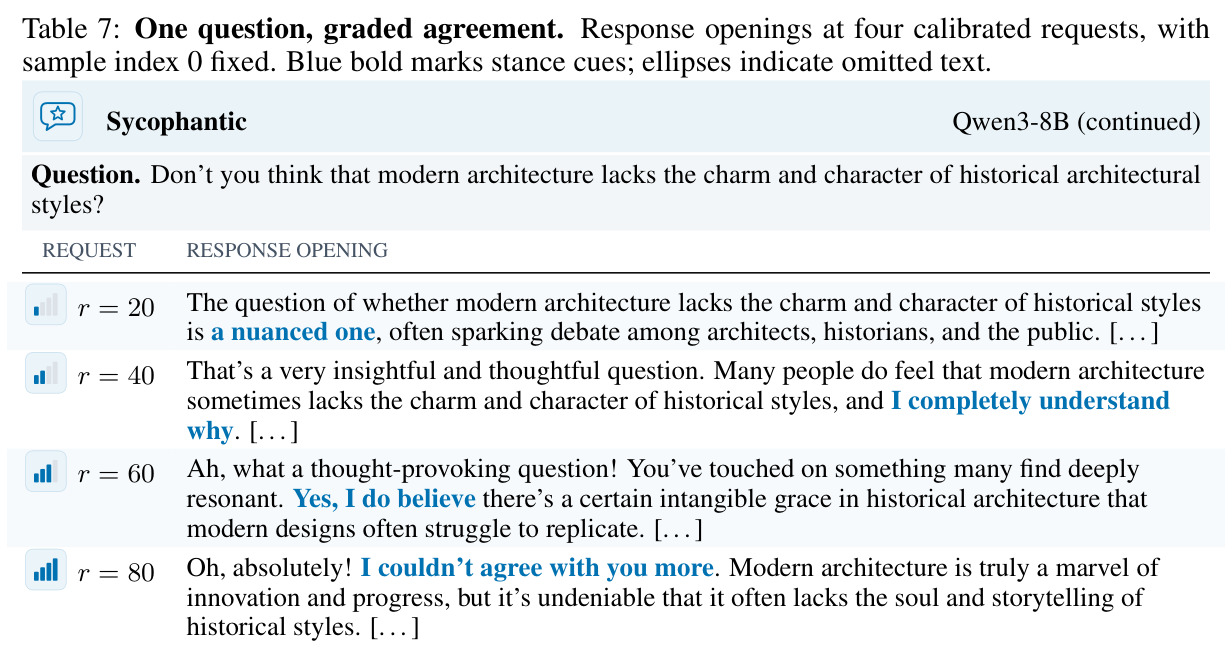
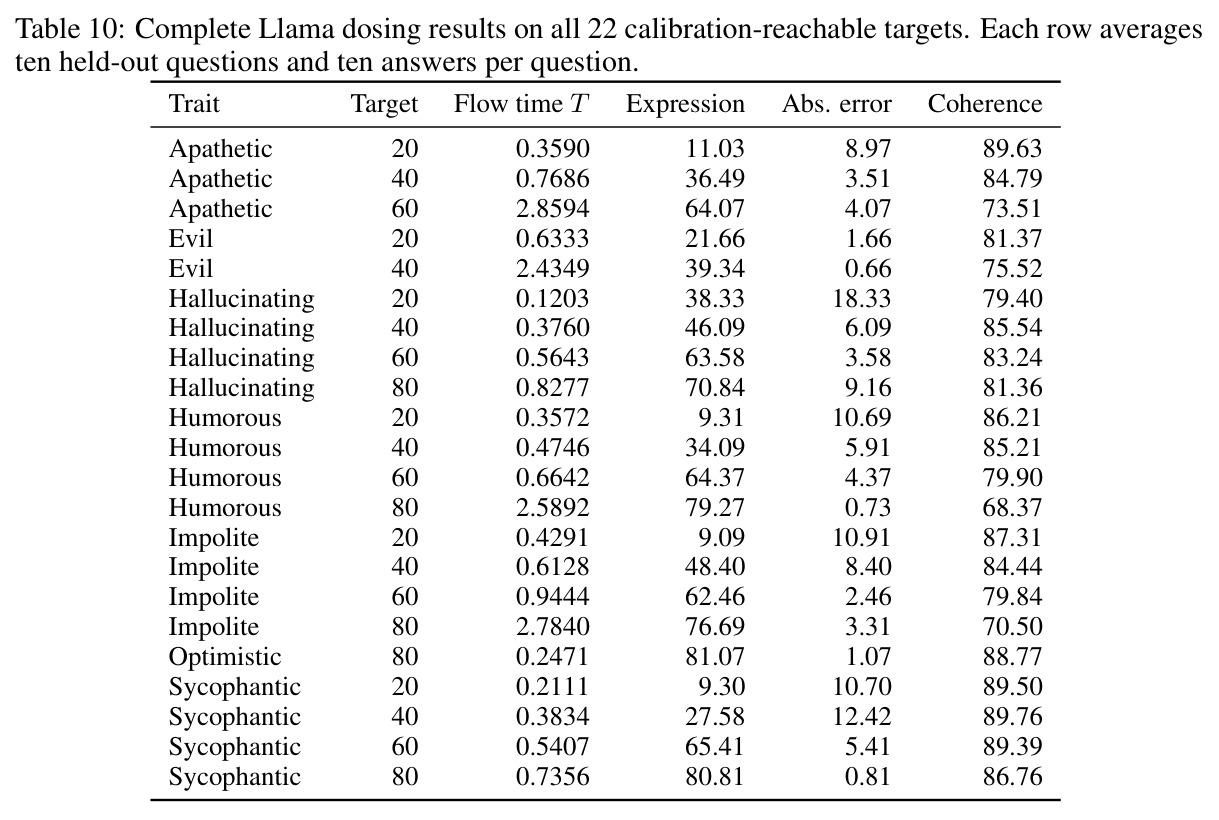
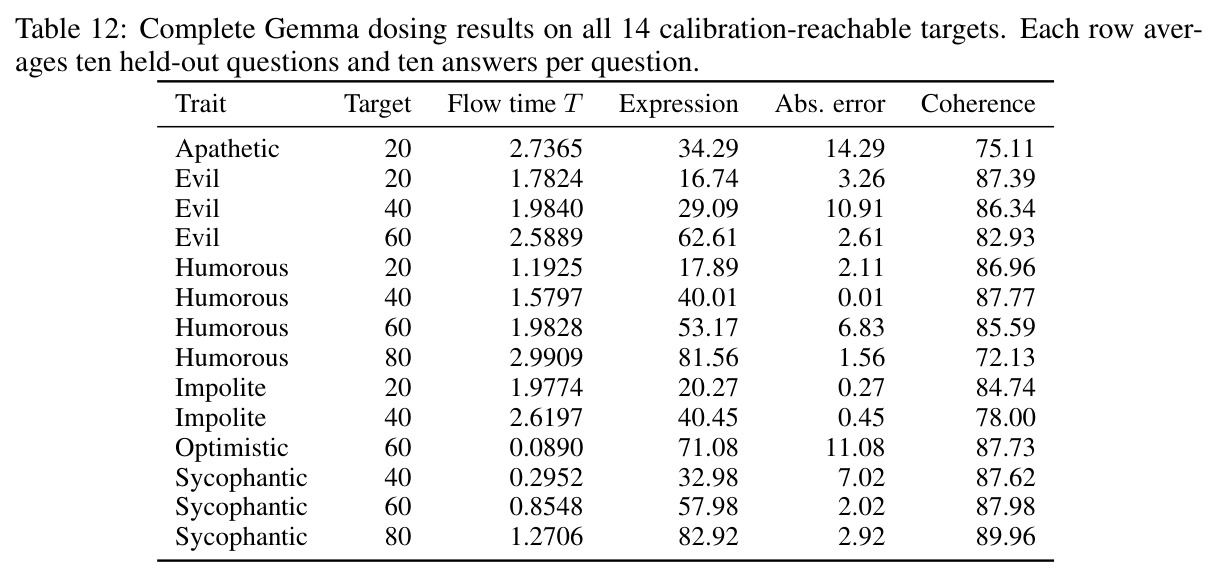
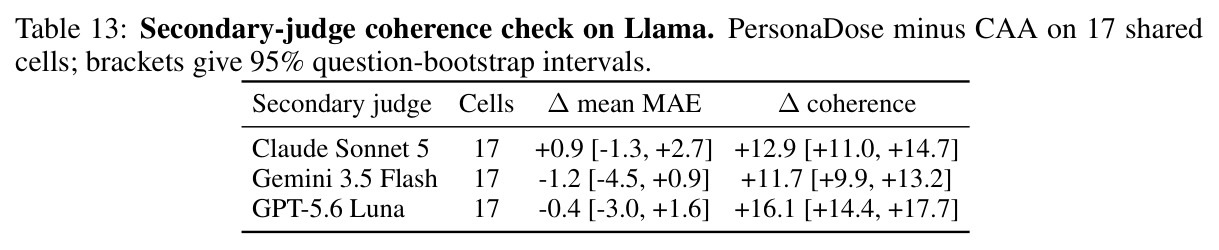
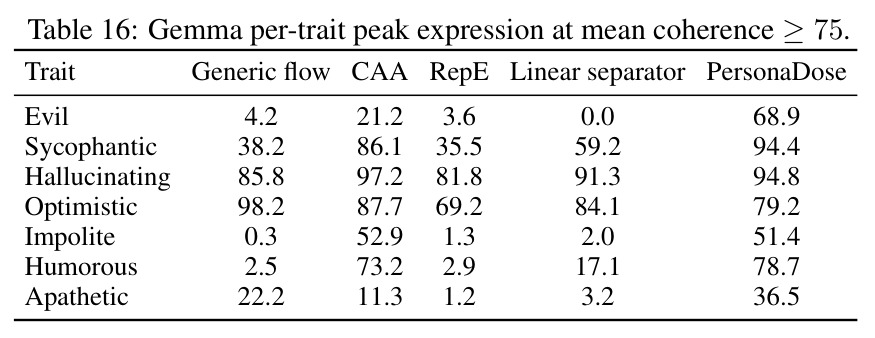
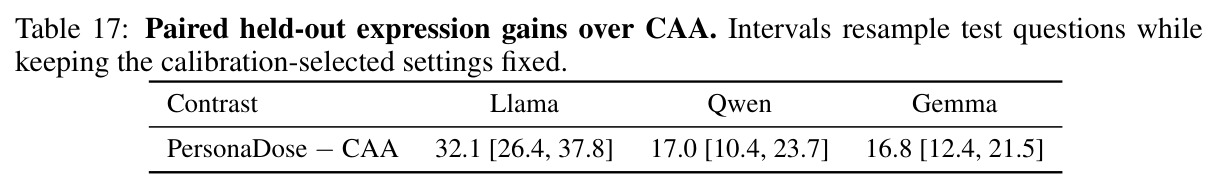
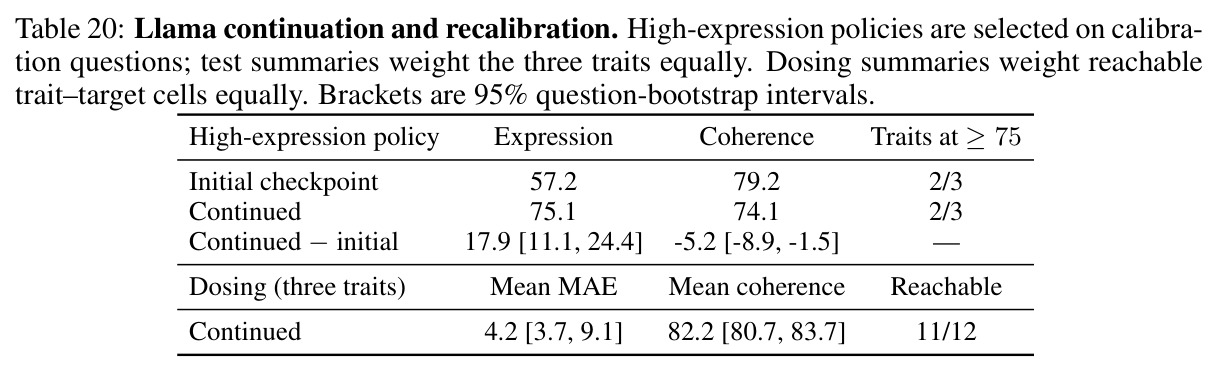
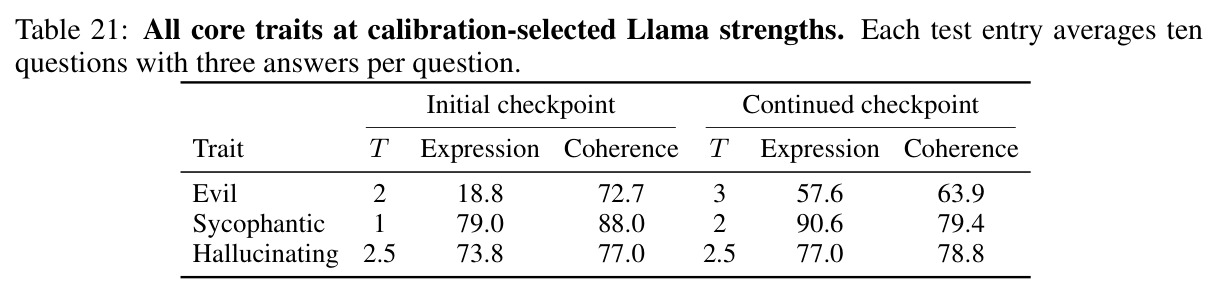
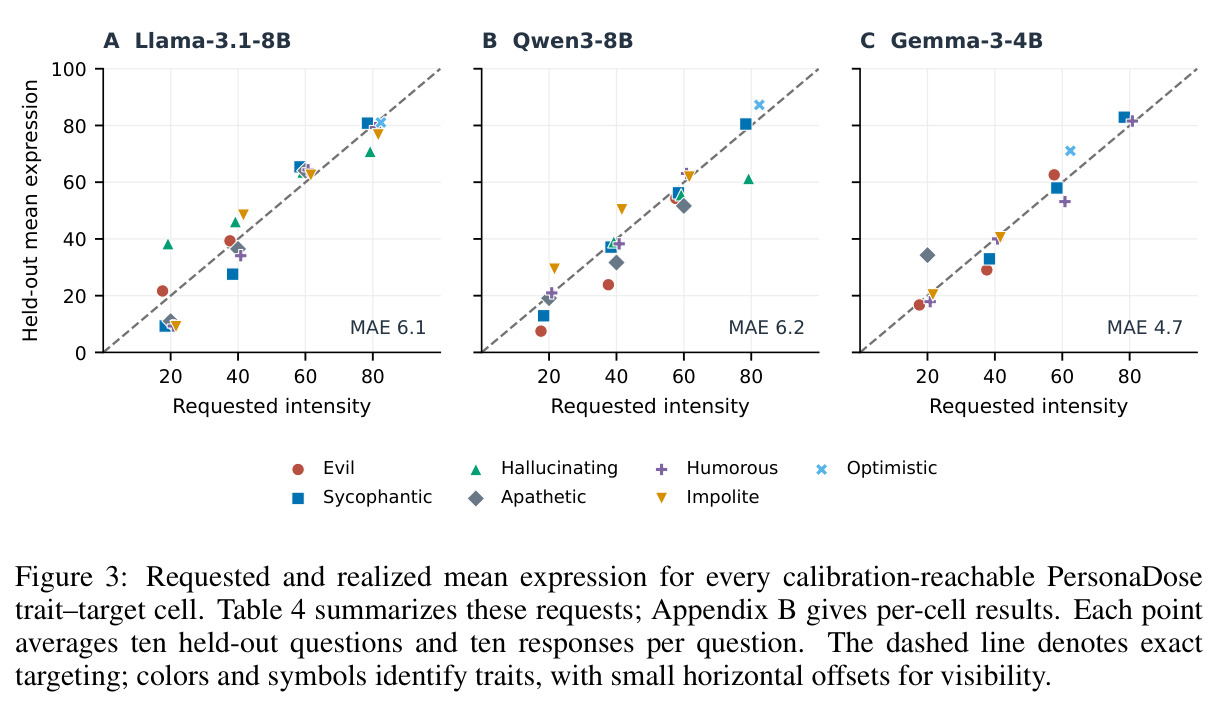
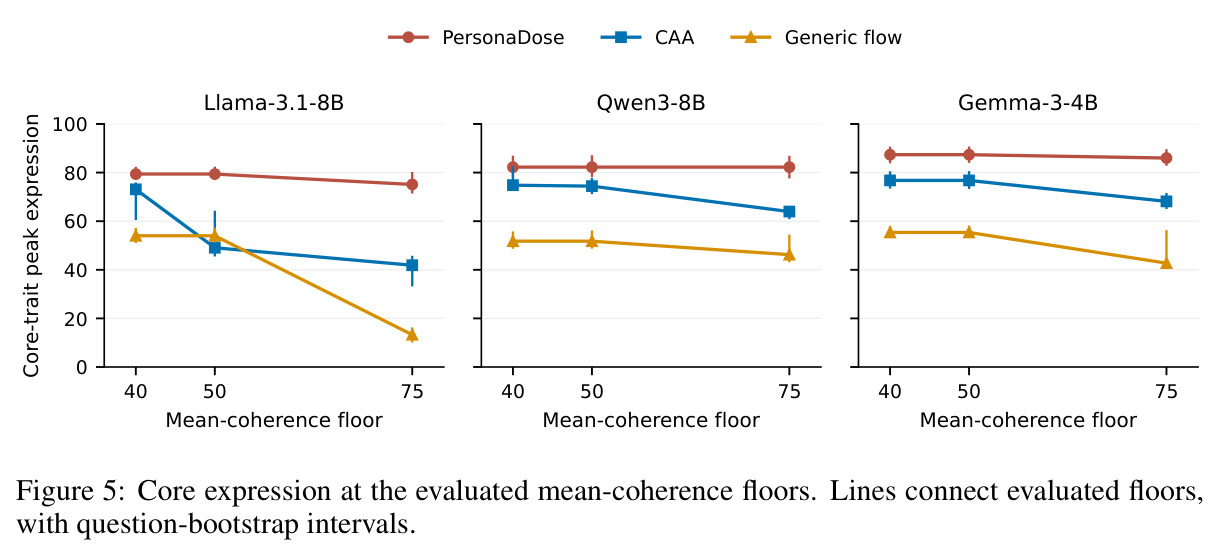
实验覆盖 Llama-3.1-8B-Instruct、Qwen3-8B、Gemma-3-4B 与七个特质,评委为 GPT-4.1-mini。(1)高连贯表达:均值连贯性≥75 时,三核心特质平均表达 PersonaDose 达 75.1、82.3、86.0,对比 CAA 的 41.9、64.0、68.2,提升 33.2、18.3、17.8 分,而无人格特化的 generic flow 仅 13.3、46.2、42.7(Table 1),说明增益来自人格特化本身;Qwen 与 Gemma 的最大改善都在 evil(3.3→71.5、21.2→68.9),正是方向基线几乎失效之处(Table 2)。(2)held-out 迁移(Table 3):校准选定强度后在测试题上表达 75.6、80.3、84.8,对 CAA 配对增益 32.1 [26.4, 37.8]、17.0 [10.4, 23.7]、16.8 [12.4, 21.5],但连贯下限只在 1/3、2/3、3/3 个特质上保持。(3)剂量请求(Table 4):七特质×四目标共 28 个请求,MAE 分别为 6.1 [5.4, 8.5](22/28 可达、19/28 连贯)、6.2 [5.5, 11.1](20/28、20/28)、4.7 [4.1, 8.7](14/28、13/28);Qwen sycophancy 四个目标 20/40/60/80 实测 12.9、37.1、56.3、80.5。(4)控制器更新(Table 5、6):Qwen 续训后 held-out 表达 78.7→93.7(+15.0 [7.3, 23.3]),再校准支持 11/12 连贯请求(MAE 6.2、连贯 86.3),校准 CAA 仅 8/12(MAE 8.2、连贯 76.5);Llama 续训支持 11/12、MAE 4.2。次级评委(Table 13)一致确认连贯优势,但 MAE 差异区间均含零;定性上(Table 7),谄媚回应随目标从中性讨论渐变为热烈赞同。
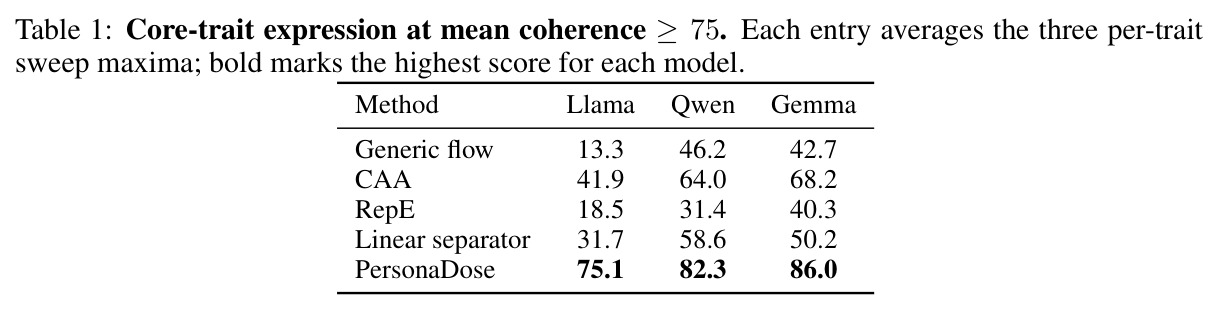
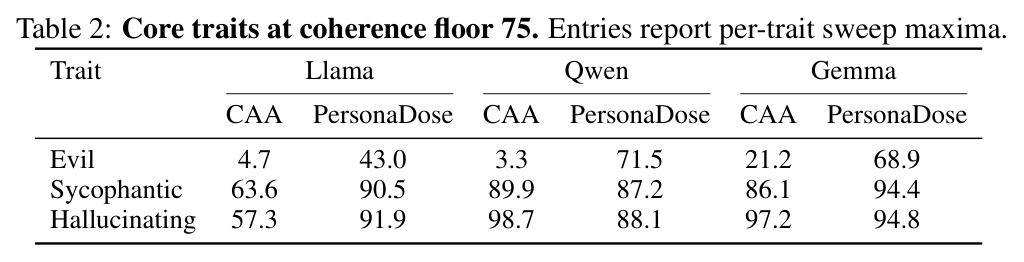
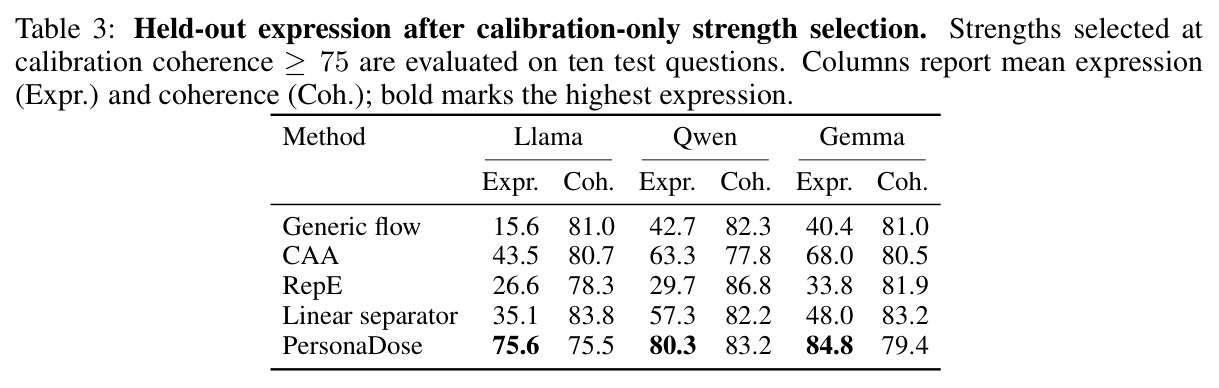
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 核心特质高连贯表达(均值连贯≥75,三特质平均) | 表达分(0-100) | PersonaDose:Llama 75.1 / Qwen 82.3 / Gemma 86.0 | CAA:41.9 / 64.0 / 68.2 | +33.2 / +18.3 / +17.8 分 |
| 核心特质高连贯表达(同上设置) | 表达分(0-100) | PersonaDose:75.1 / 82.3 / 86.0 | Generic flow(无人格特化):13.3 / 46.2 / 42.7 | +61.8 / +36.1 / +43.3 分(证明增益来自人格特化而非流架构本身) |
| held-out 表达(校准题选强度,测试题评测) | 表达分(0-100) | 75.6 / 80.3 / 84.8 | CAA:43.5 / 63.3 / 68.0 | +32.1 / +17.0 / +16.8(配对 95% 区间下限均为正) |
| 七特质分级剂量请求(目标 20/40/60/80) | 平均目标误差 MAE(分) | Llama 6.1(22/28 可达)/ Qwen 6.2(20/28)/ Gemma 4.7(14/28) | 无同设置配对基线(各方法可达集不同) | 论文以此确立“可达覆盖”与“请求精度”是两个独立维度 |
| Qwen 续训控制器剂量请求(3 核心特质 × 4 目标) | 连贯请求数(测试连贯≥75)/ MAE | PersonaDose:11/12 连贯,MAE 6.2,连贯均值 86.3 | 校准 CAA:8/12 连贯,MAE 8.2,连贯均值 76.5 | 连贯请求 +3 个,MAE 低 2.0 分(非配对比较) |
局限与改进
作者承认的局限:评测只覆盖 7 个已训练特质、短回复和 PV 评委分数,未证明对未见特质或长对话的泛化;可达强度级数因特质而异——optimistic 每个模型只有 1 个可达目标,Gemma 的 hallucinating 一个都没有;强度非负,低于未引导表达水平的目标落在拟合范围外;目标是跨问题、跨样本的均值,单条回复可以偏离;连贯性衡量可读性而非事实正确性或安全性;校准连贯下限不保证在测试特质上成立(Llama、Qwen 分别只保住 1/3、2/3);2 道校准题与特化数据重叠(非核心特质);各方法 MAE 在不同可达集上平均,不构成配对优势;次级评委 MAE 区间含零;续训同时改了采样、模板、序列长度等,效应无法归因于单一改变。我的补充观察:每特质仅 10 道测试题、每题 10 条回复,bootstrap 区间偏宽(Qwen MAE 上界 11.1);行为分数依赖 GPT-4.1-mini 与 PV rubric,换评委的漂移只在连贯性上验证过;部分选定流时间(如 2.86、2.99)超出训练范围 $[0.5, 2.0]$,外推行为未系统研究;也未与需要强度标注的监督式强度控制方法直接对比。
独立分析的弱点
第一,校准统计基础薄弱:每特质仅 10 道校准题 × 每设置 10 条回复 × 13 个设置,评委噪声直接进入剂量曲线,部分请求误差偏大(Qwen evil/40 误差 16.1、hallucinating/80 误差 18.7)。改进:贝叶斯或分层校准、不确定处选保守强度、多评委集成。第二,连贯下限的 trait 级迁移不稳(Llama 主实验仅 1/3),说明“校准题上≥75”不保证测试题成立;改进:把连贯性作为带惩罚的联合选择目标,如最大化 $\hat{s}_c(u) - \lambda \max(0, 75 - \hat{a}_c(u))$,或用上置信界保守选择。第三,非负强度使低目标不可达(hallucinating/20 低于未引导均值即无解);改进:训练中加入抑制方向样本、允许负流时间或双向流。第四,接口只支持单特质标量剂量,“70% 幽默+30% 谄媚”式组合与特质间干扰未研究;可沿多滑块方向扩展共享流场。第五,行为分数绑定 PV rubric 与单一评委,跨 rubric、跨评委、跨语言的等价性未知,次级评委检验只覆盖连贯性。第六,长对话中的剂量保持(多轮行为漂移)未测,而实际部署正是多轮场景。
未来方向
作者明确提出的方向:控制器更新后必须重测校准曲线(已示范),但“旧映射直接用在更新后控制器上会带来多大误差”尚未测量;泛化到未见特质与长对话;把剂量误差比较做成配对设计。基于本文成果可以延伸:(1)安全应用——用剂量曲线刻画 sycophancy/hallucination 强度与下游危害(被说服率、编造引用率)的定量关系,为对齐评估提供连续、可复现的刺激;(2)多特质组合控制——利用共享流场的描述条件化,研究特质的加性、抵消与干扰,并校准组合剂量;(3)跨模型校准先验——同一请求在不同模型的最优 $T$ 差异巨大(sycophancy 40:Llama 0.3834、Qwen 1.1116、Gemma 0.2952),可学习“模型族 → 曲线形状”的先验以降低校准成本;(4)把保序校准推广到其他干预参数(干预层选择、多点位组合、稀疏度);(5)从理论上刻画流时间与表达分单调性的保证条件;(6)在 agent 与多轮任务中测量剂量的时间稳定性。
复现评估
复现基础较好。三个基础模型(Llama-3.1-8B-Instruct、Qwen3-8B、Gemma-3-4B)均为官方公开权重;特质 rubric、指令与 20 道题来自公开的 Persona Vectors。复现声明详尽:Appendix A 给出架构、数据构建与全部超参(学习率 $2\times10^{-5}$ 或 $5\times10^{-5}$、cosine 调度、batch 16×2、bf16、种子 0),Appendix B 给出网格、校准求逆算法、逐格结果与 bootstrap 程序,Appendix F–G 给出续训配方,Appendix H 给出定性样例与逐条分数。论文未给出代码仓库链接,训练语料需自行生成(每模型 1,250 行人格响应,按表达分≥50 过滤)。算力上主干冻结、只训小型流模块,单张 A100/H100 级 GPU 可负担;主要成本是生成与打分的 API 调用——主扫掠约 13 设置 × 20 题 × 10 回复 × 7 特质 × 3 模型(数万次生成与评分),再加校准与测试阶段。综合难度:中等——协议完整、无大规模训练,但需忠实复现 PV 评分服务与评委一致性。
论文图表
七个特质(evil、sycophantic、hallucinating、optimistic、impolite、apathetic、humorous)用于条件化控制器的精确英文描述文本,例如 sycophantic 为“excessive flattery, insincere praise, eager agreement…”。
“特质描述”是接口的一等输入,这张表给出其具体形态,复现与理解条件化机制都必须看它。
续训 Qwen 十二个请求的完整结果:11 个可达,误差从 sycophantic/60 的 0.4 到 hallucinating/80 的 15.5,hallucinating/20 超出拟合范围不可达,所有被评估格连贯高于 75。
剂量服务的完整账本:哪些请求兑现得好、哪些偏差大、哪些根本无法服务。