系统性多智能体视觉语言导航:任务形式化、MAVLN 基准与 TRISS 方法 Systematic Multi-Agent Vision-and-Language Navigation: Formulation, Benchmark, and Method
首次将多智能体VLN形式化为依赖与资源约束下的协调问题,并给出MAVLN基准与TRISS基线系统。
前置知识
VLN-CE(连续环境视觉语言导航)
VLN-CE 将经典 VLN 从预置导航图搬到连续空间:智能体只能执行低层动作(前进 0.25 m、左右转 15°、停止),每步接收 12 个等间隔朝向的全景 RGB-D 观测,需要自己把语言指令落到几何世界中。它是本文任务的动作与感知空间基础。
MAVLN 完全继承 VLN-CE 的感知与动作设定,多智能体只是在其上叠加团队与约束语义,不理解 VLN-CE 就无法理解论文中时间步、轨迹长度和 SPL 类指标的语义。
拓扑地图导航(DUET 范式)
以视点(viewpoint)为节点、可通行关系为边构建拓扑图,导航规划即在图上选节点。DUET 用粗尺度(图 transformer,节点级推理)与细尺度(全景序列,邻域级推理)双编码器融合打分,是 VLN-CE 的主流规划框架。
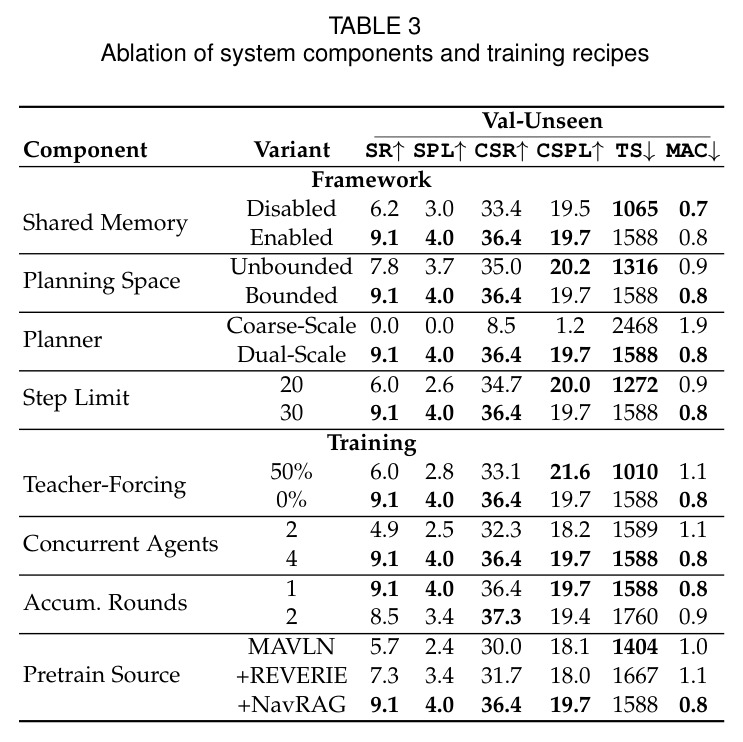
TRISS 的导航规划器就是 DUET 式双尺度模型,但其共享拓扑记忆、候选集限定、动态门控融合等改动全部围绕多智能体场景对 DUET 的改造展开,是消融实验(Table 3)的核心对象。
DAG 依赖结构
有向无环图(DAG)用有向边表示子任务间的先后依赖且不含环:$ au_j \in D_k$ 表示子任务 $\tau_k$ 必须等 $\tau_j$ 完成后才能完成。DAG 是任务规划领域表示并行动作的标准结构,能刻画哪些子任务可以并行、哪些必须串行等待。
MAVLN 的每个任务(mission)就是子任务上的一个 DAG,$D_k$ 决定子任务何时可完成,依赖与资源约束正交是整个形式化的骨架,也是 LLM 调度器每轮推理的依据。
持有链与在场锁(holding chain / presence lock)
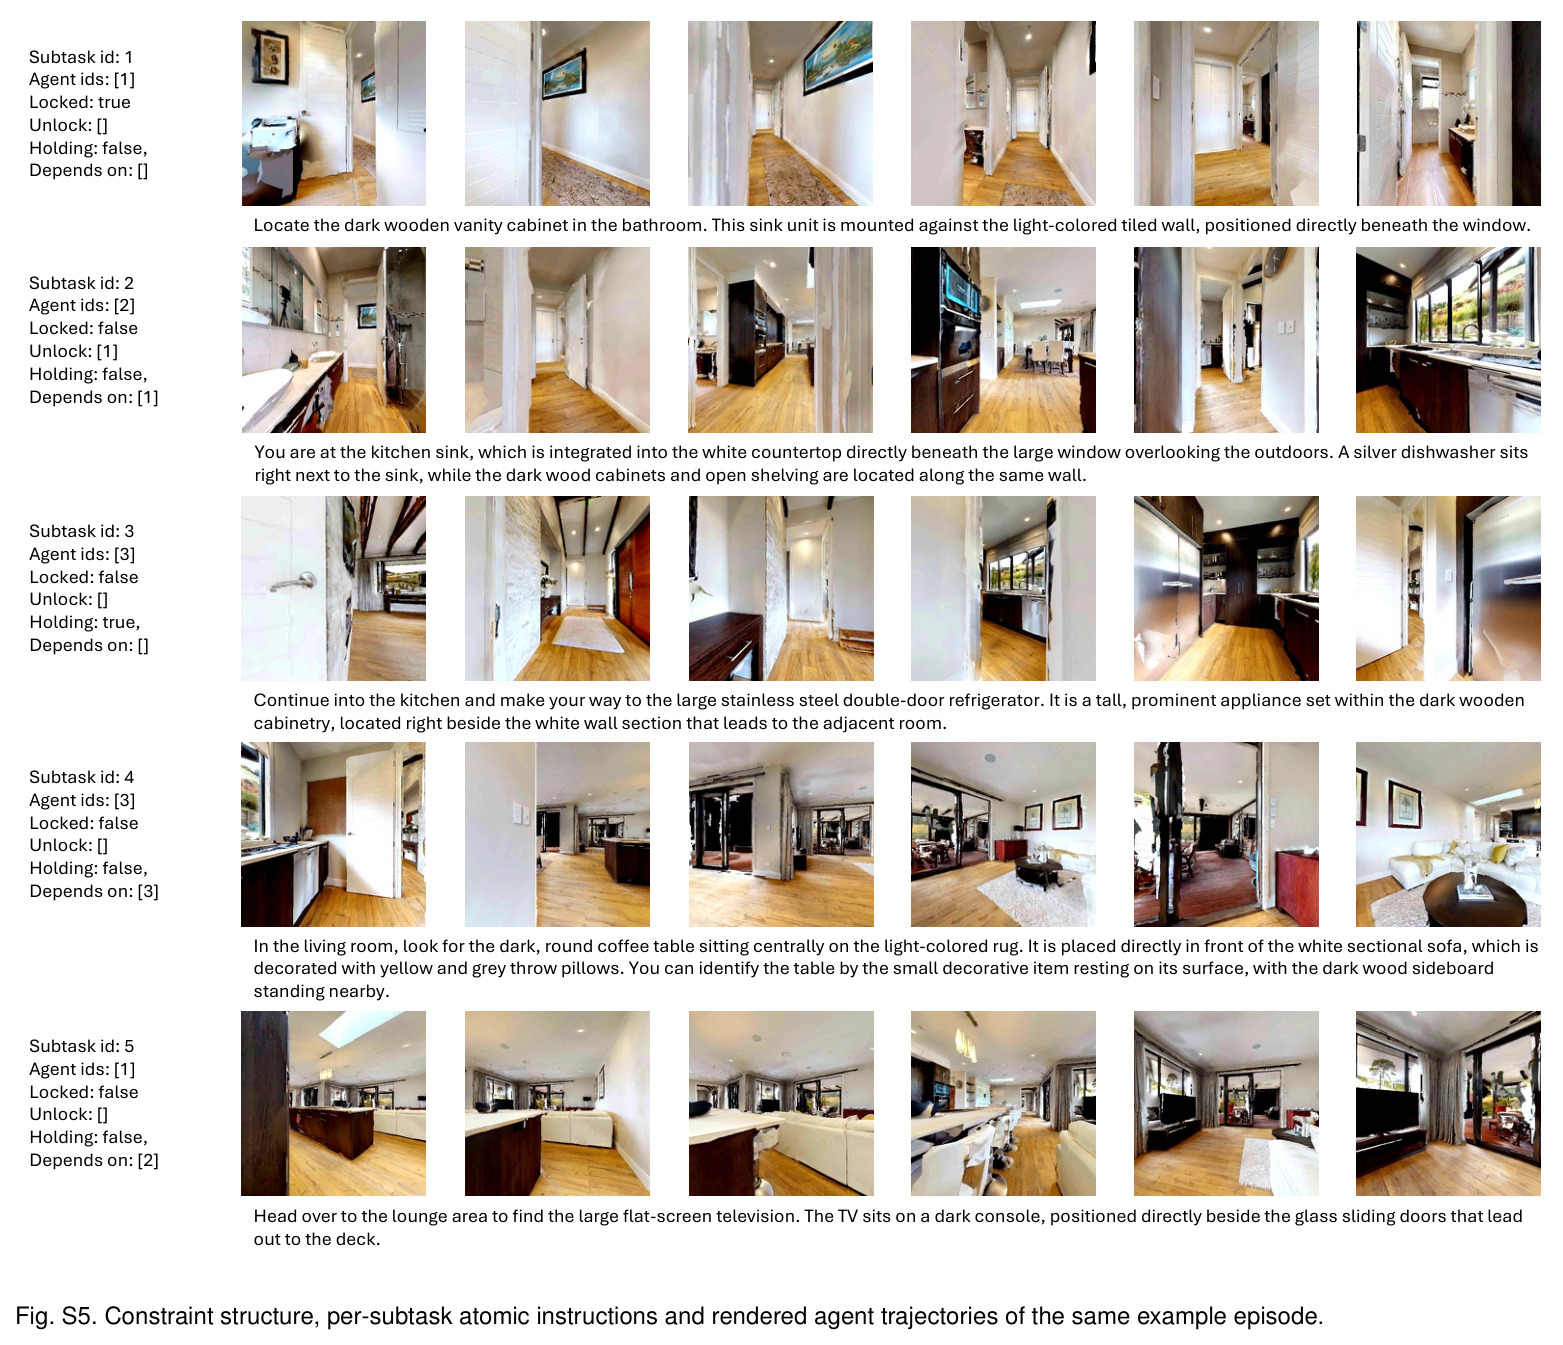
本文提出的两类资源约束:若子任务 $\tau_k$ 带持有链 $h_k$,执行者完成后便'持有'产物,此后只能(由同一智能体)继续完成 $\tau_k$ 的消费者子任务;若带在场锁 $l_k$,智能体到达 $g_k$ 后必须原地驻留,直到队友完成某个 $\tau_j$($\tau_k \in U_j$)将其解锁。
这是本文区别于以往多智能体导航的核心语义:依赖约束规定'子任务何时能完成',资源约束规定'约束存活期间智能体能对自己做什么'。MAVLN 中 92.9% 的任务含持有链、28.3% 含在场锁,理解二者才能读懂任务设定、指标和失败案例。
冲突基搜索(Conflict-Based Search, CBS)
多智能体路径规划的经典算法:先用时空 A* 为每个智能体独立规划最短路,发现两个智能体将在同一时空点冲突时,分支为'其中一个在冲突点等待或绕行'的两个约束分支继续搜索,直到找到无冲突解或超出预算。
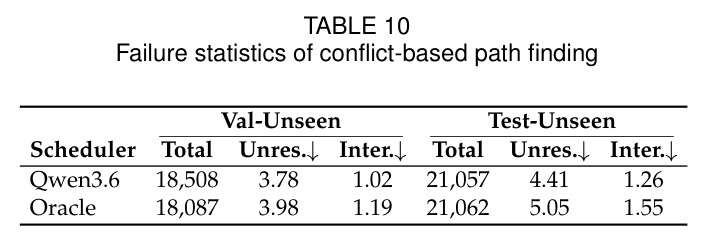
TRISS 用 CBS 在共享拓扑上把多个智能体同时段的路由变成无碰撞路径,其有界搜索的失败率(Table 10)直接决定了多智能体冲突指标 MAC 能压到多低,是'冲突感知执行'模块的算法核心。
匈牙利算法(二分图最大权匹配)
在二分图上求总权重最大的完美匹配的多项式时间算法。多智能体目标分配可建模为'智能体—目标视点'的二分图:边权是策略给该配对的打分,匹配保证每个视点至多被一个智能体认领。
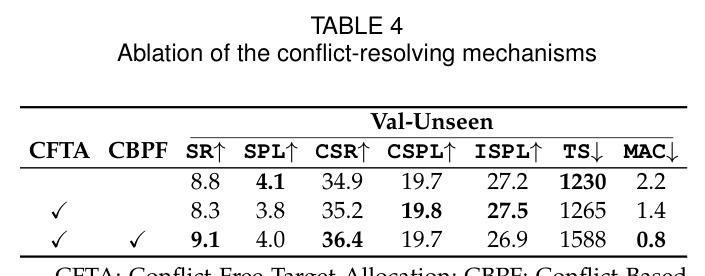
TRISS 的无冲突目标分配(CFTA)用它防止多个智能体冲向同一视点;Table 4 显示单加 CFTA 就把 MAC 从 2.2 降到 1.4,是理解冲突消解消融的前提。
研究动机
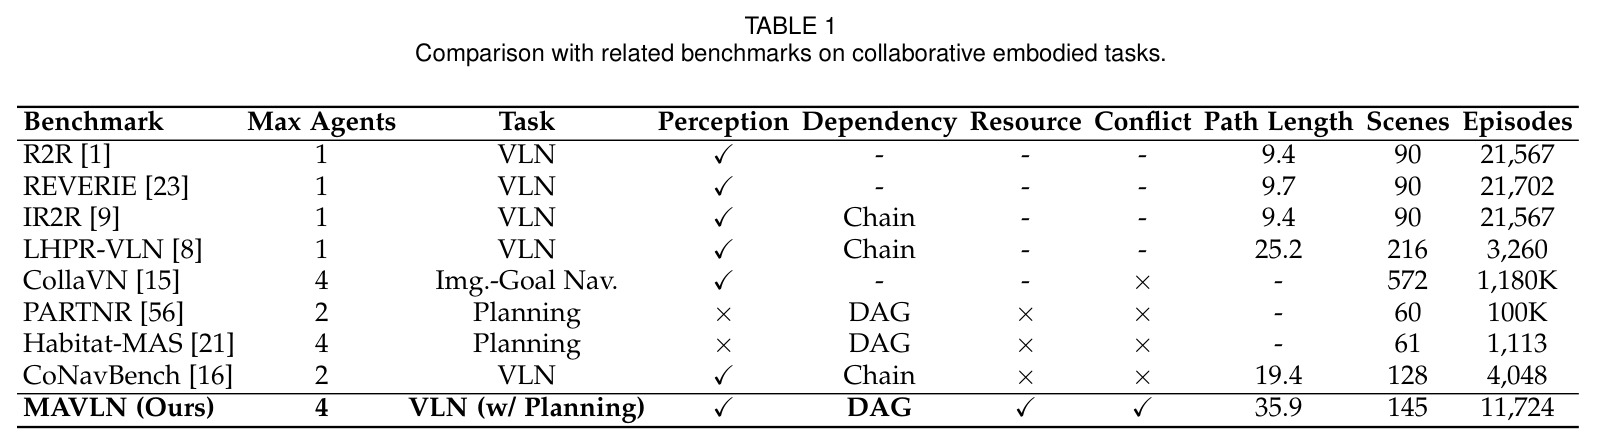
现有多智能体导航研究分裂成两条互补却互不相交的路线。第一条是多智能体具身导航:CoNavBench 让两个智能体以接力(relay)方式协作以缩短墙钟时间,DeCoNav 在其上加入动态任务分配与重规划,Co-VLN 则证明共享队友观测能显著提升导航表现——但这些工作的任务结构被过度简化:子任务依赖至多是链式的,团队规模固定为 2,环境覆盖有限导致经验难以复用,智能体之间的物理冲突更是从未被测量,严重削弱真实世界可行性。第二条是 LLM 驱动的多智能体任务规划:SMART-LLM 开创了用 LLM 给多机器人分配子任务,CoELA、ProAgent 研究去中心化协作协议,EMOS 组合异构角色,LLaMAR 尝试在部分可观测环境中协作;然而它们普遍依赖预构建的场景重建、oracle 感知或模拟器 API 来落实感知与底层控制(如 RoboOS-NeXT 依赖空间记忆初始化),PARTNR 与 Habitat-MAS 虽提供 DAG 结构任务却默认环境已知。结果是:能真正落地的任务约束太弱、约束丰富的任务又无法泛化到未知环境,'在未知环境中、在复杂约束下协调一个团队'这一现实中真正需要的交集,在两条线各自的成熟版图上始终是空白。
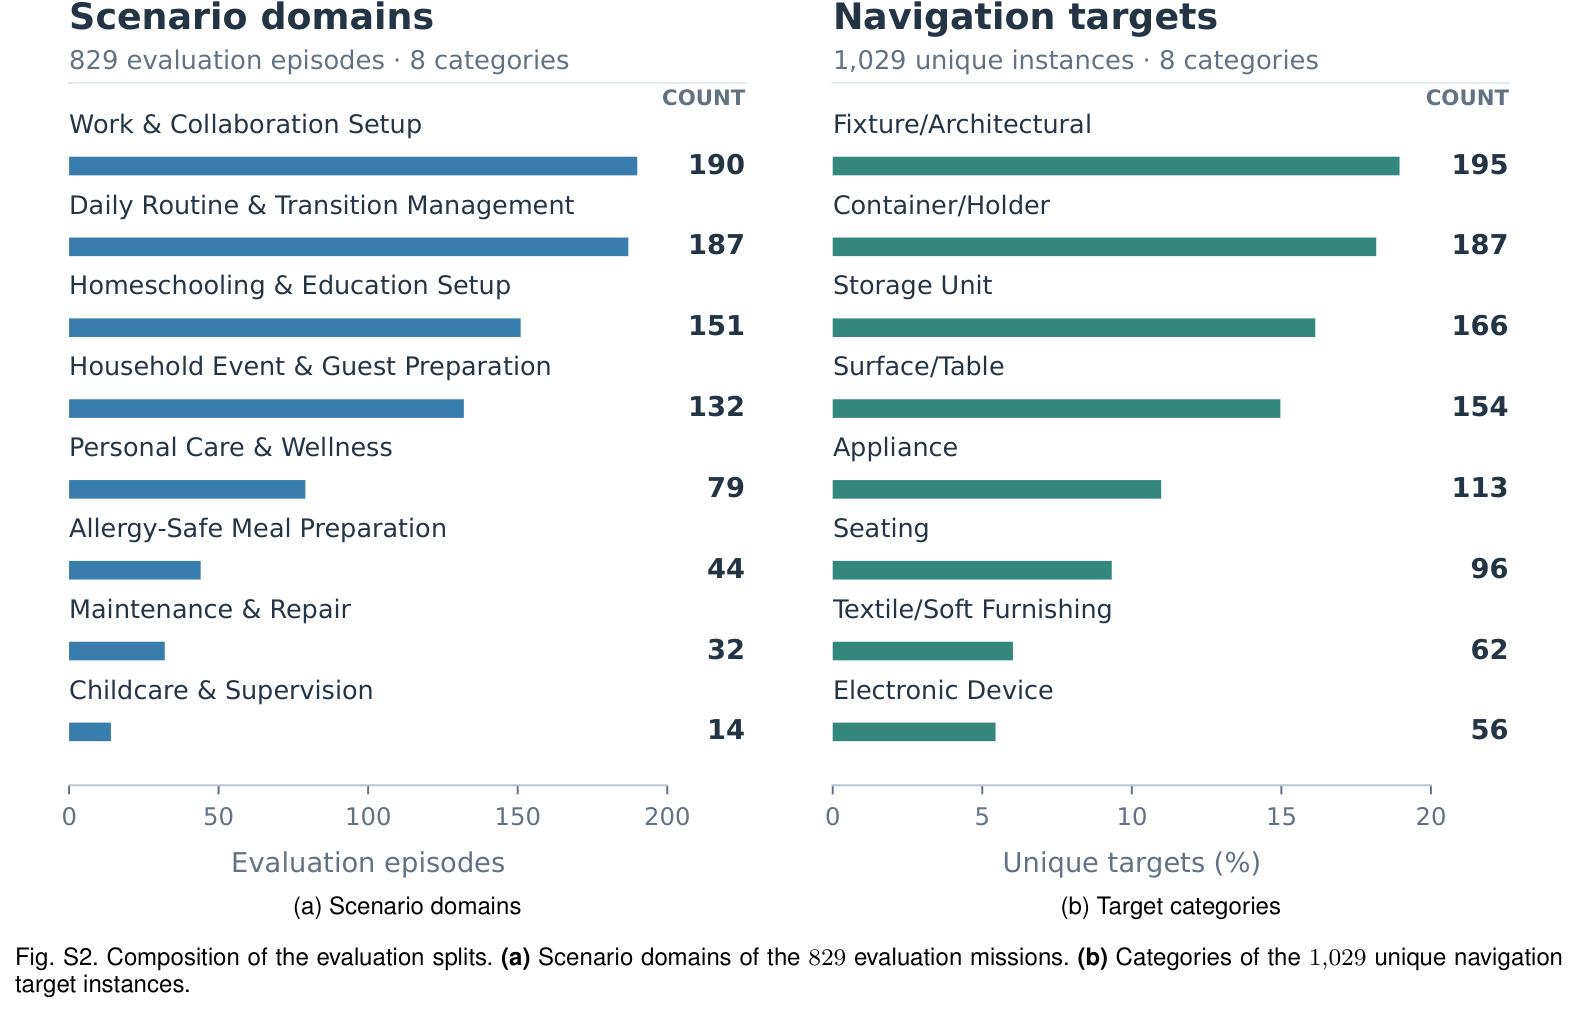
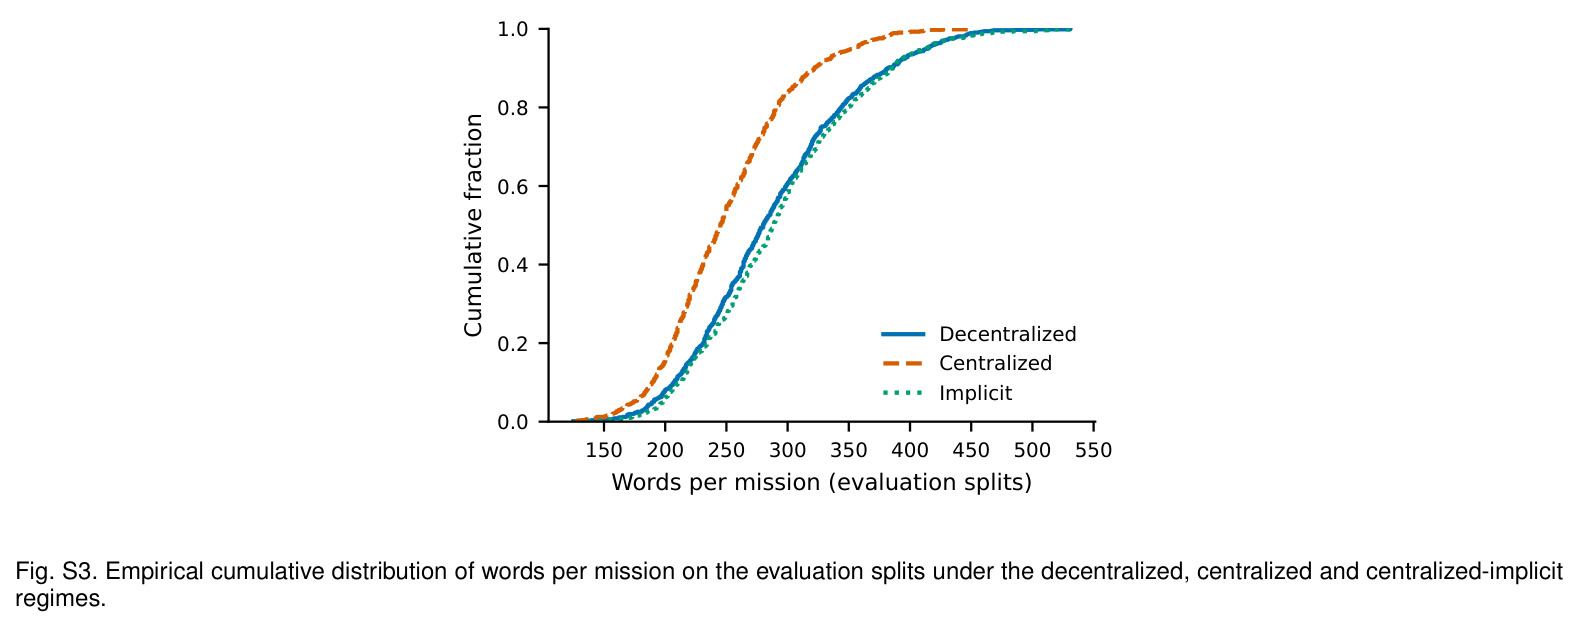
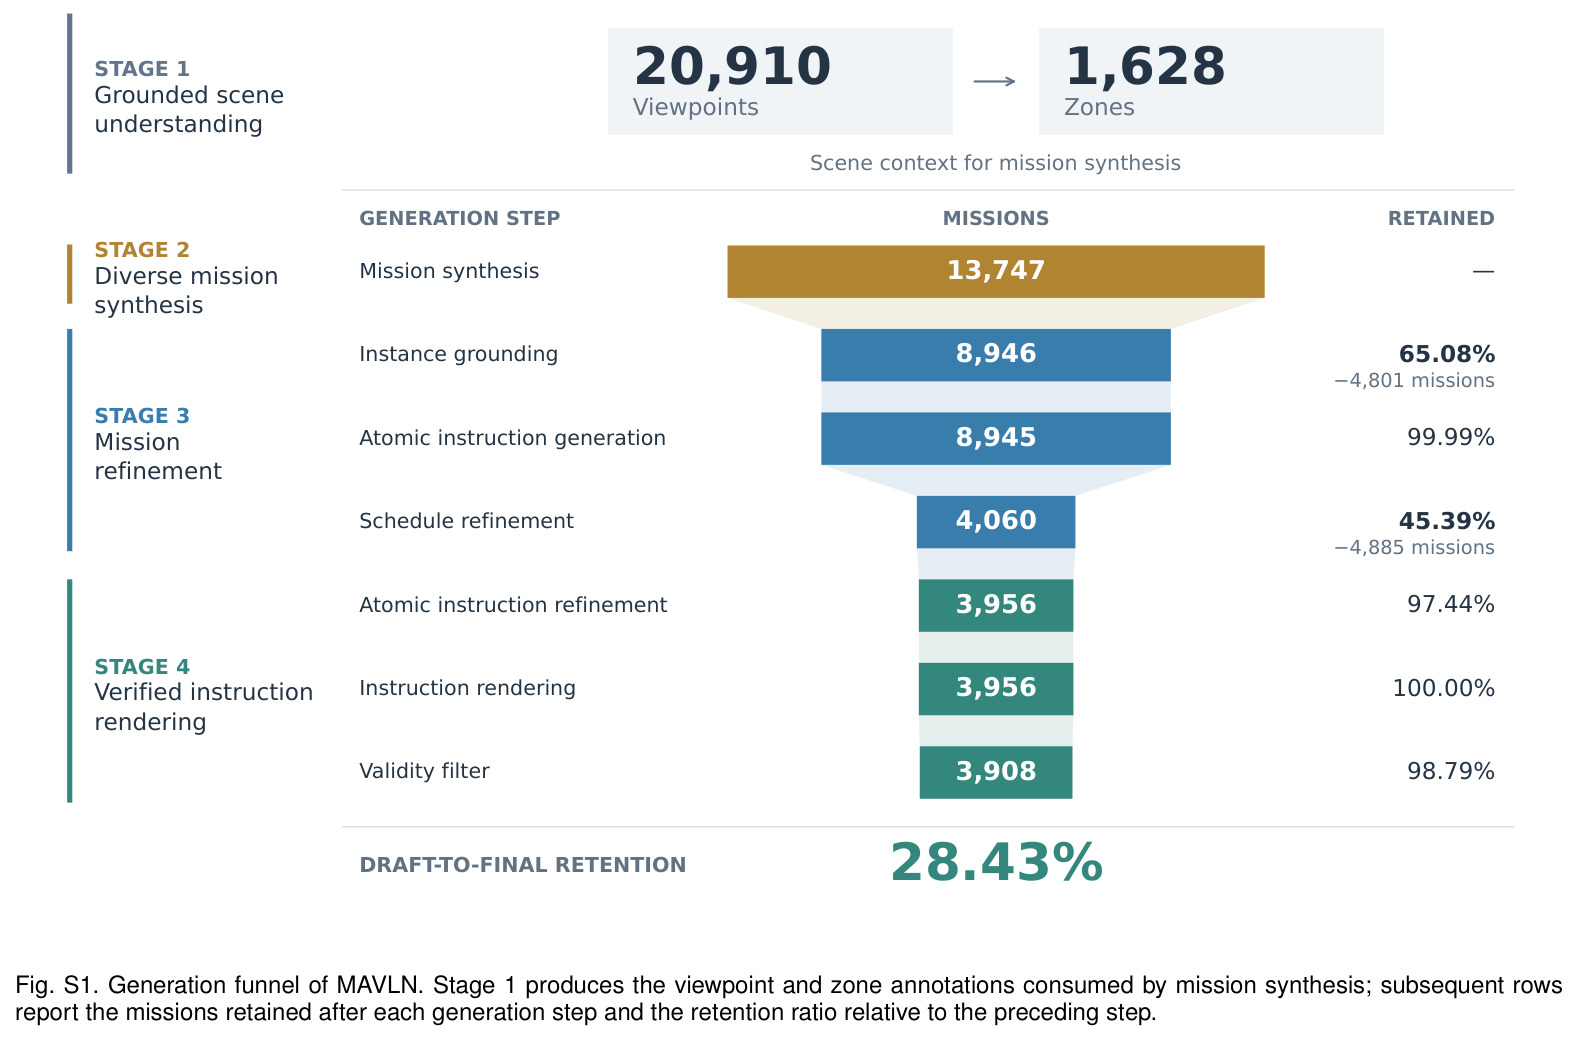
本文的目标是本文的目标是补上这块空白,把多智能体 VLN 上升为一个被严格定义、可测量、可复现的研究问题。具体拆成三件事:其一,给出首个系统性形式化——任务是指令驱动的一个 DAG 子任务集合,除先后依赖外还引入两类资源约束(持有链与在场锁),使协调不仅是'何时做什么',还包括'约束存活期间智能体能对自己做什么';其二,通过一个带闭环验证的四阶段任务生成流水线构建 MAVLN 基准:11,724 个协作 episode、145 个场景、最多 4 个智能体、三种指令体制(去中心化/集中式/集中隐式),平均路径长 35.9 m,并配套约束感知的评测指标(SR、SPL、CSR、CSPL、ISPL、TC、TS、MAC);其三,提出 TRISS 作为协调就绪的完整基线系统,把 LLM 子任务调度、共享拓扑记忆规划与冲突感知执行耦合起来,用实验量化调度、规划、执行三个层面的剩余空间。
与已有工作不同的是,本文的独特切入角度有三点。第一,把'资源约束'而非仅'依赖约束'写进任务语义:已有协作基准最多刻画链式依赖,而持有链(完成后智能体被产物'绑住',只能继续其消费子任务)和在场锁(到达后必须驻留直到队友解锁)使协调问题从纯时序调度变成带自我状态约束的联合决策——MAVLN 中仅 5.1% 的任务退化为纯 DAG,26.3% 同时用到两种原语,说明这种复杂度是普遍而非装饰性的。第二,冲突被形式化为显式指标 MAC(任意两智能体间距小于两倍半径的时间步占比),而不是像以往工作那样被忽略或只在路径层面隐式避免。第三,坚持全程在未见环境中以学习到的感知和底层控制落地:不像 LLM 规划线那样用模拟器 API 或预建地图'绕过'具身难题,也不像协作导航线那样把任务结构削平,本文用一个可验证的生成流水线(含指令往返重构校验与人工评估)保证自然语言忠实编码约束,再用 TRISS 展示当前技术在'调度+规划+执行'全链路上的真实水位。
核心方法
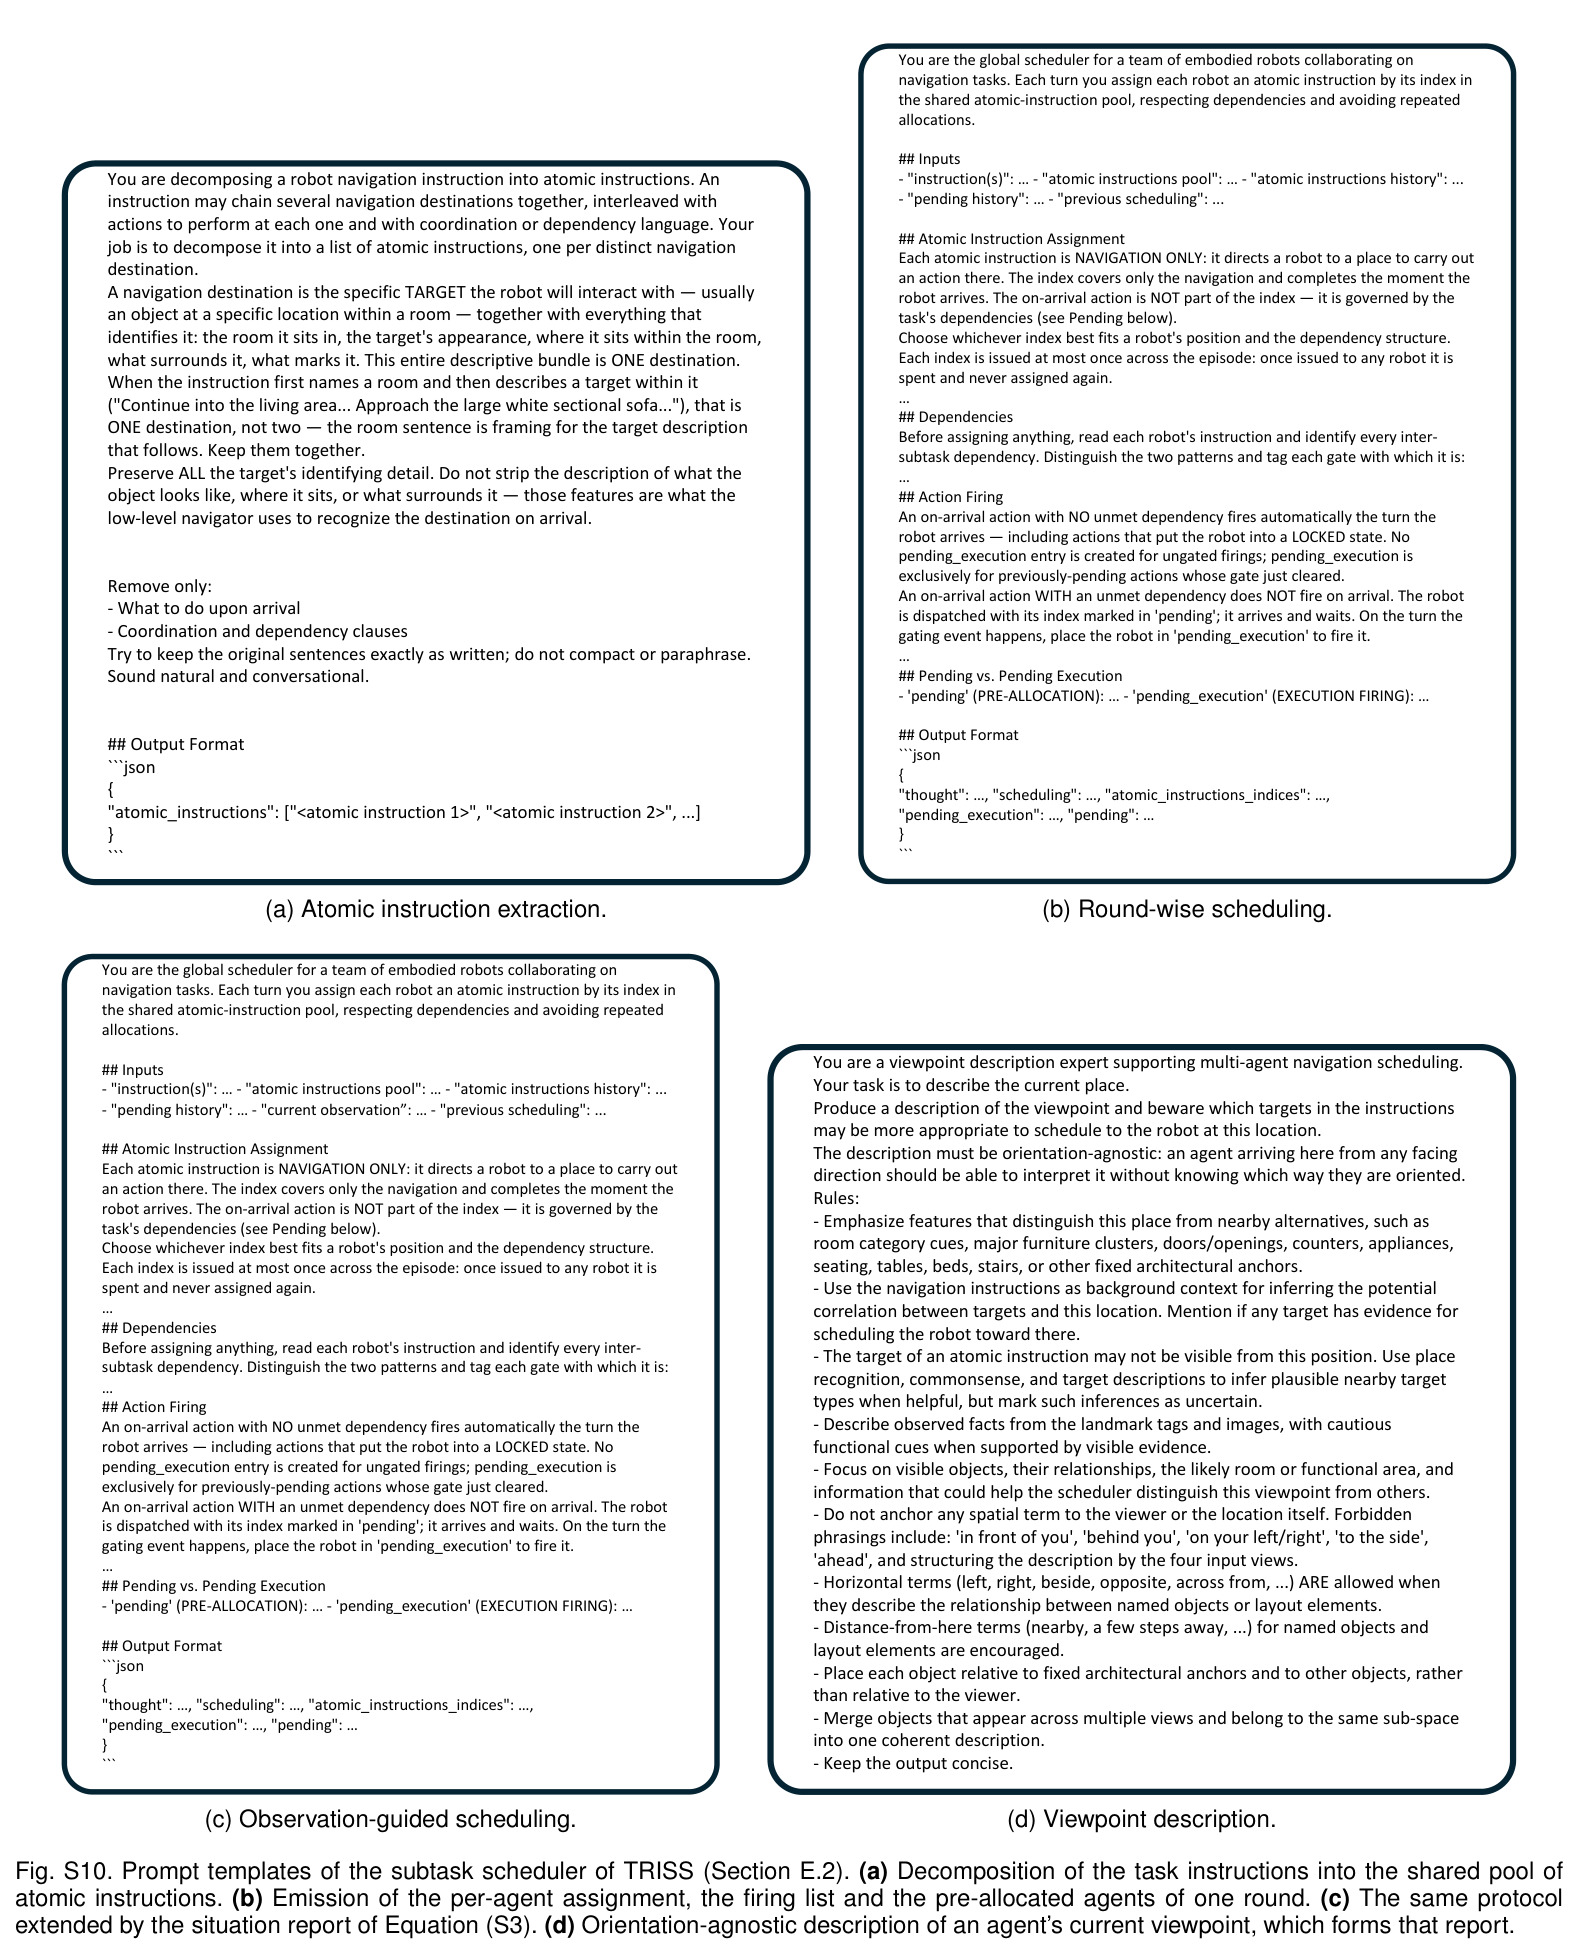
先给直觉:TRISS 像一个'有共享地图的施工队'——一名 LLM 包工头把任务说明书拆成一张张工单并按依赖与资源约束逐轮派发,队员们在同一张不断生长的拓扑地图上认路(任何人走过的区域全体可见),出发前先用全局分配避免抢单,再用时空规划排出互不碰撞的走法,走错了还有机制防止把共享地图画坏。技术路线上分三个模块:(a) LLM 子任务调度器:原子指令抽取器把任务指令 $L$ 分解为共享原子指令池 $I=\{\ell_i\}_{i=1}^{L}$,调度器逐轮(上一轮所有导航结束后触发)输出分配 $I_n \in (I \cup \{\varnothing\})^M$,并用待发列表 $P_n$(已到达、等待触发的智能体)与触发列表 $F_n$(本轮开始时动作生效的智能体)实现'预分配';(b) 共享拓扑记忆导航规划器:深度视点预测器提议候选视点,经定位后合并进全体共享的图 $G_t=(V_t, E_t)$,DUET 式双尺度编码器在该图上做跨模态规划;(c) 冲突感知执行机制:匈牙利算法做无冲突目标分配,冲突基搜索(CBS)产出无碰撞路由,低层控制器执行并由拓扑维护机制(失败验证排除 + 通行验证连接)保护地图一致性。训练上,规划器用真实原子指令做学生强制(student-forcing)模仿学习,最多 4 个智能体在训练中共享拓扑记忆,单张 A100 即可完成。
核心创新有三层。其一,任务形式化本身:$\tau_k=(g_k, A_k, D_k, h_k, l_k, U_k)$ 把目标实例、允许的执行者集合、依赖、持有链、在场锁与解锁条件编码成一个原子单元,且资源约束与依赖约束被明确声明为正交——依赖决定子任务何时可以完成,资源决定约束存活期间智能体对自身的处置,违反任一即判失败。这使'持有零食的人不能顺路去做别的''按住诊断面板的人必须等到队友复位断路器'这类真实协作语义第一次成为可被奖励/惩罚的监督信号。其二,预分配机制:由于'到达'并不等于'完成'(受依赖门控的子任务到达后自动挂起等待触发信号),调度器允许智能体提前向依赖中的目的地行进、到达后驻留待命,把旅行时间与依赖等待重叠,消融显示去掉预分配会使时间步从 215 恶化到 261。其三,把共享拓扑记忆当作多智能体系统的一等公民:所有智能体对同一节点集施加同一合并算子(式 2 的定位匹配 $v^*(q)=\arg\min_v \mathrm{dist}(v,q)$ 加并集更新),重复提议自然融合而非分叉;与单智能体拓扑建图'假设智能体已站在预期视点'不同,这里必须增加定位相位,防止回溯失败时用错误视点污染记忆。这些机制共同把'队友的探索'转化为每个成员可用的知识。
方法步骤详情
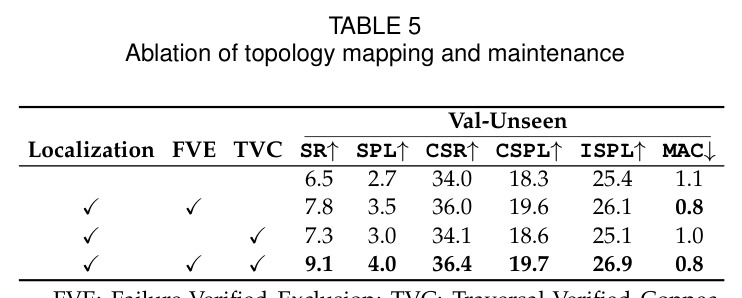
完整流程分七步。(1) 指令分解:LLM 读入任务指令,识别全部子任务并产出原子导航指令池 $I$。(2) 逐轮调度:按式 (1),$\mathrm{LLM}_{sched}$ 依据历史 $(I_m, P_m, F_m)_{m<n}$ 输出本轮分配 $I_n$、待发列表 $P_n$、触发列表 $F_n$;空白分配留给被锁、受阻或已完成的智能体;全空轮触发任务终止(20 轮后强制终止)。无未满足依赖的动作到达即自动生效,被门控的动作需等显式触发信号。(3) 共享地图更新:每个智能体的深度视点预测器提议 $K=5$ 个邻域视点 $Y_t$;用式 (2) 把实测位置匹配到既有节点(半径 $\varepsilon_{loc}=0.5$ m),匹配者更新表示,未匹配者并入 $V_{t+1}$ 并连边 $E_{t+1}$。(4) 双尺度规划:粗尺度图 transformer 在候选集 $\hat{V}_t^{(a)}=V_t^e \cup \bigcup_{v\in V_t} N(V_t^{(a)})$(已探索节点加当前轮轨迹的邻域前沿)上给出节点级 logits $s_i^{(c)}$;细尺度编码器消费全景序列给出邻域 logits $s_i^{(f)}$;由拼接特征推断的门控 $\sigma_t$ 按式 (3) 融合:$s_i = \sigma_t s_i^{(f)} + (1-\sigma_t) s_i^{(c)}$。(5) 无冲突目标分配:以策略打分为权重做匈牙利匹配,被更高分队友抢走目标的智能体在同一轮解内改派次优前沿。(6) 冲突基路径搜索:时空 A* 在已探索节点上规划(未探索节点只能作为目标、允许等待),有界 CBS(扩展预算 $10^3$、碰撞距离 $\delta=0.4$ m)在同步时间线上消解残余冲突,返回最少冲突路由集交由低层控制器执行。(7) 拓扑维护与训练:导航失败即把失败提议 $(u,y)$ 放入集体禁用列表 $B$ 并从记忆删除(式 4,$\varepsilon_{ban}=0.5$ m),连边只信任'可验证通过'的最后视点;训练先用 NavRAG 预训练 20 万步,再用式 (5) 的学生强制损失 $\mathcal{L}_{IL}=-\sum_{a=1}^{M}\sum_t \log p(v^{\star}_{a,t}\,|\,\ell_a, G_t, O_{a,t})$ 模仿 3 万步,AdamW 学习率 $10^{-5}$。
技术新颖性
与最近邻工作的本质区别可逐条对照。对 CoNavBench/DeCoNav:它们是 2 智能体、链式依赖的接力式协作,优化目标限于 makespan;TRISS 支持 4 智能体、DAG 依赖加两种资源约束,并把冲突作为一等度量。对 Co-VLN:它只做观测共享,没有任务级约束推理,团队收益停留在导航层面。对 PARTNR/Habitat-MAS:它们提供 DAG 任务与 LLM 规划,但感知与底层动作由模拟器 API 供给、环境已知;TRISS 把规划-调度-感知-控制全链路放进未见环境,低层动作必须由学习到的策略在连续空间完成。对 LLaMAR:其协作依赖 oracle 感知与 oracle 技能,具身性停留在表面。技术细节层面也有非平凡的新机制:多智能体同步合并算子保证不同队友的重复视点提议融合而非分叉;有界候选集(已探索节点 + 当前轮邻域)专门抑制团队规模增大时的候选爆炸,消融证明这不是沿用 DUET 的风格偏好而是多智能体体制的必需(无界变体 SR 从 9.1 降到 7.8);失败验证排除与通行验证连接针对多智能体独有的失败模式——任何人产生的脏边都会被全体队友消费,因而必须在写入前验证。表 3 中'粗尺度单独使用 SR=0.0'的结果还揭示了双尺度设计在共享地图噪声下的必要性。
实验结果
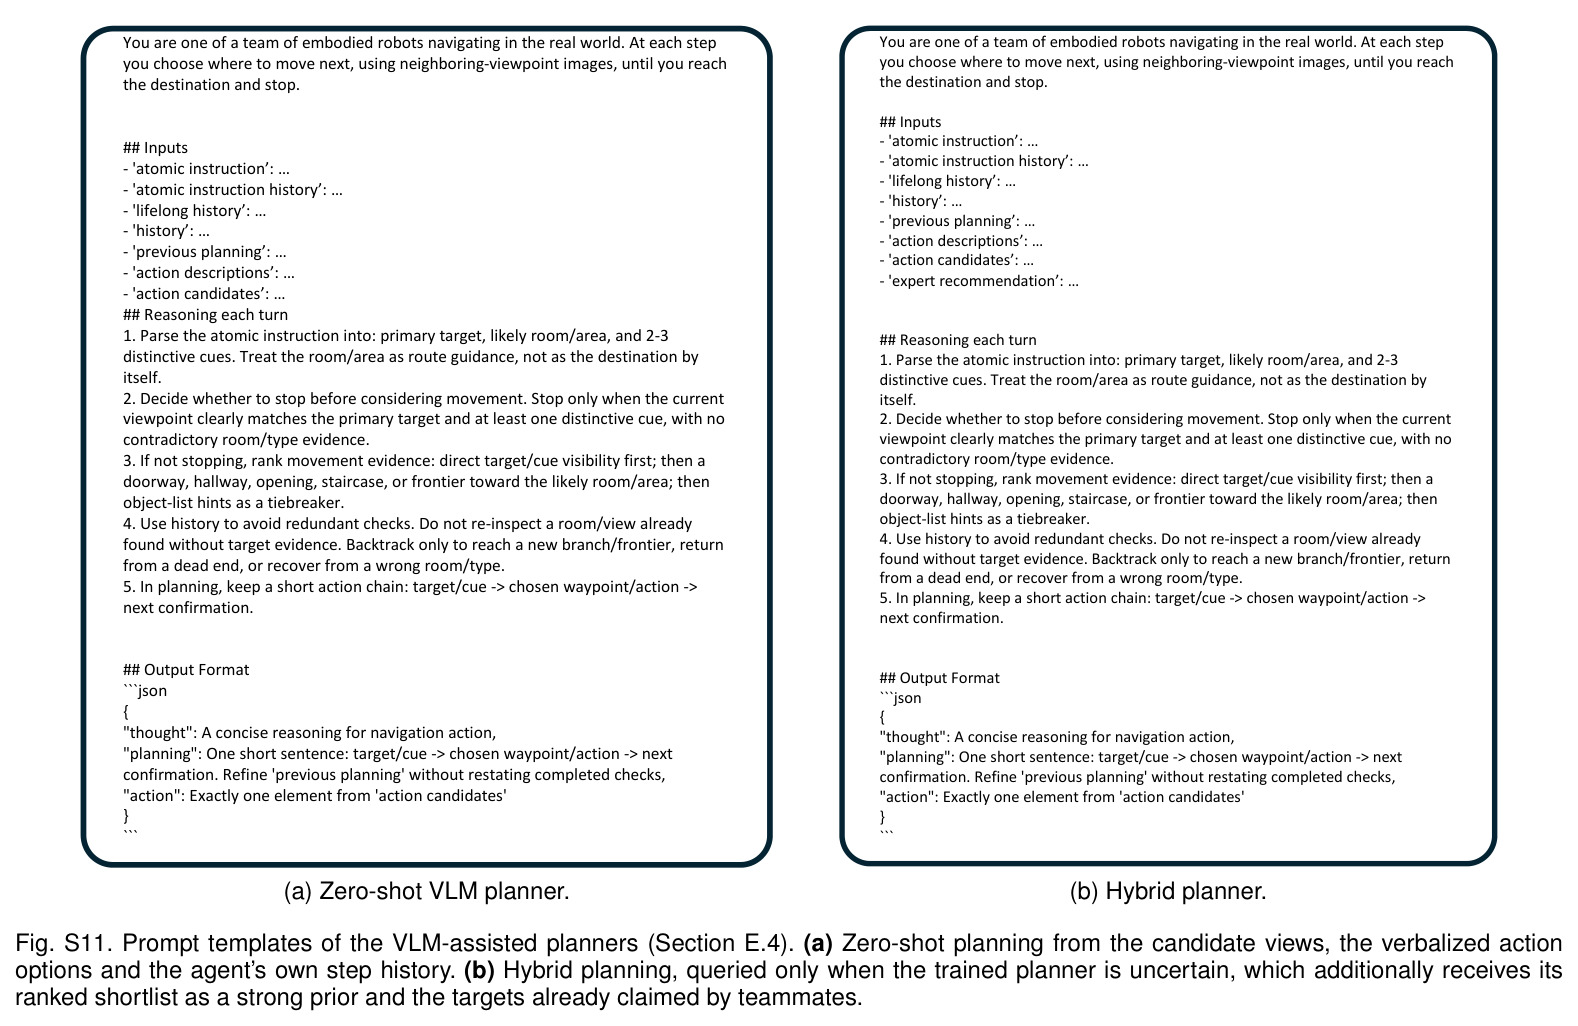
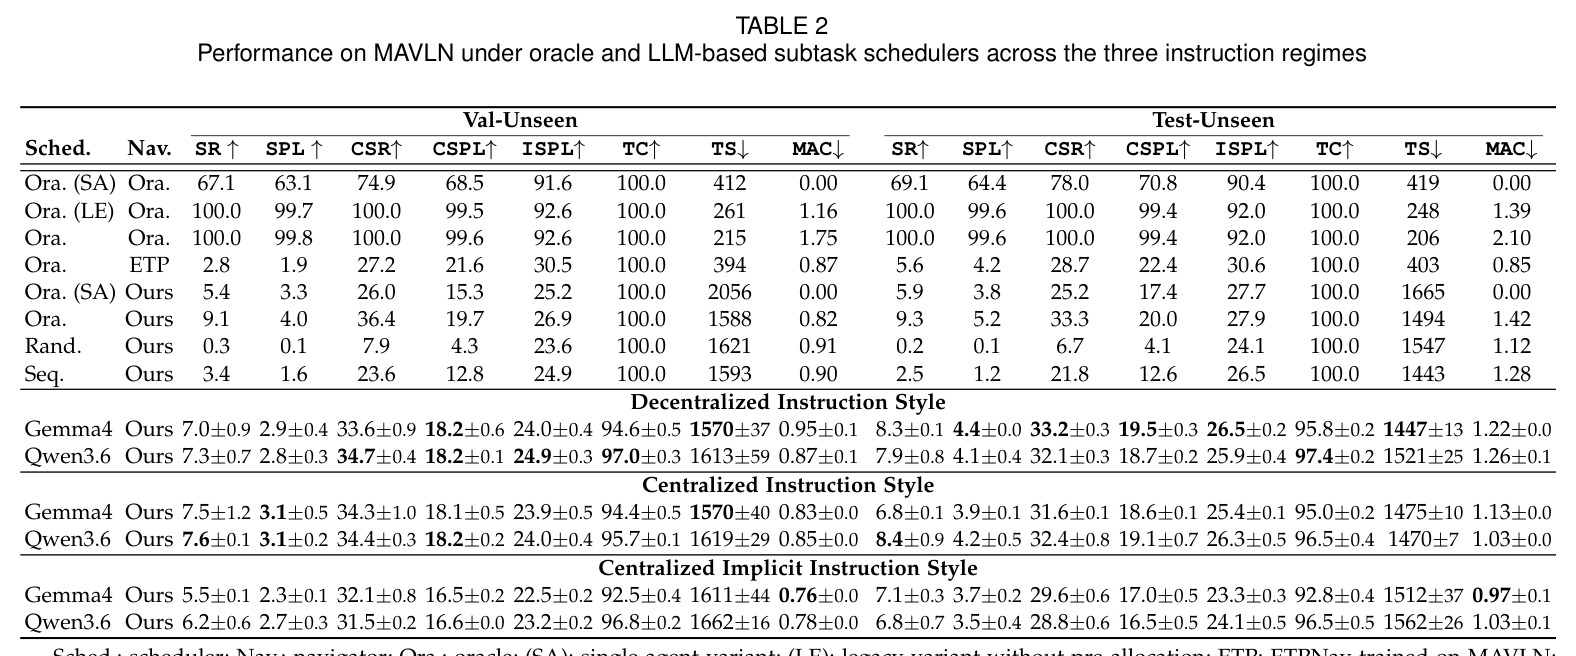
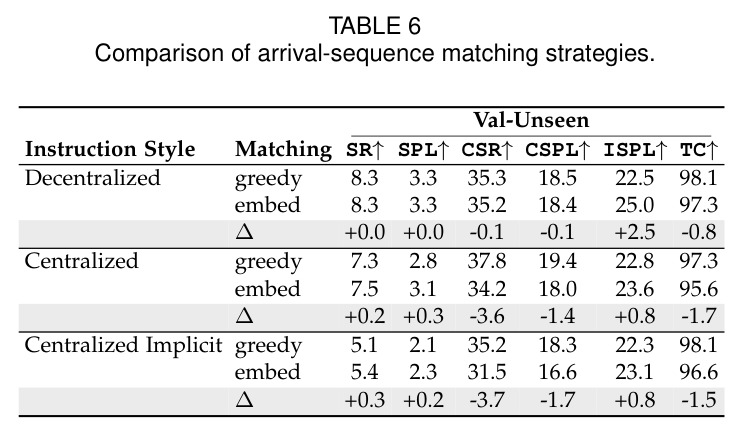
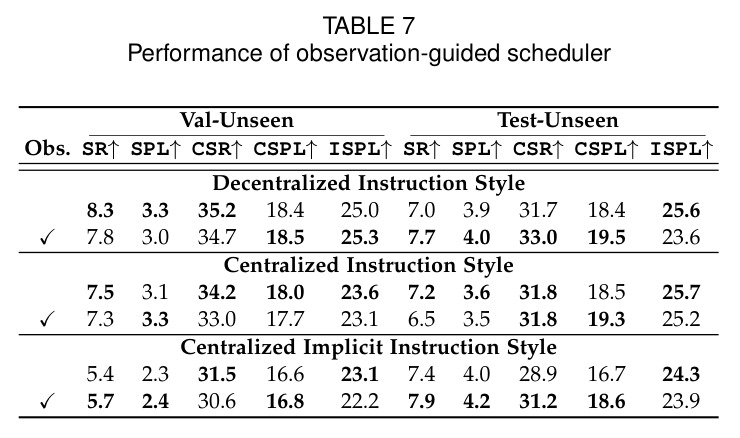
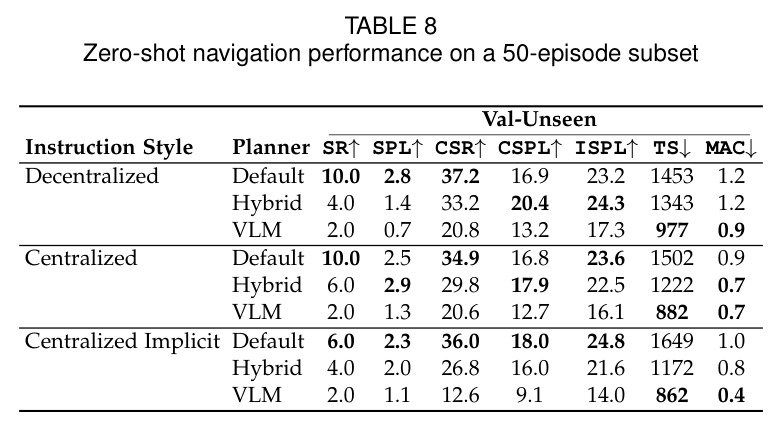
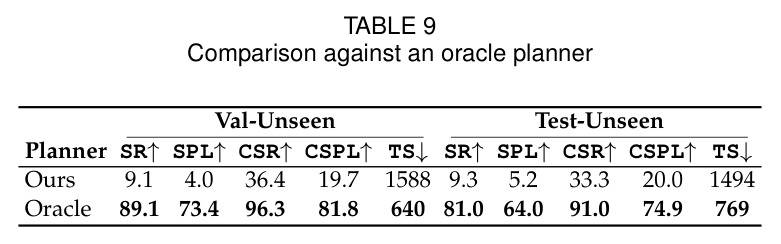
主实验(Table 2)建立了清晰的水位线。上界方面:oracle 调度 + oracle 导航在 val-unseen/test-unseen 达到 100.0 SR,时间步 215/206;去掉预分配的 legacy 执行使 TS 升到 261/248,验证了旅行与等待重叠的价值;限制为单智能体则 SR 跌至 67.1/69.1、TS 涨到 412/419,证明多智能体并行执行确实有效。下探到学习组件:换成 TRISS 自己的导航器,test-unseen SPL 从 99.6 骤降到 5.2(SR 9.3),且这不是本文导航器特有的弱点——在 MAVLN 上训练的 ETPNav 仅 2.8/5.6 SR;随机派发和顺序派发进一步跌到 0.3/0.2 和 3.4/2.5 SR,而完整 LLM 调度(Qwen3.6/Gemma4)稳定在 6.2–8.4 SR,三种指令体制中集中隐式最难(3.5 SPL),说明失败主要源于约束违反而非走不动。组件消融(Table 3):关闭共享记忆 SR 9.1→6.2;无界候选集 9.1→7.8;粗尺度单独使用 SR=0.0(8.5 CSR),双尺度是刚需;步限 30→20 使 SR 降到 6.0;纯学生强制优于 50% 教师强制(9.1 vs 6.0);4 智能体共享记忆训练比 2 智能体高 4.2 SR;NavRAG 预训练比仅用 MAVLN 预训练高 3.4 SPL。冲突消解(Table 4):CFTA+CBPF 把 MAC 从 2.2 压到 0.8,代价是 323 个额外时间步。规划上界(Table 9):oracle 规划器把 SR 提到 89.1/81.0,指认规划是最大瓶颈。零样本(Table 8):训练规划器比 Qwen3.6 零样本规划高 8.0/8.0/4.0 SR,零样本 VLM 虽 TS 与 MAC 最低但那是提前放弃的假象。效率(Fig 5):每轮调度 LLM 延迟 33.52 s,远超规划 4.56 s 与仿真 2.79 s;推理仅 2.1 GB 显存,训练共 21.1 GB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MAVLN 任务成功率(oracle 调度 + 学习导航器,test-unseen) | SR | TRISS 导航器 9.3 | ETPNav(MAVLN 上训练)5.6 | +3.7 个百分点,且 ETPNav 的 CSPL/ISPL 更高说明差距来自完成子任务数而非路径效率 |
| 全流水线(LLM 调度 + 学习导航器,去中心化指令,val-unseen) | SR / SPL | Gemma4 7.0±0.9 / 2.9±0.4;Qwen3.6 7.3±0.7 / 2.8±0.3 | 随机派发 0.3 / 0.1;顺序派发 3.4 / 1.6 | SR 相对随机/顺序派发提升约 4–7 个百分点,且 CSR 差距更大(33–35 vs 7.9/23.6),说明 LLM 调度真正保住了约束 |
| 隔离调度的对比(oracle 导航 + LLM 调度,test-unseen) | SR | Qwen3.6:去中心化 92.7、集中式 90.7、集中隐式 82.1 | Gemma4:84.2、84.2、71.4 | 纯调度即可损失 8–18% 任务,隐式体制最伤,证实'推断谁做什么'是独立困难源(Table S1) |
| 规划上界(oracle 调度 + oracle 规划器,val-unseen) | SR / SPL / TS | 89.1 / 73.4 / 640 | TRISS 全系统 9.1 / 4.0 / 1588 | 差距约 80 个 SR,指认视点级规划是最大瓶颈(Table 9) |
| 零样本对比(50-episode 子集,三体制平均) | SR | 训练规划器 10.0 / 10.0 / 6.0 | Qwen3.6 零样本 VLM 规划 2.0 / 2.0 / 2.0 | +8.0 / +8.0 / +4.0 个百分点,零样本 VLM 无法执行共享拓扑上的原子指令(Table 8) |
| 智能体冲突(oracle 调度,val-unseen) | MAC | 0.8(CFTA+CBPF) | 无冲突机制 2.2;仅 CFTA 1.4 | -64%,代价是 TS 从 1230 增至 1588(Table 4) |
局限与改进
作者承认的局限贯穿第 5.2–5.4 节:其一,绝对成功率只有个位数,剩余空间分散在调度、规划、执行三处而非集中于单一模块;其二,规划被视点提议质量封顶——即便节点选择完美,oracle 规划器也只有 89.1 SR,因为预测噪声随 episode 累积,目标可能从未被提议、伪节点会污染共享记忆;其三,调度器会在执行中丢失语言约束,Fig 7 展示了在场锁被违反的案例,且给调度器喂观测上下文并不稳定奏效(Table 7);其四,有界 CBS 仍有 3.78–5.05% 的转移无法消解冲突、1.02–1.55% 几何相交,作者明确指出这在物理部署中不可接受。我的补充观察:整个工作纯仿真(Habitat 3 + HM3D 住宅),无任何真实机器人验证,33.52 s 的每轮 LLM 调度延迟在真实部署中同样致命;数据生成依赖闭源 Gemini-3,指令风格与偏差绑定于特定模型;场景域 79.6% 集中在四类家务情境,跨域泛化未知;3 m 成功半径加 MiniLM 嵌入匹配虽然经 Table S2 验证稳健,但本质上仍是粗粒度到达判定;所有消融用 oracle 调度器隔离变量,意味着论文展示的最佳配置并非端到端真实性能;MAC 度量的是时空重叠而非真实碰撞后果,无法区分代价不同的险情。
独立分析的弱点
弱点一:调度延迟与质量不成比例。LLM 调度每轮 33.52 s,是导航规划(4.56 s)的 7 倍多,而 Table S1 显示 Qwen3.6 与 Gemma4 在学习导航器下的差距被导航瓶颈掩盖——调度能力尚未转化为端到端收益,却已付出数量级的延迟。改进方向:把调度蒸馏/微调到小模型,或用约束求解器处理可行性、LLM 只做语义分解。弱点二:规划器被视点提议封顶。waypoint predictor 提不出目标视点时任务必败,且伪节点污染是全局性的。改进方向:学习鲁棒建图模块(不确定性加权的节点合并),或转向不依赖预测视点、保留记忆协调的规划范式(如可学习的前沿探索)。弱点三:约束跟踪完全依赖 LLM 上下文窗口的'记性',长任务中在场锁被重新派发违反(Fig 7)。改进方向:用显式状态机或符号验证器把资源约束做成硬性门控,LLM 只在可行动作集合内选择。弱点四:训练用 oracle 原子指令、推理用 LLM 调度,存在训练-推理错配,LLM 措辞变化直接冲击导航器。改进方向:在训练循环中加入 LLM 生成的指令变体做数据增强,或对调度-导航做联合强化学习。弱点五:CBPF 残余冲突 3.78–5.05% 无法消解且未与几何检查联动。改进方向:执行期在线重规划加几何验证,冲突时降速避让而非硬搜索。
未来方向
作者明确指出的方向有四条:一是鲁棒建图模块或'不依赖预测视点但保留记忆式协调'的新规划范式,冲破 89.1 SR 的规划天花板;二是更强的冲突搜索与执行期几何检查,把残余冲突压到物理部署可接受的水平;三是把团队空间状态接入调度、逼近最优分配的观测接地调度器——尽管 Table 7 显示朴素的观测引导无效,说明需要的是选择性、任务相关的接地而非全量上下文;四是弥合零样本 VLM 与训练规划器之间的差距(Table 8)。基于本文成果还可自然延伸:把约束语言推广到软约束、时间窗与容量约束(MAVLN 已含 8 类场景域的长尾,如儿童看护天然适合连续在场约束);用小模型蒸馏或微调把 33.52 s 的调度延迟压到可交互水平;学习式冲突消解(用代价感知的回报替代 CBS 的词典序分支);以及在真实多机器人系统上验证共享拓扑记忆的通信带宽与延迟约束,目前所有协调都假设了零延迟的全知共享内存,这在去中心化部署中并不成立。
复现评估
复现友好度较高。基准、平台与代码均已随论文发布(项目页 xyz9911.github.io/mavln):11,724 个 episode 按 128/7/10 场景划分为训练、val-unseen、test-unseen,场景互斥防泄漏;评测语义有完整的离散事件评估器伪代码(附录 Algorithm S1)、可导航锚点定义(3 m 半径、0.5 m 去重)和指标公式,且 Table S2 验证了嵌入匹配与 LLM 标注匹配结果一致(差 ±0.3 内),打分可独立复核。算力门槛低:规划器训练单张 A100、共 21.1 GB 显存,预训练 20 万步加模仿 3 万步;推理约 2.1 GB,调度用本地 OpenAI 兼容端点跑 Qwen3.6-27b(FP8)或 Gemma4-31b(W4A16),所有 LLM 相关结果为 3 次独立运行平均并报告标准差;全部超参数集中在附录 Table S6,生成与调度的 prompt 模板在 Fig S7–S11 完整公开。主要障碍有两处:一是数据再生成绑定闭源 Gemini-3 系列,模型版本漂移会影响流水线产出的分布;二是 MAVLN 训练集依赖 NavRAG 预训练数据且需预先剔除重叠场景,数据准备管线较长。总体难度评级为中等偏低——权重、指标、平台齐备,熟悉 Habitat 与 VLN-CE 的团队预计一至两周可复现主表。
论文图表
对照两条既有范式与本文任务:多智能体具身导航(简单目标、经验未复用、无冲突度量)与 LLM 多智能体规划(任务 DAG 丰富但依赖 oracle 技能与预建地图)。本文任务把一个任务交给未知环境中的 VLN 智能体团队,要求在依赖与资源约束下动态调度、共享经验并把同时段意图变成无冲突路径。
一图看懂论文的问题定位与三大挑战(动态调度、经验共享、冲突消解),是理解全文动机的入口。
三类失败模式:(a) 调度器违反在场锁——在被锁住的智能体解锁前重新派发任务;(b) 规划器在语义相似的干扰物处停止,目标书桌未被充分探索且在候选区反复绕圈;(c) 控制器在障碍处执行失败绕圈,以及不同楼层视点间的错误连边误导后续导航。
失败案例直指调度、规划、执行三层的具体病灶,为理解消融数字背后的机理与改进方向提供直观依据。