交错强化学习驱动的统一模型原生反思学习 Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning
用整轨迹强化学习让统一多模态模型学会检查、诊断并修复自己生成的图像
前置知识
统一多模态模型(UMM)
在同一网络中同时具备视觉理解与图像生成能力的模型。本文基座 BAGEL 是 28 层混合 Transformer(MoT),理解专家与生成专家共享注意力:模型渲染完一张图后可以再“看”这张图,为自检与自修复提供了结构基础。
本文全部方法建立在“诊断文本与渲染图像出自同一套参数”之上,唯有 UMM 才能用一个结果奖励同时更新诊断与渲染两个角色。
GRPO 与组相对优势
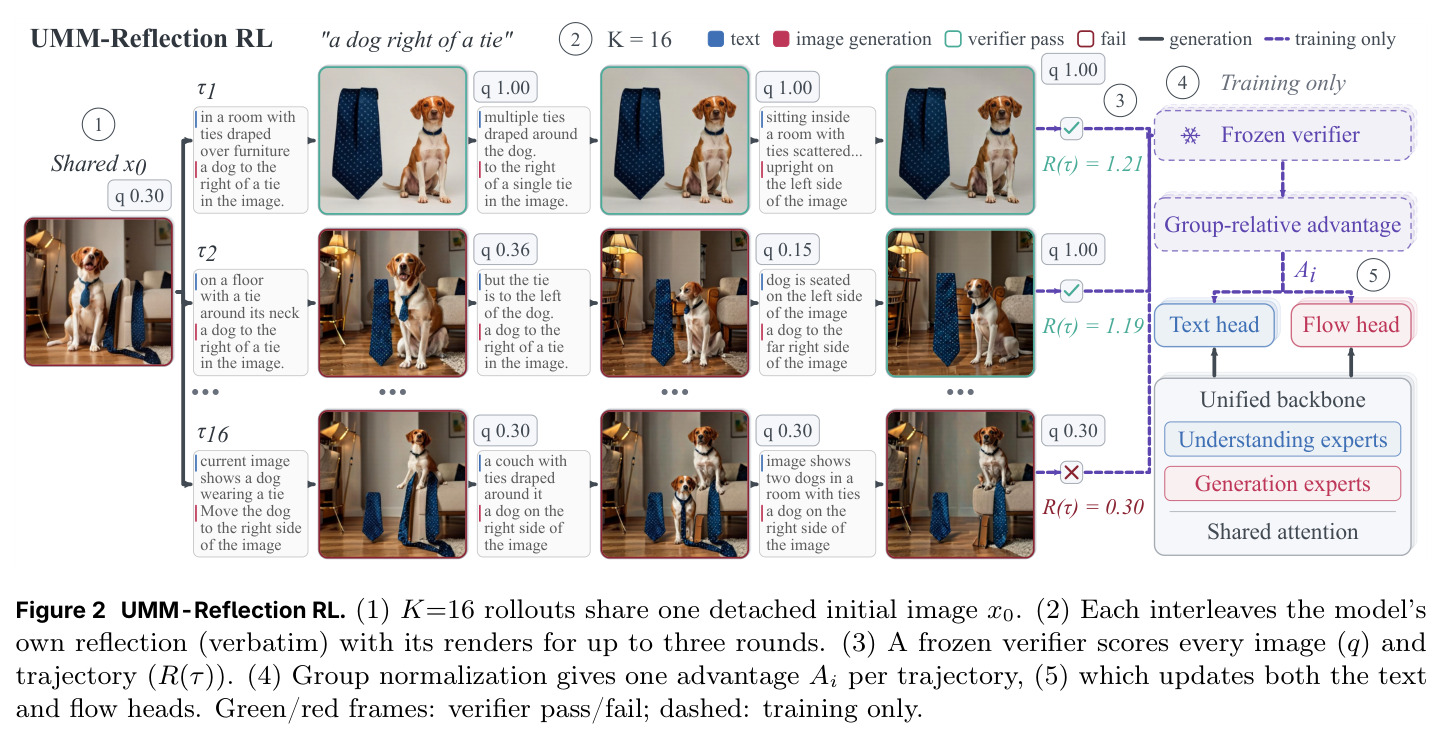
Group-Relative Policy Optimization:对同一输入采样 K 条轨迹,用组内归一化 $A_i=(R_i-\mu_R)/\max(\sigma_R,0.1)$ 充当优势,免去 value 网络。本文进一步让 K 条兄弟轨迹从同一张初始图像出发,使组内比较反映反思策略优劣而非初始生成的运气。
整轨迹 RL 的优势估计完全沿用 GRPO 框架,理解它是读懂共享根采样与轨迹级优势设计的前提。
流匹配(Flow Matching)生成
连续扩散类生成范式:模型学习速度场,把噪声沿概率流输运到图像分布。Flow-GRPO 用 SDE 采样器在去噪链中注入随机性,从而能对渲染转移计算策略梯度和闭式 KL。本文每个活跃修复只训练两个连续随机转移。
论文的“flow head”与跨转移信用分配都基于此,公式中的似然比 $\rho$ 与 KL 惩罚均定义在 SDE 转移之上。
自我修正循环与 SCoRe 教训
模型对自身输出执行“检查-诊断-修改”多轮循环。语言模型研究(Self-Refine、SCoRe)表明:无外部反馈的纯提示自纠甚至可能降精度;仅靠离线纠正轨迹的 SFT 只能给冷启动,必须在线多轮 RL 才能可靠自我修正。
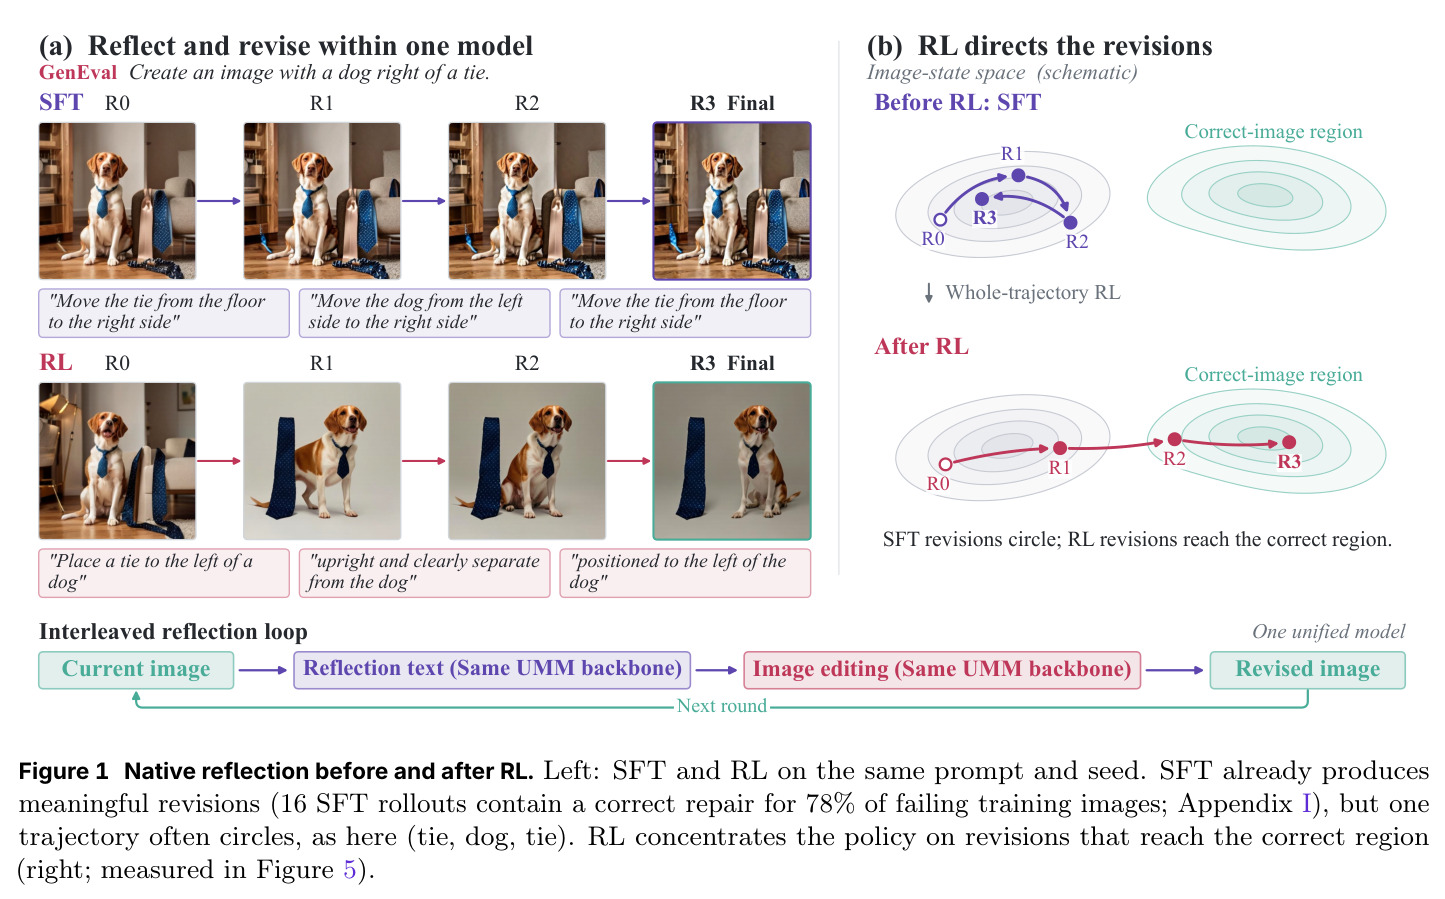
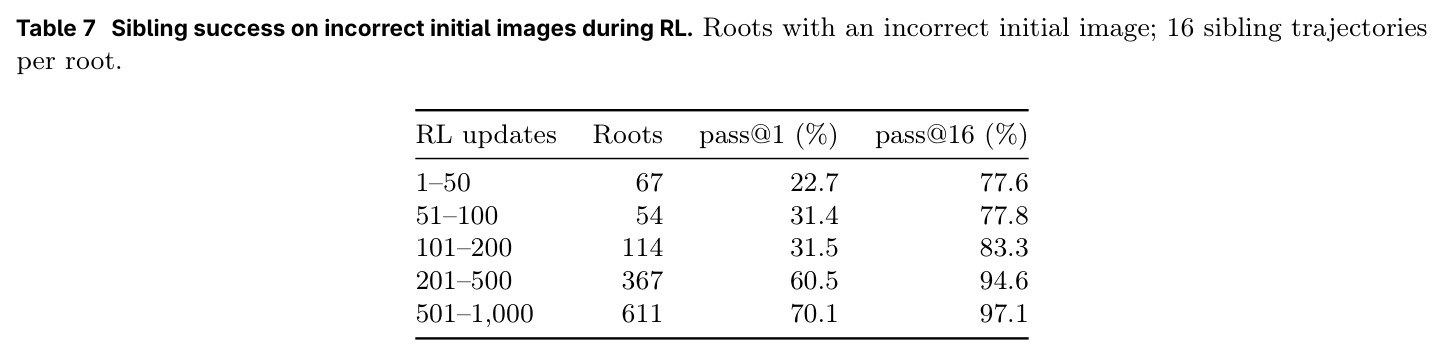
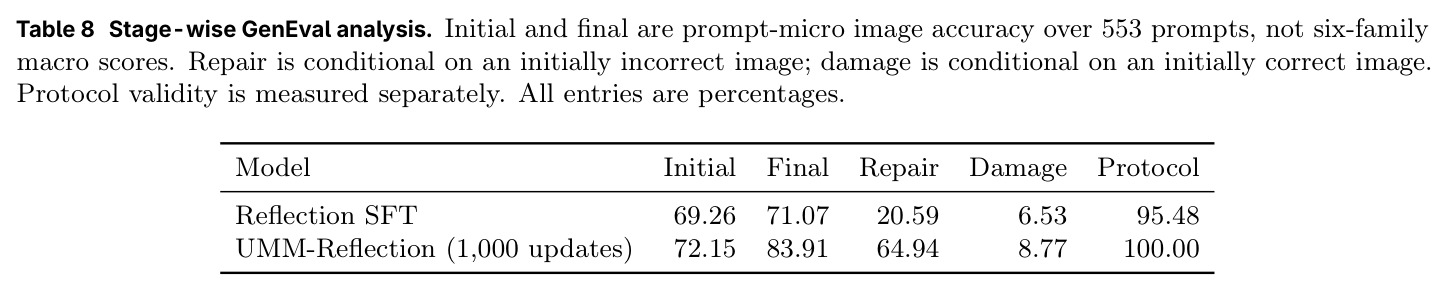
本文把这节课搬到视觉领域并定量验证:SFT 轨迹中 78% 的失败图像在 16 条 rollout 里存在正确修复,但单条轨迹只兑现 20.59%。
GenEval 等组合性评测基准
GenEval 用目标检测器对 553 条 prompt 按六类组合要求(单物体、双物体、计数、颜色、位置、属性绑定)给 0/1 判定;WISE 考世界知识,T2I-CompBench++ 考八类组合能力,OneIG-Bench 考图文对齐。
主结果、奖励设计(分级得分 $q$ 严格沿用官方阈值)与迁移实验全部围绕这些基准展开,不懂判定方式就读不懂奖励构造。
整轨迹信用分配
反思的价值要到它触发的图像渲染出来之后才可知,甚至要再等后续若干轮,因此信用必须跨轮并同时流向诊断 token 与渲染转移。若每轮分支做组内估计需 $K^N$ 条 rollout(3 轮 16 分支即 4096 条),PPO 式 critic 又要训练多模态 value 模型。
这是论文拒绝逐轮信用、选择单一轨迹级优势的直接原因,是方法合理性的核心论证。
研究动机
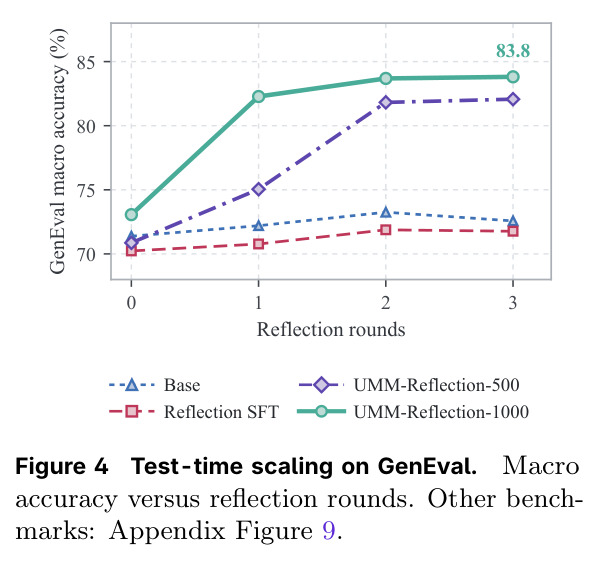
随着指令日益组合化(多物体、属性绑定、空间关系、精确计数),单次文生图经常出错且自己无法察觉。现有三条路线各有缺陷:其一,T2I-R1、ReasonGen-R1、UniRL 等把 RL 用在单次渲染上,模型从不修改自己已渲染的图像;其二,Idea2Img、GenArtist、SLD 等管线外挂一个只看像素的 critic 指挥独立渲染器,两者从不联合优化,推理时还必须在线挂载 critic;其三,Thinking with Generated Images、MINT 等用模仿学习合成多轮轨迹,只提供冷启动——论文量化后发现问题:SFT 模型 95% 的轨迹符合协议、78% 的失败图像在 16 条 rollout 中存在正确修复,但单条轨迹只修复 20.59% 的初始错误图像,且三轮反思只给 GenEval 带来约 +2 分。
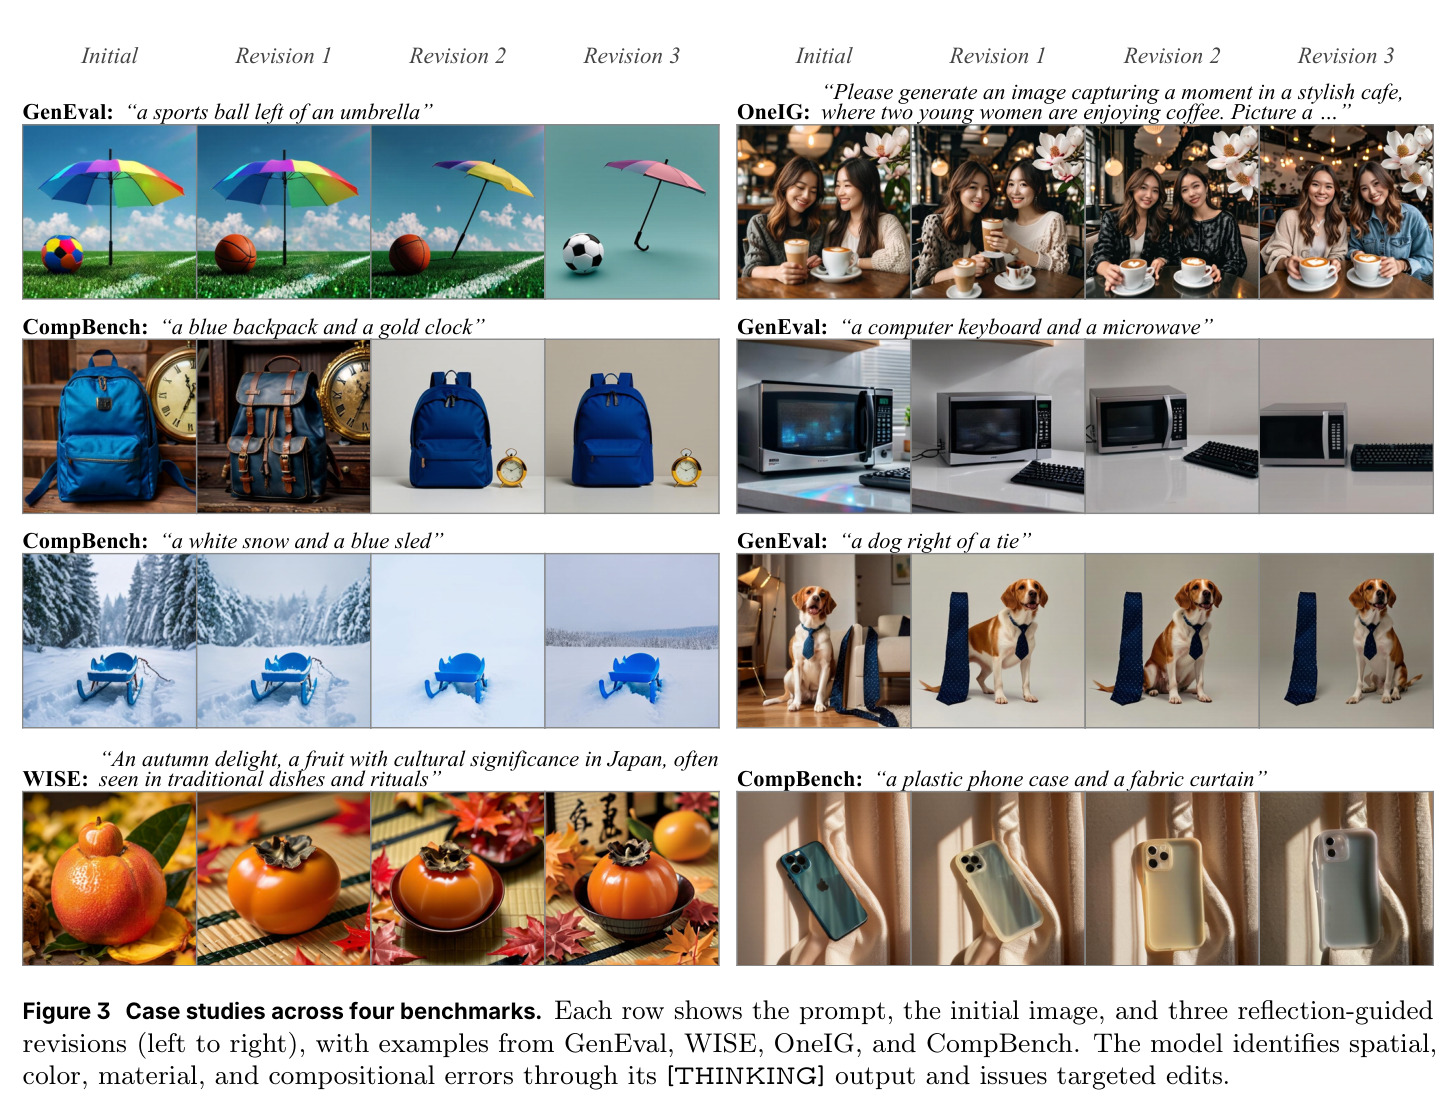
本文的目标是让统一多模态模型原生地(native reflection)执行“检查-诊断-修改”循环:反思文本与图像编辑出自同一套参数,训练时用强化学习优化完整的反思轨迹,让每次反思为其触发的视觉改进负责,而不是仅仅模仿示范轨迹。具体目标可拆成四点:其一,在 SFT 冷启动之上把“初始错误图像被单条轨迹修复”的条件修复率从 20.59% 大幅提高;其二,保证增益来自反思轮而非首轮生成——Base、SFT、RL 的首轮单发精度都应停在 70–73;其三,推理时不依赖任何外部验证器或 critic,训练时的 frozen verifier 只属于训练管线;其四,在 GenEval 上训练的能力应迁移到从未参与训练的 WISE、OneIG-Bench、T2I-CompBench++,证明学到的是可泛化的修复行为。
与已有工作不同的是,作者的独特切入是把“反思与渲染同参数”变成训练优势:诊断由 text head 写出、修正由 flow head 渲染,于是一个轨迹级结果优势就能同时传到两个角色,渲染器永远在自己实际收到的指令上训练——这既区别于单轮编辑(无需外部指令),也区别于外挂 critic 管线(无需推理时验证器)。第二个洞察承接 SCoRe:模仿给出格式但不给出高成功率修复路径,必须在模型自身 rollout 上做在线 RL。第三是工程上的省法:所有 K 条兄弟轨迹共享同一张 detached 初始图像,组相对优势比较的是反思策略而非“第一次抽卡的运气”,同时避开每轮分支所需的 $K^N$ rollout(3 轮即 4096 条)或训练 value 模型的数据成本。
核心方法
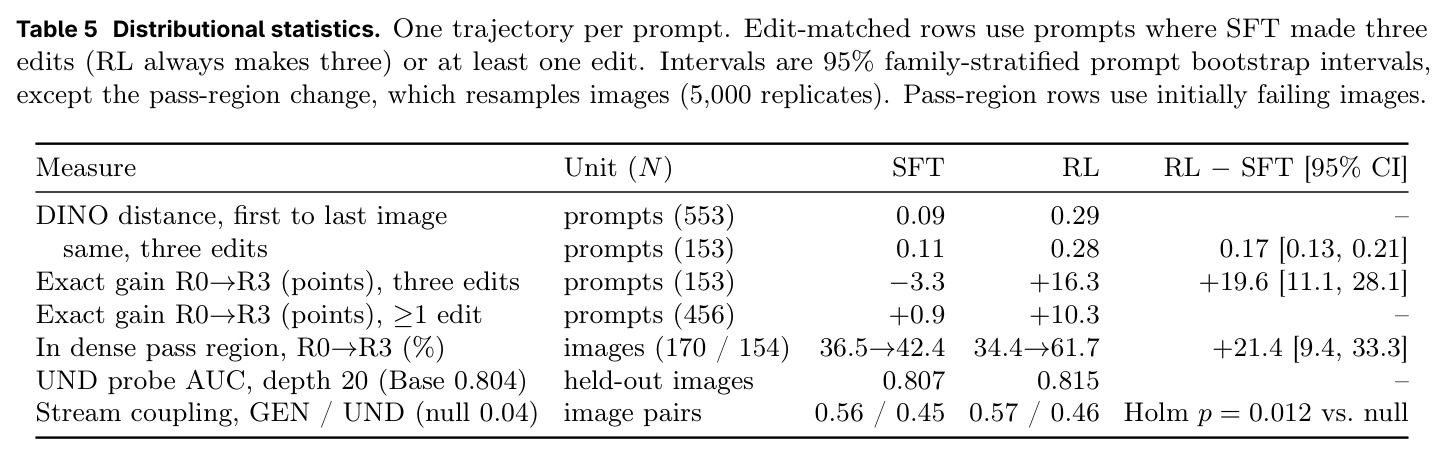
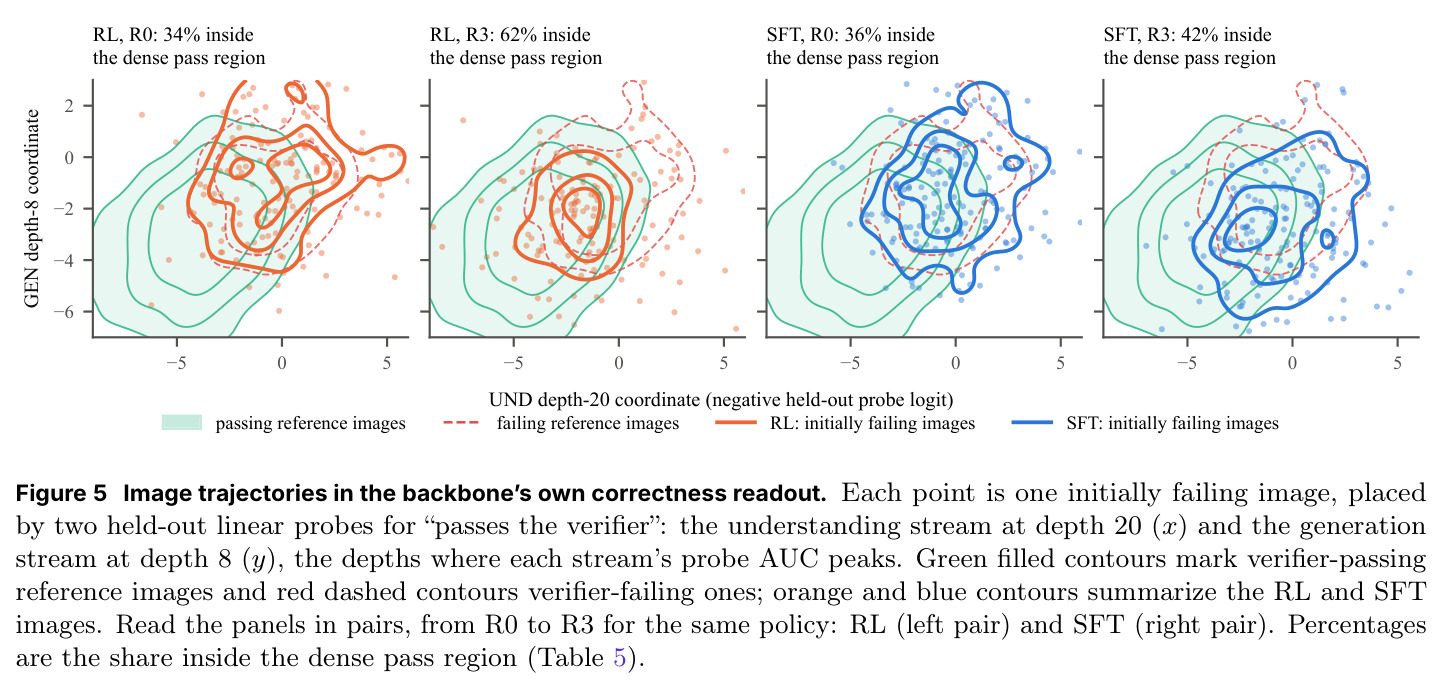
直觉上,模型其实已经“知道”自己的图对不对:在理解流第 20 层做线性探测,判断“是否通过验证器”的 held-out AUC 达 0.80,且 RL 前后几乎不变——缺的不是感知而是可靠地行动。方法分两阶段。第一阶段 SFT 冷启动:用外部模型构造的多轮轨迹教会交错协议——每轮观察请求、历史与当前图像 $x_t$,输出含 [THINKING]/[ACTION]/[EDIT] 的结构化反思 $u_t$,edit 动作携带自然语言修正指令 $e_t$ 并由同一模型渲染 $x_{t+1}\sim\pi^\text{flow}_\theta(\cdot|c,x_t,e_t)$,done 结束,最多 3 轮。第二阶段整轨迹 RL:K=16 条轨迹共享同一初始根,frozen verifier 给每张图打分级分 $q_t\in[0,1]$,按 $R(\tau)=q_T+\alpha\sum_t[\Delta_t]^+ + \beta S_\text{multi}-\lambda\sum_t[-\Delta_t]^+ - p\cdot\mathbb{1}[\text{premature done}]$ 计奖励,组归一化得到每条轨迹一个优势 $A_i$,同时更新文本与流两个通道。
核心创新是“一个轨迹级优势同时驱动两个 head”的联合信用分配。与已有方法的本质区别:T2I-R1 类只优化渲染、UniRL 只把理解当奖励、外挂 critic 管线让两个模型互不优化,而这里反思与修正共享参数,诊断 token 和它触发的流转移拿同一个 $A_i$——反思的价值由它实际渲染出的图像决定,渲染器也在自己真实收到的指令上学习。配合共享根采样(16 条兄弟轨迹从同一像素出发),组内比较纯粹反映反思策略优劣;奖励中的进步项 $[\Delta_t]^+$ 与多轮改进项 $S_\text{multi}=\sum_t[\Delta_t]^+-\max\{[\Delta_t]^+\}$ 刻意奖励持续多轮变好、惩罚改坏与过早 done。每轮分支的组估计需要 $16^3=4096$ 条 rollout,PPO 式 critic 需要训练多模态 value 模型,本设计两者皆免,保持 GRPO 的 K 样本成本。
方法步骤详情
完整流程四步。第一步数据构造:GPT-5.5 充当 critic,把请求转成可验证约束、检查图像、写结构化反思并给出原子编辑指令或 done 判定;Qwen-Image 负责初始渲染、Qwen-Image-Edit 执行编辑;BAGEL 自身不参与,避免把自身失败模式蒸馏回监督。共接受 29,529 条轨迹(一次成型 9,000、自然修复 8,645、计划递进 11,884),prompt 来自 Puffin-4M、Poster100K、OmniEdit、AnyEdit、GEdit-Bench,与所有评测基准无重叠。第二步 SFT:$\mathcal{L}_\text{SFT}=\mathcal{L}_\text{AR}+\lambda_\text{img}\mathcal{L}_\text{FM}$,分解为 167,363 行(控制器/图像转移/验证器三种视图),冻结 ViT、VAE 与词表投影,训一个 epoch。第三步整轨迹 RL:3,000 prompt 池、每更新 2 根 × K=16、20 步训练去噪、每个活跃修复取 2 个连续 SDE 转移;文本/流学习率 $5\times10^{-6}$、对 SFT 参考的 KL 系数 $10^{-4}$、clip 系数 0.2/0.1;frozen verifier 打分且 fail-closed(分级永不改变通过/失败判定)。第四步推理只跑统一模型,验证器不在线。RL 用 16 张 H100 训 1,000 更新约 33 小时。
技术新颖性
技术新颖性有三层。第一,问题形式化新:把“原生反思”定义为同一统一模型内的多轮检查-诊断-修改,并指出与单轮编辑和外挂 critic 的本质差异在于信用必须跨轮、跨角色流动。第二,算法设计新:整轨迹 RL 用单一结果优势联合优化文本与流通道(两通道各自 clip $\epsilon=0.2/0.1$、共享 $A_i$、不分别归一化),流转移用 Flow-GRPO 的 SDE 采样器;奖励只在失败区做分级($q=\min(2f,\,0.5^-)$,通过即 1)并配 fail-closed 规则,解决了二元评分下五个族 $\Delta_t=0$、进步项失效的问题;畸形轨迹还 receives 有界负修正 $A_i\leftarrow\max(\min(A_i,0)-0.5,-1)$。第三,实证发现新:作者证明 RL 不是创造新能力而是选择既有修复路径——RL 开始时 78% 的根在 16 条 rollout 中已含正确修复而 pass@1 仅 23%,训练后 pass@1 升至 70%,与 SCoRe 在语言模型上的预测在视觉域首次定量对应。
实验结果
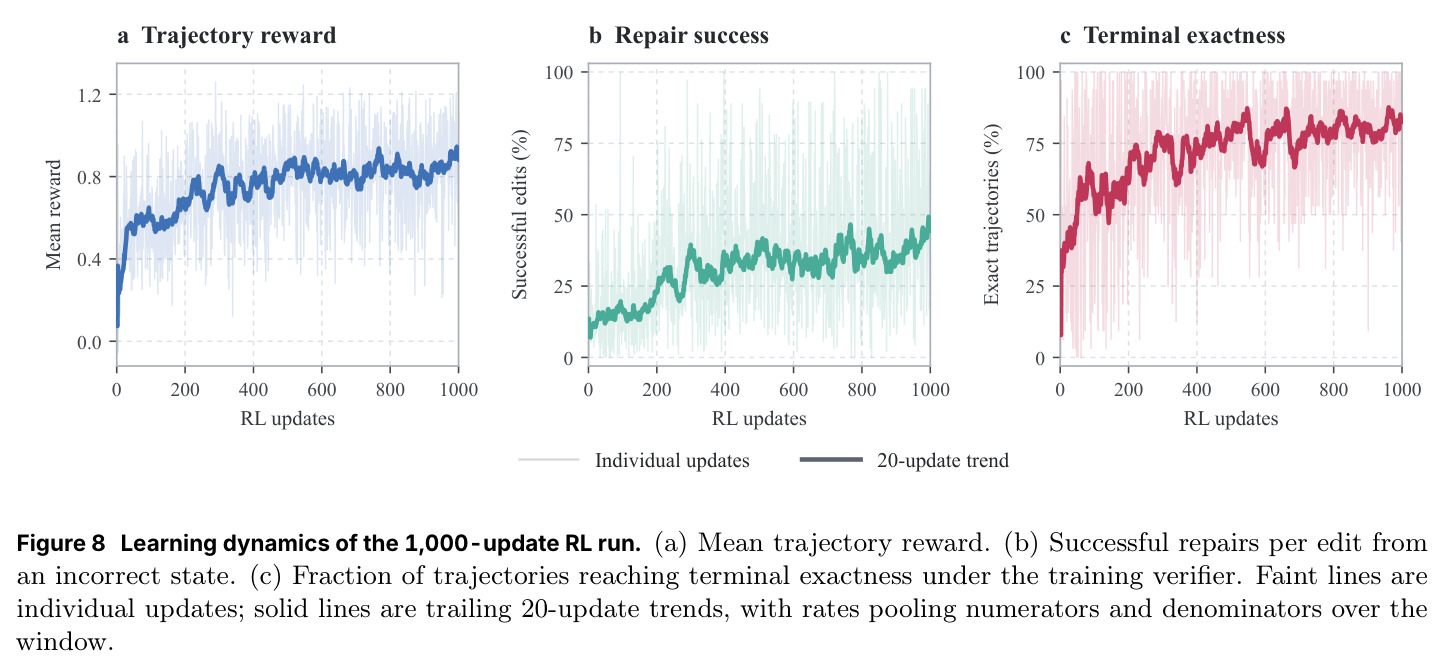
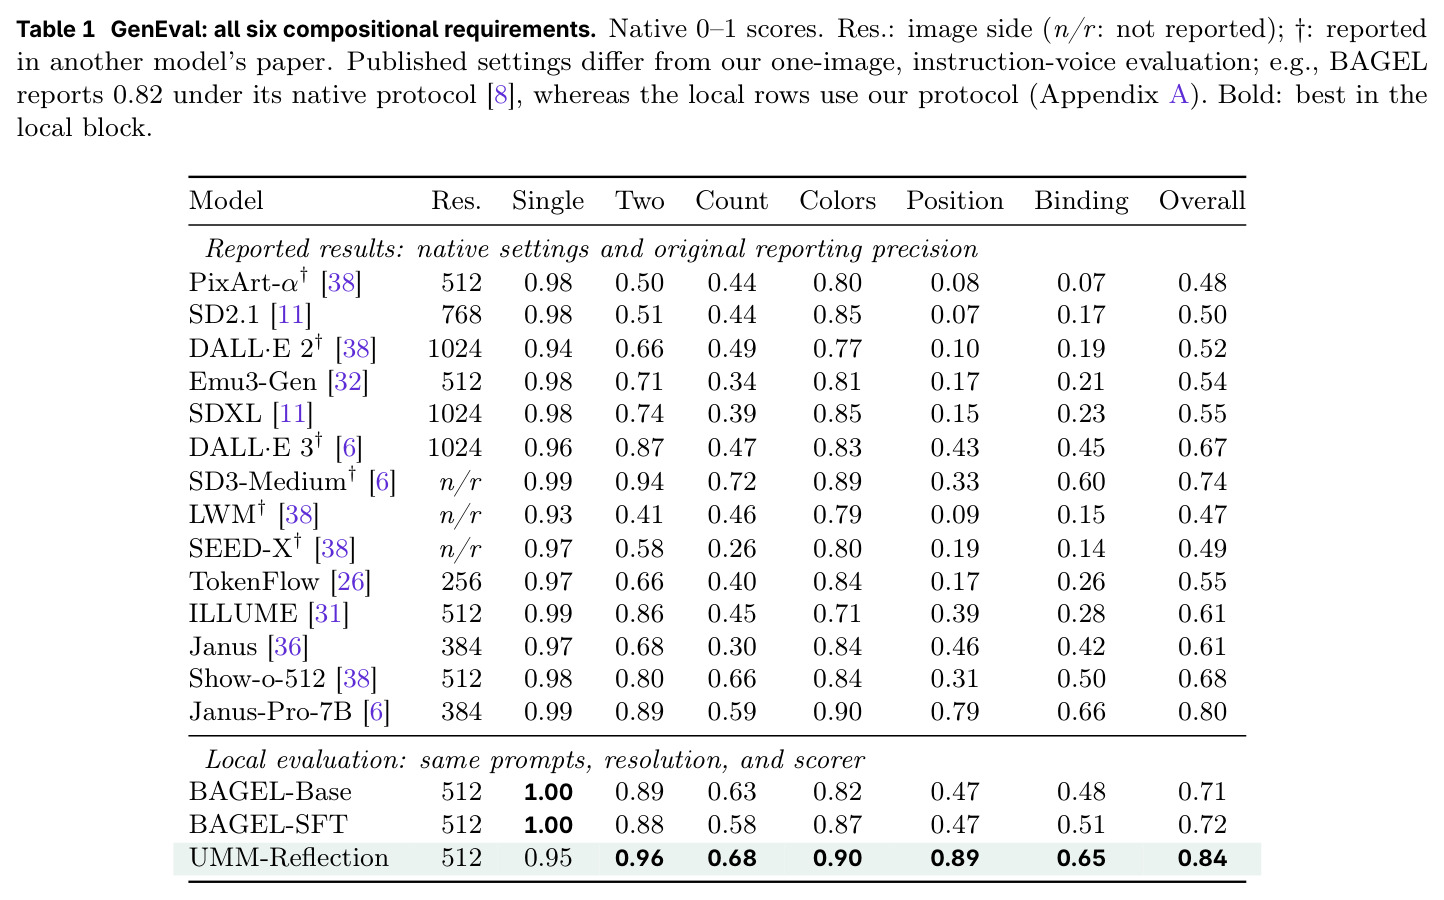
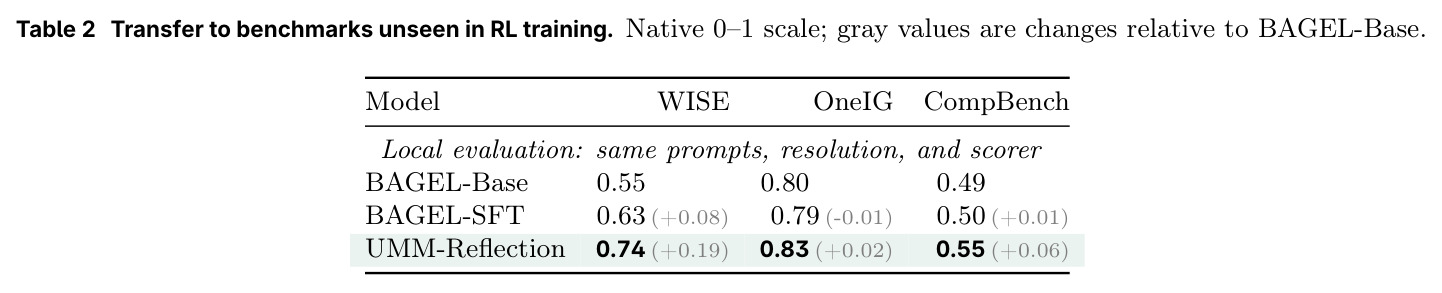
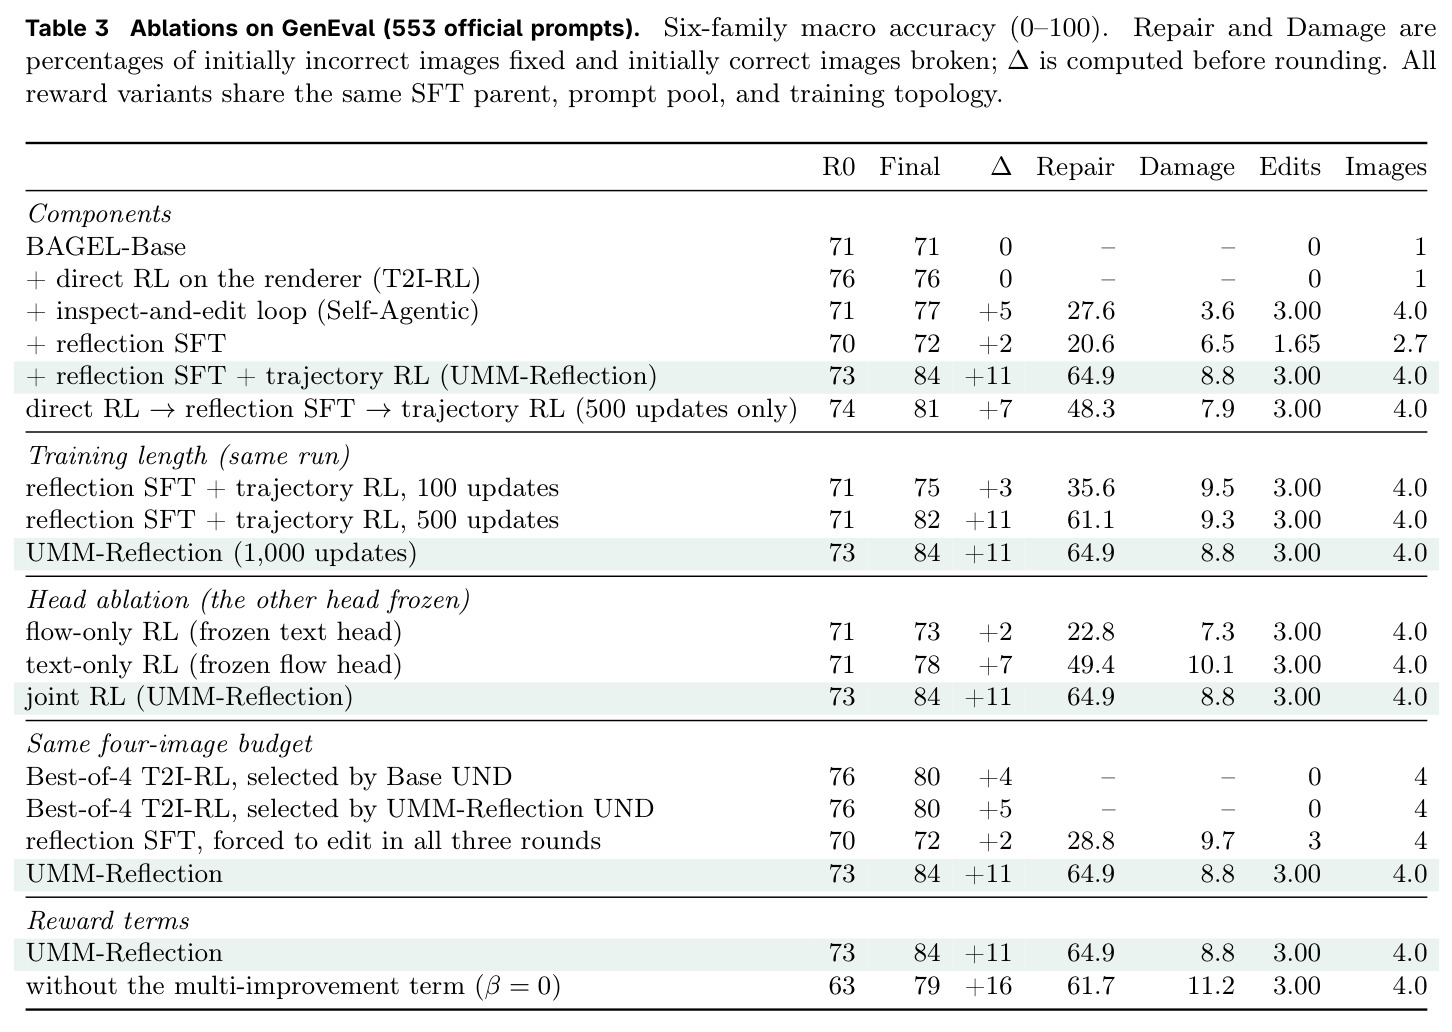
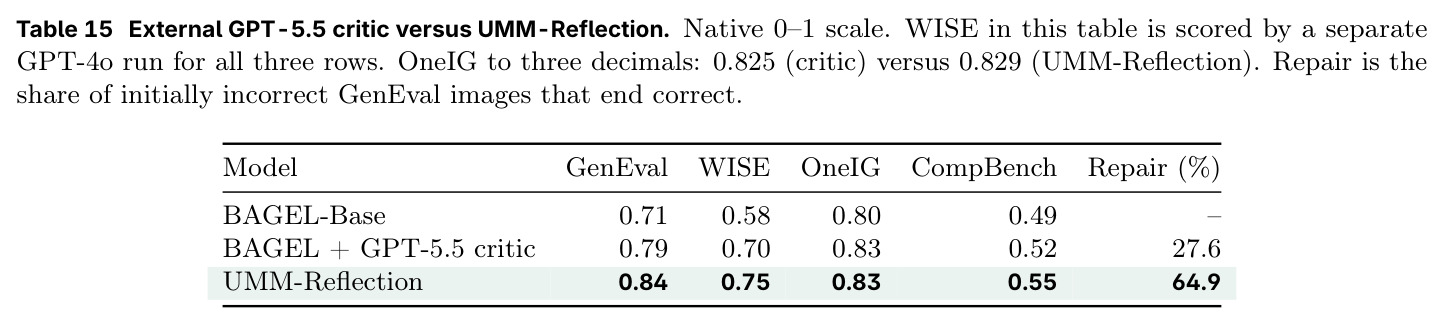
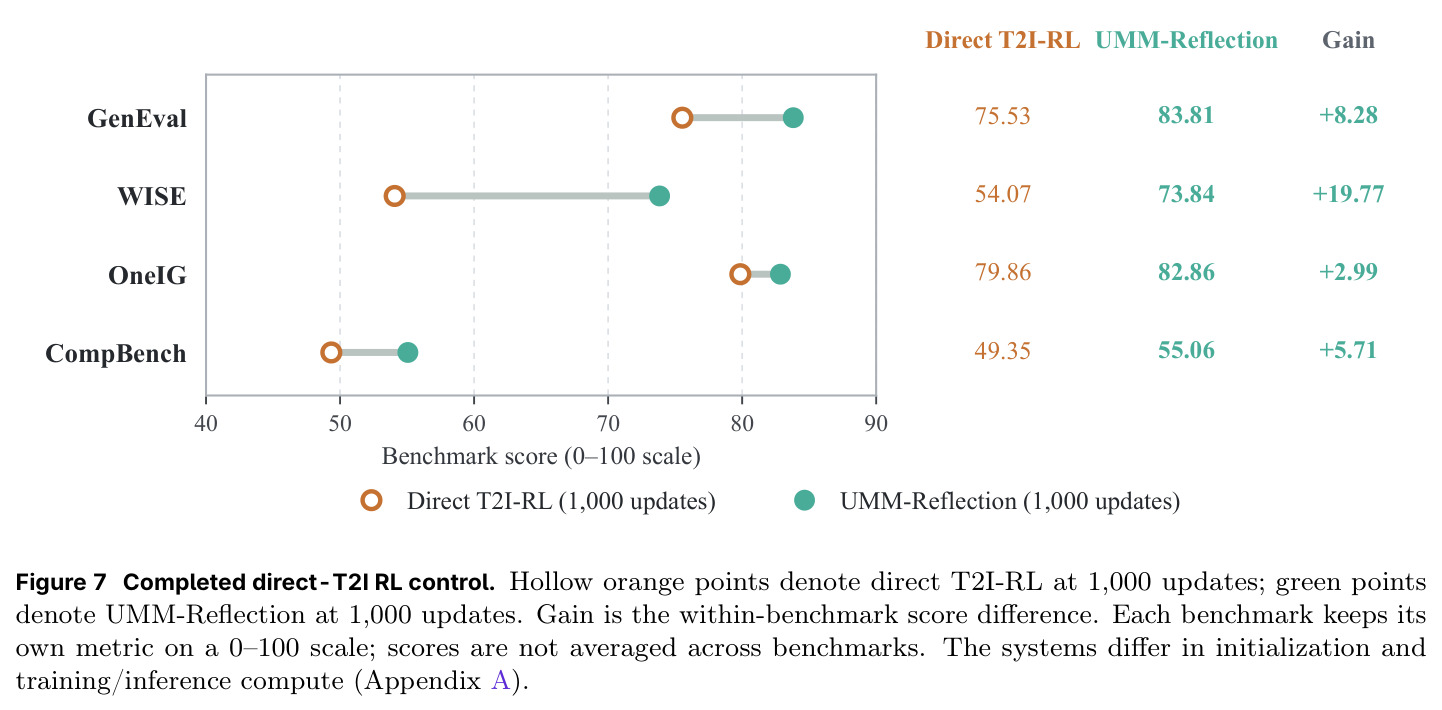
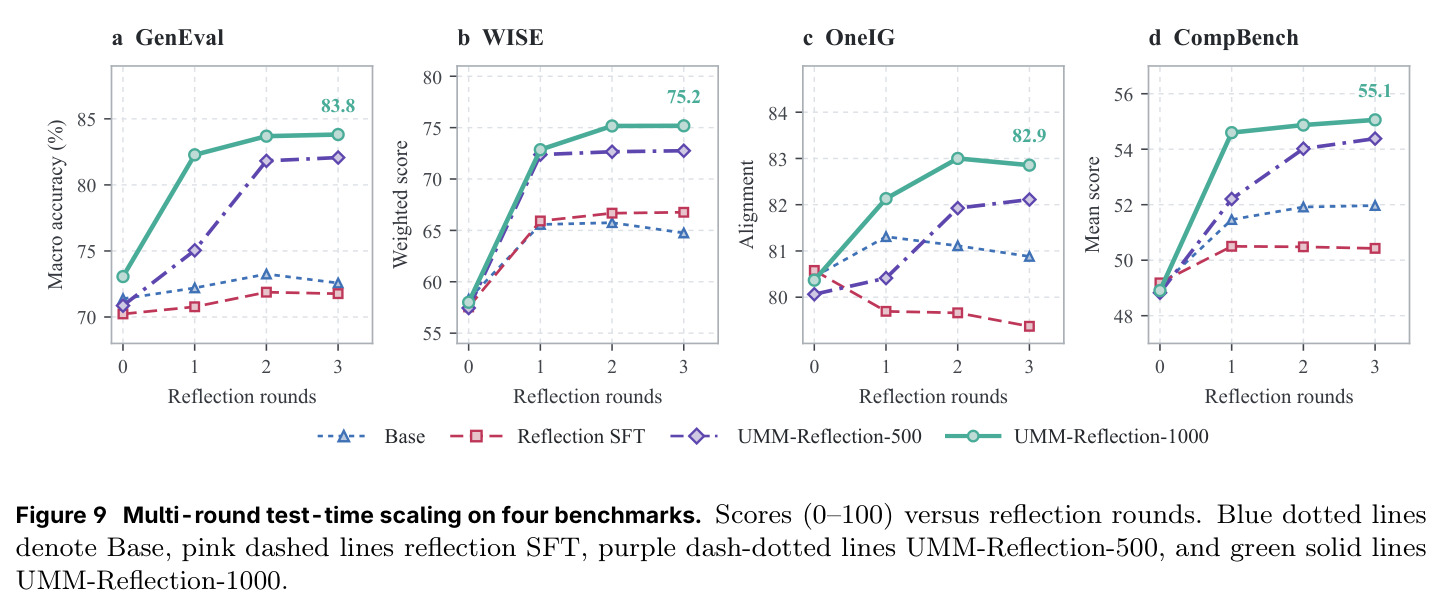
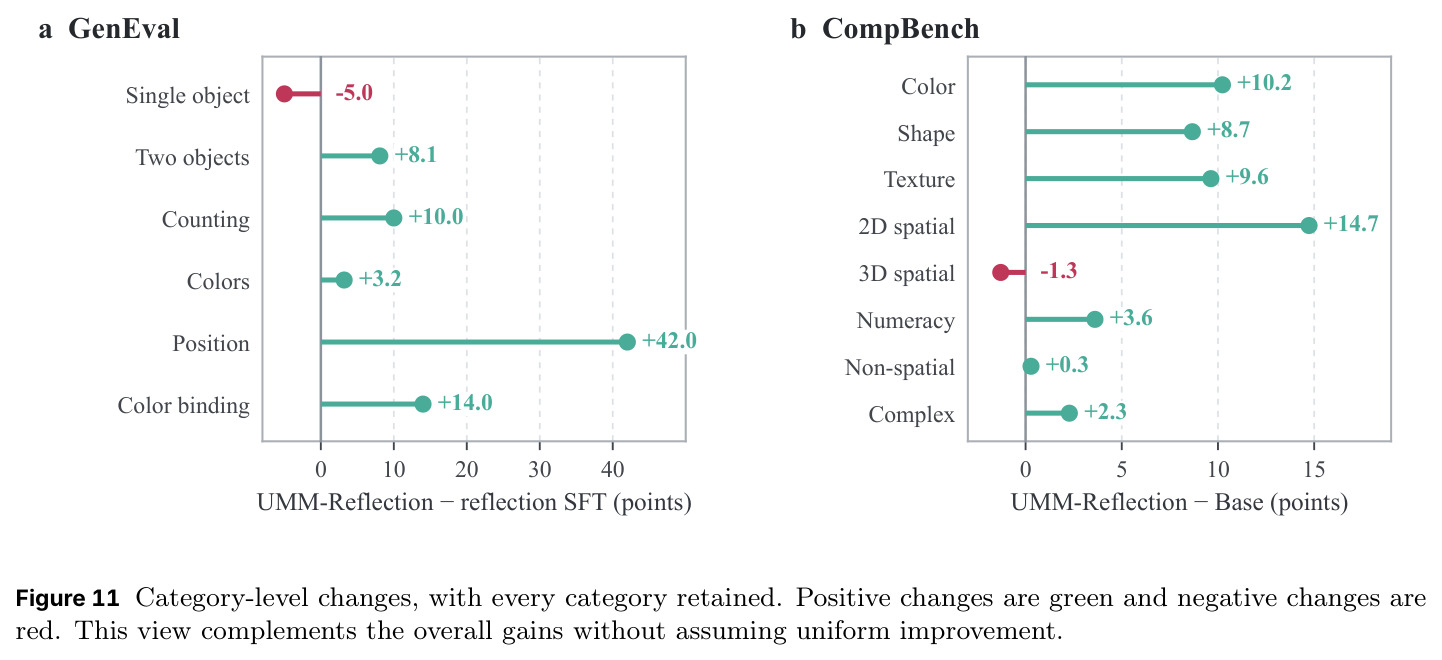
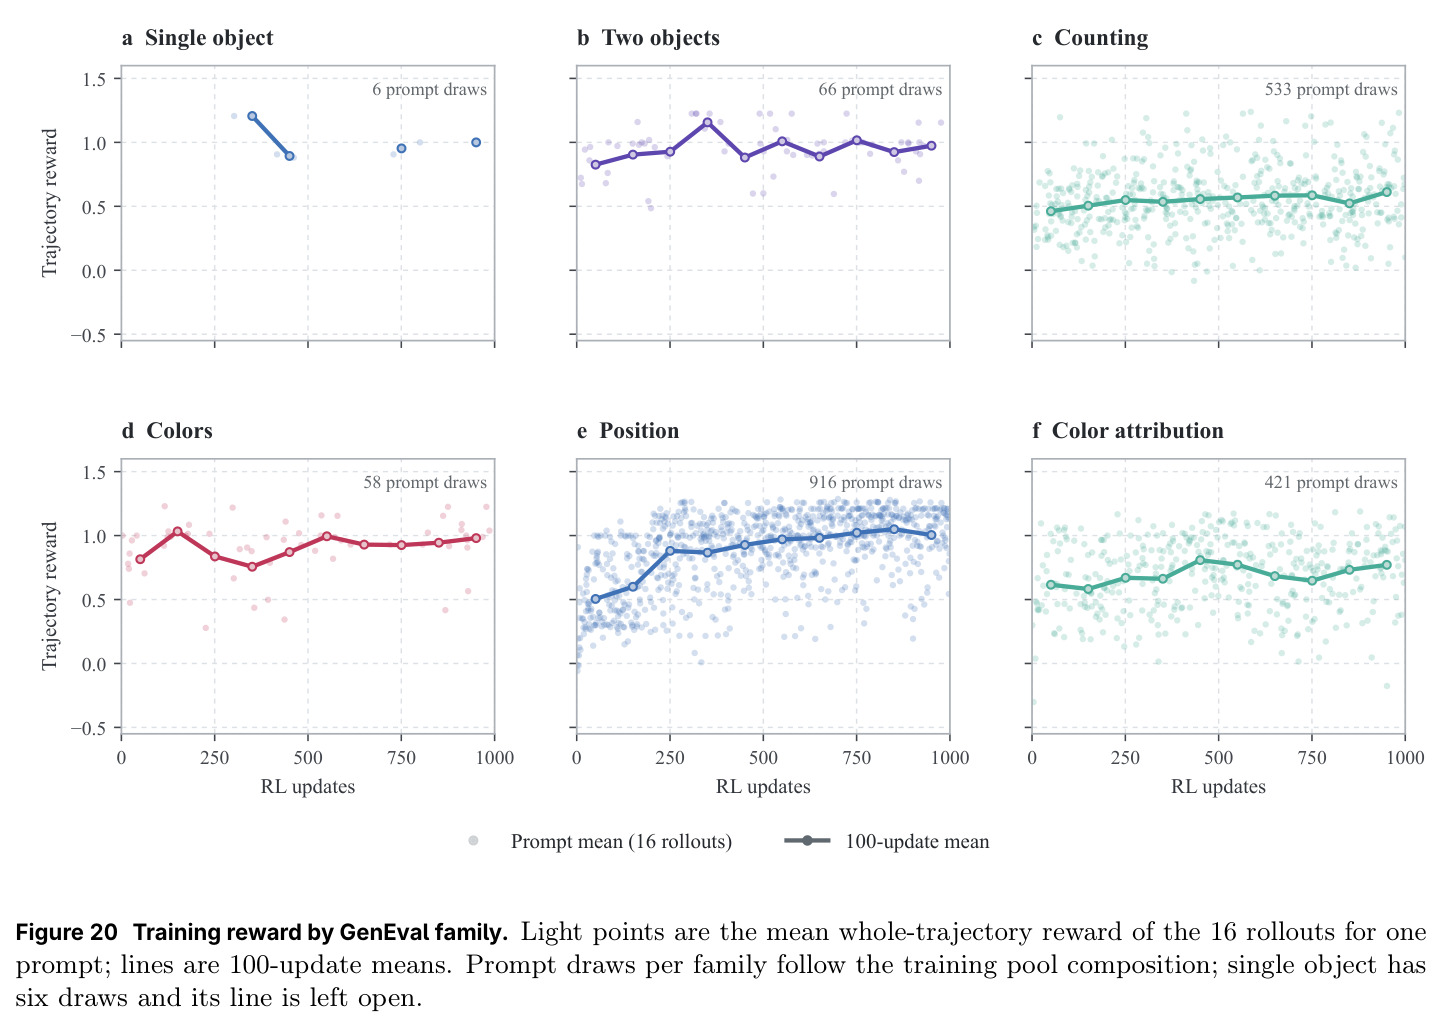
主结果集中在四组实验。域内:UMM-Reflection 在 GenEval 全部 553 条官方 prompt 上达 0.84,对 BAGEL-Base 0.71 与 SFT 0.72 提升 12.05 分,增益集中在组合修复族——position +42 分(0.47→0.89)、属性绑定 +14、计数 +10;配对 McNemar 显示 RL 对 SFT 109 胜 38 负($p<10^{-8}$),而初始图像仅 48:32($p=0.09$),证明增益来自反思轮。迁移:同一 checkpoint 在三个未见基准全面领先 SFT——WISE 0.74(+10.97)、OneIG 0.83(+3.48)、CompBench 0.55(+4.63)。消融:直接对渲染器做 Flow-GRPO(T2I-RL)单发从 71 升到 76 但不迁移(WISE 54,低于 Base 的 55);冻结流头只训文本得 78(修复率 49.4%)、冻结文本头只训流只得 73(22.8%),联合训练 84(64.9%);同 4 图预算下 Best-of-4 只有 80;去掉多轮改进项($\beta=0$)会把初始图从 73 拖到 63。机制:条件修复率从 20.59% 升至 64.94%,探测 AUC 维持 0.80–0.82,失败图像落入“通过区”的比例 RL 三轮内从 34% 升至 62%(SFT 仅 36%→42%);指令互换实验中 RL 写的指令单独修复 48.4%,高于规则化指令的 27.6%;在 62 条 Base 四次独立采样全败的 prompt 上,RL 反思挽回 60%(SFT 仅 12%)。增益大多在 500 更新内到位(100/200/500/1000 更新为 75/79/82/84)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GenEval(组合文生图,553 prompts) | 六族宏平均准确率(0–1) | 0.84 | BAGEL-SFT 0.72 / BAGEL-Base 0.71(Janus-Pro-7B 公开成绩 0.80) | +12.05 分(对 SFT),position 单族 +42 分 |
| WISE(世界知识,1,000 prompts) | 加权总分(0–1) | 0.74 | SFT 0.63 / Base 0.55 | +10.97(对 SFT)/ +19(对 Base) |
| OneIG-Bench(对齐,695 prompts) | 问题依赖对齐分(0–1) | 0.83 | SFT 0.79 / Base 0.80 | +3.48(对 SFT) |
| T2I-CompBench++(组合,2,400 prompts) | 八类平均分(0–1) | 0.55 | SFT 0.50 / Base 0.49 | +4.63(对 SFT),其中 2D spatial +14.7 |
| 条件修复率(GenEval 初始错误图像) | 被单条轨迹修复的比例 | 64.94% | SFT 20.59% | +44.35 个百分点(约 3 倍) |
| 外挂 GPT-5.5 critic 管线(GenEval) | GenEval 总分 / 修复率 | 0.84 / 64.9% | BAGEL + GPT-5.5 critic 0.79 / 27.6% | +5 分,且推理时无需任何外部模型 |
局限与改进
作者承认并实测的局限:计数族训练奖励在 1,000 更新内始终平坦,GenEval 计数精度停在 67.5 分——现有加/删/重色/重位类编辑无法可靠改变物体数量;修复过程有 8.8% 的 damage(把原本正确的图改坏,SFT 为 6.5%),单物体族甚至从 100 掉到 95;CompBench 的 3D 空间类 −1.3。我自己的观察:其一,失败案例暴露反思链的脆弱性——模型把四只长颈鹿数成三只并反复“加一只”最终变成五只,把“世界第二大经济体”答成美国,错误诊断会在轮间自我强化,而奖励无法纠正感知与知识错误;其二,奖励完全依赖 GenEval 式检测器,开放域缺乏这种 frozen verifier,OneIG 仅 +3.48 提示风格类泛化有限;其三,RL prompt 池仅 3,000 条 GenEval 风格 prompt、6 个族,训练域窄;其四,512×512 训练/评测分辨率低于 BAGEL 原生 1024,最多 3 轮修复,且 BAGEL 不原生支持交错生成、需外部 controller 逐轮喂入,并非端到端实现。
独立分析的弱点
独立分析的弱点与改进方向:其一,计数能力缺失(67.5 分不动、训练奖励平坦),可设计显式 count-aware 编辑原语或在奖励中加入数量梯度更密的整形项;其二,自我诊断错误会连锁放大(长颈鹿从 4 数成 3 再加到 5),而探测 AUC 只有 0.80,可把正确性 readout 作为辅助自监督信号,或在反思中引入多次自一致性投票再下编辑结论;其三,damage 率 8.8% 且随轮数累积,可在奖励中按图像已正确与否做非对称惩罚,或引入“编辑前验证”动作让模型先确认再动手;其四,验证器依赖——检测器给不了美学与风格信号,可混合可验证奖励与学习型偏好奖励;其五,3 轮上限与过早停止风险(附录 P 显示给 correct-done 发奖金会让 116 个失败中 112 个被过早放弃,82 掉到 79),可学习自适应停止与可变深度轨迹;其六,初始图像无 RL 信号,若底模首轮已接近正确则增益空间小,可把 direct T2I-RL 与轨迹 RL 级联(论文已示 direct→SFT→trajectory RL 在 500 更新达 81);其七,外部 controller 非原生交错,每轮重新喂入的开销限制实际部署效率,应换用原生交错骨干。
未来方向
作者明确提出的方向:count-aware edits——在奖励与协议不变的前提下让编辑动作可靠改变物体数量,是下一个训练目标(附录 Q 指出计数训练奖励平坦与精度停滞的对应关系)。基于成果可延伸的方向:其一,把 frozen verifier 换成或混合成学习型奖励/偏好模型,把可验证组合任务上的结论推广到开放域生成与风格对齐;其二,利用“骨干已有 0.80 AUC 正确性 readout”这一发现,显式蒸馏自验证头,让模型在推理时输出校准置信度并据此决定停止;其三,更长轨迹与自适应修复深度,结合 premature-done 惩罚与 done-bonus 的停止行为研究设计更优的终止定价;其四,把初始 T2I-RL、SFT、轨迹 RL 三阶段级联的训练配方系统化并研究各阶段最优配比;其五,移植到原生支持交错生成的骨干及更大规模模型,检验规模效应;其六,扩展到多图像、多区域编辑与真实用户迭代修图场景,检验修复行为在开放指令下的鲁棒性。
复现评估
复现条件相当友好。开源情况:GitHub 仓库(waltstephen/UMM-Reflection)与 HuggingFace 模型/数据合集均已放出,RL 训练用的 3,000 prompt 池随代码发布,SFT 的 29,529 条轨迹可下载;基座 BAGEL 公开。数据:SFT 数据由 GPT-5.5 + Qwen-Image(-Edit) 生成,自建需少量 API 成本;评测四个基准共约 4,648 条 prompt,均用官方 scorer 与冻结评判器。算力:RL 阶段 2 节点 × 8 张 H100 80GB(混合分片 FSDP),1,000 更新约 33 小时(中位 118 秒/更新);SFT 一个 epoch(167,363 行,全局更新至 2,969,恒定学习率 $2\times10^{-7}$)。超参在 Table 4 完整给出(双通道 lr $5\times10^{-6}$、clip 0.2/0.1、KL $10^{-4}$、SDE 噪声 1.0、文本温度 0.9)。难度评估:中偏高——主要门槛在流匹配 SDE 似然、双通道优化器与外部 controller 轨迹回放的工程实现,以及 GPT-5.5 数据生成成本;但论文统计细节(fail-closed 规则、McNemar、bootstrap CI、消融全覆盖)罕见地完备,结果可信度高。
论文图表
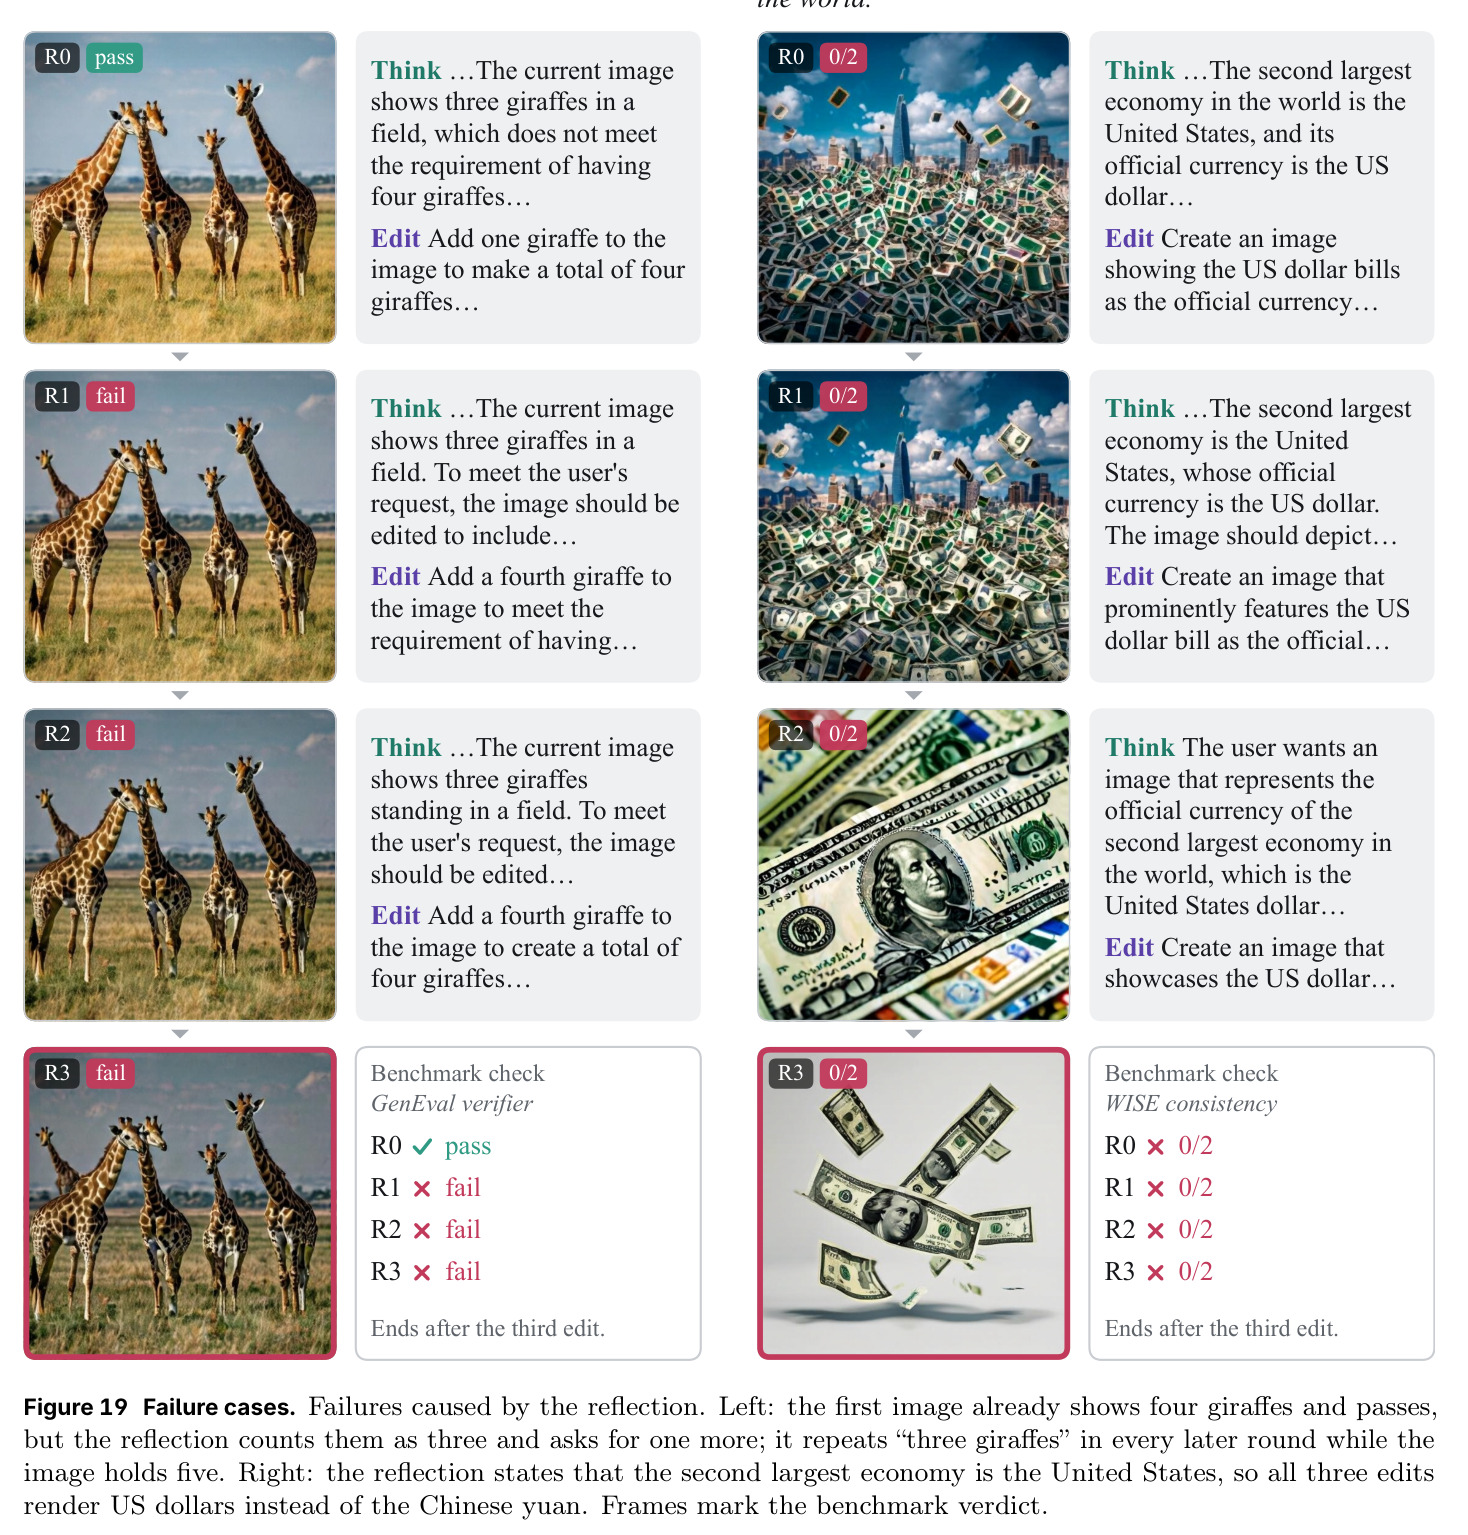
两个由反思本身导致的失败:左例初始图有四只长颈鹿且本已通过,模型却数成三只并反复“加一只”,最终变成五只且每轮都重复“三只长颈鹿”;右例模型坚信世界第二大经济体是美国,三轮全部渲染美元而非人民币。
暴露核心风险:RL 能优化行动但不能修复感知与知识错误,错误诊断会在轮间自我强化,这对部署决策很重要。