AutoRef:面向智能体多参考图生成的执行框架自动优化 AutoRef: Harness Optimization for Agentic Multi-Reference Image Generation
让编码智能体自动搜索最优生成流程代码,开源4B模型追平闭源商业模型
前置知识
多参考图生成(Multi-Reference Image Generation)
指把多张参考图(分别提供人物、物体、服装、背景、风格等)与一条文字指令一起输入图像生成模型,合成一张新图像的任务。模型必须正确理解每张参考图扮演的角色,把所有主体自然融入同一场景,而不是漏画、复制或生硬粘贴。
本文的全部问题都围绕这个任务展开,AutoRef 搜索出的 AutoRef-Harness 就是为该任务自动优化的执行流程,不理解任务就无法理解失败模式。
Harness(执行框架)
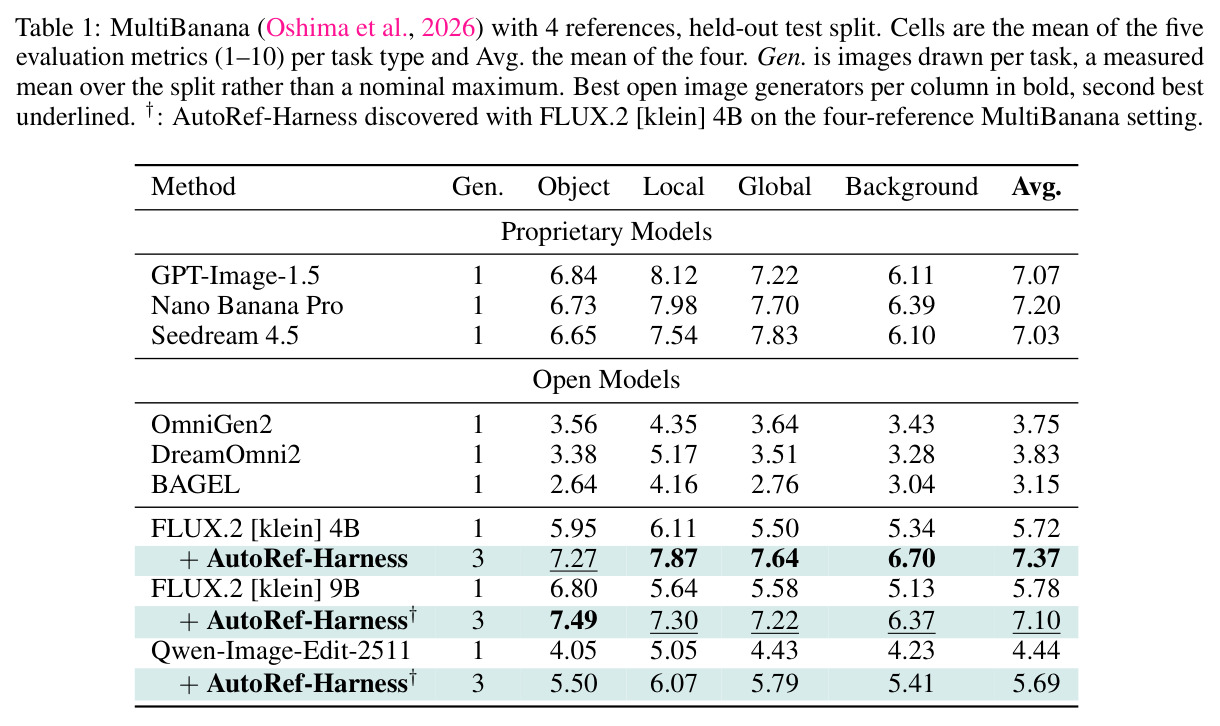
指连接冻结模型的可执行程序代码,规定了参考图如何被解读、提示词如何构造、候选图像如何生成与评估、最终输出如何挑选。同一对模型搭配不同 harness,效果差异可以超过 1.5 分(5.72 对 7.37)。
AutoRef 优化的对象不是模型权重而是 harness 代码,这是本文与微调类工作的根本区别,也是理解全文贡献的前提。
编码智能体(Coding Agent)
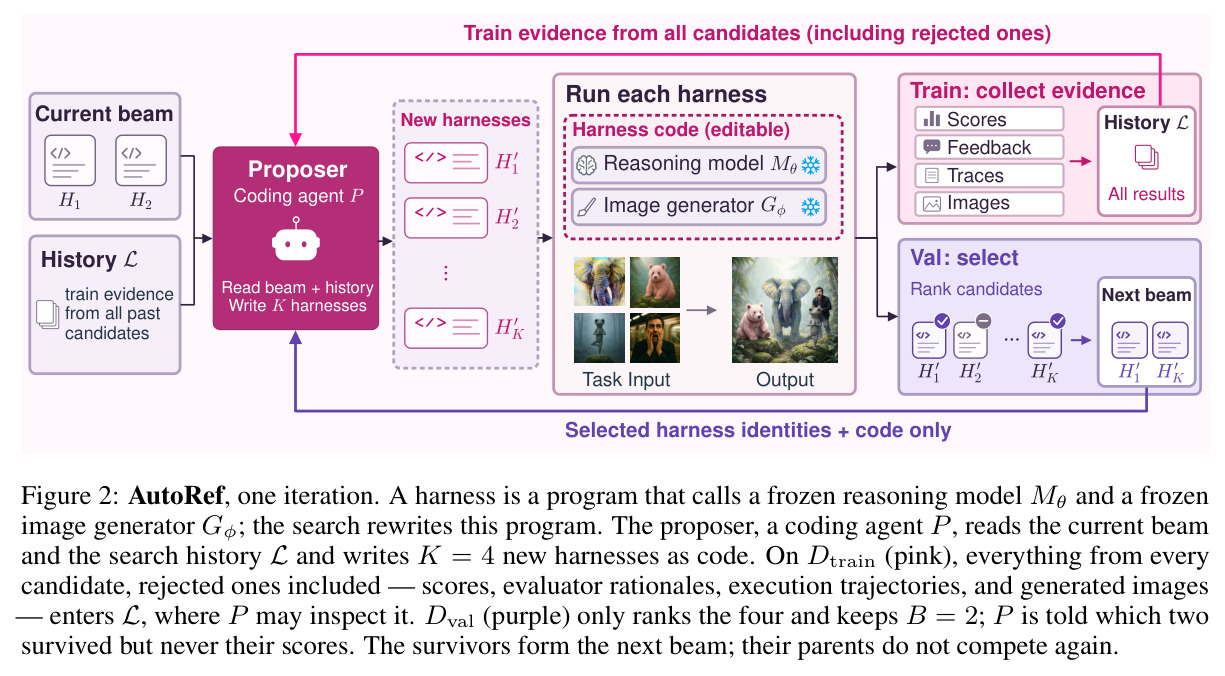
能读写代码文件、执行命令、检索日志的 LLM 智能体(如 Claude Code)。本文用它担任 proposer:每轮阅读当前 beam 与搜索历史,诊断历史候选的失败模式,然后写出新的 harness 候选代码。
proposer 由编码智能体担任,是 AutoRef 搜索循环的发动机,理解它的输入输出才能看懂算法流程。
束搜索(Beam Search)
一种保留多个最优候选继续扩展的搜索策略。本文每轮生成 $K=4$ 个候选 harness,按验证集分数 $J_{\mathcal{D}_{\text{val}}}$ 保留 top-$B$($B=2$)作为下一轮所有候选的父代,避免单路径搜索被随机生成或评估噪声带偏。
验证集 beam 是 AutoRef 相对贪心搜索的关键设计,消融实验显示它带来 6.67 到 7.37 的差异。
训练/验证任务分离
把搜索任务拆成不相交的 $\mathcal{D}_{\text{train}}$ 与 $\mathcal{D}_{\text{val}}$:前者提供反馈(分数、评估理由、执行轨迹、生成图像)供 proposer 改进 harness,后者只用于给候选排名,其分数与产物永不对 proposer 可见,只回报存活名单。
图像生成没有可验证奖励,直接对少量任务和带噪评估器优化极易过拟合,这一分离是本文针对该问题的核心方案。
VLM 评估器
用视觉语言模型(如 Qwen3-VL-8B-Instruct)按指令对齐、参考一致性、背景-主体匹配、物理真实性、视觉质量等维度给生成图像打 1–10 分的自动评估器。图像质量没有标准答案,标量分数噪声大、诊断信息少。
本文所有搜索信号都来自这种带噪评估器,理解其局限才能理解任务分离与束搜索两项设计的动机。
研究动机
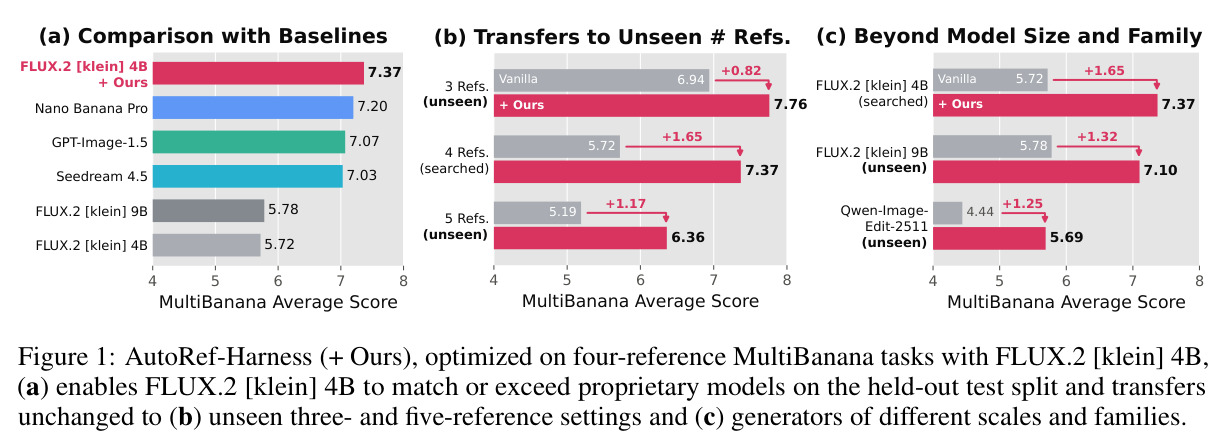
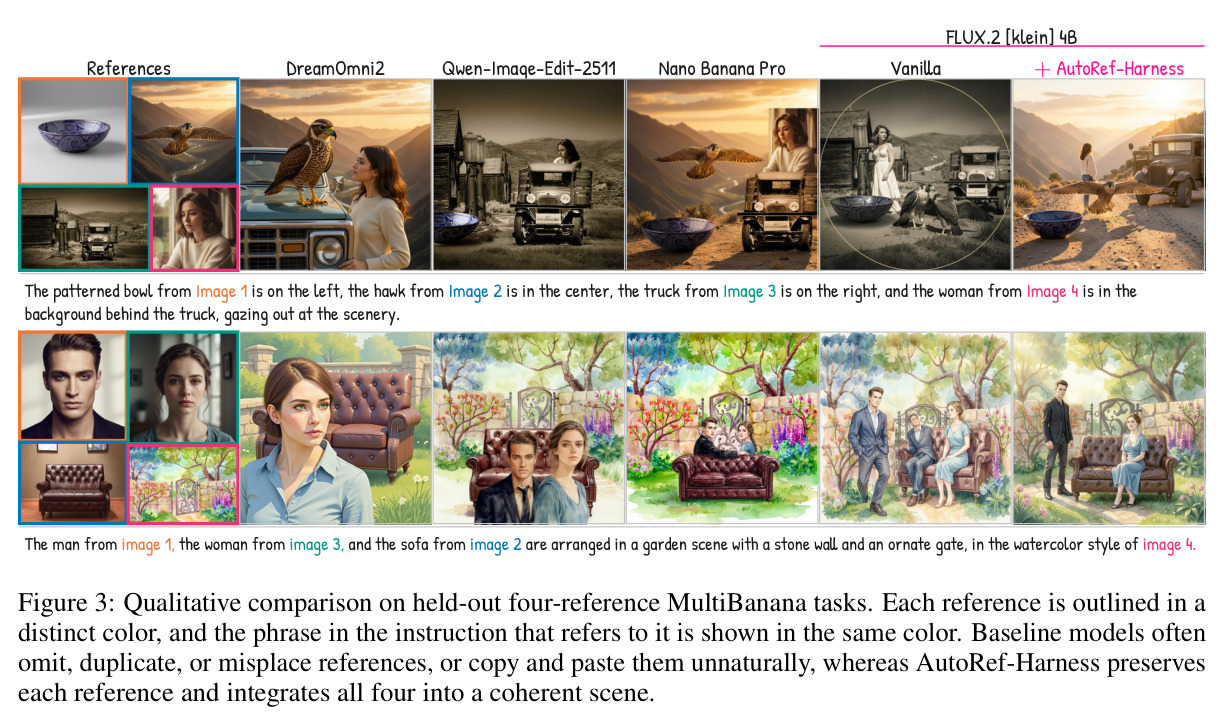
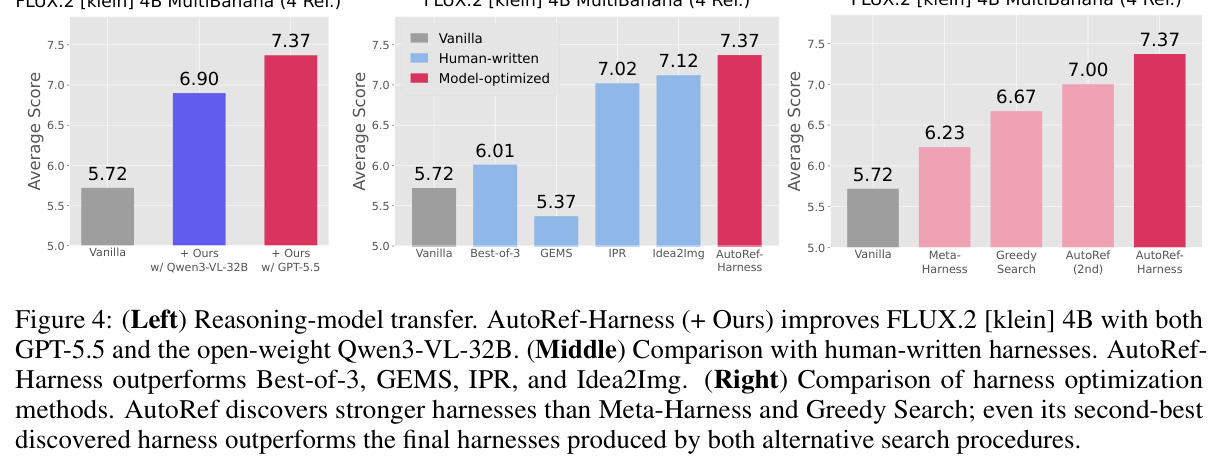
多参考图生成要求模型把多张参考图正确融合成一张图,但现有模型常出三类错:漏掉或复制某个参考主体、把主体生硬地『贴』进场景(光照、透视、色调与场景不一致)。直接调用 FLUX.2 [klein] 4B 在 MultiBanana 四参考任务上平均只得 5.72/10,开源模型 OmniGen2、DreamOmni2、BAGEL 更只有 3.75、3.83、3.15,与闭源的 Nano Banana Pro(7.20)、GPT-Image-1.5(7.07)差距明显。用智能体流程包住生成器可以改善,但 harness 是人工写的:参考图扮演不同角色(身份、背景、风格),输出要同时满足对每张参考的保真与整体自然度,哪一步改、怎么改效果难以预测,实测人工 harness 表现参差:Best-of-3 得 6.01、GEMS 5.37、IPR 7.02、Idea2Img 用 9 张图的预算也只有 7.12。而现有自动智能体优化方法(提示词、工作流、代码进化)都面向数学、代码等有可验证奖励的任务;图像生成只有带噪的标量视觉评分,诊断信息稀缺,直接优化容易同时过拟合少量搜索任务和评估器噪声。
本文的目标是本文的目标是:在图像生成器和推理模型完全冻结($\theta$、$\phi$ 不动)的前提下,自动搜索并优化 harness 代码,使多参考图生成效果显著提升,且优化出的 harness 不依赖搜索时的具体配置——换生成器(不同规模、不同家族)、换参考图数量(3 或 5 张)、换基准(MultiBanana 到 OmniContext)、换评估器(Qwen3-VL-8B 到 GPT-4.1)、换推理模型(GPT-5.5 到 Qwen3-VL-32B)时无需重新优化仍能涨分。理想产物是一个让开源 4B 小模型在 MultiBanana 四参考留出测试集上追平甚至超过闭源商业模型的执行流程,同时把每任务生成成本控制在 3 张图,并公开代码与 harness 保证可复现。
与已有工作不同的是,独特切入在于把『harness 优化』从可验证奖励任务搬到感知型、非可验证的图像生成上,并针对其两大噪声源给出机制设计。其一是提出-选择任务分离:以往 Meta-Harness 让 proposer 读反馈的任务和给候选排名的任务是同一批,容易过拟合;AutoRef 把两者拆成不相交的 $\mathcal{D}_{\text{train}}$ 和 $\mathcal{D}_{\text{val}}$,验证侧分数与图像永不进入 proposer 视野。其二是束搜索自动选父代:以往由 proposer 自己挑父候选或只保留单最优(贪心搜索),容易被随机生成和视觉评估噪声锁死在单一路径;AutoRef 用 $\mathcal{D}_{\text{val}}$ 上的 top-$B$($B=2$)自动决定下一轮父代。作者用逐级对照证明这条路线的收益可叠加:Meta-Harness 6.23 → 贪心 6.67 → AutoRef 7.37,说明两项设计各自贡献了独立增益。
核心方法
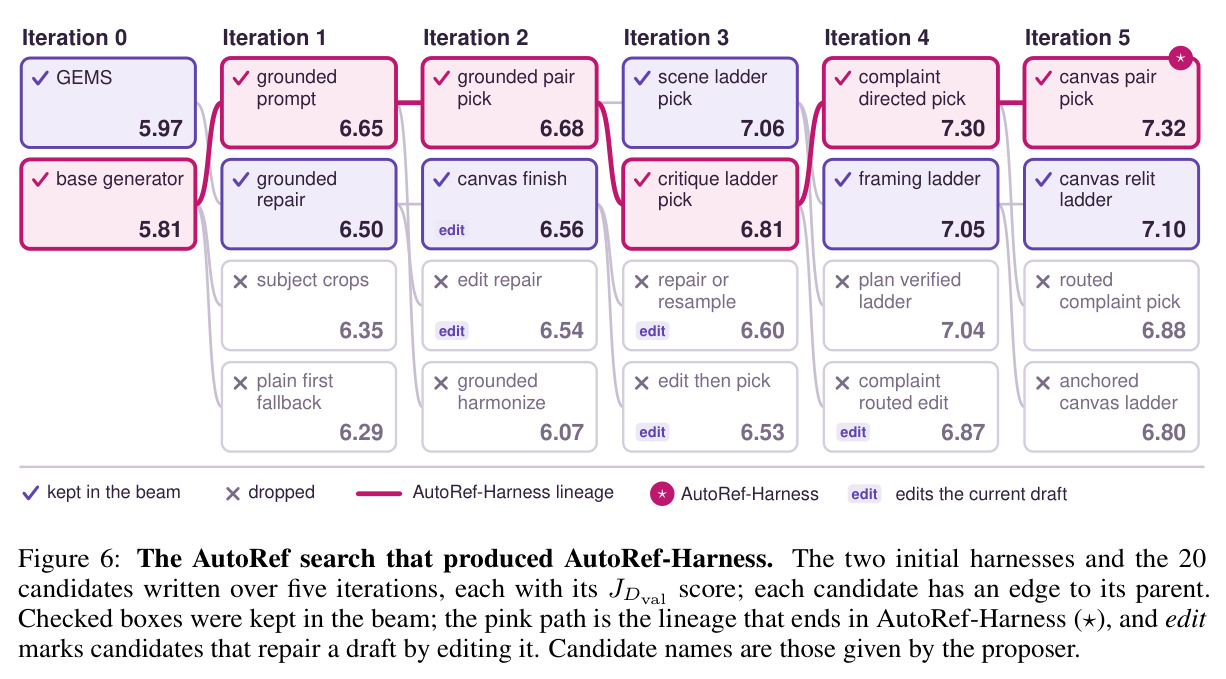
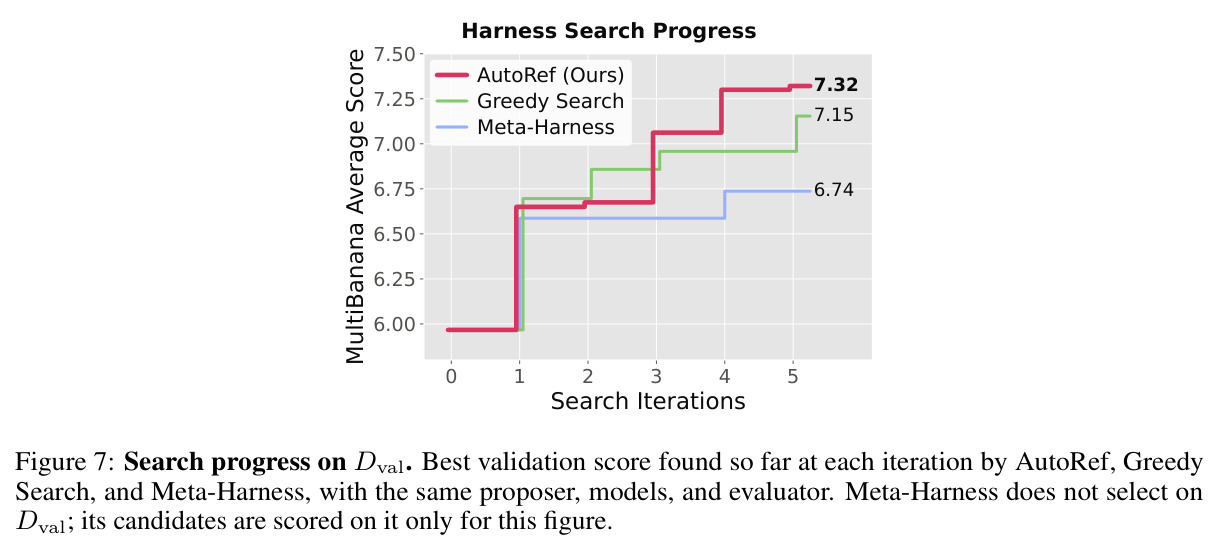
任务 $x=(u,I)$ 由指令 $u$ 与参考图集 $I$ 组成,冻结的推理模型 $\mathcal{M}_\theta$ 与生成器 $\mathcal{G}_\phi$ 被 harness 程序 $\mathcal{H}$ 调度,输出图像 $y$ 与轨迹 $\tau$,优化目标是最大化 $J(\mathcal{H})=\mathbb{E}[\mathcal{R}(y,x)]$。AutoRef 用迭代代码进化求解:初始 beam 为裸生成器与 GEMS;每轮由编码智能体 proposer(Claude Fable 5.1)阅读当前 beam 与搜索历史(候选代码、分数、理由、轨迹、图像),写出 $K=4$ 个新 harness;每个候选在 48 个 $\mathcal{D}_{\text{train}}$ 任务上运行并把证据写入历史,在 48 个 $\mathcal{D}_{\text{val}}$ 任务上排名,top-2 进入下一轮 beam;proposer 只知谁存活、不见验证分数。共 5 轮、20 个候选,取验证分最高者为最终 harness。
核心创新有两条。第一,提出-选择任务分离:$\mathcal{D}_{\text{train}}$ 上的全部证据(包括被淘汰候选的分数、评估理由、轨迹和图像)都进入历史供 proposer 做视觉诊断,而 $\mathcal{D}_{\text{val}}$ 只做排名,其分数与产物对 proposer 严格保密,只回报存活名单——改进信号与选择信号解耦,避免 harness 同时过拟合小任务集与评估器噪声。第二,基于验证集的迭代束搜索:每轮 top-$B$ 候选自动成为父代而非由 proposer 挑选或贪心保留,防止单路径搜索被随机生成和视觉评估的噪声带偏。与已有方法的本质区别在于:提示词优化(GEPA 等)只在固定程序内调 prompt;Meta-Harness 的反馈与排名共用同一批任务且父代由 proposer 自己选;AutoRef 首次同时修正这两点,并针对图像生成『标量分看不懂失败原因』的特点,让 proposer 能直接翻看历史生成图像进行视觉诊断。
方法步骤详情
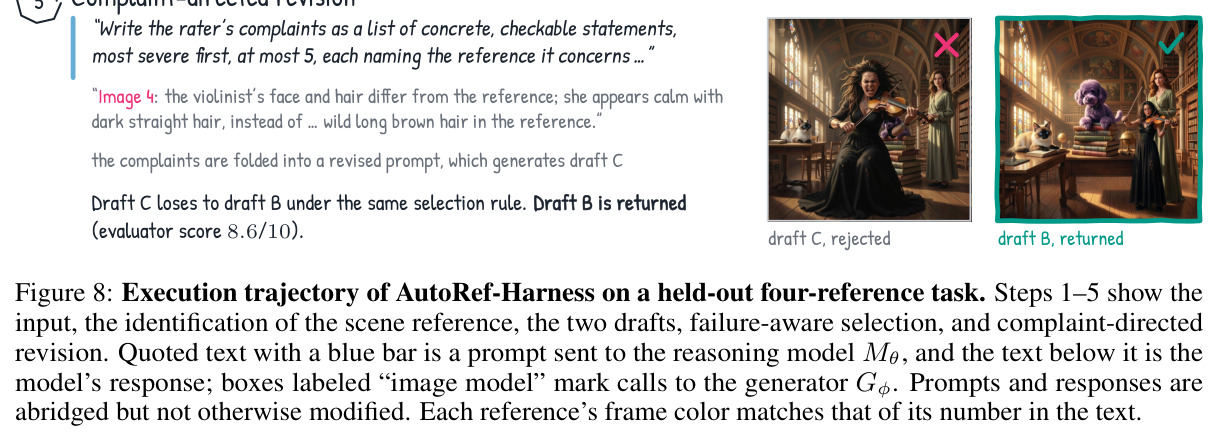
搜索逐轮累积出 AutoRef-Harness 的四个组件。第 1 轮得到参考图接地提示词:推理模型读指令与全部参考图,把原始指令改写为『把每个请求元素指派到其参考图』的结构化提示词,验证分从 5.81/5.97 升到 6.65。第 2 轮加入结构化双草稿:草稿 A 用场景优先提示词逐主体描述,草稿 B 找出作为背景或风格的参考图作为画布(canvas-anchored),要求生成器在其上作画使主体与场景联合渲染;两稿经双序成对比较选出优胜,升至 6.68。第 3 轮增加第三稿:针对当前优胜稿最弱维度改写提示词再生成一张,预算固定为每任务 3 张图(6.81)。第 4 轮加入抱怨驱动修订与失败感知选择:列出至多 5 条具体抱怨且每条指明涉及哪张参考图,据此重写提示词生成草稿 C;选择时先数硬失败(缺参考、多出或重复主体、背景错误),失败少者胜,平局则双序成对比较且挑战者必须两序皆胜(7.30)。第 5 轮恢复结构多样性使草稿 B 画布化(7.32)。被否决方向亦有记录:编辑式修复在 12 个标记任务中 8 个未消除失败,统一光照重绘使 6.16 降至 5.91。
技术新颖性
技术新颖性体现在三个层面。任务层面:这是首个针对多参考图生成、以视觉评估为信号的 harness 自动优化工作,此前的代码进化与 Meta-Harness 都面向数学、代码等可验证奖励任务,AutoDesign 虽做了论文转海报但未解决反馈-选择耦合问题。算法层面:train/val 分离加验证集 beam 的组合是新的,逐级对照(Meta-Harness 6.23 → Greedy 6.67 → AutoRef 7.37)清晰归因了每个机制的贡献,甚至 AutoRef 的次优 harness(7.00,每任务 3 张图)也胜过两个基线的最终产物(分别耗 4.2 和 5 张图)。产物层面:AutoRef-Harness 本身有工程洞察——它从不把原始指令直接交给生成器;两稿提示词结构不同而非仅换采样种子;抱怨必须指名所涉参考图;选择先数硬失败再做成对判断。这些都与人工 harness 的通用套路不同,且每个组件都在提分的迭代中被引入,原地编辑等直觉方案被数据淘汰,体现了自动搜索超越人工设计的价值。
实验结果
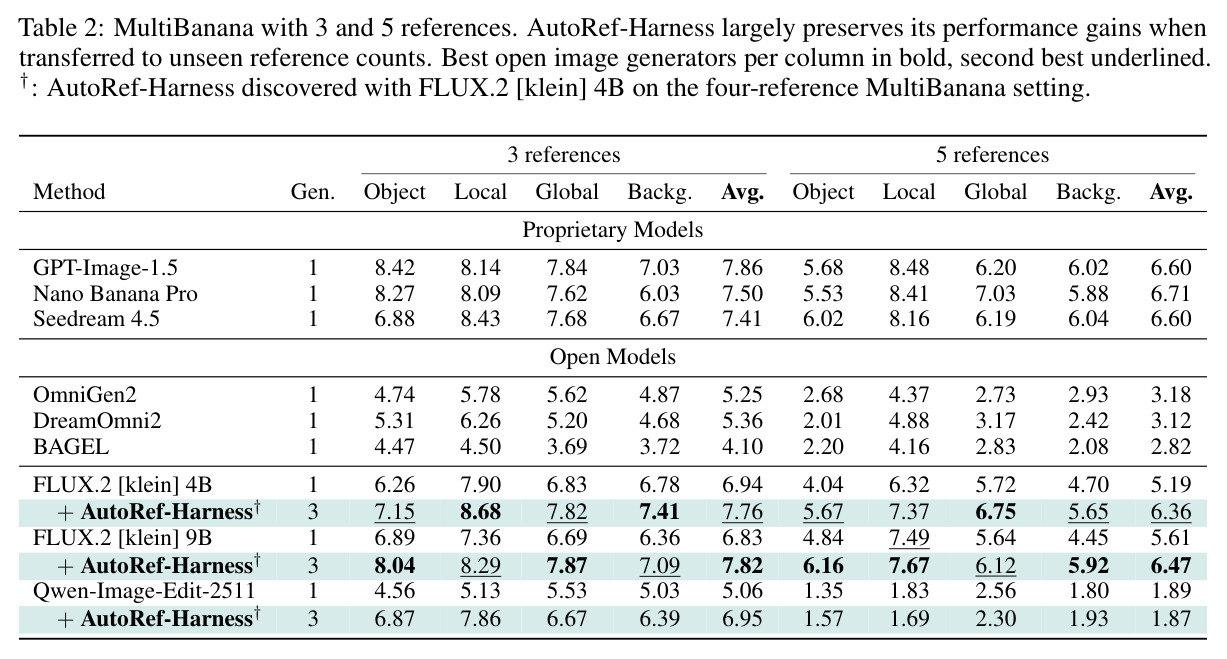
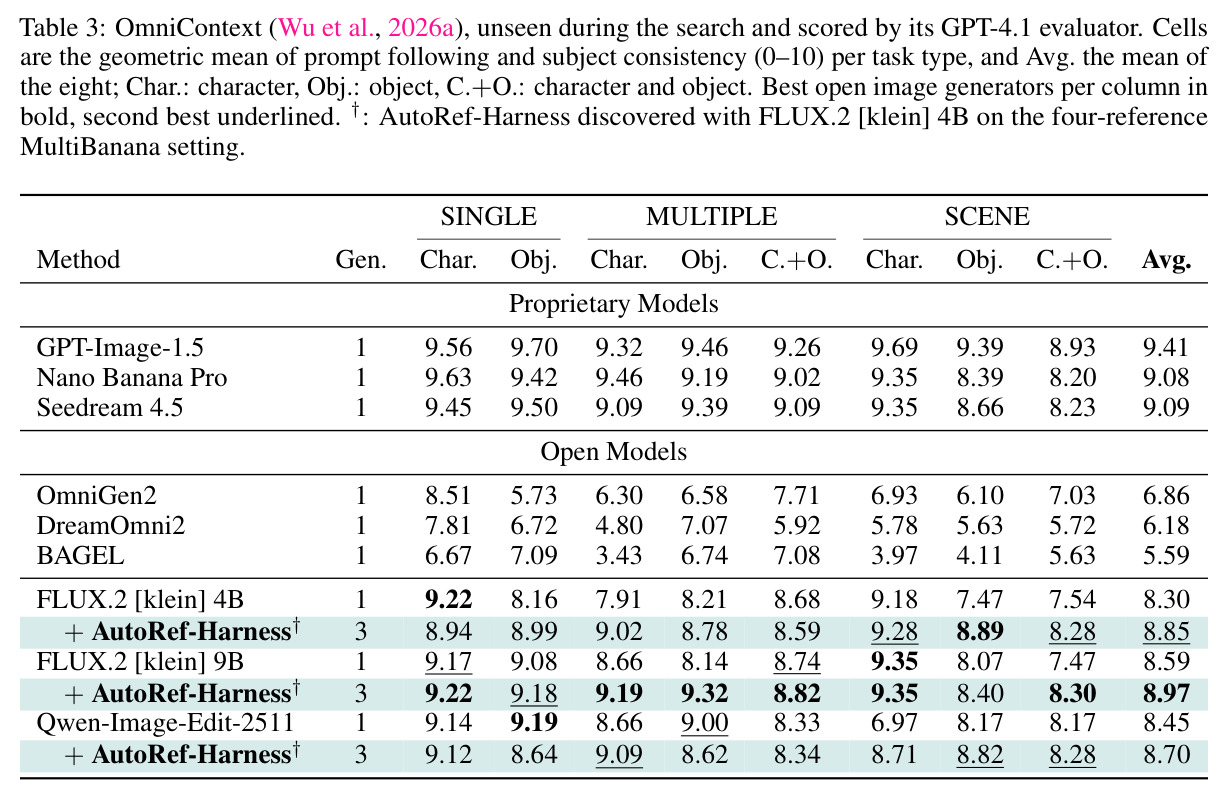
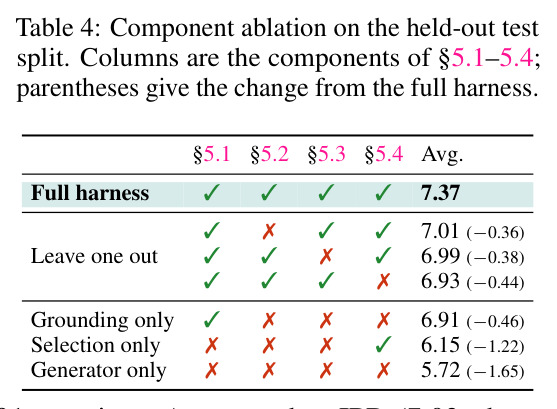
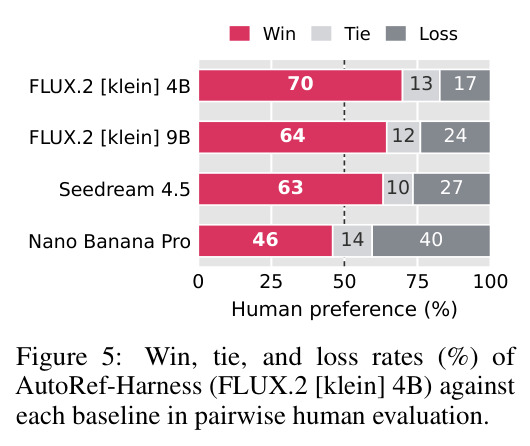
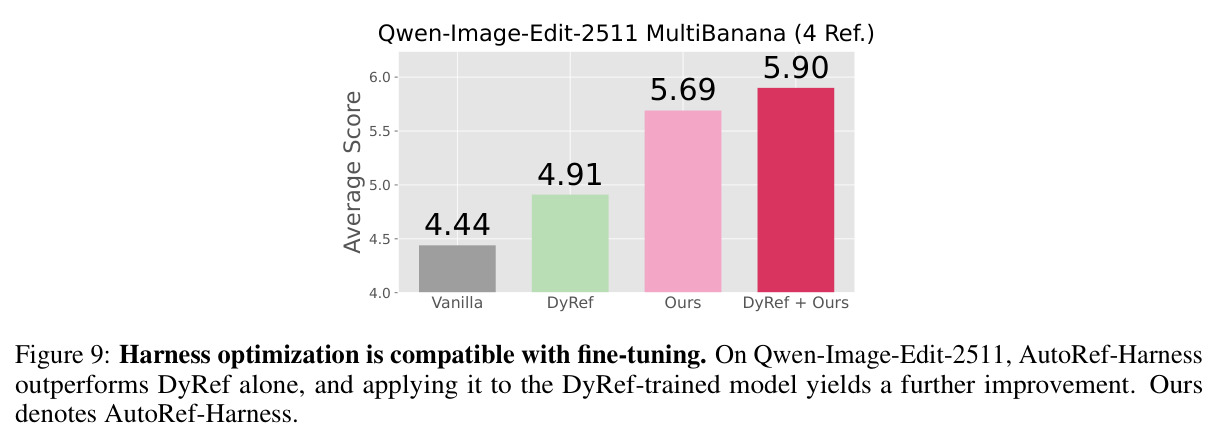
四参考 MultiBanana 留出测试集上,本文把 FLUX.2 4B 从 5.72 提到 7.37(每任务 3 张图),远超全部开源模型(次优 3.83),追平闭源最优 Nano Banana Pro 7.20。同一 harness 免重优化提升 9B(5.78→7.10)与 Qwen-Image-Edit(4.44→5.69);未见 3 参 7.76 对 6.94,5 参 6.36 对 5.19;换基准与评估器到 OmniContext 8.85 对 8.30;换 Qwen3-VL-32B 推理仍达 6.90。人工 harness 最强的 Idea2Img 耗 9 张图仅 7.12;搜索方法 Meta-Harness 6.23、贪心 6.67、本文次优 7.00。消融:去任一组件降到 6.93–7.01,仅接地 6.91、仅选择 6.15。人类盲评(4 人×50 题):对基础模型 70/13/17,对 Seedream 63/10/27,对 Nano Banana Pro 46/14/40。与微调正交:DyRef 4.91,叠加本文 5.90。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MultiBanana 四参考(留出测试集,n=133) | 五项 VLM 指标平均(1–10) | 7.37(FLUX.2 [klein] 4B + AutoRef-Harness,3 张图/任务) | 裸 FLUX.2 [klein] 4B 5.72;最优闭源 Nano Banana Pro 7.20 | +1.65,反超 Nano Banana Pro 0.17 |
| MultiBanana 三参考(未见参考数,n=96) | 五项 VLM 指标平均 | 7.76 | 裸 FLUX.2 4B 6.94;闭源最优 GPT-Image-1.5 7.86 | +0.82,开源第一、接近闭源最优 |
| MultiBanana 五参考(未见参考数,n=96) | 五项 VLM 指标平均 | 6.36 | 裸 FLUX.2 4B 5.19;闭源最优 Nano Banana Pro 6.71 | +1.17 |
| OmniContext(未见基准 + GPT-4.1 评估器,n=120) | 提示遵循与主体一致性的几何平均(0–10) | 8.85(9B 达 8.97) | 裸 FLUX.2 4B 8.30 | +0.55,在基准与评估器双重偏移下仍涨分 |
| 四参考 + 开源推理模型 Qwen3-VL-32B | 五项 VLM 指标平均 | 6.90 | 裸 FLUX.2 4B 5.72(GPT-5.5 时为 7.37) | +1.18,验证 harness 策略不绑定特定推理模型 |
| 四参考,对比人工编写的 harness | 五项 VLM 指标平均 | 7.37(3 张图/任务) | IPR 7.02(3 张)/ Idea2Img 7.12(9 张)/ Best-of-3 6.01 / GEMS 5.37 | +0.25 至 +2.00,且预算仅为 Idea2Img 的三分之一 |
| 四参考,对比 harness 搜索算法 | 五项 VLM 指标平均 | 7.37(AutoRef,3 张图/任务) | Meta-Harness 6.23(4.2 张)/ Greedy Search 6.67(5 张) | +1.14 / +0.70,且次优 harness(7.00)也胜过两者最终产物 |
局限与改进
作者承认的第一条硬限制:harness 只能从冻结生成器的产物中挑选,无法超出其能力上限。最明显的证据是 Qwen-Image-Edit-2511 在五参考下:硬失败检查在 96 题中的 87 题(91%)把全部三稿都判为失败(对比 FLUX.2 4B 五参考仅 9%、Qwen 三参考 7%),加 harness 后 1.89→1.87 几乎无变化——没有可接受的草稿时,再好的选择也无济于事。其次,搜索最大化单一 VLM 评估器的分数,虽然迁移到 OmniContext 与 GPT-4.1 评估器仍涨分,但存在迎合特定评估器偏好的风险;推理模型换成开源 Qwen3-VL-32B 后从 7.37 降到 6.90,说明效果部分依赖强推理模型。我自己的观察:每任务 3 张图加多次推理模型调用,成本至少是裸生成的 3 倍,论文未报告时延与 API 开销;搜索只用 48 个训练任务和 20 个候选,未报告多次重复运行的方差;人工评测仅 4 名标注者、每基线 50 题;harness 逻辑复杂度上升,可解释性与可控性依赖代码可读性。
独立分析的弱点
独立分析几个弱点。其一,对专有推理模型的依赖:最佳成绩 7.37 依赖 GPT-5.5,换 Qwen3-VL-32B 掉到 6.90,落地成本与可用性受限,改进方向是蒸馏或微调一个专门做『参考图接地提示词重写』的开源小模型。其二,成本结构僵化:每任务固定 3 次生成加约六次以上推理模型调用,论文未报告时延和费用,可引入难度自适应机制——首稿通过全部硬失败检查即提前返回,让简单任务降回 1 张图。其三,搜索统计可靠性:$T=5$、$K=4$、$B=2$ 共 20 个候选、48 个训练任务,单次搜索的结论缺乏方差估计,宜做多种子重复并报告均值与标准差。其四,评估器博弈风险:harness 由 Qwen3-VL-8B 评分驱动进化,可能学到迎合该评估器偏好的风格(迁移实验部分缓解但未消除),可用评估器集成或人类偏好信号交叉验证。其五,组件交互未充分消融:四个组件只做了留一法,缺少两两组合分析;grounding only 用 1 张图已达 6.91、接近 IPR 的 7.02,说明最大增益来自接地提示词,其余组件的边际收益依赖其存在,交互效应值得量化。
未来方向
作者提出的方向:用更强 VLM 与编码智能体替换评估器和 proposer 使性能水涨船高;把 VLM 与分割模型(如 SAM 3)结合构造更丰富的评估信号,降低标量评分噪声;对五参考场景需从『减少一次必须合成的参考数』入手突破生成器能力上限。基于本文成果可延伸的方向:其一,成本自适应 harness——让控制流根据首稿质量动态决定后续步骤,把搜索空间显式扩展到含提前退出的策略类;其二,把 harness 优化与参数微调交替迭代(论文已证与 DyRef 正交、可叠加至 5.90),探索『搜索-微调-再搜索』的联合循环;其三,把任务分离加 beam 的搜索协议迁移到视频生成、3D 生成等同样感知型、非可验证的多模态任务;其四,在搜索历史中引入可复用技能库(类似 GEMS 的 memory),让候选 harness 组合已验证的子程序加速收敛;其五,系统研究搜索规模定律:迭代数、候选数、任务数与最终 harness 质量的关系,回答 20 个候选之外还有多少提升空间;其六,评估器鲁棒性:以多评估器一致性作为选择信号,训练对评估器扰动不敏感的 harness。
复现评估
复现条件相当好。代码与 AutoRef-Harness 已开源(github.com/KuOnoda/AutoRef),附带数据划分和锁定版本:开源权重模型固定 HuggingFace revision,API 模型用带日期快照,评估器贪心解码;基准(MultiBanana、OmniContext)公开。算力方面,搜索与评估在 NVIDIA RTX 6000 Ada 上完成,生成器是 4B 开源模型,单卡可跑。主要门槛在 API 成本:搜索需 5 轮 × 4 候选 ×(48 训练 + 48 验证)任务的生成与评估,proposer 用 Claude Fable 5.1,推理模型用 GPT-5.5,评估用 Qwen3-VL-8B(可本地)或 GPT-4.1,粗算需数千次生成加更多次 LLM 调用。难度评估:直接使用现成 AutoRef-Harness 很容易,克隆仓库配置模型即可;复现完整搜索属中等偏难,依赖两个专有 API 的稳定性,单次搜索约一天量级的计算与费用;复现全部对照实验(3 个搜索基线、9 个生成基线、人类评测)工作量最大。总体属于开源程度较高的 agentic 研究。
论文图表
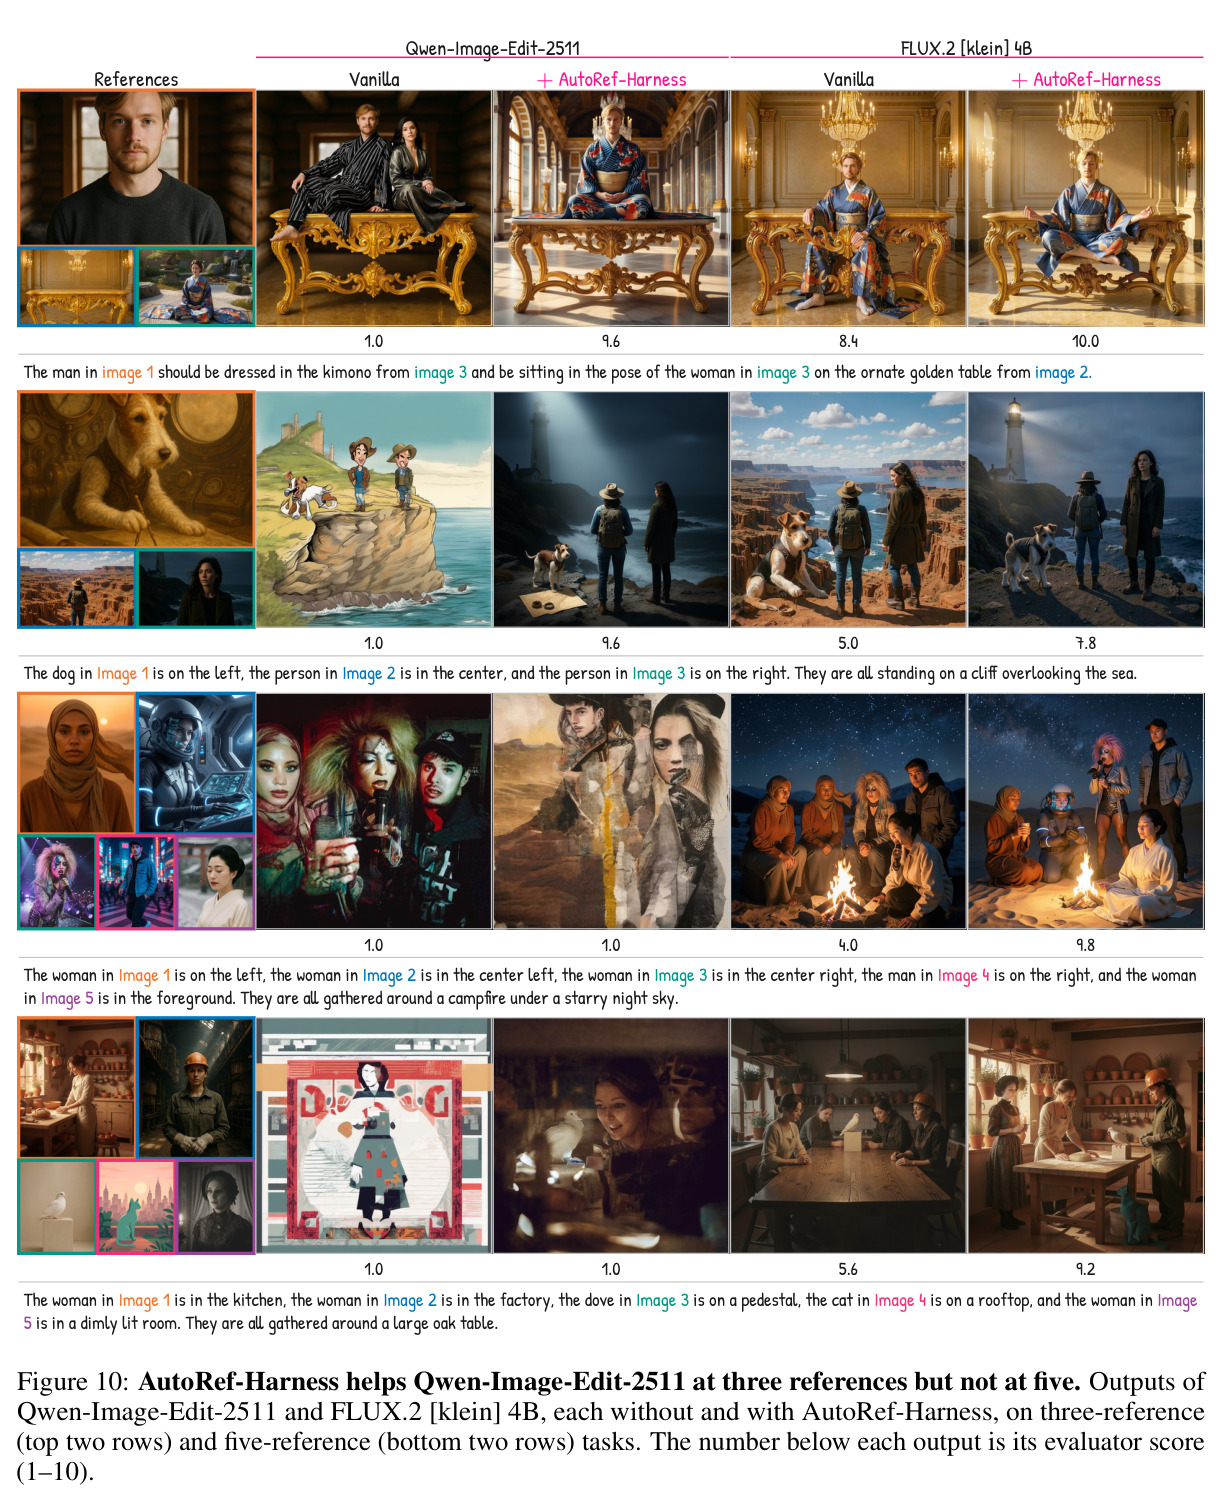
三参考(上两行)与五参考(下两行)任务上 Qwen-Image-Edit-2511 与 FLUX.2 4B 加/不加 harness 的输出对比及单图评分。三参考时 harness 明显提分;五参考时 Qwen 生成质量崩溃,91% 的任务三稿全部被硬失败检查标记(4B 仅 9%),选择机制无从发挥作用。
清晰划定方法的适用边界:harness 只能选择冻结生成器的产物,生成器本身失败时无能为力。