我们离去掉视觉编码器还有多远?无编码器多模态预训练的缩放定律 How Far Are We from Removing the Visual Encoder? Scaling Laws for Encoder-Free Multimodal Pretraining
无编码器多模态模型前期更耗算力但损失下降更快,预计约10^22 FLOPs处反超有编码器架构
前置知识
缩放定律(Scaling Law)
描述验证损失随计算量变化的幂律经验规律,标准形式为 $L^*(C) = E + KC^{-\gamma}$:$E$ 是由数据分布决定的不可约熵底,$K$ 为预因子,$\gamma$ 为损失-计算指数(越大说明增加算力降损失越快)。计算最优分配研究给定预算 $C = MD$($M$ 为每 token FLOPs、$D$ 为 token 数)时如何选择 $M$、$D$ 使损失最小,经验上 $M_{opt} \propto C^a$、$D_{opt} \propto C^b$ 且 $a + b = 1$:$a$ 大意味着最优策略偏向更大模型,$b$ 大意味着偏向更多数据。
全文所有定量结论都是两套缩放参数($\gamma$ 与 $a$)在两架构之间的差异,不掌握这套语言就看不懂图 3–5 和核心发现。
IsoFLOP 剖面(IsoFLOP Profile)
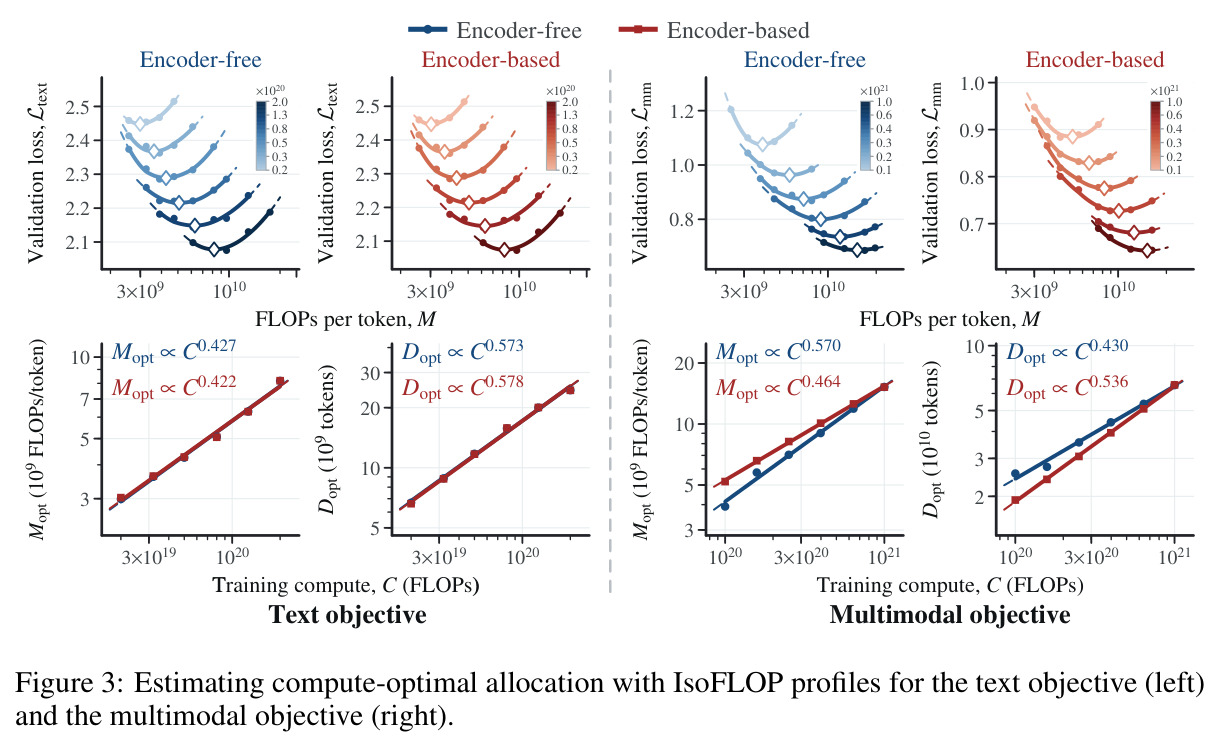
估计计算最优分配的标准实验流程(源自 Chinchilla):固定计算预算 $C$ 不变,训练一组每 token FLOPs $M$ 不同、$D = C/M$ 的模型,把验证损失对 $\log M$ 拟合二次函数,顶点即为该预算下的最优模型规模 $M_{opt}$;在多个对数等距预算上重复这一流程,就得到分配指数 $a$、$b$ 和最优损失前沿 $L^*(C)$。
本文的全部训练实验正是围绕 IsoFLOP 剖面组织的(文本目标 6 个预算、多模态目标 6 个预算),附录 F 还按主题重复了整个流程。
有/无编码器 MLLM
有编码器架构用预训练视觉编码器(如 SigLIP 2 ViT,在大规模图文对上训练)把图像变成语义化的视觉 token 再交给语言模型,视觉先验是白送的;无编码器架构把原始图像 patch 经简单线性投影直接送入解码器,由解码器从像素自学视觉表征,架构统一简洁但表示学习负担更重。两架构对比时需控制视觉 token 粒度一致(本文均为每 32×32 像素一个 token)。
论文的全部问题就是这两种架构的缩放行为差异,以及无编码器解码器如何补偿缺失的编码器职能。
稀疏混合专家(MoE)
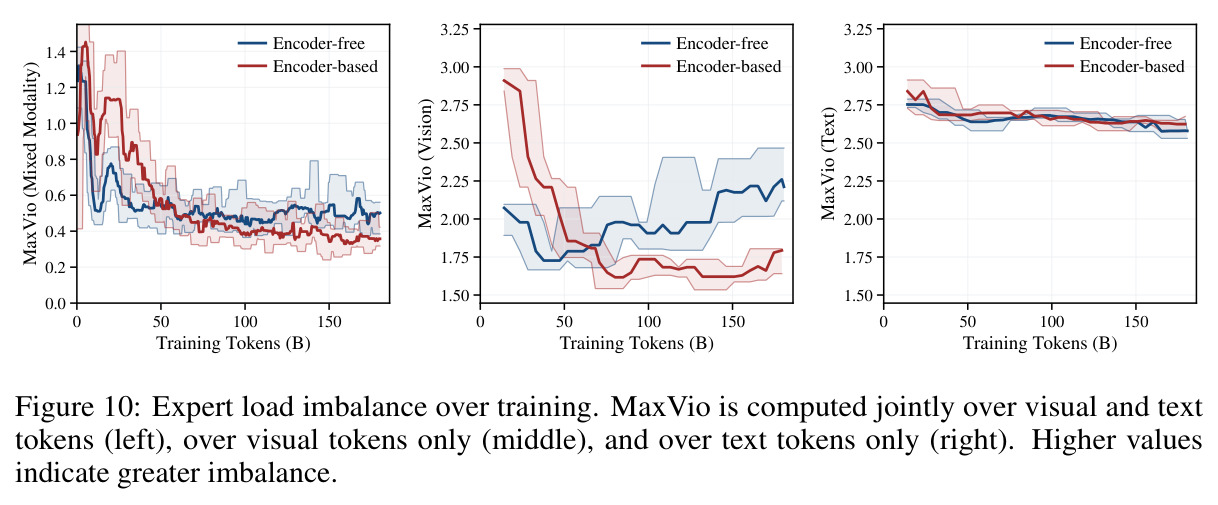
把 Transformer 每层的单个 FFN 替换为 $N$ 个专家网络,每个 token 经路由器只激活 top-k 个专家(本文为 256 选 8 加 1 个共享专家,激活率 8/256),从而在总参数很大的同时保持每 token 计算量较小。专家负载不均衡度 MaxVio 衡量最忙专家的负载超出完全均匀负载的相对比例,可用来检测专家是否按模态分化。
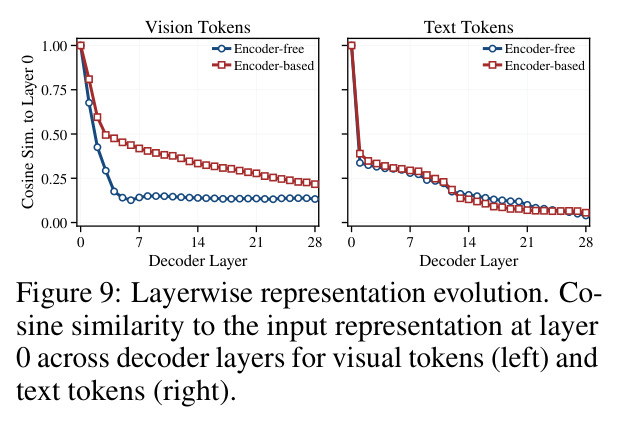
模型阶梯全部是 MoE 的;专家路由按模态分化(图 10)是『解码器接管视觉编码』机制的三大证据之一。
过训练(Overtraining)
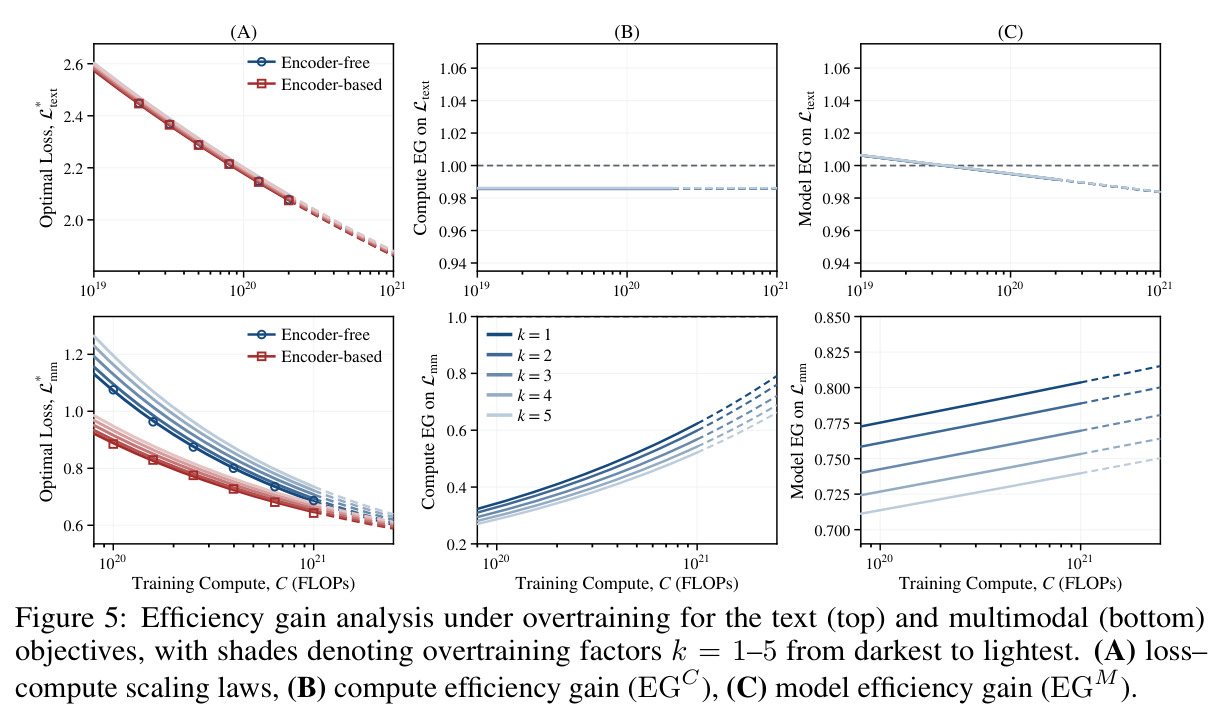
面向推理成本的训练策略:把模型规模固定在计算最优值的偏小处、用 $k$ 倍 token 数训练(实际算力 $C_{actual} = kC_{base}$),牺牲训练效率换取更小的推理开销。对损失-计算律的影响可用乘子建模:$L(C_{base}, k) = E + g(k)KC^{-\gamma}$,过训练只缩放可约项的预因子 $g(k)$、不改变指数 $\gamma$(附录 D 给出推导),因此只需少量小尺度 run 就能估计。
现实大模型几乎都过训练(如推理优先的部署模型),作者专门分析了 k=1–5 下交叉点如何被推迟,这直接影响结论的实用价值。
双向 vs 因果注意力(视觉 token)
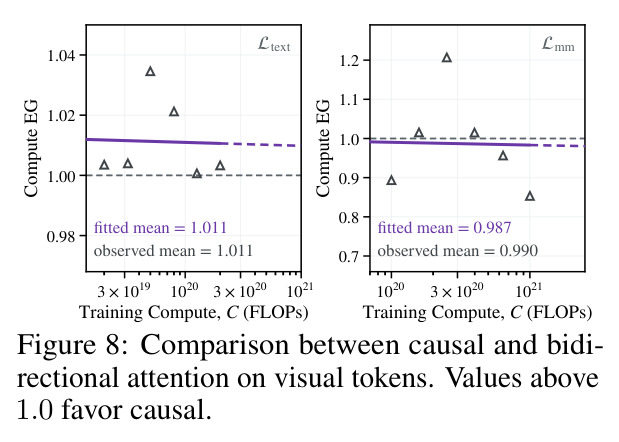
因果注意力要求每个 token 只能看见左侧上下文,是语言模型解码器的标准设置;双向注意力允许一组 token 互相看见。ViT 天然以双向注意力对图像 patch 做上下文化,而标准 MLLM 解码器对所有 token 全因果。无编码器模型让视觉 token 在图像内部双向注意、其余保持因果,正是为了让解码器重演编码器的 patch 级上下文化功能。
图 8 和表 1 的因果对照实验用来排除『多模态分配偏移是注意力掩码造成的』这一混淆解释,是机制分析的重要一环。
研究动机
现代多模态大模型几乎清一色采用『预训练视觉编码器 + 语言模型』的架构:SigLIP、CLIP 等编码器在数十亿图文对上预训练,为语言模型提供现成的视觉先验。无编码器方案(Fuyu、EVE、SOLO、SAIL 等)去掉编码器、把图像 patch 直接投影进解码器,架构统一简洁,但已有工作只回答了『能不能行』,没有人系统回答『缩放行为如何』。这带来一个现实的决策困境:无编码器模型在同等算力下损失差多少?差距随规模放大是收窄还是扩大?要多大算力才能追平?在本文之前这些问题完全空白——直觉上无编码器意味着模型要从原始像素自学视觉表征、早期必然吃亏,但吃亏的代价有多大、偿还曲线长什么样,没有任何定量刻画,工程团队无法据此判断是否值得押注这条架构路线。
本文的目标是本文的目标是在严格受控的条件下,首次系统刻画无编码器 MLLM 的缩放定律并与有编码器基线公平对比。具体拆成三件事:其一,在同一个 11 级稀疏 MoE 解码器阶梯(总参数 1.1B–44B、激活参数 71M–2.4B)上,保持数据配比、优化设置、视觉 token 粒度完全一致,分别对文本目标 $\mathcal{L}_{text}$ 和多模态目标 $\mathcal{L}_{mm}$ 拟合缩放定律,量化两架构的计算最优分配与损失-计算前沿如何随规模演化;其二,外推拟合结果,预测无编码器模型在多大规模的训练算力下能在多模态目标上追平有编码器模型,同时覆盖计算最优和过训练两种训练机制;其三,解剖解码器内部(视觉 token 注意力模式、层间表征演化、专家路由),回答『编码器被去掉之后,是谁在干它原来的活』。
与已有工作不同的是,已有无编码器研究聚焦可行性与单点改进:Fuyu/EVE/SOLO 证明架构可行,SAIL 系统研究单一 Transformer 内的模型与数据扩展,后续工作用对齐蒸馏、模态专用容量、原生视觉原语等手段提升视觉能力,但都不与有编码器基线做逐点匹配的缩放对比。另一支缩放定律文献里,Chinchilla 奠定了纯语言的方法论,近期扩展到原生多模态的工作研究的是统一多模态预训练的数据需求、或数据受限下编码器与语言模型的耦合缩放,同样没有把『有无视觉编码器』当作受控变量。本文的独特切入在于:给出第一条在同一 MoE 解码器阶梯上匹配对比的两架构缩放定律,同时提供交叉点外推(约 $10^{22}$ FLOPs)与机制层面解释(解码器通过视觉特异性适应接管编码器职能),把『效率预测』和『机理解剖』闭合成完整证据链——文本目标还天然充当了阴性对照,检验实验管道本身无偏。
核心方法
整体思路先给直觉:去掉视觉编码器后,解码器必须同时承担『学会看』和『语言建模』两份工作,因此可以预期它需要更大的模型容量(分配指数 $a$ 变大)、前期吃亏,但视觉表征学习的改进空间可能随算力兑现得更充分($\gamma$ 变大)。技术路线上,作者训练了两套完全匹配的模型阶梯:共享同一 11 级稀疏 MoE 解码器(256 个路由专家激活 top-8、加 1 个共享专家,首层稠密,RMSNorm + RoPE,序列长度 4096,Muon 优化器),1:1 文本/多模态数据配比,两前端都输出每 32×32 像素一个视觉 token。有编码器侧用固定的 SigLIP 2 ViT(约 400M 参数,27 层、宽 1152、patch 16、AnyRes 处理,与解码器联合训练)加 2×2 ConvPool 适配器和投影层;无编码器侧用最朴素的 patch projection(LayerNorm-线性层-LayerNorm、因式分解二维位置嵌入、再 LayerNorm、RMSNorm、线性投影到解码器宽度),视觉 token 在图内双向注意力、其余全因果。以解码器 FLOPs 为主要计算口径,对文本目标在 $2\times10^{19}$–$2\times10^{20}$、多模态目标在 $1\times10^{20}$–$1\times10^{21}$ FLOPs 各取 6 个对数等距预算做 IsoFLOP 剖面。
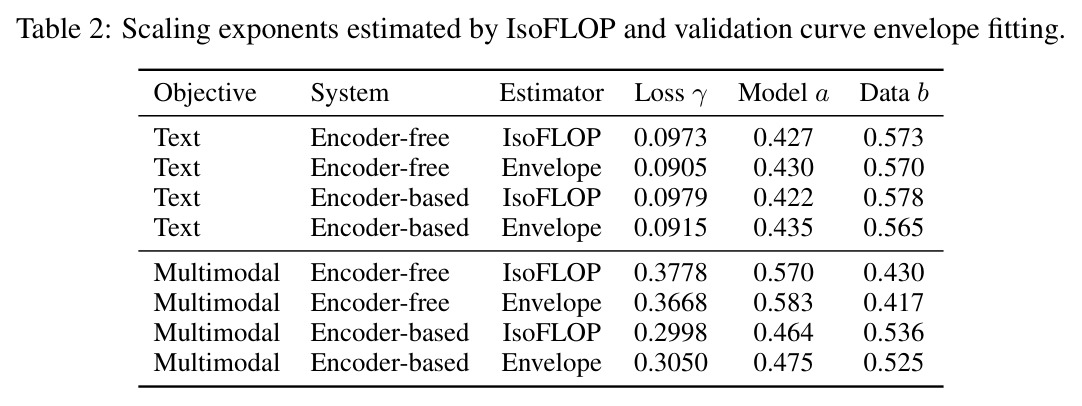
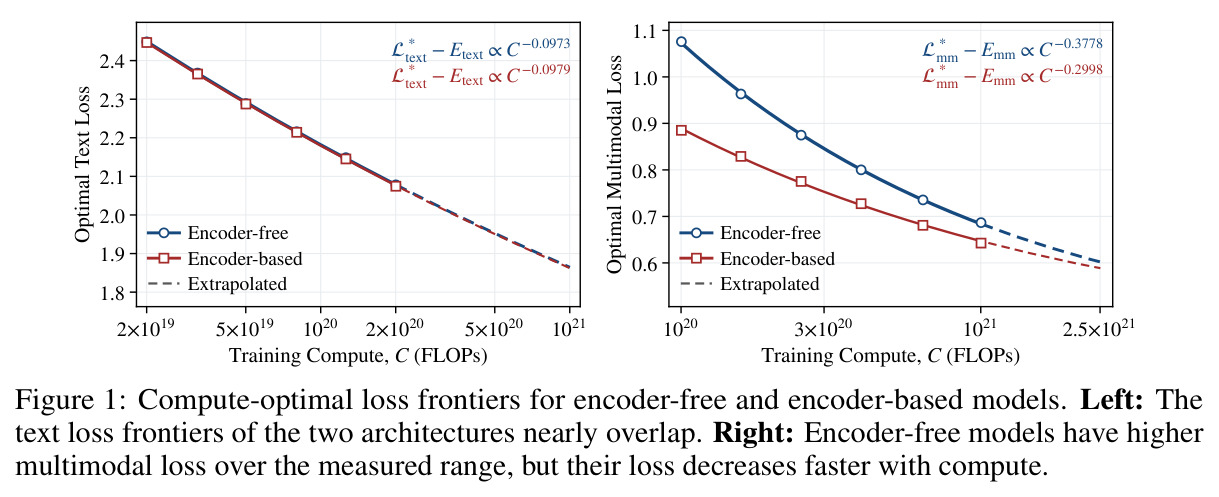
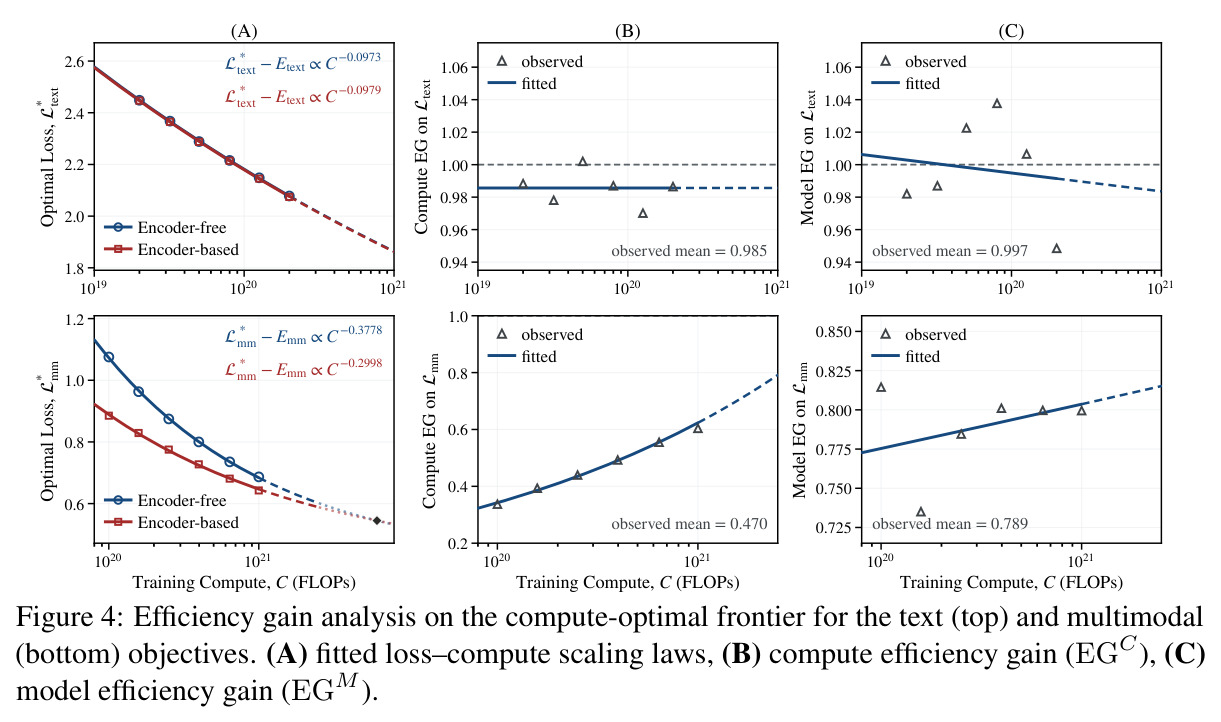
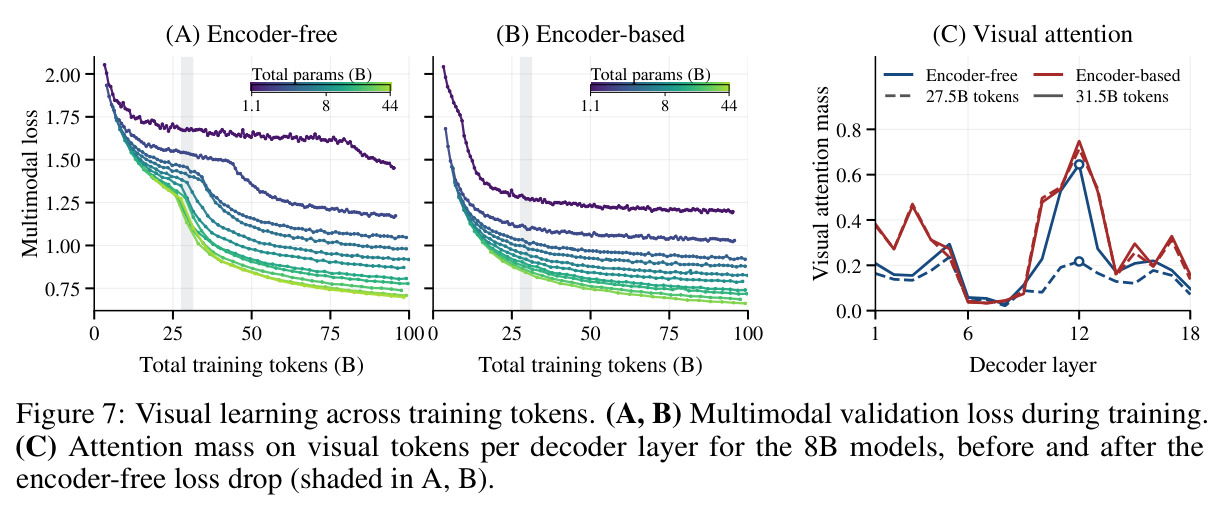
核心方法论创新是『受控变量 + 双目标缩放拟合 + 效率增益外推』的组合拳。与以往所有工作不同,本文把视觉编码器的有无作为唯一变量、其余一切对齐,使架构差异干净地映射到缩放定律参数上;文本目标充当阴性对照——两架构理应几乎一致,实测 $\gamma$ 为 0.0973 vs 0.0979,证明实验管道本身无偏,多模态目标上的差异才能归因于架构。拟合时强制两架构共享由数据分布决定的不可约损失 $E$(拟合值 $\hat{E}_{text}=0.607$、$\hat{E}_{mm}=0.403$):两架构在同一数据、同一下一 token 目标下训练,贝叶斯最优损失底理论上是同一个,这一约束防止架构差异被各自的熵底吸收而变得不可辨识。随后定义效率增益 $EG_C = C_{ref}(\lambda)/C_{tar}(\lambda)$(等损失下所需训练算力之比)与 $EG_M = M_{ref}(\lambda)/M_{tar}(\lambda)$(等损失下每 token FLOPs 之比),把参数差异转译成工程语言并外推 $EG_C = 1$ 的交叉算力。机制侧则用三个解码器内部探针(视觉 token 注意力质量、层间余弦相似度、按模态分解的专家负载 MaxVio)把损失行为与『解码器接管视觉编码』的因果故事挂钩。
方法步骤详情
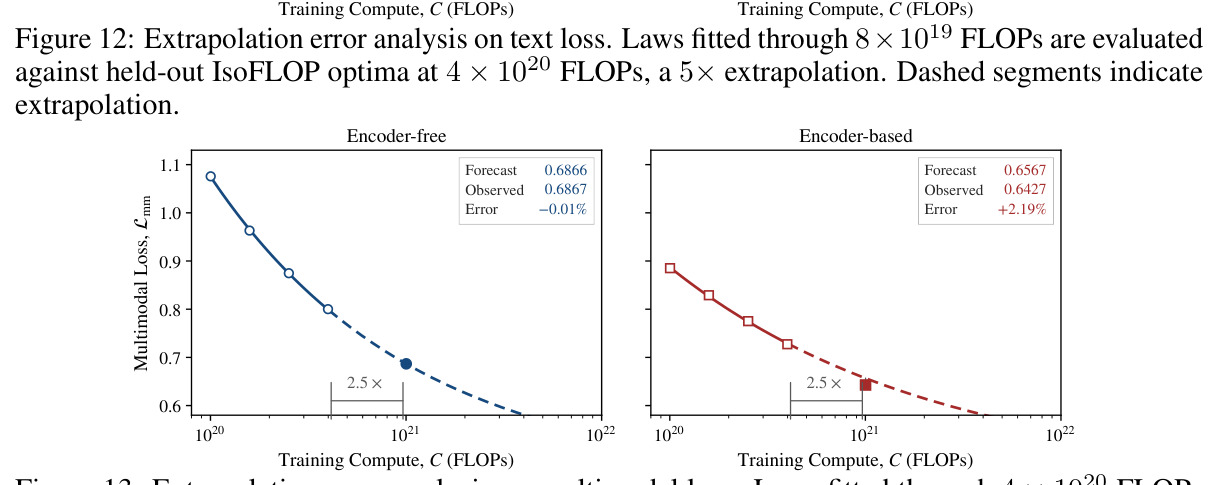
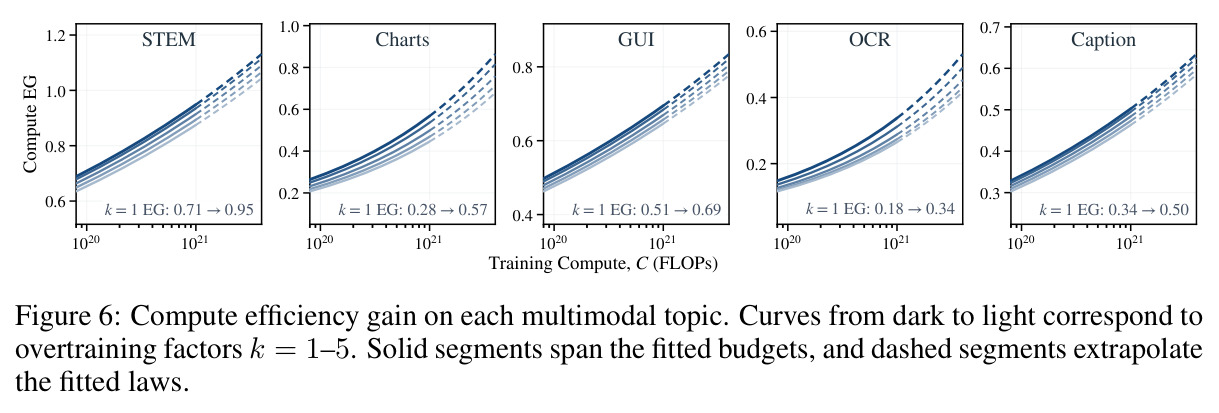
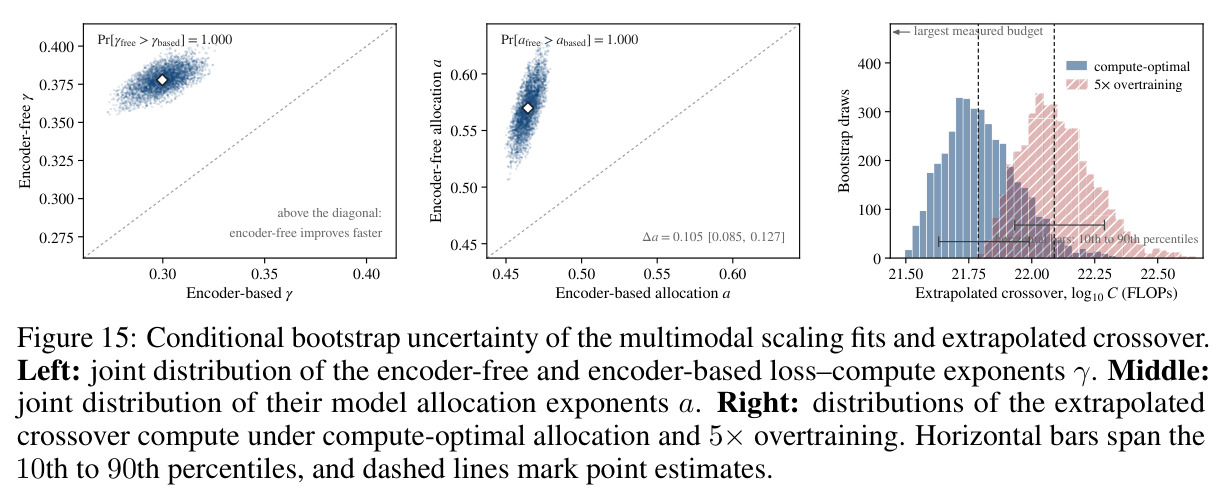
第一步,搭建匹配阶梯:11 级 MoE 解码器(总参 1.1B–44B,激活 71M–2.4B),每个 rung 内两架构使用完全相同的超参数(批量与学习率按内部缩放律随规模选取,2000 步 warmup,序列长度 4096)。第二步,训练:文本目标 IsoFLOP 预算 $2\times10^{19}$–$2\times10^{20}$、多模态目标 $1\times10^{20}$–$1\times10^{21}$ FLOPs 各 6 个对数等距点,每个预算内改变 $M$、令 $D = C/M$;所有模型吃同样的 1:1 文本/多模态混合语料,验证损失分纯文本与多模态主题统计(多模态损失只在文本 token 上计算,视觉位置被掩码但计入 $D_{mm}$)。第三步,IsoFLOP 拟合:每个预算内把验证损失对 $\log M$ 拟合二次曲线取顶点得 $M_{opt}(C)$,跨预算拟合 $M_{opt} \propto C^a$、$D_{opt} \propto C^b$ 与前沿律 $L^*(C) = E + KC^{-\gamma}$(两架构共享 $E$)。第四步,效率对比:在等损失点计算 $EG_C$、$EG_M$ 并外推交叉算力;过训练分析固定 $M = M_{opt}(C_{base})$、令 $D = kD_{opt}(C_{base})$(k=1–5),用乘子模型 $L(C_{base},k) = E + g(k)KC^{-\gamma_{base}}$ 修正预因子(k=5 时实测 $g$ 为 0.645/0.692)。第五步,按主题(STEM/Charts/GUI/OCR/Caption)重复效率分析。第六步,机制探针:统计陡降前后各层对视觉 token 的注意力质量、双向 vs 因果注意力的对照实验、各层表征与层 0 输入的余弦相似度、按模态拆分的专家 MaxVio。全程另有外推误差检验(留出预算验证误差在 2% 内)、验证曲线包络交叉验证、$E$ 敏感性分析和条件 bootstrap 不确定度量化。
技术新颖性
技术新颖性体现在四点。第一,这是首个在完全匹配的 MoE 阶梯上对『有无视觉编码器』做双目标缩放定律对比的工作:encoder-free 文献此前停留在可行性展示与单点改进,缩放定律文献从未把编码器当受控变量,二者从未交叉。第二,共享不可约损失 $E$ 的联合拟合设计巧妙——约束两架构的熵底相同,迫使差异进入 $K$ 和 $\gamma$,避免每个架构各自拟一个渐近线导致的不可辨识;并用网格扰动($E$ 在 0.05–1.45 倍间扫描)证明指数排序在任意取值下不变。第三,过训练分析从可分离损失 $L(M,D) = E + AM^{-\alpha} + BD^{-\beta}$ 出发推导出乘子 $g(k)$ 只缩放预因子、不改变 $\gamma$ 的结论,使 k=1–5 的过训练实验只需在小尺度补少量 run,成本极低。第四,机制探针与缩放预测互相印证成证据链:注意力质量在损失陡降处从 0.217 跳到 0.645、双向注意力收益随算力增长、视觉 token 在浅层被大幅重写而文本 token 轨迹不变、视觉专家路由集中而文本路由匹配——四个独立观测指向同一个结论,且因果注意力对照排除了掩码伪影,全口径(计入 ViT 算力)复核排除了记账方式的混淆。
实验结果
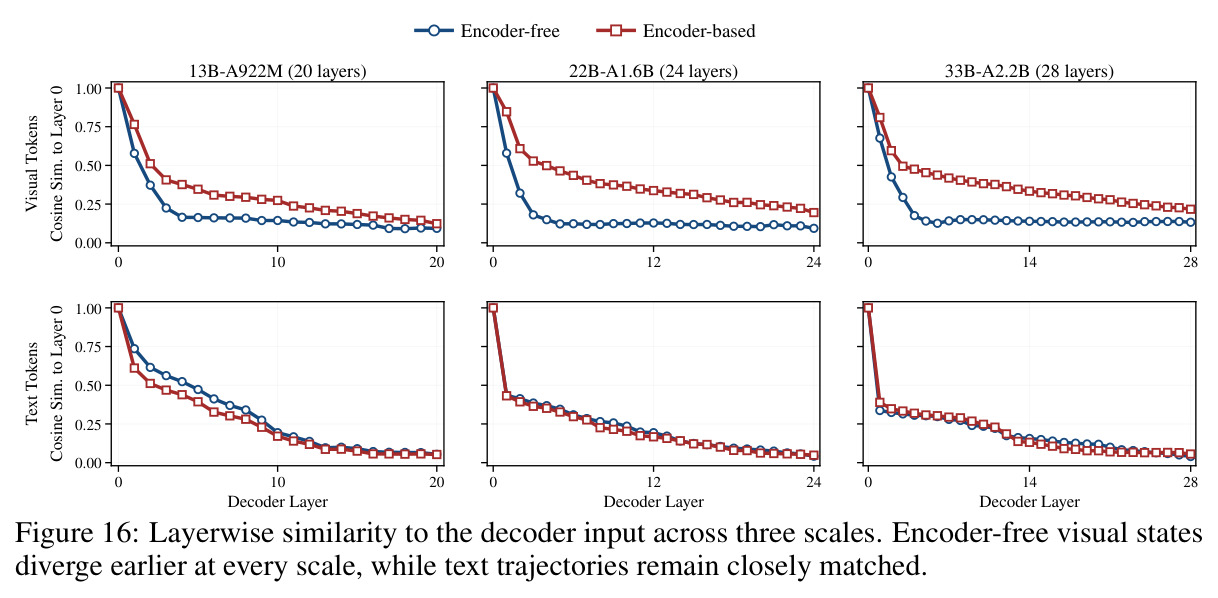
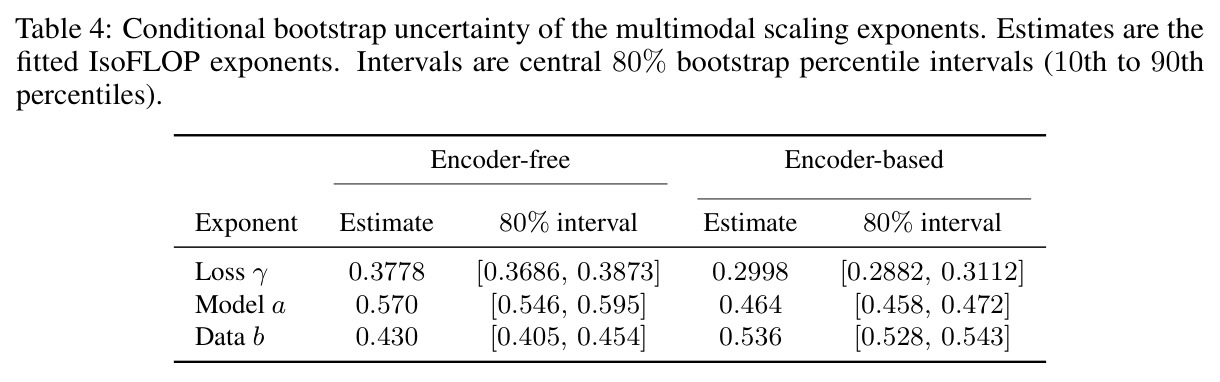
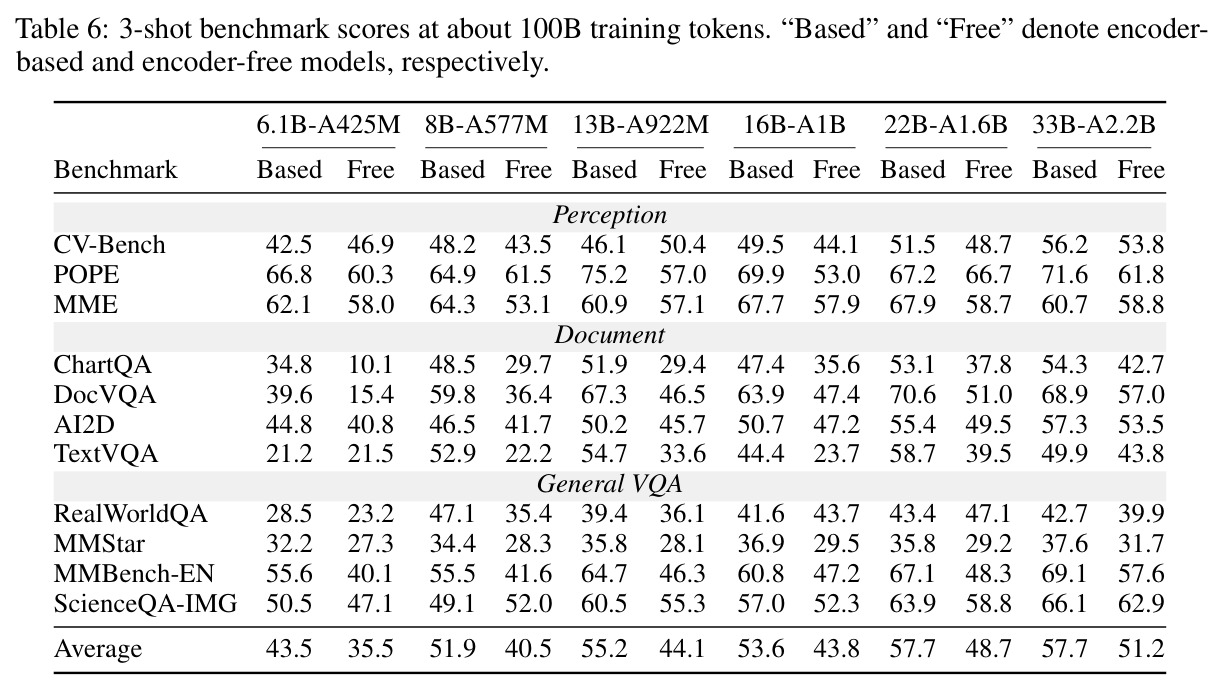
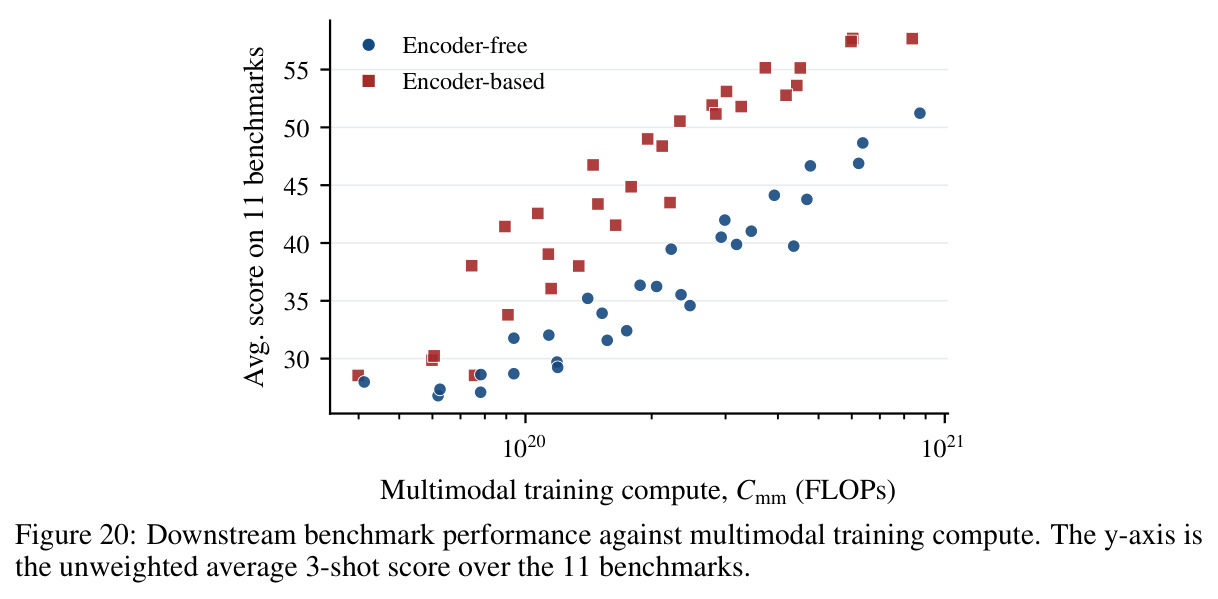
发现一(分配律,图 3、表 1):文本目标上两架构几乎一致($a=0.427$ vs $0.422$),多模态上去掉编码器使 $a$ 从 $0.464$ 升到 $0.570$(bootstrap 80% 区间 [0.546,0.595] vs [0.458,0.472],差值 $\Delta a = 0.105$ 在全部 4000 次重采样中为正),换成因果注意力仍有 $a=0.557$,排除掩码伪影。发现二(前沿与交叉,图 4–5、图 15):文本前沿几乎重合($\gamma=0.0973$ vs $0.0979$,$EG_C\approx0.98$、$EG_M\approx0.99$);多模态上无编码器目前更耗算力($EG_C$ 观测均值 0.470,最大预算处约 0.62),等损失下偏向约 1.25 倍每 token FLOPs 的更大解码器($EG_M\approx0.80$),但其 $\gamma=0.3778$ 显著大于有编码器的 $0.2998$($\Delta\gamma=0.0781$,区间 [0.0687,0.0876]),外推得到计算最优交叉点 $6.1\times10^{21}$ FLOPs(80% 区间 $[4.2,10.0]\times10^{21}$);5 倍过训练时推迟到 $1.2\times10^{22}$ FLOPs(区间 $[8.4,20]\times10^{21}$,此时 $EG_C$ 降至 0.52、$EG_M$ 0.74),仍比 Kimi K2.5 约 $10^{25}$ FLOPs 的预训练算力低约三个数量级。发现三(分主题,图 6):交叉时序与语言依赖度一致——STEM 已近持平($EG_C$ 0.71→0.95),Charts 0.28→0.57,GUI 0.51→0.69,OCR 0.18→0.34,Caption 0.34→0.50。发现四(机制,图 7–10):无编码器多模态损失先慢后陡降,8B 模型第 12 层对视觉 token 的注意力质量从 0.217 跳到 0.645;双向视觉注意力在多模态上随规模收益增大(因果 $EG_C=0.990$),文本上因果略优(1.011)但优势递减;视觉 token 在浅层就大幅偏离输入而文本 token 两架构轨迹一致;MaxVio 显示视觉 token 路由更集中而文本匹配。发现五(下游,图 20、表 6):11 个基准 3-shot 全部落后但差距随算力与模型规模收窄,约 100B token 时 33B rung 平均 51.2 vs 57.7。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多模态验证损失-计算前沿 | 损失-计算指数 $\gamma$ | 无编码器 $\gamma = 0.3778$(80% 区间 [0.3686, 0.3873]) | 有编码器 $\gamma = 0.2998$(80% 区间 [0.2882, 0.3112]) | $\Delta\gamma = 0.0781$:无编码器损失随算力下降显著更快,4000 次 bootstrap 全部为正 |
| 多模态计算最优分配 | 模型分配指数 $a$($M_{opt} \propto C^a$) | 0.570(双向注意力;因果注意力 0.557) | 0.464(双向注意力) | $+0.106$:无编码器最优解明显偏向更大模型、更少 token |
| 文本验证损失-计算前沿 | 损失-计算指数 $\gamma$ | 0.0973($a = 0.427$) | 0.0979($a = 0.422$) | 基本持平($EG_C \approx 0.98$,$EG_M \approx 0.99$),证明实验管道无偏、差异确由视觉输入引起 |
| 多模态等损失所需训练算力 | 计算效率增益 $EG_C$ | 最大拟合预算处约 0.62(5 倍过训练时 0.52) | 1.0(有编码器为参照) | 无编码器目前需约 1.6 倍算力,但差距随算力单调收窄,交叉点外推为 $6.1\times10^{21}$ FLOPs |
| 下游基准平均(3-shot、约 100B token、33B-A2.2B rung) | 11 个多模态基准平均分 | 51.2(无编码器) | 57.7(有编码器) | 仍落后 6.5 分,但差距小于 8B rung 的 11.4 分,随规模收窄趋势与损失一致 |
局限与改进
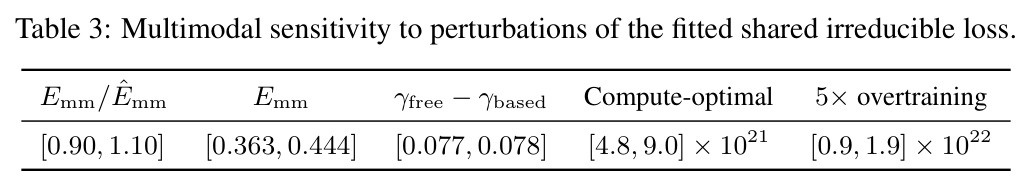
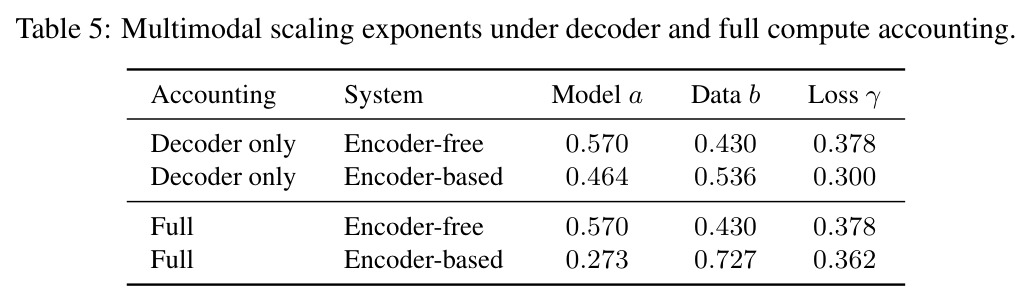
作者承认的局限:交叉点是对拟合区间外约半个到一个数量级的外推,依赖『拟合律持续成立、ViT 固定尺寸、共享不可约损失』三个假设;$E$ 的取值是结构性假设而非渐近识别,指数具体数值与外推交叉点对 $E$ 敏感($E_{mm}$ 在 ±10% 内扰动时交叉点在 $[4.8,9.0]\times10^{21}$ 与 $[0.9,1.9]\times10^{22}$ 间移动),尽管排序稳健;主要分析用解码器 FLOPs 口径,全口径下有编码器的 $\gamma$ 压缩到 0.362、差距从 0.078 收窄到 0.016。我自己的观察:其一,SigLIP 2 ViT 固定在约 400M,对 44B 解码器而言编码器占比趋零,『有编码器的视觉先验优势随规模消退』部分是这个实验设计的必然产物,联合缩放编码器可能改变结论;其二,无编码器前端是『裸』的 patch projection,没有蒸馏、对齐等已被证明有效的增强,Gemma 4 12B Unified、Inkling 等真实系统的起点更好,它们的交叉点可能更早;其三,数据配比固定 1:1,多模态数据占比是实际训练的关键自由度,未探索;其四,多模态损失只在文本 token 上计算,细粒度感知(定位、计数、OCR 级识别)未必被充分反映,3-shot 零微调下游评测也偏粗糙;其五,结论限于 top-8/256 的 MoE 家族、Muon 优化器与 4096 序列长度,向稠密模型或其他配置的迁移未验证。
独立分析的弱点
弱点一:外推可靠性。交叉点 $6.1\times10^{21}$ FLOPs 是在测量区间上界 $1\times10^{21}$ 之外约半个数量级的外推,真实缩放律常有曲率变化,虽然 $\Delta\gamma$ 的 bootstrap 区间不含零,但交叉点区间已横跨 $[4.2\times10^{21}, 1.0\times10^{22}]$,若作为工程决策依据需留足裕量。改进方向:在 $2$–$3\times10^{21}$ 附近补一个锚点预算直接验证。弱点二:固定 ViT 尺度削弱了有编码器一方的可比性。真实部署中编码器-解码器会联合缩放,固定 400M ViT 意味着小解码器时编码器占比过高、大解码器时编码器容量不足,双方都不是各自的最优形态。改进方向:补充编码器-解码器联合 IsoFLOP 扫描,求三维(解码器、编码器、数据)联合最优分配。弱点三:无编码器前端过于朴素。没有视觉 token 蒸馏、图文对齐或检测辅助损失,慢启动阶段(损失陡降前的 bootstrap 期)可能被人为拉长;这既是弱点也是机会——若用 SAIL 式辅助目标缩短 bootstrap 阶段,交叉点会比本文预测的更早,即当前结论对无编码器路线偏保守。弱点四:评测口径单一。下一个词预测损失加 3-shot 零微调下游,不足以刻画感知密集能力;应补充细粒度感知评测与指令微调后的评测,确认『Caption/GUI/OCR 交叉更晚』在下游同样成立。弱点五:单一架构家族。MoE top-8/256、Muon、4096 序列长度都是单点取值,稠密模型、不同激活率、其他优化器下 $a$ 与 $\gamma$ 的差是否保持未知,而结论的外推恰恰依赖这些参数的稳定性。
未来方向
作者明确提出的方向:设计显式面向原生视觉表征学习的解码器架构与训练策略,而不是直接继承为语言设计的组件——例如视觉 token 专属的注意力模式、层布局或专家配额。基于本文成果可以延伸的方向:其一,直接在 $10^{22}$ FLOPs 量级训练验证交叉预测,这对工业界是完全可负担的实验,也是对本文最大胆主张的终极检验;其二,把 $a\approx0.57$ 的分配指数转化为无编码器训练配方——给定预算应选更大模型、更少 token,并与推理成本联合优化选点;其三,针对慢启动现象设计课程学习:先以语言依赖型数据(STEM/Charts)启动训练,待视觉表征 bootstrap 完成后再引入感知密集型数据,或用蒸馏信号给视觉 token 提供早期梯度;其四,双向视觉注意力的收益随算力增大,提示探索『分块双向 + 全局因果』的混合注意力,或仅在前若干层开放双向的结构;其五,把机制探针(层间余弦相似度、模态化 MaxVio、注意力质量)发展成训练中的实时诊断指标,用于检测视觉表征是否完成 bootstrap、是否需要干预;其六,把同样的受控对比扩展到统一理解+生成架构以及视频、3D 输入,检验『视觉先验优势随规模消退』是否为普适规律,并研究编码器-解码器联合缩放下交叉点如何移动。
复现评估
复现门槛很高,但方法透明度是同类工业研究的上游水平。算力方面:本文训练了两套 11 级 MoE 阶梯、各 6 个 IsoFLOP 预算(文本最大 $2\times10^{20}$、多模态最大 $1\times10^{21}$ FLOPs),外加 $4\times10^{20}$ 与 $1\times10^{21}$ 的外推验证点、k=2–5 的过训练 run 以及 44B 总参模型,总训练量估计在 $10^{21}$–$10^{22}$ FLOPs 量级,远超学术实验室常规预算,完整复现基本只有大厂前沿团队可行。透明度方面:附录给出了完整细节——SigLIP 2 前端与 Gemma 4 式 patch projection 的逐层结构、训练设置(Muon、2000 warmup、序列 4096、超参随规模选取)、拟合流程(IsoFLOP、验证曲线包络、Huber 回归、共享 E 的联合最小二乘、条件 bootstrap 协议)、$g(k)$ 的完整推导、外推误差分析(5 倍外推误差 1% 内)与敏感性分析,方法论可以在小尺度阶梯上低成本模仿验证。论文未提及代码或模型开源;训练语料为内部数据(1:1 文本/多模态,覆盖 caption、charts、grounding、GUI、OCR、STEM、知识等主题),不开源则数值层面的严格复现不可能。可行的替代路径:用公开数据按相同配比在 ≤1B 的小阶梯上重演文本对照与多模态定性趋势,重点验证 $\Delta a$、$\Delta\gamma$ 的符号而非具体数值。
论文图表