RenderRank:用压缩视觉令牌学习文本重排序 RenderRank: Learning to Rerank Text with Compressed Visual Tokens
将文档渲染为图像并压缩成视觉令牌做重排序:令牌减少16.5%–35.5%,精度反超同级文本模型
前置知识
重排序器与交叉编码器
重排序是检索流水线的第二阶段:BM25 等召回器先从海量语料取回 top-k 候选,交叉编码器再把查询与每个候选文档拼接为一条输入,建模词级交互后输出一个相关性分数并重新排序。由于每个候选都要单独过一遍模型,计算成本随候选数线性增长,输入序列长度直接决定整体开销。
本文的全部动机源于重排序“逐候选打分”的成本结构——令牌节省会被候选数量成倍放大,这是理解 RenderRank 价值的前提。
视觉令牌与视觉文本压缩
视觉语言模型(如 Qwen3-VL)把图像切成 16×16 像素的图块,经 2×2 空间合并后生成视觉令牌序列送入语言解码器。视觉文本压缩指不把文本当文字、而是渲染成图片再编码:一张 896×896 像素的图约对应数百个视觉令牌,却能容纳整页文字,因此同样的文档内容可用更短的序列表示。
RenderRank 的效率收益全部来自“文档→渲染图像→更少视觉令牌”这条路径,而渲染字号、行距决定了压缩率与可读性之间的权衡。
BEIR 与 NDCG@10
BEIR 是零样本信息检索基准集合,涵盖 ArguAna、FEVER、HotpotQA、TREC-COVID 等异构任务;NDCG@10 衡量排序质量,综合前 10 位结果的相关性等级与位置折扣,取值 0–100、越高越好。本文在 11 个 BEIR 数据集上对 BM25 召回的 top-100 重排序并报告平均 NDCG@10。
论文所有核心结论都用该指标表达,例如 55.96 与 57.99 的对比意味着什么,取决于对 NDCG@10 的理解。
分数级知识蒸馏
知识蒸馏让小模型(学生)模仿大模型(教师)的输出。分数级蒸馏不要求对齐教师的隐层特征或词级分布,只要求学生在相同输入对上回归教师给出的相关性分数,例如最小化均方误差 $\mathcal{L}=\mathbb{E}[(s_\theta-t)^2]$。由于只在分数层面约束,师生输入可以是长度不同、模态不同的序列。
RenderRank 第一阶段正是靠这一机制把文本教师 Qwen3-Reranker-4B 的判别能力迁移到“文本查询+文档图像”的学生输入上。
InfoNCE 对比损失
InfoNCE 在一个正样本与若干负样本之间做 softmax 式对比:给定查询 $q_i$ 及候选集,损失为 $-\log\frac{e^{s(q_i,d^+_{i})}}{e^{s(q_i,d^+_{i})}+\sum_j e^{s(q_i,d^{-}_{i,j})}}$,逼迫正文档得分显著高于同查询的负文档,温度系数控制对比难度,学到的是候选之间的相对序而非绝对分值。
RenderRank 第二阶段用查询局部的 InfoNCE 在蒸馏基础上精调相对排序,是最终 NDCG 提升的直接来源。
LoRA 与 ReLoRA
LoRA 冻结原有权重,只训练注入的低秩增量 $\Delta W=BA$(秩 $r\ll d$),大幅降低显存与算力需求。ReLoRA 提出“合并再初始化”:定期把 LoRA 增量合并回主干,再重置新的适配器继续训练,从而用一系列低秩更新累积出高秩的有效更新。
RenderRank 冻结视觉编码器、只对文本解码器加 LoRA,并在两阶段训练之间按 ReLoRA 方式合并适配器,理解这点才能复现其训练流程。
研究动机
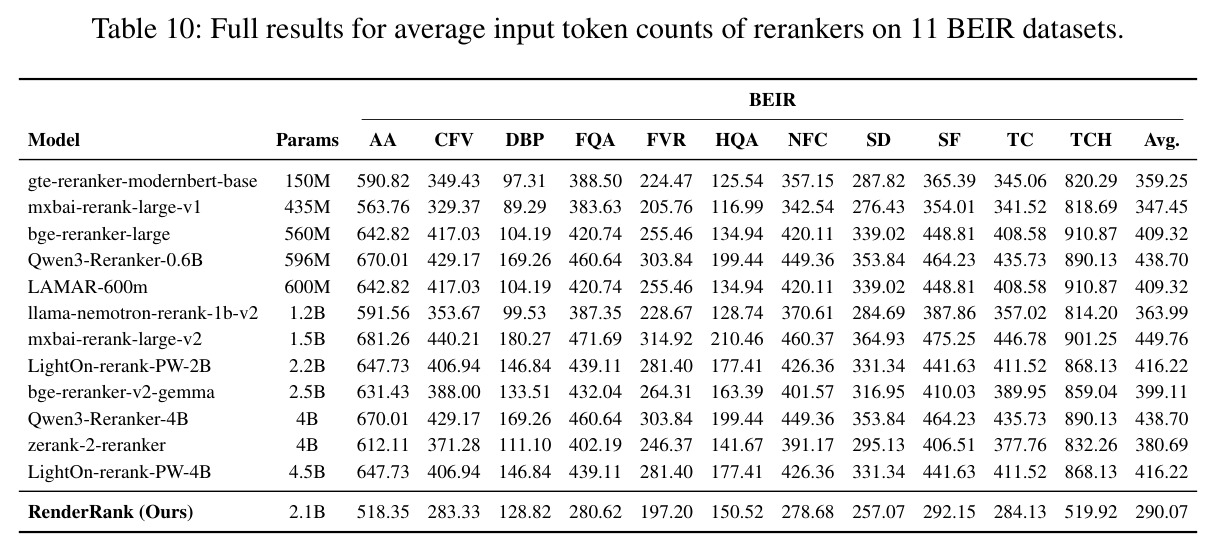
RAG 流水线依赖重排序器为每个查询的候选文档逐一打分,而交叉编码器要求查询与文档拼成一条输入,令牌开销随候选数量成倍放大。以 BEIR 上的主流文本重排序器为例,每个查询-文档对的平均输入长度在 347.45–449.76 个令牌之间,重排 BM25 的 top-100 候选意味着每个查询要处理数万个令牌;在 MLDR 等长文档场景下情况更糟,基线模型的平均输入高达约 8,600–13,900 令牌。直接截断输入虽能省算力,但会丢弃判断相关性所需的证据与上下文,损害排序质量(Li et al., 2023)。因此亟需一种能用更少令牌表示同一文档、又不丢失相关性信息的文档表示方法。
本文的目标是本文的目标是证明“压缩视觉表示”可以支撑精准的查询相关文档打分:把文档文本渲染成图像,用视觉语言模型现成的视觉编码器转换为数量更少的视觉令牌,并训练一个 2.1B 参数的重排序器从“文本查询+视觉文档”中预测与文本教师一致的相关性分数。具体量化目标包括:在 11 个 BEIR 数据集上以 16.5%–35.5% 的输入令牌削减,达到不逊于同级文本重排序器的平均 NDCG@10;在长文档数据集上以约一半的输入长度取得相当或更优的排序质量与更高的吞吐,从而在同等序列长度限制下让更多文档内容参与相关性判断。
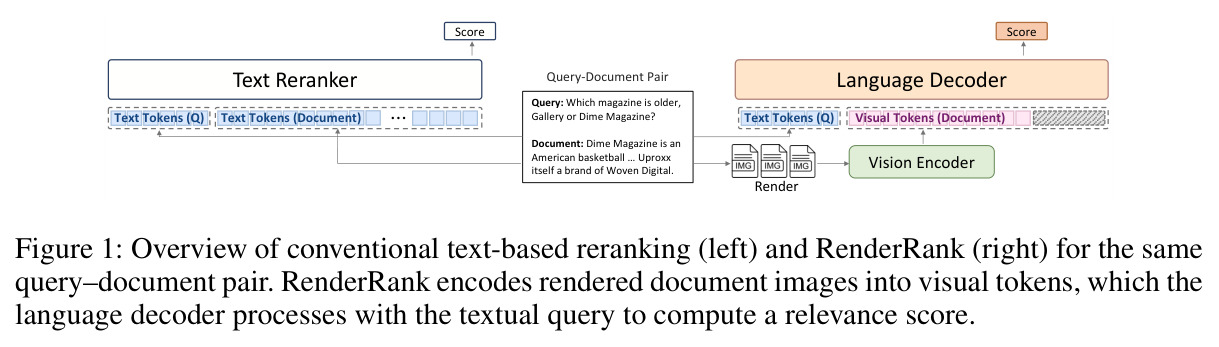
与已有工作不同的是,已有工作分三条路:一是视觉文本压缩,但只用于问答、摘要等生成任务(如 Glyph),未验证其能否支撑“与查询相关与否”的判别式打分;二是图文重排序,处理的是原生图片而非文本渲染图,且多依赖列表式打分或查询相关的视觉令牌选择等复杂机制;三是学习式压缩表示,需要把压缩器与重排序器联合训练,或修改模型内部的 KV 选择/令牌池化结构。RenderRank 的独特切入是:直接复用现成 VLM 冻结的视觉编码器作为“免训练压缩器”,用分数级跨模态蒸馏把文本教师的打分能力迁移到视觉输入,再用查询局部对比学习精调候选间的相对分序;文档图像可离线预计算并缓存,推理时每个候选只需一次前向。
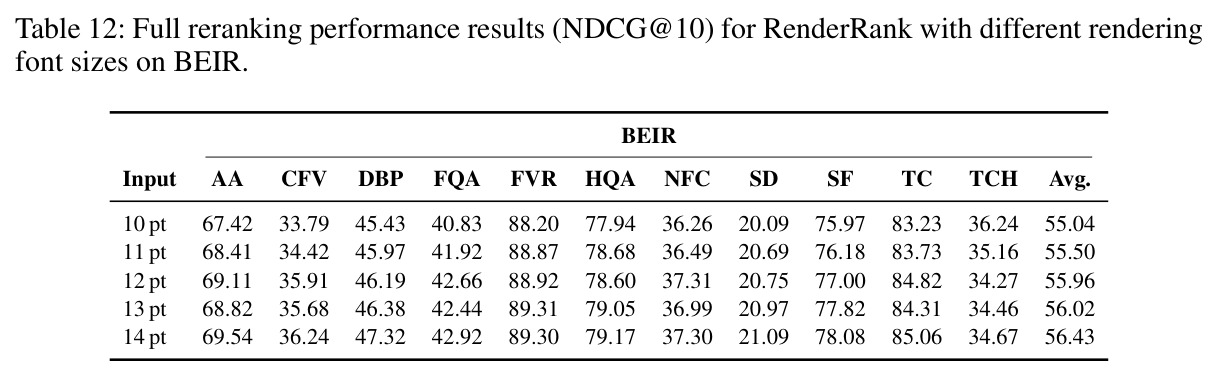
核心方法
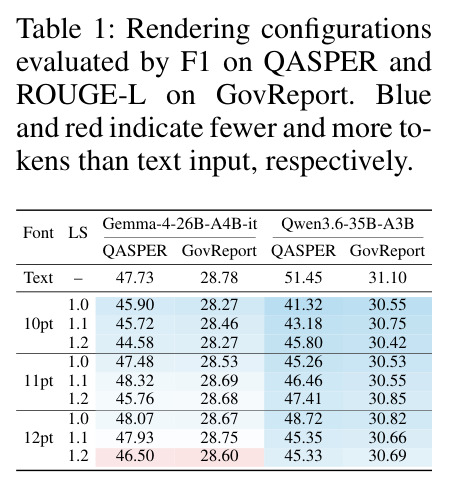
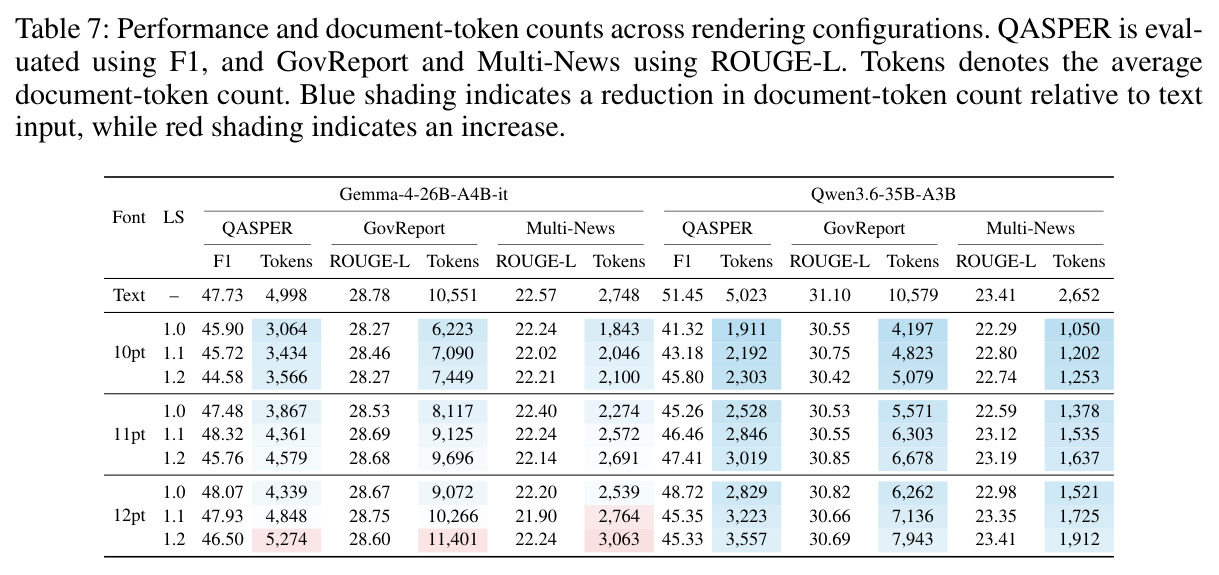
直觉上,一页文字渲染成图片后,视觉编码器能用远少于文字令牌的视觉令牌承载同样内容,语言模型理论上可以“看图”判断文档与查询是否相关,缺的只是把相关性打分能力对齐到视觉输入上。技术路线分三步:首先确定渲染配置——用 QASPER 问答(F1)与 GovReport 摘要(ROUGE-L)在 Gemma-4-26B-A4B-it 和 Qwen3.6-35B-A3B 上对比字号与行距,最终选定 Roboto Regular、12pt、行距 1.0,以 96 DPI 渲染成 896 像素定宽、高度按 32 像素递增(最高 896 像素)的图像,长文档拆成多页顺延;然后以 Qwen3-VL-Reranker-2B 为底座,冻结视觉编码器与特征合并器,只在文本解码器上加 LoRA 训练;训练分两阶段——先做跨模态相关性蒸馏(MSE 回归文本教师分数),再做查询局部相关性判别(InfoNCE 拉开正负文档分差)。推理时文档图像的视觉嵌入可预先离线算好,查询与缓存令牌一次前向即可打分。
核心创新是“分数级跨模态蒸馏 + 渲染密度可调的免训练压缩”。与需要联合训练压缩器的学习式压缩不同,RenderRank 用冻结的现成视觉编码器把文档压成视觉令牌,压缩率由渲染字号、行距等排版参数控制,无需任何额外训练即可调节质量-效率权衡。与逐令牌对齐的特征蒸馏不同,其蒸馏目标只作用在相关性分数层面:$\mathcal{L}_{\mathrm{CMRD}}=\mathbb{E}_{(q,d)\sim D}\left[\left(s_\theta(q,R(d))-t(q,d)\right)^2\right]$,其中 $s_\theta$ 是学生对视觉输入的打分、$t$ 是教师对文本输入的打分;由于只约束分数,师生输入长度不同、模态不同也无需令牌级对应,文本重排序器的判别能力因此得以平移到视觉输入。第二阶段的查询局部判别 $\mathcal{L}_{\mathrm{QLRD}}$ 用同查询候选集上的 InfoNCE 精调相对分序,弥补蒸馏只学绝对分值、不学候选间相对关系的不足。
方法步骤详情
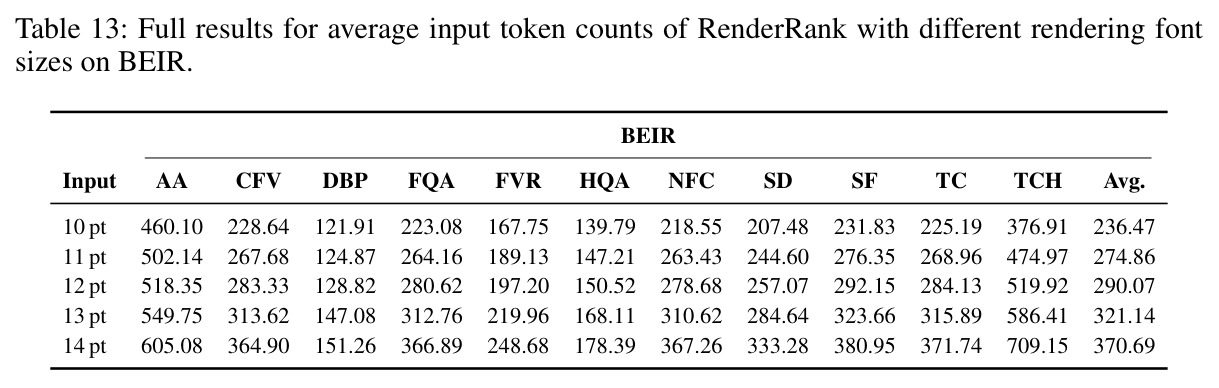
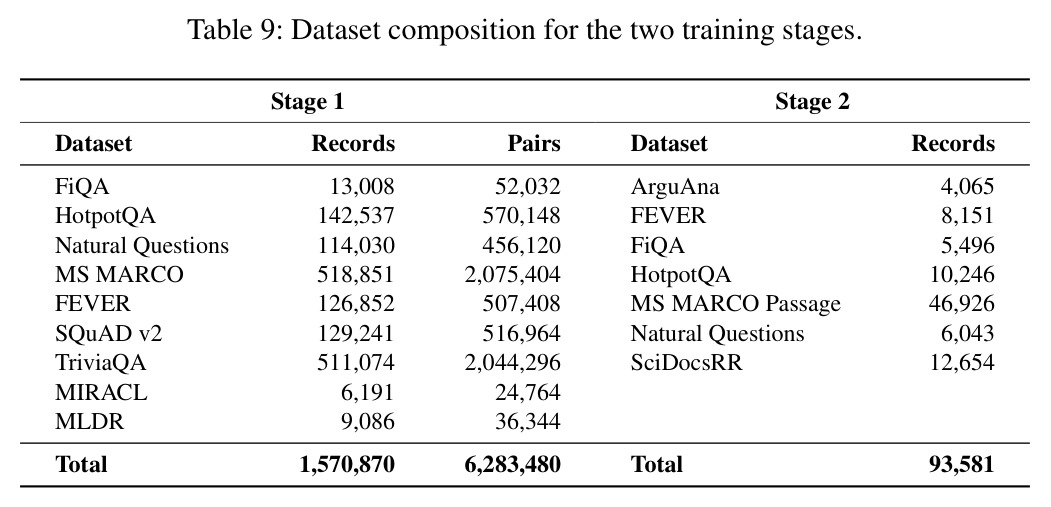
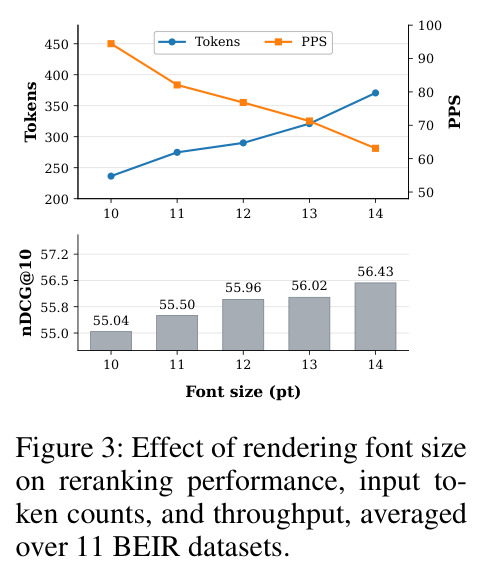
第一步,渲染配置选择:实验测得 12pt+行距1.0 在令牌削减与性能间最平衡(Qwen3.6 的 QASPER F1 从 10pt 的 41.32 升到 48.72,文档令牌从 5,023 降到 2,829),而 12pt 下加大行距只增令牌不提分,故定稿该配置。渲染前把所有空白字符规范化为单空格,黑字白底零边距,按像素宽度折行,每页最多 56 行、高 896 像素,超出内容顺延下一图。第二步,数据准备:阶段 1 用 LightOn 发布的英文检索微调数据 1,570,870 条(每条 1 正 10 负),取 1 正 3 前序负例拆成 6,283,480 个查询-文档对,教师 Qwen3-Reranker-4B 对原始文本对打分;阶段 2 用 RLHN-100K 的 93,581 条记录,每查询取 1 正 7 负构成候选集。第三步,两阶段训练:阶段 1 最小化 $\mathcal{L}_{\mathrm{CMRD}}$,总批量 1,024 对;阶段 2 在候选集内做温度 0.1 的 InfoNCE,$\mathcal{L}_{\mathrm{QLRD}}=-\frac{1}{N}\sum_{i=1}^{N}\log\frac{\exp s_\theta(q_i,R(d_i^+))}{\exp s_\theta(q_i,R(d_i^+))+\sum_{j=1}^{K}\exp s_\theta(q_i,R(d_{i,j}^-))}$,批量 128。两阶段各训 1 个 epoch、学习率 $5\times10^{-5}$、LoRA 秩 64/α=128/dropout 0.05、最大序列长 32,768,视觉编码器与合并器全程冻结,阶段间按 ReLoRA 合并适配器后重新初始化,共使用 8 张 RTX A6000 48GB。
技术新颖性
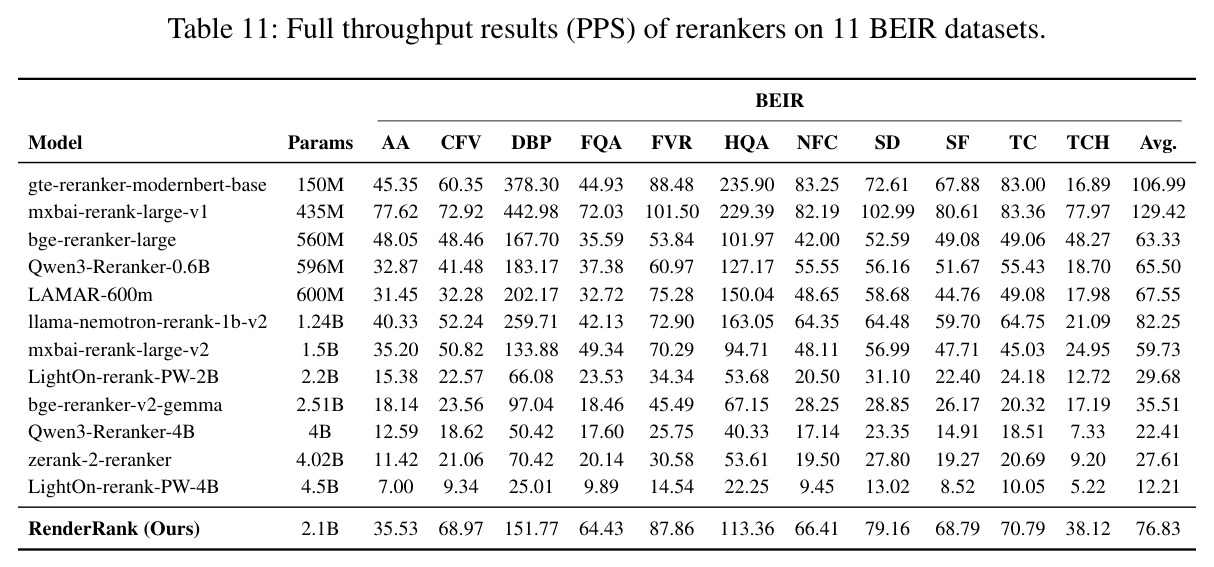
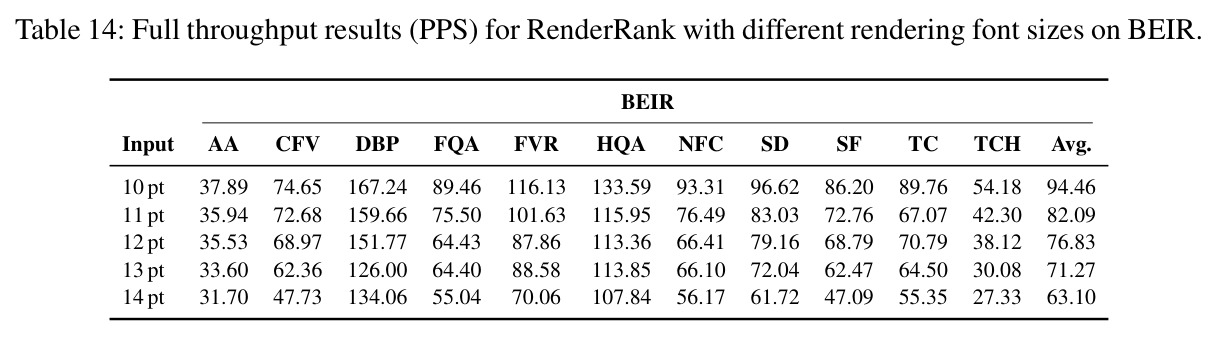
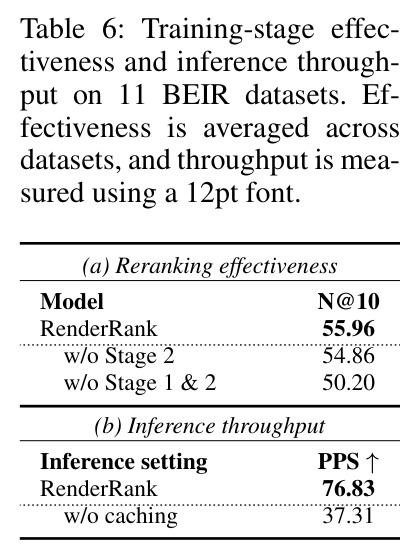
技术新颖性体现在三处。其一,压缩器零训练:不同于把压缩器与重排序器联合训练的内存令牌方法(Déjean & Clinchant, 2026),或在模型内部做 KV 选择、中间层池化的方案(Lu et al., 2026; Zhuang et al., 2026),本文证明现成 VLM 的视觉编码器本身就是合格的文档压缩器,冻结即可用,训练开销只有 LoRA。其二,跨模态分数蒸馏:Hofstätter 等的跨架构蒸馏仍在同模态文本间进行,本文把蒸馏扩展到“文本教师→视觉学生”,且只在分数层面约束,天然兼容长度不等的图文序列。其三,渲染密度即压缩旋钮:字号从 10pt 到 14pt 时令牌从约 236 涨到 371、NDCG@10 从 55.04 升到 56.43,压缩率可在部署时按需调整而无需重训,这是学习式压缩难以提供的灵活性。此外,缓存视觉嵌入后吞吐从 37.31 翻倍至 76.83 PPS,设计上贴合重排序“文档不变、查询多变”的实际场景。
实验结果
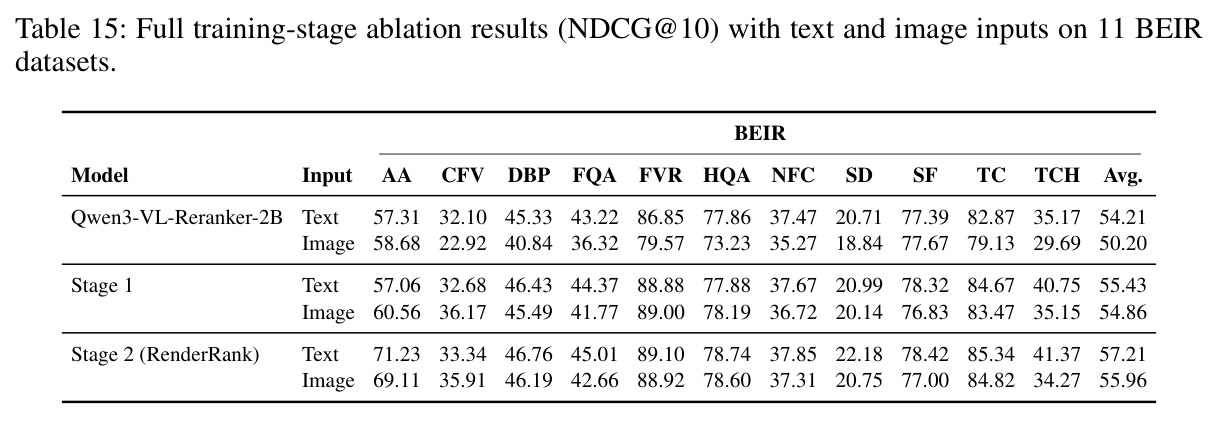
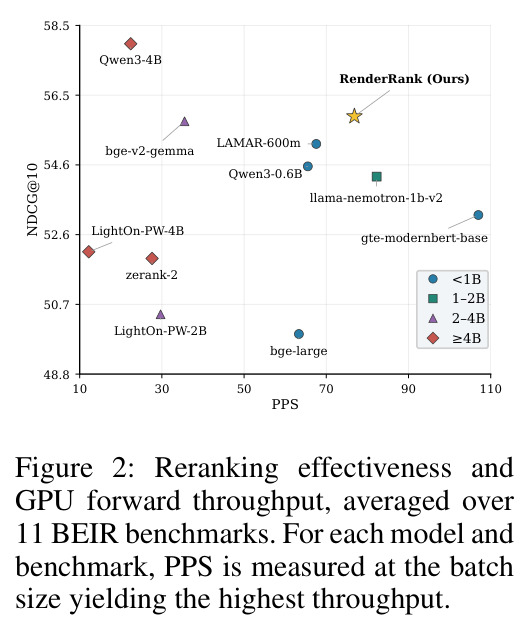
BEIR 主实验(Table 2):RenderRank(2.1B)平均 NDCG@10 达 55.96,超过所有参数量小于 4B 的基线(最佳为 bge-reranker-v2-gemma 的 55.82),也胜过 4B 的 zerank-2-reranker(相对提升 7.66%)与 4.5B 的 LightOn-rerank-PW-4B(+7.26%),但仍低于其 4B 文本教师 Qwen3-Reranker-4B 的 57.99;其平均输入仅 290.07 令牌,比基线(347.45–449.76)少 16.5%–35.5%。计算成本(Table 3,E2R-FLOPs 估计):每对 0.63 TFLOPs、QPP 20.1,对比 bge-v2-gemma 的 1.10 TFLOPs 与 12.3 QPP,同预算下能处理更多查询。实测吞吐(Figure 2,单张 A6000):76.83 PPS,约为 bge-v2-gemma(35.51)的 2.16 倍,甚至高于仅 600M 的 LAMAR-600m(67.55),说明估计 FLOPs 低不等于吞吐高。长文档实验(Table 4,MLDR+3 个 LongEmbed 数据集):平均 NDCG@10 88.27,略超 zerank-2(88.26)与 Qwen3-4B(88.15);MLDR 上 99.74 分、输入 4.20K 令牌约为基线(8.6K–8.9K)的一半;LongEmbed 上比最省令牌的基线少 53%–57%;平均吞吐 4.51 PPS,是最快基线 Qwen3-0.6B(2.66)的 1.70 倍,各数据集加速 1.55×–1.91×。固定预算实验(Table 5):在 2K/4K/8K 最大长度下分别取得 97.9/99.5/99.7 全场最佳,2K 成绩已超 gte 与 LightOn-PW-4B 在 4K 的 95.8/97.3。消融(Table 6 与附录 Table 15):底座直接用图像输入仅 50.20,加跨模态蒸馏升至 54.86,加查询局部判别达 55.96;值得注意的是训练后模型改用文本输入可达 57.21,反超底座文本输入的 54.21,说明两阶段训练对文本能力也有增益。缓存消融:预计算视觉嵌入使吞吐从 37.31 翻倍到 76.83 PPS。
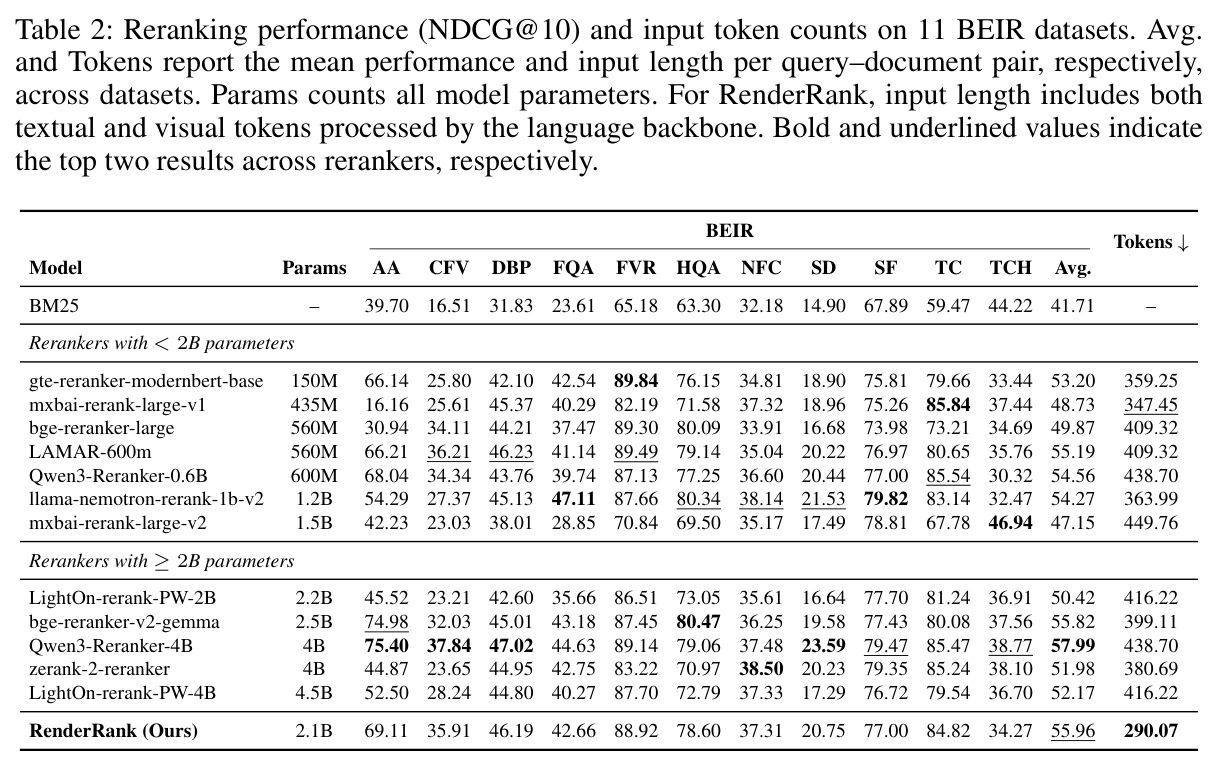
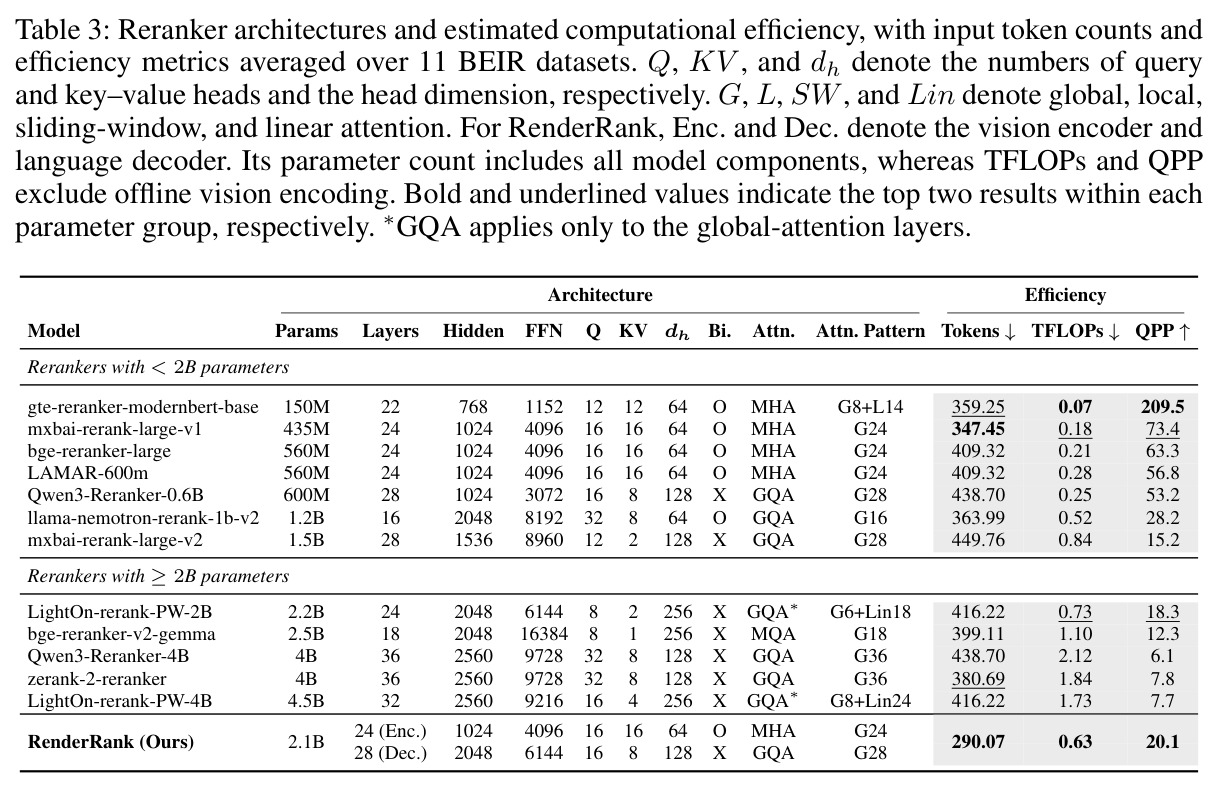
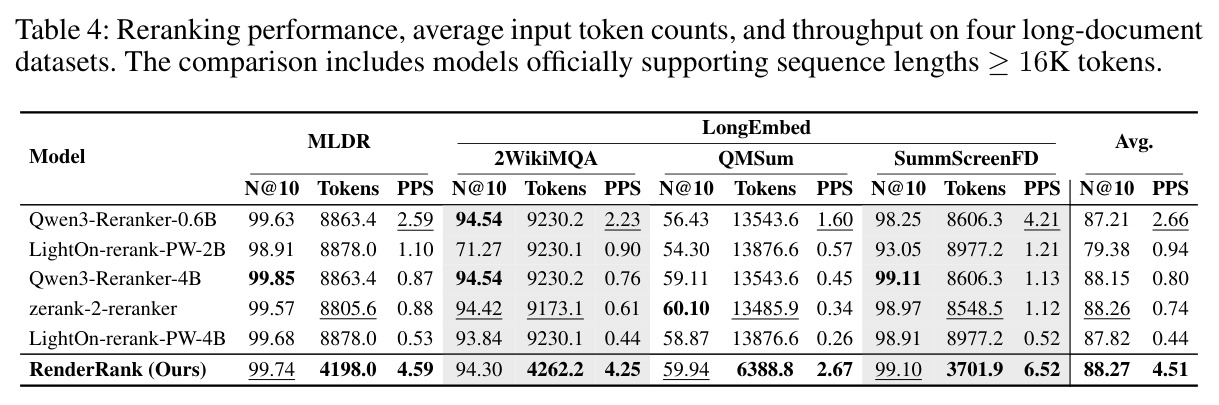
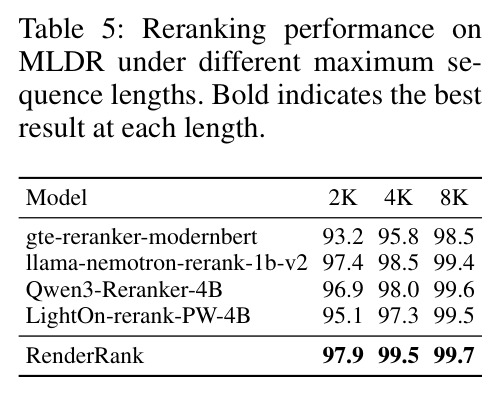
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BEIR 11 数据集重排序(BM25 top-100) | NDCG@10(平均) | 55.96(2.1B) | 最佳 <4B 基线 bge-reranker-v2-gemma 55.82;文本教师 Qwen3-Reranker-4B 57.99 | 超过所有 <4B 文本基线及 4B/4.5B 的 zerank-2(+7.66%)与 LightOn-PW-4B(+7.26%);落后 4B 教师 2.03 分 |
| BEIR 输入长度效率 | 平均输入令牌数/查询-文档对 | 290.07 | 347.45(mxbai-v1)– 449.76(mxbai-v2) | 令牌减少 16.5%–35.5% |
| BEIR 计算成本估计(E2R-FLOPs) | TFLOPs/对 ↓ 与 QPP ↑ | 0.63 TFLOPs,QPP 20.1 | bge-reranker-v2-gemma:1.10 TFLOPs,QPP 12.3 | 每对计算省约 42.7%,单位算力处理查询数提升约 63% |
| BEIR 实测推理吞吐(A6000) | PPS(对/秒) | 76.83 | bge-reranker-v2-gemma 35.51;LAMAR-600m 67.55;Qwen3-Reranker-4B 22.41 | 约为同精度 bge-v2-gemma 的 2.16 倍,快于更小的 LAMAR-600m |
| 长文档重排序(MLDR + 2WikiMQA/QMSum/SummScreenFD) | NDCG@10(平均)/ PPS | 88.27,4.51 PPS(MLDR 99.74,4.20K 令牌) | zerank-2 88.26、Qwen3-4B 88.15;最快基线 Qwen3-0.6B 2.66 PPS | 精度略优;吞吐 1.70×(各数据集 1.55×–1.91×);LongEmbed 令牌再省 53%–57% |
| MLDR 固定长度预算(2K/4K/8K) | NDCG@10 | 97.9 / 99.5 / 99.7(全部最佳) | gte-reranker 93.2/95.8/98.5;LightOn-PW-4B 95.1/97.3/99.5 | 2K 成绩超过基线在 4K 的表现,4K 即接近文本模型 8K 水平 |
局限与改进
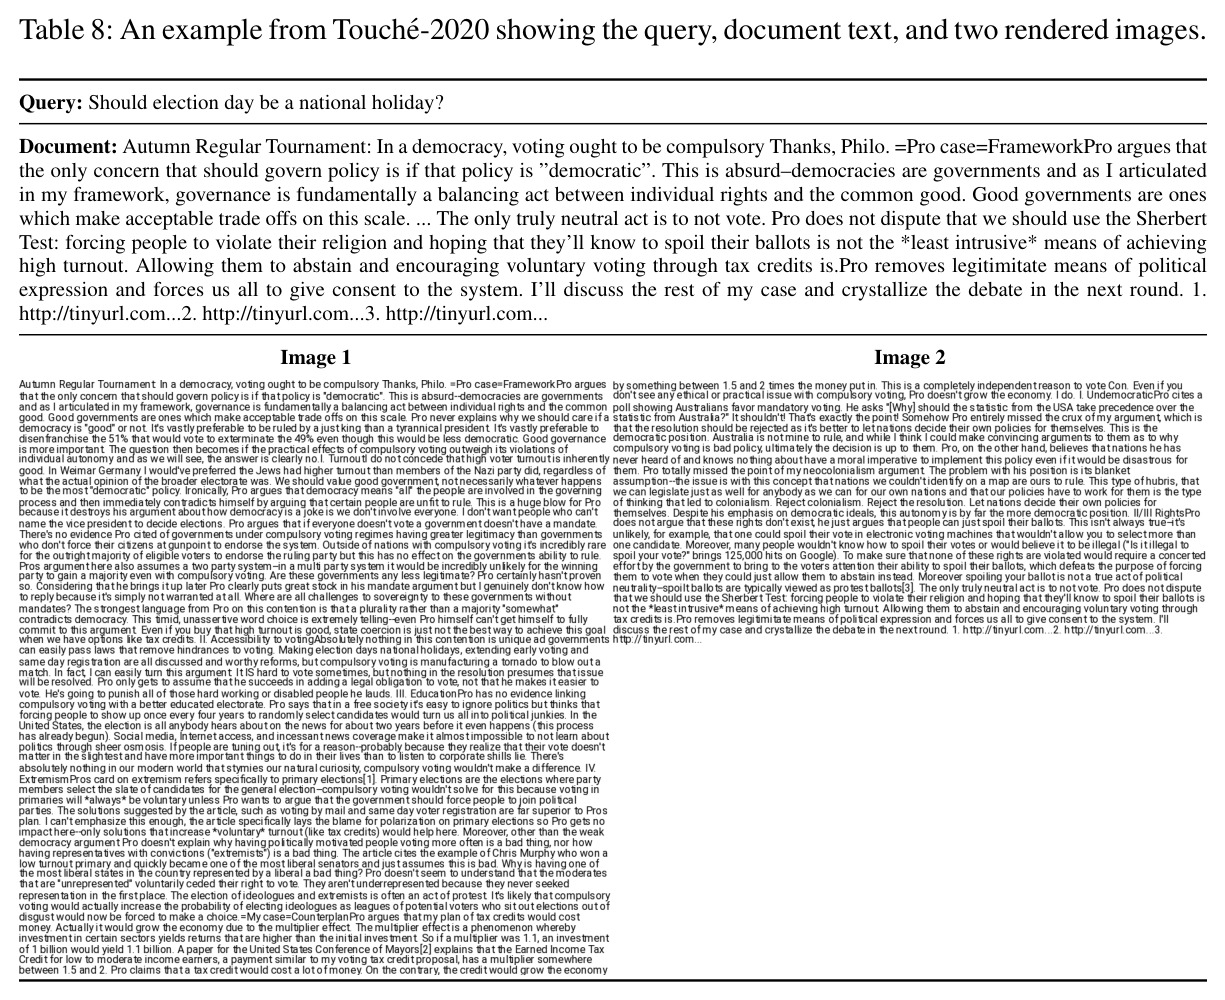
作者层面可证的局限:其一,与最强 4B 文本教师仍有 2.03 分差距(55.96 vs 57.99),视觉压缩确实损失了部分信息;其二,同一模型文本输入可达 57.21,图像输入只有 55.96,模态转换本身带来约 1.25 分损失;其三,TFLOPs/QPP 指标显式排除了离线视觉编码的开销,吞吐测试也假设视觉嵌入已预计算,端到端成本(渲染时间、图像编码、存储与缓存管理)未计入。我自己的观察:在 ArguAna(69.11 vs Qwen3-4B 的 75.40)和 Touché-2020(34.27 vs mxbai-v2 的 46.94)这类需要把握长篇论证结构的任务上劣势明显——渲染前的空白符规范化抹掉了段落与版面边界,可能伤害篇章级推理;渲染配置仅用两个大型 MLLM 做了选择实验,结论向其他 VLM 的可迁移性未知;训练与评测全部限于英文;对表格、代码、公式等结构化内容,按像素宽度折行的纯文本渲染基本失效。
独立分析的弱点
弱点一,长程论证理解不足:ArguAna 需要从数千字候选中找反论,分页渲染打散了跨页论证链,视觉令牌也难以携带篇章结构信号。改进方向:引入保留段落/标题层级的版面感知渲染,或设计跨页注意力机制。弱点二,压缩率与页数耦合:超长文档拆多页后视觉令牌随页数线性增长,QMSum 上仍有 6,388 令牌;可借鉴多压缩率训练(Wang et al., 2026)或对每页再做令牌剪枝/聚类,把长文档压到更低预算。弱点三,离线编码成本被排除在指标之外:对新增或更新的文档需要即时渲染+编码,冷启动延迟可观;可在流水线中与索引构建并行化,或蒸馏一个轻量视觉编码器专司编码。弱点四,纯文本渲染对结构化内容失效:扫描件、公式、表格在 12pt 纯文本渲染下严重失真,可扩展为对结构化区域保留原始版面的混合渲染管线。弱点五,仅点式打分:每候选一次前向虽利于缓存,但无法建模候选间冗余与多样性,未来可与列表式目标结合,用一次前向对同查询多候选页面联合打分。
未来方向
作者在结论中指出,该工作“确立了压缩视觉表示作为文档重排序的有效基础,并开启了表示与重排更长文本的道路”。据此可延伸的方向包括:一是把渲染图像同时供给重排序器与下游生成器(如 Glyph 风格的视觉上下文压缩 LLM),同一份缓存视觉令牌在检索与生成两级复用,进一步摊薄编码成本;二是扩展到多语言与跨语言重排序,渲染天然回避分词器差异,适合 MIRACL 等多语场景;三是列表式视觉重排序,把同查询多候选的页面图像拼批、一次前向完成排序;四是自适应渲染,按文档长度动态选择字号/行距,在给定令牌预算内最大化内容保留;五是用排序感知的强化学习(直接优化 NDCG 类指标)替代或加强第二阶段对比学习;六是探索更高视觉压缩比(更大空间合并、令牌聚类量化),把长文档输入压到 1–2K 令牌量级。此外,训练后模型文本输入反而变强(54.21→57.21)的现象值得单独研究,可能催生“视觉辅助训练、文本部署”的混合范式。
复现评估
复现条件较为友好。训练数据全部公开:阶段 1 使用 LightOn 在 HuggingFace 发布的 embeddings-fine-tuning-filtered-en(157 万条),阶段 2 使用 rlhn/rlhn-100K;底座 Qwen3-VL-Reranker-2B 与教师 Qwen3-Reranker-4B 均为开源权重。论文给出了渲染细节(Roboto Regular 12pt、96 DPI、896 像素定宽、Pillow 默认抗锯齿、空白规范化)与全部超参数(学习率 5e-5、LoRA r=64/α=128/dropout 0.05、对比温度 0.1、最大长度 32,768、批量 1,024/128、各 1 epoch、种子 42),并说明基于 Sentence Transformers 实现。算力门槛为 8×RTX A6000 48GB 完成训练、单卡 A6000 测吞吐,属于中等规模实验室可负担的范围;主要工程量在于数百万文档对的批量渲染与离线视觉嵌入的存储管理。论文未明确承诺开源代码与模型权重,需自行实现渲染与训练脚本;评测协议(BM25 top-100、MMTEB 版 MLDR、8 候选长文档协议)描述完整。总体复现难度:中等。
论文图表