QwenGyre:面向超长程智能体训练的弹性强化学习框架 QwenGyre: An Elastic Reinforcement Learning Framework for Training xLong-Horizon Agents
弹性GPU调度加分支轨迹处理,把在线RL扩展到数小时、百万token级的超长程智能体任务。
前置知识
组相对策略优化(GRPO/GSPO)
一种免价值网络的在线RL算法:对每个query用当前策略独立采样 $N$ 条执行构成一个组,用组内奖励的均值和方差把每个执行的回报归一化为优势 $\hat{A}_i$,从而无需训练critic。GSPO是其序列级变体,把重要性比率从token级聚合到序列级再裁剪,训练更稳定。
QwenGyre的RL算法正是GSPO的改造版:执行级裁剪区间 $[0.995,1.005]$ 加token级重要性权重封顶5,理解这些设计的前提是懂组相对优势从何而来。
Rollout–Training调度:Colocate与Async
LLM RL系统要在『采样(rollout)』和『训练』两个阶段间分配GPU。Colocate让所有GPU共享一个池、作为整体在两阶段间交替切换(如HybridFlow/ReaL);Async把GPU静态划分为专职采样池与专职训练池,两阶段可并行但互不借用算力。
本文的两个基线正是这两种范式,QwenGyre的弹性调度器是为了克服它们在超长任务下各自的GPU闲置问题,所有对比实验都在相同GPU预算和匹配陈旧度下与这两者进行。
调度陈旧度(staleness)
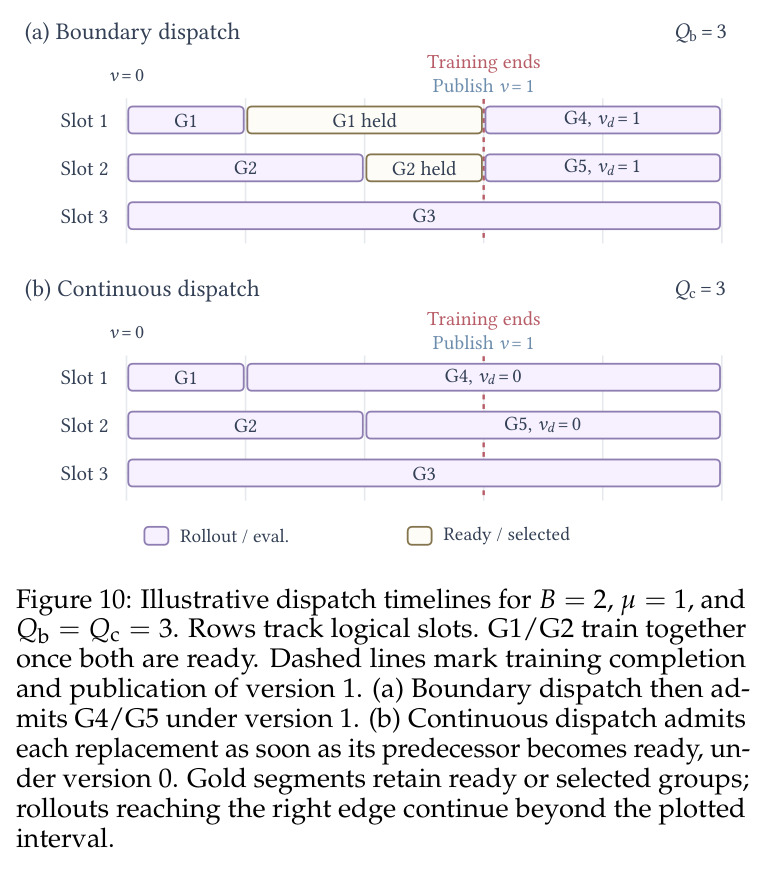
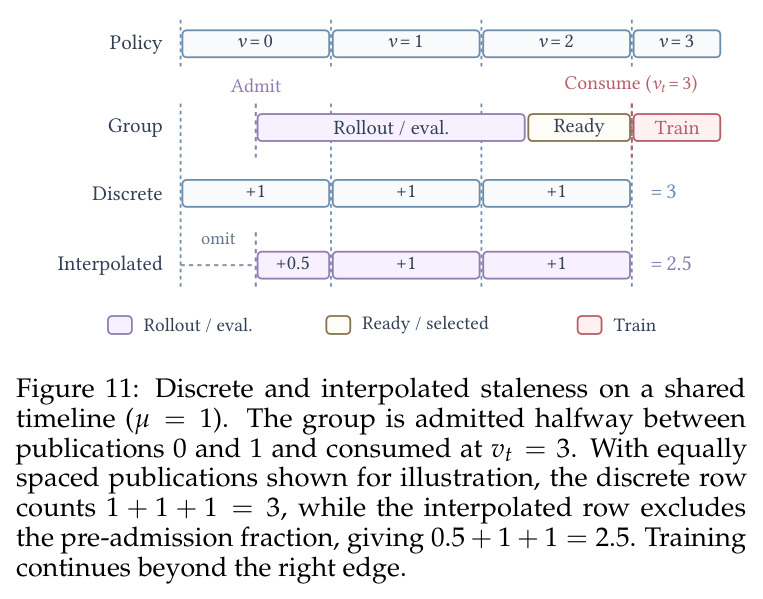
衡量训练数据『过时』程度的指标:$d = v_t - v_d$,其中 $v_d$ 是样本被派发时的最新已发布策略版本,$v_t$ 是消费它的那步训练之前的策略版本。本文证明boundary dispatch下其均值为 $\mathbb{E}[d]=\varphi+(\mu-1)/2$,并用匹配的 $\mathbb{E}[d]$ 保证方法间比较公平。
所有速度对比都在目标陈旧度 $\mathbb{E}[d]\in\{1,1.5\}$ 下进行,不理解这个量就看不懂实验设置的公平性,也看不懂参数 $\varphi$(额外派发)和 $\mu$(每burst训练步数)如何选取。
黑盒harness与代理记录
Claude Code、Codex等最强agent框架闭源且快速演进,RL框架无法把它们的控制流搬进训练器。黑盒方式是让harness经一个代理(proxy)访问模型:代理原样记录每次模型调用的输入输出token和采样时的log概率,同时完全不改变harness的执行逻辑。
QwenGyre整个数据平面建立在这个接口上:TITO记录、轨迹树构建、角色切换时的请求重路由都发生在proxy中,这是理解第5章轨迹处理器的前提。
TITO(Token-In Token-Out)
一种精确的轨迹记录格式:对每次模型调用保存确切的输入token、输出token以及输出token的行为log概率,而不是把消息文本重新编码。这样训练时能复现每个输出token生成时的原始条件上下文,避免『token不在其生成上下文中被训练』的错位问题。
轨迹处理器用TITO定义『可训练token的provenance』:只有策略采样出的token才是训练目标,系统提示、工具结果、harness注入的内容一律被掩码,这是第5.1节的核心机制。
上下文压缩与子代理分支
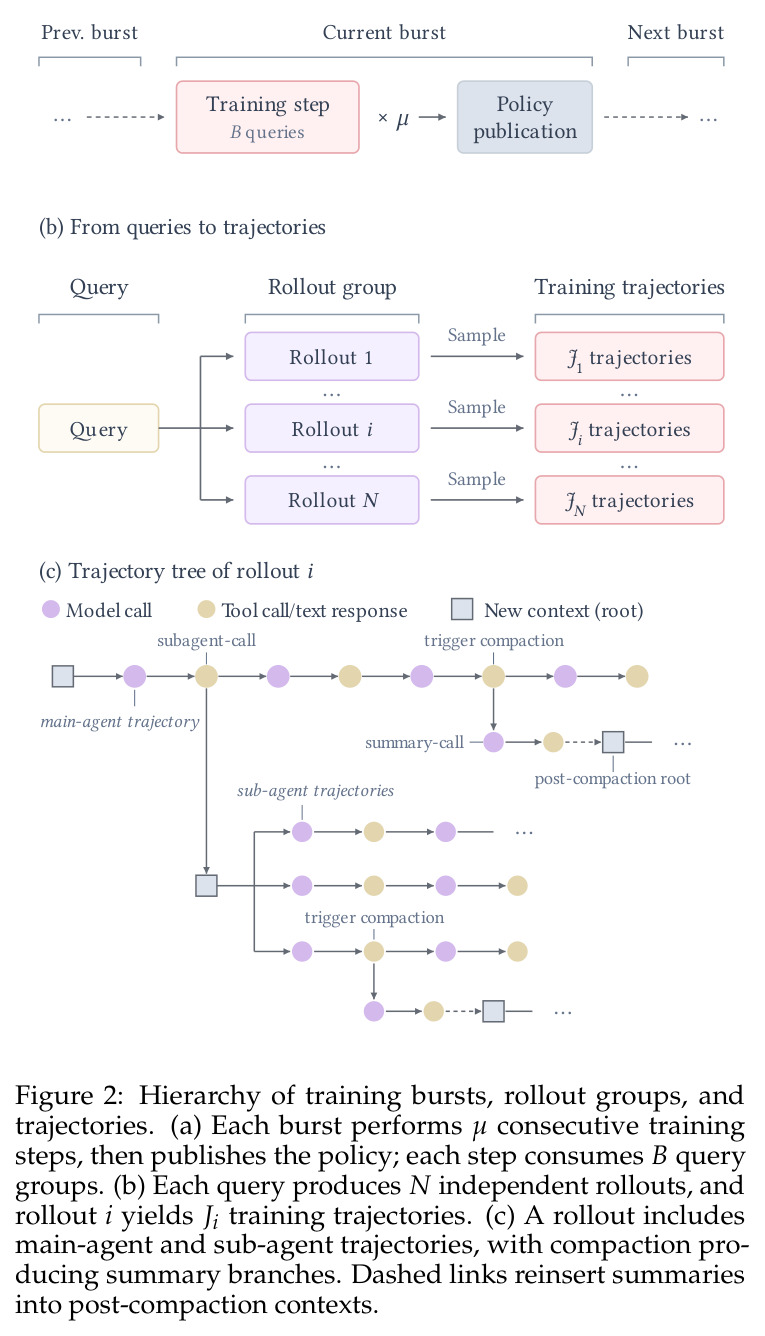
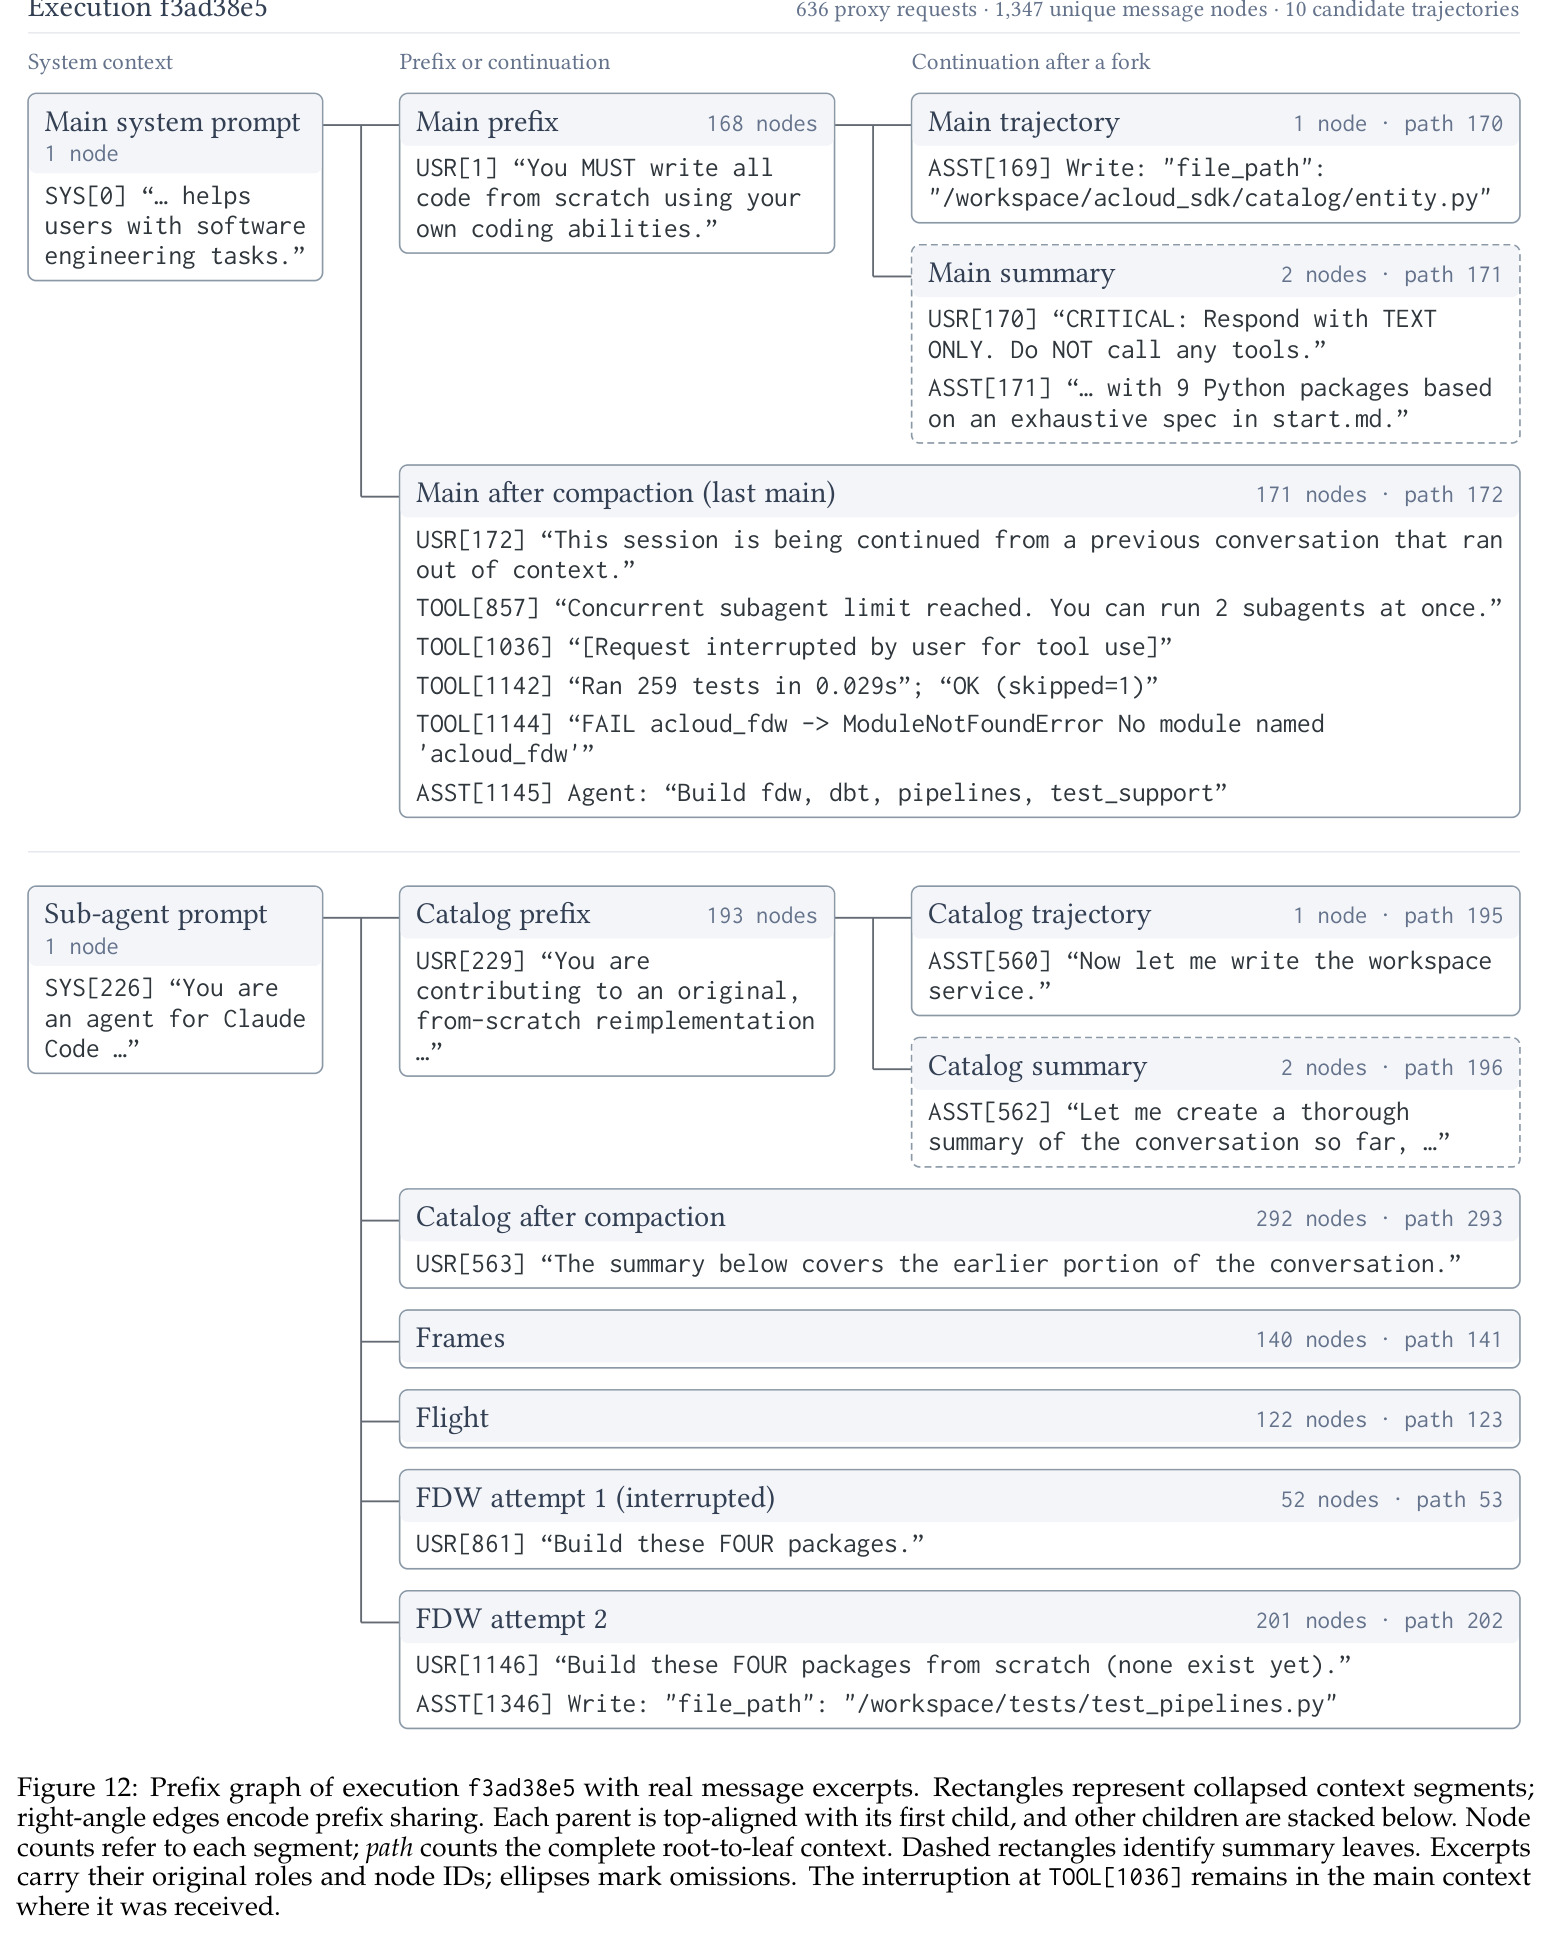
为撑过数小时的执行,现代agent harness会在上下文窗口将满时把历史压缩成摘要再续跑,还会把子任务委派给拥有独立上下文的子代理,失败路径会被重试。于是单次任务执行不再是一条线性轨迹,而是一棵带共享前缀的分叉树。
这正是本文挑战2的根源,也是轨迹树表示、角色优先采样和共享目标去重所要处理的实际数据形态;不看懂分支结构就无法理解为何需要去重与掩码。
研究动机
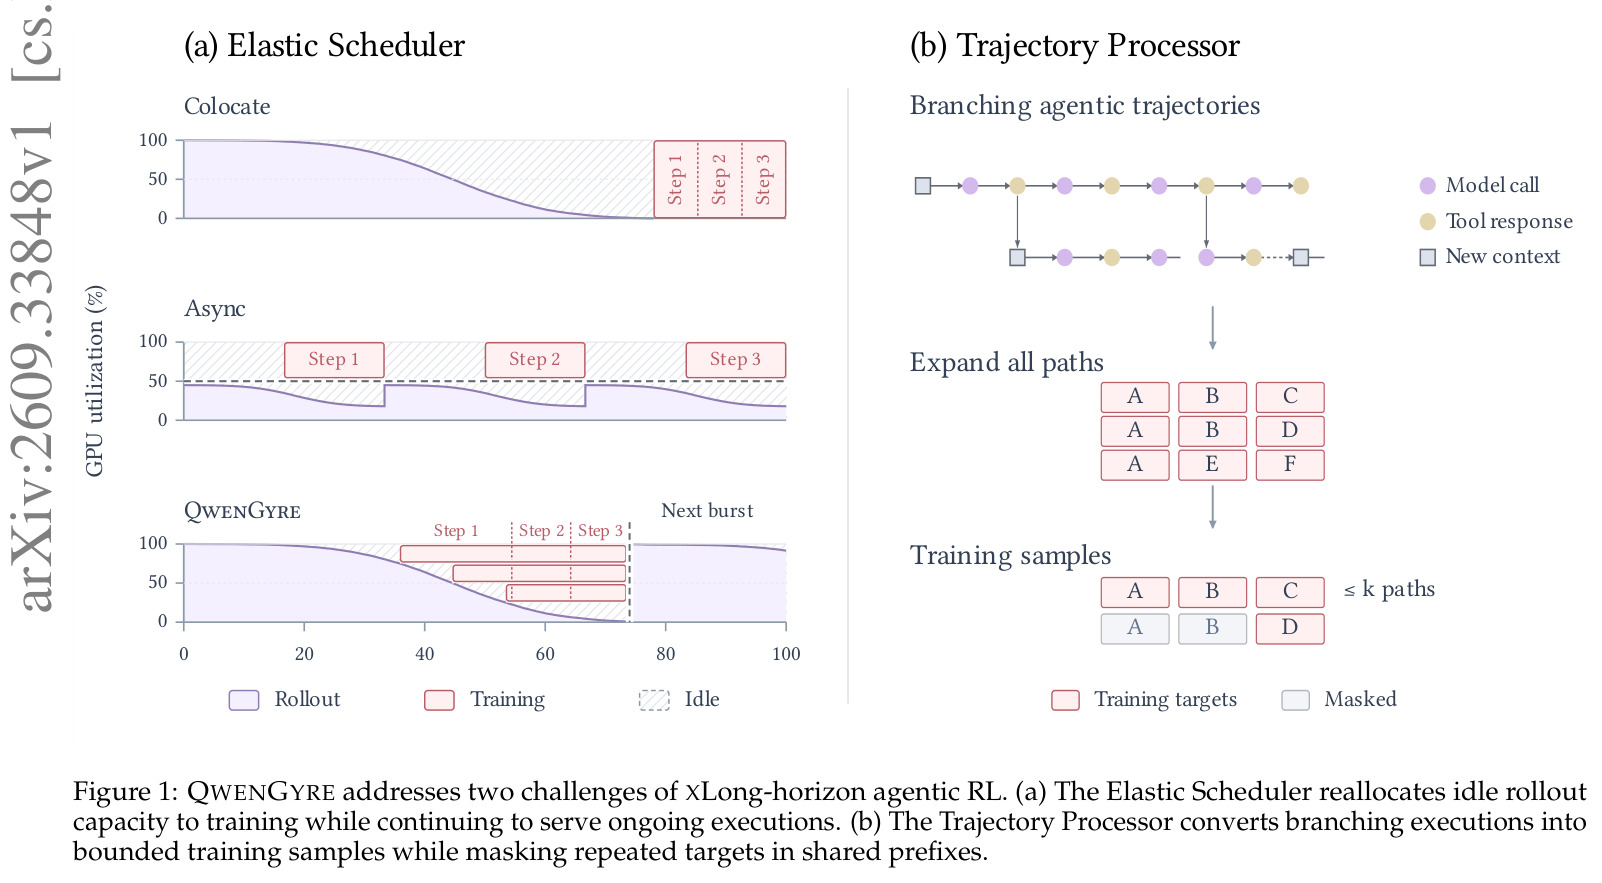
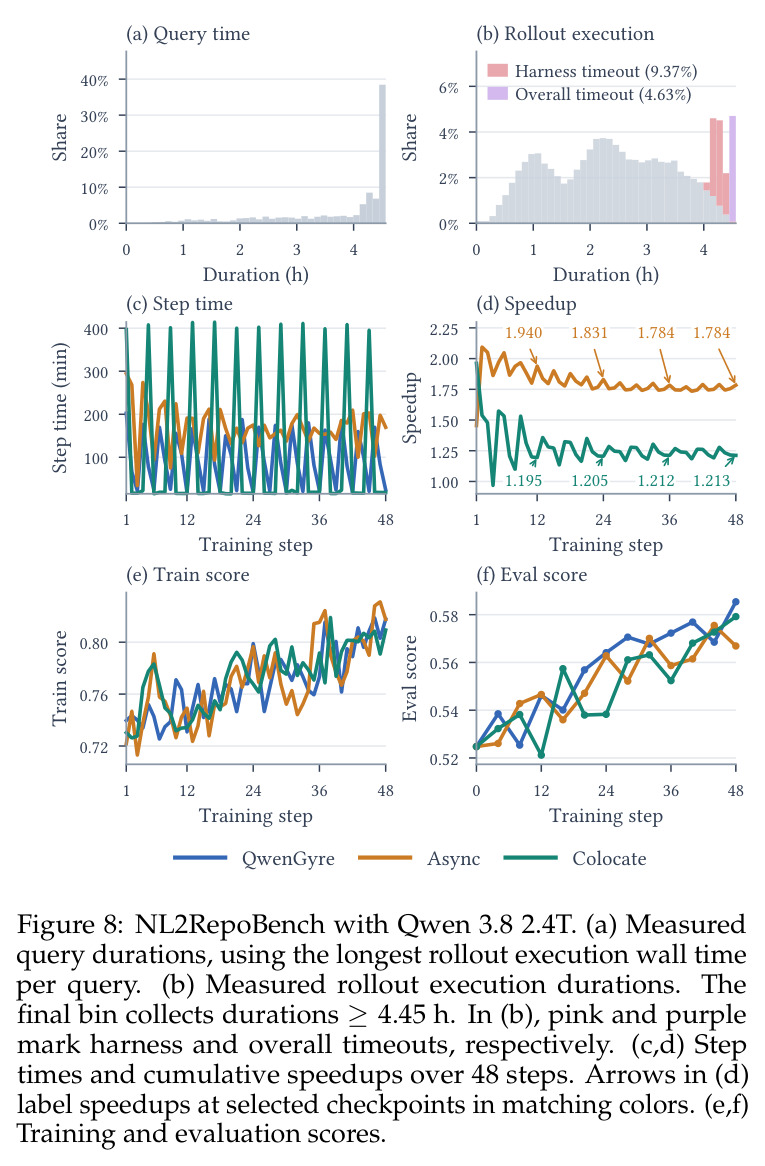
随着基座模型能力增强,agent任务正从『修一个issue』的几十次交互,扩展到从零构建整个代码库这类XLong(超长程)工作负载:单次执行持续数小时、包含数百次相互依赖的模型-环境交互、累计处理近100万token。论文在NL2RepoBench上用Qwen 3.6 122B实测:平均每次rollout执行1.93小时、每个query(16条执行取最长)2.96小时,9.51%的query超过4小时,6.25%的执行触发harness超时;换成更强的Qwen 3.8 2.4T后,61.1%的query至少跑4小时、38.2%以整体超时告终,harness超时率9.37%。这给在线RL带来两个硬问题。其一,执行时长长尾方差极大且结束时间成簇:Colocate范式必须等最慢执行结束才能整池切换训练,GPU大量空转;Async范式固定划分资源,训练池闲置时采样池借不到算力。其二,harness靠上下文压缩、子代理委派和失败重试撑过数小时执行,单次任务产出的是非线性分叉图而非线性轨迹:案例中一次执行有636次代理请求、1347个消息节点、10条候选轨迹,全部展开会产生1716个节点出现(多出369个重复前缀),训练样本和token量爆炸。
本文的目标是本文的目标是构建一个端到端的XLong-horizon在线RL框架QwenGyre,让未经修改的黑盒agent harness(实验中使用Claude Code 2.1.220)可以直接接受RL训练,同时解决调度与数据两个层面的问题。具体而言:在调度侧,GPU要能随采样工作量消耗在rollout与training两种角色间动态流转,进行中的harness执行不能因角色切换而中断或超时,新腾出的GPU要能加入正在进行的训练batch而不是干等下一个batch;在数据侧,要把带压缩、委派、重试的分支执行忠实重构为训练样本——每个输出保持在它生成时的原始上下文中,超时的执行也要对已完成的可评估部分给出有效奖励,并通过每执行轨迹限量和共享目标去重把训练开销约束在可控范围。最终验收指标是:在相同GPU预算和匹配的调度陈旧度下,端到端训练速度显著超过Colocate和Async两种基线,同时任务分数不下降。
与已有工作不同的是,已有工作基本只解决一半问题。调度方向上,TideRL用就绪信号自适应采样、BiDiRL允许分离式流水线两侧互借空闲资源、DynaResize在池间重新分配GPU、Libra用全局规划器加弹性混合池,但它们都不处理分支轨迹的训练数据构造。轨迹方向上,ClawGym II把捕获请求重组为共享前缀树并让共享节点只贡献一次训练信号,BPO/IAPO/MileGPO用分支、依赖图或中间里程碑做更细粒度信用分配,psRL在样本构造后复用共享前缀,但它们不解决GPU在数小时执行下的闲置。Agent Lightning、Polar、LEGO-RL等harness原生框架虽然连接了黑盒运行时,却没有与就绪驱动的资源重配置耦合。QwenGyre的独特切入是:把『角色随时可变的弹性cell』与『全程保留角色、分支、环境状态和评估器provenance的轨迹处理器』作为一个整体设计,从rollout采集、准入到训练物化端到端贯通,并直接在未修改的Claude Code上训练旗舰模型,而非自研简化版harness。
核心方法
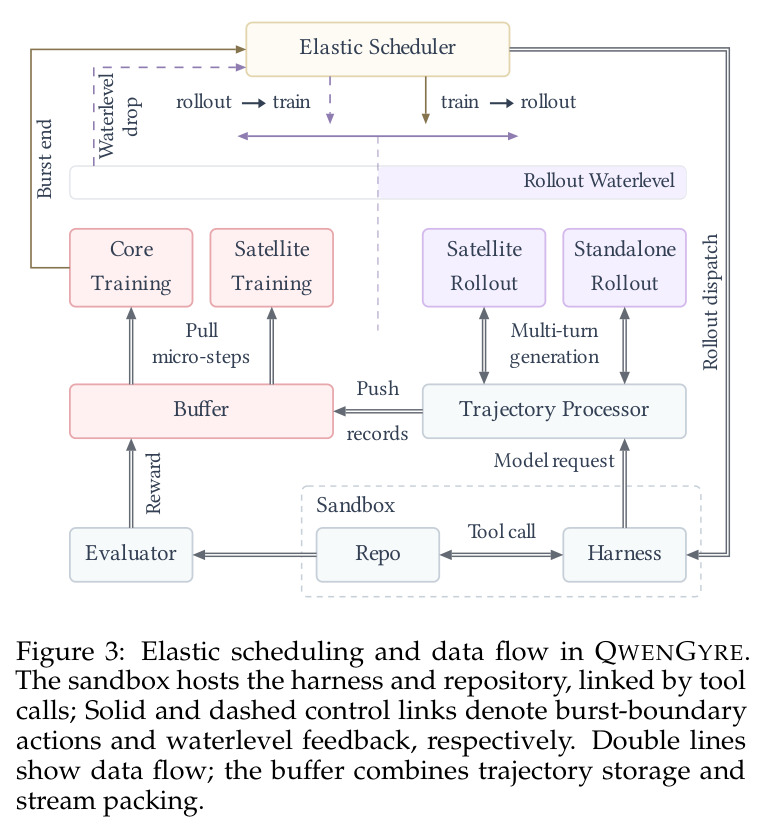
直觉上,QwenGyre把三件事的生命周期彻底解耦:harness与工作区状态活在GPU之外的沙箱里,GPU只是可随时更换角色的算力单元,模型调用记录则是可按需物化成训练样本的持久数据。架构上由两个协作平面组成(论文Figure 3)。弹性调度器把GPU组织为 $K$ 个按固定顺序排列的弹性cell(外加可选的独立rollout池),每个cell内部保持完整的张量/流水/专家/上下文并行布局,既能服务rollout也能承载一份完整的训练actor副本;排在首位的core cell独占权威权重和优化器状态,其余satellite cell在有空闲时按序加入训练。轨迹处理器则在黑盒proxy中用TITO格式记录每次模型调用的输入输出token和行为log概率,把执行组织成共享前缀的轨迹树;执行结束后由评估器对保留的工作区打分(包括超时后的部分进度),训练准入时按角色优先级每执行最多取 $J_{\max}=5$ 条轨迹,并通过树上掩码保证共享目标只计一次。两平面通过micro-step训练样本流衔接,core可以在样本未全部就绪时就开始训练,实现rollout与训练的最大重叠。
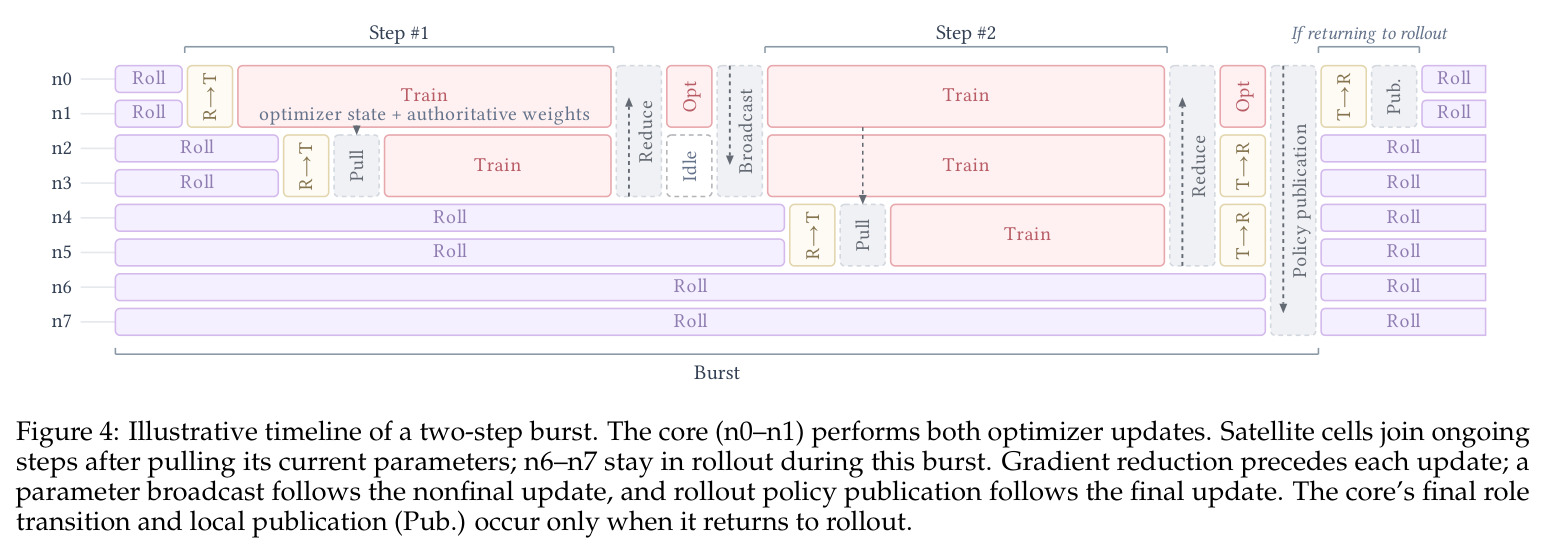
核心创新有三点,每点都与已有方案有本质区别。第一是『不中断执行的角色切换』:调度器只在burst边界和启动时改变cell角色,切换时proxy把进行中的模型调用透明重路由到保留的rollout引擎(优先独立池、再按cell序号降序,减少反复迁移),并支持经RDMA做KV-cache迁移以减少前缀重算;实测rollout→训练切换仅8.52秒、训练→rollout仅3.46秒,相对数小时的执行完全可忽略。相比之下,Colocate必须整池排空才能切换,Async根本不允许换角色。第二是树上无放回的目标采样:候选轨迹是轨迹树的叶子,按『主代理 > 主代理摘要 > 子代理 > 子代理摘要』的优先级逐条抽取,抽中的轨迹固定其目标token后把整条根到叶路径掩码掉,保证共享前缀绝不被重复训练——这与ClawGym II『每个共享节点只计一次』目标一致,但进一步引入角色优先级和每执行上限 $J_{\max}$。第三是执行级损失归一化:token损失先在被执行选中的不相交目标集内平均(归一化系数 $1/L_i$),再对batch内所有执行平均,使路径更多的执行不会获得更大的聚合权重,且更换选中的路径不改变归一化分母。
方法步骤详情
完整流程如下。启动与派发:以执行为单位做boundary dispatch,初始派发 $d(0)=(\varphi+\mu)NB$ 个执行,此后每个burst发布权重后补充 $\mu NB$ 个;陈旧度均值满足 $\mathbb{E}[d]=\varphi+(\mu-1)/2$。采集:harness与仓库沙箱在GPU外运行,每次模型调用经proxy发往SGLang rollout引擎,proxy用TITO记录token与log概率,并缓存工具调用的原始payload以防后续历史格式化造成错配。水位控制:调度器维护三个累计量 $d(t),p(t),f(t)$(派发/启动/终止数),水位 $w(t)=d(t)-f(t)$ 即未完成执行数;当剩余rollout容量 $C_R(t)=C_s+(K-k(t))C_e$ 满足 $w(t)\le C_R(t)-C_e$ 时,cell按core先行、satellite随序串行转入训练,且需通过『就绪未指派组连续 $\tau$ 时刻至少 $\rho_{\min}B$ 个』的供给检查。流式训练:satellite经Mooncake Transfer Engine用RDMA拉取core的当前参数快照后加入进行中的batch;packing buffer按最旧策略版本优先拉取就绪组,把选中轨迹物化成带损失掩码和权重的micro-step,各cell以1F1B流水领取。更新与发布:core聚合所有训练cell的梯度、裁剪后做一次优化器更新;非最终步向satellite广播新参数,burst结束后训练cell回rollout、core发布权重。奖励与准入:执行关闭后评估器对保留工作区打分(评估失败可在预算内重试,最终无有效奖励则轨迹被排除;彻底失败插入零奖励占位);组内16条执行的优势由组相对归一化得到,再按角色优先级从轨迹树抽至多5条轨迹进入训练。
技术新颖性
技术新颖性可从四个层面看。系统层面:以cell为粒度的双向弹性(训练cell可回rollout、新cell可加入进行中的batch)依赖三项此前未被组合的技术——动态成员数据并行(satellite在梯度累积期间读取一致的权重快照、优化器更新前关闭加入窗口)、请求级重路由保活harness、KV-cache的RDMA迁移与两阶段握手释放;预构建的 $K-1$ 套前缀通信组让任意cell子集都能做梯度归约。理论层面:附录A给出boundary dispatch陈旧度的精确恒等式 $\mathbb{E}[d]=\varphi+(\mu-1)/2$ 与continuous dispatch的对应式,并用Little定律推导等陈旧度下的步时比较 $T_c/T_b$,为 $\varphi,\mu$ 的选取提供闭式依据,这类分析在同类系统论文中少见。算法层面:把GSPO的序列级裁剪 $[0.995,1.005]$、执行级优势、token级封顶5的重要性权重与执行级归一化 $1/L_i$ 组合,并证明对固定目标集,共享目标挂在哪条选中路径上都不影响损失,保证了掩码式去重在数学上是干净的。数据层面:provenance掩码把『策略生成的token』与『harness注入的token』区分开,TITO使摘要被重插进后续prompt时不会误当成训练目标;案例研究显示一次执行的10条路径共享1347个节点、全展开需1716个,树上表示直接省掉369个重复节点。
实验结果
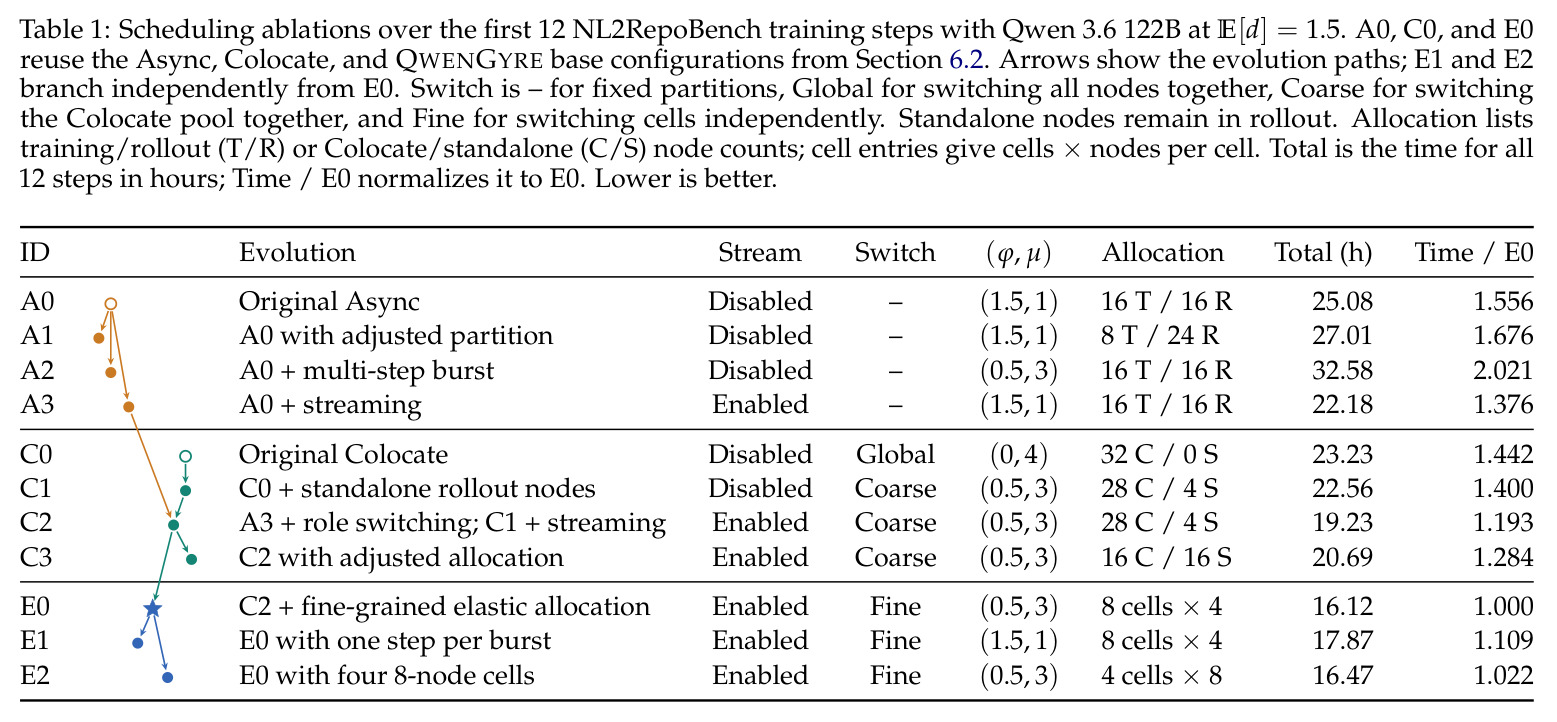
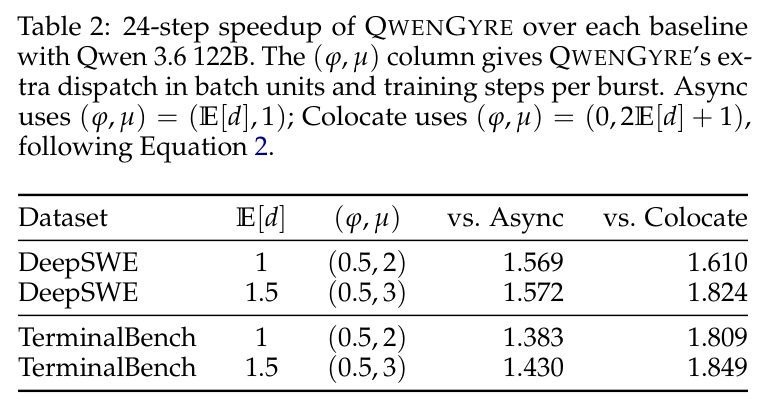
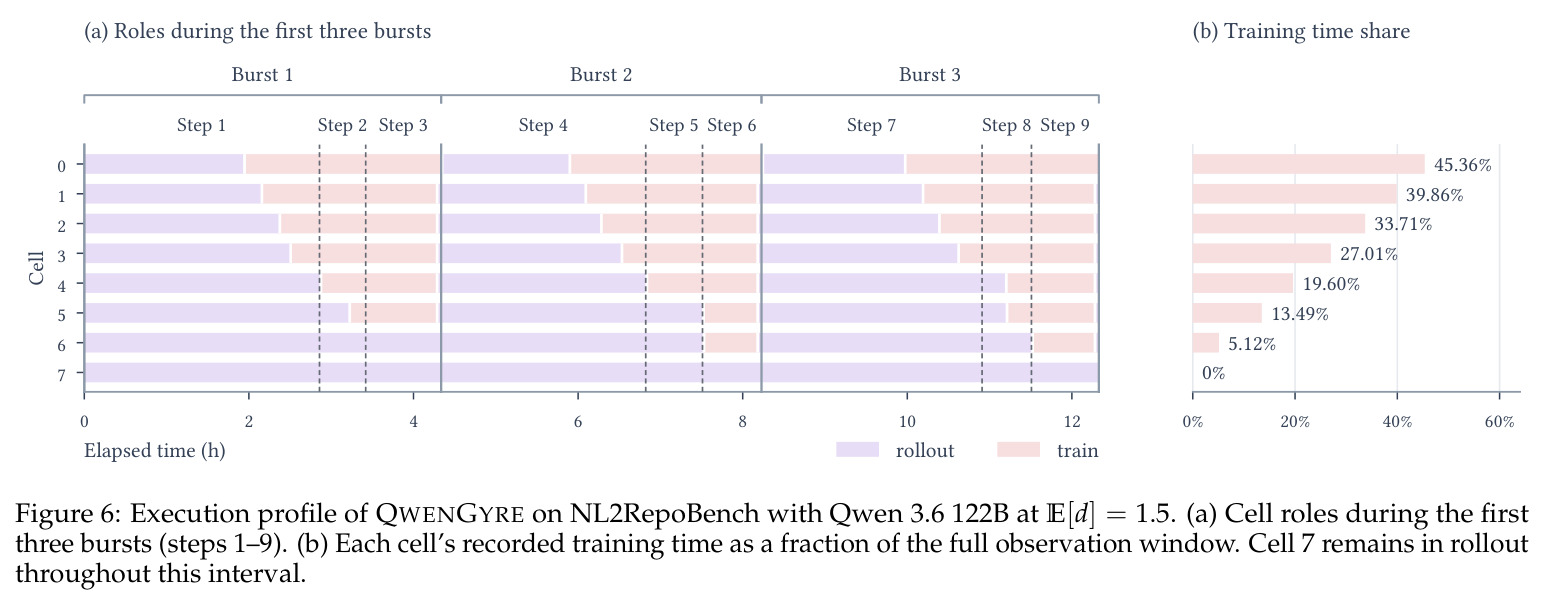
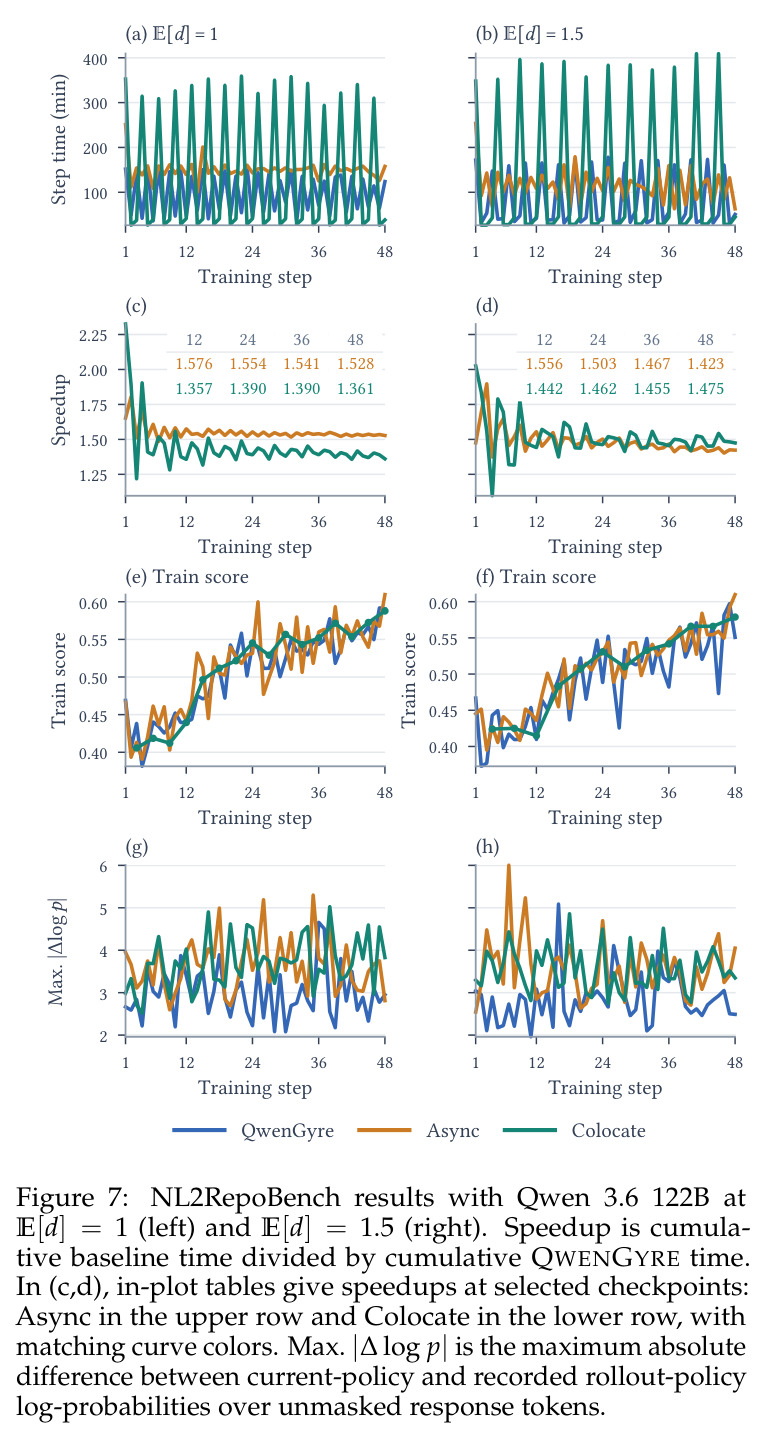
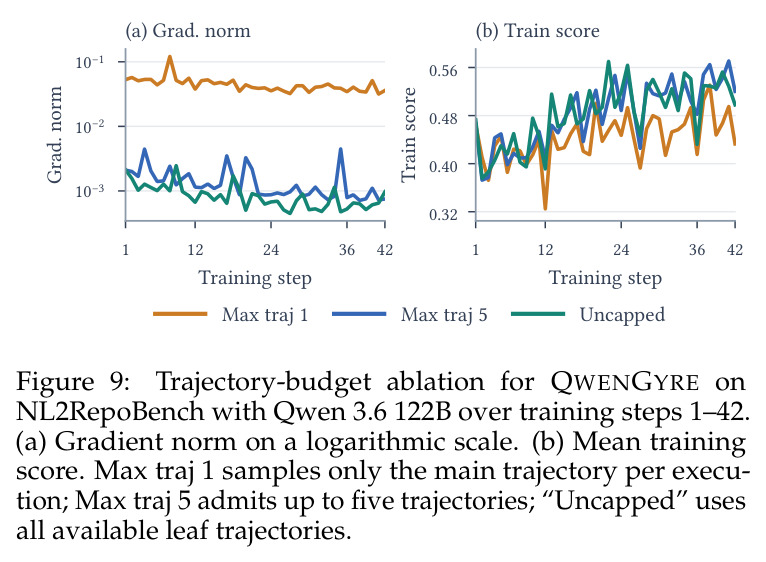
主结果分四块。旗舰规模:Qwen 3.8 2.4T在NL2RepoBench上训练48步,QwenGyre用75.42小时完成,Async需134.55小时、Colocate需91.47小时,即1.78×与1.21×加速;评测通过率从52.48%提升到58.54%(+6.06个百分点),训练分数与两基线持平。122B规模:NL2RepoBench上48步后,在 $\mathbb{E}[d]=1$ 和1.5两档下对Async加速1.42–1.53×、对Colocate加速1.36–1.47×,三者训练分数曲线相当。跨域验证:DeepSWE 24步在 $\mathbb{E}[d]=1/1.5$ 下对Async加速1.569/1.572×、对Colocate加速1.610/1.824×;TerminalBench为1.383/1.430×与1.809/1.849×。调度消融(前12步):完整配置E0(8个4节点cell+流式+$\mu=3$)16.12小时,比原版Async(A0,25.08小时)快1.556×、比原版Colocate(C0,23.23小时)快1.442×;给Async加流式(A3,22.18小时)省11.6%但受固定划分限制;给Colocate加独立rollout节点再加流式(C2)19.23小时;cell从8×4并为4×8(E2)仅慢2.2%(16.47小时);单步burst的E1慢10.9%但仍比A3快1.24×。轨迹预算消融:每执行只取1条轨迹会降低训练分数、放大梯度范数;取5条与不设上限分数相当,前向-反向时间为不设上限的74.8%(省25.2%),取1条时仅41.4%。运行特征:平均切换耗时8.52s/3.46s;E0中训练完全被rollout隐藏且仍余20.85%松弛;8个cell的训练时间占比从45.36%递减到0%(cell 7全程保持rollout)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| NL2RepoBench(Qwen 3.8 2.4T,48步RL) | 评测通过率 | 58.54% | 52.48%(训练前) | +6.06个百分点 |
| NL2RepoBench(Qwen 3.8 2.4T,48步) | 端到端训练时长 | 75.42小时 | Async 134.55小时 / Colocate 91.47小时 | 1.78× / 1.21× |
| NL2RepoBench(Qwen 3.6 122B,48步,E[d]=1.5) | 端到端加速比(vs Async) | 1.53× | Async(同GPU预算、匹配陈旧度) | 快53% |
| NL2RepoBench(Qwen 3.6 122B,48步,E[d]=1.5) | 端到端加速比(vs Colocate) | 1.47× | Colocate | 快47% |
| DeepSWE(Qwen 3.6 122B,24步,E[d]=1.5) | 端到端加速比 | 1.572×(vs Async);1.824×(vs Colocate) | Async / Colocate | 最高快82% |
| TerminalBench(Qwen 3.6 122B,24步,E[d]=1.5) | 端到端加速比 | 1.430×(vs Async);1.849×(vs Colocate) | Async / Colocate | 最高快85%(全文最大1.85×) |
| NL2RepoBench(Qwen 3.6 122B,前12步调度消融) | 12步总耗时 | 16.12小时(E0) | Async 25.08小时 / Colocate 23.23小时 | 1.556× / 1.442× |
局限与改进
作者明确承认两点局限。其一是GPU预算与cell粒度的约束:弹性调度需要多个可独立切换的cell,而每个cell必须装得下模型的显存和训练并行度,很小的GPU预算可能无法这样组织;且实验只在固定32节点预算下比较了8×4与4×8两种分组(相差2.2%),更小总预算下的效率未评估。其二是流式训练牺牲全局shuffle:$\mu>1$ 时就绪的rollout组按到达顺序增量分配给各次更新,无法在burst开始前对全部数据混洗,约束了依赖全局随机小批次的训练流程;虽然 $\mu=1$ 可避开,但样本顺序对学习质量的影响未被单独隔离。我补充几点观察:NL2RepoBench训练用Qwen 3.7-Max评估器打分,奖励质量依赖这个外部模型且未被消融;Qwen 3.8 2.4T整体超时率4.63%(38.2%的query以整体超时告终),大量算力花在被丢弃的执行上,时间预算与模型能力不匹配的问题未解决;对Async的增益(最高1.78×)显著大于对Colocate(最高1.21×),说明在共享池场景下弹性收益有限;KV-cache迁移的实际命中率与收益未给出数字。
独立分析的弱点
独立分析有五个弱点。第一,部分进度奖励的噪声风险:超时执行靠评估保留工作区拿分,『做了一半』的分数可能与最终任务成败弱相关,甚至鼓励放弃性探索;改进方向是为部分分数引入里程碑结构或置信度加权,或用过程奖励模型校准。第二,缺乏全局shuffle:$\mu>1$ 时数据按完成顺序进入训练,组间相关性可能引入梯度偏差;改进方向是跨burst的经验回放缓冲加重要性校正,或仅对低方差任务启用多步burst。第三,$J_{\max}=5$ 和角色优先级是手工规则,未考虑不同执行间轨迹价值分布的差异;改进方向是按组内优势方差自适应分配每执行的轨迹预算。第四,角色切换仅在burst边界加水位触发,对rollout中途突然涌入需求的响应粒度受cell最小单位限制;改进方向是引入副本级更细伸缩或基于到达过程的预测性水位。第五,实验全部在阿里自家Megatron+SGLang+Mooncake栈上完成,且只测了Claude Code 2.1.220一个harness,迁移到其他闭源harness(如Codex)时proxy的工具调用格式适配、KV迁移兼容性都是未知数;改进方向是抽象出harness无关的记录协议。
未来方向
作者提出的延伸方向包括:在更小GPU预算下评估弹性组织,联合调优cell数、$\rho_{\min}$ 与 $\tau$;支持burst级全局shuffle,并量化样本顺序对学习质量的影响。基于其成果还可延伸:把附录A的陈旧度-步时理论推广到 $\mu>1$、有丢弃和变batch的场景,形成自动配置 $\varphi,\mu$ 的控制器;将部分进度评分升级为里程碑/过程奖励,缓解超时样本的信号噪声;结合SAO、SPO++等异步流式策略优化,在保持陈旧度约束下进一步放宽burst边界;把KV-cache迁移从可选优化变为默认路径并量化收益;在同一proxy协议下接入多种harness与更多领域(如计算机操作、长程研究任务),检验弹性调度收益是否随时长分布变化;最后,52.5%→58.5%仅用48步就达成,说明XLong任务的RL上限远未触及,更长训练、课程式难度调度与超时预算自适应都值得探索。
复现评估
复现难度:高。论文未提及开源代码、权重或训练数据(NL2RepoBench/DeepSWE/TerminalBench本身公开,但本文训练集为内部构造;NL2RepoBench训练还需独立的Qwen 3.7-Max评估器打分)。算力门槛很高:122B实验用32节点(8个4节点cell,每cell推理并发144),DeepSWE/TerminalBench用24节点(6个cell、并发192),2.4T实验用4个48节点cell、总推理并发384;一次48步训练即便加速后也要75小时。软件栈为Megatron-LM(训练)+SGLang(推理)+Mooncake Transfer Engine(权重传输),外加自研proxy、水位调度器和轨迹处理器,大量工程细节只有定性描述(如预构建的 $K-1$ 套通信组、1F1B暂停点、工具payload缓存)。对多数团队可行的路径是:参考HuggingFace TITO博客与论文附录B的损失定义,在小模型上先验证训练语义;按附录A恒等式 $\mathbb{E}[d]=\varphi+(\mu-1)/2$ 做小规模调度器仿真;Table 1的12步消融给出了各组件的独立增益,可作为自研实现的功能清单和验收基准。
论文图表
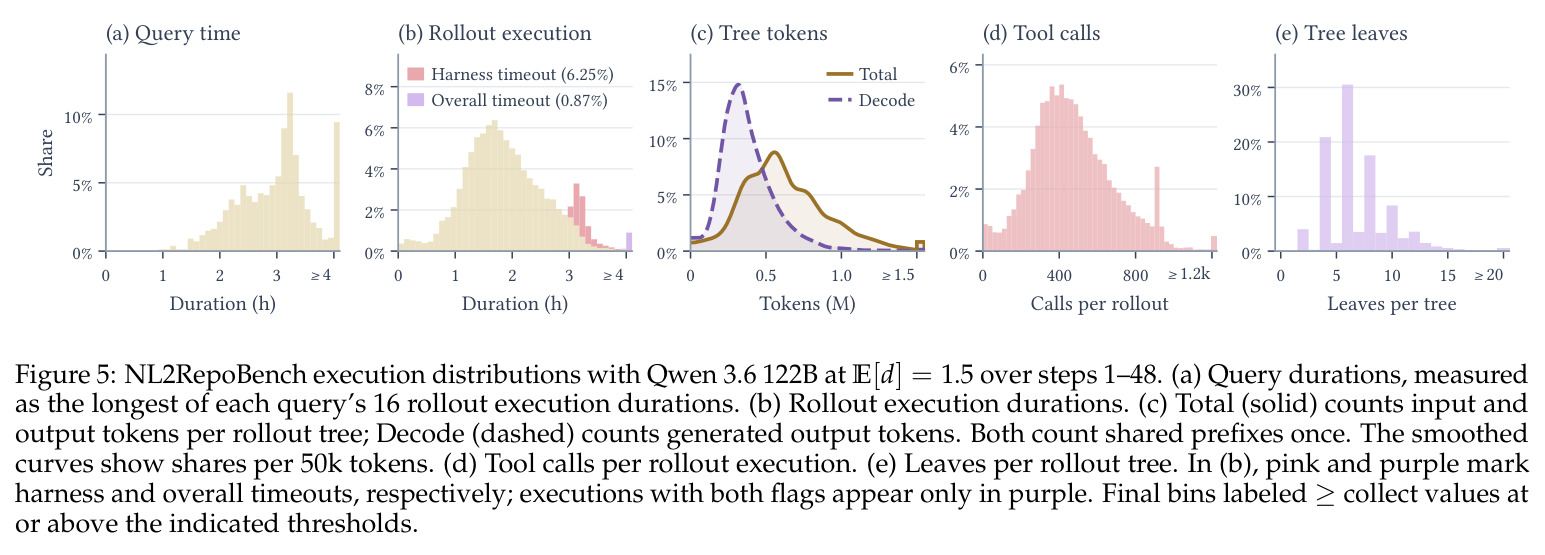
五个分布直方图刻画XLong负载的真实形态:(a) query时长均值2.96小时、9.51%超过4小时;(b) rollout执行均值1.93小时,harness超时6.25%、整体超时0.87%;(c) 每棵轨迹树的总token量(含共享前缀,只计一次)及其中解码输出占比;(d) 每次执行的工具调用次数可达800甚至1200以上;(e) 每棵树的叶子(候选轨迹)数可达5、10甚至20以上。
用实测数据论证了『长尾方差』和『分支爆炸』两大挑战不是假设而是普遍现象,是动机部分最有说服力的证据。