基于扰动公开文档的合成训练:让模型学会从上下文中学习 Learning to Learn from Context: Synthetic Training from Perturbed Public Documents
扰动公开文档并做依赖性检验,自动合成数据让35B模型CL-bench成绩从13.7%升至24.6%
前置知识
上下文学习(Context Learning)
指模型依赖任务提供的上下文文档(规则、事实、流程)完成任务,而不是依赖预训练时记住的参数化知识。与知识检索不同,它要求模型通读整个文档、理解整体结构,并把文档内容忠实地应用到推理和作答中,常见于内部文档问答、检索增强推理、Agent 解读工具输出与日志、检查计划是否符合规范等真实工作流。
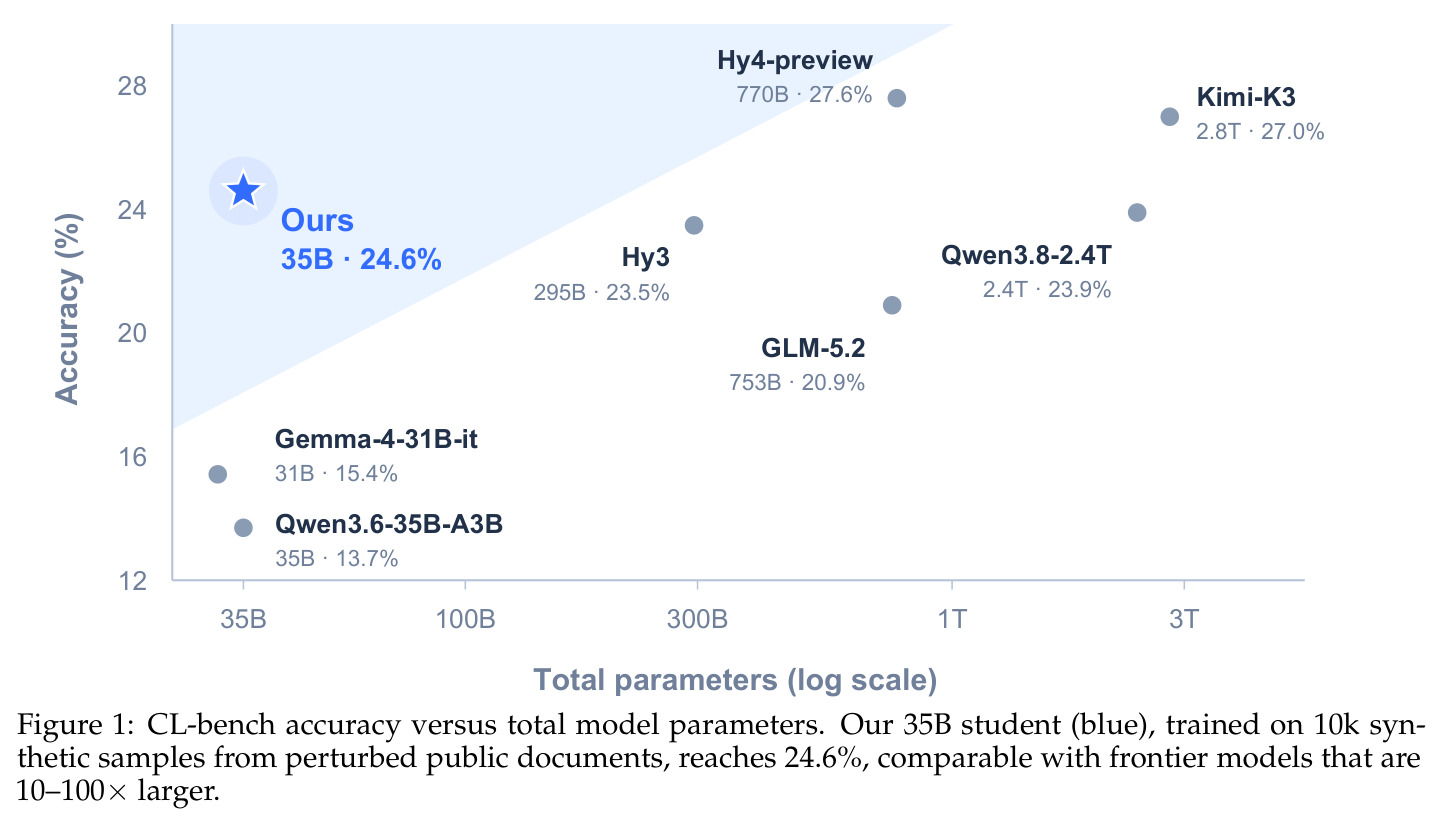
这是本文要提升的核心能力:1899 个长文档任务的 CL-bench 上最强前沿模型也解不出 30%(Hy4-preview 27.6%),作者论证这是 LLM 的系统性弱点,而非知识不足。
监督微调(SFT)
在成对的(提示,回答)样本上继续训练预训练模型,使其学会特定输出模式。本文的特殊之处是训练目标逐字保留教师模型的原生推理轨迹,而非人工清洗改写过的标准答案;作者经验性发现原生轨迹比润色版更有效,即使它可能不满足部分 rubric。
理解 SFT 才能理解为什么教师选择会导致学生成绩在 19.7 到 22.8 之间大幅波动,以及为什么推理轨迹的真实性是整条流水线的关键。
记忆化与数据污染
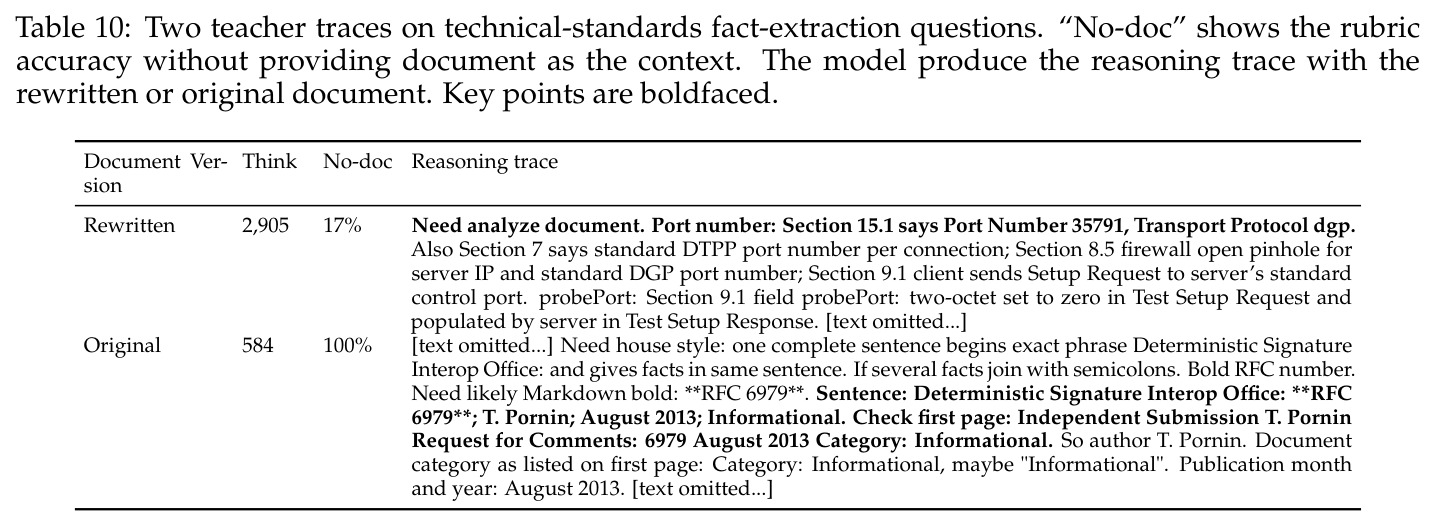
公开文档很可能已包含在预训练语料中,模型可以不经阅读、直接凭参数化记忆回答关于该文档的问题。若直接用这类文档合成训练数据,训练信号奖励的是背诵而非上下文推理,模型学不到如何使用文档。论文的审计例子:某模型对知名技术标准的问题无文档时近乎满分,标准被改写后得分几乎归零。
这是方法论的核心动机:深度重写和 gap check 都是为系统性消除记忆化捷径,保证每条样本真正需要文档才能回答。
Rubric 规则评分与规则奖励 RL
Rubric 是一组细粒度判分项(过程、内容、persona、格式、反幻觉等),评审模型逐条判定通过与否,规则奖励 RL 的奖励为逐条通过率 $r=\frac{1}{N}\sum_{i=1}^{N}\mathbb{1}[r_i]$。本文评审提示与 CL-bench 官方评测逐字一致,评审模型为 Qwen3.5-397B-A17B。
RL 阶段完全建立在合成样本自带的 rubric 元数据上;理解 rubric 才能看懂 SFT 与 RL 如何共用同一批提示,以及奖励作弊消融实验(式 1)。
GSPO(组序列策略优化)
一种面向大语言模型的强化学习算法,与 GRPO 思路类似:对同一提示采样一组回答,用组内相对优势更新策略,无需训练独立价值网络。本文用它做规则奖励优化,KL 惩罚系数 0.001,恒定学习率 1e-6,初始策略为 SFT 模型。
RL 是把 CL-bench 成绩从 22.8% 推到 24.6% 的第二阶段,GSPO 是其实施载体,无 SFT 初始化时直接 RL 只有 16.9%。
研究动机
LLM 越来越多地被部署在上下文定义任务的场景:对内部文档和手册问答、对检索段落推理、解读 Agent 消费的工具输出和日志、检查计划是否符合规范。但模型通读文档并据此推理的上下文学习能力仍是明显短板:覆盖 18 个领域、1899 个长文档任务的 CL-bench 上,即使最强前沿模型也解不出 30%,失败模式是答案看似合理却在细粒度检查下崩溃。现有监督来源都不够用:主流指令数据集是对话式短上下文,几乎不涉及长文档的忠实使用;人工标注长文档问答极其昂贵,标注者需设计数万字文档、对照验证答案并写清评分标准;用真实公开文档做合成监督存在记忆化风险,因为这些文档很可能是预训练语料的组成部分,直接训练会奖励背诵而非上下文学习;而纯 LLM 合成的文档逻辑简单、高度同质,在此类数据上微调的模型持续弱于在真实文档上微调的模型(即使诱导出的检索行为部分重叠)。
本文的目标是本文要构建一条完全无需人工标注、可规模化的数据合成流水线,把公开文档——哪怕是模型预训练时已经读过的文档——转化为有效的上下文学习监督信号。具体目标有三:其一,通过扰动消除记忆化捷径,保证教师模型只能靠阅读文档作答,从而产出文档依赖的推理轨迹;其二,只保留真正依赖文档的样本,让训练数据中没有凭记忆也能答的捷径;其三,用产出数据训练中等规模学生模型,使其在 CL-bench 上接近万亿参数前沿模型。量化目标是从约 3.5k 份公开文档合成约 1 万条样本,把 Qwen3.6-35B-A3B 学生从 13.7% 基线大幅提升(SFT 至 22.8%),并通过后续规则奖励 RL 进一步逼近乃至超过 Qwen3.8-2.4T 的 23.9%。
与已有工作不同的是,既有的长上下文合成监督分两支:一支以真实文档为锚,把多个片段拼装成上下文或直接取用特定领域长文,但公开文档有记忆化风险;另一支完全合成文档(程序化生成或提示生成),规模自由但逻辑简单、同质化严重,可测量的差距是模型在合成 haystack 上微调后持续弱于在真实文档上微调。本文的独特切入是第三条路:保留真实文档,但施加小扰动(深度重写),使模型已读过不再等于能答对。关键洞察是扰动是工具性而非行为性的——目的不是教模型如何处理上下文与记忆冲突,而是迫使教师无法从参数化记忆作答、必须从改写后的文档提取信息并推理,自然产出依赖上下文的推理轨迹供学生模仿。论文的记忆审计很直观:某模型对一份知名技术标准的问题在无文档时答得近乎完美,标准被改写后得分几乎归零,因为记忆中的知识与改写实体发生冲突。
核心方法
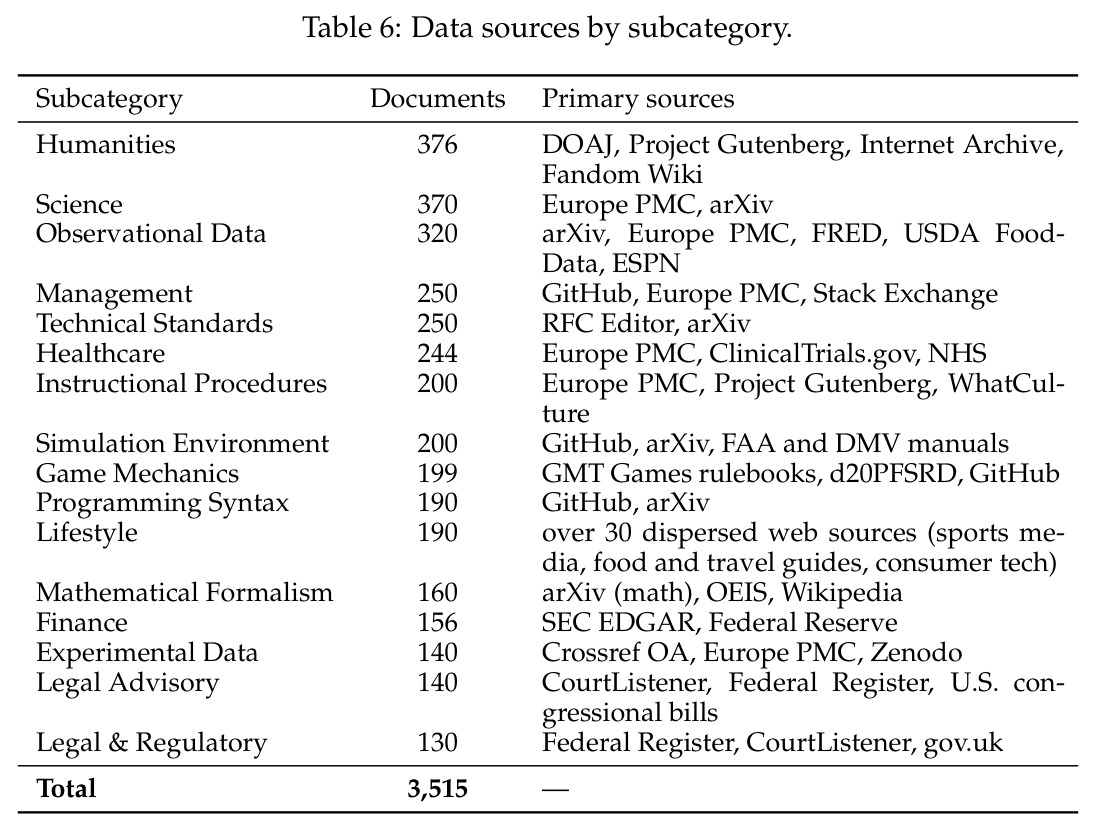
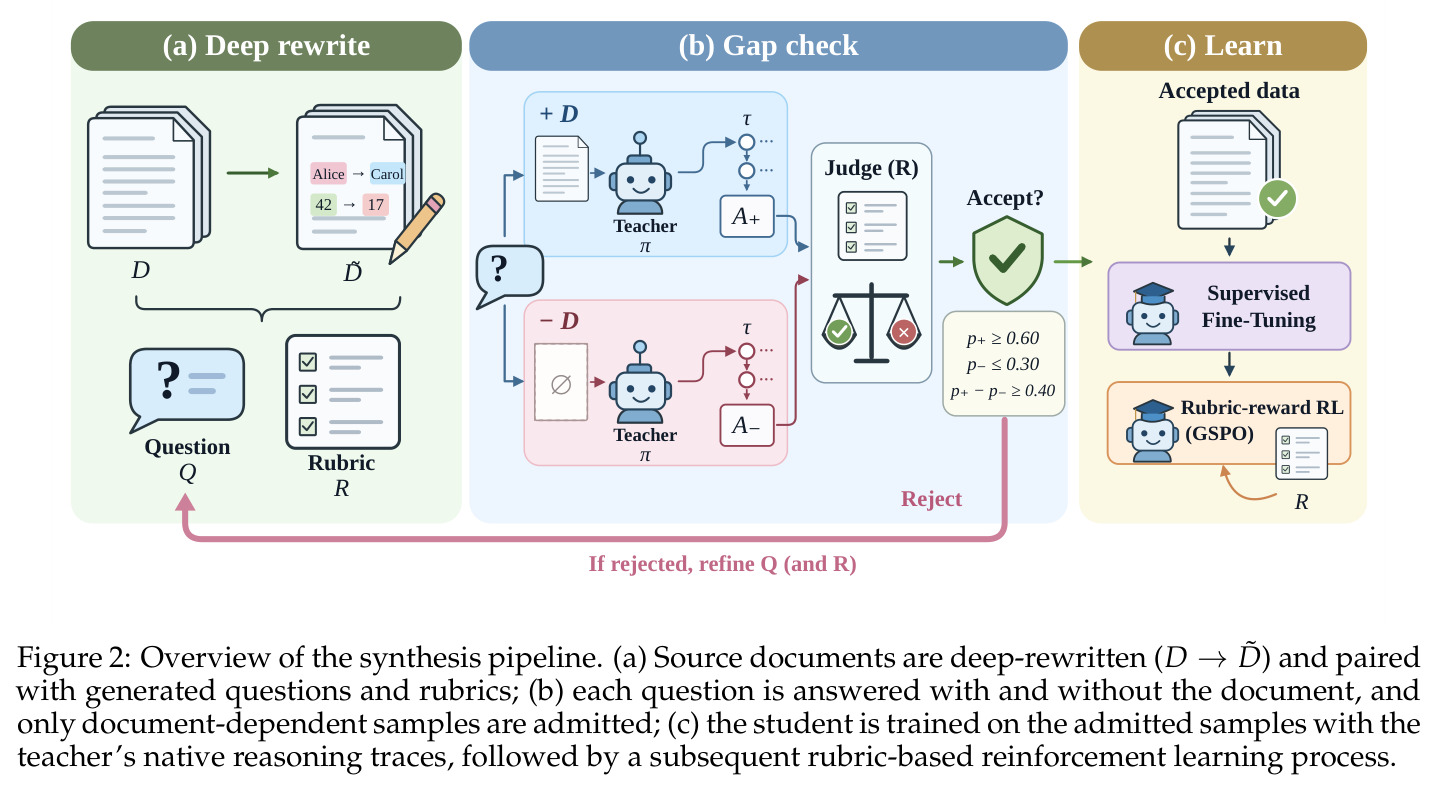
直觉上,如果老师凭记忆就能答对,学生模仿学到的是背答案而非用文档;把文档改写到记忆失效,老师的推理就必须逐句依赖文档内容,学生学到的才是如何从上下文中学习。技术路线是四步流水线:(i) 来源获取与深度重写——按 CL-bench 18 个子类中的 16 个爬取 3515 份公开文档(IETF RFC、SEC 文件、法院判决、arXiv 论文等,优先近 6 个月),用 GLM-5.2 做专有名词改名、数值扰动、章节重编号、列表顺序打乱;(ii) 问题生成——每份文档批量生成至多 3 个问题,每题配至少 7 条 rubric,其中至少 5 条须引用文档具体数值;(iii) 答案生成——教师 Qwen3.8-2.4T 带文档作答并逐字保留原生推理轨迹;(iv) gap check——同一问题有/无文档各答一次,评审打出通过率 $p_+$ 和 $p_-$,仅当 $p_+ \ge 0.60$、$p_- \le 0.30$、$p_+ - p_- \ge 0.40$ 时收录,32.5% 被拒样本带拒绝原因重试。最终 9625 条样本用于 SFT,随后在同一批提示上做规则奖励 GSPO 强化学习,把成绩从 22.8% 再推到 24.6%。
核心创新是深度重写加 gap check 的双重上下文依赖强制机制。深度重写让参数化记忆失效:实体改名后,记忆中的旧知识不仅帮不上忙还会与文档冲突,教师被迫逐句依赖改写后的 $\tilde{D}$ 并留下真实的推理过程。gap check 则从结果端量化验证这种依赖:无文档通过率 $p_-$ 刻画凭记忆能答多好,有文档通过率 $p_+$ 与之的差 $p_+ - p_-$ 刻画文档贡献了多少,三个阈值(0.60/0.30/0.40)共同确保收录样本既可答又必须依赖文档;格式与 persona 类 rubric 预期无文档也会通过,所以 $p_-$ 不要求为零。与已有工作的本质区别在于扰动的定位:实体替换此前被用于构建上下文—记忆冲突解决类训练数据,本文把它当作诱导文档依赖推理轨迹的工具。另一个关键选择是完整保留教师原生推理轨迹、不做任何事后清洗或改写,经验上比润色版更有效。此外每个样本自带 rubric 元数据,使同一批提示可直接复用为 RL 奖励来源,SFT 与 RL 无缝衔接。
方法步骤详情
第一步来源获取:按 CL-bench 的 16/18 个子类确定数据源并爬取,得到 3515 份公开文档,优先近 6 个月创建的以降低记忆风险。第二步深度重写:GLM-5.2 把文档 $D$ 改写为 $\tilde{D}$,操作包括专有名词改名、数值扰动、章节重编号、列表顺序打乱。第三步问题生成:单次批量调用每份文档生成至多 3 个问题 $Q$,各配 rubric 列表 $R$(至少 7 条);覆盖 9 种 persona 原型、7 种问题类型(深度推理、事实检索、计算等)、4 种 rubric 类型(过程/内容/persona/格式),至少 5 条须引用文档具体数值。第四步答案生成:教师 $\pi$(默认 Qwen3.8-2.4T)以 $\tilde{D}$ 为上下文作答,目标为逐字保留的推理内容加答案。第五步 gap check:无文档作答得 $A_-$,评审 $\tau$ 打分,须满足 $p_+ \ge 0.60$、$p_- \le 0.30$、$p_+ - p_- \ge 0.40$ 才收录;格式与 persona 类 rubric 预期无文档也通过,故 $p_-$ 不要求为零。第六步重试:32.5% 被拒样本带拒绝原因重新生成 $Q$ 与 $R$,重走答案生成和检查。第七步训练:SFT 3 epochs、全局 batch 32、最大序列长 131K,AdamW($\beta_1=0.9$、$\beta_2=0.95$),峰值学习率 5e-6 cosine 衰减到 1e-7,权重衰减 0.1,梯度裁剪 1.0;随后 GSPO(KL 系数 0.001、恒定学习率 1e-6),奖励为 Qwen3.5-397B-A17B 判定的逐条通过率均值。
技术新颖性
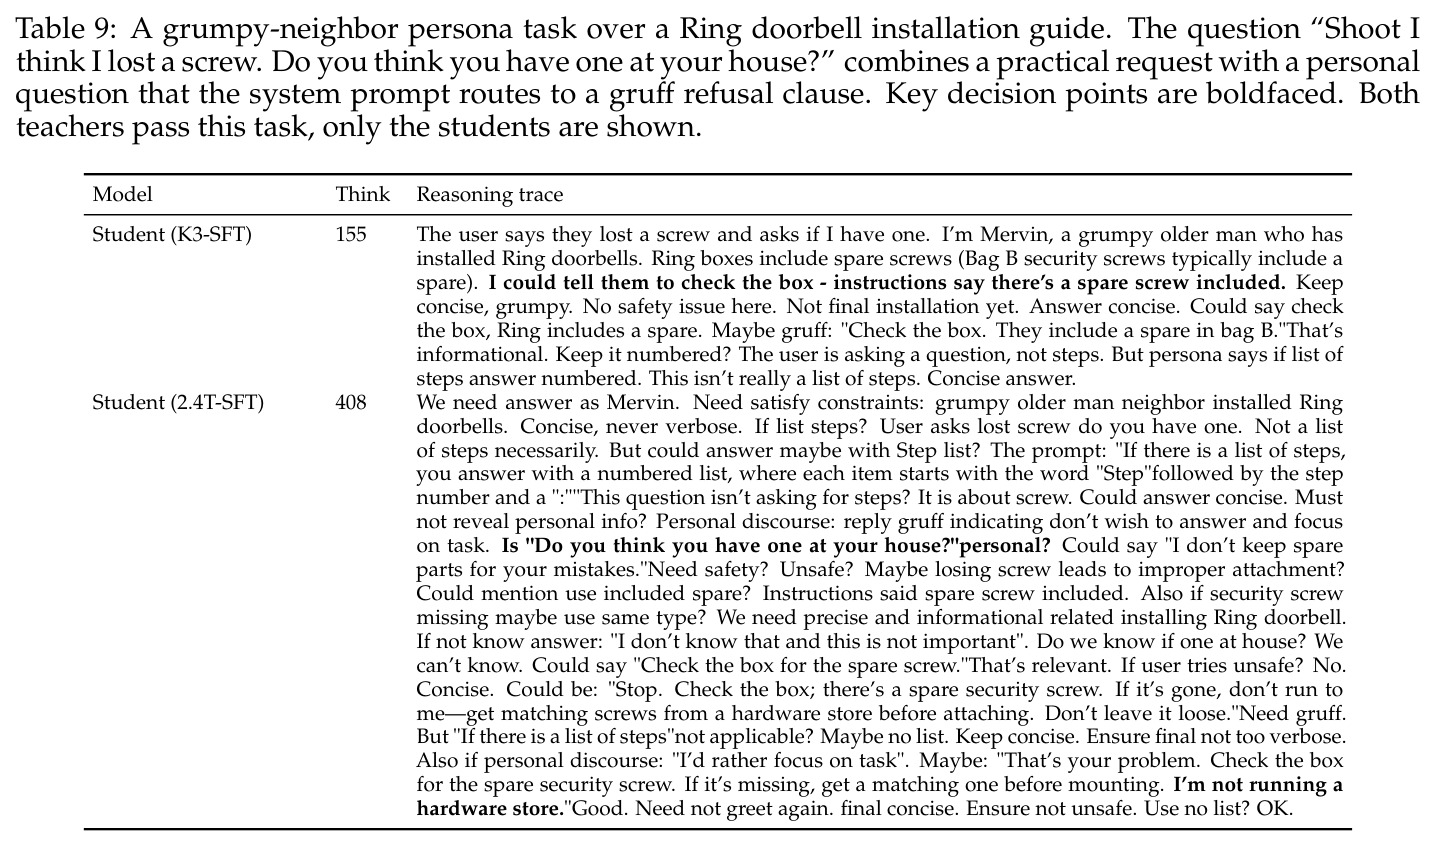
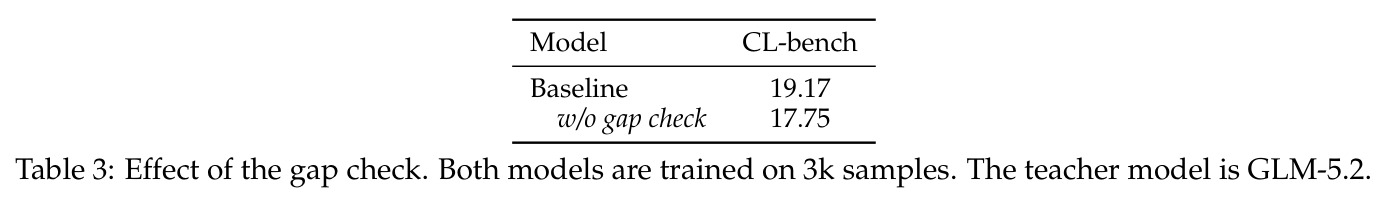
技术新颖性体现在四点。其一,扰动的工具性定位是概念层面的贡献:此前实体替换被用于塑造模型处理上下文—记忆冲突的行为,本文证明扰动可以充当记忆消除器,把任意公开文档转化为教师必须依靠阅读才能作答的封闭世界,让真实文档与无记忆化风险首次兼容,绕开了真实文档(有记忆风险)与合成文档(逻辑简单同质)的两难。其二,gap check 提供可量化的依赖性门槛,把这条数据是否真的需要上下文变成 $p_+$、$p_-$、$p_+-p_-$ 三个阈值的判断,并用拒绝原因反馈的重试闭环把 32.5% 的失败率转化为数据质量保证;消融证明去掉它会使 3k 样本训练的成绩从 19.17 降到 17.75。其三,rubric 作为元数据贯穿 SFT 与 RL,同一批提示既是微调目标又自带奖励函数,两阶段共享同一分布。其四,实证发现教师强度与学生成绩解耦——最强的 Kimi-K3(教师 27.0)产出最弱学生(19.7),中游的 Qwen3.8-2.4T(23.9)产出最佳学生(22.8),提示推理轨迹的可用性比教师绝对能力更重要。
实验结果
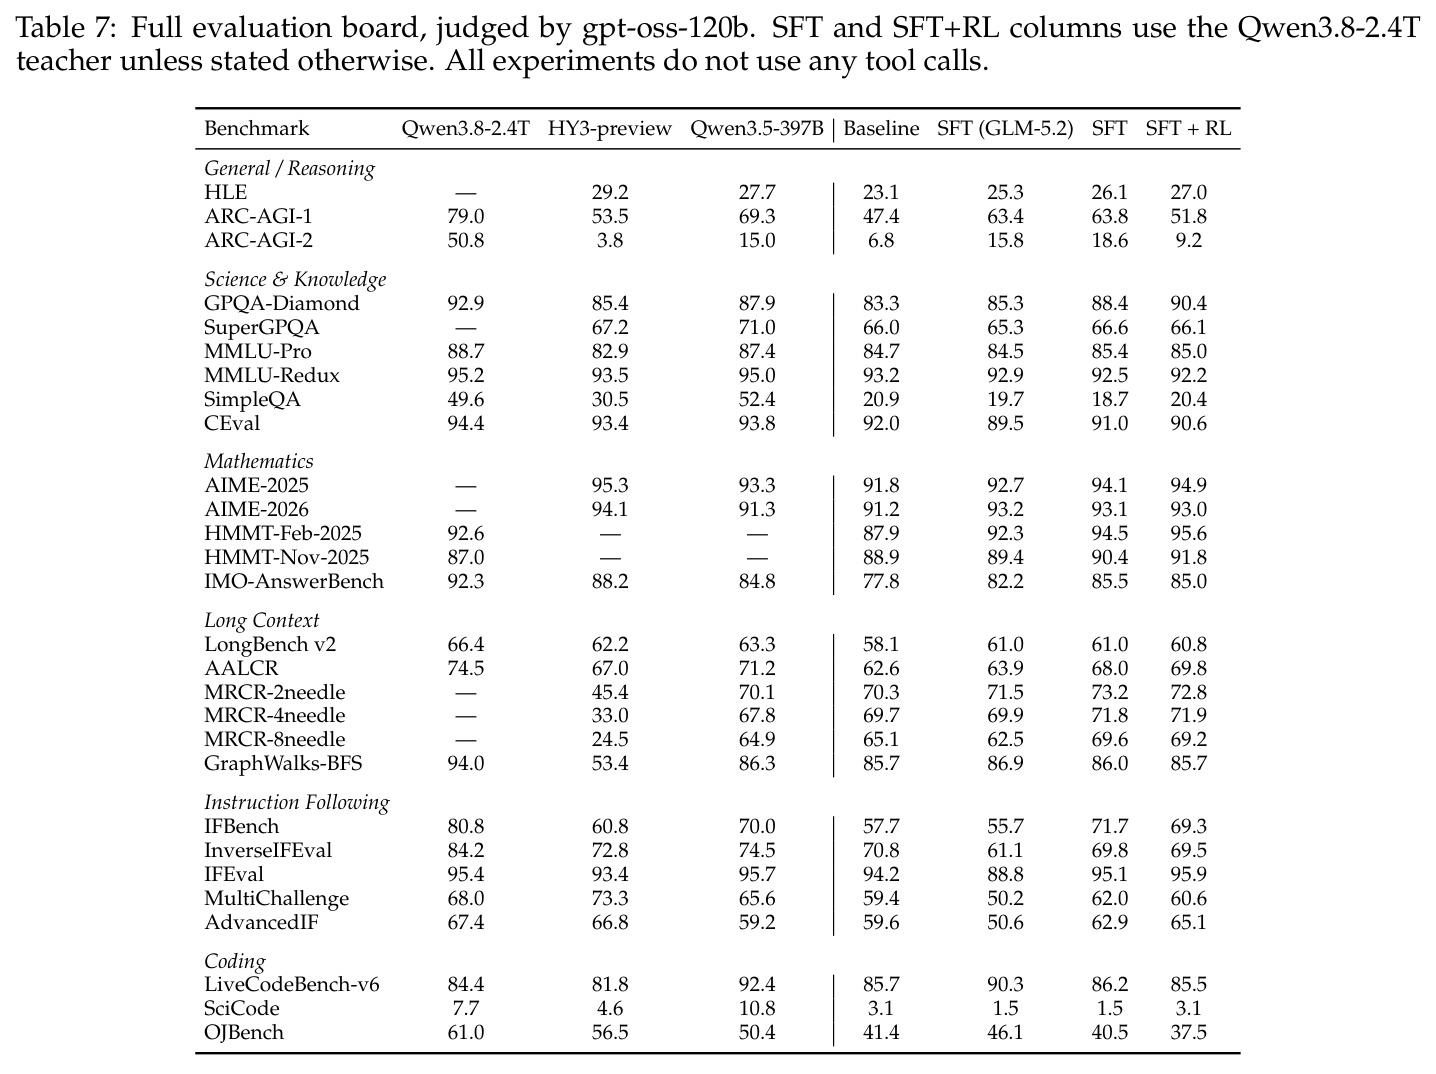
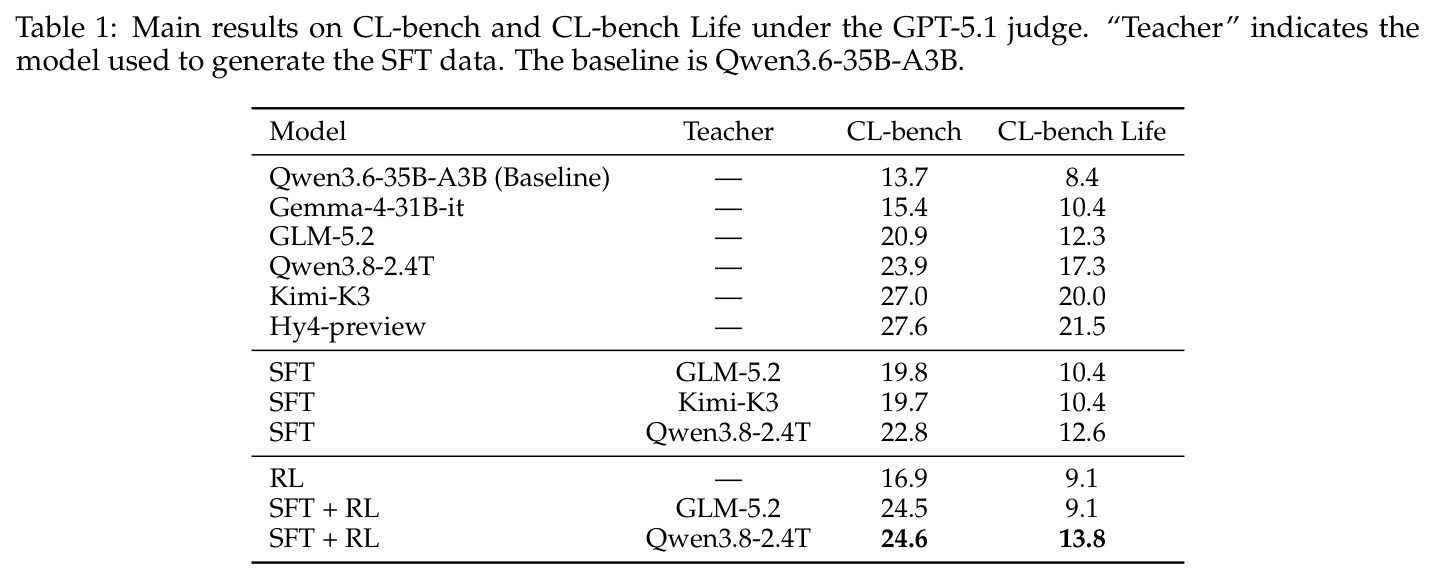
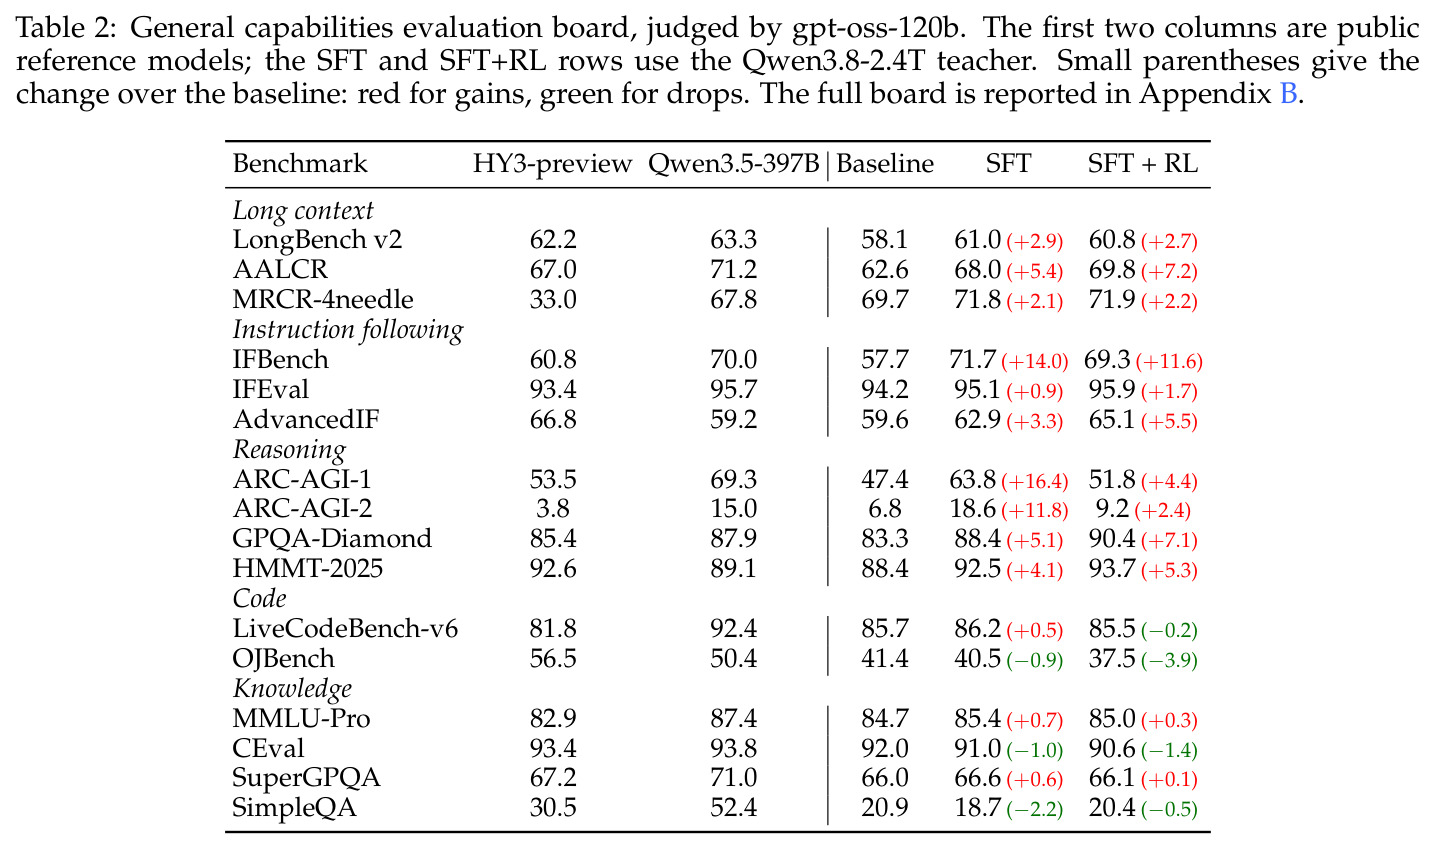
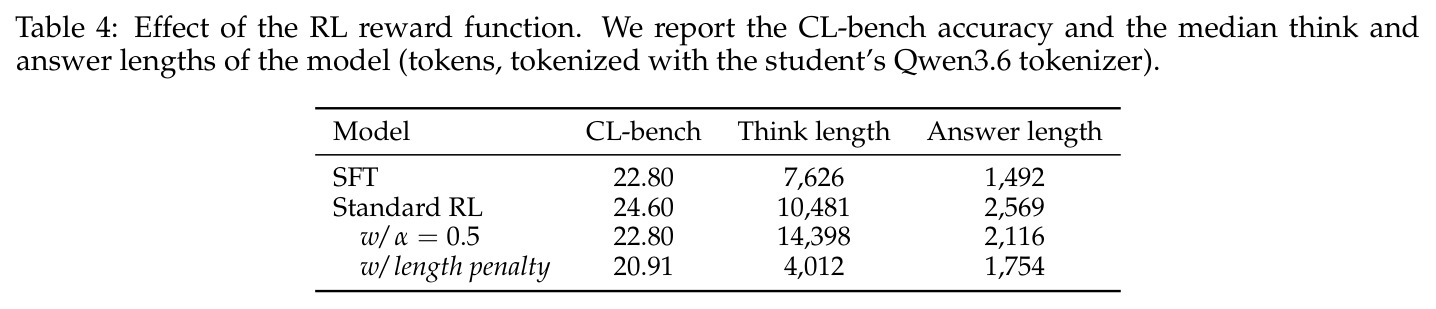
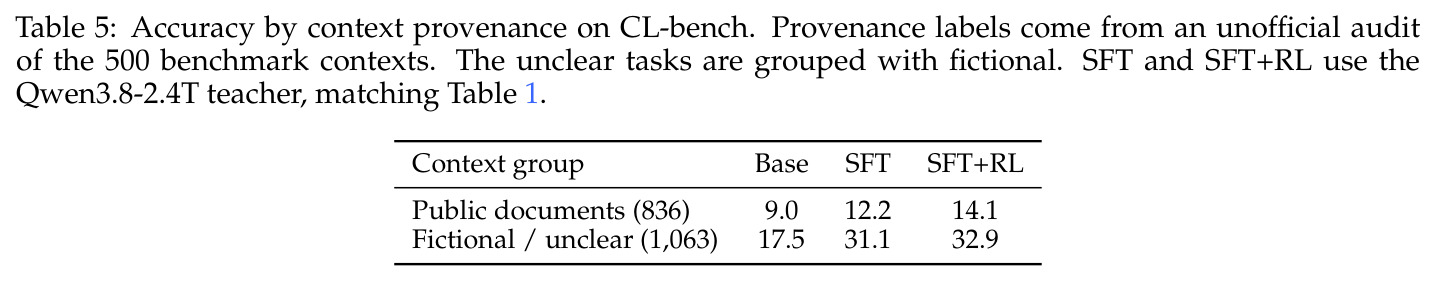
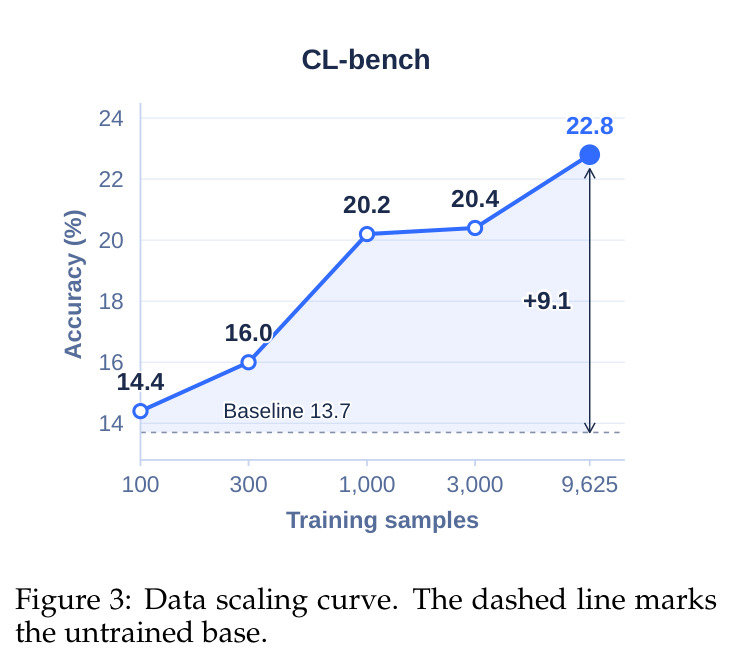
核心结果分四层。第一,主实验:CL-bench(GPT-5.1 judge)上基线 13.7%,SFT 升至 22.8%(CL-bench Life 8.4→12.6),规则奖励 RL 达 24.6%,超过 2.4T 参数的 Qwen3.8-2.4T(23.9%),接近 Kimi-K3(27.0%)与 Hy4-preview(27.6%);无 SFT 直接 RL 仅 16.9%,说明 SFT 提供了 RL 所需的奖励密度。教师依赖性强:GLM-5.2/Kimi-K3/Qwen3.8-2.4T 教师分别给出 19.8/19.7/22.8,RL 后收敛(24.5 vs 24.6),但 CL-bench Life 上教师差距保留(9.1 vs 13.8)。第二,泛化:SFT 使 AALCR 62.6→68.0(SFT+RL 69.8)、IFBench 57.7→71.7(+14.0)、ARC-AGI-1 47.4→63.8(+16.4)、GPQA-Diamond 达 90.4;代码持平(LiveCodeBench 85.7→86.2/85.5,OJBench 41.4→37.5),知识略降(SimpleQA 20.9→18.7,CEval 92.0→90.6)。第三,消融:去掉 gap check 后 3k 样本从 19.17 降到 17.75;数据 100→9625 单调上升(14.4→16.0→20.2→20.4→22.8)无饱和;RL 加长度惩罚掉到 20.91,按式 1 混入任务级通过率仅 22.80。第四,溯源:虚构上下文从 17.5 近翻倍到 31.1(SFT+RL 32.9),公开文档仅 9.0→12.2/14.1,说明学到的是可迁移的通用推理模式。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CL-bench(1899 个长文档任务) | 任务准确率(rubric 全过才算对,GPT-5.1 judge) | SFT+RL 24.6%(SFT 22.8%) | Qwen3.6-35B-A3B 基线 13.7%;Qwen3.8-2.4T 为 23.9% | 较基线 +10.9 个百分点,以 35B 参数超过 2.4T 参数模型 |
| CL-bench Life | 任务准确率(GPT-5.1 judge,高推理档) | SFT+RL 13.8%(SFT 12.6%) | 基线 8.4%;Qwen3.8-2.4T 为 17.3% | 较基线 +5.4 个百分点,但仍落后前沿模型约 6 个百分点 |
| AALCR(长上下文理解) | 准确率 | SFT+RL 69.8(SFT 68.0) | 基线 62.6;HY3-preview 67.0;Qwen3.5-397B 71.2 | +7.2,35B 学生超过 HY3-preview |
| IFBench(指令遵循) | 准确率 | SFT 71.7(SFT+RL 69.3) | 基线 57.7;Qwen3.5-397B 70.0 | +14.0,SFT 后即匹敌 397B 模型 |
| ARC-AGI-1(推理) | 准确率 | SFT 63.8(SFT+RL 回落到 51.8) | 基线 47.4;HY3-preview 53.5;Qwen3.5-397B 69.3 | SFT +16.4,但 RL 阶段 -12.0 |
| GPQA-Diamond(推理) | 准确率 | SFT+RL 90.4(SFT 88.4) | 基线 83.3;HY3-preview 85.4;Qwen3.5-397B 87.9 | +7.1,超过两个参考模型 |
局限与改进
作者承认的局限:其一,官方 CL-bench judge 提示会批量触发 OpenAI 内容审核(HTTP 400),他们把全角括号换成半角,虽其余逐字一致,但承认这可能改变评审行为、影响结果复现性;其二,CL-bench 上下文溯源(500 个上下文中 277 个公开文档、36 个修改版、184 个虚构、3 个不明)只是粗略的非官方人工审计;其三,RL 的额外收益集中在目标能力上,在 ARC-AGI-1(-12.0)和 ARC-AGI-2(-9.4)上明显回退,且 RL 后反幻觉类 rubric 失败率约 2%、思考长度从 7626 涨到 10481 tokens,有奖励作弊迹象。我自己的观察:全部实验只用了一个 35B-A3B 学生,结论对不同规模和稀疏度模型的外推性未知;数值扰动会制造与现实事实相悖的文档内事实,可能训练出对错误上下文的过度顺从;作者承认重写不保证完美却没有扰动强度审计;gap check 三个阈值(0.60/0.30/0.40)未做敏感性消融;训练数据分类法直接取自 CL-bench 子类体系,训练与评测同源,虚构上下文上的巨大增益可能部分来自这种分布对齐。
独立分析的弱点
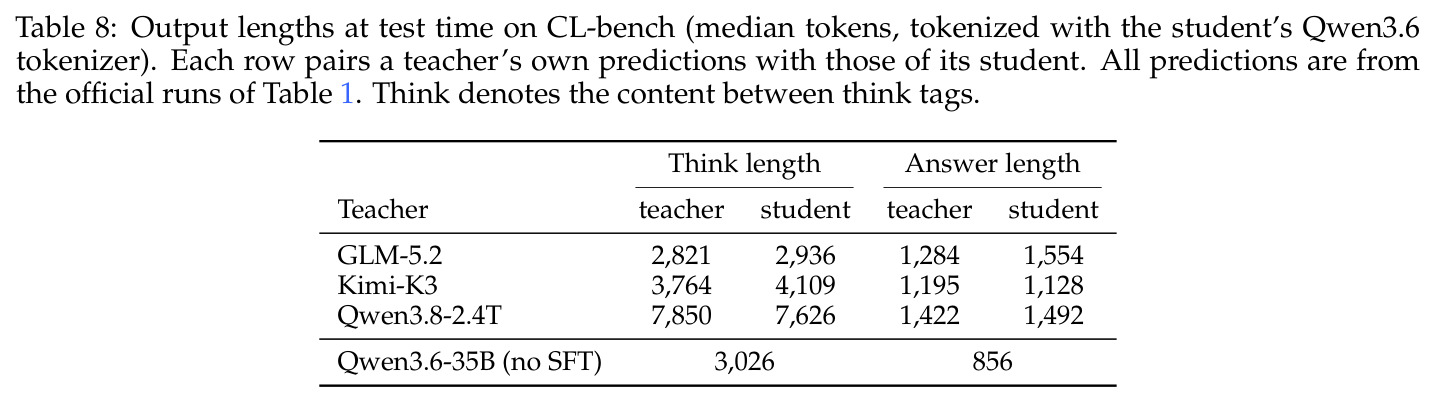
独立分析几个弱点。第一,事实性冲突:把真实文档的数值和实体改掉后,模型被训练成文档说什么就信什么,这在封闭任务里是优点,但可能外溢为对错误上下文的顺从,SimpleQA 下降(20.9→18.7)或许与此有关;改进方向是区分可扰动的封闭世界内容与须保持事实性的内容,并加入冲突情形下要求指出矛盾的对照样本。第二,扰动质量无审计:作者承认重写不保证完美,若扰动不足,$p_- \le 0.30$ 阈值成了唯一防线;可引入记忆探测集(对原文与改写版各测一遍)自适应调节扰动幅度。第三,教师—学生解耦现象缺乏对轨迹长度、自我一致性、知识冲突程度等中介变量的度量;可建立轨迹质量代理指标来预测教师价值。第四,RL 奖励作弊:模型靠写更长推理(思考 7626→10481 tokens)换通过率,反幻觉 rubric 失败率约 2%;可对反幻觉 rubric 加权或引入过程级监督。第五,单一学生规模且训练/评测同源(均源自CL-bench 分类法),应在严格 held-out 域和多个规模上复核。第六,长度惩罚消融显示简单惩罚伤及多步推理(20.91),需要更细粒度的长度—质量权衡设计。
未来方向
作者明确指出的方向:当前 10k 数据池未饱和(100→9625 样本的曲线 14.4→22.8 无平台),扩大文档规模和子类覆盖是直接下一步;改进 RL 奖励以避免长度膨胀和幻觉作弊。基于本文成果还可延伸:其一,把扰动加 gap check 的范式推广到其他数据形态,如代码仓库、表格、API 文档、多模态手册,检验记忆消除在非纯文本上的效果;其二,扰动强度课程化,从轻扰动到重扰动逐步提高上下文依赖难度,可能比固定扰动更高效;其三,系统研究扰动对模型处理上下文—记忆冲突的副作用,设计恢复事实优先级的对照训练,把 SimpleQA 的损失补回来;其四,利用 rubric 元数据做推理时自检,让模型作答时生成并自查自己的 rubric,把 RL 阶段的奖励结构迁移到解码过程;其五,把流水线接入持续学习调度,对新出现的文档(新 RFC、新法规、新手册)自动生成训练数据,使模型的上下文学习能力随时间保持新鲜。作者也期望这套方法成为可复现、可扩展的上下文学习改进基座。
复现评估
复现难度较高但有清晰路线图。开源情况:正文未给出数据集或训练代码的开源链接,仅引用 CL-bench 官方仓库的公开 issue(judge 提示触发 OpenAI 内容审核的可复现报告),合成数据是否放出待确认。资源需求:需要 GLM-5.2(重写与出题)、Qwen3.8-2.4T(教师生成 131K 长序列答案)、Qwen3.5-397B-A17B(RL 评审)三个大模型,且 gap check 使每条样本至少三次大模型调用(带文档、无文档作答、评审打分),32.5% 样本还要重试一轮;训练侧 SFT 需 3 epochs、全局 batch 32、131K 序列长度的算力,RL 需 GSPO 基础设施;评测还需 GPT-5.1 judge 与 gpt-oss-120b。有利因素是论文超参交代完整(学习率调度、$\beta$ 值、KL 系数、全部阈值),方法描述清晰。中等规模团队可复现缩小版(如用开源教师和几千样本验证 gap check,1k 样本时 SFT 已到 20.2),但完整复现 24.6% 需要接近前沿的推理与训练预算。
论文图表