TGRL:面向大语言模型高效探索的温度分组强化学习 TGRL: Temperature-Grouped Reinforcement Learning for Efficient Exploration in LLMs
把温度差变成可估计的探索收益信号,用JS散度做token级信用分配加速RLVR
前置知识
RLVR(可验证奖励强化学习)
用可自动核验的结果(数学答案对错、代码是否通过测试)作为奖励信号,对 LLM 做策略梯度后训练的范式。代表算法 GRPO 对每个 prompt 采样一组回答,用组内奖励的均值 $\mu_g$ 和方差 $\sigma_g$ 把奖励归一化为优势 $A_i=(R_i-\mu_g)/\sqrt{\sigma_g^2+\epsilon}$,再做策略梯度更新,无需价值网络。
TGRL 是对 GRPO 类组归一化范式的直接改进,理解组采样与优势归一化是看懂混合温度分组的必要前提。
采样温度(temperature)
解码时把 logits 除以 $T$ 再 softmax:$T<1$ 使分布更尖锐、采样保守,$T>1$ 使分布更平坦、采样更随机。rollout 阶段的温度直接决定轨迹多样性,是 RLVR 中控制探索强度的主要旋钮。
TGRL 的核心动作是把 $T$ 从单纯的解码参数升级为构造训练信号的受控扰动,全文围绕 $T_0=0.3$ 与 $T_1=1.2$ 的对比展开。
JS 散度(Jensen–Shannon divergence)
两个概率分布差异的对称、有界(上界 $\ln 2$)度量,定义为 $\mathrm{JS}(p,q)=\tfrac{1}{2}\mathrm{KL}(p\|m)+\tfrac{1}{2}\mathrm{KL}(q\|m)$,其中 $m=\tfrac{1}{2}(p+q)$ 是中点分布,比 KL 更稳定且可交换。
TGRL 用同一 logits 在 $T_0,T_1$ 下两个 next-token 分布的 JS 散度 $\mathcal{J}_{i,t}$ 衡量每个位置对温度扰动的敏感度,是 token 级信用分配的度量核心。
优势估计与 PPO 裁剪目标
策略梯度中优势 $A$ 衡量动作相对期望回报的好坏,$A>0$ 时增大该动作概率;PPO 用重要性比 $r_t(\theta)=\pi_\theta/\pi_{\theta_{old}}$ 的 clip 限制单步更新幅度。组归一化 advantage 用采样组统计量代替价值网络。
TGRL 的混合组优势分解(Proposition 1)与 token 级加权优势 $w_{i,t}A_i$、最终裁剪目标 $\mathcal{L}_{TGRL}$ 都建立在优势估计和 PPO 框架之上。
Pass@k 与 Avg@k
Pass@k 指每题采 k 个候选、至少一个通过评测的概率,衡量探索上限;Avg@k 是 k 次采样成绩的平均,反映平均解码质量。二者共同刻画模型在多样性与稳定性两个维度上的表现。
论文数学主表用 Avg@16,代码表用 Pass@16,理解这两个指标的差别才能正确解读提升幅度的含义(上限扩展 vs 平均质量)。
研究动机
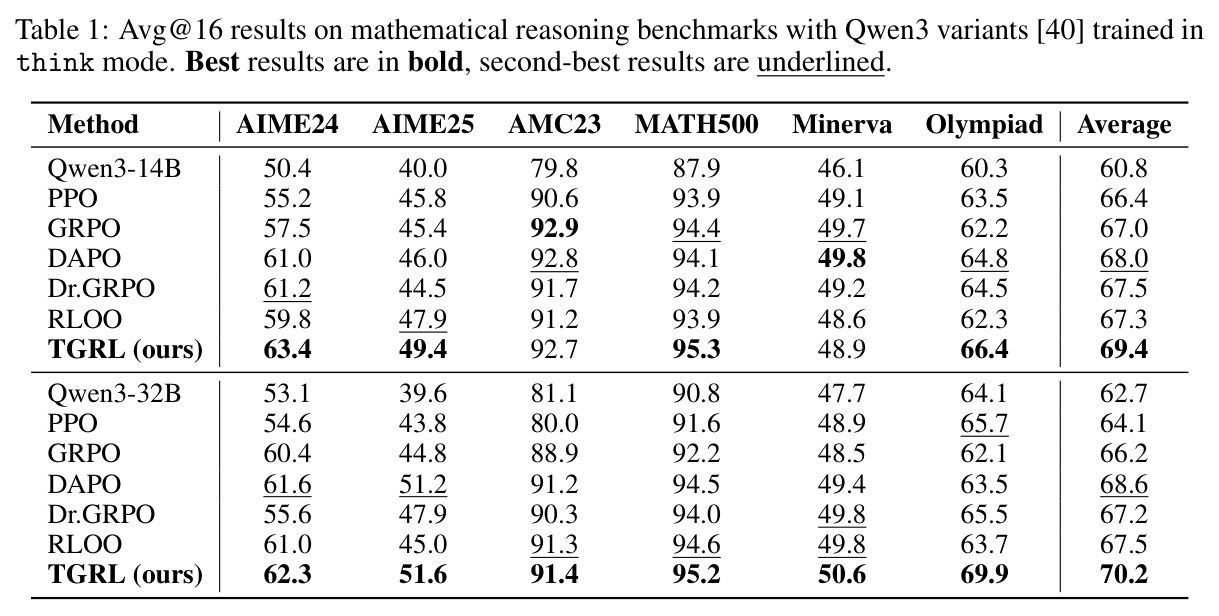
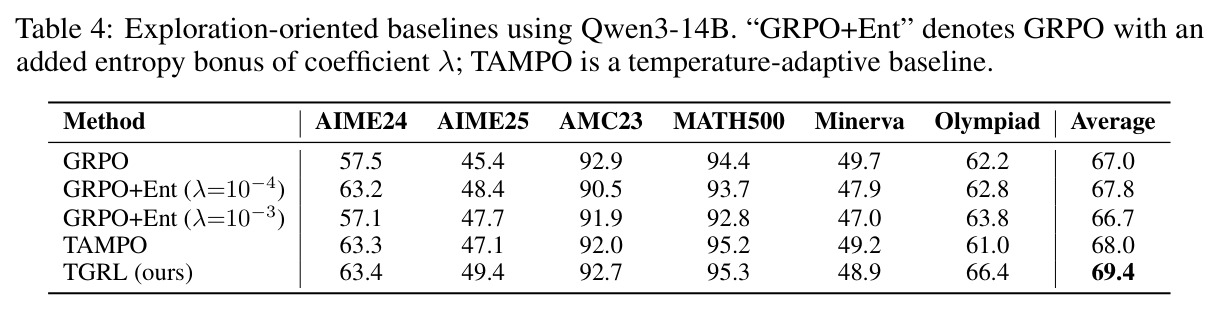
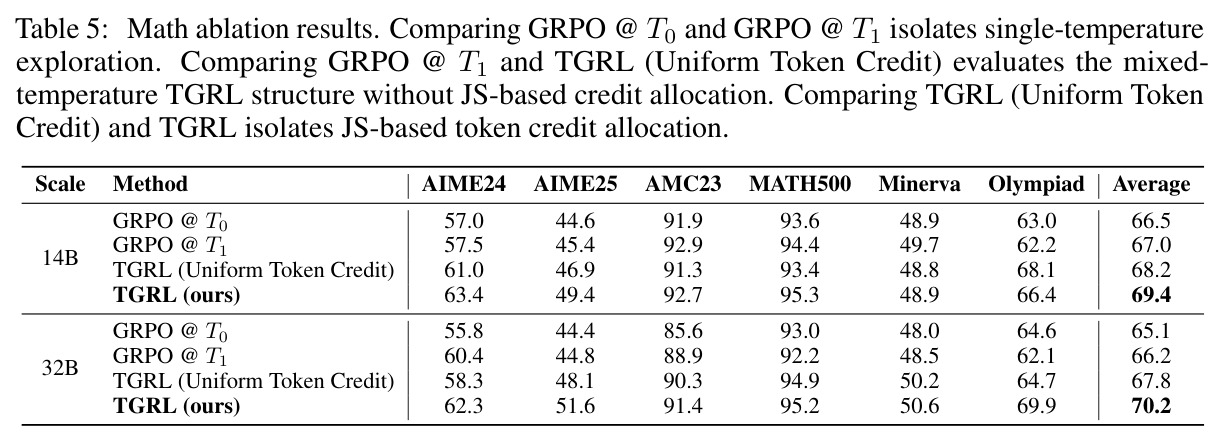
RLVR(可验证奖励强化学习)已成为提升 LLM 推理能力的主流后训练范式,但其效果严重依赖高效探索:策略必须在有限 rollout 预算内找到多样且高奖励的轨迹,否则会过早收敛到狭窄的解码模式,封住性能天花板。现有做法分两类:一是 test-time scaling,直接增加采样数量,代价是推理成本成倍增长;二是温度控制或温度调度(如 TAMPO),在 rollout 时提高采样随机性。但论文的对照实验显示单纯升温收益有限:Qwen3-14B 上 GRPO@T1 相比 GRPO@T0 六基准平均仅从 66.5% 提到 67.0%,32B 上从 65.1% 提到 66.2%。根本问题在于:这些方法要么扩大采样预算,要么把探索当作全局正则(熵奖励)、辅助目标(pass@k)或解码策略(温度调度),从未量化“这一次探索到底值多少奖励”,rollout 阶段的多样性与策略梯度更新之间缺少显式连接。
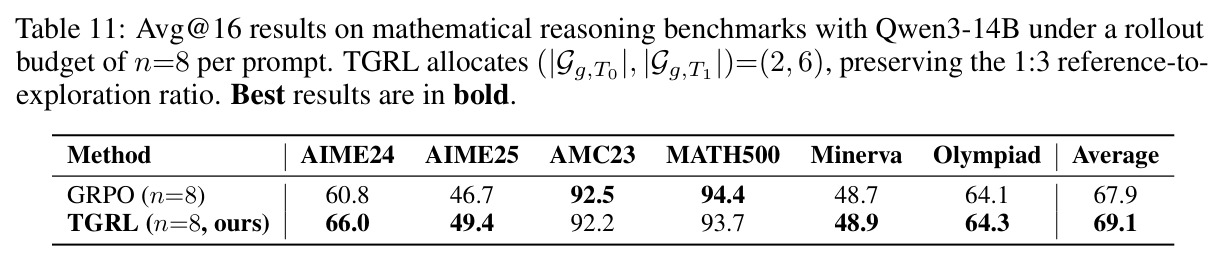
本文的目标是本文的目标是:在不扩大 rollout 预算(每题仍只采 4 条)的前提下,把温度诱导的采样多样性转化为显式的训练信号,并精确路由到最需要它的 token 上。具体拆成两个可检验的子目标:其一,为每个 prompt 估计“探索收益”——即放宽温度后可验证奖励到底提升多少,并证明低/高温组的平均奖励差 $\Delta R_g=?ar{R}^{T_1}_g-?ar{R}^{T_0}_g$ 是该收益的无偏估计;其二,把这个 prompt 级标量信号分配成 token 级信用,让策略梯度集中更新温度敏感的位置,而不是把信号摊平到整条序列。最终在数学、代码、智能体三类共 11 个基准上验证:既更快收敛(等精度比 DAPO 快 36%),又有更高的最终精度。
与已有工作不同的是,已有 RLVR 探索工作的切入角度大致三种:熵正则(GRPO+Ent 在目标里加熵奖励)、pass@k 或搜索类辅助目标、温度调度策略(TAMPO 全局调度解码温度)。它们共同把探索当作全局层面的附加物,奖励信号本身不携带“探索是否划算”的信息。TGRL 的独特之处是把温度解释为对同一策略的可控扰动,从而第一次给出 reward-grounded、prompt 级的探索收益度量:同一模型在 $T_0=0.3$ 和 $T_1=1.2$ 下采样的平均奖励差直接量化“广撒网值不值”;再借助 JS 散度作为分布对温度扰动的局部响应度量,把组级信号按 token 敏感度分配。这把“rollout 阶段的探索”与“训练阶段的信用分配”两个原本脱节的环节,用一套理论(Lemma 1 与 Proposition 1/2)串成了闭环。
核心方法
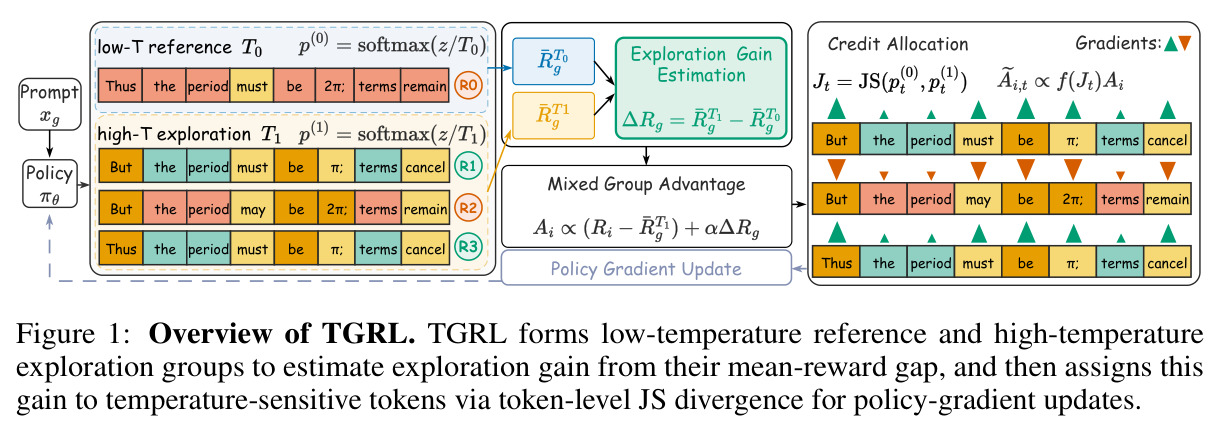
直觉上,TGRL 给每道题打一个“探索值不值”的分数:同一 prompt 用低温 $T_0=0.3$ 采 1 条参考,再用高温 $T_1=1.2$ 采 3 条探索,两组平均奖励之差 $\Delta R_g$ 为正说明放宽温度确有收益。技术路线三步:第一,两类 rollout 混成一组归一化,优势 $A_i=(R_i-\mu_g)/\sqrt{\sigma_g^2+\epsilon}$,理论上高温样本的优势会自动叠加正比于 $\Delta R_g$ 的偏移(Proposition 1),探索收益直接进入奖励信号。第二,对高温 rollout 重放前向取 logits $z_{i,t}$,计算两温度下分布的 JS 散度 $\mathcal{J}_{i,t}$,它上界该位置期望连续价值随温度切换的变化量(Lemma 2、Proposition 2),是温度敏感度的“证书”。第三,用单调对数压缩把 $\mathcal{J}_{i,t}$ 变成归一化权重 $w_{i,t}$,token 优势取 $w_{i,t}A_i$,低温组优势置零,以 PPO 裁剪目标更新。rollout 预算仍是 4 条,与 GRPO 一致。
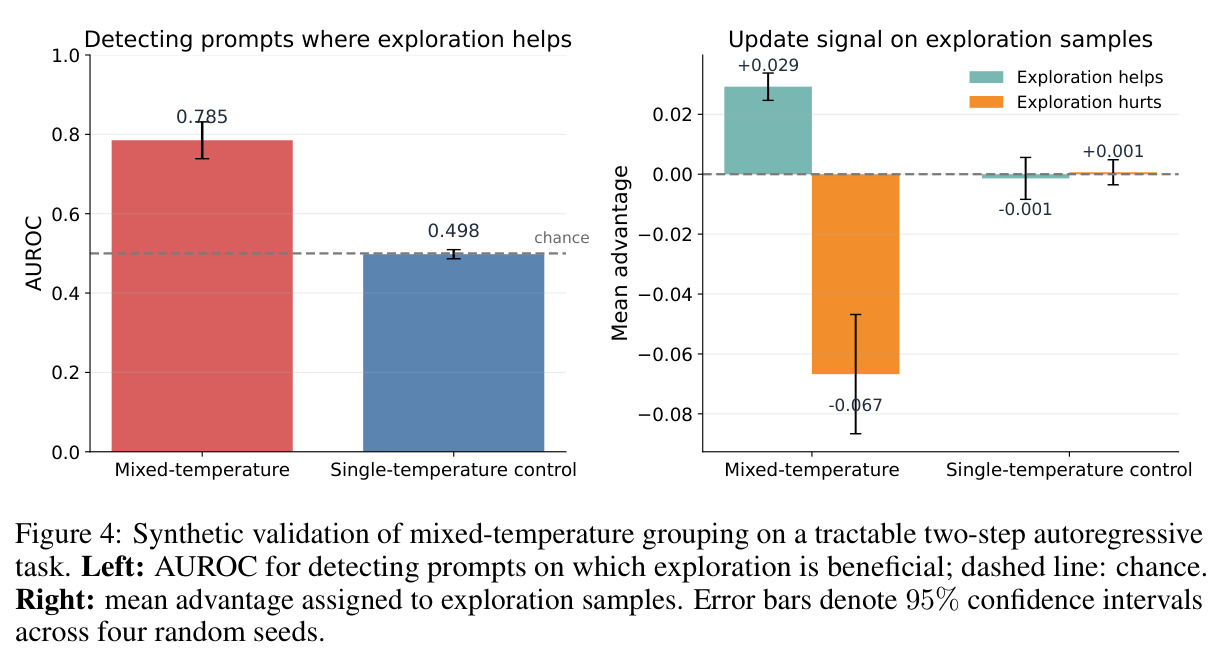
核心创新是把“探索收益”从隐性正则变成显式可估计的量,且有理论保证。与 GRPO 的本质区别在组结构:GRPO 假设同温组内轨迹已足够多样,组归一化只编码组内排序;TGRL 刻意制造温度对比,让组间奖励差承载新信息。Lemma 1 证明 $\mathbb{E}[\Delta R_g|x]=\mu^{T_1}(x)-\mu^{T_0}(x)$,即 $\Delta R_g$ 是探索收益的无偏估计,而均匀温度组归一化因组内无温度对比原则上得不到这个量。与温度调度类方法(TAMPO)的本质区别在信用分配:TAMPO 只改变“采什么样”,TGRL 进一步回答“奖励归谁”——Proposition 2 证明任何单调的 JS 加权都比均匀加权给温度敏感位置分配更多信用,且 $\sqrt{2\mathcal{J}_{i,t}}$ 上界了该位置期望连续价值在温度切换下的变化。消融数据支撑这种二分结构:14B 上混合温度分组(无 JS 加权)贡献 +1.2%(67.0→68.2),JS 信用分配再贡献 +1.2%(68.2→69.4)。
方法步骤详情
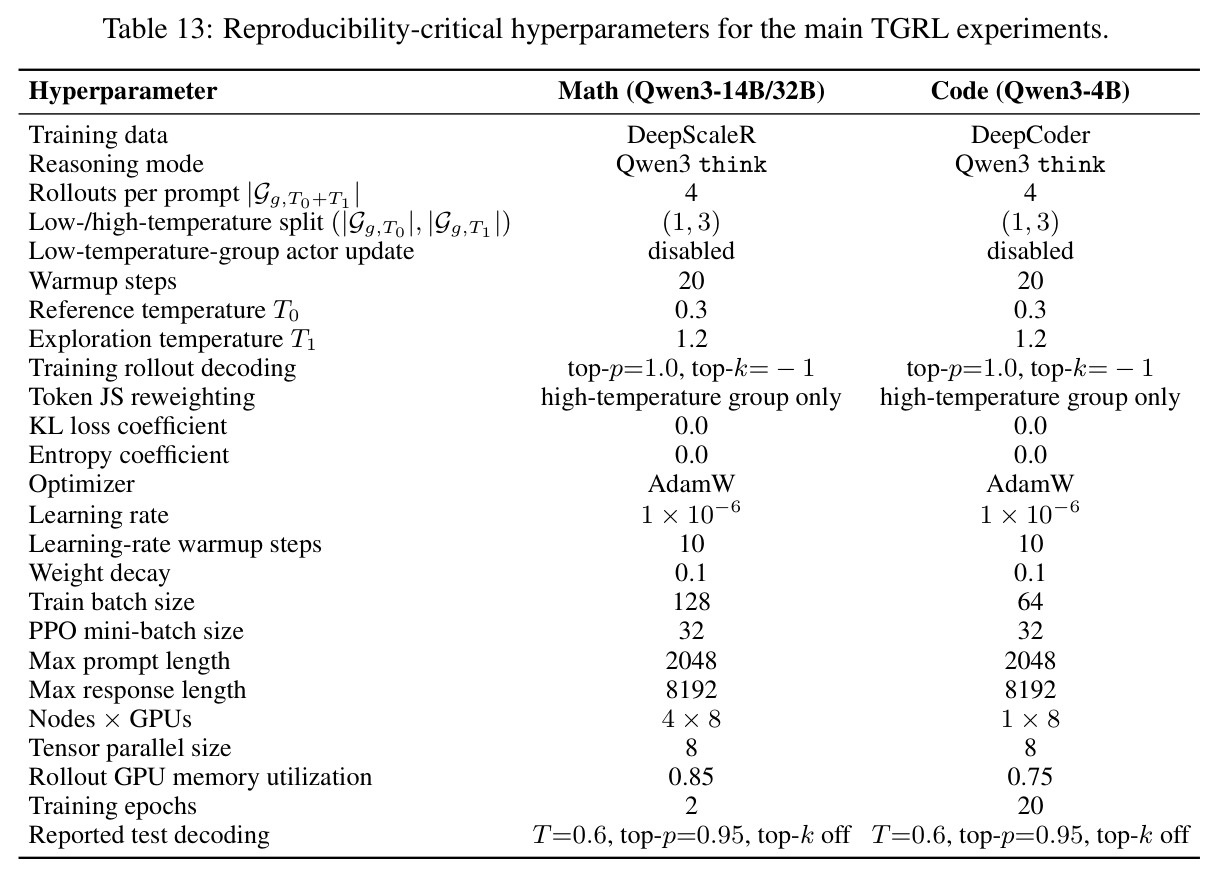
(1) 分组采样:每题用 $T_0=0.3$ 采 1 条参考、$T_1=1.2$ 采 3 条探索,预算 4 条不变;前 20 步 warmup 全部高温并优化标准单温组优势,防止低温组在策略稳定前退化。(2) 混合组优势:在两组并集上算 $\mu_g,\sigma_g$,得 $A_i=(R_i-\mu_g)/\sqrt{\sigma_g^2+\epsilon}$,输入 4 条奖励、输出逐轨迹优势。(3) token 敏感度:重放高温响应取 logits $z_{i,t}$,按 $p^{(k)}_{i,t}=\mathrm{softmax}(z_{i,t}/T_k)$ 计算两分布的 $\mathcal{J}_{i,t}$。(4) 权重构造:$\omega_{i,t}=\log(1+(\mathcal{J}_{i,t}+\epsilon)/(\bar{\mathcal{J}}_i+\epsilon))$ 对数压缩防尖峰,轨迹内归一化得 $w_{i,t}$(均值 1)。(5) 非对称优势:低温组 token 优势置 0(只贡献组统计),高温组为 $w_{i,t}A_i$。(6) 更新:以高温样本重要性比 $r_{i,t}(\theta)$ 做 PPO 裁剪目标,优化 $\mathcal{L}_{TGRL}$。
技术新颖性
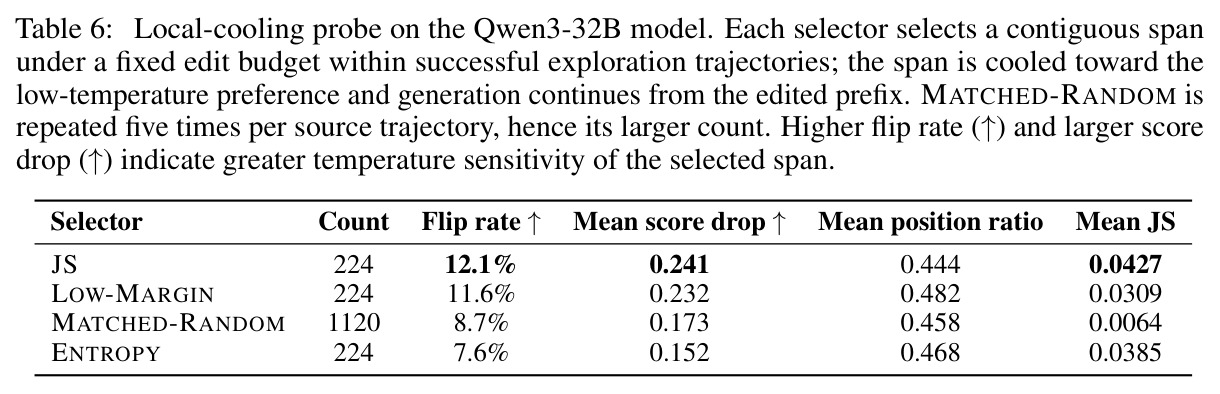
技术新颖性体现在四个层面。概念上,首次把采样温度建模为对同一策略的受控扰动而非解码超参,温度差因此成为可测量的实验干预,这是与温度调度类工作最深的分野。理论上有完整闭环:Lemma 1 给出探索收益的无偏估计及其方差 $\sigma^2_{T_1}/|G^{T_1}|+\sigma^2_{T_0}/|G^{T_0}|$;Proposition 1 证明混合组归一化等价于给高温优势叠加正比于 $\Delta R_g/\sqrt{\sigma_g^2+\epsilon}$ 的加性项;Lemma 2 用路径平均 logit 方差界住 JS;Proposition 2 在连续价值假设下证明 $\sqrt{2\mathcal{J}_{i,t}}$ 上界价值变化、单调加权必优于均匀加权。算法上,对数压缩加轨迹内归一化既平滑 JS 尖峰又保持平均权重为 1,低温组零梯度的非对称更新可避免竞争性更新方向。实证上,局部冷却探针显示 JS 选择器翻转率 12.1%、分数下降 0.241,均高于熵与边距基线。
实验结果
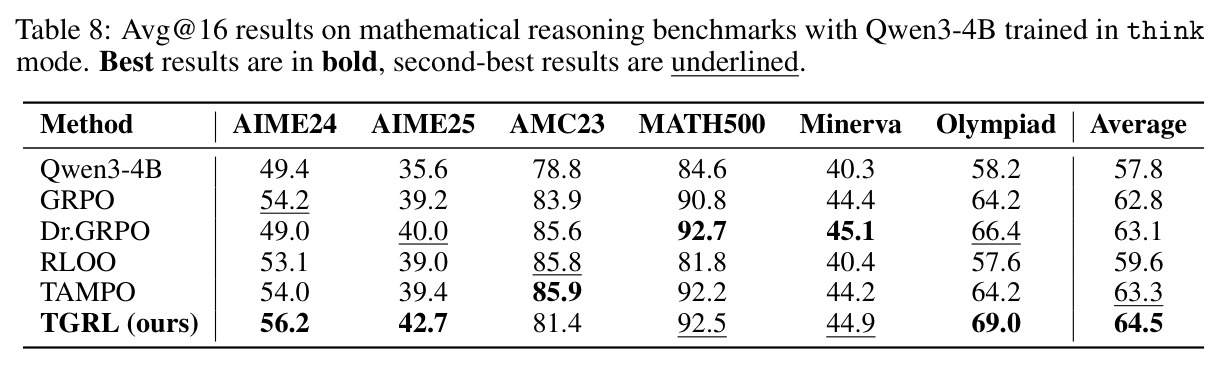
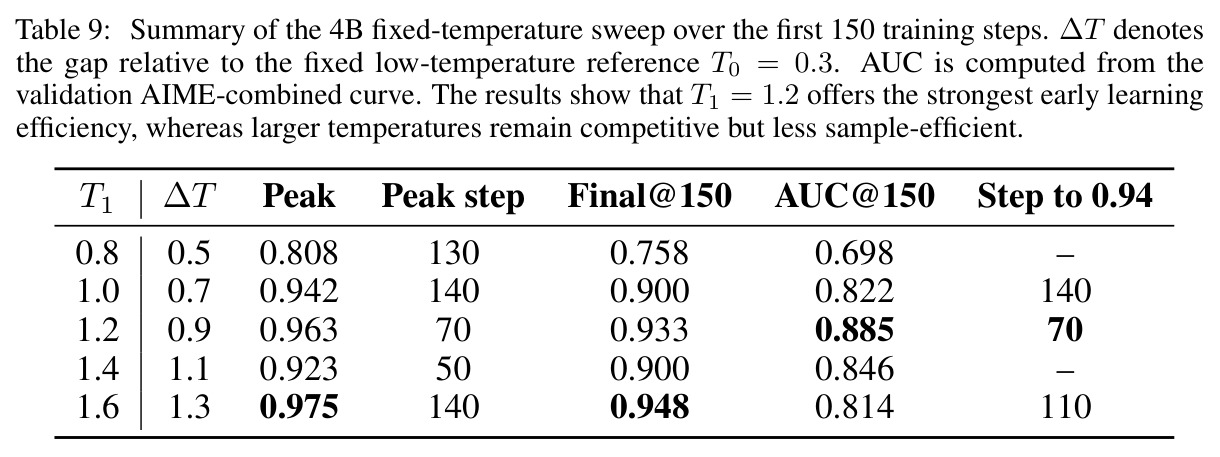
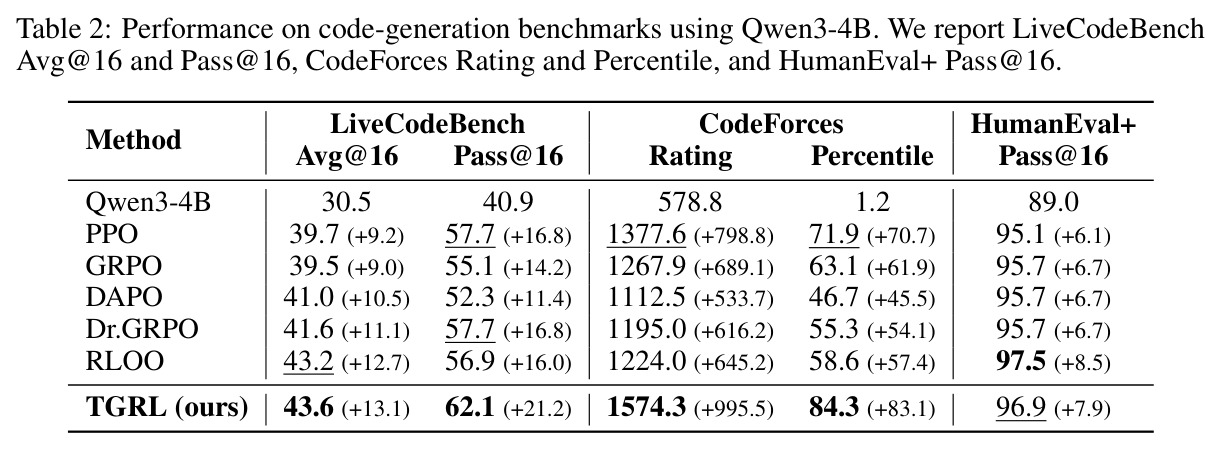
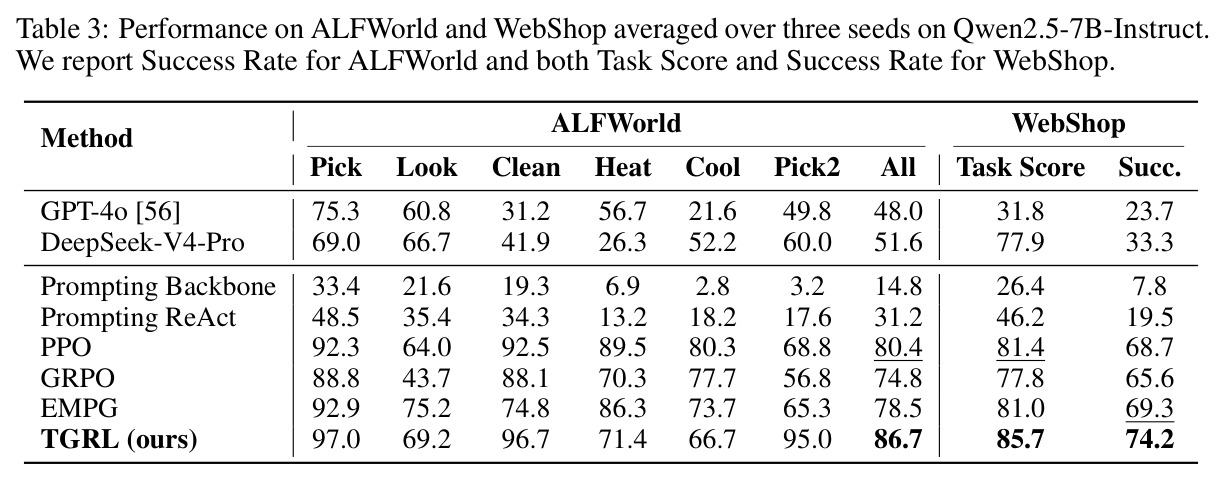
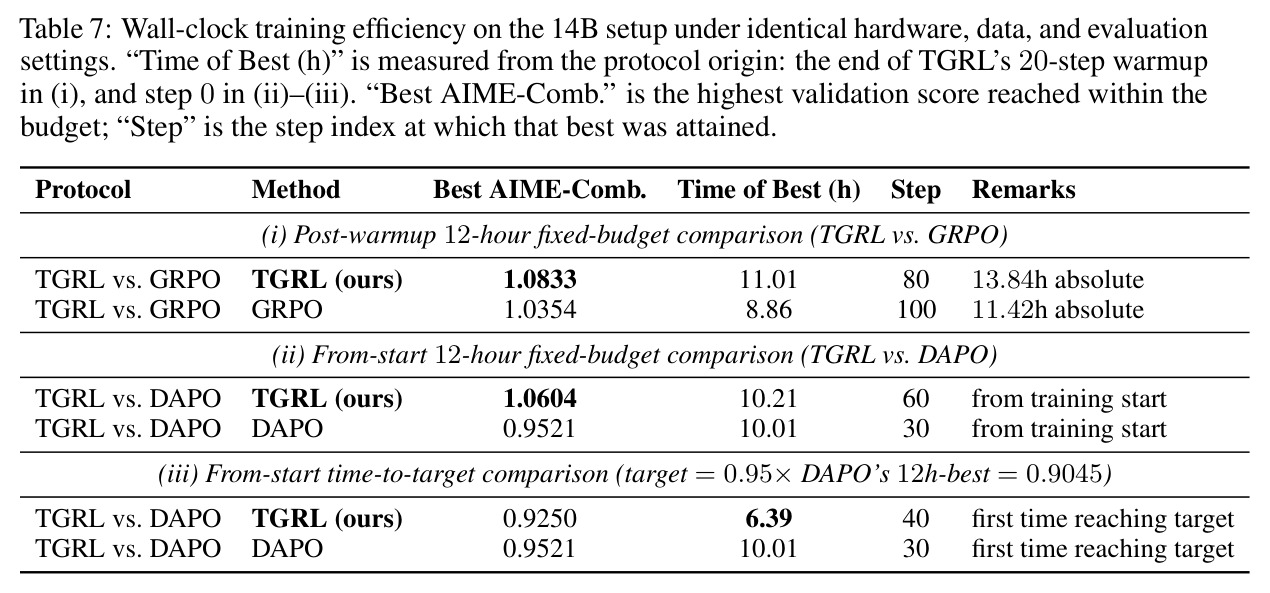
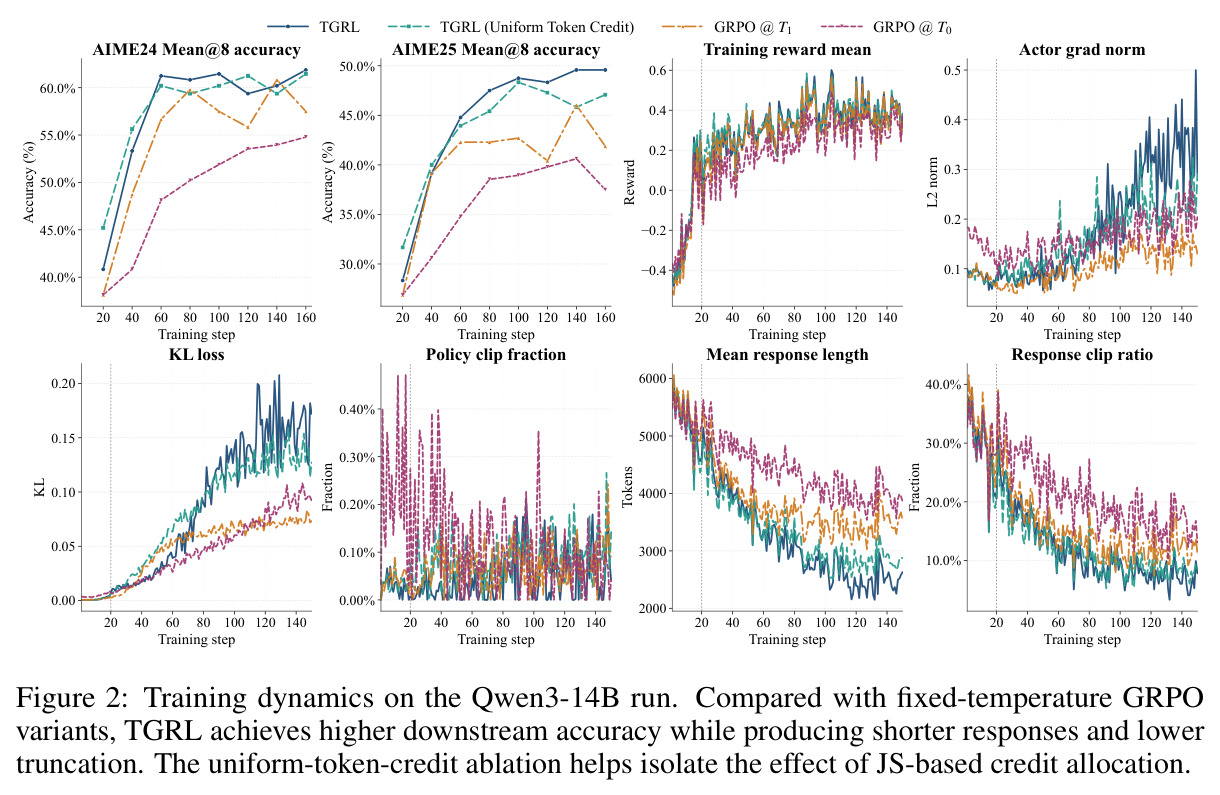
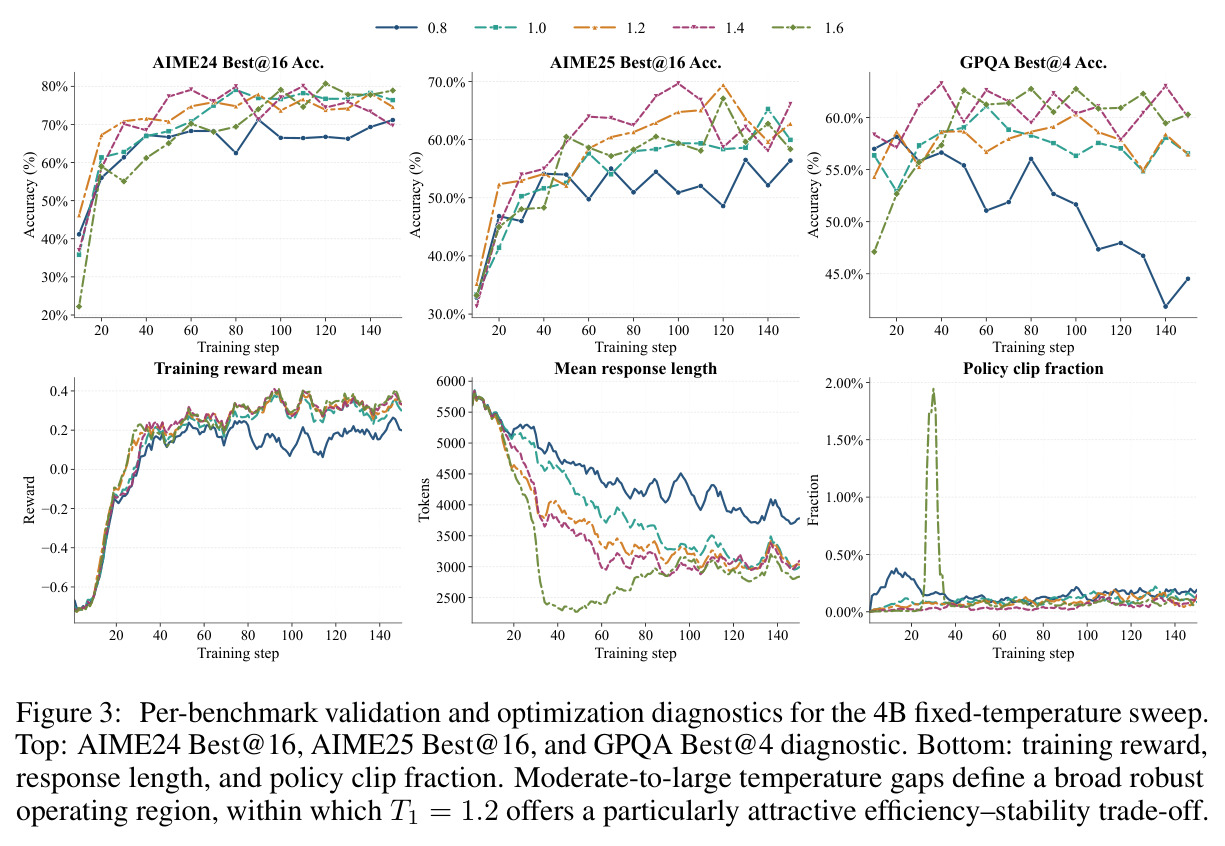
实验覆盖 11 个基准。数学:Qwen3-14B 六基准平均 69.4%(最强基线 TAMPO/DAPO 68.0%),AIME24 63.4% 领先 2.2%;Qwen3-32B 平均 70.2%(DAPO 68.6%),六项全部第一,Olympiad 69.9% 领先 4.2%。代码(Qwen3-4B):LiveCodeBench Pass@16 62.1(此前最强 57.7,+4.4),CodeForces rating 1574.3(PPO 1377.6,+196.7,百分位 71.9%→84.3%),HumanEval+ 96.9 持平最优。智能体(Qwen2.5-7B-Instruct):ALFWorld 86.7%(PPO 80.4%,+6.3),Pick2 95.0% vs 68.8%;WebShop 74.2%(EMPG 69.3%,+4.9)。效率:等精度比 DAPO 快 36%(6.4h vs 10.0h),12h 内 AIME-Combined 1.0833 vs GRPO 1.0354。训练动态:后期响应 2476 tokens(3915/3482)、截断率 7.2%(16.0%/12.4%)。消融:14B 66.5→67.0→68.2→69.4,32B 65.1→66.2→67.8→70.2。温度:T1=0.8 退化,[1.0,1.6] 具竞争力,默认 1.2。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(Qwen3-32B,六基准) | 六基准平均准确率 | 70.2% | DAPO 68.6% | +1.6% |
| 数学推理(Qwen3-14B,六基准) | 六基准平均准确率 | 69.4% | TAMPO / DAPO 68.0% | +1.4% |
| 代码生成(Qwen3-4B) | LiveCodeBench Pass@16 | 62.1 | 最强基线 57.7 | +4.4 |
| 代码生成(Qwen3-4B) | CodeForces Rating (Elo) | 1574.3 | PPO 1377.6 | +196.7(百分位 71.9%→84.3%) |
| 长程智能体(Qwen2.5-7B-Instruct) | ALFWorld 成功率 | 86.7% | PPO 80.4% | +6.3% |
| 网页购物智能体(Qwen2.5-7B-Instruct) | WebShop 成功率 / 任务分 | 74.2% / 85.7 | EMPG 69.3% / PPO 81.4 | +4.9% / +4.3 |
| 训练效率(Qwen3-14B) | 达到等精度目标所需时间 | 6.4 小时 | DAPO 10.0 小时 | 快 36% |
局限与改进
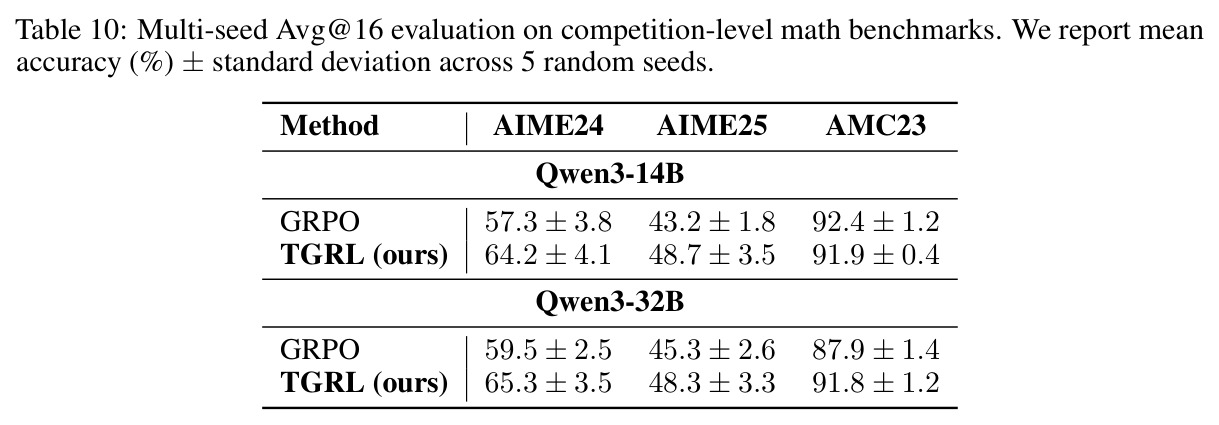
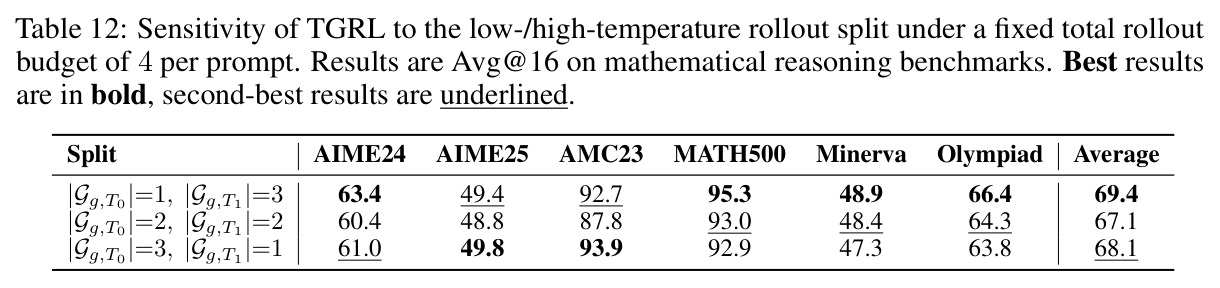
作者承认的局限:探索温度存在下限,T1=0.8 时性能明显退化,需要非平凡温度差,说明方法对超参 T0/T1 有依赖,默认 T0=0.3、T1=1.2 来自网格搜索而非自适应机制;低/高温样本配比固定 1:3,附录 Table 12 虽评估了不同划分但仍是静态设计;AIME 等竞赛基准仅 30 道题,作者虽补充 5-seed Avg@16 并显示均值差大于种子标准差,小样本评测的统计功效仍有限。我自己的观察:其一,$\mathrm{Var}(\Delta R_g|x)=\sigma^2_{T_1}/3+\sigma^2_{T_0}$ 表明高温侧只有 3 个样本,在奖励方差大的任务上探索收益估计噪声不小,错误信号会经混合组优势扩散到整组;其二,低温样本梯度置零,1/4 的 rollout 算力只产出两个统计量,预算利用不充分;其三,JS 计算需对高温 rollout 额外重放 logits,多轮智能体场景的显存与时间开销未被完全量化;其四,全部实验基于可验证奖励与 Qwen 系模型,开放式生成任务与其他模型族上的迁移性未知。
独立分析的弱点
独立分析几个弱点并给出改进方向。(1) 探索收益估计的方差:预算 4 条中高温仅 3 条,$\mathrm{Var}(\Delta R_g)=\sigma^2_{T_1}/3+\sigma^2_{T_0}$,奖励近二值且通过率中等时方差最大,单步信号可能误导整组更新;可对 $\Delta R_g$ 做跨步指数滑动平均或按 prompt 通过率分桶共享统计。(2) 低温样本浪费:置零梯度意味着 25% 算力只产出 $\mu_g,\sigma_g$,可在 $\Delta R_g<0$(探索有害)时让低温组承担负向更新或赋小权重优势。(3) JS 重放开销:需保存或重算高温 logits,32B 上代价显著,可与训练前向共享计算图或只在采样到的 top-k token 上近似 JS。(4) 静态温度设计:T0、T1 与 1:3 配比全程固定,与作者自提的自适应方向相悖,可按训练进度或通过率调节 T1。(5) 评测限于可验证奖励:WebShop/ALFWorld 仍是任务级打分,真正开放域(对话、写作)中“奖励对比”信号是否存在尚未验证。
未来方向
作者明确提出的方向包括:自适应多温度分组(让温度数量与取值随训练动态调整)、更丰富的 token 信用分配准则(超越 JS 的其他敏感度度量)、推广到更开放的交互式环境。基于本文成果还可延伸:把 $\Delta R_g$ 与课程学习结合,用探索收益为负的 prompt 判定模型已饱和并调整数据配比;与 DAPO 类动态采样结合,为探索收益高的 prompt 分配更多 rollout 预算,实现预算的 prompt 级自适应;把温度对比思想移植到离线偏好学习,在 DPO 框架下构造不同温度的候选对;理论上把 JS 度量推广到其他 f-散度或 Wasserstein 距离并比较信用分配质量;另外 Lemma 1 的方差表达式天然给出一个最优化问题——在固定总预算下联合求解最优的 $|G^{T_0}|:|G^{T_1}|$ 配比与 $(T_0,T_1)$ 组合,可做成有理论支撑的自动超参方案。
复现评估
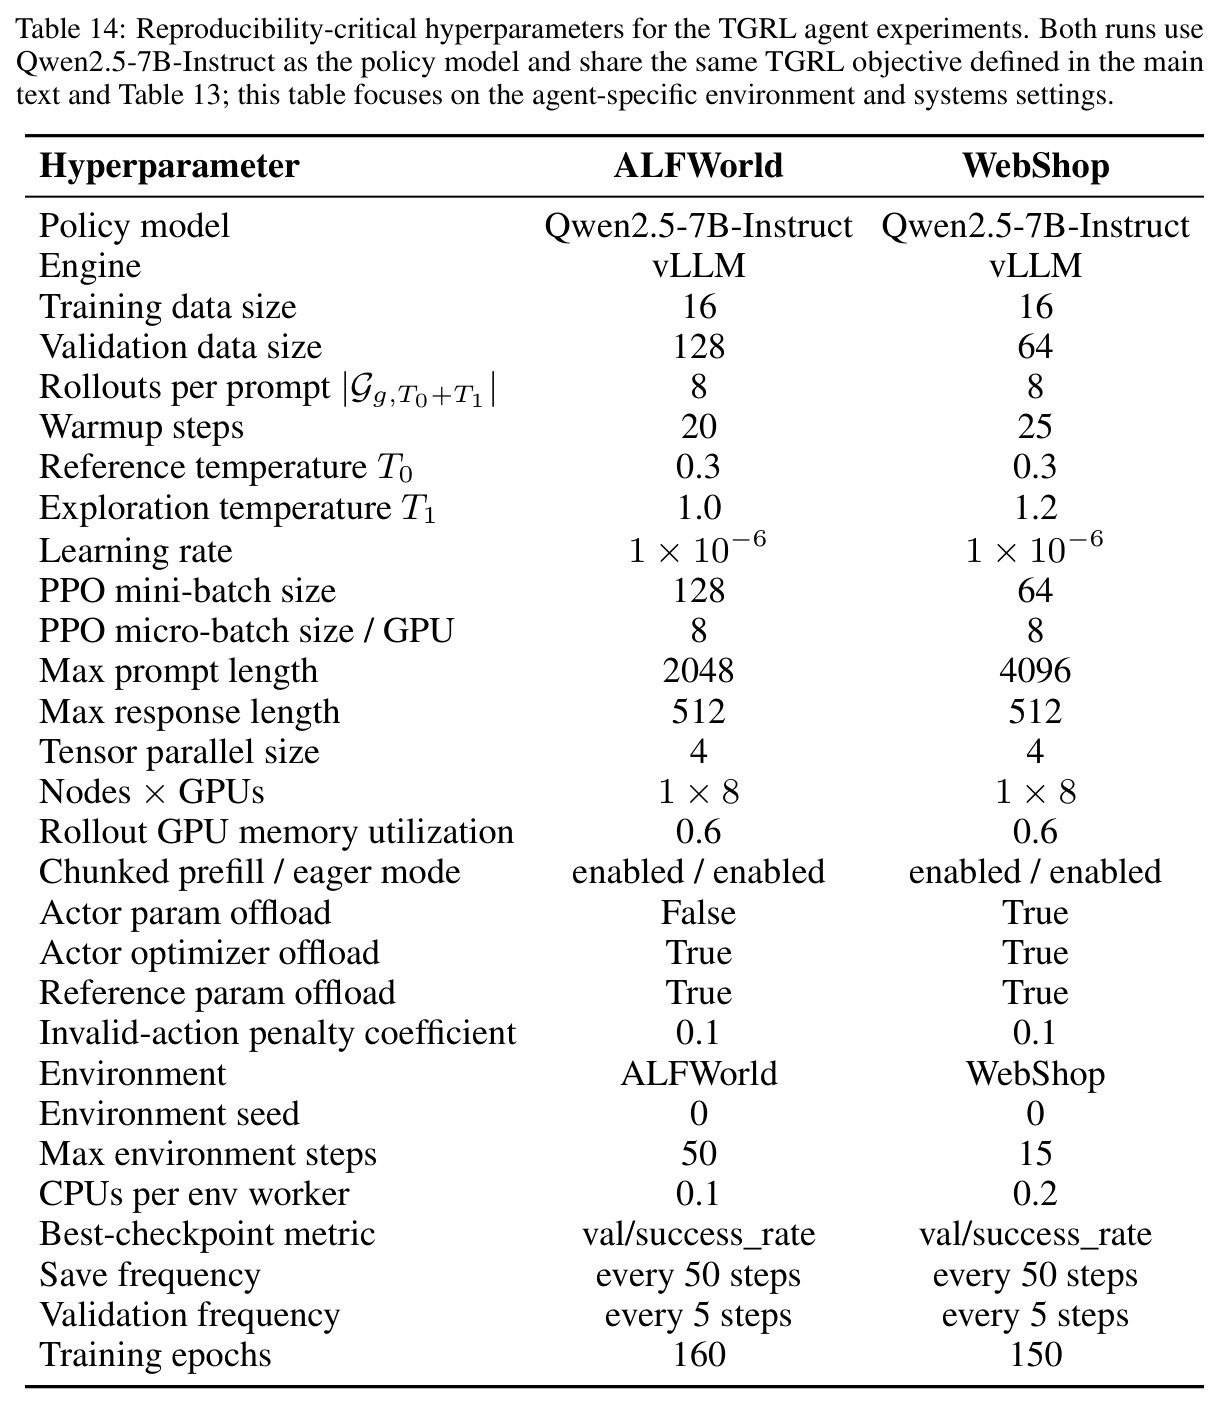
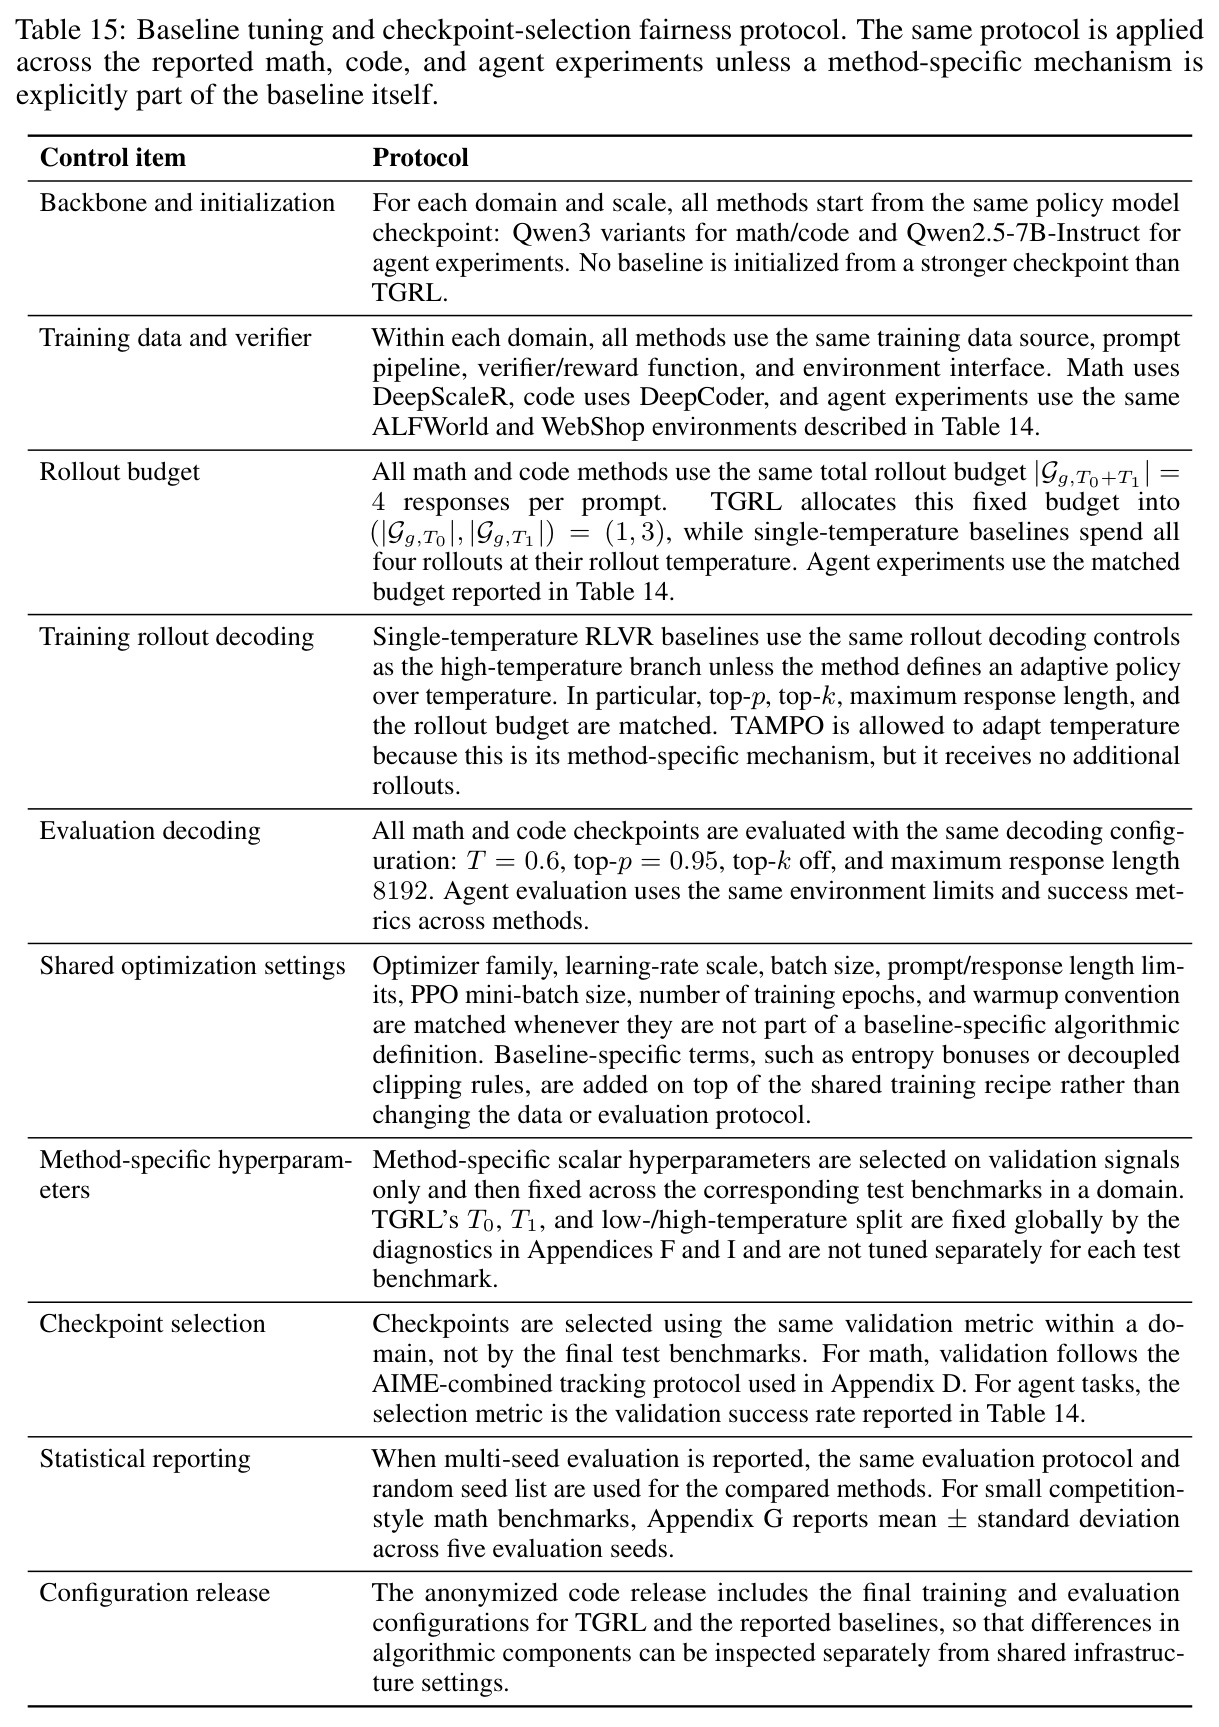
复现条件较好。代码已开源(GitHub: 1229095296/TGRL),论文给出完整超参:$T_0=0.3$、$T_1=1.2$、配比 1:3、20 步高温 warmup、rollout 预算 4、PPO 裁剪范围,以及统一评测协议(解码温度 0.6、top-p 0.95、最大 8192 tokens)。训练数据全部公开:DeepScaleR(数学)、DeepCoder(代码)、WebShop/ALFWorld(智能体),评测基准亦全部公开。算力方面,4B/7B/14B 级别在中型多卡集群(如 8×A100)可承受,32B 的 RL 训练需要更大的多节点资源;论文报告的 12 小时对照实验暗示单次运行成本可控。总体难度中等偏高:门槛不在代码而在 RL 训练基础设施的稳定性(重放 logits 的显存管理、混合精度下 JS 的数值稳定性),以及 5-seed Avg@16 评测的算力开销。附录提供了大量消融(温度敏感性、配比、局部冷却探针),复现关键结论的路径清晰。
论文图表