TT-VidT:解耦时间轴的高效运动中心视频预训练 TT-VidT: Decoupling the Temporal Axis for Efficient Motion-Centric Video Pretraining
首帧外观锚点加紧凑运动令牌做扩散压缩预训练,运动基准全面领先且算力减半
前置知识
视频自监督学习(Video SSL)
不使用人工标注,仅从海量无标签视频中学到通用表征的预训练范式。模型通过设计代理任务(如重建被遮挡的图像块、预测潜空间未来特征、对比不同裁剪视图)迫使编码器理解视频内容。学好的编码器只需接一个轻量探针(kNN、线性层或注意力池化)就能迁移到动作识别等下游任务。
本文的整个实验框架就是视频自监督学习:24 个架构-目标组合都在同一无标签视频语料上预训练,再用冻结探针评测,读懂该范式才能理解论文的对比协议和结论含义。
掩码重建与潜空间预测
两类主流视频 SSL 目标。掩码重建(如 VideoMAE)对输入时空块随机掩码,让编码器-解码器在像素或 token 空间还原缺失内容;潜空间预测(如 V-JEPA、V-JEPA 2)则在表征空间预测被遮挡区域的特征,避免像素级细节负担。两者的差异决定了编码器把容量花在像素纹理还是抽象语义上。
论文的 4×6 扫描正是把这两类经典目标(MAE、自回归)与作者提出的 Diff Compression 放在同一架构下对照,理解它们才能看懂 Table 1 中目标函数一维的六列设计。
DINOv3 图像基础模型
Meta 提出的自监督 ViT 预训练模型,通过自蒸馏(student-teacher)在纯图像上学到极强的空间表征,其 cls token 和 patch token 广泛用作下游任务的初始化底座。把每一帧独立送入 DINOv3,可得到高质量的外观特征,但对帧序变化不敏感。
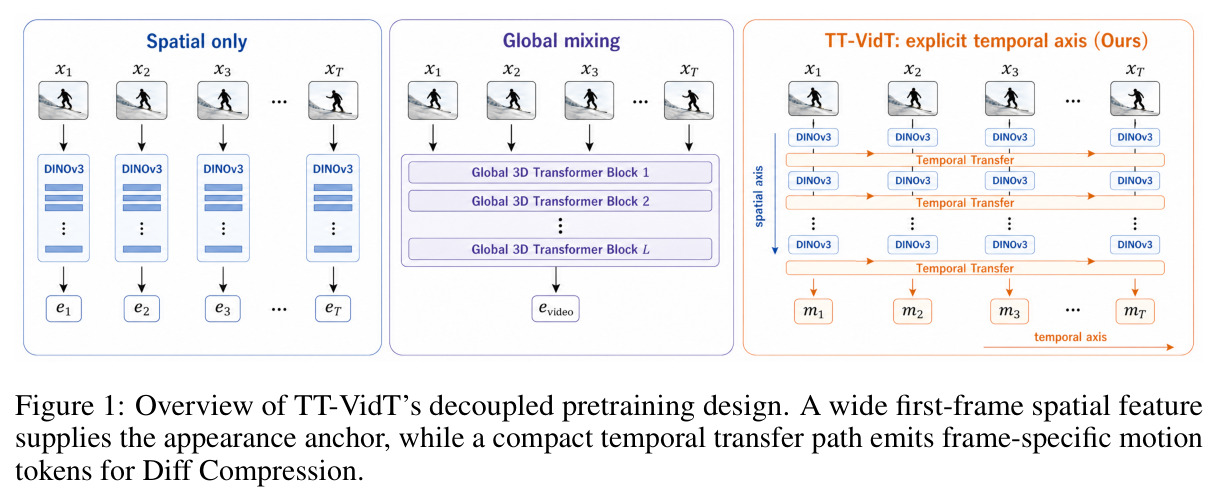
TT-VidT 的空间通路就是 DINOv3 ViT-B/16 初始化的逐帧编码器,论文称之为 order-blind substrate;Table 4 用单帧 DINOv3 作为外观对照,验证时间信息确实来自新增的时间通路。
块因果注意力(Block-causal attention)
一种按帧分块的因果掩码:第 $t$ 帧的全部 token 只允许注意第 $1,\dots,t$ 帧的 token,帧内仍可全连接。它像语言模型的因果掩码一样禁止偷看未来,但以帧为最小单位,适合视频这种天然按时间排序的序列。
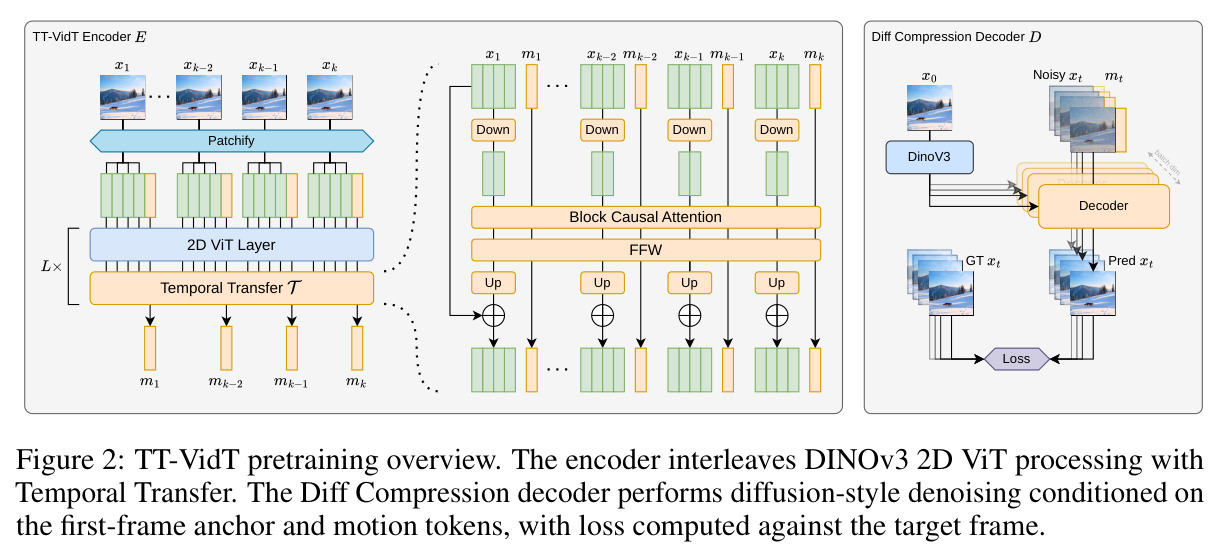
TT-VidT 的时间通路(TT1D/TT3D)都依赖块因果注意力跨帧传递信息,这保证第 $t$ 帧的运动令牌 $m_t$ 只编码过去信息,是自回归式时间建模和运动倒置探针成立的结构基础。
扩散/流匹配重建损失
生成式重建目标:向真实图像逐步加噪,训练网络在给定条件下预测去噪方向,$\ell(\hat{x}_t, x_t)$ 采用扩散或流匹配的损失形式(如 DiT 结构)。相比逐像素回归(MSE),它能重建高频细节且不会退化为输出模糊均值。
Diff Compression 的核心就是这个损失:解码器以首帧特征 $z_1$ 和运动令牌 $m_t$ 为条件做扩散去噪重建目标帧。论文 Table 2 显示 MAE-Diffusion 在同一编码器上明显更差,说明首帧锚点条件才是关键。
信息瓶颈
表示学习理论视角:若让表征通过一个容量受限的通道去完成重建或预测任务,通道中保留的将是任务最不可缺的压缩信息。容量压得越紧,冗余(如可从别处恢复的外观)越先被丢弃。
TT-VidT 的设计哲学就是把运动令牌造成信息瓶颈:每帧只有 $K=8$ 个 $d=768$ 维令牌可用,解码器重建时另有大容量首帧锚点,于是令牌被迫只装锚点补不出的帧间变化信息。
冻结探针评测
预训练完成后冻结编码器参数,只在其输出的特征上训练极轻量的分类头(kNN、线性层、MLP 或注意力池化探针)来测下游准确率。因为可训练参数极少,成绩几乎完全反映预训练表征本身的质量。
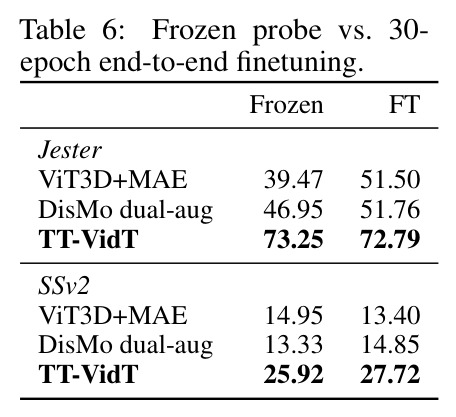
论文几乎所有主结果(Table 1、2、5)都用冻结注意力探针报告,只有 Diving48 用全量微调作补充;Table 6 进一步展示 TT-VidT 微调后几乎不掉点,说明优势确实在表征里。
研究动机
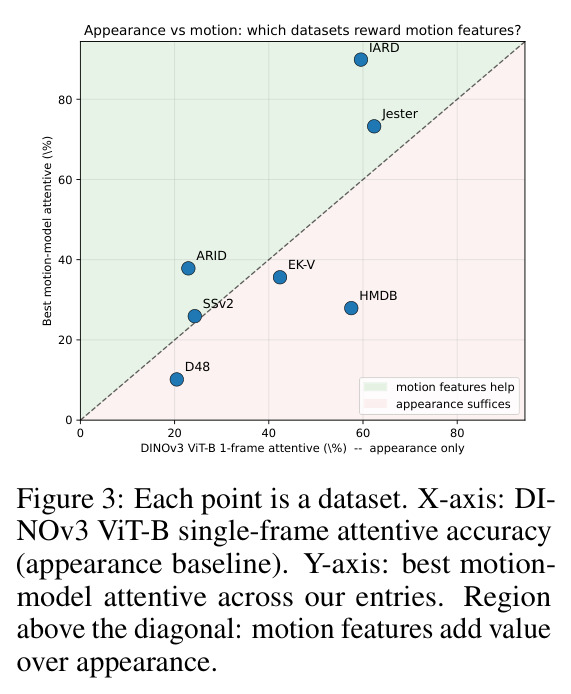
现有视频自监督学习的对比研究普遍把完整训练配方打包评测:架构、目标函数、数据量、训练时长、参数规模和解码器容量往往同时不同,导致无法归因。例如论文指出 VideoMAE 在其统计口径下用了 343M 参数、在 Kinetics-710 上约见 410M 个片段,ARVideo 约 304M 参数、406M 片段,而 DisMo 是 172M 参数、约 17M 片段——规模和目标都不同,赢了也不知道赢在哪儿。更麻烦的是动作识别基准普遍存在外观捷径:物体、场景、演员衣着甚至相机背景常常就能预测标签(Jester、SSv2、Diving48 虽以运动定义类别,静态线索仍有预测力,HMDB51 则几乎被场景与主体外观主导)。于是一个视频 SSL 方法可以大量依赖单帧可见的外观信息就拿到不错的准确率,掩盖了它其实没学到时间动态的事实。
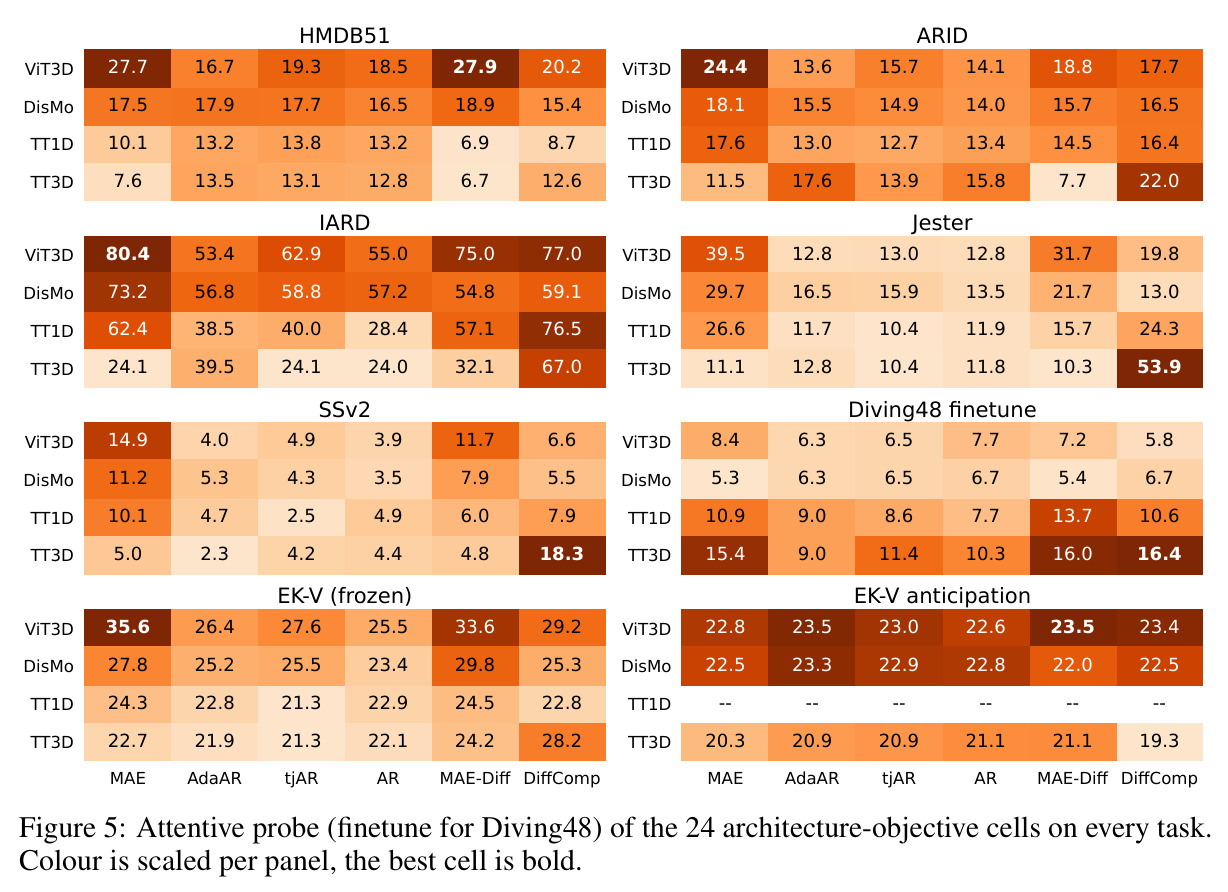
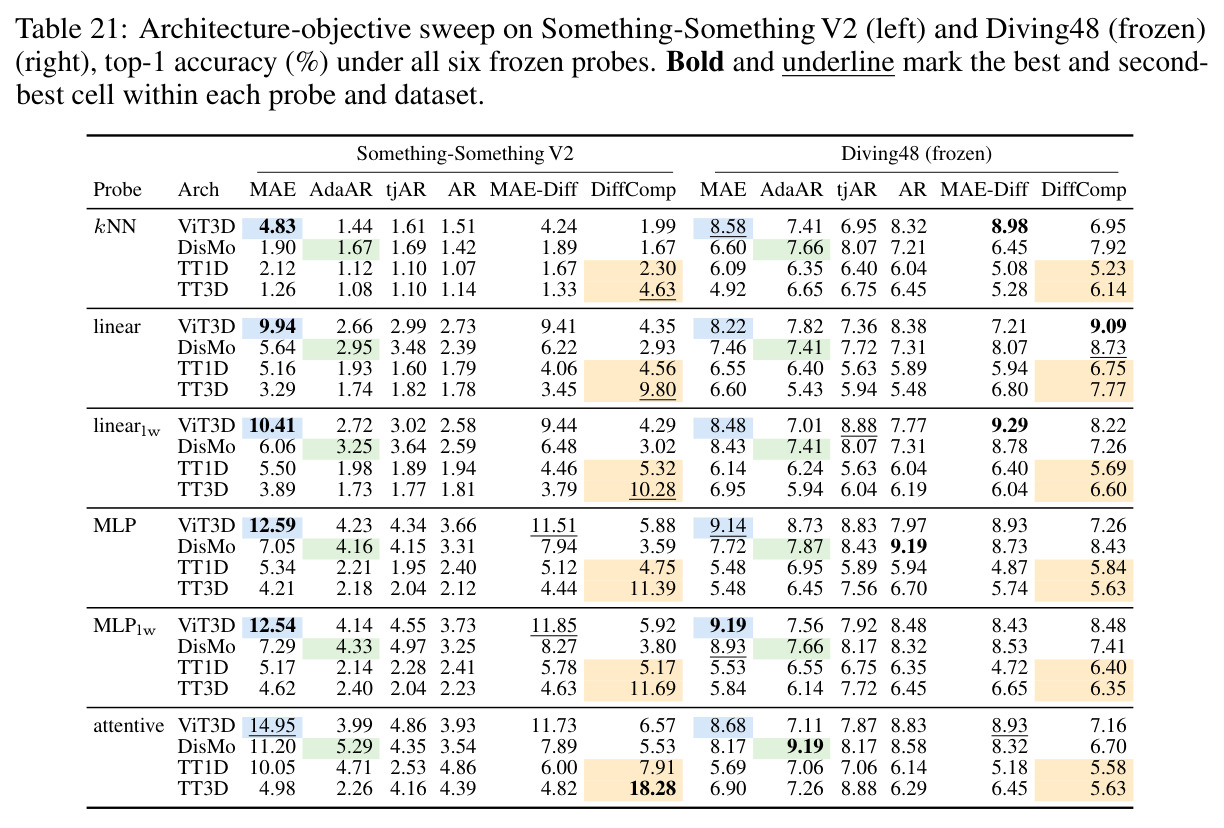
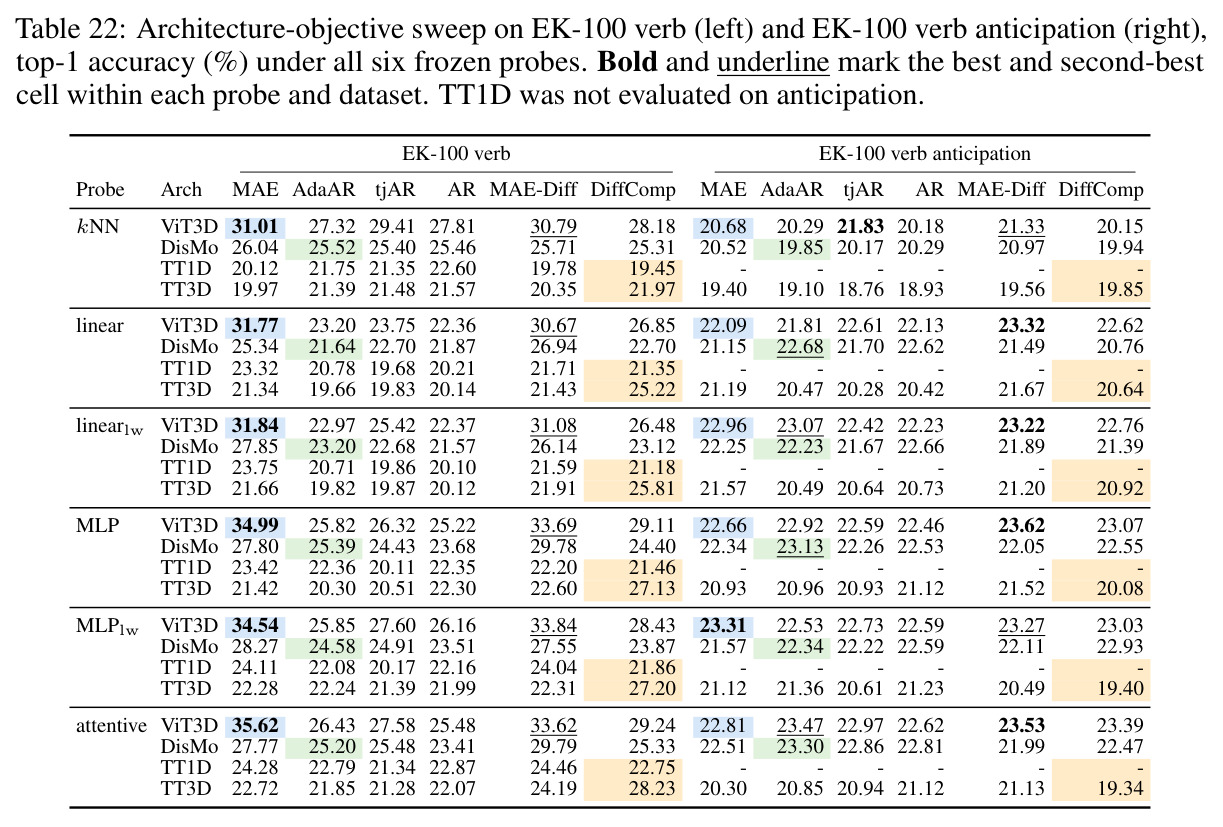
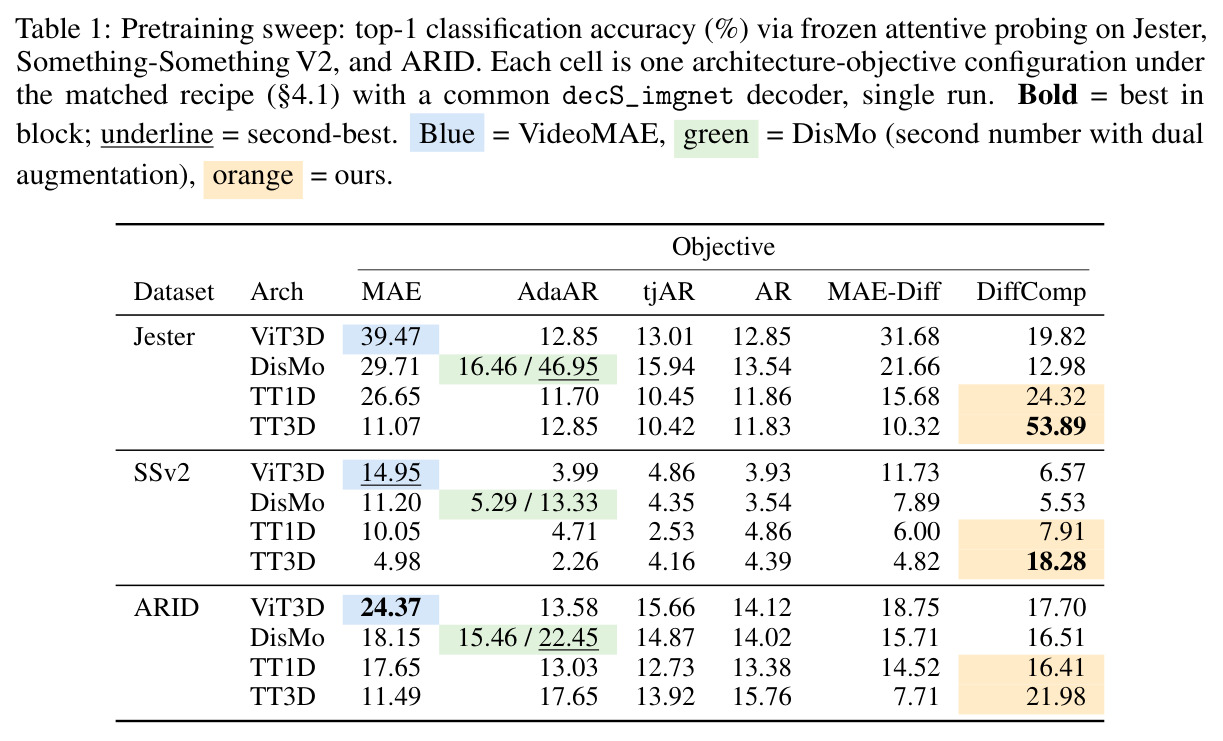
本文的目标是作者想在受控条件下回答一个精确的问题:在数据、训练计划、参数规模、评测协议全部对齐的同一配方下,哪种架构-目标组合能产生运动优先(motion-prioritized)的表征——即在帧间变化决定标签的任务上收益最大,同时在外观主导任务上仍保持竞争力。为此他们设计了一个匹配配方协议:4 种编码器(ViT3D、DisMo 式 2D+3D、TT1D、TT3D)× 6 种目标(MAE、Adaptive AR、naive AR、two-jump AR、MAE-Diff、Diff Compression)共 24 个组合,全部在约 170M∼190M 编码器规模、约 1.7M 片段(OpenVid 约 1M + Moments-in-Time v2 约 70 万)、8 epoch(每模型约见 13.6M 样本、约 42.5 万步)下预训练,并在运动导向(Jester、SSv2、Diving48、ARID)与外观导向(HMDB51、IARD、EPIC-Kitchens)的双梯队基准上诊断。最终交付一个兼具运动敏感与高效的方法 TT-VidT。
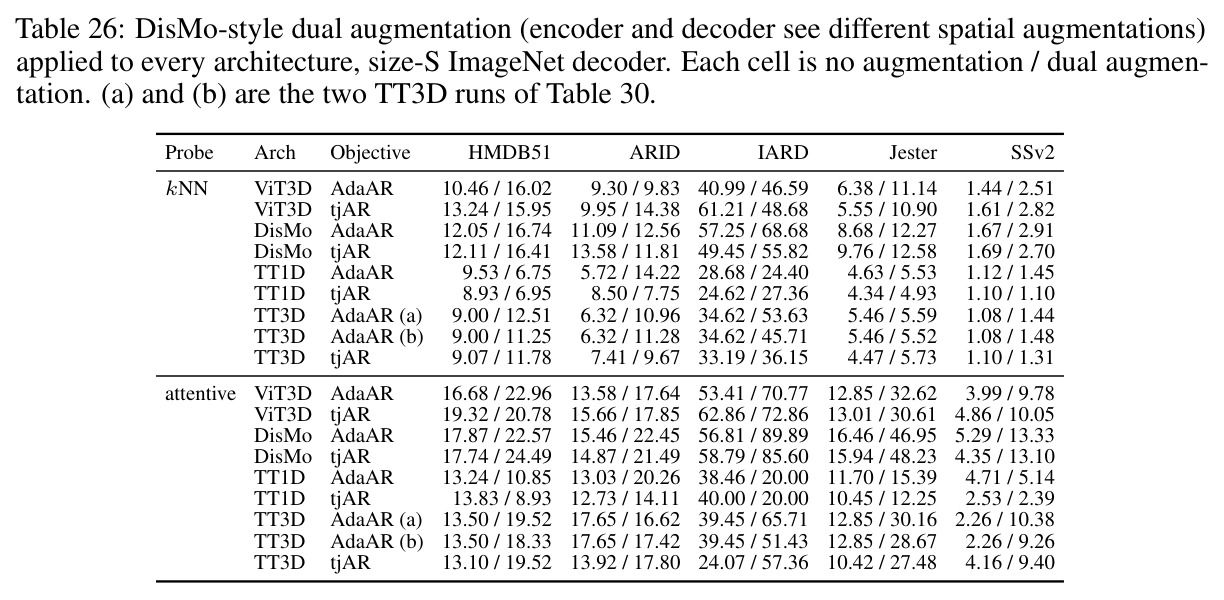
与已有工作不同的是,论文的独特之处有三层。第一,它不比较方法而比较架构×目标的交互效应:以往工作各自带着私有配方参赛,本文把配方固定后扫描 24 个格子,从而发现成功区域极其稀疏——只有 ViT3D+MAE 和 TT3D+Diff Compression 两个格子进入运动任务的第一梯队,证明关键是组件配对而非单组件。第二,它在模型内部解耦外观与时间:宽的首帧空间锚点保留外观,窄的运动令牌通路承载帧间变化,用容量压力而非数据增强(DisMo 的做法)或显式特征相减(VTok 的做法)来实现解耦。第三,它把评测写成诊断阶梯而非单一榜单,并补充运动倒置探针直接测表征对运动方向的忠实度,而不是只看平均准确率。
核心方法
直觉上,视频理解要配得上这个名字,就必须利用单帧里不存在的信息。TT-VidT 的思路是:外观交给宽通路,运动逼进窄通路。模型保留一个 DINOv3 初始化的 ViT-B/16 逐帧空间编码器,把首帧特征 $z_1$ 作为外观锚点;同时在每帧上挂 $K=8$ 个可学习的运动令牌,由紧凑的时间转移层(Temporal Transfer Layer)跨帧交换信息,产出帧特定运动嵌入 $m_t$。预训练目标是 Diff Compression:解码器只拿 $z_1$ 和 $m_t$ 重建第 $t$ 帧 $\hat{x}_t = D(z_1, m_t)$,用扩散/流匹配损失监督;锚点已提供静态外观,运动令牌这个瓶颈里能放的就是锚点恢复不了的帧间变化。时间层有两种实例:TT1D 只让 $T\times K=64$ 个运动令牌做块因果跨帧注意力;TT3D 把每帧空间 token 逐轴 4 倍下采样到 $N'=16$ 个,与 8 个运动令牌拼成 24 个 token 做 3D 块因果注意力,序列长 $T\times(K+N')=192$,远小于全时空注意力的 $T\times N=2048$。
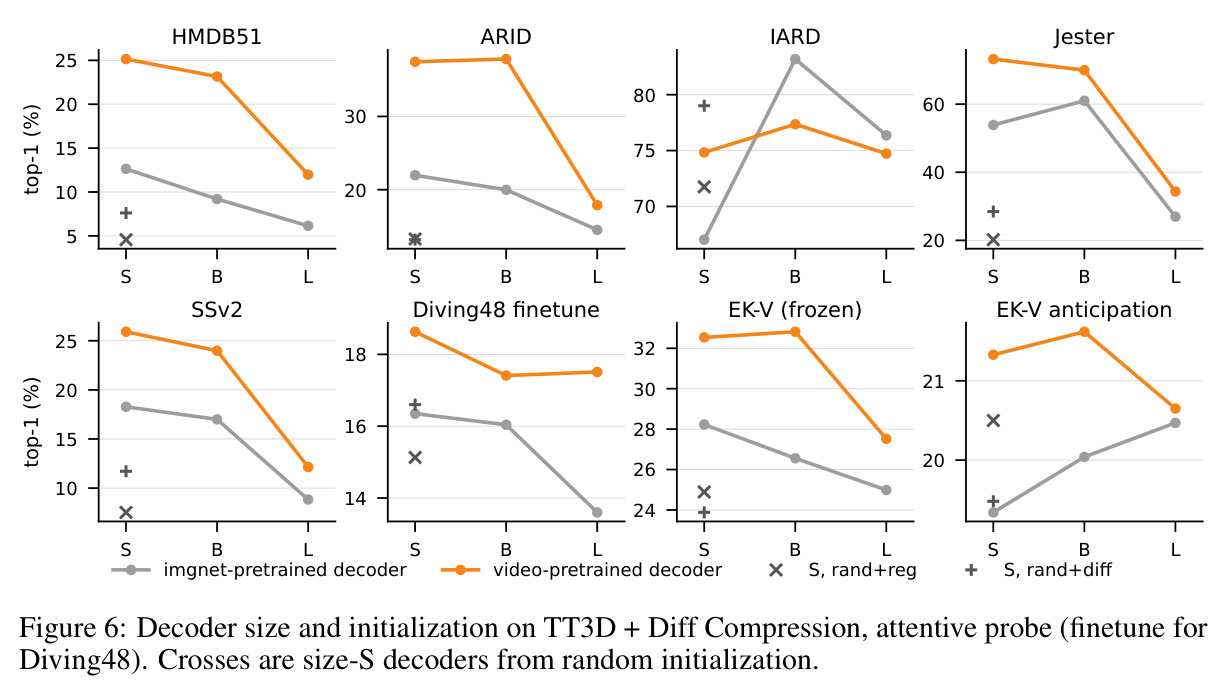
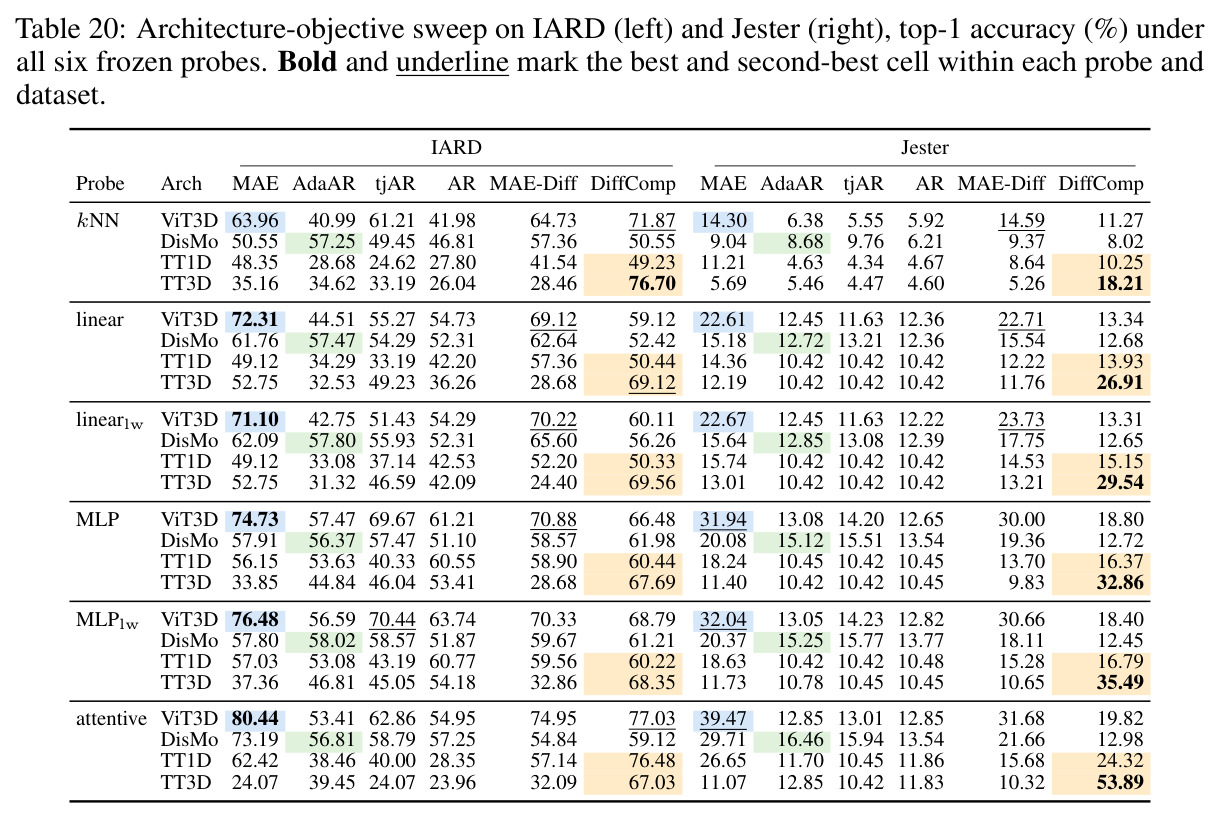
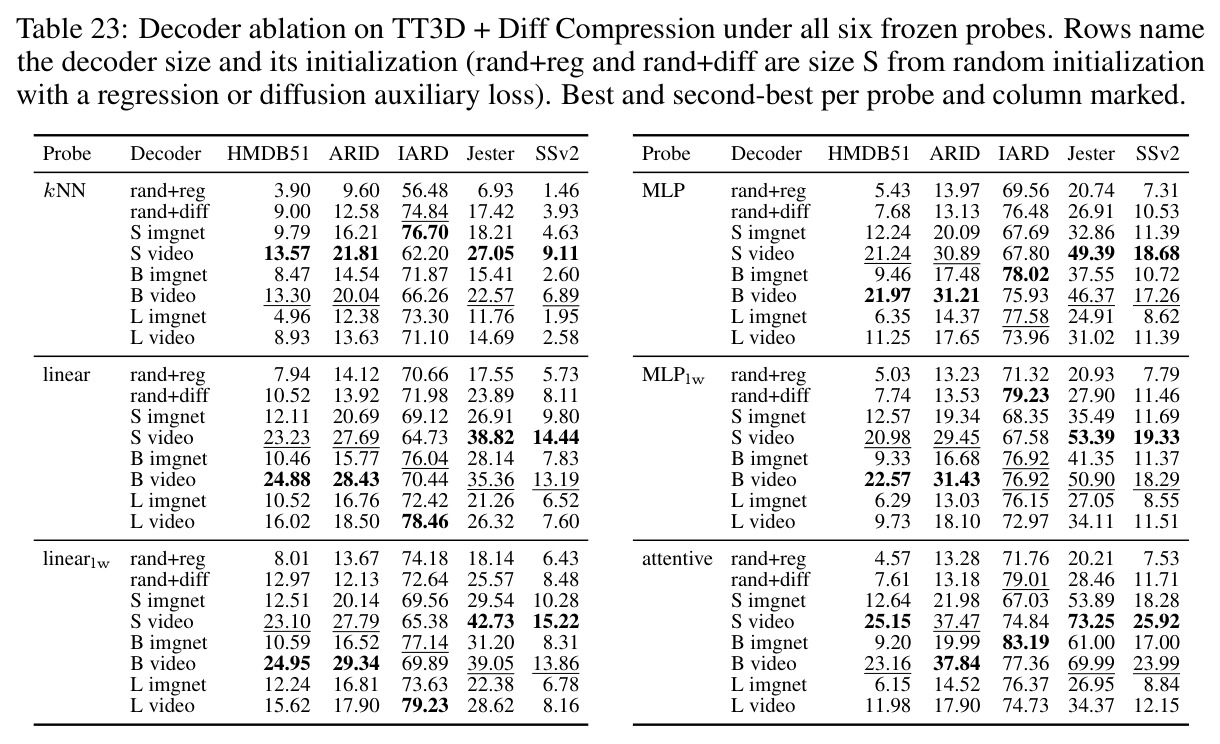
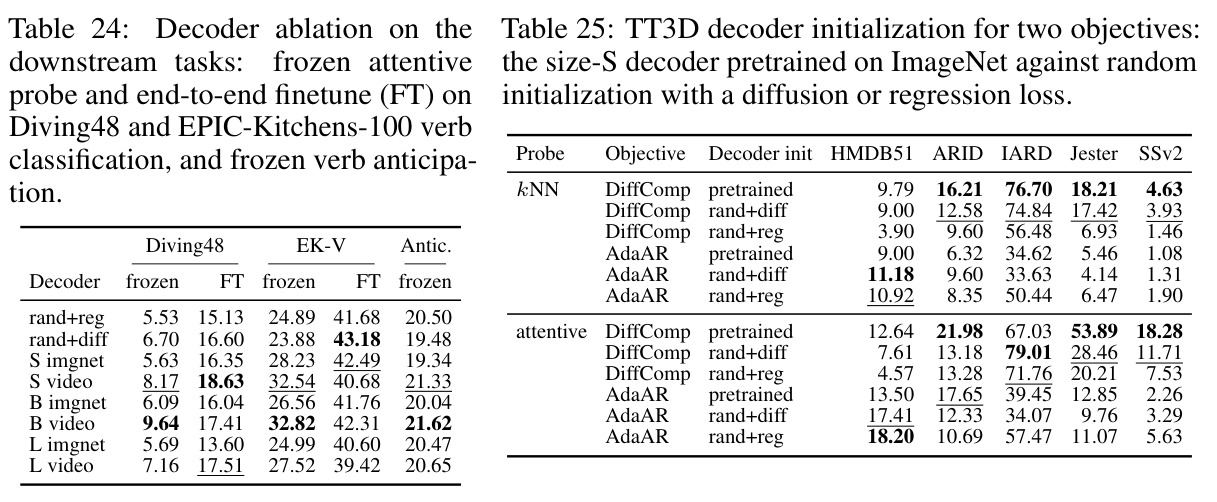
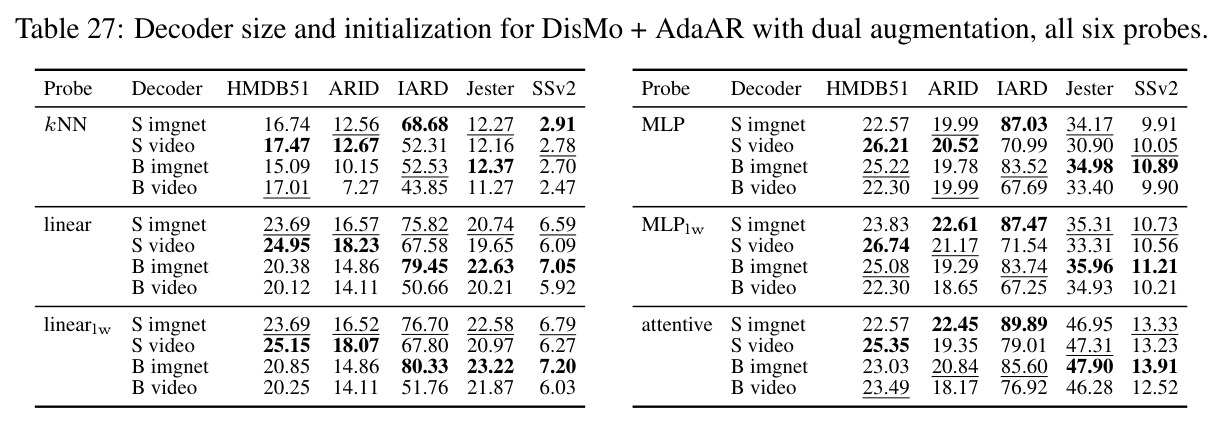
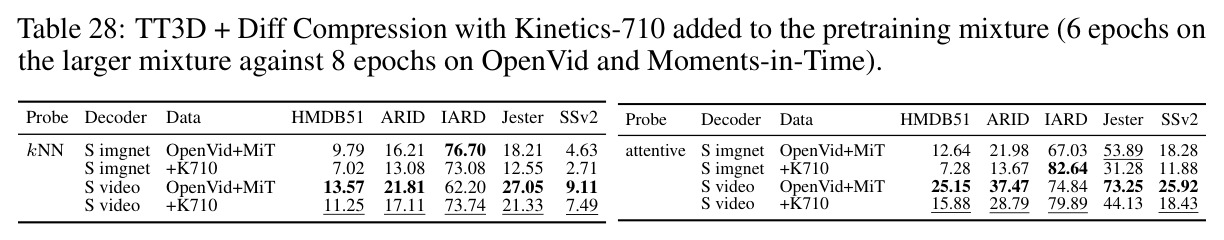
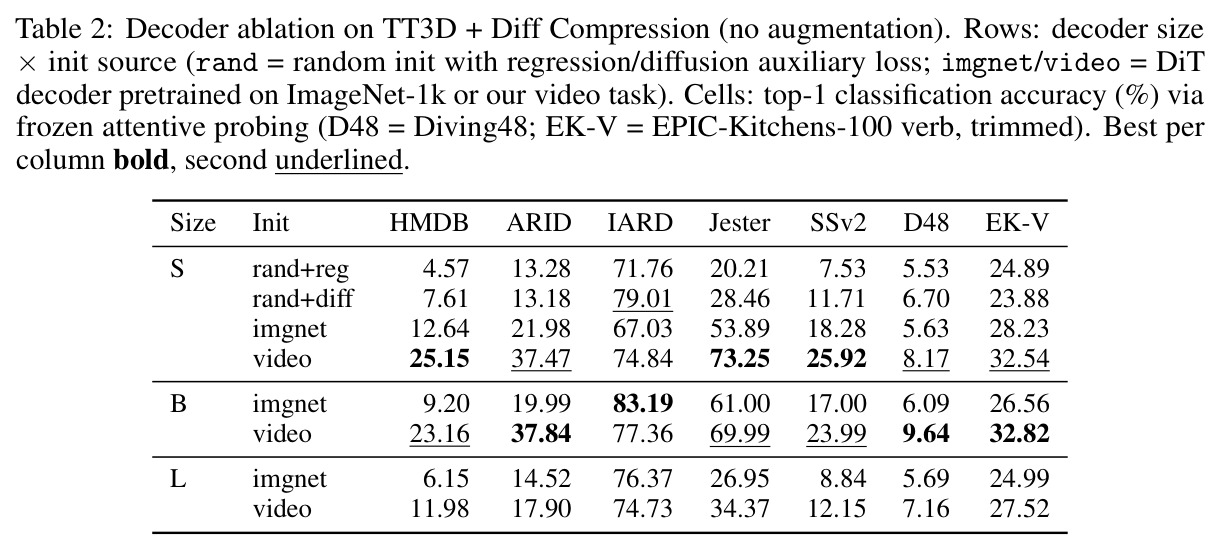
核心创新是架构与目标的配对协同,外加用容量瓶颈显式逼出运动信息。与 DisMo 靠外观增强在数据层面压制身份泄漏不同,TT-VidT 在信息层面设卡:解码器重建时另有大容量首帧锚点可用,运动令牌每帧仅 $8\times768$ 维,多余的外观信息在瓶颈处被自然挤掉。与 VTok 显式计算目标帧与关键帧的特征差再投影不同,本文的 $m_t$ 是时间通路端到端学出来的,架构里没有任何内置的差分算子,编码器可以自由决定往令牌里放什么。消融证明缺一不可:把 Diff Compression 换成 MAE,TT3D 在 Jester 上从 53.89 崩到 11.07;把 TT3D 换成 ViT3D 或 DisMo 架构,同样用 Diff Compression 也只有 19.82 和 12.98。此外解码器侧还有一个反直觉发现:小而经视频预训练的 S 解码器最好(Jester 73.25),更大的 L 解码器反而掉到 34.37——解码器容量越大,重建负担越从运动令牌转移到解码器,令牌里装的运动信息就越少。
方法步骤详情
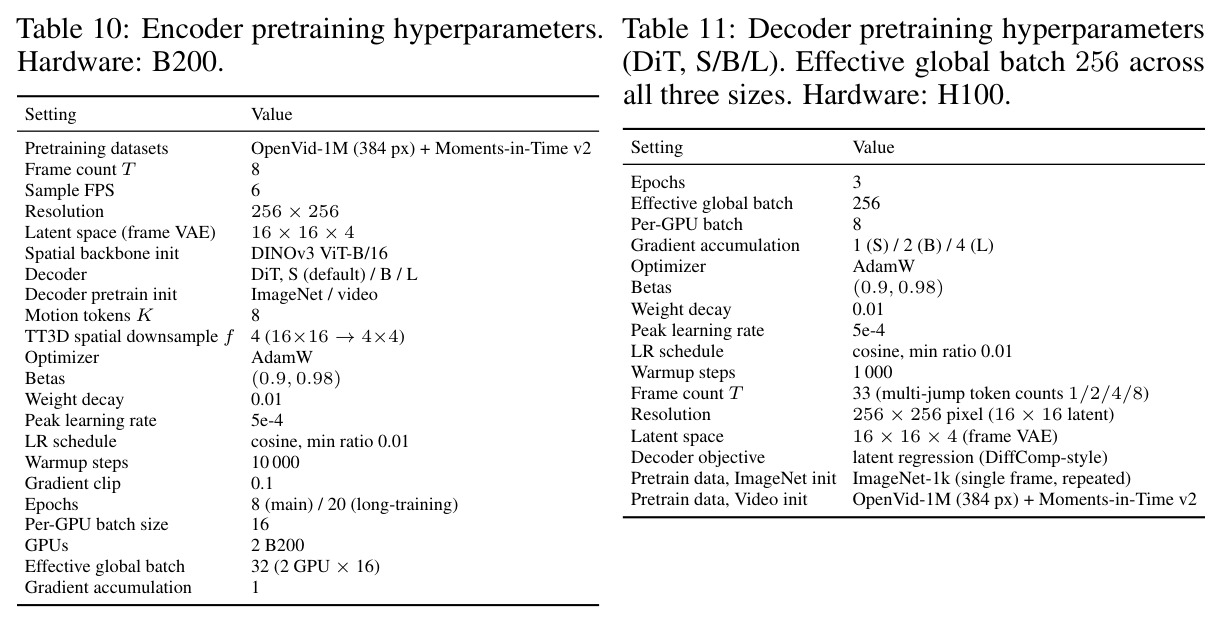
第一步,采样与编码:每段视频采 $T=8$ 帧(6 fps),逐帧独立过 DINOv3 ViT-B/16 编码器 $E$,得到 $z_t \in \mathbb{R}^{N\times d}$($N=256$、$d=768$),帧间无混合。第二步,时间转移(TT3D):每帧附加 $K=8$ 个可学习运动令牌,把该帧空间 token 逐轴 4 倍下采样到 $N'=16$ 个并拼接为 24 个 token;堆叠 $L_T=12$ 层、隐藏维 768 的 Transformer,每层先在帧内自注意力概括本帧,再对全部帧的 192 个 token 做块因果 3D 自注意力(第 $t$ 帧只看 $1,\dots,t$ 帧);TT1D 变体只用 64 个运动令牌跨帧注意。第三步,读出 $m_1,\dots,m_T$。第四步,Diff Compression 重建:DiT 解码器交叉注意完整的 $z_1$(不是下采样特征)并以 $m_t$ 为条件做扩散去噪输出 $\hat{x}_t$,$t=2,\dots,T$。第五步,计算损失 $\mathcal{L}(X)=\frac{1}{T-1}\sum_{t=2}^{T}\ell(\hat{x}_t,x_t)$,$\ell$ 默认为扩散/流匹配损失,编码器、时间层、解码器与运动令牌嵌入全部联合训练。配方:有效 batch 32、AdamW 峰值学习率 $5\times10^{-4}$(betas $(0.9,0.98)$、权重衰减 0.01、裁剪 0.1)、1 万步预热后余弦衰减到 1%、fp16、µP 基准维 256。解码器有随机/ImageNet/视频预训练三种初始化,视频版以批 256 训 3 epoch。
技术新颖性
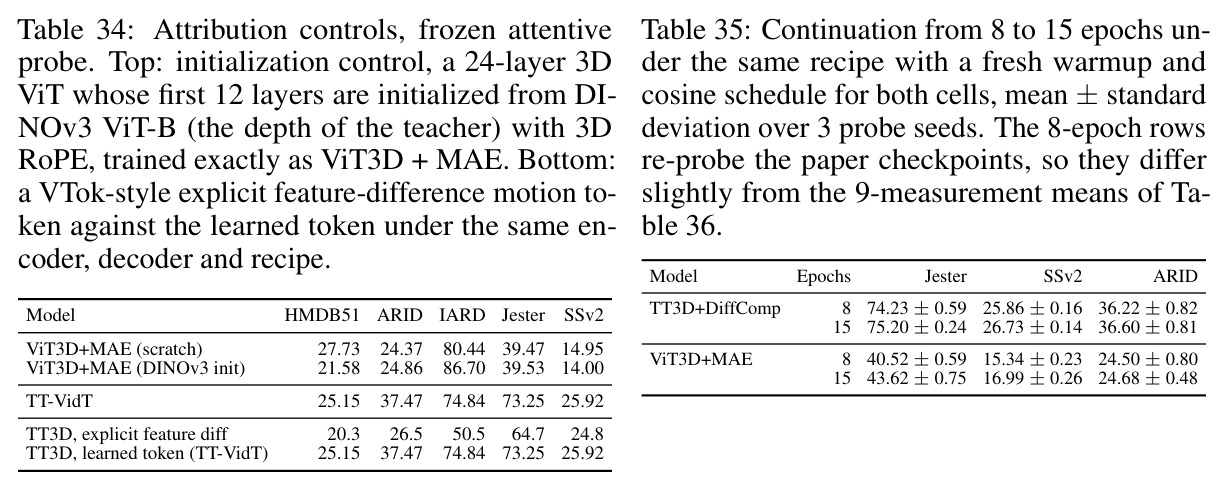
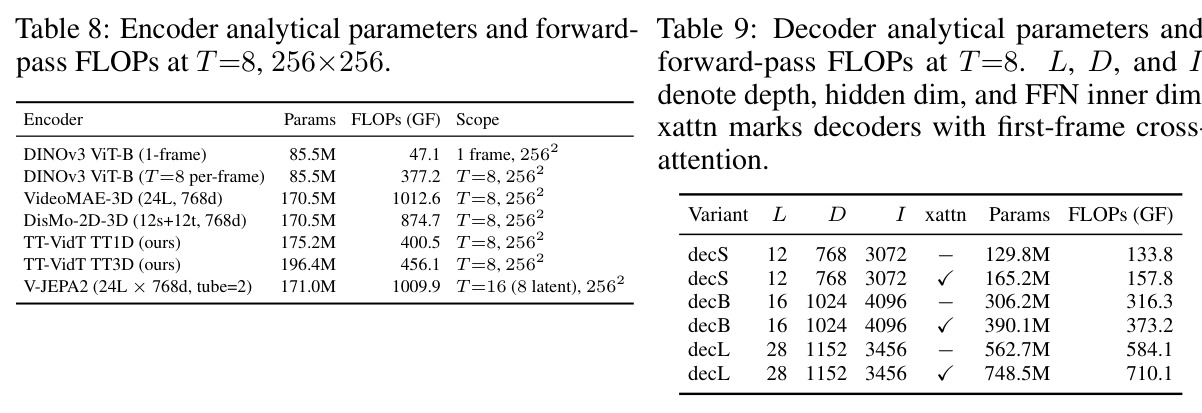
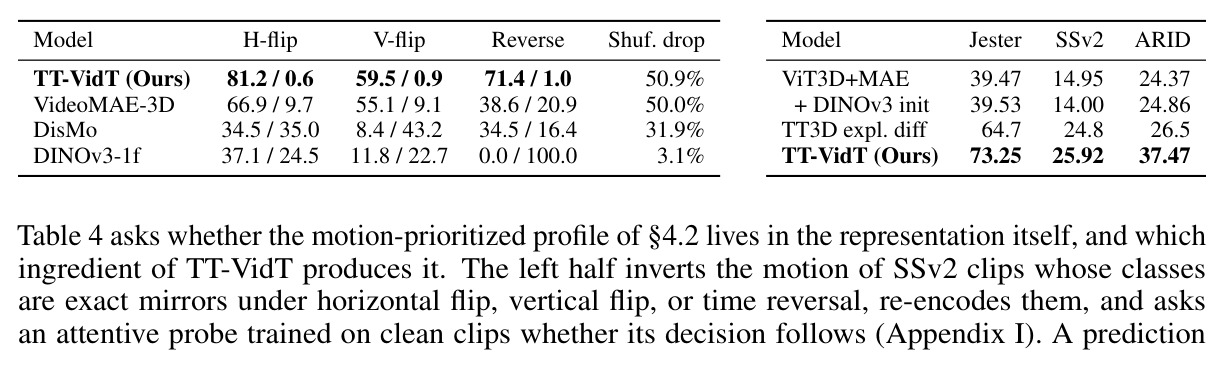
技术新颖性体现在四个方面。其一,方法论层面首次给出匹配配方的 4×6 架构-目标全扫描,并证明成功组合是稀疏的交互效应而非组件的普适增益,这本身修正了领域内比配方不比方法的坏习惯。其二,目标函数 Diff Compression 与 VTok 同为关键帧+运动令牌分解,但用学习式令牌替代显式特征差分:Table 4 显示 VTok 式显式差分在 Jester 上已能拿到 64.7 超过所有非 TT 配置,而学习式令牌在全部五个数据集上进一步胜出(Jester 73.25),说明端到端学习能保留差分会丢掉的有用外观。其三,架构上用 192 token 的下采样时空注意力替代 2048 token 全注意力,编码器算力 456.1 GFLOPs,约为同规模 DisMo(874.7)的一半、VideoMAE(1012.6)的 45%,把运动中心预训练做成了小配方可负担的事。其四,解码器消融发现视频预训练的紧凑解码器优于 ImageNet 预训练和随机初始化,且放大解码器有害,这为信息瓶颈解释提供了独立证据。
实验结果
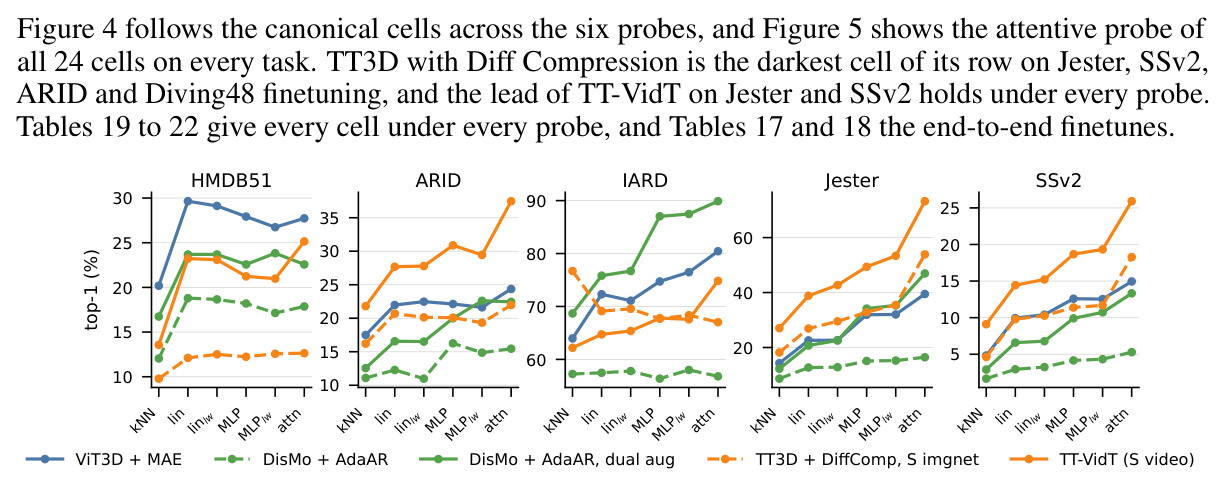
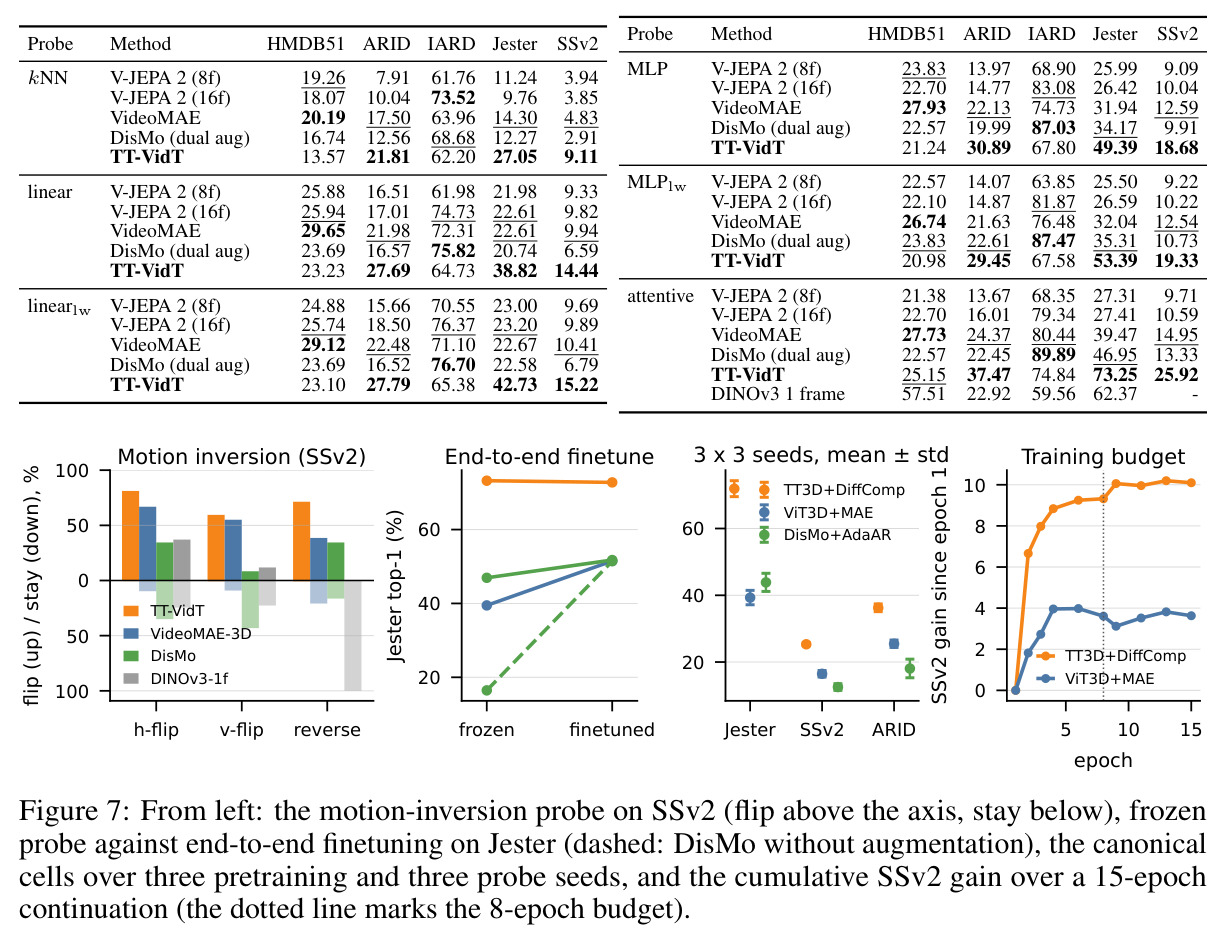
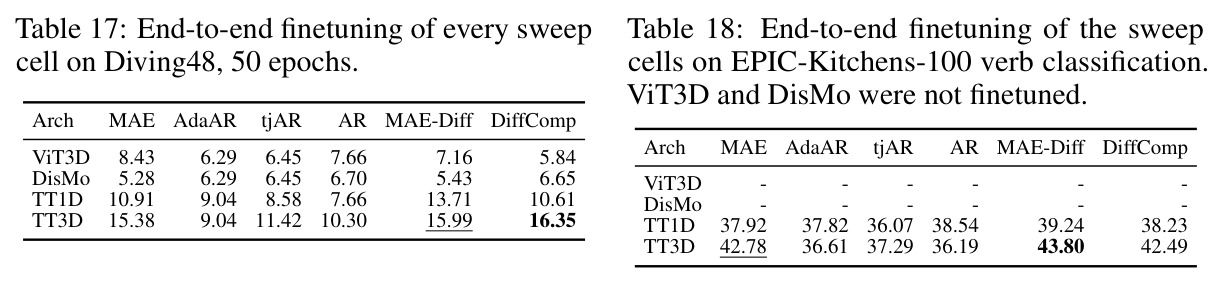
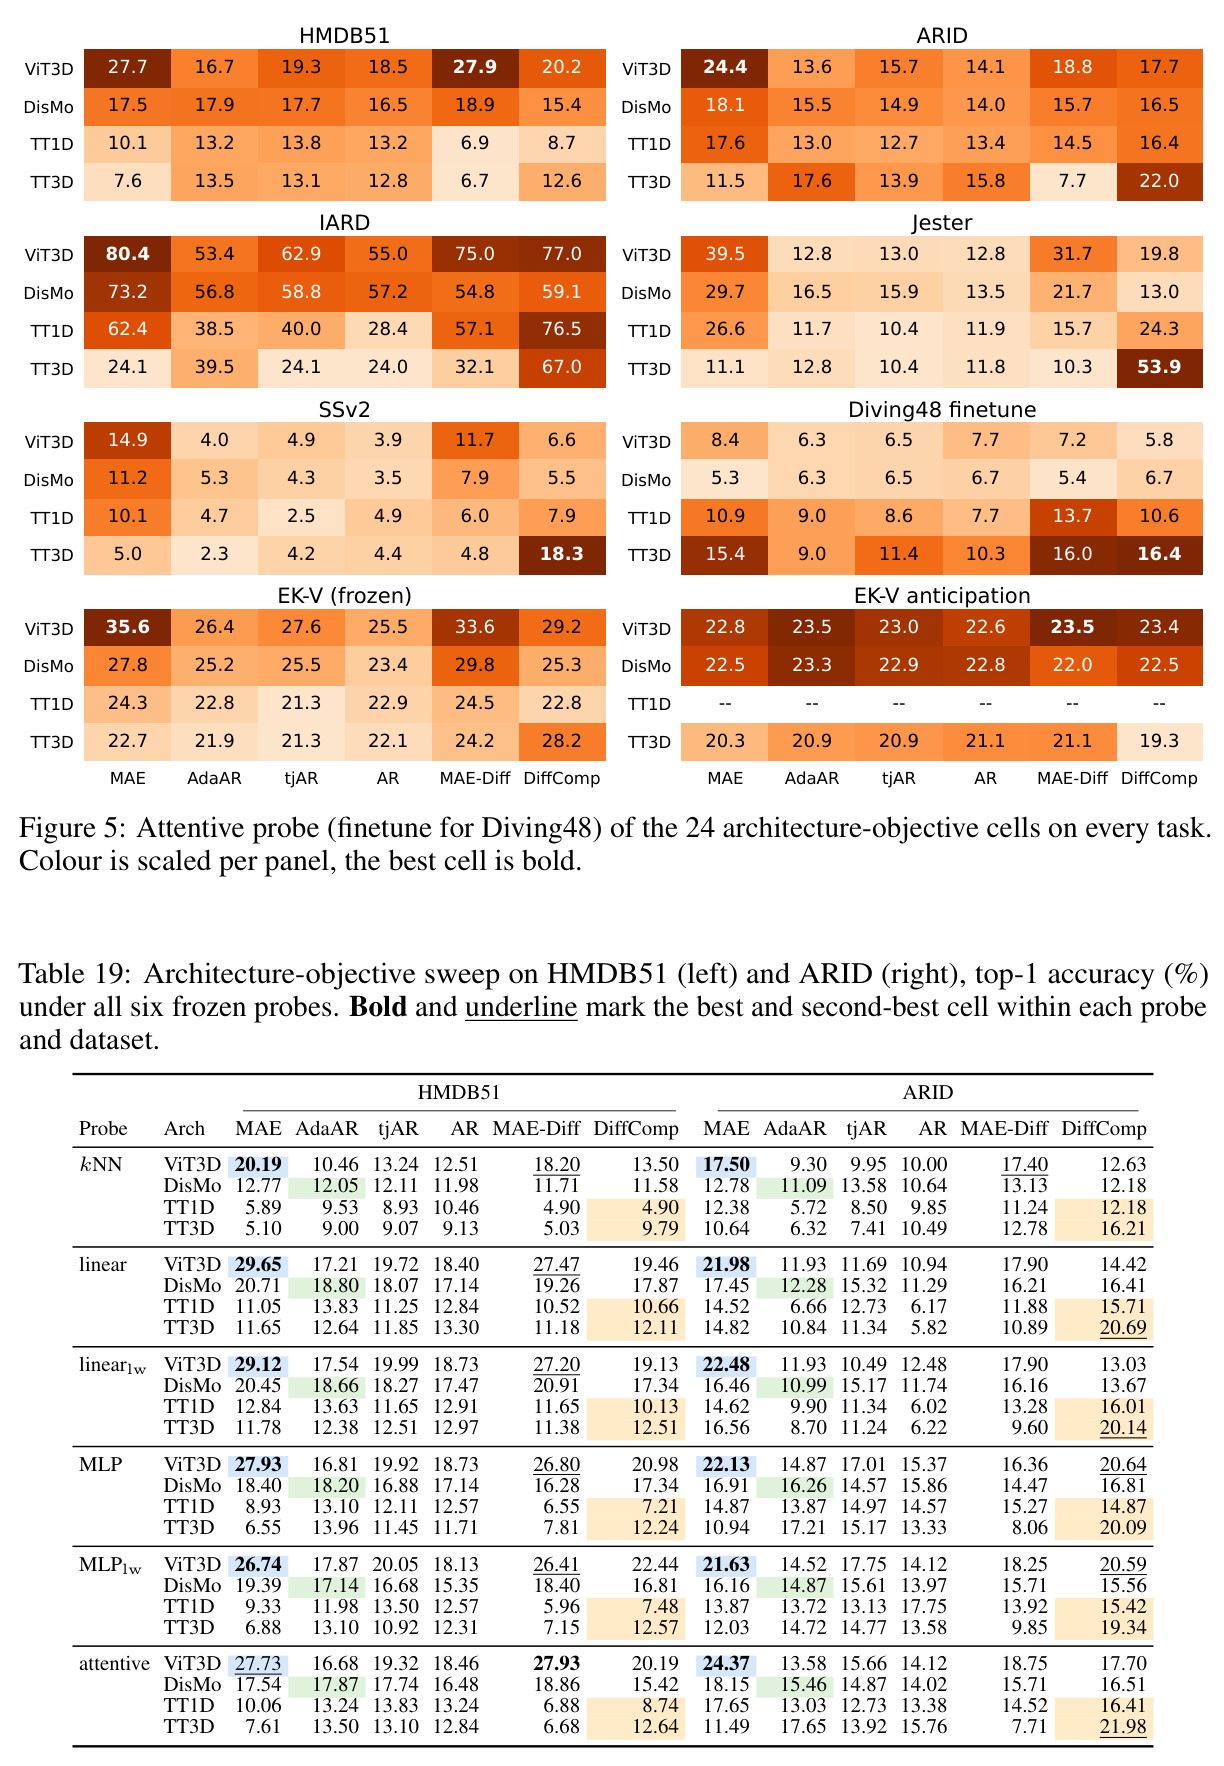
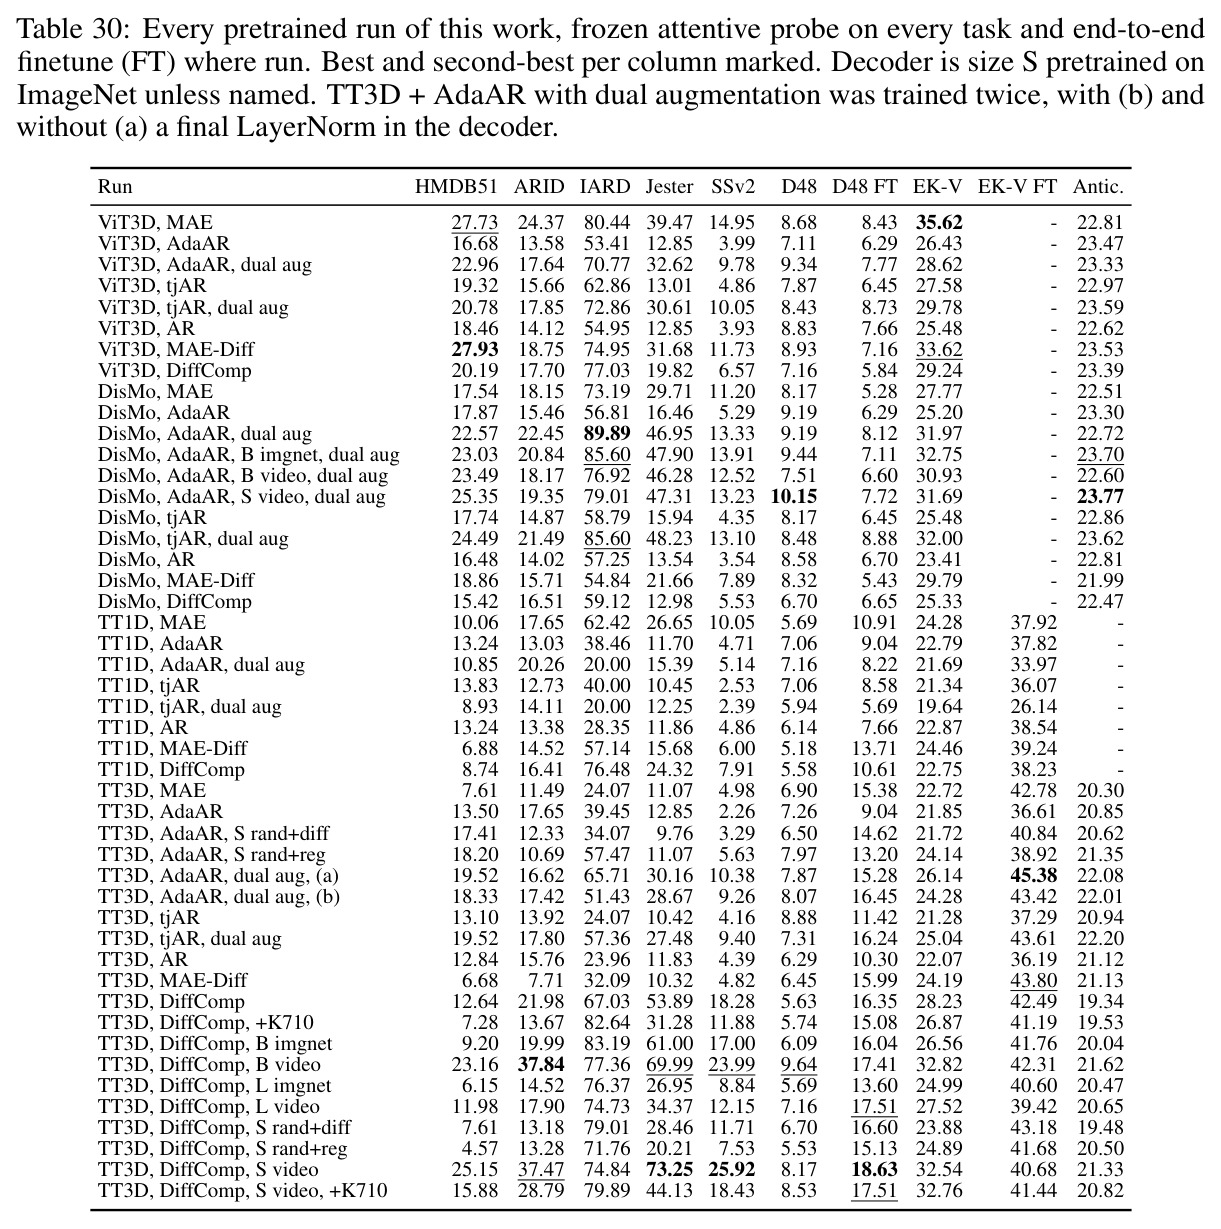
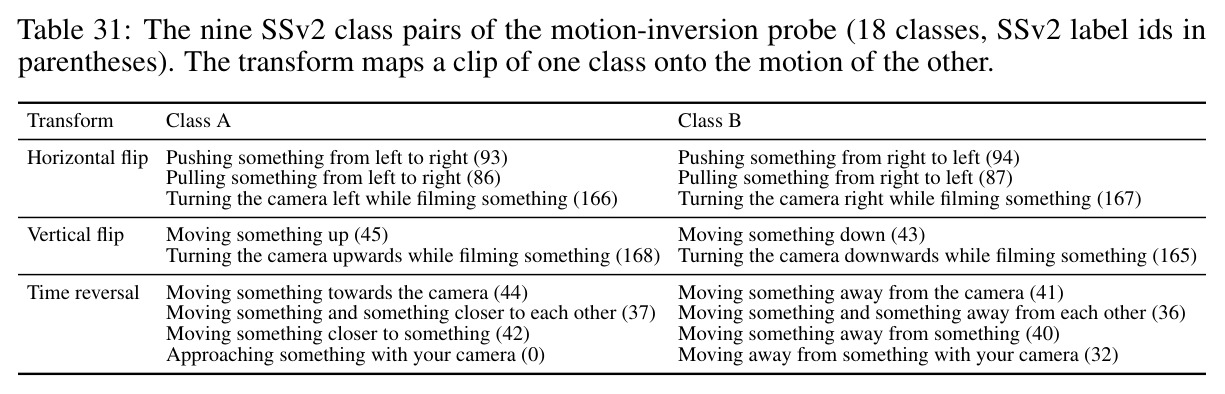
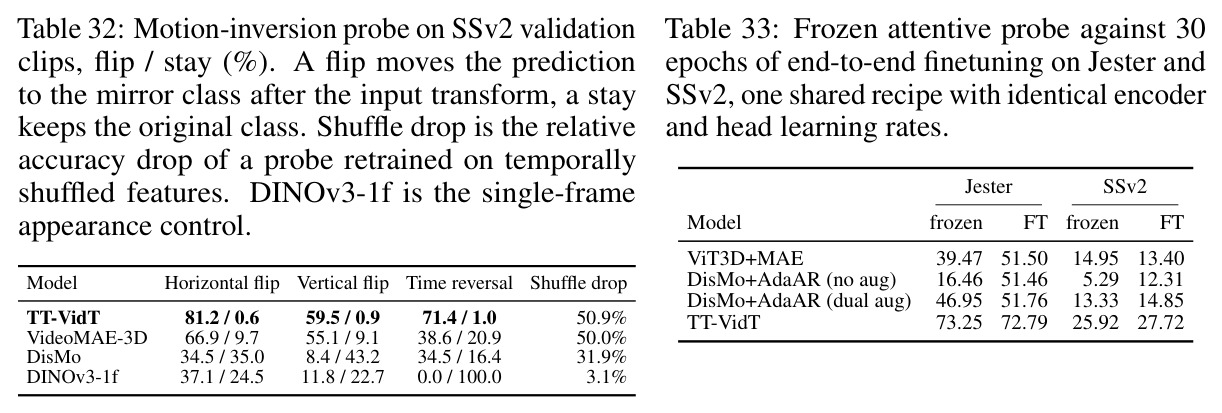
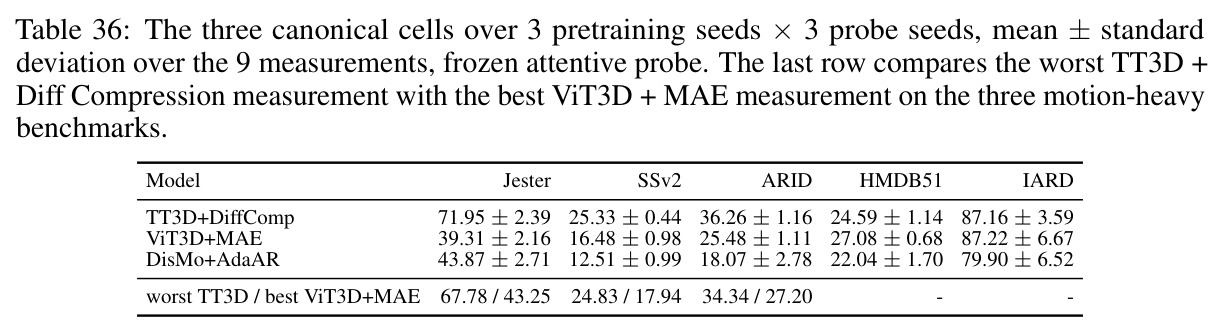
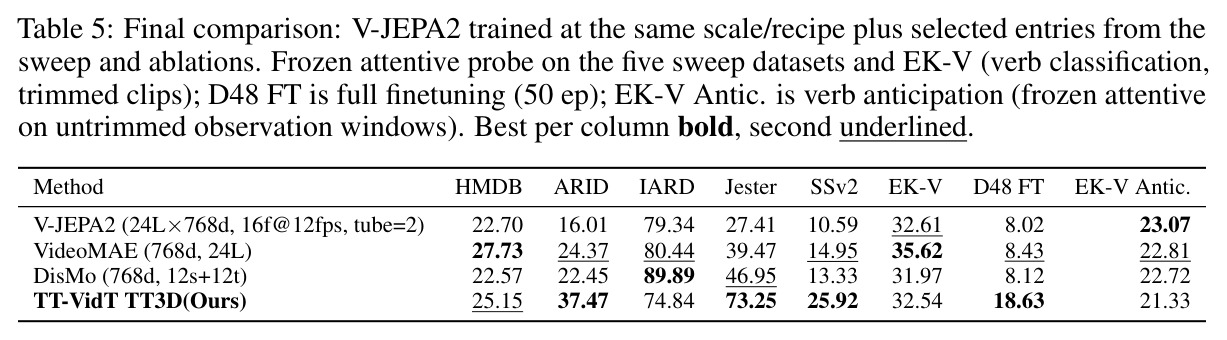
核心发现是配对效应:24 格扫描中只有 ViT3D+MAE(Jester 39.47 / SSv2 14.95)和 TT3D+DiffComp(53.89 / 18.28,配 ImageNet 解码器)进入运动任务第一梯队;固定 TT3D 换掉 DiffComp 后 Jester 跌到 11.07、SSv2 跌到 4.98,固定 DiffComp 换成 ViT3D/DisMo 架构只有 19.82/12.98,单组件都进不了强运动区。换上消融选定的视频预训练 S 解码器后,最终配置达 Jester 73.25、SSv2 25.92、ARID 37.47、Diving48 全量微调 18.63:较最强非 TT 行,ARID 领先 VideoMAE 13.1、Jester 领先双增强 DisMo 26.3、SSv2 领先 11.0、D48 FT 是 8.43 的 2.2 倍,整体提升 54%∼121%,而编码器 FLOPs 仅 456.1 GF(比 DisMo 少 48%、比 VideoMAE/V-JEPA 2 少约 55%)。运动倒置探针证实优势在表征本身:SSv2 镜像类视频经水平/垂直翻转或时间倒放后,TT-VidT 有 81.2%/59.5%/71.4% 跟随翻转到镜像类,坚持原答案仅 0.6%∼1.0%,而 VideoMAE 坚持 9.1%∼20.9%、DisMo 最高 43.2%、单帧 DINOv3 倒放时 100% 不动;打乱帧序后 TT-VidT 掉 50.9% 与 VideoMAE 的 50.0% 相当,说明两者都依赖帧序但 TT-VidT 读方向更忠实。归因上,DINOv3 初始化几乎不带来运动增益(ViT3D+MAE 加初始化后 Jester 仅 39.47→39.53),VTok 式显式差分得 64.7/24.8/26.5,全面优于非 TT 但逊于学习式令牌的 73.25/25.92/37.47。端到端微调 30 epoch 后基线在 Jester 饱和于约 51.5 而 TT-VidT 保持 72.79(SSv2 27.72),且九次测量的最差值仍高于最强基线的最好值。边界同样清晰:HMDB51(25.15 对 VideoMAE 27.73)、IARD(74.84 对双增强 DisMo 89.89)、EK-V 动词分类(32.54 对 35.62)与 EK-V 预测(21.33 对 V-JEPA 2 23.07)上仍由基线领先。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Jester(手势动作识别,运动导向) | 冻结注意力探针 top-1 准确率 (%) | 73.25(30 epoch 全量微调后仍 72.79) | DisMo 双增强 46.95;VideoMAE 39.47;V-JEPA 2 27.41 | 较最强非 TT 行 +26.3(约 +56%) |
| Something-Something V2(时序动作识别,运动导向) | 冻结注意力探针 top-1 准确率 (%) | 25.92(微调后 27.72) | VideoMAE 14.95;DisMo 双增强 13.33;V-JEPA 2 10.59 | 较 VideoMAE +11.0(约 +73%) |
| ARID(低光照动作识别,外观不可靠) | 冻结注意力探针 top-1 准确率 (%) | 37.47 | VideoMAE 24.37;DisMo 双增强 22.45;V-JEPA 2 16.01 | 较 VideoMAE +13.1(约 +54%) |
| Diving48 微调(细粒度跳水动作) | 全量微调(50 epoch)top-1 准确率 (%) | 18.63 | VideoMAE 8.43;DisMo 双增强 8.12;V-JEPA 2 8.02 | 较 VideoMAE +121%(2.2 倍) |
| SSv2 运动倒置探针(翻转/倒放输入后) | 坚持原预测比例 (%),越低越忠实于运动 | 水平翻转 0.6 / 垂直翻转 0.9 / 时间倒放 1.0 | VideoMAE 9.7 / 9.1 / 20.9;DisMo 35.0 / 43.2 / 16.4;DINOv3 单帧 24.5 / 22.7 / 100.0 | 坚持比例比最强基线低约 8~43 个百分点 |
| 编码器计算效率(T=8, 256²) | 分析型 FLOPs (GFLOPs) | TT3D 456.1(TT1D 400.5) | DisMo 874.7;V-JEPA 2 1009.9;VideoMAE 1012.6 | 比 DisMo 省 48%,比 VideoMAE / V-JEPA 2 省约 55% |
| EPIC-Kitchens-100 动词分类(边界案例) | 冻结注意力探针 top-1 准确率 (%) | 32.54 | VideoMAE 35.62(领先);V-JEPA 2 32.61 | 落后 VideoMAE 3.08,动词识别仍受益于物体与场景外观 |
局限与改进
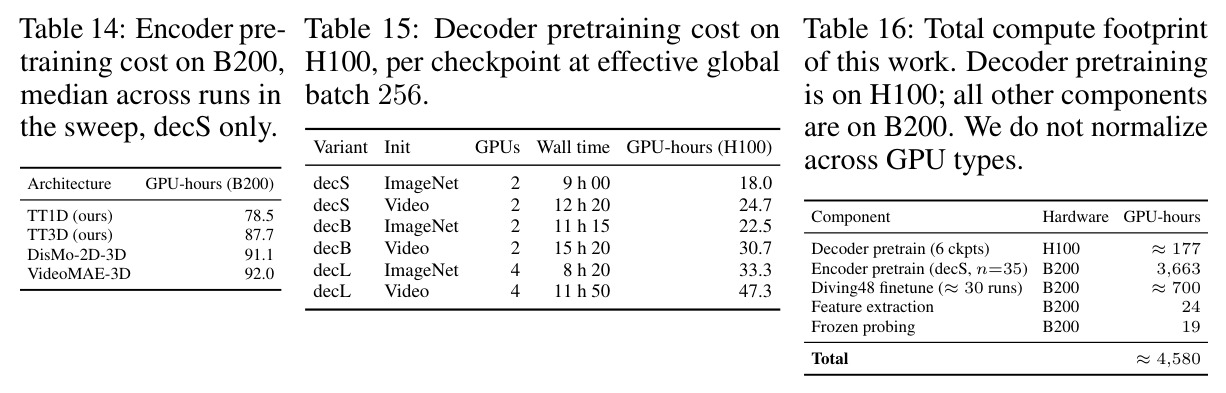
作者承认的边界有三条:研究刻意限定在小规模匹配配方——单一预训练混合(约 1.7M 片段)、单一编码器规模(170M∼190M)、扫描每格只跑一次(仅规范配置做多种子检查),结论只对该受控机制有效;未测试 TT3D 配 DisMo 式双增强、部分解冻空间编码器等组合;HMDB51、IARD、EPIC-Kitchens 上外观导向或预测型基线仍占优。我自己的观察还有:绝对性能远低于全规模系统(SSv2 25.92、D48 FT 18.63,与 VideoMAE v2、V-JEPA 2 原生配方不可比),价值在机制验证而非刷榜;ARID 在基础扫描中其实由 ViT3D+MAE 以 24.37 领先、TT3D+DiffComp 仅 21.98,是靠解码器消融才翻盘的,结论对解码器选择敏感;解码器放大反而有害的解释(容量分担重建压力)是推测性的,缺少直接的信息量测量;评测几乎全是分类探针,没有光流、跟踪、深度等密集运动任务交叉验证;FLOPs 是仅编码器的分析口径,24 格扫描加三种解码器预训练的总训练成本并未给出。
独立分析的弱点
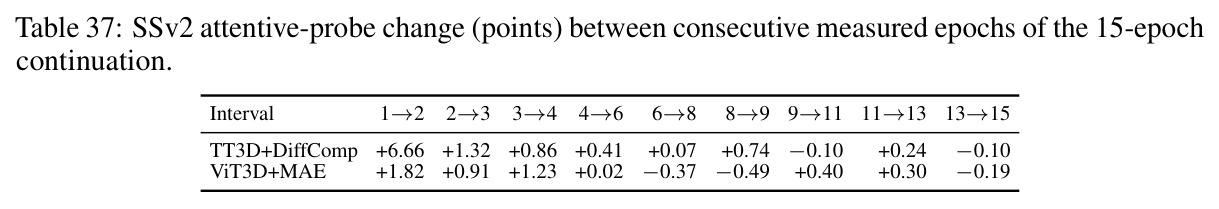
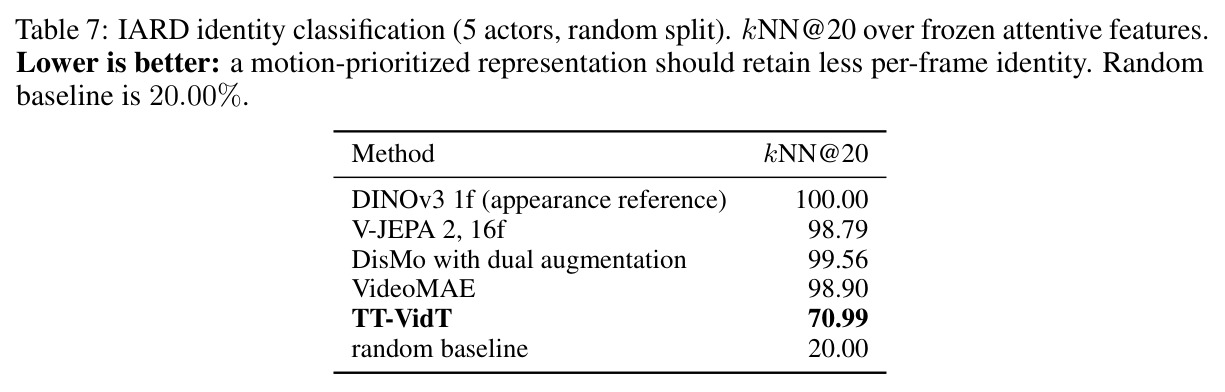
第一,规模天花板:配方刻意压小(8 epoch、1.7M 片段),V-JEPA 2 在此全面落后正说明部分方法需要规模才能发光,TT-VidT 在 VM22M 级数据上是否仍领先未知,应做规模曲线验证瓶颈设计的伸缩性。第二,解码器成为隐藏超参:最终 ARID 37.47 依赖视频预训练 S 解码器的选择,而解码器预训练本身又是额外开销,改进方向是理论化解码器容量与令牌信息量的关系,或让瓶颈宽度 $K$ 可学习。第三,外观任务回退:IARD 74.84 落后 DisMo 89.89 达 15 个点,若下游需要运动与身份兼顾(如视频检索),单锚点设计会丢身份细节,可引入多锚点或可切换宽窄通路。第四,评测维度单一:没有密集预测任务,运动倒置探针只覆盖 SSv2 镜像类,建议补充光流 EPE、点跟踪等直接度量。第五,扫描每格单种子且无置信区间,相邻格子的差距(如 ARID 的 17.70 对 17.65)可能落在噪声内。第六,TT3D 中运动令牌仍能看到下采样空间上下文,理论上存在外观泄漏进时间通路的旁路,论文未测泄漏量。
未来方向
作者明确列出的未测试方向包括:TT3D 与 DisMo 式双增强的结合、替代性外观探针、空间编码器的部分解冻。在此基础上可以自然延伸:其一,把 Diff Compression 的关键帧+运动令牌分解搬到视频生成与世界模型——它本就源自 VTok 的视频生成思路,用学习式运动令牌做长时程条件预测可能优于显式差分;其二,扩展到密集运动任务(光流、点跟踪、深度)检验运动表征的几何质量;其三,EK-V 预测上 V-JEPA 2 仍领先(23.07 对 21.33),可以把块因果运动令牌自然扩展到未来多步预测,补齐长时程预测短板;其四,研究瓶颈宽度的缩放律——$K$、$N'$、解码器大小与数据规模之间的最优配比,把 Table 2 的非单调现象变成可预测的设计规则;其五,把宽锚点换为多参考帧或可查询外观库以缓解 IARD 类身份任务回退;其六,蒸馏:TT1D 已只要 400.5 GFLOPs,可进一步蒸馏成端侧实时动作识别模型;其七,把运动倒置探针推广成标准诊断基准,覆盖更多变换(变速、相机运动)和更多数据集。
复现评估
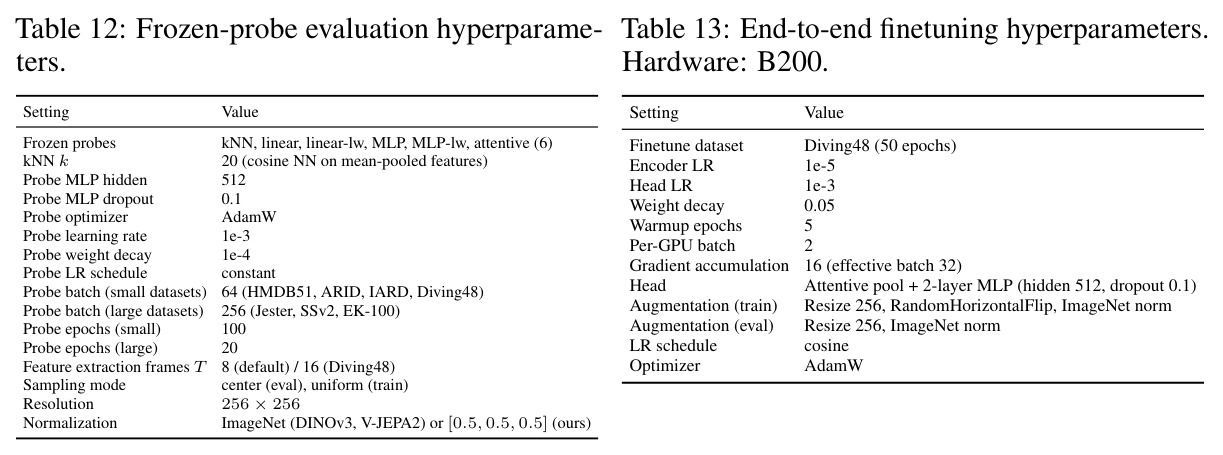
可复现性总体较好。论文给出了完整配方细节:帧采样($T=8$、6 fps)、优化器与超参(AdamW、学习率 $5\times10^{-4}$、betas $(0.9,0.98)$、权重衰减 0.01、裁剪 0.1、1 万步预热、余弦衰减到 1%、fp16、µP 基准维 256)、解码器三种初始化的具体做法(视频版以批 256 训 3 epoch)、探针阶梯(kNN/线性/MLP/注意力池化)以及运动倒置探针的构造,并有项目页 kohakublueleaf.github.io/TTVidT;所用数据 OpenVid、Moments-in-Time v2 与七个评测基准均公开。难点在于算力:完整复现需 24 次预训练(每次约 13.6M 样本、42.5 万步、170M∼190M 编码器)加三种解码器预训练和多种子检查,估计需要数十个 GPU 周;单卡用户只复现 TT-VidT 单点(一次预训练加探针)是可行的。论文由 NVIDIA 台湾研发中心支持,正文未明确承诺开源代码,实际复现难度还取决于作者是否放出训练代码与配置;若只有论文,需自行实现 DiT 解码器与时间转移层,工程量中等偏上。
论文图表