面向机器人操作的跨智能体递归框架蒸馏 Recursive Harness Distillation across Agents for Robot Manipulation
强智能体把干预经验蒸馏成操作手册并递归精炼,轻量智能体照做即可大幅提升冻结VLA成功率
前置知识
VLA(视觉-语言-动作)模型
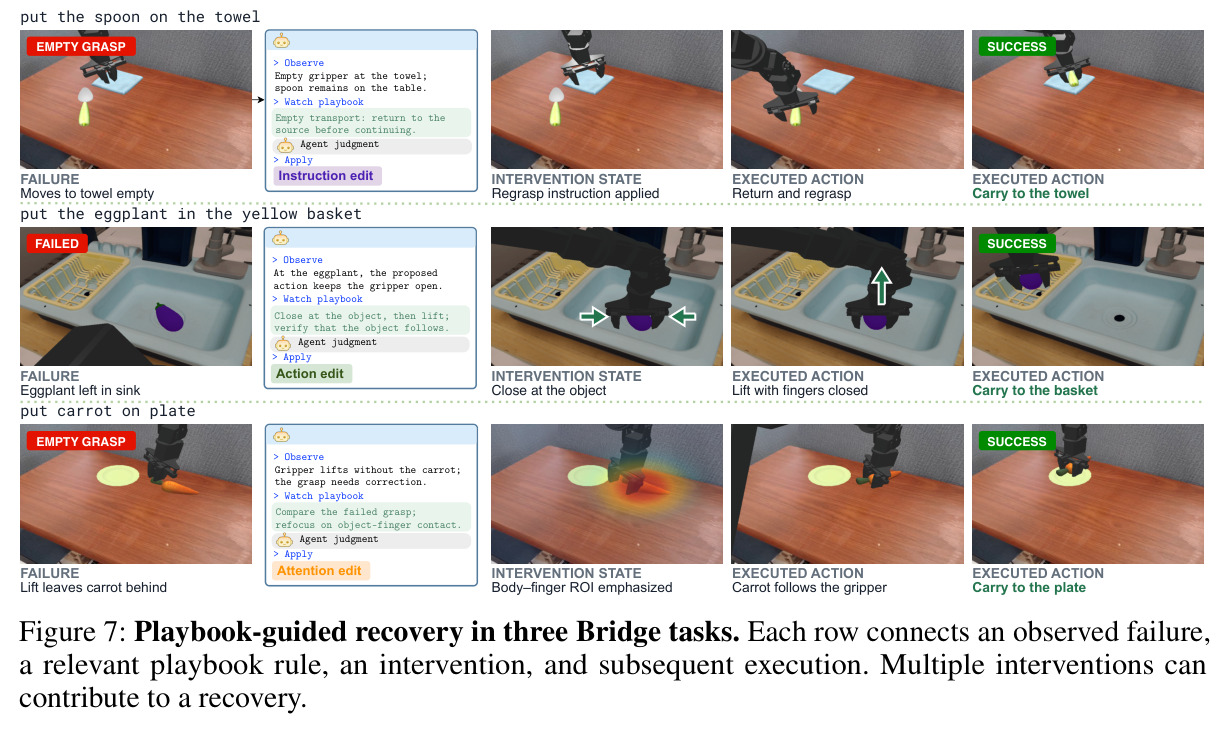
VLA 模型把预训练视觉语言表征与机器人动作学习结合,输入相机图像、本体感知和语言指令,直接输出动作块(action chunk),代表工作有 RT-2、OpenVLA、$\pi_0$/$\pi_{0.5}$ 和 GR00T。它们能靠语言指令切换任务,但在陌生视觉条件或执行状态变化下泛化受限,会出现空抓取、物体未跟随等失败。
全文的主旨是'在不改 VLA 参数的前提下操控其执行'。必须理解 VLA 的输入输出形态与典型失败模式,才能明白干预接口为何设计成指令/注意力/动作三个位点,以及手册里的规则在纠正什么。
Harness 与智能体编排
Harness 指连接语言模型推理与机器人执行的外部控制结构,提供感知、动作与反馈接口,让 LLM 智能体分解任务、监控进度、在执行失败时干预,代表工作有 SayCan、Inner Monologue、Code as Policies、VOLO。智能体在每个决策点观察历史 $h_t$,选择干预操作并决定是否执行策略提议的动作前缀。
RHD 的 harness 是承载手册的'插座'。理解接口暴露了哪些干预位点、恒等设置如何还原原始 VLA,是读懂方法设计和消融实验的前提。
知识蒸馏(Knowledge Distillation)
经典知识蒸馏用教师模型的预测分布(soft targets)监督学生训练,使小模型逼近大模型行为;后续扩展包括用教师生成的 rationales 监督学生推理,以及用学生反馈反向指导教师更新。本质是把教师能力迁移到更廉价的学生载体上。
本文把蒸馏对象从权重/概率分布换成'文本操作手册',是知识蒸馏思想在 LLM 智能体与机器人交叉处的新形态;不熟悉原概念就难以体会这种迁移的巧妙之处与代价。
SimplerEnv 与 Bridge 基准
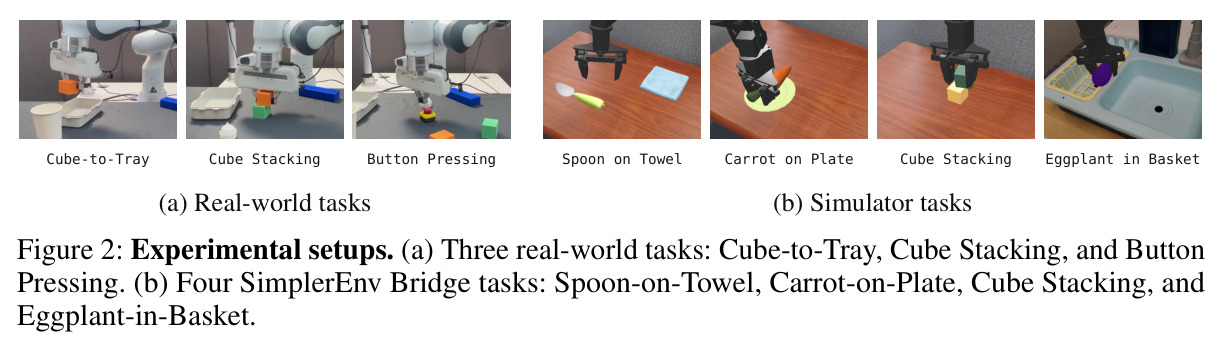
SimplerEnv 是在仿真中复现真实机器人策略评估的框架,Bridge 设置含四个 WidowX 任务:勺子放毛巾、胡萝卜放盘子、方块堆叠、茄子入篮。本文用 GR00T-N1.7-SimplerEnv-Bridge 检查点,每任务预留 12 个初始布局做开发、12 个做评估,共 48 实例/划分,回合上限 120 步(茄子入篮 240 步)。
读懂该基准才能正确解读 41.7%、66.7% 等主结果的统计含义——每个实例约值 2.1 个百分点,以及开发/评估分离、手册冻结等协议为何重要。
性能差恒等式(Performance Difference Lemma)
强化学习中连接两个策略价值差异与优势函数的恒等式 $J(\pi')-J(\pi)=\mathbb{E}_{\tau\sim\pi'}[\sum_t A^{\pi}(h_t,a_t)]$,出自 Kakade & Langford (2002) 与 TRPO 等工作,是把局部决策改进与全局性能提升联系起来的标准工具。
论文用它把'修订手册'形式化为'改善接收者在其实际遇到的历史上的决策优势'(式 3),这是 3.3 节理论框架的核心,也是理解验收规则 $\hat{J}_{S,k}(\mathcal{P})\geq\eta$ 设计动机的钥匙。
研究动机
视觉-语言-动作(VLA)模型如 GR00T 和 π0.5 把预训练视觉语言表征与机器人动作学习结合,能跨任务执行操作,但在陌生视觉条件和执行状态变化下并不可靠:SimplerEnv Bridge 四个任务上冻结的 GR00T 单独执行只有 41.7% 成功率,真实世界微调后的 π0.5 三任务总成功率也只有 37.3%(Cube Stacking 仅 3/25)。强智能体(如 Astra)能观察执行、诊断失败并通过干预纠正策略,但全程依赖强模型代价高昂:同一测试集上 Astra 推理成本 164.61 美元(每回合 3.43 美元),是轻量 Luna(30.03 美元,每回合 0.63 美元)的约 5.5 倍。更关键的是,直接给轻量智能体干预接口并不奏效:无手册的 Luna + GR00T 仅 43.8%,只比纯策略高 2.1 个百分点;真实世界无手册的 Luna + π0.5 成功率为 0%,甚至远低于策略单独执行的 37.3%。这说明'知道在哪里干预'与'知道如何有效干预'之间存在巨大鸿沟,而把强模型的操作经验转移给轻量模型本身也消耗大量探索与分析资源。
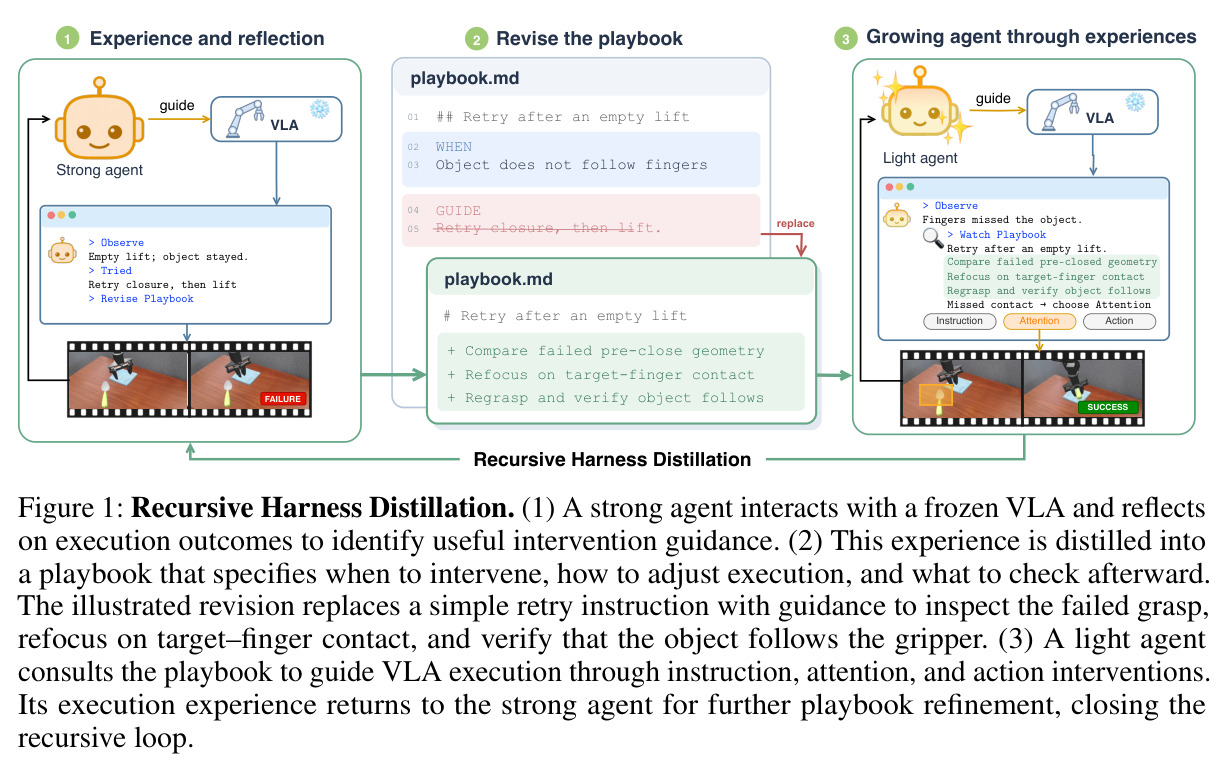
本文的目标是本文的目标是把强智能体在与冻结 VLA 交互中积累的干预经验,蒸馏成一份可复用、可跨智能体传递的文本'操作手册'(playbook),使轻量低成本智能体在不更新任何模型参数的情况下也能有效操控已部署的策略。具体而言,手册需要回答三件事:什么情况下应该干预(如空搬运、指令与动作不一致)、如何施加干预(改写指令、调节注意力、修正动作)、干预后应观察哪些信号确认起效(如物体是否跟随夹爪)。整个流程要求在有限 token 预算内完成:强智能体先探索并写出初版手册,轻量智能体携带手册执行任务,其执行反馈再回流给强智能体用于修订手册,如此递归迭代,最终让 0.63 美元/回合的轻量部署达到甚至超过无手册强智能体的成功率,并同时惠及强智能体自身。
与已有工作不同的是,已有工作在三条线上互不打通。Harness 类方法(Code as Policies、VOLO 等)提供了语言模型连接机器人执行的接口机制,让智能体分解任务、监控进度、失败时干预,但没有回答有效干预策略如何被积累并在不同智能体之间转移;经典知识蒸馏通过训练目标或教师 rationales 监督学生,蒸馏对象是模型行为而非可执行的外部文本指引,更不涉及物理执行结果;LLM 智能体的经验反思路线(Reflexion、ExpeL、ACE)保留文本反思并提炼可复用洞见,但未与 VLA 操作的物理干预接地。RHD 的独特切入是把三者统一成'教师—手册—接收者'的递归闭环:蒸馏的内容是'何时/如何干预冻结策略'的物理接地经验,修订的依据是接收者真实执行产生的失败与成功,并以策略优化的性能差恒等式给出形式化目标——改进必须发生在接收者实际遇到的历史分布上,而非教师自身的历史。
核心方法
RHD 的整体思路是‘接口 + 手册’构成 harness,由强弱两个智能体递归共建。直觉上,操控固定的 VLA 像操作一台有些脾气的机器:老手(Astra)摸索出‘遇到某现象就这么处理’的经验,写成手册交给新手(Luna),新手照做后暴露的新问题再让老手修订。技术上,接口沿 VLA 计算暴露三个干预位点:指令 $u^I_t$、注意力 $u^F_t$、输出动作 $u^A_t$,候选动作由 $\hat{e}^I_t = f_I(I, u^I_t)$、$\hat{a}_t = \pi_\theta(o_t, \hat{e}^I_t; u^F_t)$、$a_t = f_A(\hat{a}_t, u^A_t)$ 生成,$\pi_\theta$ 冻结,恒等设置还原原始 VLA;智能体也可只检查候选动作块而不推进环境,执行时仅施加获批前缀。手册 $\mathcal{P}$ 存放‘可观察情形 → 干预选择 → 预期后果’的规则。Astra 先执行任务写出 $\mathcal{P}_0$;Luna 携带 $\mathcal{P}_k$ 执行,经验 $E_{S,k}$ 回流,Astra 提出修订并评估接受,形成递归循环。
核心创新是把‘手册蒸馏’形式化为对轻量智能体诱导策略的策略优化,而非传统权重或 logits 蒸馏。目标定义为 $J_S(\mathcal{P}) = \mathbb{E}_{\tau \sim p_D(\tau; \Pi_{S,\mathcal{P}})}[Y(\tau)]$,手册价值只能通过接收者的真实执行体现。利用性能差恒等式 $J_S(\mathcal{P}’) - J_S(\mathcal{P}_k) = \mathbb{E}_{\tau \sim p_D}[\sum_{t=0}^{N(\tau)-1} A_k(h_t, b_t)]$(期望在候选策略轨迹分布上取),修订应在接收者实际遇到的历史上改善决策优势——仅复现教师自身历史上的决策毫无意义。由此催生独特验收规则:候选手册须在与教师相同的开发实例上达到教师经验成功率 $\eta$($\hat{J}_{S,k}(\mathcal{P}) \geq \eta$)才被接受,把蒸馏质量锚定在可测量的下游执行上。与已有方法的本质区别:传递对象(外部文本规则而非参数)、修订信号(接收者物理执行结果而非训练损失)与验收标准(下游成功率而非代理指标)全部围绕接收者的执行闭环组织。
方法步骤详情
方法分五步。第一步,构建干预接口:允许用不超过 512 字符的文本替换策略指令;对选定图像区域的视觉 token 施加 0–4 强度注意力 logit 偏置;修改末端执行器运动和夹爪命令(每次最多 5 个控制步),三类干预无强制顺序、可任意组合。第二步,教师初始化:Astra 在冻结 GR00T 上完成 8 个开发回合,从经验 $E_T$ 提取初版手册 $\mathcal{P}_0$,规则形如‘空搬运先回源点重抓’‘OPEN 指令仍可能返回 CLOSE,需检查策略输出前缀’。第三步,接收者执行:Luna 携带 $\mathcal{P}_k$ 执行开发任务,逐步记录决策 $b_t$(所选操作、VLA 提议动作、实际执行动作)与环境响应。第四步,教师修订:Astra 对比师生在相同案例(每轮 8 新 + 8 旧)上的执行,针对歧义、错误适用条件和无效干预提出修订,逐版本存档。第五步,验收与迭代:候选手册依次在同一批开发实例上评估,首个成功率不低于教师水平 $\eta$ 的候选被接受为 $\mathcal{P}_{k+1}$;若无候选达标则继续提案(不保证终止)。评估时手册冻结,环境成功信号对智能体不可见。
技术新颖性
技术新颖性体现在四点。其一,蒸馏对象是外部文本手册而非模型参数,实现零训练、零微调的能力迁移,且手册可版本化存档、跨智能体复用——同一份 GR00T 手册让 Luna 和 Astra 分别达到 66.7% 和 79.2%。其二,递归修订以接收者诱导的分布为经验来源(类比序列模仿学习中的 learner-induced distribution),修正了教师自说自话的偏差:Luna 自蒸馏仅得 22.9%、反而低于无手册的 43.8%,反证了强教师层级与递归反馈两个成分缺一不可。其三,把整个过程纳入策略优化框架,用性能差恒等式刻画改进目标,并设计了以教师成功率为锚的验收规则,给通常凭手感的'写 prompt 式'经验工程加上了优化语义与明确的停止条件。其四,指令/注意力/动作三个干预位点的消融量化了各通道贡献,发现手册引导的指令编辑贡献最大,说明增益主要来自'把策略指令说对'而非直接改动作,这为后续轻量化部署(如只保留指令通道)提供了依据。
实验结果
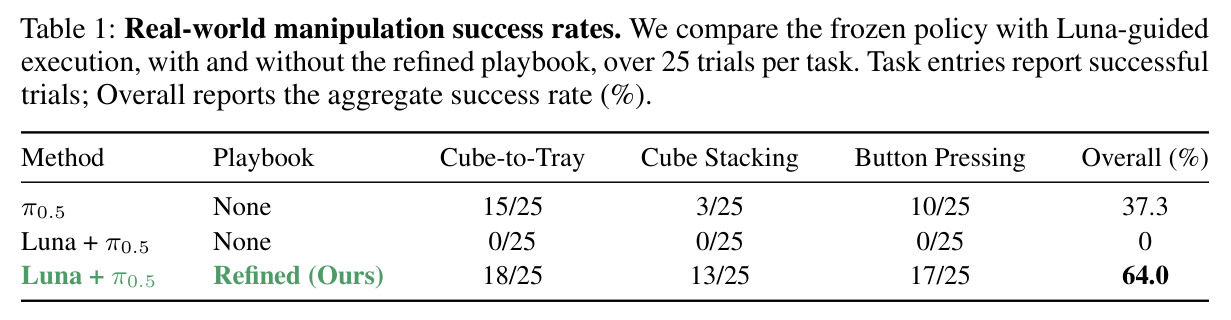
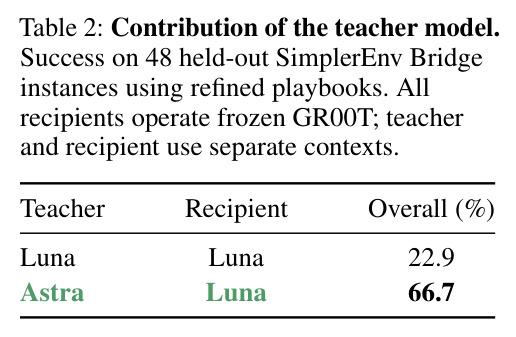
核心发现有三层。第一,手册带来大幅且跨智能体的提升:SimplerEnv Bridge 48 个保留实例上,冻结 GR00T 单独 41.7%,加无手册 Luna 仅 43.8%,携带精炼手册的 Luna 达 66.7%(+22.9 个百分点),超过无手册的强智能体 Astra(47.9%);同一手册也让 Astra 升至 79.2%。真实世界 Franka Panda 三任务(各 25 次、共 75 次)上,π0.5 单独 37.3%(15/25、3/25、10/25),无手册 Luna + π0.5 全部 0/25,精炼手册推至 64.0%(18/25、13/25、17/25)。第二,递归精炼不可或缺:初版手册把 Luna 从 43.8% 拉低到 31.3%,精炼后升至 66.7%;Figure 5 显示四任务成功率逐版上升,多数任务每回合 token 用量同步下降。第三,教师层级必要:Luna 教 Luna 仅 22.9%,Astra 教 Luna 达 66.7%。消融中,去掉指令编辑降至 54.2%(降幅最大),去掉注意力编辑 64.6%、动作编辑 62.5%,说明增益不只来自改动作。成本上,Luna 全测试集 30.03 美元(0.63 美元/回合),约为 Astra(164.61 美元,3.43 美元/回合)的 1/5.5。
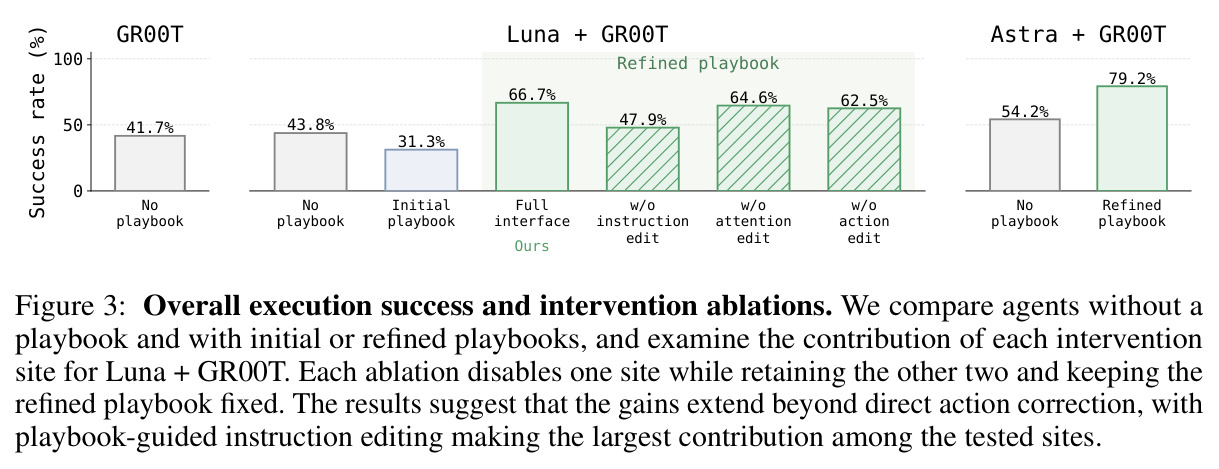
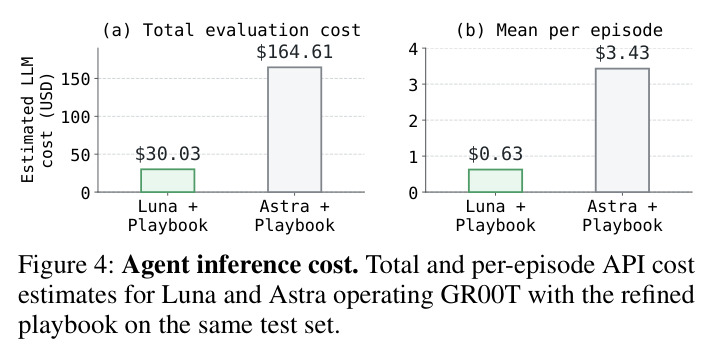
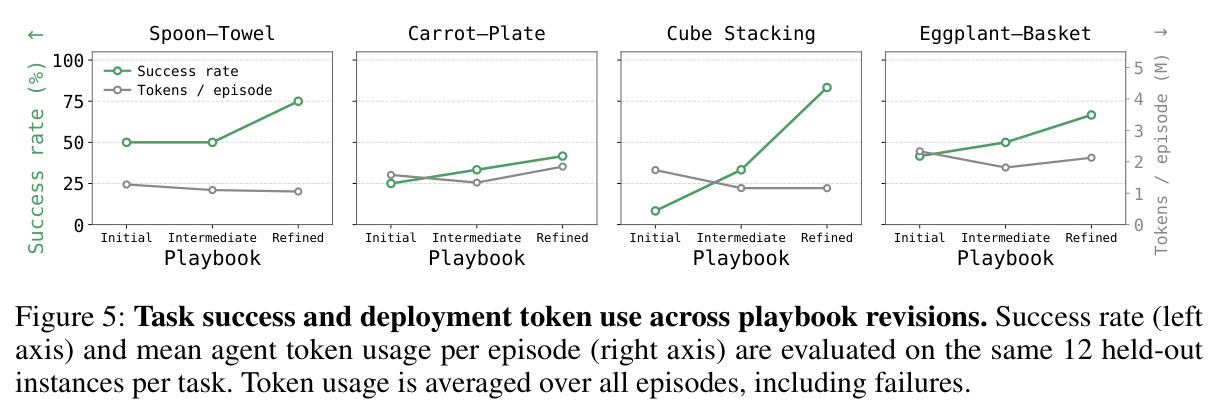
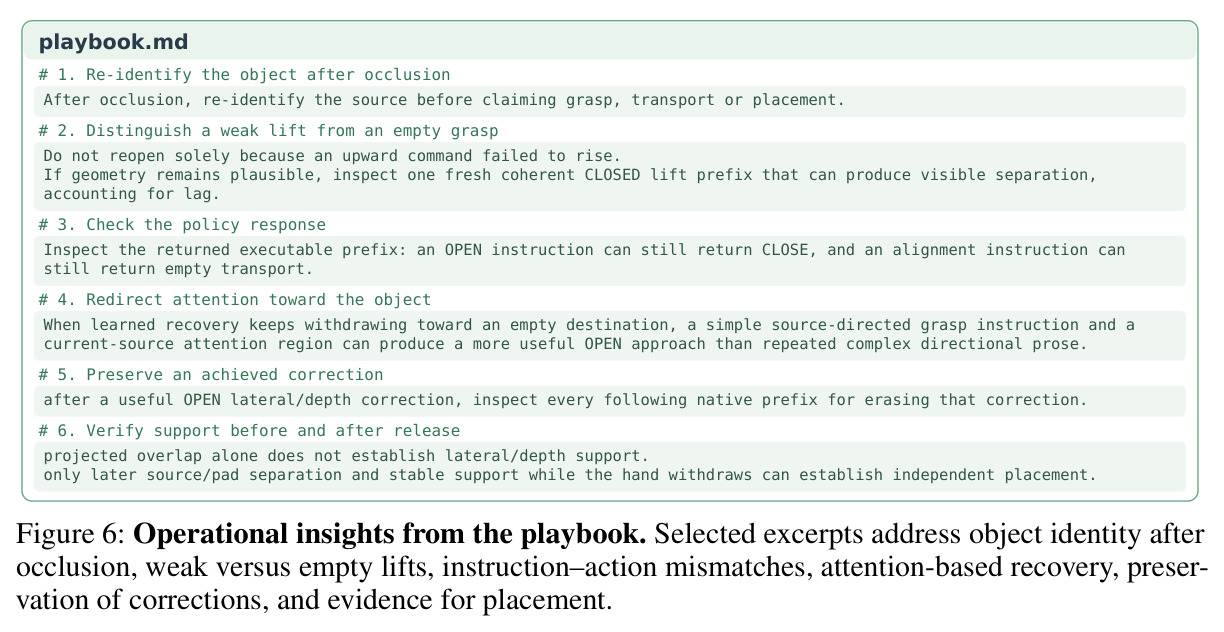
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SimplerEnv Bridge(4 任务 × 12 保留实例) | 执行成功率 | 66.7%(Luna + 精炼手册) | 41.7%(仅 GR00T);43.8%(Luna 无手册) | 较纯策略 +25.0 个百分点,较无手册轻量智能体 +22.9 个百分点 |
| SimplerEnv Bridge(强智能体验证) | 执行成功率 | 79.2%(Astra + 同一份精炼手册) | 47.9%(Astra 无手册) | +31.3 个百分点,手册可跨能力层级复用 |
| 真实世界 Franka Panda 三任务(75 次试验) | 总体成功率 | 64.0%(Luna + π0.5 + 精炼手册:18/25、13/25、17/25) | 37.3%(仅 π0.5);0%(Luna + π0.5 无手册) | 较纯策略 +26.7 个百分点;Cube Stacking 从 3/25 提升到 13/25 |
| 教师模型贡献对照(接收者固定为 Luna + GR00T) | 保留实例成功率 | 66.7%(Astra → Luna) | 22.9%(Luna → Luna 自蒸馏,低于无手册的 43.8%) | +43.8 个百分点,证明强教师层级必要 |
局限与改进
作者承认与可观察的局限:评估规模偏小,仿真每任务仅 12 个保留实例,真实世界每任务 25 次试验,单个实例成败就会撬动约 2.1(仿真)至 4(真实)个百分点,且论文未报告置信区间或多种子方差;验收规则明确'不保证终止',候选不达标时可能持续迭代,每轮 8 新 + 8 旧案例的开发预算也限制了修订决策的统计可靠性。我认为还有更深的问题:其一,手册与具体 VLA 检查点和任务分布强耦合,迁移到物理任务尚需 Astra 重新适配 GR00T 手册,跨策略、跨本体泛化完全未验证;其二,注意力干预要求访问 VLA 内部注意力 logits,闭源策略无法使用;其三,初版手册反而有害(31.3% < 43.8%)暴露了冷启动负迁移风险,而论文只在结果中呈现、未给出缓解机制;其四,智能体可改写指令而成功仍按原始目标判定,虽然协议上排除了作弊,但长时程中的'目标漂移'风险讨论不足;其五,依赖 GPT-6 Astra 与 GPT-5.6 Luna 等专有模型,手册质量与风格可能随基础模型版本漂移,影响可复现性。
独立分析的弱点
独立分析几个弱点。第一,统计功效不足:12 实例/任务下,66.7% 对 64.6% 的差距不足一个实例,注意力与动作编辑的相对贡献结论实际不可区分,应扩大保留集并报告 bootstrap 置信区间。第二,冷启动负迁移:初版手册让 Luna 从 43.8% 掉到 31.3%,说明未经接收者检验的教师经验可能系统性误导,可引入更保守的验收或先小批量试点再全量发布。第三,harness 依赖白盒注意力接口与动作块前缀执行,黑盒 API 策略无法部署完整方法,可依据消融结果做只保留指令与动作通道的降级版本,或学习代理探测器。第四,缺少与其他经验积累方法在同一接口下的对照(如 Reflexion 式逐回合反思、ACE 式上下文演化),无法判断‘递归反馈’与‘强教师’哪个成分贡献更大,应补齐方法级消融。第五,真实世界无手册 Luna 三任务全为 0%,说明接口文档完全不足以支撑操作,值得研究‘最小可行指引’的自动生成与最小化。第六,手册规则以自然语言陈述物理条件(如‘验证物体跟随夹爪’),其可靠性最终依赖接收者的视觉判断,误报与漏报率未被单独测量。
未来方向
作者指出的方向是'经验可被积累、经执行精炼、跨智能体复用'的三步范式,其自然延伸包括:把手册从单一 VLA 检查点扩展为跨策略、跨本体的分层手册库,按策略特性自动检索与适配;研究手册的持续累积与遗忘机制,让多任务、多机器人团队以联邦方式共享并合并经验;为验收规则引入统计保证,如序贯检验或下置信界验收,缓解不保证终止的问题;将手册蒸馏与参数微调结合,把高频稳定规则蒸馏回策略权重以降低推理时延;探索干预接口的自动设计,让系统自行发现可干预位点而非人工指定指令/注意力/动作三类;以及在手册中引入可验证的前置/后置条件(如基于检测的'物体是否跟随夹爪'判定),使干预决策可审计、可回放。另一条有价值的延伸是研究接收者能力与手册粒度的匹配规律:Luna 需要的操作化规则与 Astra 能消化的抽象规则显然不同,自适应手册'详细程度'可能进一步拉大轻量部署的性能上限。
复现评估
复现难度中等偏高。有利条件:GR00T-N1.7-SimplerEnv-Bridge 公开检查点与 SimplerEnv 仿真环境均开源,π0.5 亦公开;论文完整给出接口参数(指令 512 字符上限、注意力偏置 0–4、动作修改每次最多 5 个控制步)、开发/评估划分(每任务 12+12 布局)、回合长度(120/240 步)、每轮 8 新 + 8 旧案例的协议及详细成本数据(Luna 每百万 token 输入 0.20、缓存读 0.02、输出 1.20 美元;Astra 输入 10、输出 50 美元),手册按版本存档便于复用对照。障碍:强弱智能体是专有的 GPT-6 Astra 与 GPT-5.6 Luna,手册内容依赖这两者的能力,换用其他模型未必复现 66.7% 与 79.2%;论文未声明开源代码或手册全文(Figure 6 仅六条节选);真实世界部分需要 7 自由度 Franka Panda、腕/前/右三个相机及每任务 50 条遥操作演示微调 π0.5。总体而言,仿真部分用开源组件加任意强 LLM 可近似复现趋势,真实机器人部分则需要完整硬件平台与遥操作数据采集能力。
论文图表