VisionHOPE:作为自修改学习系统的视觉主干网络 VisionHOPE: Visual Backbones as Self-Modifying Learning Systems
首个自修改视觉主干:五记忆共演化加稳定步长控制,线性复杂度拿下三大基准。
前置知识
嵌套学习(Nested Learning, NL)
把模型看成一组相互嵌套的学习过程:每个过程将不断流入的上下文压缩成一个内部状态,状态参数本身就是记忆,优化状态的过程就是学习。其自参考构造允许记忆自己生成更新所需的键/值表示与超参数(学习率、保留因子),从而让所存内容和更新规则共同演化。
VisionHOPE 是 NL 自参考原理在通用视觉主干上的首次完整实例化,五个耦合记忆与 SR-DGD 更新规则全部直接来自 NL 框架,不先理解 NL 就无法理解本文在改什么、稳定什么。
关联记忆与 Delta 梯度下降(DGD)
关联记忆是参数化映射 $M: \mathbb{R}^{d_k}\to\mathbb{R}^{d_v}$,把键值对压缩进自身参数。DGD 把每步更新写成近端 L2 回归问题 $\min_W \tfrac12\|Wk_t-u_t\|_2^2+\tfrac{1}{2\lambda_t}\|W-W_{t-1}\|_F^2$,闭式解为 $W_t = W_{t-1}(I-\eta_t k_t k_t^\top)-\eta_t g_t k_t^\top$,其中 $\eta_t=\lambda_t/(1+\lambda_t\|k_t\|_2^2)$。相比普通梯度下降多出键相关修正项,会写入残差、显式修订已有关联。
VisionHOPE 五个记忆的每步状态更新就是带保留因子 $\alpha_t$ 的 DGD(SR-DGD),这是整篇论文的递推核心。
测试时训练(TTT)层
把循环网络的隐状态替换为一个内部学习者(如一个小模型的权重),在处理序列时用自监督目标在线更新它,使推理过程本身成为学习过程。TTT 层可替代注意力或普通循环层;视觉中的代表是 ViT3(全图内适配)与 Vision-TTT(沿 token 序列循环适配)。
TTT 视觉主干是本文最直接的对比对象。VisionHOPE 与它的本质差异在于:连学习者用来生成更新的表示映射和学习率/保留规则也随图像演化。
谱范数与非扩张动态
矩阵谱范数 $\|T\|_2$ 是其最大奇异值,衡量一次线性变换最多能把向量放大多少倍。若递推 $M_t=M_{t-1}T_t$ 中每步满足 $\|T_t\|_2\le 1$(非扩张),则由次乘性 $\|M_t\|_F\le\|M_{t-1}\|_F$,状态范数沿扫描单调不增,训练不会数值爆炸。
本文稳定性理论的全部内容就是证明受控转移 $T_t=A_t+B_t$ 满足 $\|T_t\|_2<1$(token 级与 chunk 级),这是方法能训起来的根基。
四向扫描与分块(chunk)并行
图像是二维网格而循环模型按序列处理,因此需先序列化:VMamba 式四向扫描沿行主序/列主序及其反方向把特征图展开成四条序列,各自维护独立状态,输出在通道维融合。分块把序列切成定长 chunk:chunk 内用固定边界状态并行生成逐 token 量,状态更新仍按 token 顺序串行累积,chunk 结束时刷新边界。
这是 VisionHOPE 高效处理二维特征图、实现 token 数线性复杂度并保留并行性的关键工程方案,也是消融中影响精度的重要设计。
研究动机
视觉主干的演进史就是计算对输入越来越自适应的历史,但自适应规则本身始终是训练时定死、推理时不变的。CNN 用共享局部卷积核做局部聚合;ViT 引入内容相关的自注意力,token 交互依赖当前图像,但生成 QKV 的映射在图内固定,且 $\mathcal{O}(N^2)$ 复杂度让高分辨率处理代价剧增(DeiT 显式注意力还带来 $O(BN^2)$ 内存);Mamba 等 SSM 让状态转移输入依赖、复杂度线性,但每个 token 只是经固定映射产生转移,token 到转移的映射本身在整张图内不演化;TTT 层更进一步,把内部学习者作为循环状态用自监督更新(ViT3、Vision-TTT),然而其表示映射与更新动态仍基本由外层参数 prescribe。也就是说,现有主干最多做到修改记什么,从不修改怎么学。同时,把学习规则纳入图内演化的朴素尝试存在硬障碍:无约束自参考更新下,记忆会生成支配自身后续更新的量,形成反馈回路,一步放大的记忆转移沿视觉上下文复合放大,直接导致训练发散。
本文的目标是本文要构建第一个通用视觉主干,把它显式形式化为自修改学习系统:在单张图像的扫描过程中,模型不仅更新存储内容的内容记忆,还同步演化生成键/值表示的键记忆、值记忆,以及控制学习率的记忆和保留因子记忆,实现记什么与怎么学的共演化。为此必须:其一,识别并解决无约束自参考更新在视觉中的稳定性屏障,给出可证明的记忆动态非扩张保证;其二,把该机制高效落到二维特征图上,保持对视觉 token 数的线性计算与内存复杂度;其三,同时实例化层级式与 plain 式两种主干,并在 ImageNet-1K 分类、COCO 检测/实例分割、ADE20K 语义分割上系统验证竞争力。
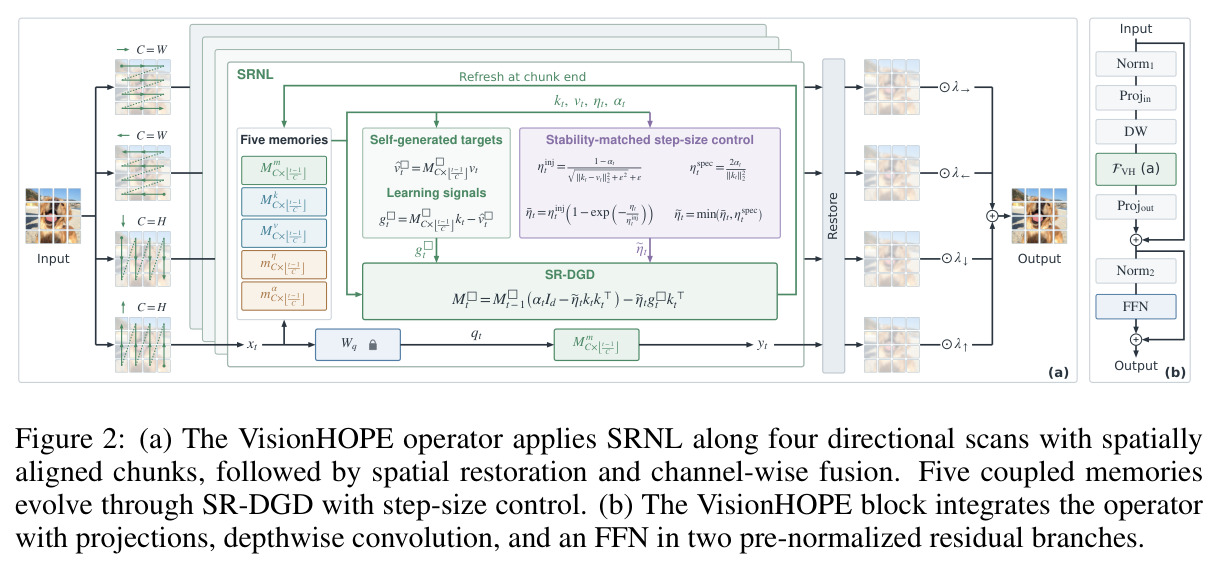
与已有工作不同的是,本文的独特切入是不发明新算子,而是把 NL 的自参考原理系统性引入视觉。原版 NL/HOPE 面向语言建模,学习信号来自 next-token prediction;判别视觉没有规范的逐 token 在线目标,把 NL 的多时间尺度 CMS 记忆搬进视觉还需额外设计在线学习目标,因此 VisionHOPE 刻意只聚焦自参考组件,并率先指出无约束自参考更新在视觉中构成稳定性屏障。理论上它不做经验正则,而是推导稳定匹配步长控制:软注入帽平滑限制自参考注入、谱钳约束保留转移,二者给出互补算子界并证明逐 token 与逐 chunk 非扩张。工程上把 NL 的 chunk 形式适配到 VMamba 式四向扫描,并让 chunk 与整行/整列对齐,同时兼顾二维结构、线性复杂度与硬件并行性。
核心方法
直觉是把一次图像扫描看成一个在线学习过程:内容记忆 $M_t^m$ 是学到的知识,键/值记忆 $M_t^k,M_t^v$ 是表示生成器,学习率记忆 $m_t^\eta$ 与保留记忆 $m_t^\alpha$ 相当于优化器超参数;这五者都在每步用当前 token $x_t$ 由上一时刻的自身状态生成,随视觉上下文积累共演化——模型在处理一张图的同时修改自己的学习规则。技术路线分四层:第一层是 SRNL 模块,用带保留因子的自参考 DGD 递推更新五个记忆;第二层是稳定匹配步长控制,先经 L2 键归一化和软注入帽、再经谱钳,把每步转移的谱范数严格压到 1 以下并给出证明;第三层是二维适配,沿四个方向扫描特征图,每个方向独立维护五记忆状态,chunk 与整行/整列对齐以便并行,四路输出经空间恢复和可学习通道权重融合;第四层是块设计,把算子嵌入带输入/输出投影、门控深度卷积和 FFN 的双 pre-norm 残差分支,支持四阶段层级式与单分辨率 plain 式两种布局。
核心创新是自参考耦合与稳定匹配步长控制的组合。与 TTT 视觉主干(ViT3、Vision-TTT)的本质区别:TTT 只在图内适配内部学习者本身,其表示映射与更新规则由外层参数固定;VisionHOPE 中每个记忆用当前 token 从自身上一状态生成键、值、步长、保留因子,且用当前状态变换共享值来产生自己的回归目标 $\hat{v}_t^\square=M_{t-1}^\square v_t$,于是内容、更新表示与学习动态成为共同演化的耦合系统。与原版 NL 的区别:直接把无约束 SR-DGD 用于视觉会发散——一步转移沿 $k_t$ 方向的谱范数下界可达 $\eta_t\|k_t\|_2\|k_t+\delta_t\|_2-\alpha_t$,超过 $1+\alpha_t$ 即扩张。本文把转移分解为保留部分 $A_t=\alpha_t I-\tilde\eta_t k_t k_t^\top$ 与自参考注入 $B_t=-\tilde\eta_t\delta_t k_t^\top$($\delta_t=k_t-v_t$),用软帽 $\bar\eta_t=\eta_t^{inj}(1-e^{-\eta_t/\eta_t^{inj}})$ 把 $\|B_t\|_2$ 压到 $1-\alpha_t$ 以下,用谱钳 $\tilde\eta_t=\min(\bar\eta_t,\,2\alpha_t/\|k_t\|_2^2)$ 保证 $\|A_t\|_2\le\alpha_t$,故 $\|T_t\|_2<1$,五记忆范数沿扫描单调不增。
方法步骤详情
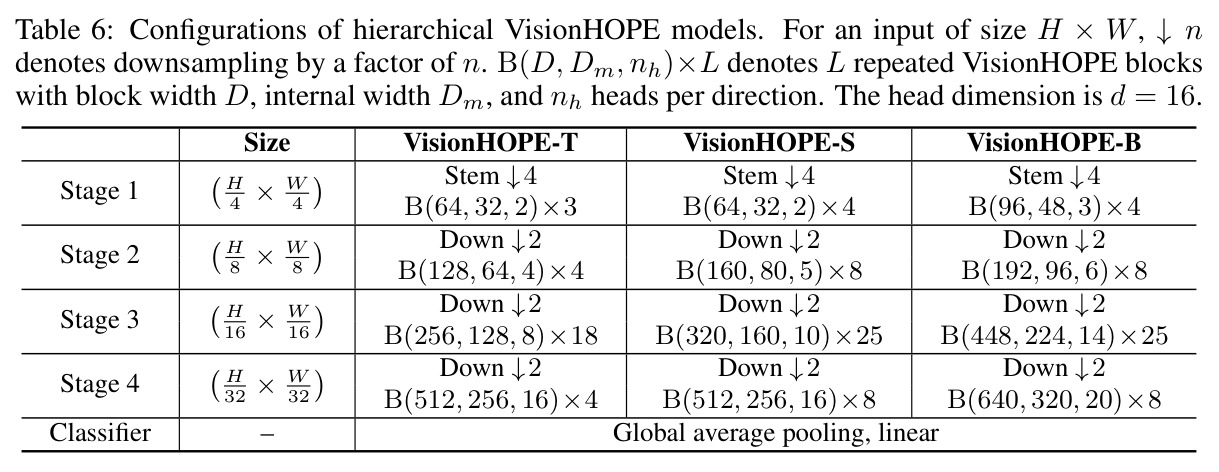
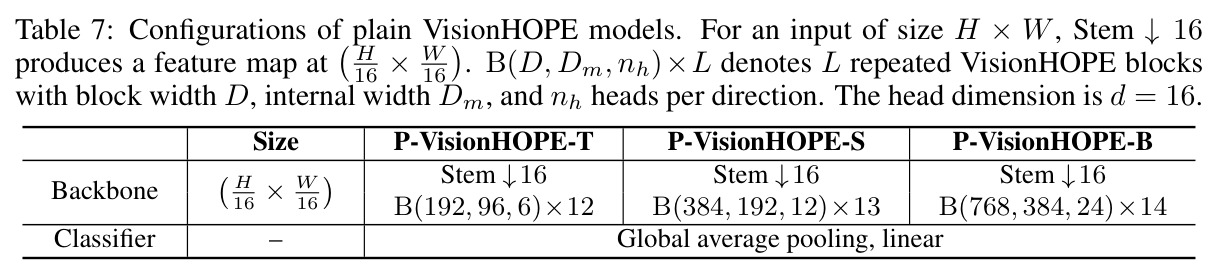
第一步,序列化:内部特征图 $Z\in\mathbb{R}^{B\times D_m\times H\times W}$ 经 $P_r$ 沿 →、←、↓、↑ 四向展开为 $Z^r\in\mathbb{R}^{B\times N\times D_m}$;行主序路由 chunk 长度为 $W$、列主序为 $H$(层级模型四阶段为 56/28/14/7,plain 模型为 14),每方向独立的五记忆状态由可学习初值初始化。第二步,chunk 内并行生成:边界状态 $M^k,M^v,m^\eta,m^\alpha$ 对 chunk 内所有 token 并行算出 $k_t,v_t$,以及 $\eta_t=\gamma_\eta\,\mathrm{softplus}(s_t^\eta)$($\gamma_\eta=0.025$)和 $\alpha_t=\sigma(s_t^\alpha+\mathrm{logit}(\alpha_{init}))$($\alpha_{init}=0.9$),键做稳定 L2 归一化。第三步,步长控制:由 $\delta_t=k_t-v_t$ 得 $r_t=\sqrt{\|\delta_t\|^2+\epsilon^2}+\epsilon$ 与注入上限 $\eta_t^{inj}=(1-\alpha_t)/r_t$,软帽得 $\bar\eta_t$;再取谱限 $\eta_t^{spec}=2\alpha_t/\|k_t\|_2^2$,执行步 $\tilde\eta_t=\min(\bar\eta_t,\eta_t^{spec})$。第四步,SR-DGD 更新:每记忆计算学习信号 $g_t^\square=M_{t-1}^\square k_t-\hat v_t^\square$,按 $M_t^\square=M_{t-1}^\square(\alpha_t I-\tilde\eta_t k_t k_t^\top)-\tilde\eta_t g_t^\square k_t^\top$ 更新,chunk 末状态成为下一 chunk 的边界。第五步,读出融合:查询 $q_t=W_q x_t$ 读内容记忆得 $y_t=M_{t-1}^m q_t$,四向输出经 $P_r^{-1}$ 恢复到网格后按 $Y=\sum_r \lambda_r\odot P_r^{-1}(Y^r)$ 融合。第六步,块结构:双 pre-norm 残差分支,第一支 Projin→门控 DW 卷积→VisionHOPE 算子→Projout,第二支 FFN;头维 $d=16$、内部宽度 $D_m=D/2$,层级模型配 MESA 训练。
技术新颖性
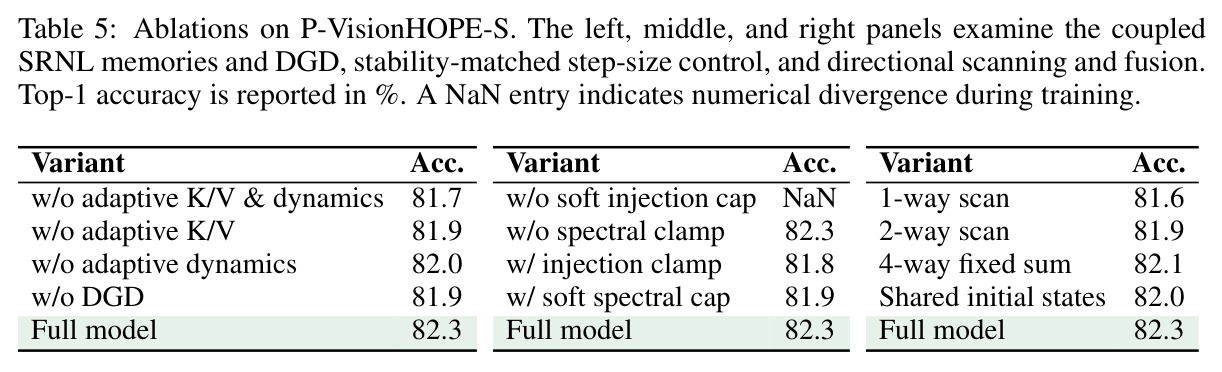
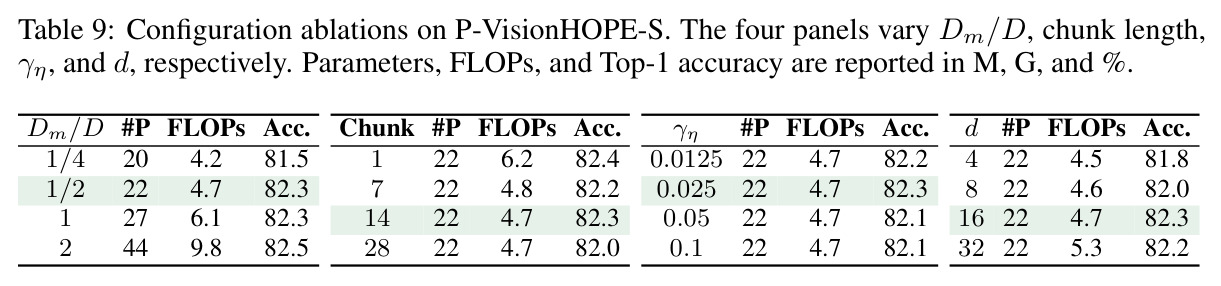
概念上,这是第一个被形式化为自修改学习系统的通用视觉主干,把 fast weights、learned optimizer、自参考权重矩阵(Irie et al. 2022)与 NL 等线索统一到视觉领域,将图内适应范围从内容推进到学习规则本身。理论上,它给出自参考循环记忆的首个视觉稳定性证明:互补算子界 $\|A_t\|_2\le\alpha_t$、$\|B_t\|_2<1-\alpha_t$ 经三角不等式得逐 token 非扩张,再借共享右乘增益表示 $M_t^\square=M_b^\square G_t$、$G_t=G_{t-1}A_t+B_t$ 把结论推广到 chunk 级(Theorem 1),且证明是构造性的、含有限精度保护($1-10^{-3}$、$1-10^{-6}$ 内缩因子)。设计上软帽与硬钳各司其职:软帽一阶保真小步长、保留学习率记忆的梯度式调制(换硬钳后 49.68% 更新被截断、精度掉到 81.8),谱钳实测仅 0.0044% 更新激活、纯作理论兜底(去掉精度不变)。工程上行/列对齐 chunk 与四向扫描结合,$C=14$ 相比 $C=1$ 推理加速 2.86 倍且精度相当。
实验结果
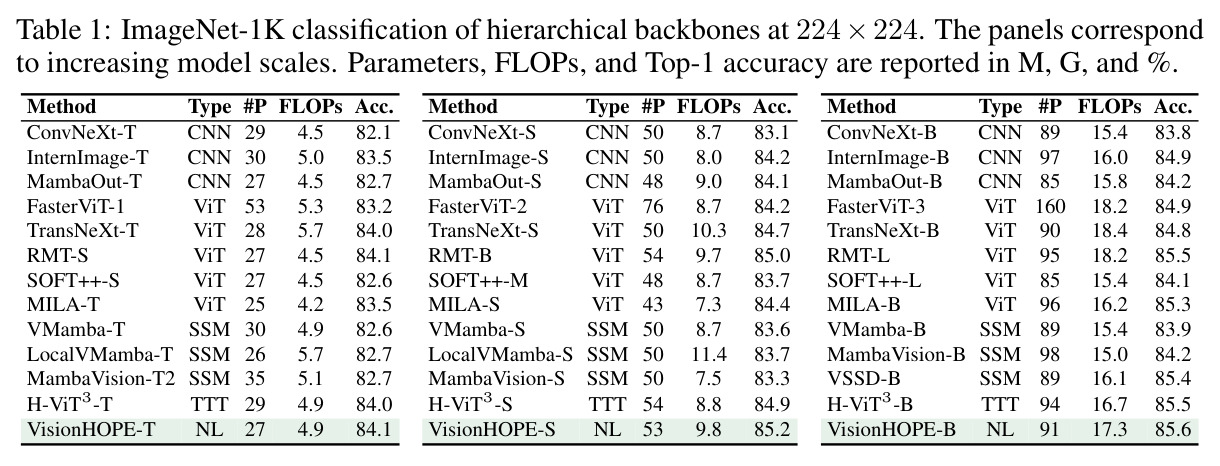
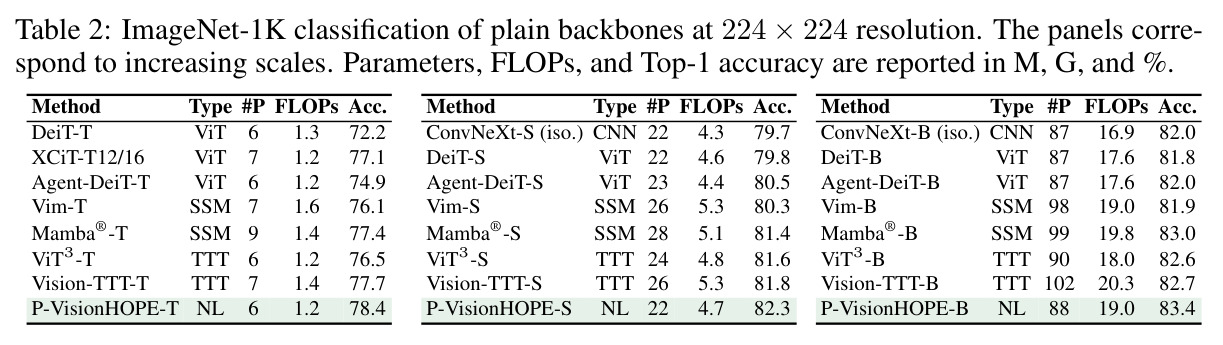
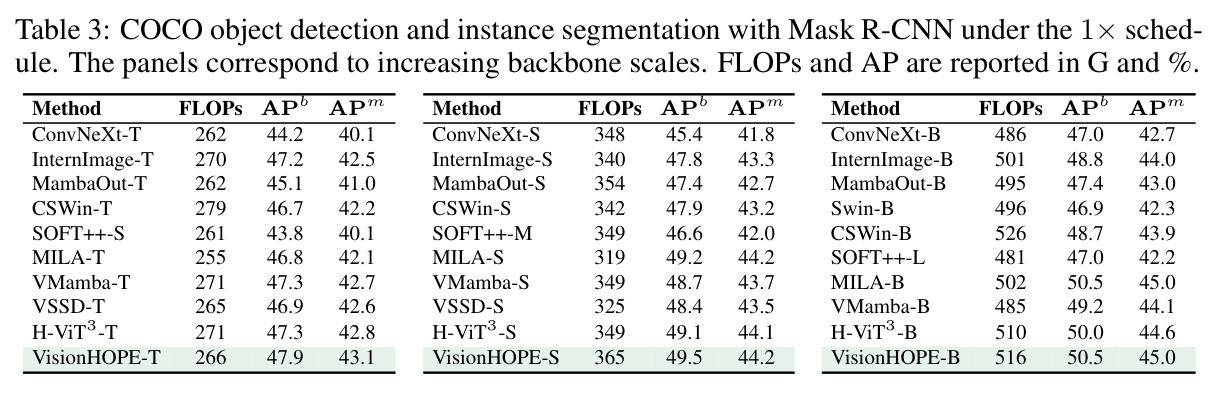
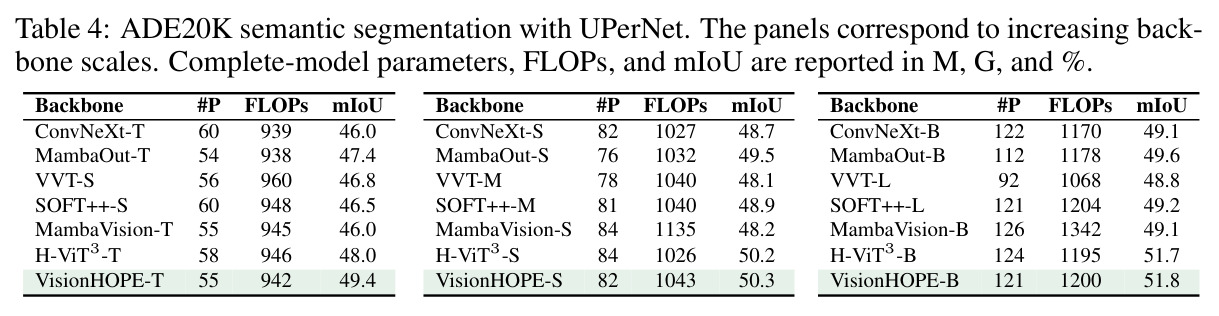
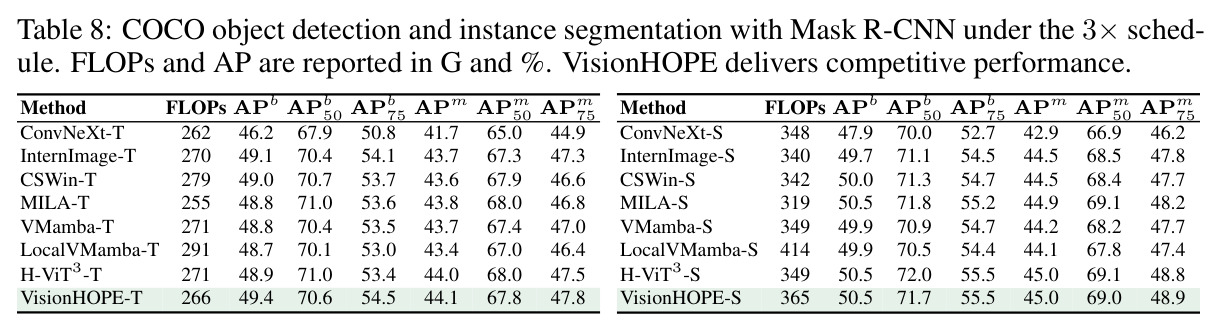
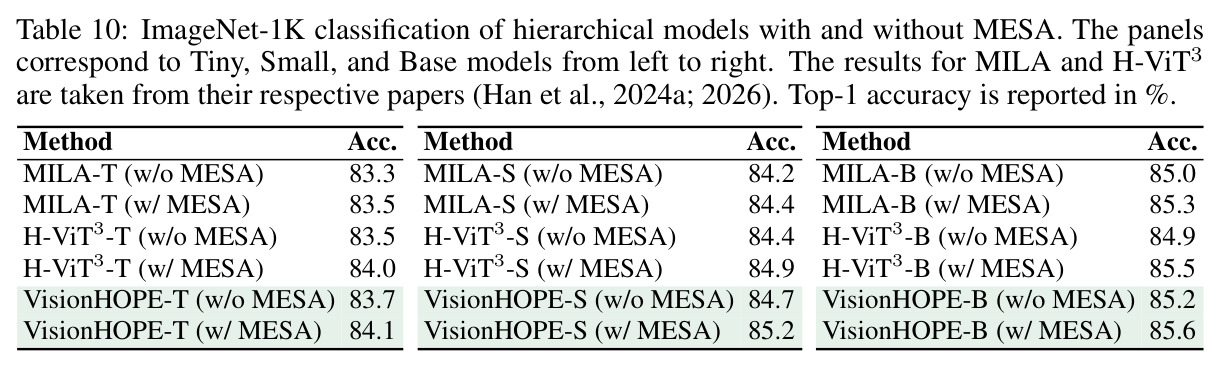
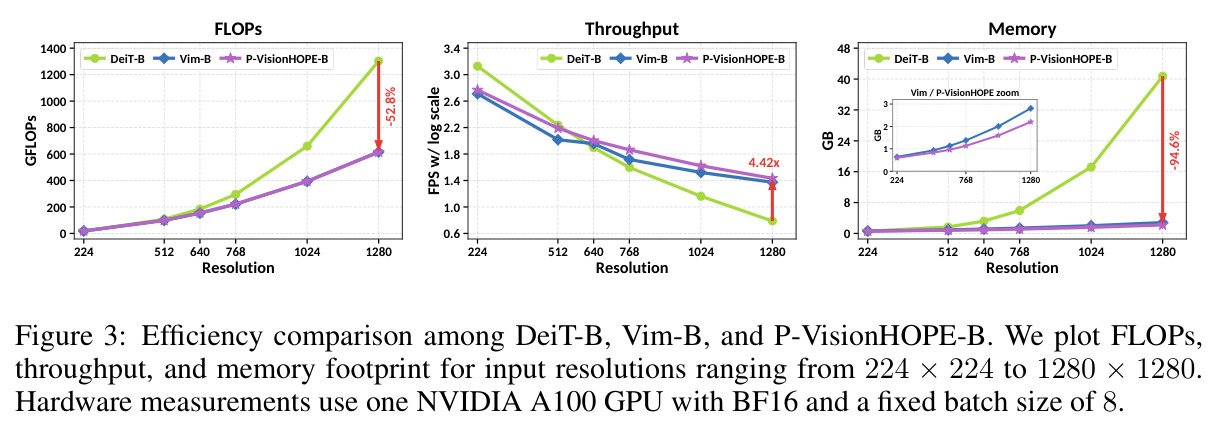
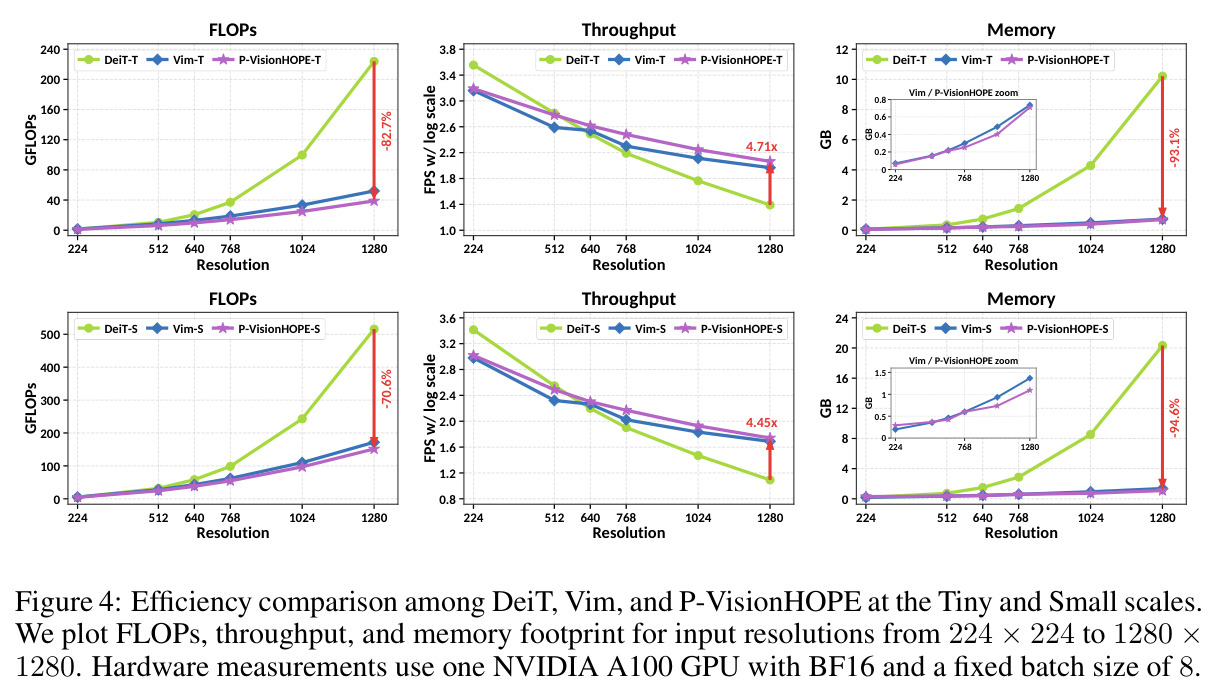
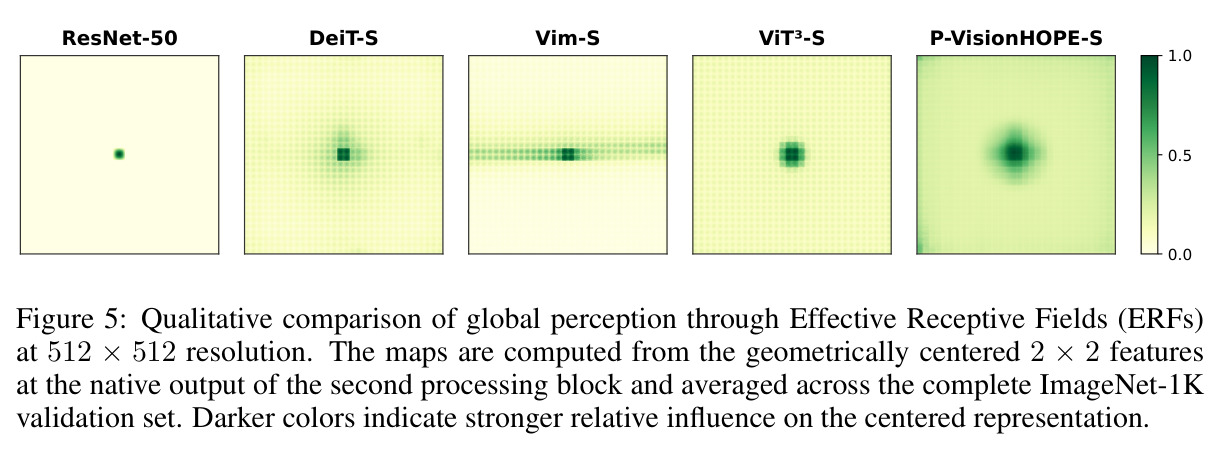
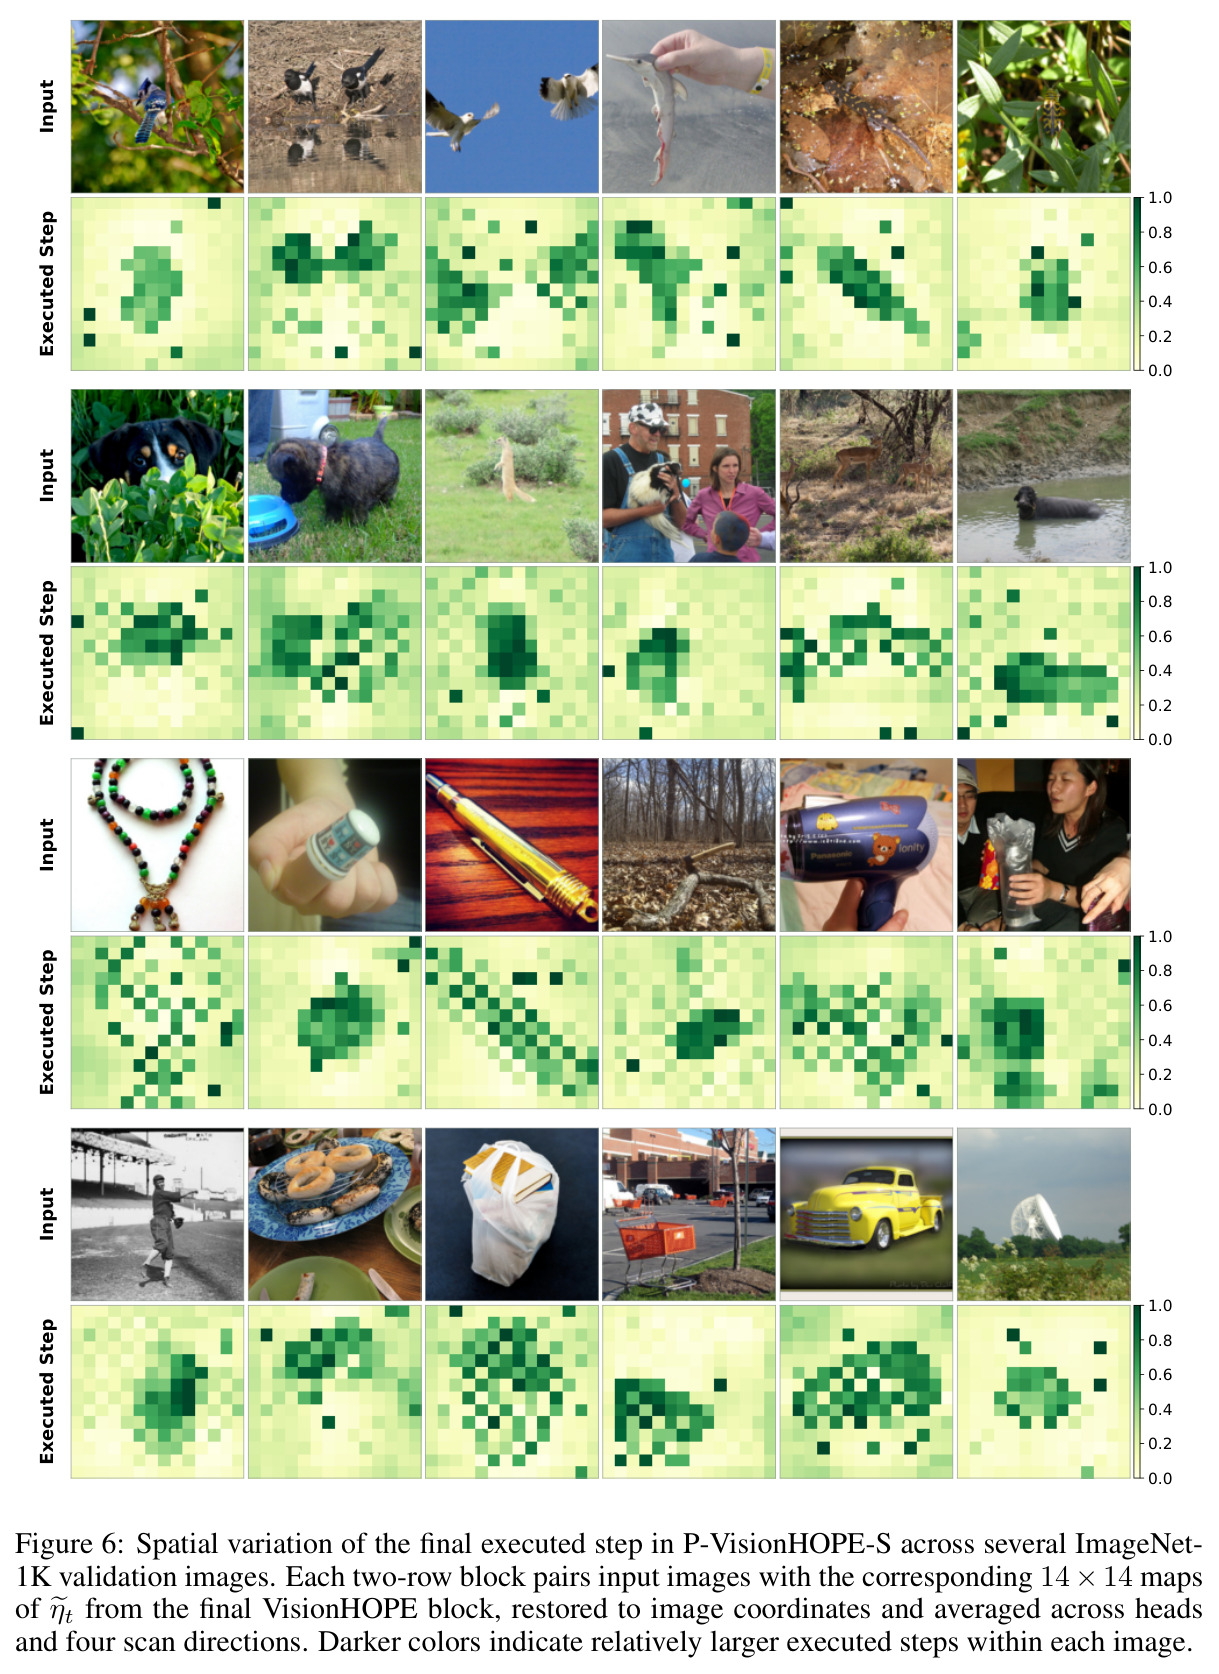
ImageNet-1K(从零训练 300 epoch,224² 单 crop Top-1):层级式 VisionHOPE-T/S/B 以 27M/53M/91M 参数、4.9G/9.8G/17.3G FLOPs 取得 84.1/85.2/85.6,在三个规模面板均为最优或并列最优,超过 TTT 系 H-ViT3-T/S/B(84.0/84.9/85.5)、RMT-L 85.5、InternImage-B 84.9、TransNeXt-B 84.8;plain 式 P-VisionHOPE-T/S/B 取 78.4/82.3/83.4,全面领先 ViT3(76.5/81.6/82.6)与 Vision-TTT(77.7/81.8/82.7)。COCO(Mask R-CNN 1×,1280×800):box/mask AP 为 T 47.9/43.1、S 49.5/44.2、B 50.5/45.0,三个规模均最优或并列最优;3× schedule 下 T 49.4/44.1、S 50.5/45.0 仍具竞争力。ADE20K(UPerNet,512×2048):mIoU 为 T 49.4、S 50.3、B 51.8 全部第一,Tiny 相对 H-ViT3-T 的 48.0 提升 1.4。效率:层交互成本 $4ND^2+232ND+1600D\sqrt N$、激活内存 $O(BND)$ 均随 token 数线性;A100/BF16/batch 8 实测,1280² 下 P-VisionHOPE-B 相对 DeiT-B 内存省 94.6%、相对 Vim-B 吞吐高 4.42×、内存省 52.8%。消融(P-VisionHOPE-S,82.3 为基准):去掉软注入帽训练早期 NaN 发散;去掉谱钳精度不变(激活率仅 0.0044%);换硬注入钳 81.8、软谱帽 81.9;去自适应 K/V 与动力学降到 81.7;单向 81.6 < 双向 81.9 < 四向定和 82.1 < 完整 82.3;chunk 从 $C=14$ 改 $C=1$ 得 82.4 但推理慢 2.86×。MESA 消融显示无 MESA 时层级模型 83.7/84.7/85.2 仍全面高于 MILA 与 H-ViT3 同设置结果。ERF 可视化显示 P-VisionHOPE-S 全局感知优于 ResNet-50、DeiT-S、Vim-S、ViT3-S;末块执行步长 $\tilde\eta_t$ 呈与显著物体对齐的结构化内容依赖模式。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-1K 图像分类(层级式 Base 级) | Top-1 准确率 (%) | 85.6(91M 参数,17.3G FLOPs) | H-ViT3-B 85.5;RMT-L 85.5 | +0.1(面板内最优) |
| ImageNet-1K 图像分类(层级式 Small 级) | Top-1 (%) | 85.2(53M,9.8G) | RMT-B 85.0;H-ViT3-S 84.9 | +0.2 |
| ImageNet-1K 图像分类(plain Tiny/Small/Base) | Top-1 (%) | 78.4 / 82.3 / 83.4 | Vision-TTT 77.7 / 81.8 / 82.7;ViT3 76.5 / 81.6 / 82.6 | +0.7 / +0.5 / +0.8(相对 Vision-TTT) |
| COCO 目标检测(Mask R-CNN 1×,Base 级) | box AP (%) | 50.5(516G FLOPs) | MILA-B 50.5;H-ViT3-B 50.0 | 并列最优 / +0.5 |
| COCO 实例分割(Mask R-CNN 1×,Base 级) | mask AP (%) | 45.0 | MILA-B 45.0;H-ViT3-B 44.6 | 并列最优 / +0.4 |
| ADE20K 语义分割(UPerNet,Tiny 级) | mIoU (%) | 49.4(55M,942G) | H-ViT3-T 48.0;MambaOut-T 47.4 | +1.4 |
| ADE20K 语义分割(UPerNet,Base 级) | mIoU (%) | 51.8(121M,1200G) | H-ViT3-B 51.7;MambaOut-B 49.6 | +0.1 |
| 高分辨率推理 1280×1280(Base 级) | 激活内存 | P-VisionHOPE-B(线性增长) | DeiT-B($O(N^2)$ 增长) | -94.6% |
| 高分辨率推理 1280×1280(Base 级) | 吞吐量(FPS,A100 BF16) | P-VisionHOPE-B | Vim-B | 4.42× |
| 分块长度消融(P-VisionHOPE-S 推理) | 加速比(保持精度相当) | C=14 相对 C=1 | 全 token 索引 C=1 | 2.86× |
局限与改进
作者承认的局限:评估仅覆盖通用视觉识别,尚未作为 MLLM 的视觉编码器检验多模态理解,也未验证医学影像、遥感等专用领域;只采用 NL 的自参考组件而未纳入 CMS 多时间尺度记忆,因为判别视觉缺少规范的图内在线学习目标,纳入 CMS 需要额外设计目标函数。我自己的观察:其一,绝对增益普遍只有 0.1–0.5 量级(ImageNet Base 级 85.6 vs H-ViT3-B 85.5 仅 +0.1;唯一大幅领先是 ADE20K Tiny 的 +1.4),自修改带来的收益相对其机制复杂度偏温和,且层级 Base 在 COCO 上与 MILA 完全打平;其二,谱钳在 99.99% 以上更新中从不激活(推理 0.0044%、训练前 10 epoch 0.0011%),实际稳定几乎全靠软注入帽,理论保证与实际行为之间联系松散,证明更像事后合理化;其三,四向扫描意味着四份串行记忆状态,序列化破坏二维平移等变性,作者自己的 ERF 显示同类方法 Vim-S 有强方向性伪影,VisionHOPE 靠四向融合缓解但未根除;其四,学习信号完全来自自生成目标 $\hat v_t^\square=M_{t-1}^\square v_t$,语义意义依赖外层监督间接塑造,缺少可解释的图内目标;其五,高分辨率只测了推理效率,未报告高分辨率微调后的精度。
独立分析的弱点
第一,方向性扫描的各向异性:单方向记忆会沿扫描轴形成偏置(Vim 的 ERF 呈强方向性模式即为例证),VisionHOPE 用四向加通道融合缓解,但四条独立 SRNL 实例使状态量与延迟近似翻两番。改进方向:探索非因果或二阶动态扫描在自参考框架下的等价物,用更少方向覆盖二维依赖。第二,chunk 边界陈旧性:chunk 内固定边界状态生成 $k_t,v_t,\eta_t,\alpha_t$,长 chunk 滞后于图内演化——消融中 $C$ 从 14 增到 28 掉至 82.0,$C=1$ 反而 82.4 但慢 2.86×。改进:自适应 chunk 长度或细粒度生成、粗粒度刷新边界的层级 chunk。第三,稳定性界保守:证明走三角不等式 $\|T_t\|_2\le\|A_t\|_2+\|B_t\|_2$,实际 $\|A_t+B_t\|_2$ 可能远小于 1,逐 token 都被过度约束,可能压制有效学习率。改进:让网络学习保留与注入间的余量分配函数,或直接对 $T_t$ 做联合谱约束。第四,记忆容量受限:每头记忆是 $16\times16$ 线性矩阵,表达力有限(原版 NL 用 MLP 记忆但无闭式 L2 递推);消融显示 $d$ 从 16 增到 32 参数涨到 27M 而精度反降至 82.2,说明单纯加宽无效。改进:为非线性记忆设计带稳定性证书的隐式更新。第五,训练技巧依赖:层级模型依赖 MESA(epoch 75 起、EMA 衰减 0.9998、软损失权重 1.0/1.5/1.5)而 plain 模型不用,削弱了跨配置对比的干净程度,应报告统一无增广训练下的对比。
未来方向
作者明确提出的方向:把 VisionHOPE 作为 MLLM 的视觉编码器,检验自修改记忆在多模态理解中的价值;扩展到医学影像、遥感等领域专用任务。基于成果可自然延伸的方向:其一,与 NL 的 CMS 结合,为判别视觉设计图内自监督在线目标(如图像块遮挡重建、扫内对比学习),实现多时间尺度记忆,逼近完整 HOPE 在视觉的对应物;其二,扩展到视频,把时间轴作为第五扫描方向或让记忆跨帧保留,检验自修改机制在长时序中的记忆保持优势——这正是保留因子 $\alpha_t$ 设计的用武之地;其三,把稳定性理论推广到非线性记忆与记忆-注意力混合架构,给出更紧、更少保守的界;其四,系统级 scaling 实验:在 1B 级参数与更高分辨率预训练下检验自修改收益是否随规模增长,回答它是否具有 ViT 式的扩展曲线;其五,利用执行步长图(Figure 6)与物体对齐的现象,把 $\tilde\eta_t$ 空间图发展为免费的显著性/定位输出,或用于弱监督定位任务。
复现评估
复现条件较好。代码开源(摘要给出链接);三个基准全部公开(ImageNet-1K、COCO、ADE20K);附录提供完整配置:层级/plain 模型的逐 stage 宽度、深度、头数(Table 6/7),训练协议(AdamW、300 epoch、lr $10^{-3}$、全局 batch 1024、20 epoch warmup、随机深度率、层级模型的 MESA 细节),以及初始化与数值细节(截断正态 0.01、$m^{\eta_0}=m^{\alpha_0}=0$、$\gamma_\eta=0.025$、$\alpha_{init}=0.9$、$\epsilon=10^{-6}$、谱钳分母下界 $10^{-20}$、有限精度内缩因子 $1-10^{-3}$ 与 $1-10^{-6}$)。效率测量注明单张 A100、BF16、固定 batch 8,Tiny/Small/Base 三档齐备。理论部分(附录 B.1–B.4)推导完整可逐行验证。难点在工程:四向扫描 × 多头 × 五记忆的分块递推需要高效 CUDA/Triton 算子,纯 PyTorch 逐步循环会极慢;ImageNet 300 epoch 从零训练需多卡(估计 8×A100 数天),检测/分割迁移还需额外微调预算。总体复现难度:中高,代码到位后可复现主要结论,但从零训练成本不小。
论文图表
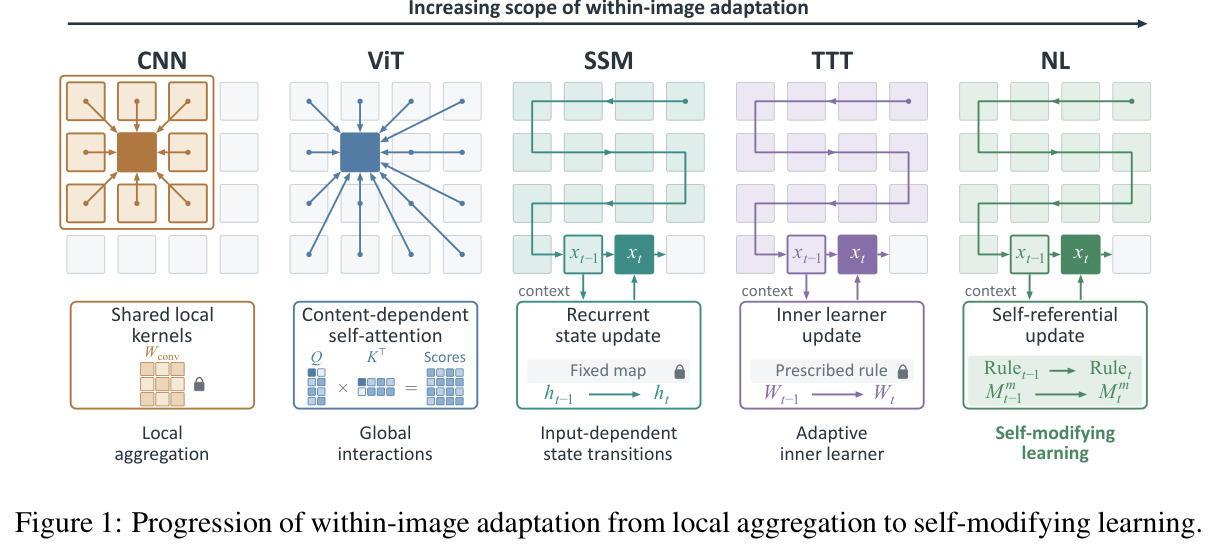
沿 CNN→ViT→SSM→TTT→NL 的谱系展示图内适应范围的扩大:CNN 共享局部卷积核 $W_{conv}$(局部聚合)、ViT 内容相关自注意力 $QK^\top$(全局交互)、SSM 输入依赖的循环状态转移(自适应状态)、TTT 内部学习者 $W_{t-1}\to W_t$(自适应内学习器)、NL 自参考更新 $Rule_{t-1}\to Rule_t$(自修改学习)。
一图定调:它把本文定位在主干演化的最前沿一档——不仅算什么自适应,连怎么算的规则也随图像演化,是理解动机与对比框架的钥匙。