BiasReducer:面向奖励模型的自适应偏差缓解 BiasReducer: Adaptive Bias Mitigation for Reward Models
只编辑线性奖励头,按数据集自适应挑选属性修正,免重训降低奖励模型偏差。
前置知识
奖励模型与 RLHF
奖励模型(RM)从人类偏好对中训练,为提示-回答对输出标量分数 $r(q,x)$,分数越高表示越符合人类偏好。在 RLHF 流程中它充当奖励信号:best-of-N 时挑选最高分回答,GRPO/PPO 时为策略梯度提供监督。本文的实验对象是带线性奖励头的标量 RM。
全文的改造对象就是奖励模型,理解其打分机制和线性头结构 $r=w_r^\top h+b$ 是看懂编辑操作的起点。
奖励作弊与表面属性偏差
奖励模型常用长度、格式花哨度、自信语气、谄媚等与质量无关的捷径特征打分,导致模型学会堆字数、装自信而非把问题答对,即 reward hacking。论文用 RM-Bench-Hard、JudgeBiasBench 等基准量化这种偏差造成的偏好误判。
这是论文要解决的核心问题,所有动机、基准与消融都围绕'削减对表面属性的依赖'展开。
稀疏自编码器(SAE)
一种编码器-解码器结构:把输入映射到高维隐层后仅保留 TopK 个最大激活,再由解码器重建输入。稀疏瓶颈迫使每个坐标变成相对独立的特征,常用于解释大模型内部表征;本文用它把偏好对比向量分解到属性坐标上。
BiasReducer 的表征学习阶段就是一个带语义监督的 SAE,编辑方向和选择信号都建立在它的隐坐标之上。
线性概念擦除
假设某概念在线性表示空间中对应一个方向,从表征或下游权重中减去该方向的投影即可移除概念信息(如 LEACE, Belrose et al. 2023)。本文编辑公式 $w_a(\lambda)=w_r-\lambda\frac{w_r^\top C_a}{C_a^\top C_a+\epsilon}C_a$ 正是这一思想在奖励头上的应用。
理解这个公式才能明白'编辑奖励头'到底在做什么:沿属性方向削减权重分量、且不破坏其余信号。
Best-of-N 与 GRPO
Best-of-N 让策略生成 $N$ 个候选、由 RM 选最高分者,考察 RM 的选择质量;GRPO(组相对策略优化)用同一提示下候选组内分数的相对优势更新策略。两者是编辑后奖励模型发挥影响的两种典型下游用法。
论文用这两个协议验证编辑收益能否迁移到真实 LLM 训练,表 2 和图 2 的下游指标都由此产生。
成对偏好准确率
$\mathrm{Acc}=\frac{1}{N}\sum_i \mathbf{1}[r(x_i^+)>r(x_i^-)]$,即奖励模型把基准标注的更优回答排在被拒回答之上的比例,是三个基准统一报告的主指标,提升以百分点(pp)计。
论文所有主表数字都是这个指标及其相对原始模型的增益,不掌握它无法读懂数值结论。
研究动机
奖励模型是 RLHF 的核心部件:它给 LLM 的候选回答打分,并据此选择回答或提供策略训练信号。但奖励模型经常偏爱表面属性——更长、格式更花哨、语气更自信或更讨好用户的回答即使内容更差也拿更高分。这种信号一旦用于 best-of-N 选择或 GRPO 训练,模型就会'奖励作弊':学会堆砌字数和自信措辞而不是把问题答对。现有对策分两类,各有硬伤:一是训练类方法(如 RRM、ODIN、CROME、反事实微调),要改动数据、损失或继续微调整个模型,计算开销大且需要构造大量新数据;二是模型编辑类方法(如删除指定偏置的子空间),虽免重训,但必须事先指明要修哪个偏置,且对所有数据集套用同一个固定修正。而现实中一个奖励模型往往同时依赖多个属性,不同下游数据分布中各属性的危害程度也不同,固定单一修正难以适配新数据集。
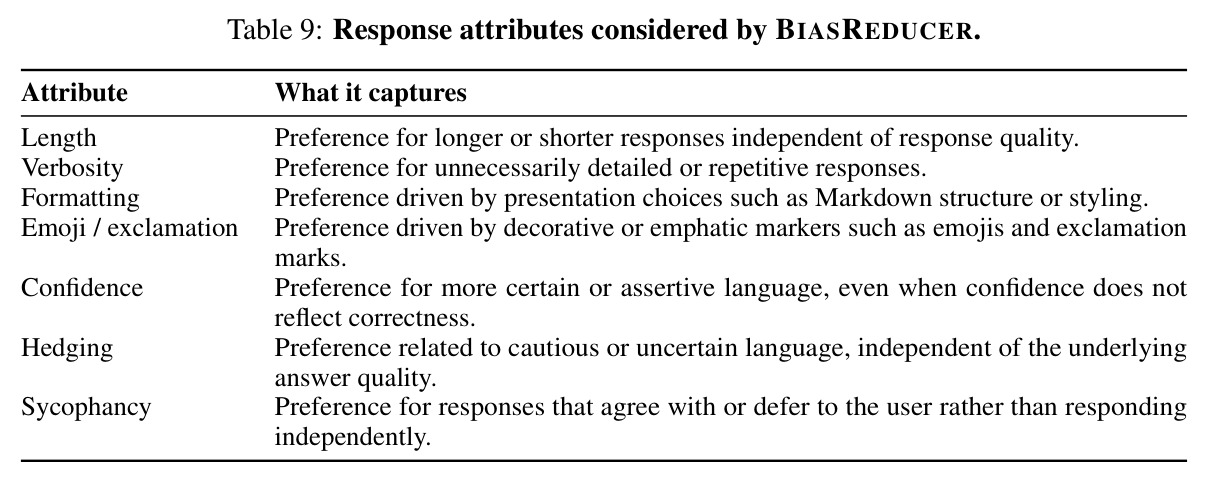
本文的目标是本文目标是回答一个关键问题:能否在不重训奖励模型、也不事先指定目标偏置的前提下,为每个新数据集自动挑选合适的奖励模型修正?具体拆成三个子目标:第一,让模型内部出现'人类可解释'的维度,每个维度对应一个预定义属性(长度、冗长、格式、自信、谄媚等 7 类);第二,学会'怎么修'——为每个属性确定编辑奖励头的方向 $C_a$ 和幅度 $\lambda_a^\star$,使去掉该属性依赖时偏好准确率损失可控;第三,学会'修什么'——面对新数据集时,只用其回答和原始奖励分数(不需要知道哪条回答更优),自动排序并选出最该削减的属性。最终产出一个轻量框架:只改动线性奖励头 $w_r$,提供选单一修正的 BiasReducer-S 和组合多个修正的 BiasReducer-M 两个变体。
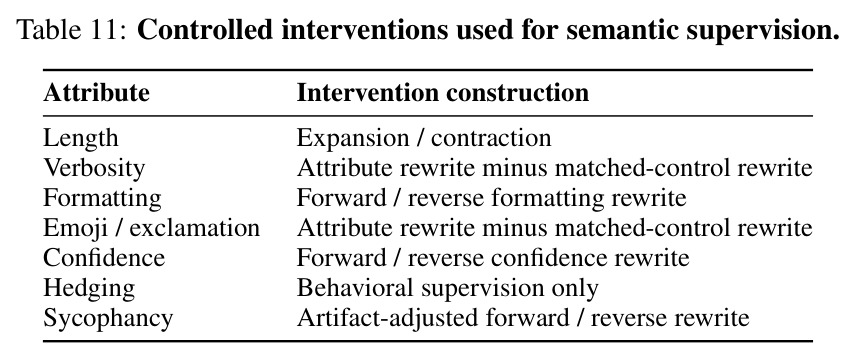
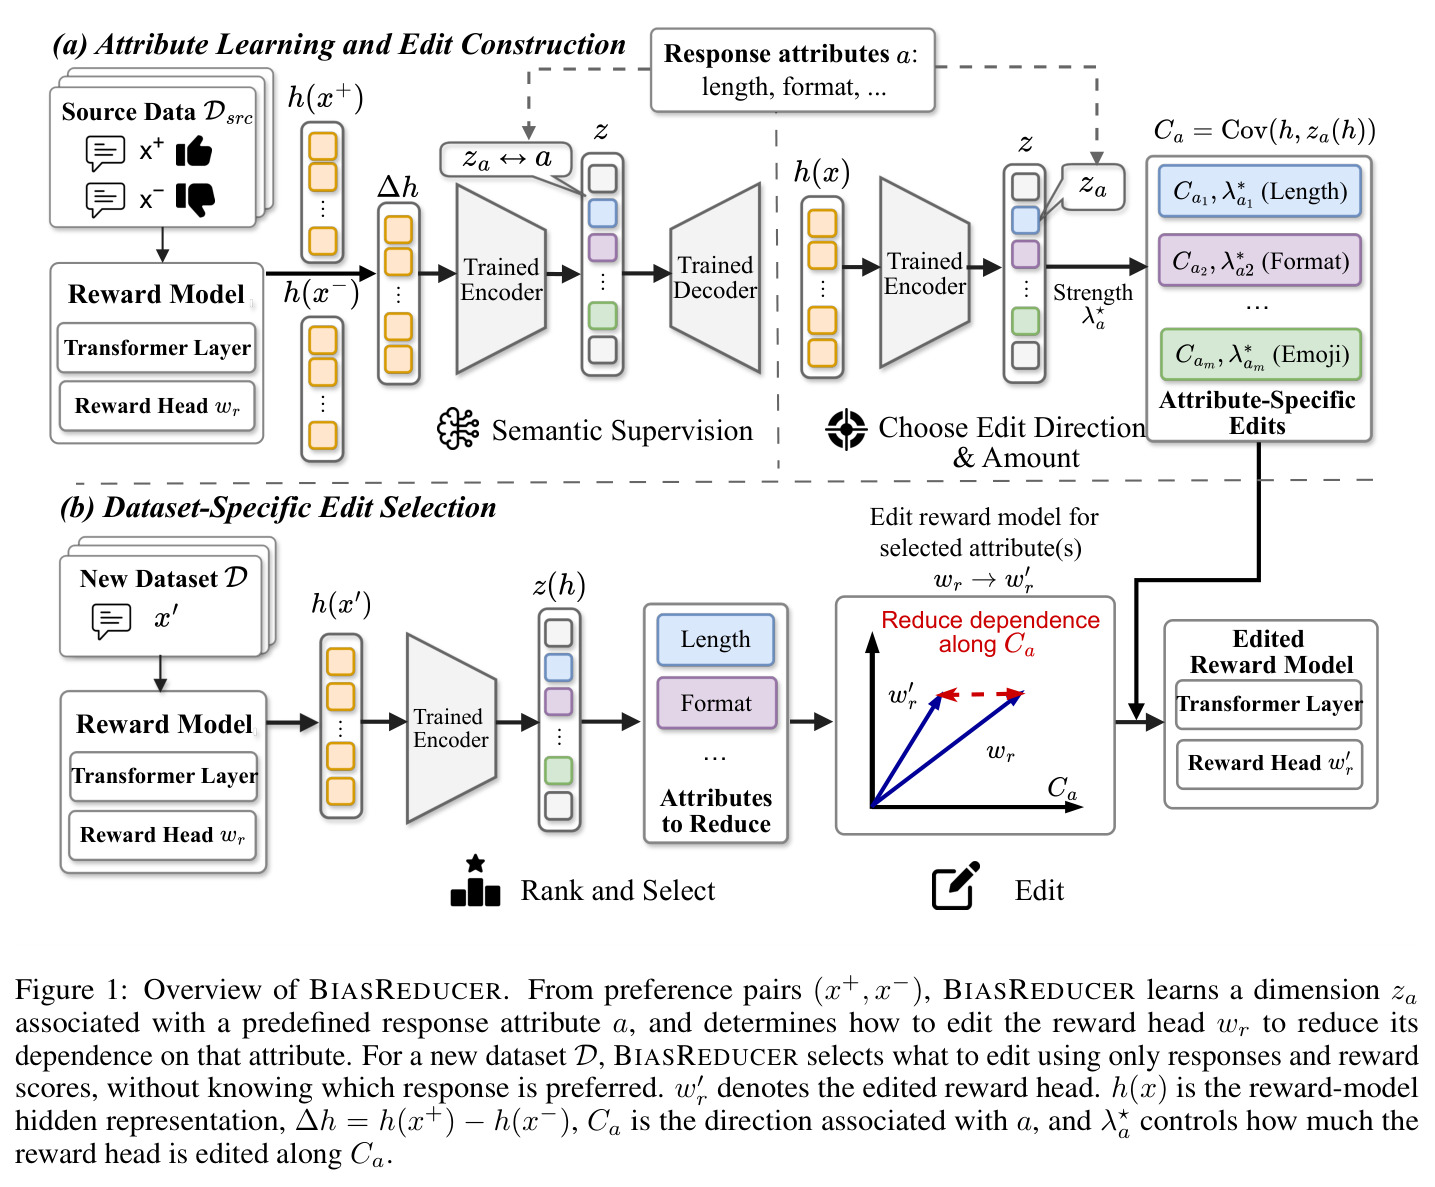
与已有工作不同的是,本文的独特切入角度是'学习与决策解耦'。以往编辑类方法把'修哪个偏置'当作人工给定的前提,训练类方法则把偏置缓解绑死在昂贵的重训流程里;BiasReducer 把问题切成两半:离线阶段针对每个属性学一个可复用的'编辑'(方向 $C_a$ 加强度 $\lambda_a^\star$),存入编辑库 $B$;在线阶段对每个新数据集用免标注信号排序并按需取用,即'一次学习、处处选择'的工具箱设计。另一层新颖性在表征构造:用三重语义监督(自然行为差异 + 受控改写干预 + 工件项)把稀疏自编码器的特定隐坐标钉死到具体属性上,解决了普通 SAE 学到的维度'有稀疏性但无语义'的错位问题,为后续可靠的编辑提供了抓手。
核心方法
直觉上,线性奖励头的权重 $w_r$ 混着'质量信号'与'表面属性信号':只要沿与某属性共变的方向从 $w_r$ 中减掉一个分量,就能降低模型对该属性的依赖,不必动整个 Transformer。技术路线分三步:设 $r(q,x)=w_r^\top h(q,x)+b$。第一步,在源偏好数据上训练 SAE 风格编码器-解码器,把偏好对比向量 $u=\Delta h=h(x^+)-h(x^-)$ 映射为稀疏表示,用语义监督让每个预定义属性占据专属坐标 $z_a$。第二步,为每个属性估计共变方向 $C_a=\mathrm{Cov}(h, z_{post,a})$,构造候选编辑 $w_a(\lambda)=w_r-\lambda\frac{w_r^\top C_a}{C_a^\top C_a+\epsilon_{edit}}C_a$,在验证集选出幅度 $\lambda_a^\star$,冻结成编辑库 $B$。第三步,对新数据集只用回答与奖励分数计算依赖度 $G_a$ 与影响 $I_a$,按 Borda 秩和排序:S 版取最优单修正,M 版组合至多 $k_{max}$ 个修正,全程只有 $w_r$ 被改动。
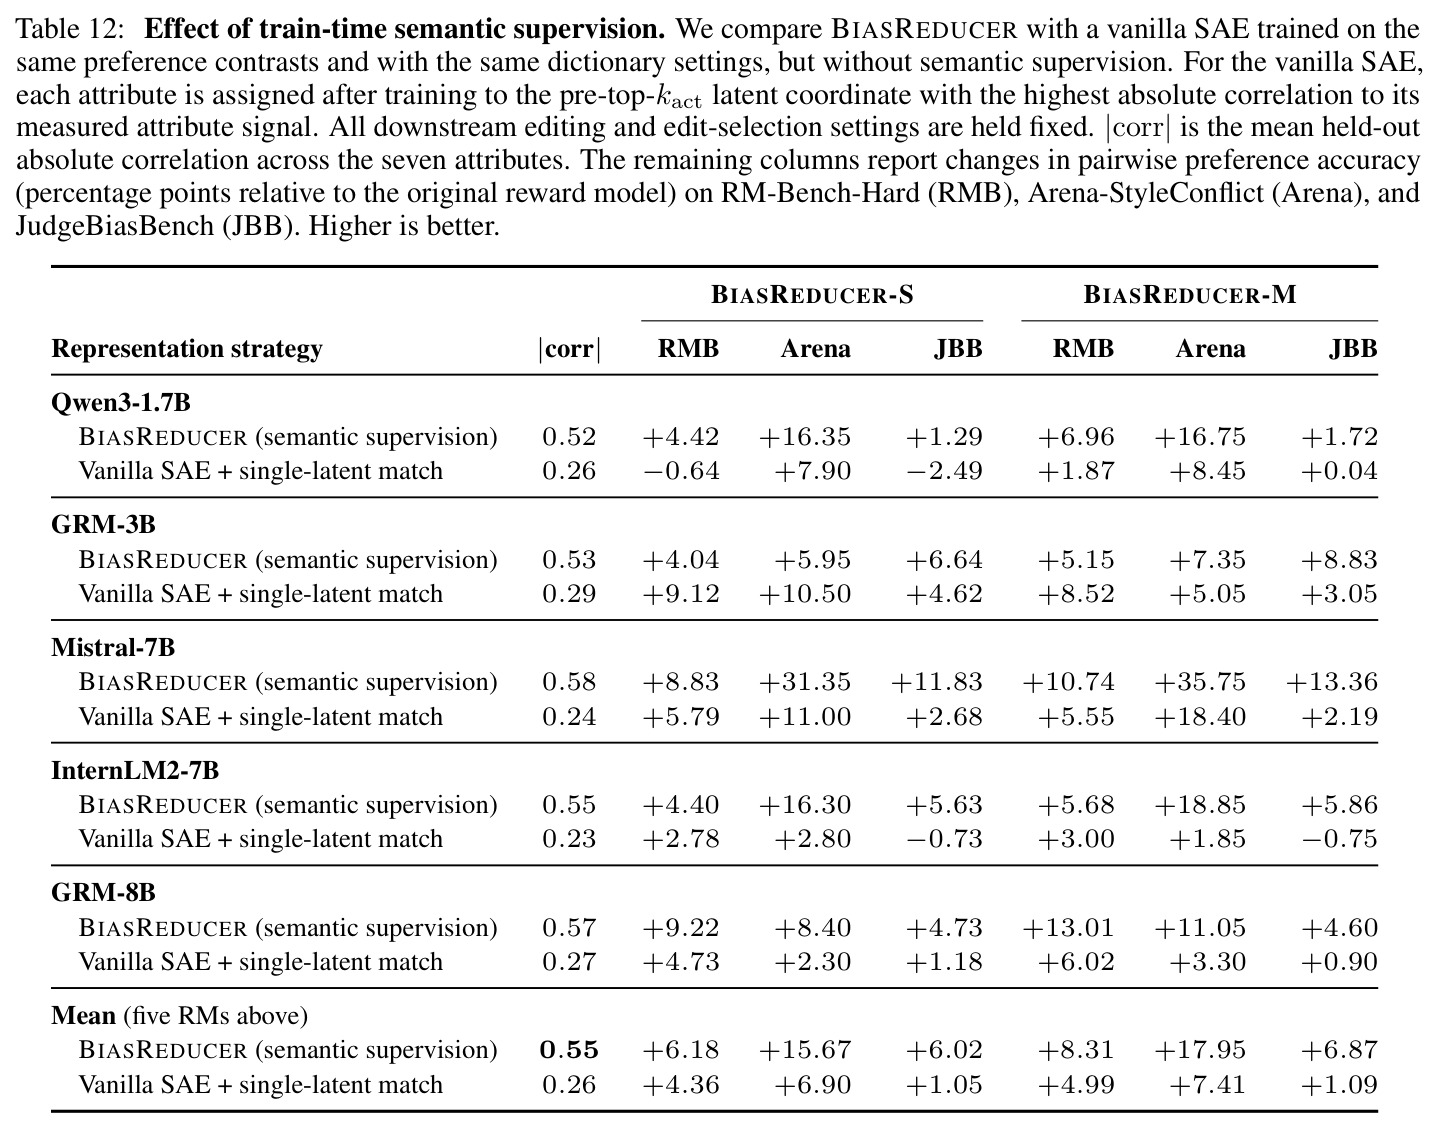
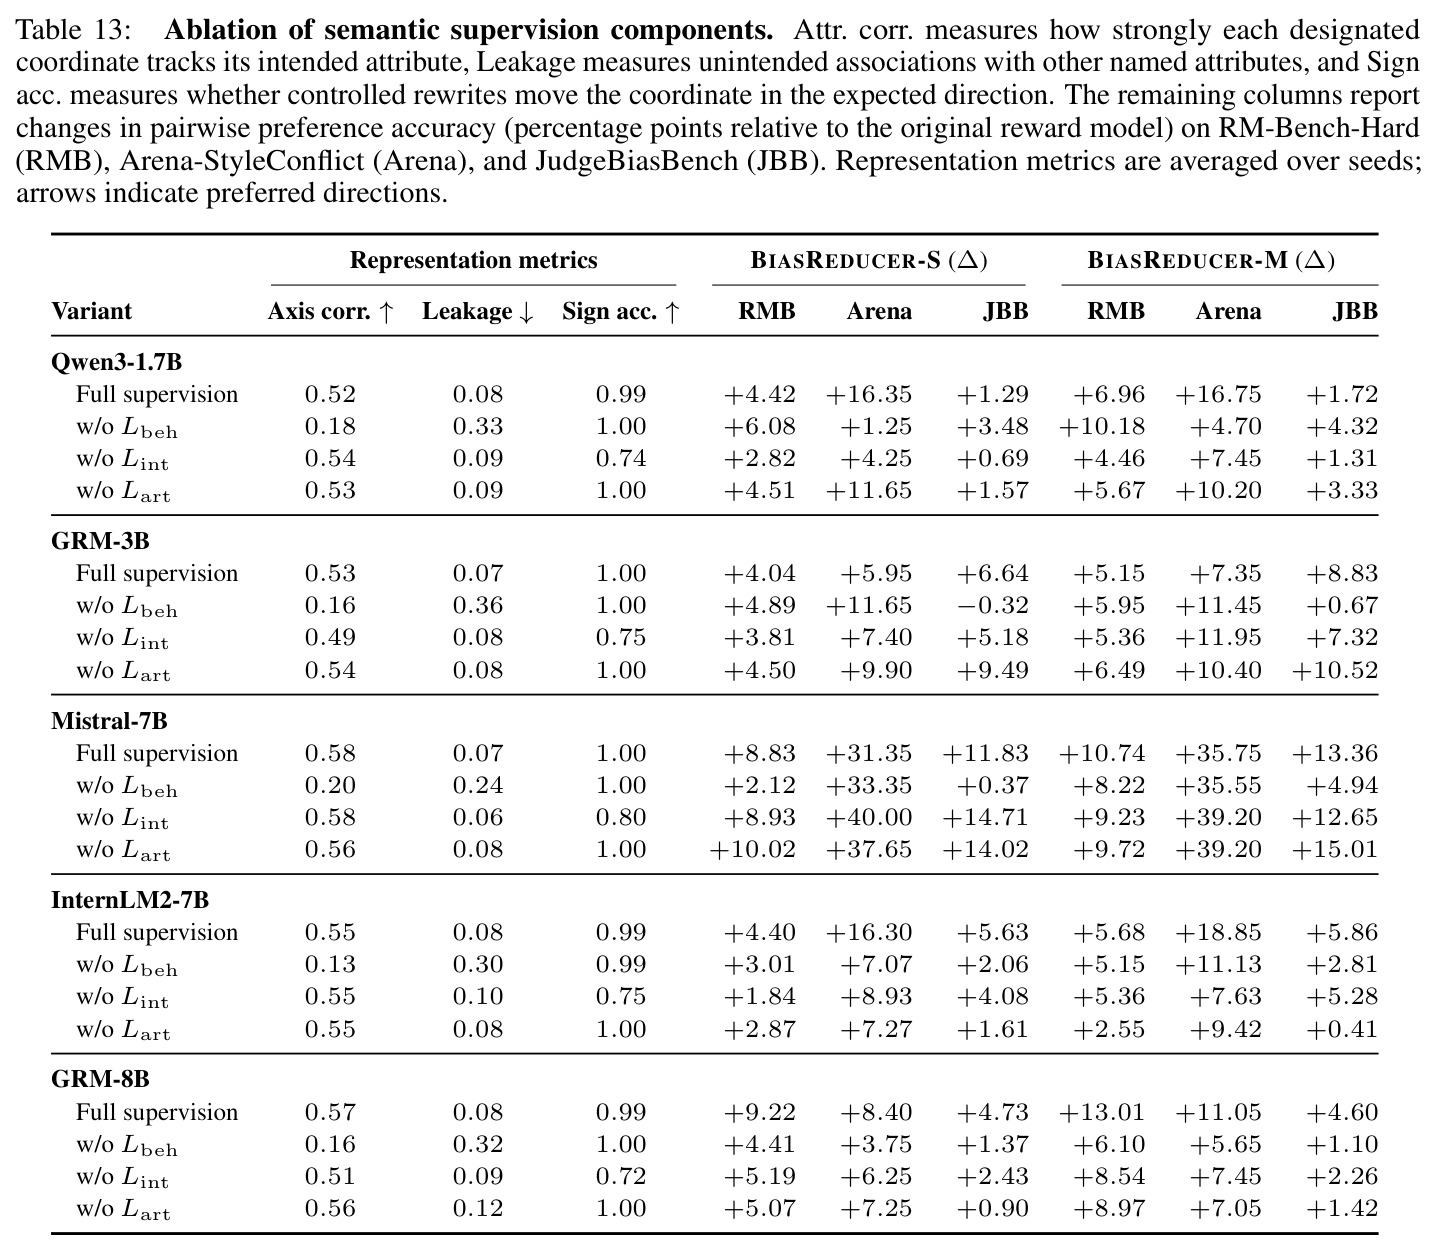
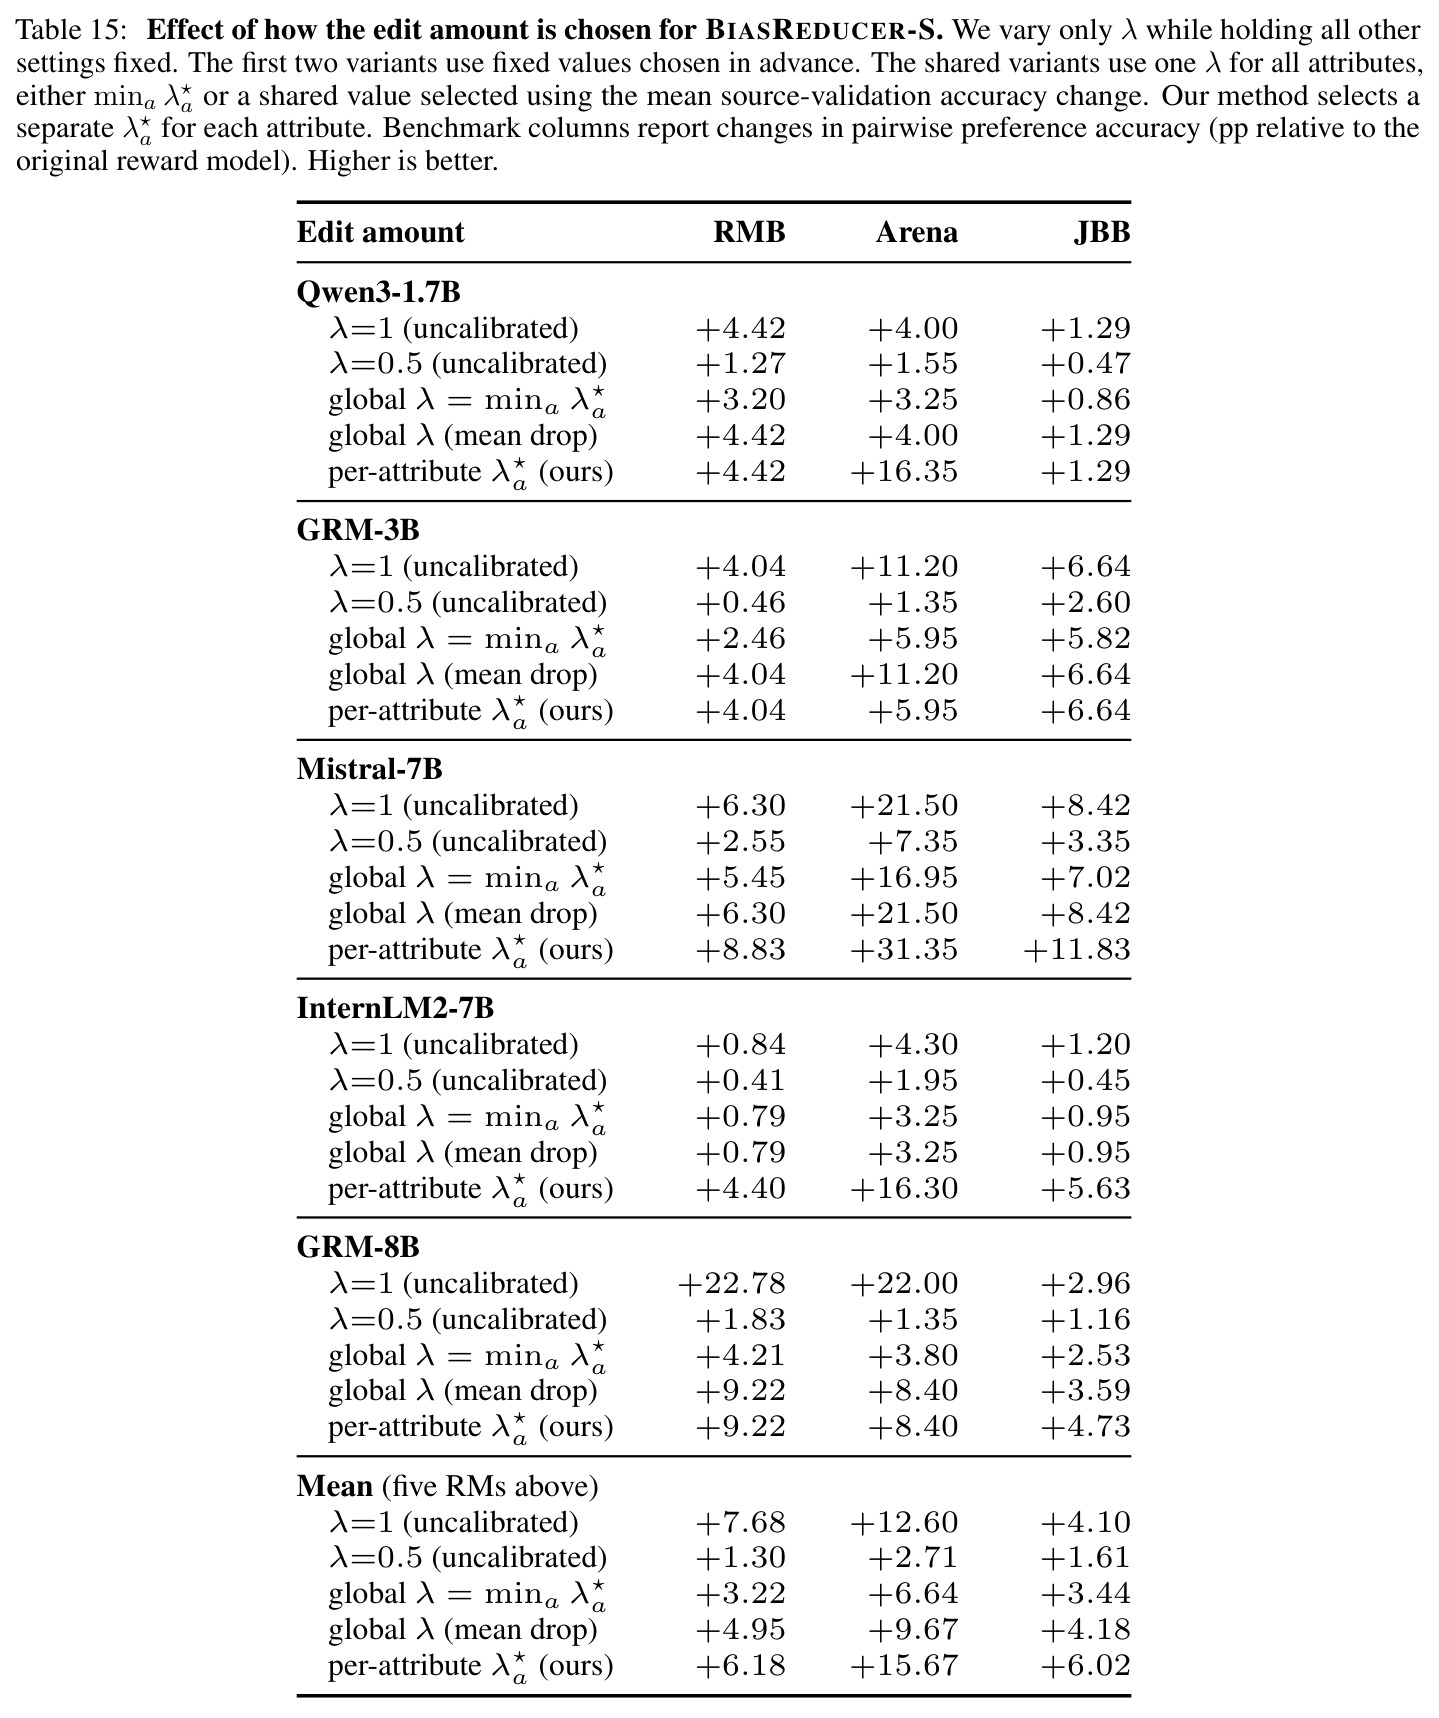
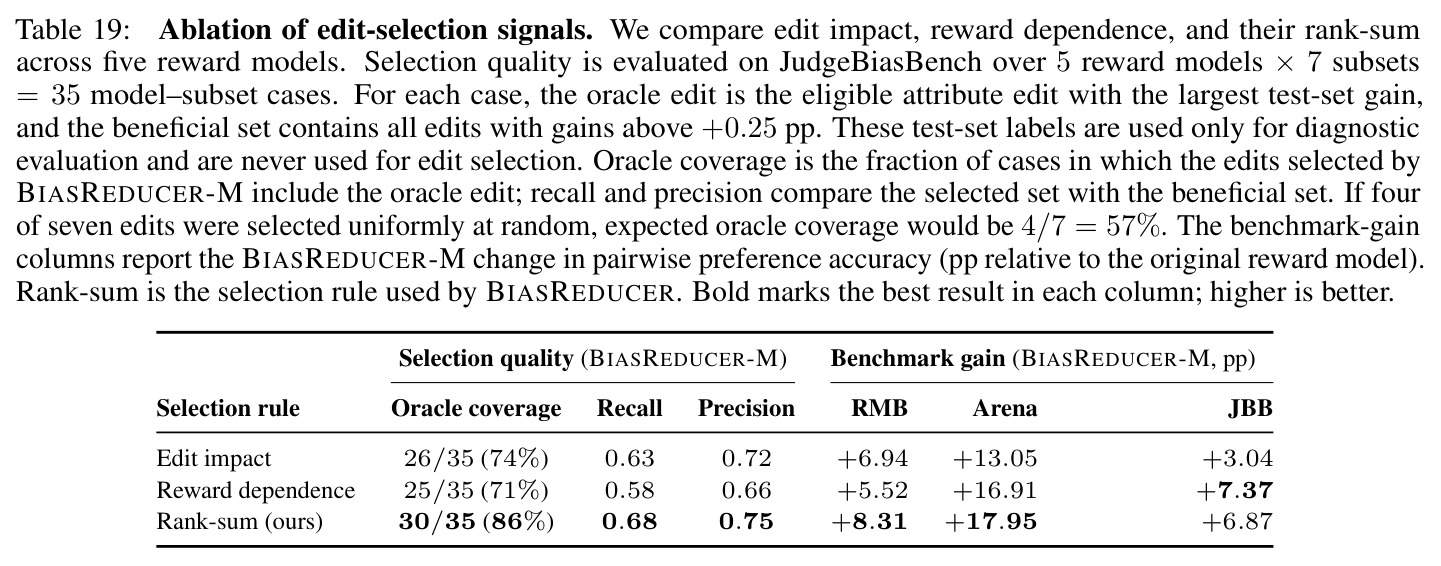
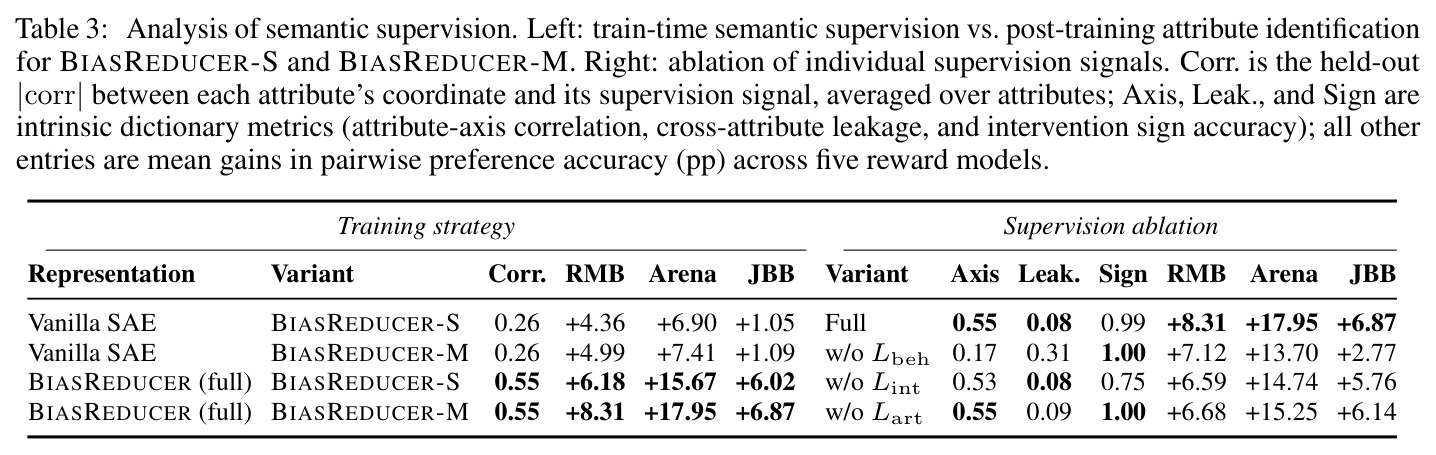
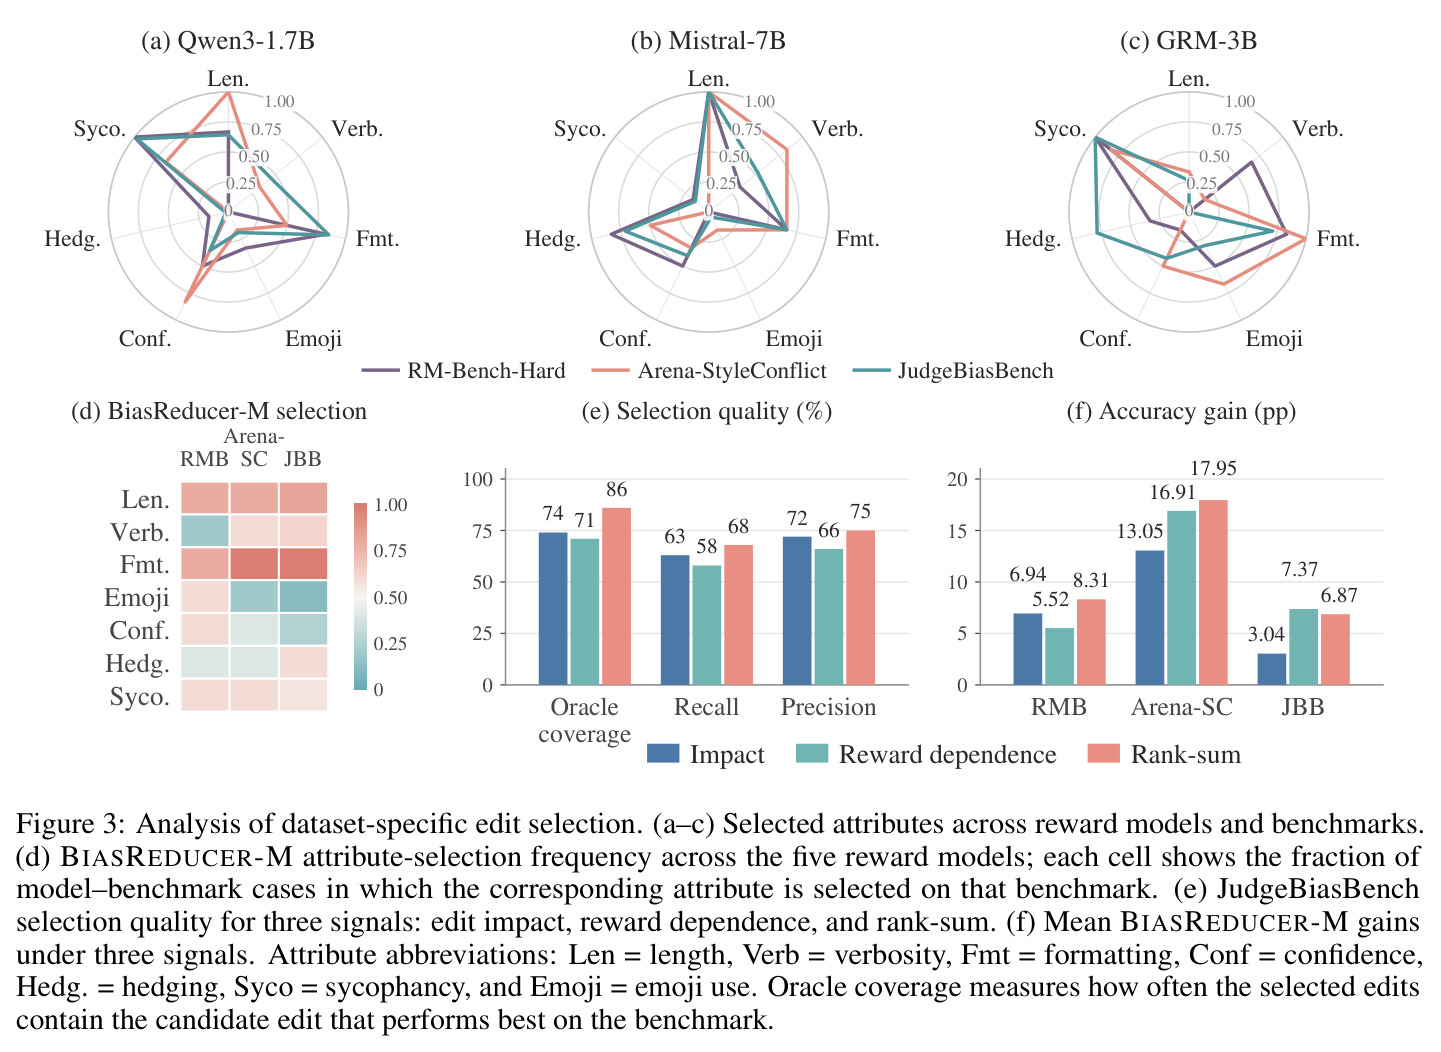
核心创新有三点且相互咬合。第一是'语义监督的稀疏表征':普通 SAE 只保证稀疏重建,哪个维度对应哪个属性只能事后猜(实测属性相关系数仅 0.26);BiasReducer 用损失 $\mathcal{L}=\mathcal{L}_{rep}+\gamma_b\tilde{\mathcal{L}}_{beh}+\gamma_i\tilde{\mathcal{L}}_{int}+\gamma_a\tilde{\mathcal{L}}_{art}$ 把指定坐标与属性绑定——行为项让 $z_a$ 追踪属性自然差异(如字数差),干预项用加长/缩短改写固定符号,工件项吸收改写共有伪变化,把相关系数提到 0.55。第二是'奖励感知的编辑方向':不用 SAE 解码器向量,而用与属性激活共变的隐状态协方差方向 $C_a$,直接对应奖励分数的变化。第三是'免标注的数据集级选择':新数据集不需要成对偏好标签,只凭 $G_a$ 与 $I_a$ 的秩和挑修正,在 JudgeBiasBench 上 86% 的情形覆盖最优候选,高于任一单信号的 71-74%。这与已有'固定偏置+固定修正'范式有本质区别。
方法步骤详情
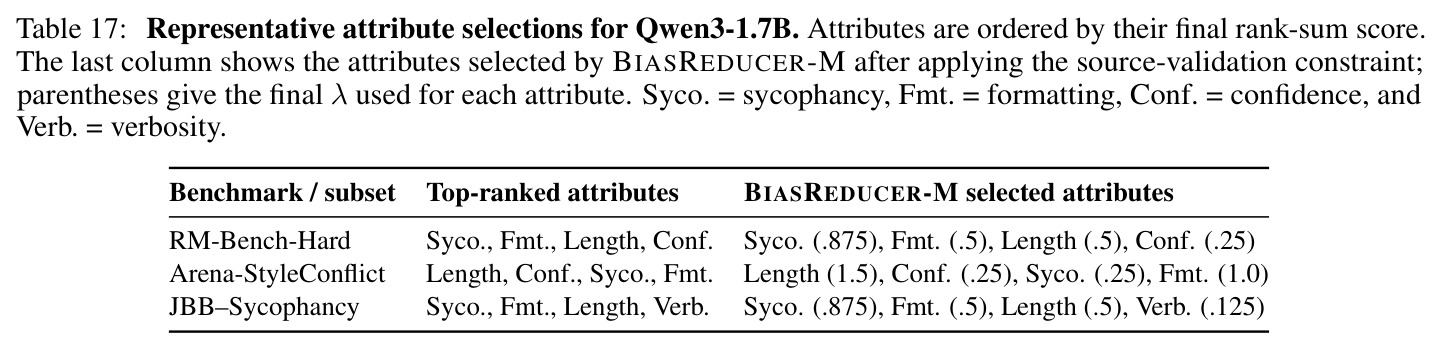
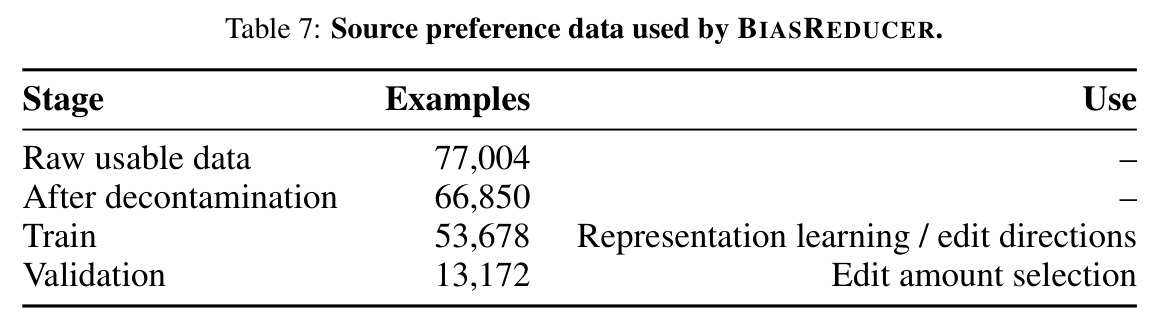
流程对应算法 1。准备:冻结奖励模型全部参数只留线性头 $w_r$;源偏好数据 $D_{src}$ 分为训练/验证两部分;属性集 $A$ 覆盖长度、冗长、格式、自信、对冲、谄媚、emoji 7 类。第一步表征学习:输入训练集偏好对,编码器算 $z_{pre}=W_{enc}u+b_{enc}$,保留 TopK 激活得 $z_{post}$,解码器 $\hat{u}=Vz_{post}$ 重建;联合损失中行为项对齐自然属性差、干预项用受控改写定符号、工件项去伪,输出各属性专属坐标 $z_a$。第二步构建编辑库:对每个 $a$ 用训练集估计 $C_a=\mathrm{Cov}_{h\sim D^{train}}(h, z_{post,a}(h))$,代入编辑公式;在验证集扫描 $\lambda$,选'奖励分数变化最大且偏好准确率降幅在预算内'的 $\lambda_a^\star$,冻结 $B=\{(a,C_a,\lambda_a^\star)\}$。第三步数据集级选择:新数据集 $D$ 只提供回答与原始分数,计算 $G_a(D)$ 与 $I_a(D)$ 取秩和 $B_a$;S 版应用秩和最小的 1 个编辑,M 版组合至多 $k_{max}$ 个。
技术新颖性
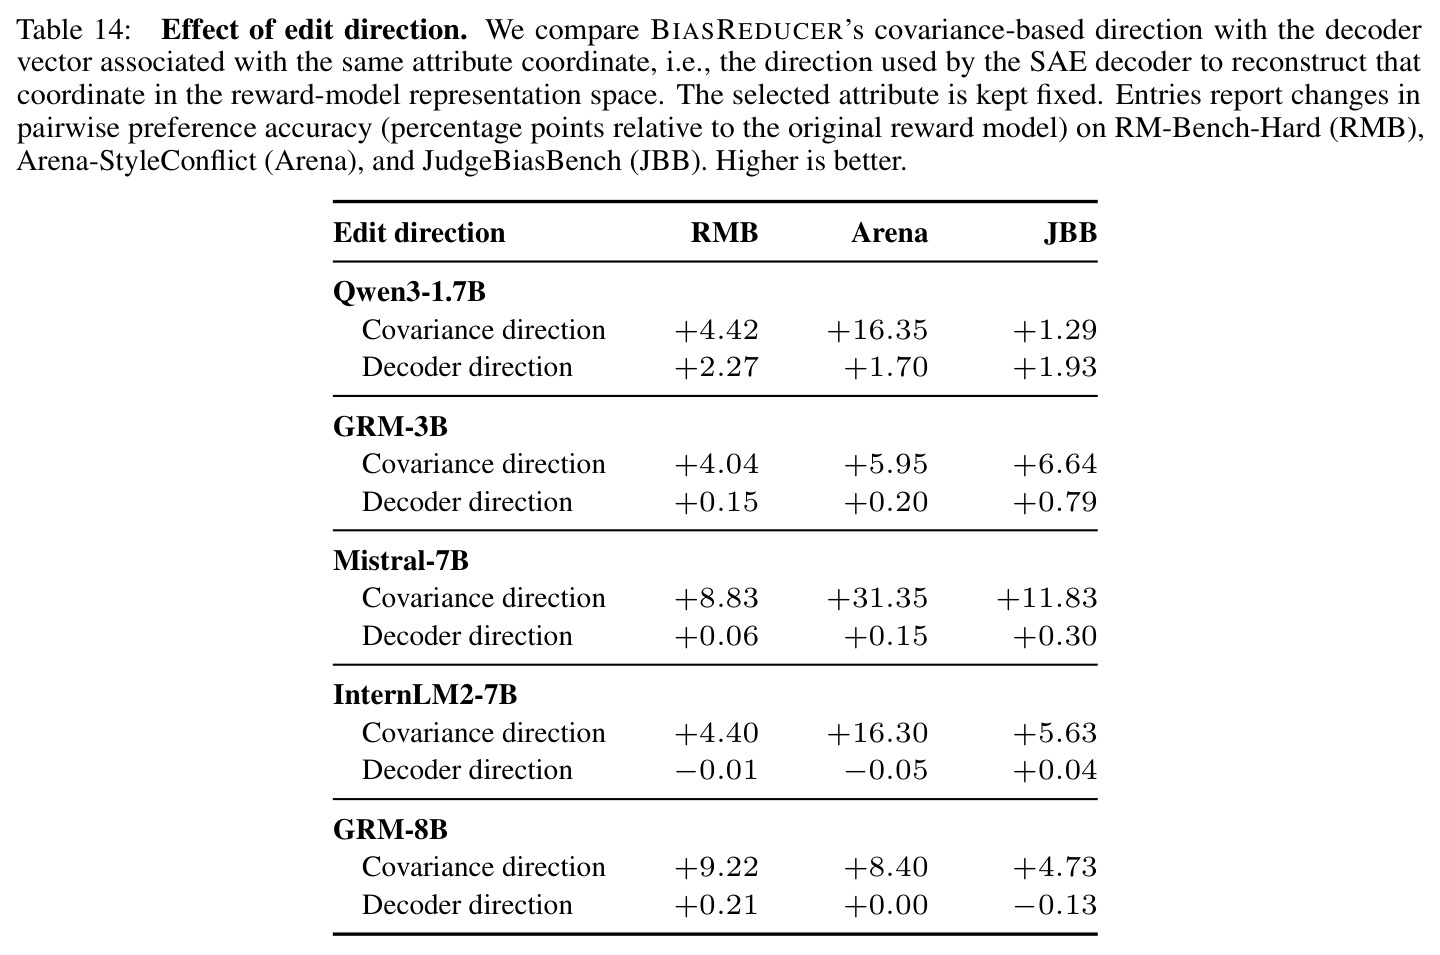
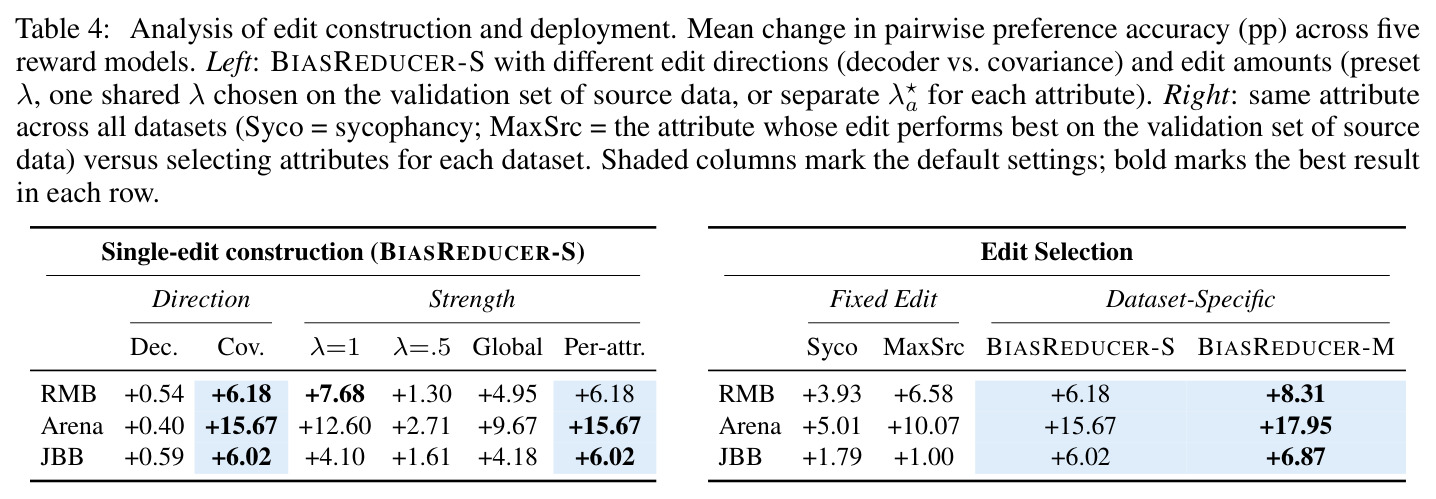
从技术坐标系看:训练类基线(RRM、ODIN、CROME、干预微调)通过改数据/损失/继续微调整个模型来'练出'鲁棒性,代价是重训和新数据;已有编辑方法(子空间移除类)虽免重训,但偏置类型由人工预先指定、修正对所有数据集一成不变。BiasReducer 的新颖性是三点叠加:(1) 把 SAE 表征从'事后解释工具'变成'事前构造的编辑原料'——专属坐标加三重语义监督,这是与 SARM、SparseRM 等稀疏表征工作的直接差异;(2) 受线性概念擦除启发的协方差方向编辑 $C_a$,实测远优于 SAE 解码器向量:RM-Bench-Hard 上 +6.18 对 +0.54 pp;(3) 每属性独立强度 $\lambda_a^\star$ 与数据集级 Borda 秩和选择,把'用哪个修正'变成可在免标注数据上求解的排序问题。消融显示去掉任何一环(语义监督、协方差方向、每属性强度、数据集选择)增益都明显缩水,说明各组件缺一不可而非单点技巧。
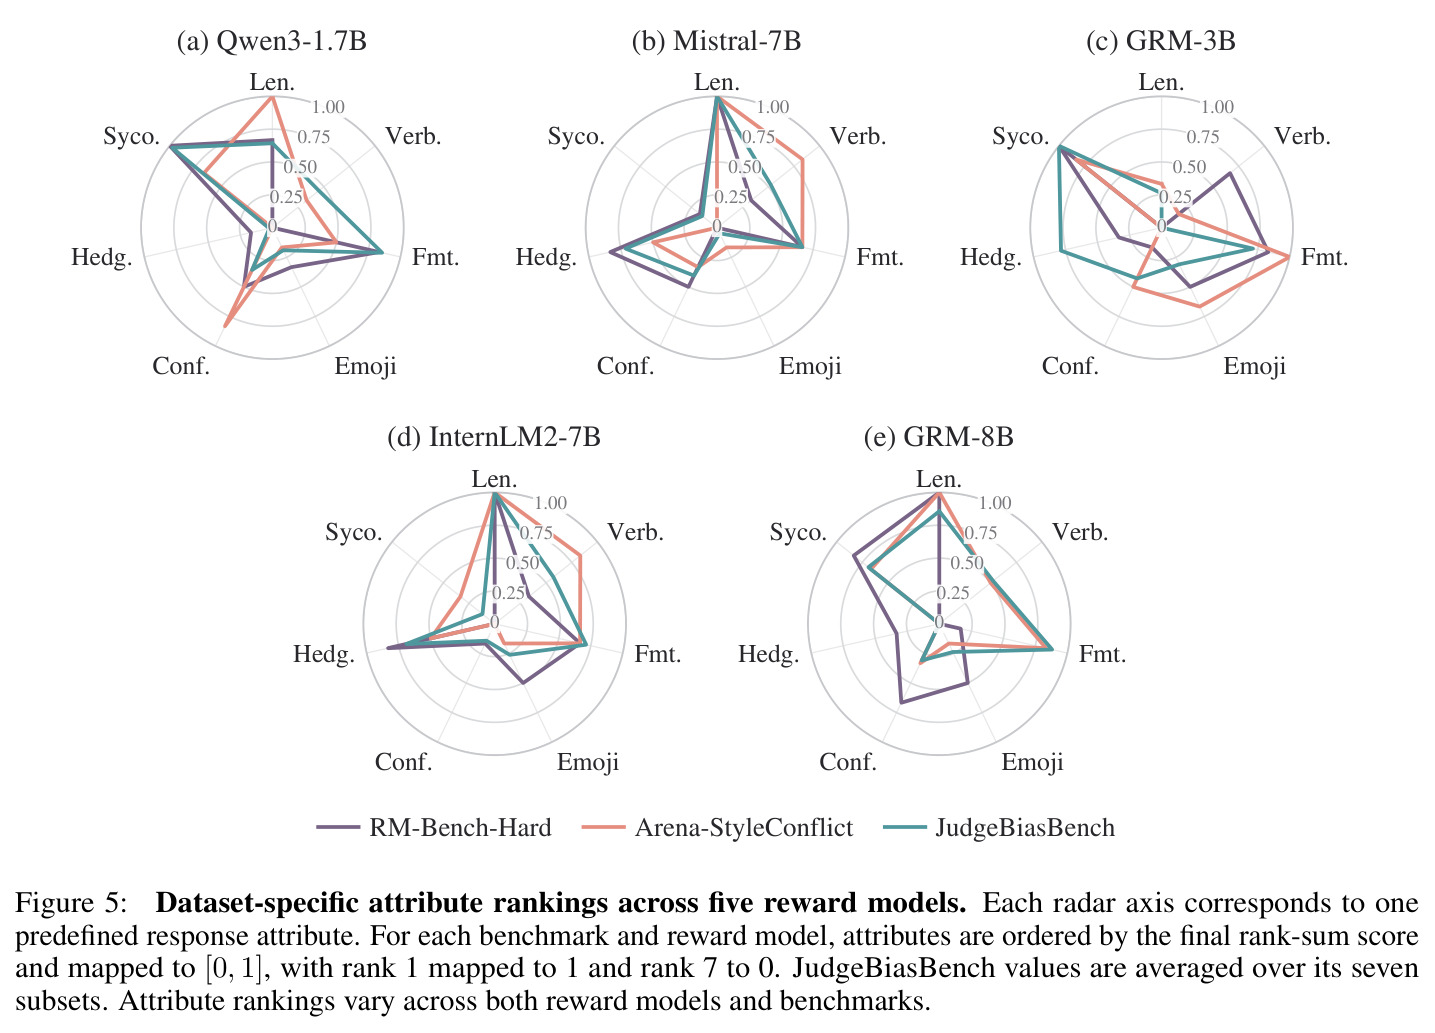
实验结果
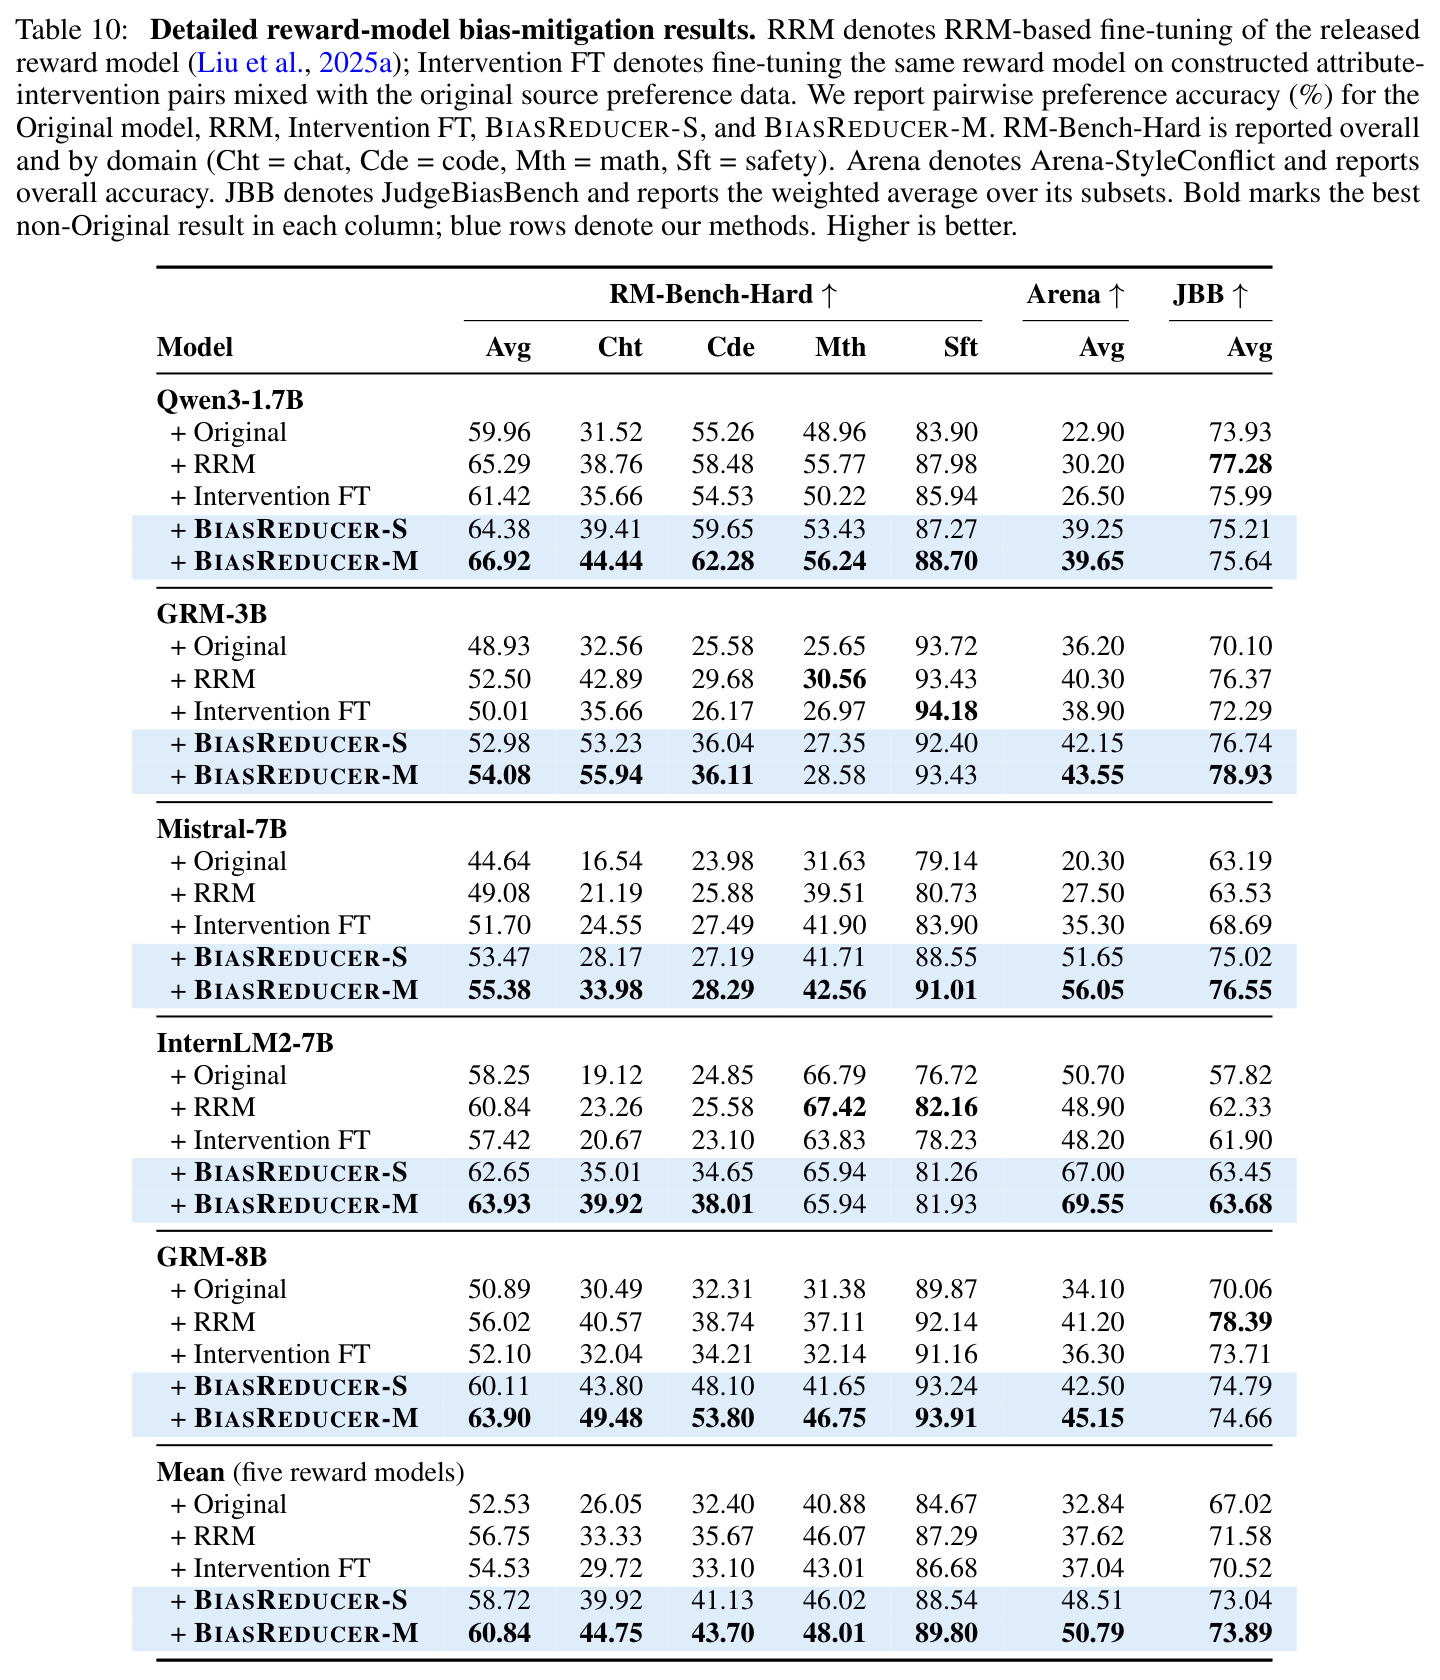
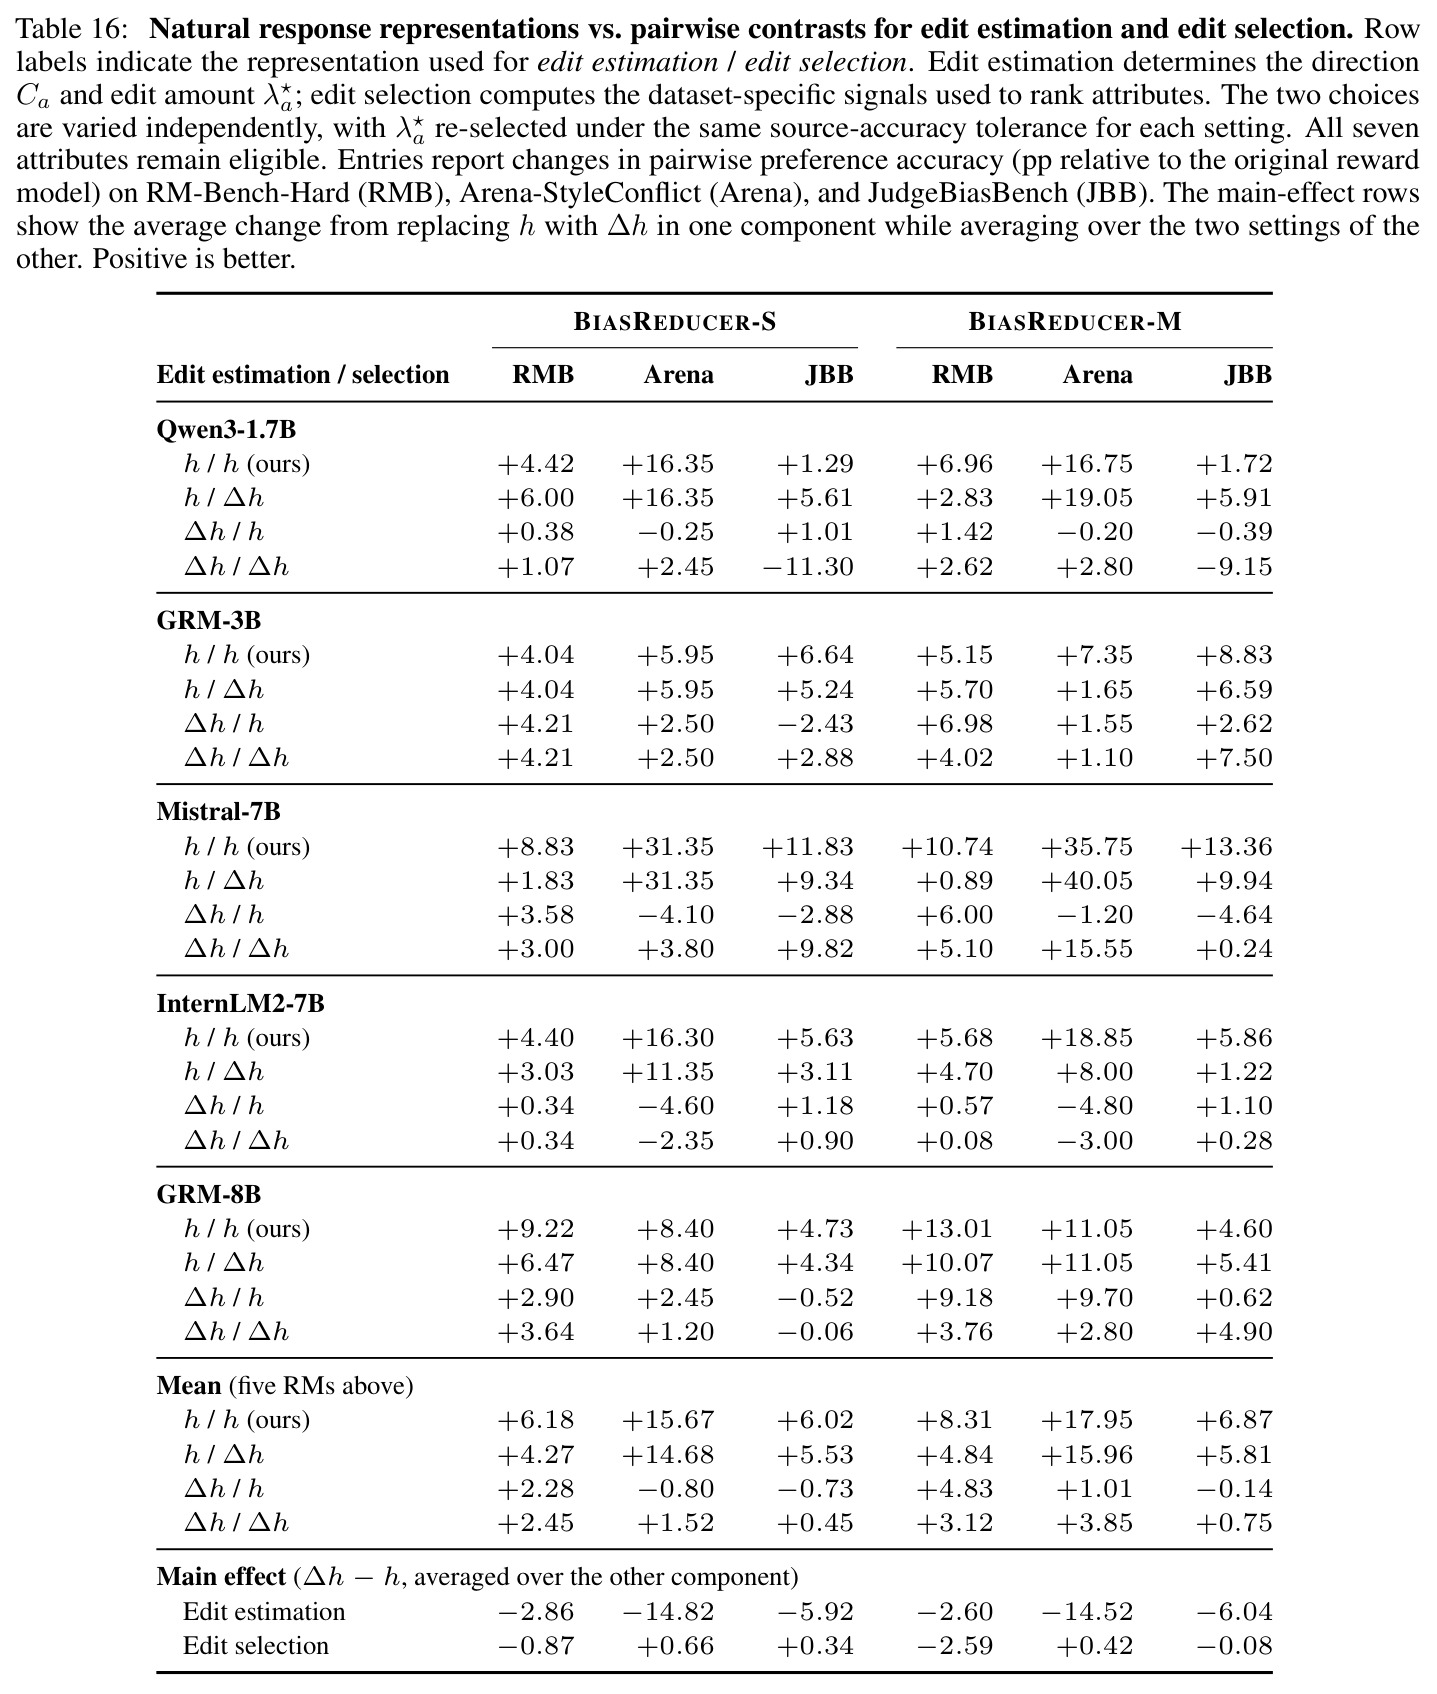
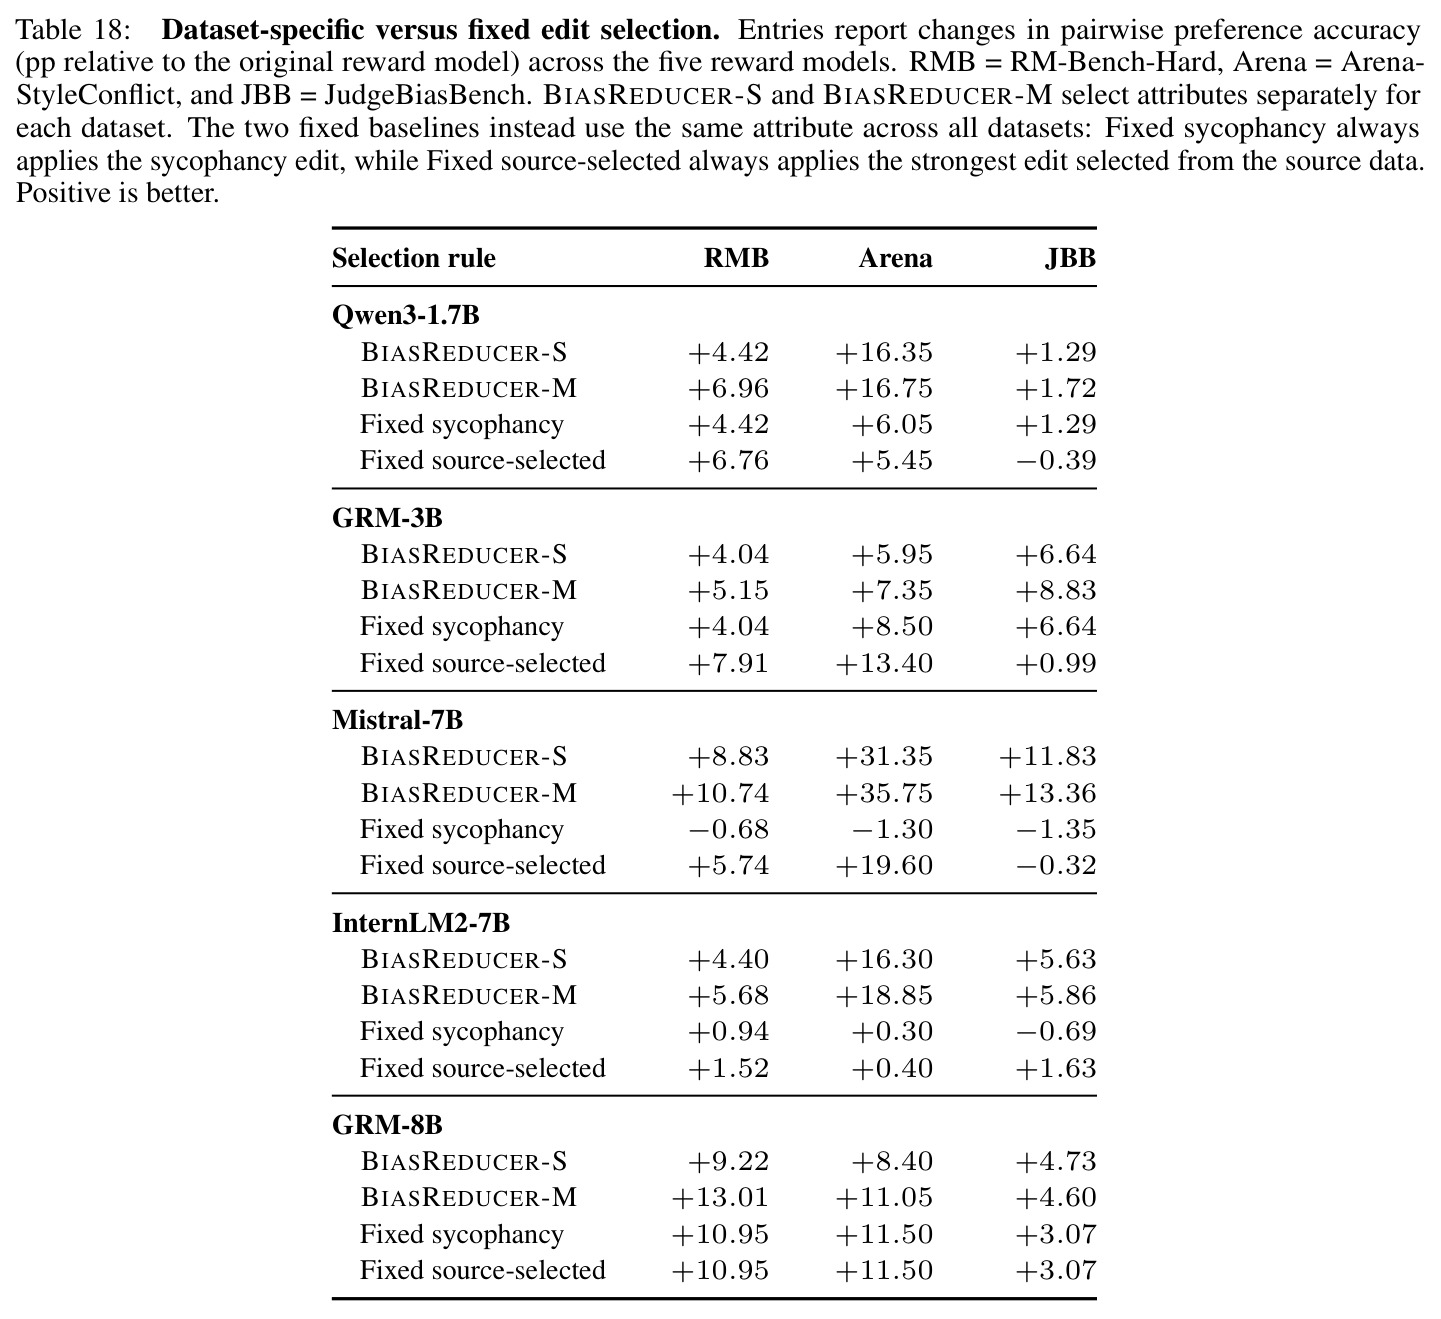
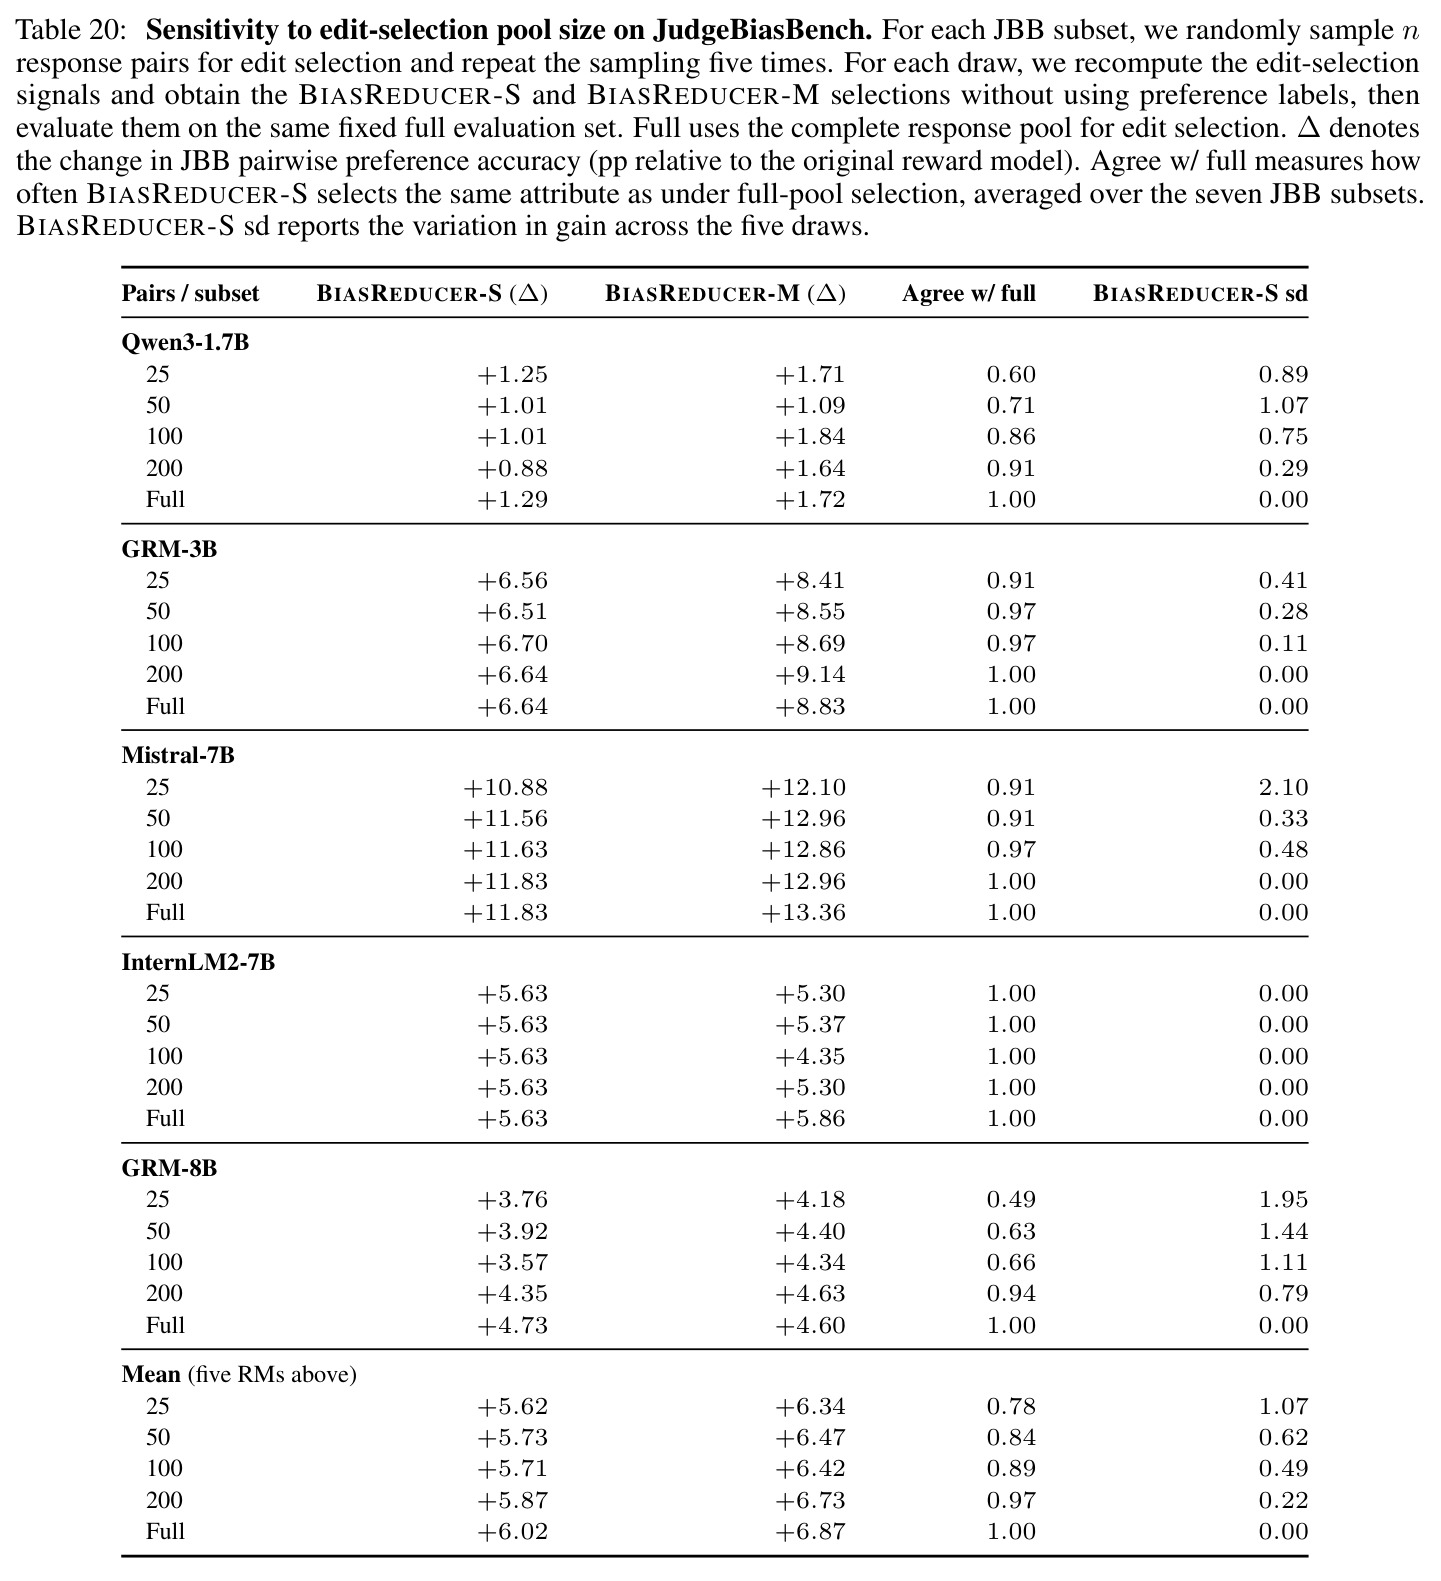
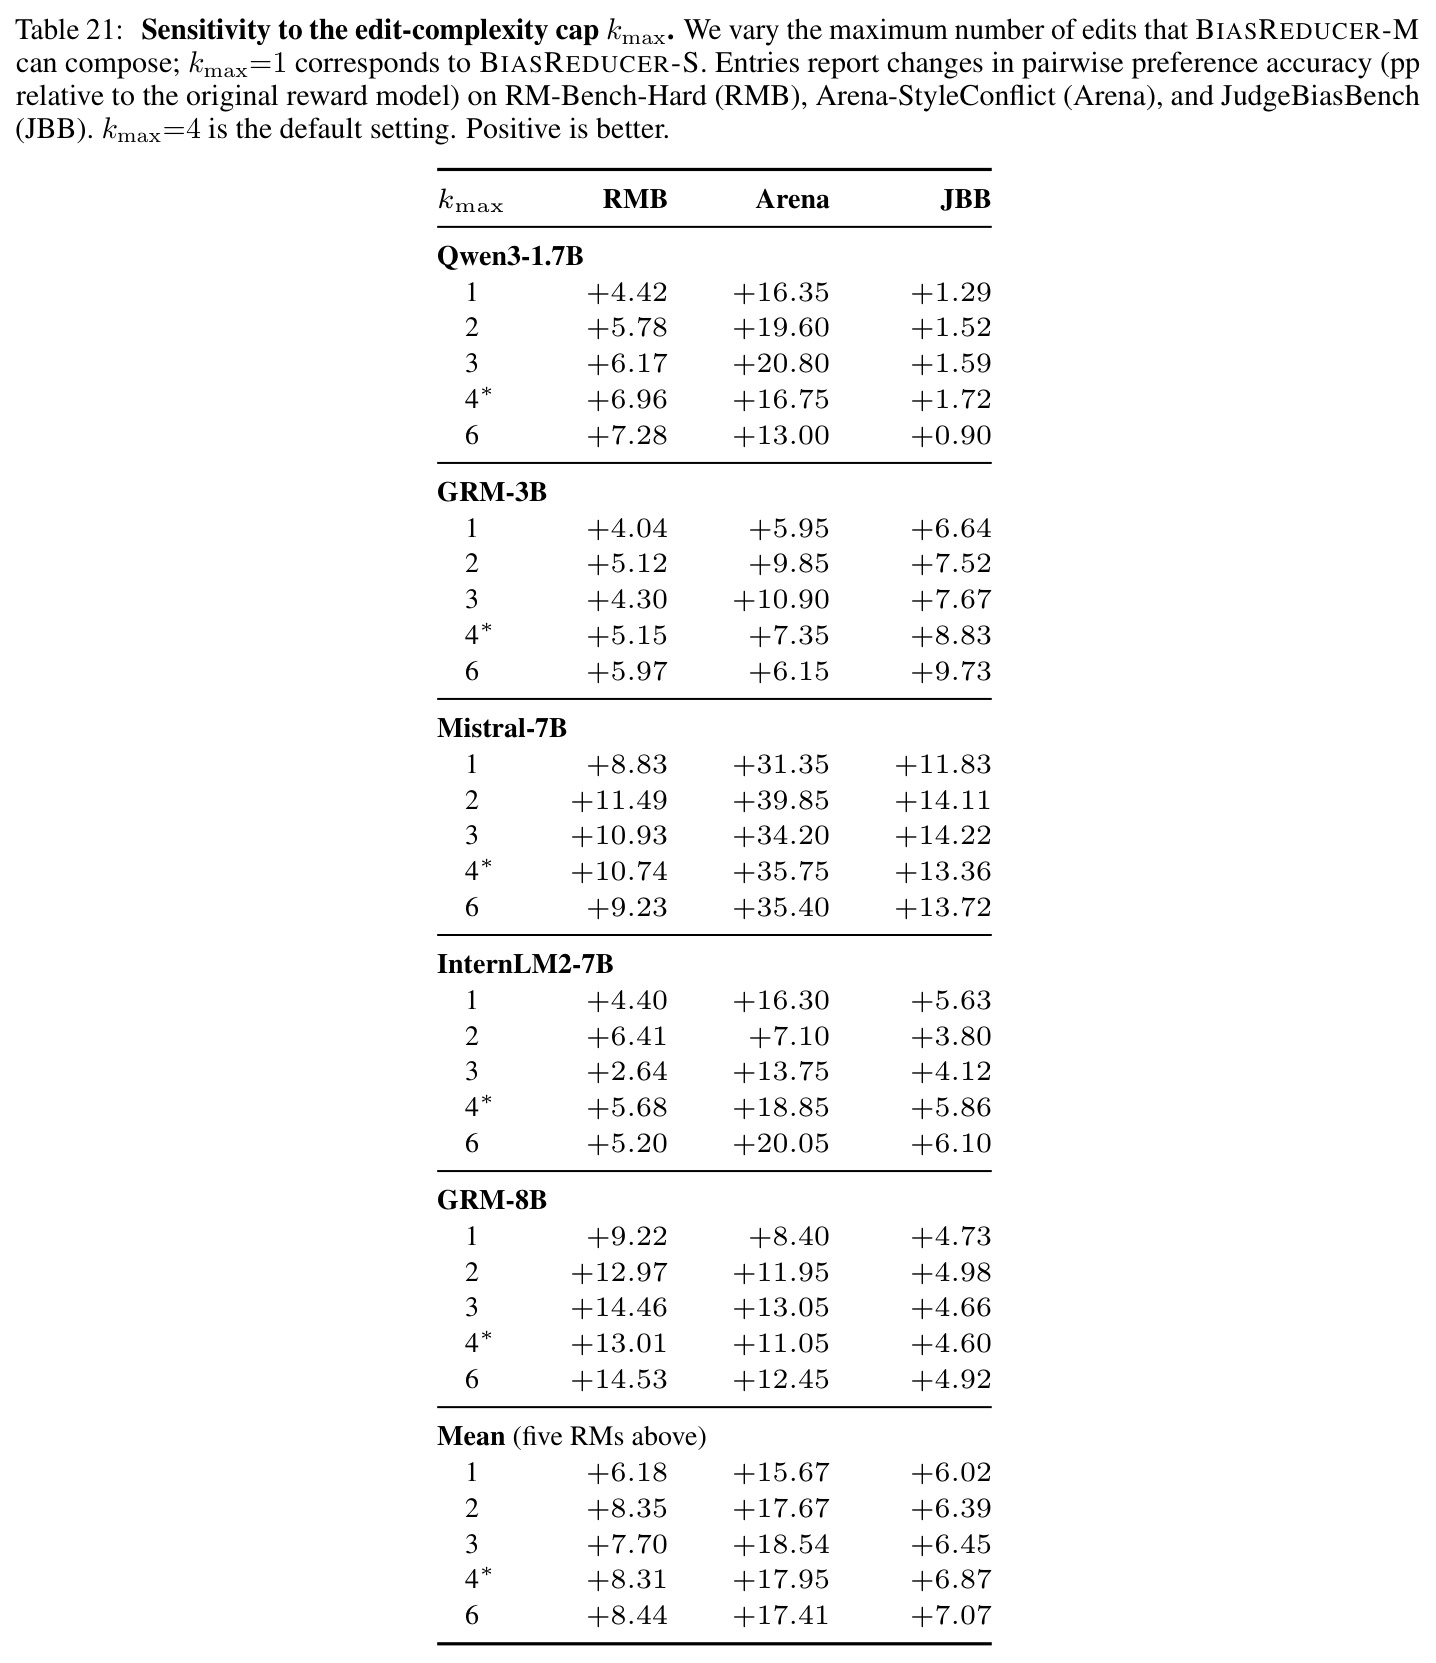
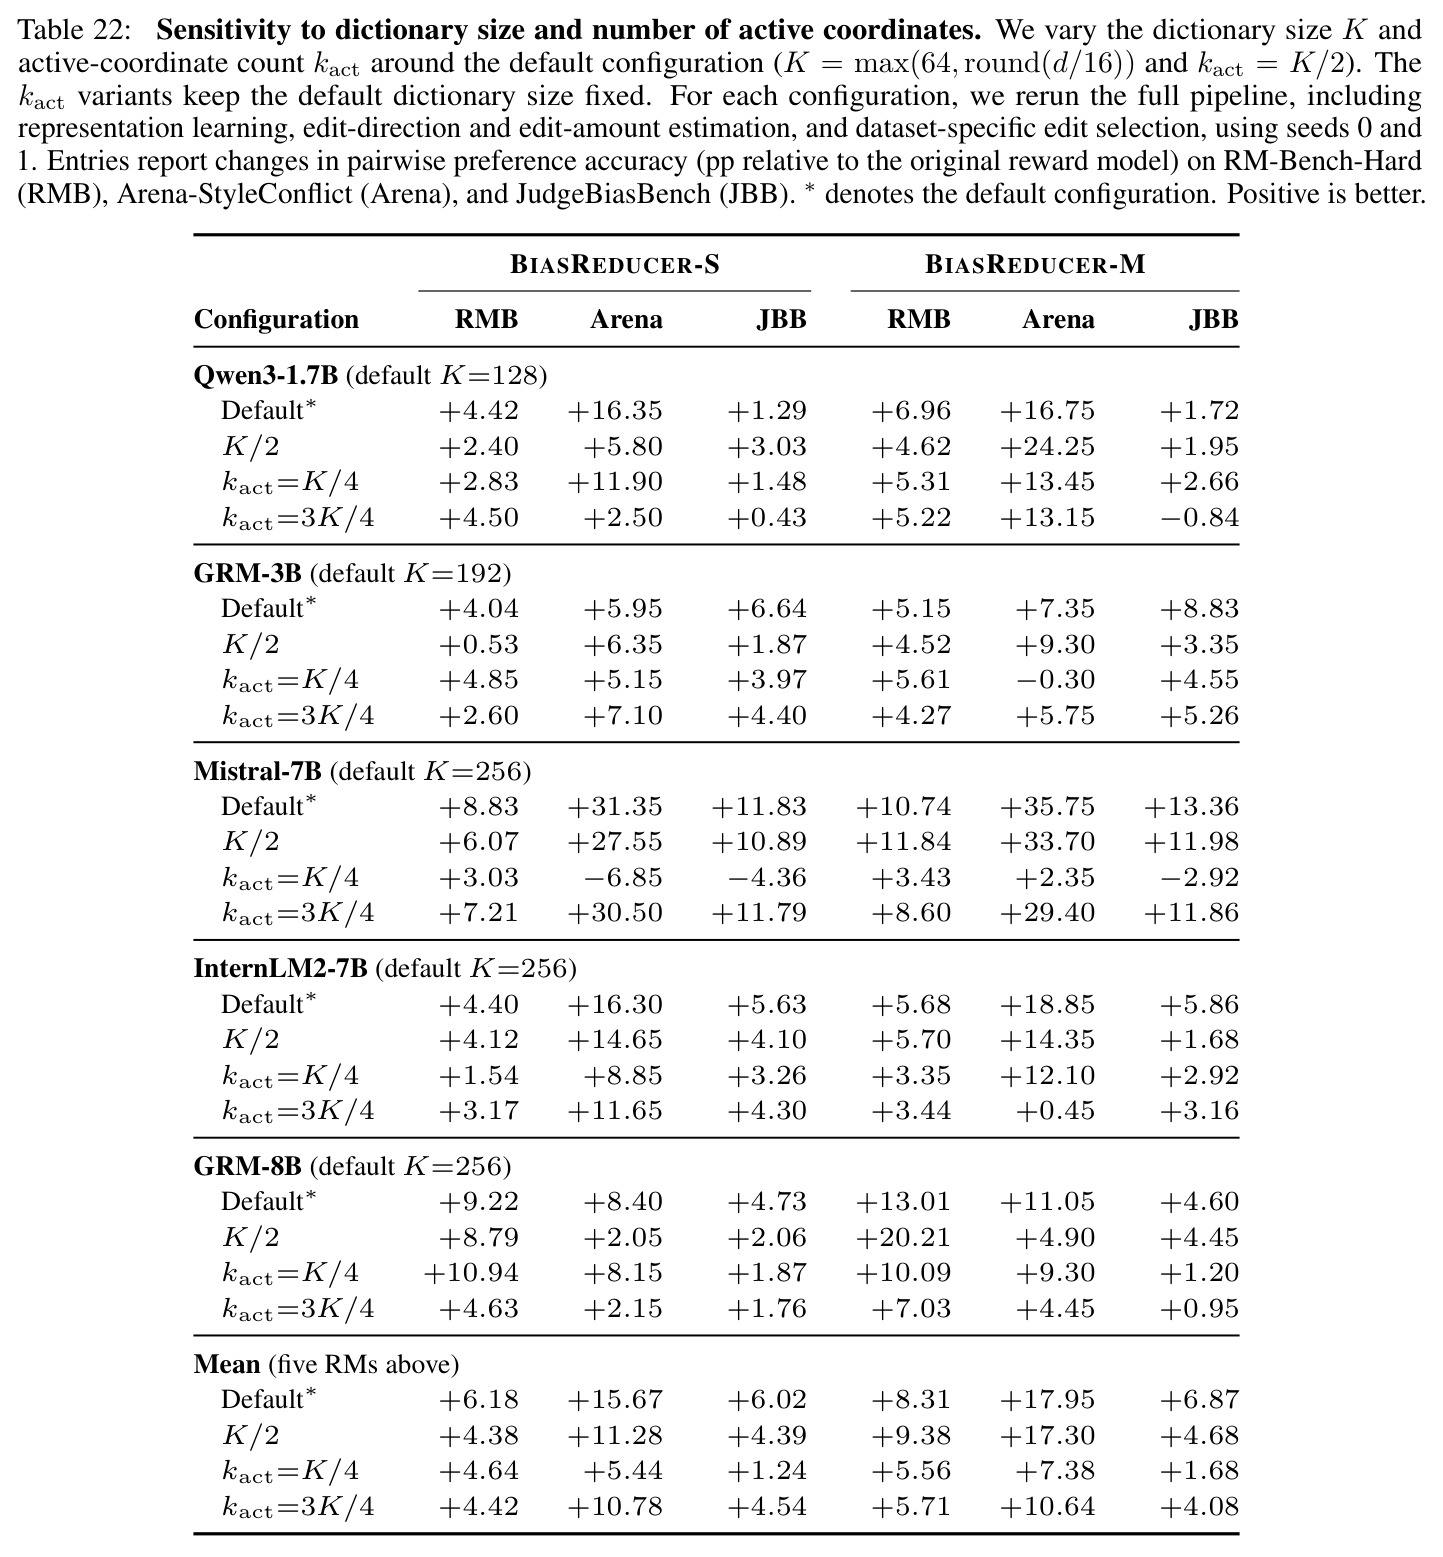
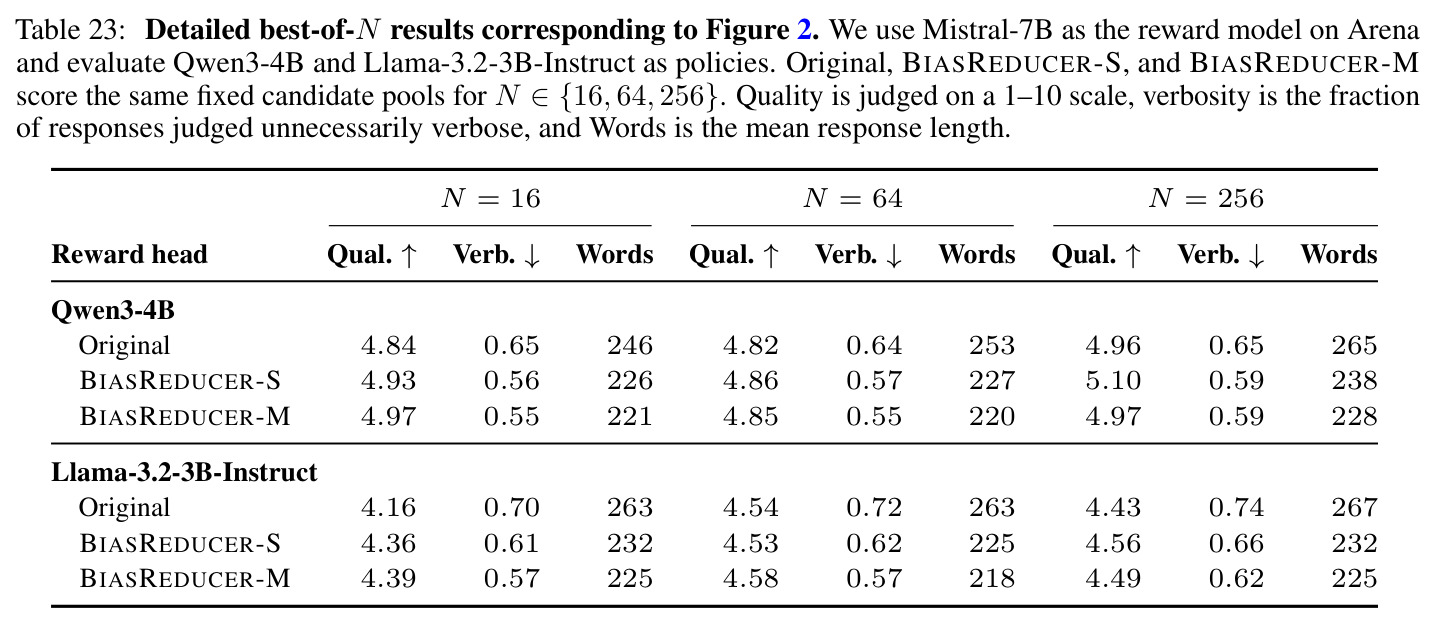
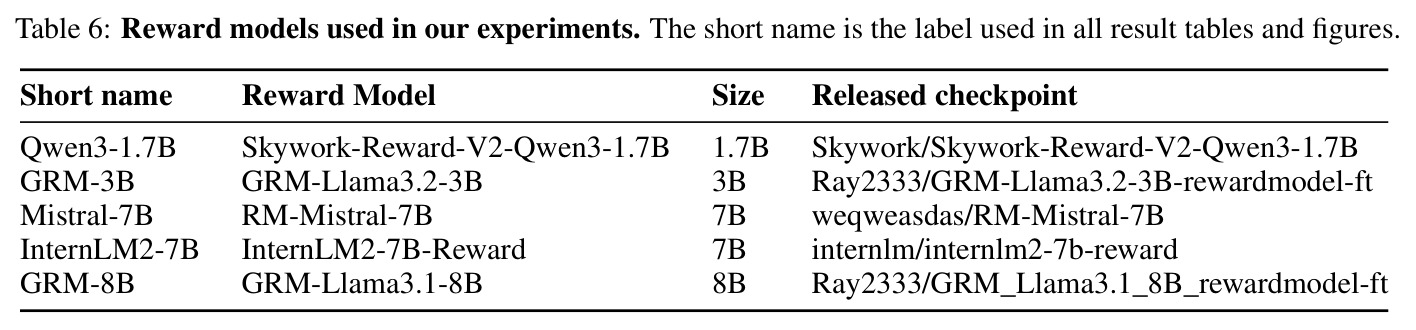
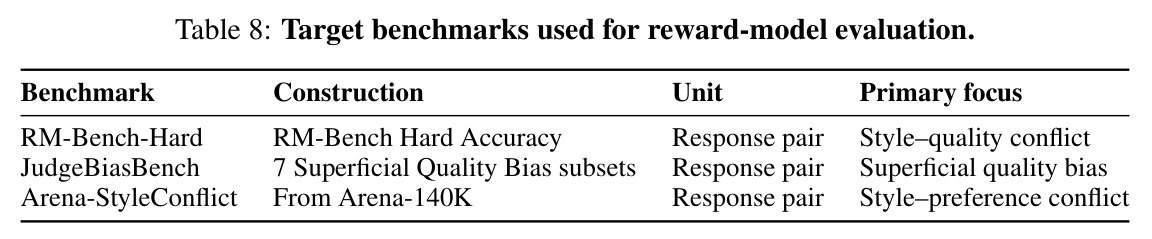
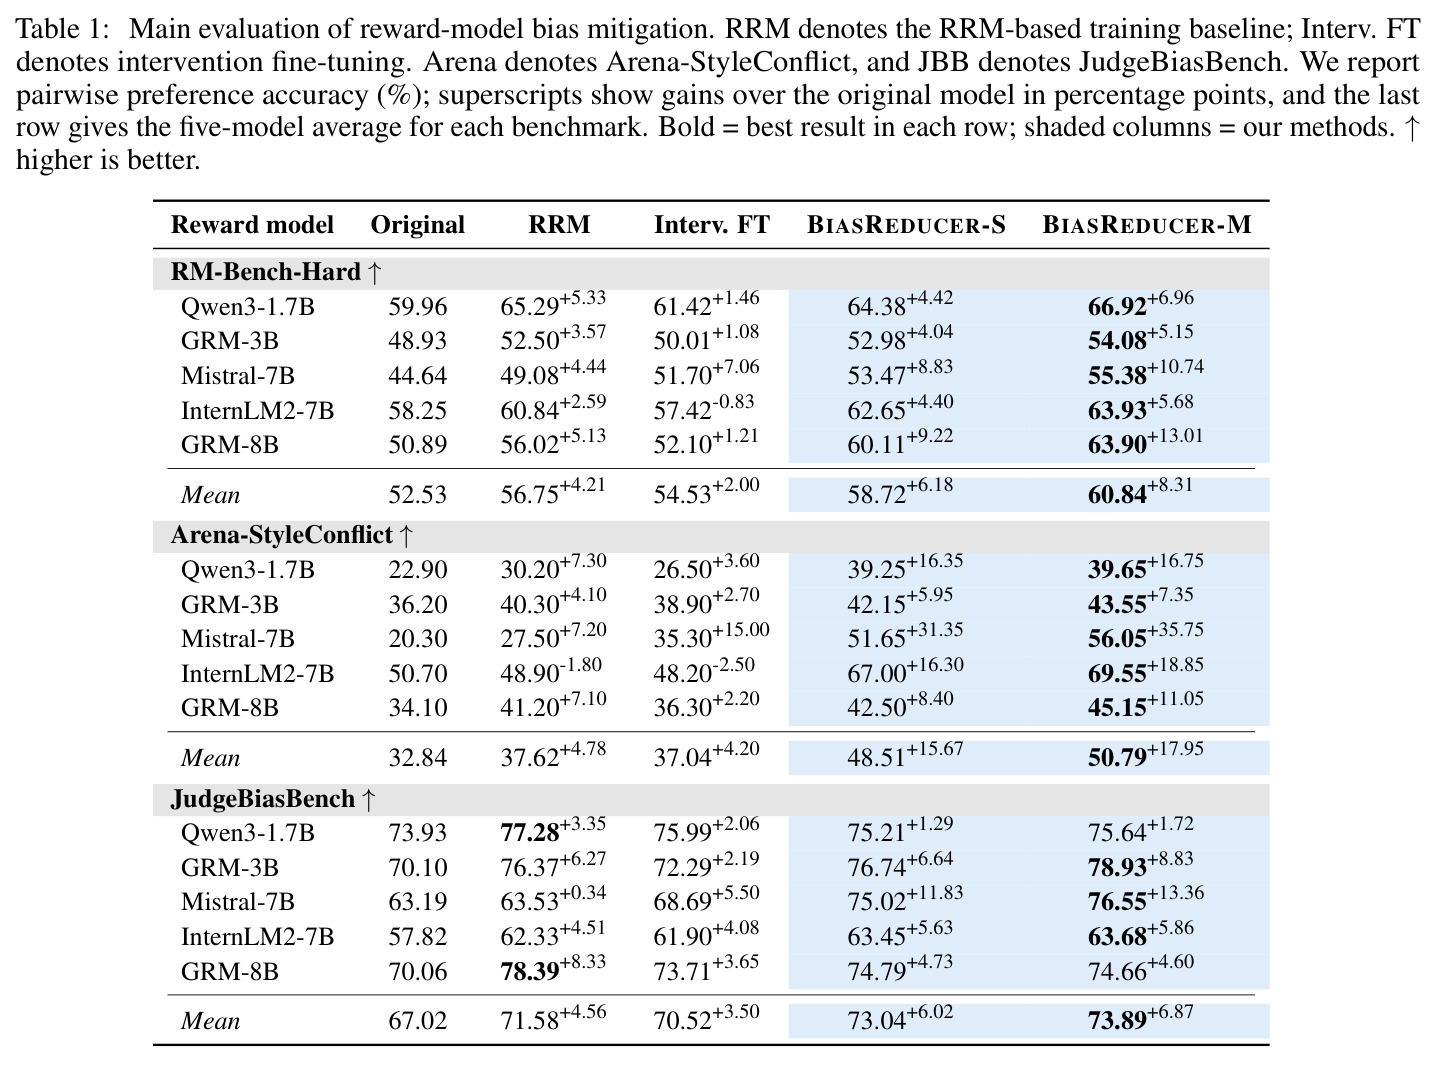
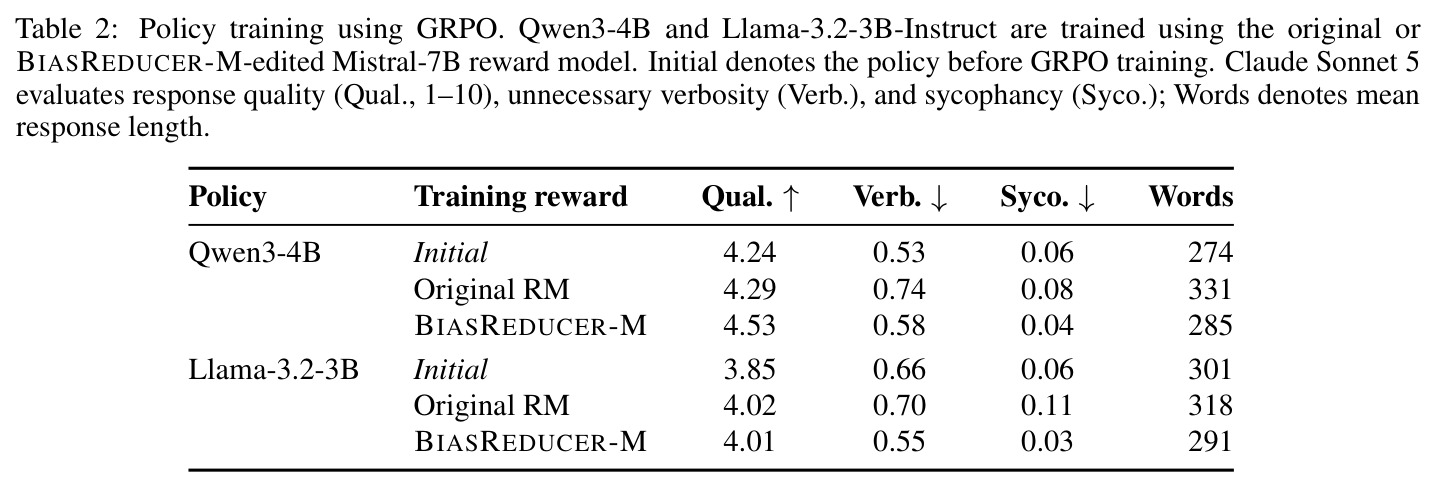
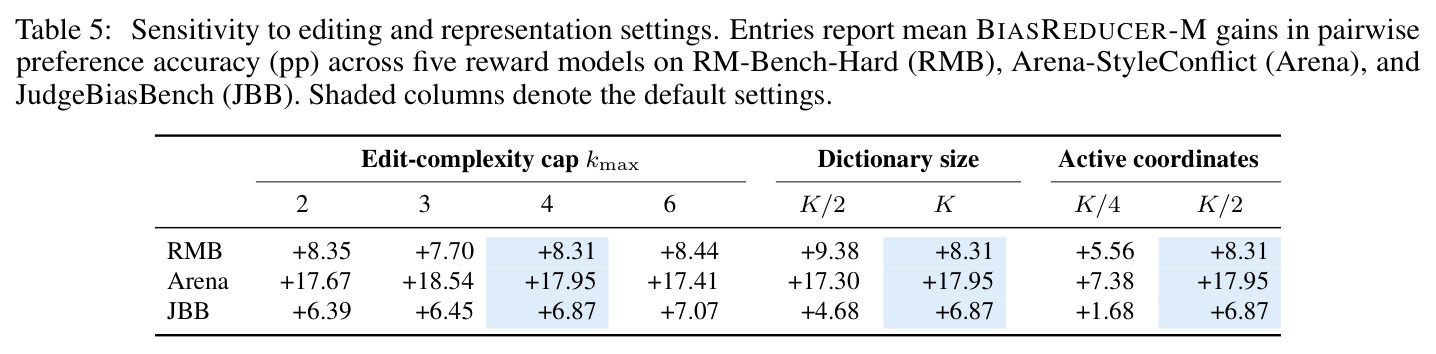
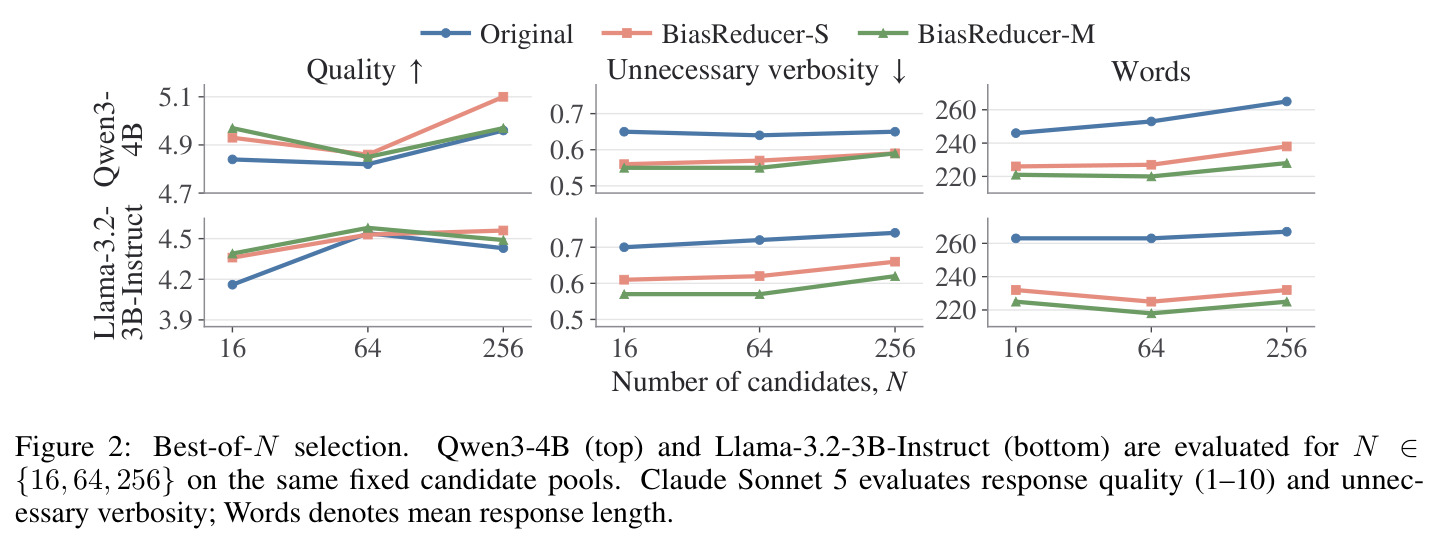
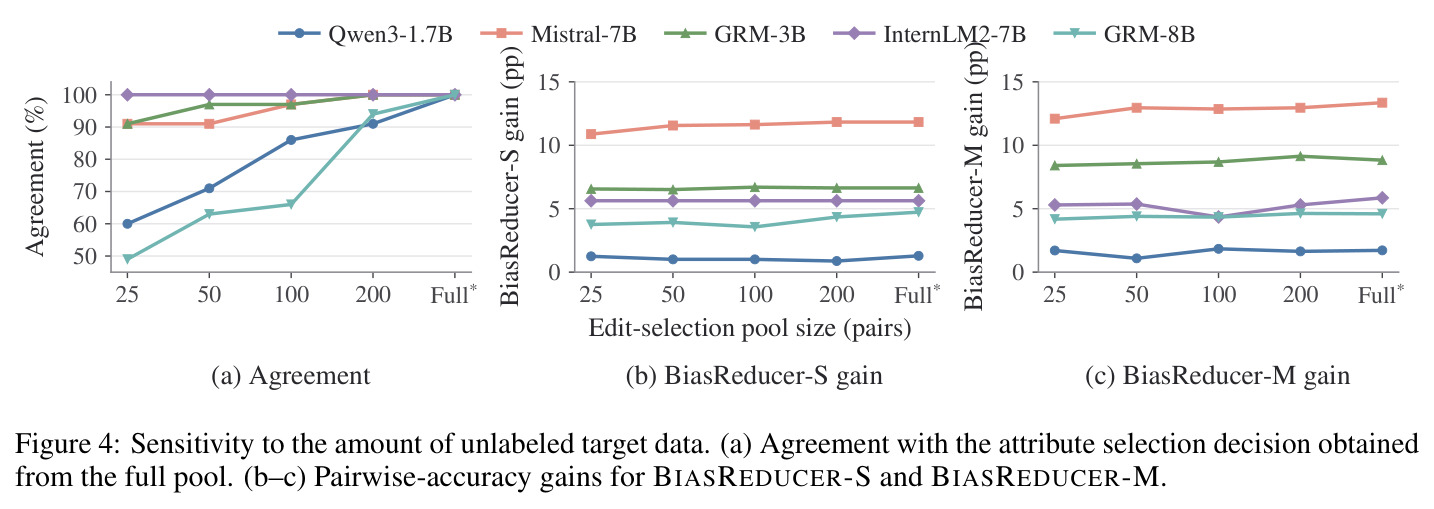
主实验覆盖 5 个奖励模型(Skywork-Reward-V2-Qwen3-1.7B、RM-Mistral-7B、GRM-Llama3.2-3B、InternLM2-7B、GRM-Llama3.1-8B)与 3 个基准。表 1:五模型平均下,BiasReducer-S 在 RM-Bench-Hard/Arena/JudgeBiasBench 分别 +6.2/+15.7/+6.0 pp,M 版提升至 +8.3/+18.0/+6.9 pp,所有组合均优于原始模型;对比更强训练基线 RRM,M 版再领先 4.1/13.2/2.3 pp。亮点:Mistral-7B 在 Arena 上 20.30→56.05(+35.75 pp)。下游迁移(表 2、图 2):M 版编辑 RM 做 GRPO,Qwen3-4B 质量 4.29→4.53、冗长 0.74→0.58、谄媚 0.08→0.04、字数 331→285。消融:语义监督把属性相关系数从 0.26 提到 0.55,去掉 $\mathcal{L}_{beh}$ 掉到 0.17、去掉 $\mathcal{L}_{int}$ 符号准确率 0.99→0.75;协方差方向完胜解码器向量(+6.18/+15.67/+6.02 对 +0.54/+0.40/+0.59 pp);秩和选择 86% 覆盖最优修正;100 条样本 89% 选择一致、200 条 97%;$k_{max}\in\{2,3,4,6\}$ 下性能稳定。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RM-Bench-Hard 成对偏好判定 | 成对偏好准确率 Acc (%) | BiasReducer-M 五模型平均 60.84(最佳单点 GRM-8B 63.90) | 原始模型 52.53;RRM 微调 56.75;干预微调 54.53 | 较原始 +8.31 pp,较 RRM +4.09 pp |
| Arena-StyleConflict 风格冲突偏好判定 | 成对偏好准确率 Acc (%) | BiasReducer-M 五模型平均 50.79(最佳单点 Mistral-7B 56.05) | 原始模型 32.84;RRM 37.62;干预微调 37.04 | 较原始 +17.95 pp,较 RRM +13.17 pp |
| JudgeBiasBench 偏见基准 | 成对偏好准确率 Acc (%) | BiasReducer-M 五模型平均 73.89(最佳单点 Mistral-7B 76.55) | 原始模型 67.02;RRM 71.58;干预微调 70.52 | 较原始 +6.87 pp,较 RRM +2.31 pp |
| GRPO 策略训练下游效果(Qwen3-4B) | Claude Sonnet 5 评分:质量(1-10)/冗长/谄媚 + 平均字数 | 编辑 RM 训练:4.53 / 0.58 / 0.04 / 285 词 | 原始 RM 训练:4.29 / 0.74 / 0.08 / 331 词;初始策略 4.24 / 0.53 / 0.06 / 274 词 | 质量 +0.24,冗长 −0.16,谄媚 −0.04,字数 −46 |
局限与改进
作者承认的局限:方法依赖预先定义的属性集 $A$,只能缓解'名单上'的偏置;评价集中在偏置型基准上,对常规能力的无损性只在三个基准内验证。我的补充观察:其一,只编辑线性奖励头 $w_r$,若偏置编码在 Transformer 主干的非线性表征 $h(q,x)$ 内部,此框架无法触及;其二,下游质量用 Claude Sonnet 5 打分,评测器自身可能偏好长而自信的回答,与被测偏差同源,存在循环评测风险;其三,Arena-StyleConflict 由作者从 Arena Human Preference 140K 自行构造,并非社区标准基准,横向可比性有限;其四,编辑强度的'准确率降幅预算'、$\gamma_b/\gamma_i/\gamma_a$、TopK 的 $k_{act}$ 等超参需要源数据验证集调校,表 5 显示激活数减半时 JBB 增益从 +6.87 跌到 +1.68,对稀疏度较敏感;其五,削减长度等属性可能误伤与质量真相关的成分(如长而严谨的证明),如何在去偏与保信号之间取得平衡值得更多分析。
独立分析的弱点
独立弱点分析:1) 属性词典人工圈定为 7 类(长度、冗长、格式、自信、对冲、谄媚、emoji),语言偏好、引用格式、代码风格等未收录的偏置完全管不到——可扩展半自动词典增长:先无监督聚类奖励敏感方向,再人工命名入库。2) $C_a$ 在源数据上估计、$\lambda_a^\star$ 在源验证集上定,若新数据分布漂移大(如从闲聊换到法律文书),共变方向可能失准——可在新数据集上用免标注信号增量微调 $\lambda$。3) $G_a$、$I_a$ 都基于奖励分数与属性坐标的线性关联,无法识别非线性依赖;可引入基于探测器(probe)的非线性检验信号。4) 组合 $k_{max}$ 个编辑时隐含'各修正近似独立'的假设,属性间强相关(冗长≈长度)时可能过修,文中未报告负交互案例,可加组合后的验证集回测门控。5) 用 LLM 评测下游质量与被测偏差同源,应引入人工评测或多裁判交叉验证。每个弱点都有明确改进抓手,不动摇框架主体。
未来方向
作者提出的方向:把编辑库扩展到更多属性与领域,在更大规模策略训练中验证迁移效果,并把'学一次可复用修正、按数据集行为选择'上升为奖励模型编辑的一般设计原则。基于成果可延伸的方向:1) 偏置自动发现——用无监督 SAE 特征加稀疏探针自动提名候选属性,摆脱人工名单限制;2) 在线化——RLHF 训练过程中周期性重估 $G_a/I_a$,动态启停编辑,形成持续'防作弊'机制;3) 与过程奖励模型(PRM)结合,对步骤级打分去偏;4) 组合编辑的交互理论——分析多个秩一修正叠加对偏好准确率的影响界,指导 $k_{max}$ 自适应选择;5) 把编辑库做成可插拔、可版本管理与安全审计的工件,实现'编辑即服务'的生态;6) 条件化编辑——研究对真正依赖长度的任务(长文写作、数学证明)的保护机制,避免去偏误伤有效信号。
复现评估
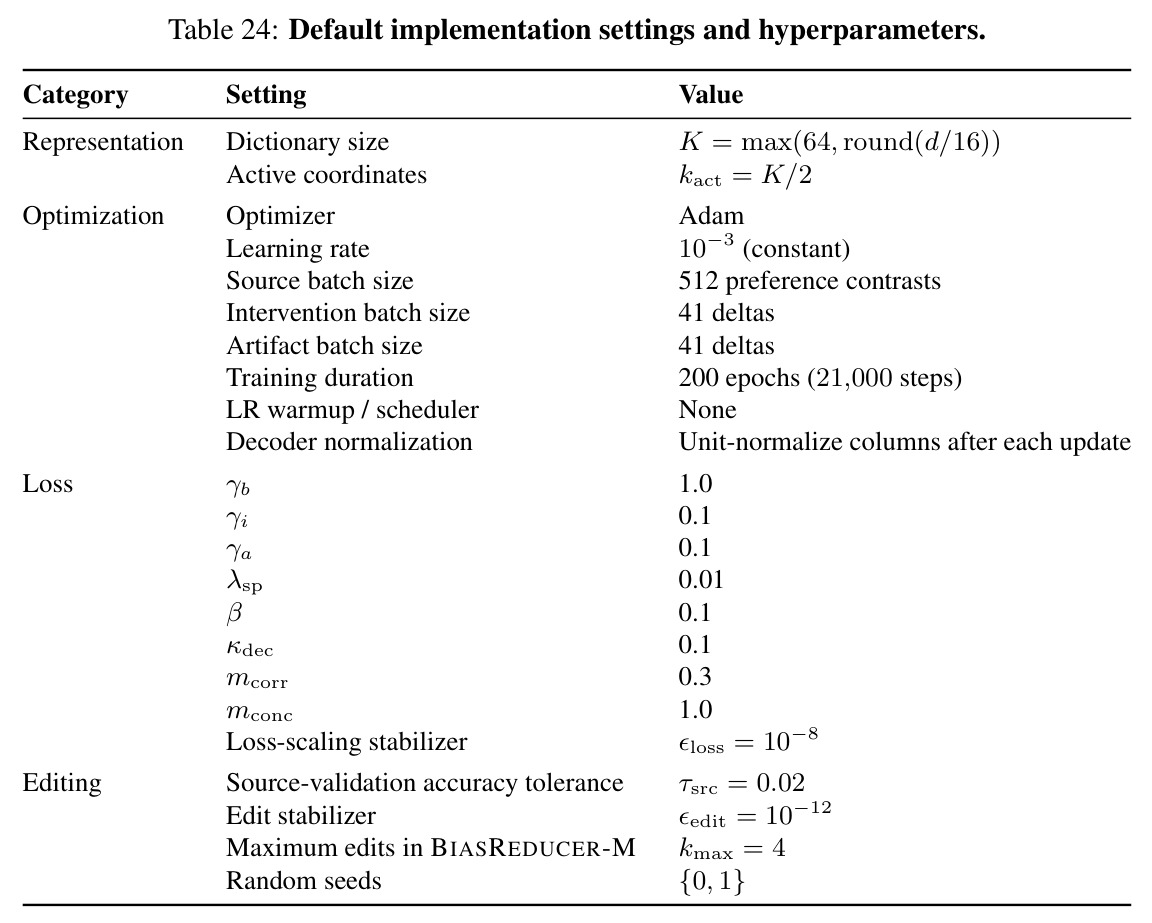
复现评估:论文正文与附录(A 实验细节、B 方法细节、C.4 补充结果、D 下游结果)覆盖了主要超参与构造细节,但所给文本中未见明确的代码开源声明。所需资源基本全部公开可得:5 个奖励模型(1.7B-8B)均为公开权重;源数据 Skywork-Reward-Preference-80K-v0.2、RM-Bench-Hard、Arena Human Preference 140K 亦公开(JudgeBiasBench 出自 Zhou et al. 2026)。算力门槛中等偏低:核心流程只需前向抽取隐状态、训练一个 TopK 稀疏编码器和线性代数运算,单卡即可完成;较重的部分是受控改写数据构造(加长/缩短改写需 LLM 生成并清洗)与下游 GRPO 训练(Qwen3-4B/Llama-3.2-3B,需数卡)。总体复现难度中等:主要成本在语义监督三损失权重 $\gamma_b/\gamma_i/\gamma_a$、TopK 的 $k_{act}$、准确率降幅预算等超参未全部给出默认值时的搜索,以及调用 Claude Sonnet 5 做下游评测的费用。
论文图表