基于在途KV缓存与干净锚点的自回归视频扩散加速 In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion
复用去噪前向自产的同阶段KV缓存,辅以稀疏干净锚点,长视频生成更快且质量更高。
前置知识
KV 缓存(KV Cache)
Transformer 的自注意力把每个位置的隐藏态投影成 Key 和 Value。自回归生成模型逐块处理时,把已算过的 K、V 存入缓存,新块只需计算自己的 Q、K、V 并与缓存交互,避免重算整个历史。在扩散 Transformer(DiT)中同理:跨块条件生成时,历史块的 KV 就是该块的"记忆",其噪声水平与可用时机直接决定生成依赖图。
本文全部效率收益来自"哪些 KV 由哪次前向产生、何时可被后续块读取"这一状态契约设计,不理解 KV 缓存就无法理解其加速机制。
自回归视频扩散
将长视频按时间切成若干 latent 块(chunk),逐块去噪生成;生成每块时以已生成块的特征(通常打包成 KV 缓存)为条件以保证时间连贯,形成"块间自回归、块内扩散"的两层结构。代表工作有 Self-Forcing、CausVid、HiAR 等,是当前长视频生成的主流范式。
FlashForward 修改的正是块间传递的表示形式与消费时机,必须先掌握这一框架才能理解其改动位置。
少步扩散与 Rectified Flow
Rectified Flow 把扩散建模为直线输运:加噪满足 $x_\sigma=(1-\sigma)x_0+\sigma\epsilon$,模型预测速度 $v=\epsilon-x_0$,沿噪声水平 $\sigma$ 从大到小积分即可去噪。经蒸馏后采样可压缩到约 4 步,每一步称为一个"去噪阶段",$S=4$ 时噪声水平满足 $\sigma_S>\cdots>\sigma_0=0$。
论文以 4 个去噪阶段为流水线基本调度单位,速度参数化公式贯穿推理(Eq. 2)与训练目标(Eq. 5),是读懂方法细节的数学基础。
缓存更新专用前向(cache-update-only forward)
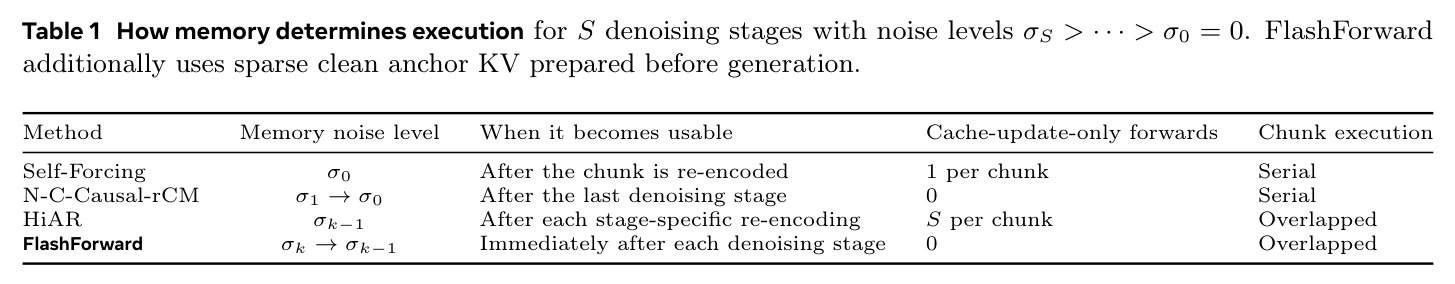
指只为构造干净或低噪历史 KV 而额外执行的模型前向:输入是已完成的 latent,输出并不推进任何新内容,仅产出供后续块读取的缓存。Self-Forcing 每块完成重编码 1 次,HiAR 为支持跨块重叠在每个去噪阶段都重编码(每块 $S$ 次)。这些前向只建记忆、不产出像素,是延迟的重要来源。
FlashForward 的核心贡献是把这类前向降为 0,理解它的代价才能准确评估加速的来源与边界。
LoRA 与角色嵌入
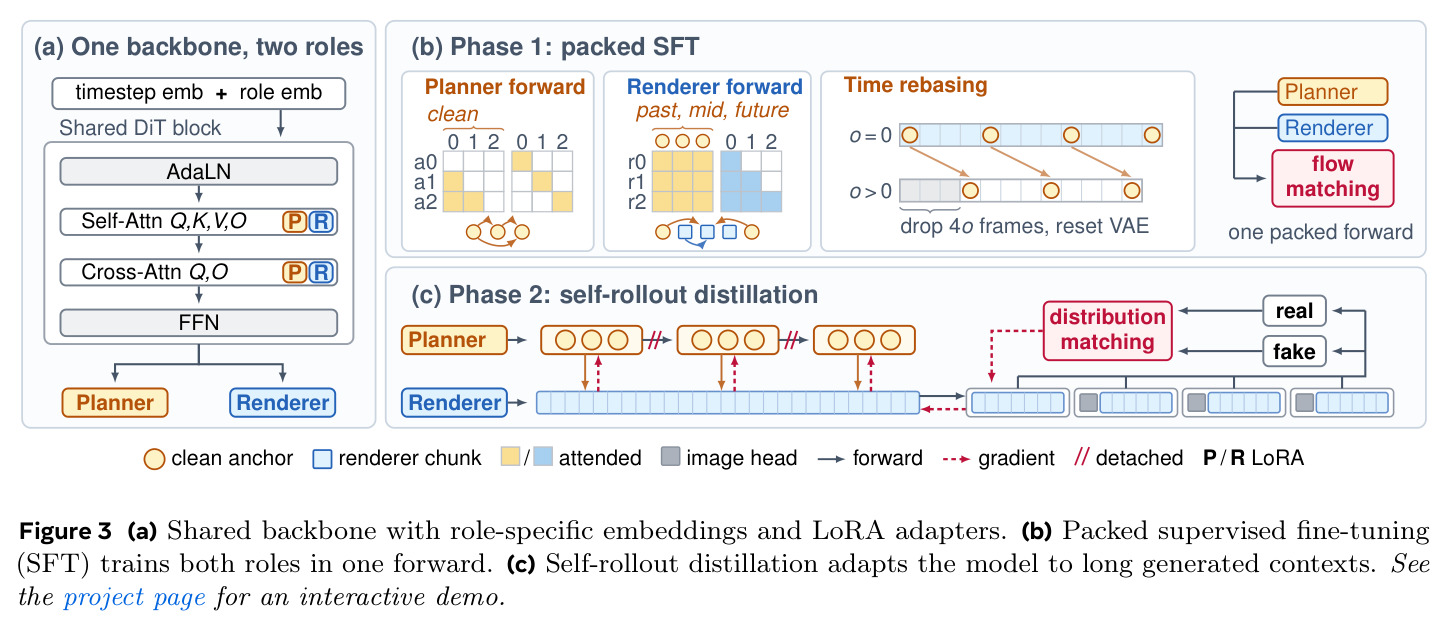
LoRA 在冻结权重旁挂低秩增量矩阵 $\Delta W=BA$(秩远小于原维度),只训练增量参数,适配成本低。本文为 planner/renderer 两种角色各配一套 rank-256 LoRA(作用于自注意力 QKV/O 与交叉注意力 Q/O 投影),并用一个经 AdaLN 注入的零初始化角色嵌入向量区分子任务,让共享骨干分化出不同的时间依赖行为。
方法用单一 Wan2.1 骨干同时扮演规划与渲染两个角色,分工完全靠 LoRA+角色嵌入实现,训练与延迟评估(LoRA 合并)都围绕它展开。
分布匹配蒸馏(DMD)
一种少步蒸馏目标:维护一个可训练的"假分数"(critic)与冻结的"真分数"(教师),用两者速度预测之差构造分布匹配目标 $y=\hat{x}_0^{fake}-\hat{x}_0^{real}$,把学生少步 rollout 的输出分布拉向教师多步采样分布,从而用极少步数逼近多步质量。Self-Forcing 等方法均采用此类目标。
第二阶段训练用 DMD 把打包 SFT 模型蒸馏成 4 步、guidance-free 的生成器,且蒸馏会放大 planner/renderer 输出统计差异(接缝问题的根源),是复现训练必需的概念。
研究动机
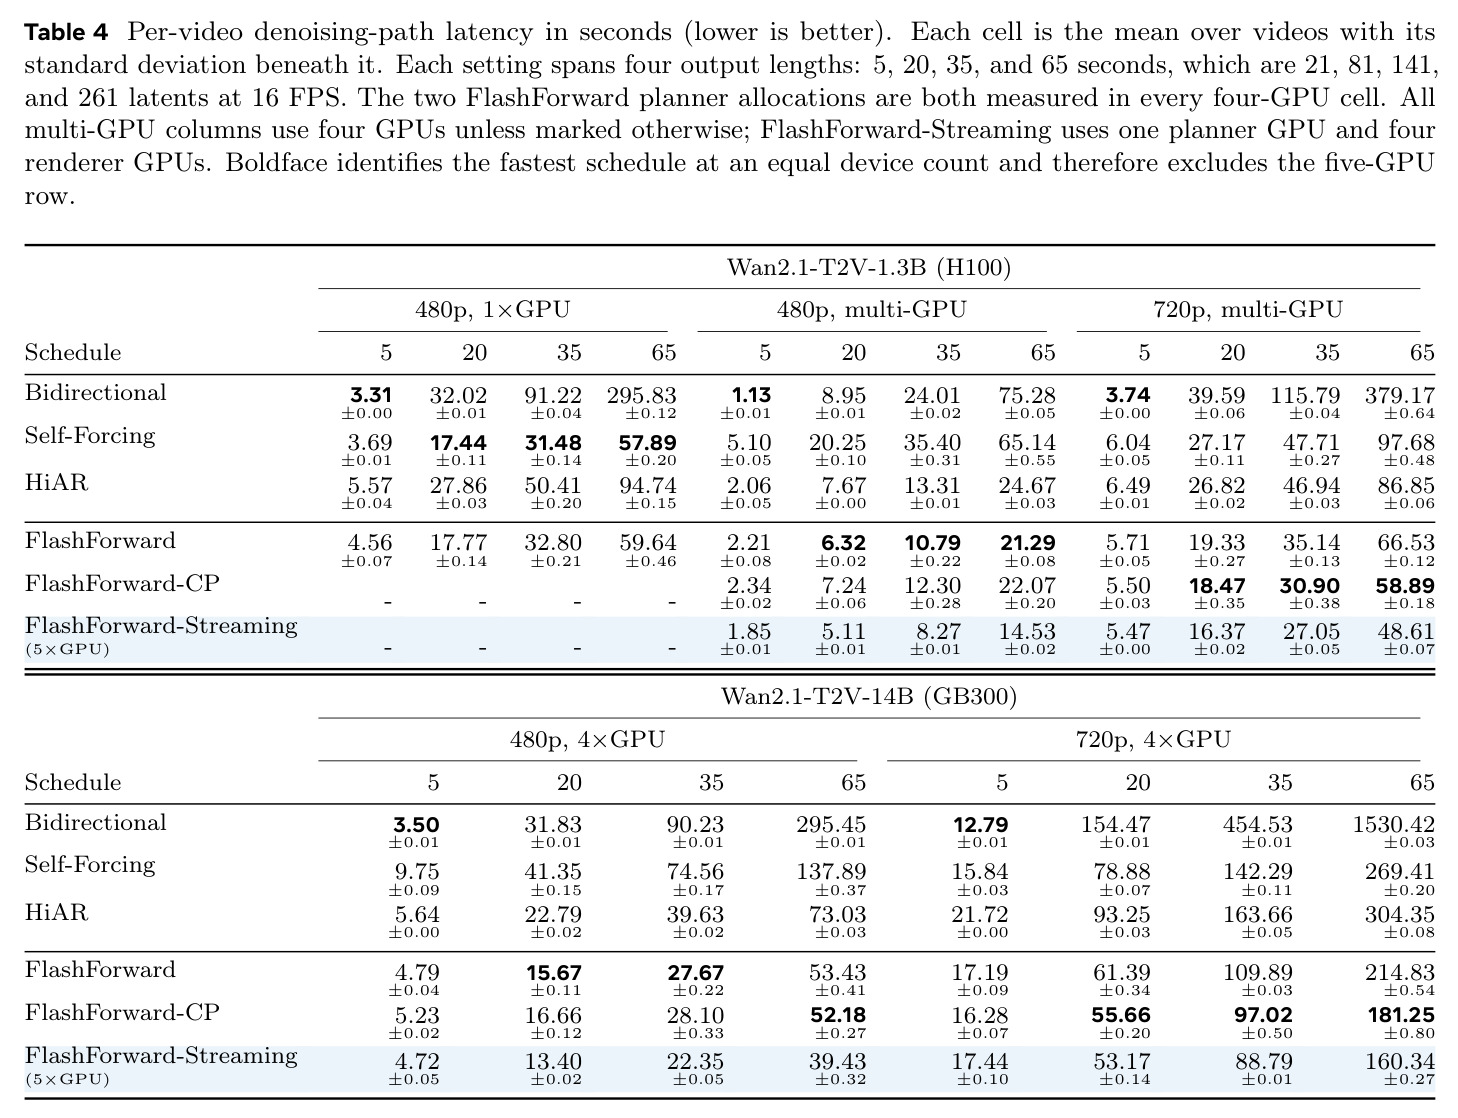
少步自回归视频扩散把长视频切成时间块逐块生成,块间靠 KV 缓存传递记忆。为了让后续块拿到"干净"或"低噪"的历史,现有方法必须执行不推进输出的缓存更新专用前向:Self-Forcing 在每块完成后把干净输出重编码 1 次(每块 1 次),且串行依赖使各块无法重叠执行;HiAR 为了让不同块在不同去噪阶段上流水线化,每个阶段都重新编码一次被消费的前驱(每块 $S=4$ 次)。这些前向只建缓存、不产出内容。随着蒸馏把块内去噪压到 4 步,块内计算骤减,这类开销占比急剧上升:例如生成 65 秒 480p 视频,Self-Forcing 四卡需 65.14 s、HiAR 需 24.67 s,而理论下界(双向 4 卡)为 75.28 s(1 卡 295.83 s),专用于建缓存的计算已成为长视频生成延迟的主要瓶颈。
本文的目标是本文要重新设计"跨块状态契约"——每个块发布什么表示、处于什么噪声水平、何时可被后续块消费——把构造记忆的计算完全合并进推进输出的普通前向,同时不牺牲长视频的时间一致性。具体目标有三:(1) 每个普通去噪前向在推进当前块的同时就发布同阶段 KV,使不同块能被分配到不同去噪阶段的不同 GPU 上并发执行(波前流水线),且零专用前向;(2) 针对该早期可用状态"噪、只见过去"的缺陷,用稀疏干净锚点提供过去与未来两侧的粗粒度结构约束;(3) 在 1.3B 与 14B 骨干、480p/720p 分辨率上验证延迟收益,并用 VBench 证明质量不降反升。
与已有工作不同的是,已有工作把跨块记忆当作"表示去噪程度"的选择题(干净 vs 低噪),本文将其重构为"状态可用性"问题:可用时机决定了依赖图与可并行性。这一视角转换暴露了一个此前未被利用的事实——每个去噪前向本来就会算出当前块的 in-flight KV,把它直接发布给后续块在同一阶段复用即可,无需任何专用前向。在 Tab. 1 的设计空间中,这是唯一既由"推进输出的前向"发出、又足够早可被跨阶段流水线消费的记忆。为补偿其噪声与只见过去的缺陷,作者又把"先规划关键帧再填充"(plan-then-infill)的稀疏两面条件化改造成粗时间尺度的干净锚点 KV,与细尺度的同阶段历史按时间尺度分工互补,这种"稀疏干净+密集噪声"的双记忆结构在之前的自回归扩散方法中尚未出现。
核心方法
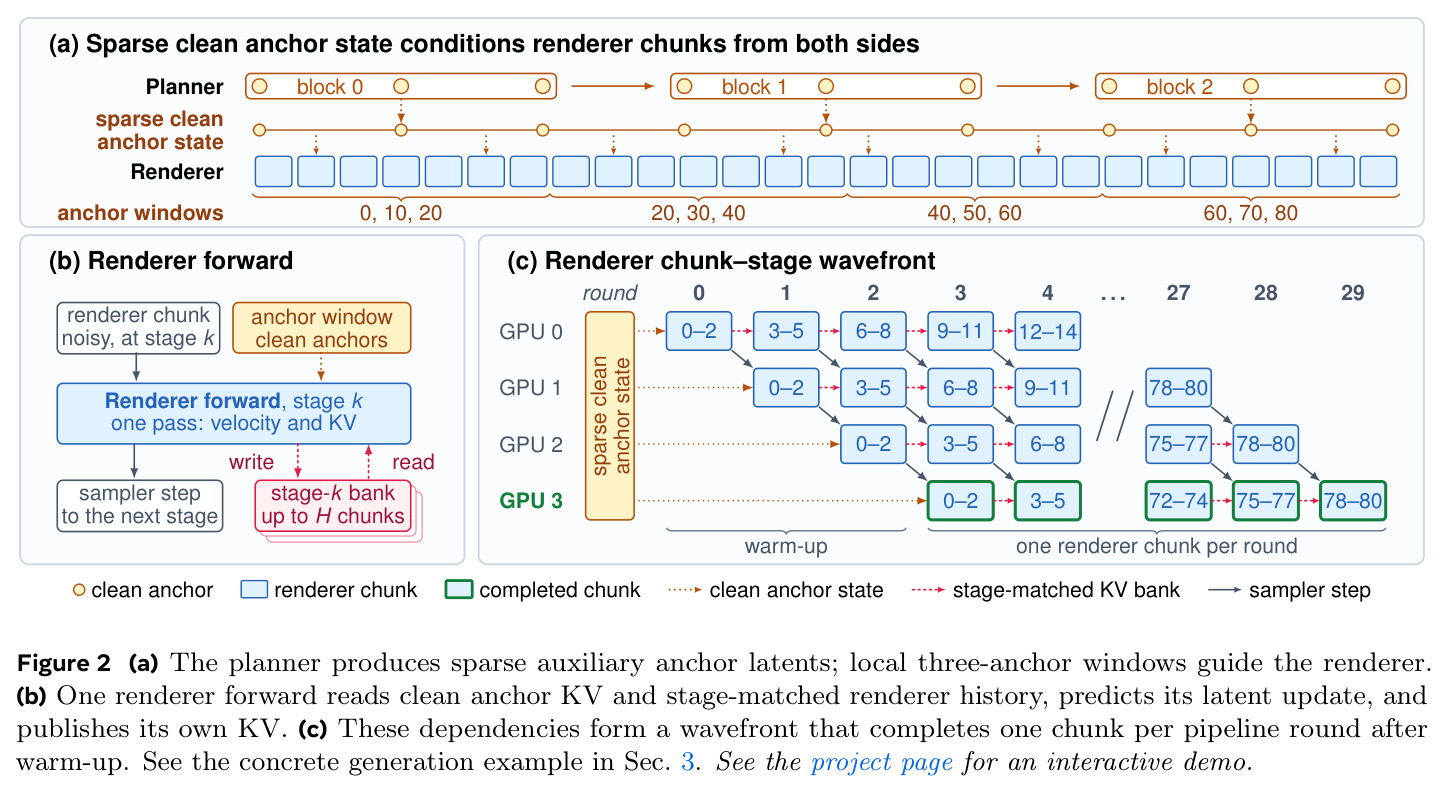
直觉上,FlashForward 让"记忆"成为"生成"的副产品:渲染器每一次普通前向既把当前块从 $\sigma_k$ 推进到 $\sigma_{k-1}$,也顺手把自己的 KV 写入第 $k$ 阶段的历史库,后续块走到同一阶段时直接读取,于是任何专用于更新缓存的前向都不再需要。由于每个块在第 $k$ 阶段的输出会被下一块在第 $k$ 阶段读取,块与阶段之间自然形成反对角线波前:给 $S=4$ 个阶段各分配一张 GPU,热身后每轮流水线恰好完成一个块。代价是这种"阶段匹配历史"来自未完成的噪声块且只看过去,单独使用会造成外观与运动漂移;为此引入 planner 角色,提前生成稀疏的干净锚点 latent(步长 $\Delta=10$),并在每个局部区域生成前完成干净锚点 KV 提取,为渲染器提供过去与未来两侧的粗结构参照。技术路线上,单一 Wan2.1 骨干通过角色嵌入与 LoRA 分饰 planner/renderer 两角,训练分两阶段:真实视频上的打包 SFT 建立两角色的依赖关系,自展开分布匹配蒸馏适配 4 步生成。
核心创新是把跨块状态从"事后重建"改为"在途发布"。对比 Tab. 1:Self-Forcing 要等块完成后经一次专用前向才发布干净 KV(每块 1 次专用前向,串行);N-C-Causal-rCM 复用最后一次去噪的 KV 免去专用前向,但要等前驱到最后阶段才可用(仍串行);HiAR 在每个阶段重编码被消费前驱(可重叠,但每块 $S$ 次专用前向)。FlashForward 则让普通前向同时完成去噪与发布:$\tilde{v}^R_{i,k},K^R_{i,k},V^R_{i,k}=F_{\theta R}(x^R_{i,k},c,\tau_k;A_{\Gamma(i)},B^i_k)$,且 $B^{i+1}_k=\mathrm{Tail}_H(B^i_k\cup(i,K^R_{i,k},V^R_{i,k}))$——专用前向数为 0,同阶段依赖自动导出可并发的波前。第二层创新是时间尺度分工:稀疏干净锚点 KV 提供长程双向的粗结构(一个 planner 块推进 30 个 latent,自回归深度比渲染器的 3 个 latent 缩短约 10 倍),密集同阶段历史提供近程精细演化;噪声但即时的记忆与干净但稀疏的记忆互补,兼顾效率与长程一致性。
方法步骤详情
以 81 个 latent 的生成为例($B_P=B_R=3$,$\Delta=10$,$W_{ctx}=21$):第一步规划,planner 自回归地逐块(每块 3 个锚点)去噪生成位置 $\{0,10,\ldots,80\}$ 的 9 个干净锚点,每完成一块执行一次干净端点缓存提取前向(planner 唯一的额外前向),把干净锚点 KV 追加进库 $A$。第二步渲染,渲染器把 81 个位置切成 27 个 3-latent 块,块 $i$ 读取两侧锚点窗口 $\Gamma(i)=\{2u\Delta,(2u+1)\Delta,(2u+2)\Delta\}$ 的干净 KV 与最近 $H=5$ 个前驱块的同阶段历史 $B^i_k$,一次前向输出速度 $\tilde{v}^R_{i,k}$ 用于从 $\sigma_k$ 步进到 $\sigma_{k-1}$,同时按 Eq. (2) 发布自身 KV。第三步波前调度,4 张 GPU 各管一个阶段,节点 $(i,k)$ 依赖 $(i,k+1)$ 的更噪输入与 $(i-1,k)$ 的历史,共 $N_R+S-1$ 轮,热身后每轮产出一个块。训练分两阶段:Phase 1 打包 SFT 在一条 20 秒真实视频上单次前向同时训练两角色——planner 对干净早块做因果注意,renderer 对干净锚点与 5 个前驱同噪块注意,并做时间重定基增强(每步采 4 个偏移各裁出 71 个 latent、8 个锚点);Phase 2 自展开蒸馏先完整 rollout planner+renderer,随机选退出阶段 $k^\star$ 做梯度截断,再用冻结 Wan2.1-14B 真分数(CFG 3.0)与可训 1.3B critic 做分布匹配蒸馏,分数窗口 $W_{score}=21$ 分 4 块瓦片并在后续瓦片前拼接解码再编码的图像头。
技术新颖性
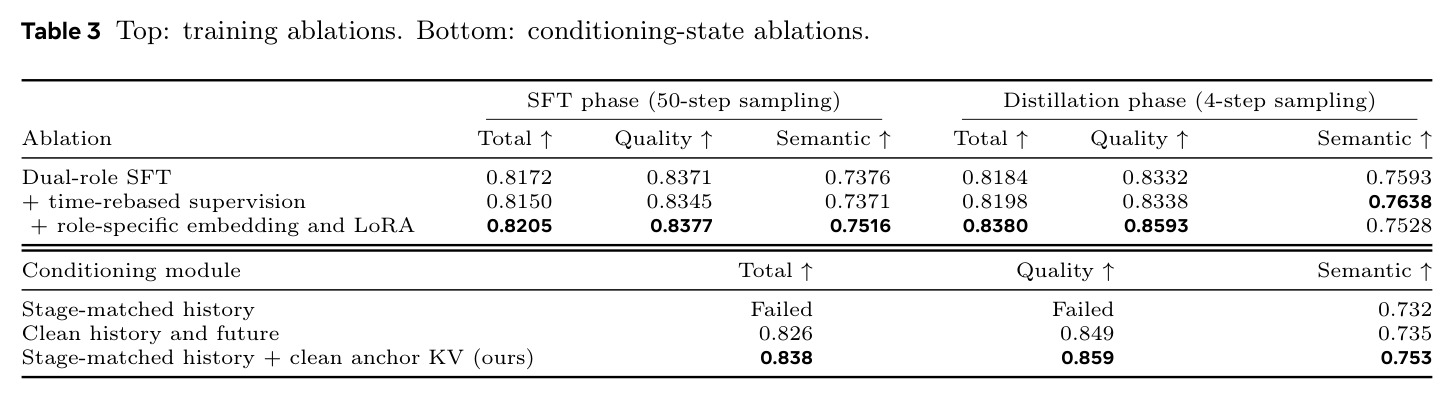
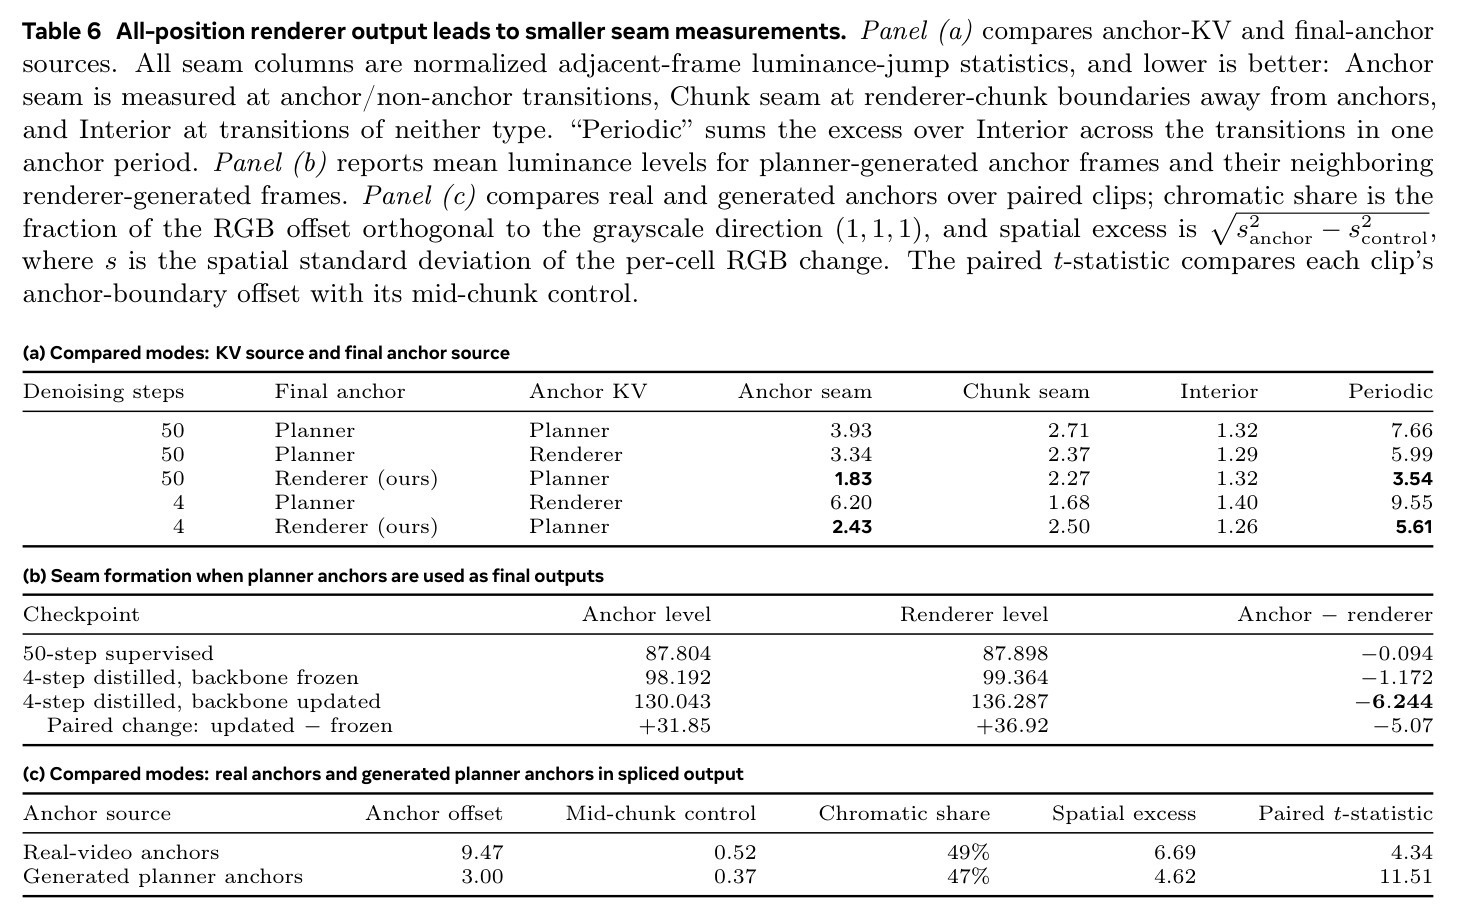
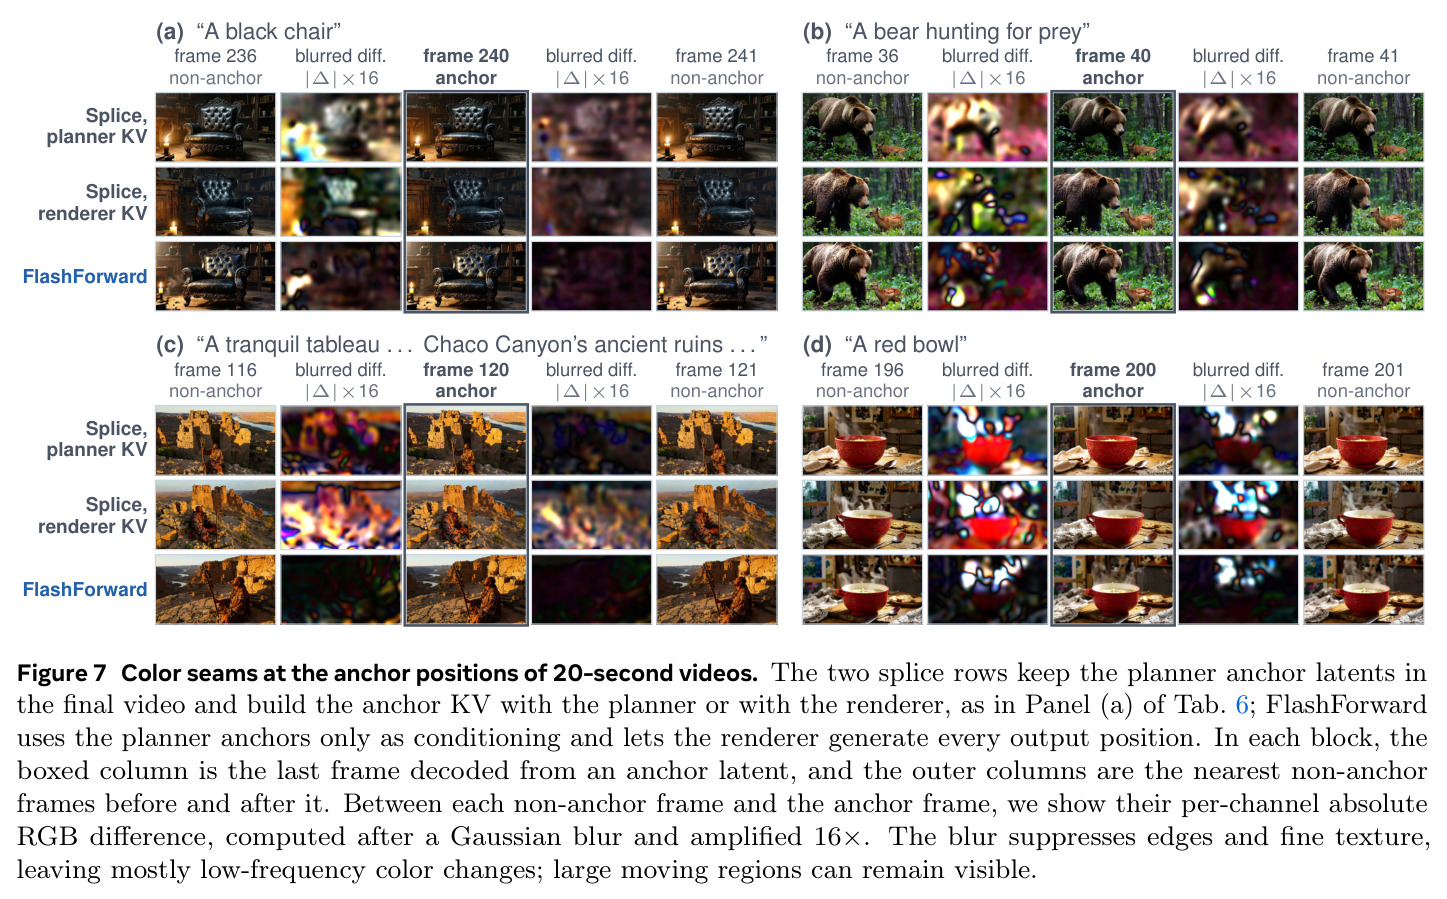
技术新颖性有四层。(1) 概念层面:首次把自回归扩散的块间记忆显式形式化为"跨块状态契约"(发布什么、什么噪声水平、何时可用),用它统一解释 Self-Forcing、N-C-Causal-rCM、HiAR 与本文的执行差异(Tab. 1),指出可用时机而非噪声水平决定依赖图与可并行性。(2) 系统层面:"在途 KV"复用近乎零成本——缓存写入本就发生在输出推进前向内部,把专用前向降为 0 的同时自动获得阶段级流水线;HiAR 的反对角调度需要每阶段重编码维持,而这里由同阶段依赖直接导出,无需重编码。(3) 表示层面:把 plan-then-infill 的两面条件化改造成与密集噪声历史互补的粗尺度干净状态,且锚点仅作条件、最终输出全部由渲染器再生成,避免跨角色输出拼接的周期性接缝(附录 B 定量验证:4 步时拼接式 anchor seam 6.20 vs 本文 2.43)。(4) 训练层面:打包 SFT 在单次前向内训练两个角色并用时间重定基扩大监督范围;蒸馏阶段刻意保留渲染器到锚点的 KV 梯度通路,作为生成损失训练 planner 的唯一路径。
实验结果
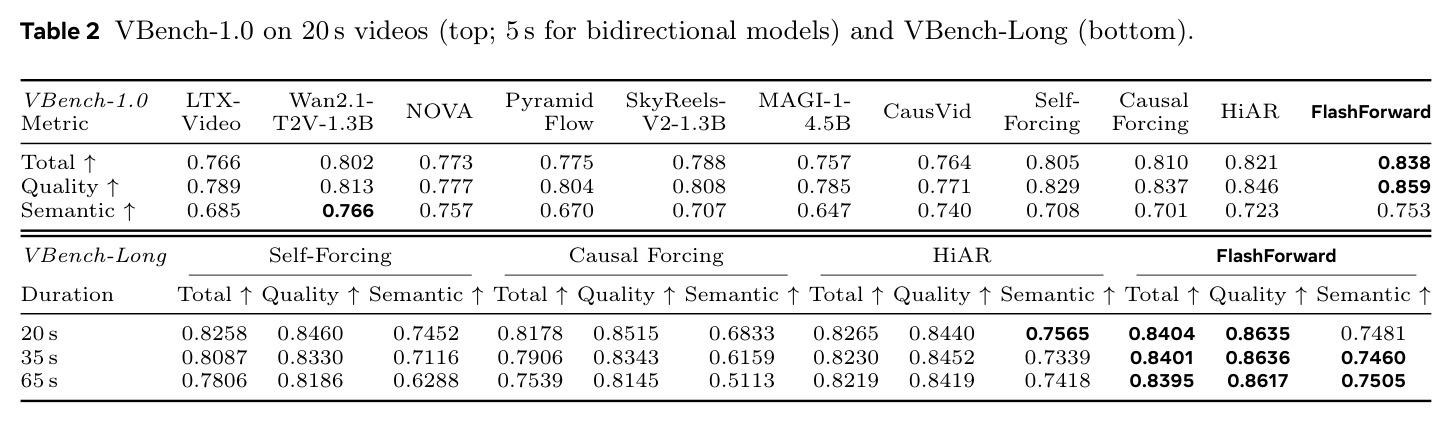
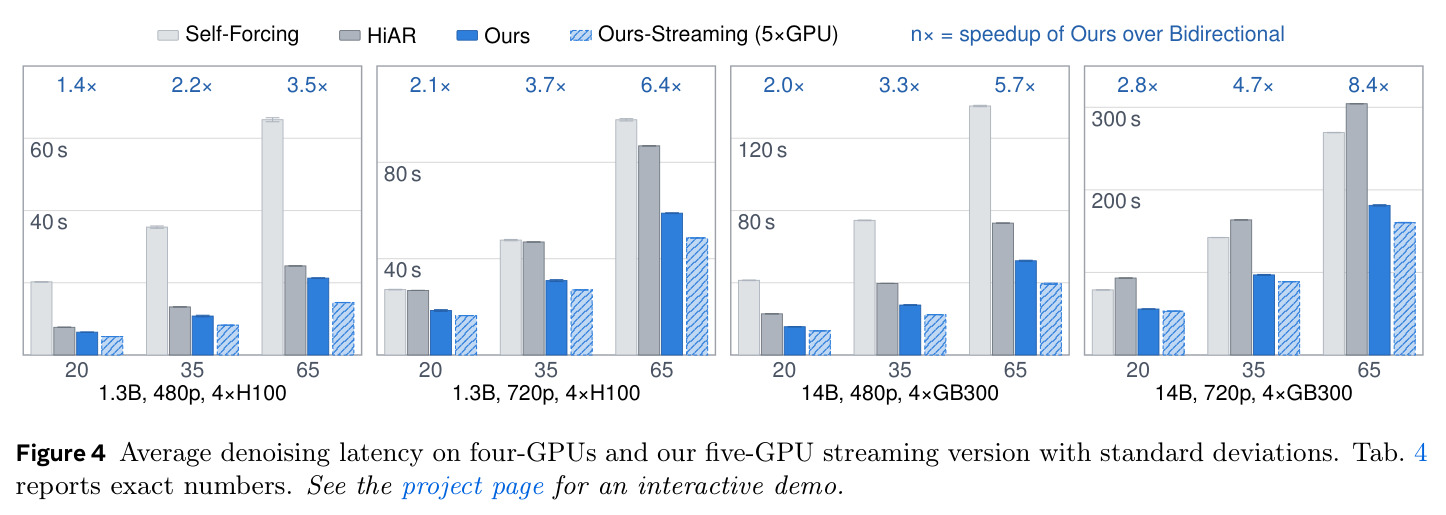
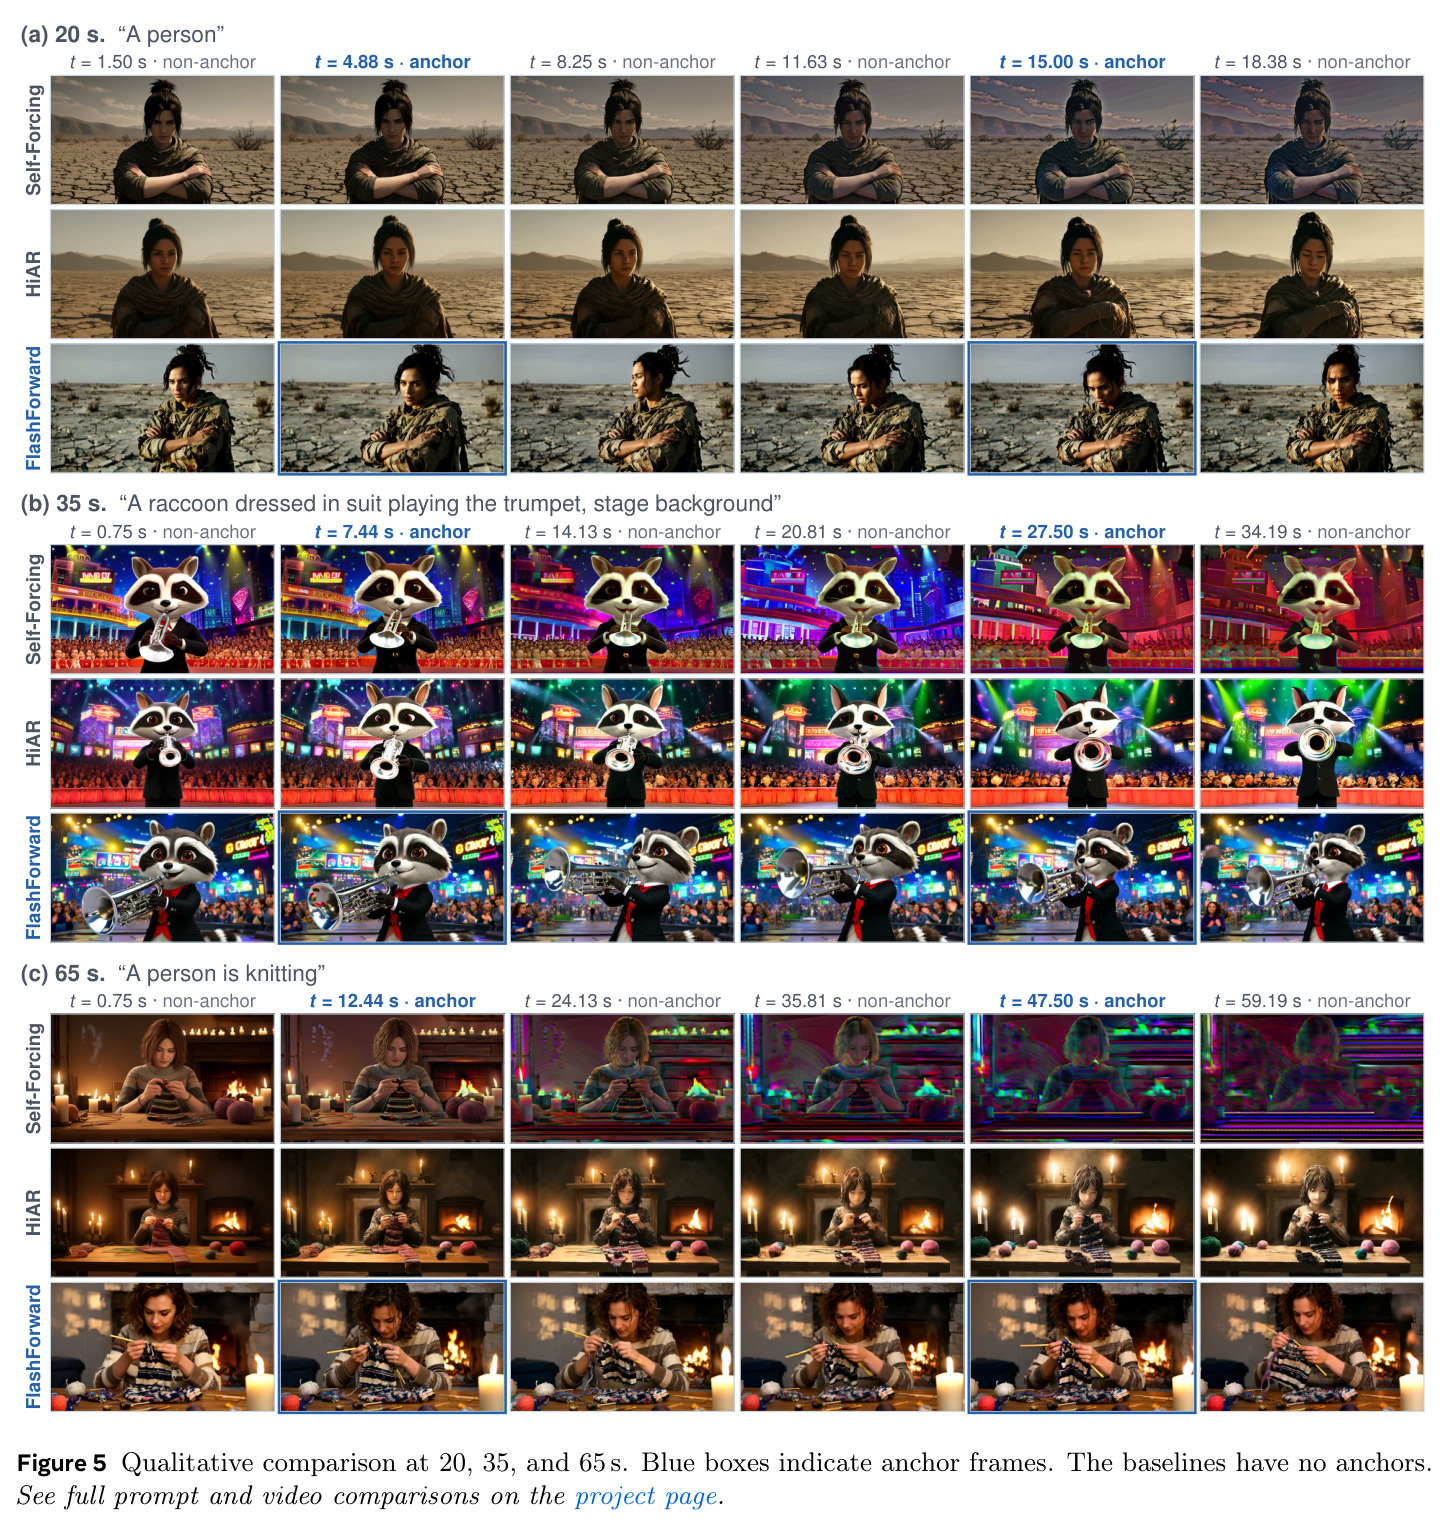
速度方面(Tab. 4、Fig. 4):20 秒及以上的所有模型-分辨率设置中,四卡下 FlashForward 都是最快的自回归调度,比 HiAR 快 1.16–1.69×,比 Self-Forcing 快 1.42–2.92×。具体地,1.3B/480p/4×H100 生成 65 秒视频需 21.29 s(HiAR 24.67 s、Self-Forcing 65.14 s、双向 75.28 s);14B/720p/4×GB300 需 214.83 s,CP 版 181.25 s(HiAR 304.35 s、Self-Forcing 269.41 s、双向 1530.42 s);65 秒时相对双向生成提速 3.54–8.44×。单卡下虽无波前并行,仍比 HiAR 快 1.54–1.59×(省去专用前向),但比 Self-Forcing 慢 1.9–4.2%(四个阶段都要维护历史库的开销)。理论前向计数上 81 latent 时 FlashForward/Self-Forcing/HiAR 分别为 123/134/212 次;流式 5 卡版把 planner 与渲染重叠,1.3B 再快 1.18–1.47×、14B 快 1.15–1.36×,且 anchor_wait 稳定在首块成本(480p 约 0.51 s),说明 planner 稳态完全隐藏在渲染之下。质量方面(Tab. 2):VBench-1.0 20 秒 Total 0.838,高于 HiAR 0.821、Causal Forcing 0.810、Self-Forcing 0.805;VBench-Long 上 20/35/65 秒 Total 为 0.8404/0.8401/0.8395 几乎不衰减,而 Self-Forcing 从 0.8258 跌至 0.7806、Causal Forcing 跌至 0.7539。消融(Tab. 3)显示角色嵌入+LoRA 把蒸馏后 Total 从 0.8184 提至 0.8380;条件模块消融中仅用阶段匹配历史会闪烁到 VBench 无法打分,仅用干净历史则是高延迟的"变体 Self-Forcing",两者结合才达到 0.838。附录 B 证明渲染器重生成锚点位置使 4 步 anchor seam 从 6.20 降至 2.43。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VBench-1.0 长视频质量(1.3B, 480p, 20s) | Total | 0.838 | HiAR 0.821 / Self-Forcing 0.805 | +0.017 / +0.033 |
| VBench-Long(65s 视频) | Total | 0.8395 | HiAR 0.8219 / Self-Forcing 0.7806 | +0.0176 / +0.0589 |
| 去噪延迟(1.3B, 480p, 4×H100, 65s 视频) | 秒(越低越好) | 21.29 s | HiAR 24.67 s / Self-Forcing 65.14 s / 双向 75.28 s | 快 1.16× / 3.06× / 3.54× |
| 去噪延迟(14B, 720p, 4×GB300, 65s 视频) | 秒 | 214.83 s(CP 版 181.25 s,流式 160.34 s) | HiAR 304.35 s / Self-Forcing 269.41 s / 双向 1530.42 s | 快 1.68× / 1.49× / 7.07×(CP) |
| 流式生成(1.3B, 480p, 5×GPU, 65s) | 秒 | 14.53 s | 四卡 FlashForward 21.29 s / 双向 75.28 s | 快 1.47× / 5.18× |
| 逻辑前向计数(81 latents, S=4) | 次 | 123 | Self-Forcing 134 / HiAR 212 | 较 HiAR 减少 42%,理论加速上界 1.72× |
局限与改进
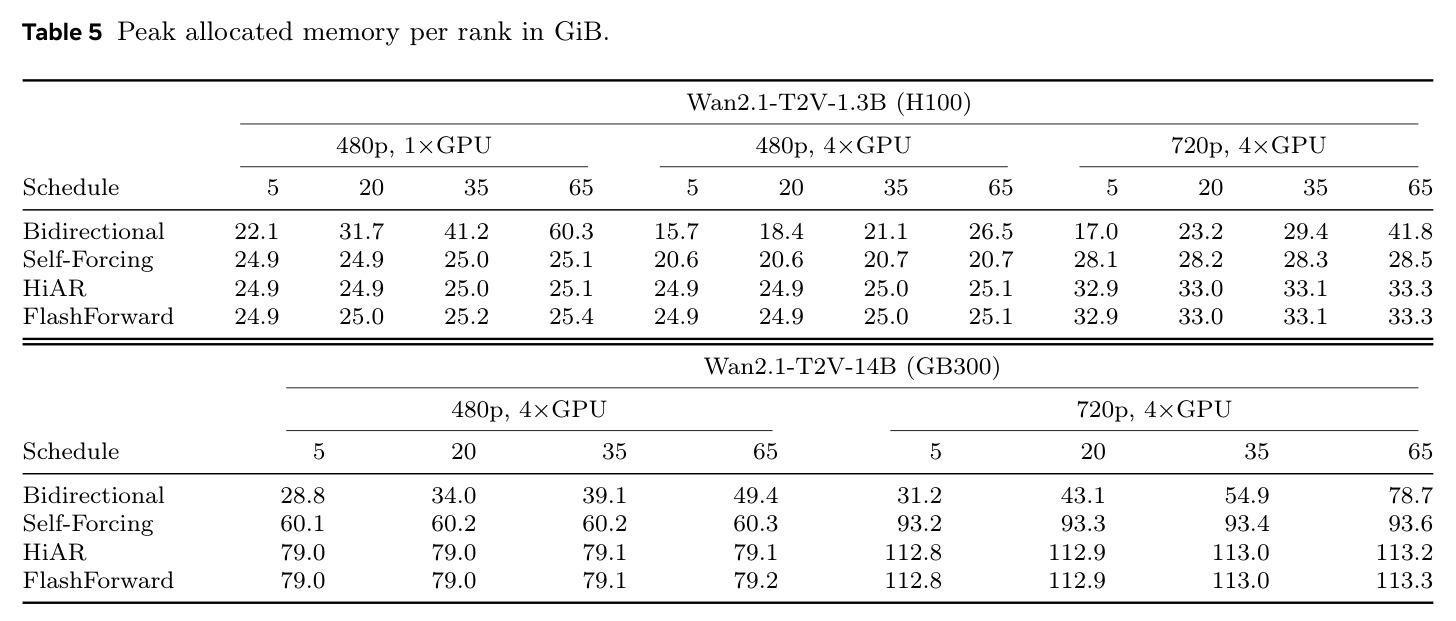
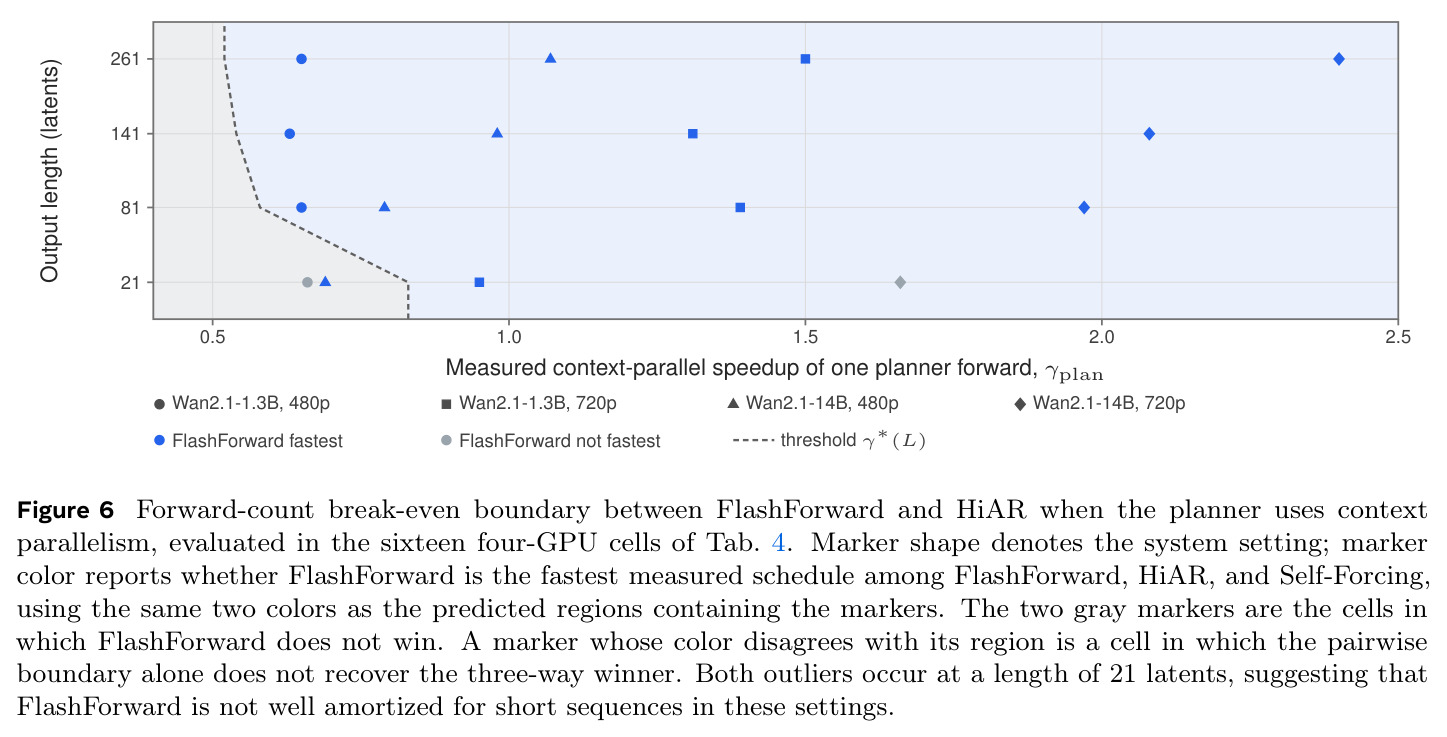
作者承认的局限:方法面向多 GPU 上的长序列少步生成,planner 前置与 $S-1$ 轮流水线热身削弱了短视频收益(5 秒/21 latent 设置中双向基线在全部五个系统中最快);单卡无法利用波前并行;训练数据只有真实世界视频,偏向照片级内容,动画与风格化域可能受限;锚点步长 $\Delta=10$、条件窗口与训练配方固定,干净锚点状态假设未放松,自适应锚点选择留作未来工作。我自己的观察:(1) planner/renderer 两套合并后权重不能同时驻留,角色切换需 0.10–0.17 s 的主机内存换入换出,部署复杂度高于数字表面暗示;(2) 14B 行是"仅系统级计时"——用相同张量形状与调度实例化 14B 骨干测延迟,未报告 14B 质量指标,速度结论不能直接外推为质量结论;(3) $W_{ctx}=21$ 的固定预算在剧烈场景切换或多主体场景下是否足够缺乏分析;(4) Semantic 分数(0.753)虽是蒸馏自回归方法中最高,但与 Quality(0.859)的差距提示复杂语义遵循仍是短板;(5) 显存上 14B 720p 每卡峰值 113 GiB,远高于双向基线的 78.7 GiB,对小显存部署不友好。
独立分析的弱点
(1) 短视频无优势:planner 完整 rollout 前置加上 $S-1$ 轮热身,使 5 秒视频成为可比方法中较慢的选择之一;改进方向是更小的块/更少的阶段,或让 planner 更早与渲染交叠(流式版已部分缓解)。(2) 噪声历史的风险未充分量化:阶段匹配历史只保留 $H=5$ 块,误差可在窗口内传播,论文只给定性对比与 VBench 分数,缺少 65 秒以上(如 5 分钟级)的时程压力测试与灾难性失败率统计。(3) 固定锚点步长:$\Delta=10$ 由流式产销匹配决定,对相机大运动或场景切换可能过疏(结构约束不足)或过密(浪费算力),内容自适应或可学习的锚点调度是明显改进点。(4) 干净锚点并非真正可靠:planner 锚点由 4 步学生生成,其"干净 KV"若在早期块就漂移会被当作可信条件持续传播,可引入锚点置信度评估或渲染后回写修正。(5) 单卡场景收益为负:比 Self-Forcing 慢 1.9–4.2%,因为四个阶段都要写历史库;可结合 KV 压缩或只维护部分阶段的历史库来降低写开销。(6) 工程约束:合并 LoRA 后两个全量模型轮流驻留设备,14B 720p 每卡需 113 GiB 且依赖 pinned host memory 与上下文并行实现,论文未全部开源这些工程细节时,外部复现延迟数字会打折扣。
未来方向
作者提出的:把跨块状态契约与 KV 选择/压缩/合并/切换策略正交结合;修改 RoPE 位置编码以更好适配阶段匹配历史;引入其他抗漂移技术;探索锚点界定区间的并行生成(借鉴 Xiang et al. 的分段并行范式);放松干净锚点状态假设、研究自适应锚点选择。基于成果可延伸的:(1) 把 planner–renderer 双角色推广为多分辨率或多噪声尺度的金字塔式记忆层级,进一步分离结构与纹理约束;(2) 将流式 5 卡版发展为真正的在线视频流生成——planner 领先渲染数块,可支持交互式续写与实时预览;(3) 在动画/风格化数据上微调以修正真实视频偏置;(4) 用状态契约分析框架重新审视 N-C-Causal-rCM 等免专用前向方法并组合两者优点;(5) 把干净锚点与语义级规划(字幕级关键帧描述)结合,针对性提升 Semantic 分数;(6) 探索单卡下的部分波前(2 卡 2 阶段)等中间配置,扩大适用硬件范围。
复现评估
复现难度中等偏上。有利因素:骨干 Wan2.1-T2V-1.3B 公开;训练与推理超参完整给出——LoRA rank 256、SFT 1800 步(batch 128、lr $10^{-5}$、AdamW $\beta_1=0$、EMA 0.999)、蒸馏 600 步(1:5 生成器/critic 比,即 100 次生成器更新,critic lr $10^{-6}$)、学生调度 $T_{student}=(999,937,833,624)$、flow shift 5.0、CFG 3.0,且 Alg. 1–3 给出完整伪代码;项目页(yikai-wang.github.io/FlashForward)有交互 demo 与视频对比。不利因素:训练数据为 256K Shutterstock 视频+生成字幕,非公开,需用 OpenVid/Panda 等替代;Phase 2 依赖冻结的 Wan2.1-T2V-14B 真分数,需要 14B 级推理算力(多张 A100/H100);延迟对比需 4×H100 或 GB300,且依赖上下文并行、LoRA 合并、权重换入换出等工程实现,论文未声明代码已开源,CP 通信与 pinned memory 细节缺失意味着端到端延迟数字难以精确对齐;14B 结果为系统级计时,复现者需自行实例化。总体判断:算法逻辑与小规模质量验证可在公开资源下近似复现,但完整延迟矩阵与 14B 结果的复现门槛很高。
论文图表
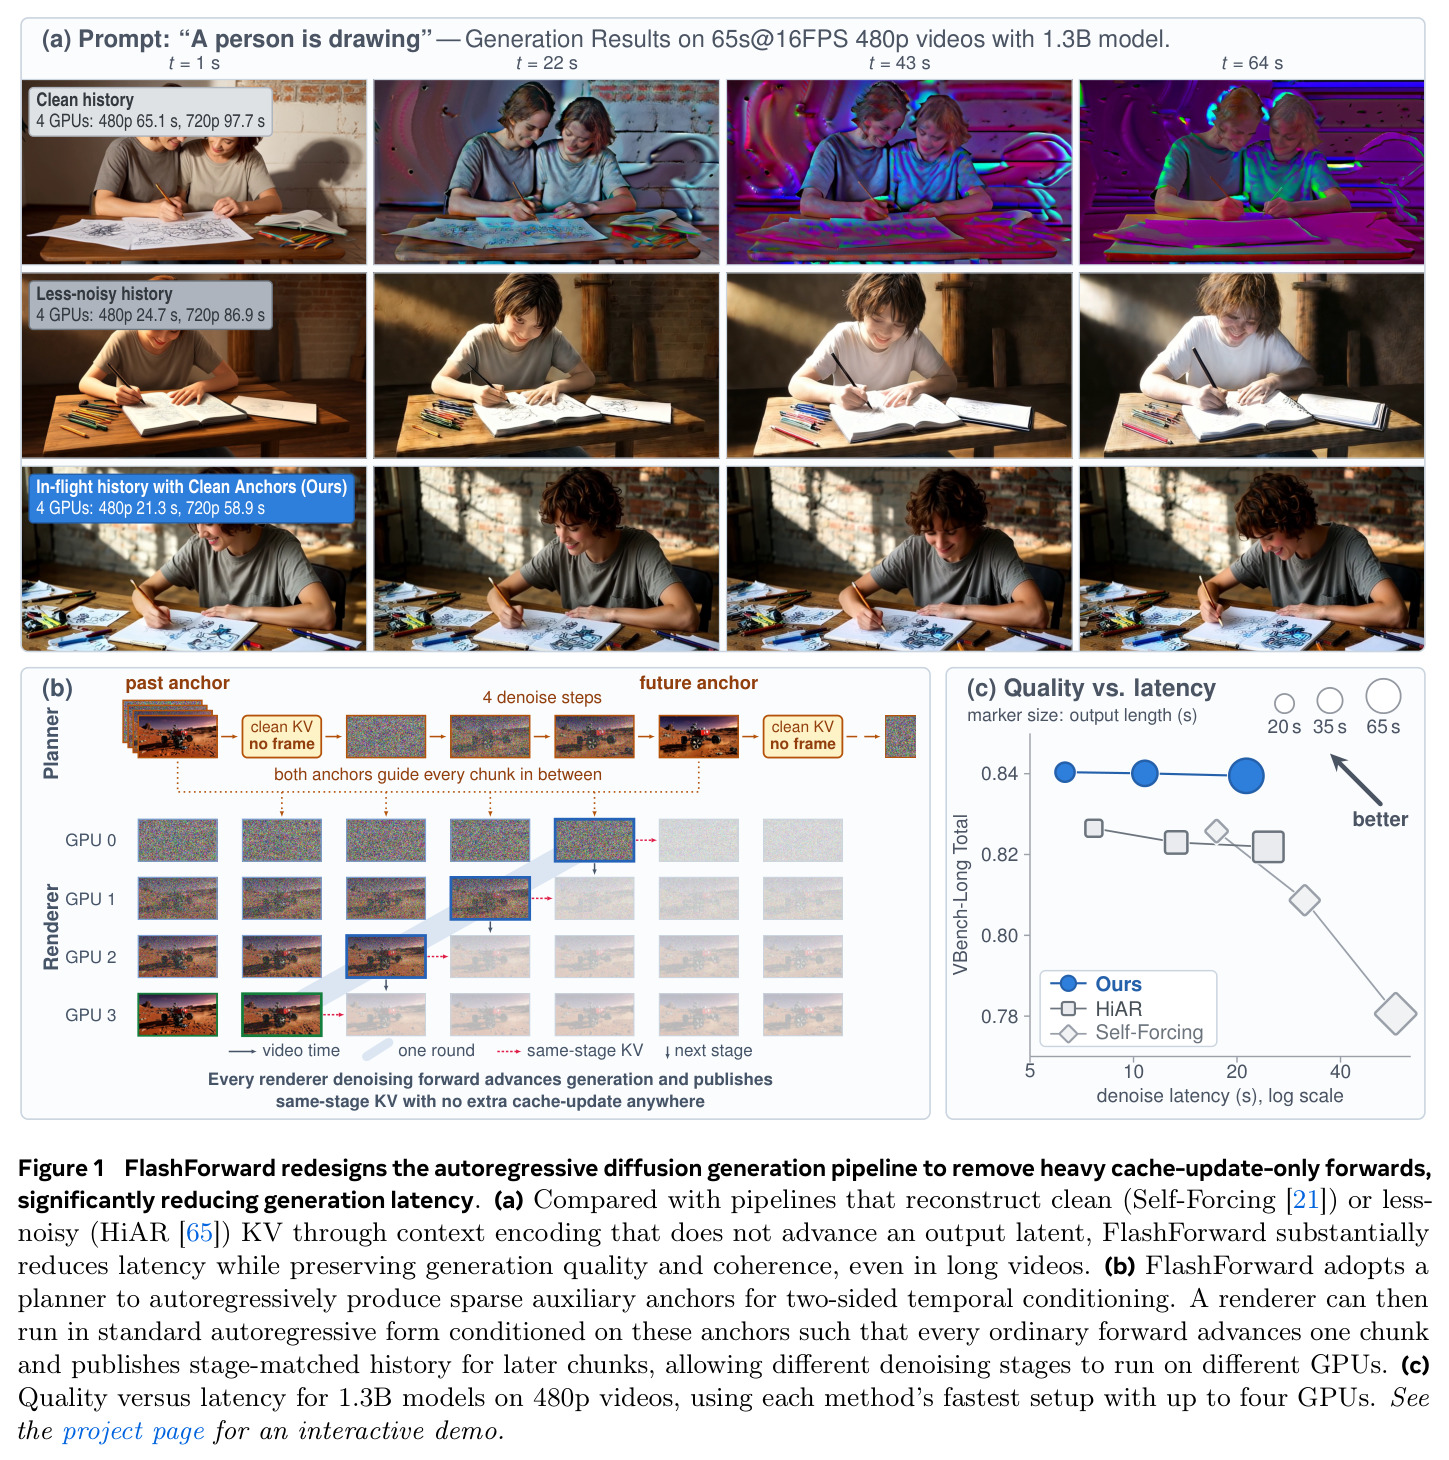
三联概览图:(a) 提示词"A person is drawing"下 65s@16FPS 480p 的三方法帧对比与 4 卡延迟——clean history(Self-Forcing 式)480p 65.1s/720p 97.7s,less-noisy(HiAR 式)24.7s/86.9s,本文 21.3s/58.9s;(b) planner-renderer 数据流:过去与未来干净锚点 KV 共同约束中间每个渲染块;(c) 1.3B 480p 的 VBench-Long 质量对去噪延迟散点图(log 轴),本文位于"更快且更好"的左上角。
一张图同时给出动机(现有管线的专用前向开销)、方法骨架(双锚点双侧条件化)与结果(质量-延迟帕累托优势),是向同事介绍这篇论文的最佳入口。