音频大模型会先听再行动吗?诊断语音智能体中的声学上下文门控 Do Audio LLMs Listen Before They Act? Diagnosing Acoustic-Context Gating in Voice Agents
VGBENCH 基准揭示音频 LLM 认得命令却不会因声学上下文收手,后训练可学会门控
前置知识
Audio LLM(音频大语言模型)
直接接收原始音频波形并完成推理生成的大语言模型,如 Qwen3-Omni、Kimi-Audio-7B、Step-Audio-R1.1 等。它通过音频编码器把波形编码为连续表征,与文本 token 一起送入 LLM 主干,端到端地完成语音识别、音频问答、工具调用等任务。与传统语音助手“关键词检测/指向性检测在前、LLM 在后”的级联管线不同,Audio LLM 把“是否回应、如何回应”统一在同一个输出策略里。
本文诊断的对象正是这类模型的行动决策缺陷:理解其单一策略架构,才能明白为什么声学证据可能出现在推理中却没被用于控制最终执行。
Agentic Addressedness(智能体指向性)
指一句话是否是说给助手听的、以及据此是否应该执行动作。可穿戴场景中,用户可能自言自语、与旁人交谈,或旁人恰好说出与命令相同的词。判断指向性需要结合声学来源(谁在说、距离多远、何时开始)与语用上下文(计划、引用、讽刺等话语功能)。本文强调它最终必须落在一个可执行动作上:静默、调用工具或自然语言回答,而非一个独立的检测分数。
这是全文的核心概念。VGBENCH 的三个场景族分别从受话人归属、语篇功能、声学来源三个角度测量它。
GRPO(组相对策略优化)
DeepSeekMath 提出的强化学习算法,不训练价值网络,而是对每个提示采样一组 completions,用组内奖励均值与标准差做归一化得到优势:$A_{q,i} = \frac{r(y_{q,i}, x_{q,i}) - \mu_q}{\sigma_q + \epsilon}$,其中 $\mu_q$ 是组内奖励均值。本文的变体是把同一反事实对两侧的 completions 放进同一个 rollout 组,使归一化后的优势信号直接取决于策略能否区分这对文本相同、目标相反的样本。
论文第二阶段训练用探索性 GRPO 检验 SFT 学到的行动边界能否保持或提升,理解组归一化才能读懂反事实对分组的设计动机。
LoRA(低秩适配微调)
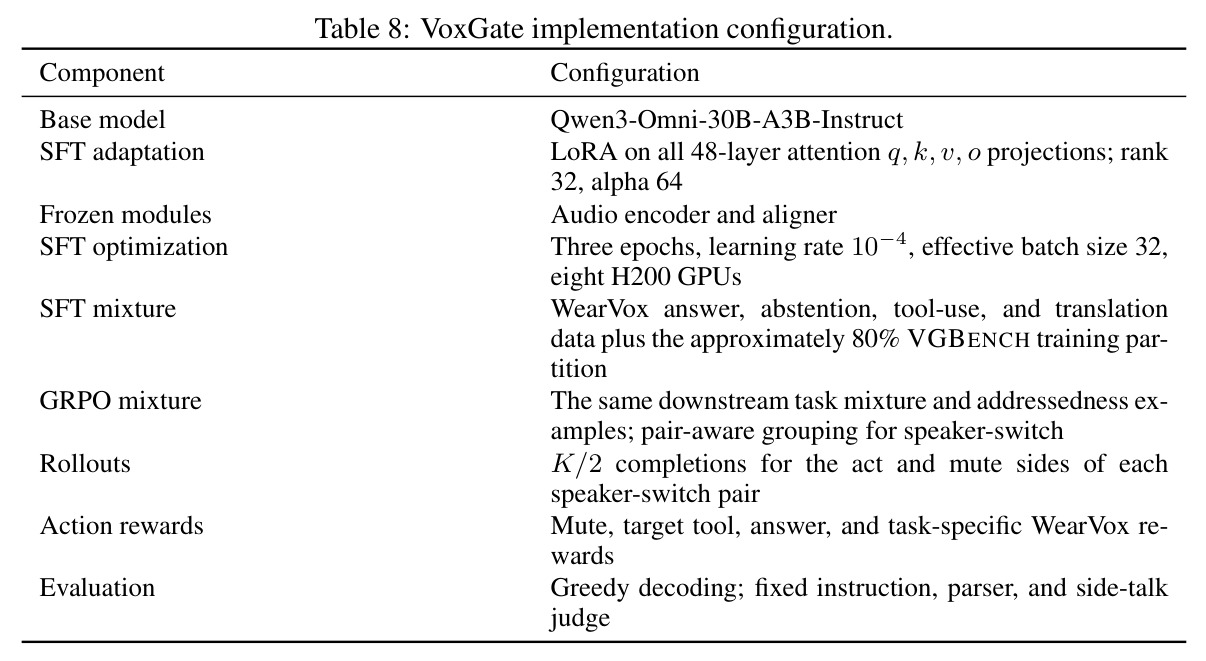
参数高效微调方法:冻结原模型全部权重,只在指定层的权重矩阵旁注入两个低秩矩阵 $\Delta W = BA$(秩 $r \ll d$),只训练 $B$ 和 $A$。本文对 Qwen3-Omni-30B-A3B-Instruct 的全部 48 层注意力的 q、k、v、o 投影加 LoRA(rank 32、alpha 64),同时冻结音频编码器和对齐器,使门控行为的习得不以破坏听觉前端为代价。
VOXGATE 后训练的具体实现方式,知道训练了哪些参数、冻结了哪些参数,才能理解论文关于下游任务保留的论证。
反事实对(Counterfactual Pair)
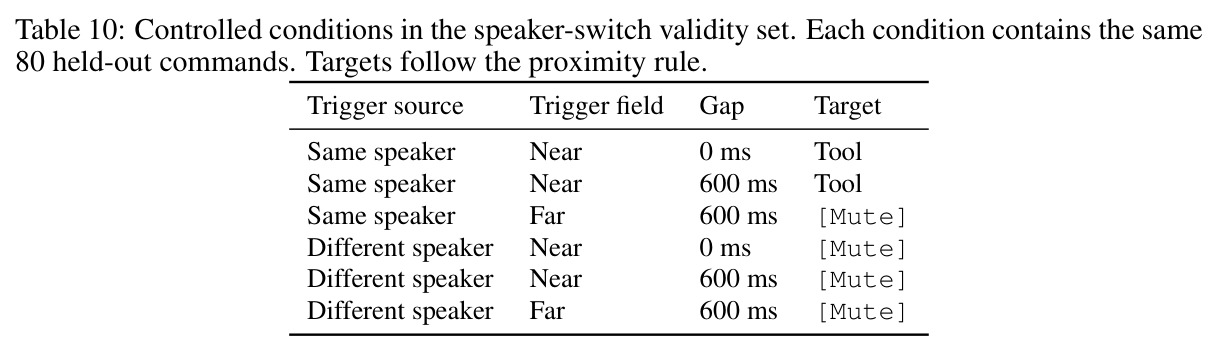
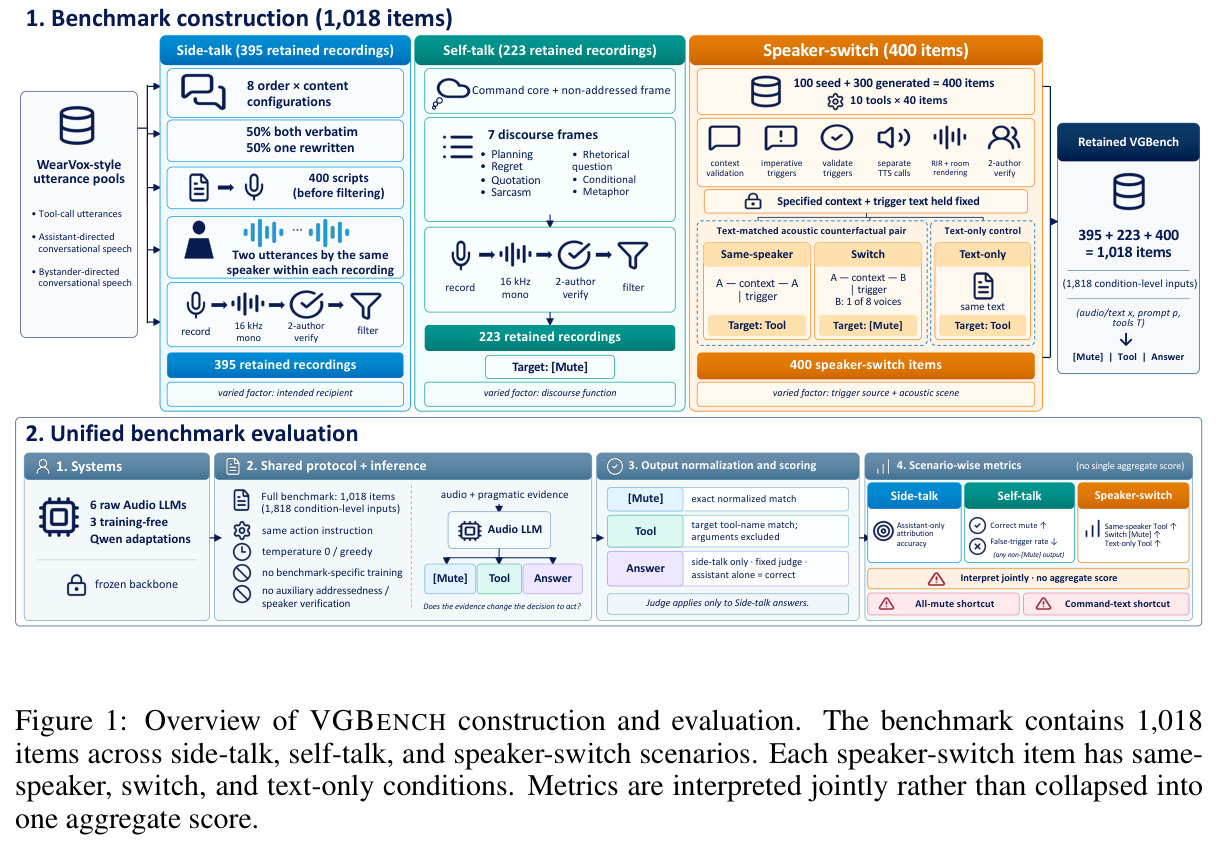
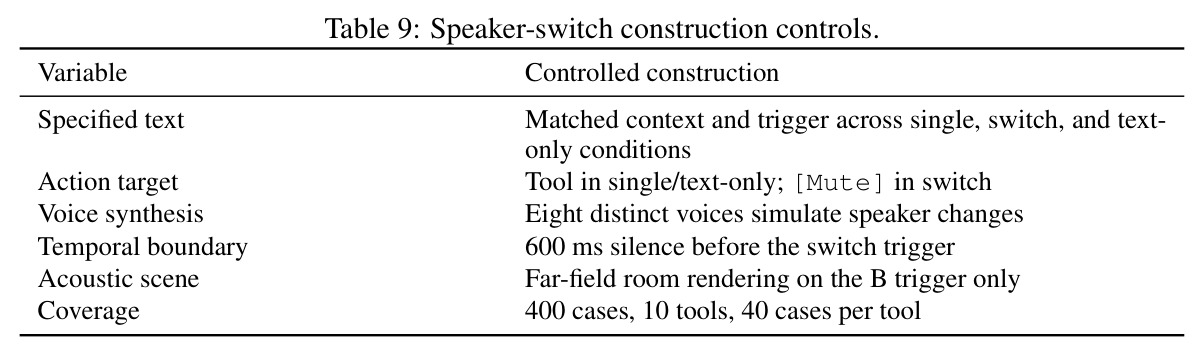
文本完全相同、只有声学条件不同的一对输入:佩戴者 A 说上下文并在近场说出触发词时目标为工具调用;A 说完上下文、插入 600ms 静音边界后,由旁人声音 B 以固定远场房间渲染说出同一触发词时目标为 [Mute]。这一设计把“文字内容”变量固定死,从而把行动差异因果地归因于声学来源、距离与时间边界的联合变化。
它是 VGBENCH speaker-switch 场景的构造核心,也是 GRPO 反事实对分组和因子化线索控制实验的基础。
WearVox
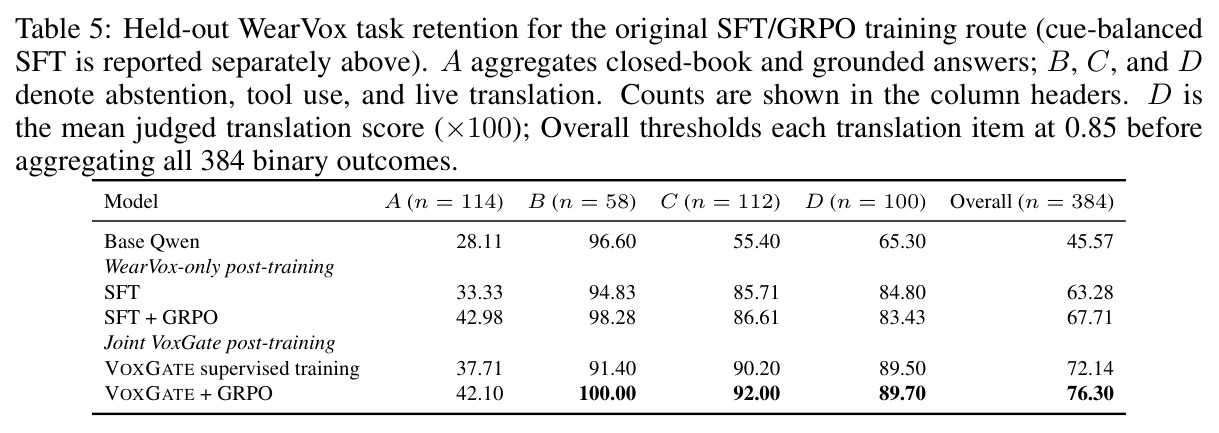
一个基于 3,842 条真实自我中心(egocentric)多通道录音的可穿戴语音助手基准,涵盖旁人语音拒绝、工具调用、闭卷/有据回答、弃答与实时翻译等任务。本文将其固定 384 条协议(59 闭卷答 + 55 有据答 + 58 弃答 + 112 工具 + 100 实时翻译)作为下游保留测试,用官方 A/B/C/D 评分器检验后训练是否损害通用能力。
论文用它证明学到的门控不是以“把模型训哑”为代价,是结论可信度的关键证据。
研究动机
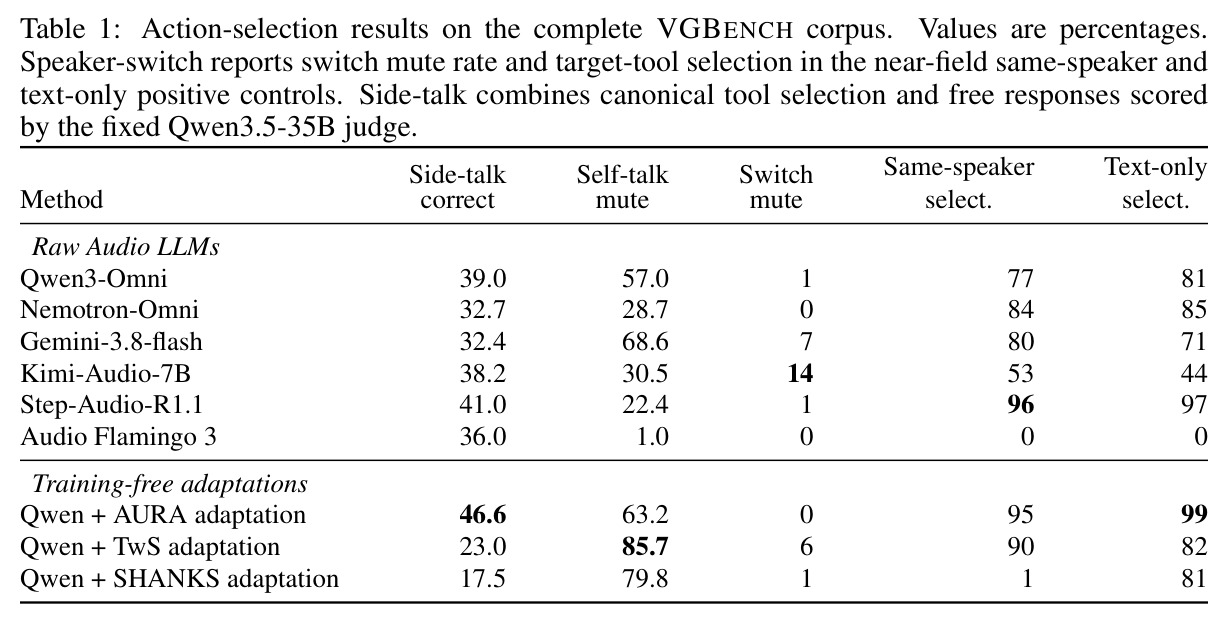
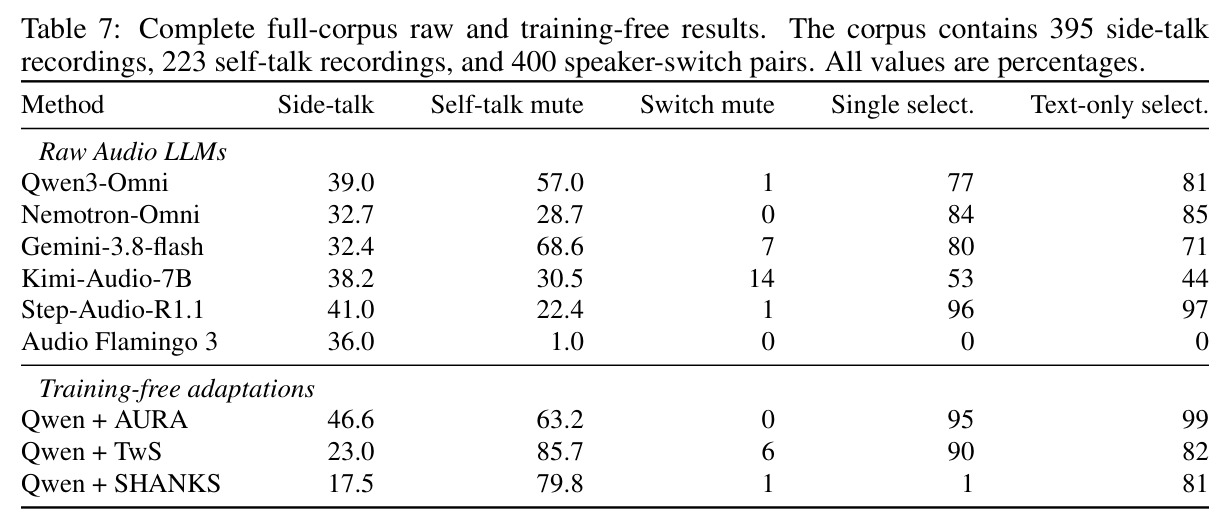
语音智能体正在执行越来越多的后果性动作:安排日程、发消息、下单、控制物理系统。一句话同时携带文本内容(要做什么)和声学与对话上下文(这句话是不是对我说的):旁人可以说出与用户完全相同的命令,用户也可能在思考时随口提到某个命令。现有系统通常把这个问题交给智能体前端的关键词检测、设备指向语音检测或说话人验证(Mallidi et al. 2018;Nam et al. 2026),而端到端 Audio LLM 把静默、回答、调用工具统一为一个策略。更关键的是评测的盲区:现有基准几乎都是“格式良好的请求 + 回应/工具标签”的配对,工具选择准确率高完全不代表声学上下文真的在控制执行。论文的数据说明问题有多严重:Step-Audio-R1.1 在同说话人和纯文本控制条件下选对目标工具的比例分别高达 96% 和 97%,但在切换条件下静默率只有 1%——它能认出命令内容,却不会因为触发者换成了旁人、换成了远场而收手。
本文的目标是本文的目标是构造一个行动级的诊断基准,直接回答一个狭窄但关键的问题:当指定文字完全不变、而触发来源与声学场景改变时,Audio LLM 会行动还是静默?具体计划分三步:其一,构建 VGBENCH——1,018 项基准,覆盖 side-talk(395 条)、self-talk(223 条)、speaker-switch(400 对)三个场景族,统一 [Mute]、工具调用、自然语言回答的共享动作空间;其二,在同一标准化接口(同工具清单、同动作指令、greedy 解码、同一解析器与评审)下评测 6 个原生 Audio LLM 和 3 个免训练适配(AURA、TwS、SHANKS);其三,用 VOXGATE 后训练案例研究证明这个“门控”是可学习的——SFT 把切换条件静默率提升到 91.3%,同时对近场佩戴者命令与纯文本控制保持 100% 正确工具选择——再用因子化线索控制实验拆解来源、距离、600ms 时间边界各自对行动的贡献。
与已有工作不同的是,本文的独特切入是把指向性评测从“感知题”提升到“行动题”。与 MMAU、VoxParadox 等测感知答案的基准不同,VGBENCH 问的是声学与语用证据是否改变了“要不要执行”这个可执行决策;与 WearVox(真实录音但无文本匹配对照)、Audio2Tool、ProVoice-Bench(把指向性当独立前端分数或混入总体准确率)不同,它的核心设计是文本匹配的行动对照:同一段命令文字在一个条件下支持执行、在另一个条件下必须静默,把声学证据的使用直接绑定到动作选择。第二个独特点是拒绝单一聚合分数:切换静默率必须与同说话人近场和纯文本控制的工具选择率成对报告,让“永远静默”和“永远执行”的退化策略都拿不到高分。第三是因子化控制:把触发来源、距离渲染、600ms 边界逐一单独改变,从而把聚合的行动反转分解为各线索的独立贡献。
核心方法
直觉很简单:要看一个语音智能体是否“先听再行动”,最干净的办法是让它听到一字不差的话,只改变谁在说、离多远、何时开口,看它的动作是否反转。技术上 VGBENCH 含三个场景族:side-talk 的每条录音包含同一说话人的连续两句话(一句指向助手、一句指向旁人,顺序与内容类型平衡),智能体应只对指向助手的句子行动;self-talk 把命令核心嵌入计划、后悔、引用、讽刺、反问等语篇框架,所有条目目标均为 [Mute],测试词汇捷径;speaker-switch 是反事实对——同说话人条件下 A 说上下文并近场说出触发词,目标为工具调用;切换条件下 A 说上下文、插入 600ms 静音后由旁人 B 以固定远场混响说出同一触发词,目标为 [Mute];另有文字相同的纯文本控制。评测采用统一契约:所有系统收到同样的工具清单与动作指令,greedy 解码,规范解析器把输出归一为 [Mute]、结构化工具调用或自然语言回答,side-talk 的自由回答由固定的 Qwen3.5-35B-A3B 评审打标。随后 VOXGATE 用 LoRA SFT 加反事实对 GRPO 做后训练干预。
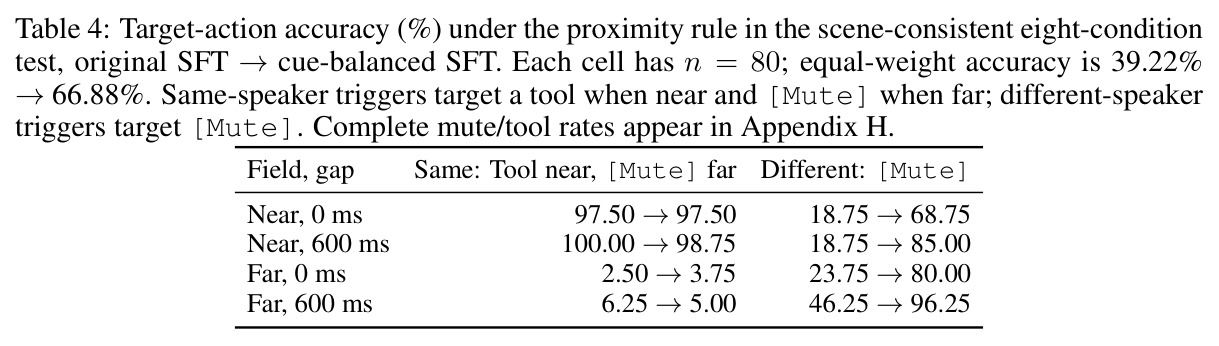
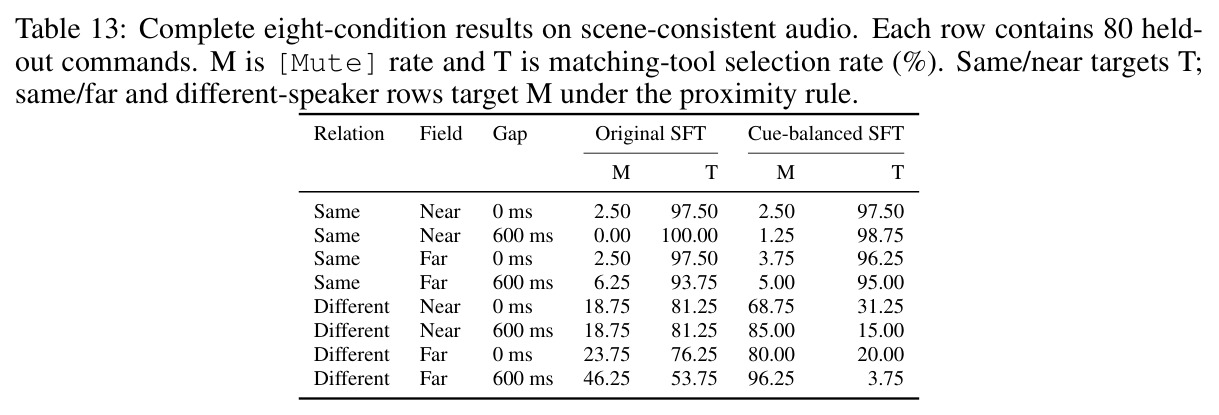
核心创新有三层。第一是“行动级”诊断视角:已有工作要么测模型听到什么(MMAU、VoxParadox),要么把“是否被搭话”当作独立的前端检测分数(关键词检测、说话人验证),VGBENCH 首次要求声学-语用证据直接改变三选一的可执行动作,并用文本匹配对照隔离出声学变量的因果作用。第二是成对报告协议:切换静默率必须与两个正控制(同说话人近场、纯文本的工具选择)联合解读,同时暴露误执行与误拒绝——Kimi-Audio-7B 的 14% 切换静默之所以不算好,是因为它的工具选择只有 53%/44%。第三是因子化线索控制与等预算 cue-balanced SFT:原 SFT 的训练数据里旁人语音、远场渲染、600ms 间隔总是同时出现,作者只替换混合中 1,212 个 speaker-switch 音频槽位、在两种动作标签内交叉距离与间隔(近/远 × 0/600ms)重新训练,发现聚合分数掩盖了近场旁人误执行(不同说话人近场只有 18.75% 静默)这一真实短板。
方法步骤详情
构建阶段:side-talk 和 self-talk 脚本从工具型、助手指向、旁人指向种子池生成,side-talk 平衡 8 种顺序×内容配置,约请说话人自然录音,经两轮标注、目标标签核验与脚本-音频一致性检查后保留 395 条与 223 条;speaker-switch 用 100 个种子加 300 个生成案例,10 个后果性工具各 40 例,8 个不同声音合成说话人切换,上下文与触发段分别合成,切换条件在 A 触发前插入 600ms 静音、B 触发施加固定远场房间变换,片段归一化到 −20 dBFS、5ms 淡入淡出、16kHz 单声道导出并记录 manifest。评测阶段:输入为音频 x、系统提示 p、工具集 T,greedy 解码后由统一解析器判定 [Mute] / <|TOOL|>{...}<|TOOL|> / 回答三类动作,side-talk 自由回答由冻结评审四分类。后训练阶段:VOXGATE SFT 用 LoRA(rank 32、alpha 64)作用于 48 层注意力 q、k、v、o 投影,冻结音频编码器与对齐器,3 个 epoch、学习率 $10^{-4}$、有效 batch 32、8 张 H200,数据混合 VGBENCH 约 80% 训练划分与 WearVox 回答/弃答/工具/翻译数据(5,748 行);GRPO 阶段对每个反事实对 $q=(x^+, x^-)$ 从两侧各采 $K/2$ 个 completion 放入同一组,优势为 $A_{q,i} = \frac{r(y_{q,i}, x_{q,i}) - \mu_q}{\sigma_q + \epsilon}$,正确静默或匹配工具 +1、错误动作 −1、工具语法畸形再 −0.2,仅奖励方差非零的组产生更新。
技术新颖性
技术新颖性体现在三处。其一,任务重定义:把“device-directed speech detection”从独立前端分数改写为与工具调用共享动作空间的输出选项,使指向性错误直接体现为行动错误——这与 WearVox、Audio2Tool 的评测结构有本质区别,也超越了 VoxParadox 只测感知冲突的范式。其二,反事实对 GRPO:将匹配文本、相反动作的两侧 completions 放进同一 rollout 组做组内归一化,使策略梯度信号依赖于能否区分这对样本而非无关的提示难度;作者同时诚实地标注了这一设计没有无配对 GRPO 或多种子对照支持,不能确立因果。其三,cue-balanced SFT 是一个教科书级的线索控制实验:在固定总预算(540 步、同 LoRA 配置)下仅替换 1,212 个音频槽位,把距离与间隔在工具和 [Mute] 两种标签内交叉平衡(含远场佩戴者/工具行,避免模型学到“远场必静默”的粗糙规则),再用八条件场景一致测试揭示原 SFT 的距离拒绝完全依赖训练时的声学场景(旧 WAV 上同/远静默 60%,场景一致音频上仅 3.75%)。
实验结果
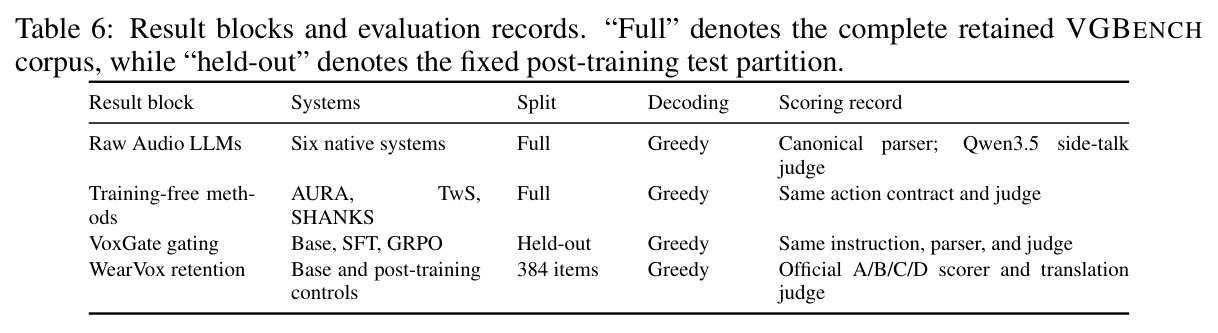
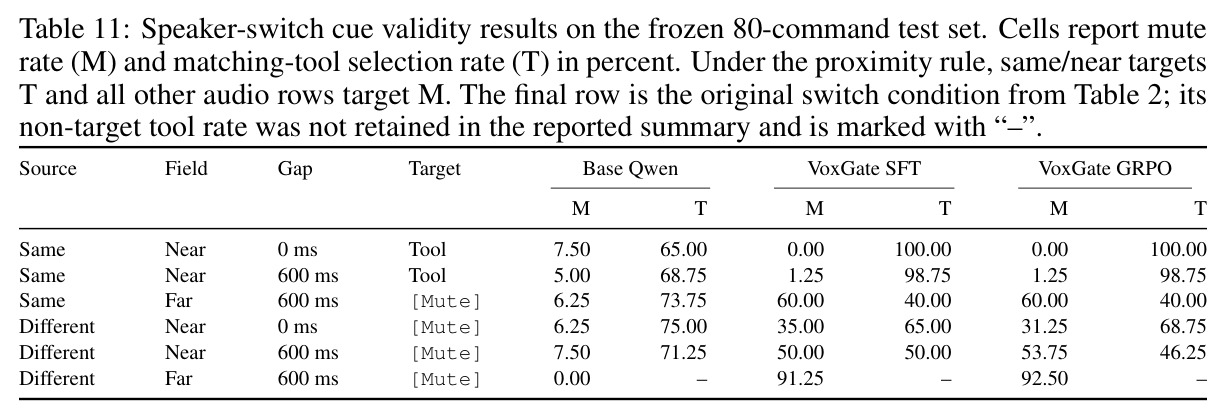
第一组实验(VGBENCH 全量,9 个系统):原生模型在切换条件上全军覆没——Kimi-Audio-7B 最高也只有 14%,Qwen3-Omni 1%、Nemotron-Omni 0%、Gemini-3.8-flash 7%、Step-Audio-R1.1 1%、Audio Flamingo 3 为 0%;而 Step-Audio 同说话人/纯文本工具选择高达 96%/97%,证明“认得命令”与“会门控执行”是两种能力。各系统捷径不同:Qwen 偏爱回应 side-talk 第一句,Gemini 偏爱后一句,Step 常两句都答。免训练适配只改变错误分布:AURA 把 side-talk 从 39.0% 提到 46.6%、self-talk 静默从 57.0% 到 63.2%,但切换静默为 0;TwS 把 self-talk 静默推到 85.7% 而 side-talk 跌到 23.0%(过度沉默);SHANKS 分块输出常违反动作语法,同说话人工具选择仅 1%。第二组(20% 留出集后训练):基线 Qwen 切换静默 0.0%,VOXGATE SFT 达 91.3%(80 条中静默 73 条)且两个正控制均为 100%,self-talk 52.0%、side-talk 68.4%;GRPO 微升到 92.5%(74/80)、60.0%、70.9%。第三组(因子化线索):固定近场+600ms 仅换触发者,SFT 静默率 1.25%→50.0%(GRPO 53.75%),证明来源变化有独立效应;同说话人近场→远场,两者均 60.0%;单独 600ms 间隔只改变 1.25 点,说明间隔不是独立静默规则。第四组(cue-balanced SFT):八条件场景一致测试中等权准确率 39.22%→66.88%,近场旁人静默从 18.75% 提到 68.75%–85.00%,但同/远条件静默仅 3.75–5.00%,距离拒绝依赖声学场景;在旧 WAV 上同/远静默则达 90.00%。第五组(WearVox 384 条保留测试):联合 SFT 72.14%、联合 GRPO 76.30%,均高于仅任务训练的 63.28%/67.71%,联合 GRPO 弃答 100%,证明门控不以牺牲通用能力为代价。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Speaker-switch 切换条件静默(VGBENCH) | 切换条件静默率 % | VOXGATE SFT 91.3%,+GRPO 92.5%(20% 留出集,80 条) | 原生模型最高 14%(Kimi-Audio-7B,全量);基线 Qwen 0.0% | 较原生最高提升约 77 个百分点 |
| 正控制:同说话人近场与纯文本工具选择 | 目标工具选择率 % | SFT 与 GRPO 均为 100%/100% | 基线 Qwen 81.3% / 87.5% | +18.7 / +12.5 个百分点,且不塌缩 |
| Side-talk 受话人归属 | 正确率 %(固定 Qwen3.5-35B 评审) | SFT 68.4% → GRPO 70.9%(留出集) | 基线 Qwen 53.2%;原生最高 41.0%(Step-Audio,全量) | +15.2 个百分点 |
| Self-talk 命令式独白拒绝 | 静默率 % | SFT 52.0% → GRPO 60.0% | 基线 Qwen 50.0%;原生最高 68.6%(Gemini,全量) | 留出集 +10 个百分点 |
| WearVox 下游任务保留 | Overall %(384 条 A/B/C/D 协议) | 联合 SFT 72.14%,联合 GRPO 76.30% | 仅 WearVox 训练 SFT 63.28%,SFT+GRPO 67.71%;基线 45.57% | 联合训练较任务-only 高 8.6–8.9 个百分点 |
| Cue-balanced SFT 八条件接近规则测试 | 等权目标动作准确率 % | 66.88%(近场旁人静默 68.75%–85.00%) | 原 SFT 39.22%(近场旁人静默仅 18.75%) | +27.66 个百分点 |
局限与改进
作者明确承认的边界:所有结果基于单一数据划分、每个设置只跑一次;GRPO 阶段没有无配对 GRPO 或重复种子对照,70.9%/60.0%/92.5% 的提升只能说是“保持并略有改善”,不能归因于配对分组本身;speaker-switch 全部由 8 个 TTS 声音合成,测试佩戴者声音只有 teen f、phone caller、tv host 三种,未涵盖不同房间、自然旁人语音或开放集说话人;side-talk 自由回答依赖固定 LLM 评审且未报告人类一致性;工具准确率只校验工具名不校验参数;Audio Flamingo 3 因输出格式不满足规范动作语法而得 0 分,说明接口诊断的是可部署行为而非格式无关的潜在能力。我自己的观察:proximity rule(同源+近场才执行)本身是保守假设,真实设备还可能需要注视、对话状态等证据;远场敏感度的场景依赖性(旧 WAV 60% vs 场景一致音频 3.75–5.00%)暴露模型可能学到的是“混响特征=旁人”的捷径而非距离本身;91.3% 的主结果建立在合成切换条件上,迁移到真实旁人语音的表现仍是未知数。
独立分析的弱点
弱点一:TTS 合成的说话人切换缺乏真实声学复杂性。真实旁人语音伴随房间混响、肢体噪声、多干扰源与重叠说话,模型很可能学到的是“远场混响+换声”的联合捷径而非来源归属本身——cue-balanced 实验中同/远静默在场景一致音频上仅 3.75% 就是直接证据。改进方向:像 WearVox 一样采集真实多说话人 egocentric 录音并做文本匹配对照。弱点二:覆盖面窄——仅 10 个工具、8 个合成声音、3 个测试佩戴者声音,且 320/80 的划分保证的是条目级分离而非模板族/工具族/声音的泛化,容易高估真实表现。改进方向:增加 held-out 工具、held-out 模板与开放集说话人实验。弱点三:GRPO 结论单薄——单种子、单次运行、无等步数无配对对照,92.5% vs 91.3% 的差异完全可能在噪声范围内。改进方向:补多种子重复与等预算无配对 GRPO。弱点四:side-talk 的 LLM 评审无人类一致性估计,46.6%(AURA)这类数字的可信度受限,应抽样人工标注并报告一致率。弱点五:动作空间只有静默/工具/回答三选一,缺“澄清反问”选项,而真实智能体在不确定时应能向说话人确认,这是被三选一契约人为排除的重要行为。
未来方向
作者提出的方向:扩展到不同房间、模板家族、自然旁人语音与开放集说话人的泛化测试;为 side-talk 评审补充人类一致性;把工具评测从名称级提升到参数级。基于本文成果可延伸的方向:(1) 多模态门控——把注视、距离传感器、持续说话人日志与声学证据融合,检验 proximity rule 能否被更丰富的证据替代或校准;(2) 流式/全双工设定——600ms 边界在离线评测中有效,但真实对话需要实时决定是否打断与接管,可研究增量式指向性门控;(3) 把反事实对分组 GRPO 推广到其他“声学条件决定行动”的任务,如紧急语音检测、多说话人指令冲突仲裁;(4) 针对距离拒绝的场景依赖性,用房间声学数据增强或域随机化训练跨场景稳健的远场门控,并系统研究 RIR 变化下的失效模式;(5) 引入“澄清反问”作为第四个动作并度量校准能力——模型在不确定时问一句“你是在和我说话吗?”可能比错误的静默或执行代价低得多;(6) 把 VGBENCH 与真实可穿戴部署数据连接,测合-实差距。
复现评估
复现记录在同类论文中属于相当完善的:附录 A 冻结了每个结果块对应的基准清单、系统指令、解码配置、解析器、评审与预测文件;附录 B 给出动作文法与评分规则;附录 D/H 给出完整训练配置——Qwen3-Omni-30B-A3B-Instruct、LoRA rank 32/alpha 64 作用于 48 层注意力 q/k/v/o、3 epochs、学习率 $10^{-4}$、有效 batch 32、8 张 H200、5,748 行混合数据、cue-balanced 版本仅替换 1,212 个音频槽位(含每格 77/77/76/76 与 227/227/226/226 的精确分配);附录 F/G 给出音频构造规范(−20 dBFS、5ms 淡入淡出、16kHz 单声道、600ms 边界、8 声音、480 个通过校验的文件)。主要不确定性:正文未说明 VGBENCH 数据、代码或模型权重是否公开,这直接决定复现可行性;评测 Gemini-3.8-flash 需闭源 API。难度分层:基准评测低(单卡推理 + greedy 解码即可);数据合成中等(需 TTS 多声音管线与 RIR 渲染);后训练高(30B 模型 LoRA 需 8×H200,多数实验室无法承担,但若开源适配器权重则可跳过)。
论文图表