LANTERN:照亮语言模型中隐含的数学知识 LANTERN: Illuminating Hidden Mathematical Knowledge in Language Models
用LLM隐层状态为OEIS五千万序列对排序,8小时验证出62条隐藏数学关系
前置知识
OEIS(整数序列在线百科)
数学家自1960年代起人工维护的整数序列数据库,每个条目包含一行定义、首若干项、公式区、评论区,条目之间的交叉引用(CROSSREFS)记录了人们已经注意到的序列间关系。数据库带完整版本历史,任何一条交叉引用都能查到它是何时加入的。
本文的实验对象(10000条最常被引用的序列)、训练标签(已有交叉引用)、廉价验证手段(条目存储的前25–102项)和时间切分测试集(版本历史)全部建立在OEIS的结构之上。
LLM 残差流与隐层表示
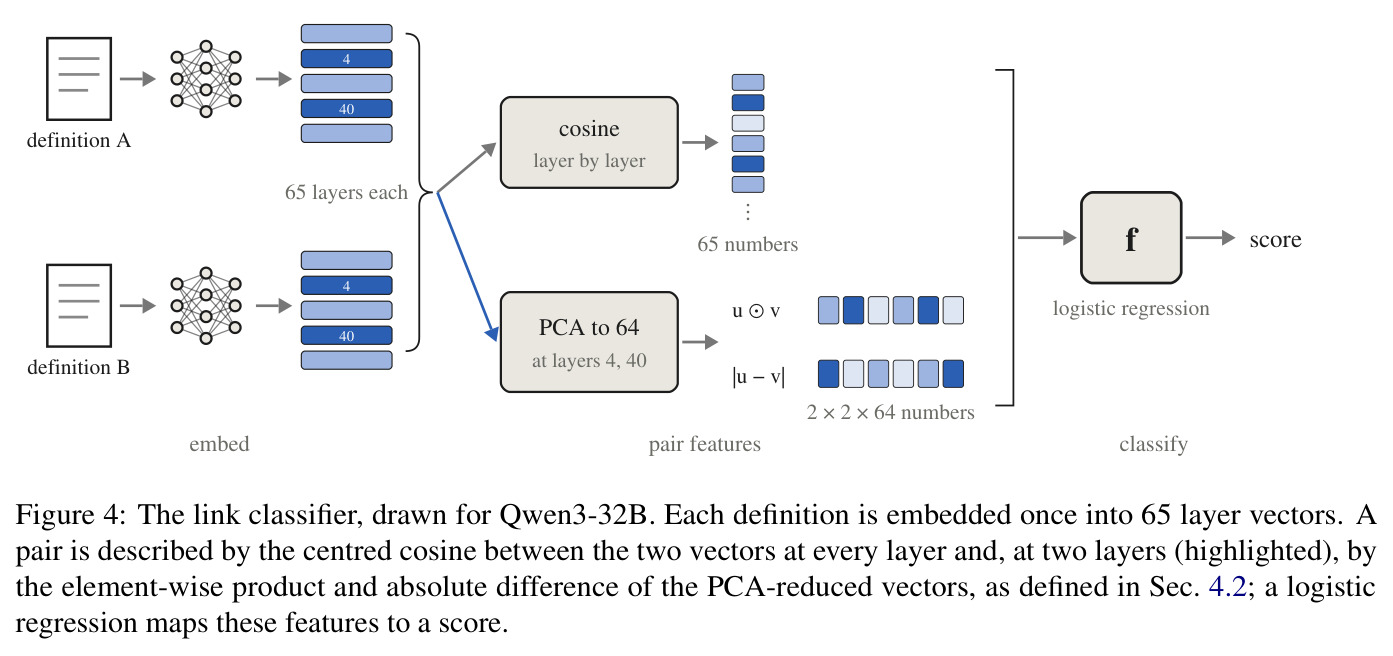
Transformer每一层都向残差流写入信息,把某层所有token的残差向量 $h_t^{(\ell)}$ 做平均池化并归一化,就得到该层的一个句子级向量 $x^{(\ell)}$。Qwen3-32B有64层,一次前向即可取出65个向量,覆盖从浅层语法到深层语义的不同抽象层级。
LANTERN的全部核心假设是:两个数学对象的关系信息已经编码在这些冻结的隐层向量中,本文不微调模型、不做生成,只从这些向量构造特征做二分类。
文献间发现与链接预测
Swanson在1986年提出的“未发现的公共知识”:两篇文献各自被第三方连接但彼此未被对照,其间的隐含联系值得挖掘。图上的链接预测(如材料科学中的HyGRAIL用GNN+LLM预测缺失边)是它的现代化身,典型做法是用已知边训练分类器给未知边打分。
本文本质上是把OEIS看作一张“序列关系图”,预测其中缺失的边,只是边的特征不来自图结构本身,而来自LLM对两个节点文本的隐层编码。
逻辑回归与类别不平衡
线性分类器 $p(y=1|x)=\sigma(w^\top x+b)$,在标准化特征上训练,输出可解释为排序分数。极度不平衡时(本文正例仅占5000万对的约1/18000)直接训练会退化为全预测负类,需要负采样、每条目上限等重平衡技巧。
LANTERN的排序器就是一个321维特征上的逻辑回归,论文的大量设计(gold/silver/trivia分级标签、每条目最多8个正例、负例1:10并按三种来源均分)都是为了解决标签稀缺与标签噪声问题。
ROC-AUC
受试者工作特征曲线下面积,衡量一个打分器把正例排在负例前面的能力:0.5等价随机,1.0完美排序,且对阈值选取不敏感,适合评价“排序”而非“分类”任务。
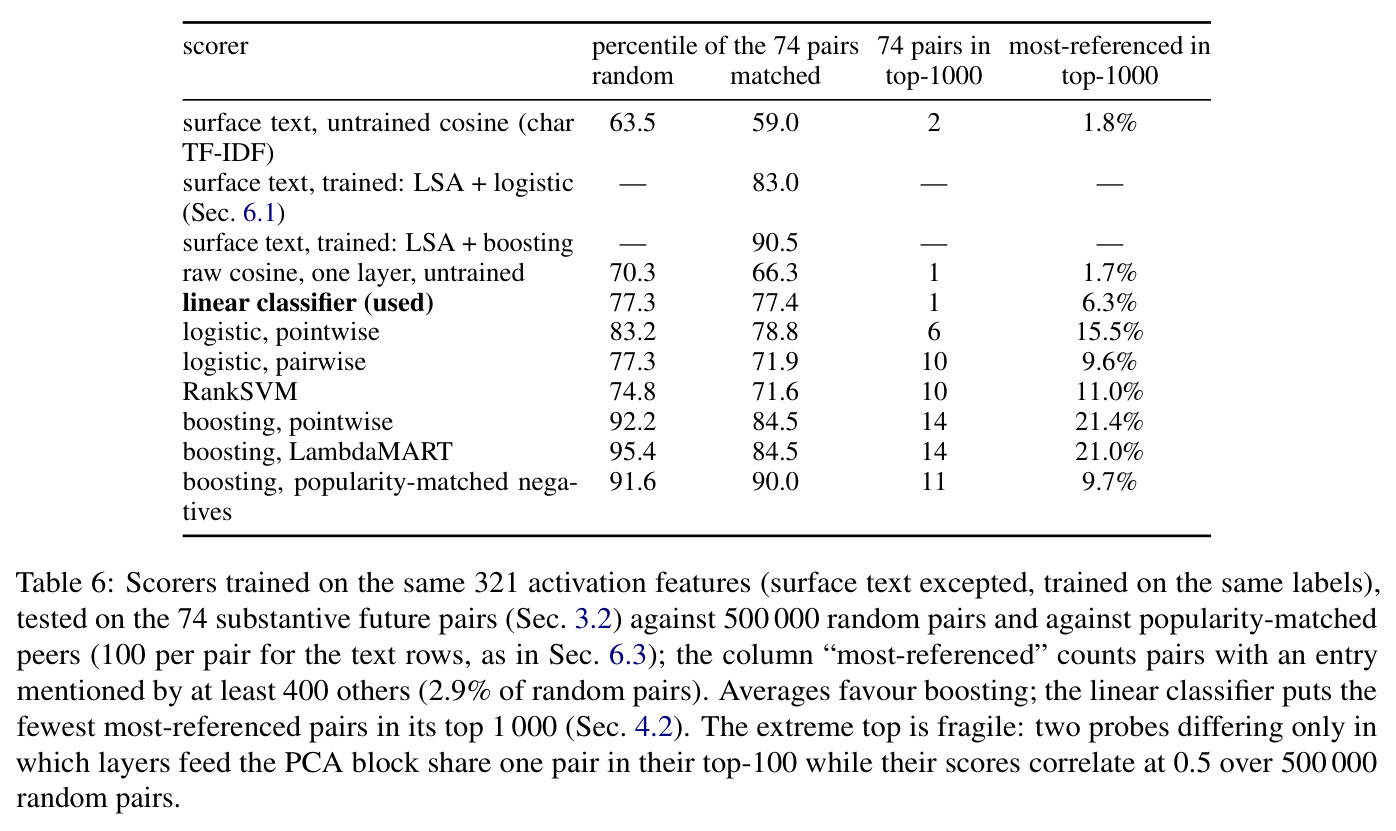
论文第6节三个对照实验(表层文本、记忆、标签偏差)全部用AUC量化,是判断“隐层里到底有没有数学知识”的关键证据,例如主题匹配背景下文本打分器AUC=0.51而激活分类器0.57–0.58。
生成函数与 q-级数
把序列 $a(n)$ 编码为幂级数 $\sum_{n\ge0}a(n)q^n$,级数乘法对应序列卷积,使组合恒等式变成代数恒等式。theta级数(如 $\Theta(q)=\sum_{j\in\mathbb{Z}}(-1)^jq^{j(5j-1)/2}$)、连分数(如Rogers–Ramanujan连分数 $R(q)$)和整数分拆计数是其中的经典工具,Jacobi三乘积公式是最常用的恒等式。
62条已验证关系中绝大多数以形式幂级数恒等式表述,旗舰发现之一 $T(q)^2R(q)^5=\sum c_5(n)q^n$(5-core分拆的生成函数)及其证明必须用这套语言才能读懂。
元胞自动机
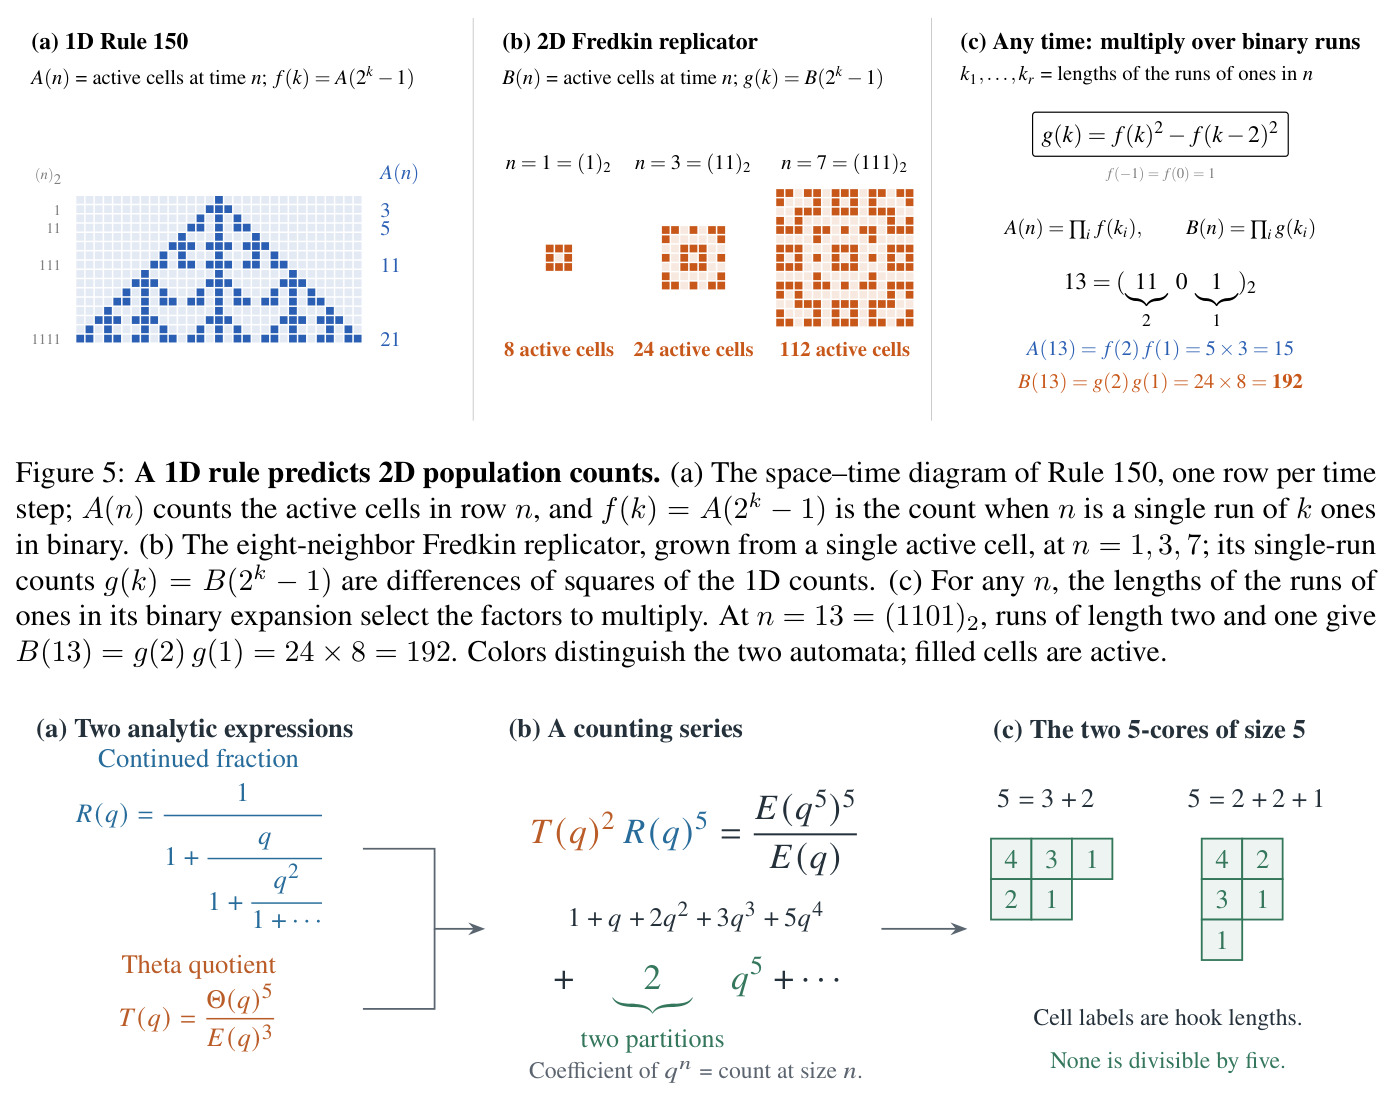
网格上的离散动力系统,每格按局部规则同步更新。Rule 150是一维规则:细胞下一时刻取自身与左右邻居的XOR;Fredkin replicator是二维规则:八个邻居中活跃数为奇数时下一时刻活跃。两者都从单个活细胞出发,$A(n)$、$B(n)$ 记录第 $n$ 步的活细胞总数。
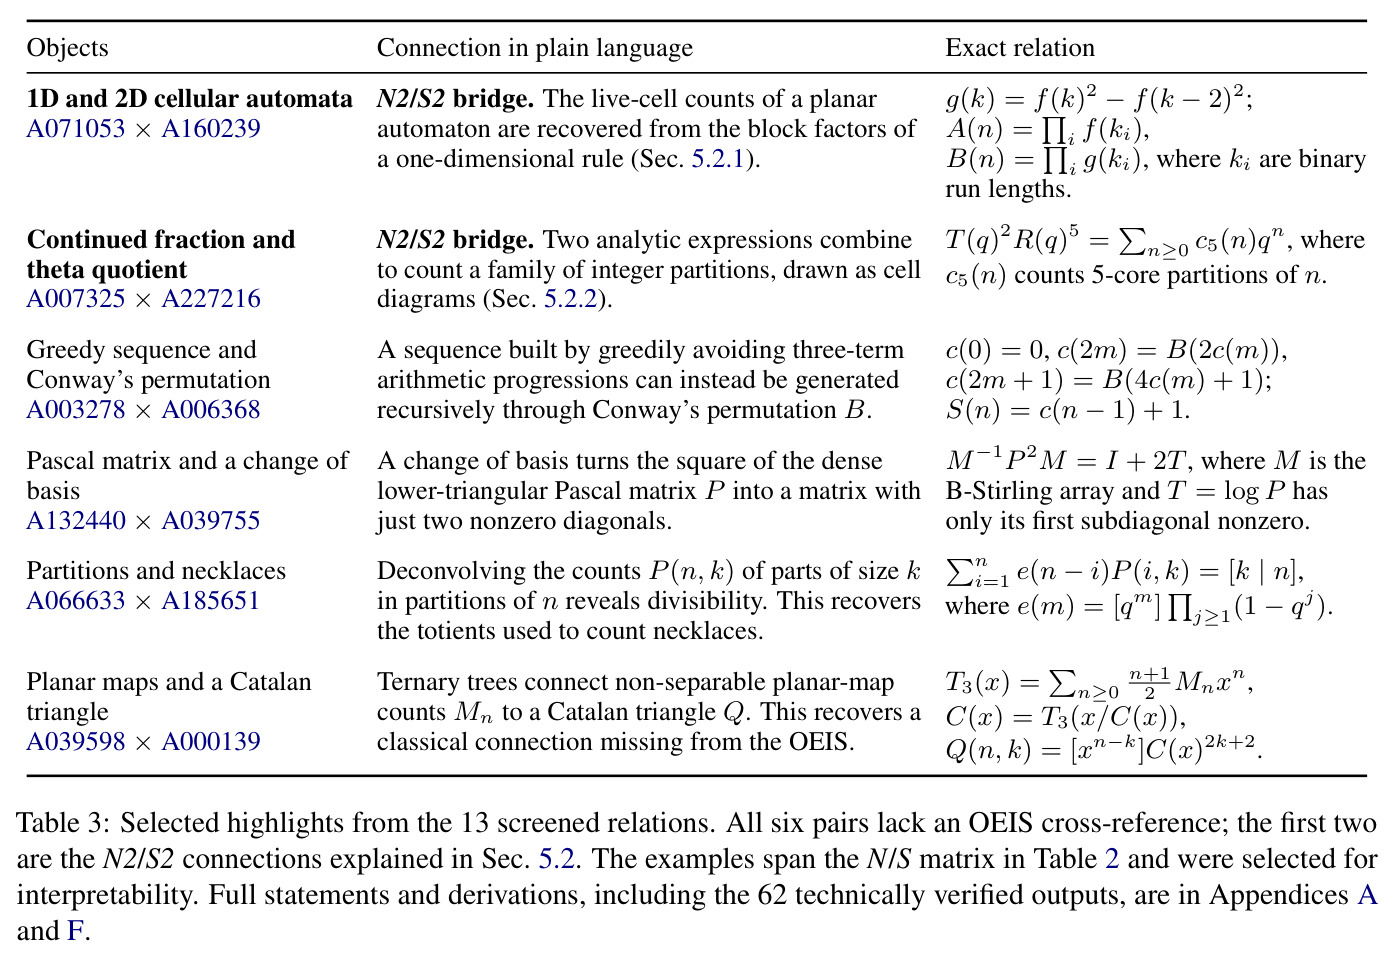
论文最“像发现”的结果(N2/S2)正是这两类维数不同、规则不同的自动机之间的精确人口计数桥梁 $g(k)=f(k)^2-f(k-2)^2$,是理解论文成果分量的核心例子。
研究动机
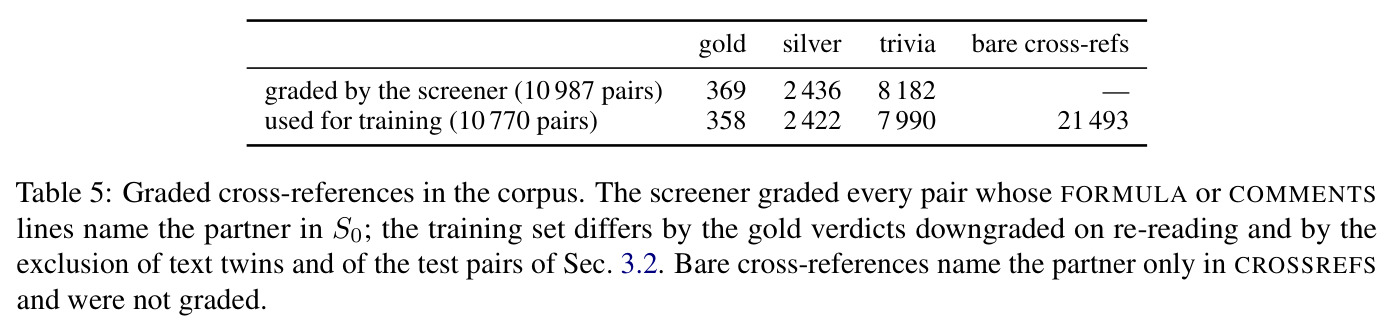
AI数学发现系统长期受困于“选题”瓶颈:FunSearch、AlphaProof、co-scientist等系统证明能力再强,也需要人类先指定要攻的问题,这被称为AI辅助数学的瓶颈与机器发现的第一判据。另一方面,OEIS这类知识库积累了几十年人类标注的交叉引用,但新连接出现极慢——第九个Dedekind数(A000372)在第八个之后32年才被算出。已有自动猜想工作(Ramanujan Machine、LeanConjecturer等)生成的是全新命题,新颖性难界定、验证昂贵。更麻烦的是,OEIS现存交叉引用大多是平凡连接:剔除文本孪生后的32,263个已连接对中,67%(21,493对)只在CROSSREFS一节被提及,25%(7,990对)被评 为trivia(重标度、平移、模板孪生),只有约9%(gold 358 + silver 2,422)含定理级实质内容。也就是说,“在数百万对象中识别哪两个对象间存在值得注意的深层关系”这一数学家凭直觉完成的选择步骤,此前没有被自动化。
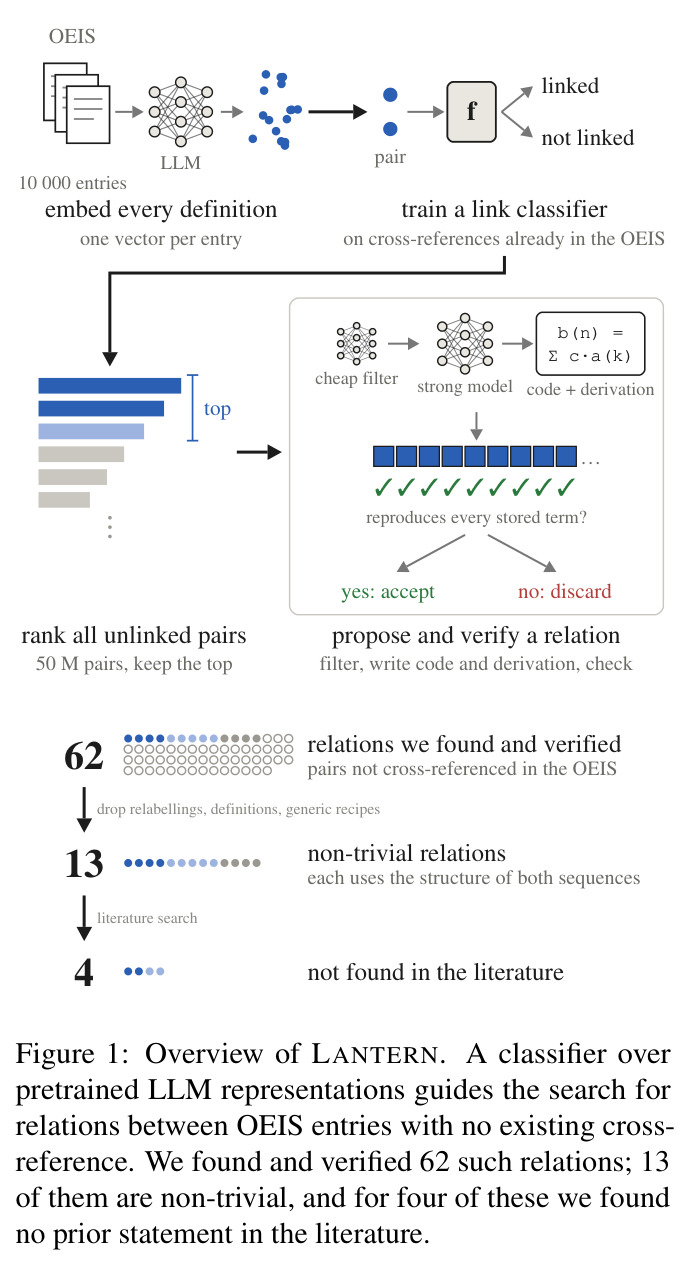
本文的目标是本文要验证一个明确假设:预训练语言模型在预训练时已经学到数学对象的性质,这些知识编码在其内部表示中,可以直接用来在知识库中搜索对象之间未被记录的关系。具体目标是在OEIS上构建并跑通一条低成本完整流水线LANTERN:用Qwen3-32B的隐层状态训练线性分类器,给10,000条最常被引用序列组成的全部50,000,000个序列对打分排序,再经廉价过滤、强模型提出假设、沙箱可执行验证与解析推导检查四个阶段,最终产出既通过数学验证、又通过“内容上有价值”筛选的新关系,并要求端到端总耗时控制在数小时量级(最终实测不到8小时),从而证明“让模型帮忙选题”在算力和成本上都是现实的。
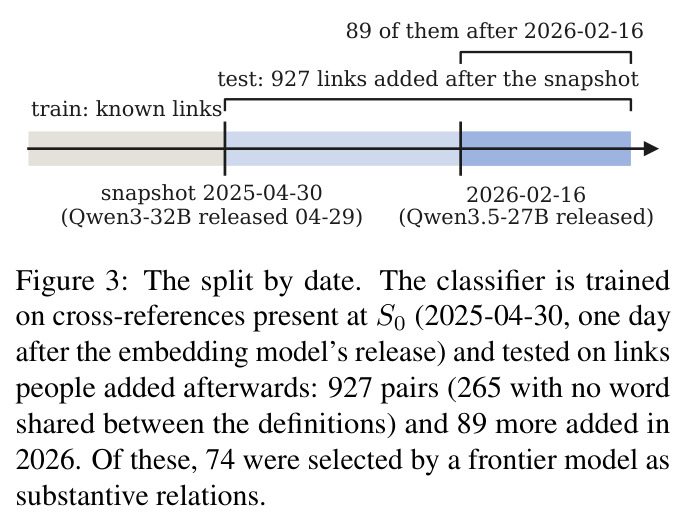
与已有工作不同的是,本文的独特切入有三点。第一,它不让模型生成新数学(自对弈、符号枚举、LLM提示式猜想生成都属于此类),而是直接读取模型隐层状态,把“模型已经学到了什么”转化为对已有对象间缺失关系的预测器——这与probing研究(Tshitoyan的材料学词嵌入、Burns的CCS、Schut的AlphaZero概念探针)和知识图谱链接预测(HyGRAIL)相关,但首次把两者结合到数学知识库的完整发现闭环中。第二,OEIS提供了独一无二的评估条件:交叉引用是天然标签,存储首项给出廉价可执行验证,而版本历史允许把交叉引用图冻结在嵌入模型发布次日(2025-04-30),用其后人类新增的927条链接(其中265条定义无任何共享词)构造无泄漏的测试集。第三,作者严格区分“技术正确”与“数学上有内容”:62条技术验证的关系要再过一道内容筛选和S/N双轴评估,避免用重标号、换参数这类平凡恒等式冒充发现。
核心方法
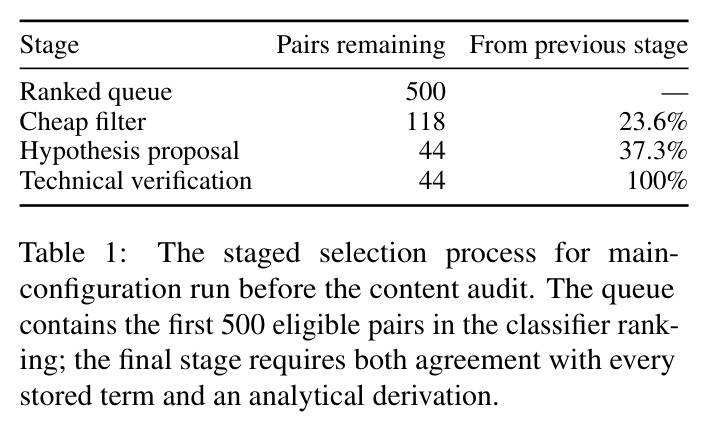
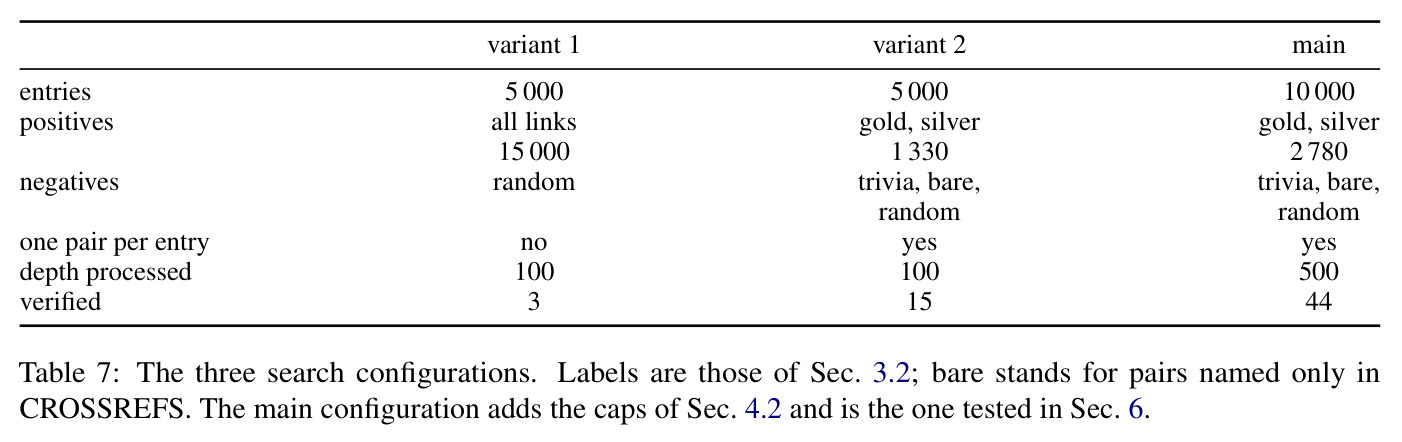
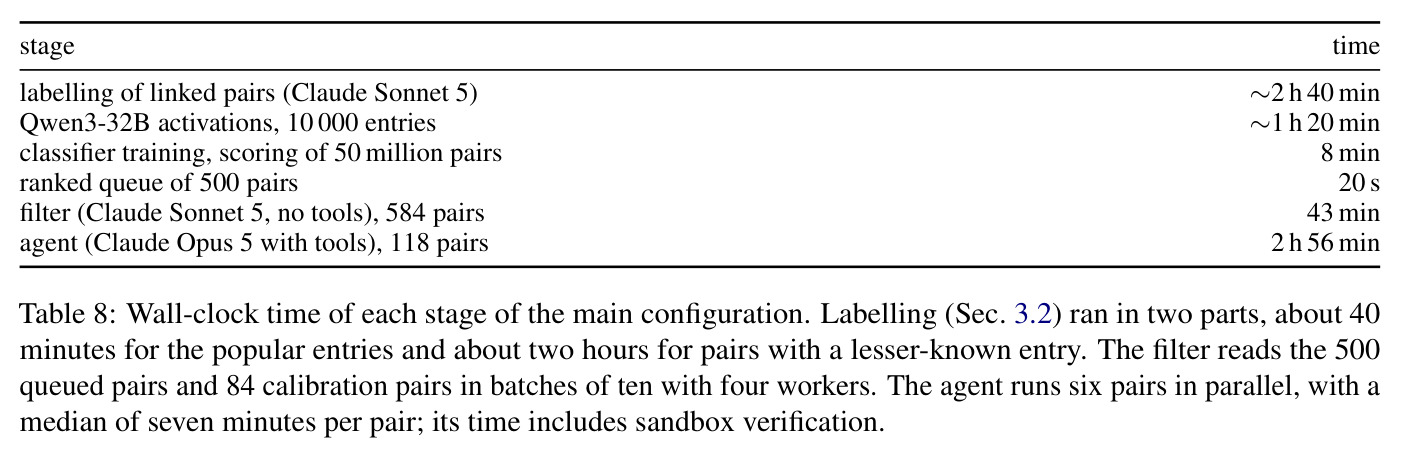
直觉是:若模型在预训练中见过海量OEIS页面和数学文献,两个序列定义文本的隐层向量应携带“这两个对象在数学上接近”的信息,即使当时的OEIS还没把它们连起来。技术路线分四步。(1) 语料:从2026-08-15快照的398,320个条目中保留至少25项、定义至少15字符且不提及其他条目、无dead/dupe等标记的条目,取被引用最多的10,000条(至少被提及17次),构成50,000,000个对。(2) 标注:用Claude Sonnet 5把有交叉引用的对评为gold(358条定理级恒等式/双射/渐近结果)、silver(2,422条教科书级)、trivia(7,990条平凡),gold再由Claude Fable 5.1复核(91–94%维持);gold+silver共2,780对(占已连接对9%)作正例。(3) 打分:每个定义经Qwen3-32B一次前向得到65个层向量,构造321维对特征,逻辑回归8分钟内给全部5000万对打分。(4) 阶梯验证:前500对经Sonnet 5廉价过滤剩118对,Opus 5 agent为44对写出解析推导和可执行Python函数,沙箱中与存储的每一项核对,44对全部通过;主配置加两个变体共62条技术验证关系。
核心创新是把“发现”重构为“读出”:不要求模型提出新数学,而是假设预训练已把OEIS中人类尚未注意到的联系编码进隐层状态,再用一个仅2,780个正例训练的线性分类器把它读出来。与HyGRAIL等GNN+LLM链接预测的本质区别在于:这里完全不做图上的消息传递,特征只来自冻结的预训练表示,图结构仅充当标签来源。第二个关键设计是“以未来为测试”防泄漏:交叉引用图冻结在Qwen3-32B发布次日(S0,2025-04-30),其后的927条新链接(265条定义无共享词)以及S1(2026-02-17,Qwen3.5-27B发布次日)之后的89条构成测试集;前沿模型从中选出74对实质性关系用于评估。第三个设计是分级标签与重平衡:trivia和裸交叉引用显式作为负例、随机负例三者各占三分之一,正例每条目上限8个、每位贡献者上限50条,防止分类器学会“识别重标度和平移”这类捷径——毕竟实质链接在5000万对中只占约1/18000。
方法步骤详情
流程如下。(1) 嵌入:定义 $d_i$ 纯文本输入嵌入模型,取每层残差流的token平均 $x_i^{(\ell)}=\frac{1}{T_i}\sum_t h_t^{(\ell)}(d_i)$ 并归一化,每条目得 $L+1$ 个向量(Qwen3-32B为 $L=64,d=5120$)。(2) 特征:第一类是每层中心化余弦 $c_{ij}^{(\ell)}=\langle x_i^{(\ell)},x_j^{(\ell)}\rangle-m_i^{(\ell)}-m_j^{(\ell)}+\bar m^{(\ell)}$,$m_i^{(\ell)}$ 为条目对512条随机样本的平均余弦,用于扣除“热门条目与谁都像”的偏置;第二类在相对深度 $\ell=4,40$ 两层把中心化向量投影到前64个主成分得 $u_i$,取元素积 $u_i\odot u_j$ 与绝对差 $|u_i-u_j|$,共256维;两类合计321维,标准化后训练逻辑回归。(3) 排序:删除已有交叉引用的对和文本孪生(TF-IDF余弦 $\ge0.85$ 且仅为参数变化),贪心下行、每条目只出现在一个入选对中,得500对队列。(4) 廉价过滤:Sonnet 5无工具判断是否存在精确关系,留118对。(5) 假设生成:Opus 5带shell、本地OEIS镜像与截断幂级数精确算术库,输出命名步骤的推导、证明类别和Python函数,或弃掉,产出44个假设。(6) 验证:无文件、无网络、无第三方库的沙箱中运行函数并与目标序列全部存储项比对(每对25–102项),人工读码防硬编码,再做解析检查,44/44通过。主配置44条+变体1三条+变体2十五条共62条,再按附录B八条规则做内容筛选保留13条。
技术新颖性
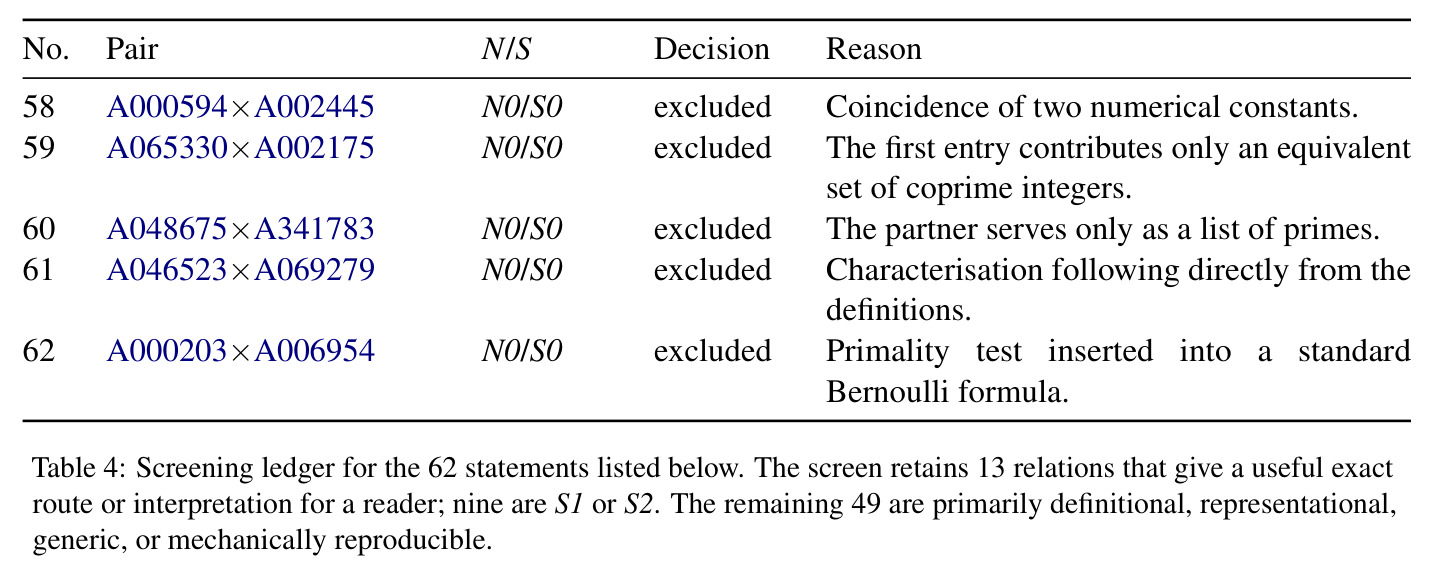
技术新颖性有四层。第一,任务层面首次把隐层知识读出用于数学知识库的缺失链接预测并配齐数学验证闭环:此前probing工作只证明模型内部有潜在知识(材料学、AlphaZero概念),没有人在整个知识库规模上把它变成可执行、可证明的发现;HyGRAIL虽在材料图上做LLM+GNN链接预测,但缺少把候选转化为可执行关系与解析证明的机制。第二,特征工程极简却有效:321维(65层中心化余弦+两层PCA的256维乘积/绝对差)上的逻辑回归,就显著超过用同样标签训练的表层文本打分器(主题匹配背景AUC 0.57–0.58对0.51),说明信号确实存在于激活而非定义字面。第三,评估方法学:利用OEIS版本历史做时间切分,并设计三个逐一排除替代解释的对照——表层文本对照、记忆对照(2026年新建的2,379个条目上分类器AUC 0.88,几乎不掉)和标签偏差对照(无标签直接提问达到与分类器相同的中位百分位88.5对88.0)。第四,诚实的结果报告:用内容筛选+S/N双轴把62→13→9的漏斗完整公开(附录A给出全部62条的逐条去留理由),把“技术正确”与“值得报告”分开,这在AI4Math文献中少见。
实验结果
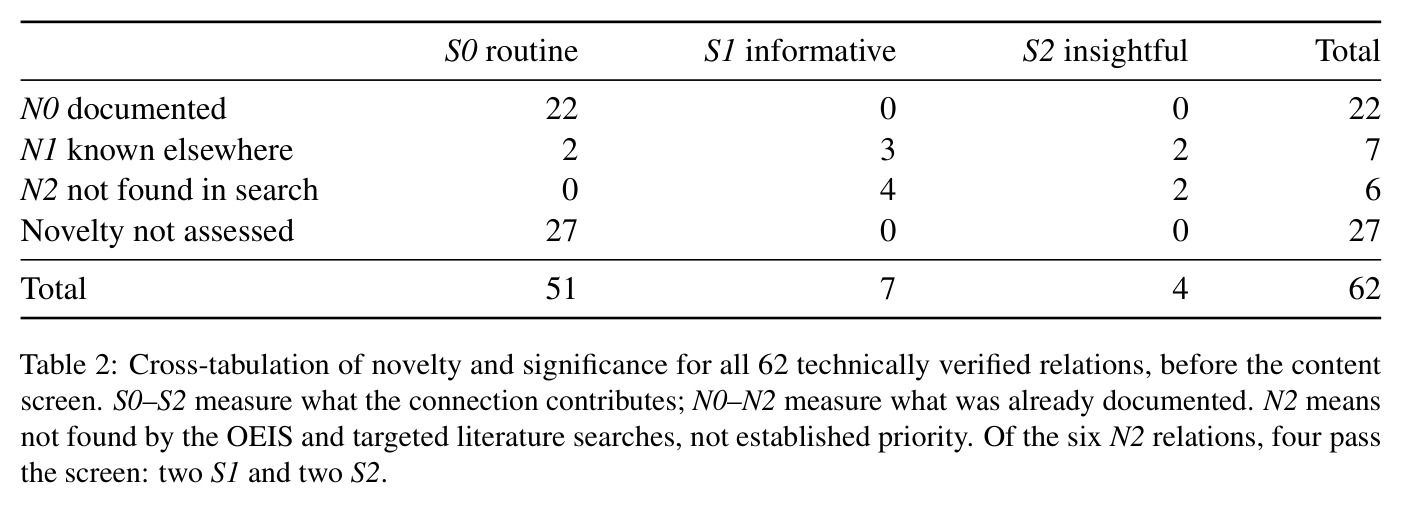
主漏斗:50,000,000对 → 分类器取前500 → 廉价过滤118对(23.6%)→ Opus 5提出假设44对(37.3%)→ 沙箱+解析验证44/44通过 → 三配置合计62条技术验证关系(主配置44、变体1三条、变体2十五条)→ 内容筛选保留13条 → 9条为S1/S2,其中4条为OEIS与文献均未记载(N2)的新连接。筛前分布:S0 routine 51 / S1 7 / S2 4;N0 22 / N1 7 / N2 6 / 未评估27。两个旗舰N2/S2发现:其一A071053×A160239,一维Rule 150自动机活细胞数 $A(n)$ 与二维Fredkin replicator的 $B(n)$ 都按 $n$ 的二进制1-游程长度因子分解 $A(n)=\prod_i f(k_i)$、$B(n)=\prod_i g(k_i)$,且块因子满足 $g(k)=f(k)^2-f(k-2)^2$,如 $13=(1101)_2$ 时 $A(13)=5\times3=15$、$B(13)=24\times8=192$,由 $f(k)=(2^{k+2}-(-1)^k)/3$、$g(k)=\frac{5}{3}4^k-2(-2)^k$ 代数恒等推出;其二A007325×A227216,连分数 $R(q)$ 与theta商 $T(q)$ 满足 $T(q)^2R(q)^5=\sum_{n\ge0}c_5(n)q^n$,即5-core分拆的生成函数,用Jacobi三乘积按模5分组证明。对照实验:793条S0后新增链接的主题匹配测试中,文本打分器AUC 0.51(随机),激活分类器三规模均0.57–0.58;42条实质对0.61对0.67–0.69。2026年新建2,379条目的5,557条引用上,仅用旧条目训练的分类器AUC 0.88(旧条目0.89),文本打分器0.85→0.78。无标签提问与分类器中位百分位88.5对88.0。总耗时<8小时:标注2h40m、嵌入1h20m、5000万对打分8分钟、过滤43分钟、agent 2h56m。
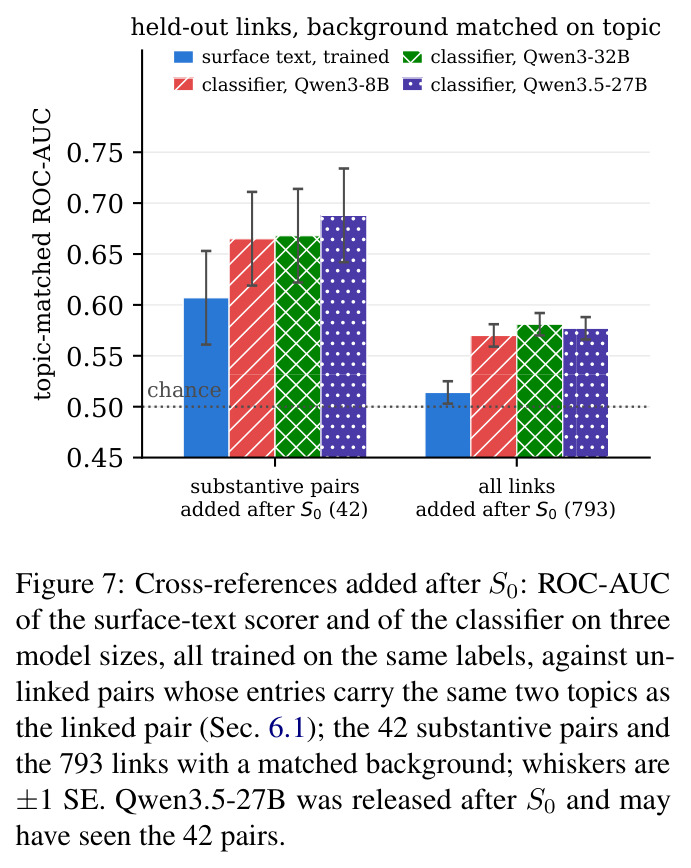
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 排序模型知识截止后新增的OEIS交叉引用(793条,主题匹配负例) | ROC-AUC | 激活分类器(Qwen3-8B/32B、Qwen3.5-27B)0.57–0.58 | 同标签训练的表层文本打分器(字符3–5gram TF-IDF+LSA)0.51 | 文本特征处于随机水平,激活特征稳定在其上,证明隐层含有文本之外的数学关系信息 |
| 42条实质性未来对的排序(主题匹配负例) | ROC-AUC | 0.67–0.69(三个模型规模) | 表层文本打分器0.61 | 约+0.06–0.08 AUC |
| 2026年新建(模型训练截止后)2,379个条目的5,557条交叉引用排序 | ROC-AUC | 分类器0.88(仅用旧条目交叉引用训练) | 旧条目随机held-out上0.89;文本打分器从0.85降至0.78 | 激活信号几乎无衰减而文本信号明显衰减,排除对OEIS页面的记忆 |
| 无标签直接提问排序74条实质性未来对(各配100条同热度未链接对) | 中位百分位 | 直接提问88.5 / 训练分类器88.0 | 随机排序为50 | 不依赖训练标签也能恢复同等强度信号;分类器的优势是吞吐(一次嵌入打完5000万对) |
| 端到端发现流水线(5000万对→62条已验证关系) | 墙钟时间 | 总计<8小时(标注2h40m+嵌入1h20m+打分8min+过滤43min+agent 2h56m) | 无直接可比基线;人类OEIS交叉引用增长以年计 | 首次以小时级成本完成“排序—假设—验证”全闭环并产出4条文献未见关系 |
局限与改进
作者承认两点:其一,OEIS是特别结构化的试验台——对象自带人工定义、公式、初项和显式交叉引用,方法能否推广到不那么形式化的数学对象、或关系不以显式链接记录的知识库,尚不清楚;其二,语料偏向被频繁引用的序列,且只评估了Qwen3一族预训练模型(8B/27B/32B)。我自己的观察还有几点:第一,产出率低且N2只表示“我们的检索没找到”而非确立优先权——5000万对最终只出4条全新且深刻的关系,62条中49条因过于平凡被筛掉,说明分类器顶端仍混有大量记账式关系;第二,存在LLM循环风险:标签由Claude Sonnet 5分级、gold由Claude Fable 5.1复核、内容筛选与S/N评估再由LLM完成,整个评价体系内嵌同族模型的偏好,附录F明确说明全部推导未经数学家检查;第三,时间越往后信号越弱——S1之后的89条链接(48条实质对)上所有打分器AUC落在0.55–0.62、彼此相差不到一个标准误,无法区分;第四,第七节还披露一个细节:20条陈述的内容筛选只读了条目的公式与评论行,评估输入本身不完整;第五,“实质性”的74对测试集由前沿模型挑选,本身就可能偏向分类器学到的模式。
独立分析的弱点
第一,发现效率与反馈缺失:50,000,000对→4条全新S1/S2关系,良率约 $10^{-7}$ 量级,而内容筛选的判定结果(哪些对被保留)没有被回灌进分类器训练;改进方向是把筛选信号作为弱标签做迭代式主动学习,或训练成本感知的排序模型,把“可能值得验证”的先验逐轮收紧。第二,标签与评估的LLM循环:分级、复核、筛选、S/N评估全部由闭源LLM完成,存在系统性偏好且不可复现其行为;改进是请人类数学家对保留的13条做盲评,并用Lean等形式化证明器机器验证一部分关系,把“agent推导正确率”变成硬指标。第三,特征只用了定义文本的单行嵌入,完全没用到序列前几十项的数值结构(首项、增长率、模周期、素因子模式等);这些廉价特征与激活特征几乎肯定互补,融合后应能显著提高顶端排序纯度。第四,单一模型族:只有Qwen3系列,数学语料占比更高的模型(如专门数学预训练模型)是否携带更强信号、层间信息如何分布(论文只报告4/40两层用于PCA),都是空白。第五,时间外推弱:S1之后的held-out上所有方法AUC仅0.55–0.62且无法区分,说明分类器学到的是“截至2026年初的连接风格”,对更新、更稀疏的链接预测能力有限。
未来方向
作者指出的方向:推广到其他结构化知识库(定理库、化学与材料知识图谱)、非Qwen的模型族、以及关系不以显式链接记录的数据库;论文还建议评估方法在更弱形式化对象上的适用性。基于其成果可直接延伸的方向包括:(1) 把LANTERN排序器接到自动形式化与证明agent(AlphaProof式系统)前端,构成“选题—形式化—证明”完整闭环,用证明成功率反过来校准排序器;(2) 用对比学习或无监督探针(如CCS)替代依赖人工负采样的逻辑回归,消除对LLM分级标签的依赖;(3) 层间归因分析——回答“数学关系信息集中在哪些层、哪些注意力头”,与Schut等人的概念迁移研究接轨;(4) 把版本历史+时间切分的评估协议移植到引文网络、专利引用、蛋白质互作网络等其他有时间戳的图上,检验“潜在公共知识”假设的普适性;(5) 把附录B的八条内容筛选规则形式化为可复用的“数学趣味性评估器”,本身就是一个可独立发表的贡献;(6) 对62条推导做专家审查并形式化入库,量化LLM生成证明的可靠性边界。
复现评估
总体复现条件较好。代码与验证代码在公开仓库(论文写明“the verification code is in the repository”),62条推导全文和逐条筛选台账分别在附录F与附录A/Table 4公开。数据全部可得:OEIS公开且版本化,三个快照日期明确(2025-04-30、2026-02-17、2026-08-15),语料过滤规则(≥25项、≥15字符定义、关键词黑名单、top-10,000被引用)和文本孪生阈值(TF-IDF余弦0.85)写死在文中。算力门槛低:嵌入10,000条定义仅需Qwen3-32B约1h20m的单次前向,5000万对打分8分钟CPU级,无任何微调;主要开销是LLM API调用(标注2h40m、过滤43分钟、agent 2h56m),个人实验室可负担。难点有三:一是三个闭源LLM(Sonnet 5、Fable 5.1、Opus 5)的行为一致性——API版本漂移会改变分级和筛选结果,且论文未附提示词全文;二是沙箱与截断幂级数精确算术库的工程搭建;三是前沿模型挑选74对“实质性”测试对的环节依赖模型判断。特征与分类器部分(321维、逻辑回归)则完全可复现。
论文图表
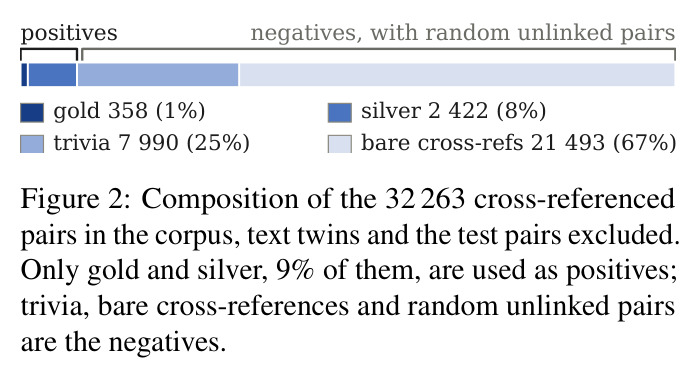
条形/构成图显示已连接对的标签构成:gold 358(1%)、silver 2,422(8%)、trivia 7,990(25%)、仅在CROSSREFS提及的裸交叉引用 21,493(67%)。只有gold+silver(9%)作正例,trivia、裸交叉引用与随机未链接对作负例。
解释了为什么要做标签分级和重平衡:绝大多数交叉引用是记账式平凡连接,直接用它训练分类器只会学会识别平凡关系。
三联图:(a) 两个解析对象——连分数 $R(q)$ 与theta商 $T(q)$;(b) 它们按 $T^2R^5$ 组合后 $q^n$ 的系数给出规模为 $n$ 的5-core分拆个数,级数开头 $1+q+2q^2+3q^3+5q^4+2q^5+\cdots$;(c) $q^5$ 的系数为2,对应恰好两个hook长度都不被5整除的分拆 $(3,2)$ 与 $(2,2,1)$ 的Young图。
把第二个旗舰发现(N2/S2)从抽象恒等式落到具体组合对象,直观展示“解析表达式相乘=计数分拆”。