融合预训练扩散模型与多模态条件化的摄影测量数字表面模型精化 Enhancing Photogrammetric Digital Surface Models with Pretrained Diffusion Models and Multimodal Conditioning
预训练扩散模型融合立体DSM与卫星影像,密集城区高程RMSE从6.00米降至3.45米
前置知识
流匹配(Flow Matching / Rectified Flow)
一类生成建模方法:学习随时间变化的速度场 $v_t(x_t)$,通过常微分方程 $\frac{d}{dt}x_t = v_t(x_t)$ 把高斯噪声分布连续输运到数据分布。rectified flow 变体把路径取为直线 $x_t=(1-t)x_0+tx_1$,目标速度场为常数 $x_1-x_0$,网络用 MSE 拟合(JCFM 目标),采样时从噪声出发做 Euler 数值积分。Stable Diffusion 3 正是基于 MM-DiT 架构的流匹配模型。
本文的整个生成框架和损失函数都建立在 rectified flow matching 之上,其核心贡献 patch-wise 归一化正是对这个损失的重新推导(重新参数化速度场并按 $s^2/E[s^2]$ 加权)。
ControlNet
一种给冻结的预训练生成模型加空间条件的技术:复制一份可训练的网络副本处理条件输入(如深度图、边缘图),再把其中间特征以残差形式逐块加回主干,从而实现像素级控制而不破坏大规模预训练学到的视觉先验。
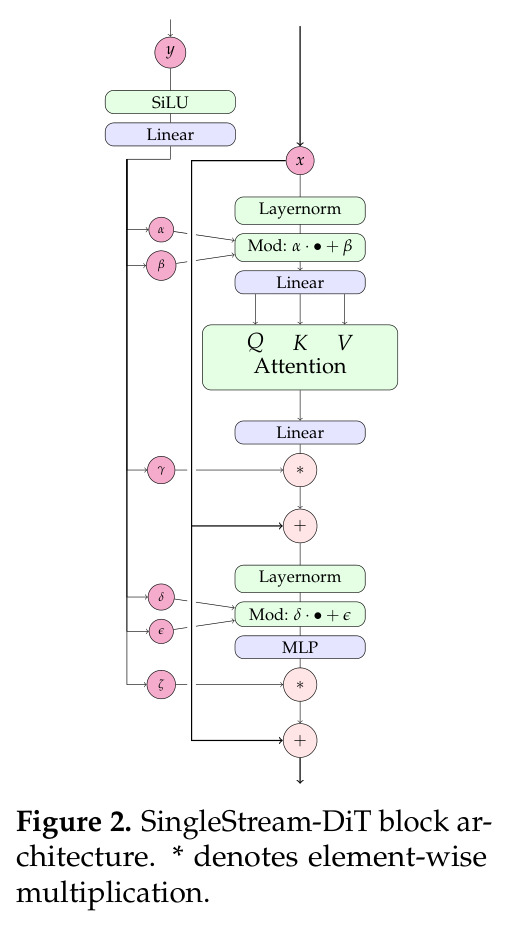
本文用两个独立的 ControlNet 分别注入立体 DSM 和 Pléiades RGB 两种模态,每个 Transformer 块做元素级残差相加,这是全文多模态条件化的核心机制,也是 DSM-only 与 DSM+RGB 对照实验的基础。
DSM 与立体摄影测量
数字表面模型(DSM)是记录地表(含建筑、植被顶面)高程的栅格。立体摄影测量利用同一卫星两次成像的视差三角化恢复高程(CARS、S2P、MicMac 等管线),可从 0.5 m 分辨率的 Pléiades 卫星影像低成本大范围生产,但存在匹配噪声、遮挡空洞和重复纹理误差;机载 LiDAR 精度高一个量级但采集昂贵、覆盖有限。
论文的输入(CARS 立体 DSM)、可选条件(RGB 影像)、监督目标(LiDAR-HD 点云栅格化)和全部误差指标(米制 MAE/RMSE)都围绕这三类地理空间数据展开,不理解数据就无法理解任务。
潜空间扩散与 VAE
Stable Diffusion 先用变分自编码器(VAE)把图像压缩到低分辨率潜空间,扩散/流匹配在潜空间进行以节省算力,生成后再用 VAE 解码回像素。本文把单通道高程图归一化后复制成三通道送入 SD3 的 VAE,解码时对三个通道取平均再换算回米。
VAE 是流程中的固定环节且未微调,其往返重建误差(RMSE 0.573 m、边缘 MAE 0.709 m)是整套方法表征精度的硬约束之一,论文专门用一节诊断它。
Fréchet 距离(FD_DINOv2)
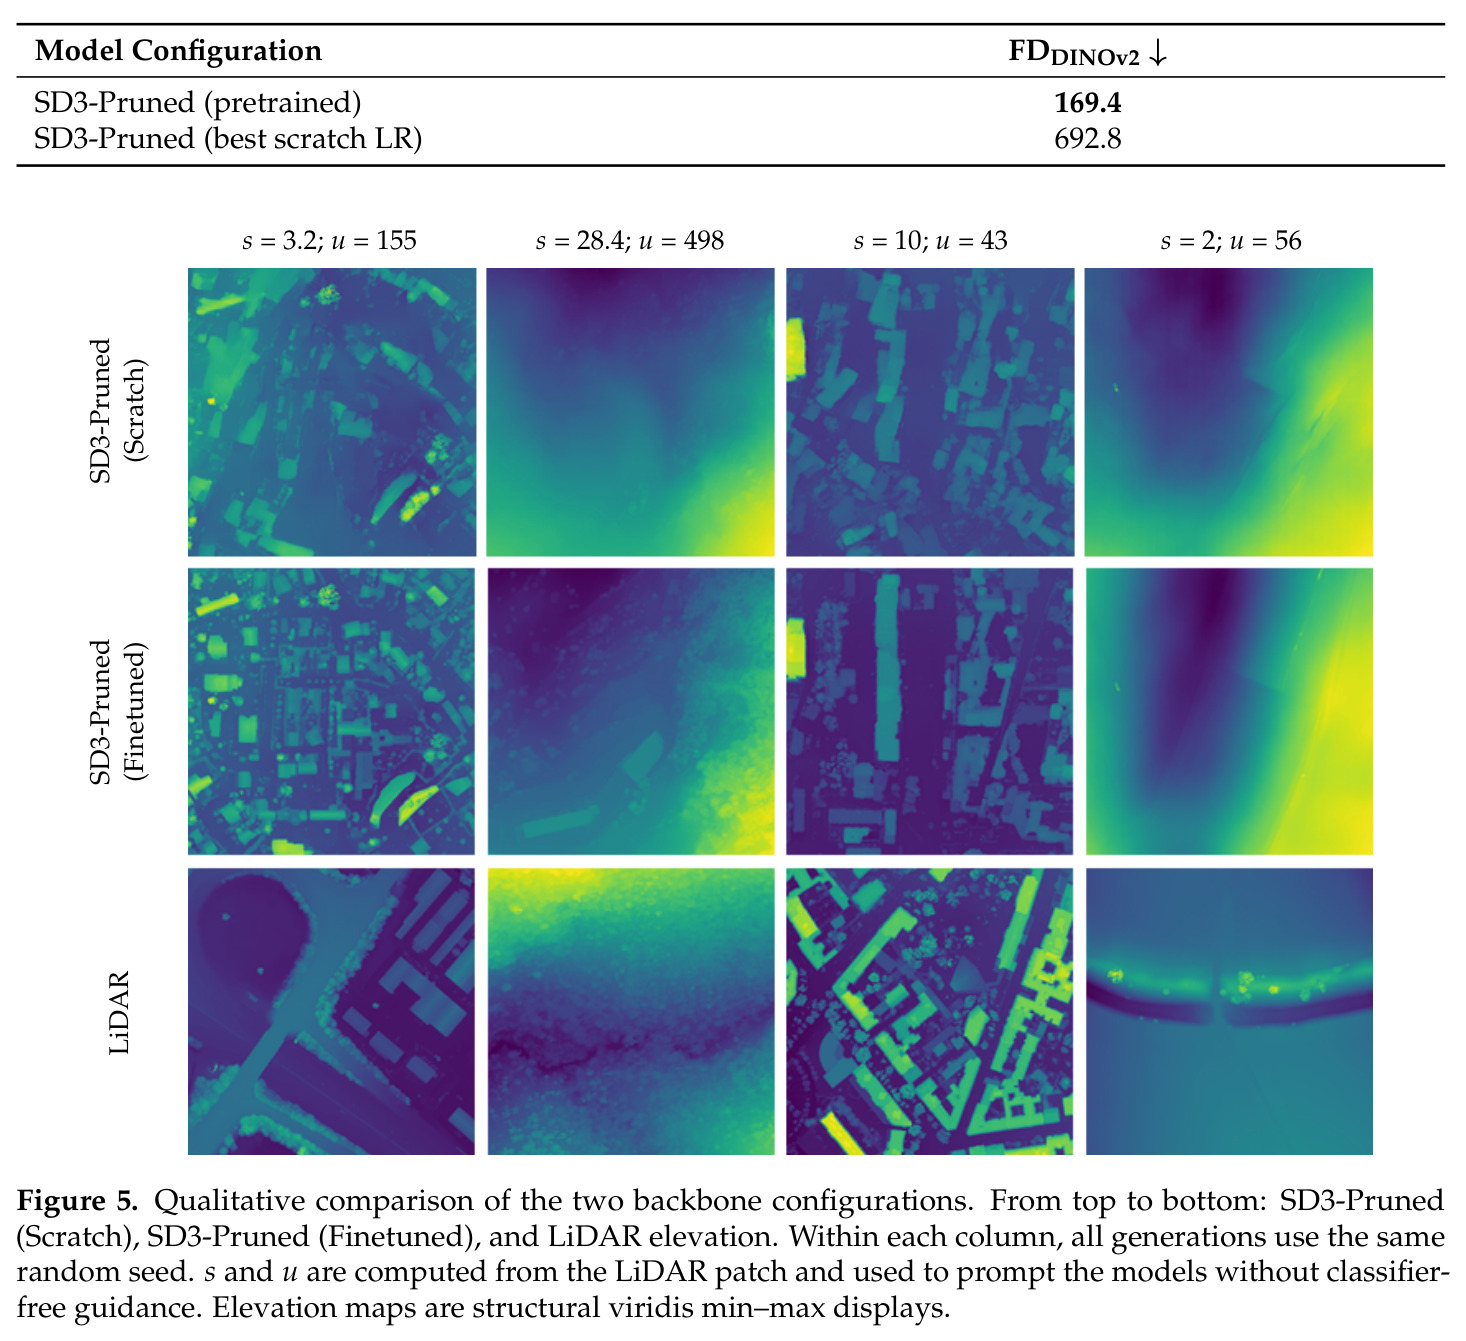
衡量生成样本与真实样本在预训练特征空间(此处用 DINOv2)中高斯分布距离的指标,与图像生成中常用的 FID 同族,无量纲、越低越好。论文在 5 万个样本上计算,用于比较不同骨干初始化策略生成的 LiDAR 高程图与真实 LiDAR 分布的接近程度。
它是'自然图像预训练可迁移到高程域'这一核心主张的唯一量化证据:预训练初始化 169.4 对从零训练最佳 692.8 的差距支撑了整条技术路线的合理性。
研究动机
大范围、低成本的高精度三维地表数据是测绘、城市规划和灾害响应的基础设施。主流做法是用立体摄影测量管线(CARS、S2P、MicMac、NASA ASP)从光学卫星影像(如 Pléiades-HR,0.5 m 分辨率)三角化生成数字表面模型(DSM),成本远低于机载 LiDAR。但这样得到的 DSM 质量明显逊色:立体匹配在重复纹理、遮挡和低纹理区域产生大量噪声与离群值,并留下空洞。论文在法国城市上量化了这一点:经过采集级垂直配准后,CARS 立体 DSM 在 8 个 in-context 测试城市的密集城区 RMSE 高达 6.00 m(MAE 2.95 m),农田区 RMSE 6.64 m,而同区域的机载 LiDAR-HD 点云可提供分米级参考。换言之,密集城区建筑高程平均误差达数米,直接用于城市三维建模并不可靠。LiDAR 虽然精度高,但成本和覆盖限制使其难以支撑大范围、时效性强的制图,偏远地区尤甚。如何把'便宜但脏'的摄影测量 DSM 精化到接近 LiDAR 质量,是本文要解决的核心问题。
本文的目标是本文的目标是训练一个条件生成模型:输入经过垂直配准的摄影测量 DSM(以及可选的同源 Pléiades 正射 RGB 影像),输出误差被系统性修正、直接以米为物理单位的高程图,使其在典型地表类型上逼近 LiDAR-HD 参考。具体可分解为三点:其一,验证从 SD3 自然图像预训练权重出发可以迁移到结构完全不同的高程栅格域,并用 Fréchet 距离定量证明;其二,解决高程数据'全局动态范围大、局部方差小'导致的流匹配训练不稳定问题——数据集中最小的 patch 局部标准差仅 0.00473 m——且不使用任何 epsilon 裁剪或零方差兜底;其三,在同一配对评测协议下拆分量化 DSM 单模态与 DSM+RGB 多模态条件化各自的增量贡献,并在地理上隔离的波尔多市检验泛化能力。
与已有工作不同的是,已有生成式高程工作各自只覆盖相邻任务:Diff-DEM 专注 DEM 空洞填充;MESA 做文本驱动的地形生成;Marigold-DC 在推理时动态融合稀疏深度做零样本深度补全;多个 GAN 系工作(WGAN、上下文注意力等)面向缺失区域补全;DSM-to-LoD2 用 GAN 把立体 DSM 精化为 CityGML 风格的结构化参考;DSM 超分方法改变的是分辨率。论文用 Table 1 的任务边界矩阵说明这些方法的输入设定与评测协议都不同于'对密集、有噪声但已配准的立体 DSM 做系统性逐像素修正'。本文的独特切入有三:一是把校准后的 CARS DSM 本身作为任务基线和条件输入,目标是局部误差修正而非从任意未配准输入重建,并显式声明 A1(垂直配准)与 A2(地表一致性)两个前提假设;二是系统研究 SD3 级别自然图像预训练向度量高程域的迁移,配合 patch-wise 归一化这一新配方;三是用双 ControlNet 在同一协议下分离 DSM 与 RGB 各自的贡献。
核心方法
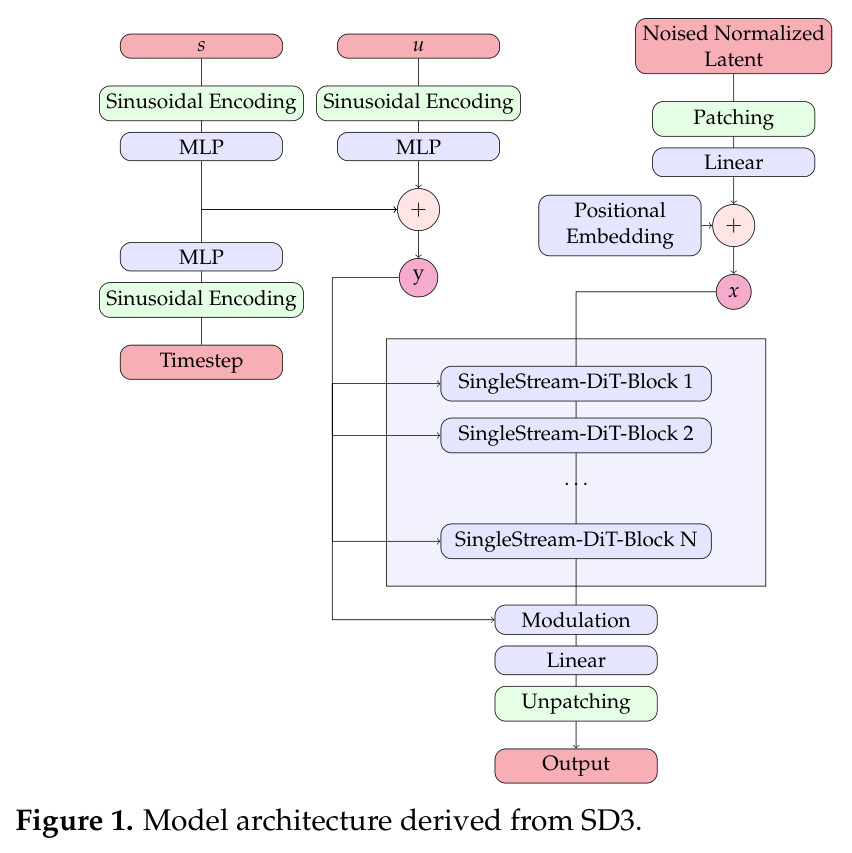
直觉上,立体 DSM 已把建筑和地形的大轮廓放在了正确的高程量级上,缺的是局部精度:噪声、毛刺和少量大离群值。因此让生成模型以 DSM 为'锚',在其邻域内搜索 LiDAR 风格的干净高程场,同时用同源 RGB 影像提供建筑轮廓、树冠等语义边界来消歧。技术上,作者从 Stable Diffusion 3 Medium 出发:先剪掉文本流(CLIP-L/G、T5-XXL 编码器及文本侧 Q/K/V、FFN、LayerNorm 与调制层),把联合文本-图像注意力改成纯图像自注意力,2.028B 参数的 MM-DiT 变成 1.033B 的 SingleStream-DiT 骨干;归一化高程 patch 复制成三通道通过 SD3 的 VAE;冻结骨干旁挂两个 ControlNet 分别吃 DSM 和 Pléiades RGB,逐块以元素级残差注入。训练采用 rectified flow matching,但噪声和目标都被按 patch 平移缩放:$x_0 = s\epsilon + u$、$\hat{x}_1 = (x_1-u)/s$,条件阶段取 $u=\mathrm{mean}(x_{\mathrm{dsm}})$、$s=\mathrm{std}(x_{\mathrm{dsm}})/0.25$;速度场在归一化空间预测,采样后乘 $s$ 加 $u$ 恢复物理单位。
核心创新是 patch-wise 归一化的流匹配配方。直接对以米为单位的原始高程建模时,数据集全局高程范围达数百米,而单个 512×512 patch 内的局部起伏往往只有几米,训练目标(速度场 $v_t = x_1-x_0$)的数值尺度被全局范围主导、局部细节被淹没,训练不稳定。作者不做全局标准化或 epsilon 裁剪,而是在 multisample flow matching 的耦合分布层面动手:令条件噪声 $x_0 \sim \mathcal{N}(u, s^2 I)$,$u$、$s$ 取自目标 patch(骨干阶段)或条件 DSM 的有限像素(条件阶段),使噪声与目标处于同一局部尺度,轨迹变成归一化空间 $\hat{x}_t$ 上的标准 rectified flow;由此推导出速度参数化 $\hat{v}_\theta \approx \hat{x}_1 - \epsilon$ 和按 $s^2/E[s^2]$ 加权的损失——后者把损失恢复到 SD3 在自然图像上的量级,从而可沿用常规微调学习率。与已有方法的本质区别:不做空洞填充、超分或文本驱动生成,而是条件化修正密集输入 DSM 的局部误差;且推理时 $s$、$u$ 只需条件 DSM 即可算出,无需任何目标信息。
方法步骤详情
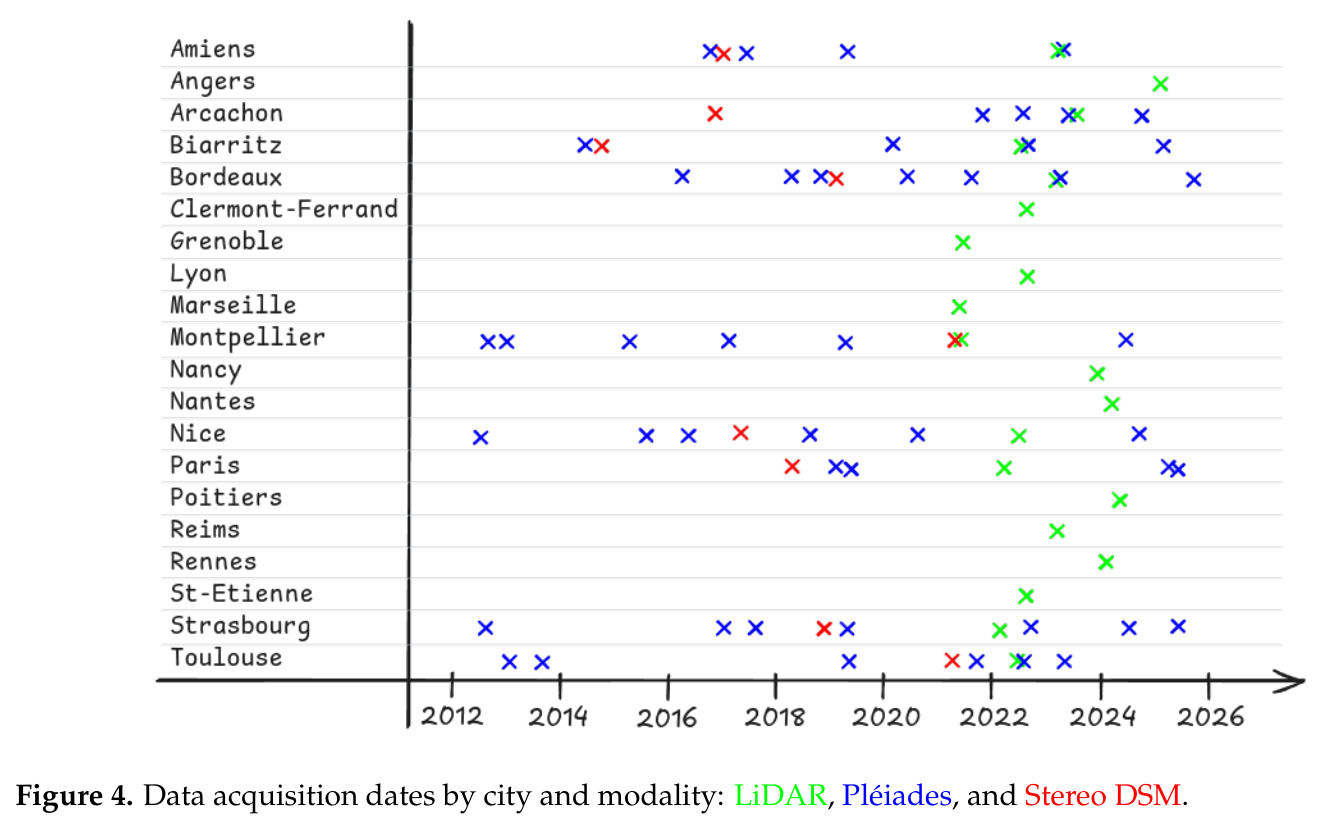
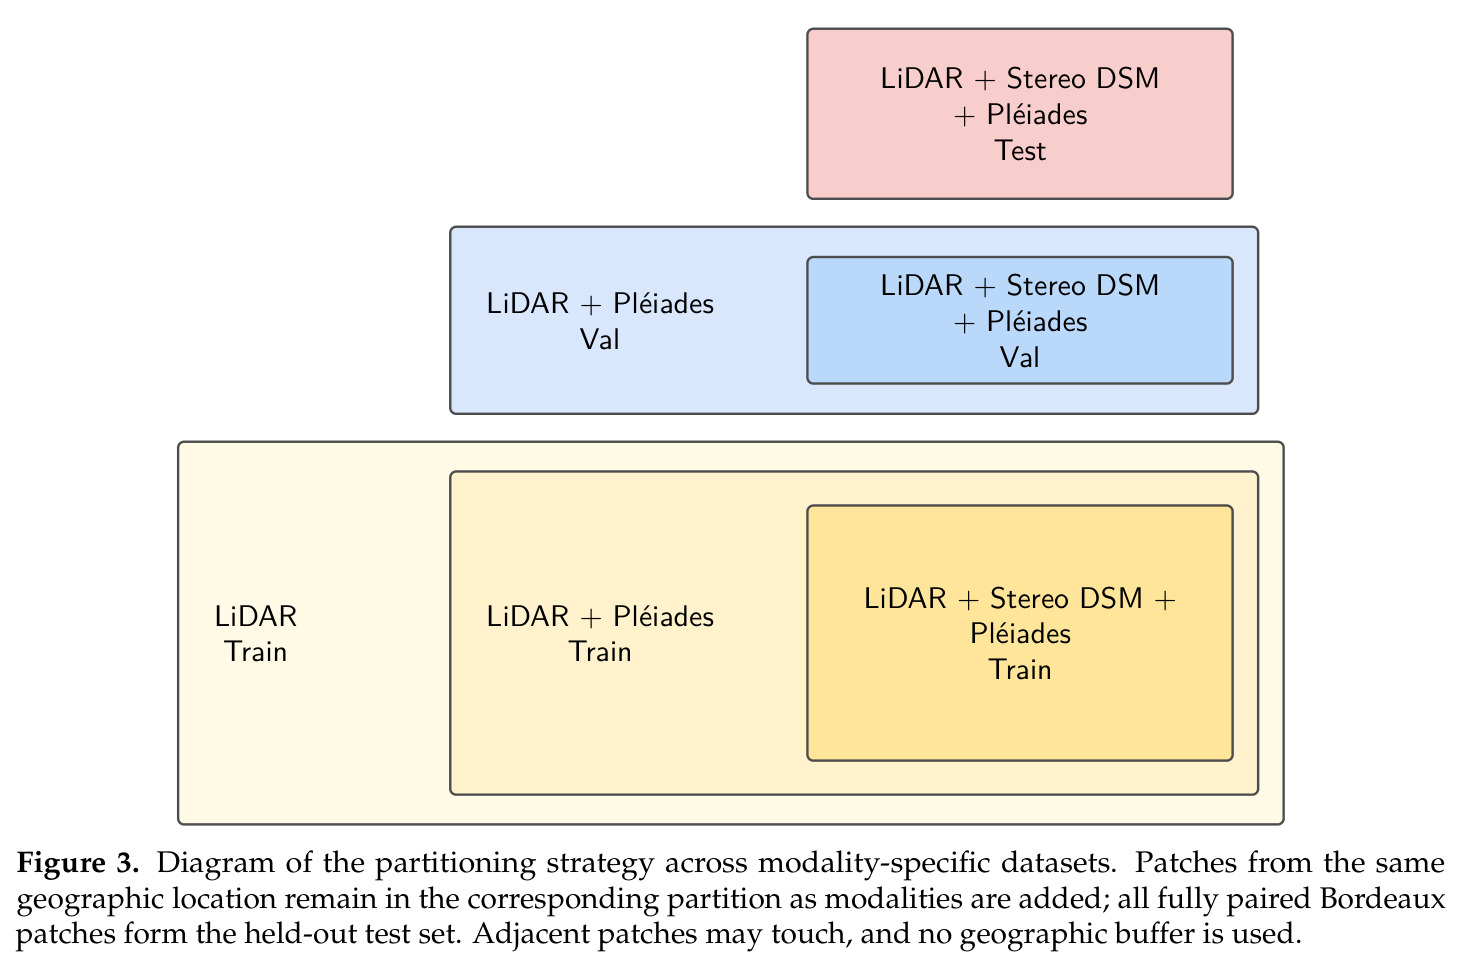
第一步,数据构建:LiDAR-HD 点云经 CARS-rasterize 中值聚合为 0.5 m 栅格,小于 800 像素的 NoData 连通域用 7×7 邻域迭代填充;CARS DSM 通过 ±100 m、4096 bin 的 DSM–LiDAR 差值直方图减去众数 bin 中心完成垂直配准;按城市保留校准 RMSE 低于 P90 的 patch(40,589 中保留 36,525、剔除 4,064)。第二步,切分:512×512 非重叠 patch(每片 256 m×256 m),先切块再划分,8 个城市全配对数据按 70/10/20 分训练/验证/测试(测试 6,385 patch),波尔多 3,209 个全配对 patch 整体留出。第三步,骨干训练:剪枝 SD3 在 19 个城市的 LiDAR 上训练 50k 步(batch 120,lr $1\times10^{-5}$,100 A100 GPU 时)。第四步,顺序 ControlNet 训练:先在 LiDAR+RGB 上训 Pléiades ControlNet(20k 步 batch 120 + 30k 步 batch 360),冻结后再训 DSM ControlNet;DSM 空洞以哨兵值 −1 编码,$s$、$u$ 经正弦编码加 MLP 与时间步嵌入相加。第五步,推理:从高斯噪声出发用 FlowMatchEulerDiscreteScheduler 积分 50 步,VAE 解码三通道取均值后乘 $s$ 加 $u$ 得到米制高程。
技术新颖性
新颖性体现在四个层面。架构上,文本流剪枝是低成本但少见于文献的做法:外科手术式删除 MM-DiT 中文本 token 专属的投影、FFN、LayerNorm 与调制层,把联合注意力降级为图像自注意力,骨干参数从 2.028B 砍到 1.033B、ControlNet 从 1.063B 减半到 0.547B,完整保留图像流预训练权重——FD_DINOv2 169.4 对 692.8 证明权重确实可迁移,且吞吐提升约 1.4 倍。数学上,把'噪声分布也随目标平移缩放'写进耦合 $q(x_0,x_1)$ 并完整推导对应损失与采样流程(Algorithm 1–3),是对 flow matching 框架干净实用的扩展;物理单位在推理末端才恢复,避免病态尺度。训练策略上,双 ControlNet 顺序训练(先 RGB 后 DSM、逐级冻结)规避多模态联合训练的调参风险,尽管作者未做顺序消融。评测设计上,任务边界矩阵、显式 A1/A2 假设、地表类型分层评估、城市级/块级配对 bootstrap 与种子方差分离,都比该领域常见的端到端报告严谨。
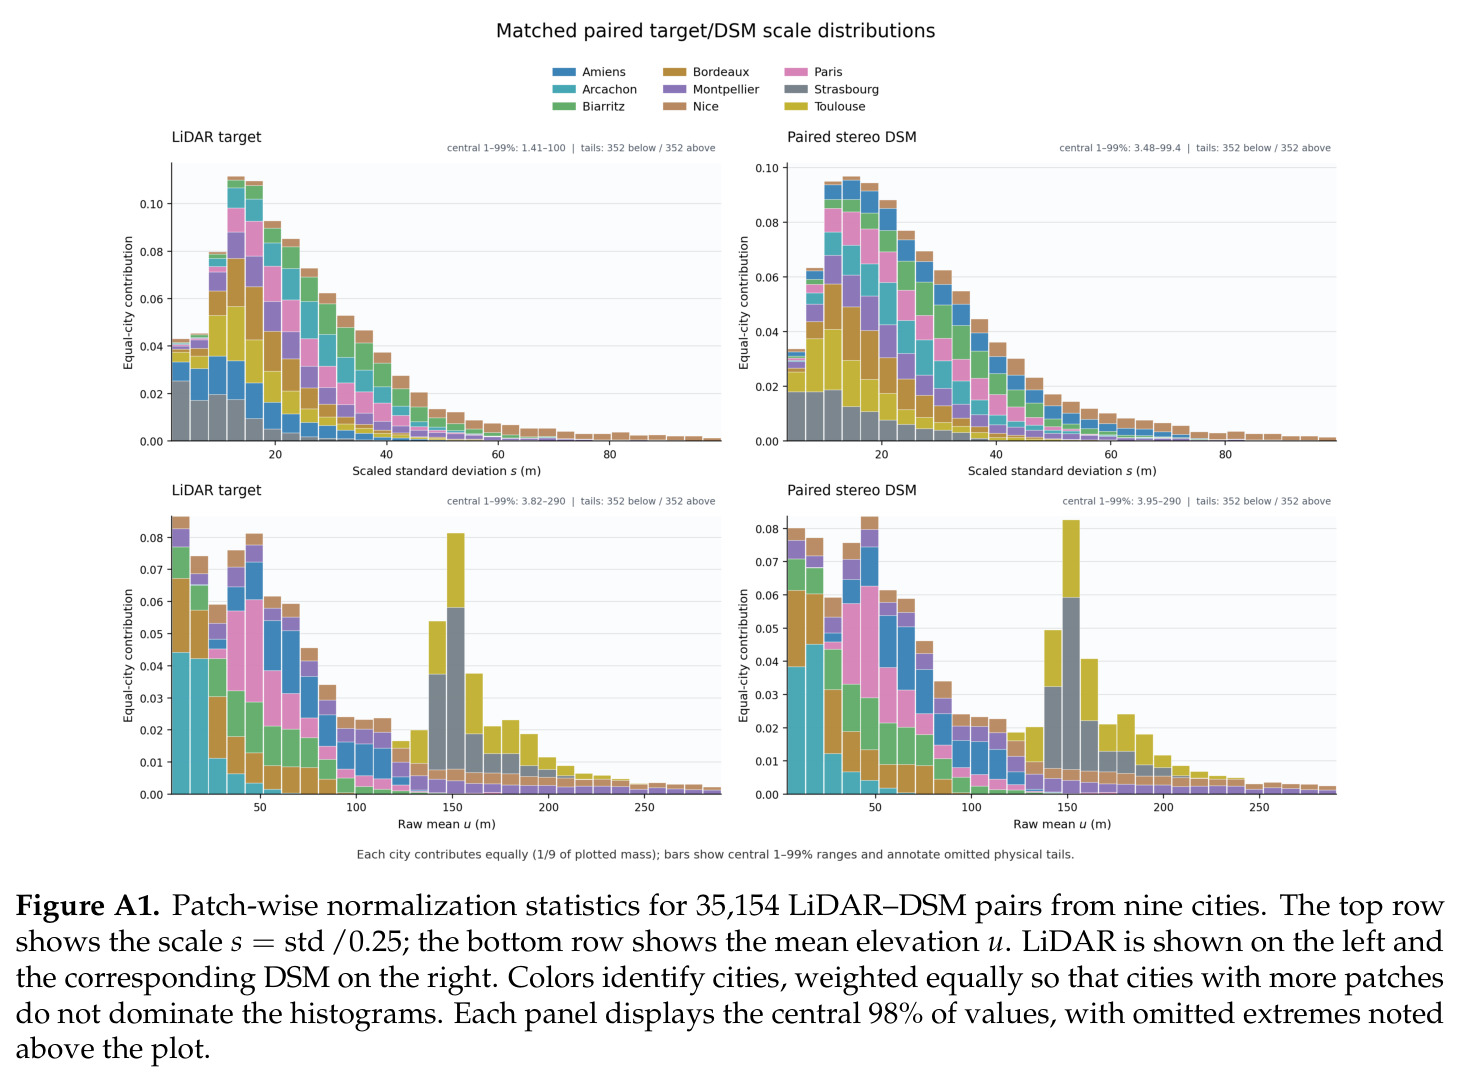
实验结果
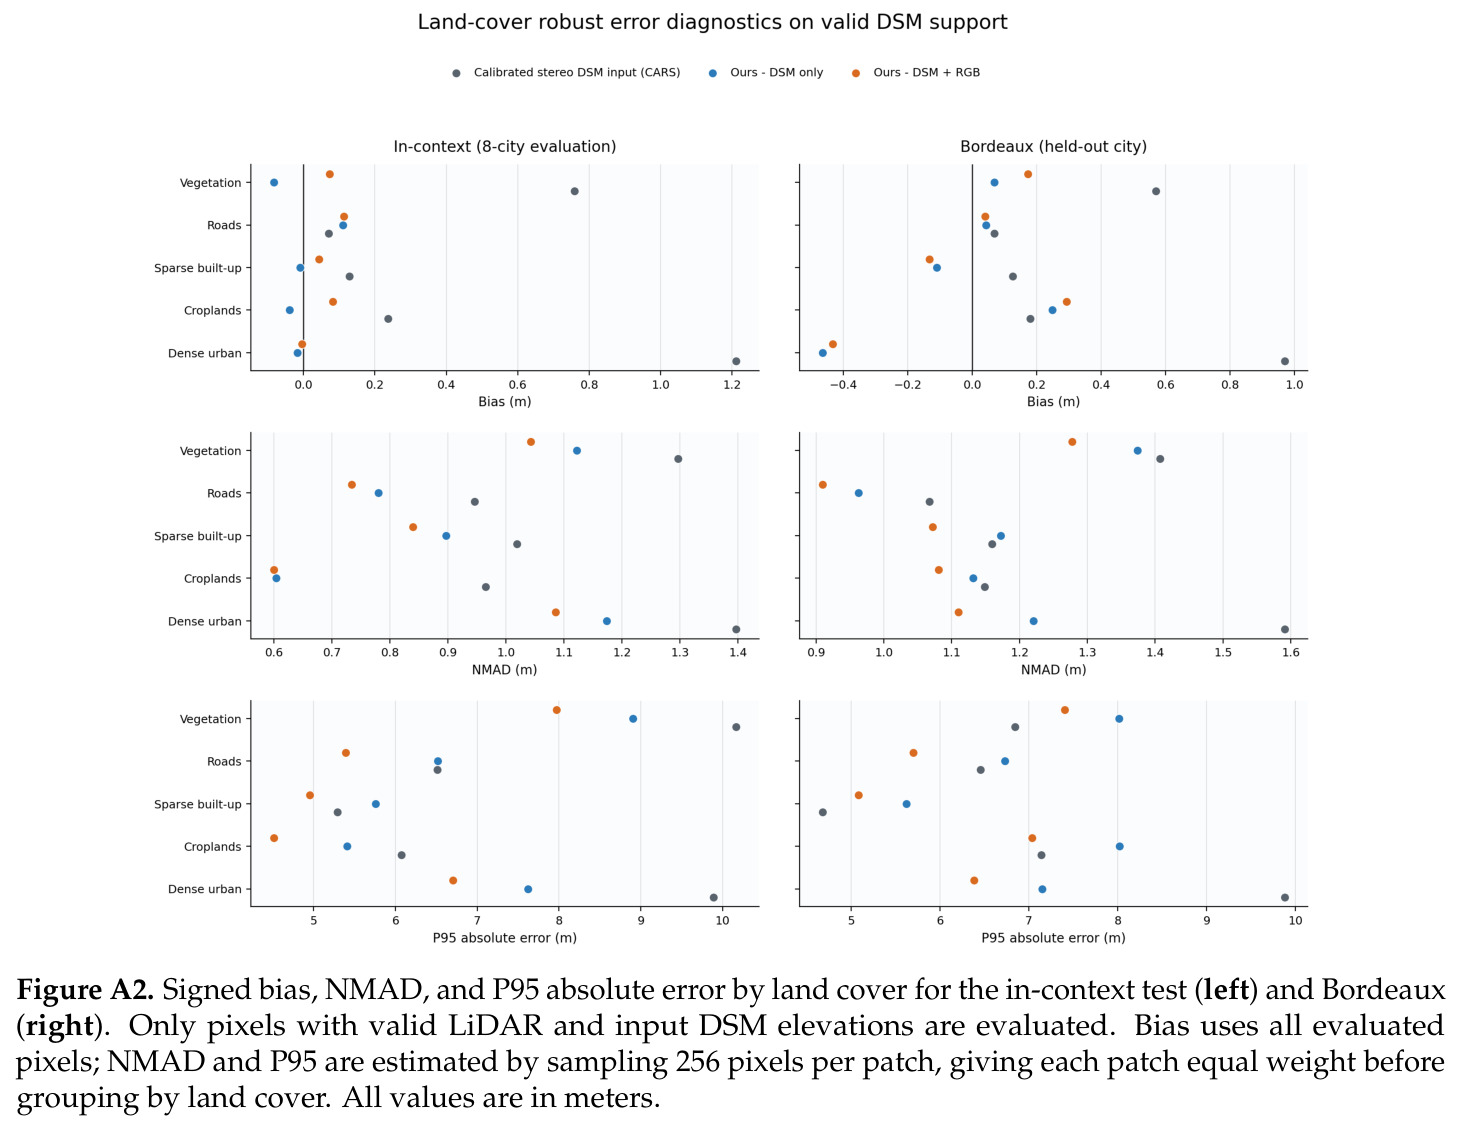
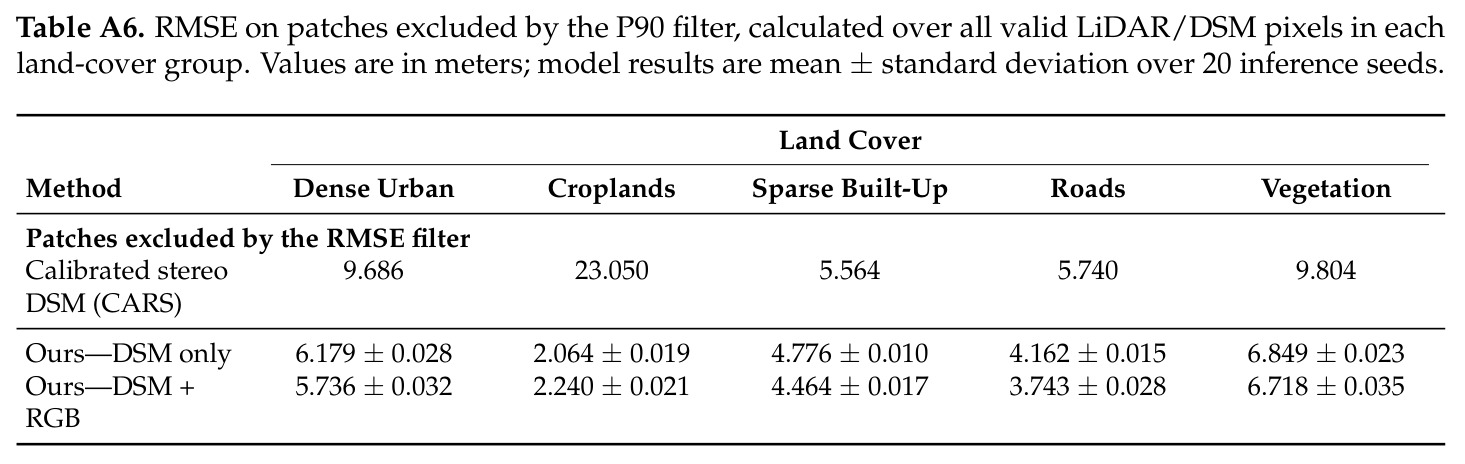
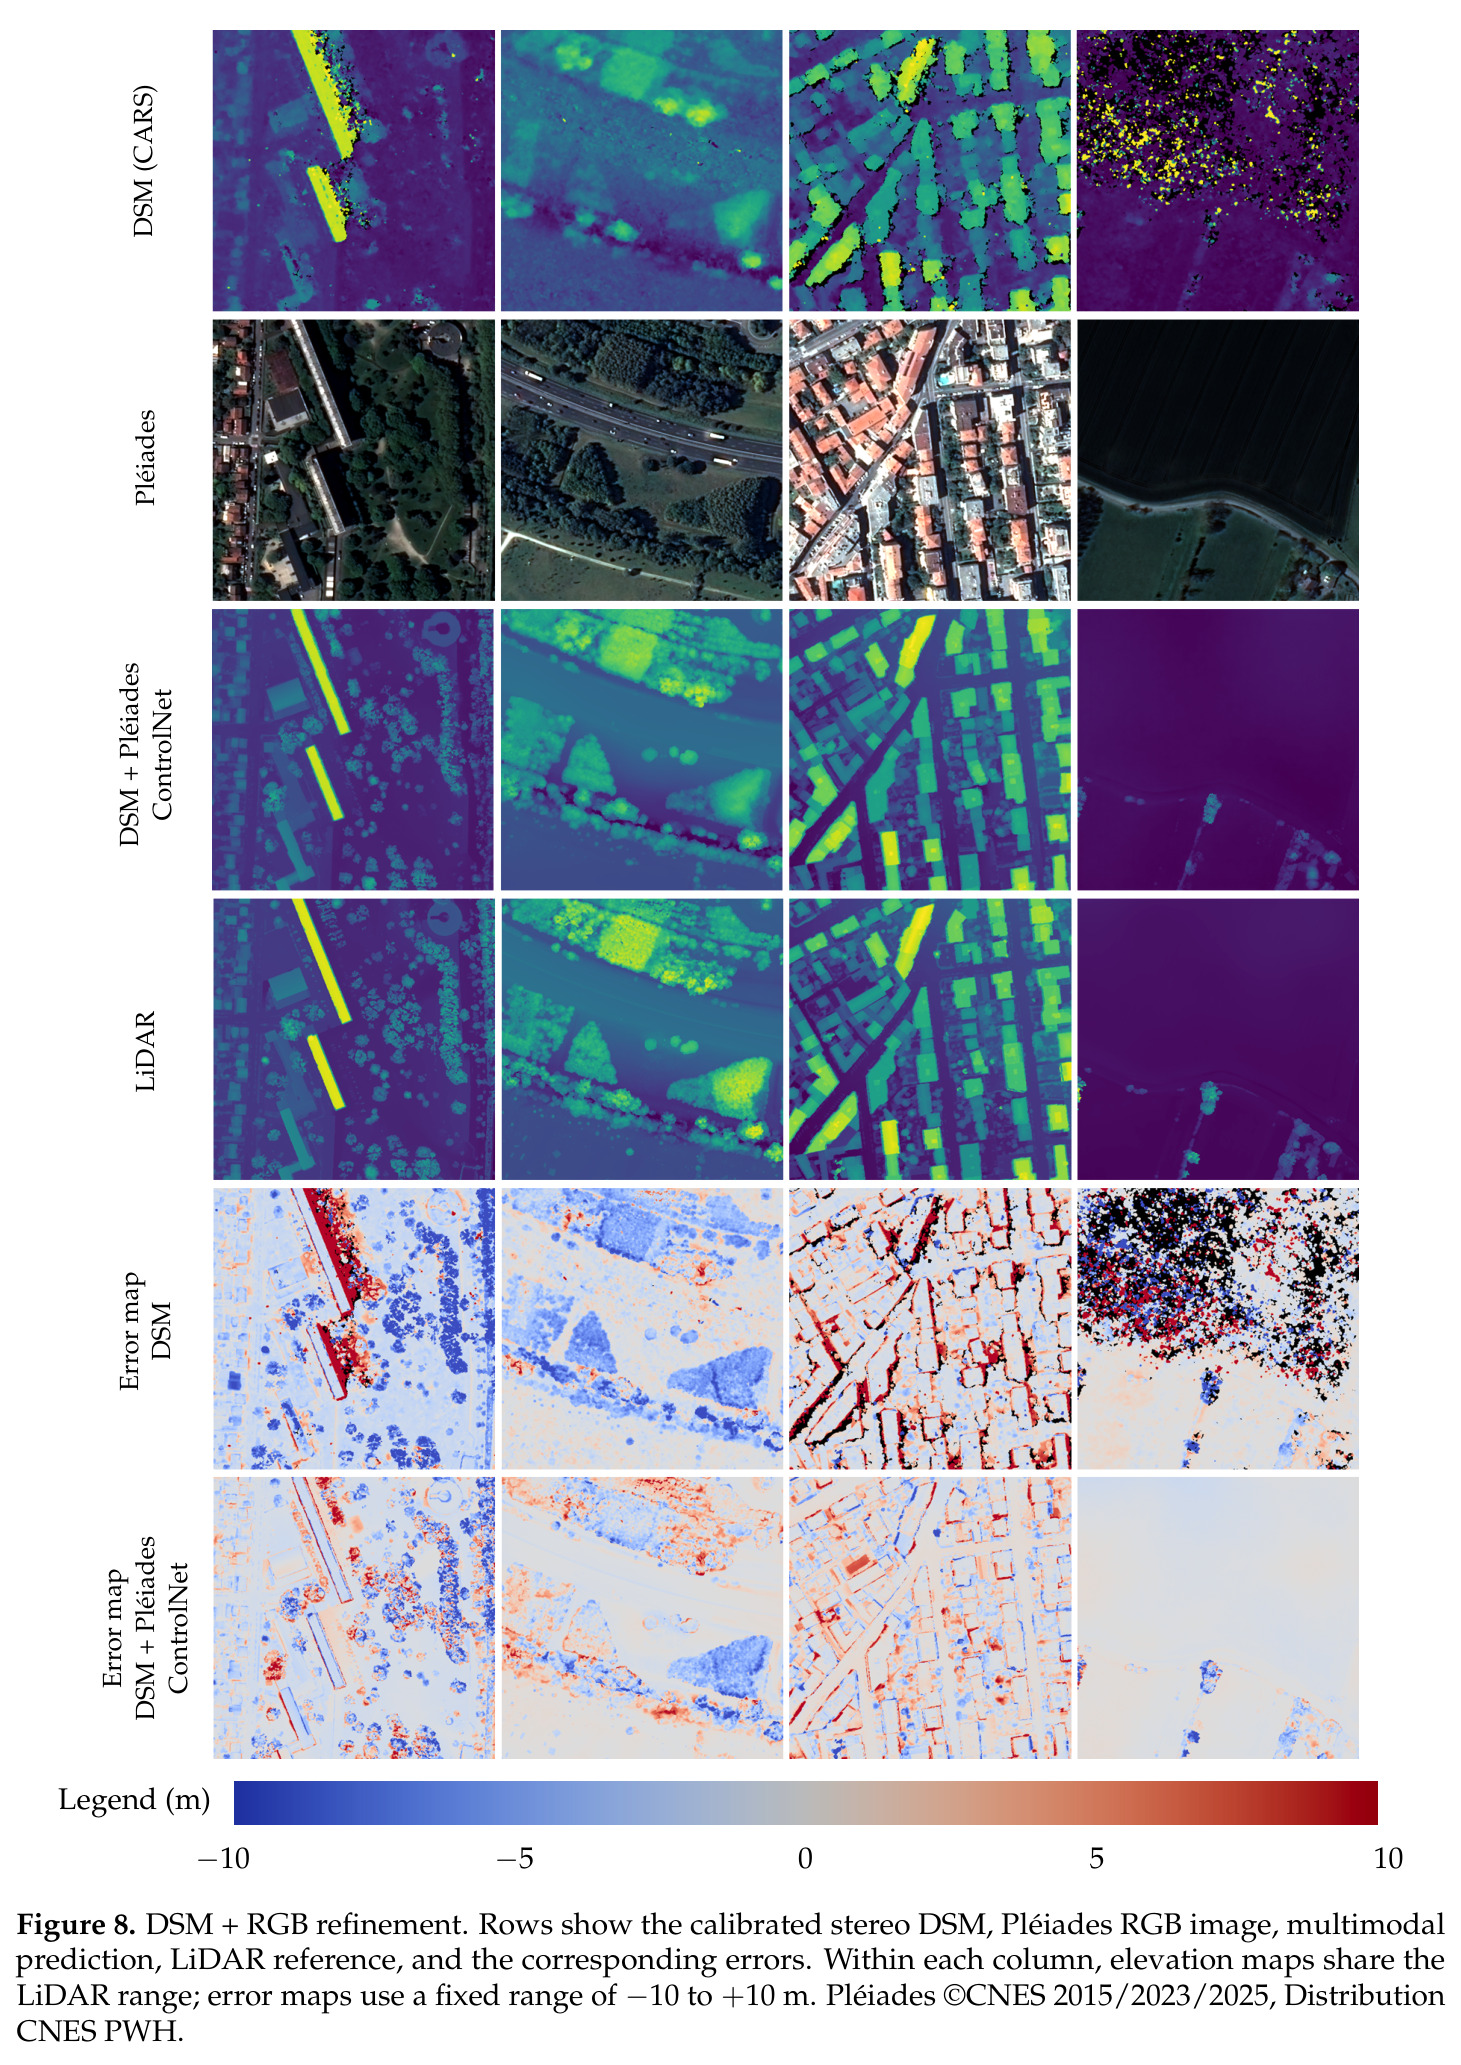
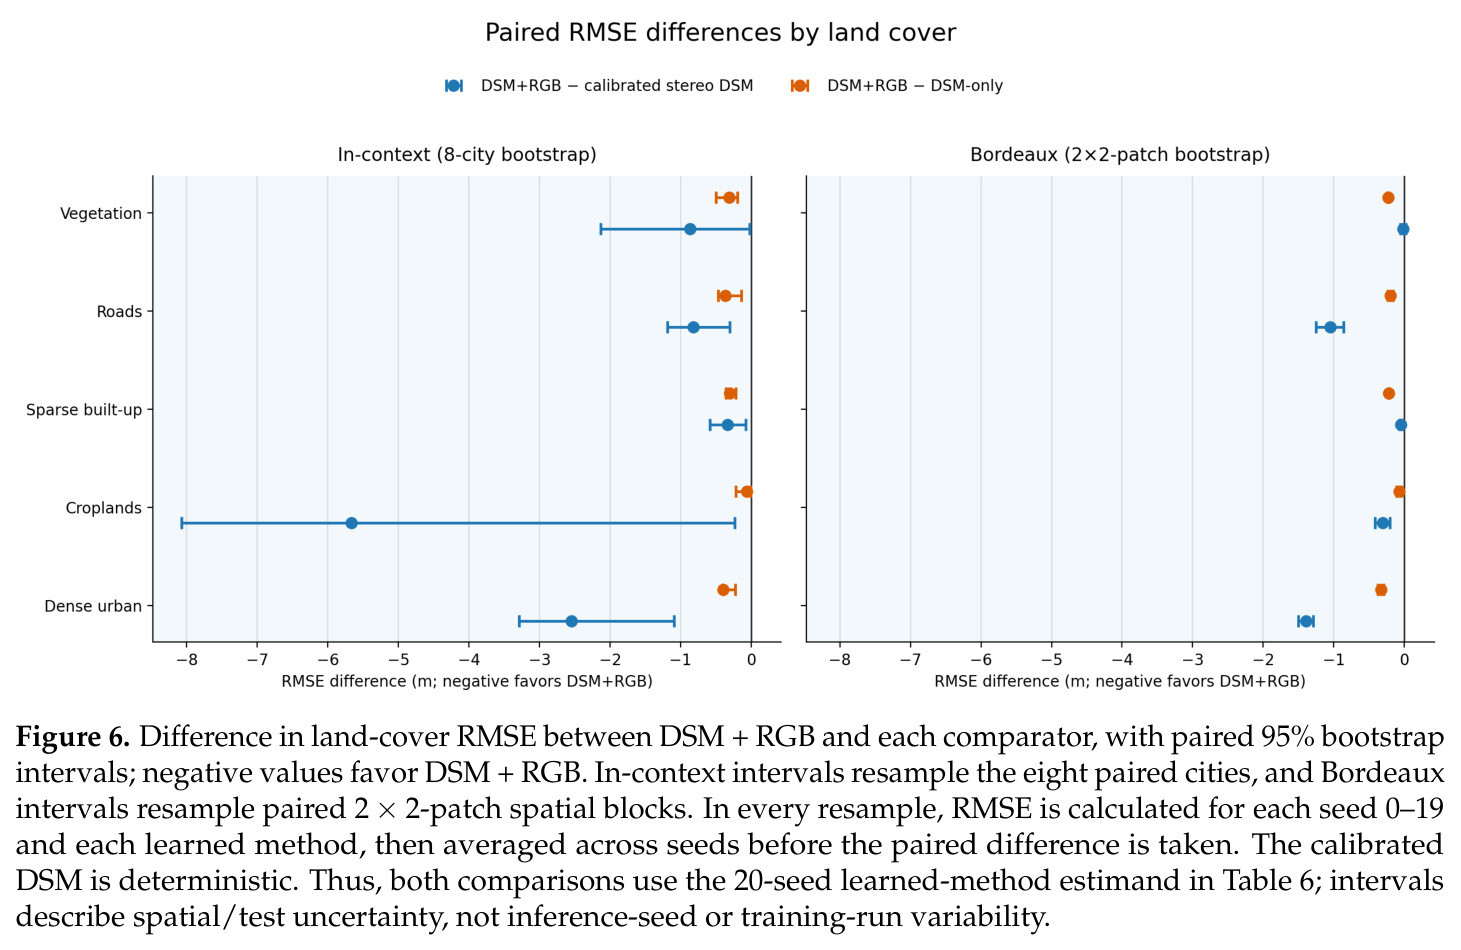
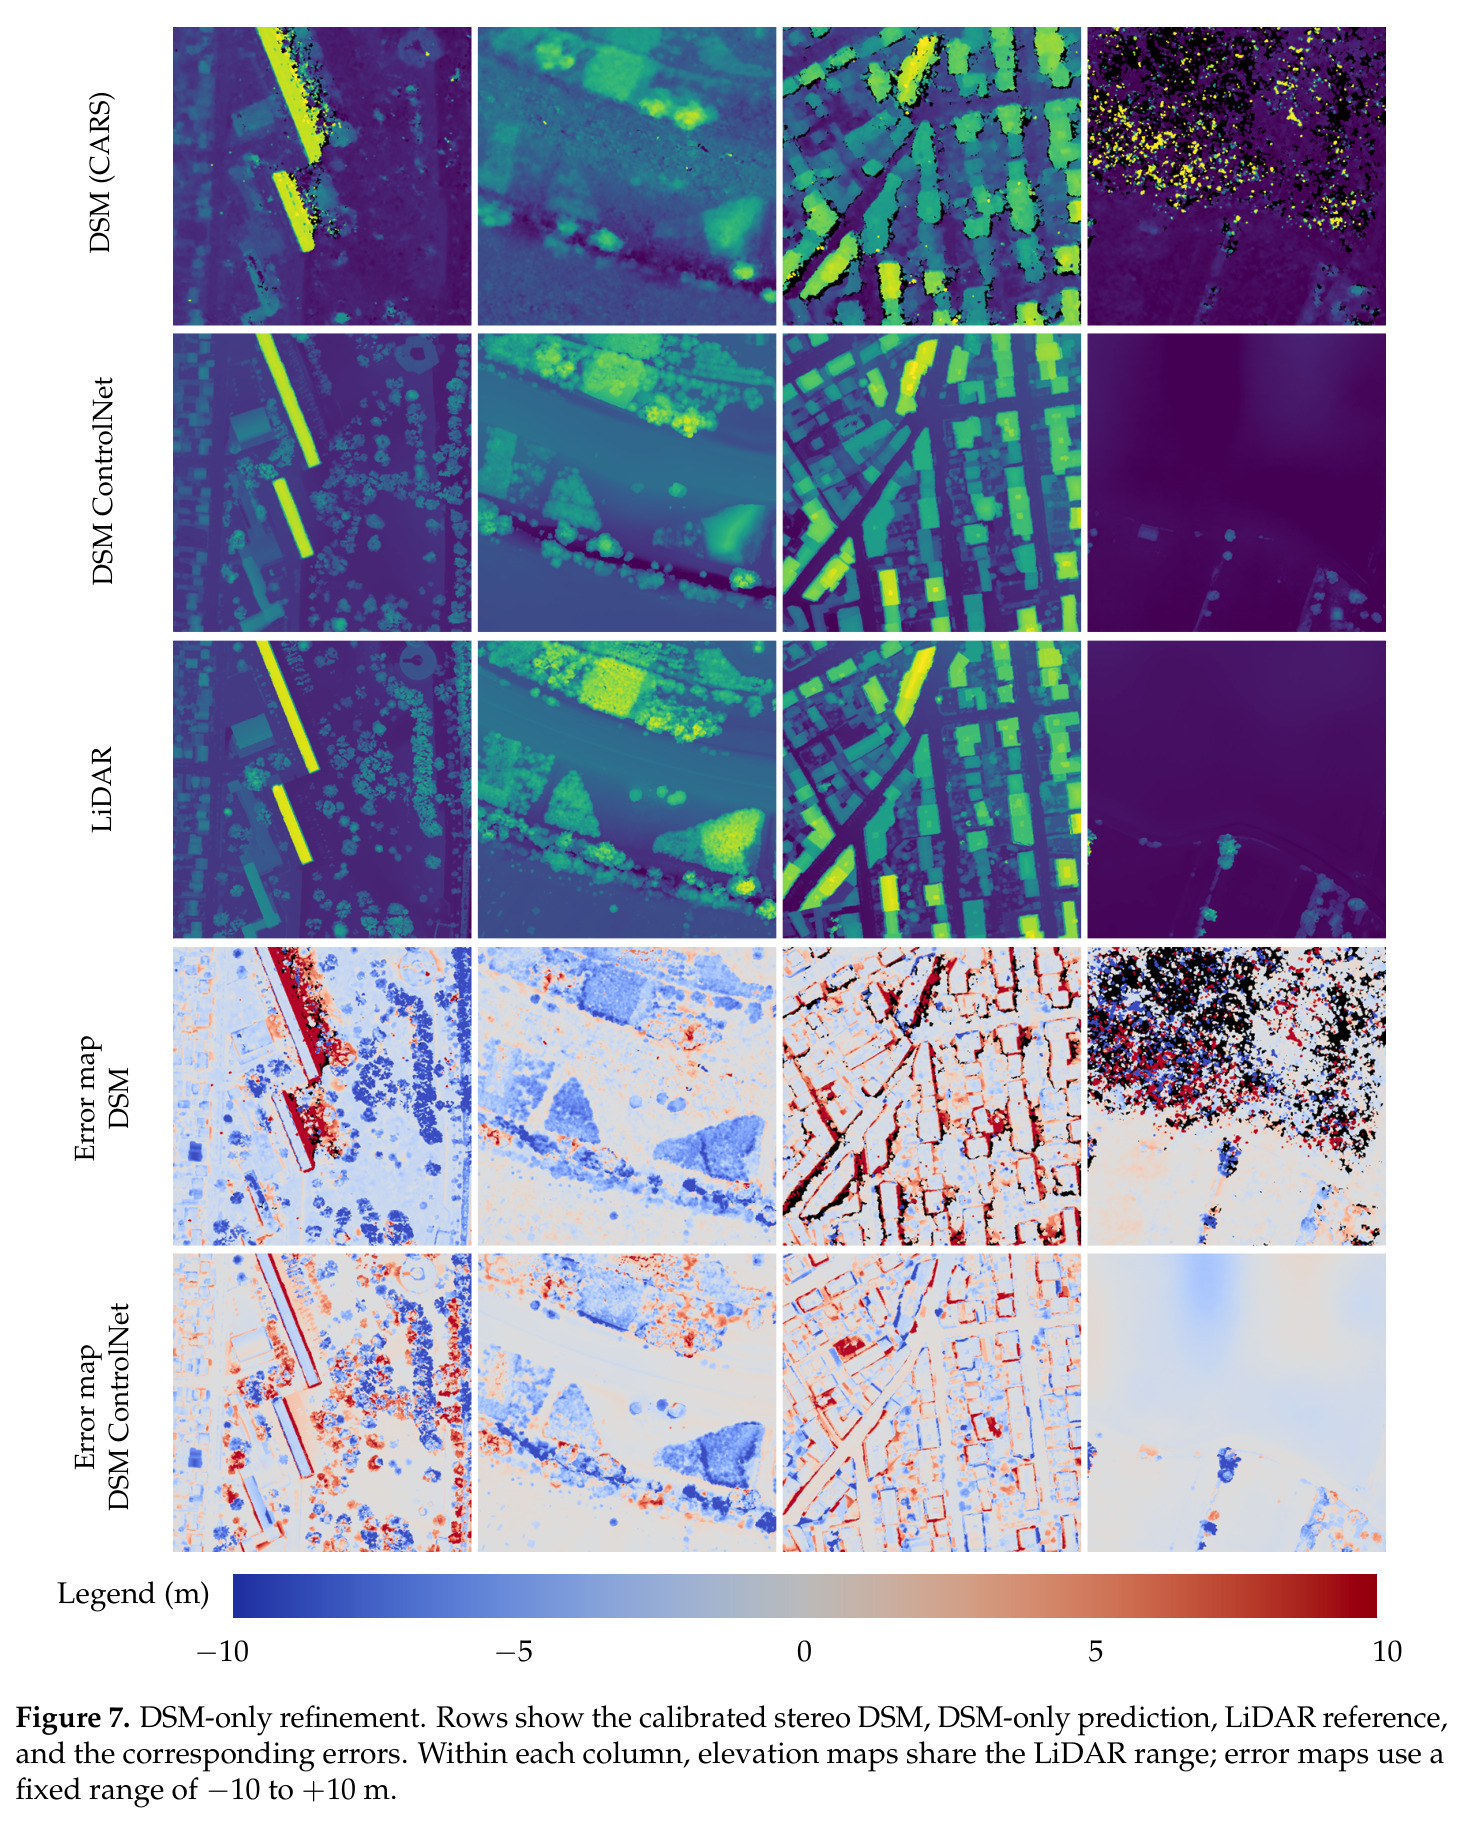
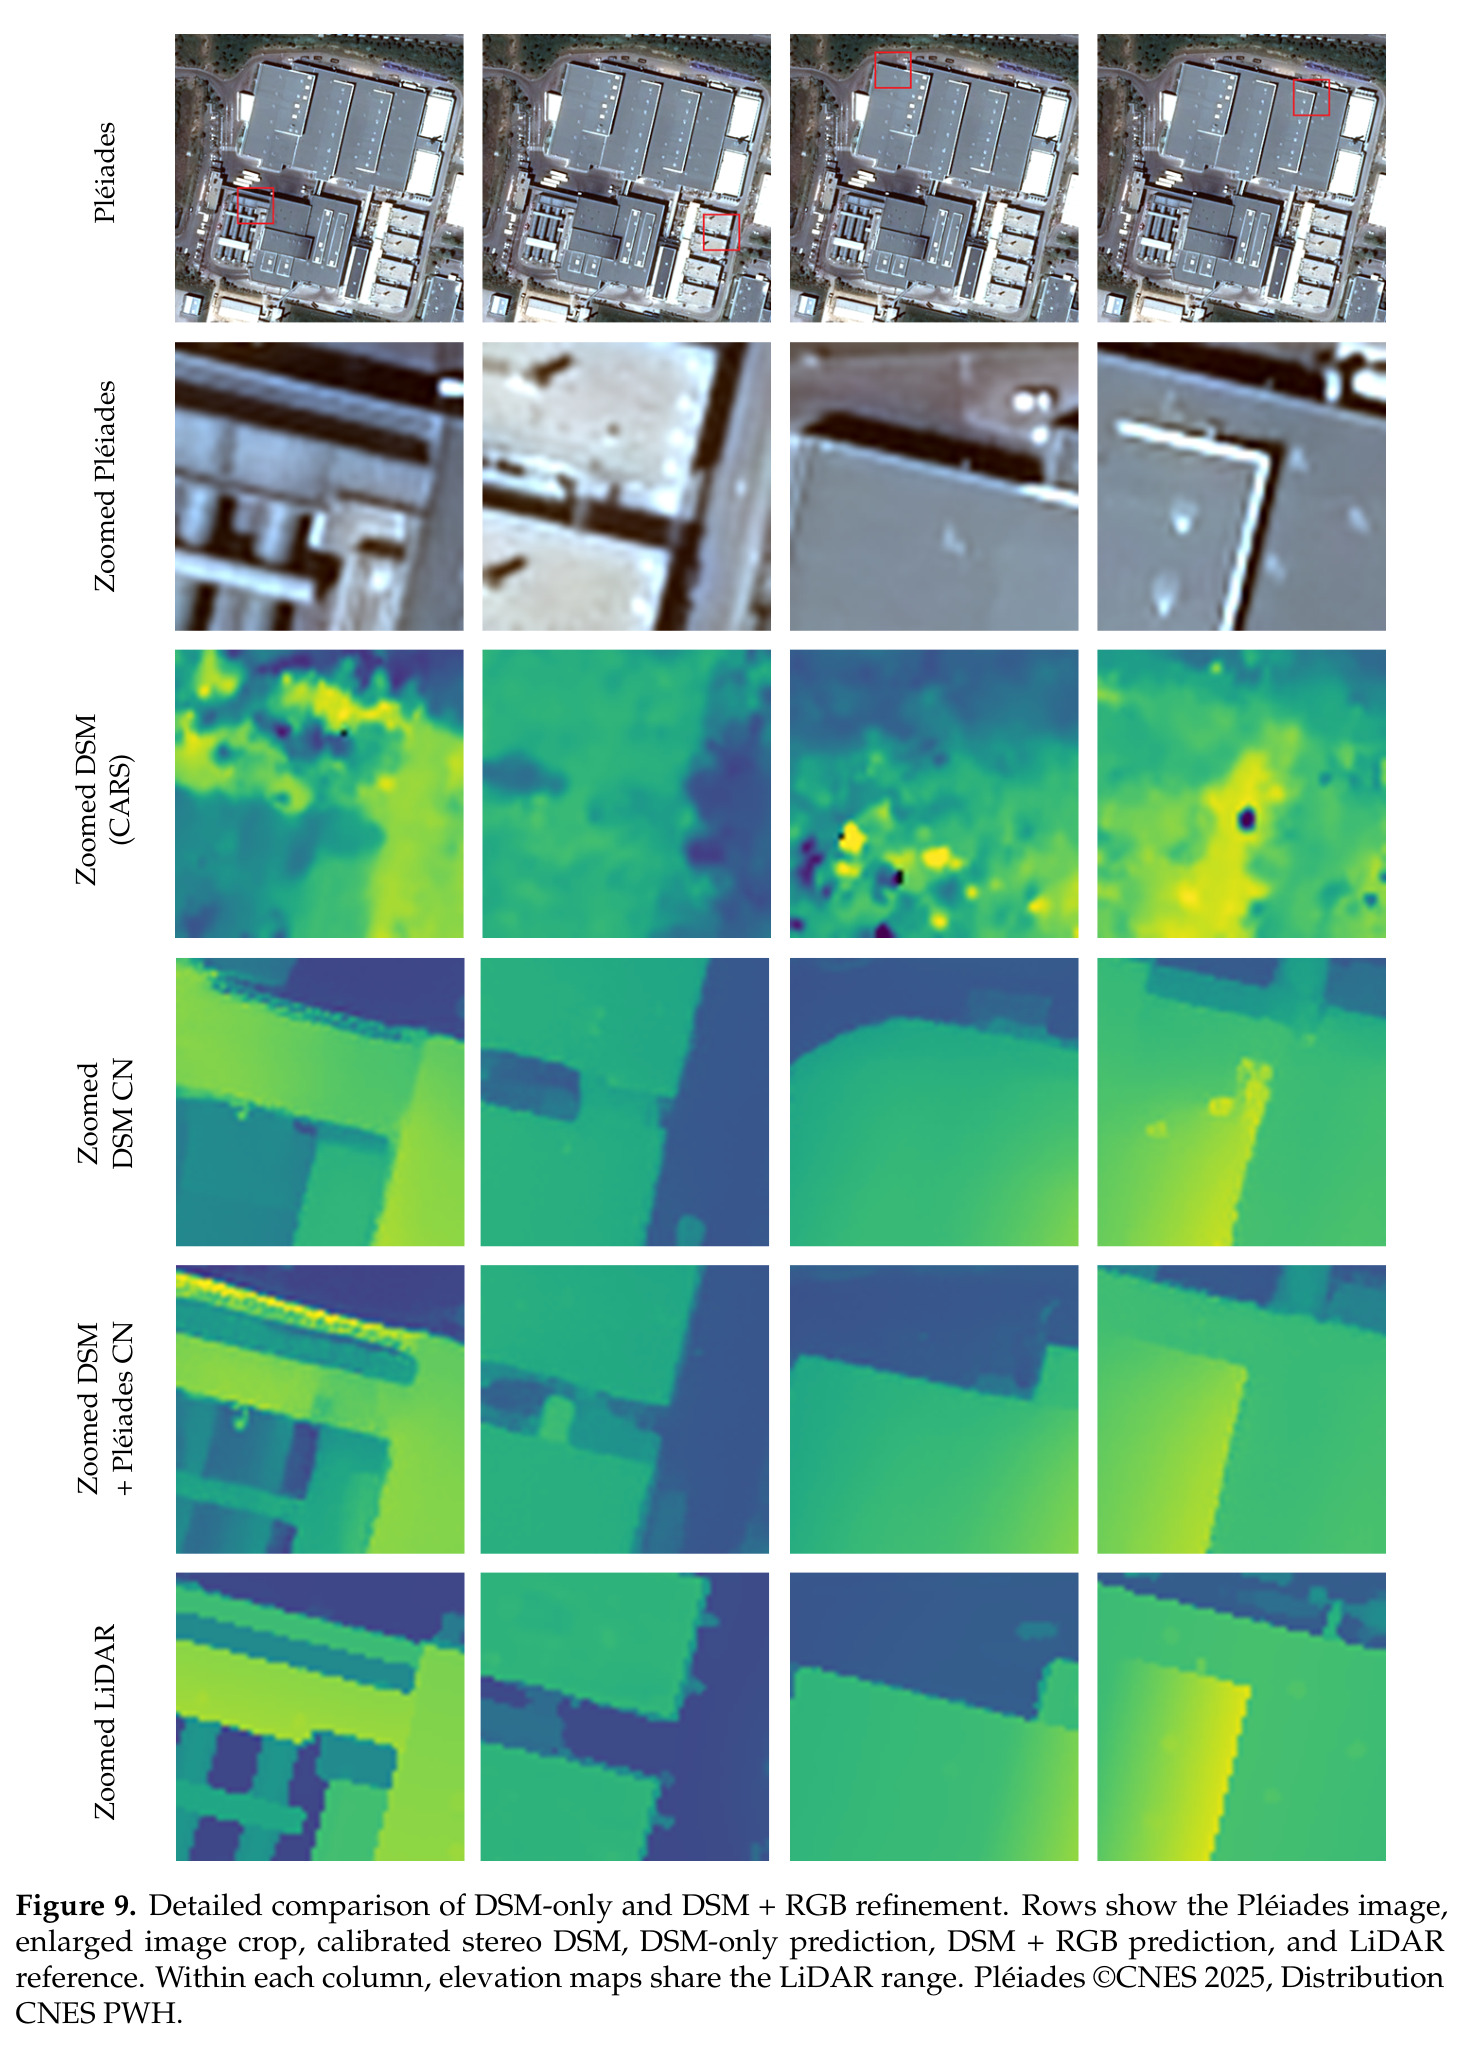
实验链条五环。一,骨干迁移:剪枝架构保留预训练权重的 FD_DINOv2 为 169.4,从零训练扫 6 个学习率后最佳也有 692.8,证明自然图像预训练可迁移到高程域。二,VAE 往返诊断:9,594 个测试 patch 过一遍 SD3 VAE,偏差 −0.004 m、MAE 0.272 m、RMSE 0.573 m,边缘 MAE 0.709 m,构成流程的表征精度下限。三,主实验(20 种子平均):in-context 密集城区 RMSE 从输入 6.00 m 经 DSM-only 3.85 降至 DSM+RGB 3.45 m(−43%),农田 6.64→0.98 m,道路 2.96→2.14 m,植被 4.19→3.32 m;波尔多密集城区 4.16→2.77 m(−33%)、道路 3.12→2.07 m。但 DSM-only 在波尔多使稀疏建成区(2.39→2.56 m)和植被(3.12→3.33 m)变差,RGB 可挽回植被 RMSE(3.10 m)但 MAE 仍高于输入(1.75 对 1.69 m)。四,不确定性:种子标准差最大 0.035 m;10,000 次配对 bootstrap 显示密集城区与道路增益显著,植被区间含零。五,补充:4,046 个被剔除高误差 patch 上两模型仍全面降 RMSE(农田 23.050→2.064 m,但 RGB 使其升至 2.240 m);DSM 空洞处 DSM+RGB 在全部组别优于 DSM-only(密集城区 3.576 对 4.135 m)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 密集城区 DSM 精化(8 个 in-context 城市,6385 patch) | RMSE (m) | 3.45(DSM+RGB) | 6.00(校准 CARS 立体 DSM 输入) | −42.5%(论文报告 43%) |
| 密集城区 DSM 精化(地理留出城市波尔多,3209 patch) | RMSE (m) | 2.77(DSM+RGB) | 4.16(校准 CARS 输入) | −33% |
| 农田 DSM 精化(in-context) | RMSE (m) | 0.98(DSM+RGB) | 6.64(校准 CARS 输入) | −85% |
| 道路 DSM 精化(波尔多) | RMSE (m) | 2.07(DSM+RGB) | 3.12(校准 CARS 输入) | −34% |
| 高程图生成骨干(LiDAR 域,预训练 vs 从零) | FD_DINOv2(越低越好) | 169.4(预训练初始化) | 692.8(从零训练最佳学习率 $2\times10^{-4}$) | 降低约 4.1 倍 |
| 剪枝架构推理效率(A100、batch 32、50 步采样+VAE 解码) | 吞吐(样本/秒) | 1.74(骨干+VAE,剪枝后) | 1.22(未剪枝 SD3 Medium) | +43%(约 1.4×),显存 39.19 对 41.72 GiB |
局限与改进
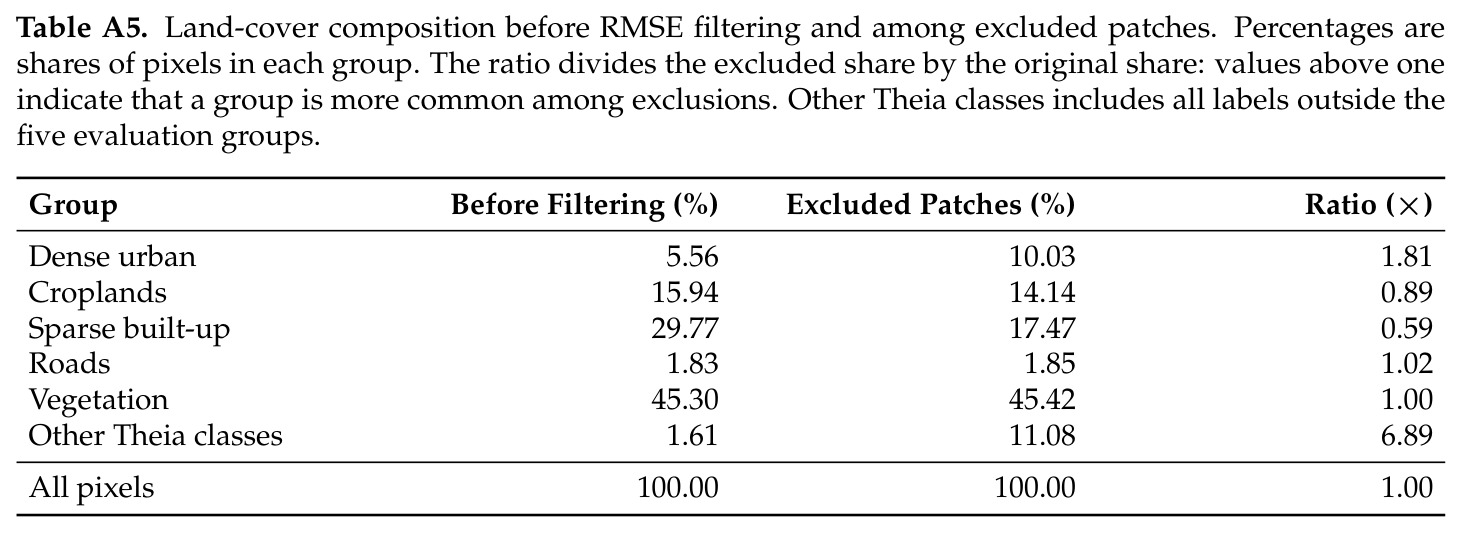
作者承认的局限:方法依赖 A1(输入已垂直配准)与 A2(地表一致),不能自行估计垂直基准;P90 筛选是间接启发式且改变数据构成——密集城区像素在剔除集中占比是原来的 1.81 倍、其他类 6.89 倍;仅一个留出城市、同一 Pléiades/CARS 设定,未验证他国、其他传感器或地形;相邻训练/测试 patch 允许接触、无空间缓冲,bootstrap 不能完全消除空间依赖;10 m 土地覆盖标签只是粗分层;未与其他 DSM 增强方法做任务匹配对比,只证明优于未精化输入与 DSM-only;高层建筑、桥梁、陡坡未评估。我的观察:双 ControlNet 推理吞吐仅 0.82 样本/秒(A100、batch 32、每 patch 约 0.065 km²),全国尺度制图需数月单卡时;VAE 往返 RMSE 0.573 m、边缘 MAE 0.709 m,为 RGB 设计的 VAE 会模糊建筑边缘等高频结构;植被负迁移被归因于物候但无定量时相分析;ControlNet 顺序、P90 阈值、LiDAR 填充规则均未消融。
独立分析的弱点
第一,强依赖输入配准:若 DSM 未与目标垂直基准配准(现实中常见,恰是廉价 DSM 最典型的系统性误差),模型无从修正整体偏移;改进方向是把采集级偏移作为可估计变量,或把直方图众数配准自动化为前端模块。第二,算力与延迟:50 步采样加 VAE 解码在单张 A100 上双 ControlNet 仅 0.82 样本/秒,单个城市可承受但全国尺度代价高昂,可引入时间步蒸馏或一致性模型。第三,VAE 瓶颈:单通道高程复制三通道塞进为自然图像训练的 VAE,边缘 MAE 0.709 m 表明高频结构被模糊,走向分米级应用时将成为硬约束;为高程域微调 VAE 或改用像素空间/高程专用潜空间更干净。第四,多模态收益不稳定:农田加 RGB 在剔除集上变差(2.064→2.240 m),波尔多植被近似无增益,说明 RGB 价值依赖影像与 DSM/LiDAR 的时相一致性,可把采集间隔或物候特征作为显式条件。第五,筛选规则敏感性未量化,换用其他分位阈值后结论稳健性未知;两 ControlNet 的元素级残差融合也未与注意力融合、联合训练等机制对比,最优融合方式存疑。
未来方向
作者提出的方向:扩展到更大地理范围、其他城市与传感器,评估未过滤、独立配准的输入;用时间步蒸馏减少采样步数使大区域处理实用化;探索用自然灾害(滑坡、地震)前后的立体 DSM 精化改进高程变化图,但需验证精化不会抹掉或伪造真实变化;把适配后的扩散骨干作为地理空间预训练表征迁移到分割、目标检测等下游任务。基于本文成果可自然延伸的:开发自动化的 DSM–RGB–LiDAR 配对质量控制管线,替代粗糙的 P90 规则并直接检测 A2 违反(建设、拆除、物候变化);系统消融 ControlNet 融合方式、训练顺序与联合训练;设计高程专用 VAE 以消除 0.573 m 的表征地板;研究瓦片边界连续性,使模型可无缝拼接大图生产;引入时相感知条件(多日期 RGB 加采集间隔),把季节变化从干扰源变成信息源;在桥梁、高层建筑、陡峭地形等未覆盖场景建立专门基准;以及将 patch-wise 归一化推广到其他物理值栅格(温度、污染、重力场)的生成建模,这是论文 Highlights 明确暗示的通用价值。
复现评估
复现门槛较高。数据:LiDAR-HD 可从 IGN 免费下载,但 Pléiades-HR 是 CNES 商业产品(经 PWH 获取),CARS DSM 依赖 Airbus 影像;论文声明因 IGN/CNES 及商业许可限制不能重新分发任何数据,'实现未公开发布',模型权重、源 TIFF、原始 patch 均不提供,第三方只能按合理请求索取配置细节与非受限摘要——直接复现论文数字不可能。算力:全部训练用 NVIDIA A100,骨干 100 GPU 时、DSM-only ControlNet 340(70+270)、多模态两阶段 340+440,总计千级 A100 GPU 时以内,学术团队可承受但不轻量。方法描述完整:Algorithm 1–3 给出归一化、训练、推理伪代码,超参(AdamW、lr $1\times10^{-5}$、batch 120→360、BF16、梯度裁剪 1)与评测协议(20 种子、10,000 次 bootstrap)均在正文与附录。综合:在开源数据(如 USGS 3DEP LiDAR 加开放影像)上重新实现可行、难度中等偏上(需复刻 CARS 生成与垂直配准流程);完全复现结果受数据许可限制。
论文图表
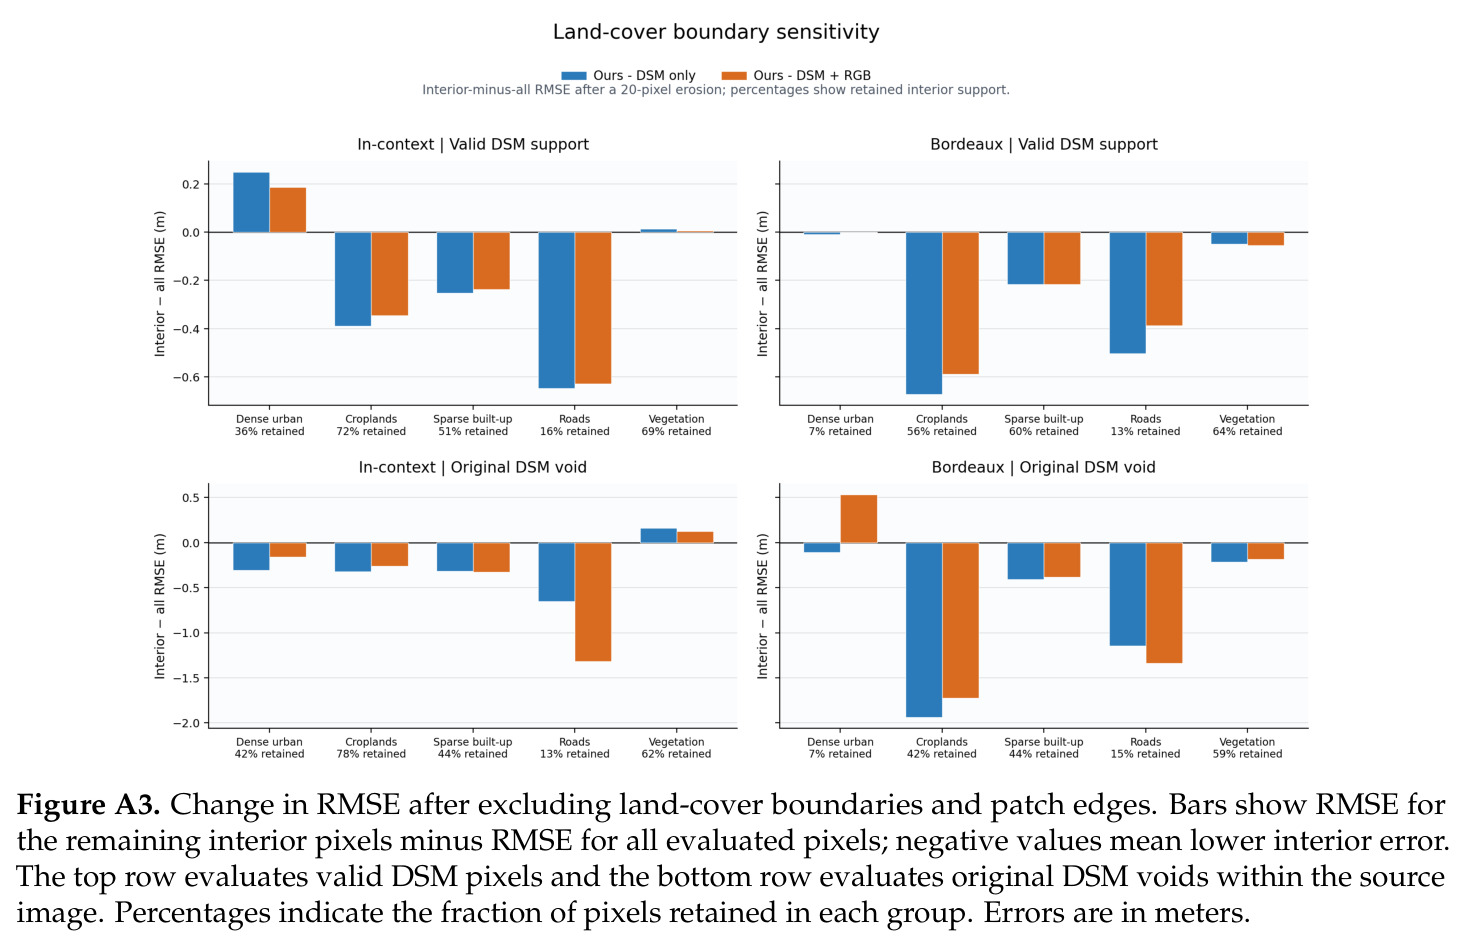
剔除 10 m(20 像素)类边界与 patch 边缘缓冲后重算 RMSE 的变化(负值表示内部误差更低);农田、稀疏建成区、道路的内部误差更低,但道路和波尔多密集城区仅剩很小比例的像素。
评估 10 m 粗标签向 0.5 m 网格重采样带来的边界混合效应对分层指标的影响,说明分层结果的解释边界。
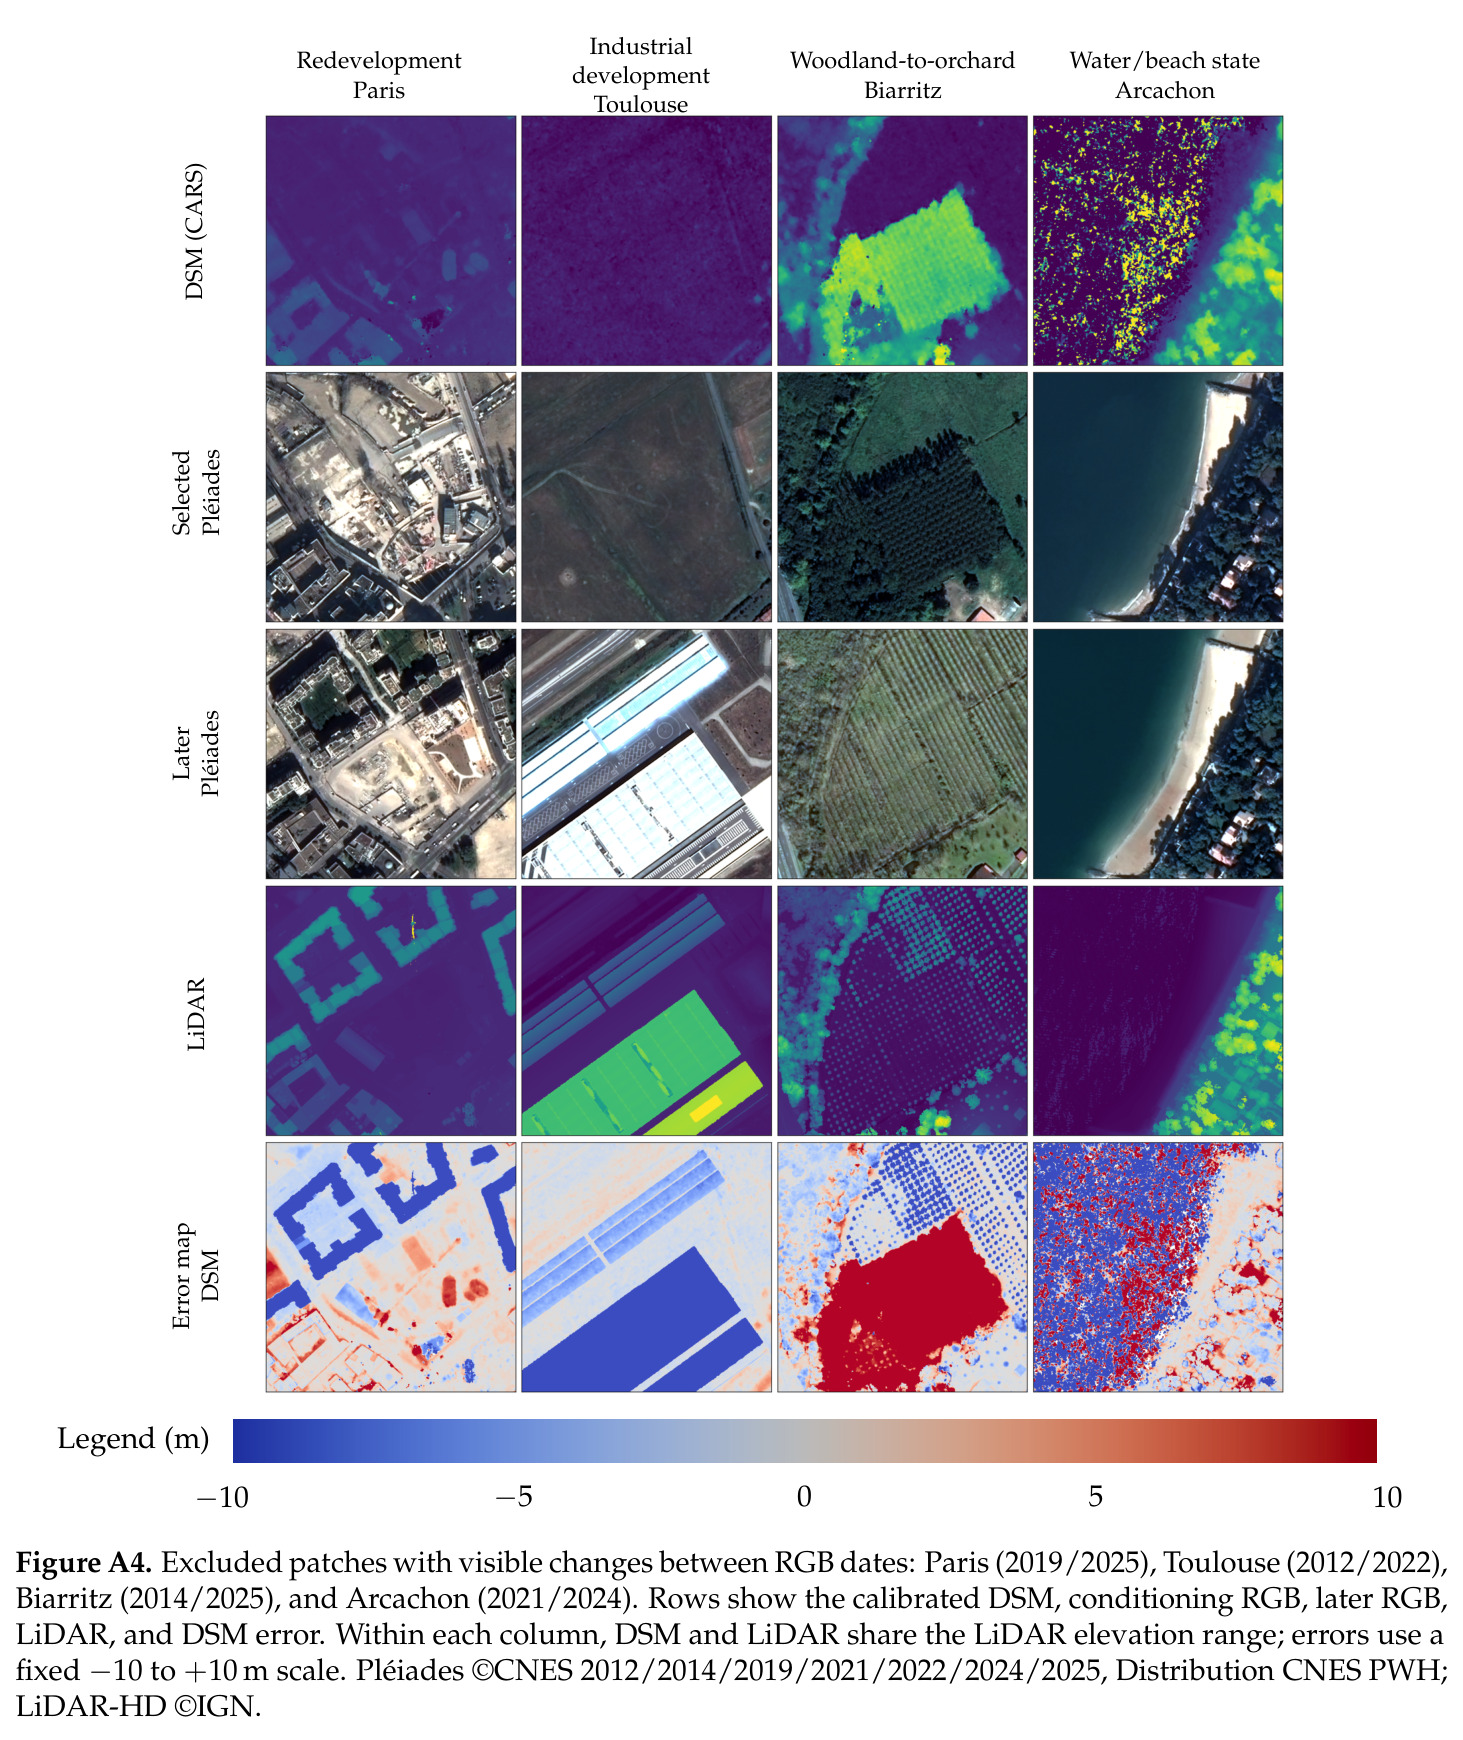
四个被 P90 剔除的位置的不同日期 RGB 对比:巴黎城市再开发(2019/2025)、图卢兹工业建设、比亚里茨林地转果园、阿卡雄海岸线变化;行展示校准 DSM、条件 RGB、后期 RGB、LiDAR 与 DSM 误差。
具体演示 A2 假设何时失效:地表在采集间发生真实变化时 DSM–LiDAR 差异不代表模型可修正的误差,也解释了 RMSE 筛选的必要性。
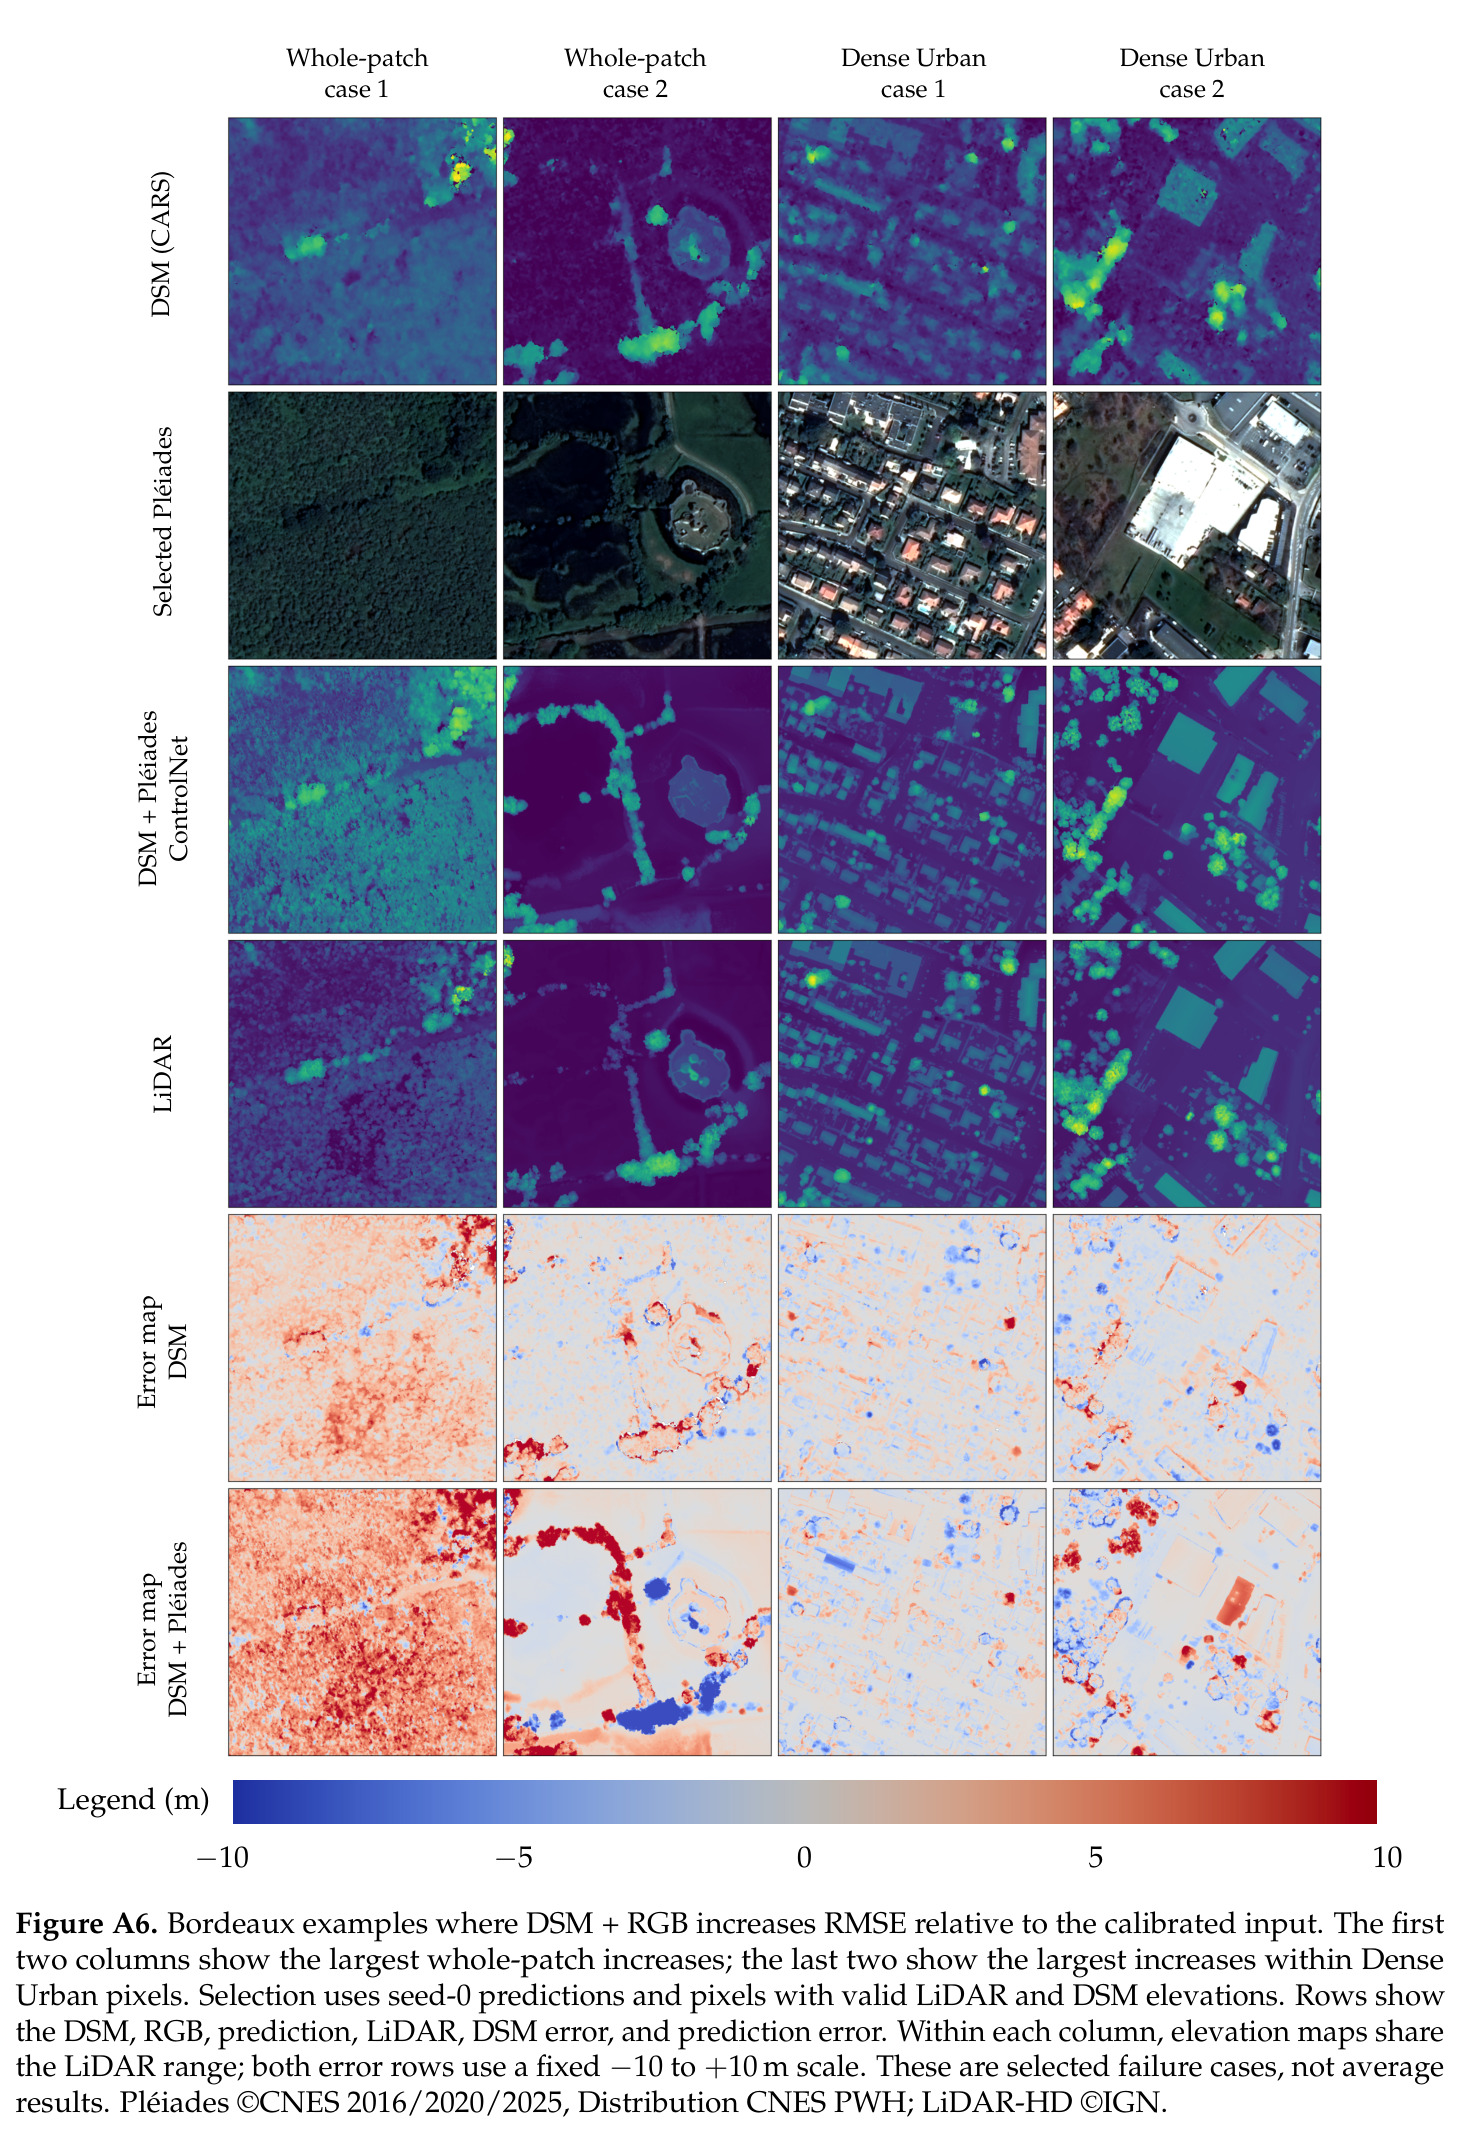
波尔多失效案例(seed-0 预测、有效像素选择):前两列为整 patch RMSE 增幅最大的案例,后两列为密集城区内增幅最大的案例;行展示 DSM、RGB、预测、LiDAR 及两种误差图。
诚实的失败案例展示,是多模态条件化并非处处有益、且生成模型可能主动改坏输入的直接证据,平衡了正面结果。
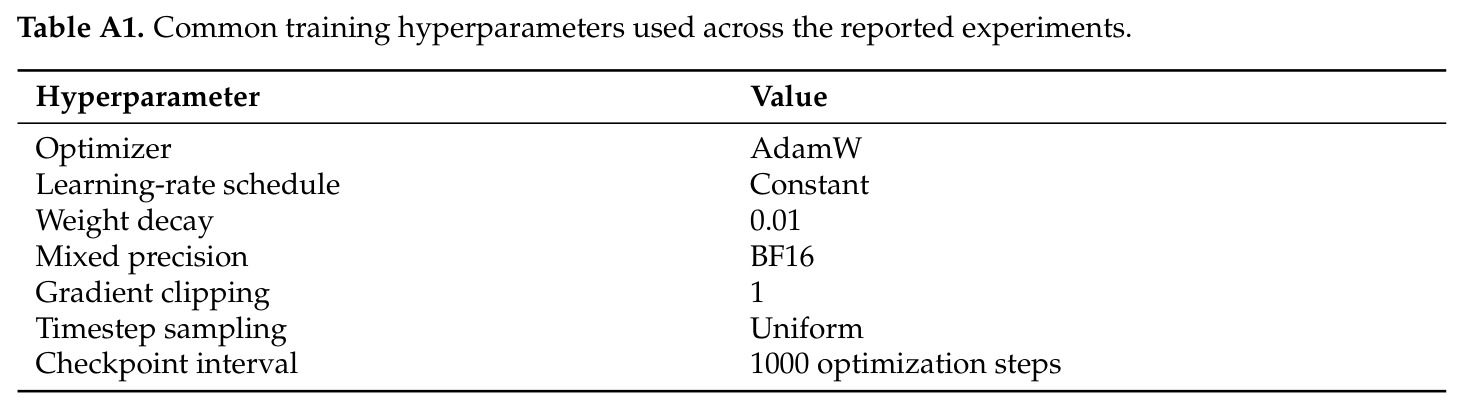
共同超参:AdamW、常数学习率、权重衰减 0.01、BF16 混合精度、梯度裁剪 1、均匀时间步采样、每 1000 优化步存档一次。
复现训练所需的基础超参数清单。
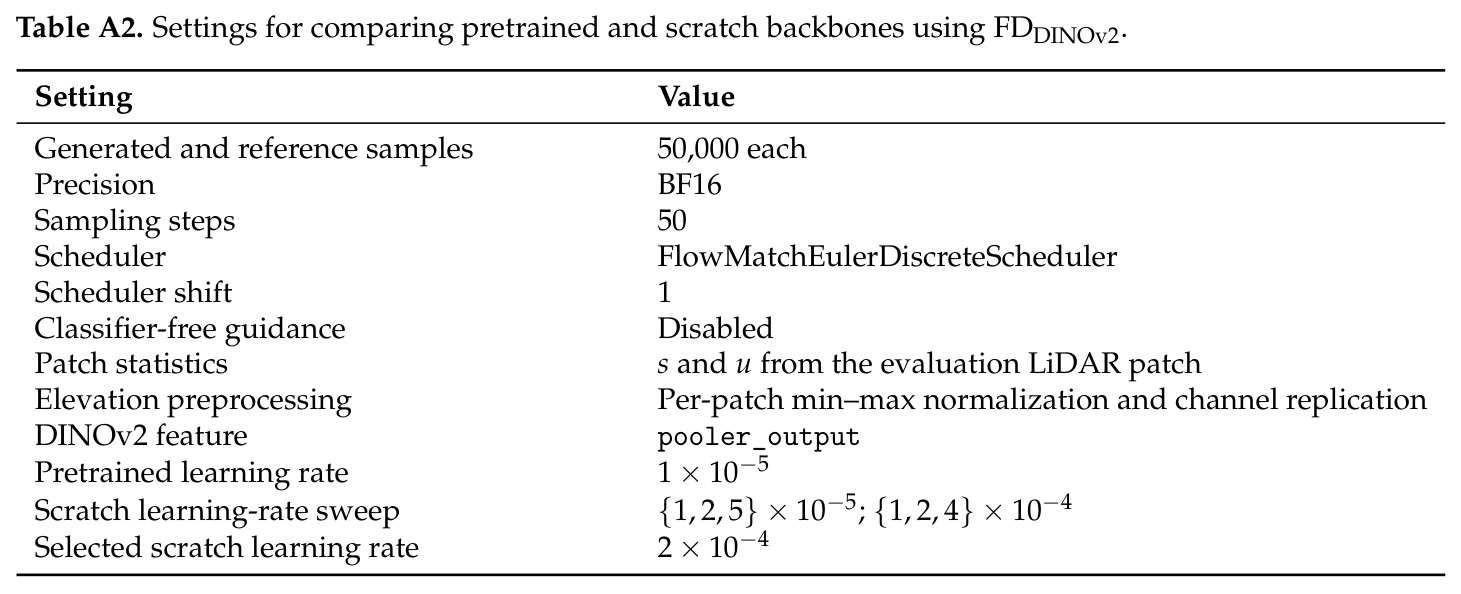
FD 评测协议:生成与参考各 50,000 样本、BF16、50 步 FlowMatchEulerDiscreteScheduler(shift 1)、禁用 classifier-free guidance、DINOv2 pooler_output 特征、scratch 学习率扫描 $\{1,2,5\}\times10^{-5}$ 与 $\{1,2,4\}\times10^{-4}$。
说明骨干对比实验的具体设置与公平性保障(scratch 也经过了充分的学习率搜索)。
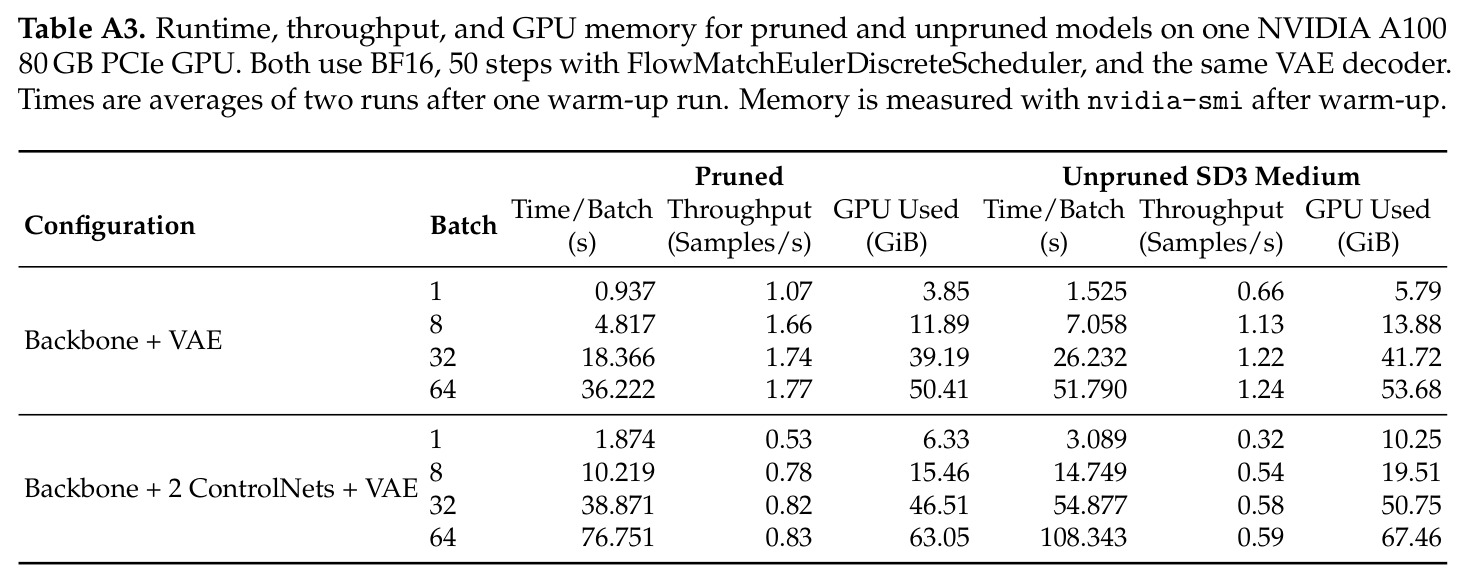
剪枝在所有 batch 下更快更省显存:骨干+VAE batch 32 吞吐 1.74 对 1.22 样本/秒、39.19 对 41.72 GiB;双 ControlNet 时 0.82 对 0.58;参数量 2.028B→1.033B(骨干)、1.063B→0.547B(ControlNet)、VAE 0.084B。
量化文本流剪枝的工程收益,说明该架构改造不仅是学术洁癖而有实际部署价值。
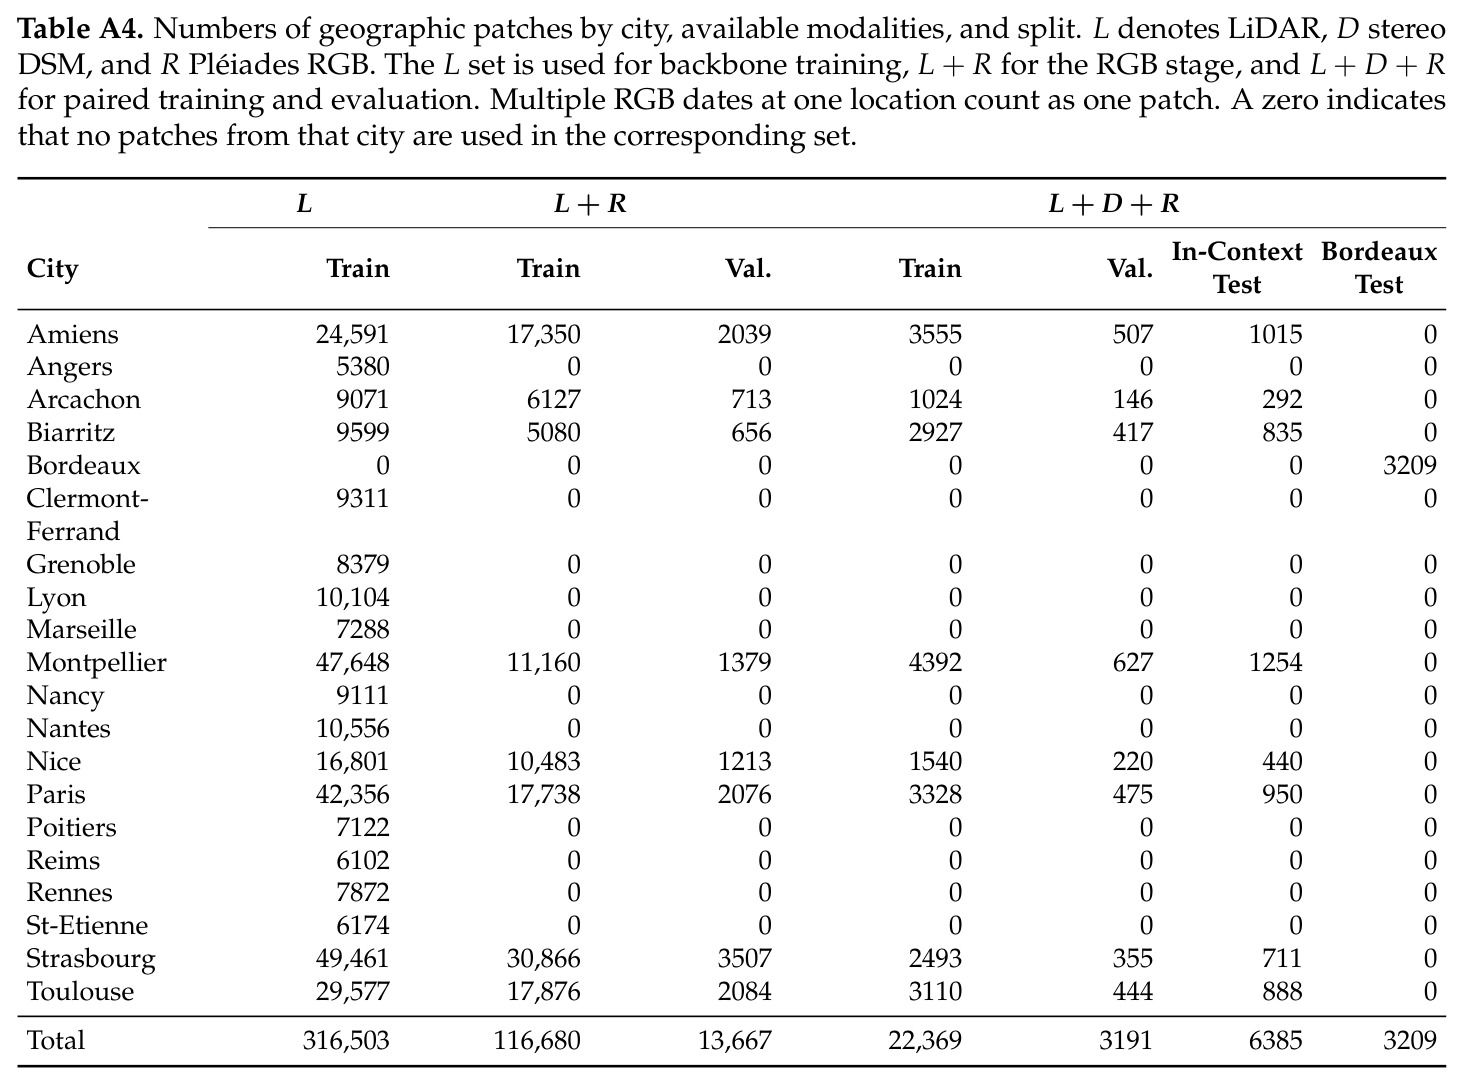
各城市在 L(LiDAR)、L+R、L+D+R 三种模态集下的训练/验证划分及 in-context 测试(共 6,385)与波尔多测试(3,209 全配对整体留出)的 patch 数量明细。
评测集规模的权威来源,支撑对统计功效和城市间数据不平衡的判断。
P90 筛选前后的土地覆盖构成:密集城区在被剔除样本中占 10.03%(原 5.56%,1.81 倍),其他 Theia 类 6.89 倍,稀疏建成区仅 0.59 倍,说明筛选同时改变了输入质量与地表类型构成。
量化'筛选引入评估偏差'这一重要局限性,提示头条指标是在相对容易的子集上测得的。
4,046 个高误差剔除 patch 上:密集城区输入 RMSE 9.686→DSM-only 6.179±0.028→DSM+RGB 5.736±0.032 m;农田 23.050→2.064±0.019→2.240±0.021 m(RGB 反而变差);两模型在所有组仍优于输入。
检验模型在分布外高误差输入上的鲁棒性,同时暴露 RGB 在农田的负面案例,是对 Table 6 的重要压力测试。
原始 DSM 空洞处的恢复精度:DSM+RGB 在两组测试全部 5 个地表组都优于 DSM-only(in-context 密集城区 3.576±0.037 对 4.135±0.038 m),植被仍最难(5.2–6.0 m);校准输入在此无定义。
证明空洞恢复是精化模型的免费副产品,把本文与专门的 GAN 填洞工作联系起来,扩展了方法的实用价值。
推理种子间标准差:最大 0.035 m(波尔多 DSM+RGB 植被组 RMSE),多数组在 0.003–0.025 m,远小于 Table 6 中方法间的差异。
支撑'方法间差异远大于生成随机性'的结论,也说明作者对生成模型固有的采样方差做了透明报告。