ARGUS:气候政策因果评估中识别假设的证据锚定审计 Evidence-Grounded Auditing of Identification Assumptions in Climate-Policy Causal Evaluations
以 11 维假设清单和有界 LLM 流水线审计 DID 论文证据支持度,用缺陷注入评估
前置知识
双重差分(DID)
DID 用处理组与对照组在政策前后变化量之差估计因果效应:$\hat{\tau} = (\bar{Y}_{T,post} - \bar{Y}_{T,pre}) - (\bar{Y}_{C,post} - \bar{Y}_{C,pre})$,核心思想是用对照组的变化抵消共同时间趋势。它是评估碳定价、碳排放交易、排放标准等气候政策的主流方法,但结论是否可信不取决于估计量本身,而取决于一组识别假设是否成立。
本文审计的全部对象就是 DID 研究的识别假设,11 维清单、缺陷分类学和评估语料都是围绕 DID 展开的,不理解 DID 无法读懂本文。
平行趋势与无预期假设
平行趋势要求若无政策干预,处理组与对照组的结果路径应当平行,实践中用事件研究(event-study)图的前期系数检验,前期系数应接近零且不显著;但论文强调前期系数不显著也可能只是检验功效低(Roth 2022)。无预期假设要求主体在政策真正实施前不改变行为;气候政策从公布到落地常有时间差,企业可能提前减排,直接破坏识别。
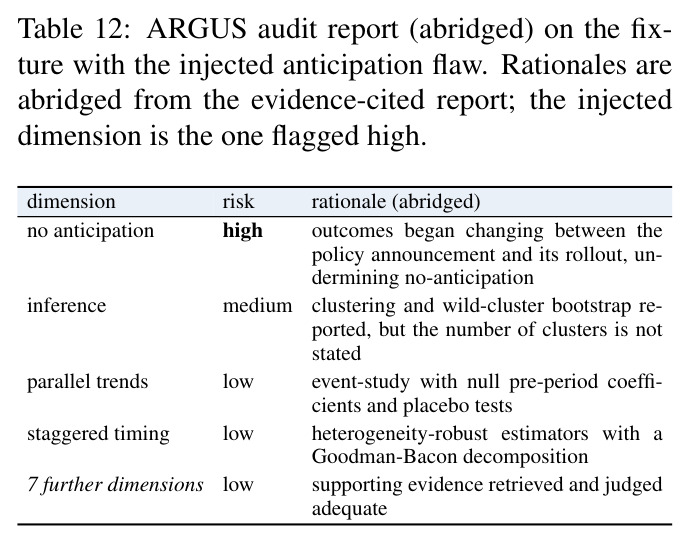
这两维是清单中最核心的两项,论文展示审计报告样例(Table 12)时用的正是注入了预期缺陷的夹具。
交错采用与异质性处理效应
当不同单位在不同时间接受处理(staggered adoption)时,传统双向固定效应(TWFE)会把已处理单位当作对照,产生"禁止比较",回归权重可能为负,导致估计严重有偏。Goodman-Bacon 分解(2021)、Callaway–Sant'Anna(2021)、Sun–Abraham(2021)等稳健估计量以及 de Chaisemartin & D'Haultfœuille(2020)的负权重分析都是为修复这一问题而生。
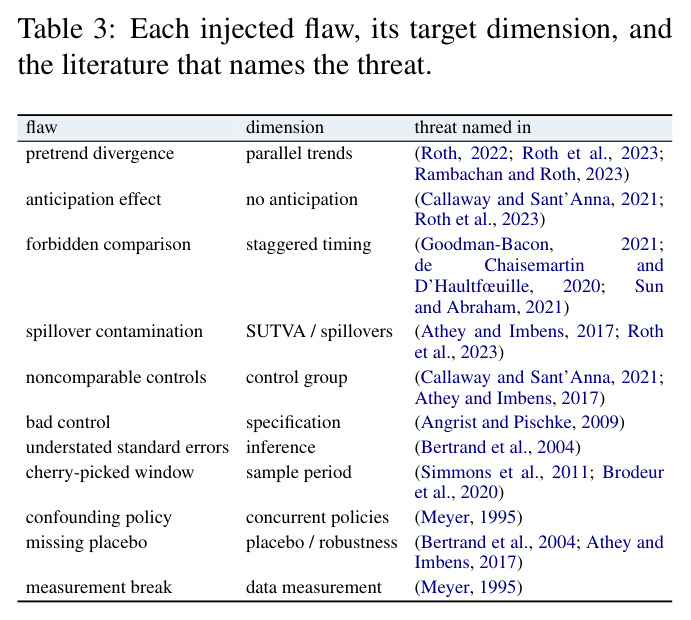
ARGUS 的缺陷分类学逐条溯源到这些文献(Table 3),理解这条线索才能明白"证据充分"审的到底是什么。
SUTVA 与溢出效应
稳定单元处理值假设(SUTVA)要求一个单位的潜在结果不受其他单位处理状态的影响。气候政策场景特别容易违反:污染随空气与水流跨行政区扩散、企业为规避管制跨区转移生产,都会让"对照组"也沾染处理效应,污染差分比较。稳健的做法是显式建模溢出或做空间安慰剂检验。
无干扰/溢出是 11 维清单之一,也是气候场景比一般经济学场景更难审计的原因之一。
证据接地与检索门控
证据接地(evidence grounding)要求模型的每个判断都必须引用文档中的具体段落,而非凭参数记忆作答。检索门控(relevance gate)是接地的一种实现:先检索候选段落,再用一次 LLM 调用把每段标注为"高相关/部分相关/无关",只有相关的段落才进入下游判断;若全部无关,系统显式输出 unknown 弃权,而不是硬给一个结论。
ARGUS 约 40% 的 unknown 弃权率、弱检索被误判为高风险等关键现象都源于这一机制,是解读其结果的关键。
缺陷注入与局部真值
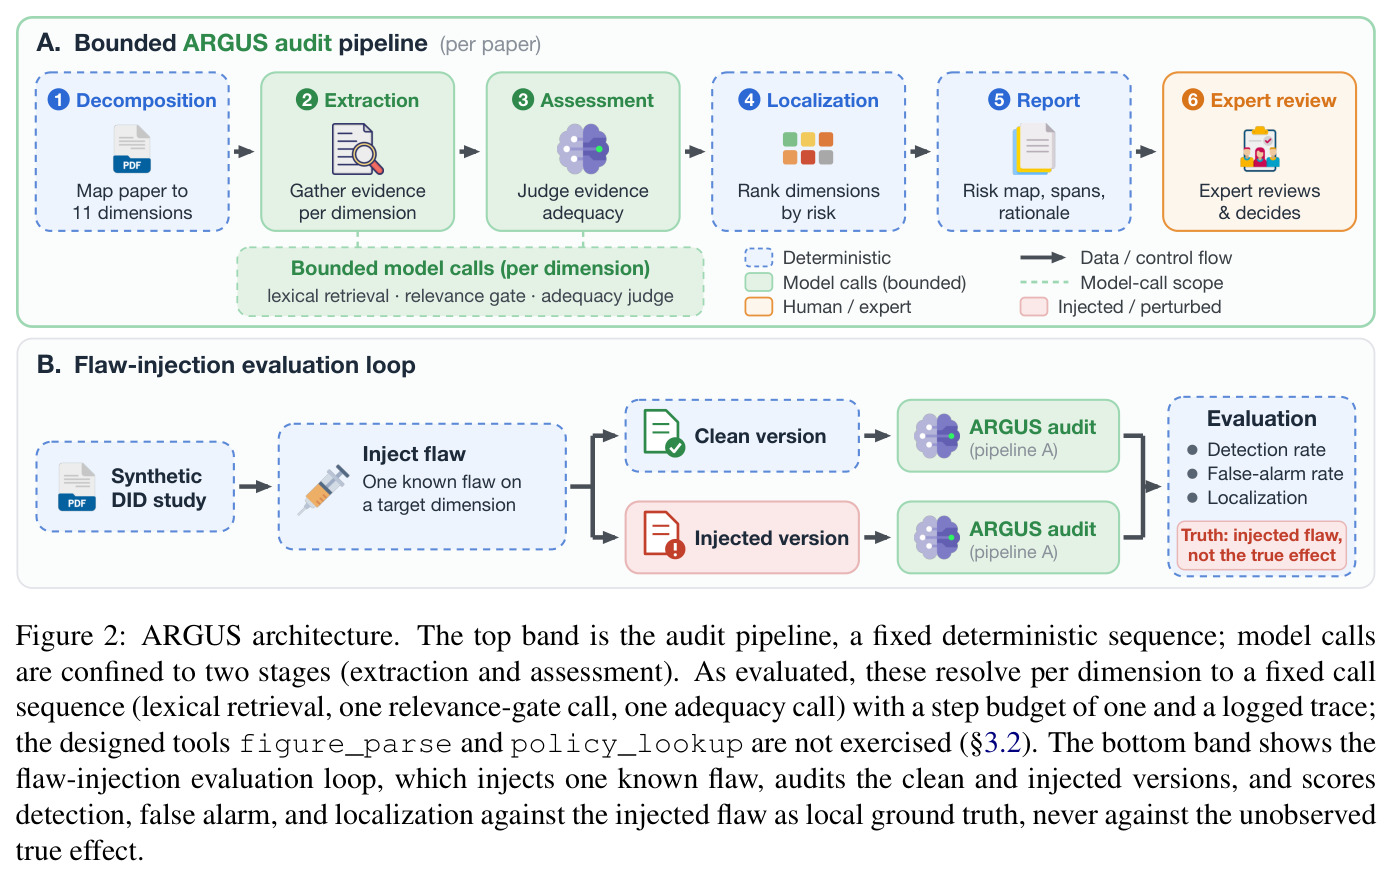
因果效应的真值永远不可观测,无法直接验证审计器"审得对不对"。缺陷注入(flaw injection)改用受控扰动构造局部真值:从一篇 11 维证据齐全的合成论文出发,精确注入一个已知缺陷(如删除安慰剂检验章节的 omission 型,或改写散文引入设计缺陷的 commission 型),然后检验审计器能否在目标维度报警、在干净版本上保持沉默、并把目标维度排在最高风险。
这是本文评估方法学的核心发明:检测率、误报率、定位率三个指标全部由此定义,不需要任何真实效应数据。
有界流水线 vs 自由智能体
ReAct 式自由智能体由模型自行决定下一步动作序列,控制流由模型决定,推理路径难以复现和审计。有界(bounded)设计则把执行顺序写死在代码里,模型调用被限定在检索与判断两个阶段,并配以工具白名单、硬性步数上限(max_steps=1)和全程日志轨迹,用牺牲自主性换取可检查性、可复现性与证据可追溯性。
ARGUS 明确自称"有界而非智能体",这直接决定了它的结果稳定性(三轮运行 32/33 一致)和评估方式。
研究动机
DID 是评估碳定价、碳排放交易、排放标准等气候政策的主流方法,但结论可信度完全依赖一组识别假设:平行趋势、无预期、交错采用的正确处理、单元间无干扰等。方法论文献已反复证明其脆弱:Bertrand 等(2004)指出序列相关下标准误被严重低估;Goodman-Bacon(2021)与 de Chaisemartin & D'Haultfœuille(2020)证明交错采用下双向固定效应把已处理单位当对照、产生负权重;Callaway & Sant'Anna(2021)等给出稳健估计量;Roth 等(2023)梳理了预趋势检验的低功效。评估这些假设远不止找到某张诊断图:一篇论文可以放一张事件研究图,读者必须同时权衡设计、前期系数、推断方式与政策公布和落地的时点才能接受"平行趋势成立",而且要为每篇论文的每个假设重复这一过程。气候场景更棘手:政策可能重叠、分期实施、跨行政区溢出,结果变量常来自模型或遥感数据。当估计直接影响政策时,证据薄弱的因果结论会误导决策;背后是多团队对同一数据集结论差异巨大(Silberzahn 等 2018)、p-hacking 普遍(Brodeur 等 2020)的可靠性危机。
本文的目标是本文的核心目标是把"一篇 DID 研究的识别假设是否被其报告证据充分支持"变成一个机器可审计的对象,而刻意不去判断因果效应真值——因为反事实从未被观测。目标拆成三项贡献:其一,操作化:把 DID 方法论文献转化为 11 维"假设-含义-证据"审计清单(以声明式 YAML 存储、可检查可修改),并构建一条有界、证据接地的 LLM 流水线,在检索不到相关证据时显式弃权(unknown),最终产出每个判断都附引用证据、可供专家复核的风险报告;其二,评估方法学:以缺陷注入作为局部真值——从证据齐全的合成论文出发每次注入一个已知缺陷,用检测率、误报率、定位率三指标评分,并辅以按计算量分级的消融和预言检索对照来定位增益来源;其三,诊断:在 26 篇真实经济学论文和 5 篇 × 11 维的人工标注试点上定位失败模式——证据接地能力限制覆盖率、系统性过度严厉限制与人工标签的一致性——并用一条预先固定的确定性规则在样本内缓解过度严厉。
与已有工作不同的是,本文的独特视角是一句话:因果效应真值不可观测,但"识别假设的证据支持度"是可审计的。这把任务与三个相邻方向清晰区分开。与 LLM 因果推理基准(CLadder、Corr2Cause、CausalBench 等)不同,那些工作测的是模型自己能否做因果推断,结论是模型常会复述因果语言却做不出可靠因果推理;ARGUS 问的是"这篇人写的论文的识别假设有没有被证据支撑",因果裁决被设计排除在外。与最接近的 CausalVerify 不同,后者把评估接地在执行上——运行模型生成的估计代码、在合成数据上核对能否恢复已知效应——但完全不审计识别假设层;ARGUS 直接复用其 259 篇经济学论文语料,在其上新增维度级识别风险标注层。与 ReAct 式自由智能体不同,ARGUS 固定执行顺序、把模型自主性限制在检索和判断两个环节,明确用可检查性交换自主性。与气候声明核查 NLP(CLIMATE-FEVER 等)不同,ARGUS 把文档接地验证从孤立事实声明扩展到整个因果识别论证链。作者还自觉引用了"操作化一种能力并非中立"的基准批判文献,把消融对准自家流水线的脚手架。
核心方法
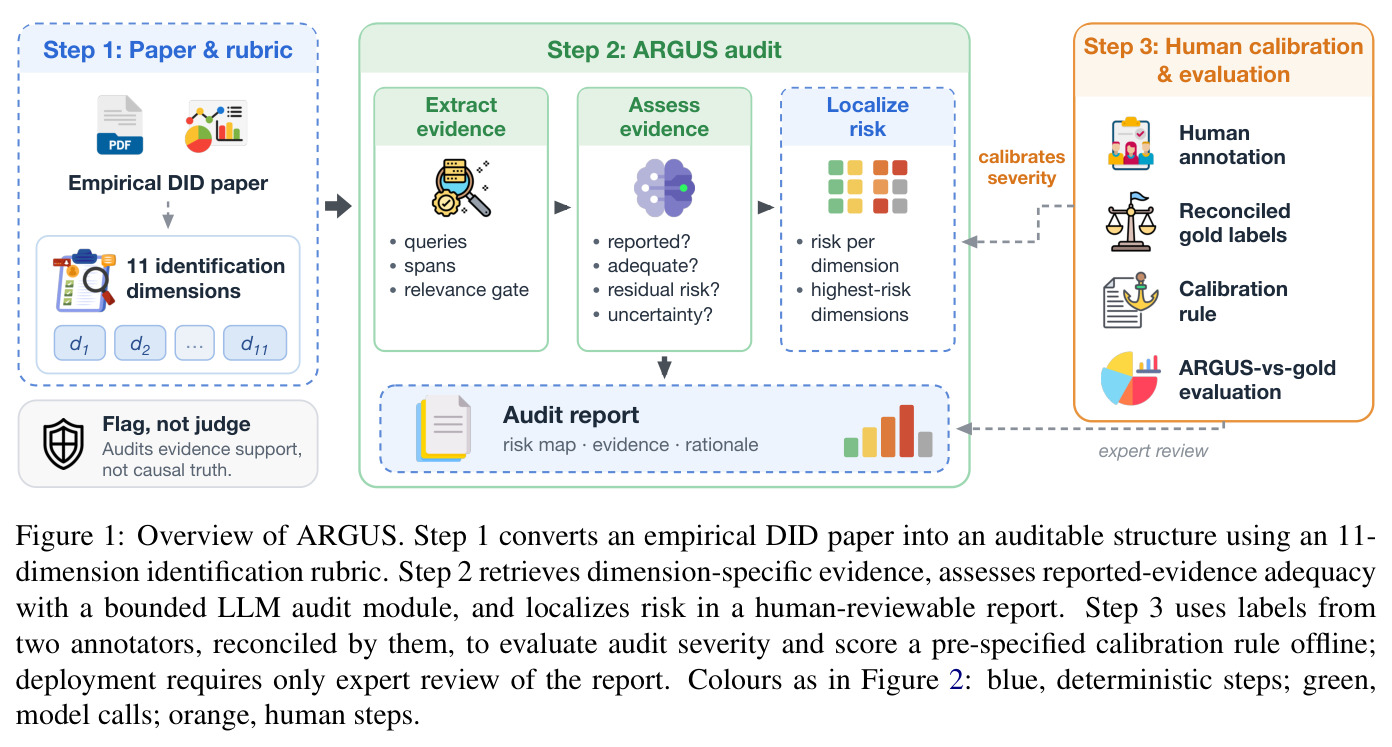
直觉上,ARGUS 像一位拿着清单的技术审稿人:它不评价论文结论对不对,而是逐条检查每一项识别假设——论文里有没有拿出合格证据来支撑。技术路线分三步。第一步,把 DID 研究分解为 11 个可审计维度:平行趋势、无预期、交错时点处理、SUTVA/溢出、对照组构造、模型设定、统计推断、样本期选择、同期政策、安慰剂/稳健性、数据测量;每一维写成"假设(必须成立什么)-可检验含义(应能观察到什么)-合格论文应报告的证据"三元组,以 YAML 声明式存储,审计对象透明可查而非埋在代码里。第二步,运行一条固定顺序的有界流水线:分解→证据抽取→充分性判断→风险定位→报告;阶段顺序写死在代码中,模型调用仅限两处——抽取(词法检索+一次相关性门控)和判断(一次充分性评估)。第三步,输出"研究-维度-风险"三元组与带证据引用的人工可读报告,最终裁决留给专家。设计哲学是"标记而非裁决":低/中/高风险大致对应证据充分、部分、缺失或有缺陷;unknown 则表示检索层没有找到相关段落,是关于检索的信号而非对论文的实质判断。
核心创新有二。第一是审计对象的重新定义:不去验证不可观测的因果效应,而是把应用计量经济学"可信性革命"文献中每个已知威胁一对一映射为清单维度——如预趋势发散→平行趋势、禁止比较→交错时点、坏控制变量→设定、低估标准误→推断(Table 3 给出逐条文献溯源)——把"识别可信度"这个模糊构念变成逐维可检查的证据支持问题。与已有系统的本质区别在于:因果推理基准测模型自身、CausalVerify 验证代码执行结果,ARGUS 审的是论文文本中论证链的完整性。第二是评估上的"缺陷注入作为局部真值":从一篇 11 维证据齐全的合成论文出发,每次精确注入一个已知缺陷并检验三个指标。这里有一个体现方法论纪律的关键细节:初版注入器直接写入"前期系数显著为正"之类句子,使关键词流水线检测率虚高到 1.000——注入器种下的正是检测器匹配的字符串,属于循环论证(短语泄漏);改为结构性扰动(omission 删除章节,commission 以自然散文改写出设计缺陷并验证不含哨兵词)后,数字才可信。这一"结构性扰动而非哨兵"原则,正是把智能体基准"脚手架互相遮蔽"的批判对准自家流水线的 inward 应用。
方法步骤详情
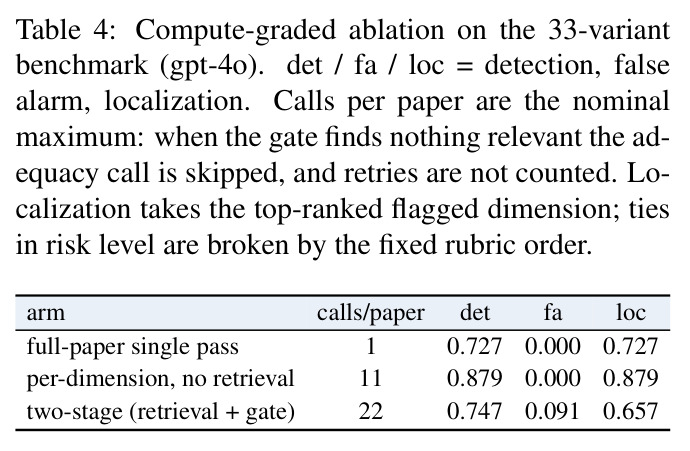
审计流水线五阶段。①分解:把论文映射到 11 维清单,为每维实例化假设-含义-预期证据。②抽取:只查询被审论文本身;每维用固定的 11–19 个词项查询包做词法检索,章节块按词频打分,保留 top-4 块、每块截断至 2000 字符;一次相关性门控调用把候选标注为 high/partial/none(只读前 1200 字符),若无相关候选该维直接判 unknown、跳过充分性调用。③判断:充分性评审器收到保留段落加清单条目,返回 risk、evidence_status、理由与引用证据,映射大致 sufficient→low、partial→medium、missing→high、flawed→high,强调"证据存在不等于证据充分"。④定位:聚合各维判断为风险图并按风险排序。⑤报告:渲染含风险图、跨度和理由的文档给专家。评估循环:从 clean_supported 夹具构造 11 个缺陷与 33 个变体(每维 2 个 commission 改写 + 1 个 omission 删除),干净版与注入版各审一遍,计算检测率(目标维度风险≥medium)、误报率与定位率。评估配置 max_steps=1,图表只通过题注进入。
技术新颖性
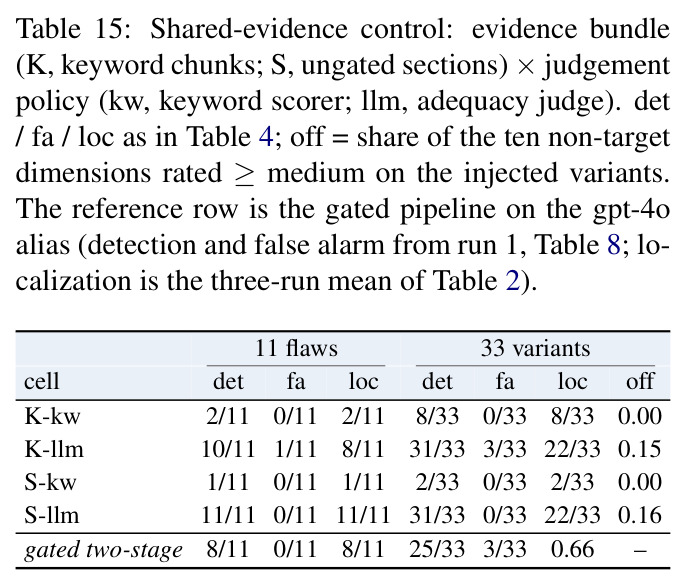
新颖性体现在四点。其一,声明式清单:11 维"假设-含义-证据"以 identification_dimensions.yaml 存储,审计什么、改什么一目了然,与把判断逻辑埋进提示词的常见做法不同;配套缺陷分类学逐条溯源到命名该威胁的文献,保证清单覆盖有据可查。其二,无真值评估协议:缺陷注入 + 预言检索臂 + 按计算量分级的消融,构成一套可在"无地面真值任务"上复用的评估模板,明确借鉴 Zhang 等(2026b)"脚手架互相遮蔽"的基准批判并把它对准自家流水线。其三,共享证据对照(Table 15):把证据包冻结到磁盘,同一证据分别喂给关键词评分器和 LLM 充分性判断器,把"判断策略带来的增益"与"检索路径差异"干净地分离——结果显示增益几乎全部来自判断策略。其四,把检索失败显式建模为 unknown 弃权状态而非伪装成实质判断,并配一个只降不升、只作用于模型已产出字段的确定性校准层(弱检索的 high 降为 medium 或 unknown),让"覆盖率"与"过度严厉"成为可分别优化的两个对象,而非混在一个准确率数字里。
实验结果
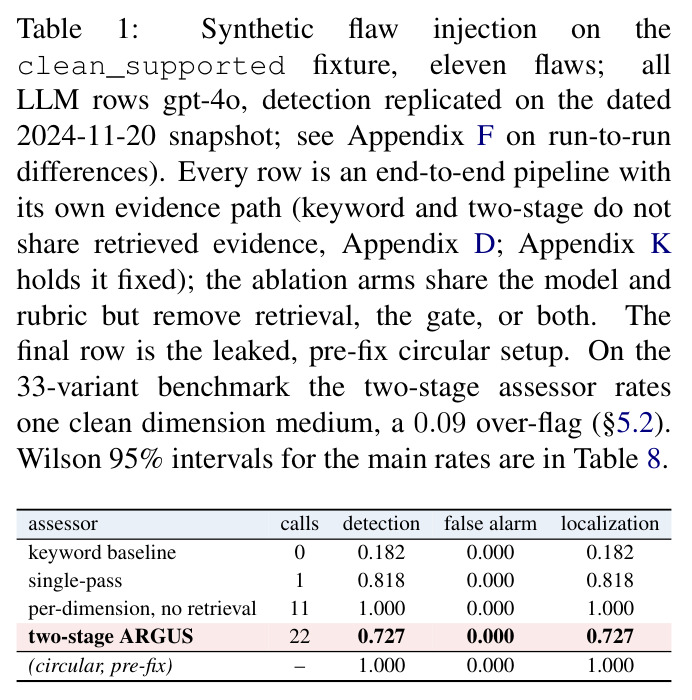
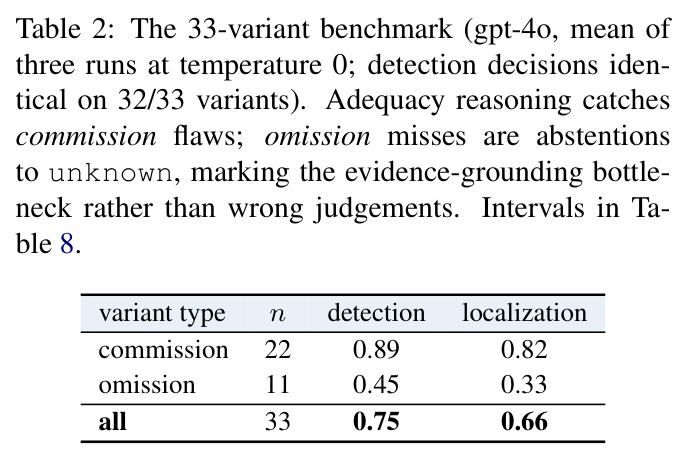
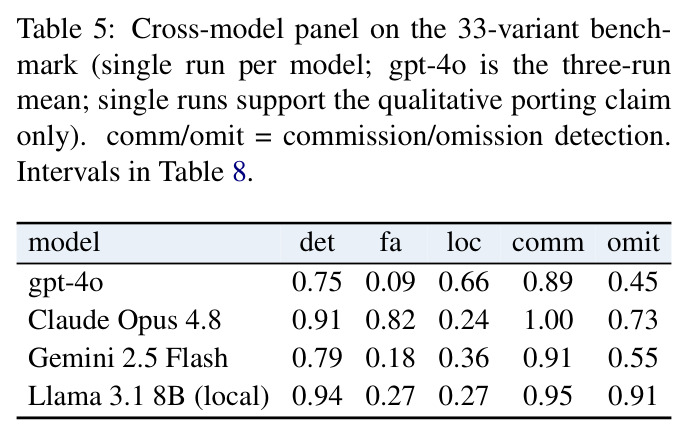
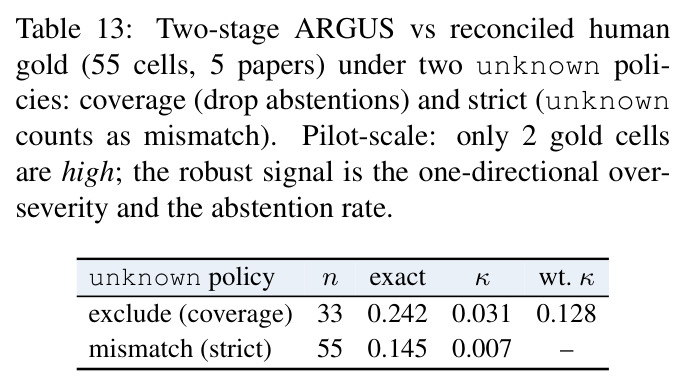
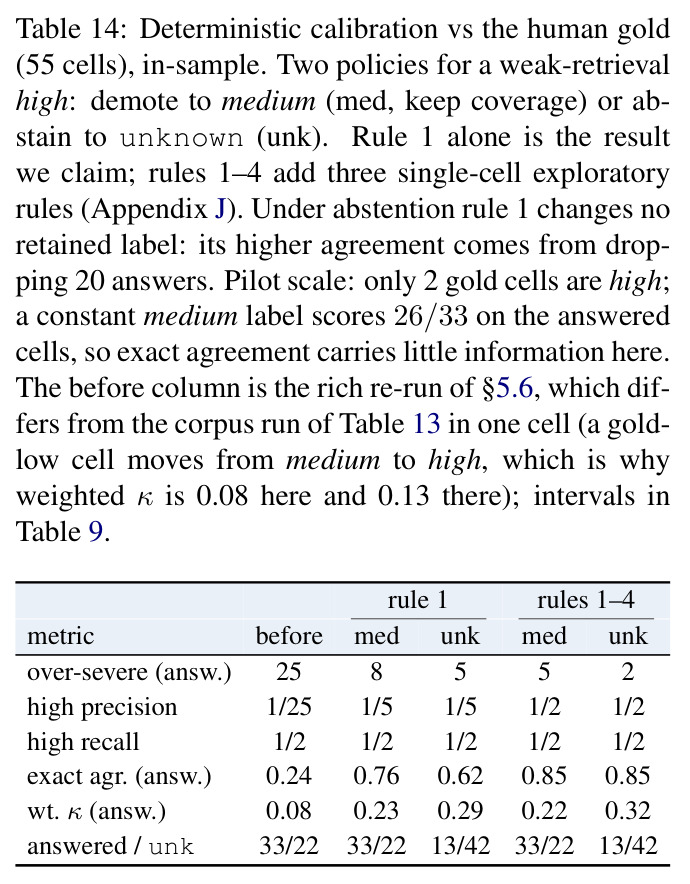
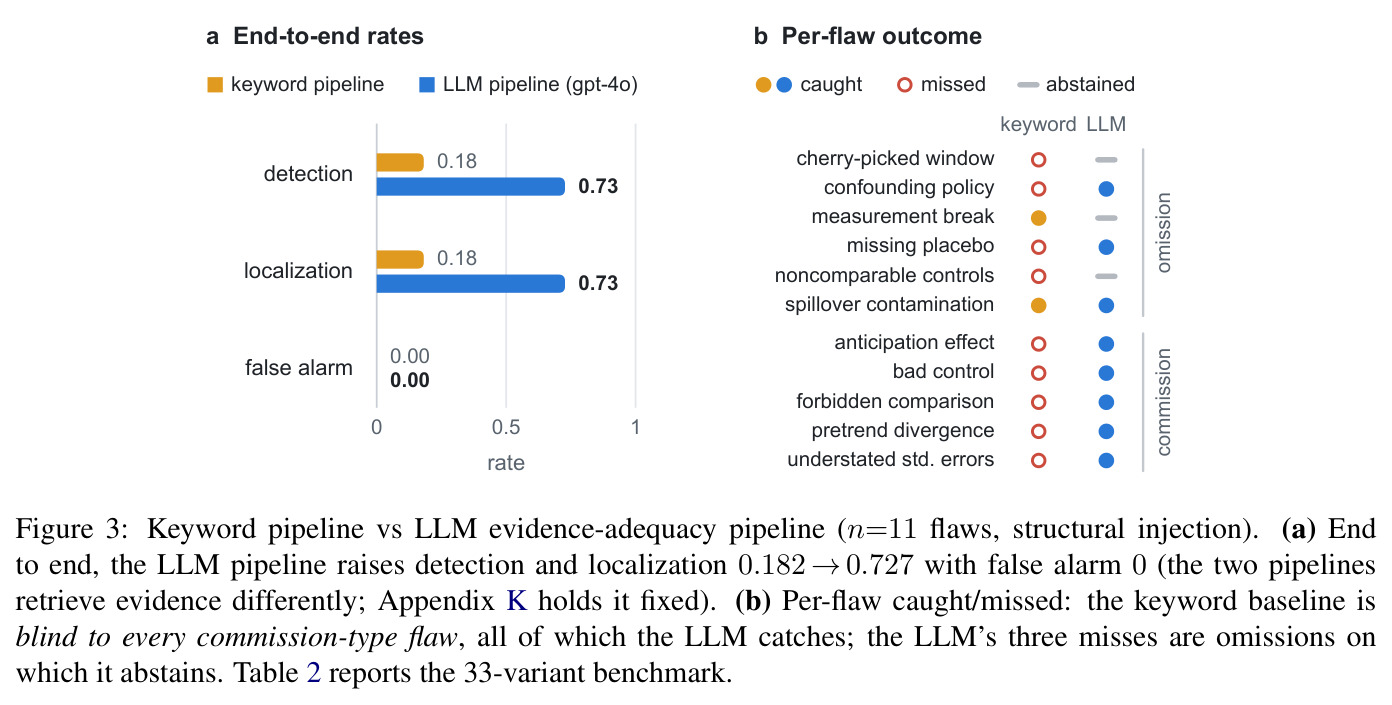
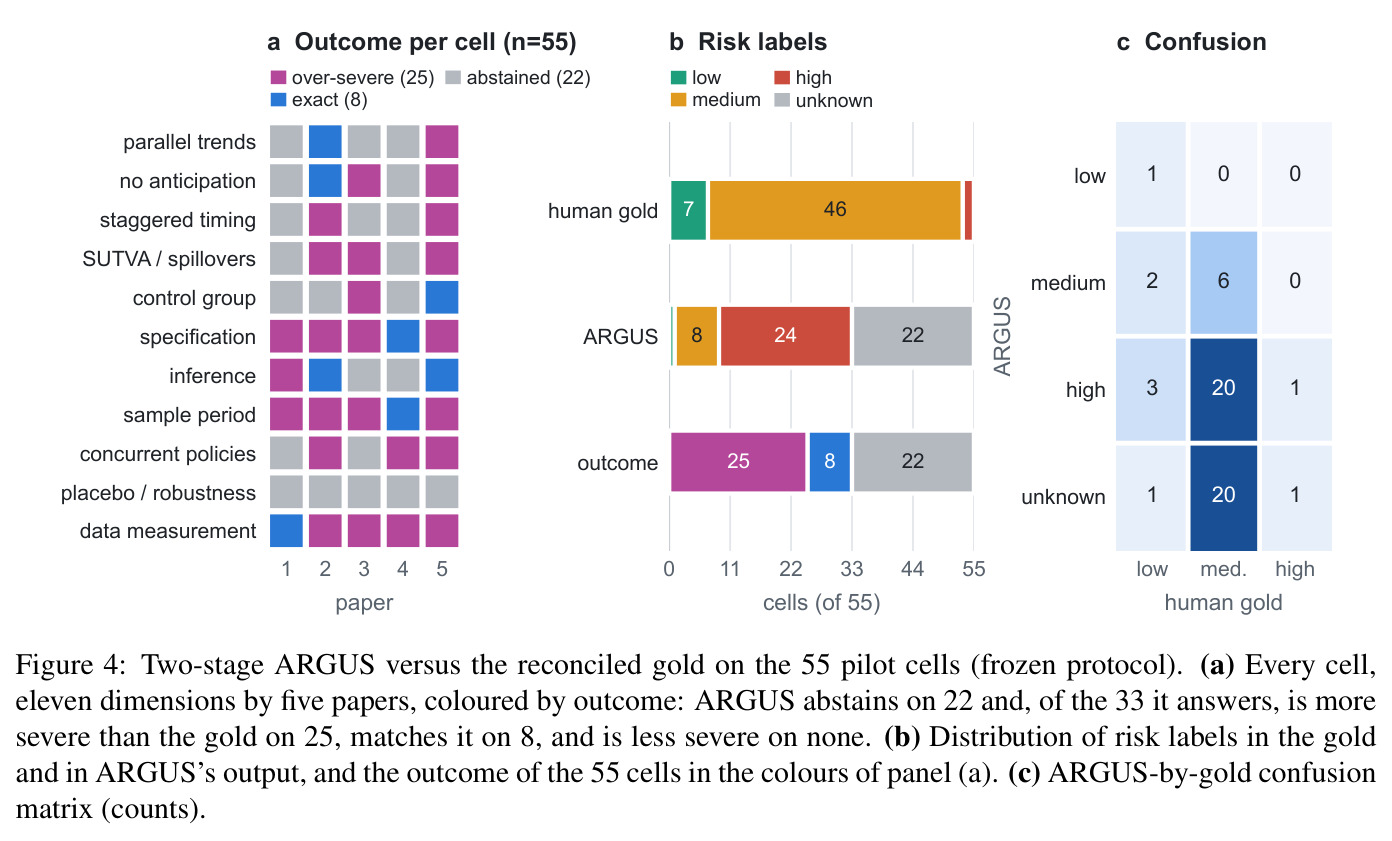
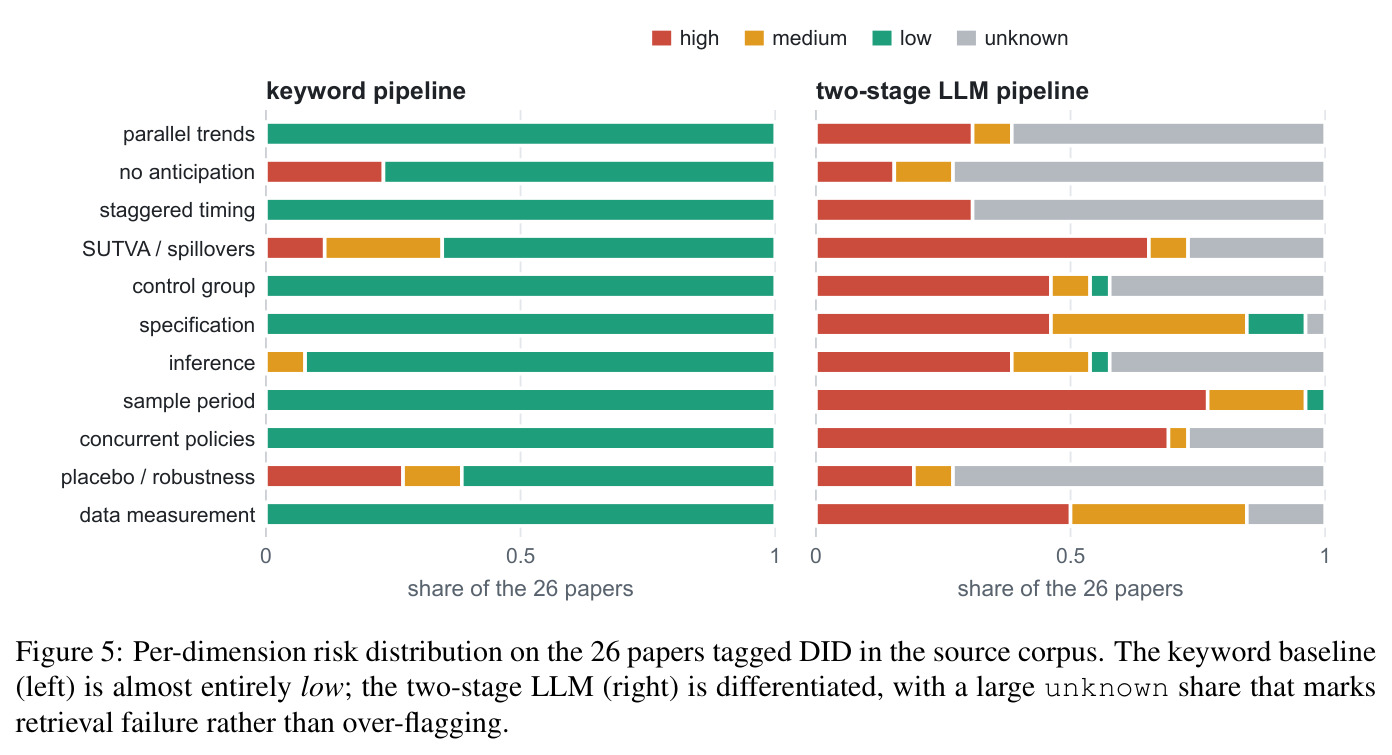
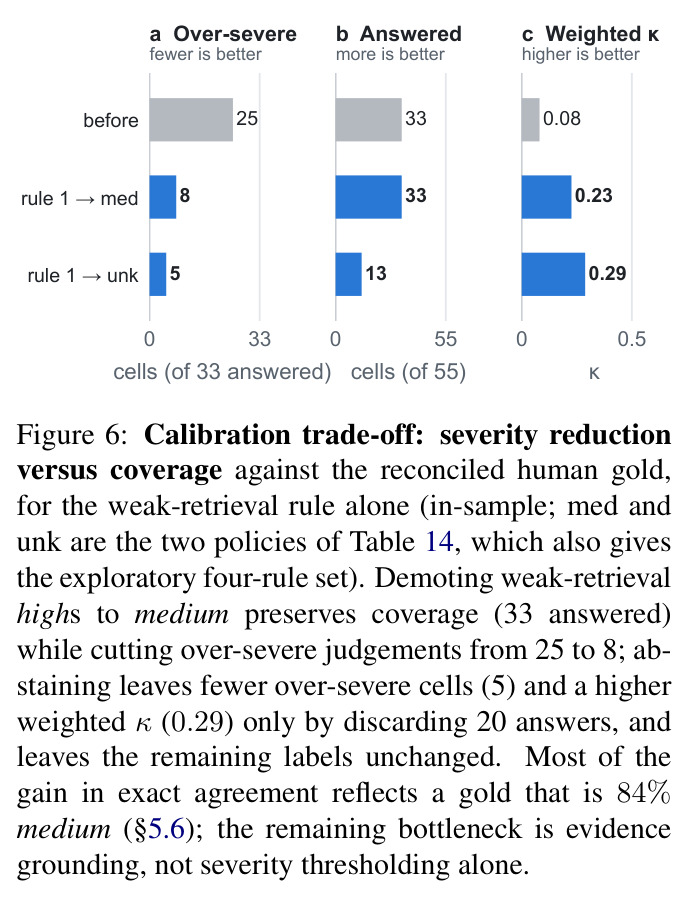
四大发现。①证据充分性判断完胜关键词匹配:11 缺陷基准上关键词基线检测率仅 0.182,两级 ARGUS 达 0.727(8/11),误报均为 0;共享证据对照证明增益来自判断策略:同一证据包上 LLM 判断器 10/11 对关键词评分器 2/11(McNemar p=0.008)、33 变体 31/33 对 8/33。②架构检测率差异不显著但行为不同:33 变体上各架构检测 24–30/33(两两 McNemar 均不显著);commission 检测 0.89、omission 仅 0.45,6 个漏检全部弃权为 unknown 而非硬判。③真实论文上接地限制覆盖:26 篇 DID 论文上关键词基线 91% 判 low,两级管线约 40% unknown、约 44% high。④对人工标签系统性过度严厉:和解金标(两位标注员 Cohen's $\kappa$=0.56、加权 $\kappa_w$=0.62;7 low/46 medium/2 high)下 ARGUS 弃权 22/55,回答的 33 格中 25 格更严厉、0 格更宽松;弱检索 high 降级为 medium 的预固定规则使精确一致率 0.24→0.76、过度严厉 25→8 格,但加权 $\kappa$ 仅 0.08→0.23 且区间含零。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 合成缺陷注入基准(11 缺陷,clean_supported 夹具,gpt-4o) | 检测率(目标维度风险≥medium) | 两级 ARGUS 0.727(8/11),误报 0 | 关键词基线 0.182(2/11);单次全纸调用 0.818;逐维无检索 1.000 | 较关键词基线 +0.545,并捕获关键词全盲的全部 commission 缺陷;漏检 3 个均为主动弃权的 omission |
| 33 变体扩展基准(22 commission + 11 omission,三轮 gpt-4o 均值) | 检测率 / 定位率 | 0.75 / 0.66(commission 0.89、omission 0.45) | 单次全纸 0.727(24/33);逐维无检索 0.879(29/33);预言检索 0.86(30/33) | 两两差异均不显著(McNemar p=0.125–1.000);6 个 omission 漏检全部弃权为 unknown 而非硬判 |
| 共享证据对照(同一冻结证据包,不同判断器) | 检测率 | K 证据包上 LLM 判断器 10/11(11 缺陷)、31/33(33 变体) | 同一证据包上关键词评分器 2/11、8/33 | 精确 McNemar p=0.008;证明 Table 1 的差距来自判断策略而非检索路径差异 |
| 26 篇真实 DID 经济学论文审计 | 风险标签分布 | 两级管线约 40% unknown、约 44% high | 关键词基线 91% 判 low,几乎不报警 | 把检索失败显式暴露为弃权信号,而非像关键词基线那样宣布"证据充分" |
| 人工标注试点(5 篇 × 11 维 = 55 格,和解金标) | 精确一致率 / 二次加权 κ(33 个已回答格) | 校准前 0.24 / 0.08 → 弱检索降级规则后 0.76 / 0.23(探索性四规则 0.85) | 恒定 medium 标签在相同 33 格上可得 26/33 | 过度严厉格 25→8(McNemar p<0.001);但加权 κ 区间含零,属样本内结果 |
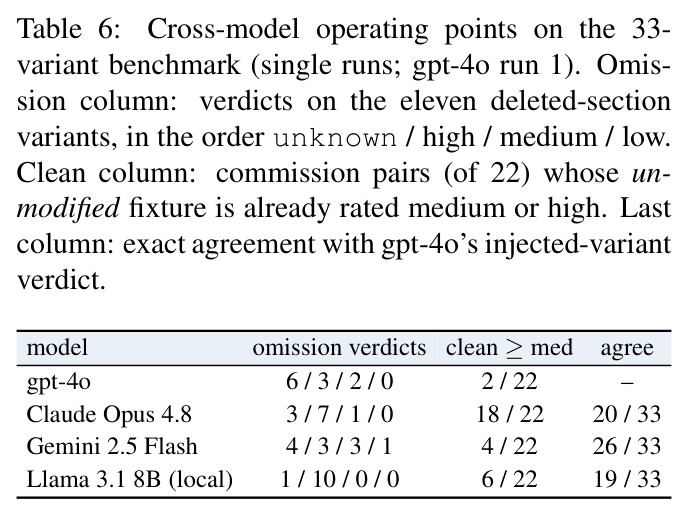
| 跨模型移植(33 变体,单次运行) | commission 检测率 / 误报率 | gpt-4o 0.89/0.09;Claude Opus 4.8 1.00/0.82;Gemini 2.5 Flash 0.91/0.18;Llama 3.1 8B 0.95/0.27 | 以 gpt-4o 三轮均值为参考运行点 | 高 commission 检测跨模型成立,但误报与运行点差异巨大,换模型需重新评估误报校准 |
局限与改进
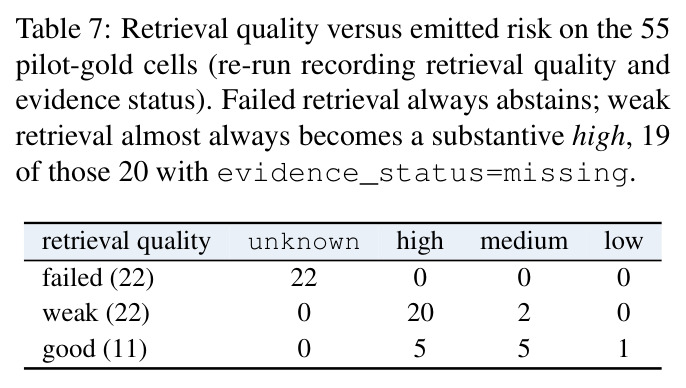
作者承认的局限相当坦诚。其一,人工金标只是试点规模:5 篇论文 55 格,由两位非作者标注员自行和解分歧,金标 84% 是 medium、仅 2 个 high,精确一致率因此宽松(恒定 medium 可得 26/33),加权 κ 才是有效统计量;所有一致性数字以 ARGUS 回答的 33 格为条件。其二,基准太小:n=11 和 n=33 下任何架构两两差异都不显著,55 格嵌套在 5 篇论文中却被当独立样本。其三,校准规则在评分所用的同一批论文上推导,提升属样本内。其四,夹具、分类学与注入器协同设计,合成检测率只是内部一致性证据;平行趋势判据不评估预趋势检验功效。其五,真实语料是通用经济学压力测试,26 篇中无严格意义的气候政策评估,环境能源子集仅 4 篇。我的补充观察:词法检索单轮 top-4、截断 2000 字符,嵌入检索从未扫描,figure_parse 设计了却未被调用——而事件研究恰恰以图形呈现,这是审计能力的硬伤;每维只注入单一缺陷,无法测试多缺陷叠加;2026 年 6 月与 7 月运行结果差异大(two-stage 检测 1.000/0.909 对 0.727)且原因不明。
独立分析的弱点
独立分析四个弱点。①检索是单点故障:词法检索在短夹具上删除章节后直接弃权,但在真实长论文上"部分相关"段落几乎总能找到,22 个弱检索格中 20 个被判 high——检索失败被提示词的 missing→high 映射包装成了实质风险判断,正是过度严厉的主要来源。改进方向:引入嵌入/混合检索,把检索质量作为一等不确定性输入显式传给判断器,而非事后字符串规则修补。②图形证据不可达:事件研究图是平行趋势的核心证据,评估运行中图表只通过题注进入,figure_parse 从未启用。改进方向:启用图表解析,用多模态模型读取事件研究图的前期系数,并把"证据仅存在于图中"记为独立证据状态。③金标太弱且偏置方向未经专家裁决:金标只有 2 个 high 格,无法估计 high 精度;ARGUS 的 25/33 过度严厉究竟是无理报警还是专家级的严格要求,两位非专家标注员无法回答。改进方向:招募 DID 方法论专家标注小组,优先标注 high 格。④单一缺陷注入覆盖不了真实世界:真实缺陷论文往往多问题叠加(交错采用+弱推断+样本期挑选),缺陷间可能相互掩盖。改进方向:多缺陷注入与缺陷交互矩阵,并利用期刊撤稿/更正论文构造"天然缺陷"测试集。
未来方向
作者明确提出的方向:在专门的气候政策语料上运行(目前动机来自气候政策、评估却用合成环境政策夹具加通用经济学语料,环境能源子集仅 4 篇且 unknown 占比 0.43 对其余 0.39,尚无法判断域差);由独立专家撰写缺陷,摆脱"夹具-分类学-注入器协同设计"的内部一致性限制;把清单加注入的方法学扩展到 IV、RDD、合成控制等准实验设计;样本外检验校准规则——leave-one-paper-out 复发检查显示"弱检索+缺失证据"触发模式在全部 5 折复现(79–86% 与 94–100%),但规则未在留出折上重新评分。基于成果可延伸的方向:把 ARGUS 的识别审计层与 CausalVerify 的执行验证层串成"论证完整性 + 代码可复现"两级评审流水线;启用并扩展图表解析,用多模态模型读取事件研究图;把 unknown 弃权机制推广为审计类系统的标准接口;在期刊投稿与 arXiv 审核流程中做辅助审稿集成实验;用嵌套/分层自助法处理论文内单元格相关性(目前把 55 格当独立样本);向多语言论文和更广的实证研究审计(统计报告完整性、可复现性检查)扩展。
复现评估
复现条件在同类工作中属最好一档。代码、配置、提示词、提交的运行文件、冻结的试点输入、标注协议和锁定金标全部开源在 github.com/yonghongzhang-io/ARGUS。算力与成本:33 变体一次完整运行约 750 次调用、约 20 分钟、约 8 美元(gpt-4o);两级管线审一篇论文约 22 次调用、约 0.25 美元;本地 Llama 3.1 8B 约 67 分钟(笔记本、零 API 成本)。确定性:gpt-4o 温度 0 下三轮运行检测决策 32/33 一致、风险标签 31/33 一致;检测率在 gpt-4o 别名与 2024-11-20 快照间精确复现,但定位率在 0.455–0.727 间波动,且 2026 年 6 月与 7 月运行出现过未解释的大差异。数据:合成夹具随代码发布;真实语料复用 CausalVerify 公开的 259 篇经济学论文(26 篇标注 DID,含一篇字节级重复);试点标注协议先于标注提交、每次提交以 SHA-256 记录、金标一次锁定。整体评估:中等偏易——代码数据齐全、成本极低,但需注意跨厂商解码默认不同、结果对检索实现与运行日期敏感,人工试点部分应直接使用冻结输入。
论文图表
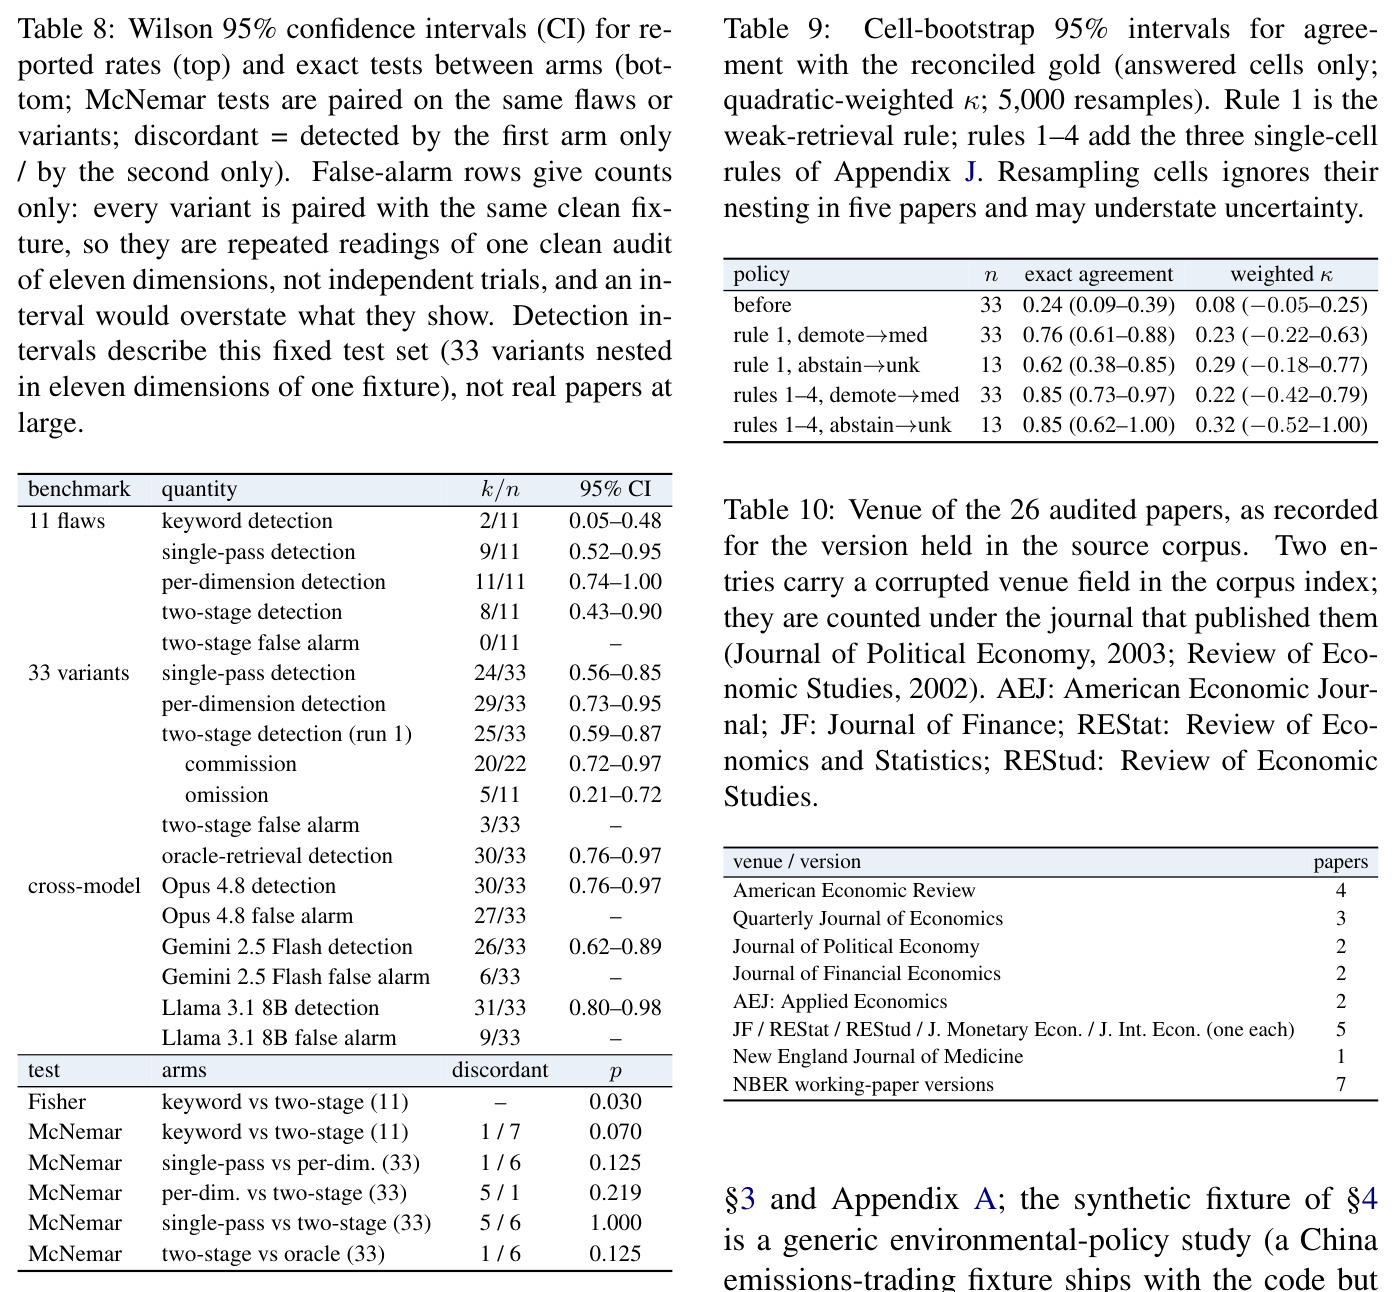
主文所有比例的置信区间和配对精确检验结果,包括对"干净审计只有一个、误报行非独立试验"的诚实说明。
所有"哪个架构更好"的结论都必须带着这些区间读:论文由此坦承 n=11/n=33 下两两差异均不显著,只支持描述性比较——这是评估其结论强度的必读表。
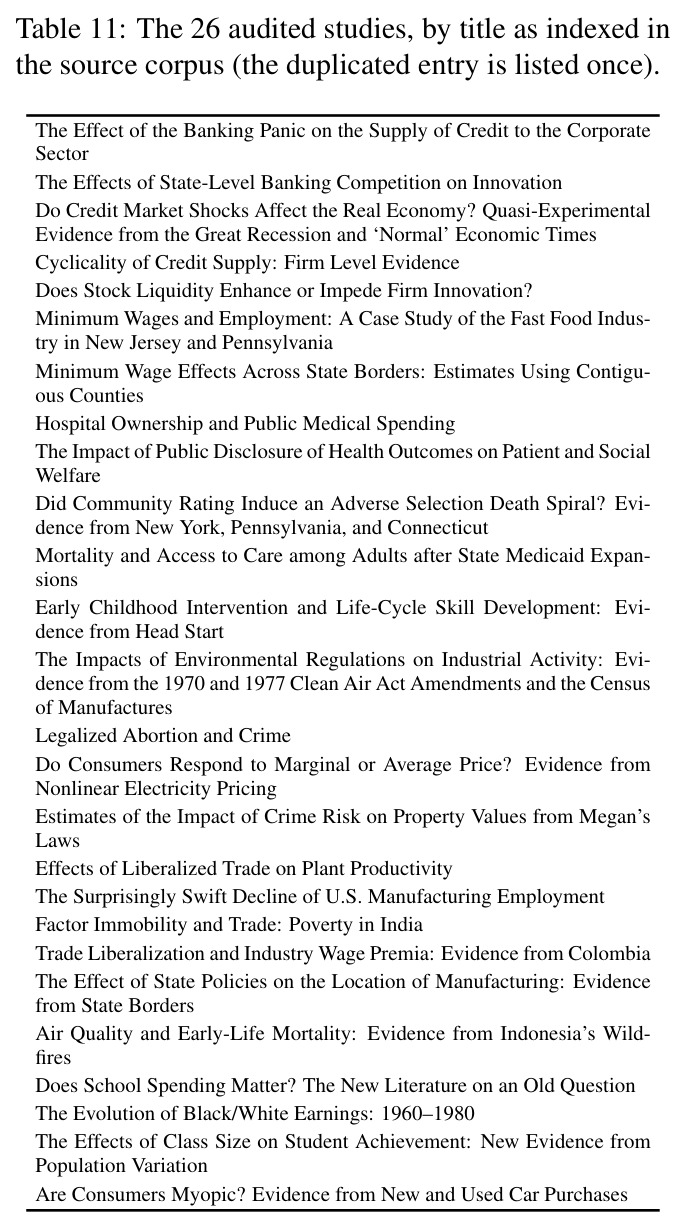
26 篇被审论文的发表载体分布,注明语料索引中两个 venue 字段损坏的处理方式。
说明真实语料的质量构成:以顶刊经济学为主,帮助读者判断"通用经济学压力测试"这一语料定位的代表性与局限。