TrackEverything:基于 3D 场景表征去重的长时程稠密点跟踪 TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations
以体素去重的持久 3D 场景表征,首次在 40GB 显存内实现千帧全点稠密 3D 跟踪
前置知识
点跟踪(Point Tracking / TAP)
给定一段视频和若干查询点(像素坐标+出生帧),预测每个查询点在整段视频中每一帧的位置与可见性。「稀疏跟踪」只跟踪用户指定的少量查询点,如 PIPs、CoTracker3、TAPIP-3D;「稠密跟踪」跟踪画面网格上的所有点。按可覆盖的点集范围又分「首帧稠密」(只跟踪第一帧可见点)与「全帧稠密」(所有帧出现的所有点,最严格的设定)。
本文的任务设定就是全帧稠密 3D 点跟踪,论文对基线的三分类(稀疏/首帧稠密/全帧稠密)和所有实验结论都建立在这些概念区分之上。
Pointmap 与前馈 3D 重建(DUSt3R/VGGT)
Pointmap 指为每一帧的每个像素直接预测一个世界坐标系下的 3D 坐标,形成逐像素 3D 点图。DUSt3R、VGGT 等前馈模型可在单次前向中从任意视频估计相机位姿和 pointmap,把 2D 图像「提升」到以首帧相机(cam0)为锚、全局尺度归一化的统一世界坐标系中。
TrackEverything 完全依赖外部几何把 2D 特征反投影成世界坐标 3D 特征云;几何来源(传感器/估计器)是它可替换的模块,也是论文的重要消融维度。
4D 相关体(4D Correlation Volume)
RAFT/PIPs 一脉跟踪器的核心组件:在查询点特征与全视频稠密特征之间构建的相关性代价体,维度为点数×帧数×高×宽,为「点该移到哪里」提供直接匹配证据。其构建与查询的内存、计算随点数和帧数快速增长,是跟踪点数上限和视频长度的根本瓶颈。
理解 4D 相关体的开销,才能理解本文用 3D WAFT(特征采样+自注意力)替代它的动机,以及为何本文能把查询点扩展到 1 万个。
WAFT(Warp-Aligned Feature Transforms)
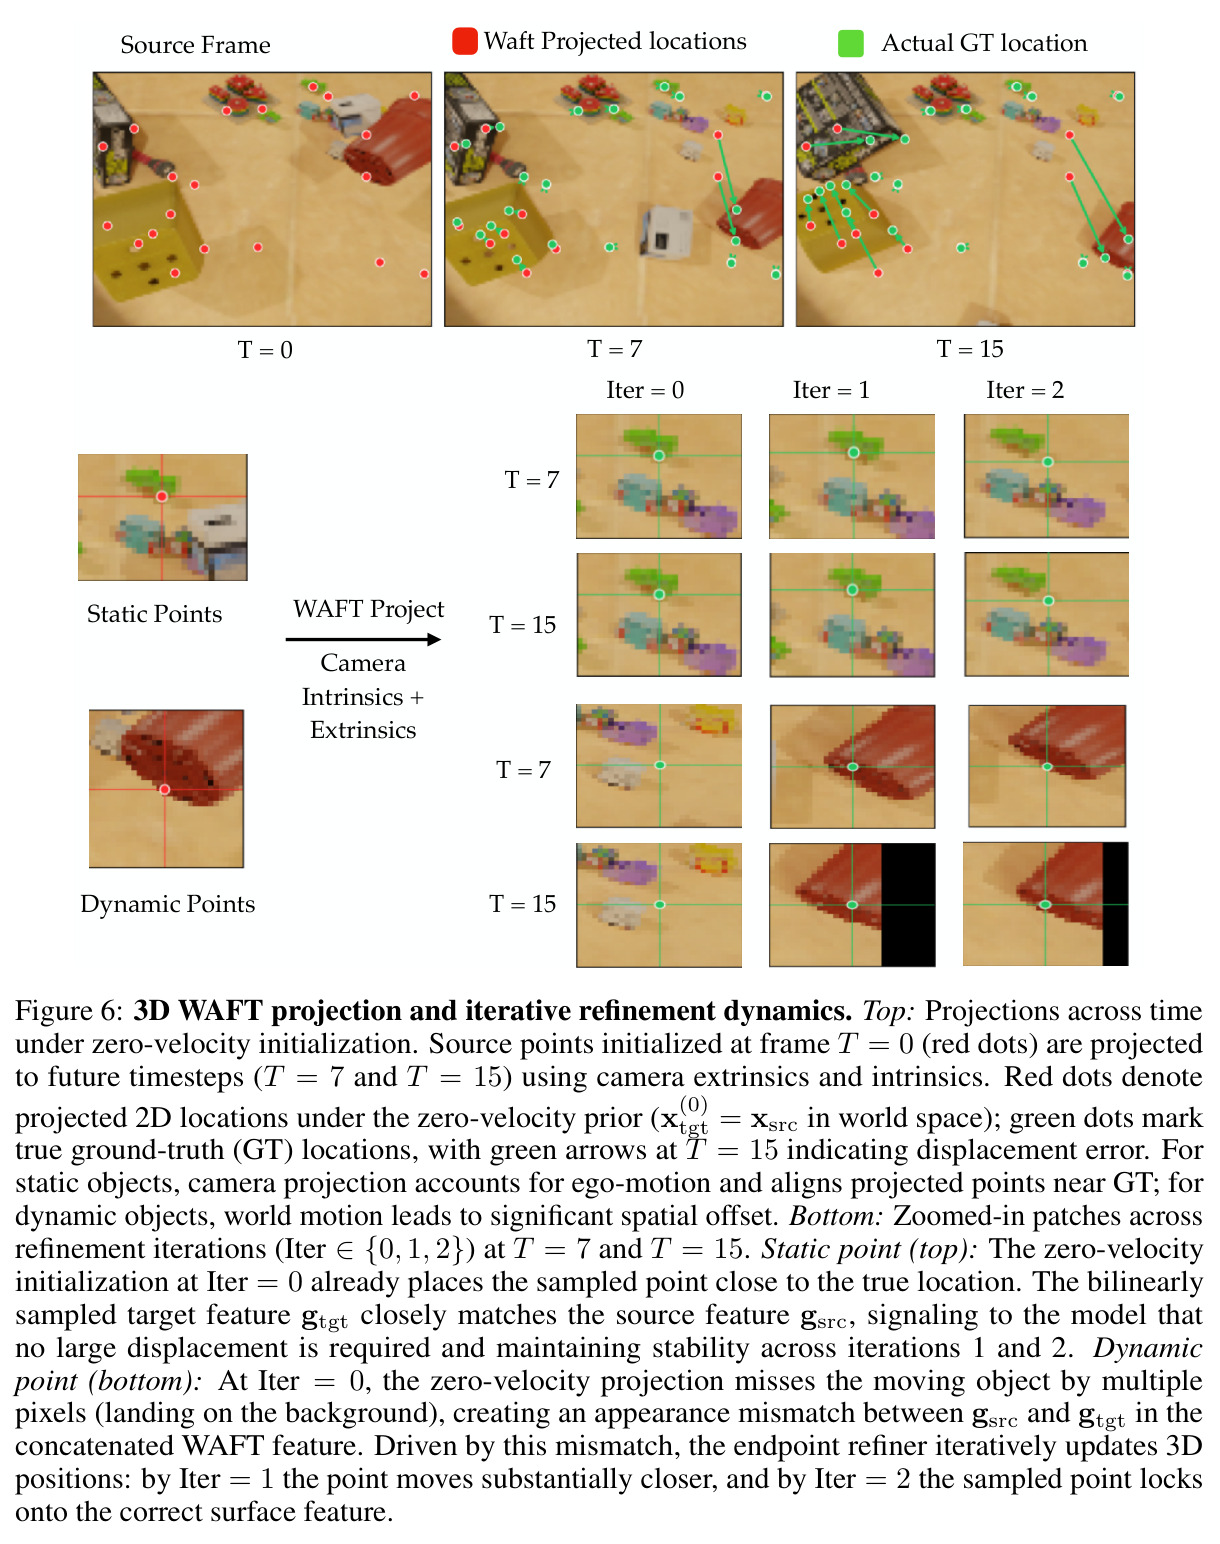
一种光流方法,核心发现是:不需要相关体,只要把当前估计的目标位置 warp 到源/目标帧特征图上做双线性采样,把源特征与目标特征拼接后做自注意力,网络即可完成对应匹配——两特征相似说明当前估计已准确,不相似则说明需要继续修正,天然构成模板匹配信号。
本文提出的 3D WAFT 把这一思想首次扩展到 3D 点云跟踪,在投影位置采样特征,是效率提升的两大关键组件之一。
滑动窗口循环推理(Sliding-window Recurrent Inference)
把长视频切成固定长度(本文 $L=16$ 帧)的窗口逐段处理,上一窗口结束时输出的点位置作为下一窗口的初始化,像 RNN 一样在窗口间传递状态;窗口内部则做 K 次迭代精炼。训练时不跨窗口反传梯度以控制显存。
跨窗口体素去重恰恰发生在窗口边界——「窗口边界处所有点已对齐到同一目标时刻」是合并合法性的物理前提,这是全文最核心的机制。
APD 评测指标(TAPVid-3D)
Average Position Distance:统计预测点落在真值一定距离阈值内的比例,再对一组阈值取平均。APD-P(point-wise)把像素阈值 $\{1,2,4,8,16\}$px 经相机内参反投影为深度相关阈值,较严格,是稀疏跟踪器惯用口径;APD-M(metric)用固定米制阈值 $\{0.1,0.3,0.5,1.0\}$m,较宽松,稠密跟踪器多用。
论文主表同时报告两种口径,且「超过 20% APD」这一核心声明的比较对象就是 APD-P,正确理解指标才能准确解读实验表格。
研究动机
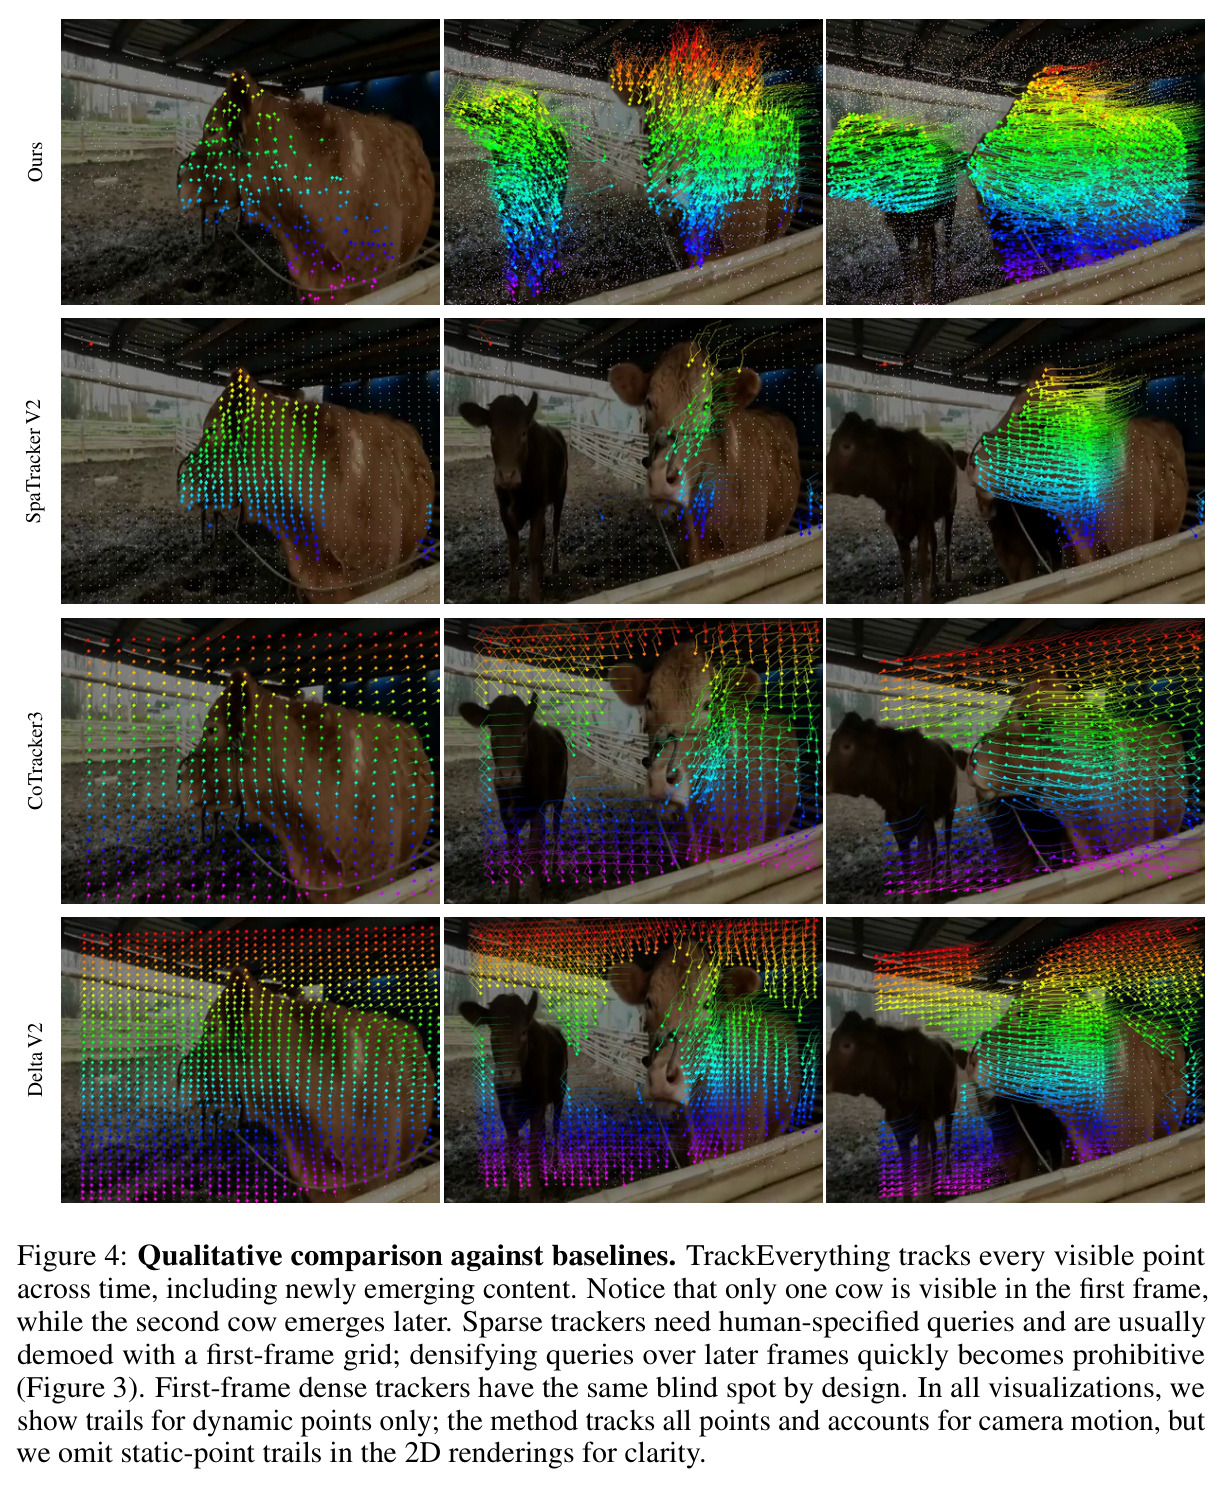
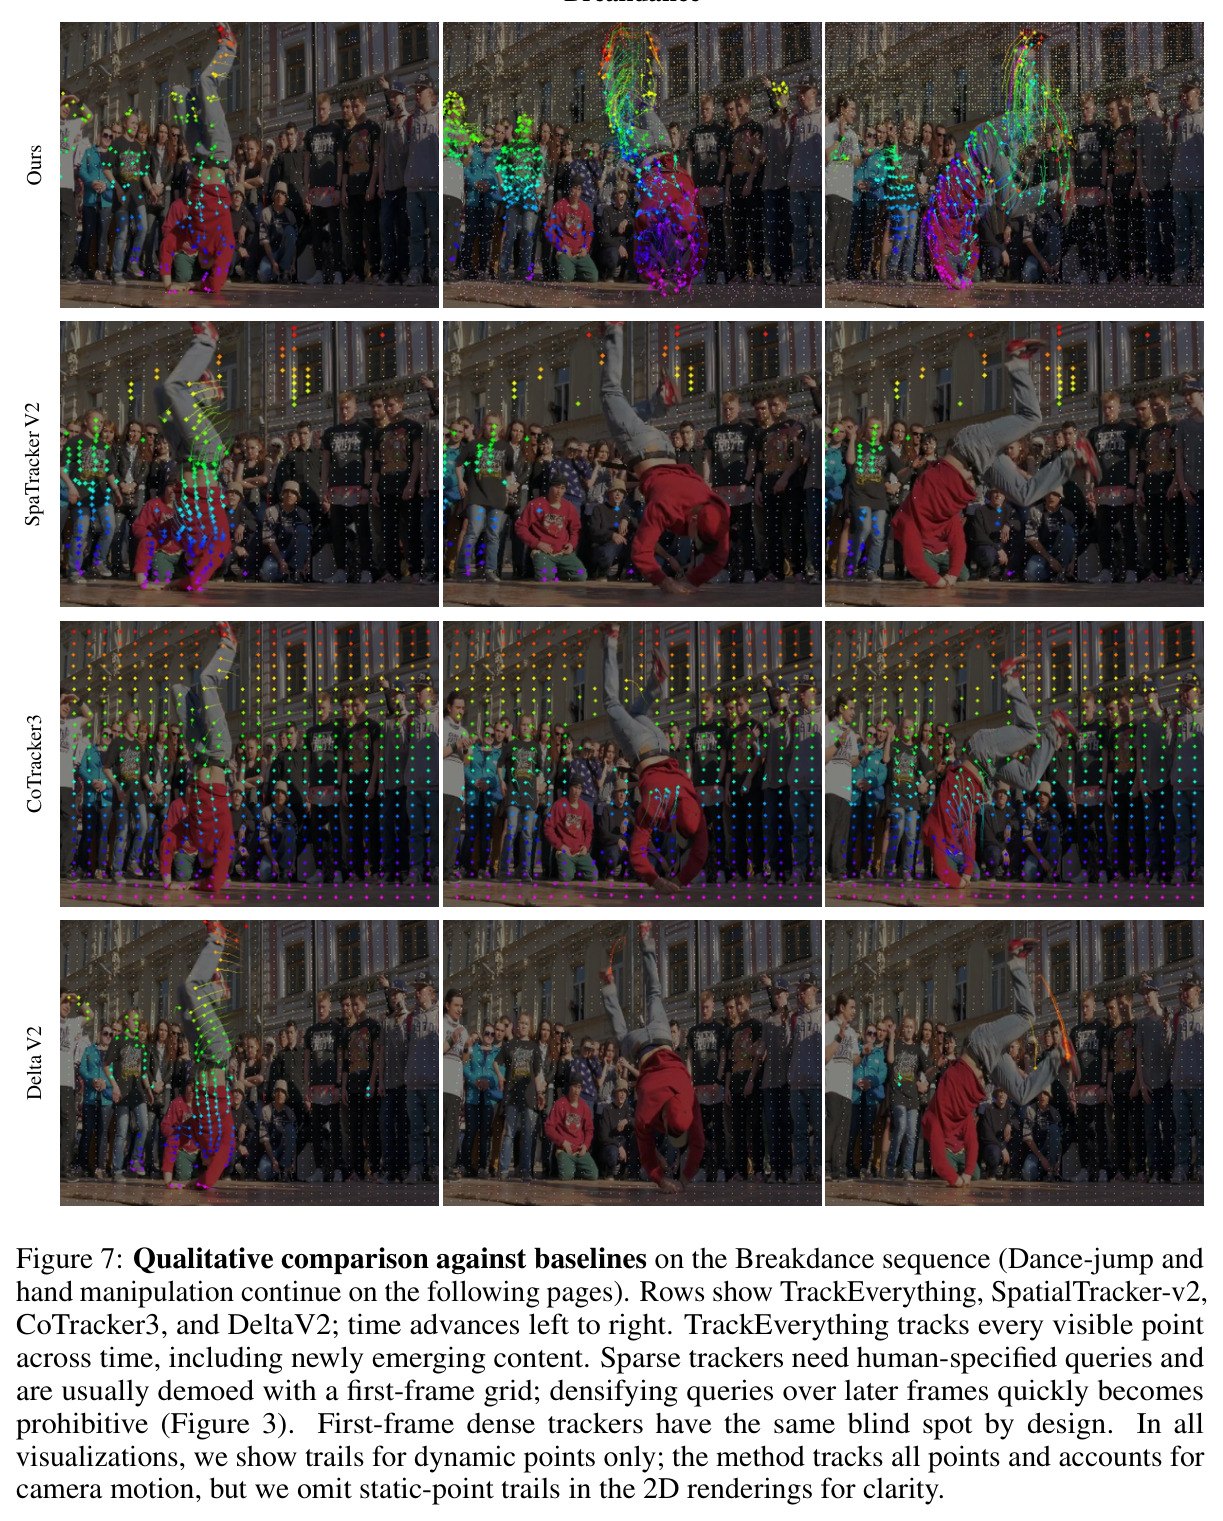
现有点跟踪模型存在根本性权衡。稀疏跟踪器(SpatialTracker-v2、TAPIP-3D、CoTracker3)可以借助滑动窗口跨越长时程,但只能跟踪用户指定的少量查询点,场景其余部分完全未被建模;稠密跟踪器工作在逐帧的 2D 像素空间,每一帧都会重新引入一整网格视觉 token,无论该帧揭示的是新场景内容还是对已见表面的重复观测,导致计算与显存随视频时长线性乃至平方级膨胀。因此现有稠密方法被迫二选一:DELTA、AllTracker、ST4RTrack、Any4D 只跟踪第一帧可见点,无法覆盖后续新出现的表面;VDPM、TraceAnything、D4RT 虽能全帧全点跟踪,却被压缩在 48–64 帧的短片内。论文给出一个直观量级估算:对 512×512、200 帧的视频做全点跟踪需要约 $10^{10}$ 次预测。结果是,没有任何已有方法能在完整长度的视频上跟踪所有可见点。
本文的目标是本文目标是构建 3D 点跟踪器 TrackEverything,同时满足三个此前互斥的要求:第一,稠密——跟踪视频中所有可见表面点,包括第一帧之后新出现的区域,同时保留接受任意时刻稀疏亚像素查询点的能力;第二,长时程——扩展到 1000 帧以上的视频而不耗尽显存;第三,精度有竞争力——在 TAPVid-3D 基准上与稀疏 SOTA 相当。更根本地,作者希望模型的复杂度随「唯一物理场景几何」而非「视频帧数」增长,从而在 40GB 显存的单张 GPU 上让全帧稠密长视频跟踪首次变得可行,为下游基础模型提供持久动态 3D 场景表征。
与已有工作不同的是,本文的独特切入点是一个被逐帧 2D 处理范式掩盖的事实:视频只是底层持久 3D 世界的相机投影流。在 2D 像素空间里,同一块桌面会在每一帧被表示成一份独立的点网格,时序冗余无法消除;而在世界坐标的 3D 空间里,静态表面永远停在同一个位置,多帧的重复观测可以显式合并。作者把「两个物理实体不能在同一时刻占据同一空间位置」这一物理常识转化为表示层操作:在窗口边界按体素合并共置点。由此,表示大小由场景中唯一几何的总量决定——相机扫回旧区域不会让模型变大,只有真正的新内容出现才扩张。这个「场景中心」而非「帧中心」的扩展规律,是全文所有设计(体素去重、静动分解、3D WAFT)的共同出发点,也是与 SpatialTracker-v2 等「虽用 3D 表示但每帧保留完整点网格」方法的本质分野。
核心方法
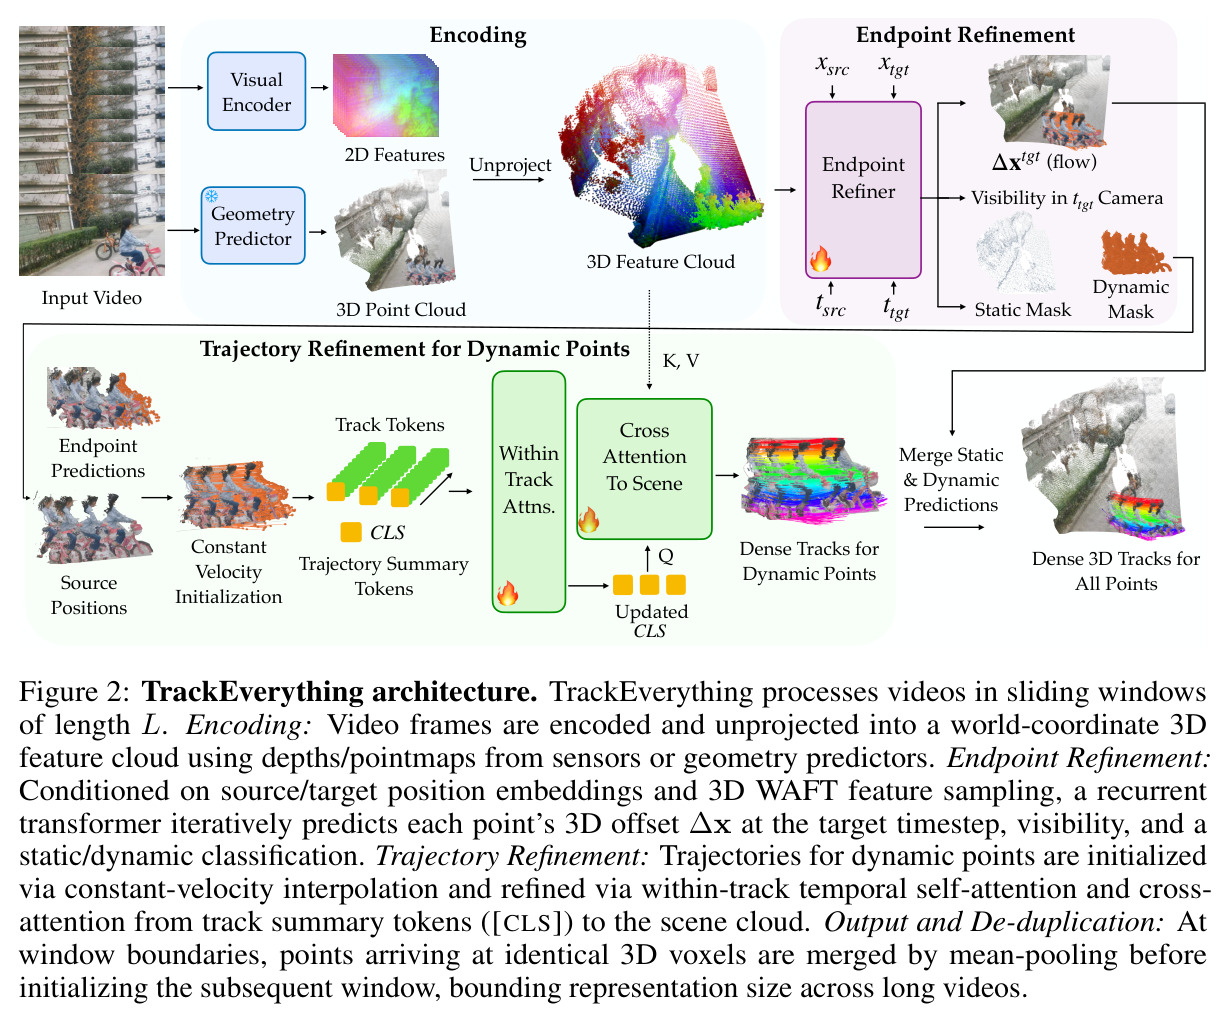
直觉上,真实场景绝大部分是静止的:相机来回扫动的长视频里,绝大多数点只是被反复看到。如果跟踪的对象不是「每帧的像素」而是「持久的 3D 物理点」,长视频就不再可怕。技术路线分四步。编码:视频按 $L=16$ 帧的滑动窗口处理,冻结的 DINOv3-small 加可训练 ViT Adapter 为每帧提取特征($D=384$),用外部 pointmap 把特征反投影进以首帧相机为锚的世界坐标,并在帧内做体素量化去冗余,拼成时空 3D 特征云。端点精炼:一个循环 Transformer 迭代预测每个点在窗口末端时刻的 3D 位置残差 $\Delta x$、可见性与静/动分类。轨迹精炼:只为被判为动态的点解码窗口内稠密轨迹。边界去重:把所有点按被跟踪到的末端位置做体素化,均值池化合并共置点,与下一窗口新观测拼接后进入下一窗口,如此往复。整条流水线在窗口内的迭代机制与跨窗口的链接机制完全同一,区别仅在于初始化来自上一迭代还是上一窗口。
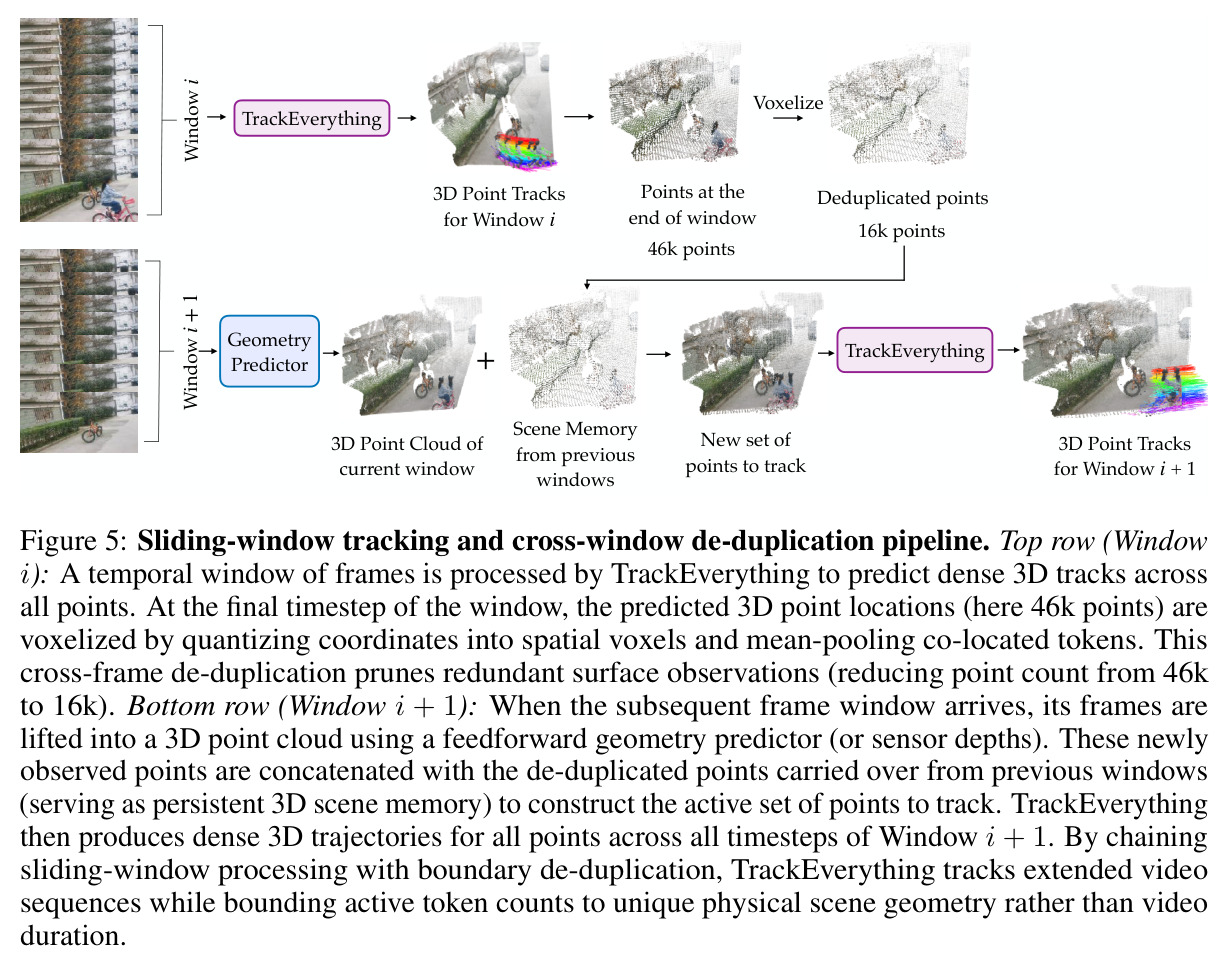
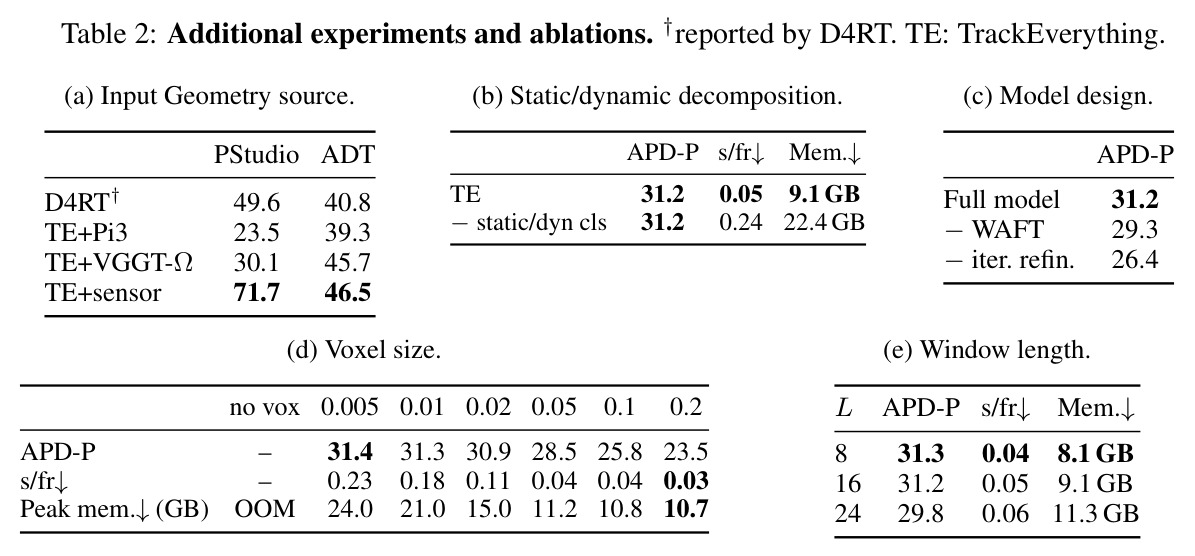
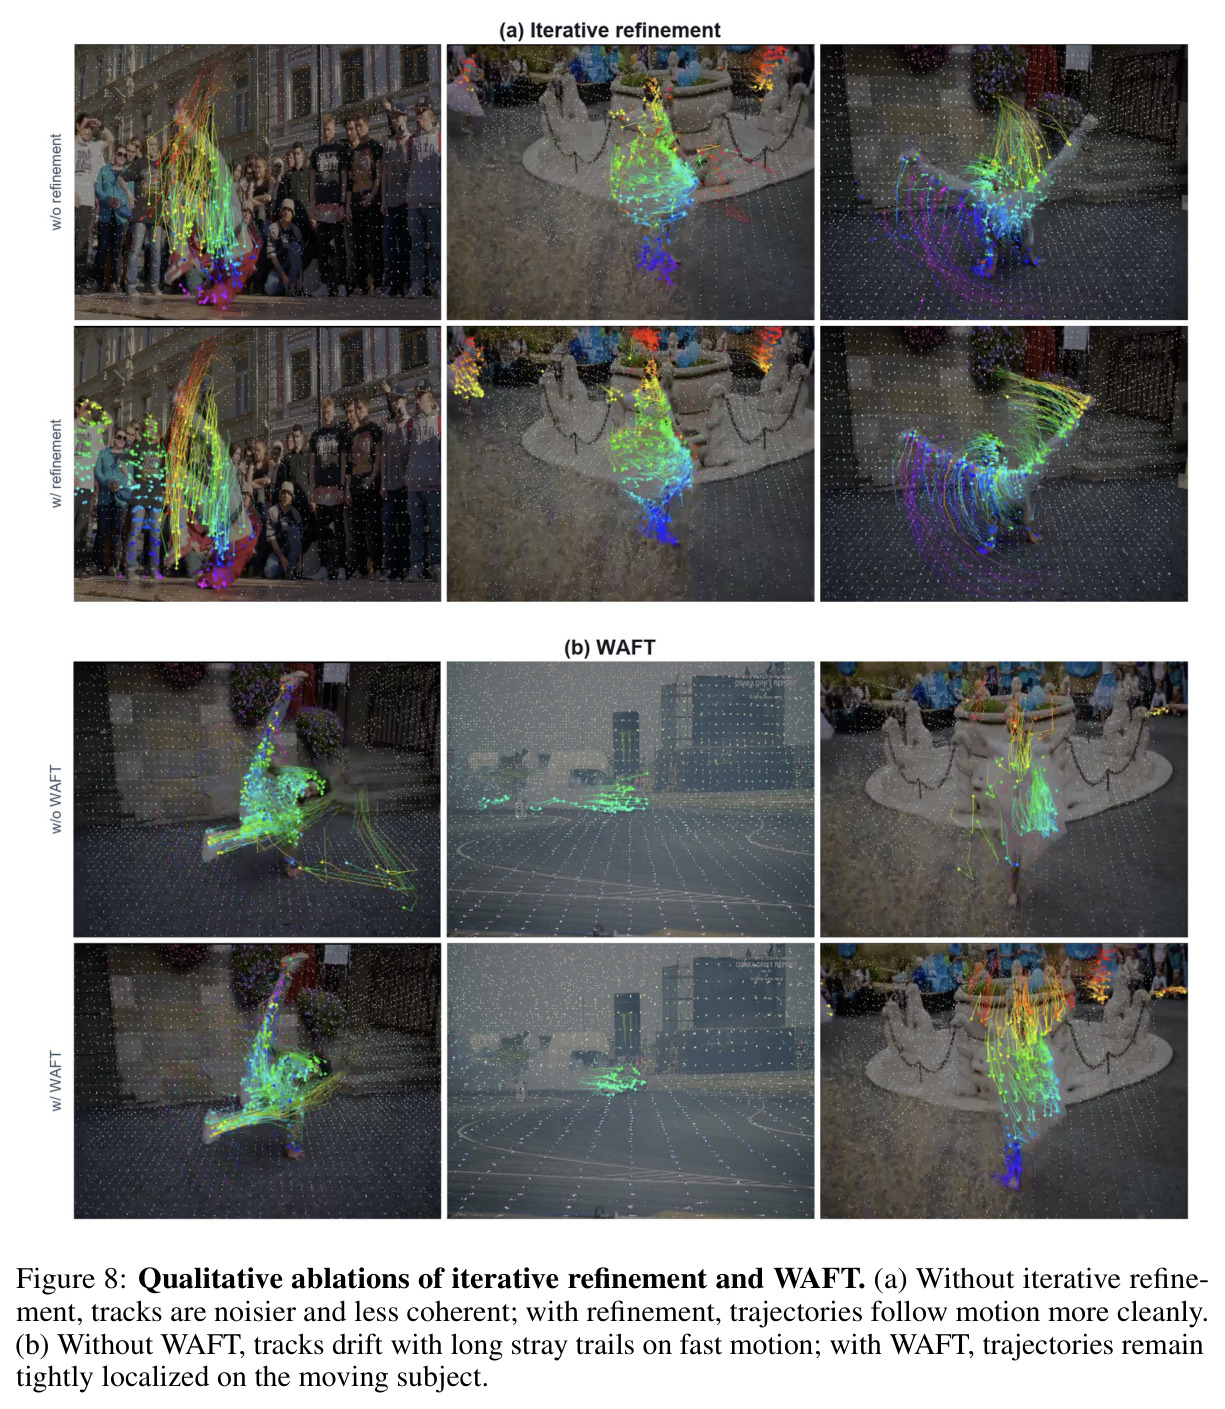
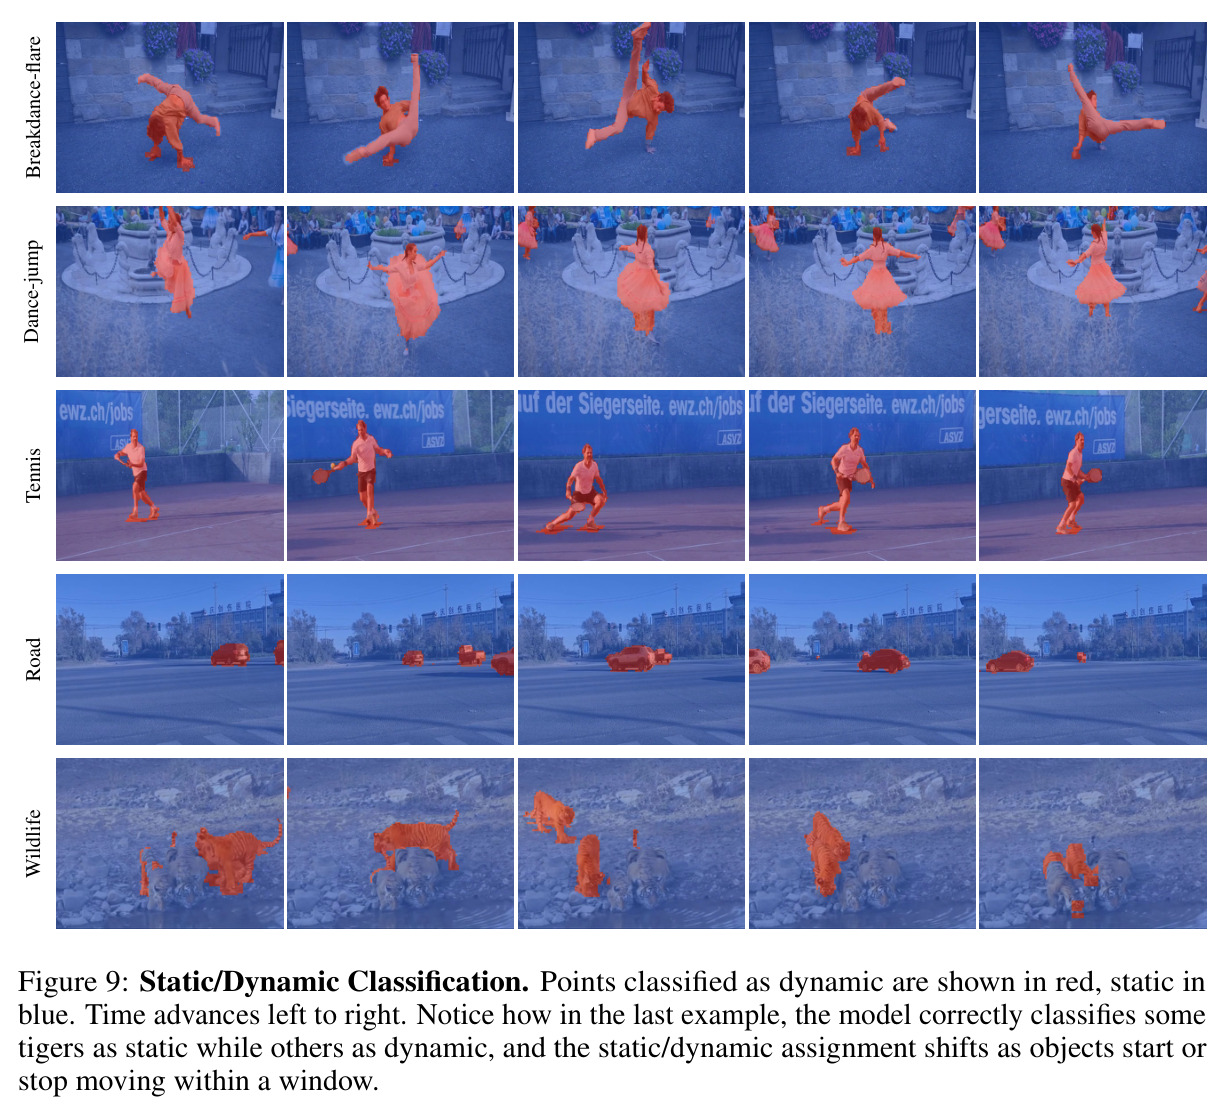
核心创新有三,本质区别在于把「去重」从工程技巧提升为表示层的第一性操作。其一,跨窗口体素去重:按 $\mathbf{k} = \lfloor \mathbf{x}/v \rfloor$(默认 $v=0.02$,归一化单位)量化,把落到同一体素的点均值池化为单一规范轨迹。与 SpatialTracker-v2、TAPIP-3D 等保留每帧完整点网格、内存随帧数线性增长的 3D 方法不同,本文的活跃点集只随唯一几何增长(Fig. 5 中一个窗口内 46k 点合并为 16k)。其二,「先端点、后轨迹」的任务分解:滑窗传递状态只需要每个点在窗口边界的落点,稠密解码只对动态点进行——静态点在世界坐标中天然不动,直接继承位置即可。这一分解利用了「场景中运动点是少数」的事实,消融显示它以零精度代价换来 4.8 倍提速。其三,3D WAFT:把点的当前目标位置估计投影到目标帧 2D 特征图上双线性采样 $g_{tgt}$,与出生点特征 $g_{src}$ 拼接成 $[f_i;\, g_{src,i};\, g_{tgt,i}]$ 供自注意力使用,用模板匹配信号完全替代昂贵的 4D 相关体。
方法步骤详情
第一步编码:输入 $I \in \mathbb{R}^{T\times H\times W\times 3}$ 与 pointmap $P$(来自传感器或 VGGT-Ω),逐帧编码并反投影;帧内按 $\lfloor x/v \rfloor$ 体素量化、同体素均值池化,跨 $L$ 帧拼成特征云——去重只在帧内进行,避免不同时刻占据同一空间的表面被误并。第二步端点精炼:每个点带源时刻 $t_{src}$(本窗口首次被观测的帧,跨窗携带点为 $-1$)与目标时刻 $t_{tgt}$(推理时固定为 $L-1$);注入四个正弦位置嵌入 $f_i \leftarrow f_i + E^{xyz}_{src}(x_{src,i}) + E^{xyz}_{tgt}(x^{(k-1)}_{tgt,i}) + E^{t}_{src}(t_{src,i}) + E^{t}_{tgt}(t_{tgt})$,经 $N_{attn}$ 层全云自注意力后由 MLP 解码 $\Delta x$、可见性、静/动三个头,更新 $x^{(k)}_{tgt} = x^{(k-1)}_{tgt} + \Delta x^{(k)}$,重复 $K$ 次。第三步轨迹精炼:动态点以恒速插值初始化 $L$ 帧轨迹,每个时刻 token 由轨迹特征、$g_{src}$、按当前估计位置采样的特征拼接,附 [CLS] 汇总 token;「轨迹内时间自注意力 + [CLS] 对场景云交叉注意力」交替多层,各轨迹互相独立(训练可随机解码子集而不产生分布偏移),MLP 输出逐时刻 3D 流残差与可见性。第四步窗口边界去重:以预测末端位置做跨帧体素化合并,与下一窗新点拼接进入下一窗。损失为 $\mathcal{L} = \mathcal{L}_{coord} + \lambda_{vis}\mathcal{L}_{vis} + \lambda_{dyn}\mathcal{L}_{dyn} + \lambda_{conf}\mathcal{L}_{conf}$,仅在有标注的点上计算。
技术新颖性
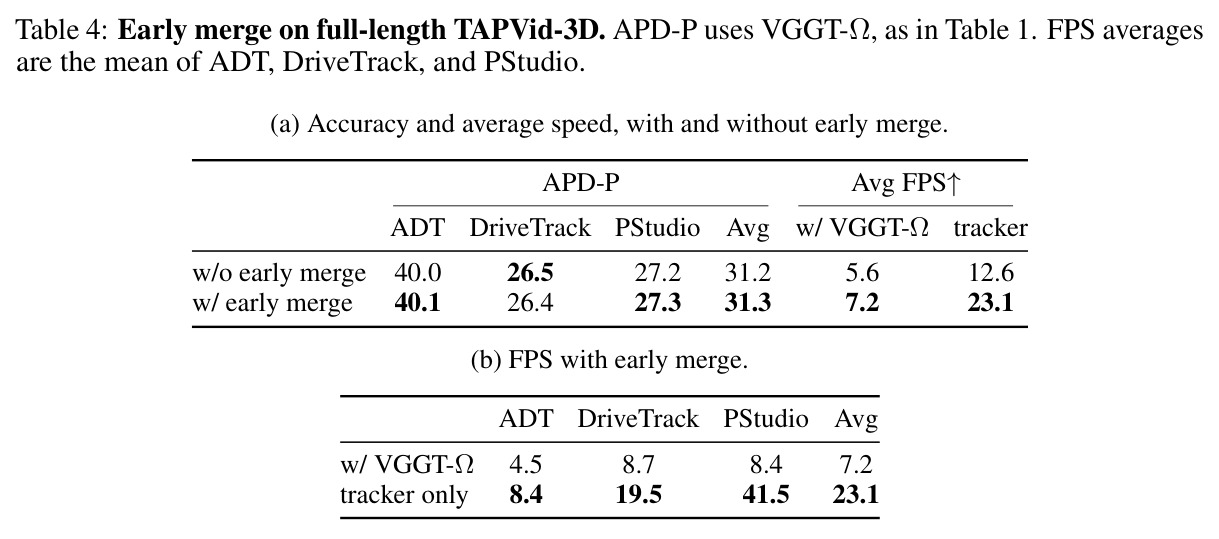
技术新颖性可从四个层面评估。表示层面:据作者所知这是第一个把「随唯一几何扩展、而非随帧数扩展」作为显式设计目标的跟踪器;去重通过不可逆均值池化物理地压缩表示,体素哈希按需分配索引,支持任意扩展的开放场景,无需空间边界或截断。任务分解层面:端点/轨迹两段式与 D4RT 等端到端解码所有轨迹的方案不同,把 $O(N\cdot L)$ 的稠密解码压缩到 $O(N_{dyn}\cdot L)$,静动分类还会随窗口在线更新。匹配层面:3D WAFT 把 WAFT「免相关体」的结论首次带入 3D 跟踪,配合源/目标双特征采样,比 TAPIP-3D 的 3D 邻域注意力和 SpatialTracker-v2 的 2D+3D 相关更省。工程层面:模块化几何接口使模型无需重训练即可受益于更好的几何后端(Pi3→VGGT-Ω→传感器带来 +6.4 到 +25.6 的 APD-P 提升);整个模型仅 61M 参数(含 20M 冻结骨干)、只用 3 个公开合成数据集训练,对比 D4RT 的 1B+ 参数与私有数据。此外还支持免体素化的稀疏查询点分支、通过轨迹谱系记录精确反解全部历史轨迹 $X_{orig}(t) = X_{vox[p]}(t) + r$,以及零精度代价的静态点早期合并加速。
实验结果
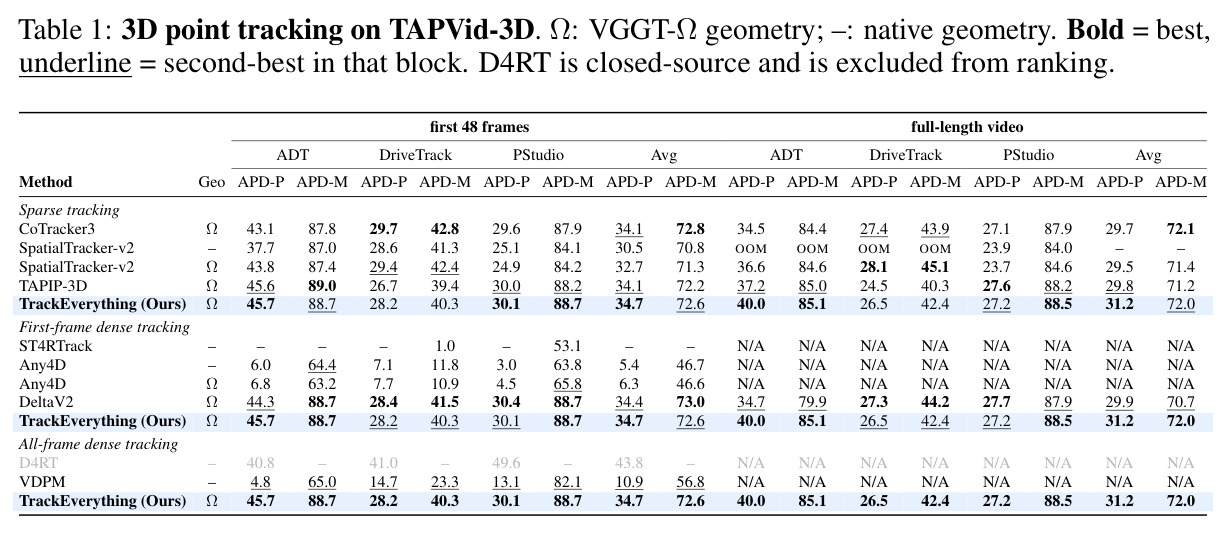
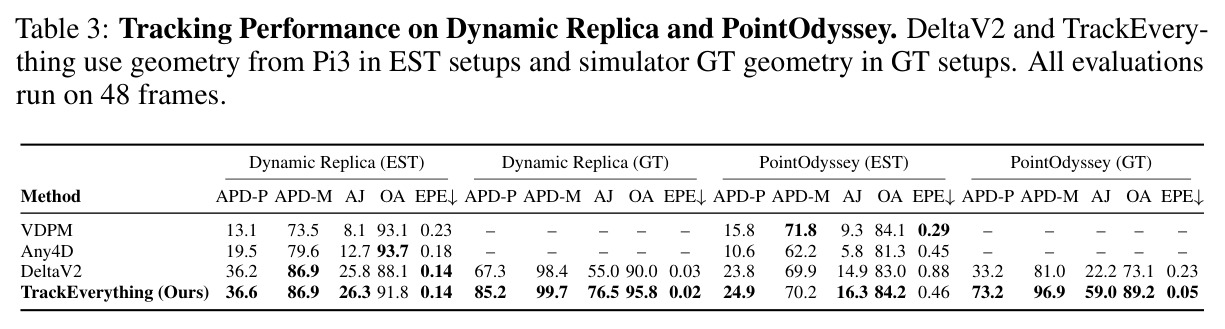
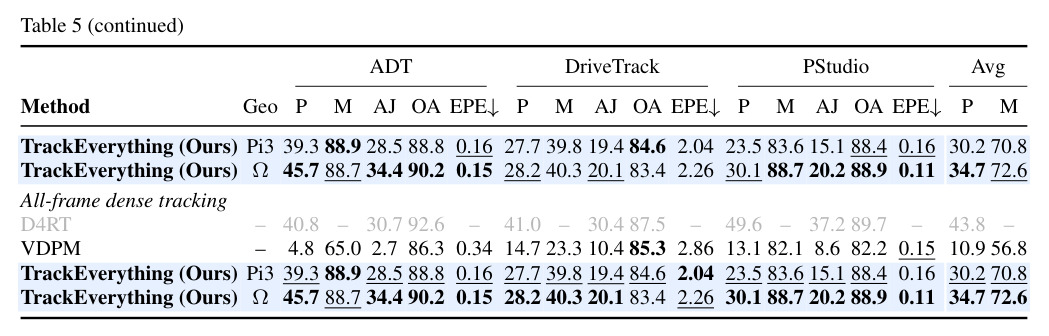
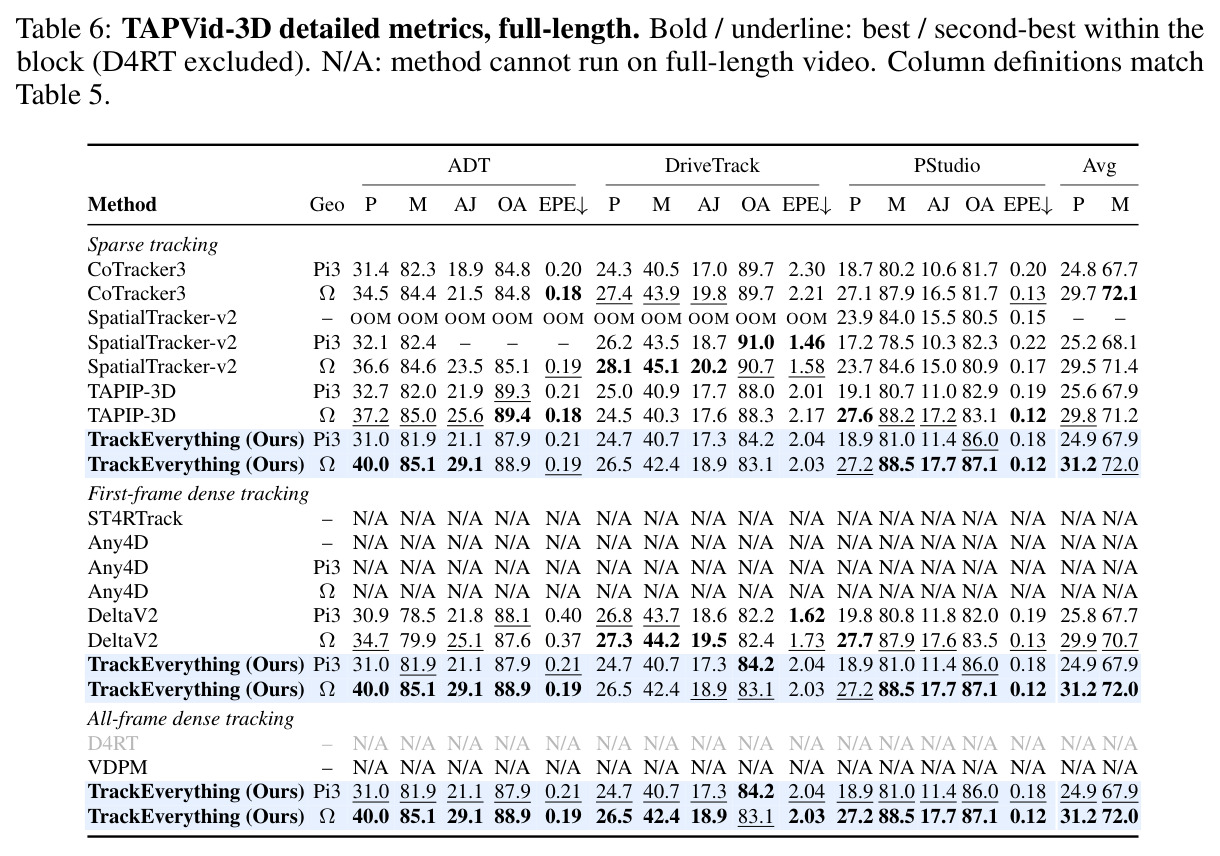
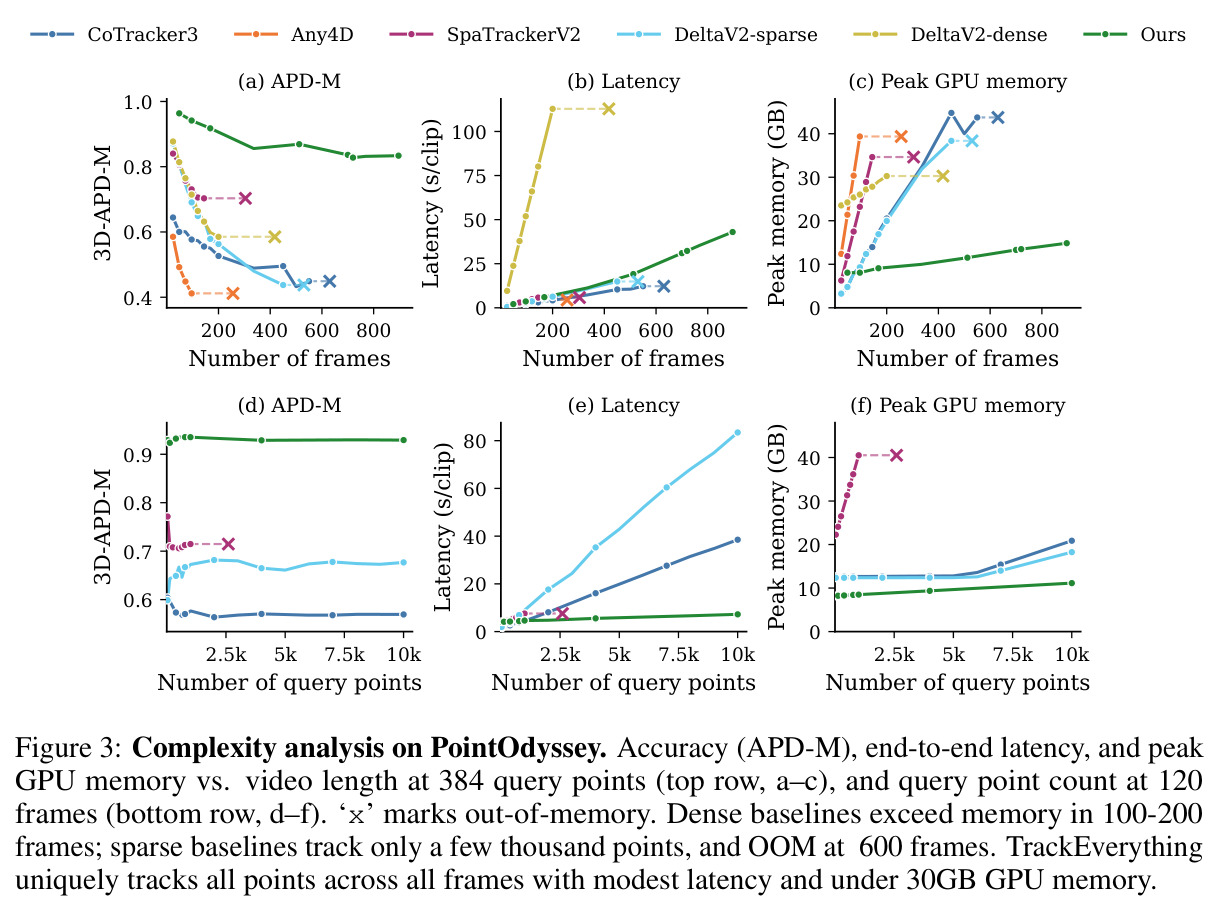
主实验在 TAPVid-3D(ADT/DriveTrack/PStudio 各 50 段 minival)上进行。48 帧设定下,TrackEverything(VGGT-Ω 几何)取得平均 APD-P 34.7 / APD-M 72.6:比最强开源全帧稠密基线 VDPM(APD-P 10.9)高出一倍以上,兑现「20%+ APD」的声明;比闭源的 D4RT(43.8)整体落后,但 D4RT 参数量约为其 20 倍、使用私有数据且仅评 48 帧,且在 ADT 上(40.8)反而低于本文(45.7);与首帧稠密的 DeltaV2(34.4)持平略胜,但本文额外覆盖了后续帧出现的所有点。全长度设定下,本文平均 APD-P 31.2 / APD-M 72.0,是唯一能跑完全程的全帧稠密方法,同时追平稀疏 SOTA(TAPIP-3D 29.8、SpatialTracker-v2 29.5、CoTracker3 29.7),尽管后者只跟踪几百个查询点而本文跟踪场景全部点。复杂度实验(PointOdyssey,单张 L40S-46GB):900 帧时峰值显存低于 30GB,而 Any4D 96 帧、SpatialTracker-v2 与 DeltaV2-dense 约 200 帧、DeltaV2-sparse 约 500 帧、CoTracker3 约 600 帧即 OOM;查询点扩容实验中本文延迟近乎恒定,支持 1 万个额外查询点,SpatialTracker-v2 在 1000 点即 OOM。补充实验:GT 几何下 Dynamic Replica 48 帧 APD-P 85.2(DeltaV2 67.3)、PointOdyssey 73.2(DeltaV2 33.2);千帧 PointOdyssey 全部 1 万+标注点上 APD-P 31.8 / APD-M 74.5,静动分类准确率 91.2%(动态 F1 78.5%、静态 F1 92.5%);静态点早期合并使 tracker 吞吐从 12.6 升到 23.1 FPS(1.8 倍)而精度不变(31.3)。
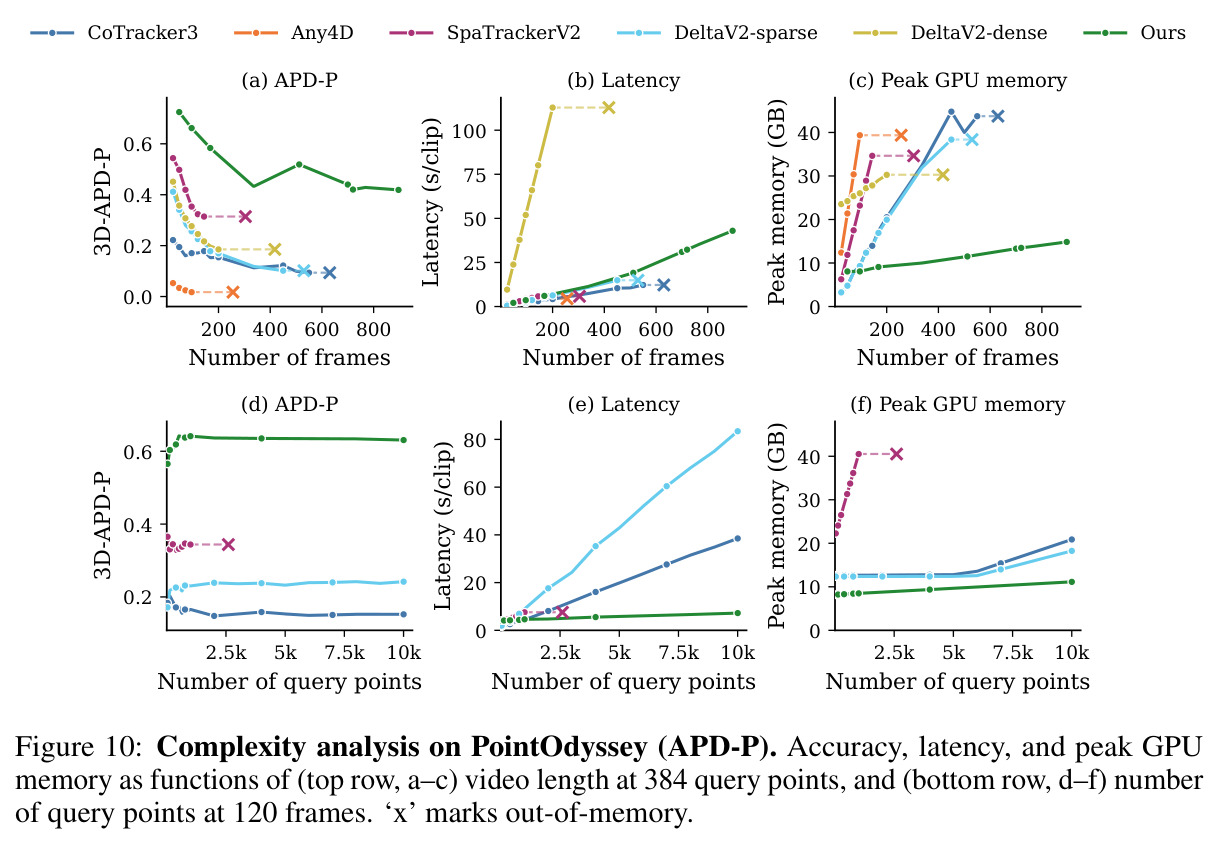
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TAPVid-3D 48 帧(ADT+DriveTrack+PStudio 平均) | APD-P | 34.7 | VDPM 10.9(最强开源全帧稠密);D4RT 43.8(闭源,仅参考) | 较 VDPM +23.8;较 D4RT −9.1 但参数仅约其 1/20 |
| TAPVid-3D 全长度视频平均 | APD-P | 31.2 | TAPIP-3D 29.8;CoTracker3 29.7;SpatialTracker-v2 29.5(均为稀疏跟踪) | +1.4~+1.7,且跟踪点数高出数个数量级 |
| TAPVid-3D ADT 全长度 | APD-P | 40.0 | DeltaV2(首帧稠密)34.7 | +5.3 |
| PointOdyssey 长视频跟踪(单卡 L40S-46GB) | 峰值显存 | 900 帧时 <30 GB | Any4D 96 帧 OOM;SpatialTracker-v2/DeltaV2-dense 约 200 帧 OOM;DeltaV2-sparse 约 500 帧;CoTracker3 约 600 帧 OOM | 可跟踪长度提升约 5 倍以上 |
| 查询点扩容(120 帧) | 最大可用查询点数 | 10,000+,延迟近恒定 | SpatialTracker-v2 于 1,000 点 OOM | 容量提升约 10 倍 |
| Dynamic Replica 48 帧(GT 几何) | APD-P | 85.2 | DeltaV2 67.3 | +17.9 |
| PointOdyssey 48 帧(GT 几何) | APD-P | 73.2 | DeltaV2 33.2 | +40.0 |
| 静/动分解消融(全点强制走轨迹解码器) | 延迟 / 峰值显存 | 0.05 s/帧 / 9.1 GB | 0.24 s/帧 / 22.4 GB(APD-P 均为 31.2) | 提速 4.8×、省显存 2.5×,精度零损失 |
局限与改进
作者承认四点局限。第一,体素去重虽把内存增长与场景内容绑定,但在永不停止的开放世界探索中活跃内存仍会持续膨胀,小时级轨迹需要引入空间缓存驱逐机制。第二,与多数 3D 跟踪器一样依赖外部几何,模块化换来灵活性,但性能上限被 pointmap 保真度锁死——动态场景中的深度估计误差会直接污染世界坐标。第三,跨窗口去重基于窗口边界时刻的空间邻近性,且合并用不可逆均值池化实现,跟踪误差会让两个不同物理表面永久坍缩成一条轨迹(用户可用免体素化的查询点分支保护关键点)。第四,模型容量(61M)与训练数据(3 个合成集)较小,复杂真实动态上仍有提升空间。我的补充观察:全长度设定下 DriveTrack 的 APD-P(26.5)仍低于 SpatialTracker-v2(28.1)与 CoTracker3(27.4);被误判为「静态」的动态点会被冻结整整一个窗口(16 帧),对间歇运动的物体可能产生周期性僵直;稠密评测只能依赖仿真数据的 GT 几何,真实开放世界的全帧稠密精度缺乏定量验证;去重合法性隐含「几何误差远小于体素尺寸 $v=0.02$」的假设,这在低纹理、反光、玻璃表面上未必成立。
独立分析的弱点
独立分析四个弱点并给出改进方向。其一,不可逆合并的鲁棒性风险:均值池化一旦把两个表面合并就永远无法拆开,而触发条件只是边界时刻的空间共置——深度估计抖动、快速运动模糊都可能造成假阳性合并。改进方向是用可逆的并查集谱系替代均值池化(保留各成员身份,仅在输出层聚合),或引入基于外观特征相似度的软合并门控。其二,静态点的「零成本」假设:被误判为静态的动态点会冻结一个窗口,虽然下窗口可恢复,但对手部、宠物等间歇运动物体可能产生肉眼可见的僵直。改进方向是在窗口中段用廉价的位移校验对静态点做一次重访,或按运动不确定性调整合并半径。其三,对几何前端的强依赖没有不确定性建模:pointmap 噪声直接进入世界坐标,体素尺寸却是全局固定标量。改进方向是根据局部几何置信度自适应调整 $v$,或在合并前用协方差做马氏距离检验。其四,评测与现实的差距:TAPVid-3D 只在稀疏查询点上评测,稠密指标的 GT 全部来自仿真,真实场景下全帧稠密质量(反光水面、人群遮挡、透明物体)尚无定量证据。改进方向是构建带稠密伪真值的真实长视频评测集,例如用多视角重投影一致性做交叉验证。
未来方向
作者明确提出的方向包括:为小时级轨迹引入空间缓存驱逐(对远处/久未见的表面保留摘要而非全量点);改进去重机制以消除不可逆坍缩;扩大模型容量与预训练数据以应对复杂真实动态。基于本文成果还可自然延伸:第一,把这种持久、去重、动态的 3D 场景表征作为下游基础模型的基座——作者在引言中指出显式 3D 表示对视觉语言模型、机器人操作策略、视频生成的价值,而现有方案局限于静态/准静态场景,全帧跟踪正好补上动态一环,可充当动态世界模型与 VLA 策略的记忆层;第二,与 SLAM/在线重建统一,让跟踪与几何互相修正,摆脱对外部 pointmap 的单向依赖;第三,语义与实例感知的合并准则——同一体素内不同实例或材质交界处的点不应被池化;第四,把「随唯一几何扩展」的思想迁移到 4D 重建与长视频生成,作为时间冗余压缩的通用原则;第五,利用轨迹谱系机制实现开放词汇的时空查询:给定文字描述返回任意表面点在任意时刻的位置。
复现评估
复现条件总体友好。模型很小:61M 总参数(41M 可训练 + 20M 冻结 DINOv3-small),训练用 8 张 L40S-46GB、每卡 batch size 1、学习率 $1\times10^{-4}$、共 41 万迭代(先 10 万步 32 帧视频,再 30 万步 32/64 帧混合),属于实验室可负担的规模;推理在单张 46GB GPU 上完成,千帧视频峰值显存低于 30GB。训练数据全部公开(Kubric、PointOdyssey、Dynamic Replica)。作者承诺随代码发布,并附带其对 PointOdyssey 的修复管线(该数据集存在相机外参错位一帧、可见性标注损坏等问题,修复细节见附录 A.5,涉及约 16 条序列 2.5 万帧);项目页 trackeverything.github.io 提供大量全长度可视化。复现的主要不确定点:外部几何默认用 VGGT-Ω,其版本与可用性需自行确认;attention 层初始化自 DINOv2-small 末层、各损失权重 $\lambda$ 等超参的完整程度待代码核对;与 D4RT 的对比因对方闭源而只能引用其论文报告数。综合评估:有单机多卡条件的研究组可在数周内复现训练,仅做推理验证则单卡即可。
论文图表
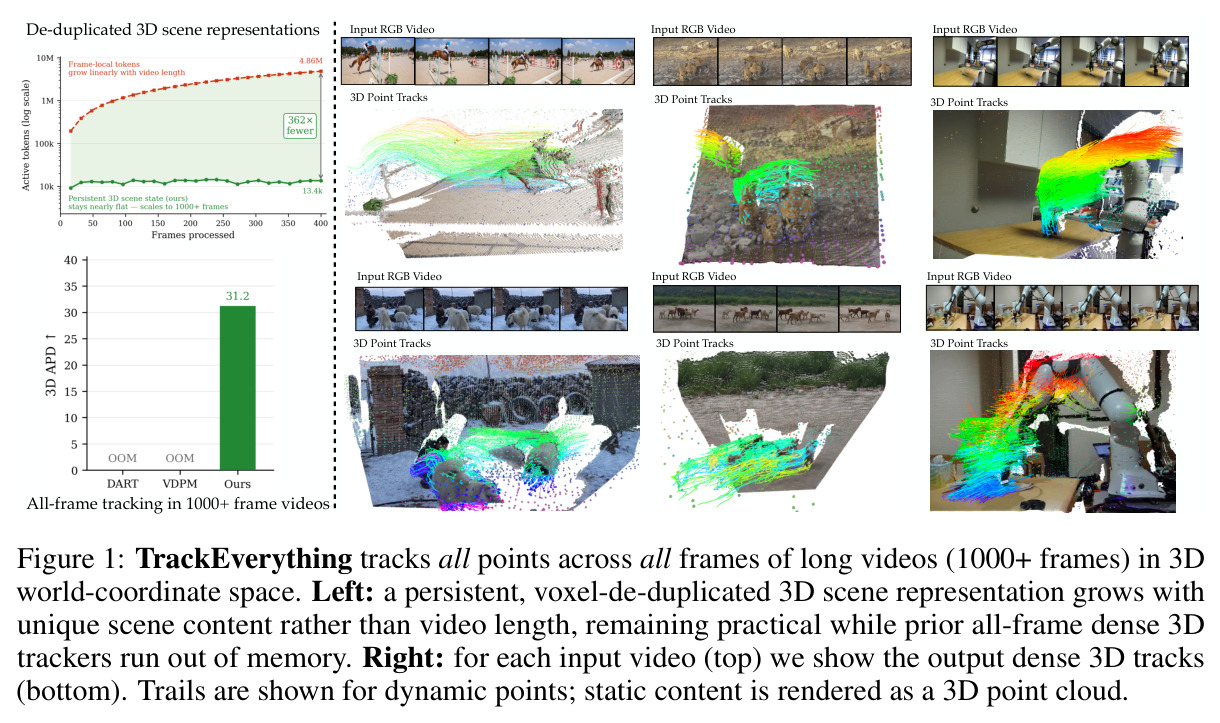
左侧对比:本文的持久、体素去重 3D 场景表示随唯一场景内容增长而保持实用,而已有全帧稠密 3D 跟踪器在长视频上显存耗尽;右侧展示多段输入 RGB 视频及其输出的稠密 3D 点轨迹(动态点绘制轨迹线,静态内容渲染为 3D 点云)。
一图道破论文的核心卖点与差异化定位:表示复杂度与视频时长解耦、是唯一能做 1000+ 帧全点跟踪的方法,适合作为导读起点。