WanPE:面向现代文生视频的电影级提示词增强 WanPE: Towards Cinematic Prompt Enhancement for Modern Text-to-Video Generation
397B模型从真实视频反向学习电影级分镜规划,30秒视频偏好提升50.86分
前置知识
文生视频提示词增强(T2V Prompt Enhancement)
插入在用户请求与视频生成器之间的文本处理模块,把简短请求改写为生成器易于消费的详细条件文本。早期只做描述性润色;现代生成器上下文变长后,它承担规划动作、运镜、灯光、声音如何在多镜头序列中展开的导演职能。
本文的全部动机就是重新定义这一模块的角色:从润色升级为像素渲染前的电影级规划,读懂立论必须先理解这一演变。
GRPO(组相对策略优化)
一种 RLHF 类策略优化算法:对同一提示从当前策略采样一组输出,用组内奖励标准化得到相对优势 $\hat{A}_g$,配合 PPO 式 clip 目标与对参考策略的 KL 惩罚更新参数,无需训练价值网络,被广泛用于大模型对齐。
本文提出的 SC-GRPO 直接构建在 GRPO 之上,只是把奖励换成九维语义一致性评分,不了解 GRPO 就无法理解其优化方式。
分布对齐与 KL 散度
KL 散度 $\mathrm{D}_{KL}(p\|q)=\sum_y p(y)\log\frac{p(y)}{q(y)}$ 衡量两个分布的差异,是策略学习与蒸馏的核心工具。本文用它形式化'增强器输出分布应匹配视频生成器训练字幕分布 $p_{vg}$'这一目标。
理解论文为何强调前向扩写会造成分布失配、反向构造为何在源头更优,都依赖这一概念。
Bradley–Terry 模型
经典成对比较模型:为每个方法估计一个强度 $b_k$,A 胜 B 的概率为 $p_{kj}=\sigma(b_k-b_j)$。本文把 both-good 与 both-poor 记为平局,拟合强度后以 $BT_k=100\sigma(b_k)$ 报告相对平均对手的偏好分。
论文所有视频评测主表(Table 1/2/3)都同时报告专家偏好分 $S$ 与 BT 分,不懂它就读不懂核心结果。
视频级字幕
用多模态模型为真实视频生成详细文本描述的技术。本文特指层次化电影级字幕:视频级概览加带时间戳的镜头级规划,逐镜头记录构图、动作、灯光、运镜、对白与音效,是反向构造中 SFT 目标 $y$ 的唯一来源。
它是视频字幕分布 $p_{vg}$ 的代理与整个训练管线的起点,其质量直接决定方法上限。
研究动机
早期视频生成器(如 Wan2.2)上下文有限、指令遵循能力弱,提示词增强只承担'装饰性润色'角色,把用户请求扩写成更细致的描述。随着 Wan3.0、Seedance 2.5 等现代生成器把时长推到 30 秒并能忠实遵循复杂指令,文本控制已升级为'电影导演级':需要规划动作、镜头轨迹、灯光、对白与音效在多镜头序列和时间轴上的展开。此时现有前向增强范式暴露两个根本问题:其一,前向扩写的输出服从由重写程序决定的合成重写分布,与视频生成器训练所用的视频级字幕分布 $p_{vg}$ 存在系统性失配,造成下游训练—推理条件错位;其二,语义保持从局部要求升级为跨镜头的全局一致性要求,用户指定的主体、动作、对白与镜头指令可能在长序列中被遗漏、篡改、绑定到错误对象,或在后续镜头中被推翻。
本文的目标是本文的目标是把提示词增强重新设计为'导演级电影规划'架构:给定自然语言用户请求,生成一份层次化的电影级条件文本,包含视频级概览和带时间戳的镜头级规划,逐镜头规定构图、主体、动作、灯光、运镜、转场、对白、音乐与音效,从而在像素渲染前就编排好整部分镜剧本。同时要严格满足双重约束:一方面输出分布须对齐视频生成器的条件分布 $p_{vg}$,另一方面须完整保留用户请求中的所有语义与指令约束 $C(x)$,不遗漏、不篡改、不矛盾。作者还希望建立覆盖 5 到 30 秒、从高层意图到镜头级指令不同粒度的评测基准 WanPEval,并验证该架构在 4B 到 397B 模型规模以及不同下游视频生成器上的一致有效性。
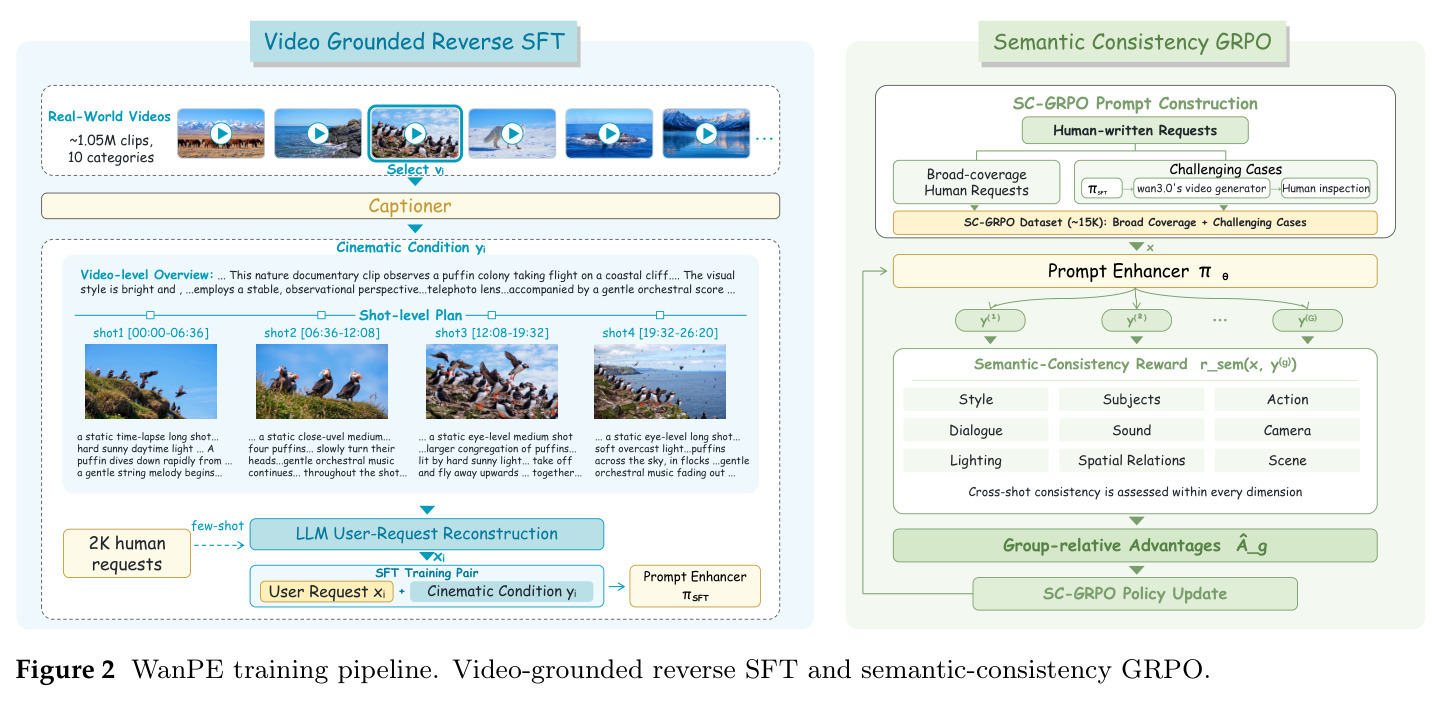
与已有工作不同的是,本文的独特切入点是'反向构造'训练数据:不走'从简短请求前向扩写成丰富描述'的老路,而是先用多模态视频字幕模型为约 105 万条真实视频生成电影级条件 $y$,再用 gpt-5.4 结合 2000 条人工请求示范,从 $y$ 反向重构出自然的用户请求 $x$,构成 $(x,y)$ 监督对。由于 $y$ 来自对真实成片的逆向描述,其组织方式天然匹配视频生成器训练所见的字幕分布 $p_{vg}$,从源头消除了合成重写分布与真实条件分布的错位。针对语义保真,作者提出 SC-GRPO:在组相对策略优化框架下用九维语义一致性奖励(风格、主体、动作、对白、声音、镜头、灯光、空间关系、场景)显式惩罚遗漏、篡改、错误绑定与时间不一致,把跨镜头需求传播变成可优化的全局目标。
核心方法
直觉上,增强器应像导演一样输出分镜剧本,且剧本必须用视频生成器'看得懂'的语言书写——即真实视频字幕的分布。形式化地,系统由增强器 $\pi_\theta$ 与视频生成器 $G_\phi$ 组成:$x\sim p_u$,$y\sim\pi_\theta(\cdot|x)$,$\hat{v}\sim G_\phi(\cdot|y)$。理想目标分布是视频字幕分布在语义有效集 $Y_{sem}(x)$ 上的截断:$p^*(y|x)=p_{vg}(y)\,\mathbb{I}[y\in Y_{sem}(x)]/Z(x)$,训练目标为最小化 $\mathbb{E}_{x\sim p_u}[\mathrm{D}_{KL}(p^*(\cdot|x)\|\pi_\theta(\cdot|x))]$。实现分两阶段:先做视频级反向 SFT 学会连贯电影规划并逼近 $p_{vg}$,再用 SC-GRPO 强化语义保真;最后在 WanPEval(249 条请求)上做文本级评分与 60 位影视专家约 1.1 万次盲评的成对评测(Bradley–Terry 拟合),实验动用 512 张 GPU。
核心创新有二。第一是视频级反向构造:传统增强器从用户请求前向扩写,输出服从合成重写分布;WanPE 反转配对流程——先对真实视频做电影级字幕($y_i=f_{cap}(v_i;s_i)$,按内容类别定制字幕指令 $s_i$),再用 LLM 从 $y$ 重构用户请求 $x_i=f_{LM}(y_i;E_i)$,保证 $y_i\in Y_{sem}(x_i)$。这样 SFT 目标直接来自 $p_{vg}$ 而非人工重写风格,消融显示反向构造比前向重写偏好高 10.37 分、比前向目标 SFT 高 14.69 分。第二是 SC-GRPO:在 GRPO 中引入九维语义一致性奖励 $r_{sem}(x,y)\in[0,100]$,显式惩罚遗漏、弱化、篡改、矛盾、主体—属性与说话人—对白的错误绑定、动作与镜头顺序错误及跨镜头冲突,同时接受语义等价的改写与兼容性补充,把语义保真变成跨镜头的全局可优化目标。
方法步骤详情
流程分六步。(1)数据:约 105 万条真实视频,切分至 ≤30 秒,经技术、视觉、运动质量多级过滤,覆盖十个内容维度。(2)电影级字幕:字幕模型按类别指令生成层次化目标 $y_i$,含视频级概览与带时间戳的镜头级规划(构图、动作、灯光、运镜、对白、音效等随时间演进),仅保留结构完整、时间戳有效且与源一致者。(3)请求重构:gpt-5.4 结合每类 5 条、共 2000 条人工请求示范,从 $y_i$ 反向重构 $x_i$。(4)SFT:从 Qwen3.5-4B/9B/35B-A3B/397B-A17B 初始化,最小化 $\mathcal{L}_{SFT}=-\frac{1}{N}\sum_i\log\pi_\theta(y_i|x_i)$。(5)SC-GRPO:约 1.5 万条提示(多样覆盖+困难案例),Qwen3.7-Max 按九维打分 $r_{sem}$,组内标准化为优势 $\hat{A}_g$,带 clip 与对 $\pi_{SFT}$ 的 KL 惩罚更新策略。(6)评测:WanPEval 249 条请求文本级评分 + 60 位影视专家盲评与 Bradley–Terry 拟合。
技术新颖性
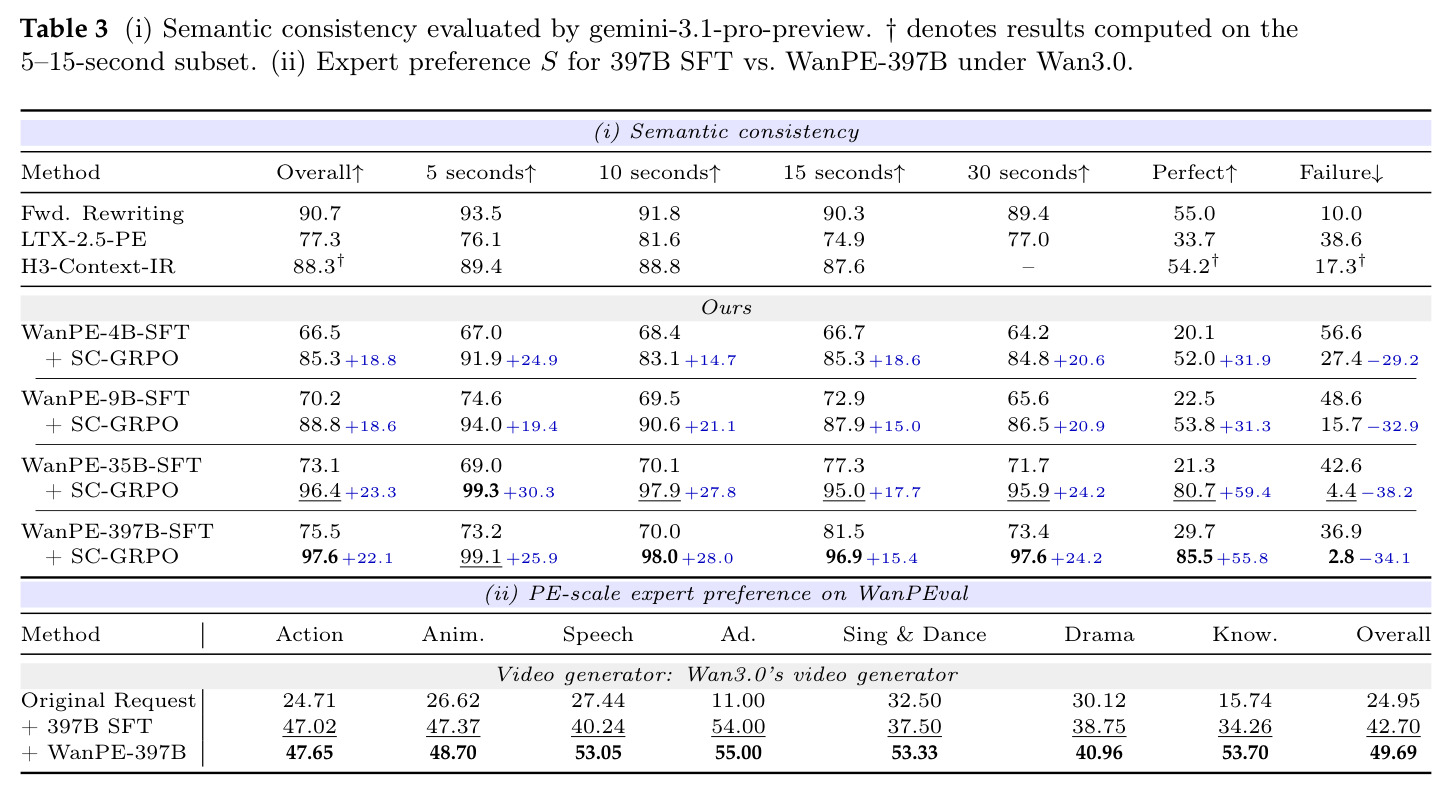
与已有工作的本质区别有三。首先,定位升级:此前 POS、RAPO、VPO、Prompt-A-Video、VidPrompter、CAPE-T2V 等把增强视为描述性润色、检索增强或推理时迭代精修,WanPE 把文本定位为像素渲染前编排动作、运镜、声音与叙事的生产蓝图,输出对象从一段描述变成多镜头分镜规划。其次,监督来源反转:不靠人工设计指令让 LLM 前向扩写,而是从真实成片反向提取电影结构再重构请求,使训练目标分布在源头对齐 $p_{vg}$,这是消融实验中 10.37 分优势的直接来源。第三,优化目标全局化:SC-GRPO 不是逐句流畅性优化,而是把用户约束的跨镜头传播形式化为九维奖励,覆盖主体绑定、说话人—对白对应、镜头顺序与跨镜头一致性;作者进一步证明该文本级代理指标的优化能转化为下游视频偏好的实际提升(42.70 升至 49.69 分)。
实验结果
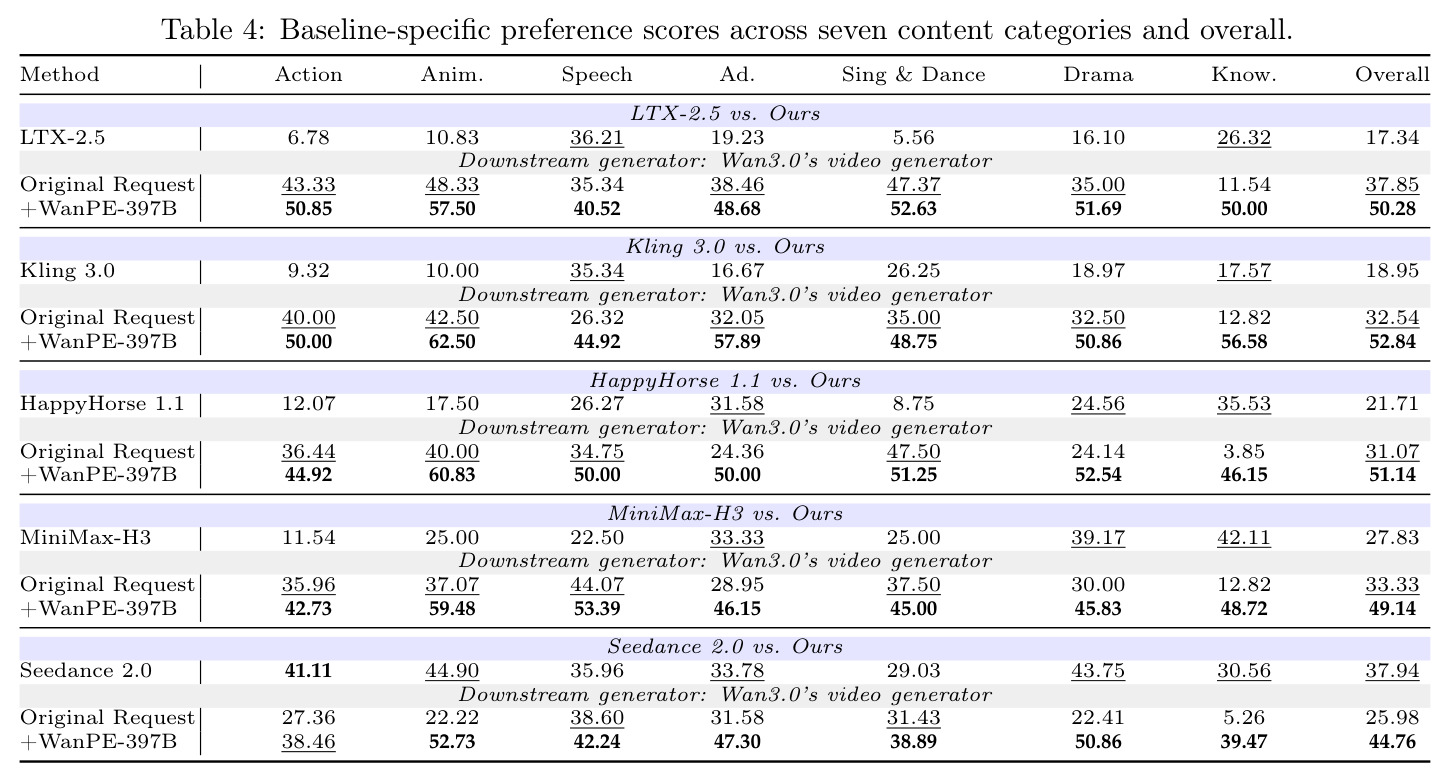
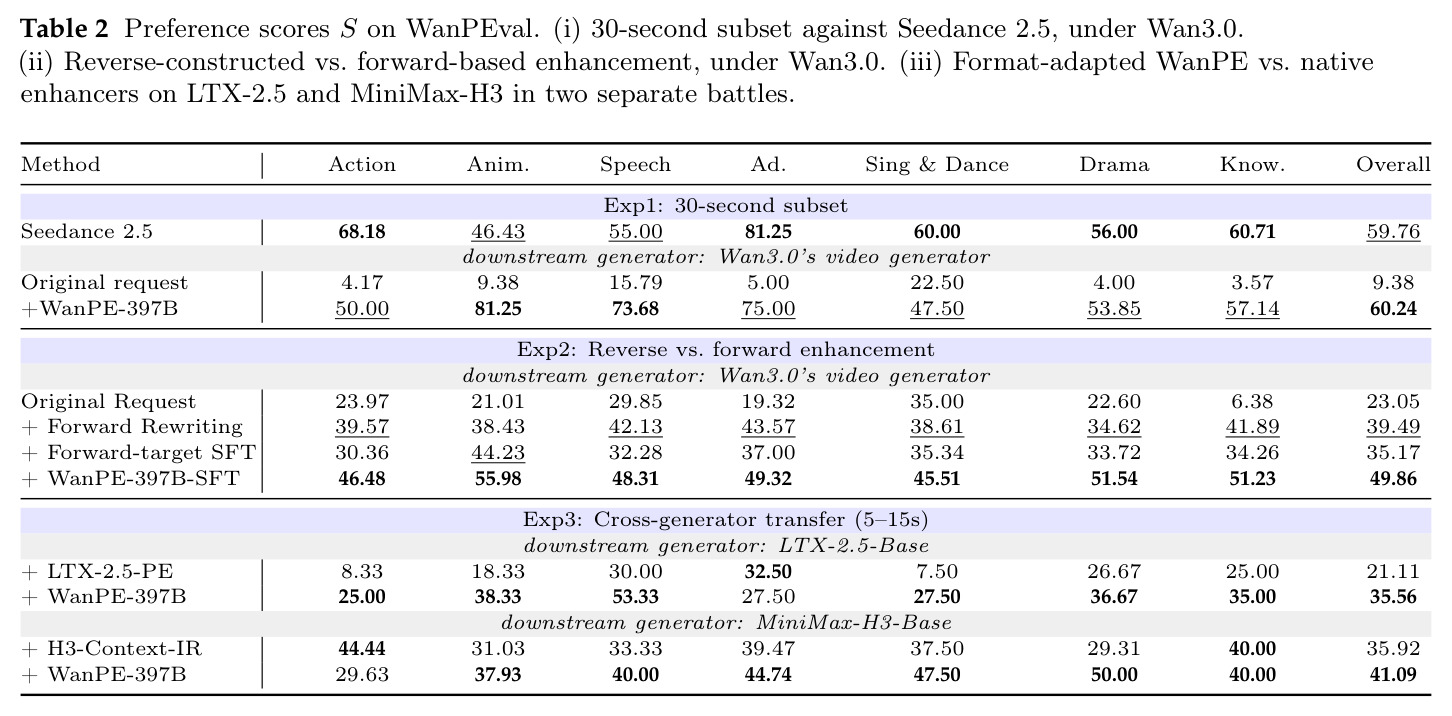
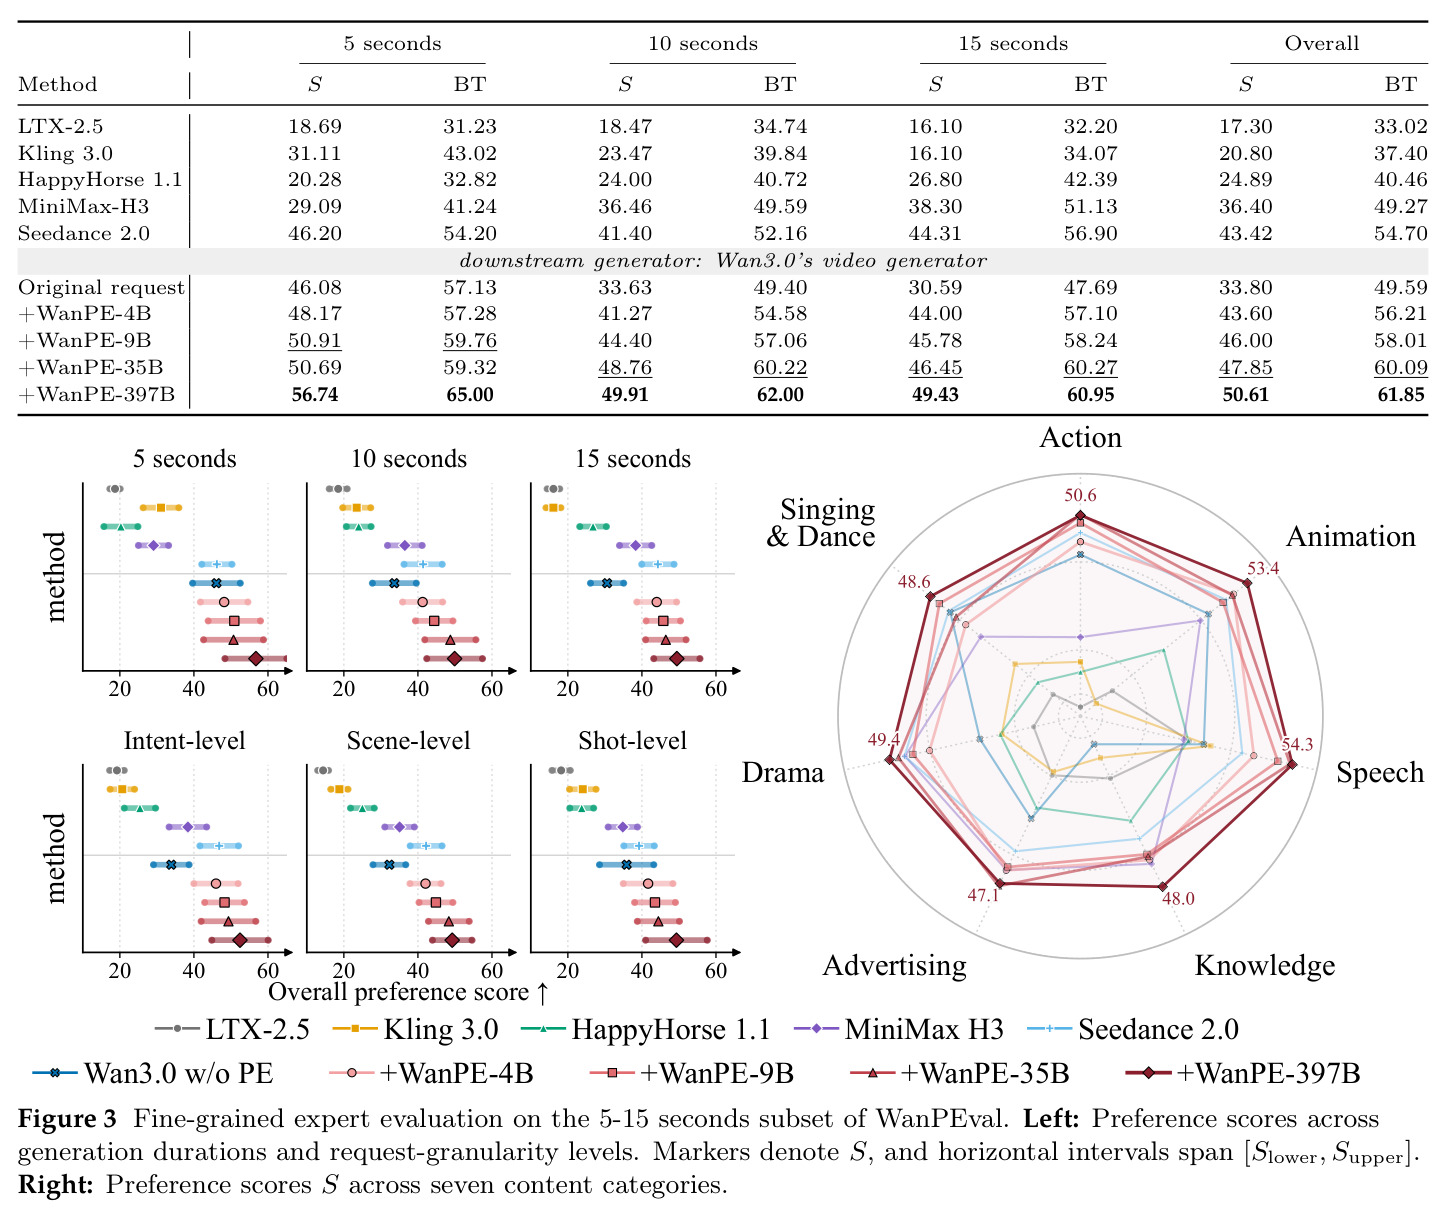
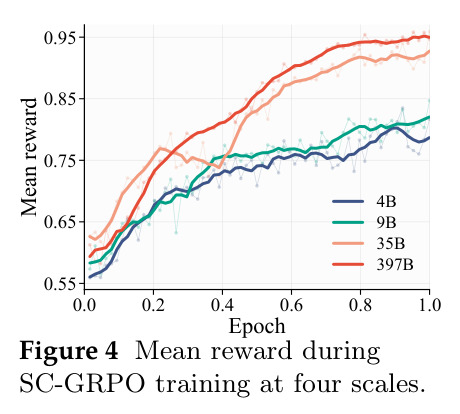
结果五组:(1)5-15秒总榜:WanPE-397B+Wan3.0 各时长均第一,总体 S 50.61/BT 61.85,超 Seedance 2.0(S 43.42)7.19 分;较原始请求 5/10/15 秒分别 +10.66/+16.28/+18.84 分。(2)30秒:S 从原始请求 9.38 跃至 60.24(+50.86),略超 Seedance 2.5(59.76),动画 81.25、演讲 73.68 领先。(3)反向vs前向:WanPE-397B-SFT 49.86 七类全第一,超 Forward Rewriting(39.49)10.37 分、Forward-target SFT(35.17)14.69 分。(4)迁移:LTX-2.5 上 35.56 对 21.11(+14.45),H3 上 41.09 对 35.92(+5.17)。(5)SC-GRPO:语义一致性四档 +18.6-23.3 分,397B 75.5→97.6,完美输出 29.7%→85.5%、失败率→2.8%,偏好 42.70→49.69;三粒度较无增强 +18.55/+16.97/+13.45 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 5-15 秒视频生成(专家盲评偏好) | 偏好分 S / Bradley–Terry 分 | S 50.61 / BT 61.85(WanPE-397B + Wan3.0 生成器) | Seedance 2.0(S 43.42);原始请求不增强(S 33.80) | 较 Seedance 2.0 +7.19 分,较原始请求 +16.81 分,三个时长 S 与 BT 均第一 |
| 30 秒长视频生成 | 偏好分 S | 60.24(WanPE-397B + Wan3.0) | Seedance 2.5(59.76);原始请求(9.38) | 较原始请求 +50.86 分,总体略超 Seedance 2.5 |
| 文本级语义一致性 | 语义一致性分 $r_{sem}$(0-100) | 97.6(WanPE-397B,SC-GRPO 后;完美输出 85.5%,失败率 2.8%) | WanPE-397B-SFT 75.5;Forward Rewriting 90.7 | +22.1 分(四档规模提升 18.6-23.3 分),失败率 36.9%→2.8% |
| 跨生成器迁移(LTX-2.5-Base / MiniMax-H3-Base) | 偏好分 S(5-15 秒) | 35.56(LTX-2.5-Base);41.09(MiniMax-H3-Base),均经格式适配 | LTX-2.5-PE 21.11;H3-Context-IR 35.92 | 分别 +14.45 分与 +5.17 分 |
| 反向构造 vs 前向扩写消融 | 偏好分 S | 49.86(WanPE-397B-SFT,反向构造) | Forward Rewriting 39.49;Forward-target SFT 35.17 | 分别 +10.37 分与 +14.69 分,七类内容全胜 |
局限与改进
作者承认的局限与我的观察如下。作者指出跨生成器迁移需要格式适配——用 GPT-5.4 把 WanPE 输出转换为目标生成器的原生格式(如 H3-Context-IR、LTX-2.5-PE),说明学到的电影规划尚未形成统一条件接口;且在 MiniMax-H3 上优势较小(+5.17),对生成器特性敏感。我观察到的局限包括:语义奖励完全依赖 Qwen3.7-Max 的纯文本评审,存在奖励模型偏见与被策略钻空子的风险,文本级代理指标与视频实际质量之间的因果链条只靠一次 42.70→49.69 的对比验证;评测基于自建 WanPEval(仅 249 条请求)与内部 60 位专家,协议不公开,与商业系统的对比还因时长上限不同被拆成 5-15 秒与 30 秒两个不完全对齐的战场(Seedance 2.5 只比了 30 秒);训练依赖 512 张 GPU、105 万条视频与 gpt-5.4 等闭源模型,门槛极高;字幕模型质量构成 $p_{vg}$ 目标的上限,论文未分析字幕噪声如何传导到最终生成质量。
独立分析的弱点
独立分析四点弱点。其一,奖励可被利用:SC-GRPO 优化的是文本评审分而非视频质量,策略可能学会写评审友好的模板化分镜而非真正利于生成的条件,建议引入视频级回评奖励或对抗性评审校验。其二,评测生态封闭:WanPEval、专家池、评审提示词均未公开,S/BT 分数的可复现性与跨论文可比性受限,建议开源基准并接入 Artificial Analysis Video Arena 等第三方榜单。其三,流水线黑箱堆叠:字幕模型、gpt-5.4 请求重构、Qwen3.7-Max 奖励评审三层闭源模型串联,误差难以归因——例如 35B 语义分(96.4)几乎追平 397B(97.6)而视频偏好差距更大的现象缺乏分析,建议做字幕质量与最终偏好的中介效应研究。其四,迁移需二次格式转换:每接入新视频生成器都要一次 LLM 转换加验证,工程成本高且 MiniMax-H3 上仅 +5.17 分提示适配仍有损耗,可探索统一中间表示或条件格式元学习来降低适配成本。
未来方向
作者提出的方向:论文结尾称这些发现为提示词增强的下一阶段奠定可靠基础,且收益随时长增长(30 秒提升 50.86 分远超 5-15 秒的 10.66-18.84 分),暗示更长时程、多镜头叙事生成的价值。基于成果可延伸的方向:把 SC-GRPO 的文本级奖励扩展为包含生成视频回评的多模态奖励,实现与视频生成器的端到端联合优化;研究提示增强的规模定律——四档模型(4B/9B/35B/397B)显示更大模型奖励收敛更高,可绘制算力—偏好曲线指导部署选型;将电影规划接口标准化为跨生成器通用中间表示,免除格式适配;结合音频与对白的分镜级可控编辑,支持用户局部修改再重生成;探索个性化与风格记忆,让增强器沉淀用户美学偏好;并在 249 条之外构建更大规模、多语言请求集验证泛化与安全边界。
复现评估
复现难度极高。代码、模型权重、105 万条训练视频、WanPEval 基准、约 1.5 万条 SC-GRPO 数据与评审提示词均未开源,仅有项目页 wan-pe.github.io。关键依赖闭源组件:gpt-5.4 做请求重构与格式转换、Qwen3.7-Max 做奖励模型、gemini-3.1-pro-preview 做部分语义评测,基座为 Qwen3.5 系列(4B/9B/35B-A3B/397B-A17B),训练动用 512 张 GPU。若想复现核心思想,可行路径是缩小规模:用开源多模态模型替代闭源字幕器做电影级字幕,反向构造数万级 SFT 对,以 7B 级模型配合 verl/OpenRLHF 类框架跑 GRPO,用开源评审模型实现九维奖励;预期数字会缩水,但足以验证反向构造优于前向扩写这一核心论点。测试集复现相对容易:可仿照其分层流程自建 5-30 秒、多粒度请求集,招募影视背景评审做随机化盲评并拟合 Bradley–Terry 分数。
论文图表
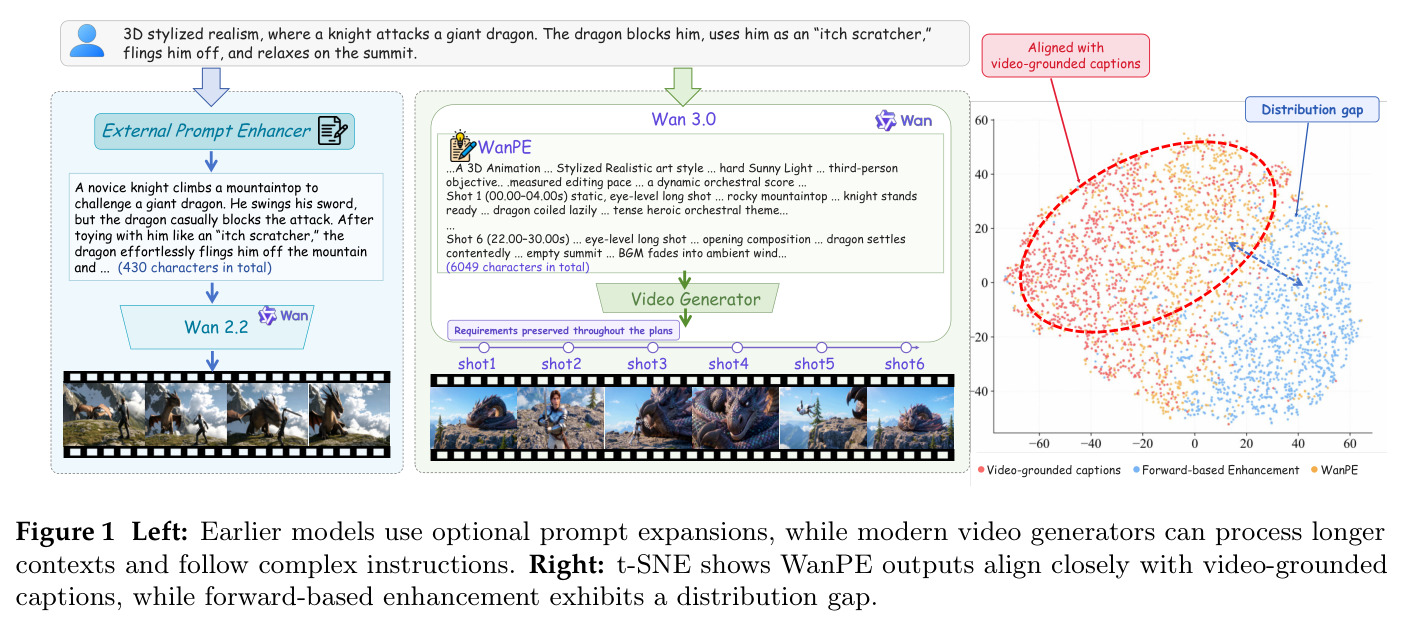
左图对比两代范式:以 Wan2.2 为代表的老一代只需可选的简短提示扩写(约 430 字符),而 Wan3.0 等现代生成器可消费 6000+ 字符的多镜头分镜规划并让用户需求贯穿始终;右图用 t-SNE 可视化显示 WanPE 的输出在嵌入空间中紧贴视频级字幕分布,而前向增强方法的输出与之存在明显分布鸿沟。
一张图讲清论文动机:提示增强的角色已从装饰升级为导演,且反向构造在分布层面确实消除了前向方法的条件失配,是全文立论的直观证据。