CodeGraph:基于 Wikidata 锚定的开放分类法源代码知识图谱 CodeGraph: Open-Taxonomy Knowledge Graph for Source Code with Wikidata Grounding
LLM抽取1.45亿代码文件的语义标签,三阶段锚定Wikidata,构建亿级代码知识图谱
前置知识
类型属性图(Typed Property Graph)
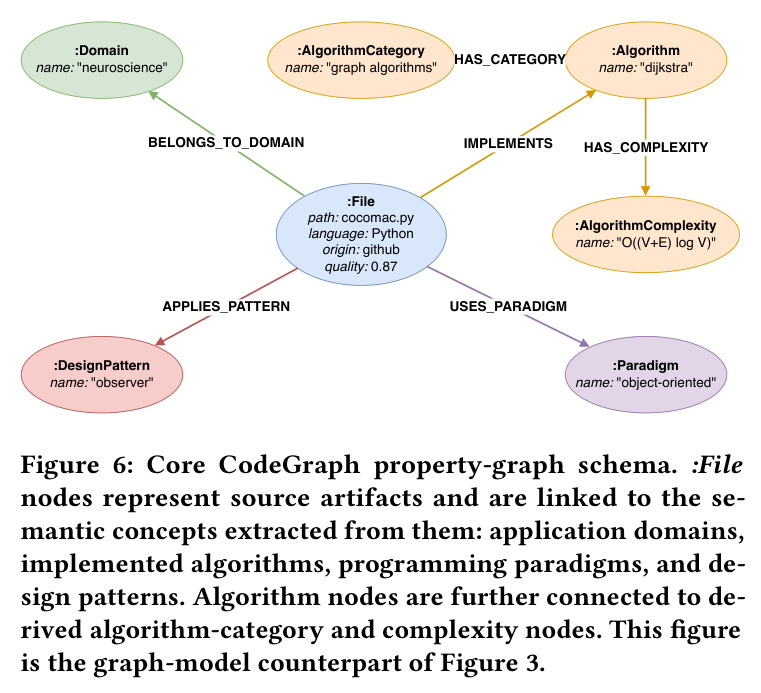
一种图数据模型:节点和边都可以带类型(如 :File 节点、IMPLEMENTS 边),并能附加键值属性(如 language: Python、quality: 0.87)。相比关系表或无标号网络,它能在同一个模型里同时容纳异构工件(源码文件)、概念节点(算法/范式/模式/领域)和带出处的证据边。
CodeGraph 的全部 schema、图示与查询示例都建立在这个模型上(158,202,834 个节点、1,020,887,480 条类型边),不懂它就无法理解图的两层概念结构和语义查询方式。
Wikidata 接地与实体链接(QID、wdt:P31/P279)
Wikidata 是维基媒体旗下的免费结构化知识库,每个实体有全局唯一 QID(如 Q207011=neuroscience),实体经 wdt:P31(instance of)与 wdt:P279(subclass of)性质构成类层次。实体链接就是把自由文本提及映射到正确 QID;SPARQL 是其官方查询语言,可做带类层次过滤的全文候选检索。
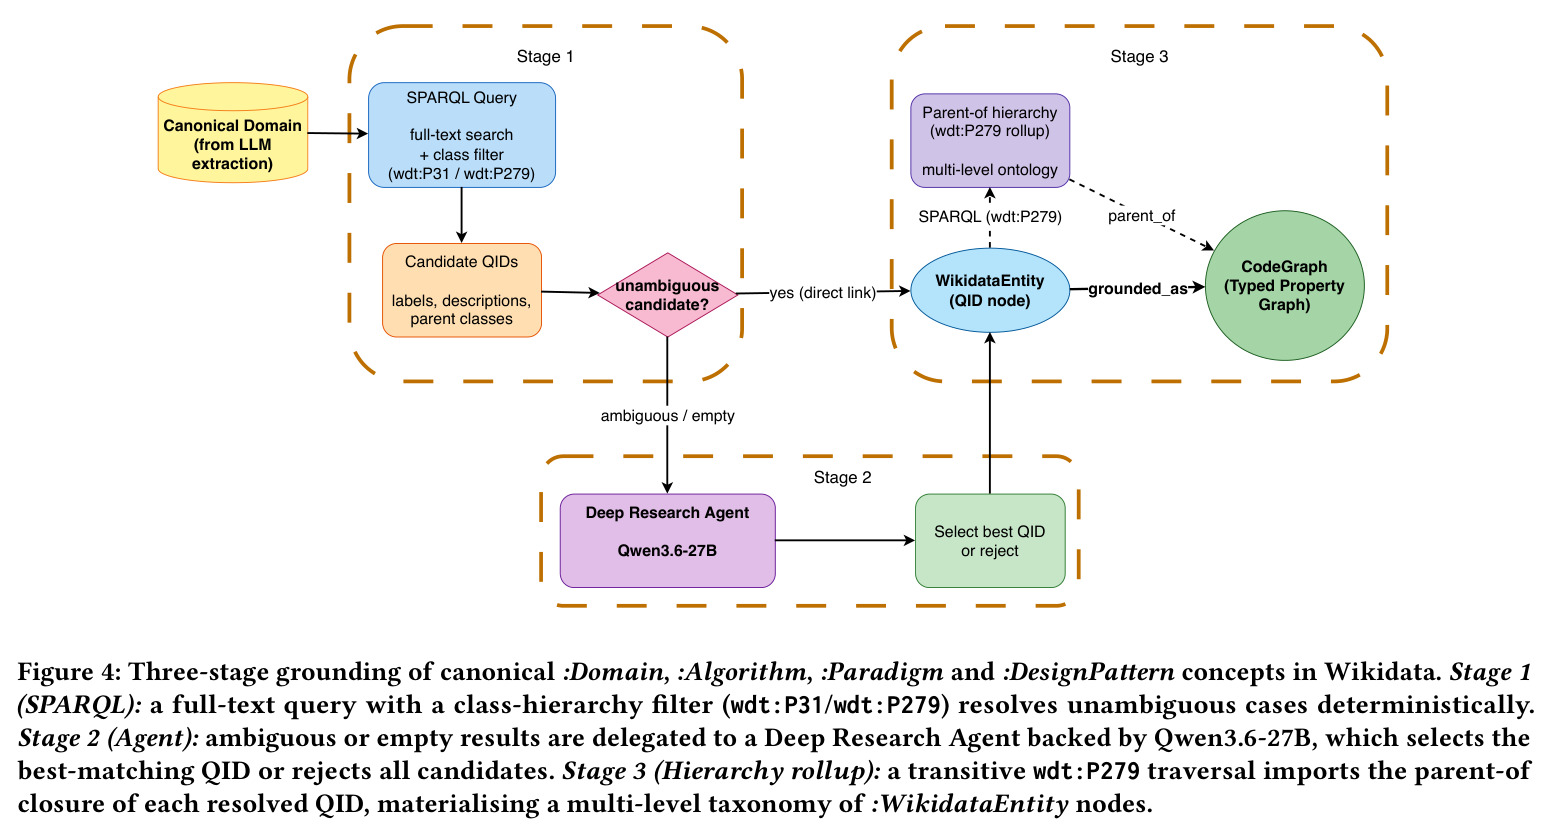
三阶段接地流程(确定性 SPARQL + 类过滤器 + P279 父类上卷)是论文的核心贡献之一,不熟悉这些术语就读不懂方法章节和 Fig. 4/5。
开放分类法(Open Taxonomy)
与封闭词表(预先固定标签集、模型只能从中选择)相对,开放分类法允许模型自由生成概念名,之后再做规范化、去重与外部知识库锚定。好处是词表不被预设锁死、可随时扩展新语义轴;代价是必须额外处理『同一概念多种写法』带来的噪声。
这是本文与已有固定词表零样本标注工作的根本分野,标题中的 open-taxonomy 即指此;理解它才能明白为什么需要后续的规范化与 Wikidata 接地阶段。
混合专家模型(MoE)
混合专家架构在 Transformer 中设置多个『专家』前馈网络和一个路由器,每个 token 只激活少数专家,从而以很小的每步计算量获得大总参数量的表达能力。本文用的 Qwen3-Coder-30B-A3B-Instruct 总参数 30B、每步前向仅激活约 3B,推理成本远低于同规模稠密模型。
理解为什么 1.45 亿文件的全量标注能在约 40 万 A100 GPU 小时内完成,以及作者选择该模型的成本与可复现性考量。
LLM-as-a-judge 与 κ 一致性系数
用 LLM 代替人类做质量判定(本文中是判断〈文件, 标注〉对是否 Okay)。一致性用 κ 系数量化:Fleiss' $\kappa$ 衡量多名标注者超出随机水平的一致程度,Cohen's $\kappa$ 衡量两人(或人机)间一致性,取值 $[-1,1]$,低于 0.2 通常视为很弱。本文人工金标的 Fleiss' $\kappa$ 仅 0.153,说明任务对人类标注者也很难。
第 5 章质量保障协议完全围绕人工金标、六模型裁判海选和 κ 指标展开,是理解论文精度声称(68.4%–88% 精度区间)的关键。
vLLM + Ray 分布式推理
vLLM 是高吞吐 LLM 推理引擎,依靠 PagedAttention 与连续批处理提高 GPU 利用率,支持张量并行;Ray 提供分布式任务调度。两者组合可在多节点 GPU 集群上做数据并行推理,保持单节点语义的同时让吞吐接近线性扩展。
论文的实验设置依赖这套基础设施把抽取扩展到 LEONARDO 超算的 256 块 A100(64 节点 × 4 GPU),是复现工作的工程前提。
研究动机
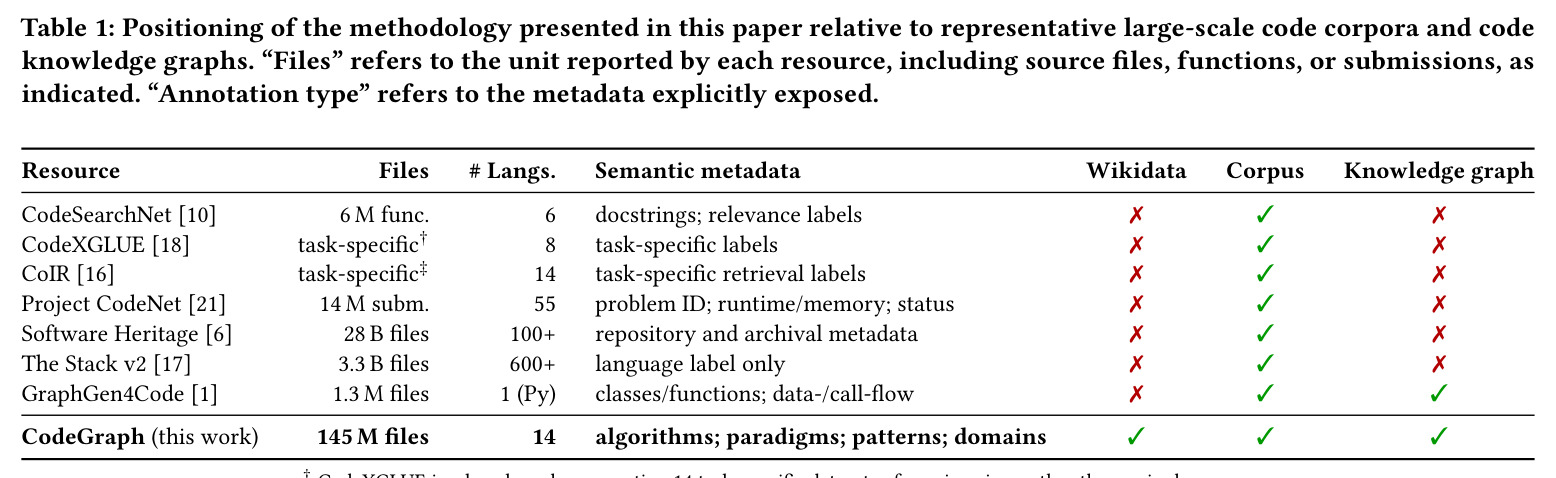
GitHub 与 Software Heritage 等公共仓库保存了数十亿源码文件,可以说是史上最大规模的『人类解题活动记录』,但其中隐含的工程知识——文件实现了什么算法、遵循什么编程范式、实例化了哪些设计模式、服务于什么应用领域——几乎没有结构化索引。现有手段各有硬伤:静态分析工具(编译器、调用图分析)精度高,却止步于句法层面,回答不了『程序在做什么、为什么这样设计』;监督学习更通用,但需要人工标注,对数亿异构文件完全不现实。现有资源呈两极分化:The Stack v2 有 33 亿文件、600+ 语言,却只暴露语言标签;Project CodeNet 的 1400 万道提交只带题目 ID 与运行时/内存元数据;CodeSearchNet 的 600 万函数只有 docstring;最接近的 GraphGen4Code 仅覆盖约 130 万个 Python 文件,建模的还是类、函数、数据流/调用流等句法工件。也就是说,没有任何资源能在亿级规模上同时暴露代码的高层语义承诺。
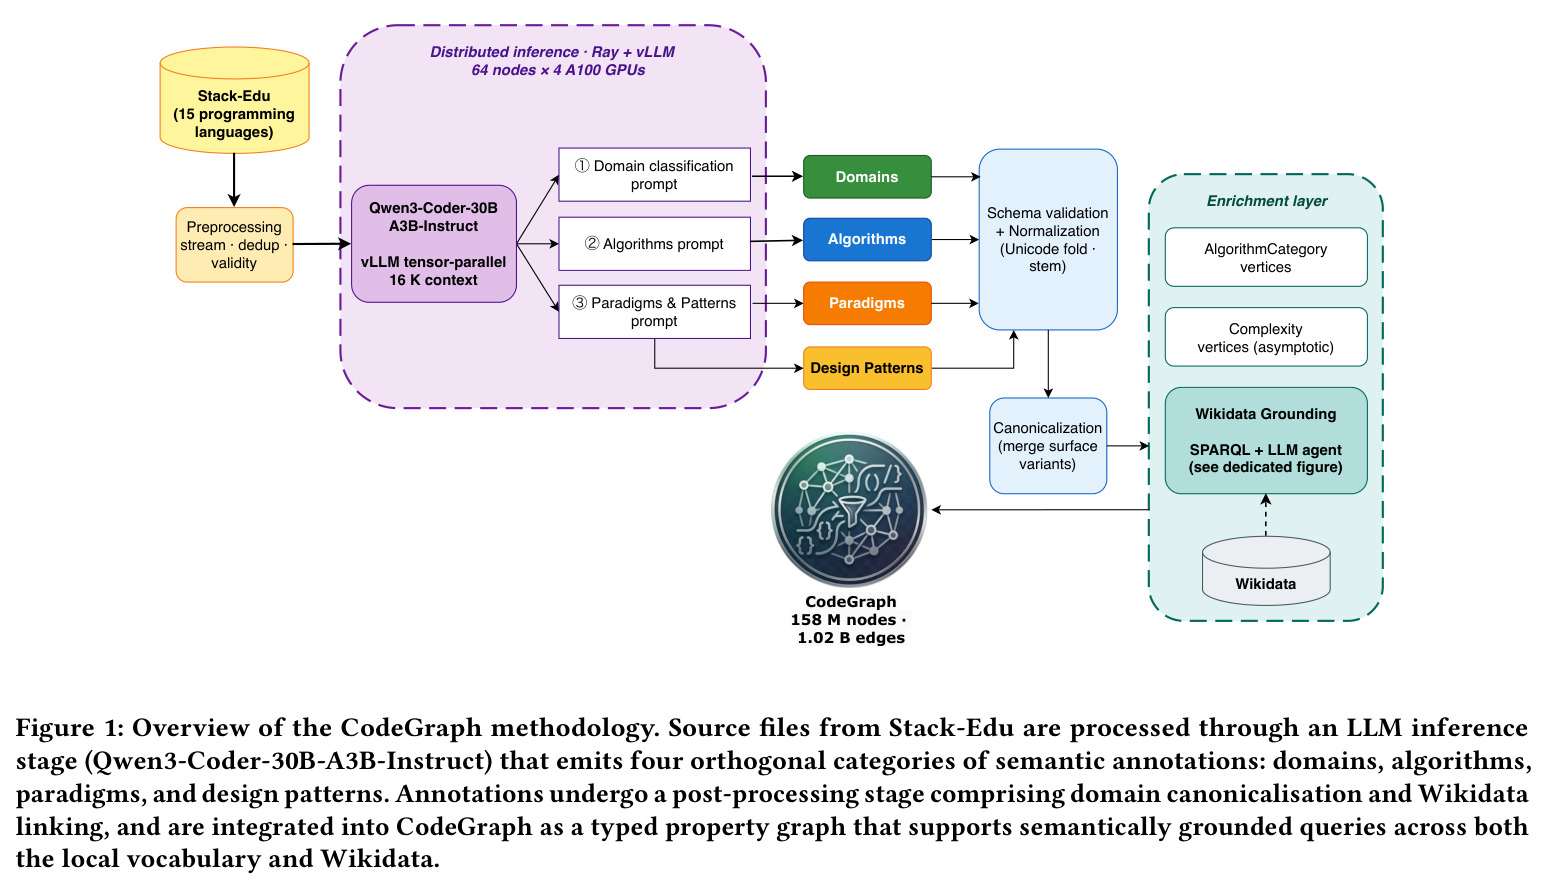
本文的目标是本文的目标是给出一条可复现的方法学流水线:在海量源码语料(数亿文件级)上,用代码专精 LLM 为每个文件抽取四类正交的语义标注——应用领域、算法(附类别与渐近复杂度)、编程范式、设计模式;采用『开放分类法』而非固定词表,让模型自由生成概念名再做事后归一;随后把抽取出的概念词表经三阶段流程锚定到 Wikidata 的全局标识符空间(QID),并导入其类层次形成多层分类;最终把全部标注材料化为带出处信息的类型属性图 CodeGraph。同时配套一套校准过的质量保障协议:用小规模人工金标加 LLM-as-a-judge 量化标注精度,让下游使用者能显式选择精度/召回工作点。作者将该流水线应用于 Stack-Edu 全量 1.67 亿文件(14 种编程语言、1250 亿 token),产出首个开放分类法的源代码知识图谱。
与已有工作不同的是,本文的独特切入有三点。第一,LLM 的角色从『助手』(补全、重构、查 bug)转为『分析器』:此前 CodeLLaMA、StarCoder、Qwen-Coder 等代码 LLM 几乎只被用于辅助性工作负载,本文首次把开放权重代码模型作为零样本标注器在亿级语料上做系统性语义挖掘。第二,开放分类法:不同于在固定词表上做多标签分类(如 GitHub 仓库主题预测),模型自由生成标签、事后经字符串归一与 Wikidata 锚定收敛,词表不被预设锁死,语义轴也可模块化扩展。第三,接地策略的『保守混合』:能用确定性 SPARQL(带 wdt:P31/wdt:P279 类层次过滤器)唯一消解的概念绝不动用 LLM,只有歧义或空结果的残余长尾才交给 Deep Research Agent,兼顾成本、确定性与可审计性;再辅以『人工金标 + 六模型海选』选出的 LLM 裁判做逐标注可靠性过滤——这种『抽取器 + 验证器』双协议虽然曾在远程监督 NLP 中出现,但在亿级代码语义标注上是首次。
核心方法
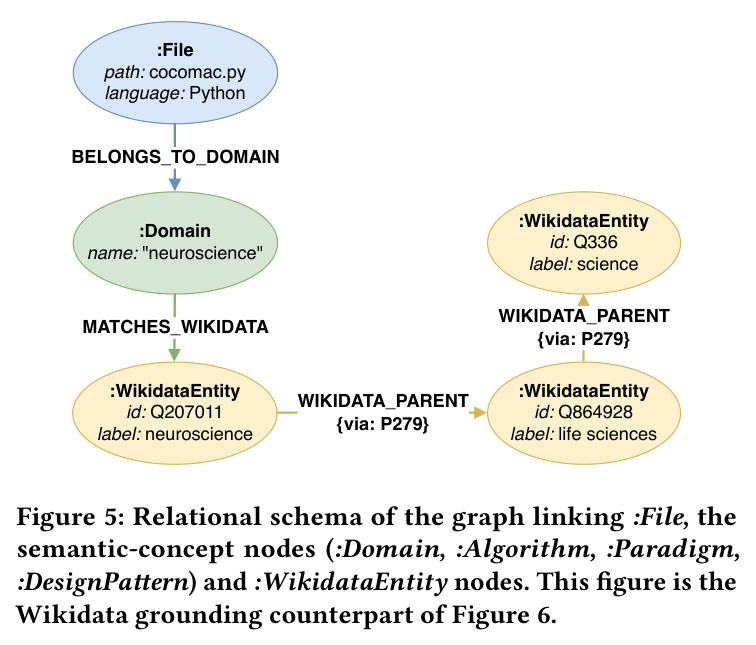
直觉上,这相当于给 1.45 亿个源码文件各配一位『读懂代码的图书馆员』,为每份文件登记四张索引卡:属于什么领域、实现什么算法、用什么范式、套了哪些模式;再把这些卡片汇成一本带国际标准编号(Wikidata QID)的总目录。技术路线分四步。其一,语料选用 Stack-Edu——The Stack v2 经学习型质量分类器筛选出的教学价值子集,含 15 种语言(14 种编程语言 + Markdown)约 1.67 亿文件、1250 亿 token、约 150GB;剔除约 2200 万 Markdown 文件后,约 1.45 亿文件成为图的 :File 节点。其二,抽取使用 Qwen3-Coder-30B-A3B-Instruct(总参 30B、每步激活约 3B 的 MoE 模型),以 vLLM 服务、16384 token 上下文、Ray 数据并行部署在 LEONARDO 超算的 256 块 A100 上,共耗约 40 万 GPU 小时,采样参数为温度 0.7、top-$p$ 0.8。其三,抽取出的标签经规范化合并成规范词表,再通过三阶段流程锚定 Wikidata。其四,全部结果材料化为类型属性图,最终含约 1.58 亿节点、10.2 亿条边。
核心创新是把『大规模语义标注』拆成三个解耦、各司其职的组件。第一,正交提示抽取:对每个文件并行发起四个结构化 prompt,分别针对领域、算法(附类别与复杂度)、范式(附文本证据)、设计模式(附证据);每个 prompt 强制严格 JSON schema,并要求无证据时返回空数组——把『沉默遗漏』变成可度量的显式负例。相比单个多输出大 prompt,短而聚焦的输出经验上显著减少漂移与幻觉,且新增语义轴不会使旧标注失效。第二,三阶段 Wikidata 接地:Stage 1 用 SPARQL 对标签与别名做全文检索,配合 wdt:P31(instance of)/wdt:P279(subclass of)类层次过滤,命中唯一候选即直接建立 MATCHES_WIKIDATA 边;Stage 2 只对歧义或空结果调用基于 Qwen3.6-27B 的 Deep Research Agent,由其查阅候选的 Wikidata 描述后择优选取 QID 或全部拒绝;Stage 3 沿 wdt:P279 链向上遍历两跳,把父类与祖父类导入为 :WikidataEntity 节点并以 WIKIDATA_PARENT 边相连,在图内材料化出多层分类体系。第三,校准 QA 协议:127 个分层抽样文件、292 条人工判断构成金标,据此从六个候选 LLM 中选出 Devstral-2 2512 作为生产验证器,再对全语料逐〈文件, 标注〉对打 Okay/NotOkay 可靠性标签。
方法步骤详情
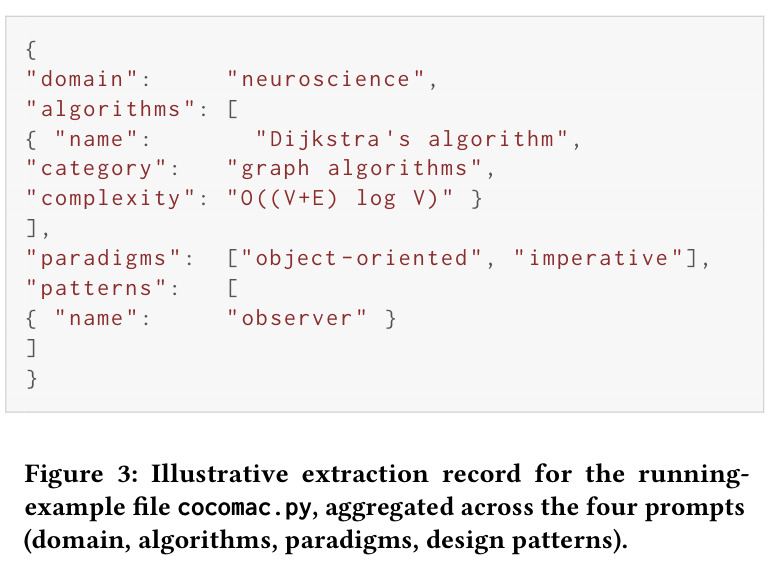
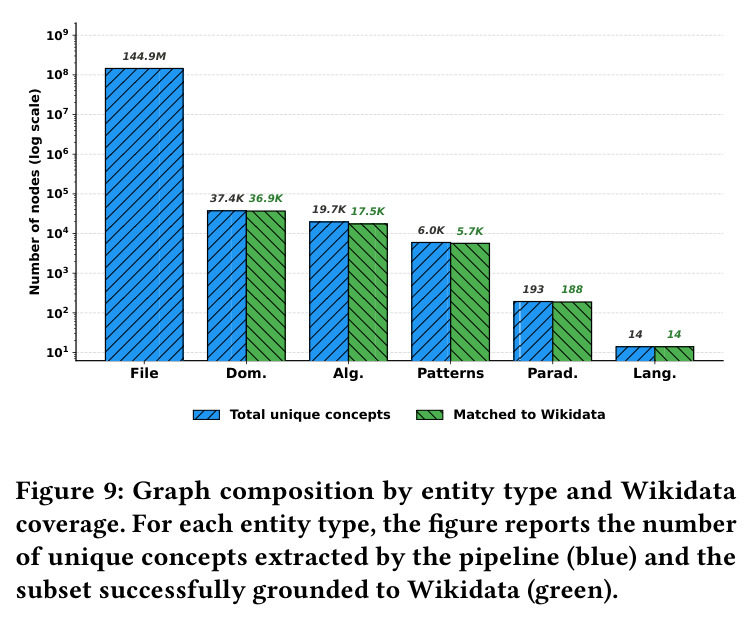
论文用运行示例 cocomac.py(一个加载 CoCoMac 皮层连接数据集、用二叉堆优先队列跑 Dijkstra 最短路径的 Python 模块)串起全流程。步骤 1(数据准备):输入 Stack-Edu 的 1.67 亿文件,剔除约 2200 万 Markdown,输出约 1.45 亿待标注源码文件。步骤 2(LLM 抽取):输入单个源码文件,四个并行 prompt 分别输出 JSON 记录,例如 {"domain":"neuroscience","algorithms":[{"name":"Dijkstra's algorithm","category":"graph algorithms","complexity":"$O((V+E)\\log V)$"}],"paradigms":["object-oriented","imperative"],"patterns":[{"name":"observer"}]}。步骤 3(图构建):先做规范化——小写化、去分隔符与杂散标点、超过复现阈值的高频变体合并——语义词表收敛为约 3.74 万领域、1.97 万算法、约 6000 设计模式、193 个范式;然后建 :File/:Domain/:Algorithm/:Paradigm/:DesignPattern 节点,连上 IMPLEMENTS、BELONGS_TO_DOMAIN、USES_PARADIGM、APPLIES_PATTERN 等带类型、带标注出处的有向边;派生层再挂 268,394 个 :AlgorithmCategory 节点和 12,941,405 个 :AlgorithmComplexity 节点(把 'O(n log n)'、『线性于输入』、『二次时间』等自由文本统一解析为渐近记法词表)。步骤 4(三阶段接地):如 neuroscience(Q207011) 经 WIKIDATA_PARENT 链接到 life sciences(Q864928) 再到 science(Q336),共导入 19,807 个 :WikidataEntity。步骤 5(质量保障):金标评估 → 六模型海选验证器 → 全语料逐标注打可靠性标签,抽取器标注与验证器判定都保留在图中供下游选用。
技术新颖性
与最近邻工作 GraphGen4Code 相比,本质区别在建模对象:后者刻画程序内部句法结构(类、函数、数据流/调用流边),回答『这个项目内部怎么调用』;CodeGraph 刻画文件『关于什么』,回答『哪些文件实现了动态规划』——且规模大两个数量级(1.45 亿 vs 130 万文件),语义元数据从无到有。与固定词表零样本标注(如 GitHub 仓库多标签主题预测)相比,开放分类法加事后归一让词表不被预设锁死,正交 prompt 还保证语义轴可增量扩展。与经典实体链接管线(字符串匹配 → 候选生成 → 嵌入排序)相比,『确定性优先、LLM 只啃长尾』的分配更省算力也更可审计——SPARQL 阶段结果可复现,只有残余歧义标签经过模型判断。此外,把抽取器标注与验证器判定同时保留在图中,让下游可以在 68.4%(人工金标 Okay 率,保守精度下界)与约 88%(银级接受率,宽松上界)之间自选精度/召回工作点,这种『逐标注可靠性元数据』在同类资源中是新的;与远程监督 NLP 中的『抽取器+验证器』协议相比,这里验证器是从六模型海选中按人机一致性选出的,且有分层指标支撑。
实验结果
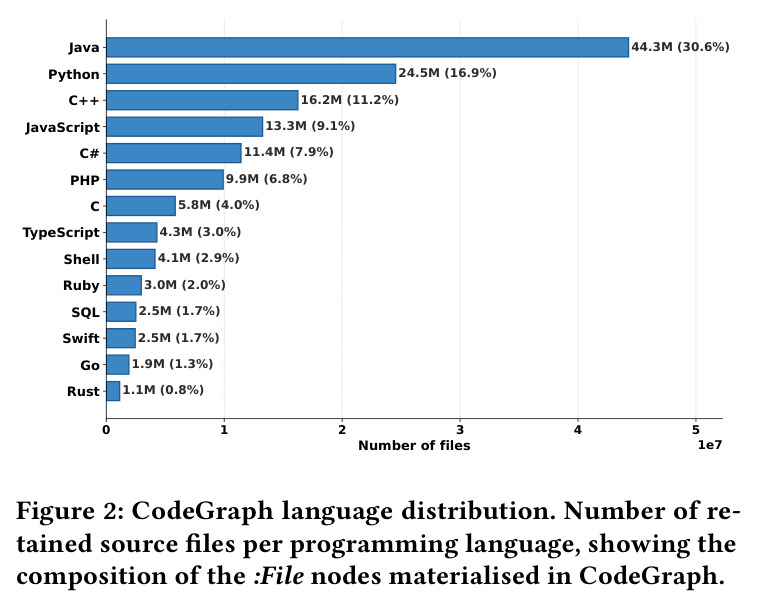
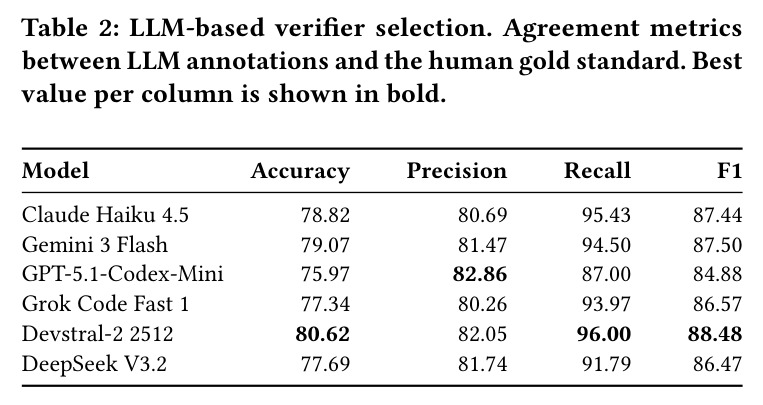
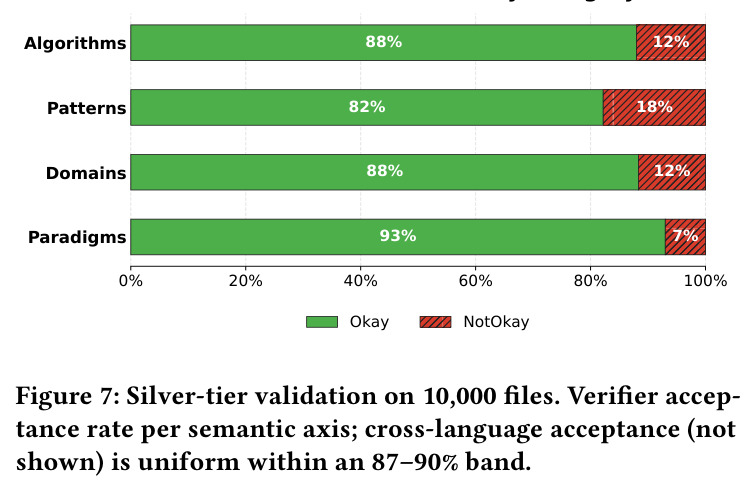
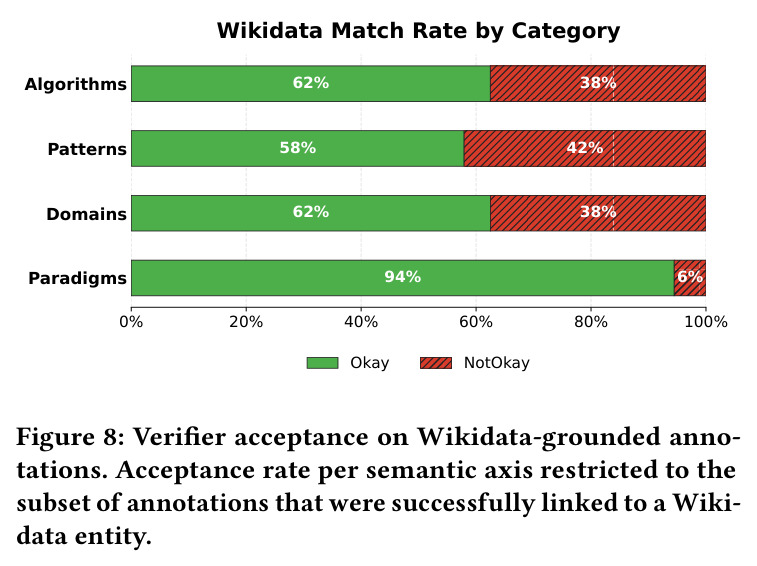
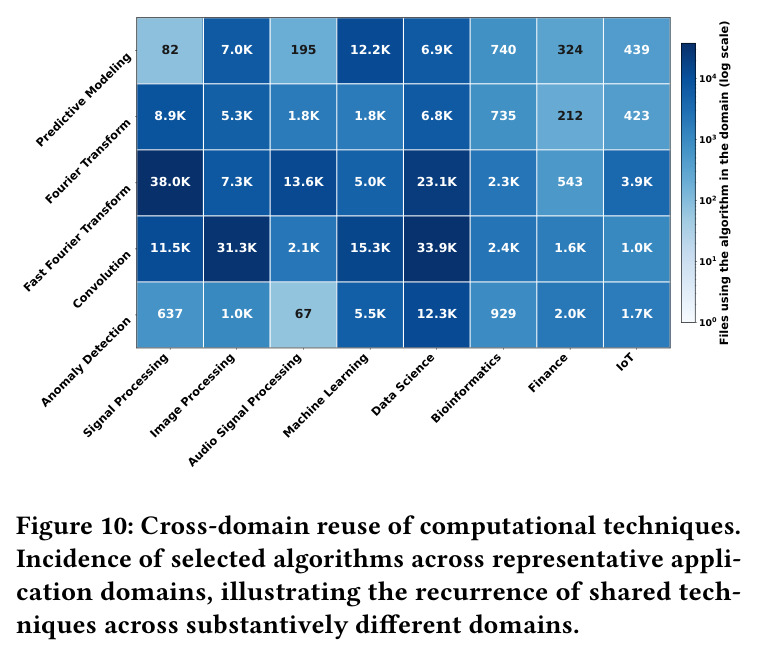
最终图含 158,202,834 个节点、1,020,887,480 条边,其中 144,910,008 个 :File 节点,平均度 12.91,大而稀疏。语义层经规范化后含 37,412 个唯一领域、19,660 个算法、5,955 个设计模式、193 个范式;Wikidata 接地率分别达 98.6%(36,879)、89.0%(17,492)、95.1%(5,666)、97.4%(188),共导入 19,807 个 :WikidataEntity;接地后的领域收敛到 12,144 个唯一 QID、算法收敛到 5,888 个,说明长尾多为同指称的词形变体。语言分布:Java 30.6%、Python 16.9%、C++ 11.2%,前三合计 58.7%。质量评估方面,金标 292 条判断中 68.4% 为 Okay,标注者间 Fleiss' $\kappa=0.153$(domain 0.213、algorithm 0.200、pattern 0.024、paradigm $-0.111$),说明任务对人也很难。验证器海选(1,536 个人机对比对):六个代码 LLM 的 F1 落在 84.9–88.5%,Devstral-2 2512 以准确率 80.62%、精确率 82.05%、召回率 96.00%、F1 88.48% 胜出并成为生产验证器;在 256 个有效人机对比上其原始准确率 77.3%、domain 上 Cohen's $\kappa=0.353$;对 50 例分歧做人工裁决,模型在 33 例(66.0%)中站得住,说明原始 κ 低估了真实可靠性。银级验证(1 万文件):paradigm 93%、algorithm 88%、domain 88%、pattern 82% 接受率,跨语言稳定在 87–90%;仅看 Wikidata 接地子集时 paradigm 94%,但 domain/algorithm 降至 62%、pattern 降至 58%。内容发现:领域头部为 web development(6210 万文件,超第二名 database 的 2710 万两倍多)、data science 2490 万、game 1640 万;算法头部是线性搜索(600 万)、字符串操作(400 万)等日常原语而非教科书算法;约 75.1% 的领域、38.8% 的算法关联文件数少于 1000,呈明显长尾。异常检测等技术横跨机器学习、IoT、金融等域,展示了跨域技术复用分析的可能。
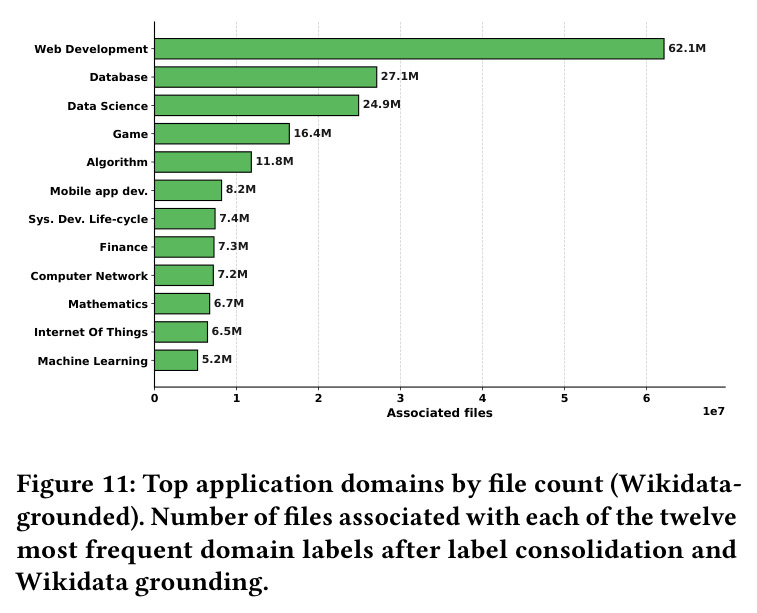
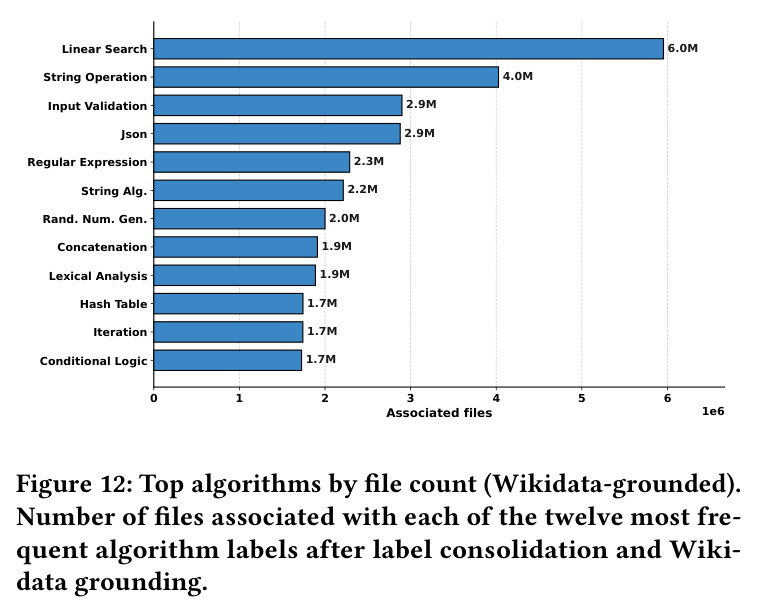
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 验证器海选(人机一致性对比) | F1(1,536 个人机对比对) | Devstral-2 2512:88.48%(准确率 80.62%、精确率 82.05%、召回率 96.00%) | 其余五个候选 LLM:84.88–87.50%(GPT-5.1-Codex-Mini 84.88%、Haiku 4.5 87.44%、Grok Code Fast 1 86.57%、DeepSeek V3.2 86.47%、Gemini 3 Flash 87.50%) | 六模型中最高,领先次优 Gemini 3 Flash 约 1.0 个百分点 |
| 银级全语料验证(10,000 文件) | 验证器接受率 | 约 88%(paradigm 93%、algorithm 88%、domain 88%、pattern 82%;跨语言 87–90%) | 人工金标 Okay 率 68.4% | 两个数值共同框定精度区间:68.4% 为保守下界,88% 为宽松上界 |
| 图规模与语义元数据丰富度 | 文件数 / 语义标注 | 1.45 亿文件、14 语言、4 类语义标注 + Wikidata 接地 | GraphGen4Code:130 万 Python 文件、仅类/函数/数据流等句法工件 | 约 100 倍(两个数量级),且从句法层升级到语义层 |
| Wikidata 接地覆盖率(首个此类资源,无外部基线) | 概念接地率 | 领域 98.6%、算法 89.0%、设计模式 95.1%、范式 97.4%,共 19,807 个 :WikidataEntity | 无(CodeGraph 是首个开放分类法代码知识图谱) | — |
| Wikidata 接地子集上的验证 | 验证器接受率 | paradigm 94%、domain 62%、algorithm 62%、pattern 58% | 银级全量对应值:93% / 88% / 88% / 82% | 除 paradigm 外大幅下降(最多 -30 个百分点),揭示函数/类级概念与文件级验证的粒度错配 |
局限与改进
作者承认的局限:人工金标仅 127 个文件、292 条判断,因为每个标签都要求有领域能力的标注者跨四个分类轴评估并裁决边界情况,扩大规模不现实;标注者间一致性整体偏低(Fleiss' $\kappa=0.153$),范式与设计模式两轴($\kappa$ 分别为 $-0.111$ 与 0.024)不足以支撑定量结论,只能作为探索性信号发布;验证器接受率(约 88%)系统性高于人工 Okay 率(68.4%),部分因为人类 Unsure 被转为 Okay、且验证器存在假阳性;在 Wikidata 接地子集上 domain/algorithm/pattern 的接受率骤降至 58–62%,作者归因于粒度错配——算法与模式常是函数/类级概念,却用整个文件去验证是否『实例化』某 Wikidata 概念;分布严重长尾(75.1% 领域、38.8% 算法关联文件 <1000),稳健统计仅限高频标签。我的补充观察:抽取器(Qwen3-Coder)与验证器(Devstral-2)都是 LLM,可能共享对『什么是好标签』的偏好,银级 88% 或高估真实精度;1294 万个复杂度节点来自自由文本解析,其准确性未单独评估;金标只覆盖 6 种语言;40 万 GPU 小时意味着几乎无第三方能端到端重跑验证其数字。
独立分析的弱点
第一,文件级评估粒度错配:单例模式、Dijkstra 通常活在一个函数或一个类里,用整个文件判定是否『实例化』某 Wikidata 概念必然压低接地子集上的接受率(58–62%),改进方向是把抽取与验证都下沉到函数级 AST 单元,复杂度节点也应挂到函数而非文件。第二,同源偏置:抽取与验证都是 LLM,二者对标签『合理性』的判断相关,可能系统性放过彼此偏爱的标签,可用测试执行、静态分析器或非 LLM 检索启发式做三角验证,或至少报告跨模型一致的子集。第三,金标太小且一致性差($\kappa=0.153$,paradigm 轴为 $-0.111$),作者因此把两轴降级为探索性信号,但这也意味着约 6 万个 pattern/paradigm 概念节点的可用性存疑,改进方向是扩充专家金标、制定标注指南并公开边界案例的仲裁记录。第四,开放分类法的归一只靠字符串规范化与频次阈值,无法区分词形变体与真正的语义近邻(同义不同名),可引入嵌入聚类辅助合并,减少 3.74 万领域中大量同指称变体。第五,成本与碳排放:40 万 A100 GPU 小时只有超算级团队能负担,可用 LoRA 微调小型模型或蒸馏出专用抽取器降低复现门槛。
未来方向
作者明确列出的后续工作:全量语料发布后的扩展跨域分析,以及对 AI 模型训练(数据配比、去重)的影响研究;改进 Stage 1 的 SPARQL 召回与候选生成,让 Deep Research Agent 吸收目前未接地的算法轴长尾(未接地概念集中在定制启发式、库特定例程等算法标签上);以及更精细、可能函数级的评估单元。基于本文成果可自然延伸的方向还包括:把 CodeGraph 用作算法选择器的自动组合素材库——论文已展示异常检测技术横跨机器学习、数据科学、IoT、金融等多个领域,单域人工策展无法凑齐这样的组合;与稠密检索结合做『概念引导』的语义代码搜索,先沿 IMPLEMENTS 边生成候选、再经导航 Wikidata 层次拓宽或收窄、最后用嵌入重排;用图结构指导代码 LLM 预训练数据的领域平衡与去重;借助统一的 QID 空间做跨语言、跨语料的可比软件工程分析;以及设计增量更新流水线,让图随上游仓库演化而滚动维护,支持软件生态的时序演化挖掘。
复现评估
复现支持相当充分:流水线源码连同四个 prompt 模板与 JSON schema 完整开源在 GitHub(github.com/halykoss/CodeGraph),完整 CodeGraph 数据集(约 1.45 亿文件节点、10.2 亿边)发布在 HuggingFace(halykoss/CodeGraph),三个关键模型 Qwen3-Coder-30B-A3B-Instruct、Qwen3.6-27B、Devstral-2 2512 均为开放权重;Stack-Edu 本身公开,但需接受 BigCode 许可条款并完成 opt-out 检查后下载。主要障碍是算力:抽取阶段耗约 40 万 GPU 小时(LEONARDO 超算 64 节点 × 4 A100),一般实验室无法整卷复现,只能信任或抽检其发布数据。不过论文附有小规模复现样本,且接地与 QA 阶段(SPARQL 查询、Deep Research Agent、六模型裁判对比、金标协议)在数千到万级文件上完全可以在单节点多卡环境中重做。综合评价:工件复现(直接下载图并查询)容易,端到端全规模复现基本不可行,中等规模的方法学复现中等偏易,适合作为后续研究的基座而非必须重跑的实验。
论文图表