IterSynth:角色解耦的迭代式综合深度搜索智能体范式 IterSynth: Rethinking Deep Search Agents via Role-Decoupled Iterative Synthesis
用规划器-综合器双角色轮流迭代,让 8B 小模型在深度搜索上超越 30B 智能体。
前置知识
ReAct 范式
ReAct(Reasoning + Acting)是最主流的 LLM 智能体工作流:单个策略在同一个不断增长的上文里交替输出思考(Thought)、工具调用(如搜索)和综合(Synthesis)。它先经 SFT 学习搜索-推理轨迹,再用结果驱动的 RL 或偏好优化训练。绝大多数开源深度搜索智能体(如 Tongyi DeepResearch、MiroThinker 早期版本)都遵循这一配方。
本文的出发点就是 ReAct 的两个结构性缺陷——角色耦合与上下文累积噪声,理解 ReAct 才能明白 IterSynth 在纠正什么。
GRPO(组相对策略优化)
GRPO 是一种免价值网络的策略梯度 RL 算法:对同一查询采样 G 条轨迹,用组内奖励的均值和标准差把每条轨迹的优势归一化,即 $A_i = (r_i - \mu)/\sigma$,再代入标准策略梯度更新。它省去了训练 critic 的开销,是 DeepSeek 系列模型常用的 RL 方法。
RDPO 完全建立在 GRPO 之上,区别仅在于把奖励按角色拆成两个池分别归一化,必须先懂 GRPO 的组归一化机制。
信用分配问题
在长轨迹 RL 中,终端奖励只告诉智能体最终对错,却不指出轨迹中哪一步做对了、哪一步做错了。信用分配就是把最终回报拆解到每个中间动作上的问题。方法包括奖励塑形、turn 级评分等。IterSynth 观察到:把不同角色的 turn 奖励混在一个池里归一化,会让综合器(产生密集奖励)和规划器(产生稀疏奖励)的信号互相污染。
RDPO 的全部动机就是解决多角色长轨迹下的信用分配,这是理解为何'分池归一化'能带来 +1.8 分收益的关键。
上下文累积与压缩
长视距搜索会把检索段落、中间思考、部分结论不断堆进上下文,有用证据被噪声淹没,早期错误还会向后传播。已有对策包括周期性摘要重置(ReSum)、主动上下文折叠(AgentFold)、每步用报告重建工作区(IterResearch)。但它们通常把摘要当成外挂辅助模块,而非策略可学习的一部分。
IterSynth 的核心主张是让摘要更新成为智能体策略中显式可优化的行为,需要对比这些已有压缩方案的差异。
研究动机
现有 ReAct 式深度搜索智能体存在两个结构性缺陷。其一是角色耦合:单一策略必须同时承担规划、查询构造、证据筛选、缺口识别、冲突消解和最终综合等异构能力,导致过早终止、冗余搜索和浅层证据利用。其二是上下文累积:长视距搜索把检索段落、中间想法和部分结论持续堆入同一上下文,有用信息被噪声淹没,早期错误不断向后传播。作者在附录 H 中给出一个触目惊心的量化数据:即使给 64K 上下文,ReAct 轨迹在 BrowseComp 上超过 59% 的案例在上下文耗尽前都无法终止。已有的两类补救各有短板——多智能体方案(如 InfoFlow 的 researcher-refiner 分工)能降低认知负担,但要部署多个模型,推理成本、部署复杂度和协调开销都上升;摘要式方案(ReSum、AgentFold、IterResearch)能缓解上下文膨胀,却把摘要视为外部辅助模块而非策略的可学习部分,规划与证据利用仍然耦合,外部摘要还可能丢弃有用信息或保留误导性噪声。
本文的目标是本文目标是设计一个统一范式,同时做到三件事:把规划与综合这两种异构能力解耦到不同角色;让摘要更新成为智能体自身显式、可优化的行为而非外挂模块;且全程只用一个共享参数的 LLM,不增加参数量,从而同时获得多智能体系统的专业化和有界上下文两项收益。在训练侧,目标是为这种双角色轨迹设计配套的强化学习算法——把终端结果奖励与轮级 rubric 奖励结合,并按角色分池归一化优势,使规划器和综合器各自获得干净的梯度信号,从而在约 8B 参数规模上稳定学会长视距搜索行为,最终在 BrowseComp、BrowseComp-ZH、GAIA、xBench-DS 等五个深度搜索基准上建立小模型智能体的强前沿,并验证该范式对前沿闭源模型同样有效。
与已有工作不同的是,已有工作把'上下文窒息'和'能力纠缠'当作两个独立问题分别处理:IterResearch 用工作区重建解决前者,InfoFlow 用组件分工解决后者,但没有方法在单一共享策略内同时实现角色解耦与工作区重建。IterSynth 的独特切入是把摘要从'被动的压缩产物'重新定义为'搜索的持久状态'——规划器只看紧凑的 $s_t=(q, M_t)$,综合器负责把新证据并入摘要。这一步同时拿到了多智能体的专业化收益(无需额外模型)和摘要式的有界上下文收益(摘要更新本身进入策略学习范围),附录 D 的表 7 从四个架构维度对比说明没有先前的单策略方法能同时做到这两点。
核心方法
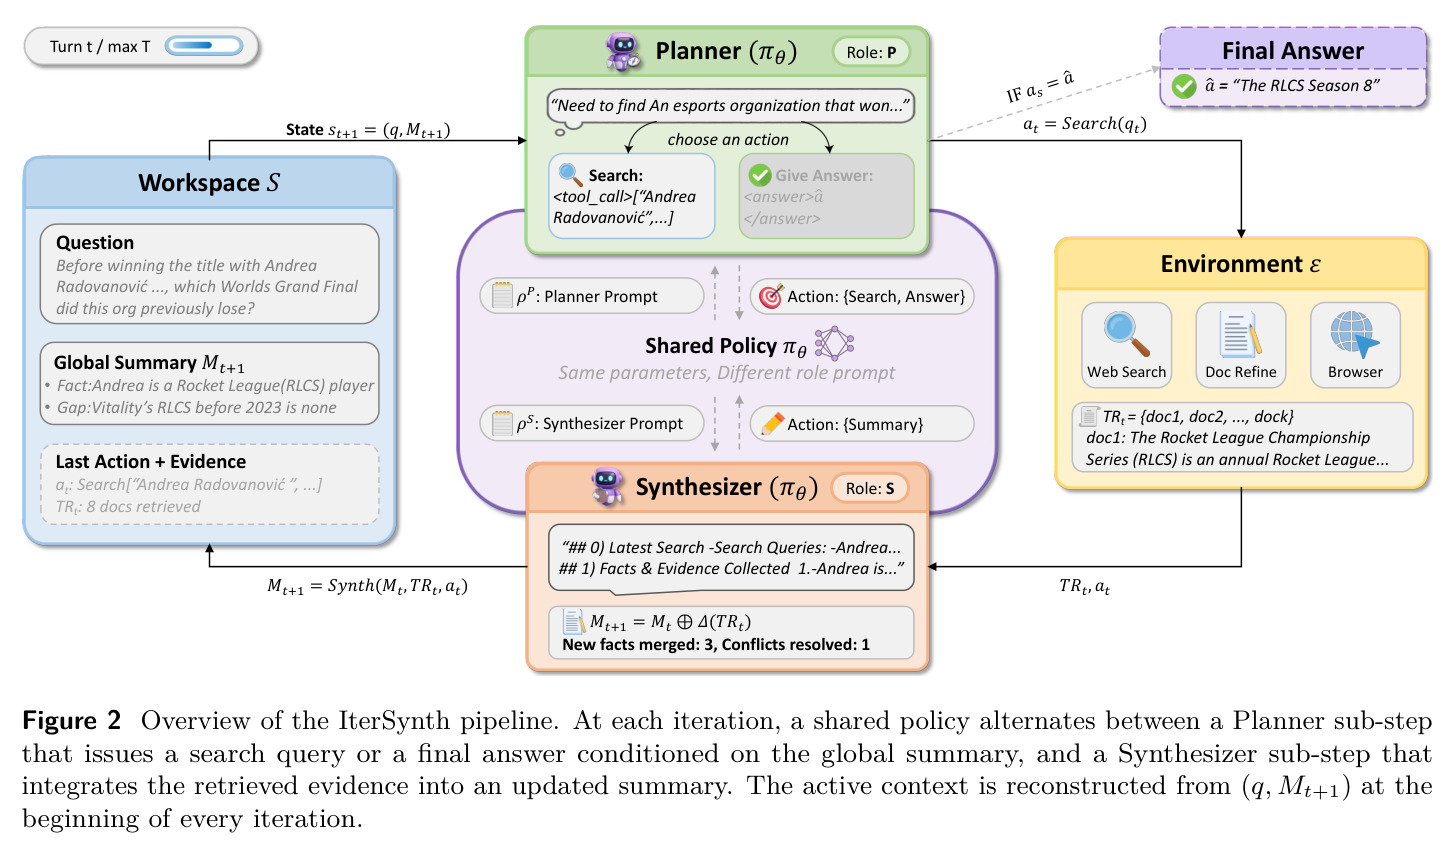
直觉上,深度搜索像一场研究接力:一个角色负责决定'下一步查什么',另一个角色负责'把查到的东西消化进笔记本',两者共用同一本笔记本(全局摘要)交接。技术上,IterSynth 把深度搜索形式化为增强 MDP $\langle S, D, E, T, R\rangle$:状态就是紧凑二元组 $s_t=(q, M_t)$,其中 $q$ 是原始问题、$M_t$ 是全局摘要。每次迭代含两个连续的角色子步,由同一策略 $\pi_\theta$ 在不同角色提示 $\rho_P$、$\rho_S$ 下执行。规划器在状态上加角色提示后输出思考与动作 $d^P_t = [\text{Think}^P_t, a_t] \sim \pi_\theta(\cdot|s_t, \rho_P)$,动作从 $\{\text{search}(q_t), \text{answer}(\hat{a})\}$ 中选择;若选择搜索,环境返回检索结果 $TR_t$,综合器再条件于状态、规划决策和证据生成新的摘要 $d^S_t = [\text{Think}^S_t, M_{t+1}] \sim \pi_\theta(\cdot|s_t, d^P_t, TR_t, \rho_S)$。状态转移将记忆替换为新摘要 $s_{t+1}=(q, M_{t+1})$,直到规划器给出最终答案。训练采用两阶段:先冷启动 SFT 教会双角色协议,再用自研的 RDPO 做强化学习。
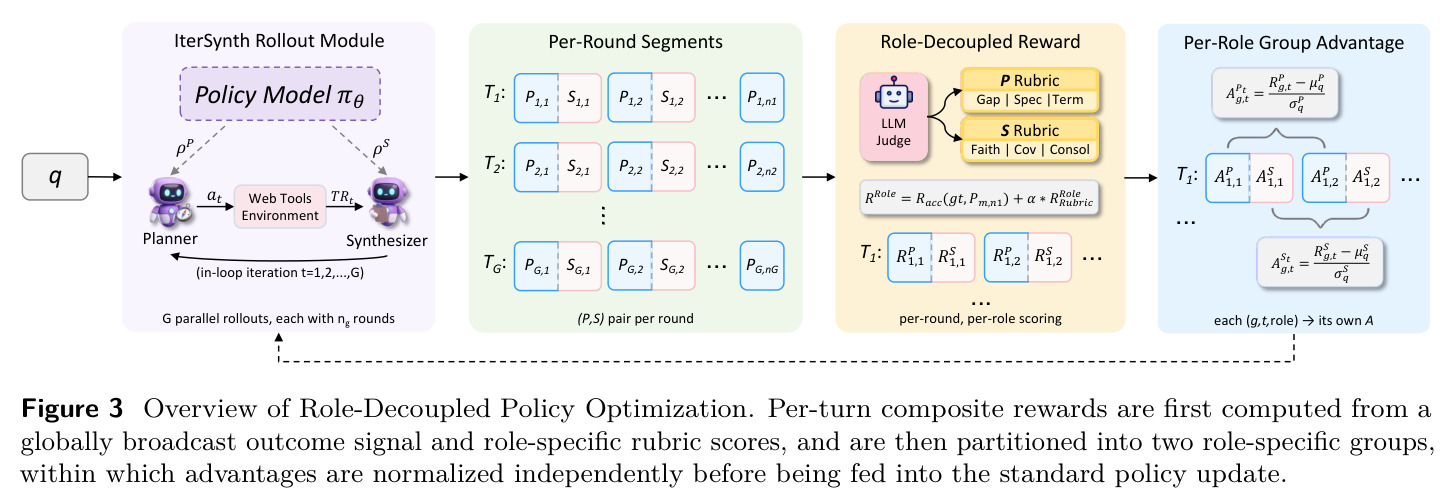
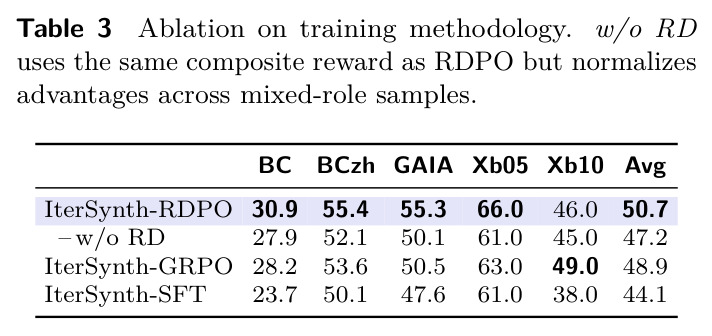
核心创新有两个层面。工作流层面:把摘要从被动压缩产物提升为搜索的持久状态,并且摘要更新由策略自身完成——这和 ReSum 的外部周期压缩、IterResearch 的固定模板重建有本质区别,摘要里保留什么、过滤什么本身成为可被 RL 优化的决策。训练层面:RDPO 发现每条轨迹天然分解为多个独立交互轮次,于是把终端结果奖励 $r_{\text{acc},i}$ 广播到轨迹每一轮,再叠加 LLM judge 沿五个维度打出的轮级 rubric 奖励,组成复合奖励 $r^{\rho}_{i,t} = r_{\text{acc},i} + \alpha \cdot r^{\rho}_{\text{rubric},i,t}$;关键的一步是把奖励按角色拆成两个池 $R^{\rho}_q$,在池内独立做组归一化 $A^{\rho}_{i,t} = (r^{\rho}_{i,t} - \mu^{\rho}_q)/\sigma^{\rho}_q$。消融证明这不是可有可无的细节:同样复合奖励但混合归一化的 w/o RD 版本掉到 47.2,甚至低于纯结果奖励的 GRPO(48.9),说明规划器的稀疏奖励和综合器的密集奖励共享基线会互相污染。
方法步骤详情
第一步,冷启动 SFT:用前沿基础模型 Qwen3.5-397B-A17B 在真实搜索环境中滚动双角色循环,为每个问题合成多轮 Planner-Synthesizer 轨迹;原始轨迹经过过滤流水线——修复非法工具调用、删除幻觉推理、只保留以可验证正确答案结尾的轨迹——得到约 10K 高质量轨迹。每条轨迹展开成逐轮样本,每个规划器/综合器响应都是条件于各自角色提示和重建工作区的独立监督目标,然后在 Qwen3-8B 骨干上全参数 SFT。第二步,RDPO:对查询 $q$ 执行 G 条独立 rollout,每条轨迹 $i$ 展开 $T_i$ 轮,得到轮次集合 $\mathcal{C}_q$;LLM judge 对每个中间行为按五个预定义维度打分得到 $r^{\rho}_{\text{rubric},i,t}$,终端答案对错 $r_{\text{acc},i} \in \{0,1\}$ 广播到全轨迹;复合奖励按角色分池,池内归一化出优势后直接接入标准 GRPO 目标,无需修改算法其余部分。第三步,评估时智能体通过搜索引擎和网页浏览器与环境交互,RL 期间用缓存检索,评测用实时工具。
技术新颖性
与多智能体方法相比,IterSynth 用'同一参数 + 不同角色提示 + 不同动作空间约束'实现了角色专门化,避免多模型部署成本;与摘要式方法相比,摘要不再是用固定提示调用的外挂工具,而是策略在 RL 中被直接优化的输出目标——摘要质量的好坏会通过轮级 rubric 奖励和终端结果奖励反馈回梯度。与训练算法创新相比(OffSeeker 的 DPO、WebExplorer 的 outcome-only RL),本文指出在多角色轨迹上直接套用这些算法会遭遇信用分配纠缠,w/o RD 消融(47.2 分,低于 GRPO 的 48.9)从反面证实了这一点。RDPO 的工程优雅之处在于它不修改 GRPO 本体,只是改变了奖励分池和归一化的统计单位,因此可以无损接入任何现有 GRPO 训练栈。
实验结果
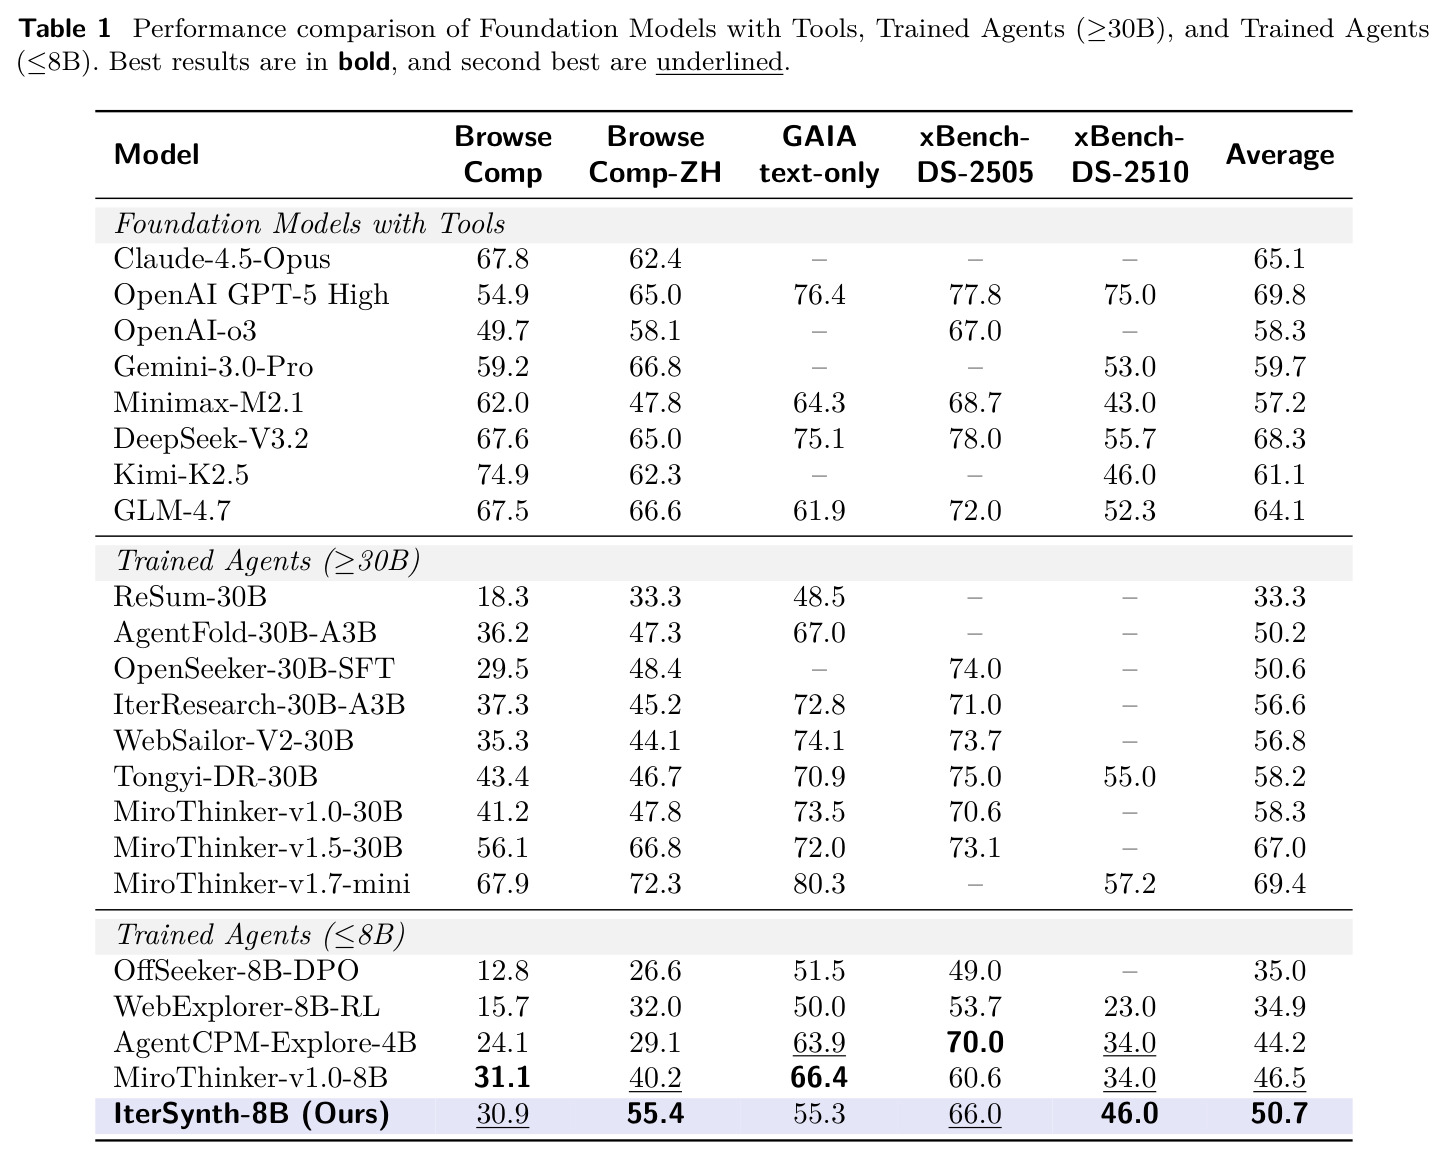
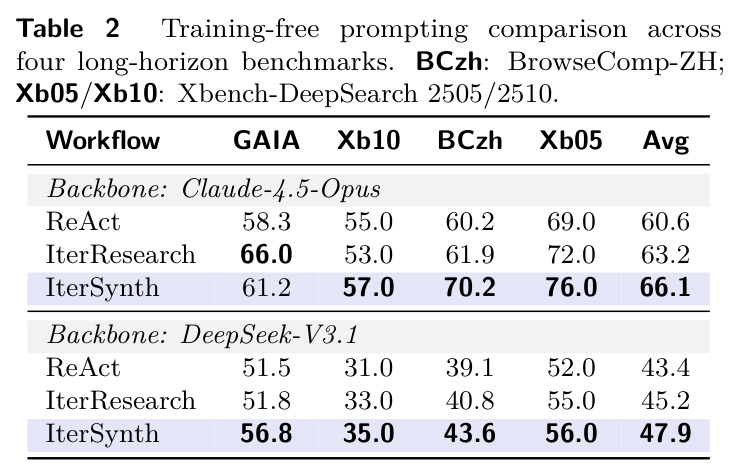
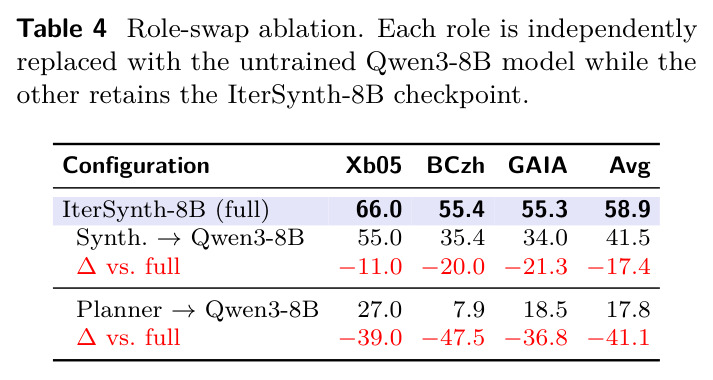
主实验(表 1)在 BrowseComp、BrowseComp-ZH、GAIA-text-only、xBench-DS-2505、xBench-DS-2510 五个基准上,IterSynth-8B 取得 50.7% 的平均分,超过最强此前 ≤8B 智能体 MiroThinker-v1.0-8B(46.5%)达 +4.2%;最大增幅出现在最探索密集的 BrowseComp-ZH 上,达 55.4%,比最强小模型基线高 +15.2%,xBench-DS-2510 也有 +5.4% 的增益。尽管只有 8B 参数(不到 30B 的三分之一),它超过 ReSum-30B(33.3)、AgentFold-30B-A3B(50.2)、OpenSeeker-30B-SFT(50.6),逼近 IterResearch-30B-A3B(56.6)和 WebSailor-V2-30B(56.8)。训练方法消融(表 3):SFT 基线 44.1 → outcome-only GRPO 48.9 → RDPO 50.7;同为复合奖励但混合角色归一化的 w/o RD 只有 47.2,低于 GRPO,证明分池归一化是收益来源而非 rubric 奖励本身。角色替换实验(表 4):把综合器换成未训练的 Qwen3-8B 平均掉 17.4 分,把规划器换掉则暴跌 41.1 分(BrowseComp-ZH 上只剩 7.9),说明 RDPO 端到端优化了两个角色的能力,且规划是更难的角色。免训练提示实验(表 2):作为纯提示范式,IterSynth 在 Claude-4.5-Opus 上平均 66.1(比 ReAct 的 60.6 高 +5.5,比 IterResearch 的 63.2 高),在 DeepSeek-V3.1 上平均 47.9(比 ReAct 高 +4.5),BrowseComp-ZH 上最高领先 ReAct 达 +10.0 个百分点(70.2 对 60.2)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五基准平均(BrowseComp/BC-ZH/GAIA/xBench-2505/xBench-2510) | 平均准确率 % | 50.7 | MiroThinker-v1.0-8B:46.5 | +4.2 |
| BrowseComp-ZH(跨语言长视距搜索) | 准确率 % | 55.4 | 最强 ≤8B 基线(约 40.2) | +15.2 |
| xBench-DS-2510 | 准确率 % | 46.0 | MiroThinker-v1.0-8B:34.0 | +12.0 |
| BrowseComp(训练后,8B 模型) | 准确率 % | 30.9 | MiroThinker-v1.0-8B:31.1 | -0.2(基本持平) |
| 训练消融:RDPO 对 GRPO | 五基准平均 % | 50.7 | outcome-only GRPO:48.9;w/o RD:47.2;SFT:44.1 | +1.8(对 GRPO) |
| 角色替换:Synthesizer→未训练 Qwen3-8B | 三基准平均 % | 41.5(满血 58.9) | IterSynth-8B 完整版:58.9 | -17.4 |
| 角色替换:Planner→未训练 Qwen3-8B | 三基准平均 % | 17.8(满血 58.9) | IterSynth-8B 完整版:58.9 | -41.1 |
| 免训练提示(Claude-4.5-Opus 四基准平均) | 平均准确率 % | 66.1 | ReAct:60.6;IterResearch:63.2 | +5.5(对 ReAct) |
| 免训练提示(DeepSeek-V3.1 四基准平均) | 平均准确率 % | 47.9 | ReAct:43.4;IterResearch:45.2 | +4.5(对 ReAct) |
局限与改进
作者承认或数据中可见的局限:其一,BrowseComp(英文版)上 30.9 分与 MiroThinker-v1.0-8B(31.1)基本持平甚至略低,GAIA-text-only 55.3 也明显低于 AgentCPM-Explore-4B 的 63.9 和 MiroThinker 的 66.4,说明优势集中在中文与探索密集型任务,并非全面领先;其二,与前沿闭源模型差距仍大——GPT-5 High 平均 69.8、Claude-4.5-Opus 65.1,IterSynth-8B 的 50.7 只是在小模型类别内领先;其三,rubric 奖励依赖 LLM judge,附录虽给出构造细节,但 judge 的偏差、成本和可复现性是 RL 训练的隐患,论文未报告 judge 评分与人类判断的一致性;其四,RL 期间使用缓存检索而评测用实时工具,训练与推理环境存在分布差异;其五,剪断式摘要可能系统性丢弃后来才发现有用的信息——这正是作者批评外部摘要的点,但由策略自己学摘要是否真的避免该问题,缺乏直接证据;我自己观察到的额外局限:50.7 对 48.9 的 RDPO 增益只有 1.8 分,且五个基准中 xBench-2510 反而从 GRPO 的 49.0 降到 46.0,边际收益的稳定性存疑;此外双角色机制使每轮交互次数翻倍,推理延迟和 token 开销未见报告。
独立分析的弱点
弱点一:摘要状态的不可逆性。状态转移是替换式 $s_{t+1}=(q, M_{t+1})$,综合器一旦在摘要中误删关键线索,规划器后续再也无法找回,只能靠重新搜索补救。改进方向:引入软删除或版本化摘要,让被剪掉的内容可低成本恢复,或训练一个'回溯'动作。弱点二:角色耦合只是被 prompts 缓解而非根除——两个角色共享全部参数,梯度更新会同时影响双方,可能引发角色间干扰;可以探索 LoRA 分支或角色特定的适配器,在保留单模型部署优势的同时隔离参数。弱点三:rubric 奖励依赖 LLM judge 的五个维度,但论文未公开 judge 模型的校准数据;若 judge 偏好某种摘要风格,策略可能过拟合到'讨好 judge 的摘要'而非真正有用的摘要。改进方向:用人类标注子集验证 judge 一致性,或用可程序化验证的指标(如答案子句覆盖率)替代部分维度。弱点四:英文基准 BrowseComp 和 GAIA 上无优势,暗示中文语料/检索质量可能贡献了部分 BrowseComp-ZH 的 +15.2 增益,需要在受控检索条件下重跑消融以剥离数据因素。弱点五:单条轨迹轮数 $T_i$ 与 G 条 rollout 的采样成本高,RDPO 的轮级信号需要每轮都过 LLM judge,训练开销比 outcome-only GRPO 明显更大,论文未给出训练成本对比。
未来方向
作者方向:附录 J 展示的 not-attempted 重采样策略能把额外推理算力换成稳定的准确率增益,值得扩展为推理时自适应算力分配;附录 K 给出的 BrowseComp 案例分析可发展为对摘要状态演化的系统可解释性研究。基于成果可延伸的方向:其一,把 Planner-Synthesizer 双角色推广到代码智能体、GUI 智能体等长视距工具使用场景——任何'探索-整合'结构的问题都适用该范式;其二,RDPO 的分池归一化思想可推广到任意多角色轨迹(如辩论、写作-审稿循环),甚至按子任务难度动态分组;其三,用综合器输出的结构化摘要(事实/缺口/冲突标记,如图 2 示例中的 Fact/Gap 注记)作为过程奖励模型的监督信号,进一步降低对 LLM judge 的依赖;其四,探索摘要状态的跨任务迁移——同一摘要格式在免训练提示下已展现跨骨干泛化(Claude 和 DeepSeek 双双有效),提示摘要可作为通用中间表示用于模型蒸馏或数据合成。
复现评估
论文给出代码仓库(github.com/Tencent/IterSynth),但截至论文写作时开源完整性未知:RDPO 依赖的 LLM judge 配置、rubric 五维度的具体定义、约 10K SFT 轨迹数据集是否全部释出都需在仓库中核实。算力方面,骨干为 Qwen3-8B 全参数训练,SFT 加上 G 条 rollout 的 RL(每轮还要调用 judge 模型,论文用 Qwen3.5-397B-A17B 级别的模型做教师和 judge),估算需要数十张高端 GPU 的量级,中小团队难以完整复现 RL 阶段。相对容易的复现路径是免训练提示实验(表 2):只需在 Claude-4.5-Opus 或 DeepSeek-V3.1 上按论文描述实现双角色提示循环即可验证 +5.5 的平均增益,这是检验范式有效性的最低成本入口。评测使用五个公开基准(BrowseComp、BrowseComp-ZH、GAIA、xBench-DS 2505/2510),指标清晰。另需注意 RL 阶段用缓存检索、评测用实时工具的环境差异,复现数字时会有一定波动。总体评估:范式部分(双角色提示)复现门槛低,训练部分复现门槛高。
论文图表
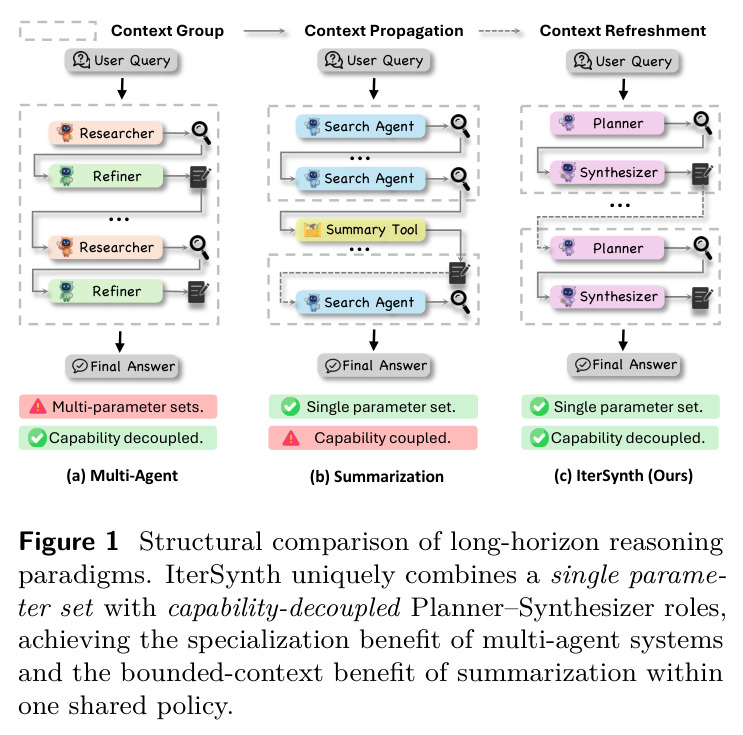
并排对比三种长视距推理范式的结构:(a) 多智能体方案(如 InfoFlow)用 researcher/refiner 等多个模型分工,上下文在组内传播,但需要多套参数;(b) 摘要式方案(如 ReSum/AgentFold)用单参数模型配合外部摘要或工具,能力仍然耦合;(c) IterSynth 用单参数集 + Planner/Synthesizer 双角色提示,唯一同时做到能力解耦与单模型部署,上下文每轮从摘要刷新。
这张图一图道尽论文的定位:通过三个维度的对照(参数集数量、能力是否解耦、上下文如何传播/刷新),读者能立刻看清 IterSynth 相对多智能体与摘要式两条已有路线的差异,是理解动机部分的最佳入口。