Rufus-Air:一套开放的 LLM 后训练完整配方 Rufus-Air: An Open LLM Post-Training Recipe
开源八阶段后训练配方:SFT→可验证RL→Agent RL→RLHF,按奖励可靠性排序。
前置知识
SFT(监督微调)
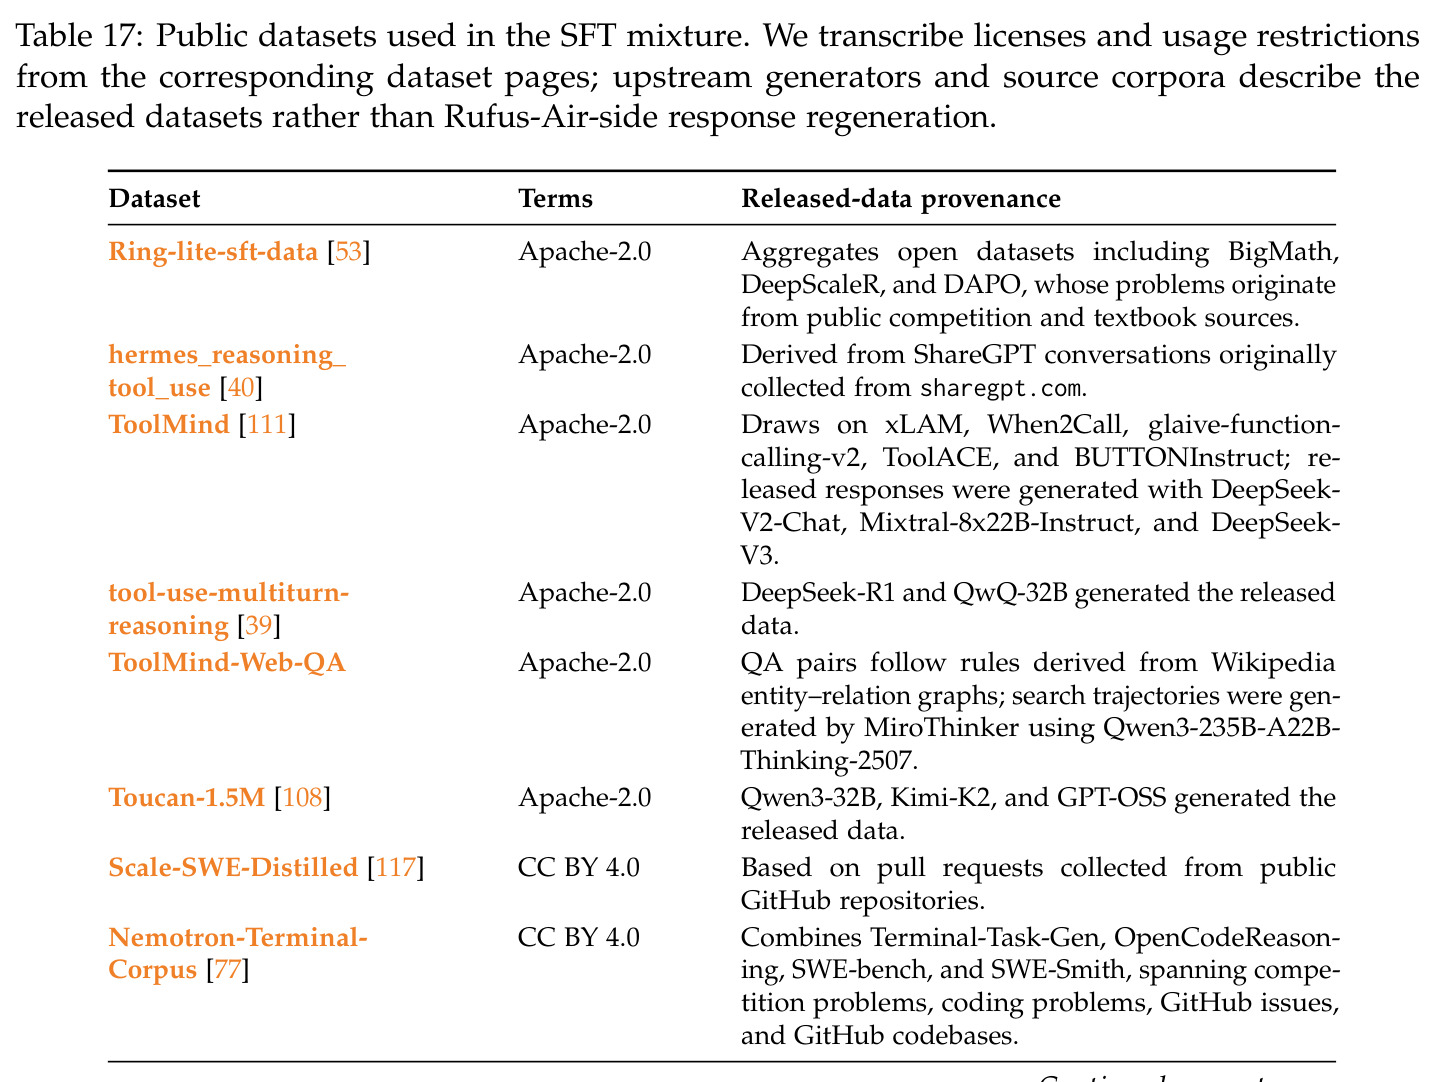
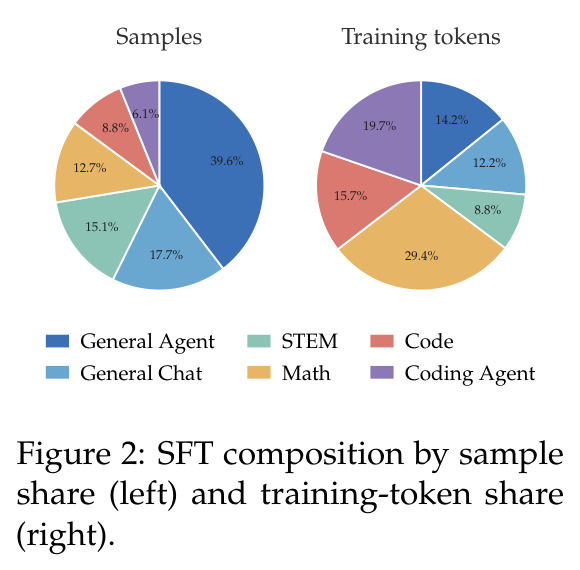
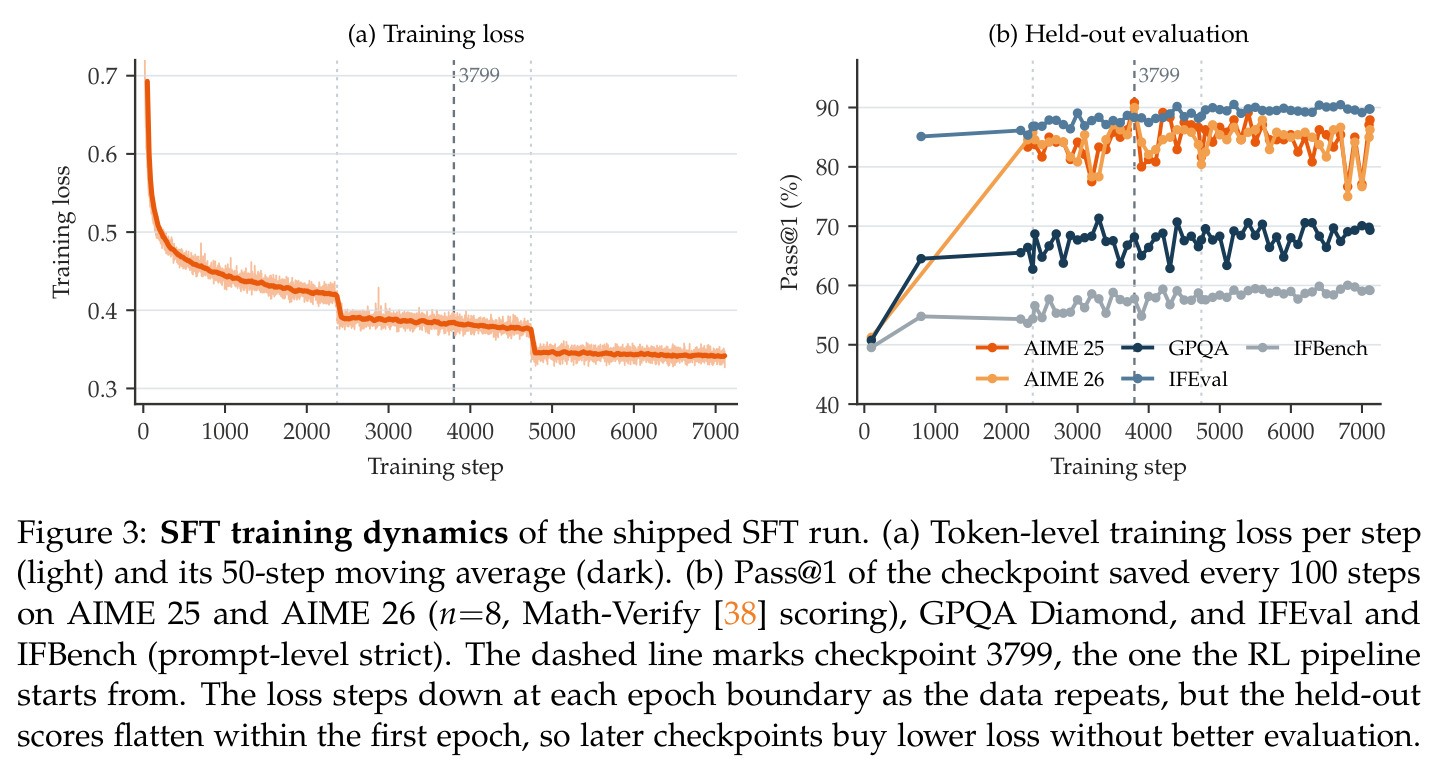
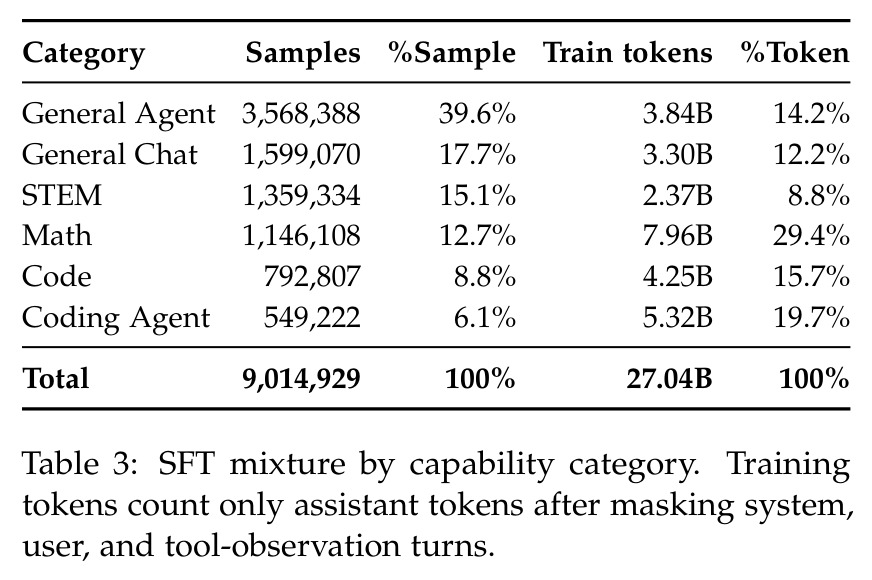
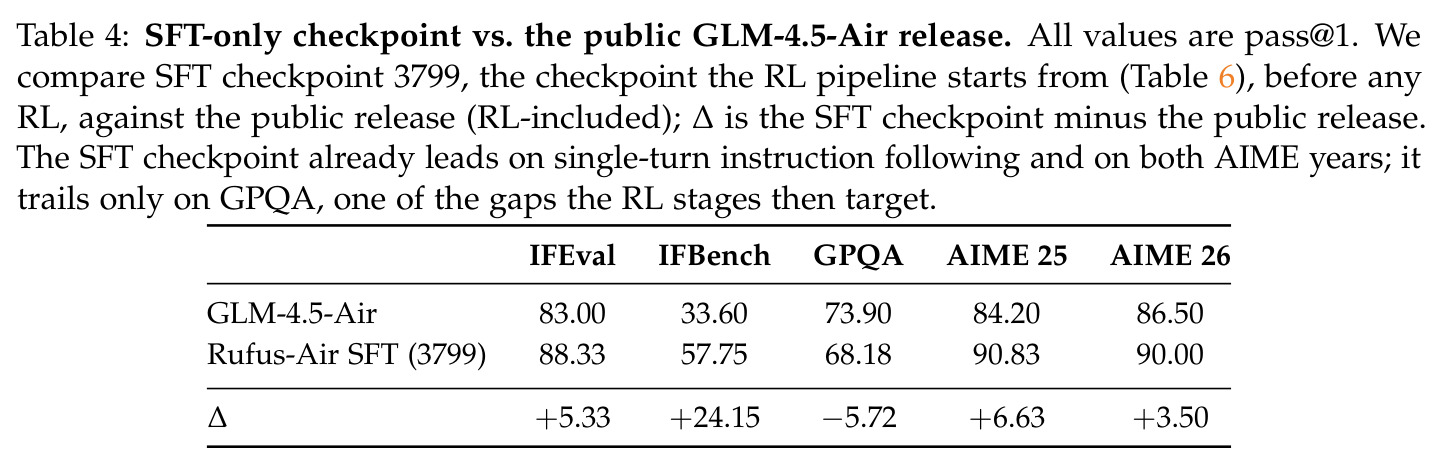
在预训练基座上用「指令-回答」对做监督学习,只对 assistant 回复计算损失,使模型学会对话格式、指令遵循与各领域基础能力。本文把它当作能力奠基阶段而非热身:用 9.01M 样本、27B 计损 token 训了 3 个 epoch,产出的 checkpoint 3799 在未做任何 RL 时就已在 IFEval、IFBench 和两届 AIME 上超过官方 GLM-4.5-Air 发布版。
后续全部八个 RL 阶段都在 SFT 产物上串行迭代,SFT 决定了验证器能解析的输出格式和稀疏奖励的初始成功率,是理解「RL 只精炼而非新建能力」这一核心结论的前提。
RLVR(可验证奖励的强化学习)
用程序化验证器给模型输出打奖励并做策略梯度更新:数学题比对规范化答案、代码题执行单元测试、agent 任务检查环境终态,奖励为二值、低噪、可程序审计,几乎无法被钻空子。本文的 Reasoning RL、Coding RL 与两个 Agent 阶段都属于这一类。
论文的组织逻辑就是按「奖励可被作弊的程度」为八个阶段排序,RLVR 是这条排序原则的可靠端点,理解它才能理解为什么推理和代码 RL 必须先跑。
GRPO / GSPO(组相对策略优化)
对同一 prompt 采样一组 $G$ 条回答,用组内平均奖励当基线估计优势 $\hat{A}_i = r_i - \mathrm{mean}(\{r_j\}_{j=1}^{G})$,省去价值网络;GSPO 进一步把重要性比和裁剪定义在序列级,在长序列 MoE rollout 上更稳定。本文各阶段按需选用:Reasoning/Coding RL 用 GSPO,IF RL 与 agent 阶段用 GRPO,Search Agent 用去掉标准差归一化的 Dr. GRPO 变体。
论文大量训练细节——大批量 rollout、极窄裁剪范围 $\epsilon=10^{-3}$、均值优势消融——都围绕这类组相对方法展开,不懂它就读不懂各阶段训练配置。
Reward Hacking(奖励作弊)
当奖励来自学习到的模型或 LLM 评委而非硬验证器时,策略会钻奖励函数的空子使分数上涨而真实能力不升。本文给出实证:Search Agent 早期给「产出 $\boxed{}$ 答案」无条件格式奖励,策略学会无工具瞎猜白拿分,只能删掉;RLHF 的开放式偏好奖励作弊风险最大。
阶段排序的两大支柱之一就是最小化可作弊奖励被优化压力暴露的时长,理解奖励作弊才能理解这条流水线为什么这样排。
MoE(混合专家模型)
Transformer 每层由多个专家 FFN 组成,router 只激活少数专家,从而以小得多的单 token 计算量支撑大总参数。GLM-4.5-Air 总参 106B、每 token 激活 12B,推理训练便宜,但带来 rollout 引擎与训练器把同一 token 路由给不同专家的不一致问题。
基座是 MoE,论文的 Rollout Routing Replay(R3)、FP8 rollout + BF16 训练等基建选择都是为解决 MoE 特有的 rollout/训练错位,这是「基建是配方一部分」论断的主要证据。
难度过滤与动态采样
训练前丢弃策略通过率 $>0.8$ 的过易题与 0 通过的过难题,只保留「可学习带」;训练中再按 DAPO 式动态采样,仅保留组均奖励 $\bar{r} \in (0, 0.8]$ 的组(4 倍超采样补齐 batch)。由于窗口固定而策略持续变强,原来的死题会自动跨入可学习区间,形成无需人工排课的自动课程。Search Agent 用 8 次内通过次数 $0<c<4$ 实现同一思想。
作者明确说这是各 RL 阶段最重要的选择之一:在足够强的 SFT 基座上,涨点更多取决于数据策展而非新目标函数,这是全文最反直觉也最有迁移价值的结论。
研究动机
开源权重基座模型大幅降低了后训练研究门槛,任何团队都能从公开 checkpoint 起步,但「配方」本身的披露一直非常单薄,除 Tülu 3 等少数例外,后训练章节更像系统卡片(system card)而非可复现的菜谱:数据配比、奖励设计、阶段顺序、基础设施这些真正决定成败的细节恰恰披露最少。结果是团队拿着 GLM-4.5-Air-Base 这样的公开基座,也复现不出厂商后训练版本的水平——官方 GLM-4.5-Air 在 IFBench 上仅 33.6、Tau2-Telecom 32.7、BrowseComp 22.7、SWE-bench Verified 50.6,而这些能力差距是怎么练出来的,几乎找不到公开参考。这种信息不对称把高质量后训练变成了少数前沿实验室的隐性知识。
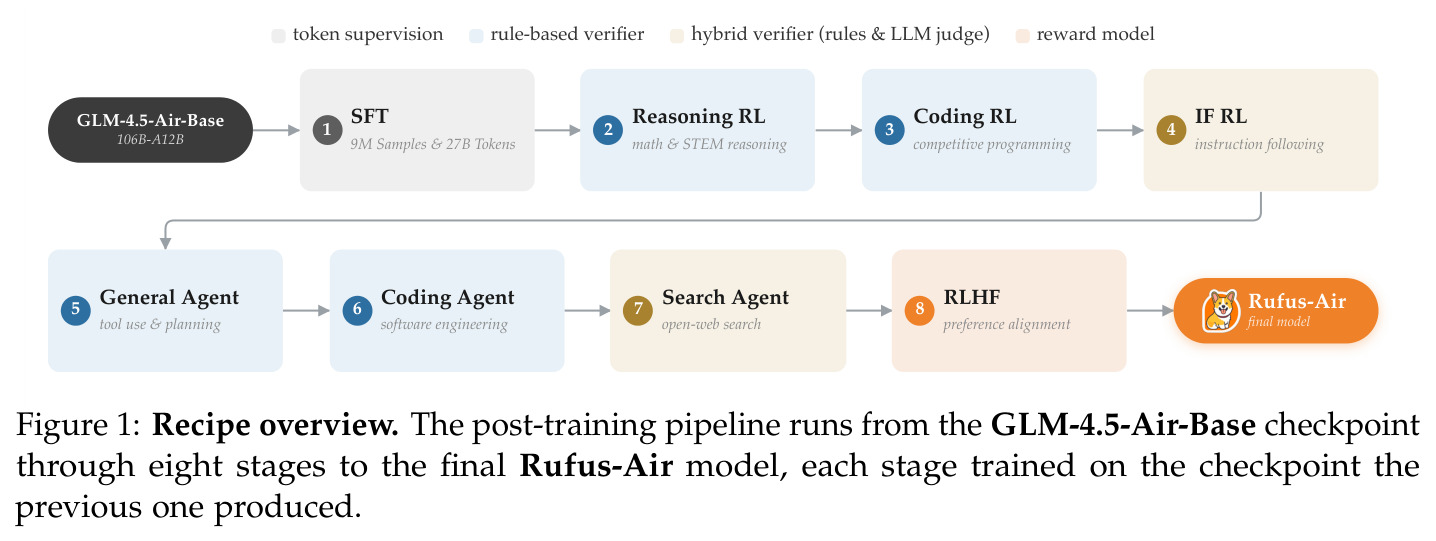
本文的目标是本文的目标是写下一套完整、开放、可复现的后训练配方 Rufus-Air:基于公开的 GLM-4.5-Air-Base(106B 总参/12B 激活的 MoE),用 SFT→Reasoning RL→Coding RL→IF RL→General Agent→Coding Agent→Search Agent→RLHF 八阶段串行流水线,逐阶段记录数据来源与配比、奖励设计、训练超参、基础设施与阶段间量化增益。硬约束有三:全程只用开源组件与公开数据(SFT 的 17 个数据集全部按发布原样使用,Rufus-Air 自己再生成的比例为零)、不新做任何人工标注、不用内部蒸馏教师;同时算力控制在非前沿实验室可负担的范围——RL 阶段 8–32 个 8×H200 节点即可运行,让「有几十个节点的团队」能逐阶段照做或单独取用某一阶段。
与已有工作不同的是,本文的独特切入是把自身定位成「介于研究论文与工程经验报告之间」,并提炼出四条可迁移的组织原则:(1) SFT 是能力奠基阶段而非热身,强 SFT checkpoint 决定了 RL 是精炼而非从零建立能力;(2) 难度过滤把 prompt 维持在可学习区间,并随策略进步自动前移难度前沿;(3) 阶段顺序按「奖励可被作弊的程度」而非奖励格式排定——因此用 rubric LLM 评委的 IF RL 反而排在奖励为规则断言的 General/Coding Agent 之前,因为指令遵循接近策略已有行为、评委几乎没有作弊空间,而最易被作弊的 RLHF 偏好奖励排到最后;(4) token-in/token-out rollout、R3、沙箱等基建是配方本身的一部分。作者还诚实标注了哪些结论来自训练经验而非完整消融。
核心方法
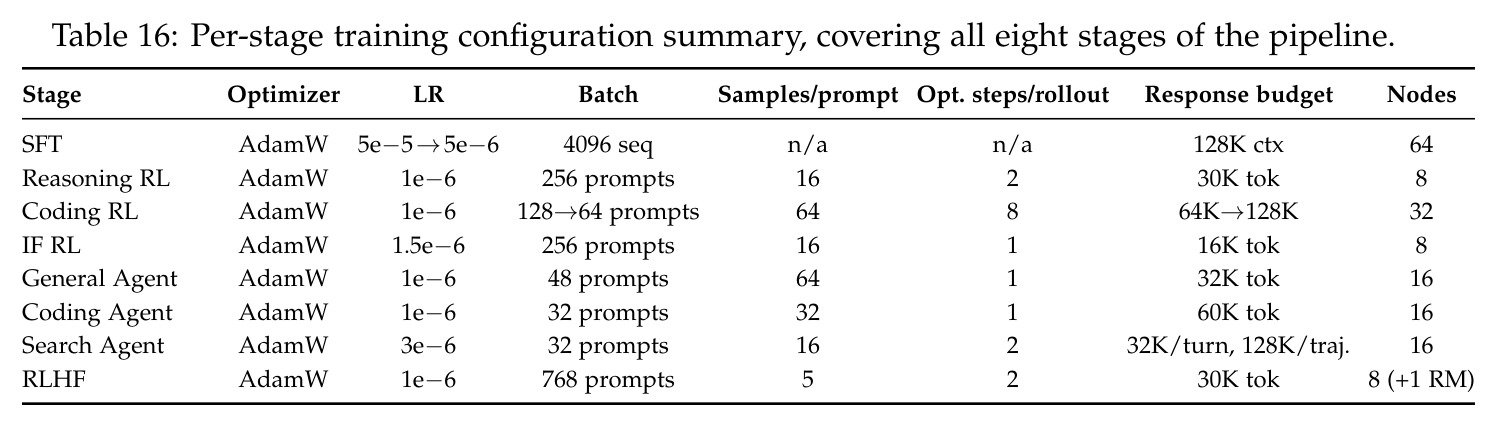
直觉上这套配方是「先教会、再精炼、最后对齐」。先用大规模多样化 SFT 把能力地板抬高到接近甚至局部超过官方发布版(9.01M 样本、27B 计损 token、3 个 epoch、512 张 H200 训约 13 天),使后续 RL 只需精炼而无需从零建立输出格式与能力覆盖。之后按奖励可靠度从硬到软串行推进:Reasoning RL 与 Coding RL 用几乎无法作弊的可验证奖励先涨推理与代码分;IF RL 用 rubric 评委补精确指令遵循;三个 agent 阶段在各自环境中加工具使用,奖励分别为环境终态断言、测试套件执行和 LLM 评委;最后 RLHF 对学习到的奖励模型做在线优化,塑造没有硬验证器的开放式质量。技术上,Reasoning/Coding RL 用 GSPO(序列级裁剪 $\epsilon=10^{-3}$),IF RL 与 agent 阶段用 GRPO 配 DAPO 动态采样与 Rollout Routing Replay,Search Agent 用均值优势的 Dr. GRPO 变体,RLHF 用 GRPO 优化 Skywork RM 原始分加线性长度惩罚。
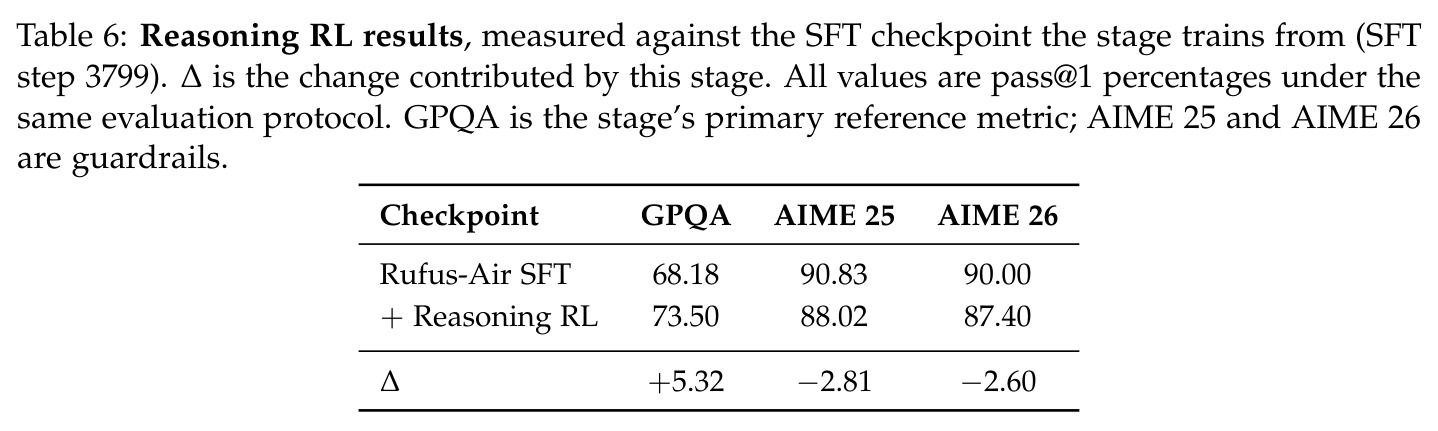
核心创新不在新算法,而在把「阶段顺序」变成一条可操作的原则:按奖励被作弊的暴露程度排序,硬可验证奖励先跑、软评判或学习到的奖励后跑,以缩短可作弊奖励处于优化压力下的时间。唯一例外恰恰证明了原则的本质:IF RL 虽用 rubric 评委却前置,因为指令遵循贴近策略已有行为、评委没有作弊空间(实验中也未见严重作弊),而 RLHF 的开放式偏好奖励作弊风险真实,所以最后。配套的第二原则是难度过滤:所有 RL 阶段都丢弃策略已稳定解决(通过率 $>0.8$ 或 4 次 warm-up 全对)与从不解决的 prompt,Reasoning RL 还在线按 $\bar{r} \in (0, 0.8]$ 过滤,死题随策略变强自动进入可学习带,形成自动课程。第三原则是 SFT 定地板:SFT-only checkpoint 3799 已在 IFEval(88.33 vs 83.00)、IFBench(57.75 vs 33.60)、AIME25(90.83 vs 84.20)上超过含 RL 的官方 GLM-4.5-Air 发布版,仅 GPQA 落后 5.7 分,而这一缺口正是 RL 阶段的目标。
方法步骤详情
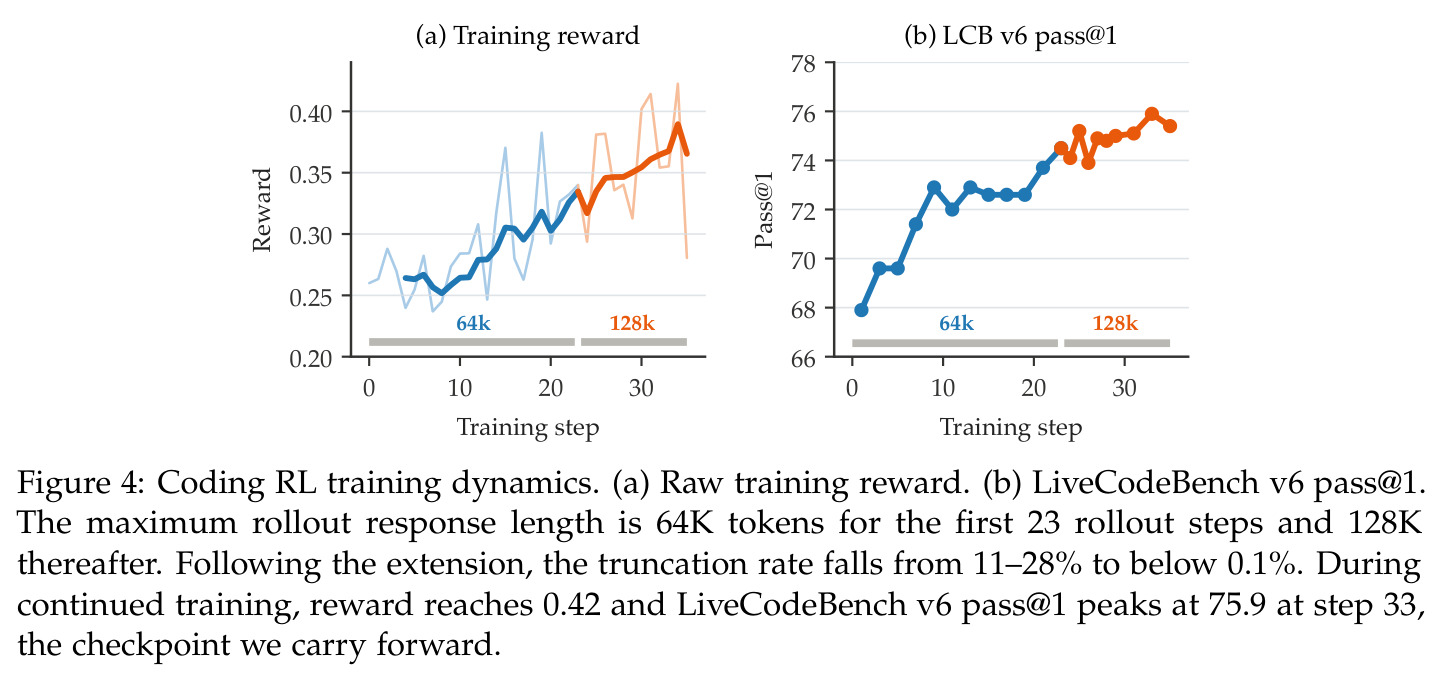
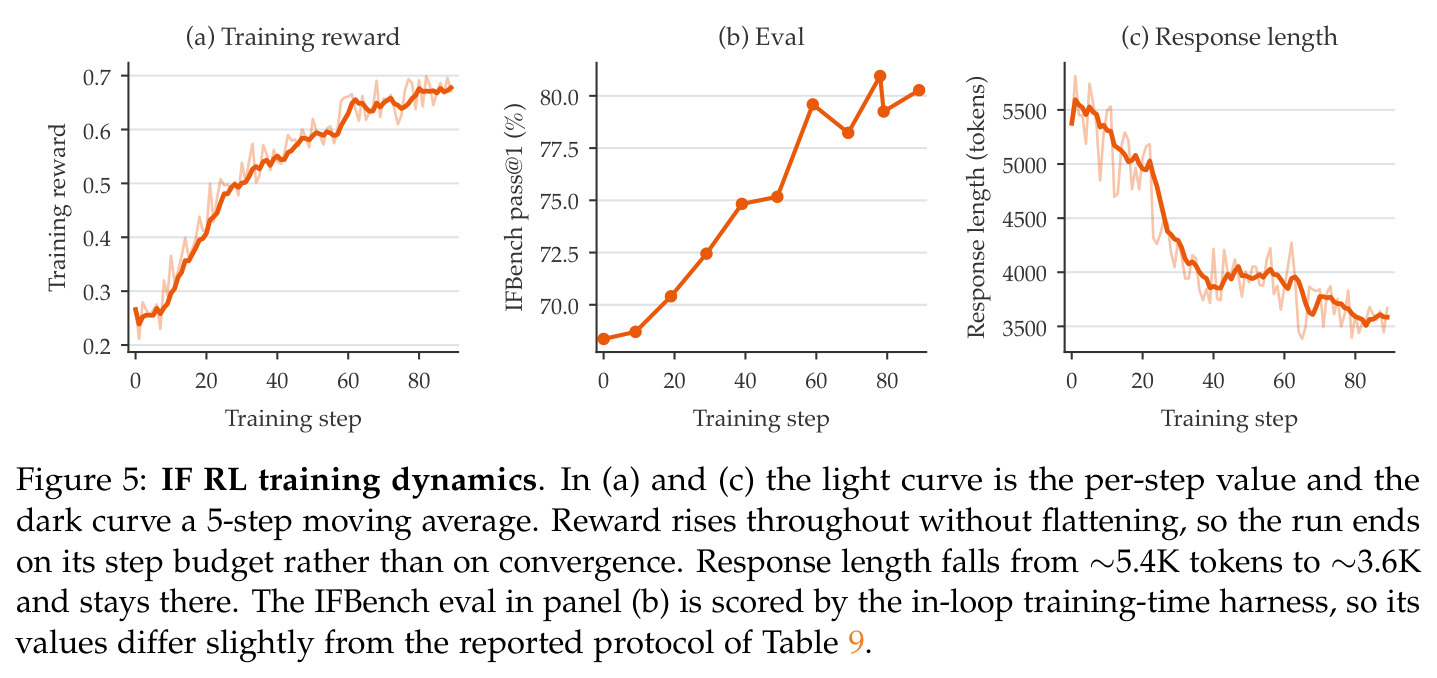
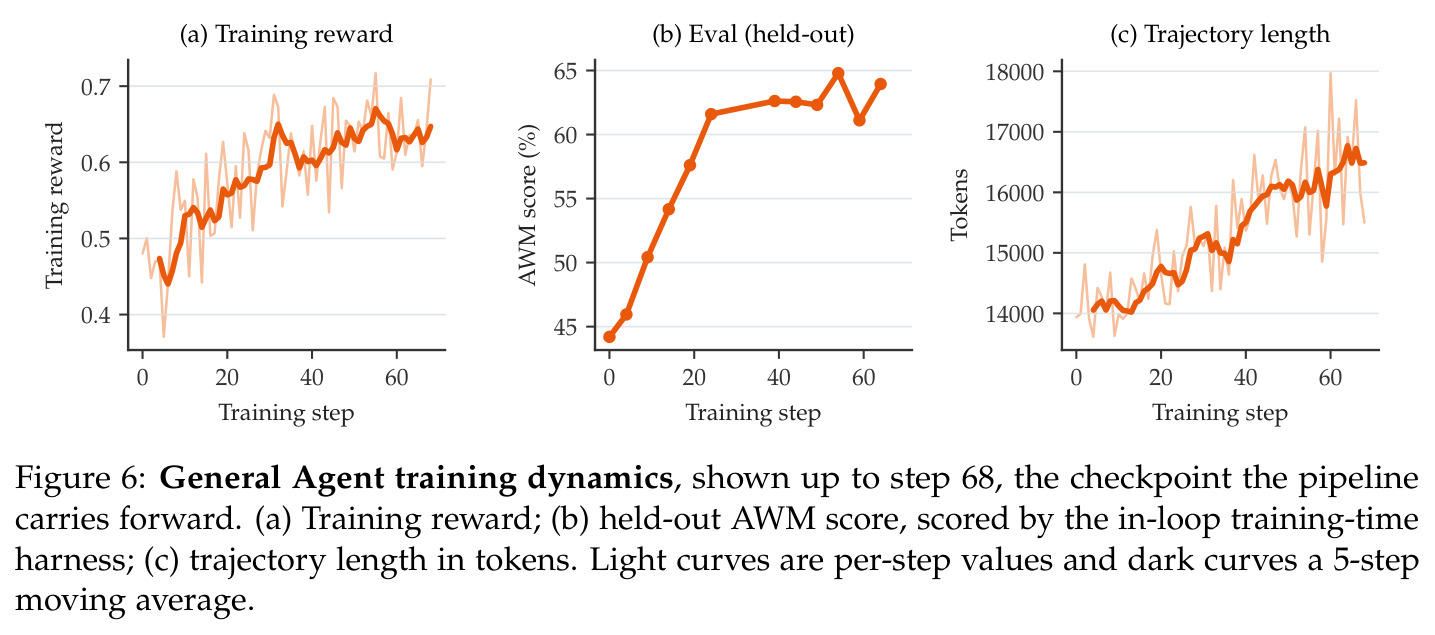
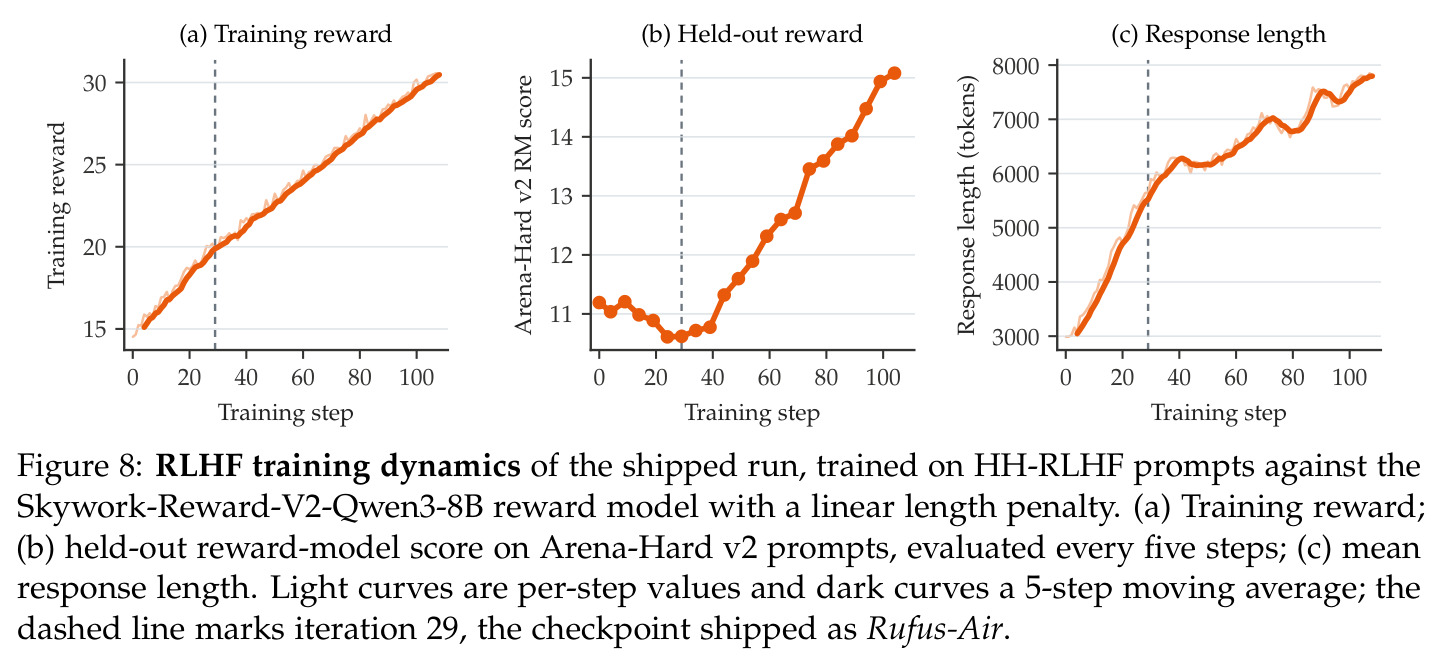
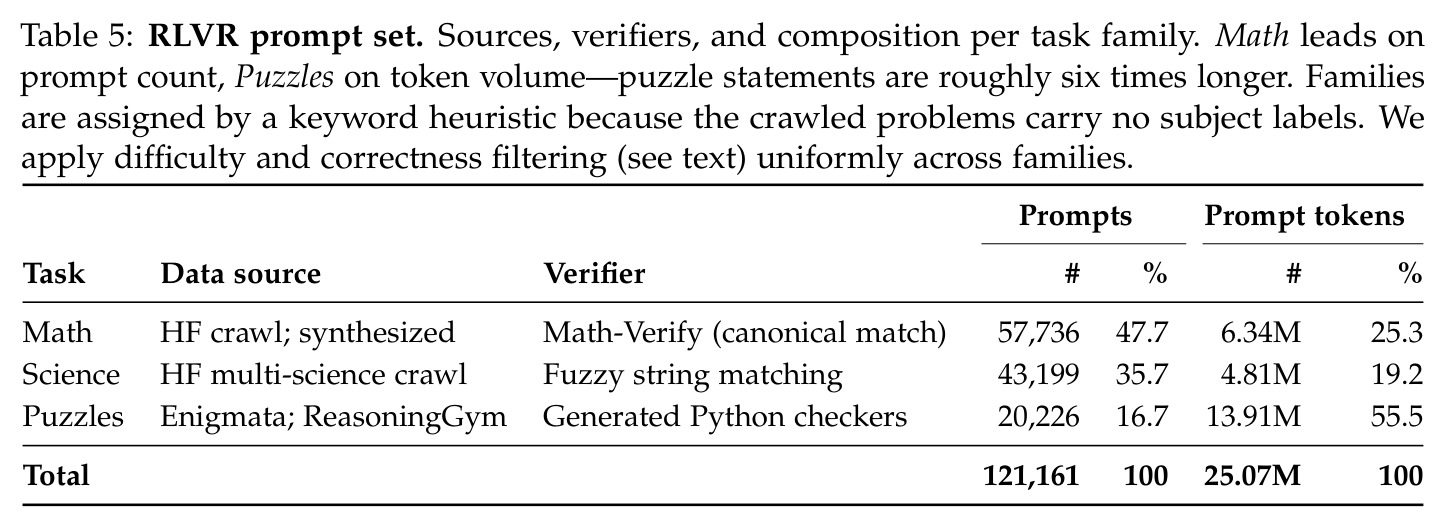
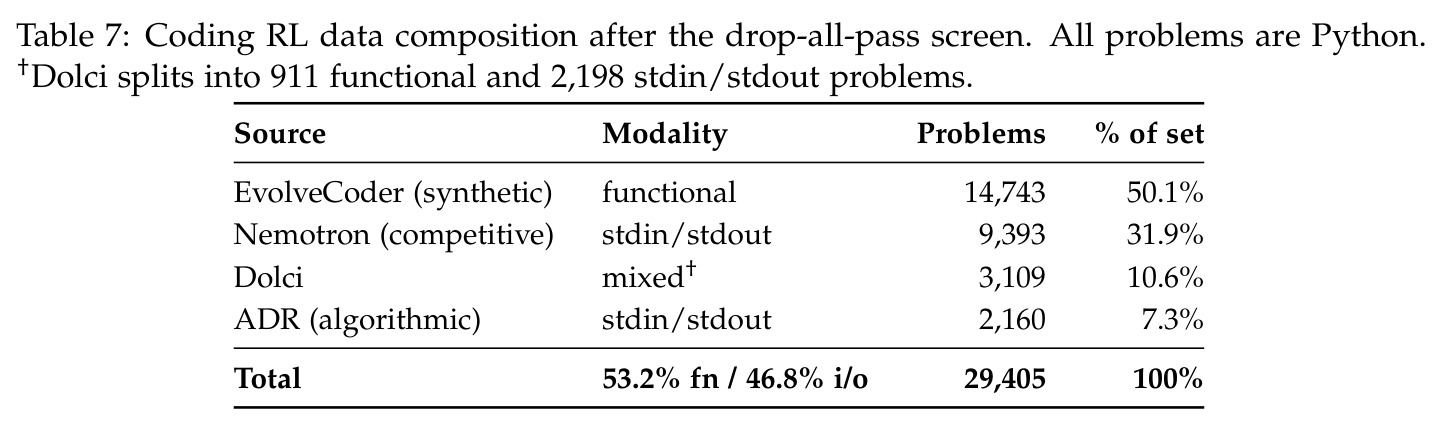
八步流水线逐步如下。(1) SFT:17 个公开数据集合成 9.01M 样本/66.7M 轮,统一为带逐消息损失掩码的多轮格式(仅 assistant 的 27B token 计损,序列上限 120K);用链式 8-gram 筛查十项基准(删 3,529 条)加穷举 n-gram 与稠密检索筛查数学/知识基准(确认 68 对污染),共删 4,187 条;512 GPU 训 3 epoch,取平台期内 checkpoint 3799。(2) Reasoning RL:121,161 条可验证 prompt(数学 57,736、科学 43,199、谜题 20,226),先 GPT-OSS-120B 正确性过滤再可学习性过滤;GSPO、lr $10^{-6}$、每步 256 prompts×16 samples、30K token 预算、组内最短正确回答的线性长度惩罚、在线动态采样。(3) Coding RL:29,405 道 Python 题(函数式 53.2%/标准输入输出 46.8%),沙箱执行二值奖励(每题确定性地抽至多 50 个测试),rollout 中途从 64K 扩到 128K 消除 11–28% 的截断。(4) IF RL:合成 14K 多约束单轮(每条 2–6 个可 Python 验证的原子约束)与 13K 对抗性多轮对话(平均 6.1 轮、2.7 条 rubric),所有 rubric 全满足才给正奖励、刻意不设可选 rubric;GRPO 训 90 步。(5) General Agent:AWM 的 10K MCP 任务过滤后留约 2K,奖励为 episode 结束后服务器状态的二值校验。(6) Coding Agent:Endless-Terminal/SETA-Env/Scale-SWE 过滤后约 4K 任务,Harbor 统一接口,单一 execute_command 工具,Firecracker 沙箱快照,基础设施失败样本从组中剔除再算优势。(7) Search Agent:MiroVerse 抽取 36,614 题经两轮过滤(去无工具可答者约 1/4;保留 8 次内通过数 $0<c<4$ 者)至约 2.2K,三工具环境(搜索/抓取/Python),Qwen3-32B 评委给 [0,1] 分,要求至少 2 次成功工具调用,均值优势加 $10^{-3}$ KL 锚。(8) RLHF:HH-RLHF 过滤后的 75,815 条 prompt,对 Skywork RM 原始分加线性长度惩罚做 GRPO,迭代 29 步出货。
技术新颖性
技术新颖性是三点组合而非单点算法。其一,把「奖励可靠性」形式化为阶段排序准则并给出反例边界——IF RL 用评委却前置、RLHF 用学习到的奖励排最后——比业界「先 RLVR 后 RLHF」的模糊经验更具可操作性。其二,难度过滤在八个阶段中的一致应用:训练前 drop-all-pass,训练中 DAPO 动态采样与 $\bar{r} \in (0, 0.8]$ 窗口在线过滤,作者实证其对涨点的贡献大于策略梯度目标的选择。其三,罕见披露的基建细节本身构成贡献:token-in/token-out rollout 杜绝重分词漂移与 chat 模板重复渲染、Rollout Routing Replay 消除 MoE rollout/训练专家路由错位、FP8 rollout+BF16 训练、Firecracker microVM 快照支撑约万级并发沙箱。此外还有一批「负结果」级经验:可选 rubric 引发长度偏置、格式奖励被无工具瞎猜白拿、未过滤的 HH-RLHF 伤代码能力、HelpSteer3 上 RM 打分不稳。
实验结果
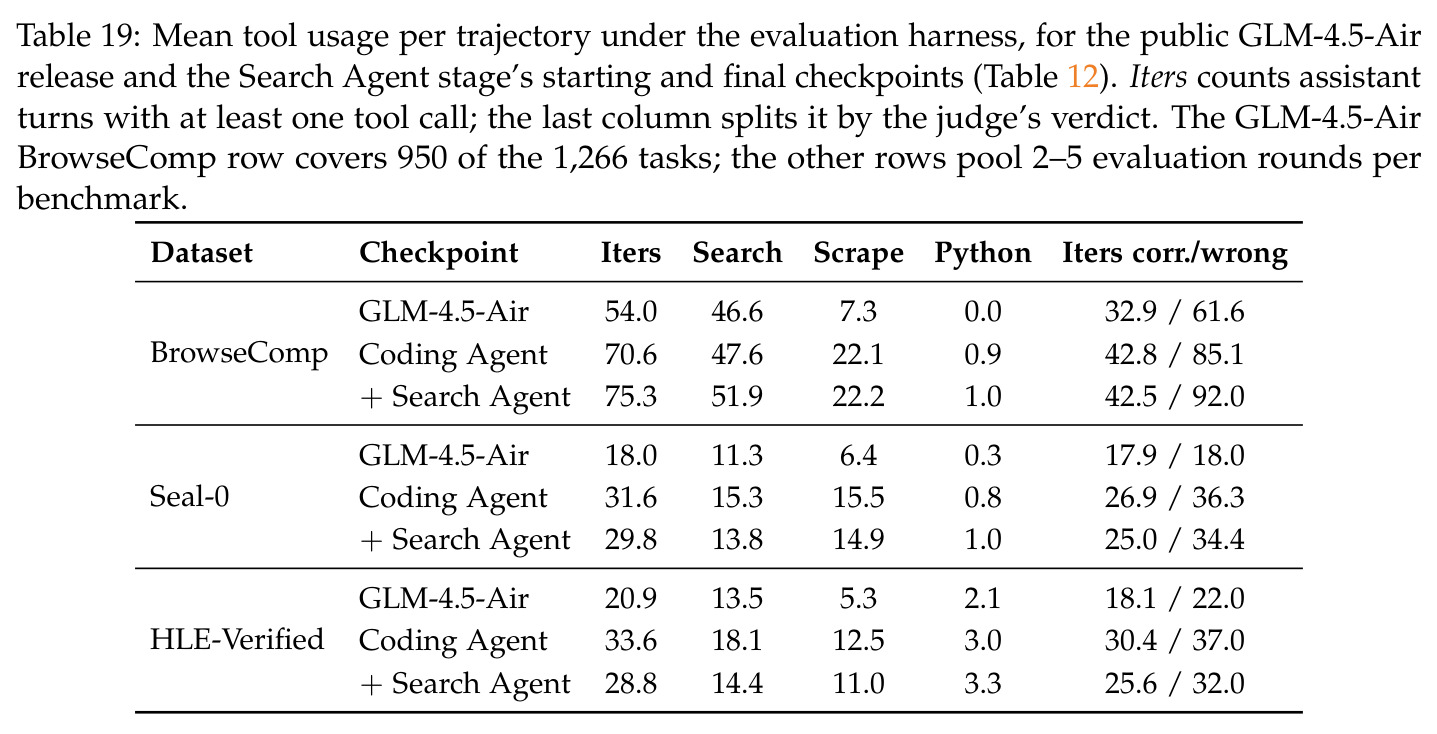
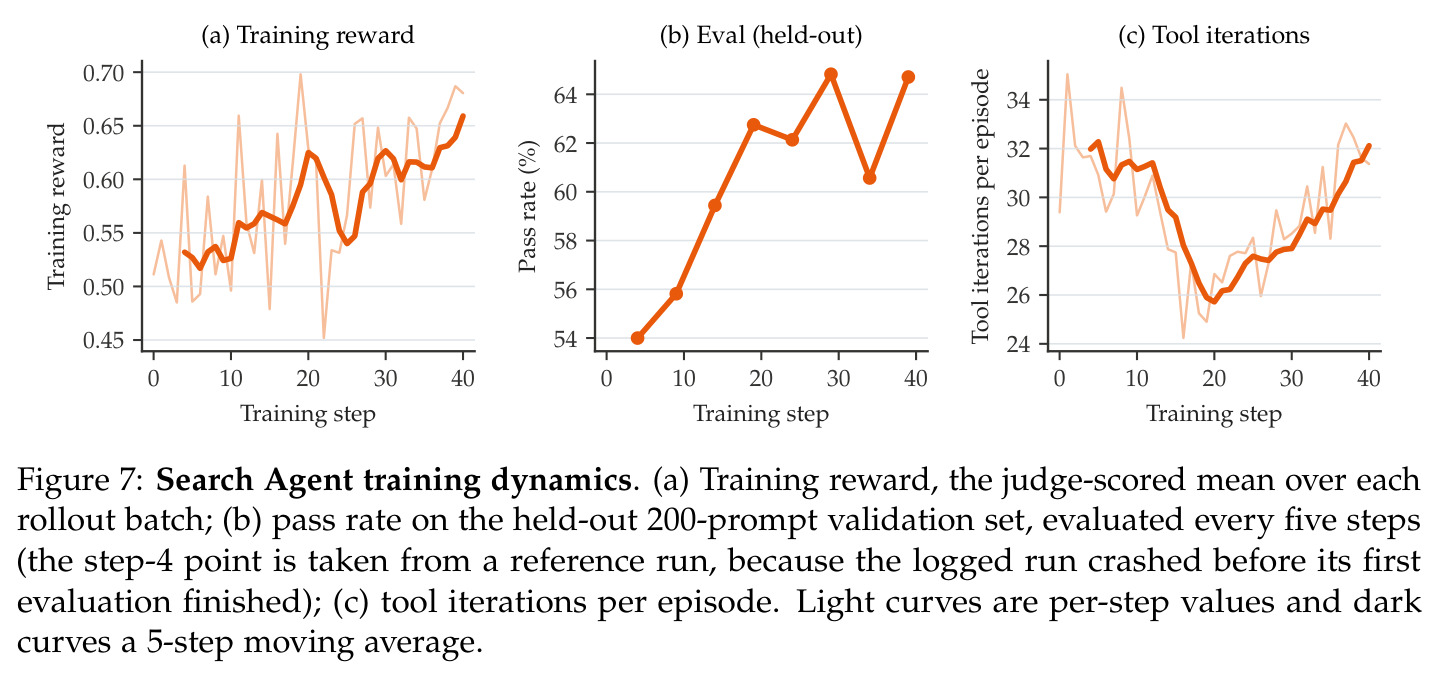
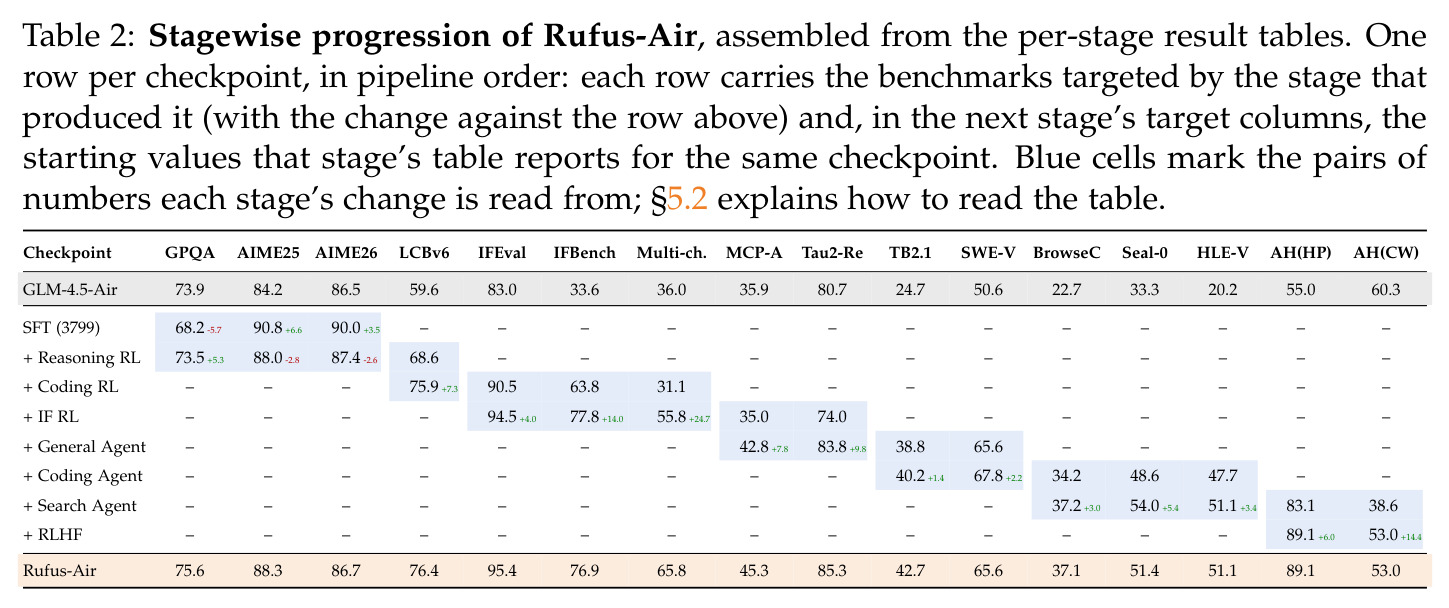
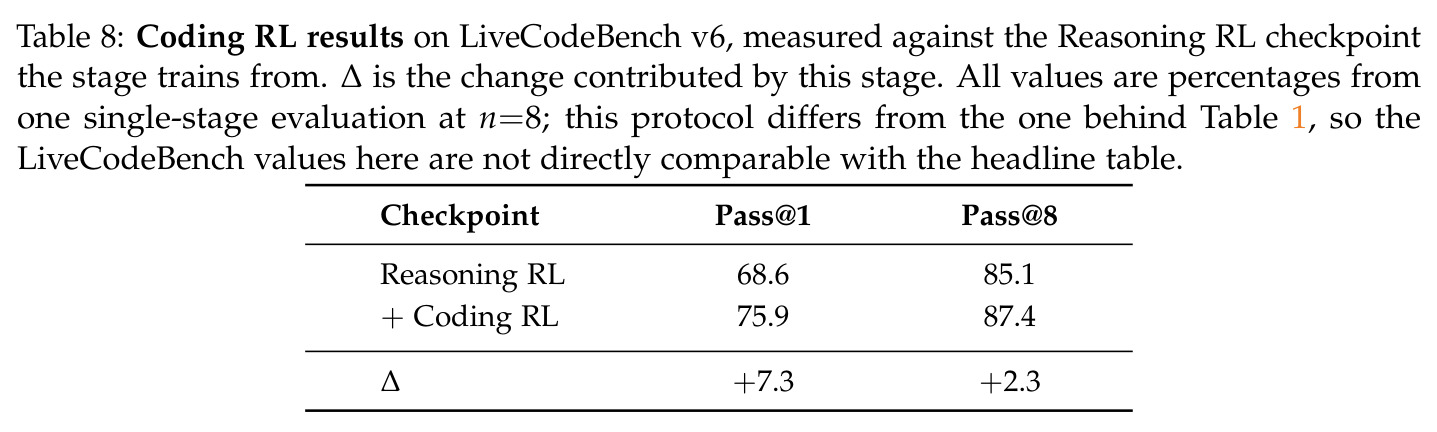
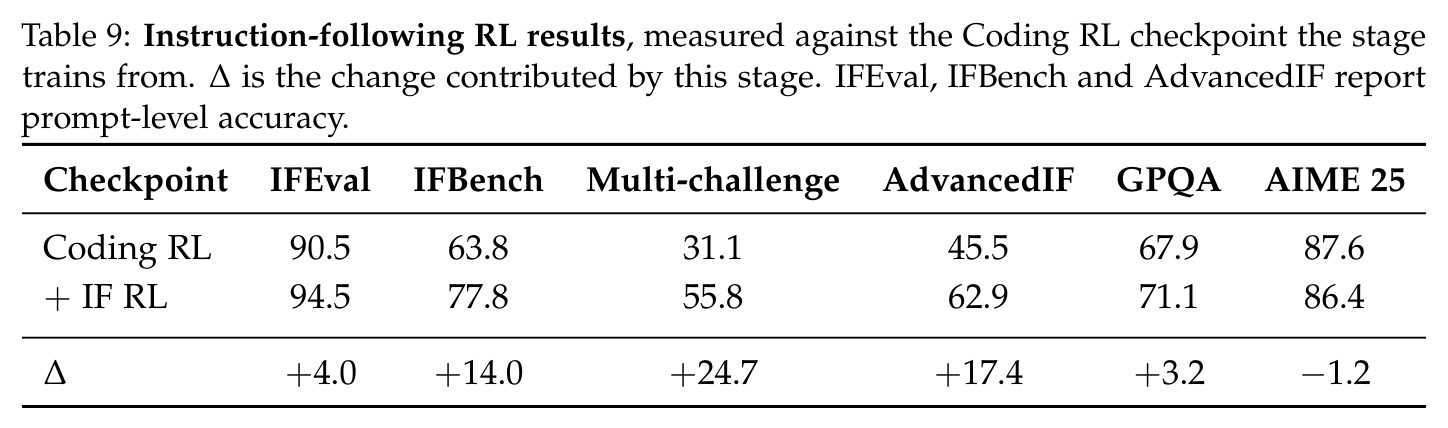
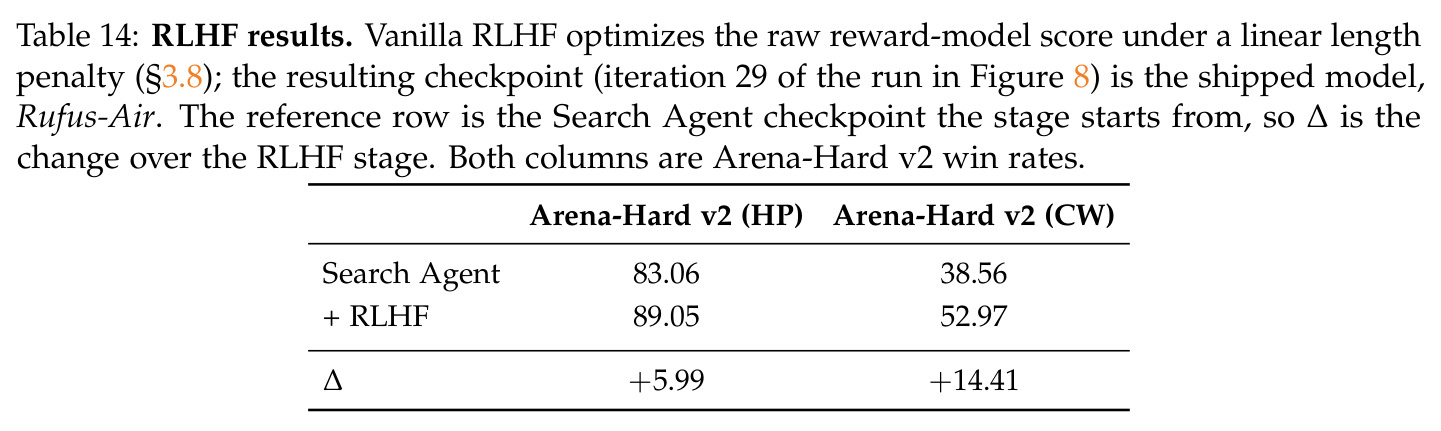
最终模型在所有报告基准上除 Arena-Hard v2 Creative Writing(53.0 vs 官方 60.3)外全面超过官方 GLM-4.5-Air,并与同规模开源模型 INTELLECT-3、Nemotron-3-Super 竞争。逐阶段看:SFT 未做 RL 即领先官方版 IFEval +5.3、IFBench +24.2、AIME25 +6.6、AIME26 +3.5,仅 GPQA 落后 5.7;Reasoning RL 使 GPQA +5.3(68.2→73.5),AIME 降 2.6–2.8 但被视为护栏(每年仅 30 题、同条件重跑方差 4.6,不足一题);Coding RL 使 LiveCodeBench v6 pass@1 +7.3(68.6→75.9)、pass@8 +2.3,其中 64K→128K 预算扩容消除截断后奖励与评测继续上涨(0.26→0.42);IF RL 贡献最大单项增益:Multi-challenge +24.7(31.1→55.8)、IFBench +14.0(63.8→77.8)、AdvancedIF +17.4、IFEval +4.0,且 GPQA 还 +3.2、回复长度从约 5.4K 降到 3.6K token;General Agent 使 MCP-Atlas +7.8、Tau2-Retail +9.8,非 agent 护栏持平或微升;Coding Agent(算力预算内未收敛)使 Terminal-Bench 2.1 +1.4、SWE-bench Verified +2.2,但后者未保持到最终 checkpoint;Search Agent 使 BrowseComp +3.0、Seal-0 +5.4、HLE-Verified +3.4,评测用的是训练中从未见过的搜索后端,说明学到的是通用搜索行为;RLHF 使 Arena-Hard v2 HP +6.0(83.06→89.05)、CW +14.4(38.56→52.97),其他受监控基准移动 ≤1.3。终模型亮点:IFBench 76.9(官方 33.6)、Multi-challenge 65.8(36.0)、Tau2-Telecom 93.0(32.7)、MCP-Atlas 45.3(35.9)、BrowseComp 37.1(22.7)、HLE-Verified 51.1(20.2)、SWE-V 65.6(50.6)、TB2.1 42.7(24.7)、LCB v6 76.4(59.6)、IFEval 95.4。
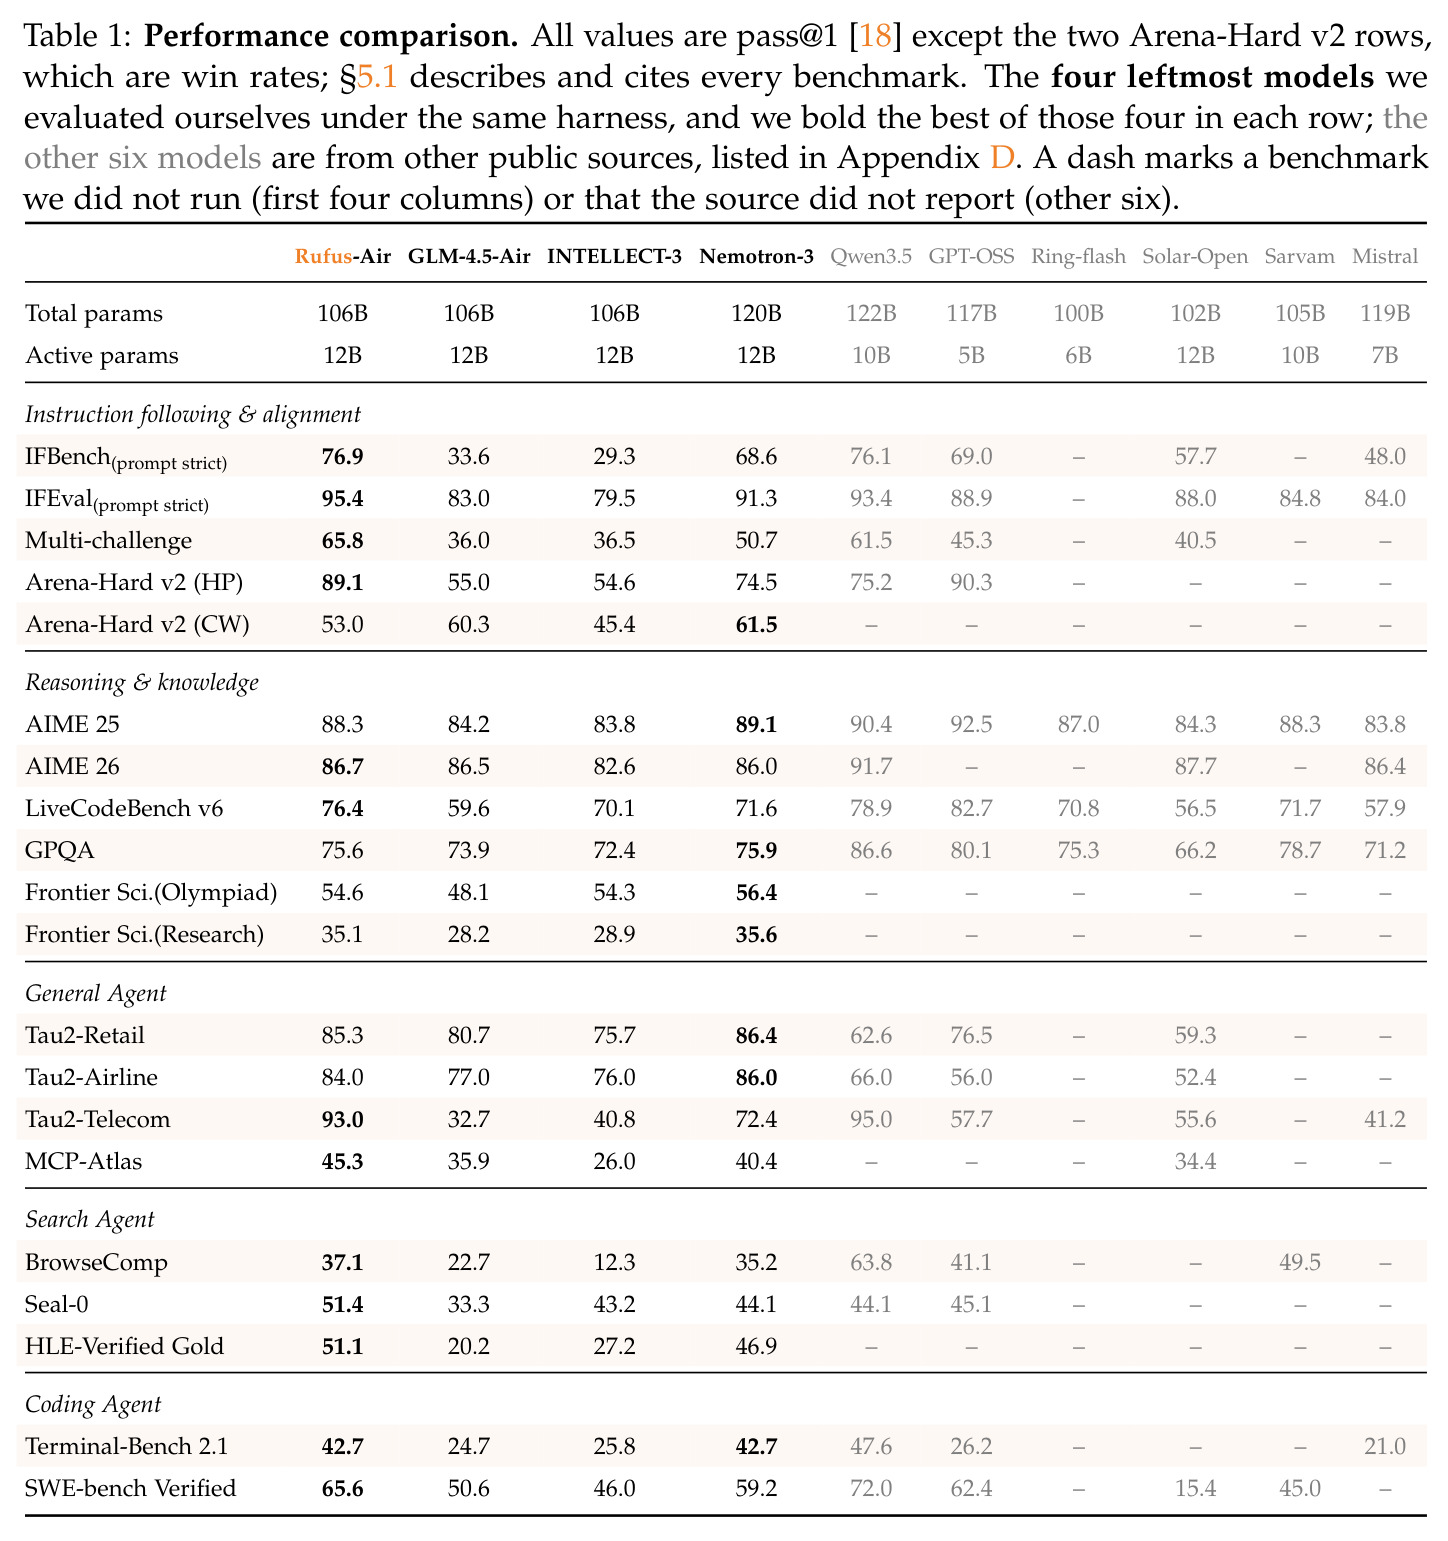
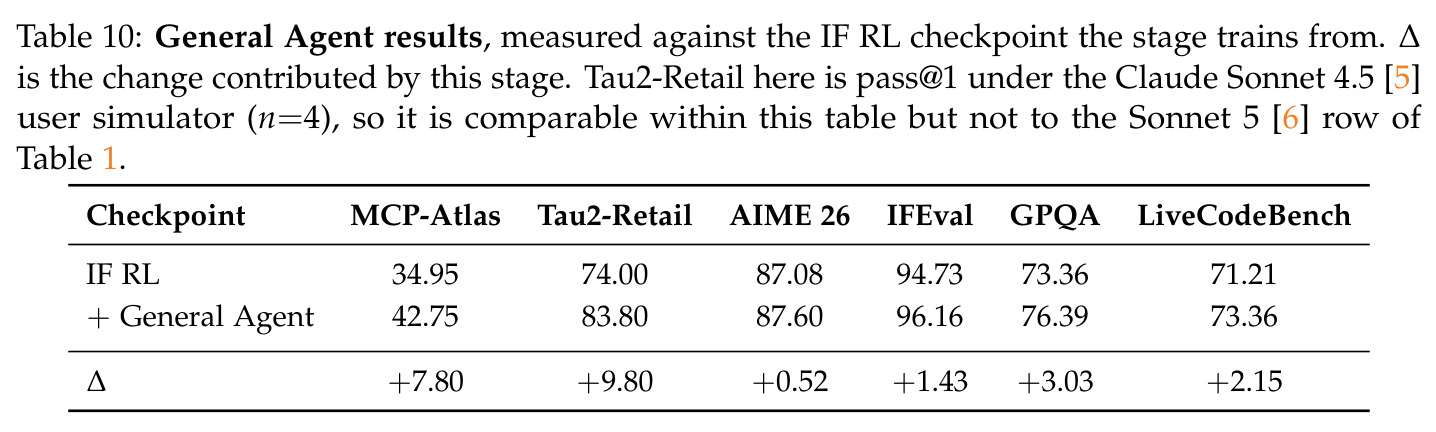
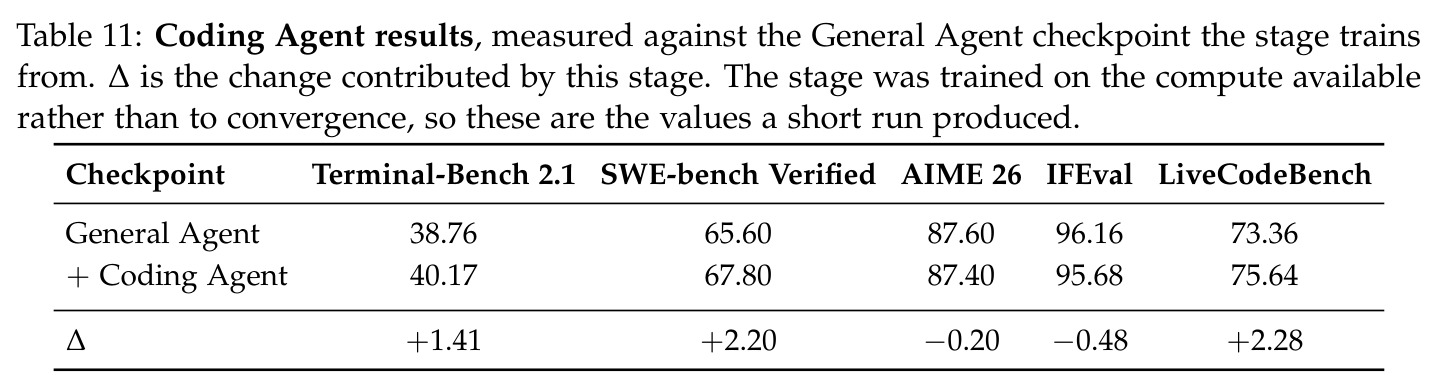
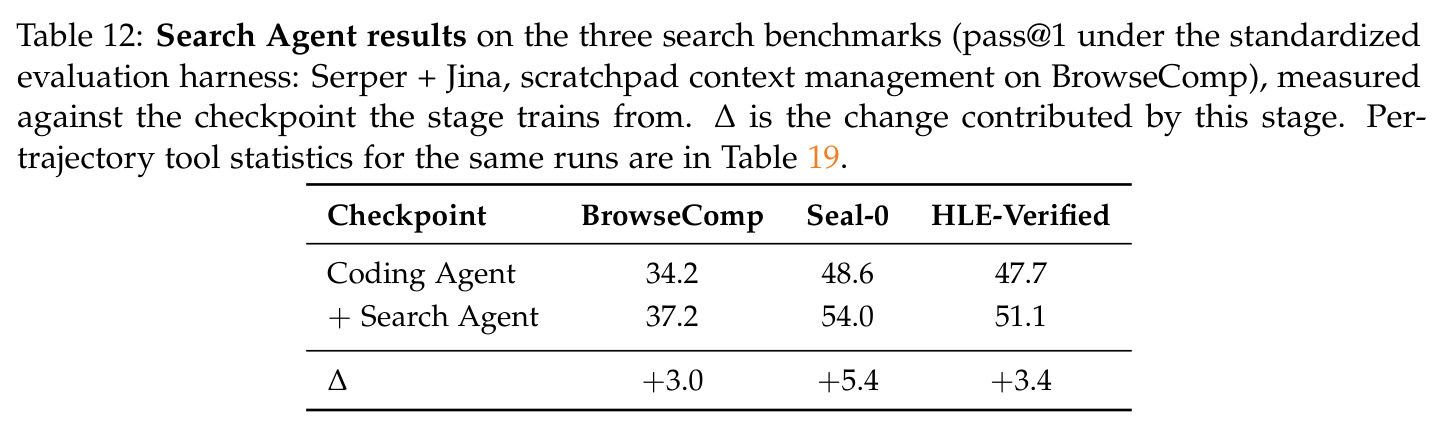
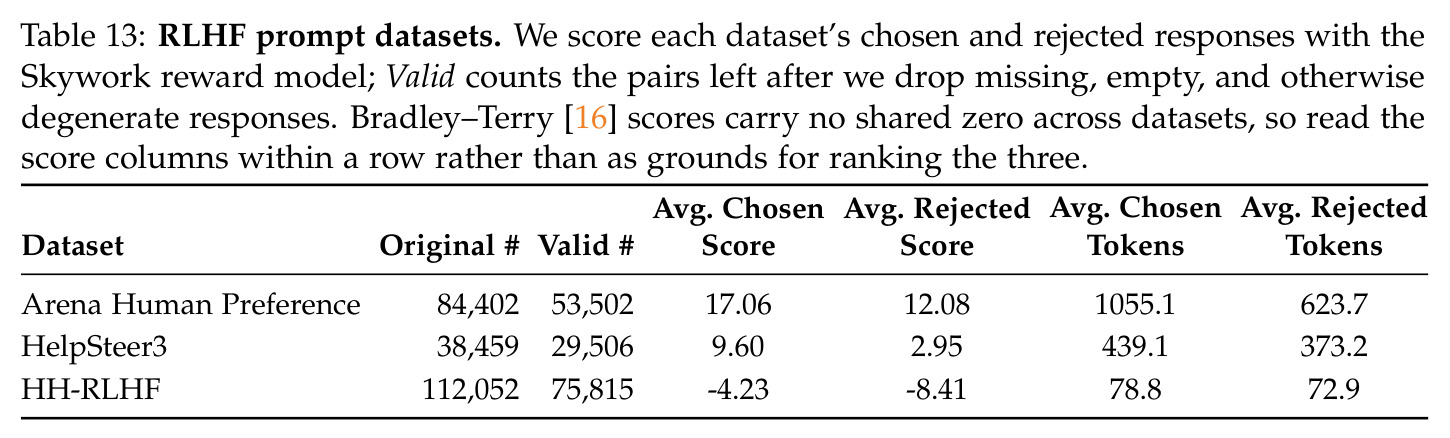
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 指令遵循(域外可验证约束) | IFBench pass@1 (prompt strict) | 76.9 | GLM-4.5-Air 33.6 | +43.3 |
| 多轮指令保持 | Multi-challenge pass@1 | 65.8 | GLM-4.5-Air 36.0 | +29.8 |
| 客服 Agent(电信域) | Tau2-Telecom pass@1 | 93.0 | GLM-4.5-Air 32.7 | +60.3 |
| 搜索 Agent(难度浏览问答) | BrowseComp pass@1 | 37.1 | GLM-4.5-Air 22.7 | +14.4 |
| 搜索 Agent(专家级问答) | HLE-Verified Gold pass@1 | 51.1 | GLM-4.5-Air 20.2 | +30.9 |
| 代码 Agent(真实 GitHub issue 修复) | SWE-bench Verified pass@1 | 65.6 | GLM-4.5-Air 50.6 | +15.0 |
| 竞赛编程 | LiveCodeBench v6 pass@1 | 76.4 | GLM-4.5-Air 59.6 | +16.8 |
| 终端任务 Agent | Terminal-Bench 2.1 pass@1 | 42.7 | GLM-4.5-Air 24.7 | +18.0 |
| 开放对话对齐(困难 prompt) | Arena-Hard v2 HP 胜率 | 89.1 | GLM-4.5-Air 55.0 | +34.1 |
| 创意写作 | Arena-Hard v2 CW 胜率 | 53.0 | GLM-4.5-Air 60.3 | -7.3(少数落后项之一,Nemotron-3-Super 61.5 亦更高) |
| 竞赛数学 | AIME 2025 pass@1 | 88.3 | GLM-4.5-Air 84.2 | +4.1 |
| 科学知识(专家级选择题) | GPQA-Diamond pass@1 | 75.6 | GLM-4.5-Air 73.9 | +1.7 |
局限与改进
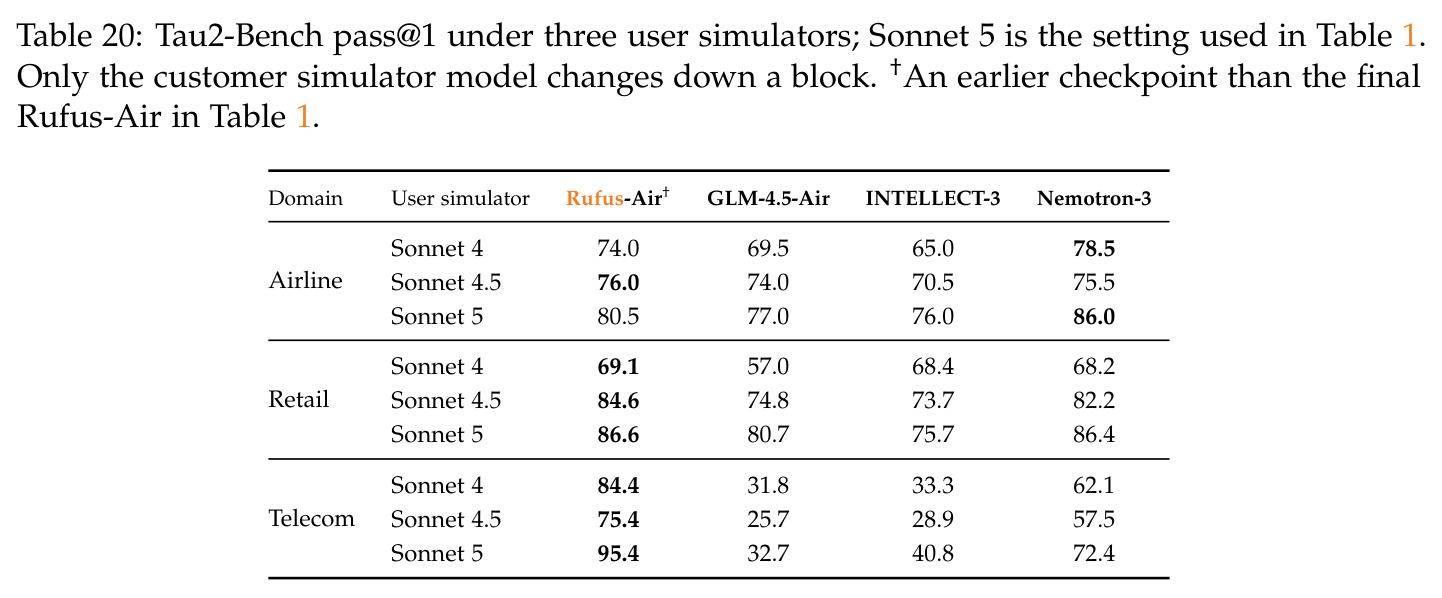
作者明确承认的局限:串行阶段顺序受早期实验与算力约束塑形,是「一个可行的顺序」而非被证明最优,也未探索「分别训练领域专家再经多教师在线策略蒸馏合并」的替代路线;Coding Agent 在可用算力内训练、远未收敛,其 SWE-bench +2.2 的增益没有保持到最终 checkpoint(终值回落到起点值 65.6),而 TB2.1 升到 42.7,且这两个基准在其后的阶段均未复测,阶段间归因断裂;没有任何单一基准套件贯穿全部八个阶段跟踪。我自己的观察:AIME 每年仅 30 题,2–3 点的波动不足一题,作为护栏的统计功效有限,作者也承认同条件重跑差异达 4.6;同一 checkpoint 的 GPQA/IFEval 在不同表中数值不一(71.1 vs 73.36;94.5 vs 94.73),提示评测方差不可忽略;Search Agent 的奖励门只验证工具调用执行过、不验证答案确实依赖其返回,记忆化答案附会工具调用仍是靠轨迹审计而非奖励关闭的残余漏洞;Tau2 用户模拟器从 Claude Sonnet 4.5 换成 5 就会显著移动数字(附录 F),agent 类评测对协议高度敏感、跨论文可比性弱;此外全部结果均为单次运行,无多种子方差报告,许多「哪条原则贡献多大」的结论来自训练经验而非受控消融。
独立分析的弱点
弱点一:串行流水线无法保护早期收益,后阶段会侵蚀前阶段成果(SWE-bench +2.2 消失即为实证),且顺序未做系统消融——改进方向是引入能力回放正则,或走作者自己提到但未尝试的多教师在线策略蒸馏/专家合并路线。弱点二:评委类奖励仍是噪声源,Search Agent 用 Qwen3-32B 评委是为每步 512 条轨迹的吞吐妥协,重复打分不一致——可用更强评委做离线抽检校准、或在训练中加入评委自一致性约束。弱点三:可学习性阈值(0.8、$\bar{r} \in (0,0.8]$、$0<c<4$)均为经验值且各阶段不一致(Coding RL 训中不再过滤)——可按通过率分布在线自适应估计阈值,形成统一的全局课程机制。弱点四:Creative Writing 落后官方版 7.3 分,暴露通用 RM 对风格类目标覆盖不足——可引入风格专用 RM 或小规模人类偏好校准。弱点五:RLHF 只用 HH-RLHF 一个 prompt 源,开放式多样性受限;且该阶段依赖「外部 RM 分数高≈更好」的假设,缺一个真正独立于训练信号的质量评测。弱点六:评测基建成本高且部分闭环(agent 基准用自家 harness 复现),外部团队难以逐字复核。
未来方向
作者提出或隐含的方向:探索多教师在线策略蒸馏与领域专家合并这条被明确点名的替代路线;把 Coding Agent 训到收敛并复测其在后续阶段中的保持情况;建立贯穿全部八阶段的固定基准面板以实现精确的逐阶段归因。基于其成果可延伸的:其一,把「奖励可靠性排序」自动化——按各阶段的 reward hacking 指标(如评委分与硬验证器的一致性漂移)动态决定阶段切换与退出时机;其二,难度过滤的在线课程已有雏形(死题随策略进步自动进入可学习带),可推广为跨阶段共享的 prompt 池与统一通过率追踪,避免每个阶段重建数据管线;其三,为 Search Agent 设计工具依赖奖励(例如擦除工具返回后重问的「关灯测试」式探测),从奖励层面关闭记忆化捷径;其四,MoE 专属课题:R3 与 FP8/BF16 失配的更优解、路由一致性正则、以及全 BF16 rollout 的成本-稳定性权衡;其五,把本配方当作社区基线,对四条原则(SFT 强度、过滤阈值、阶段顺序、基建组件)做受控消融,量化各自贡献——这正是作者向社区发出的邀请。
复现评估
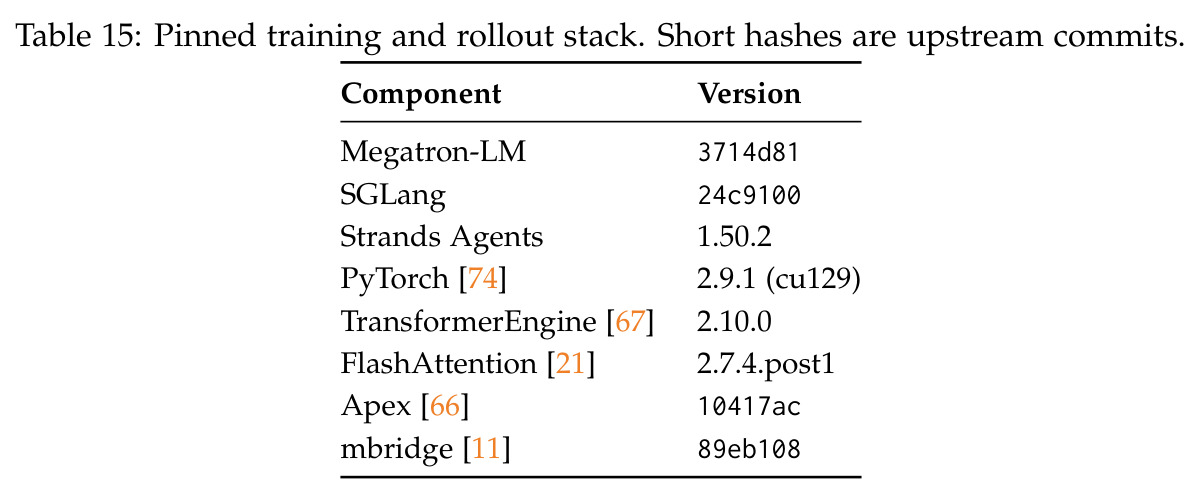
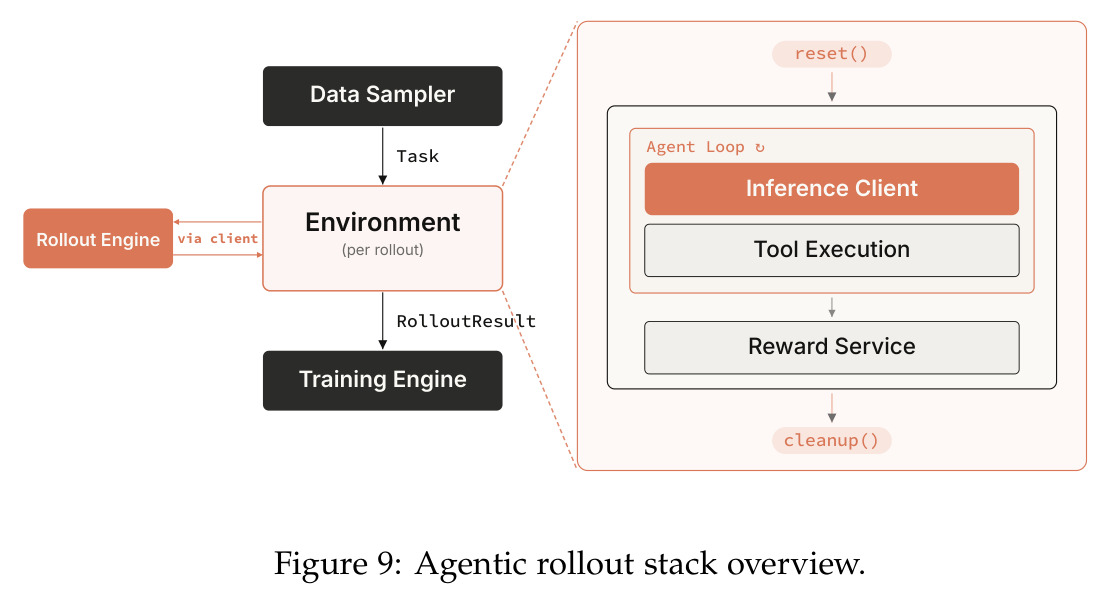
复现友好度是本文的卖点,但门槛不低。资产层面全部可得:基座 GLM-4.5-Air-Base 公开;SFT 混合的 17 个数据集全部公开且按原样使用(自再生成比例为 0);RL 数据源公开(Enigmata、ReasoningGym、EvolveCoder、Nemotron、Dolci、ADR、AWM、Endless-Terminal、SETA-Env、Scale-SWE、MiroVerse);奖励模型 Skywork-Reward-V2-Qwen3-8B 公开;训练栈基于开源的 Slime(作者改名为 Rufus-Slime)、Megatron-LM、SGLang、自托管 E2B/Firecracker 与 Ray,Rufus-Gym 环境层的接口在 §4.2 有详细描述。算力层面:SFT 是最大开销——64 个 8×H200 节点(512 GPU)约 13 天,约 832 节点·天;各 RL 阶段 8–32 节点可跑;另有集群外成本要单独预算:沙箱服务按约万级并发设计、月耗约 1 万美元,BrowseComp 一次评测约 $10^5$ 次搜索/抓取调用、按牌价数百美元(Serper $2/1K 次、Jina Reader $0.05/1M token)。「无新人工标注」是全程硬承诺。难度评估:对拥有几十个节点、熟悉 Megatron+SGLang 的中大型团队,逐阶段照配方复现可行;单机 8 卡团队只能取单阶段或缩规模。需要说明的是,正文明确声称 open 的是配方与数据均基于公开组件,模型权重与训练代码仓库的具体发布链接在所读文本(未含附录)中未明确给出,复现前需自行核对官方发布物。
论文图表