MemBodied:面向视觉-语言-动作模型的循环联想记忆 MemBodied: Recurrent Associative Memory for Vision-Language-Action Models
用固定大小的联想记忆与初始场景锚点替代不断增长的观测历史,让机器人策略记住交互过程
前置知识
VLA 模型(视觉-语言-动作模型)
以预训练视觉-语言模型(如 PaliGemma)为骨干、外接动作专家的通用机器人策略:每次调用输入当前相机观测 $I_t$、机器人状态 $s_t$ 和语言指令 $\ell$,输出未来 $H$ 步动作。代表工作有 RT-2、OpenVLA、$\pi_0$(flow-matching 连续动作头)和 $\pi_{0.5}$。
MemBodied 是在不改动 VLA 主干的前提下给 $\pi_0$/$\pi_{0.5}$ 加装情节记忆,论文所有实验、基线和消融都围绕这两个骨干展开。
动作分块(action chunking)
策略每次调用一次性预测未来 $H$ 步(本文 $H=50$)的动作序列再整体执行,可提高动作一致性并摊薄推理开销,但块与块之间的观测信息不会自动保留到下一次调用。
本文的延迟写入时机、训练序列构造(相邻样本相隔一个 horizon)以及 LIBERO 上 10 个记忆槽轮转的设计都直接由 chunk 机制决定。
时序状态混叠(temporal state aliasing)
部分可观测决策问题:当前观测相同或相似,但最优动作取决于过去发生的事件。例如积木被挪走后,画面里不再显示它最初在哪块垫子上,策略必须依赖历史才能把它放回原处。
这是论文的问题定义与全部任务设计的核心,RMBench 的 M(1)/M(n) 任务分类以及失败模式标注都在量化这类混叠引发的错误。
联想记忆与门控 Delta 规则
快速权重思想:把历史压缩进固定大小的键值矩阵 $S$。写入时按 delta 规则 $S_t = S_{t-1} + \beta(v_t - S_{t-1}k_t)k_t^\top$ 修正与键 $k_t$ 关联的旧值而非无限累加,读取用 $r = Sq$;Gated DeltaNet 进一步加入数据依赖的保留门。
MemBodied 的核心状态就是这套门控 delta 矩阵,理解它是看懂论文写入/读取公式、容量消融和与 vanilla 循环记忆区别的前提。
LoRA 微调
低秩适配:冻结原模型权重,只训练注入的低秩矩阵(秩 $r$ 远小于原维度),大幅降低微调的显存与算力需求,是 VLA 领域常用的下游适配方法。
RMBench 实验中视觉主干用 LoRA rank 16、动作专家用 rank 32,所有本地基线在相同的适配配方和训练步数下比较,结果才可比。
研究动机
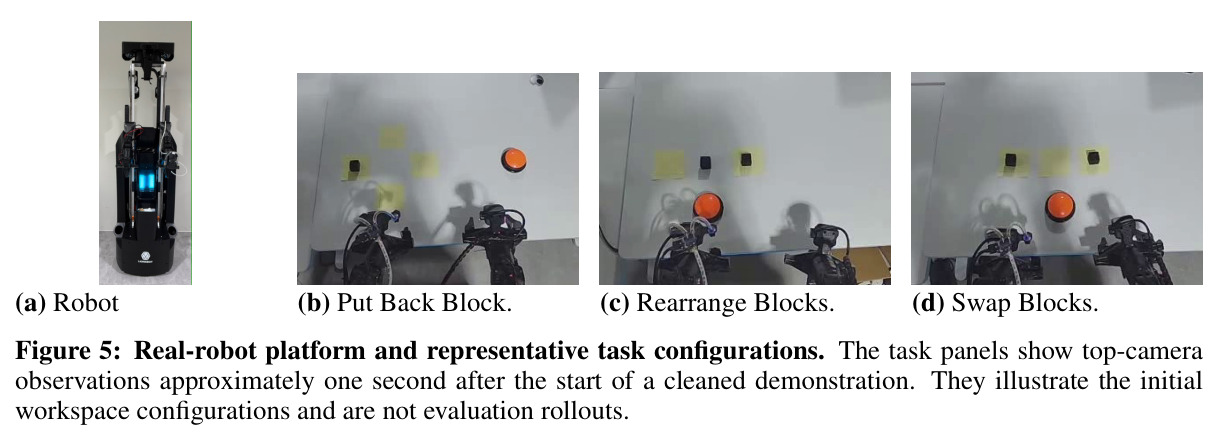
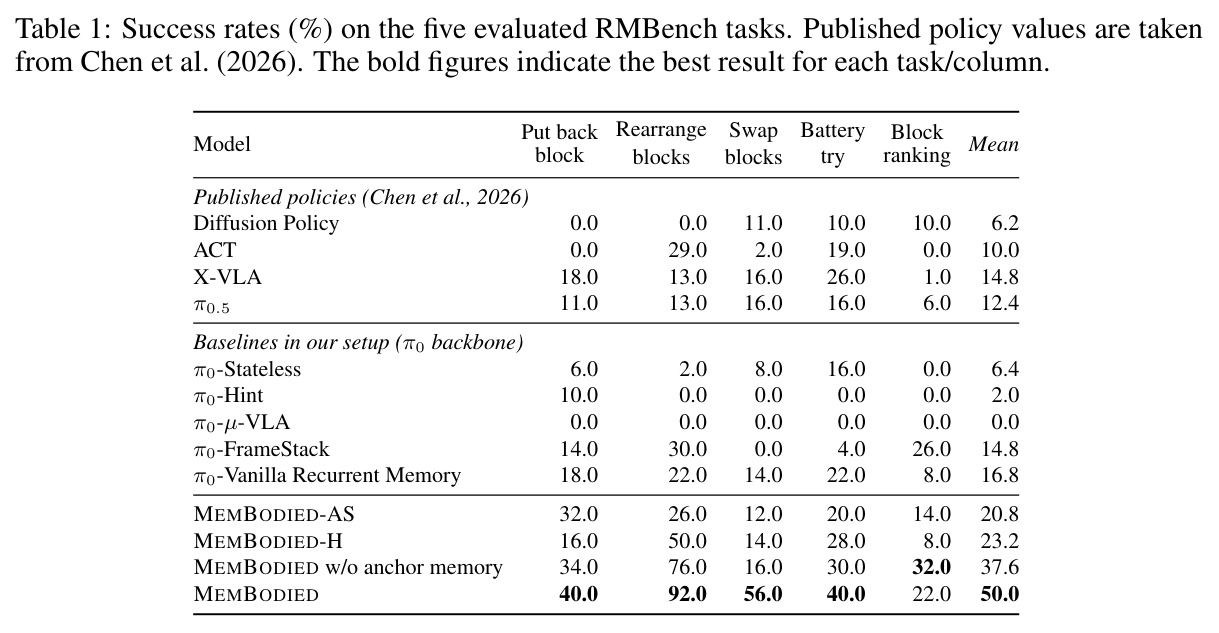
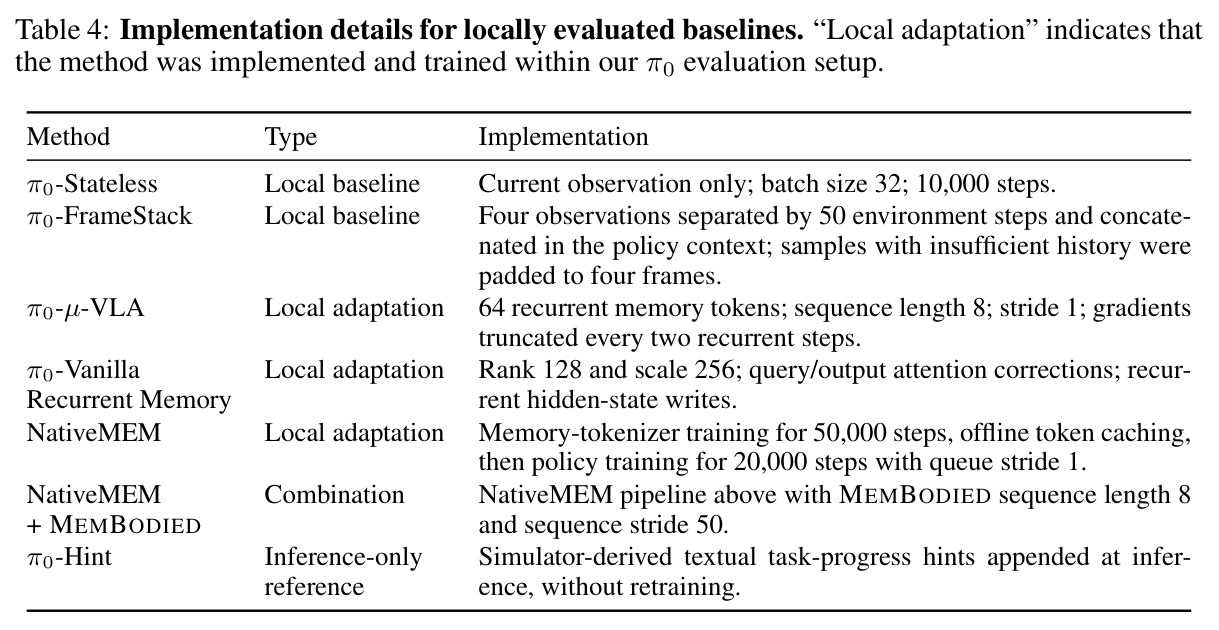
主流 VLA 策略每次调用只条件于当前观测与指令,动作分块也不会把观测信息带进下一次调用,导致『历史依赖』操作任务大量失败。典型场景是 Put back block:机器人把积木从四块垫之一挪到中央、按下按钮后,画面里已经看不到它最初在哪块垫上,必须靠记忆放回原位。在 RMBench 五个记忆任务上,无记忆的 $\pi_0$-Stateless 平均成功率仅 6.4%(Block ranking try 为 0.0%),已发表的 $\pi_{0.5}$ 也只有 12.4%,甚至连推理时喂入模拟器文字提示的 $\pi_0$-Hint 都只有 2.0%。直接把历史帧放进上下文代价高昂:上下文长度、显存与推理延迟随回合不断增长;固定窗口又会把任务相关证据挤出去,且关键事件可能与当前决策相隔几十步中间观测。
本文的目标是构建一个容量固定、与回合长度无关的情节记忆,让策略在不扩大策略上下文的前提下保留两类信息:跨调用累积的交互历史(做过什么动作、产生了什么视觉后果)和初始场景的紧凑参考(任务开始时世界什么样)。同时要求它不损害完全可观测(Markovian)任务上的通用操作能力,并在推理延迟、显存和新增参数量上显著优于压缩历史类方法。
与已有工作不同的是,已有三条路线各有代价:HAMLET/NativeMEM 把历史观测压缩成 token,但 token 数量随回合增多、上下文仍会膨胀;$\mu$VLA、ReMem-VLA 等携带循环隐状态,靠嵌入的反复变换隐式保存信息,缺乏显式读写结构;MemoryVLA、MAP-VLA、Notes-to-Self 依赖记忆库、检索或语言便签,引入额外的训练目标或处理流水线。本文的独特切入是把线性注意力/快速权重社区的『联想记忆 + delta 规则』系统移植到连续机器人控制:显式读写接口、固定尺寸矩阵状态、仅凭动作目标端到端学习『写什么、留什么、取什么』,并额外设计初始场景锚点通路,弥补 delta 规则反复覆写会冲刷早期细节的固有缺陷。
核心方法
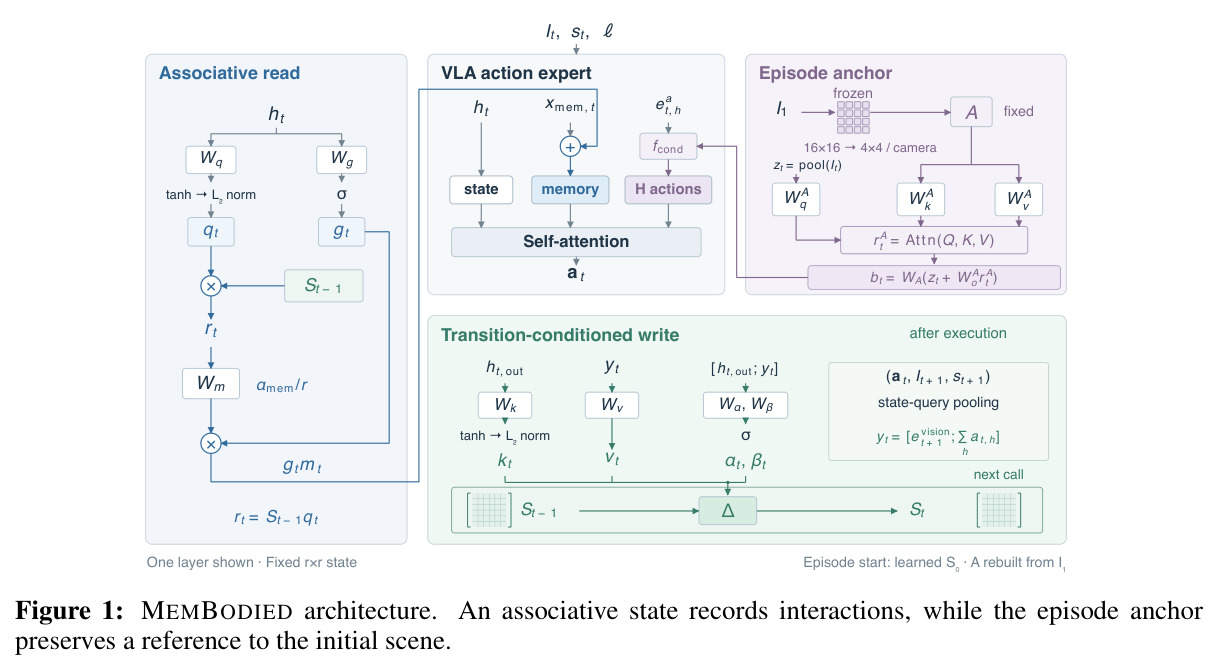
直觉上,MemBodied 给策略一本『操作日志』和一张『开场快照』。日志是联想记忆:每个动作专家层维护一个 $r\times r$ 的键值矩阵 $S^{(l)}_t \in \mathbb{R}^{B\times r\times r}$(实验取 $r=128$),每完成一次交互就写入一条『动作+视觉后果』的联想记录,读取时用当前状态作查询检索。快照是 episode anchor:把第一帧每个相机的 $16\times16$ patch 网格平均池化成 $4\times4$ 并跨相机拼接,作为回合内固定不变的初始场景参考。技术流程:每次策略调用先用 $(I_t, s_t, \ell)$ 读记忆 $M_{t-1}$ 并生成 $H$ 步动作块 $a_t$;动作执行后环境返回 $I_{t+1}$,模型将其与刚执行的动作块摘要拼成写值,经门控 delta 规则更新 $S_t$;锚点 $A$ 在回合开始时构建、期间不变。两条通路的读出最终都注入动作专家,且整个记忆 footprint 与访问成本不随回合长度增长。
三点本质区别:其一,写入的记忆值不是孤立的观测帧,而是『转移』$y_t = [\tilde{e}^{vision}_{t+1}; \sum_h a_{t,h}]$——刚执行的动作块摘要加上执行后的视觉后果,即记忆存的是因果交互而非静态快照;其二,用门控 delta 规则 $S^{(l)}_t = \mathrm{Diag}(\alpha^{(l)}_t)S^{(l)}_{t-1} + \mathrm{Diag}(\beta^{(l)}_t)\big(v^{(l)}_t - \mathrm{Diag}(\alpha^{(l)}_t)S^{(l)}_{t-1}k^{(l)}_t\big)(k^{(l)}_t)^\top$ 做有选择的覆写而非无限累加:$\alpha$ 控制旧状态保留多少、$\beta$ 控制修正强度,状态尺寸恒定;其三,单独的锚点通路保存初始场景,且锚点不进策略前缀、不改变 token 位置与注意力掩码,而是由当前状态派生的查询 $z_t$ 通过秩 $r_A=64$ 的交叉注意力按需取用,避免前缀视觉 token 分散注意力。读出向量则以『上下文内容』的形式注入专用 memory token。
方法步骤详情
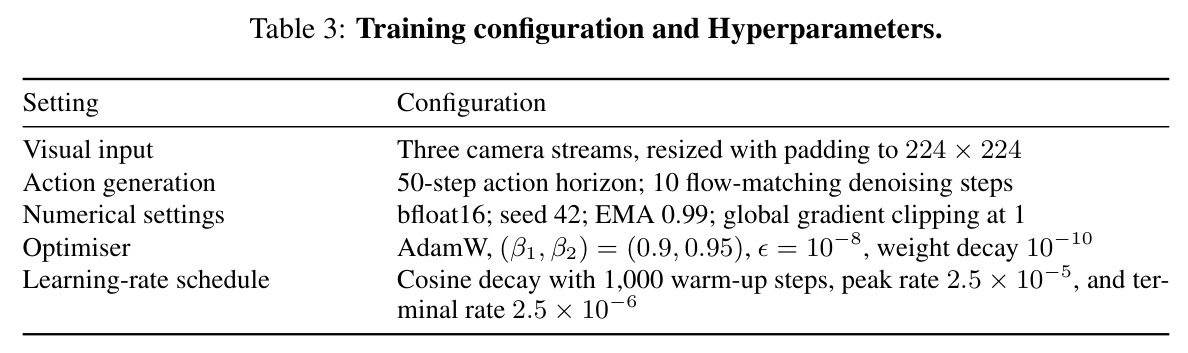
完整流程分五步。(1) 读:第 $l$ 层用 $q^{(l)}_t = \mathrm{L2Norm}(\tanh(W^{(l)}_q h^{(l)}_{t,in}))$ 从进入该层的状态表示构造查询,取读出 $r^{(l)}_t = S^{(l)}_{t-1}q^{(l)}_t$;读出经 $m^{(l)}_t = \frac{\alpha_{mem}}{r}W^{(l)}_m r^{(l)}_t$ 缩放($\alpha_{mem}=256$,即 2 倍显式检索系数)并由门控 $g^{(l)}_t = \sigma(W^{(l)}_g h^{(l)}_{t,in})$ 加到可学习 memory token 上,该 token 位于后缀 [state token, memory token, H 个动作 token] 中参与自注意力。(2) 动作生成:动作专家经 10 步 flow-matching 去噪输出 50 步动作块并执行。(3) 延迟写:下一观测 $I_{t+1}$ 到来时,用投影后的 $s_{t+1}$ 作查询对各相机 patch token 做注意力池化得 $\tilde{e}^{vision}_{t+1}$(梯度在 patch token 处截断),与动作块求和拼成 $y_t$,逐层投影出 $k,v$ 并算门 $\beta,\alpha$,按 delta 规则更新。(4) 锚点读取:$z_t$ 由当前状态对当前观测池化得到,交叉注意力查询 $A$,输出投影后沿 horizon 复制并经 $f_{cond}$ 融入每个动作表示。(5) 训练:每个样本含 $N$ 个相隔一个 horizon 的观测-动作对,图像编码沿 batch/序列维并行、记忆状态沿序列顺序传播,梯度穿过全序列,仅用策略原生动作损失,无独立记忆预测损失。
技术新颖性
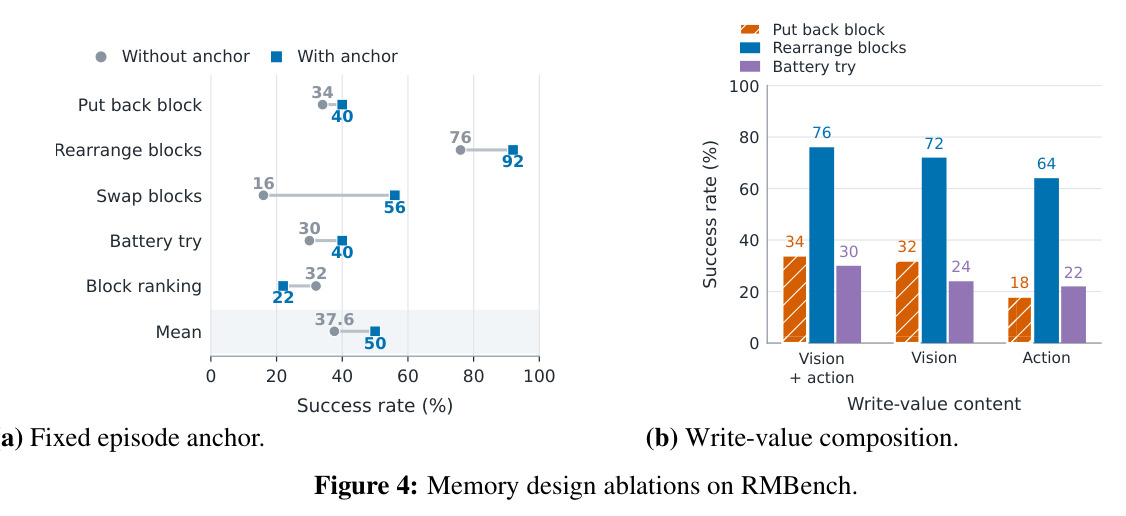
新颖性在于『机制移植 + 接口设计』四点。(1) 首次把门控 delta 联想记忆(DeltaNet/Gated DeltaNet 一类线性注意力快速权重机制,$\delta$-Mem 曾将其用于 LLM)系统迁移到连续机器人控制,并用消融证明接口选择是关键:把读出作为上下文内容注入 memory token(无锚点时 37.6%)显著优于仅修正注意力查询/输出的 attention steering(20.8%)和 LSTM 式分层记忆(23.2%)。(2) 记忆值取『动作-视觉后果』转移对而非观测本身,并通过延迟写入保证因果性——动作 $a_t$ 看不到由它引发的 $I_{t+1}$,训练与推理对交互事件的解释一致。(3) 双通路互补设计:联想状态记录演变过程,锚点补充 delta 覆写易丢失的初始场景(去掉锚点均值从 50.0% 掉到 37.6%)。(4) 全程无辅助记忆损失、无检索流水线、无语言生成通道,记忆参数完全由动作目标端到端塑造,与 MemoryVLA/Notes-to-Self 等外挂式方案形成鲜明对照。
实验结果
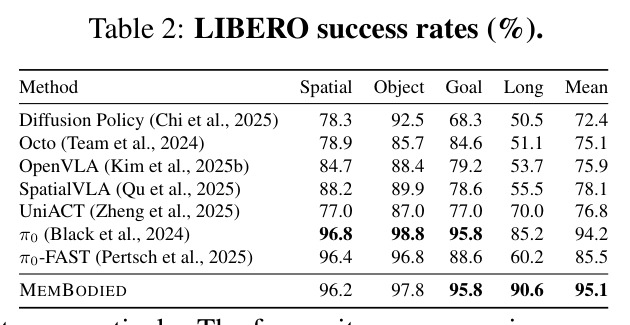
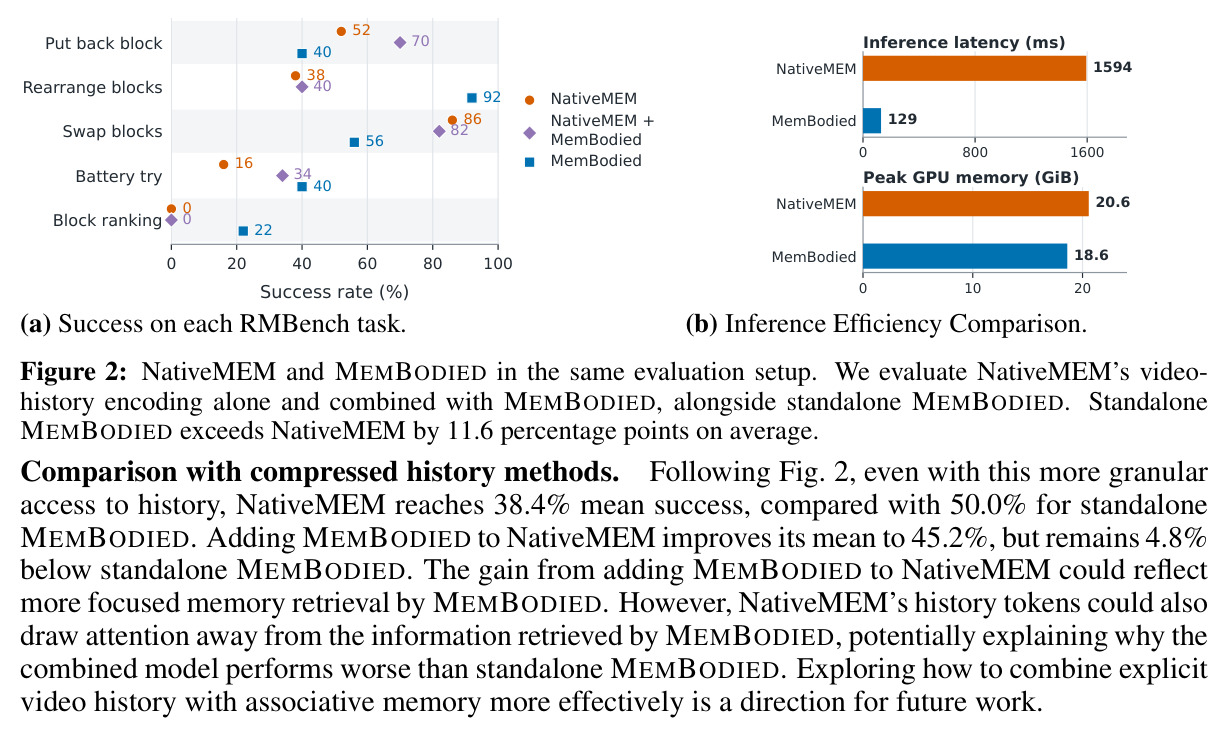
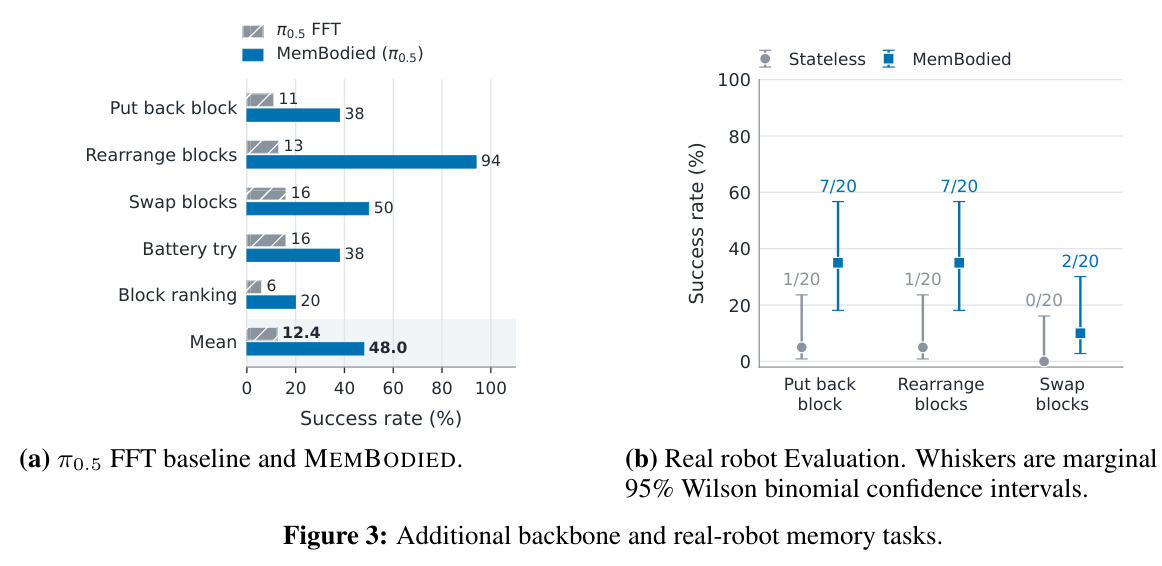
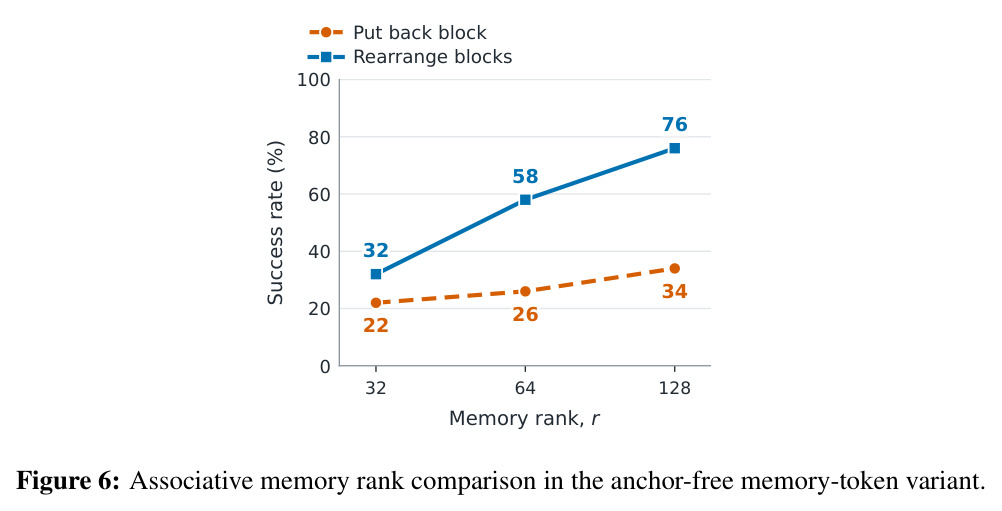
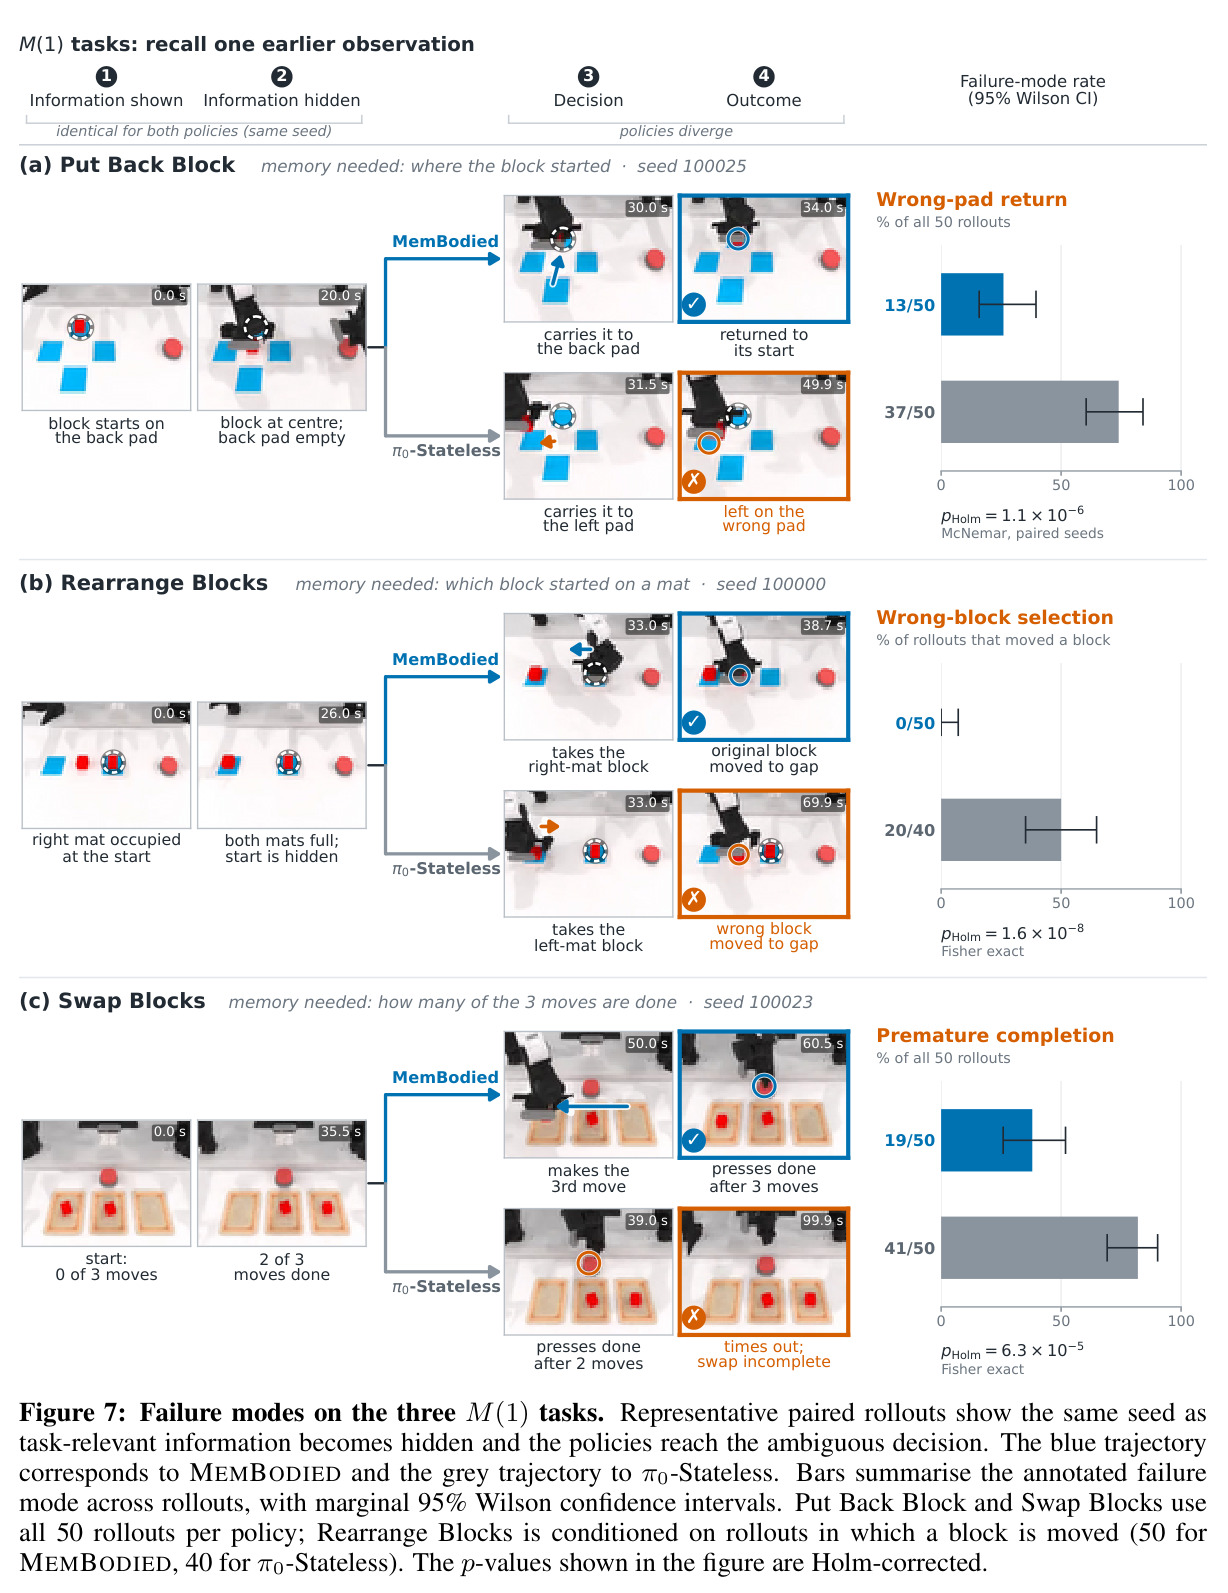
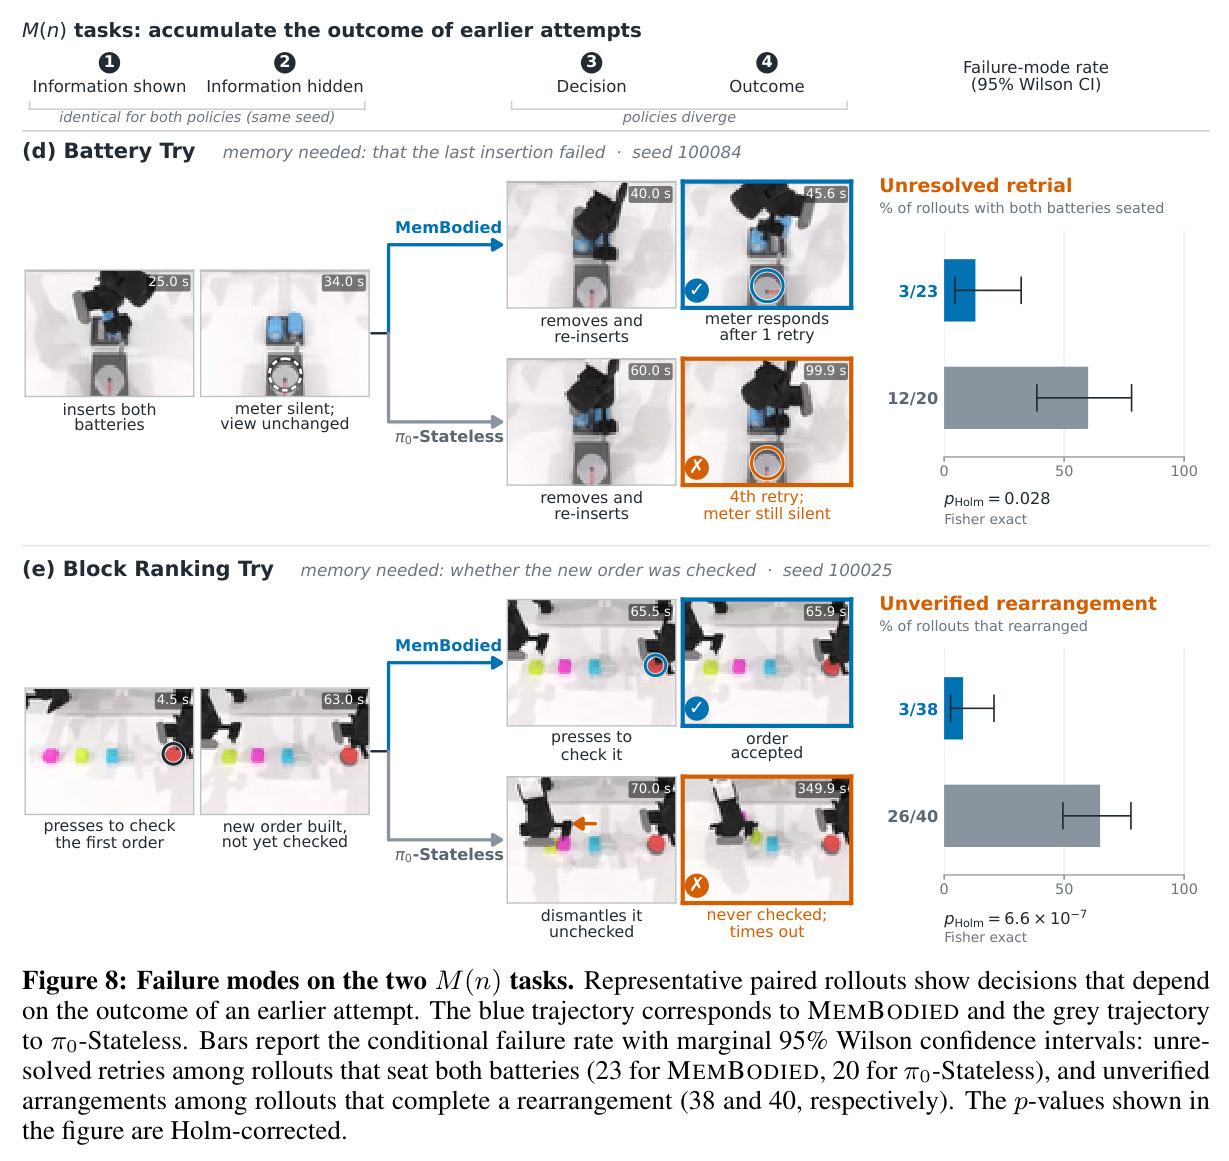
RQ1(记忆任务有效性):五个 RMBench 任务(Put back block、Rearrange blocks、Swap blocks、Battery try、Block ranking try,每任务 50 次 rollout)上,MemBodied 平均成功率 50.0%,是无记忆 $\pi_0$-Stateless(6.4%)的 7.81 倍、vanilla 循环记忆(16.8%)的 2.98 倍、$\pi_0$-FrameStack(14.8%)的约 3.4 倍;Rearrange blocks 从 2.0% 升至 92.0%,Swap blocks 从 8.0% 升至 56.0%。与最强记忆基线 NativeMEM(38.4%)相比高 11.6 个百分点(1.30 倍),且 NativeMEM+MemBodied 组合(45.2%)反而低于 MemBodied 单独使用。换 $\pi_{0.5}$ 骨干后 48.0% 对基线 12.4%(3.87 倍),五个任务全部提升,Rearrange blocks 从 13.0% 到 94.0%。真机双臂(双 AgileX PiPER)三任务各 20 次:平均 3.33%→26.67%(8 倍)。RQ2(效率):对 NativeMEM 延迟 129.2ms 对 1593.7ms(降 91.9%),峰值显存 18.61 对 20.57 GiB(降 9.5%),新增参数 40M($\pi_0$ 的 1.26%)对 415M(12.81%),约十分之一。RQ3(通用性):LIBERO 四套件全量微调,均值 95.1% 对 $\pi_0$ 的 94.2%,其中 LIBERO-Long 90.6% 高出 5.4 个百分点,Spatial/Object 微降 0.6/1.0。消融:锚点使均值 37.6%→50.0%,Swap blocks 16→56;写值消融视觉+动作 46.7% > 仅视觉 42.7% > 仅动作 34.7%;记忆秩 32/64/128 下两任务均值 27→42→55%。定性分析:Put back block 错垫归还从 37/50 降到 13/50($p<10^{-4}$),Swap blocks 过早按完成键从 41/50 降到 19/50,Battery try 在失败后通常一次重试内解决(20/23),而无记忆基线中位数要 4 次重试(8/20)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RMBench 五任务平均(记忆依赖双臂操作) | 成功率 (%) | 50.0 | $\pi_0$-Stateless 6.4;$\pi_0$-FrameStack 14.8;$\pi_0$-Vanilla Recurrent Memory 16.8;NativeMEM 38.4 | 较无记忆基线 7.81×,较 vanilla 循环记忆 2.98×,较最强记忆基线 NativeMEM 1.30×(+11.6 个百分点) |
| RMBench($\pi_{0.5}$ 骨干) | 平均成功率 (%) | 48.0 | $\pi_{0.5}$ 全量微调 12.4 | 3.87×,五个任务全部提升,Rearrange blocks 13.0→94.0 |
| 真机双臂三任务(各 20 次 rollout) | 平均成功率 (%) | 26.67 | 无记忆策略 3.33 | 8.0×,三个任务全部提升 |
| LIBERO-Long(长时程完全可观测) | 成功率 (%) | 90.6 | $\pi_0$ 85.2 | +5.4 个百分点;四套件均值 95.1 对 94.2,不损伤通用能力 |
| 推理效率(对 NativeMEM,A100 80GB,bf16) | 单策略周期延迟 / 峰值 GPU 显存 | 129.2 ms / 18.61 GiB | 1593.7 ms / 20.57 GiB | 延迟降低 91.9%,显存降低 9.5%,新增参数少一个数量级(40M vs 415M) |
局限与改进
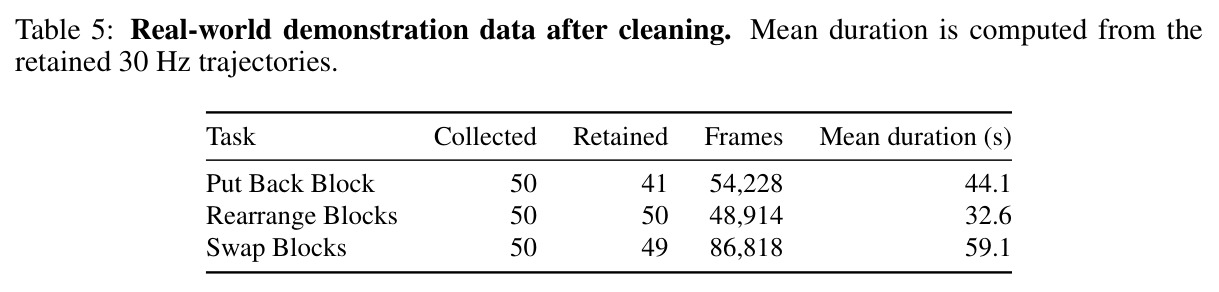
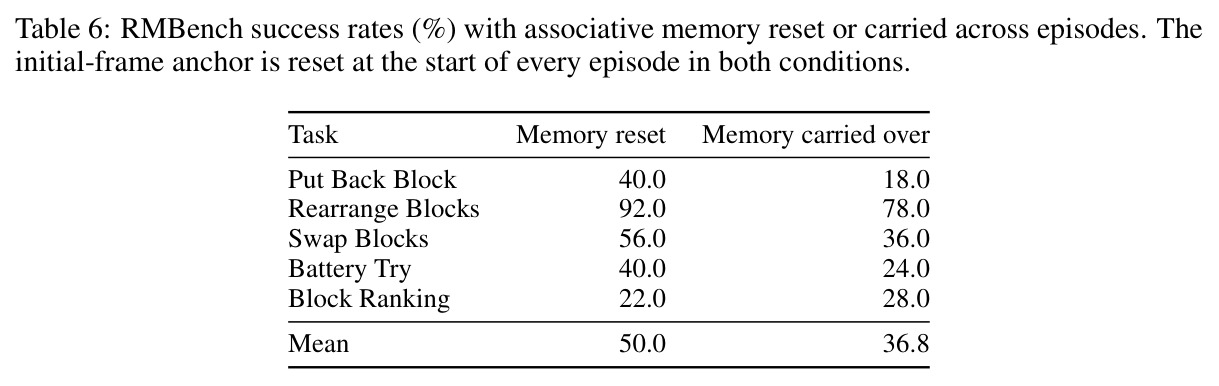
作者承认的局限:锚点并非普适——Block ranking 依赖追踪任务进展而非回忆初始场景,加锚点反而从 32.0% 降到 22.0%;压缩历史与联想记忆各有所长,没有任何方法在五个任务上全面占优(NativeMEM 在 Put back block 和 Swap blocks 上更强);$\mu$VLA 适配在共享预算下全部 0.0%,说明循环 token 方法可能需要更长训练;跨回合携带记忆使均值从 50.0% 降到 36.8%,不支持泛化的记忆继承。我观察到的:绝对成功率仍不算高,M(n) 类任务中 Block ranking try 仅 22.0%、Battery try 40.0%;剩余失败大量来自运动执行而非记忆(Put back block 的 17 次正确归垫中 14 次到位却不松爪,Battery try 的 30 次失败中 25 次是抓取/插入时掉电池),且 22 次残余记忆失败中 12 次发生在第 2 步后就按完成键,说明多次 delta 更新后的长程追踪仍会丢失信息;真机评测规模小(每任务仅 20 次 rollout、约 50 条演示);评测集中在 $\pi_0$/$\pi_{0.5}$ 两个骨干与 RMBench 一个模拟基准上。
独立分析的弱点
(1) 长程多事件记忆仍弱:delta 规则本质是有损压缩,需累积多次尝试结果的 Block ranking try 只有 22.0%,且 Swap blocks 的残余失败集中在最后一两步转换(12/22 在第 2 步后误按完成键),可引入按事件显著性调制的写入门或多条时间尺度不同的状态矩阵。(2) 写入间隔固定为一个 horizon(50 步;LIBERO 上靠 10 个槽轮转模拟),快于该间隔的关键瞬态事件可能被跳过或混叠,可做自适应写入频率。(3) 锚点假设初始场景值得全程保留,对初始布局与决策无关的任务(Block ranking 从 32.0% 降到 22.0%)是负资产,可学习『何时弃用/衰减锚点』的门控。(4) 论文自己的失败分析表明剩余瓶颈多在运动执行(不松爪、掉电池、按不到按钮),记忆模块对此无能为力,需要与更精细的低层控制协同。(5) 与 NativeMEM 的简单拼接反而从 50.0% 降到 45.2%,说明两条记忆通路会互相分散注意力,融合机制值得专门研究。(6) 训练要求梯度穿过全序列(序列长 8-18、batch 8),更长回合或更高频控制下的训练显存与时间成本论文未报告,可探索截断 BPTT 或记忆状态的离线预训练。
未来方向
作者明确提出的:更有效地结合显式视频历史与联想记忆(组合模型反而变差的现象值得深挖);改进 M(n) 类多事件累积记忆的机制。基于成果可延伸的:把锚点从『第一帧』推广为带时间戳的可学习查询,支持任意历史时刻的场景参考检索;设计带遗忘/整合机制的跨回合终身记忆(当前简单携带记忆使均值从 50.0% 降到 36.8%,说明 naive 继承有害);将同样的记忆接口迁移到导航、长程装配、双臂协作等更长 horizon 的域;在理论上分析 delta 状态在动作块粒度写入下的容量与遗忘界;在 OpenVLA-OFT、GR00T 等更多骨干上验证『memory token 注入优于注意力修正』这一接口结论的普适性;结合世界模型让写入值包含预测后果而不仅是实际观测,提升数据效率。
复现评估
开源情况良好:代码在 github.com/declare-lab/MemBodied,项目页 declare-lab.github.io/MemBodied。仿真复现的主要依赖是 RMBench(双臂模拟基准)与 $\pi_0$/$\pi_{0.5}$ 预训练权重;论文给出了完整超参:PaliGemma LoRA rank 16/$\alpha$16、动作专家 rank 32/$\alpha$32,1 万步、batch 8、峰值学习率 $2.5\times10^{-5}$ 余弦衰减(终值 $2.5\times10^{-6}$),bfloat16、EMA 0.99、梯度裁剪 1,记忆秩 $r=128$、$\alpha_{mem}=256$、锚点秩 $r_A=64$;LIBERO 为全量微调 3 万步、batch 32、五步重规划配 10 槽轮转。消融、基线实现(表 3、表 4)与推理剖析协议(A100 80GB、2548/2563 个策略周期取稳态均值)都写得具体,复现可信度高。真机部分门槛明显更高:需双 AgileX PiPER 臂、Orbbec Gemini 336L 顶相机加两个 RealSense D405 腕相机,每任务手动采集 50 条 30Hz 演示(清洗后 41-50 条)并做 20 次物理 rollout。总体判断:仿真复现难度中等(需要多卡训练 VLA),真机复现难度高。
论文图表