六层之差:面向 Whisper 的编码器剪枝与免标注恢复 Six Layers Less: Encoder Pruning for Whisper with Label-Free Recovery
按ΔWER排序剪掉Whisper编码器6层,免标注蒸馏恢复性能,端到端提速1.75倍
前置知识
WER(词错误率)
语音识别的核心评估指标,计算识别文本与参考文本之间的编辑距离(替换 S、删除 D、插入 I)占参考词数 N 的比例:$\mathrm{WER} = \frac{S+D+I}{N}$,数值越低识别越准。本文所有层重要性排序和剪枝效果都以多语言平均 WER 的变化量(ΔWER)来衡量。
本文把 ΔWER 直接当作层重要性的定义,读不懂 WER 就无法理解剪枝决策与全部实验结果。
留一层法(leave-one-layer-out)
逐个移除网络中的一层并测量任务性能变化的重要性评估方法:对 32 个编码器层分别构建删去该层的模型,实测其 WER 与完整模型的差值 ΔWER,差值小则说明该层冗余。相比基于隐状态余弦相似度的代理指标,它直接反映对最终任务的真实影响。
本文的层排序、k=6 的选择乃至悬崖现象的发现都建立在这个度量之上,是方法的第一步。
知识蒸馏
让小模型(学生)模仿大模型(教师)输出的训练范式。本文用完整编码器做教师、剪枝编码器做学生,最小化两者隐状态的均方误差 $\mathcal{L}_{MSE} = \frac{1}{n}\|\mathrm{Enc}(x) - \mathrm{Enc}_{/R}(x)\|_2^2$。所谓免标注(label-free)是指训练只需无标注音频,不需要任何人工转写文本。
零样本剪枝损失的性能正是靠这种蒸馏恢复的,理解 MSE 损失与免标注的含义是读懂方法第三步的关键。
残差连接
Transformer 每层的输出为子层输出与输入之和:$x_{l+1} = x_l + F(x_l)$,让信号可以绕过注意力/前馈模块直接向后传递。这导致深层网络中各层隐状态高度相似,也是 Whisper 编码器前中段存在大量冗余层、可以安全剪除的结构性原因。
它是本文「编码器存在大量冗余、剪掉六层影响不大」这一核心假设的机理来源。
whisper-large-v3-turbo
OpenAI Whisper 的官方加速版本:编码器保持 32 层不变,把解码器从 32 层削到 4 层,在保持较高精度的同时大幅提速。本文只动它的编码器,删 6 层后剩 26 层,与官方的解码器剪枝思路正交互补。
这是论文的全部实验对象,理解其结构和解码器已被压缩的背景,才能明白作者为何转向编码器。
FLEURS
Meta 发布的多语言语音基准,覆盖 100 余种语言的朗读式音频,常用于评估 ASR 的跨语言性能。本文取丹麦语、英语、德语、法语四个语言的测试集计算 WER,并把四语言的平均 ΔWER 作为层重要性排序的依据。
论文所有 WER 数字(18.2%、21.9%、20.1%)均来自该基准,是理解全部实验结果的载体。
研究动机
Whisper 是目前应用最广的编码器-解码器架构语音识别模型,医疗转写、实时字幕等场景强烈需要更小更快的版本。压缩 Whisper 的成功案例几乎都集中在解码器一侧:官方 whisper-large-v3-turbo 把 32 层解码器砍到 4 层,Distil-Whisper 更是只保留 2 层,换来了显著的端到端转写加速。相比之下,编码器一侧虽有不少压缩尝试,却始终没有方案被广泛采用,一个重要原因是许多压缩后的模型需要定制推理实现才能发挥优势,部署门槛高。而编码器并非不重要:实测中当 batch size 为 8 时编码器占端到端转写时间的 56%,是主要瓶颈之一。同时,残差连接使得编码器各层隐状态高度相似,大部分信号绕过注意力直接向前传递,暗示编码器内部存在大量可被安全移除的冗余层,只是缺乏可靠的方法来识别它们。
本文的目标是本文的目标是把 whisper-large-v3-turbo 的编码器变浅,而不是改造成结构怪异的压缩模型:设计一套简单可靠的层重要性排序方法,找出移除后对词错误率影响最小的若干编码器层并直接删掉,使剪枝后的模型仍然只是一个层数更少的常规编码器,可以在 Transformers 等现有推理库中原样加载、无需任何定制推理代码。同时针对零样本剪枝带来的多语言性能损失,作者希望只用无标注、单语言的语音数据做轻量知识蒸馏,在不增加任何标注成本的前提下尽量恢复性能,最终在参数量、模型体积和推理速度上给出可量化的收益,并把代码与剪枝后的模型全部开源。
与已有工作不同的是,本文切入点的独特性有三。其一,层重要性度量不走传统路线:近期工作(Hinostroza 等,2026)指出用层输入输出的余弦相似度衡量重要性并不可靠,本文改用任务级指标——留一层法计算移除每层后的词错误率变化 ΔWER,并跨丹麦语、英语、德语、法语四种语言取均值,让剪枝决策直接对齐最终评测指标。其二,多数 Whisper 压缩工作盯着解码器,本文系统性地回答了编码器能否剪、能剪多少层、边界在哪里。其三,恢复阶段用纯英文的无标注音频做 MSE 蒸馏,结果却让所有语言同步恢复,揭示免标注蒸馏恢复的是声学表征而非语言特定特征,为低资源场景提供了零标注成本的压缩-恢复范式。
核心方法
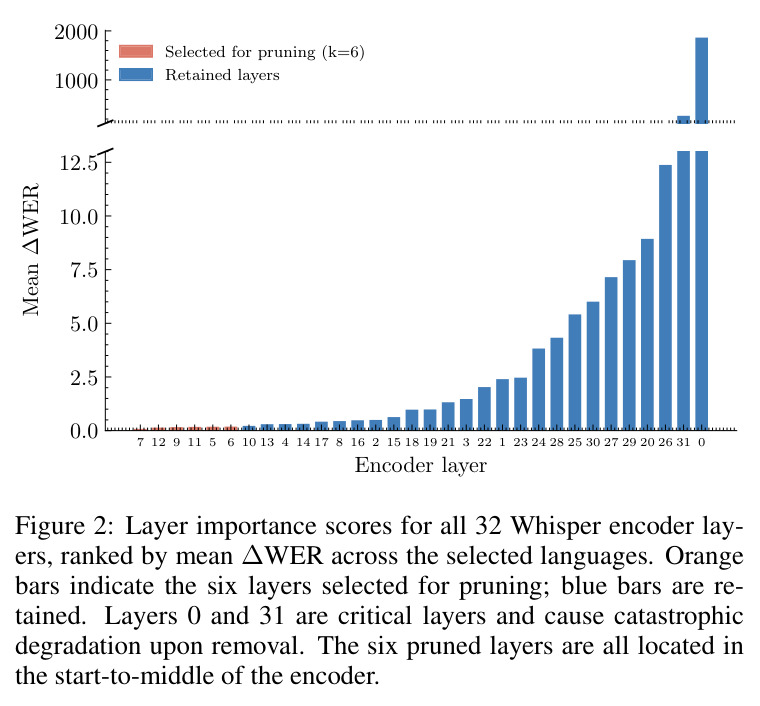
方法的直觉来自大语言模型深层冗余的发现(Gromov 等,2025):Whisper 编码器的残差连接让大部分信号直接穿过各层,隐状态在层间高度相似,因此前半段许多层可能是多余的。技术路线分三步。第一步做层重要性排序:对 32 个编码器层逐一构建留一层编码器,在 FLEURS 测试集上测丹麦语、英语、德语、法语四语言的 WER,取平均 ΔWER 排序,发现第 0 层和第 31 层是关键层,移除会灾难性退化,而网络前半段到中段最不敏感。第二步剪枝:选 k=6 个最不重要的层 $R=\{L5, L6, L7, L9, L11, L12\}$,占编码器的 18.5%,直接从 PyTorch 的 nn.ModuleList 中删掉,得到 26 层编码器。第三步免标注恢复:以完整编码器为教师、剪枝编码器为学生,用无标注音频最小化隐状态的均方误差损失 $\mathcal{L}_{MSE}(x) = \frac{1}{n}\|\mathrm{Enc}(x) - \mathrm{Enc}_{/R}(x)\|_2^2$,训练和评估全程冻结解码器。
核心创新是把层重要性的裁决权交给最终任务指标而非代理指标。传统做法比较层输入输出的余弦相似度,但近期研究表明这种度量不足以反映层的真实贡献;本文用留一层 ΔWER——每移除一层就在 FLEURS 四语言测试集上真实测一次词错误率——得到可靠的重要性排序。另一个本质区别在剪枝的产物:不是新增注意力掩码或其他需要定制推理代码的结构,而仅仅是一个 26 层的更浅编码器,可作为即插即用替代品直接跑在现有推理栈上,与 whisper-large-v3-turbo 官方削减解码器的做法天然互补。恢复阶段也别具一格:完全不需要任何转写标注,只用无标注英文语音做隐状态 MSE 蒸馏,教师与解码器全程冻结,训练半小时就把四语言平均 WER 从零样本的 21.9% 拉回到 20.1%,证明恢复的是跨语言共享的声学表征。
方法步骤详情
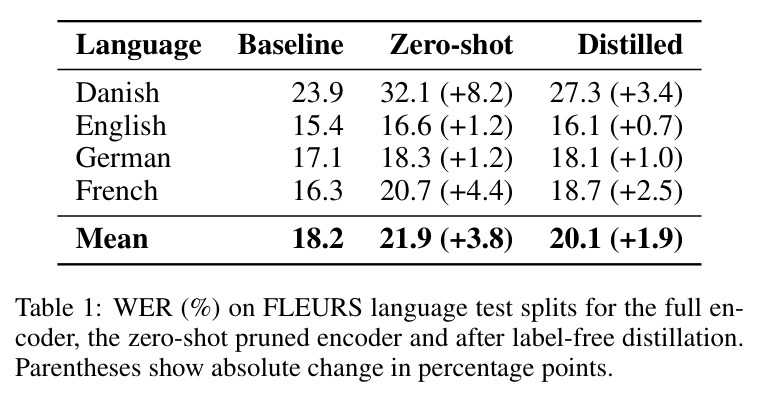
第一步,基线评估:在 FLEURS 四语言测试集上测得完整模型平均 WER 为 18.2%(丹麦语 23.9%、英语 15.4%、德语 17.1%、法语 16.3%)。第二步,重要性排序:构建 32 个留一层编码器分别测 ΔWER 并对四语言取均值,图 2 显示第 0、31 层为关键层,前中段最冗余。第三步,剪枝:选取 ΔWER 排名最低的 6 层 $R=\{L5, L6, L7, L9, L11, L12\}$,把模型编码器的 nn.ModuleList 替换为删去这 6 层的副本,得到 26 层编码器,零样本下平均 WER 升至 21.9%(+3.8 个百分点)。第四步,蒸馏恢复:用 People's Speech 验证集的无标注英文音频,冻结教师编码器与解码器,以 AdamW、batch size 8 训练学生编码器 2000 步,每 500 步评估一次确认收敛,在单张 Nvidia A100 上约半小时完成。第五步,最终评估:平均 WER 恢复至 20.1%(+1.9),并测量模型体积与 Apple M4 Pro 上的推理速度。
技术新颖性
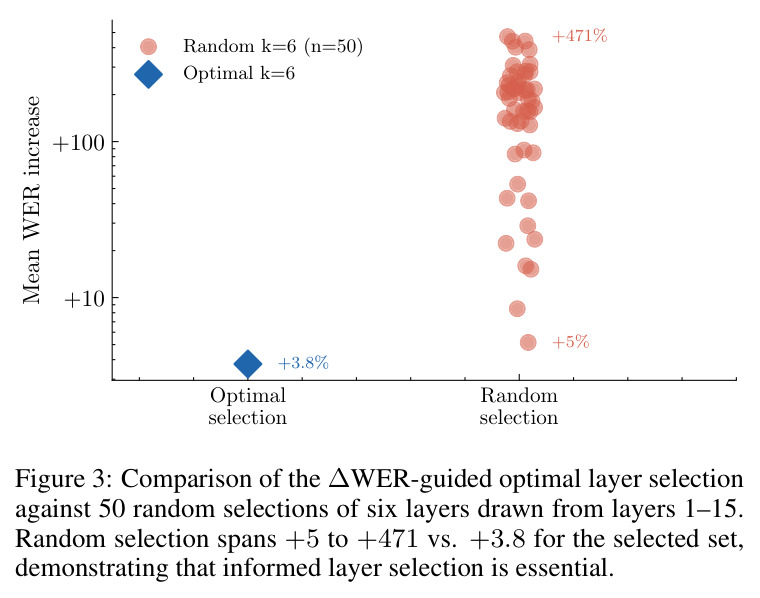
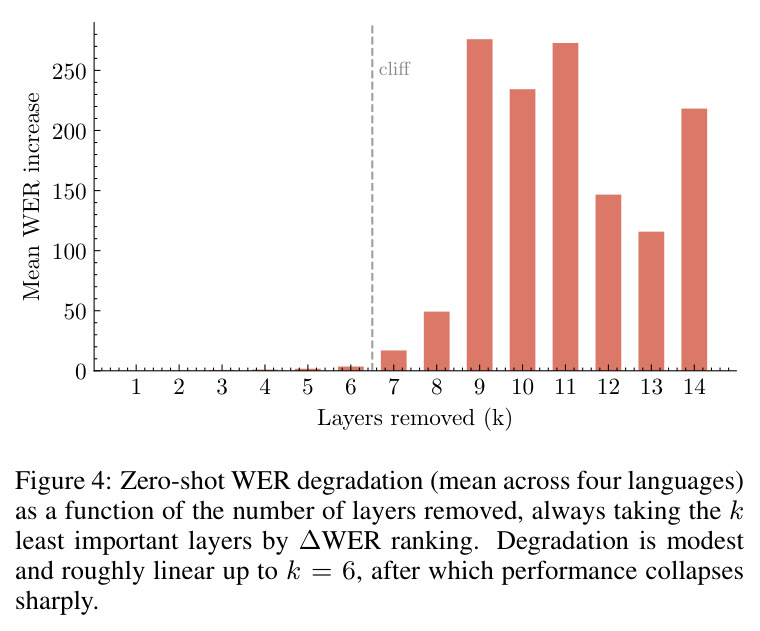
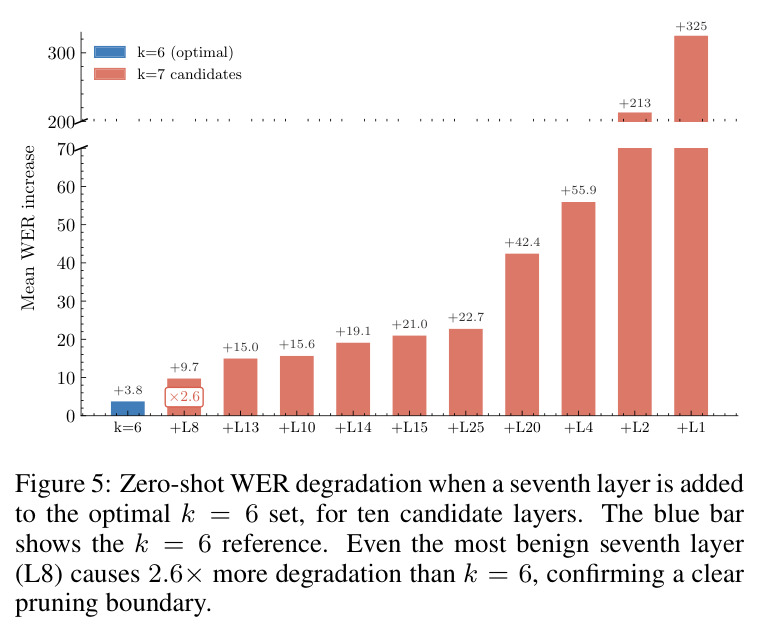
技术新颖性体现在四个方面。第一,度量方式:以 ΔWER 这一端到端任务指标替代余弦相似度做层排序,并通过随机对照实验证明其必要性——从第 1–15 层随机抽 6 层(n=50)的 WER 增幅从 +5 到 +471% 不等,而 ΔWER 选出的组合只有 +3.8%,说明冗余并非均匀分布、盲目剪枝不可行。第二,部署友好性:剪枝产物是标准浅层 Transformer,无需自定义推理实现,直接被现有框架加载,绕开了以往压缩模型难落地的症结。第三,恢复方式:仅用英文无标注数据实现多语言恢复,表明 MSE 蒸馏对齐的是声学表征而非语言特定知识,丹麦语恢复最多(+8.2 降到 +3.4 个百分点)即是证据。第四,边界刻画:发现 k=7 处存在性能悬崖,最优第七层 L8 也造成 2.6 倍于 k=6 的退化,且连续五层缺口(L5–L9)比分散剪层更可取,为后续剪枝研究提供了经验规律。
实验结果
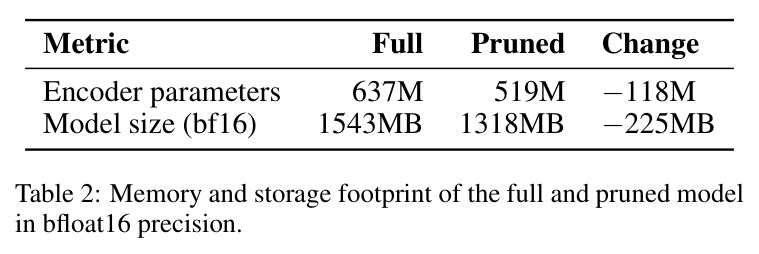
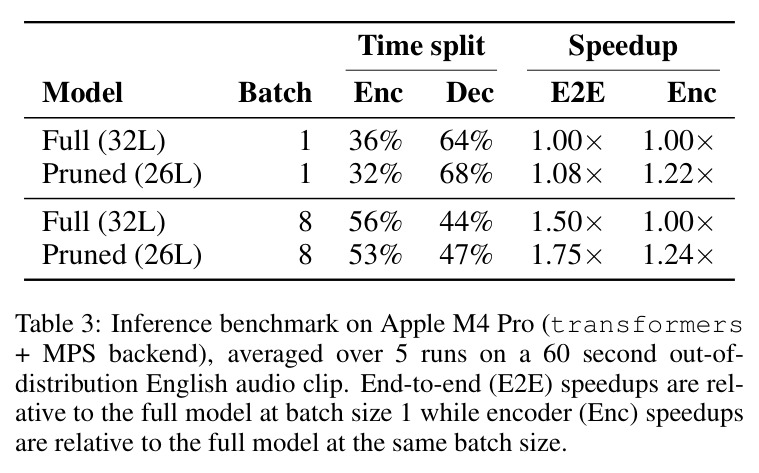
实验结果可按四组数据解读。其一,识别质量(表 1):FLEURS 四语言平均 WER 从基线 18.2%,零样本剪枝后升至 21.9%(+3.8 个百分点),蒸馏后回落到 20.1%(+1.9);分语言看,丹麦语 23.9%→32.1%→27.3%,法语 16.3%→20.7%→18.7%,英语与德语几乎完全恢复(16.1%、18.1%)。其二,体积(表 2):编码器参数从 637M 降到 519M(-118M),bf16 模型文件从 1543MB 缩至 1318MB(-225MB)。其三,速度(表 3):在 Apple M4 Pro(transformers + MPS 后端)上,编码器加速稳定在 1.22–1.24×,端到端 batch 1 为 1.08×、batch 8 达 1.75×;batch 8 时编码器占端到端时间 56%,是加速收益的主要来源。其四,敏感性与边界:层 0 和 31 移除即灾难性退化;k 从 7 增到 14 出现悬崖式恶化,最优第七层 L8 也带来 +9.7 的 WER(2.6 倍于 k=6 的 +3.8)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多语言语音识别(FLEURS 四语言测试集) | 平均 WER (%) | 蒸馏后 20.1% | 完整编码器 18.2% | 相对零样本剪枝的 21.9%,退化从 +3.8 收窄到 +1.9 个百分点 |
| 模型存储与参数量 | bf16 文件大小 / 编码器参数量 | 1318MB / 519M | 1543MB / 637M | 节省 225MB 存储,减少 118M 参数(编码器削减 18.5%) |
| 端到端推理速度(Apple M4 Pro,batch 8) | E2E 加速比 | 1.75× | 完整模型 1.00× | 编码器自身加速 1.24×,端到端提升 75% |
| 端到端推理速度(Apple M4 Pro,batch 1) | E2E 加速比 | 1.08× | 完整模型 1.00× | 编码器加速 1.22×,但受解码器占 64% 时间限制 |
局限与改进
作者明确承认的局限有二:实验只覆盖丹麦语、英语、德语、法语四种语言,更全面的语言扫描可能暴露低资源语言的风险;结论只针对 whisper-large-v3-turbo 的编码器,模型规模不同结果可能不同。此外蒸馏只用英文数据,作者猜测多语言蒸馏数据或许能进一步帮助丹麦语、法语这类受损最重的语言。我的补充观察:剪枝后平均 WER 仍有 +1.9 个百分点的差距,对精度敏感的场景未必可接受;batch 1 时解码器占端到端时间 64%,端到端加速仅 1.08×,单独剪编码器对单条音频的实时场景收益有限;ΔWER 排序需要 32 次多语言全量评估,排序本身成本不低;评测只用了 FLEURS 朗读式数据,缺乏医疗转写等真实领域验证;也没有与量化、低秩近似(如 LiteASR)等其他压缩手段做组合或对比。
独立分析的弱点
第一个弱点是重要性度量的开销与泛化性:留一层 ΔWER 要为 32 层各做一次多语言完整评估,换模型或换领域都要重跑,改进方向是用激活相似度或梯度信息做廉价初筛,再用少量 ΔWER 评估校准。第二个弱点是单条音频加速有限:batch 1 时解码器占 64% 时间、端到端仅 1.08×,应与解码器剪枝、量化或推测解码组合,让收益在低吞吐场景同样显著。第三个弱点是 k=7 悬崖缺乏机理解释,只有经验观察,可从残差流信息容量的角度建模,预测任意架构的可剪深度。第四个弱点是蒸馏后丹麦语仍差 3.4 个百分点,英语数据无法覆盖其全部声学特性,加入多语言无标注数据或语言加权损失可能收窄差距。第五个弱点是领域外风险未验证:FLEURS 是朗读式基准,而作者 affiliation 包含 Laerdal Medical(医疗设备),医疗转写等噪声真实场景的鲁棒性亟待补充评测。
未来方向
作者提出的方向有二:深入研究 k=6 之后的悬崖现象,解释为何超过该边界性能骤降;把方法推广到更现代的 ASR 模型(如 Cohere Transcribe)验证普适性。基于本文成果还可延伸:用多语言无标注数据做蒸馏,重点验证能否进一步恢复丹麦语和法语;把 ΔWER 排序与量化、低秩分解(LiteASR)等正交压缩手段叠加,追求更大的体积与速度收益;将层选择从贪心前缀扩展为组合搜索,检验连续缺口是否确实优于分散剪层,并探索非前缀组合;在 CPU、手机等资源受限设备上做系统基准;评估剪枝对语音翻译等其他任务的影响;以及把免标注蒸馏恢复范式迁移到 wav2vec 2.0、HuBERT 等其他编码器骨干,形成通用的层剪枝工具链。
复现评估
复现条件非常友好。代码开源于 GitHub(rasgaard/whisper-encoder-layer-prune),剪枝后的模型发布在 Hugging Face(rasgaard/whisper-large-v3-turbo-encoder-pruned),可直接下载即插即用。训练侧门槛很低:蒸馏仅需 People's Speech 验证集的无标注英文音频,AdamW、batch size 8、2000 步,在单张 A100 上约半小时完成,普通实验室或消费级云 GPU 都能负担。评估需要 FLEURS 四语言测试集以及 32 个留一层编码器的推理,主要开销在多次解码评估而非训练。层删除的实现也极其简单——直接把编码器的 PyTorch nn.ModuleList 替换为删去选定层的副本。总体复现难度低,唯一需要留意的是显存占用(bf16 下完整模型约 1.5GB)与长音频解码的耗时。
论文图表
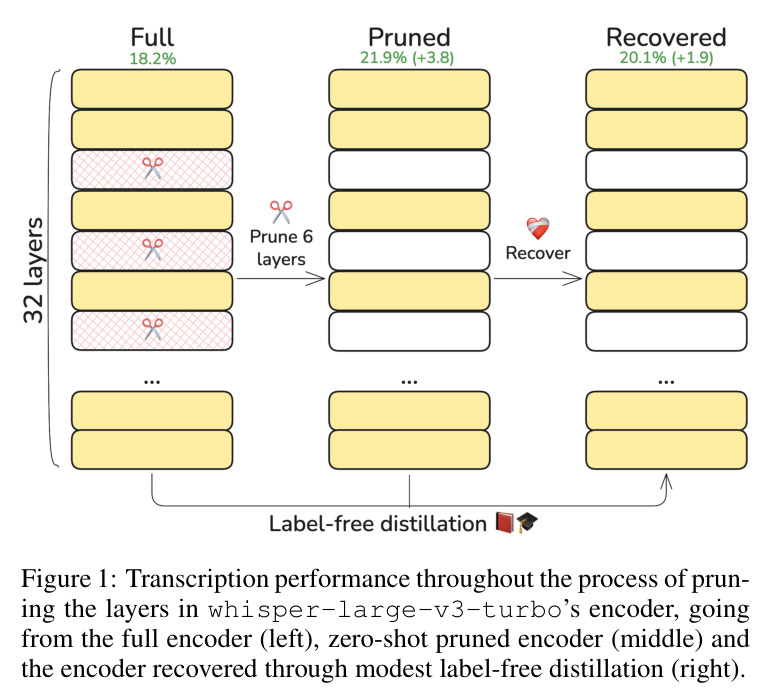
三联图直观对比剪枝全流程三个阶段的转写性能:完整 32 层编码器、零样本剪掉 6 层后的 26 层编码器、以及经免标注蒸馏恢复后的版本,展示出「剪枝导致退化、蒸馏挽回大部分损失」的整体叙事。
这是全文的概览图,读者一眼即可看懂方法的三段式流程和最终净效果,是理解论文故事线的入口。