Hunyuan-A13B 技术报告:80B 总参数仅激活 13B 的高效混合专家大语言模型 Hunyuan-A13B Technical Report
腾讯混元开源 MoE 模型:800 亿总参仅激活 130 亿,性能对标更大模型
前置知识
混合专家架构(MoE)
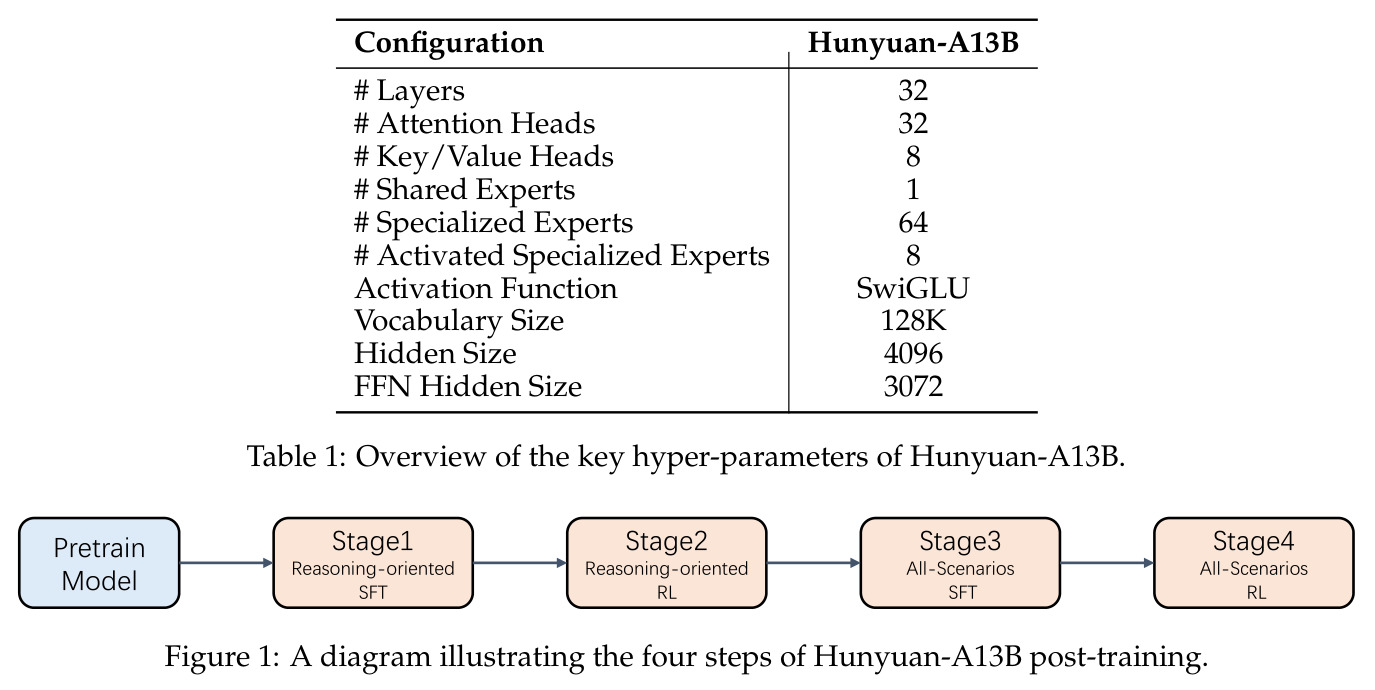
一种稀疏激活架构:把 Transformer 每层的 FFN 换成多个并列的'专家'子网络,由路由器为每个 token 只挑选少数专家计算,其余专家不参与前向传播。本文采用 1 个常驻共享专家加 64 个细粒度专家、每 token 激活 8 个非共享专家,实现 80B 总参数但仅 13B 激活参数,用小计算量撑起大模型容量。
全文反复出现'总参数 vs 激活参数'的对比逻辑(80B/13B),模型的效率主张和所有基准结论都建立在对 MoE 工作机制的理解之上。
分组查询注意力(GQA)
多头注意力的一种省显存变体:让多个 Query 头共享同一组 Key/Value 头。本文模型有 32 个注意力头但只有 8 个 KV 头,KV Cache 体积缩为原来的约 1/4,推理吞吐显著提升,而质量损失很小,是长上下文场景的标配技术。
论文声称的 256K 上下文与高吞吐(Table 7)都依赖 KV Cache 的压缩,理解 GQA 才能明白推理效率从何而来。
GRPO(组相对策略优化)
DeepSeek 提出的强化学习算法:对同一提示采样一组回答,用组内奖励减去组均值得到相对优势来更新策略,无需训练独立的价值网络,训练开销低于 PPO。本文在此基础上进一步移除 KL 散度约束,配合结果奖励模型与代码沙箱反馈训练数学、代码、逻辑、科学四域推理。
推理导向 RL(3.1.2 节)是本文后训练的核心环节,GRPO 及其'去 KL 约束'改动直接决定了模型 AIME 等基准的提分来源。
NTK-aware 位置编码外推
对 RoPE 旋转位置编码的高频分量做非线性缩放(引入标量 alpha),使主要在短上下文上训练的模型无需海量长文本训练即可外推到更长窗口。本文预训练后用 alpha=50 扩到 32K、alpha=1000 扩到 256K。
长上下文三阶段训练(2.3 节)和 RULER 基准上'衰减最平缓'的表现都依赖这一外推技术,不理解它就看不懂 256K 上下文是怎么来的。
双模式思维链(Dual-CoT)
在同一模型内实现两种推理深度:慢思考在 块中显式生成逐步推理,快思考则将该块刻意留空、直接给出答案;用户通过 /think 与 /no think 控制标签切换,缺省为慢思考。两种模式的数据在后训练中统一格式联合优化。
这是本文最重要的产品级创新,也是理解 Table 3(慢思考)与 Table 4(快思考)两套成绩为何差距巨大的关键。
生成式奖励模型(GRM)
用大语言模型担任'裁判':将候选回答与参考答案(开放式任务)或标准答案(确定性任务)对比,生成评估意见与奖励分数;还可选读思维链、调用外部工具、核对长度与格式约束。相比固定规则奖励,能覆盖创意写作等开放式生成的质量评估。
全场景 RL(3.2.2 节)靠 GRM 加 16 个子领域、30 多个打分服务构成奖励体系,这是 Agent 与通用能力后训练的技术底座。
研究动机
当前最强的大语言模型(GPT-4o、o1/o3、Gemini 2.5、DeepSeek-R1、Qwen3)虽然能力步步逼近 AGI,但部署代价极高:稠密架构(如 Qwen2.5-72B,72B 参数全量激活)每次推理都要跑完所有权重;即便是 MoE 模型,Hunyuan-Large 也需要 389B 总参、52B 激活参数,显存占用和硬件成本令中小企业与个人研究者难以承受,推理延迟也限制了实时场景。另一方面,以长思维链见长的推理模型在处理简单问询时也会生成冗长的推理过程,把低延迟应用的体验拉垮。数学、代码、Agent 等高价值能力的提升,往往以参数规模和推理开销的爆炸式增长为代价,'性能与效率不可兼得'成为开源社区的核心痛点。
本文的目标是本文的目标是构建并开源一个高效且能力全面的大语言模型 Hunyuan-A13B:采用稀疏混合专家架构,总参数 800 亿、每次推理仅激活 130 亿,在大幅降低推理成本的前提下达到与更大模型相当的水平。具体拆解为四点:(1) 在 20T token 精筛语料(其中 STEM 高质量数据达 2500 亿 token)上预训练,抬高推理与事实性上限;(2) 通过'推理 SFT → 推理 RL → 全场景 SFT → 全场景 RL'四阶段后训练,系统强化数学、代码、逻辑、科学推理以及 Agent 工具调用能力;(3) 引入双模式思维链,让同一个模型能在低延迟'快思考'与深度'慢思考'之间按需切换;(4) 把上下文窗口扩展到 256K 并优化推理吞吐,适配延迟敏感与资源受限场景,最终将模型开源回馈社区。
与已有工作不同的是,本文的切入点不是单一算法突破,而是'小激活大能力'的系统化工程组合。首先,基于 MoE 缩放律实验确立了'1 个共享专家 + 64 个细粒度专家、每 token 仅激活 8 个'的配置——实验发现没有共享专家的模型明显变差,而共享专家超过 1 个后收益递减甚至波动,这为 MoE 设计提供了可复用的经验法则。其次,双模式 CoT 用同一个 块的有无(空块 vs 填充推理)在单一模型内统一快慢两种推理,用户以 /no think、/think 标签切换,免去了维护两个模型的成本。第三,Agent 能力被提到战略高度:五角色(用户/规划器/工具/Agent/检查器)合成数据引擎、约 20000 种工具格式组合、覆盖 16 个子领域的 30 多个打分服务,使这个仅 13B 激活参数的模型在 BFCL v3、τ-Bench 等 Agent 基准上反超数倍规模的对手。
核心方法
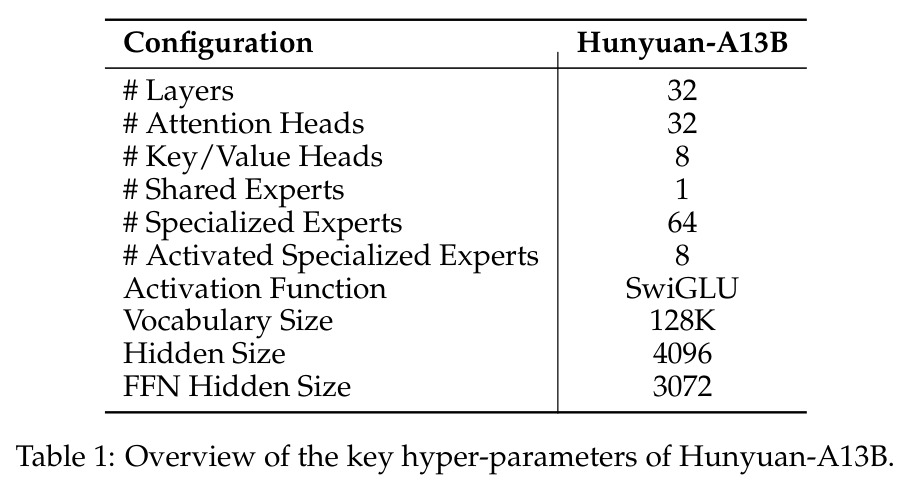
整体思路的直觉是'用更少的激活算力,换更好的数据和训练流程'。技术上,模型采用细粒度 MoE:32 层、32 个注意力头(GQA,8 个 KV 头)、隐藏维 4096、FFN 隐藏维 3072、SwiGLU 激活、128K 词表;每层含 1 个常驻共享专家与 64 个细粒度专家,训练时每 token 激活 8 个非共享专家,合计 13B 激活 / 80B 总参。训练流水线分两段:预训练沿用 Hunyuan-TurboS 的数据管线(去重、低质过滤、去噪、主题标注、模型抽取纯文本、语义级去重),并重点强化 STEM 数据的获取与清洗;随后经历基础训练(20T token)→ 快速退火(300B token)→ 长上下文扩展(32K→256K)三阶段。后训练按 Figure 1 所示四步推进:推理导向 SFT → 推理导向 RL → 全场景 SFT → 全场景 RL,全程以双模式 CoT 的统一格式组织数据。
核心创新有三。第一,MoE 结构经验法则:通过缩放实验发现共享专家'有一个很关键、多于一个没必要',据此确定 1+64(激活 8 个)的配置,并以 GQA 降低 KV Cache 开销。第二,双模式思维链:不同于为快慢推理分别训练两个模型,本文在后训练时用统一结构化格式同时优化两种模式——快思考样本的 块刻意留空,慢思考样本填入逐步推理,用户以 /no think、/think 控制标签选择,缺省慢思考;同一模型按任务复杂度动态分配'思考预算'。第三,推理 RL 基于 GRPO 但移除 KL 散度约束,允许更灵活的策略更新,配合 on-policy、大批量、高 rollout 数和 0.6-0.8 的较低采样温度,并在 24K→32K 两阶段上下文课程中系统性加深推理链,奖励只来自结果校验(ORM 二值奖励 + 36 语言代码沙箱),杜绝猜测得分的可能。
方法步骤详情
完整流程与输入输出:(1) 预训练数据:多源语料经去重、低质过滤、去噪、主题标注、模型抽取与语义级去重,输出 20T token,其中强化 STEM 清洗得到 2500 亿 token,并建立知识标注与多维难度分级体系用于选料。(2) 基础训练:学习率从 0 线性预热至 $3 \times 10^{-4}$,在 13.5T token 上余弦衰减至 $3 \times 10^{-5}$ 后保持,上下文固定 4096。(3) 快速退火:300B token 内余弦衰减至 $8 \times 10^{-6}$,上下文升至 8192。(4) 长上下文扩展:NTK-aware 位置编码,alpha=50 扩到 32K、alpha=1000 扩到 256K。(5) 推理 SFT:数学(教材/竞赛题,奖励模型迭代校验)、代码(GitHub 转指令对,沙箱执行验证)、逻辑(ZebraLogic 式合成+人工复核)、科学(LLM 验审单位换算与化学记号)四域长 CoT 数据。(6) 推理 RL:GRPO,150K 样本(数学:代码:逻辑:科学=2:2:1:1,10% 与 SFT 重叠),排除选择题/判断/证明题,移除 KL 约束,24K→32K 两阶段上下文课程。(7) 全场景 SFT+RL:语言理解、创意写作、多语言、复杂指令、角色扮演、知识问答、多轮对话、Agent 八大类数据(Agent 用五角色数据引擎与约 20000 种工具格式组合),RL 用 GRM 双信号(正确性+风格质量)覆盖 16 子领域、30+ 打分服务。
技术新颖性
与已有工作的本质区别:(1) 相对 Qwen3-A22B(235B 总参/22B 激活)和更大的稠密模型,本文以 80B/13B 的更小配置在 AIME2024(87.3 分全场第一)和 Agent 基准(BFCL v3 78.3)上反超,证明'数据质量 + 训练课程'可在相当程度上替代参数规模,而非单纯堆参数;(2) 双模式 CoT 虽与 Qwen3 的 hybrid thinking 思路相近,但本文进一步把两种模式的数据在 SFT 与 RL 中联合优化,用空 块作为显式格式约定,训练与推理协议简洁统一;(3) 推理 RL 移除 KL 约束、专门从 SFT 模型表现不稳定的样本中采题(10% 与 SFT 重叠、90% 新题),并排除不可验证题型以保证奖励信号干净,这些细节在同类报告中披露得更具体;(4) 全场景 RL 的'GRM + 16 子领域 × 30+ 打分服务'奖励矩阵,以及五角色 Agent 数据引擎,是对 Agent 后训练工程的一次罕见的完整公开。
实验结果
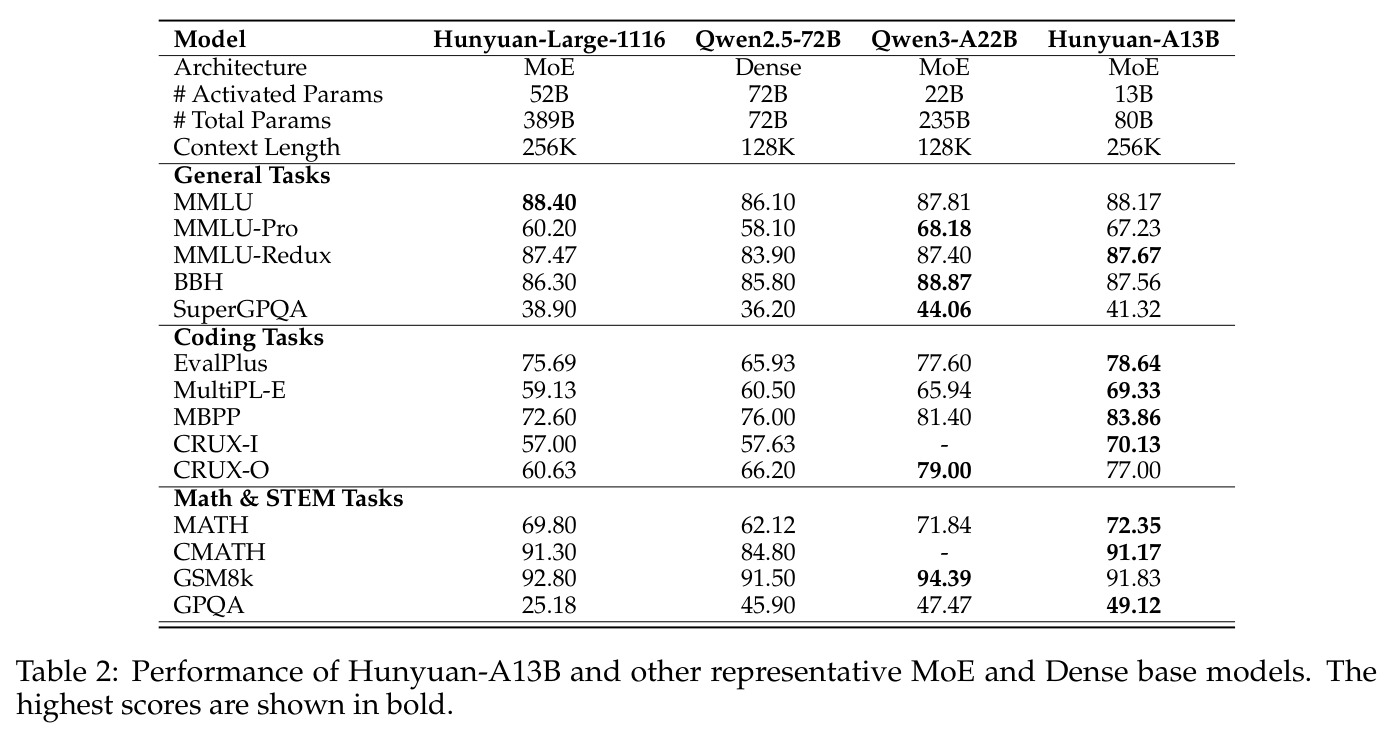
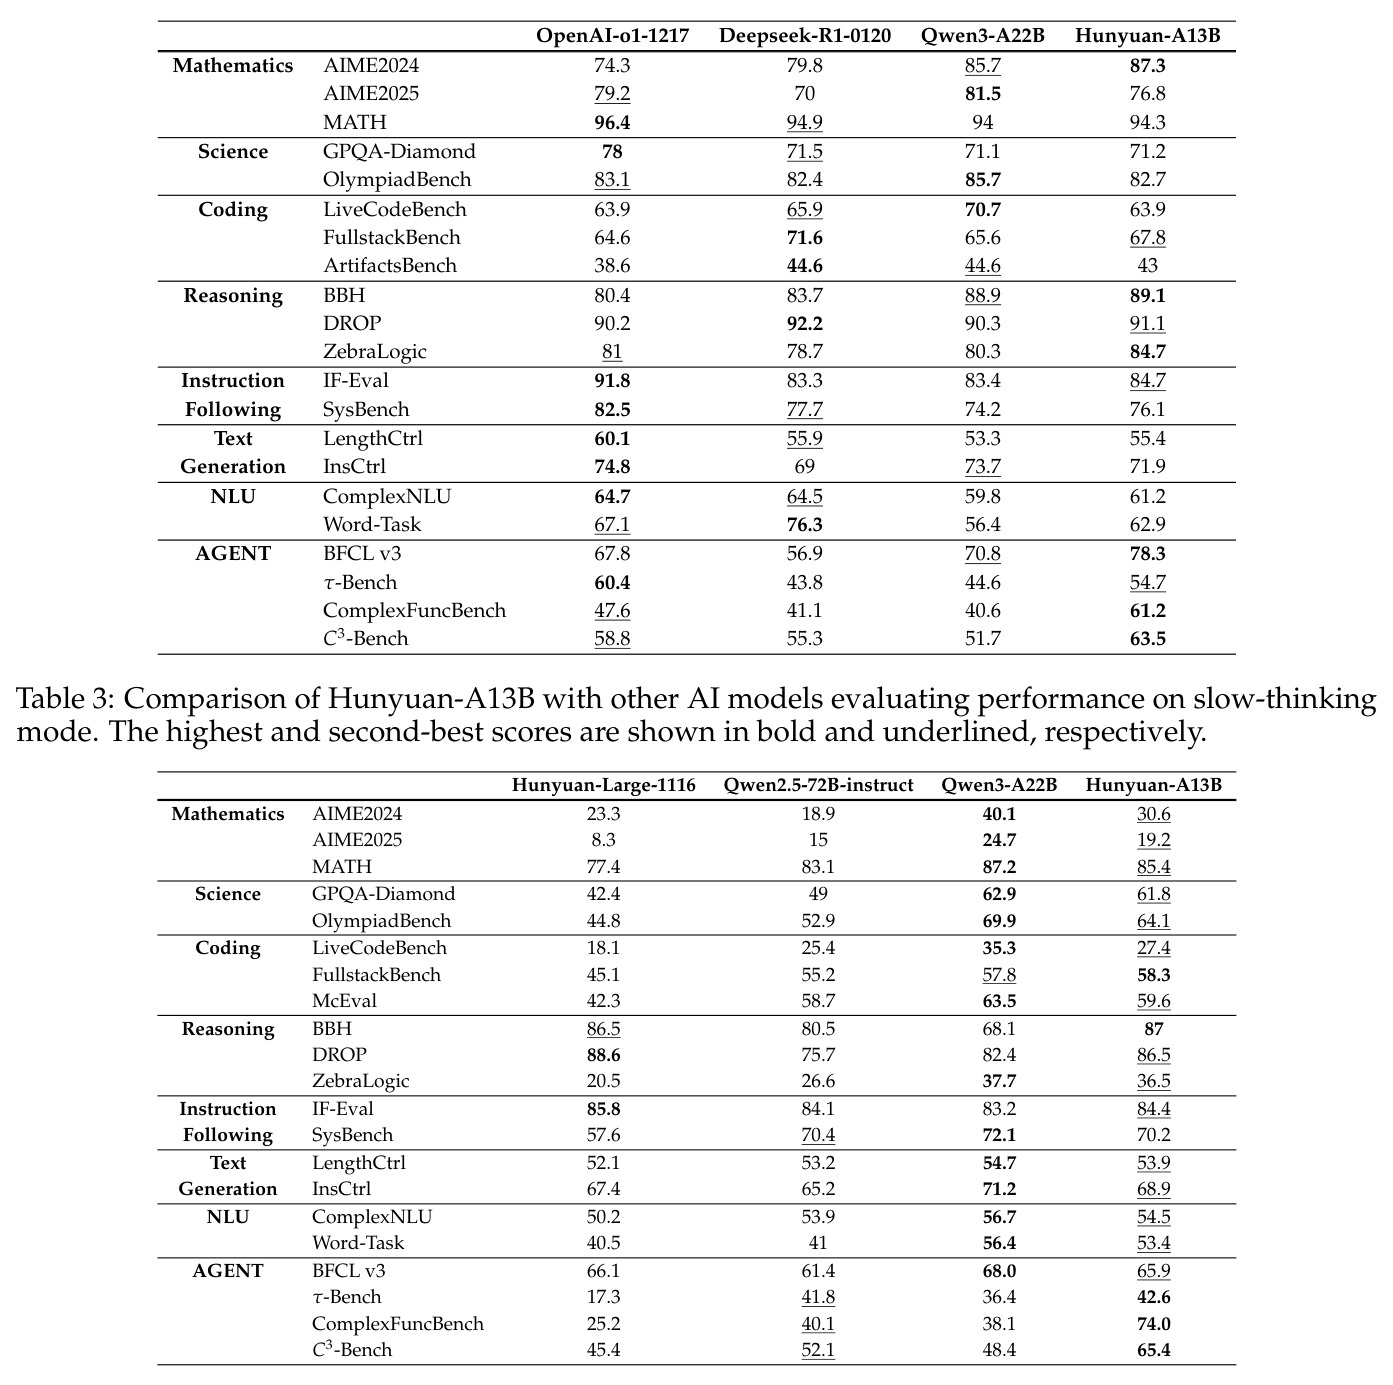
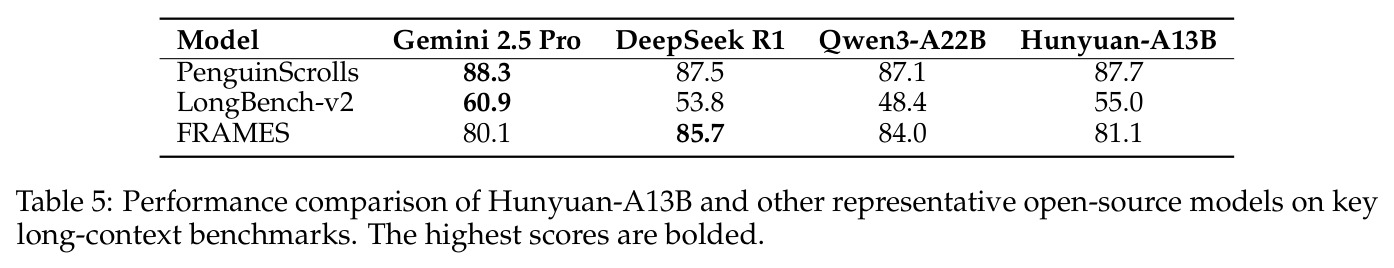
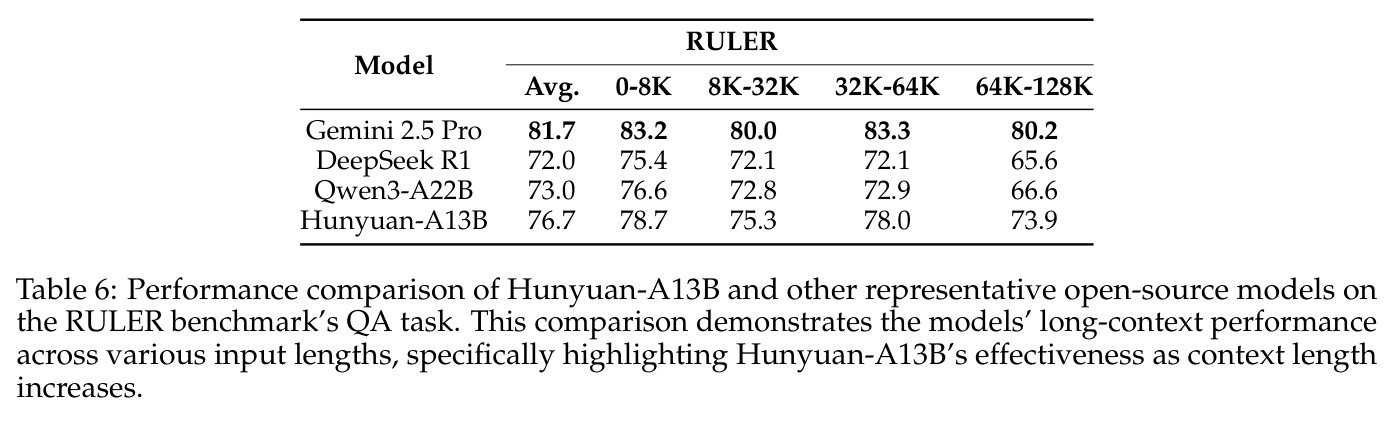
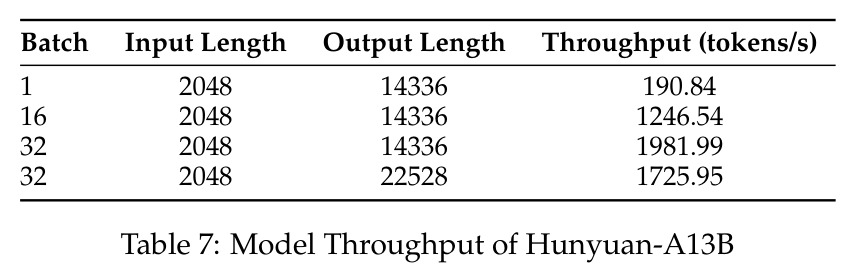
基座模型(Table 2):以约 1/4 激活参数在 14 项基准中 12 项超过 Hunyuan-Large(MMLU 88.17 vs 88.40,MATH 72.35 vs 69.80);较总参相近的稠密 Qwen2.5-72B 几乎全面领先(GPQA 49.12 vs 45.90);与总参 3 倍、激活 2 倍的 Qwen3-A22B 在可比 12 项中赢 7 项(EvalPlus 78.64 vs 77.60,MBPP 83.86 vs 81.40)。慢思考模式(Table 3):AIME2024 得 87.3 全场最高(o1-1217 为 74.3、DeepSeek-R1 为 79.8、Qwen3-A22B 为 85.7),BBH 89.1、ZebraLogic 84.7 均列第一,MATH 94.3、GPQA-Diamond 71.2 逼近 o1;Agent 四项全面领先:BFCL v3 78.3、τ-Bench 54.7、ComplexFuncBench 61.2、C3-Bench 63.5。快思考模式(Table 4)下 ComplexFuncBench 仍达 74.0、C3-Bench 65.4,大幅领先所有对比模型,但 AIME2024 降至 30.6,暴露模式切换代价。长上下文(Table 5/6):PenguinScrolls 87.7 逼近 Gemini 2.5 Pro(88.3),LongBench-v2 55.0 为开源最佳,RULER QA 平均 76.7,且在 64K-128K 区间保持 73.9(R1 仅 65.6、Qwen3 66.6),衰减最平缓之一。推理效率(Table 7):batch=1 吞吐 190.84 tokens/s,batch=32 达 1981.99 tokens/s,配合 INT8/W8A8/KV FP8 量化可进一步压成本。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学竞赛推理(指令模型,慢思考) | AIME2024 准确率 | 87.3 | OpenAI o1-1217 74.3;DeepSeek-R1 79.8;Qwen3-A22B 85.7 | 较最强开源对手 Qwen3-A22B 高 1.6 分,较 o1 高 13 分,全场第一 |
| 通用知识(基座模型) | MMLU(5-shot) | 88.17 | Hunyuan-Large 88.40(52B 激活);Qwen2.5-72B 86.10 | 以 1/4 激活参数追平 52B 激活的 Hunyuan-Large,超过 72B 稠密模型 2.07 分 |
| 代码生成(基座模型) | EvalPlus(0-shot) | 78.64 | Qwen3-A22B 77.60;Hunyuan-Large 75.69 | 超过激活参数近 2 倍的 Qwen3-A22B 1.04 分 |
| 工具调用 / Agent | BFCL v3 准确率(慢思考) | 78.3 | Qwen3-A22B 70.8;OpenAI o1-1217 67.8 | 较 Qwen3-A22B 高 7.5 分,较 o1 高 10.5 分 |
| 长上下文稳健性 | RULER QA 平均(64K-128K 区间) | 73.9 | DeepSeek-R1 65.6;Qwen3-A22B 66.6;Gemini 2.5 Pro 80.2 | 在最长区间领先开源对手约 7-8 分,仅次于 Gemini 2.5 Pro |
| 推理吞吐 | tokens/s(batch=32,输入 2048/输出 14336) | 1981.99 | batch=1 时为 190.84 tokens/s(同模型自身对比) | 批量扩展下吞吐提升约 10.4 倍,体现 13B 激活的部署经济性 |
局限与改进
作者承认的局限与笔者的补充观察:(1) 代码是相对短板——慢思考 LiveCodeBench 仅 63.9,明显低于 Qwen3-A22B 的 70.7,论文将其归因于参数规模但未做专项分析;(2) AIME2025 得 76.8,低于 Qwen3-A22B 的 81.5,说明竞赛级数学并非全面领先;(3) GPQA-Diamond 71.2 低于 o1 的 78,与顶尖闭源模型在科学知识上仍有差距;(4) RAG 型长上下文偏弱,FRAMES 得 81.1,落后 DeepSeek-R1 的 85.7,作者也承认有改进空间;(5) 大量内部基准(LengthCtrl、InsCtrl、ComplexNLU、Word-Task 及'即将公开'的 ArtifactsBench)不对外开放,第三方无法复核。笔者的观察:报告缺少预训练与 RL 的消融实验和总算力(GPU 数 × 时长)披露,双 CoT 对最终成绩的贡献没有被单独量化;快慢模式差距过大(AIME2024 从 87.3 跌至 30.6),说明模式选择策略仍显粗糙;模型为纯文本,无多模态;安全性仅有训练流程描述、没有基准数字。
独立分析的弱点
独立弱点分析:(1) 快慢模式能力断层过大——慢思考 AIME2024 为 87.3,快思考骤降到 30.6,MATH 也从 94.3 降到 85.4,一旦用户误用 /no think 或系统误判任务难度就会灾难性掉分;改进方向是引入可学习的难度感知路由,例如在快思考输出上估计不确定性,超阈值自动回退慢思考。(2) 代码生成偏科——LiveCodeBench 63.9 落后 7 分,建议在 RL 阶段加入对抗性测试用例生成与仓库级多文件任务,并把沙箱反馈从'通过/不通过'扩展为定位错误的原因信号。(3) 评估可信度风险——内部基准占比高且不公开,容易被视为择优报告,应开源评测集、提示词与判分脚本。(4) 缺多模态与安全量化——对齐只给了训练流程描述,建议补充 SafetyBench 类基准的量化结果。(5) 长上下文验证不彻底——NTK-aware 插值只测到 128K,256K 端到端表现未报告,建议公开全窗口压力测试与位置编码 alpha 的消融。
未来方向
作者明确提出的后续工作:公开 ArtifactsBench 前端代码生成评测基准,并持续改进 RAG 场景的长上下文处理。基于本文成果可延伸的方向:(1) 把双 CoT 的模式选择从人工标签升级为模型自主决策(自适应计算/元认知),在保留快模式低延迟的同时修复难题大幅掉分问题;(2) 将 GRPO + 无 KL 约束的 RL 配方迁移到多模态与工具学习,探索 Agent 奖励的自动化构造,减少 30+ 打分服务的人工维护成本;(3) 五角色数据引擎可泛化为可配置的合成环境生成器,训练更复杂的多轮多智能体协作;(4) 80B/13B 的成功暗示继续压缩激活比(如 10% 以下)的 MoE 缩放律研究值得做;(5) 借鉴 2500 亿 STEM 语料的清洗经验,构建跨领域数据质量自动评估闭环;(6) 模型已支持 W8A8/KV FP8 与 TP/EP,可进一步向端侧和边缘部署的极限量化(INT4/AWQ)延伸。
复现评估
复现评估:模型权重已在 HuggingFace 开源,官方适配 vLLM、SGLang、TensorRT-LLM 一键部署,提供 W16A16 及 Weight-Only INT8、W8A8、KV Cache FP8 量化,并支持 TP/EP/FusedMoE 加速,推理复现门槛低——单张 80GB 级 GPU 即可跑通推理并复现 Table 7 量级的吞吐测试,公开基准也可按论文标注的 few-shot 设置(MMLU 5-shot、GPQA 5-shot CoT 等)用 lm-evaluation-harness 类框架复核,难度中等。但完整复现训练几乎不可行:20T token 预训练与两轮大规模 RL 的算力未披露(估计需数千张 GPU 运行数月),预训练语料、150K RL 样本及八大类全场景 SFT 数据均未开放;LengthCtrl、InsCtrl、ComplexNLU、Word-Task 等 12 项内部基准与尚未发布的 ArtifactsBench 缺少评测脚本,这部分结论只能按作者口径引用。总体属于'模型可复用、结论部分可验证、训练不可复现'的典型工业界技术报告。
论文图表
快思考模式下的同套基准对比:MATH 85.4、BBH 87、ComplexFuncBench 74.0、C3-Bench 65.4 仍大幅领先,但 AIME2024 从慢思考的 87.3 骤降至 30.6,MATH 也降约 9 分。
与 Table 3 对照才能看清双模式 CoT 的收益与代价:低延迟模式下简单任务保持强势,但难题掉分严重,这直接影响部署时的模式选择策略。