onPanda:基于 Token 级修正的 LLM 与 Agent 在策略对齐数据高效标注工具 onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correction
用定位-修正-继续的Token级循环标注对齐数据,时间降52%且保持on-policy分布
前置知识
On-policy 与 Off-policy 数据
on-policy 指训练数据由当前(或标注时的)策略模型自身采样生成,与模型分布一致;off-policy 数据则来自其他模型或大幅人工改写,与 rollout 分布存在偏移。SFT 在 on-policy 数据上训练更贴近模型自身行为分布,能减少 exposure bias 带来的误差累积。
本文的核心卖点就是标注工具产出的数据 97.0% 的 token 由模型自生成、保持 on-policy 属性,理解这一概念才能读懂 PPL 保真度实验的设计与结论。
Token 级 logprobs 与 top-k 候选
语言模型每步输出词表上的概率分布,logprobs 是其对数形式;top-k 候选指概率最高的 k 个 token(本文默认 k=20)。推理框架(如 vLLM、SGLang)可在流式生成时返回每个位置的采样概率与候选列表,这是概率可视化与候选点选修正的基础。
onPanda 的整套交互——概率着色、候选弹窗、修正三元组——都建立在 logprobs 之上,这也是论文承认的工具对推理 API 的两项硬性依赖之一。
SFT 与偏好数据
SFT(监督微调)用 (prompt, 合格回答) 对直接训练模型模仿目标行为;偏好数据则是同一 prompt 下成对的正/负回答,用于训练奖励模型或 DPO 等偏好优化方法。两者是 RLHF 后训练的两大数据形态,成本与监督粒度各不相同。
onPanda 的标注树每次修正自动保留正负分支,可同时导出 SFT 样本与响应级偏好对(实验中平均每 prompt 7.43 对),理解两类数据才能明白其数据协议设计的意义。
困惑度 PPL
困惑度 $\mathrm{PPL} = \exp\left(-\frac{1}{N}\sum_{i=1}^{N}\log p(x_i|x_{<i})\right)$ 衡量语言模型对一段文本的预测难度,PPL 越低说明文本越落在模型自身分布内。本文用 rollout 模型给各方法产出打分,以相对重采样基线的偏移衡量 on-policy 保真度。
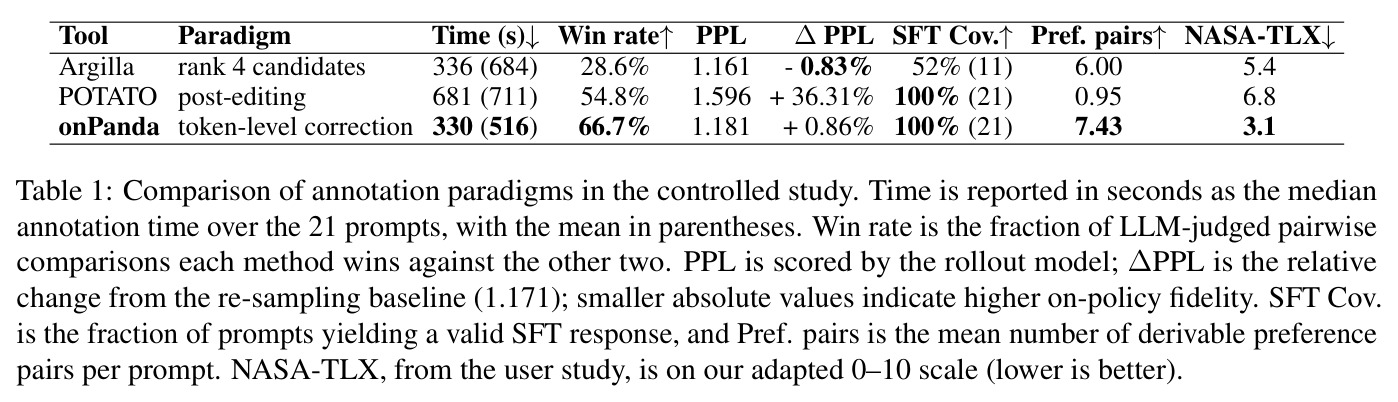
Table 1 中 $\Delta$PPL 的对比(onPanda +0.86% vs POTATO +36.31%)是保真度主张的关键定量证据,不懂 PPL 就无法评估该实验的说服力。
MCP 与 Agent 轨迹标注
MCP(Model Context Protocol)是连接 LLM 与外部工具/环境的标准协议。Agent 轨迹由多步'推理-工具调用-环境反馈'构成,标注时任何修正都必须真实执行工具、拿到反馈之后生成才能继续,因此比纯文本标注复杂得多。
onPanda 通过 MCP 接入外部环境,并用 harness_to_mcp 适配器把 Claude Code/Codex/OpenClaw 包装成 MCP 服务器,这是其支持交互式 agent 轨迹标注的核心机制。
NASA-TLX 工作量量表
NASA-TLX 是经典的任务负荷主观量表,从心理需求、时间需求、绩效、努力程度、挫败感等 6 个维度评估认知负荷。本文采用适配版 0-10 打分,对每个标注者取 6 维平均再跨人平均,分数越低代表负荷越小。
用户研究用 NASA-TLX 量化三个标注平台的认知负担(onPanda 3.1 vs Argilla 5.4 vs POTATO 6.8),是效率主张之外、使用体验主张的关键证据。
研究动机
高质量对齐数据的获取长期陷入三难困境:标注成本、on-policy 保真度与监督粒度无法兼得。人工从头撰写或全文后编辑(用于 SFT)成本高昂,且大量人工键入的文字会把数据推离 rollout 模型的自身分布——对照实验中 POTATO 平台后编辑产出的响应 PPL 高达 1.596,相对重采样基线 1.171 偏移 +36.31%,就是这种分布漂移的量化。偏好排序虽然省时,但只提供响应级粗粒度监督,且只能在模型本来能采样的候选中挑选:当所有 rollout 都不合格时几乎无法提供纠错信号——Argilla 在 21 个 prompt 中仅 11 个(52%)能选出合格 SFT 响应,同时要求标注者头脑中保持四条长响应(NASA-TLX 5.4),均值 684.5 秒远超中位 336 秒的长尾正是负担的体现。Agent 轨迹标注更难:轨迹源于多步环境交互,任何修正都必须真实执行工具、拿到反馈后生成才能继续;现有工具要么只能观察评分(如 AgentDiagnose),要么像 Reptile 局限于终端 SWE 任务、依赖逐字手敲纯文本,无法实时修正通用推理与结构化 tool call。
本文的目标是本文的目标是构建名为 onPanda 的交互式标注工具,让标注者以最低的认知与打字成本精确控制 LLM 生成,并使一次标注同时产出三类数据:保持模型分布的 on-policy SFT 样本、天然配对的响应级偏好对、以及位置精确的 token 级修正监督。具体设计目标有四个:(1) 高效——大部分修正是鼠标点选候选而非打字,'边读边改'的线性流程避免修正后反复通读全文;(2) on-policy 保真——人工只触碰少数错误位置,绝大多数 token 由 rollout 模型自生成,从高概率候选点选的修正对分布扰动更小;(3) 细粒度监督——自动记录每次修正的错误位置、替换 token 与修正前后样本,可转换为 RM/DPO 偏好数据或以被修正 token 所在步骤为单位的 PRM 数据;(4) 完整表达力——当 top-k 候选都缺正确内容、偏好标注无能为力时,仍可自由编辑注入正确文本并让模型从修正前缀续写。此外工具要能经 MCP 连接真实工具与 harness,支持多模态与 agent 轨迹标注,并随文发布 Panda-CVL 数据集与 token 级修正基准。
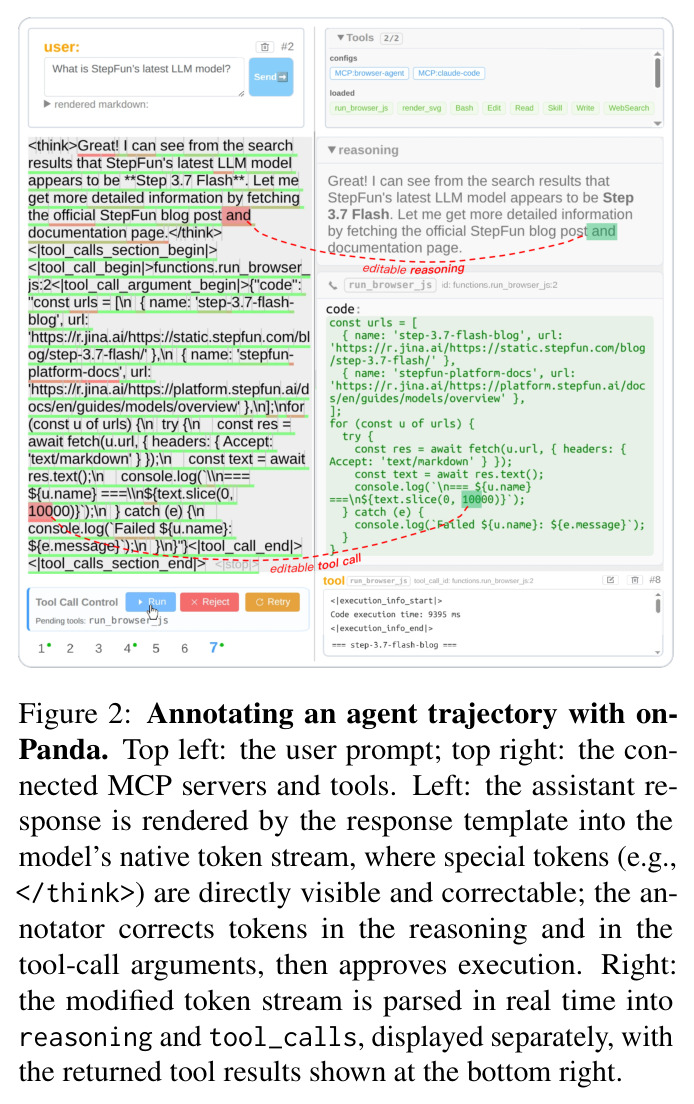
与已有工作不同的是,本文的独特切入是把'修正'下探到 token 粒度,并作为统一交互原语贯穿三种数据形态。已有工作:POTATO/Argilla 等通用平台只做全文后编辑或四选一排序;最接近的 Reptile 虽支持'编辑模型输出后让终端环境执行再续跑',但面向终端 SWE 任务,修正几乎全靠手敲纯文本(难以利用模型自身候选,损害 on-policy 性),且把推理和动作编码为纯文本与 shell 命令,无法支持通用 tool-call 格式。onPanda 的差异化有三点:(1) 修正优先从模型 top-20 候选中点选,对分布扰动天然最小;(2) 借助 response template 把结构化消息(reasoning、content、tool_calls)与原生 token 流双向转换,连 、<|tool_call_begin|> 等特殊 token 都可见可修;(3) 每次修正自动记录位置精确、方向精确的 (负样本, 被拒 token 及位置, 选中 token) 三元组,正负 token 在同一位置一一配对,且在任意 tokenizer 下均可计算。
核心方法
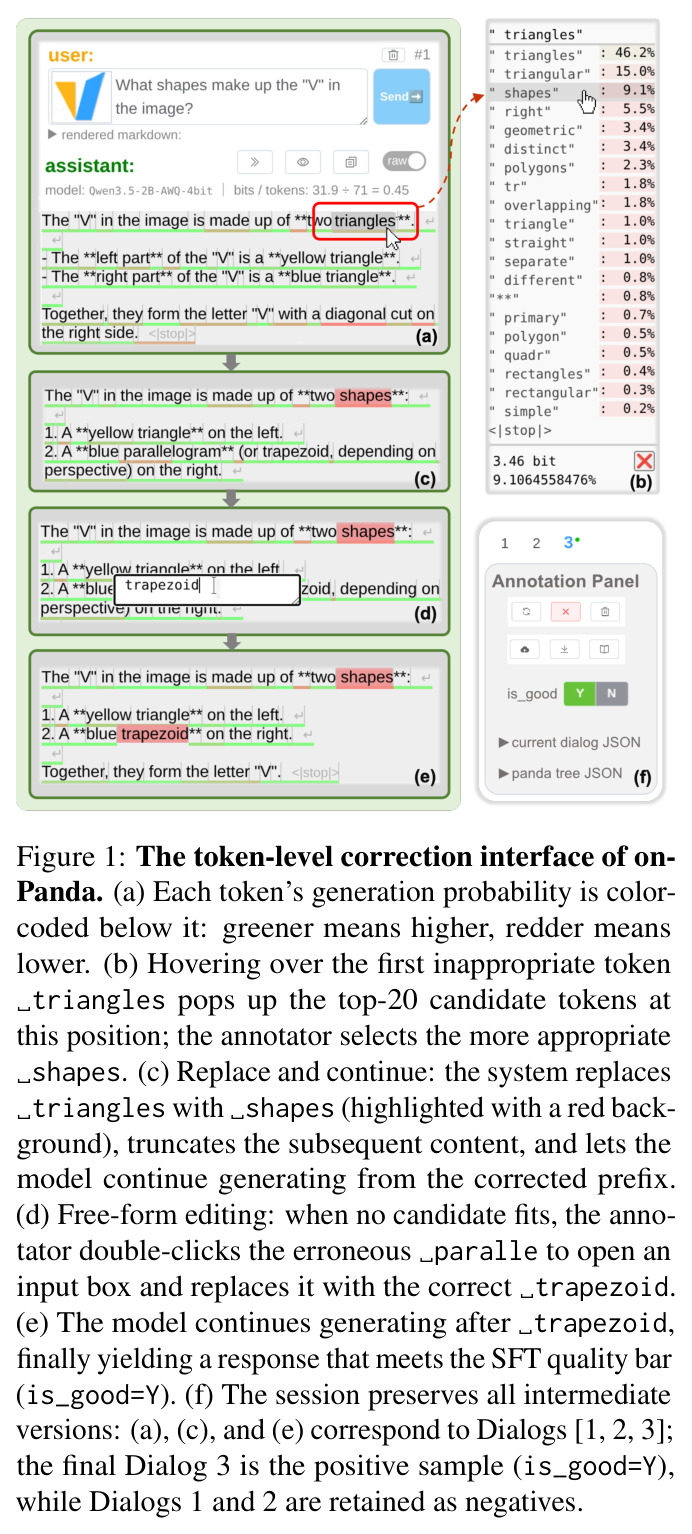
直觉上,模型生成的回答绝大多数 token 是对的,人真正要做的只是找到第一个错误处、换上正确内容,然后让模型自己把后续写完——反复通读和全文重写都是浪费。技术上,onPanda 是组件化前端库,有轻量 web app(静态托管、无数据库,拖入标注文件即用)和嵌入现有数据平台两种模式;唯一的外部依赖是推理 API 必须支持 (i) 从 assistant 消息前缀继续生成(如 vLLM 的 continue_final_message)和 (ii) 返回每个 token 的 top-k 候选与概率。生成请求以流式加 logprobs 方式发出,系统记录每个 token 的采样概率和 top-20 候选,并在 token 下方用颜色编码概率(绿高红低,Figure 1a)。标注者读到第一个不合适的 token 时,或从候选弹窗点选替代,或双击自由输入任意文本;系统随即截断该位置之后的所有内容,以修正后的响应为 assistant 前缀请求原生续写,重复'定位-修正-继续'循环直到满足 SFT 质量线。整个会话的消息、标注、操作日志与概率缓存序列化为单个 .panda.json 文件。
核心创新是把 token 级修正做成'定位-修正-继续'的最小交互循环,由此同时解决成本、分布保真与监督粒度三个问题。与全文后编辑的本质区别在于人工干预的稀疏性:修正只发生在少数错误位置,其余由模型从正确前缀续写,生产数据显示 97.0% 的 token 由模型生成、2.1% 来自候选点选、仅 0.9% 手工键入,数据因此高度贴近 rollout 分布;而且错误往往在一篇回答中反复出现,后编辑必须逐处抓漏,onPanda 只修第一次出现,续写自然与修正保持一致,这是中位时间从 POTATO 的 681 秒降到 330 秒(−51.5%)的关键。与偏好排序的本质区别在于监督粒度与配对结构:偏好数据只在'模型能采样出好答案'时有信号,而 token 级修正把'第一个错误在哪、应换成什么'记录为 (负样本, 被拒 token 及位置, 选中 token) 三元组,正负 token 在同一位置一一对应,为优化提供位置与方向都精确的平衡信号;即便模型完全采不出正确内容,自由编辑仍能注入正确知识,仅以极小的分布代价换取正确性。
方法步骤详情
流程分五步。①环境准备:部署前端,接入支持 assistant 前缀续写与 logprobs 的推理 API,rollout 统一采样参数(temperature 0.7、top-p 0.8 的 Qwen3.5-35B-A3B)。②生成与阅读:流式生成,UI 按 grapheme 边界聚合 token(避免拆散多字节字符),每个 token 下渲染概率色条,标注者定位第一个不当 token。③修正与续写:点选 top-20 候选或双击自由输入替换;系统截断修正点之后的内容,以修正后响应为前缀请求续写;自由编辑文本经一次 prompt_logprobs 请求重算全文概率('刷新'),也适用于外部粘贴文本和切换模型。④结构化与 agent:response template 双向转换结构化消息与原生 token 流,特殊 token(如 )可见可修,解析方向实时还原 reasoning/content/tool_calls 供工具执行;环境经 MCP 接入,harness_to_mcp 把 Claude Code/Codex/OpenClaw 包装为 MCP 服务器,工具调用可配置等审批,被拒轨迹存为负样本。⑤导出:标注树每次修正 fork 新节点并保留全部版本,操作日志含类型、时间戳、修正内容、是否 on-policy 与采样配置快照;onpanda 库导出 is_good=Y 节点为 SFT 样本、正负节点配成偏好对并计算修正三元组。
技术新颖性
技术新颖性体现在四个层面。交互层面,'修正前缀再续写'可追溯到 LLM 之前的机器翻译系统 Predictive Translation Memory(Green et al., 2014)和 INMT(Santy et al., 2019),但 onPanda 首次把它引入通用对齐数据标注,并扩展到多模态与结构化 agent 场景。工程层面,grapheme 边界的 chunk 聚合解决 tokenizer 拆分多字节字符的交互粒度错位;prompt_logprobs 概率刷新让任意外部文本和跨模型场景都能显示逐 token 置信度,使工具兼任模型检查器。数据协议层面,标注树自动 fork 节点、无需人工版本管理即保存全部中间版本,操作日志带采样配置快照保证可溯源;修正三元组在不同 tokenizer 下均可计算(评测用 Qwen3.6 tokenizer 的 find-and-replace 格式),使 token 级修正成为可跨模型评测的基准形态。对比层面,与 Reptile 纯手工文本编辑不同,onPanda 把概率着色的候选点选与结构化 reasoning/tool-call 续写结合,显式记录修正位置与替换文本,故作者不与 Reptile 直接对打、只比较完整工作流。
实验结果
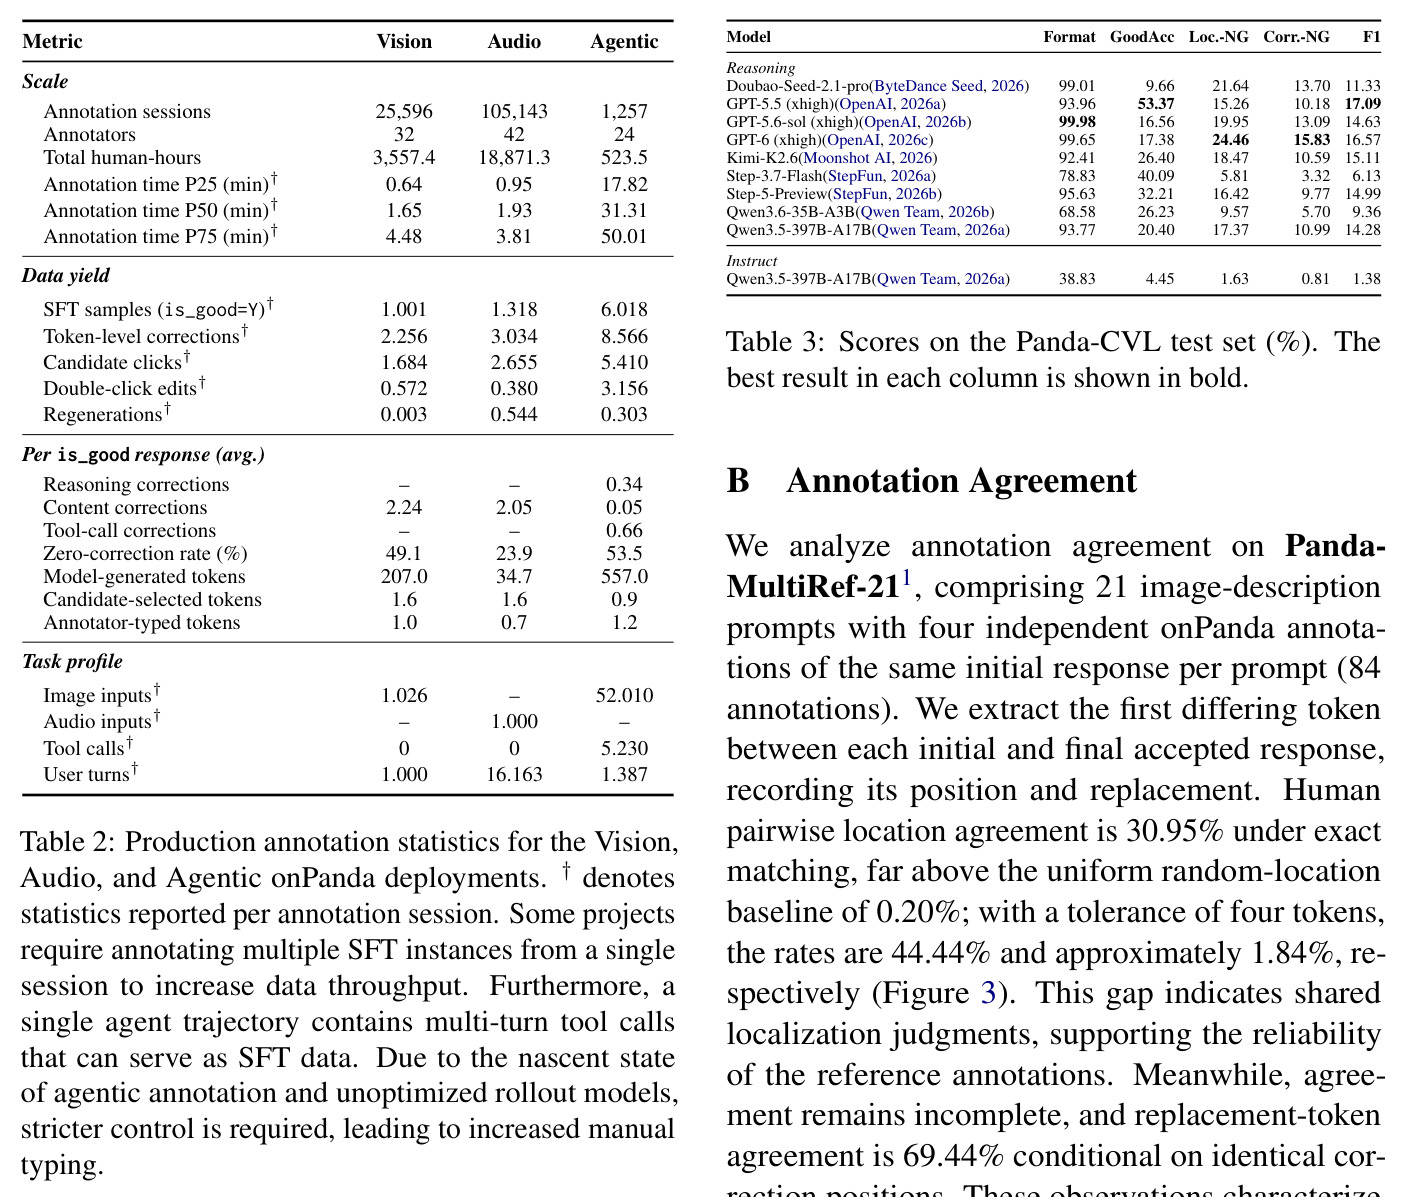
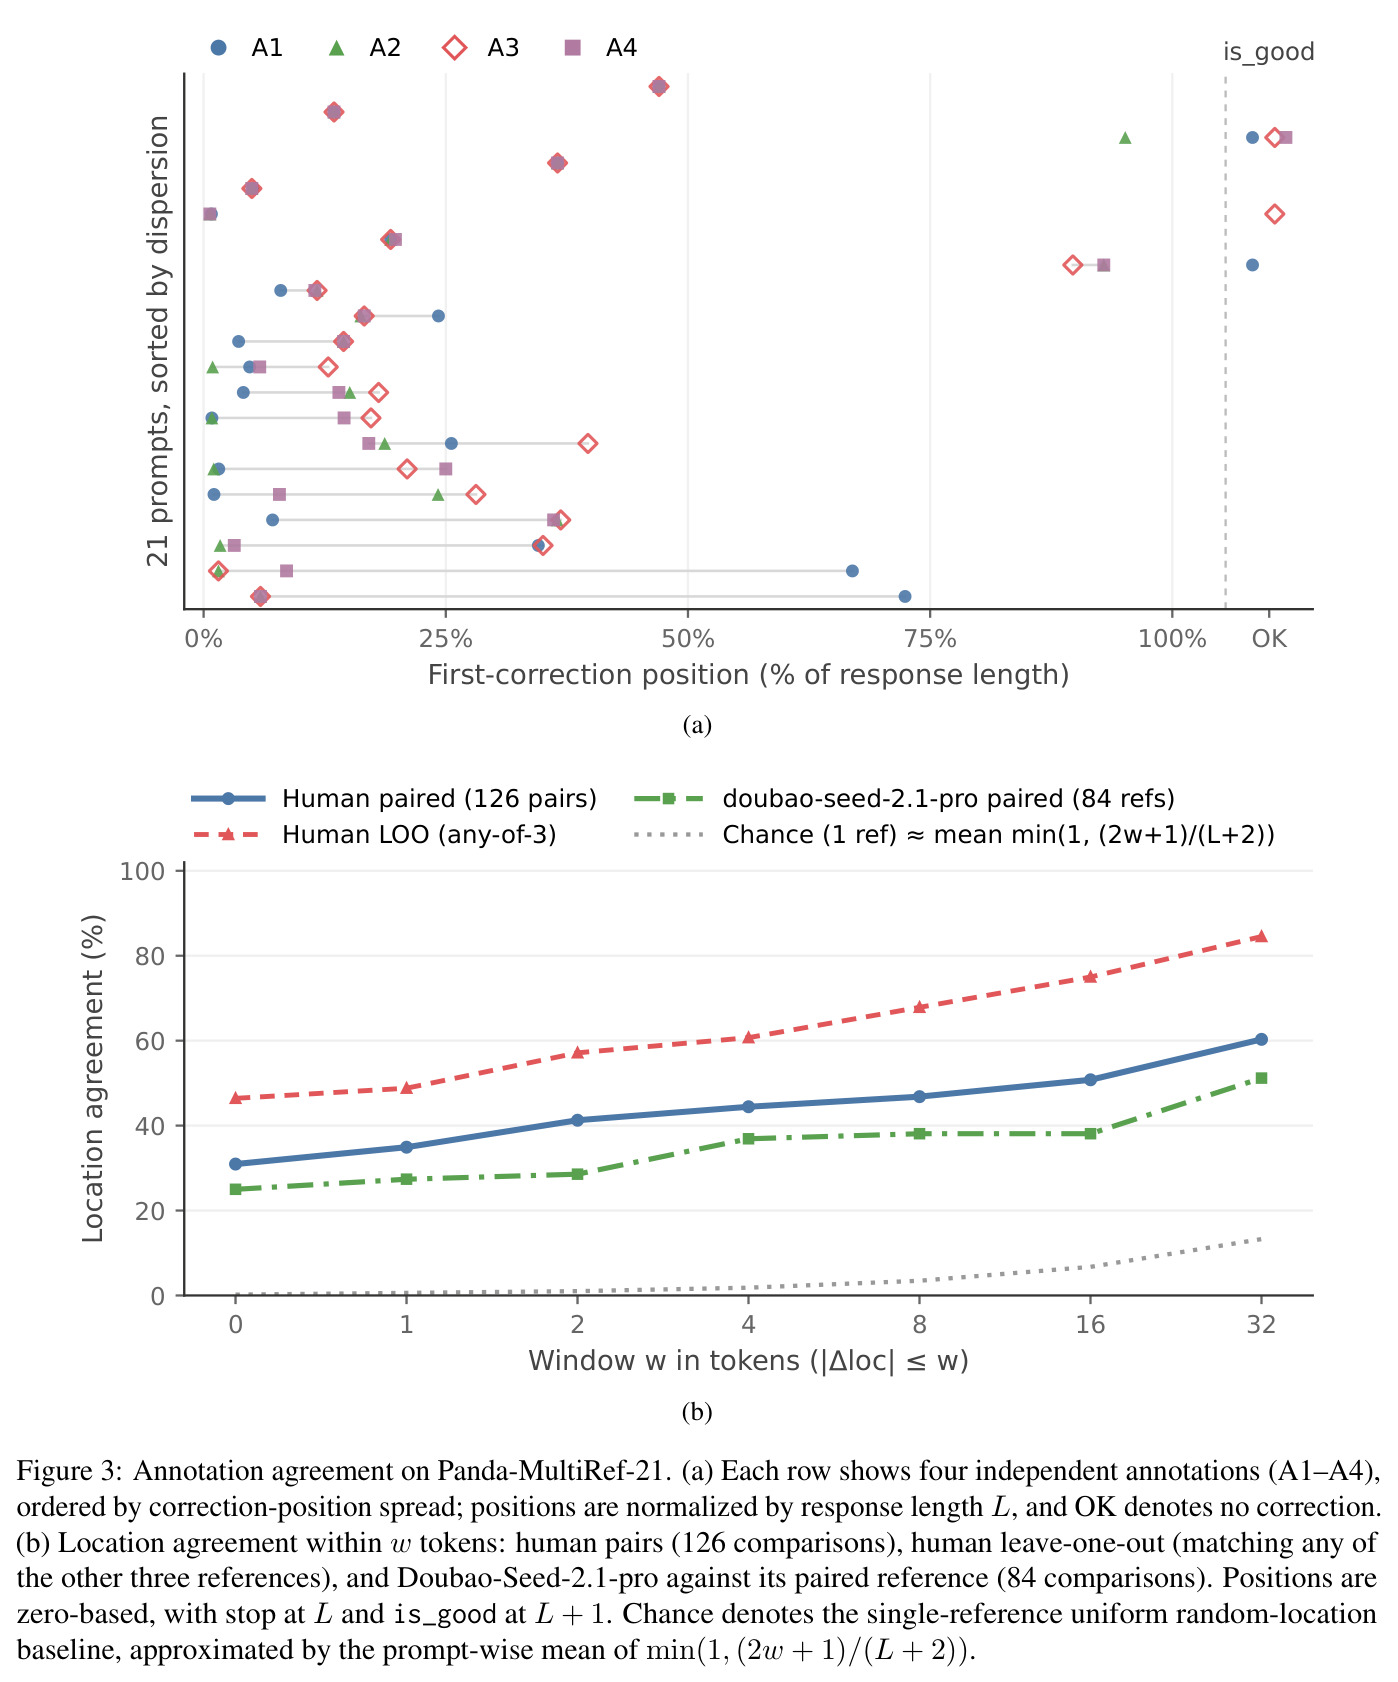
对照实验(3 名非开发者标注者 × 21 个图像描述 prompt,拉丁方轮转,统一 Qwen3.5-35B-A3B rollout)给出三条主结论。效率:onPanda 中位标注时间 330 秒,比 POTATO 的 681 秒低 51.5%,与 Argilla 的 336 秒持平;均值 515.6 秒比两基线(711.1/684.5 秒)低 27.5%/24.7%。质量:GPT-5.5 双序评审中 onPanda 胜率 66.7% 最高(54.8%/28.6%),人类盲评也有 54.8% 配对偏好 onPanda。保真度:onPanda PPL 1.181($\Delta$PPL +0.86%)与 Argilla 1.161 都在重采样噪声 ±2.8% 内,POTATO 1.596(+36.31%)严重漂移;SFT 覆盖率前两者均 100%、Argilla 仅 52%(11/21);每 prompt 偏好对 7.43 个(6.0/0.95);NASA-TLX 3.1 最低(5.4/6.8)。生产端累计 25,596/105,143/1,257 个会话、约 38.8 万次修正,97.0% token 由模型生成。Panda-CVL 基准(2,126 实例)显示任务仍难:$F_1$(GoodAcc 与 Corr.-NG 的调和平均)最佳仅 17.09%(GPT-5.5,GoodAcc 53.37%),GPT-6 定位最好(Loc.-NG 24.46%),所有推理模型 Corr.-NG < 16%。人类标注精确位置一致率 30.95%(机会基线 0.20%),±4 token 容差 44.44%,位置一致时替换 token 一致率 69.44%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 对照研究:标注效率(21 个图像描述 prompt,拉丁方设计) | 中位标注时间(秒,括号内为均值) | onPanda 330(515.6) | POTATO(后编辑)681(711.1);Argilla(四选一排序)336(684.5) | 较 POTATO 中位时间降低 51.5%,均值较两基线分别低 27.5% 和 24.7% |
| on-policy 保真度(rollout 模型重采样基线 PPL = 1.171) | $\Delta$PPL(相对基线的偏移,绝对值越小越保真) | +0.86%(PPL 1.181) | POTATO +36.31%(1.596);Argilla −0.83%(1.161) | 偏差较 POTATO 缩小约 42 倍,落在重采样噪声 ±2.8% 区间内 |
| 输出质量(LLM-as-a-judge 成对比较,GPT-5.5 双序评审) | 成对胜率(对另两方法) | 66.7% | POTATO 54.8%;Argilla 28.6% | 较 POTATO 高 11.9 个百分点;人类盲评中 onPanda vs POTATO 亦有 54.8% 偏好率 |
| SFT 覆盖率与偏好对产出 | 产出合格 SFT 响应的 prompt 比例 / 平均每 prompt 偏好对数 | 100%(21/21)/ 7.43 对 | Argilla 52%(11/21)/ 6.0 对;POTATO 100%(21/21)/ 0.95 对 | 偏好对较 POTATO 多约 7.8 倍,且精确对齐到修正位置;覆盖率补齐 Argilla 短板 |
| 用户主观负荷(适配版 NASA-TLX 用户研究) | 六维平均分(0-10,越低越好) | 3.1 | Argilla 5.4;POTATO 6.8 | 三者中最低,较 POTATO 降低约 54% |
| Panda-CVL token 级修正基准(652 测试会话 → 2,126 实例) | $F_1$(GoodAcc 与 Corr.-NG 的调和平均,%) | 基准任务:最佳模型 GPT-5.5 达 17.09(GoodAcc 53.37) | GPT-6 F1 16.57(Loc.-NG 24.46、Corr.-NG 15.83);Qwen3.5-397B-A17B instruct 仅 1.38 | 说明 token 级修正能力远未解决,为'修正模型'研究提供公共测试床 |
局限与改进
作者坦承的局限有四类。其一,核心交互依赖推理 API 的两项能力:assistant 前缀续写与 top-k logprobs(概率刷新还需 prompt_logprobs),部分专有 API 不暴露就无法标注 on-policy 数据。其二,效率与 on-policy 优势建立在'稀疏错误'前提上:若模型远低于任务要求、修正变密集,两项优势都会消退,只能退回自由编辑;且 on-policy 是相对标注时 rollout 模型而言,换模型训练或权重持续更新后收益衰减。其三,证据边界:对照实验仅 3 人 × 21 个图像描述 prompt、单一 rollout 模型;用户研究参与者全来自内部标注团队;质量评估主要靠 LLM-as-a-judge;agent 场景没有对照实验;下游训练收益未经训练验证。此外我观察到:效率结论基于图像描述这类简单任务,对定位分歧更大的任务未必成立——人类精确位置一致率也仅 30.95%,'第一个错误在哪'主观性强,单参考 exact-match 监督可能带噪;agentic 会话中位耗时 31.31 分钟、平均 52 次图像输入,成本仍高;与 Reptile 缺少同任务对比。
独立分析的弱点
独立来看,本文有以下弱点。第一,统计功效薄弱:3 人 × 21 prompt 的拉丁方实验设计虽干净,但样本量下置信区间必然很宽,51.5% 的时间缩减在更难任务上是否保持未知,改进方向是预注册的多任务、多模型、更大样本对照实验。第二,'第一个错误'的定义依赖标注者主观判断,benchmark 自测人类精确一致率仅 30.95%,单参考监督必然引入噪声,可利用 Panda-MultiRef-21 式多参考构建软标签或一致性加权训练目标。第三,交互只支持修正 assistant 当前轮次,早期轮次的反馈(如后续工具报错指向早前输出)无法直接标注。第四,被拒轨迹虽自动存为负样本,但'拒绝 + 文字引导'中的引导文本如何转化为可训练信号没有给出协议。第五,生产统计显示零修正率为 49.1%/23.9%/53.5%,过半会话仍需多次人工修正,可引入预测修正密度的路由机制,对高难度任务改用多 rollout 或更强模型。第六,benchmark 把修正压缩为 find-and-replace 三元组,可能低估模型在真实交互界面(有候选约束、可迭代)中的能力,评测形态与实际使用形态存在错位。
未来方向
作者明确提出三个方向。一是基于 token 级修正数据做后训练:训练'修正模型'(correcting model,奖励模型的 token 级对应物)与'token 级修正优化'(DPO 的 token 级对应物),随文发布的 benchmark 正是修正能力的现成测试床。二是标注-训练飞轮:让修正模型预定位可疑 token 并提议修复供人审核,每批新标注触发增量训练并更新线上 rollout 模型,模型变强后修正更稀疏、标注更便宜,同时缓解 on-policy 衰减。三是支持早期轮次标注,把'未来反馈监督过去生成'结构化为在线文本反馈学习:训练模型把工具报错、用户抱怨等文本反馈翻译成对早期输出的 token 级修正,无需标量奖励即可从真实交互中持续学习。基于这些成果,我认为还可延伸:用 MultiRef 多参考数据建模修正位置与替换的分布而非单点标签;把修正三元组用于训练过程奖励模型(PRM)并与 PRM800K 式步级标注对比样本效率;在飞轮闭环中按预测修正密度主动采样训练任务形成 curriculum;以及对修正位置分歧做因果分析,区分'模型能力缺陷'与'标注规范歧义'。
复现评估
复现条件总体友好。开源:onPanda 前端与 onpanda 解析库(on-panda.github.io/research)、Panda-CVL(7,491 个 .panda.json 会话,6,839 训练/652 测试,图像自制或开放授权)、Panda-MultiRef-21(21 prompt × 4 标注者共 84 条参考)、benchmark 的 prompt 模板与评测实现均随仓库发布。推理侧 vLLM/SGLang 原生支持前缀续写与 logprobs,llama.cpp/ollama 覆盖核心交互;接入新模型只需按开发指南适配 response template,作者称编码 agent 通常可自动完成。算力门槛低:标注只需 API 调用,实验用的 step-1o-turbo(32B dense VLM)与 Qwen3.5-35B-A3B 均公开可得。难点在人力:复现 Table 1 需至少 3 名非开发者标注者按拉丁方完成三轮任务(每 prompt 中位 5.5-11.4 分钟 × 21 prompt × 3 方法),问卷与 GPT-5.5 评审亦需预算;生产级 38.8 万次修正来自内部平台无法复现,但 Panda-CVL 已是其可发布子集。综合:代码与数据复现容易,实验结论复现中等难度,主要成本是标注人力。
论文图表
各前沿多模态模型在 Panda-CVL 测试集(652 条会话扩展为 2,126 个实例:652 个合格 + 1,474 个不合格响应)上模拟人类流程执行 token 级修正的成绩:GPT-5.5 取得最佳 GoodAcc 53.37% 与整体 F1 17.09%;GPT-6 定位最强(Loc.-NG 24.46%、Corr.-NG 15.83%,F1 16.57);GPT-5.6-sol Format 最高 99.98% 但 GoodAcc 偏低;Doubao-Seed-2.1-pro F1 仅 11.33%;Qwen3.5-397B-A17B instruct 模式 F1 只有 1.38。九个推理模型中七个 Format 超 90%,但所有模型 Corr.-NG 均低于 16%。
它定义了'token 级修正'这一新任务并给出首版基线:即使最强模型 F1 也只有 17.09%,说明该能力远未解决,为作者提出的'修正模型'与'token 级修正优化'提供了公共测试床;同时 Format 高不等于定位与修正准的结论,警示了单看格式遵从的评测陷阱。