文档检索感知分块(D-RAC):经由 PDF 归一化与多模态 Markdown 转换实现企业文档的通用检索感知摄取 Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware Ingestion of Enterprise Documents via PDF Normalization and Multimodal Markdown Conversion
任意文档先归一化为 PDF,经一次多模态转换后按 ID 规划分块,成本大降且检索持平
前置知识
RAG(检索增强生成)
RAG 先把知识库切分成块并嵌入为向量,查询时用语义相似度召回最相关的若干块,再把它们作为上下文交给 LLM 生成答案。它让模型无需重训练即可引用企业私有知识,是当前企业级 LLM 应用的主导范式。
本文的全部设计目标都是服务于 RAG 的摄取端:分块质量直接决定检索上限,D-RAC 的每一项取舍(表格散文化、标题前缀)都在优化下游检索。
文档分块(Chunking)
把长文档切分为适合嵌入和召回的短文本单元。固定分块按字符数硬切,容易把一个主题拦腰截断;语义分块试图按主题划界。块太碎则上下文丢失,太大则嵌入语义稀释、召回精度下降,通常数百字符较优。
分块边界是 RAG 系统中影响最大的工程决策之一,论文证明结构破坏(而非嵌入质量)才是 PDF 摄取的瓶颈:固定分块 Recall@6 仅 0.717。
智能体分块(Agentic Chunking)
让 LLM 通读原始抽取文本,理解语义后把文档重写为语义连贯的块。效果通常好于规则方法,但模型必须重新生成几乎全文,而输出 token 价格是输入的 4-8 倍(GPT-4.1 输出 $8/1M),成本与延迟被输出端主导,且改写引入幻觉面。
它是本文的主要对比基线:D-RAC 用 ID 级规划把输出 token 从 270,454 压到 11,714,成本降 77.8%-85.6%,检索质量却持平。
多模态大模型
能同时接收图像与文本输入的 LLM(如本文用的 Gemma-3 27B/12B)。视觉编码器把页面图像转为 token 序列,模型据此读取版式、表格与文字。它读的是像素而非格式标记,因此天然对文档格式无关。
D-RAC 的关键设计是把多模态模型的使用压缩到恰好一次——格式转换环节,理解其角色才能明白成本结构为何能重构。
稠密检索与嵌入
把文本映射为固定维向量(本文用 Titan Text Embeddings V2,1024 维),查询向量与块向量做余弦相似度排序取 top-K。语义相近但措辞不同的文本也能匹配,是 RAG 召回的主流方式;但表格单元格脱离行列上下文时嵌入几乎无意义。
表格逐行散文化正是针对稠密检索这一失效模式的定向修复,理解嵌入如何工作才能理解 D-RAC 转换规则的动机。
检索评价指标(Recall@K / MRR / NDCG)
Recall@K 衡量 top-K 结果覆盖了多少条支撑事实;MRR(平均倒数排名)看第一条相关结果出现得多早;NDCG@K 在此基础上按相关度位置加权折损。本文判定相关的规则是块中至少出现支撑事实 60% 的内容词。
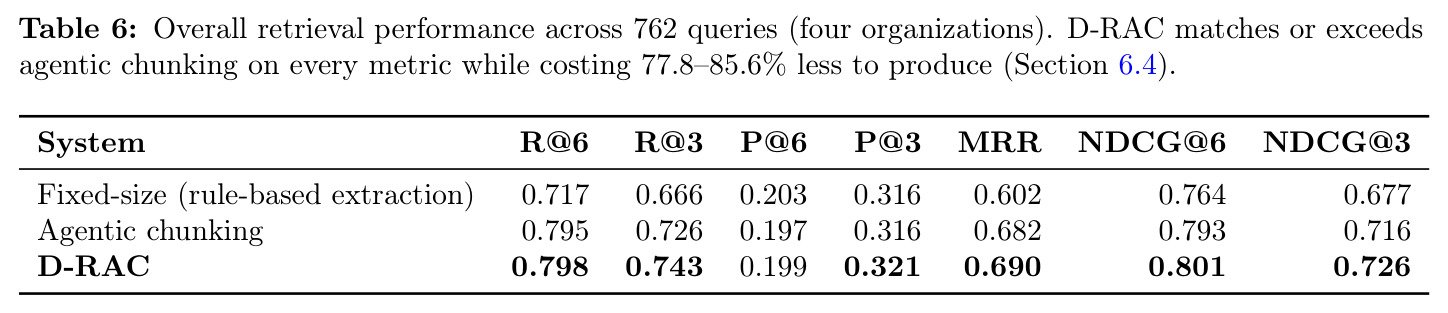
论文的检索结论全部由这三个指标表达(如 D-RAC R@6 0.798 对固定分块 0.717),不熟悉它们就无法评估改进是否真实。
研究动机
企业知识库由 PDF、Word、PPT、XLSX、扫描件等异构格式构成,内容被锁在复杂视觉版式、多栏排版和密集表格里。传统摄取管线依赖规则文本抽取(PyMuPDF、pdfminer、pdfplumber)或 OCR,经常破坏阅读顺序、把表格压扁成空白分隔的碎片、丢失标题层级——而标题层级恰是结构化分块的骨架。版式分析模型(LayoutLM、Docling)改善了结构恢复,但需要专门部署,且仍把表格输出为网格:脱离行列上下文的单元格在稠密检索中语义近乎为零。若直接在抽取文本上做 agentic chunking,LLM 必须边修复抽取损伤边重新生成全文,而输出 token 价格是输入的 4-8 倍(GPT-4.1 下 $8.00/1M),成本、延迟与幻觉风险全部被输出端放大。论文实验量化了后果:在 RAG-Multi-Corpus 基准上,传统的 1000 字符固定分块对抽取文本只达到 Recall@6 0.717、MRR 0.602,说明结构破坏才是 PDF 摄取的真正瓶颈。
本文的目标是作者此前提出的 Web Retrieval-Aware Chunking(W-RAC)把网页分块从文本生成问题重构为语义规划问题:页面被确定性解析为 ID 寻址单元,LLM 只输出单元 ID 的有序列表来规划块边界、绝不重写文本,从而把分块相关输出 token 削减 84.6%、端到端延迟降低约 60%、总 LLM 成本降低 51.7%。但 W-RAC 依赖可确定性解析的 HTML 结构,面对 PDF 就没有可靠的结构可解析。本文目标是设计一条格式无关的扩展管线 D-RAC,让 DOCX、PPTX、XLSX、HTML、扫描件和原生 PDF 都能以统一方式进入检索感知分块流程,同时完整保留 W-RAC 的低成本、确定性与可观测性;并通过检索感知的转换规则(表格逐行散文化、显式标题层级、图像抑制)直接修复稠密检索在表格与结构上的已知失效模式,且能线性扩展到 500 页以上的长文档。
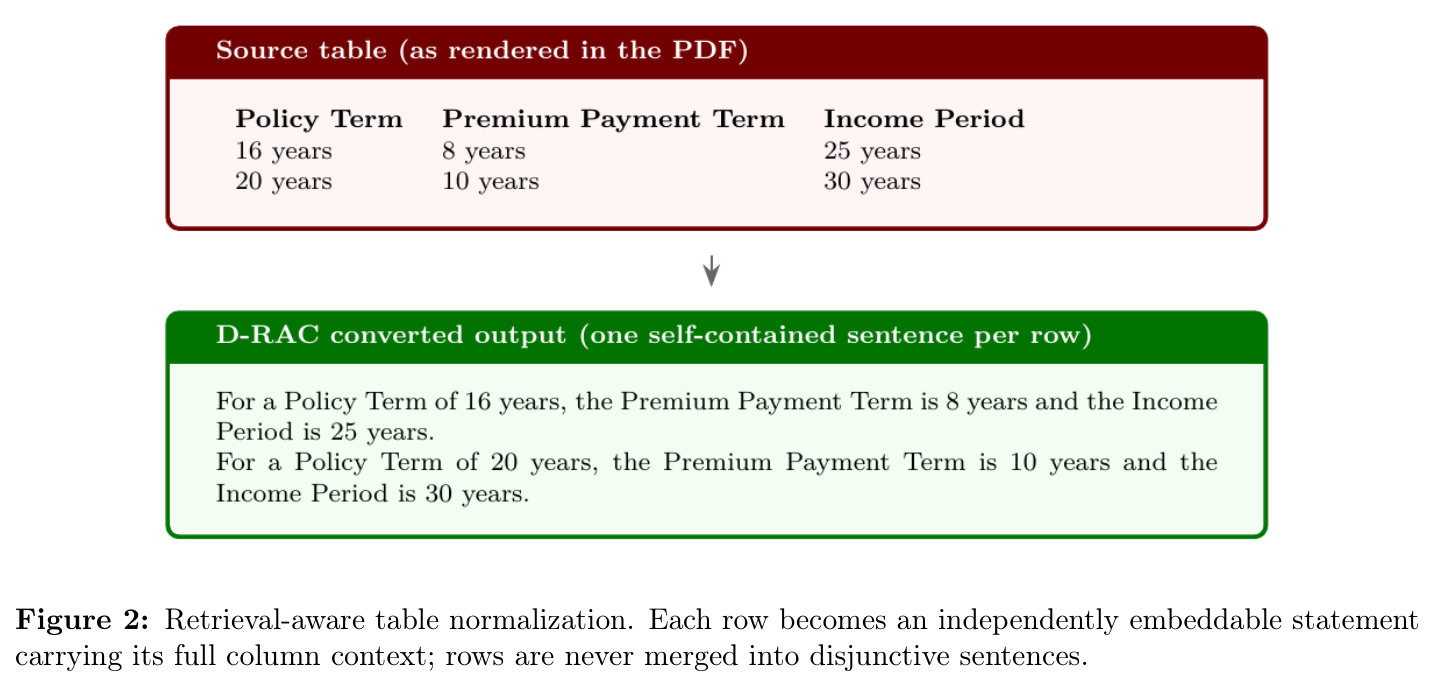
与已有工作不同的是,本文的独特切入由两个观察组合而成。其一是把 PDF 当作通用视觉交换格式:几乎每种文档格式都有忠实、确定性的 PDF 渲染(office 用 headless LibreOffice、HTML 打印为 PDF、扫描件图片包装),于是异构格式问题被归约为统一的像素读取问题,按格式的工程量压缩为商品化转换。其二是把多模态 LLM 的使用压缩到恰好一次——只用于把渲染页面转成检索优化的 Markdown,而非像 vision-guided chunking 那样既做理解又生成分块文本;此后分块退化为只输出 ID 数组的廉价规划。更进一步,作者把检索感知前移到转换环节本身:表格每行改写为携带列头上下文的自包含陈述句、严禁用 or 合并多行、标题层级显式重建、装饰性图像直接丢弃。这些是针对稠密检索失效模式的定向设计,通用 OCR 或文档理解系统都不会这样做。
核心方法
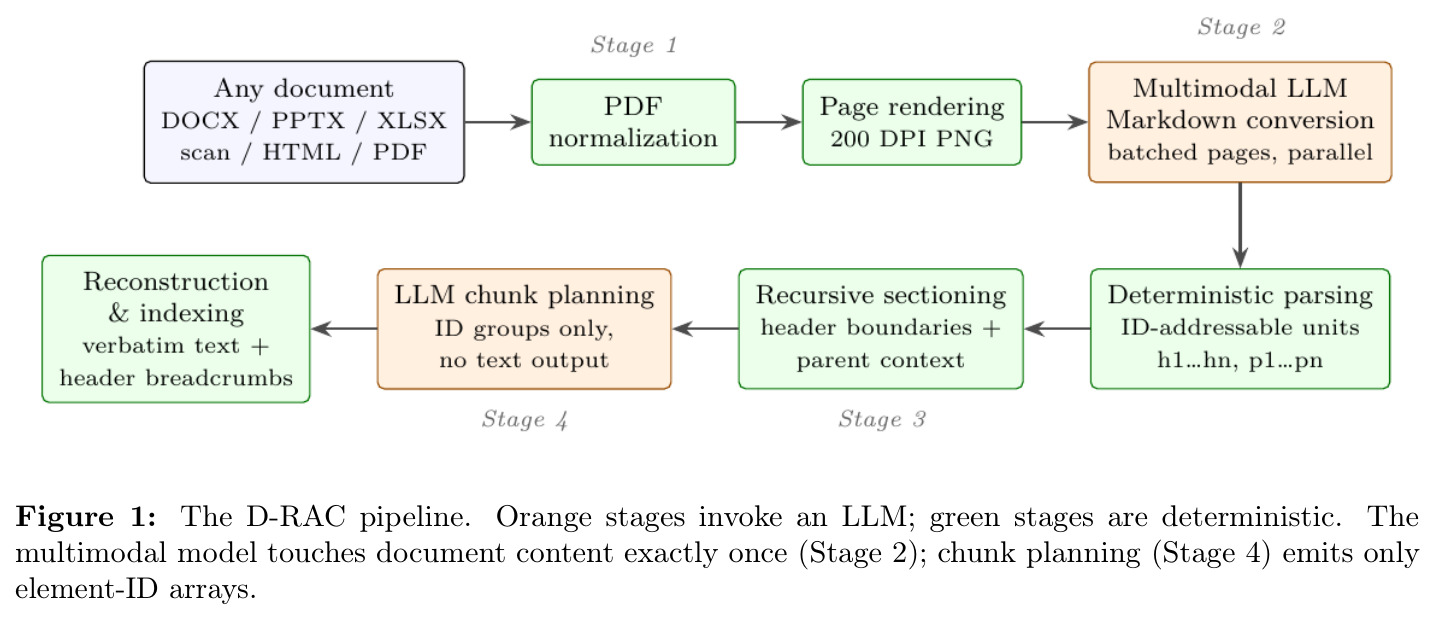
直觉上,D-RAC 回答一个简单问题:能否用一次多模态 LLM 调用从页面图像恢复出足够结构,让 W-RAC 的全部机制原封不动地适用于文档?管线分四阶段(Figure 1)。阶段一归一化与渲染:非 PDF 输入经确定性工具转为 PDF,再以 200 DPI 渲染成 PNG、最长边压到 1568 像素以匹配视觉编码器输入限制,每文档仅 1-7 秒、无 LLM 参与。阶段二多模态转换:渲染页按 5 页一批送入 Gemma-3 27B/12B(AWS Bedrock,temperature 0.1,5 批并行,单批上限 8192 输出 token),产出检索优化的 Markdown。阶段三确定性解析与分节:Markdown 被解析为 h1/h2 等标题与 p1/p2 等内容块,超过 60 元素调用预算时按标题边界递归分节并附带父级标题链。阶段四 ID 级规划:LLM 只接收元素 ID、200-400 字符截断预览和层级元数据,输出形如 [["h1","h2","p1","p2"]] 的 JSON 数组,最后在本地把 ID 映射回逐字文本重建块。
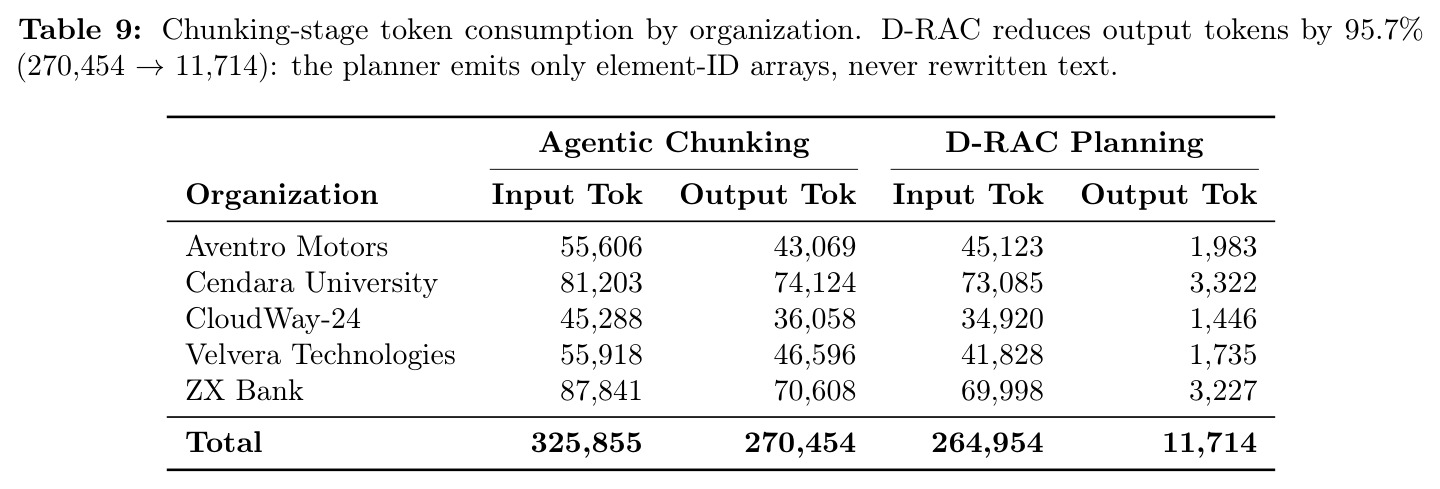
核心创新是把昂贵 LLM 的触点从分块移到转换,且只发生一次。与 agentic chunking 的本质区别:后者让前沿模型通读全文并重写为语义连贯的块,输出 token 占其成本 77-87%(成本 $\text{cost} = n_{in} \cdot p_{in} + n_{out} \cdot p_{out}$,其中 $p_{out}$ 是 $p_{in}$ 的 4-8 倍),每次重分块都要全量重新生成;D-RAC 中规划器只输出 ID 数组,分块阶段输出 token 从 270,454 剧减至 11,714(降 95.7%)。与 vision-guided chunking 的区别:后者对理解与块生成都用大视觉模型,保留完整输出成本;D-RAC 只在不可替代处(从像素恢复结构、归一化表格)用一次。同时检索感知内建于转换:表格每行成为携带列头上下文的独立可嵌入陈述句,多行严禁合并为并置句(否则查询某配置会召回断言多个配置的句子);标题层级既驱动分节又前缀到每个块。转换产物是持久化工件,检索策略变更只需秒级 ID 重规划,永不重付转换成本。
方法步骤详情
阶段一:DOCX/PPTX/XLSX 用 headless LibreOffice、HTML 打印、扫描件图片包装等方式转为 PDF,PyMuPDF 以 200 DPI 渲染 PNG 并把最长边压到 1568 像素,零 LLM 成本。阶段二:5 页一组送 Gemma-3 27B/12B(Bedrock Converse API,temperature 0.1,5 批并行,单批 8192 输出 token,节流错误指数退避重试 3 次);提示词强制:全文逐字保留、禁止 Markdown 表格语法且每行改写为以列头为上下文的完整句子、严禁用 or 合并行、完全忽略图像图表、以 #/##/### 重建标题层级、每页前加页码注释;随后确定性后处理剥离代码围栏、删除图像引用、对漏网表格做规则化散文化兜底,失败页记为内联错误标记而不中断文档。阶段三:解析为 ID 寻址元素,超 60 元素预算时按标题边界递归分节(优先最粗层级、无标题区固定兜底、相邻小节合并),每节携带祖先标题链。阶段四:规划器按每组 3-8 个内容块、标题 ID 可跨块复用、每个内容 ID 恰好覆盖一次输出 JSON ID 数组(每节 16,384 token 上限、各节并行);程序化校验覆盖,遗漏 ID 归入兜底块保证无损;最后本地重建,每块前缀祖先标题链与面包屑后嵌入入库。
技术新颖性
技术新颖性体现在四个层面。第一,格式无关性经由归一化为 PDF 这一平凡但关键的观察实现:无需 per-format 解析器,新格式支持成本趋近于零。第二,单次转换加 ID 级规划的两段式解耦根本改变了成本结构——转换按文档一次性支付,重分块只付规划成本:503 页、5,060 元素的招股书,95 个并行节调用共 68.7 秒即完成规划,仅为其转换时间的约 5%,使检索策略迭代从全量重生成变为秒级重规划。第三,检索感知转换规则(行级表格散文、no-merge 纪律、显式层级、图像抑制)针对稠密检索失效模式定向设计,并沿用作者先前关于上下文化表格散文改善表格 QA 的发现。第四,可验证性:每个内容 ID 恰好入一块由程序保证,规划输出仅是可与元素表校验的 ID 数组,规划阶段零幻觉面——输出中没有任何散文可被模型悄悄改写,这是 agentic chunking 结构上无法提供的保证。
实验结果
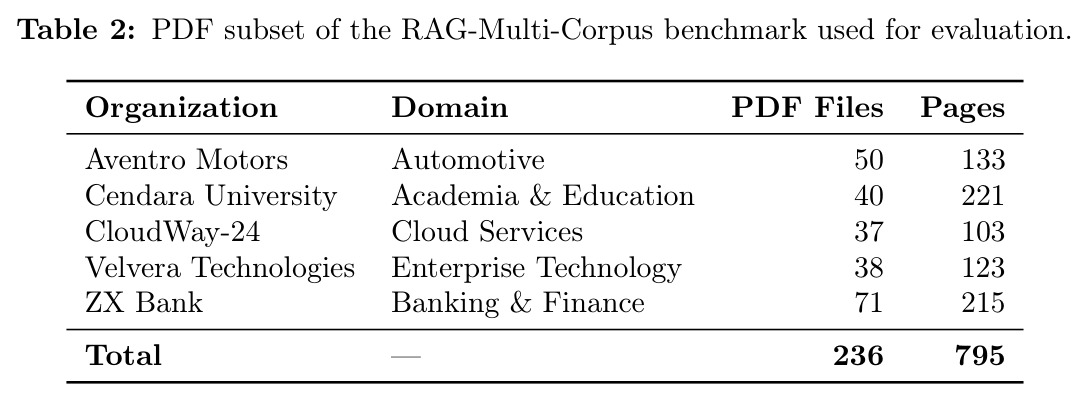
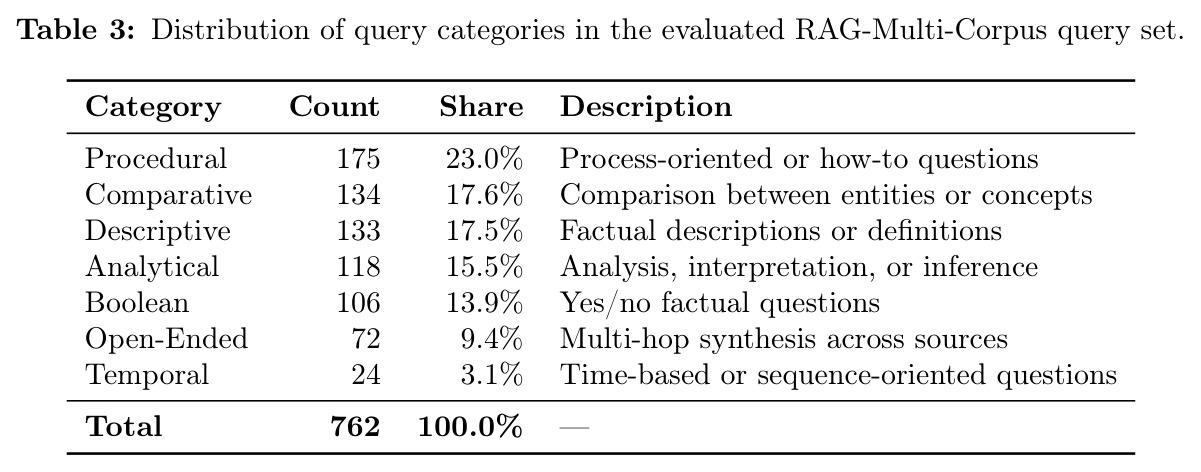
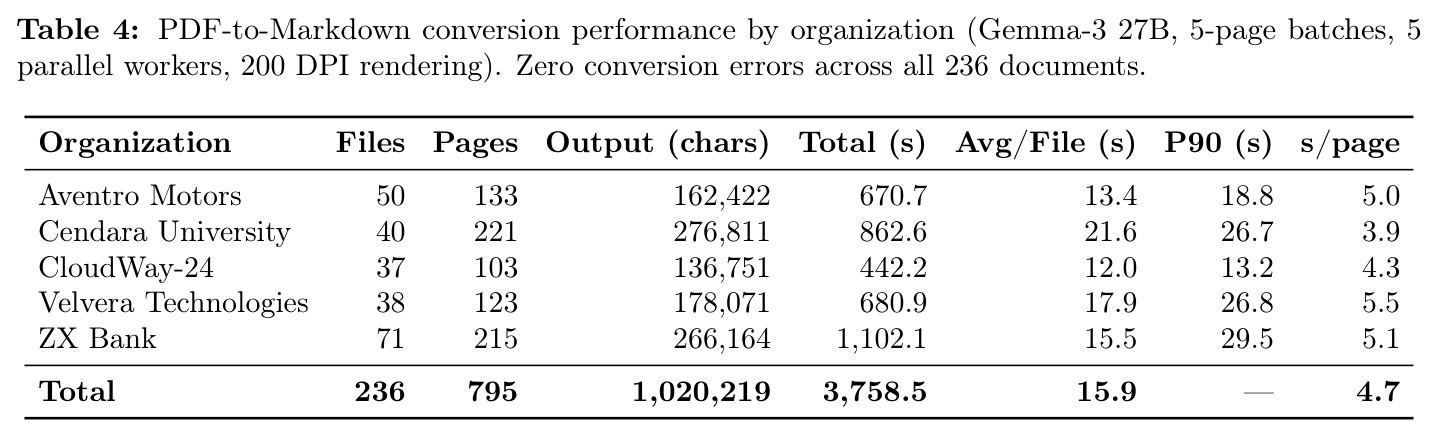
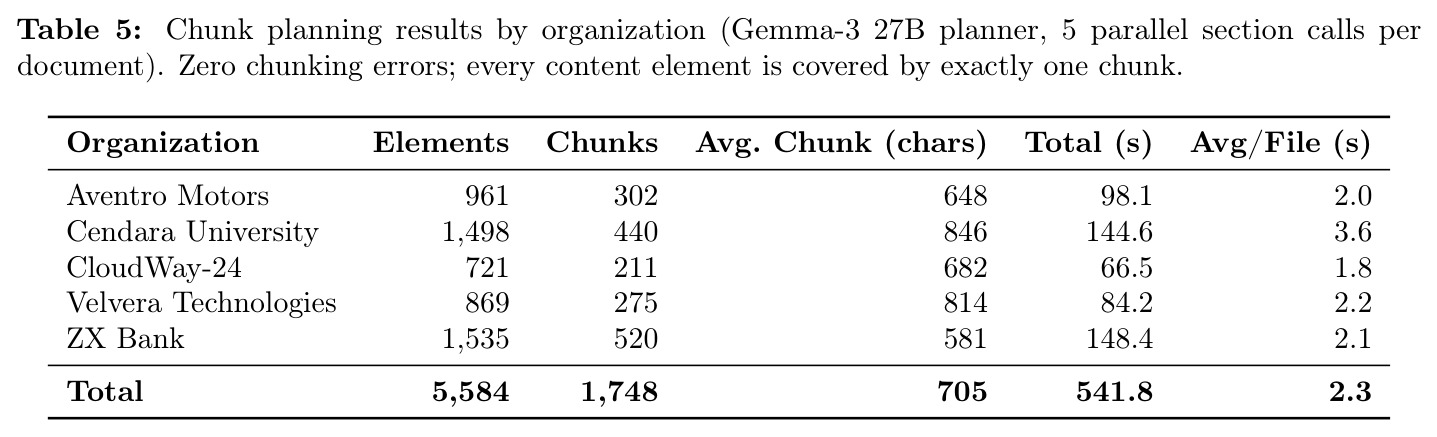
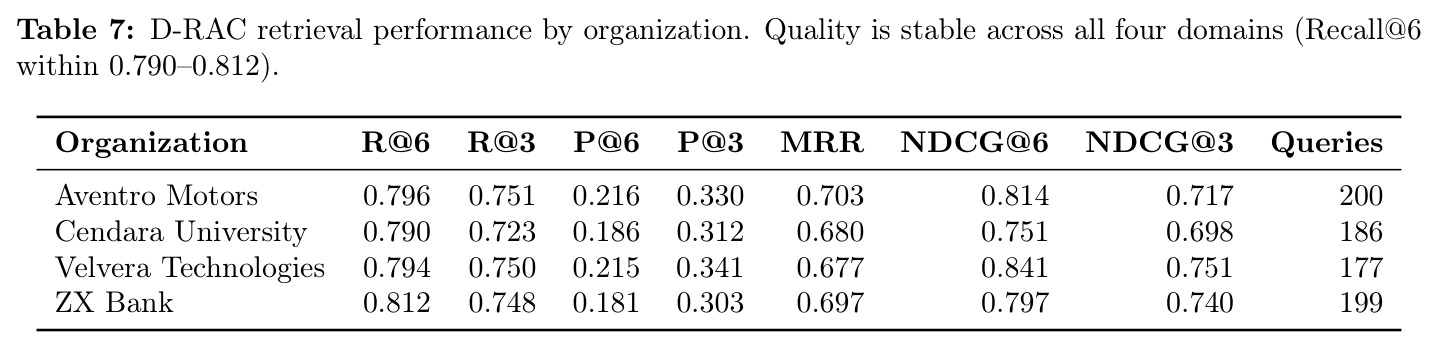
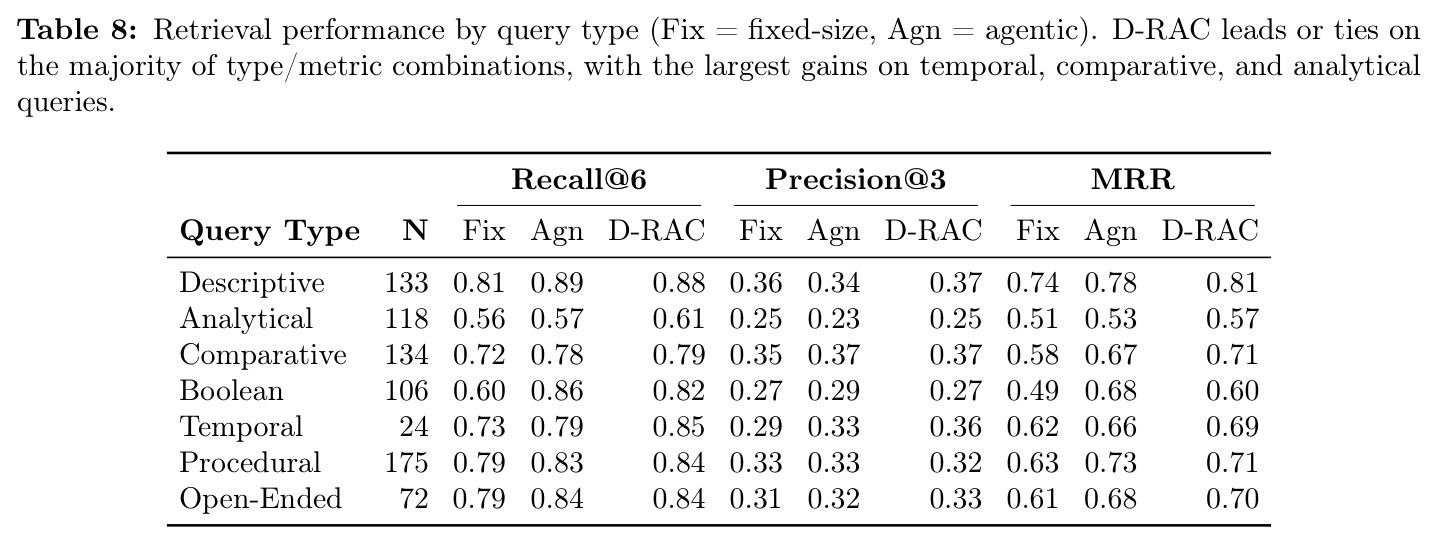
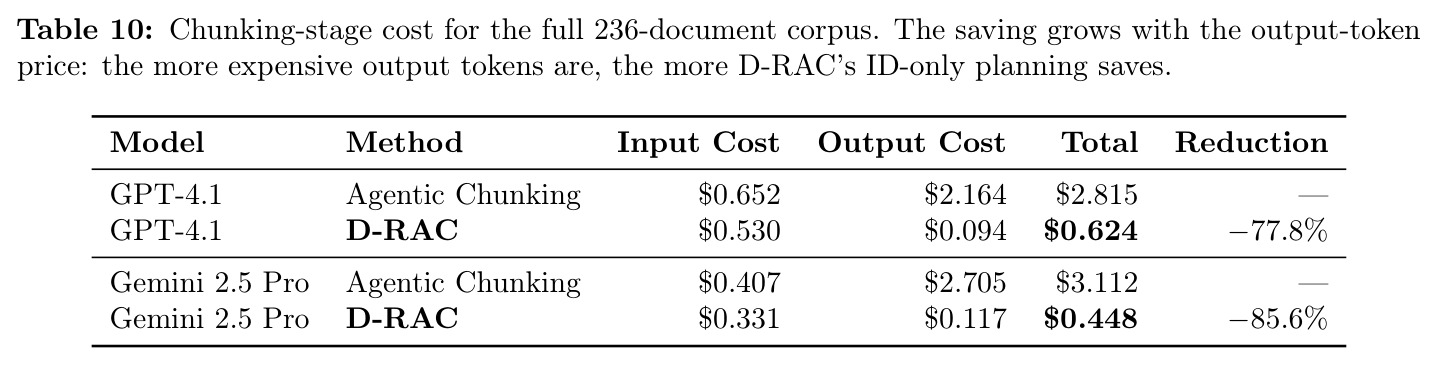
转换吞吐(Table 4):236 文档、795 页在 Gemma-3 27B 上累计转换 3,758.5 秒(62.6 分钟;含规划墙钟 71.7 分钟),五领域零转换错误,输出 1,020,219 字符,每页 3.9-5.5 秒且跨领域稳定,说明短企业文档成本由 API 延迟而非内容复杂度主导。分块规划(Table 5):5,584 个元素规划为 1,748 个块仅 541.8 秒(占转换时间 14%,平均每文档 2.3 秒),平均块长 705 字符(581-846),零分块错误。检索质量(Table 6):三系统统一用 Titan Text Embeddings V2 与同一词面判定器(60% 内容词重叠),D-RAC 达 R@6 0.798、MRR 0.690、NDCG@6 0.801,七项指标全部持平或超过 agentic chunking(0.795/0.682/0.793),大幅超过固定分块(0.717/0.602/0.764;R@6 相对提升 11.3%、MRR 提升 14.6%)。分查询类型(Table 8):时序类 R@6 0.85(固定 0.73)、比较类 0.79(0.72)、分析类 0.61(0.56)获益最大;布尔类是 agentic 唯一领先的类别(0.86 对 0.82)。分机构(Table 7):R@6 在 0.790-0.812 间仅波动 0.022。成本(Table 9-10):输出 token 270,454 降至 11,714(降 95.7%),GPT-4.1 定价下 $2.815 降至 $0.624(降 77.8%),Gemini 2.5 Pro 下 $3.112 降至 $0.448(降 85.6%),分块时间 2,167.5 秒降至 541.8 秒(降 75%)。可扩展性:503 页招股书转换 21.6 分钟(27B)/13.4 分钟(12B),5,060 元素 68.7 秒规划完毕;外推 1M 页语料,GPT-4.1 下分块成本从约 $3,540 降至约 $785。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 端到端文档检索(762 查询,4 机构) | Recall@6 | 0.798 | 固定分块 0.717;agentic chunking 0.795 | 较固定分块相对提升 11.3%;较 agentic +0.003 持平略优 |
| 端到端文档检索 | MRR | 0.690 | 固定分块 0.602;agentic 0.682 | 较固定分块相对提升 14.6%;较 agentic +0.008 |
| 端到端文档检索 | NDCG@6 | 0.801 | 固定分块 0.764;agentic 0.793 | 较两基线均有提升 |
| 分块阶段 token 效率(236 文档) | 输出 token 数 | 11,714(仅 ID 数组) | agentic chunking 270,454(重写全文) | 降低 95.7% |
| 分块阶段成本(GPT-4.1 定价 $2/$8 每 1M token) | 总成本 | $0.624 | agentic $2.815 | 降低 77.8% |
| 分块阶段成本(Gemini 2.5 Pro 定价 $1.25/$10) | 总成本 | $0.448 | agentic $3.112 | 降低 85.6% |
| 分块阶段延迟(236 文档) | 处理时间 | 541.8 s(平均 2.3 s/文档) | agentic 2,167.5 s(W-RAC 实验测得) | 降低 75.0% |
| 时序类查询检索(24 条) | Recall@6 | 0.85 | 固定分块 0.73;agentic 0.79 | 边界敏感查询获益最大的类别之一 |
| 比较类查询检索(134 条) | Recall@6 | 0.79 | 固定分块 0.72;agentic 0.78 | 行级表格散文直接改善跨实体比较 |
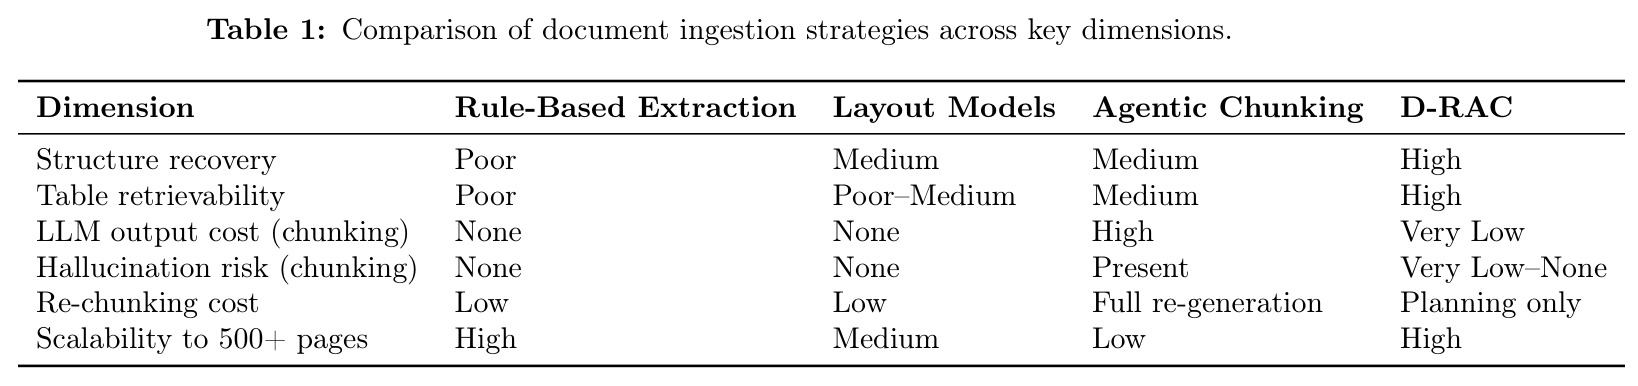
| 长文档可扩展性(503 页招股书) | 转换时间 / 规划时间 | 21.6 分钟(27B)/13.4 分钟(12B);5,060 元素规划 68.7 s | agentic chunking 对 500+ 页可扩展性低(Table 1) | 每页成本与短文档一致,线性扩展无超线性退化 |
局限与改进
作者承认并经我补充的局限如下。其一,评测仅在 RAG-Multi-Corpus 的 PDF 子集上进行,阶段一是恒等映射——DOCX/PPTX/XLSX/扫描件的实际转换质量(字体嵌入、扫描倾斜、公式渲染)未被验证,而这恰是通用摄取这一卖点的核心场景。其二,转换保真完全依赖提示词的逐字保留要求,论文没有对 1,020,219 字符转换输出做多模态模型漏抄、错抄或幻觉改写的量化审计,只有确定性后处理做格式兜底。其三,检索判定采用块中出现支撑事实至少 60% 内容词的词面规则,可能系统性偏向行级散文化表格(与查询措辞词面重叠更高),缺少人工或 LLM 判定的交叉验证。其四,布尔类查询上 agentic 仍占优(0.86 对 0.82),说明 ID 规划并非在所有推理类型上零代价。其五,语料为五个虚构企业组织,真实企业文档的页眉页脚、水印、附件噪声鲁棒性未测;只评测检索指标而未评测端到端 RAG 答案质量与引用忠实度;仅用单一嵌入模型(Titan V2)和固定余弦 top-K,结论对其他检索器的普适性未知。
独立分析的弱点
独立分析的弱点与改进方向。第一,转换幻觉无验证机制:提示词要求逐字保留,但不存在源页面与输出的对齐校验,金融费率、医疗剂量等高风险内容可能被无声改写后进入索引;可引入 OCR 文本与转换输出的对齐评分,低置信页降级为人工审核或升级更强模型。第二,行级散文膨胀索引规模:长费用表每行一句,可能把一页表格变成数百条独立句子,嵌入与存储成本随之上升,且丢失了行的聚合视图;可对同表句子做父子关联存储,命中时重建原表供引用展示。第三,200 DPI 加 1568 像素上限对小字号表格(如保险费率表)可能仍不可读,论文未按页面分辨率做失败分析;可加自适应重渲染,对低置信区域局部放大后再转换。第四,Gemma-3 27B/12B 属中等规模开源模型,遇到多栏加公式加脚注的复杂学术版式时稳健性存疑(评测语料版式相对规整);可引入难度路由,难页自动升级到更大模型。第五,吞吐依赖 Bedrock 并发配额:5 并行 worker、5 页批的假设在配额受限环境不可复制,批大小与并行度应做成自适应以贴近真实部署约束。
未来方向
作者在结论中提出的方向:实体感知分块、基于图的检索、按租户策略驱动的块重组——三者都因转换产物持久化、重规划只需秒级 ID 调用而变得切实可行。基于本文成果可自然延伸的研究:把行级表格散文与知识图谱三元组抽取结合,使表格事实同时服务稠密检索与符号推理;在转换阶段增加忠实度自评与确定性 OCR 比对形成闭环质检,把零错误从吞吐指标升级为保真指标;构建 W-RAC/D-RAC 统一路由,输入先判别是否为原生结构化内容以避免不必要的像素化开销;把评测推进到端到端 RAG 答案正确性与引用忠实度,并在真实企业脏数据上重跑;探索更小的专用转换模型(在 Gemma-3 12B 以下蒸馏或微调),进一步压缩每页 3.9-5.5 秒的转换延迟;以及在布尔类查询上加装轻量关键词或混合检索通道,补齐相对 agentic 的唯一短板。
复现评估
复现条件较为友好。评测基准 RAG-Multi-Corpus 已开源(github.com/udayallu/RAG-Multi-Corpus);两个核心提示词全文见于附录 A.1(八条转换规则)与 A.2(ID 级语义分组规则);A.3 给出实现细节:PyMuPDF 200 DPI 渲染、1568 像素上限、Bedrock Converse API、temperature 0.1、3 次指数退避重试、5 页批、5 并行 worker、60 元素分节预算。算力上无需自建 GPU——只需 AWS Bedrock 访问权限(Gemma-3 27B/12B 与 Titan Text Embeddings V2);按 Table 10 量级,236 文档全流程分块成本不足 $1($0.624),加转换成本也在个位数美元级,重复实验代价很低。风险在于论文未明确说明管线代码本身是否开源,分节算法(最粗优先递归、小节合并阈值)需按文字描述自行实现,提示词之外仍有工程细节要补。总体难度中等偏低,一名熟悉 RAG 工程的工程师约 1-2 周可复现主干并在小语料上验证趋势。
论文图表