PackLab:机器人装箱中多模态大模型的开发、训练与评估综合框架 PackLab: A Comprehensive Framework for Developing, Training, and Evaluating MLLMs in Robotic Bin Packing
用物理仿真数据微调9B多模态大模型,实现闭环机器人装箱决策,性能超启发式与RL。
前置知识
机器人装箱问题
在尺寸受限的容器内逐个放置三维物体,目标是最小化占用高度、最大化空间利用率。它不仅是几何优化问题,更是序列决策问题:每一次放置都会改变剩余可用空间,影响后续所有物体的可行性。经典解法包括遗传算法等离线优化、DBLF/MTA/SDF-Pack等在线几何启发式,以及强化学习策略。
本文的全部动机、公式与评测指标(Success Ratio、Compactness)都建立在对这个问题的形式化理解之上,不懂装箱的任务结构就无法理解为什么闭环历史输入如此重要。
多模态大语言模型(MLLM)
能同时处理文本与视觉输入的自回归大模型,典型结构是文本tokenizer加视觉编码器,视觉特征经投影层映射到语言模型的嵌入空间,与文本token拼接成统一序列后解码输出。本文用的Qwen3.5-9B即此类模型,可接受交错的图像与文本上下文。
PackLab-VLM的核心就是把容器高度图当作图像输入、把物体属性和动作历史当作文本输入,靠MLLM的多模态表征能力联合决策,理解其输入编码方式(论文公式5-8)是读懂方法部分的前提。
容器高度图
从容器顶部向下投影得到的二维高度栅格 $H_t$,每个单元记录该位置当前堆叠物的最高高度。它是装箱状态的紧凑表征:新物体放到 $(x_t, y_t)$ 时,其垂直坐标 $z_t$ 取其footprint覆盖区域内高度图的最大值,即重力下的最低可达位置。
高度图是PackLab-VLM唯一的视觉输入和状态反馈通道,动作的垂直坐标由它决定,消融实验中把它换成黑色干扰图会导致Overall Score从0.660跌到0.494,可见它是模型空间推理的信息来源。
监督微调(SFT)
在标注好的输入-输出对上继续训练预训练模型,目标是最大化真实输出token的条件对数似然。本文用step级监督:每条装箱轨迹的每个决策步都提供(多模态上下文,真实动作文本)样本,损失为负对数似然 $\mathcal{L} = -\frac{1}{N}\sum_n \sum_t \log p_\Theta(\tau^*_{n,t} | X_{n,t})$。
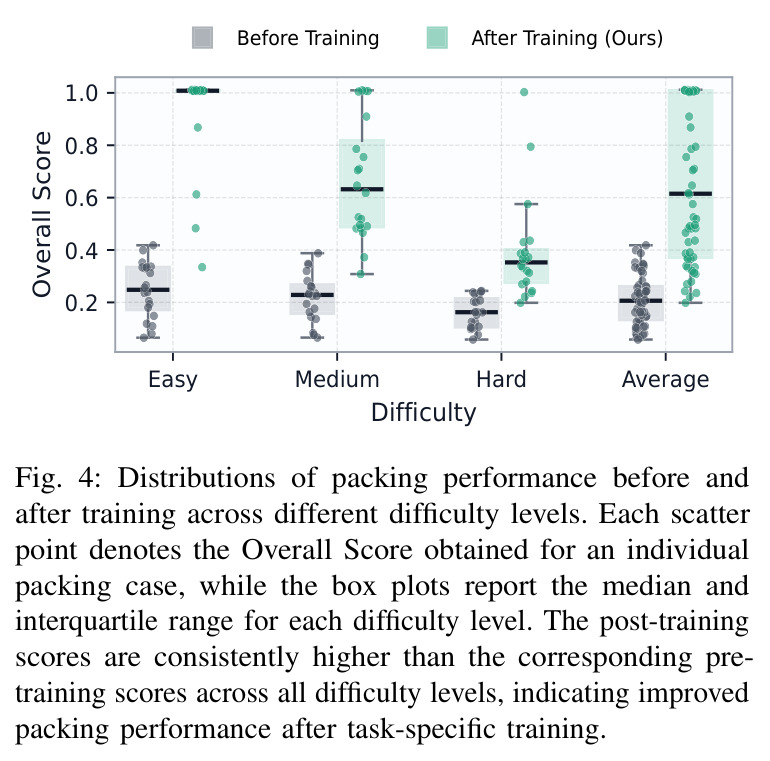
论文训练前后对比显示零样本基座模型平均Overall仅0.209,SFT后升至0.660,说明任务专用监督是方法成立的关键;同时这是数据生成引擎价值的直接体现。
闭环序列决策
决策与环境反馈交替进行的决策模式:每一步动作执行后环境状态发生变化,下一步决策基于更新后的完整状态序列而非一次性规划。与之相对的是开环方式——先离线算出完整方案再顺序执行,遇到物理偏差即失效。
本文标题和核心贡献都围绕closed-loop:模型每步看到演化后的高度图和已执行动作历史再决策。消融中去掉动作历史Overall降到0.589、只用当前观测降到0.533,闭环正是超越开环规划的性能来源。
研究动机
机器人装箱要求在容器内逐个放置物体以最大化空间利用率,本质是长时程序列决策:每一步放置都会改变后续所有物体的可用空间。现有方法有三类缺陷。其一是手工几何启发式(DBLF选最深最低位置、MTA最大化接触面积、SDF-Pack最小化符号距离场),只评估单次放置的局部目标,无法显式考虑对剩余空间和后续可行性的影响——本文实验中最强的SDF-Pack在统一评测下平均Overall Score也只有0.602,且在密集受限场景中常把剩余空间碎片化。其二是强化学习方法(TAP-Net、IR-BPP),需在预定义的物体与容器分布上大量试错,官方checkpoint在统一协议下平均Overall仅0.474和0.442;即便同分布用等量试错重训也只达0.405和0.345,难以泛化到异构配置。其三是已有MLLM工作(OPA-Pack、iPack、LLM-Pack)只用大模型推断物体属性或语义约束,动作执行仍交给传统规划器,形成两段式管线;PackingGPT虽直接预测顺序放置,却不做基于演化状态的闭环决策。
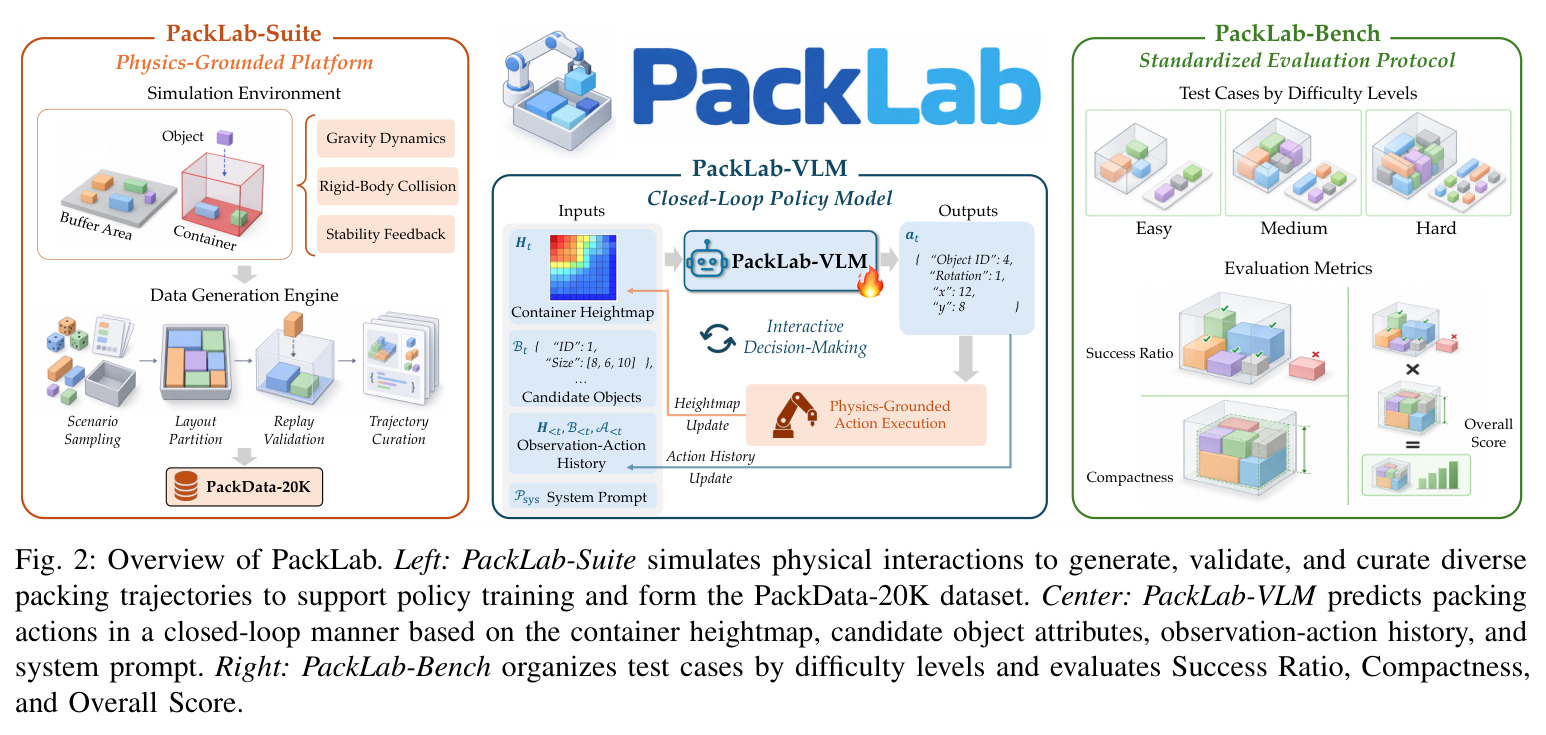
本文的目标是本文要回答一个根本问题:多模态大语言模型能否直接执行闭环的物体选择与放置决策,跨越多样的物体集合、容器几何和任务复杂度?为此作者构建了一个自成一体的框架PackLab,一次性补齐四个此前缺失的环节:(1) 物理接地的仿真平台,模拟重力、刚体碰撞与稳定性反馈;(2) 可扩展的训练数据生成,产出两万条物理有效的多样化装箱轨迹(PackData-20K),避免穷举式前向采样;(3) 装箱专用的训练配方,让9B的MLLM理解演化的容器高度图与候选物体状态,逐步自回归地联合输出物体选择、朝向和平面坐标;(4) 标准化评测协议PackLab-Bench,60个用例按easy/medium/hard三档共905个装箱步骤,以Success Ratio、Compactness及其乘积Overall Score统一比较启发式、RL和通用MLLM基线。最终目标是在异构装箱配置上超越传统方法,并通过真机实验验证sim-to-real可行性。
与已有工作不同的是,论文的独特切入在于把MLLM从装箱系统中的辅助角色提升为决策主体。此前MLLM方法只负责理解——推断物体属性或语义约束,放置动作交给几何搜索或规划器;而PackLab让一个模型直接在每一步输出结构化动作文本(选哪个物体、转90度还是0度、放到哪个平面坐标),且决策时能看见完整的多轮交互历史:历史高度图、历史候选物体缓冲与已执行的动作序列。这种闭环形式化迫使模型隐式学习空间推理与长时程后果预测,而不是把推理外包给规划器。作者同时意识到这个方向的真正瓶颈不在模型而在生态:没有物理仿真就没有可靠的监督与验证信号,没有大规模轨迹数据就无法微调,没有与训练集严格隔离的benchmark就无法公平比较——因此把仿真平台、数据引擎、训练方法和评测协议整合成一个可复用的框架,本身就是对领域基础设施缺口的一次性补齐,这也是论文标题强调comprehensive framework的原因。
核心方法
直觉上,装箱就像三维版俄罗斯方块:模型每步俯视容器高度图 $H_t$ 和候选物体清单 $B_t$,决定拿哪个物体、转多少度、放到平面哪个位置;物体在重力下落到最低可达位置,环境返回更新的高度图,循环直到处理完所有物体。技术路线分三部分。首先把装箱形式化为闭环序列决策:第 $t$ 步状态 $S_t = (H_t, B_t)$,策略预测动作 $a_t = (b_t, o_t, x_t, y_t)$;垂直坐标由物理决定,$z_t = \max H_t[x_t+i, y_t+j]$,即放置footprint内高度图最大值。其次,PackLab-Suite以重力 $-9.8\,m/s^2$、刚体碰撞和稳定性反馈驱动仿真,用layout-first引擎逆向重建物理有效的装箱轨迹,构成PackData-20K。第三,PackLab-VLM以Qwen3.5-9B为骨干,把系统提示、文本化的物体与动作历史、视觉编码的高度图拼成多模态序列,自回归解码出结构化动作文本;最后PackLab-Bench按三档难度60个用例评测。
核心创新是闭环多模态决策的完整实例化,与已有方法有三点本质区别。第一,决策主体不同:启发式和RL在固定配置下优化策略,此前MLLM方法(OPA-Pack、iPack、LLM-Pack)只做属性推断、动作交给外部规划器,PackingGPT不做状态闭环;而PackLab-VLM每步基于完整交互历史 $X_t = (P_{sys}, S_1, a_1, \ldots, S_{t-1}, a_{t-1}, S_t)$ 直接联合输出物体选择与放置。消融证实闭环历史是性能命脉:去掉动作历史Overall从0.660降到0.589,只用当前观测跌到0.533。第二,数据生成范式不同:layout-first逆向生成——先采样容器尺寸与物体数,把容器按高度切层、层内切非重叠区域构成终局布局,再迭代移除几何可达物体并反转顺序得到前向轨迹 $A^*$,避免对物体-放置组合的穷举前向采样,最后在重力、碰撞、稳定性下重放验证,过滤后得到2万条跨难度训练数据。第三,训练目标不同:step级SFT最大化真实动作文本的对数似然,让模型学会可执行的结构化输出而非泛泛的语义描述。
方法步骤详情
流水线分五步。第一步,问题形式化:定义状态、动作与目标,垂直坐标 $z_t$ 自动取放置区域高度图最大值。第二步,PackLab-Suite仿真:每次放置后以 $-9.8\,m/s^2$ 重力模拟沉降,用盒状碰撞几何解析各类接触,稳定性模块监测线速度与角速度,低于阈值判定静止并记录后置状态。第三步,数据生成四阶段:采样容器尺寸与物体数;容器沿高度切层、层内切非重叠区域构成终局布局;迭代移除几何可达物体、反转顺序重建轨迹 $A^*$,物理重放并丢弃无效轨迹;筛选形成跨难度混合的PackData-20K。第四步,PackLab-VLM训练:文本序列经嵌入层得 $U_t$,当前与历史高度图经视觉编码器得 $V_k$,组合成 $F_t$ 后自回归解码动作文本;损失 $\mathcal{L} = -\frac{1}{N}\sum \log p_\Theta(\tau^*|X)$,AdamW学习率 $1\times10^{-5}$、5个epoch、8卡FSDP;朝向离散为0°/90°,坐标2.5cm。第五步,PackLab-Bench评测:60用例分三档难度,3个随机种子报告三项指标。
技术新颖性
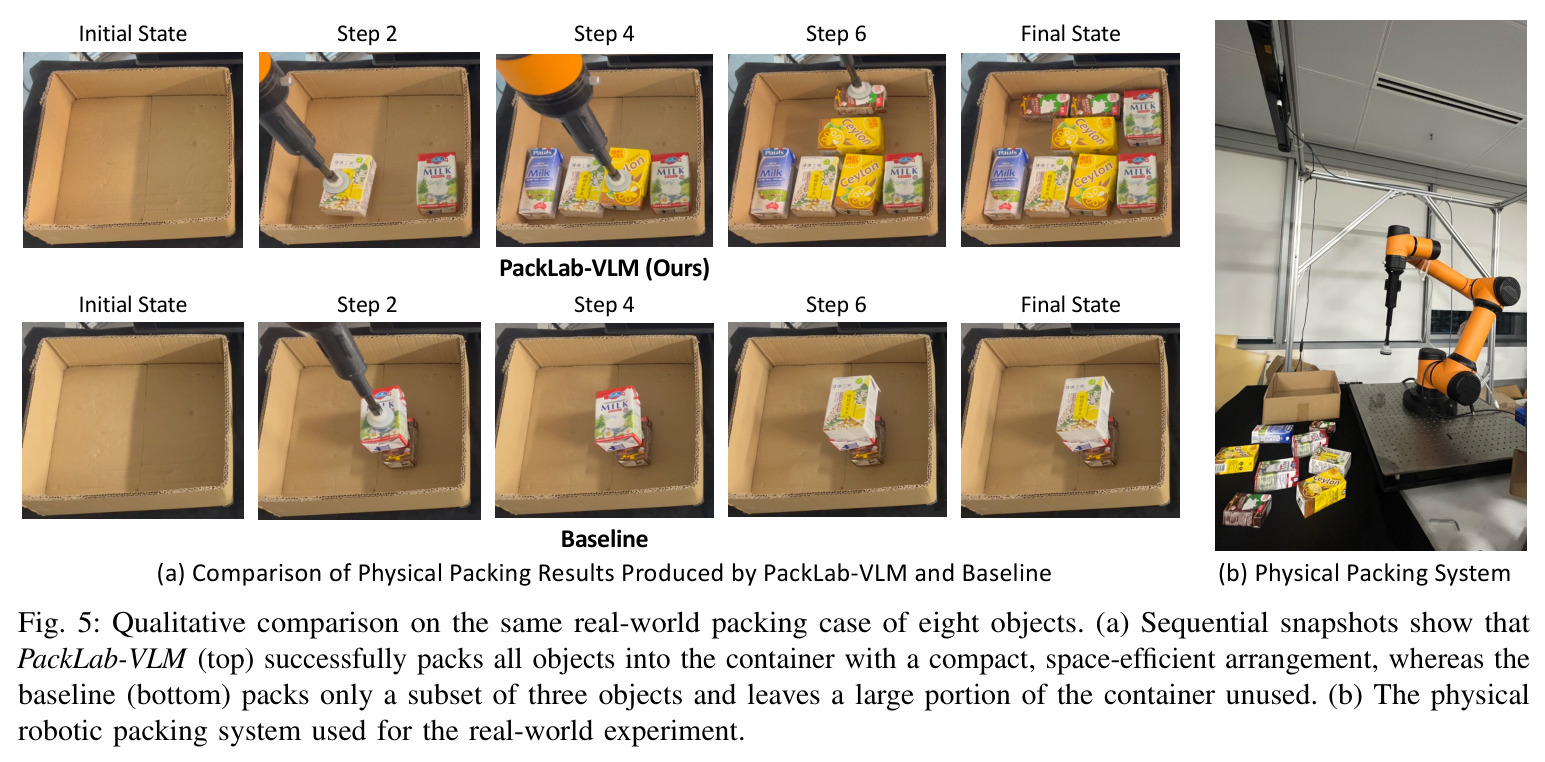
技术新颖性体现在四个层面。数据层面,layout-first逆向生成是少见做法:不从随机前向采样出发,而是先构造几何合法、空间紧凑的终局布局再反推动作序列,保证每条轨迹目标可达,重放验证进一步用真实物理过滤,最终PackData-20K覆盖easy(4-8物体)、medium(9-18)、hard(19-32)三档。模型层面,把多轮视觉-文本交错历史作为一等公民输入——当前与历史高度图都过视觉编码器,消融中把真实高度图换成黑色干扰图使Overall从0.660跌至0.494,证明模型真正利用视觉几何而非表面输入格式。评测层面,PackLab-Bench与训练集严格不相交(用例独立采样并校验),Overall定义为 $R_{all} = R_{succ} \cdot C$,同时惩罚放不进去和放得松散两类失败,比单指标更公允。系统层面,闭环延伸到真机:SAM3分割缓冲区物体、点云估计尺寸、主轴分析定抓取朝向,每次放置后重扫描容器、偏差过大时触发重规划,把sim-to-real落差处理纳入框架设计而非事后补丁。
实验结果
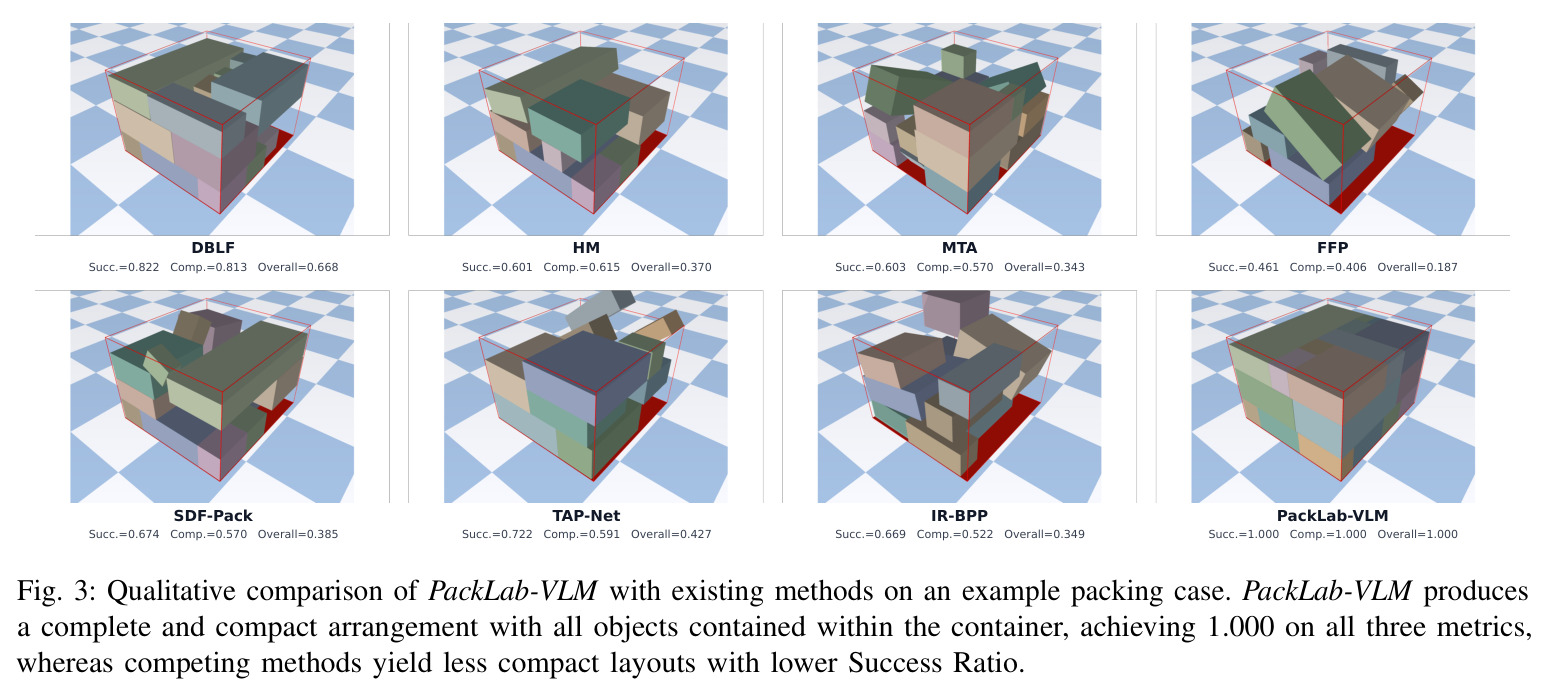
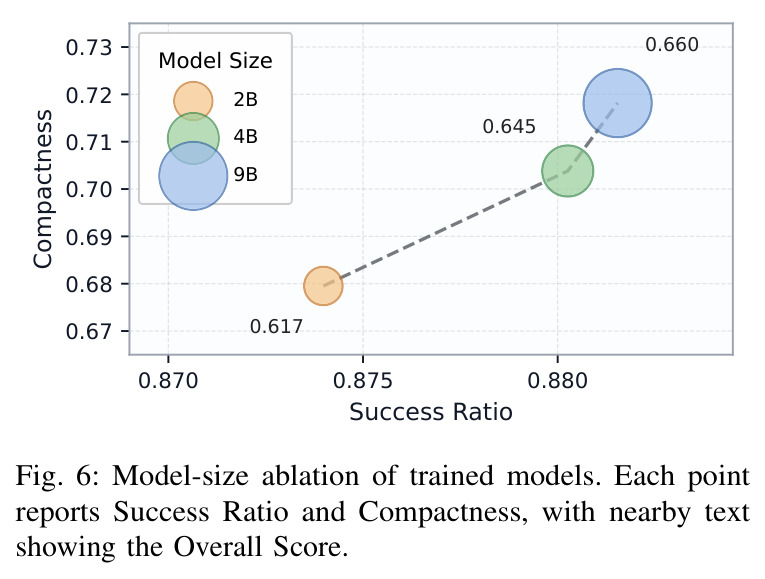
主实验(Table II)中PackLab-VLM平均Overall 0.660全场最佳:超最强启发式SDF-Pack(0.602)0.058、超最强RL方法TAP-Net(0.474)0.186,Succ 0.882与Comp 0.718均最高。分难度:easy近乎完美(0.999/0.923/0.922),medium 0.665超DBLF的0.626;hard是唯一短板,0.394低于SDF-Pack等的0.469。训练增益显著:零样本基座仅0.209,训练后0.660。同分布重训TAP-Net与IR-BPP仅0.405和0.345。Table III消融:高度图换黑色干扰图降至0.494,只用当前观测0.533、去动作历史0.589,全历史0.660最佳。Table IV数据消融:25%/50%/100%数据对应0.578/0.630/0.660,easy-only 0.587、easy+medium 0.604、混合0.660。模型尺寸2B/4B/9B对应0.617/0.645/0.660。真机:8物体全部放入(Succ 1.00、Comp 0.72),基线只放入3个。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 异构装箱配置平均性能(PackLab-Bench,60用例) | Overall Score(Success Ratio × Compactness) | 0.660(Succ 0.882,Comp 0.718) | SDF-Pack 0.602(最强启发式);TAP-Net 0.474(最强RL官方checkpoint) | 较SDF-Pack +0.058,较TAP-Net +0.186 |
| Easy难度装箱(buffer 3,1-2层,4-8物体) | Overall Score | 0.922(Succ 0.999,Comp 0.923) | SDF-Pack 0.718 | +0.204,接近完全装箱 |
| Medium难度装箱(buffer 5,2-3层,9-18物体) | Overall Score | 0.665(Succ 0.966,Comp 0.680) | DBLF 0.626 | +0.039,成功率持平下紧凑度更高 |
| Hard难度装箱(buffer 10,3-4层,19-32物体) | Overall Score | 0.394(Succ 0.680,Comp 0.552) | SDF-Pack 0.469;DBLF 0.469 | -0.075(落后),密集受限场景仍弱于几何搜索 |
| 真实机器人装箱(AUBO机械臂,30×30×10cm容器,8物体) | Success Ratio / Compactness | 1.00 / 0.72,8个物体全部放入且排列紧凑 | 基线方法仅放入3个物体,容器大片空间闲置 | 装箱物体数3→8,空间利用率大幅提升 |
| 同分布重训的RL基线对照 | Overall Score | 0.660 | 重训TAP-Net 0.405;重训IR-BPP 0.345 | +0.255 / +0.315,说明MLLM路线在异构配置上优势显著 |
局限与改进
作者明确承认的局限:hard难度下Overall 0.394低于SDF-Pack与DBLF的0.469,空间约束极紧、剩余布局复杂时MLLM的细粒度空间推理仍不敌专门几何搜索;受算力限制最大只测到9B模型,更大规模的潜力未知;结论中提出需扩展到更广的物体几何与物理设定。我自己的观察还有几点:动作空间被强离散化——朝向仅0°/90°两种、坐标2.5cm网格,对需要任意角度旋转或亚厘米精调的异形物体不友好;仿真与数据生成采用盒状碰撞几何和水平层分解,天然偏向长方体堆叠,非凸物体的密集堆叠未覆盖;评测全部在自建的PackLab-Bench上进行,缺少与外部装箱benchmark或OPA-Pack等前作设置的交叉验证;真机实验只展示一个8物体案例并给出定性比较,样本量小,重规划触发机制的量化效果未报告;此外每步推理都要重新编码全部历史高度图,上下文长度随步数线性增长,905步评测的显存与时延开销、以及长序列下的历史截断策略论文均未讨论,这对实际部署是潜在瓶颈。
独立分析的弱点
第一,hard场景短板(0.394 vs SDF-Pack 0.469):密集高歧义状态下模型易做出局部可行但破坏后续空间的放置,可引入test-time搜索——采样多个候选动作后用轻量仿真rollout打分择优,或对high-ambiguity状态加权采样训练。第二,离散动作空间限制表达力:90°旋转加2.5cm网格无法表达斜放与精调,可增加连续回归头或扩散式动作解码。第三,数据生成几何假设过强:layout-first按水平层切分隐含长方体堆叠偏置,对圆柱、L形物体需推广可达性分析,或用SDF表示做非凸布局分区。第四,历史输入效率问题:每步重编码全部历史高度图,上下文随步数线性膨胀,可研究历史状态压缩或层级记忆。第五,评测生态单薄:所有对比都在自家bench完成,应补充对未见容器形状和物体分布漂移的zero-shot测试,并与外部装箱协议对齐。第六,真机验证太薄:单一8物体案例难以支撑sim-to-real结论,应报告多场景成功率分布与重规划触发率,并加入扰动实验考察恢复能力。
未来方向
作者在结论中提出两个方向:扩展PackLab到更广的物体几何与物理设定,以及支持用户自定义目标与约束的更灵活装箱行为。基于本文成果还可延伸几条路。其一是RL后训练:当前纯SFT模仿layout-first生成的轨迹,性能上限受数据分布约束,若以Overall Score为奖励做GRPO/PPO式微调,模型有机会超过数据本身的紧凑度,尤其可能补齐hard场景的0.394。其二是规模扩展与推理时计算:模型尺寸消融显示2B到9B单调提升(0.617到0.660),作者也明言更大MLLM是未来方向,配合多候选采样加仿真验证的test-time扩展值得尝试。其三是主动感知:真机管线已用SAM3分割和容器重扫描触发重规划,未来可让模型直接消费多视角点云或增量高度图,减少对完美高度图重建的依赖。其四是框架迁移:PackLab的仿真-数据-评测三件套是可复用基础设施,可迁移到卸货、码垛、料箱拣选等相邻顺序操纵任务。其五是评测维度扩展:加入时间效率、能耗与机械臂可行性约束(可达性、避奇异点),让Overall Score更贴近工业部署指标。
复现评估
复现条件总体较好。开源情况:代码、模型权重、PackData-20K数据集和PackLab-Bench基准全部公开于GitHub(github.com/Correr-Zhou/PackLab),四大件齐全。算力需求:完整训练用8卡集群、5个epoch,FSDP加bf16与梯度检查点,AdamW学习率 $1\times10^{-5}$、全局batch 8;9B微调对普通实验室偏高,但消融显示2B/4B分别有0.617/0.645的Overall,资源受限时可先复现小规模验证流程。数据侧:layout-first生成引擎随代码发布,可自行扩展数据或调整难度配比;评测侧60个用例固定且与训练集严格不相交,三个指标的公式定义清晰,结果为3个随机种子平均,方差可控。主要复现风险:仿真引擎的物理参数(重力、稳定性速度阈值、碰撞几何精度)需读代码确认细节;真机部分需要AUBO机械臂、RealSense与Photoneo双相机及SAM3分割模型,门槛较高,但纯仿真与benchmark复现无此依赖。综合判断:仿真与评测流水线复现难度中等,训练9B需要多卡环境,真机部分依赖实验室硬件条件。
论文图表
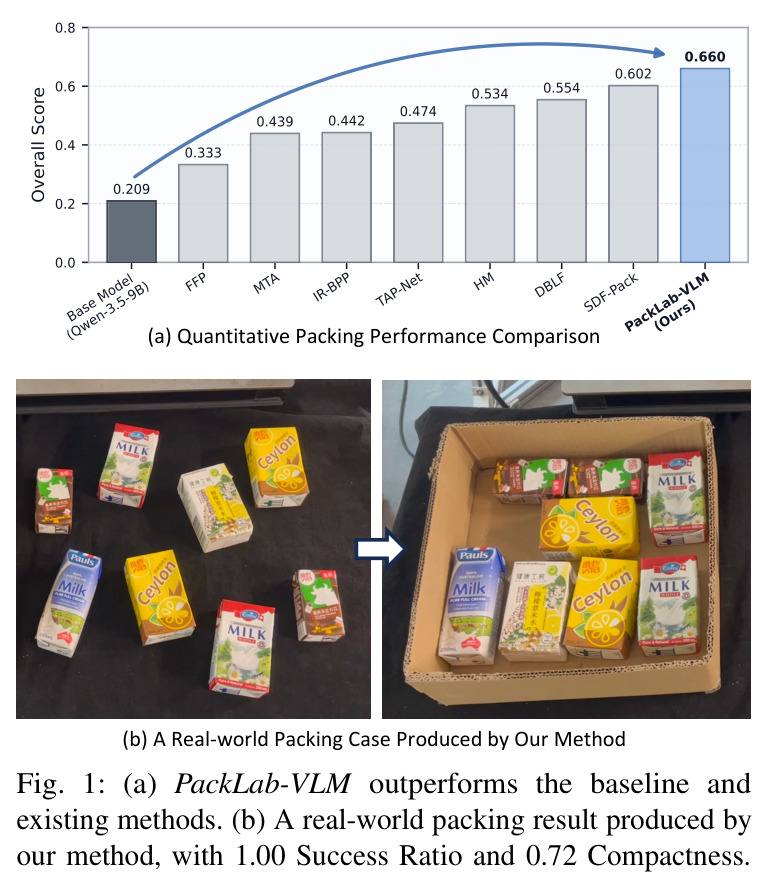
两部分组成:(a) 是定量装箱性能对比柱状图,展示PackLab-VLM在Overall Score上超越基线和现有方法;(b) 是方法产生的真实世界装箱案例照片,Success Ratio 1.00、Compactness 0.72,物体排列整齐紧凑。
开篇即用一张图同时给出定量优势与真机可行性证据,是快速把握论文核心主张(MLLM闭环装箱全面超越启发式与RL)的最佳入口。
PackLab-Bench三档难度的参数统计:Easy档buffer 3、1-2层、4-8个物体;Medium档buffer 5、2-3层、9-18个物体;Hard档buffer 10、3-4层、19-32个物体,合计60个用例、905个装箱步骤。
定义了评测协议的难度轴(候选缓冲大小、堆叠层数、物体数量、容器尺寸),是解读Table II中分难度结果和设计数据消融配方的基准参照。
主结果表:8种方法(DBLF、HM、MTA、FFP、SDF-Pack五种启发式与TAP-Net、IR-BPP两种RL)在easy/medium/hard/平均四列下的三指标对比。PackLab-VLM平均Overall 0.660最佳(Succ 0.882、Comp 0.718),easy 0.922、medium 0.665均领先,hard 0.394低于SDF-Pack与DBLF的0.469。
论文最重要的证据表:所有定量结论(超越启发式与RL、easy/medium优势、hard短板)都出自此表,其逐难度分解也是理解方法适用边界的关键。
输入上下文消融:把高度图换成黑色干扰图使Overall从0.660降至0.494;顺序历史方面,只用当前观测得0.533、去掉动作历史得0.589,完整历史(本文方法)0.660最佳。
证明模型确实依赖视觉几何信息与闭环历史而非表面输入格式,是闭环多模态设计这一核心主张的直接实验支撑。
训练数据消融:数据规模上25%/50%/100%的PackData-20K对应Overall 0.578/0.630/0.660;数据配方上easy-only 0.587、easy+medium 0.604、三档混合(本文方法)0.660。
论证了layout-first引擎产出的数据量和难度覆盖都是性能来源:easy案例稳定几何基础、medium教会常见受限决策、hard暴露密集高歧义状态,混合配方缺一不可,直接指导数据工程实践。