一对多,多对一:面向软件工程智能体的类目感知迭代专家训练 One to More, More to One: Category-Aware Iterative Expert Training for Software Engineering Agents
按类目把SWE任务分而治之训练专家,再用多教师在线蒸馏合并成单一更强智能体
前置知识
仓库级软件工程任务(Repository-level SWE)
指智能体在真实代码仓库中解决问题的任务。论文将其形式化为五元组 $x=(R,b,q,E,V)$:仓库 $R$、基线版本 $b$、自然语言问题描述 $q$、可复现执行环境 $E$ 和可执行验证器 $V$。智能体只能看到问题描述和工具返回,不能看参考补丁与隐藏测试,最终提交补丁 $p=\mathrm{diff}(R_0,R_T)$,须通过 fail-to-pass(修复目标缺陷)与 pass-to-pass(不引入回归)两类测试才算成功。
本文全部训练与评测都建立在这类可执行任务上,理解五元组与二值可执行奖励是看懂任务构建、奖励定义和 Pro-618 评测口径的基础。
RLVR 与稀疏二值终端奖励
可执行验证强化学习(RLVR)用环境验证结果充当奖励。SWE 任务中奖励 $r^{env}(x,p)=\mathbb{I}[\mathrm{apply}(p)\wedge V_{F2P}(R_T)\wedge V_{P2P}(R_T)]$ 只有 0/1 两种取值,且要经过多达 150 轮工具调用的长轨迹才能获得,信号极其稀疏;同一任务多次采样的成败差异构成了组内对比学习的唯一信号来源。
奖励稀疏且二值,直接决定了论文为何要引入 RLOO 基线、K1 正则、按通过率选题等一系列训练稳定化设计。
RLOO(留一法组相对优势)
对同一任务采样 $G$ 条轨迹,用除去自身的其余轨迹平均回报作基线:$\bar{R}_i = R_i - \frac{1}{G-1}\sum_{j\neq i} R_j$。该基线与轨迹 $i$ 条件独立,期望上不改变策略梯度却能显著降方差,且无需训练 critic。二值奖励下,若一组仅一条成功轨迹,RLOO 给它优势 1,而含自身的均值基线(GRPO 式)只有 $7/8$($G=8$ 时)。
Agentic-miniRL 用 RLOO 保住稀缺成功轨迹的学习信号,这是理解其 RL 目标函数为什么这样设计的关键组件。
在线策略蒸馏(On-Policy Distillation)
传统蒸馏用教师在自身轨迹上的输出监督学生,存在师生轨迹分布失配。在线策略蒸馏让学生自己生成完整轨迹,教师只在学生实际访问到的状态前缀上提供逐 token 对数概率,学生据此更新,从而消除分布失配。多教师版本(MOPD)进一步按任务的领域标签把每个样本路由给对应教师。
本文最终用标签路由的 MOPD 把三个类目专家合并成一个可部署模型,方法章末尾与全部集成实验的核心机制就是它。
K1 反向 KL 正则
$d^{K1}_{i,t}=\log\pi_{\theta^-}(a_{i,t}|h_{i,t})-\log\pi_{ref}(a_{i,t}|h_{i,t})$ 是更新前策略与冻结参考策略的对数比。把它作为 stop-gradient 奖励项放进回报路径(而不是把 K3 估计量当作可微辅助损失),给出 KL 正则化目标的 score-function 梯度,已有受控实验表明比 K3-in-loss 更稳定。
参考策略在本文出现两次:Agentic-miniRL 中用 K1 约束长程漂移,MOPD 中作外推锚点,分清这两处用途才能读懂两阶段目标函数。
研究动机
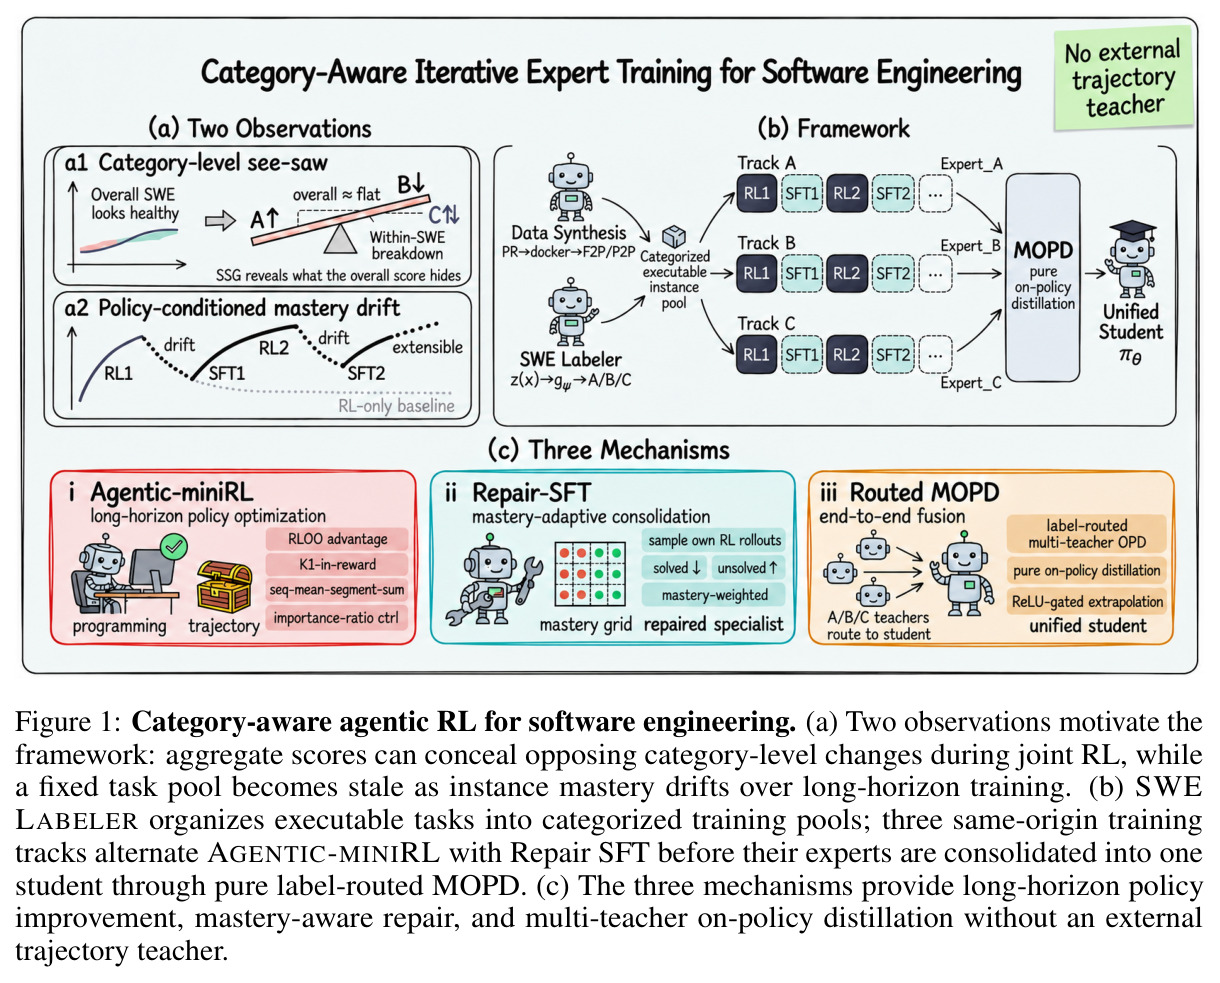
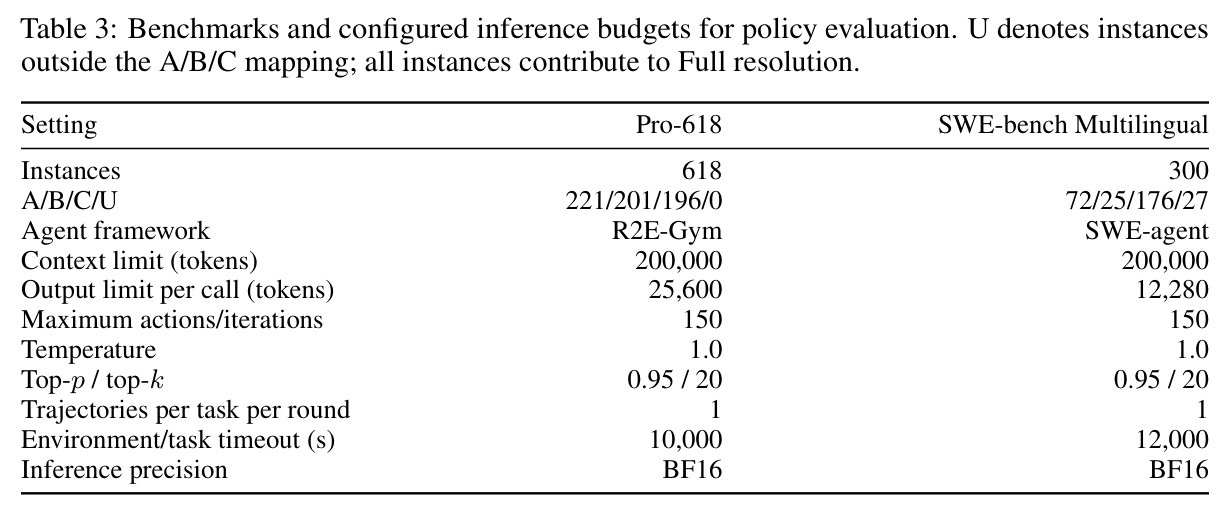
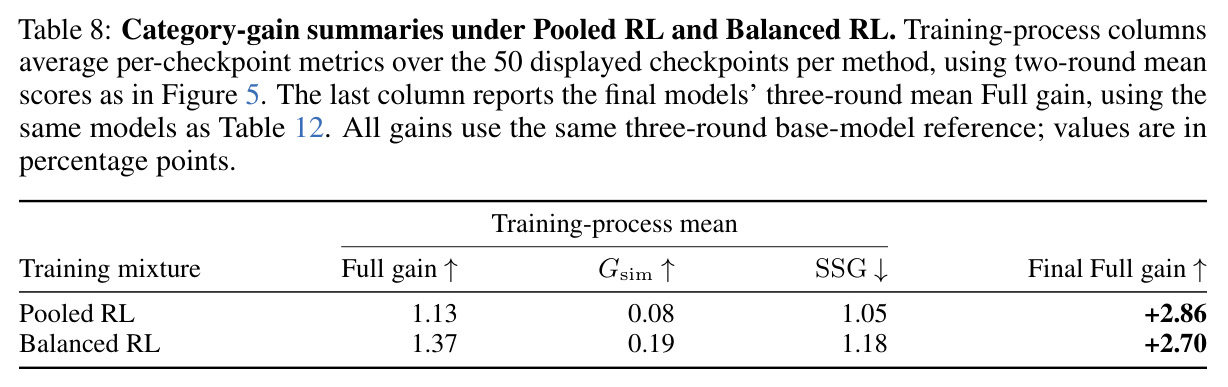
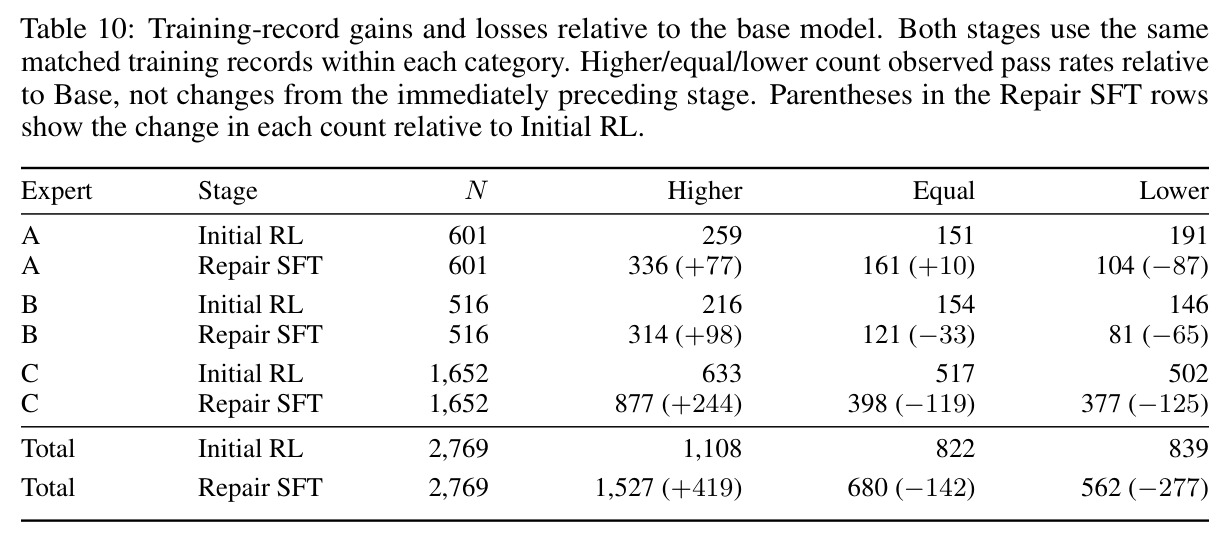
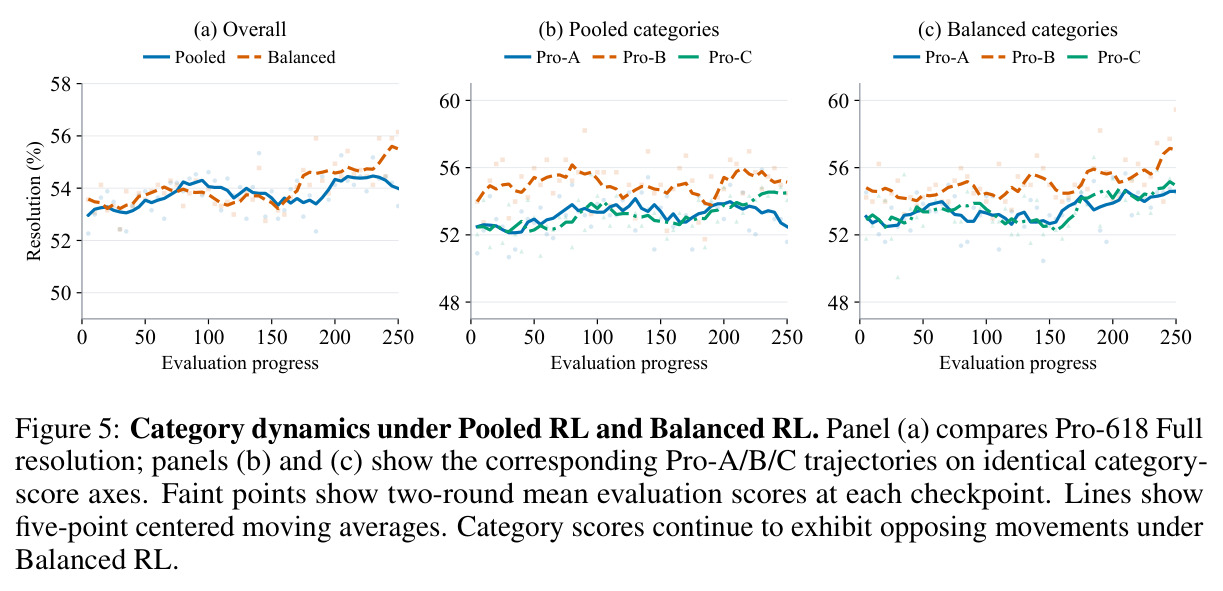
仓库级 SWE 表面上是一个单一任务域,内部却混合了服务/数据层缺陷修复、用户界面调整、基础设施与工具链改造、性能与安全补丁等异质任务,它们在轨迹长度、奖励方差和数据频率上差异巨大。现有系统(SWE-RL、SWE-Gym、SWE-Master 等)把全部任务混在一个池子里做联合 RL。作者在 6,723 个任务上做 Pooled RL,并在 Pro-618(SWE-bench Pro 经审计的 618 实例子集,Pro-A/B/C 分别含 221/201/196 题)上定期评测,发现了所谓「类目跷跷板」:某些类目提升的同时另一些类目回退,而聚合分辨率曲线几乎看不出异常。用论文定义的指标说,联合 RL 过程中平均最小类目增益 $G_{\mathrm{sim}}$ 只有 0.08 个百分点,平均跷跷板间隙 SSG 达 1.05 个百分点,个别检查点上总体增益为正而最差类目增益为负。更细的实例级诊断还显示:即便类目平均分上涨,2,769 条训练记录中仍有 839 条(30.3%)成功率下降。也就是说,单一聚合指标完全掩盖了学习在任务空间内部此消彼长的再分配。
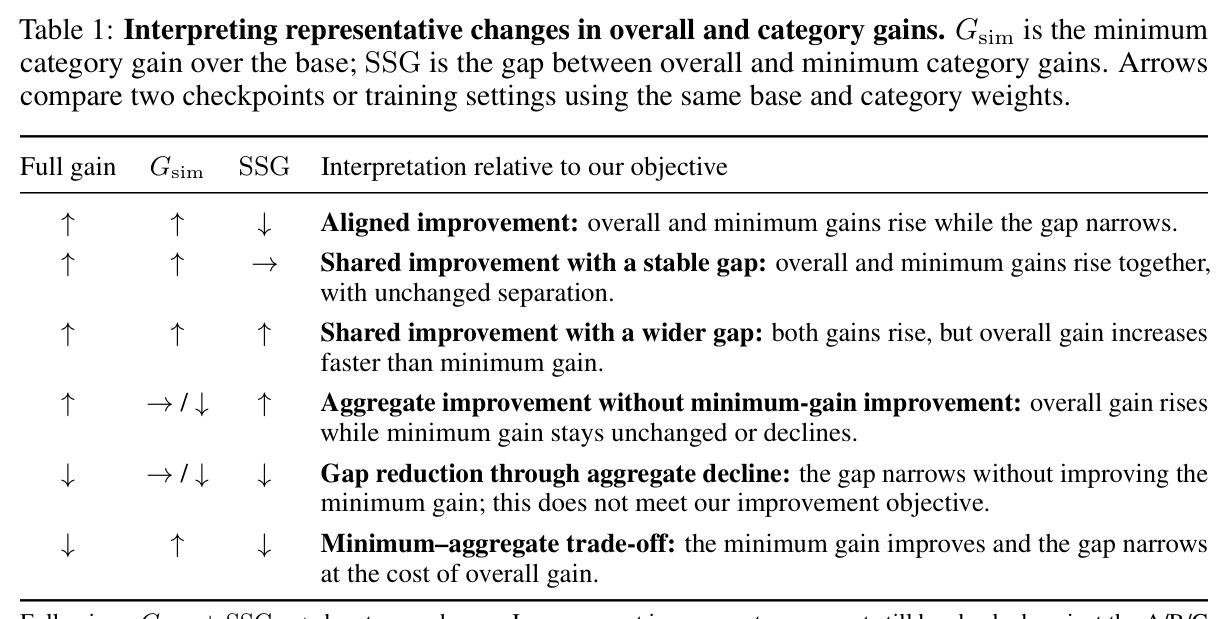
本文的目标是本文的目标是:在不依赖任何外部教师模型提供解题轨迹或动作目标的前提下,把仓库级 SWE 的异质任务组织成可审计的类目,为每个类目训练出显著强于联合 RL 的类目专家,再把多个专家的行为整合进单一可部署策略,使其总体分辨率与每个类目的分辨率同时超过 Pooled RL 和 Balanced RL 两个基线。形式化地说,作者追求表 1 中「对齐改进」模式:最终模型的 Full 增益 $\Delta_{all}$、最小类目增益 $G_{\mathrm{sim}}=\min_c \Delta_c(t)$ 同时变大,且跷跷板间隙 $SSG=\Delta_{all}-G_{\mathrm{sim}}$ 保持较小。最终结果达成目标:MOPD 策略在 Pro-618 上达到 58.04%(较基座 +5.39pp),在 SWE-bench Multilingual 上达到 59.00%(+2.78pp),且三个类目在两个基准上全部优于两个联合 RL 基线。
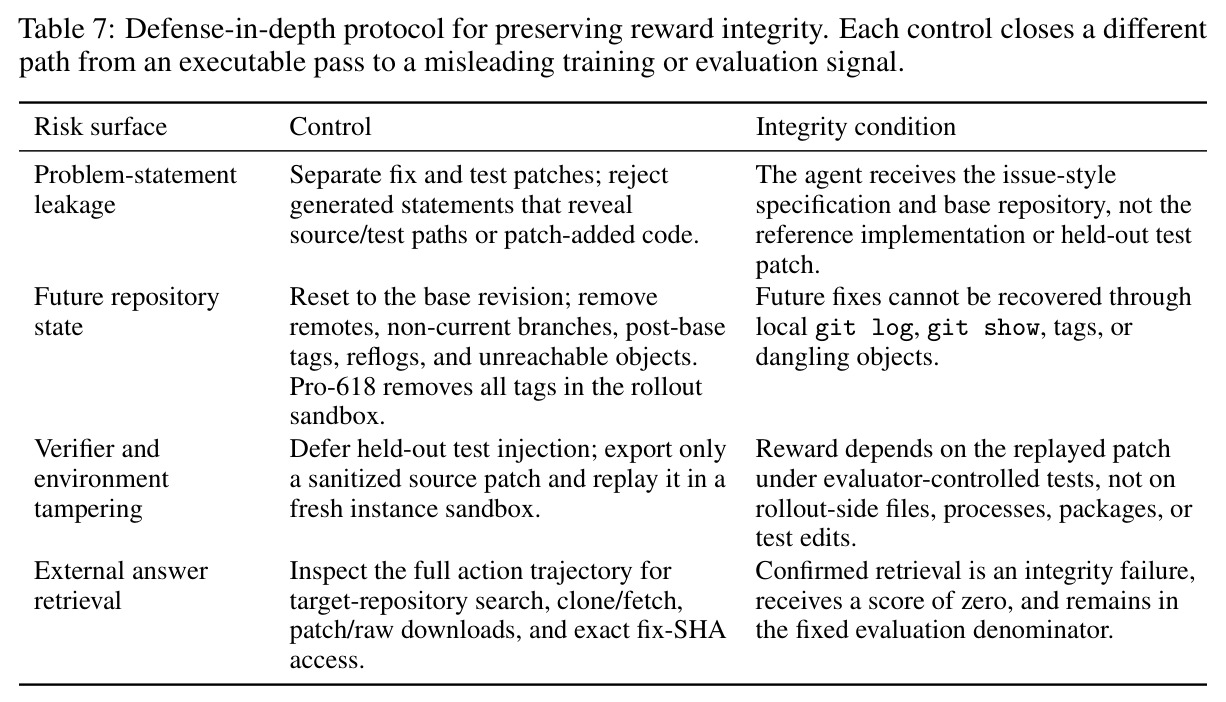
与已有工作不同的是,已有三条路线各留缺口:联合池化训练压抑了类目结构;Agentless、SWE-Fixer、AutoCodeRover 等把解题工作流拆成定位/修复等功能阶段,与本文按训练任务分布划分类目的思路互补而非相同;Branch-Train-Merge、MOPD、ExOPD 等跨域专家拆分-融合方法则依赖天然存在的领域边界(数学、代码生成、指令跟随),在单个传统领域内部并没有现成的专家划分可用。本文的独特切入是:在一个 SWE 领域内部,用锚定权威软件工程文献(ISO/IEC 25010、ISO/IEC/IEEE 14764、MITRE CWE、Fowler 重构目录)的证据型标签体系 SWE Labeler 显式建立类目粒度,用确定性规则把 Repository Domain L1 映射为 A(服务/数据/安全)、B(面向用户应用)、C(系统/工具/运行时)三条路由;然后让三个同源专家各自经历 Agentic-miniRL 与「刷新-修复-扩展」迭代养成,最后用标签路由 MOPD 加 ReLU 门控奖励外推把它们蒸馏回单一模型。整个闭环不需要外部大模型给出解法轨迹,这是与 SWE-Master 等「大教师蒸馏+RL」流水线的本质区别。
核心方法
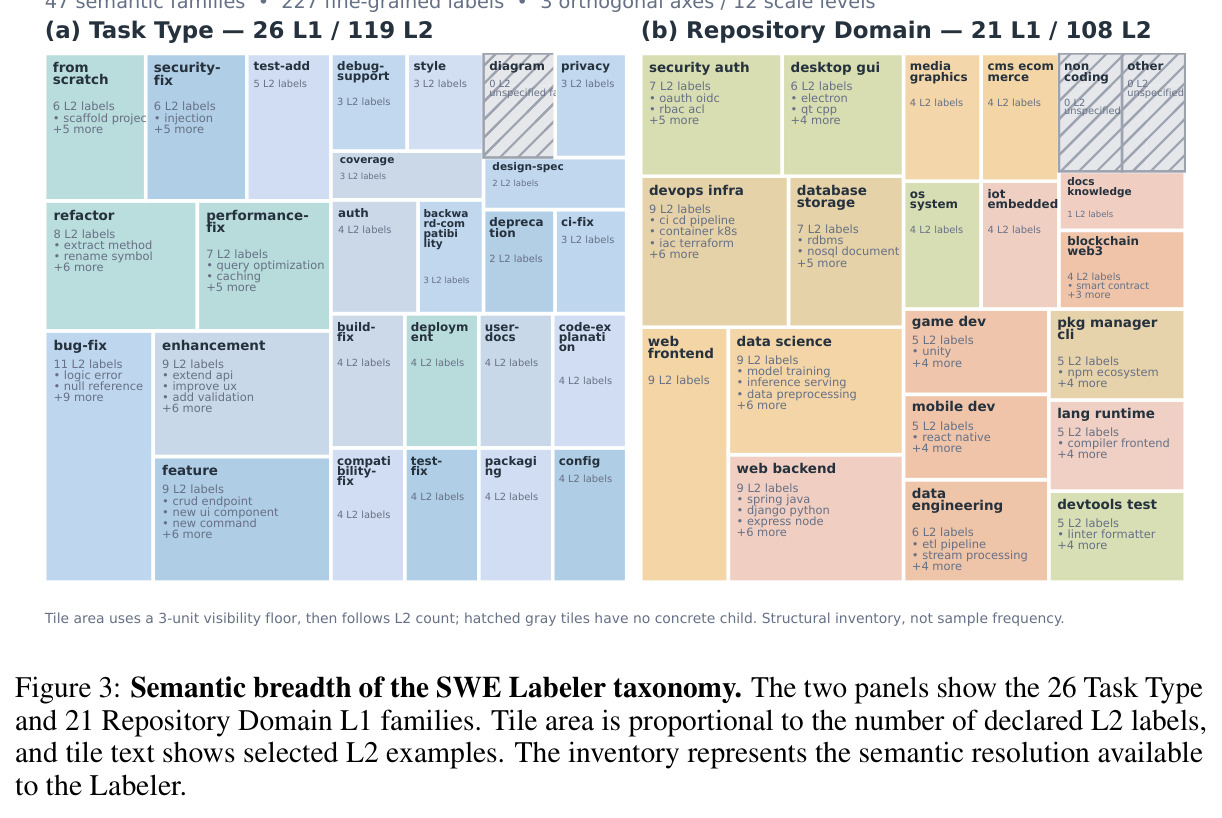
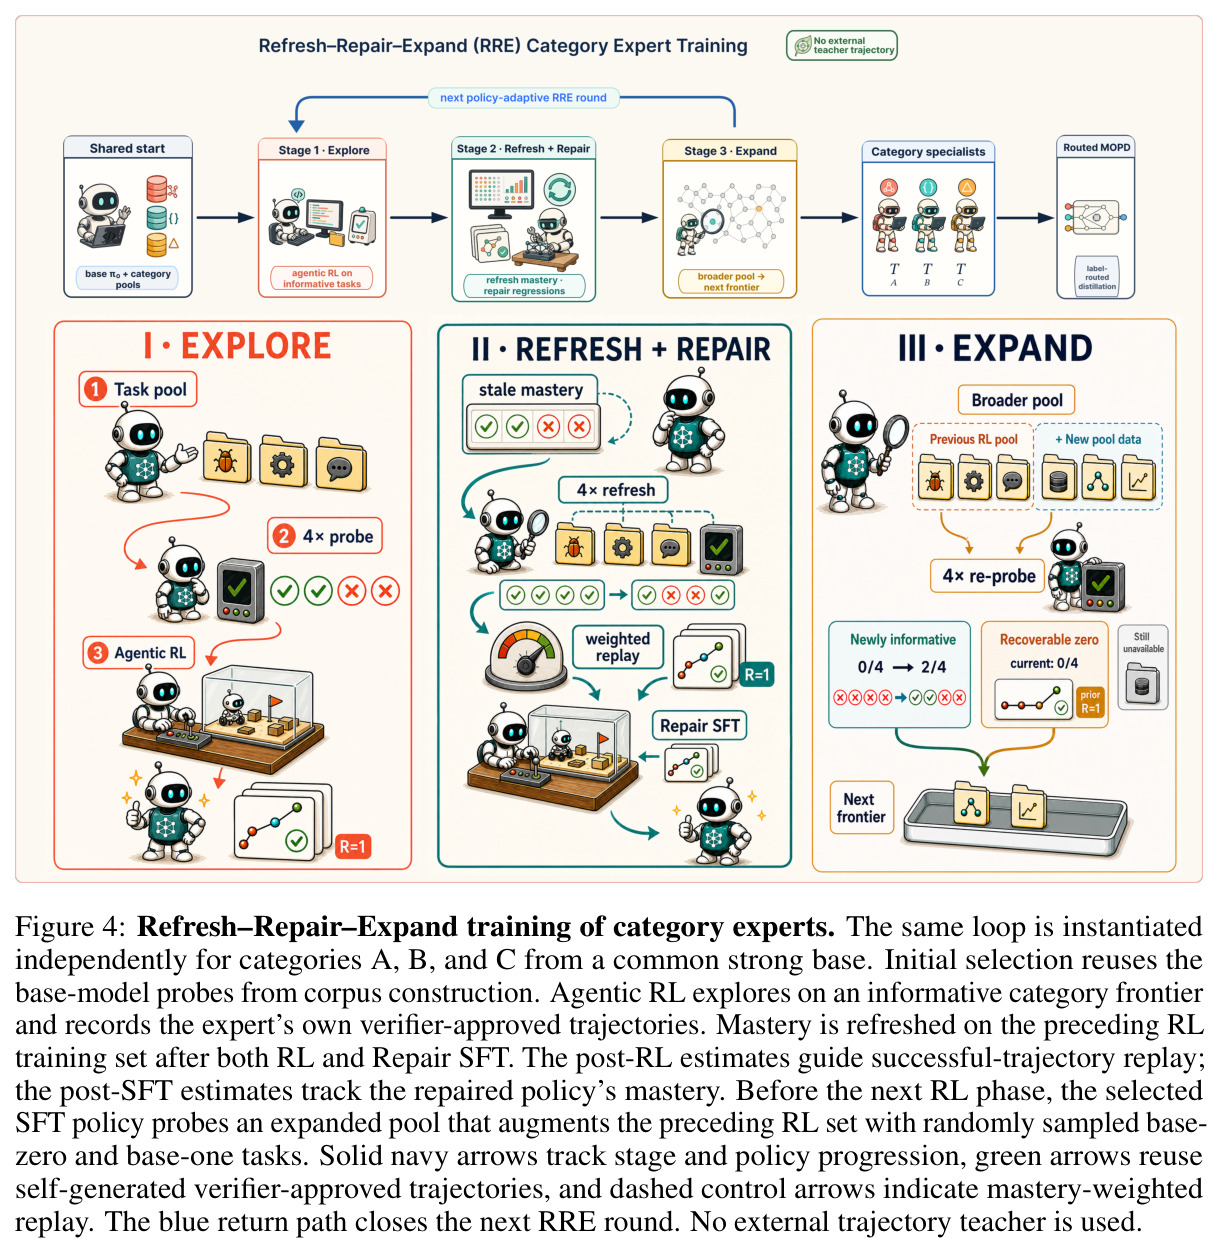
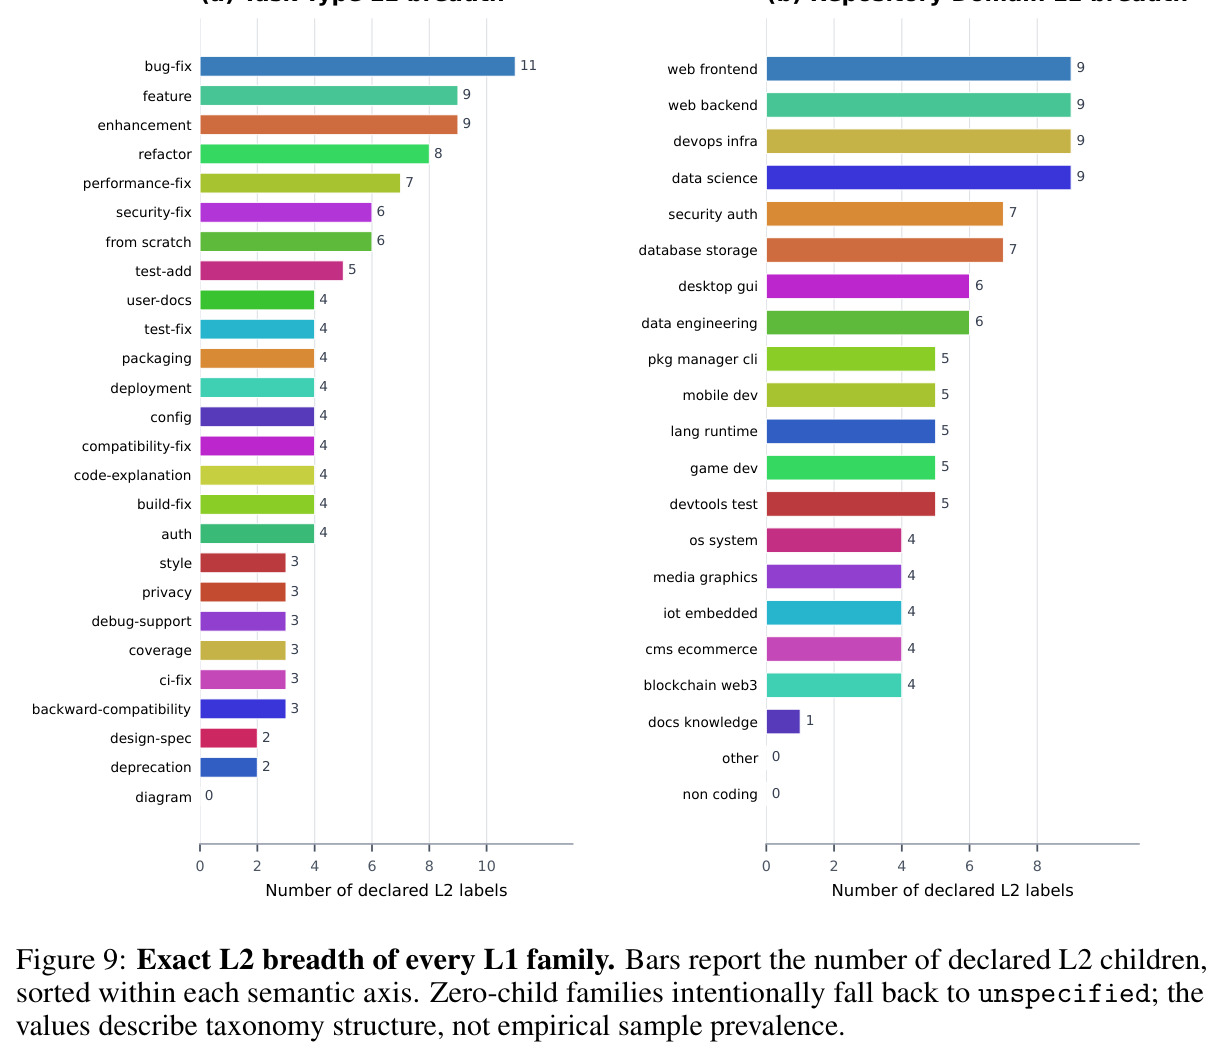
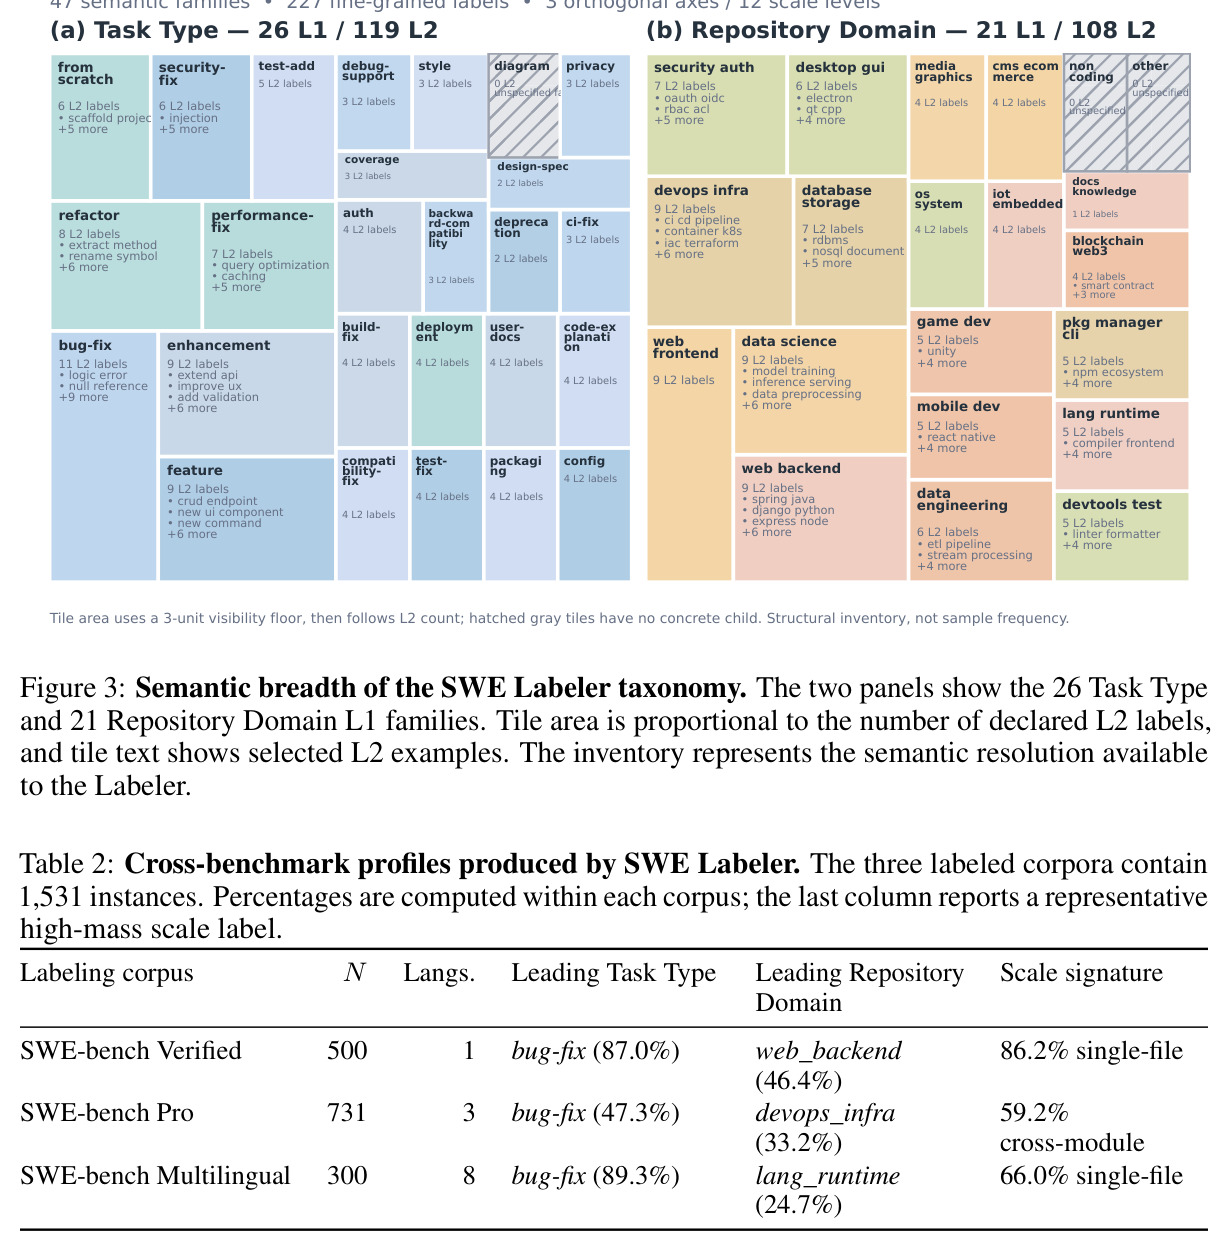
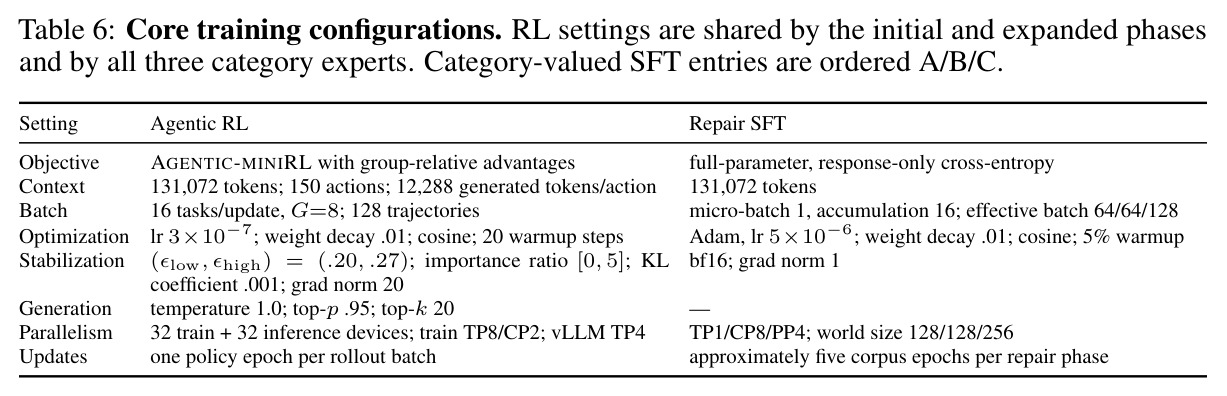
直觉上方法分三步:先把混在一起的 SWE 任务按可观测证据切成类目(分而治之),再让每个类目自己迭代变强(专家养成),最后把多个专家的本领蒸馏回一个模型(合而为一)。技术路线由四个组件构成。(1) 可执行任务构建:从合并 PR 与关联 issue 出发,LLM 改写问题描述并做泄漏检查,用 RepoLaunch 构建 Docker 环境,金补丁前后反复跑测试剔除 flaky 验证器,得到约 32K 可执行候选任务。(2) SWE Labeler:两个语义轴(Task Type、Repository Domain)加三个有序规模轴(修改范围、认知复杂度、预计解决时间),细粒度共 26 个 Task Type L1/119 个 L2、21 个 Domain L1/108 个 L2,再用确定性规则把 18 个可路由 Domain L1 粗化为 A/B/C 三类。(3) 每个类目从同一基座 $\pi_0$ 出发,交替使用 Agentic-miniRL 与 Refresh–Repair–Expand(RRE)循环训练成专家。(4) 标签路由多教师在线蒸馏(MOPD)把三个专家合并为单一学生。主实验基座为 Qwen3.6-27B,训练 rollout 使用 131,072 token 上下文、最多 150 次动作、每任务采 $G=8$ 条轨迹。
核心创新有三处。其一,「类目跷跷板」诊断视角:把聚合分辨率分解为类目性能向量 $(S_1(t),\ldots,S_K(t))$,用同时增益 $G_{\mathrm{sim}}(t)=\min_c \Delta_c(t)$ 与间隙 $SSG(t)=\Delta_{all}(t)-G_{\mathrm{sim}}(t)$ 暴露联合 RL 内部的此消彼长,把「一个领域该不该分解」从假设变成可检验的实验命题。其二,RRE 把策略发展与数据选择耦合:每次 RL 后用可执行验证重新估计实例掌握度(Refresh),把专家自己验证成功的轨迹按当前掌握度加权回放给低掌握度实例(Repair SFT),再探测扩大池并依据当前掌握度与历史成功证据重选下一轮 RL 前沿(Expand)。由于修复用的是环境验证过的自身轨迹,整个专家训练不需要外部教师。其三,集成阶段的标签路由 MOPD 优势 $A^{MOPD}_t=\sum_k m_k(x)\left[-d_{t,k}+(\lambda_k-1)\max(e_{t,k},0)\right]$,其中 $d_{t,k}=q_t-\log\pi_{T_k}$ 是学生-教师差距、$e_{t,k}=\log\pi_{T_k}-\log\pi_{ref}$ 是教师-参考差距;ReLU 门控只保留教师优于参考的正向外推方向($\lambda_k=1.25$),让外推项获得系统性方向而不是正负抵消的残差。
方法步骤详情
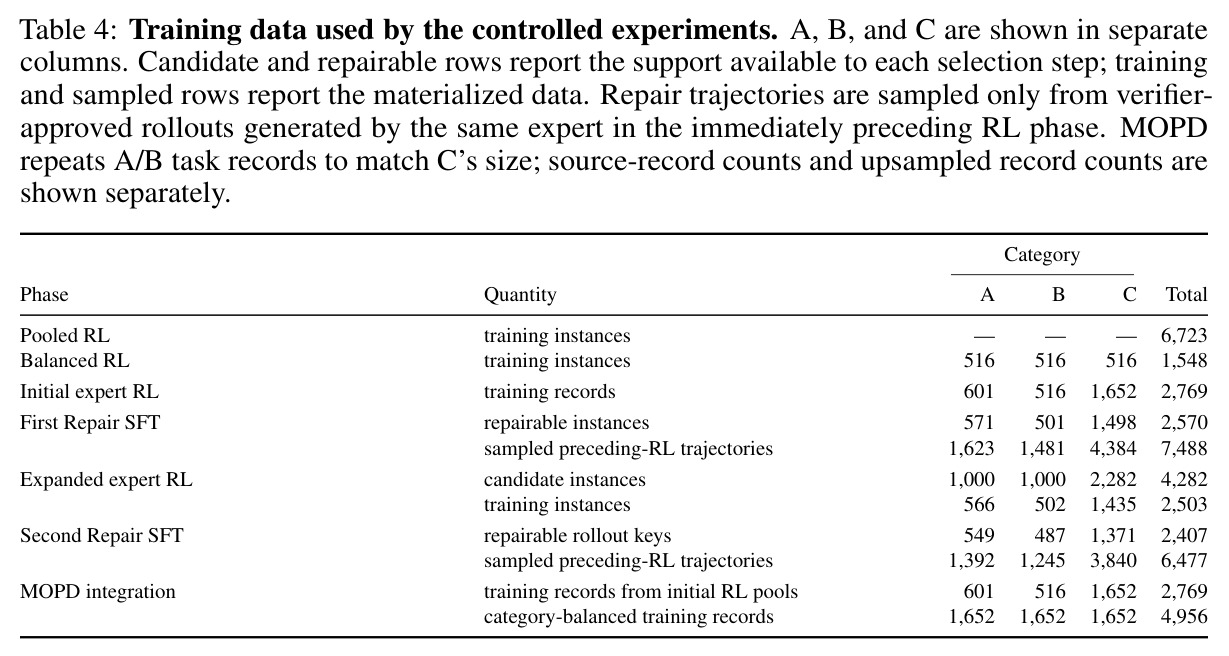
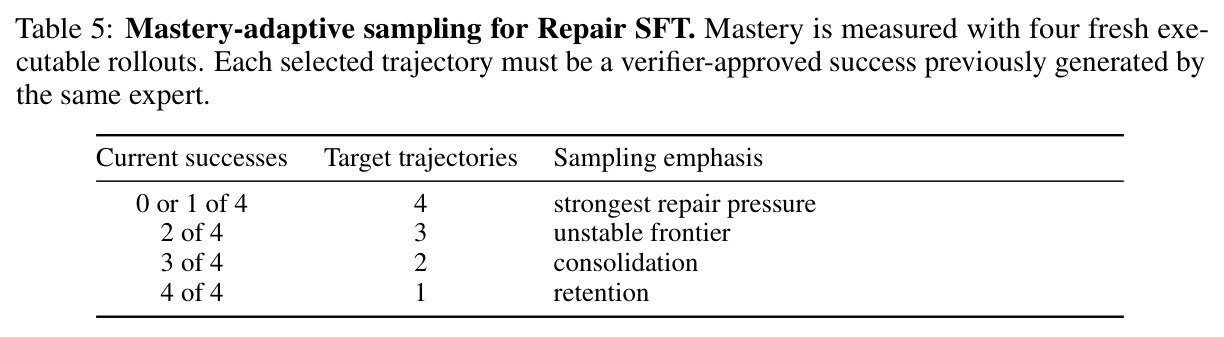
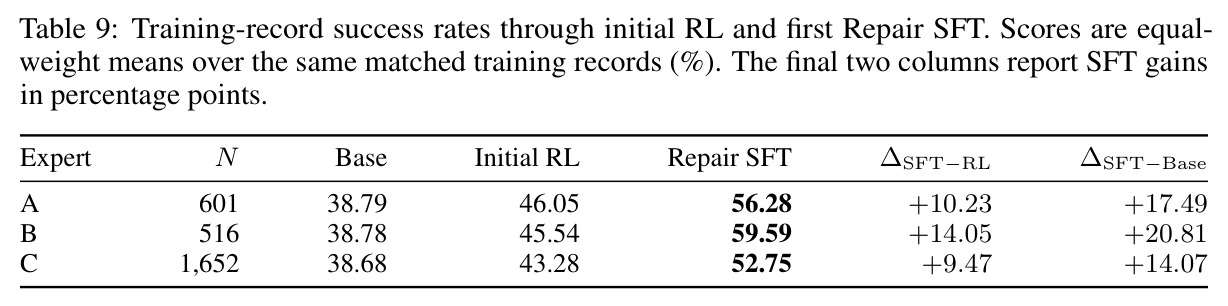
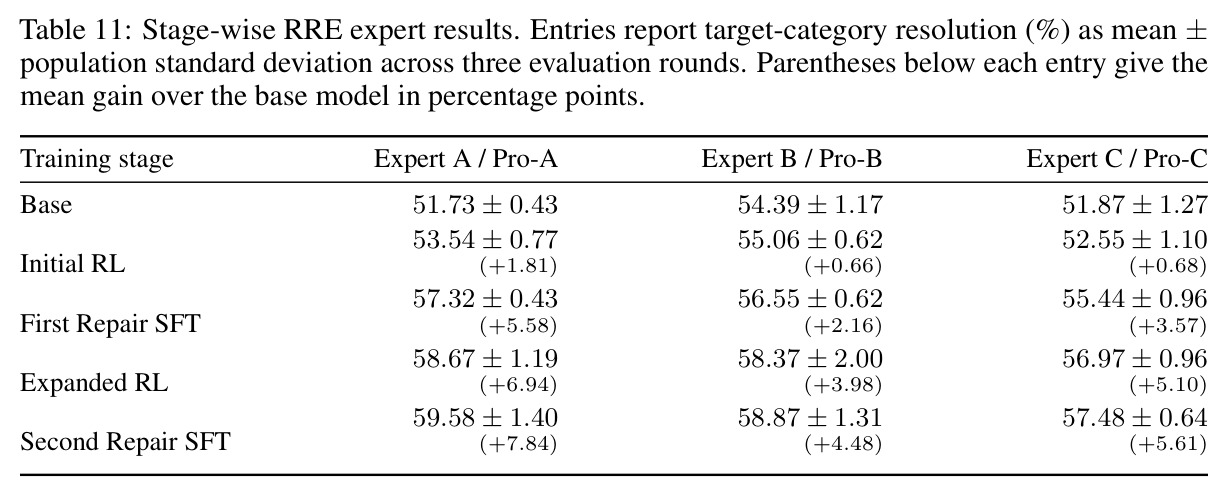
完整流程分六步。第一步任务构建:合并 PR+issue,LLM 改写问题陈述并拒绝暴露源码/测试路径或补丁代码的陈述,RepoLaunch 构建 Docker 镜像,金补丁验证留下 fail-to-pass 与 pass-to-pass 集合,反复验证过滤 flaky,产出约 32K 实例。第二步标注:Qwen3.7-max 按 SWE Labeler 两阶段层次化标注(先预测 L1,再在 L1 子嗣内条件化选 L2 并赋三个规模轴),随后用确定性规则映射到 A/B/C。第三步构建语料:选基座通过率在 0 到 0.5 之间的 3,048 个合成实例,加 3,675 个 SWE-rebench V2 任务,共 6,723 条,其中 A/B/C 各 601/516/1,652 条。第四步 Agentic-miniRL:每任务采 $G=8$ 条轨迹,RLOO 中心化奖励,K1 放入奖励路径后算折扣累计回报,MiniRL 有界重要性权重(截断到 $[0,5]$)与符号感知近端掩码($(\epsilon_{low},\epsilon_{high})=(0.20,0.27)$)校正行为策略失配,损失按助手回合聚合。第五步 RRE 循环(共两轮):RL 后用 4 次新 rollout 刷新训练集掌握度;Repair SFT 按掌握度分配配额(4 次成功中 0-1 次者配 4 条轨迹、全对者配 1 条),只回放本阶段验证通过的轨迹;SFT 后再刷新;下一轮 RL 前随机加入基座通过率为 0 或 1 的扩池实例(A/B/C 各 1,000/1,000/2,282),取「信息前沿 + 有历史成功证据的零通过题」作为新训练集。第六步 MOPD:学生从 $\pi_0$ 初始化,在三池上采样均衡到 4,956 条记录,纯蒸馏模式(环境奖励不入损失、无组基线、无 K1 惩罚),每教师模仿系数 1、外推系数 1.25、优势截断 $\pm 5$,学习率 $3\times 10^{-6}$。
技术新颖性
新颖性体现在四个层面。问题层面:据作者所知,这是首个在仓库级 SWE 单一领域内部做「类目划分→类目专家→单策略整合」的系统性研究,此前专家拆分-融合都依赖跨域边界。数据层面:SWE Labeler 把每个细粒度标签做成「权威来源-操作规则-正信号-邻界边界」的决策记录(如 bug_fix.logic_error 锚定 CWE-682/697),可审计、可同时作用于 issue-补丁实例与交互轨迹,还能刻画基准画像:Verified 87.0% 是 bug 修复且 86.2% 单文件改动,而 Pro 相应为 47.3% 与 59.2% 跨模块。算法层面:RRE 相比 DAPO 式动态采样维护的不是单次更新内的组过滤,而是跨阶段、策略自适应的可执行任务前沿;Repair SFT 是奖励过滤的自蒸馏,与 SPEE 维护抽象文本经验池不同,它演化的对象是任务前沿本身。集成层面:把 ExOPD 奖励外推从跨域迁移到域内标签路由场景,并提出 ReLU 门控修正外推方向;同一标签体系同时承担训练池构建、教师路由与类目级评测三种职能,这种「一套标签贯穿全程」的设计也是已有工作不具备的。
实验结果
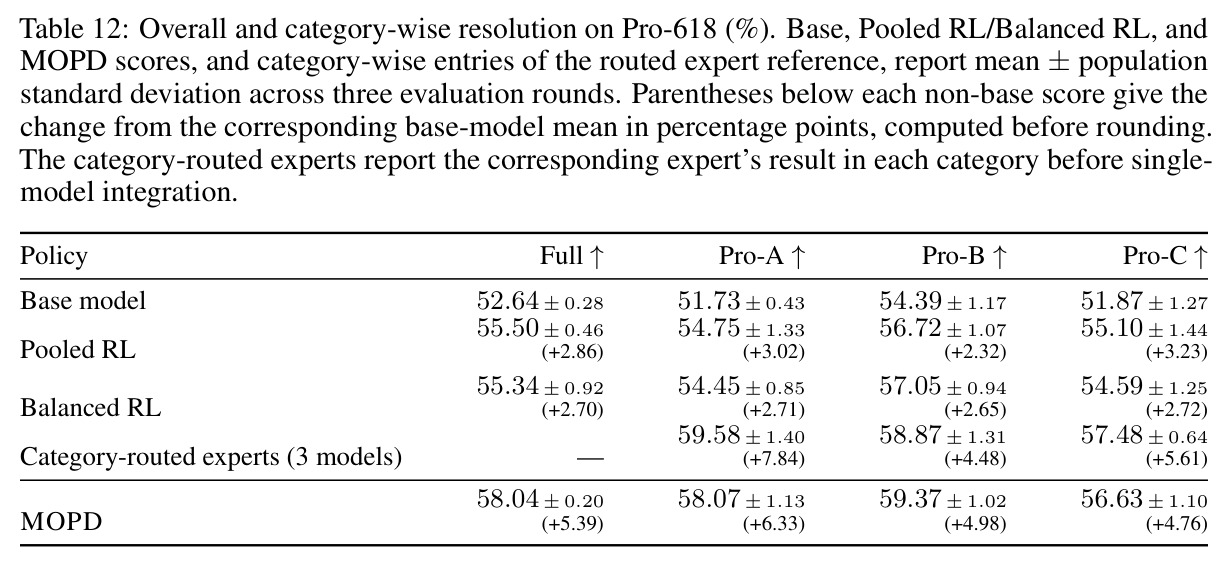
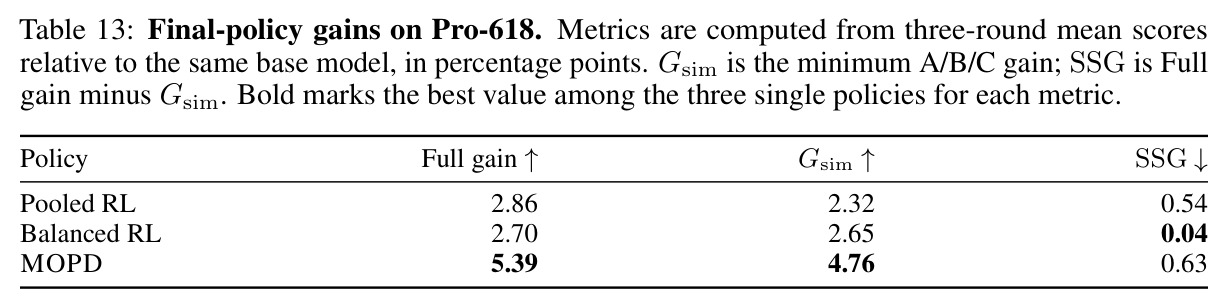
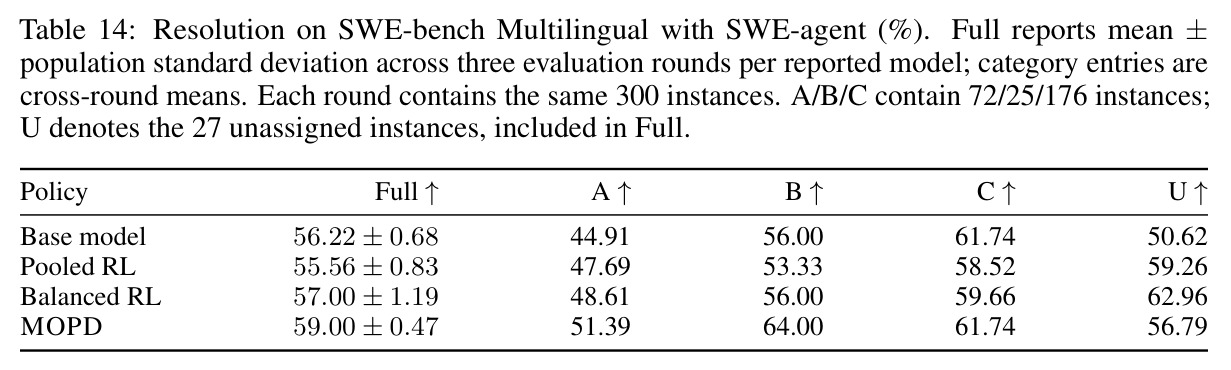
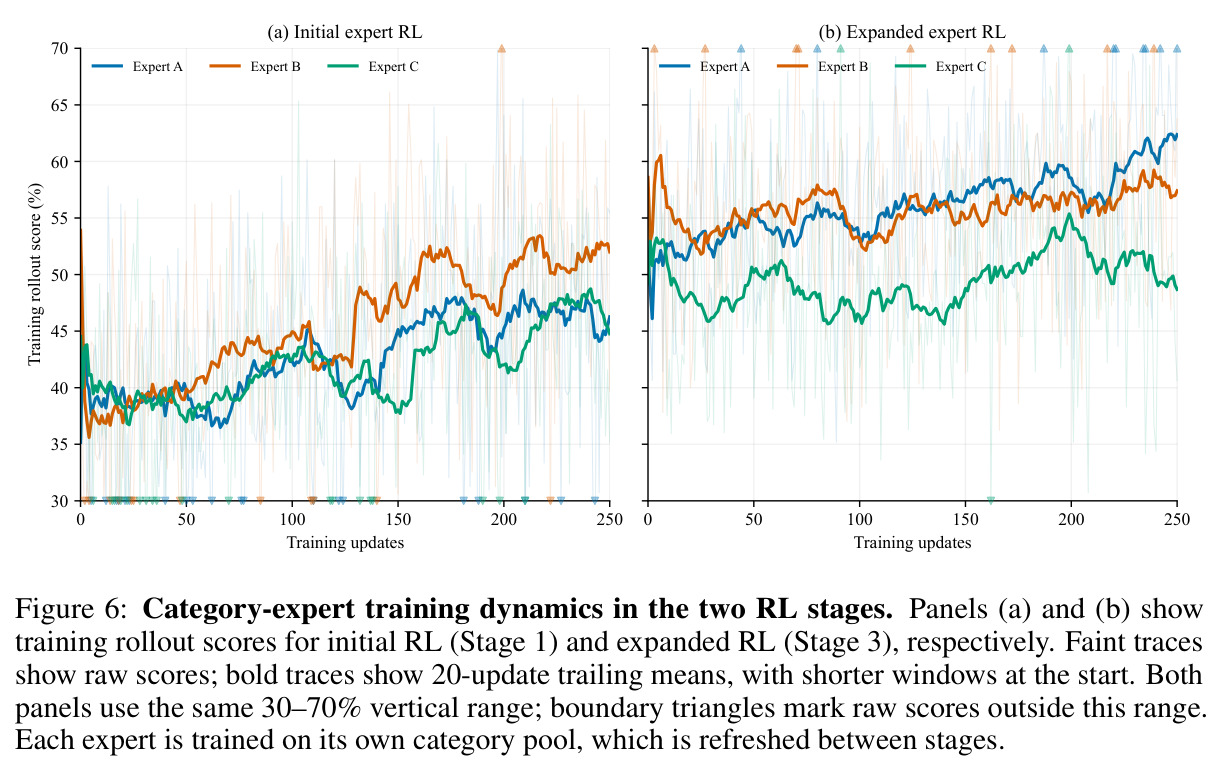
三个研究问题的答案都带有具体数字。RQ1:Balanced RL(每类目 516 题、共 1,548 题)与 Pooled RL(6,723 题)最终 Full 分辨率几乎持平(55.34% vs 55.50%,基座 52.64%);过程平均 Full 增益 1.37 vs 1.13、$G_{\mathrm{sim}}$ 0.19 vs 0.08,但平均 SSG 反而更高(1.18 vs 1.05),类目间反向运动依旧存在——只调数据配比无法消除跷跷板。RQ2:初始类目 RL 的目标类目成绩仅 53.54%/55.06%/52.55%,低于 Pooled 端点的 54.75%/56.72%/55.10%;实例诊断显示训练集平均成功率分别上涨 7.26/6.76/4.60 个百分点,但 2,769 条记录中 839 条(30.3%)不升反降;第一轮 Repair SFT 把训练成功率推到 56.28%/59.59%/52.75%,被纳入修复的 751 条回退实例中 69.8%/73.0%/61.3% 恢复到基座水平以上;经两轮 RRE,三专家相对基座分别 +7.84/+4.48/+5.61 个百分点,在扩展 RL 后即全部超过 Pooled 端点。RQ3:MOPD 学生训练 rollout 分数从 45.51% 升至 56.91%(+11.41pp),学生-教师 KL 同期下降 43.0%;最终在 Pro-618 达 58.04%(+5.39pp),Pro-A/B/C 为 58.07%/59.37%/56.63%(+6.33/+4.98/+4.76pp),相对 Pooled RL 总体 +2.54pp、最小类目提升 1.53pp,相对 Balanced RL 总体 +2.70pp、最小类目提升 2.04pp;专家增益回收率 A/B/C 为 80.8%/111.1%/84.8%。在 SWE-bench Multilingual 上达 59.00%(基座 56.22%、Pooled 55.56%、Balanced 57.00%),但对 Balanced RL 的配对 bootstrap 95% 区间为 $[-0.78,4.78]$,跨零。
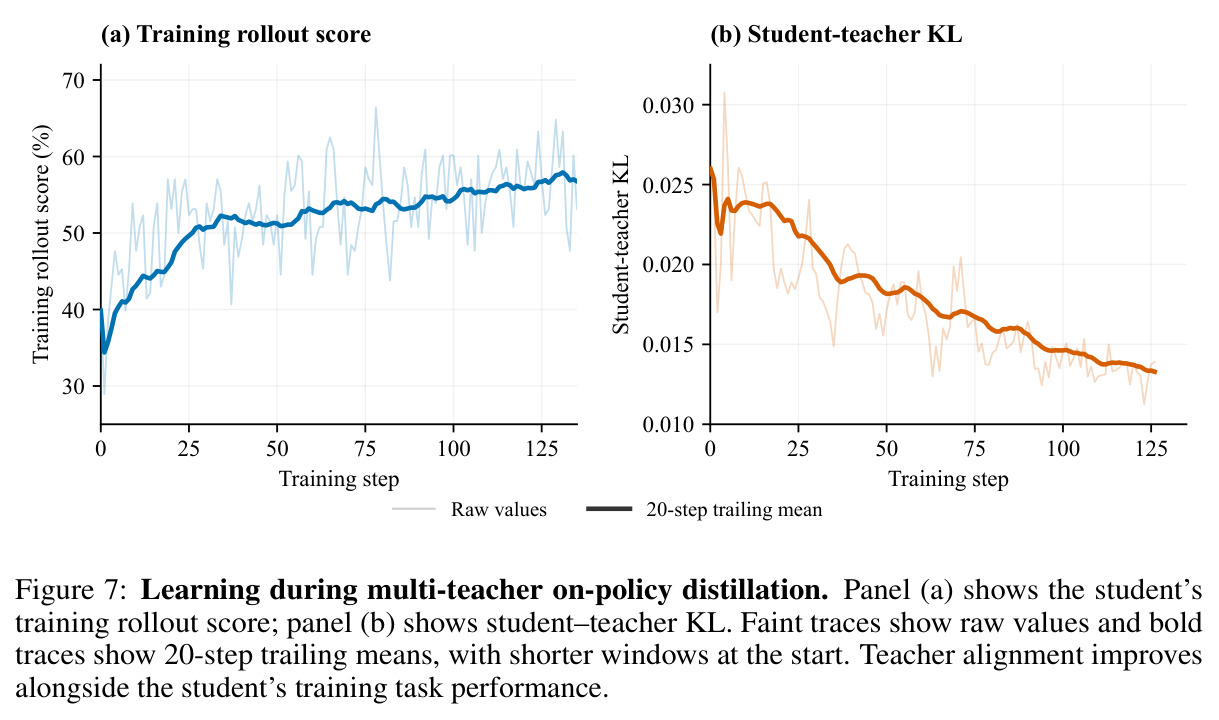
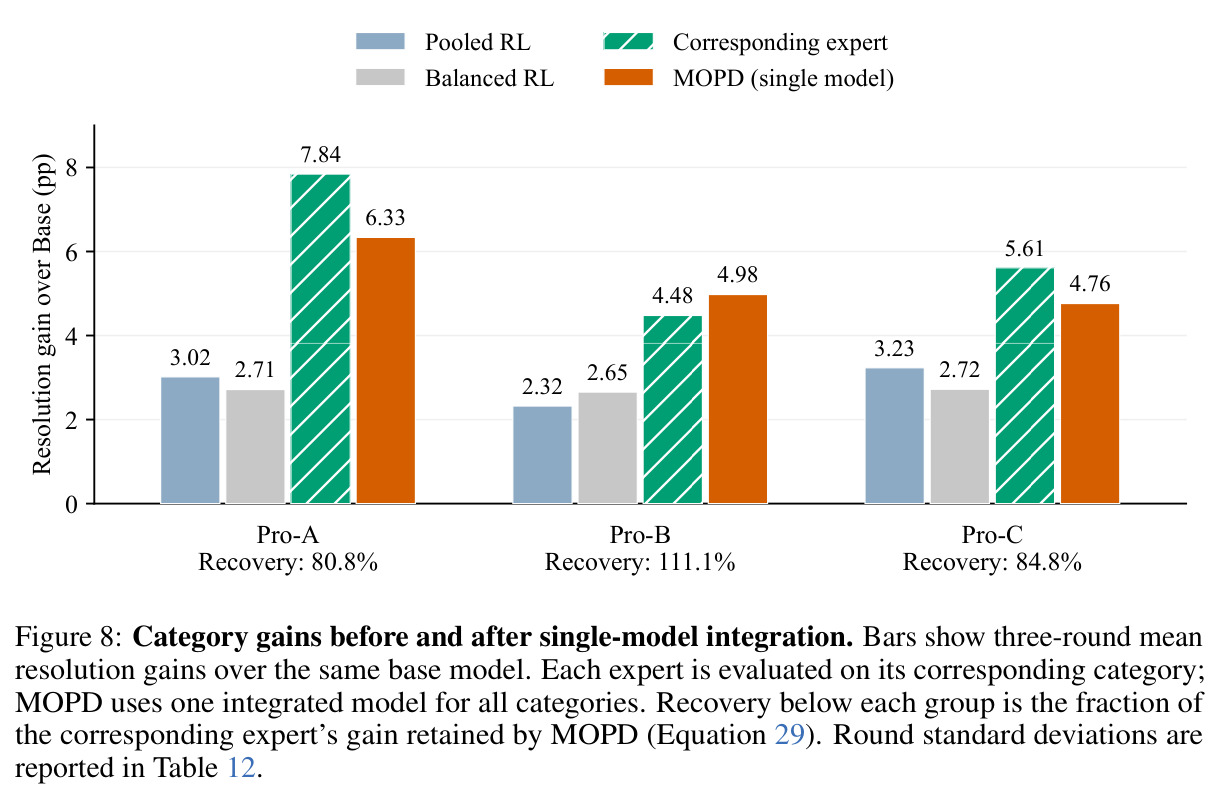
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Pro-618 总体(SWE-bench Pro 审计子集,618 题) | 平均解决率(3 轮评测) | 58.04%(MOPD) | 基座 52.64%;Pooled RL 55.50%;Balanced RL 55.34% | 较基座 +5.39pp;较 Pooled RL +2.54pp;较 Balanced RL +2.70pp |
| Pro-618 Pro-A(服务/数据/安全,221 题) | 平均解决率 | 58.07% | 基座 51.73%;Pooled RL 54.75%;Expert A 59.58% | 较基座 +6.33pp,较 Pooled RL +3.32pp;回收 Expert A 增益的 80.8% |
| Pro-618 Pro-B(面向用户应用,201 题) | 平均解决率 | 59.37% | 基座 54.39%;Pooled RL 56.72%;Expert B 58.87% | 较基座 +4.98pp,较 Pooled RL +2.65pp;回收率 111.1%(反超专家 0.50pp) |
| Pro-618 Pro-C(系统/工具/运行时,196 题) | 平均解决率 | 56.63% | 基座 51.87%;Pooled RL 55.10%;Expert C 57.48% | 较基座 +4.76pp,较 Pooled RL +1.53pp;回收率 84.8% |
| SWE-bench Multilingual(300 题,42 仓库 9 语言,SWE-agent 框架) | 平均解决率(3 轮评测) | 59.00% | 基座 56.22%;Pooled RL 55.56%;Balanced RL 57.00% | 较基座 +2.78pp(bootstrap 95% CI [0.33,5.22]),较 Pooled RL +3.44pp,较 Balanced RL +2.00pp(CI [-0.78,4.78] 跨零) |
局限与改进
作者承认的局限包括:硬路由假设每个任务只属于一个类目,而真实 SWE 任务常横跨多类;训练 K 个专家并为每个教师做前向带来大量额外算力,最优 K 随数据、基座和预算变化;同源教师可能过于相似而缺乏互补信号,也可能过度特化后难以稳定整合;通过率无法衡量补丁质量,测试驱动奖励仍可能被钻空子或继承脆弱的任务规约;仓库清洗与新鲜沙箱重放不能消除预训练记忆;Pro-618 上的结论不能外推到未执行的完整 Pro 集;实验评估的是完整框架与阶段产出,没有对每个优化组件、回放选择或路由粒度做消融隔离;单次运行的类目轨迹含评测噪声。我的补充观察:主结果基于作者自建的审计子集 Pro-618,与社区通行的 SWE-bench Pro 分数不直接可比;SWE-bench Multilingual 上对 Balanced RL 的优势置信区间跨零,且 B 类仅 25 题使类目均值噪声很大;表 13 显示 MOPD 的 SSG 为 0.63,高于 Balanced RL 的 0.04,说明增益均匀性反而变差;此外基座在训练集上已有约 38% 的通过率,「无外部教师」的前提是基座本身具备可自举的能力储备,这一点在弱基座上未必成立。
独立分析的弱点
独立分析的弱点:其一,A 类增益回收率最低(80.8%),学生比 Expert A 低 1.51pp,说明蒸馏在类目间存在能力干扰,改进方向是为 token 或实例学习软路由权重,或按回收率动态调整各教师的模仿/外推系数 $\lambda_k$。其二,硬路由把多标签任务强行单选,全栈改动等边界任务可能被错误路由,可改用 SWE Labeler 完整标签向量做 top-k 混合教师。其三,算力开销大:专家阶段每类目 32 台训练+32 台推理设备,MOPD 阶段学生 32+32、三个教师与参考各 16,合计约 128 台加速卡,小团队难以复制;可探索 LoRA 专家或先做参数空间合并再轻量蒸馏,压缩教师前向成本。其四,二值通过率奖励不衡量代码质量,Repair SFT 反复回放自身成功轨迹有强化捷径解的风险,可引入静态分析或代码评审模型作辅助信号。其五,训练语料仅覆盖四种语言的 SWE-rebench 切片加自建合成池,跨语言泛化证据有限。其六,类目数 K=3 是固定预算下人为粗化的选择,类目粒度、专家数量与性能的缩放关系缺乏实验支撑。
未来方向
作者提出的方向包括:对每个优化组件、回放策略与路由粒度做消融以隔离贡献;更广泛地比较采样与路由策略;确定随数据与预算变化的最优 K。基于其成果可自然延伸的研究:把硬路由升级为基于标签向量的软路由或层次化路由,处理跨类目任务;把 RRE 的「策略自适应任务前沿」思想迁移到网页、操作系统等长程智能体域;在蒸馏阶段引入按类目增益回收率自适应的教师加权或 token 级门控,收窄 A 类 80.8% 的回收缺口;利用 SWE Labeler 的三个规模轴构建难度课程,替换随机扩池;结合任务算术等模型合并方法在参数空间先融合专家、再用 MOPD 修正,减少部署与训练开销;在奖励侧加入超越测试通过的补丁质量度量,回应作者自己对 reward hacking 与可维护性的担忧;还可把框架用于持续学习,新类目到来时只需训练新专家并增量蒸馏,而不必重训整个策略。
复现评估
论文未提及开源代码或模型权重,基座 Qwen3.6-27B(系统提示中标注 Logics-SWE-Qwen3.6-27B)与标注所用 Qwen3.7-max 均为阿里内部模型,外部完全复现门槛很高。可复用的部分包括:SWE-rebench V2 与 SWE-bench 系列公开数据;Pro-618 排除清单所依据的公开确定性审计 receipt(83 个规约/确定性缺陷、26 个对抗判定、3 个金补丁重放失败,加 1 个 OpenAI 官方审计的 prompt-测试错配,合计剔除 113 题);以及非常完整的超参表(RL 学习率 $3\times10^{-7}$、每更新 16 任务×8 轨迹、 Repair SFT 有效批 64/64/128、MOPD 学习率 $3\times10^{-6}$、$\lambda=1.25$、优势截断 $\pm5$、种子 42 等)。算力方面:RL 阶段 32 台训练+32 台推理设备(train TP8/CP2、vLLM TP4),MOPD 阶段学生 32+32、三个教师与冻结参考各 16,合计约 128 台加速卡;沙箱每实例 4 CPU/16GiB、轨迹上限 9,600 秒,27B 模型 131k 上下文。整体属于高成本、多基础设施依赖(ROLL/ROCK/R2E-Gym/vLLM)的复现,难度高;但阶段级指标(表 9-11)披露极细,RRE 循环的有效性可在小模型、小任务池上先行低成本验证。
论文图表
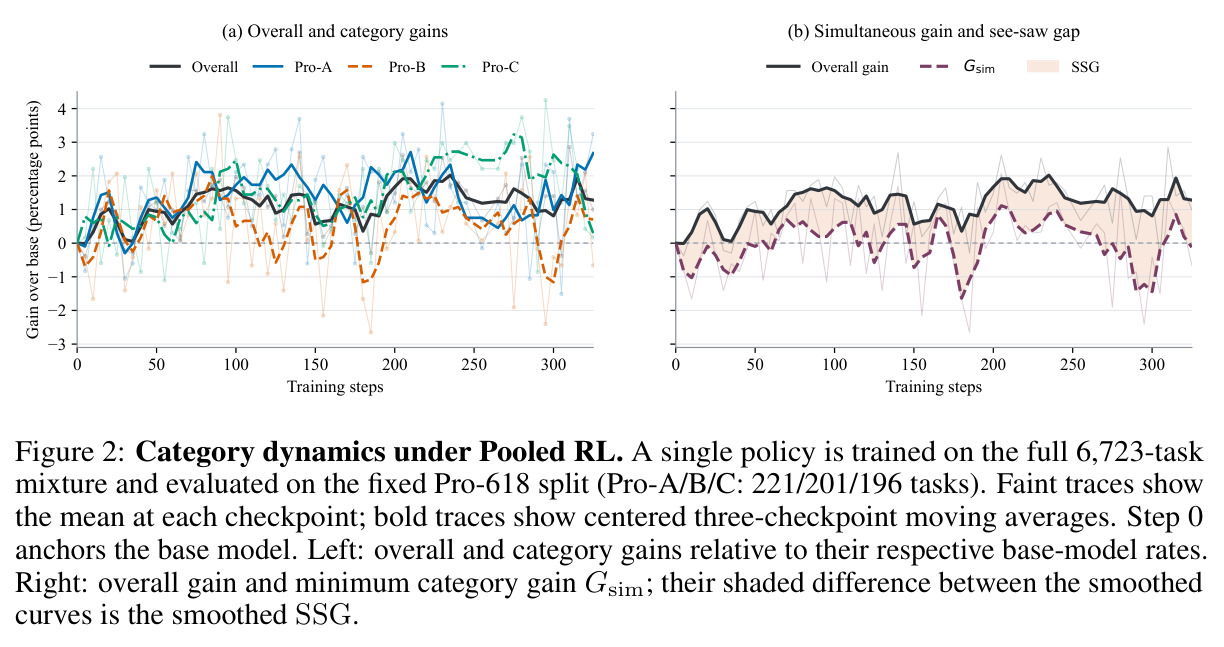
单一策略在 6,723 任务混合池上训练、在 Pro-618 上追踪评测的结果。左图为总体与 Pro-A/B/C 相对基座的增益曲线,可见类目间此消彼长;右图为总体增益与最小类目增益 $G_{\mathrm{sim}}$,两者阴影差即平滑 SSG,存在总体增益为正而最小类目增益为负的时段。
提供「类目跷跷板」现象的直接实验证据,是整篇论文动机的实证支点。