并非所有秩都同等重要:跨任务的预算感知 LoRA 合并 Not All Ranks Are Equal: Budget-Aware LoRA Merging Across Tasks
提出数据无关的净效用指标,跨层跨任务为 LoRA 合并智能分配秩预算
前置知识
LoRA(低秩适配)
LoRA 是参数高效微调方法,不直接更新权重矩阵 $W$,而是学习低秩增量 $\Delta W = BA$,其中秩 $r$ 远小于矩阵维度。推理时把 $\Delta W$ 加到冻结的基座权重上即可获得任务能力,每个任务只需保存一个小适配器,服务 $n$ 个任务意味着维护 $n$ 个适配器并按任务切换。
本文处理的对象正是多个任务的 LoRA 增量:如何在固定总秩预算下把它们合并成一个适配器。不理解 LoRA 的低秩因子结构和'秩'的含义,就无法理解全文的预算分配问题。
任务向量与模型合并
任务向量定义为微调权重与预训练权重之差 $\Delta W = W_{ft} - W_0$。Task Arithmetic(TA)对任务向量缩放求和;TIES 剪裁小幅参数后按符号投票平均;DARE 随机丢弃参数并重缩放;TSV 在正交化的奇异向量基上合并。这些都是把多个任务能力压进单一模型的算子。
Net Utility 是与合并算子正交的'预算分配'模块。实验在 TA、TIES、DARE、TSV、Iso-C 五种方法和全空间/Core/KnOTS 三种合并空间上展开,不熟悉这些方法就看不懂实验设计。
奇异值分解(SVD)
SVD 把矩阵分解为 $\Delta W = U\Sigma V^\top = \sum_k \sigma_k u_k v_k^\top$,即若干秩一块之和,奇异值 $\sigma_k$ 按能量降序排列。每个奇异方向 $v_k$ 代表适配器作用于输入空间的一个独立子方向,谱能量分布刻画了各方向对更新的贡献大小。
本文的分配单元就是奇异方向:对每个任务 LoRA 做 SVD,为每个秩一组件打分,再决定全局保留哪些方向。SVD 是方法叙述的基本语言。
输入几何与加权半范数
论文用加权半范数 $\|X\|^2_G = \mathrm{tr}(XGX^\top)$ 度量保留误差,其中 $G_i = \mathbb{E}_{x\sim p_i}[h_l(x)h_l(x)^\top]$ 是任务 $i$ 的输入二阶统计(层输入协方差),衡量权重改动落在'该任务真正经过的输入方向'上造成的误差。因任务数据不可得,用适配器权重构造无数据代理 $G_i \approx \kappa_i \Delta W_i^\top \Delta W_i$。
净效用公式的每一项(源任务收益、跨任务干扰)都在这个 $G$ 几何下推导,理解它才能看懂公式 (8) 中各项的来源与归一化设计。
归一化准确率
合并模型在某任务上的准确率除以该任务独立 LoRA 的准确率得到的比值。因为不同任务难度差异大,绝对准确率不可直接比较;比值刻画'合并带来了多少退化',越接近独立适配器的水平越好。KnOTS 等先前工作均采用此协议。
论文所有主表(Table 1-4)报告的都是归一化准确率,例如 TA 全空间 R=64 从 63.5 提升到 66.9,都是该指标下的数值。
NP 难与贪心选择
在总数受限的约束下从海量候选方向中选出使保留损失最小的子集,是组合优化问题,论文指出其为 NP 难。但当目标可分离、即每个候选的贡献独立可加时,按分数排序取 top-K 就是精确最优解,这正是贪心选择成立的条件。
论文通过命题 1 把方向之间耦合的保留目标松弛为可分离上界,使全局 top-$R_G$ 选择具有最优性保证,这是整个方法从'NP 难'变为'一次排序'的关键。
研究动机
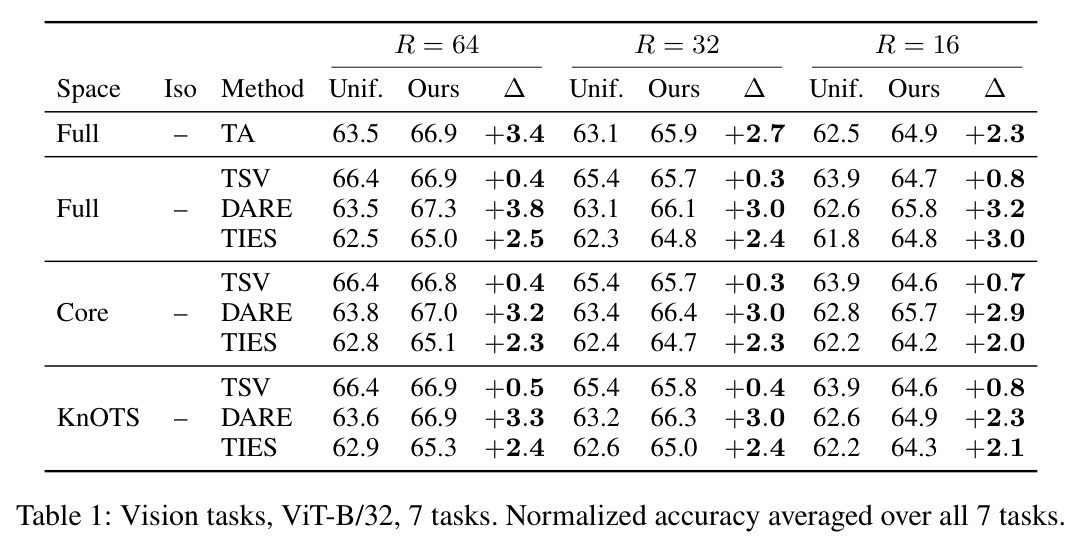
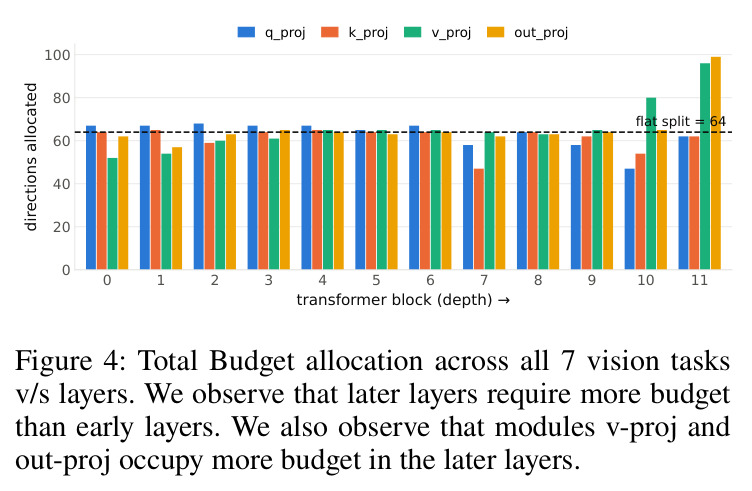
LoRA 合并把 $n$ 个任务适配器折叠成一个低秩适配器,免去了端侧设备上的热切换,但服务成本直接由秩决定:解码延迟随 batch 中出现的秩线性增长,混合秩适配器会让低秩请求为 batch 中最高秩买单,因此部署时往往固定一个秩。然而现有合并方法默认两个'均匀'假设——每层获得相同的秩预算,且各任务平分预算(如 TSV-Merging 每层固定 $d/n$、PRIME 约取层维度的 $1\%$)。LoRA 更新的谱能量在层间分布极不均匀,不同任务依赖的层也不同:论文 Figure 1 在 ViT-B/32 的七个视觉任务上显示,低层分配少、高层分配多,且 GTSRB、RESISC45 等任务的秩剖面彼此差异明显。实验表明,仅仅把均匀分配放开,Task Arithmetic 合并在七个视觉数据集上的平均性能就能提升 $+3.4\%$——说明均匀预算假设正是合并模型与逐任务 LoRA 之间性能差距的主要来源。
本文的目标是本文目标是设计一个秩分配准则,在总预算 $R_G = L \cdot R$($L$ 为适配层数,$R$ 为每层平均秩)约束下,决定'保留每个任务每一层哪些奇异方向',且满足四个要求:(1) 数据无关(data-free)——只用适配器权重,不需要任务数据、验证集或任何前向传播;(2) 同时权衡一个方向对本任务更新的重建收益、与它对其他任务输入几何造成的干扰;(3) 分数跨任务、跨层无量纲可比,从而能放进一个全局池统一排序;(4) 即插即用——能叠加到 Task Arithmetic、TIES、DARE、TSV、Iso-C 五种合并方法和全空间、Core、KnOTS 三种合并空间上,而不改变合并算子本身。最终在匹配预算下平均超越均匀分配:视觉任务 $+2.1\%$、语言任务 $+2.2\%$。
与已有工作不同的是,已有的合并工作(TIES、DARE、TSV、Iso-Merging、KnOTS 等)都把保留秩当作先验固定的全局常数;专门的秩选择工作则各有代价:AdaRank 观察到主导奇异分量未必有用,但需要在测试时用无标注校准数据做熵最小化学掩码、依赖梯度下降;PRIME 最小化干扰-保留目标却把秩解析成全层共享的单一常数;CtM 把秩瓶颈搬到合并之前。与它们本质不同,Net Utility 是适配器权重的闭式函数——SVD 之后直接算分,无数据、无优化循环;且因为所有方向在全局池中打分,'每层每任务该留多少秩'不是先验输入,而是 top-$R_G$ 选择后自然涌现的秩剖面。相比参数级的 PCB-Merging,它在奇异方向粒度上平衡'对自己有用'与'对别人干扰',并用分数直接决定秩而非固定稀疏率。
核心方法
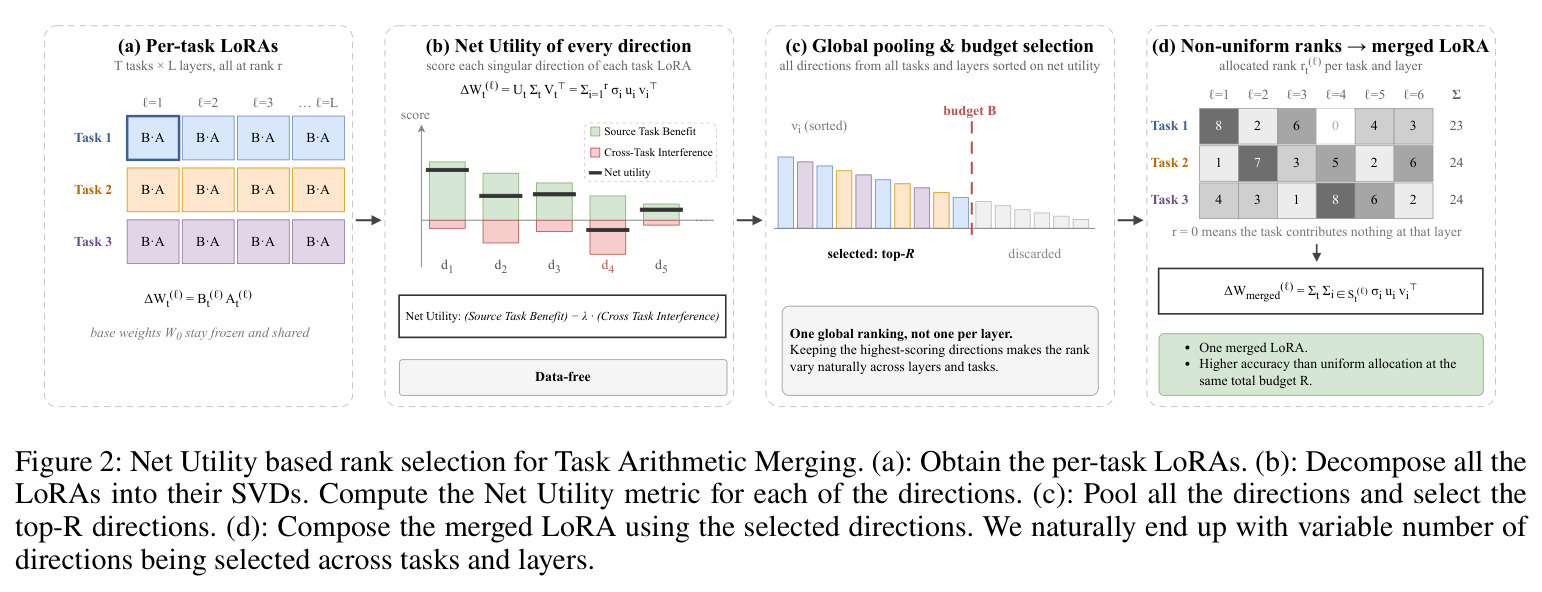
直觉:一个奇异方向若对本任务重建重要、且与其他任务方向近似正交,就应保留;反之若能量大却与其他任务强重叠造成干扰,就应舍弃。分四步:先对每个任务每层的 $\Delta W_i^l$ 做 SVD,拆成秩一组件 $D_{i,k}=\sigma_{i,k}u_{i,k}v_{i,k}^\top$;再由线性化保留目标与无数据几何代理 $G_i \approx \kappa_i \Delta W_i^\top \Delta W_i$ 推出每方向效用 $g_{j,k} = \sigma_{j,k}^4/w_j - \lambda\sigma_{j,k}^2 \sum_{i\neq j}\sum_n (\sigma_{i,n}^2/w_i) v_{j,k}^\top v_{i,n}$($w_j=\sum_n\sigma_{j,n}^4$):首项是归一化源任务收益,次项是跨任务行空间重叠的干扰;然后把所有层所有任务的分数放入全局池,保留正分数中前 $R_G = L\cdot R$ 个;最后重构组件并交给合并算子。7 个视觉任务平均提升 $+2.1\%$,6 个语言任务 $+2.2\%$。
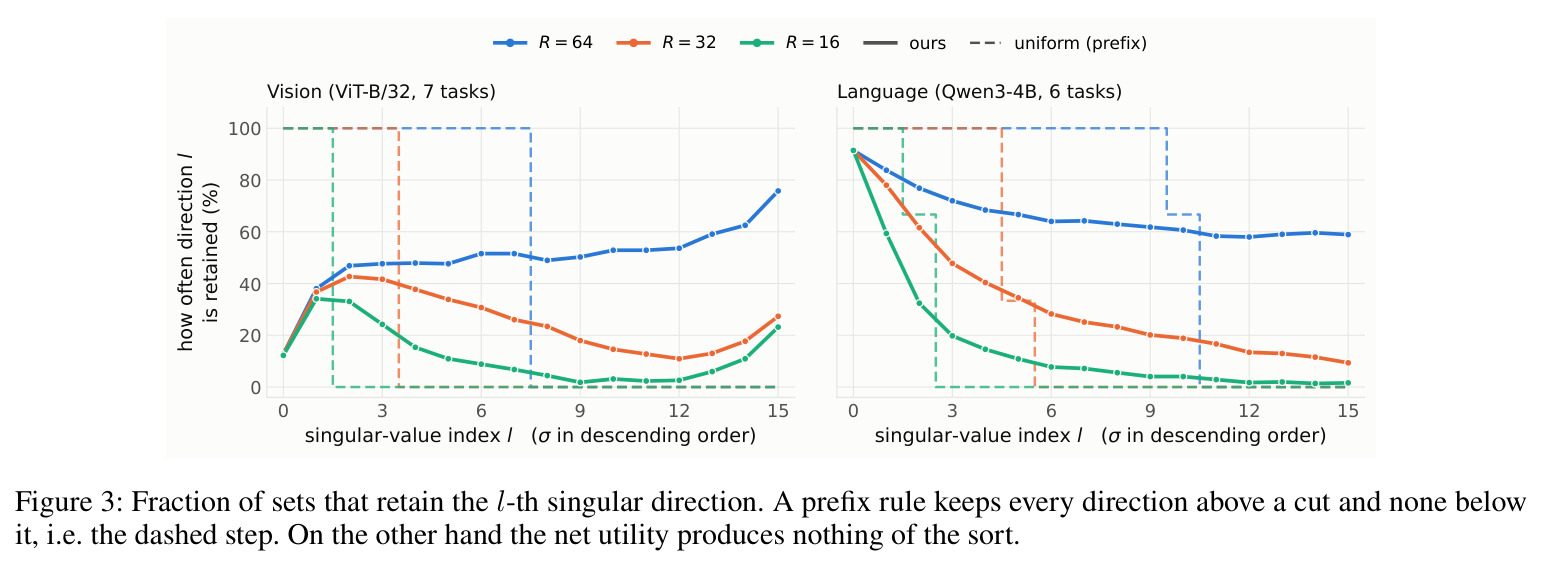
核心是把'合并的秩分配'改写成全局预算约束下的方向选择问题并给出闭式解。直接最小化 $\ell_i = \|\Delta W_i - \Delta W_m\|^2_{G_i}$ 时,各方向因交叉项耦合无法独立打分。命题 1 证明:对任意 $\lambda>0$,$\tilde{\ell}_i$ 不超过'源任务残差'与'其他任务干扰'两个归一化项的加权和(公式 7),该可分离上界让每个方向获得固定分数(公式 8),以 $w_j$ 归一化后无量纲、跨任务可比。干扰项源于 $V_j^\top V_i$ 行空间重叠:与其他任务正交的低奇异值方向可排在大奇异值方向之前——这解释了最优集为何非前缀。$\lambda$ 用中位数比 $M(\tilde\pi)/M(\sigma^2\tilde C)$ 数据自由设定;几何指数 $\alpha\in\{0,1\}$ 依能量异质性 $h=\mathrm{Var}(\log\|\Delta W_i\|_F)$ 选择(视觉 $h=1.83$ 取 0,语言 $h=0.63$ 取 1),防止高能量任务主导。
方法步骤详情
Algorithm 1 流程:(1) 输入 $M$ 个任务更新 $\{\Delta W_i^l\}$、系数 $\lambda$、预算 $R_G = L\cdot R$ 与合并算子;(2) 对每层每个 $\Delta W_i^l$,用 LoRA 因子 $B_i$、$A_i^\top$ 的 QR 分解算薄 SVD,复杂度 $O(r^2(d_{in}+d_{out}))$,不物化稠密矩阵;(3) 计算任务尺度 $w_l^i = \sum_n (\sigma_{l,n}^i)^4$;(4) 计算任务对重叠 $V_j^\top V_i$(每层 $O(M^2r^2d_{in})$ 时间),按公式 (8) 算出方向效用 $g_{j,k}$;(5) 汇总全部 $C$ 个方向分数,保留正分数中前 $R_G$ 个(排序 $O(C\log C)$),正分数不足时预算自然闲置;(6) 重构组件 $K_l^i$ 并调用合并算子输出最终 LoRA。行空间几何 $\hat G_i = \kappa_i V_iV_i^\top$ 变体只需按附录 A.4 换用 $\hat w$、$\hat g$。
技术新颖性
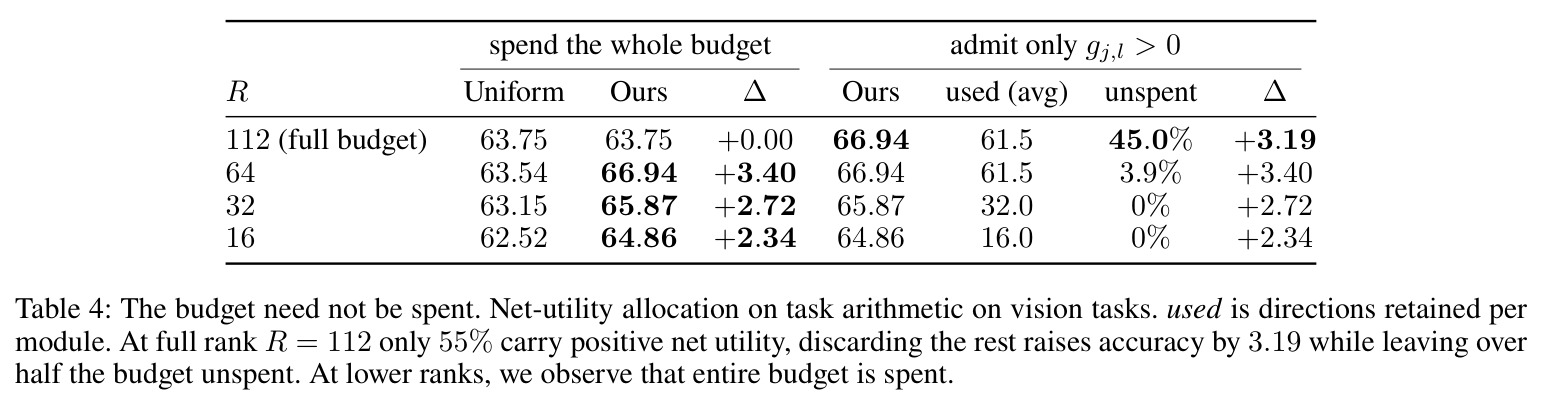
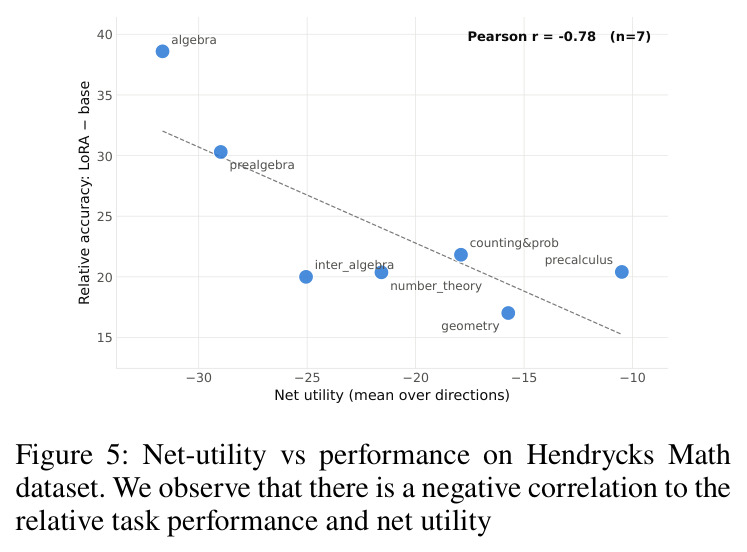
新颖性有四点。第一,问题重定义:首次把 LoRA 合并中的秩当作全局稀缺资源,在奇异方向粒度上做预算约束选择,而不是每层等额、每任务均分。第二,闭式 data-free 打分:与 AdaRank 的测试时熵最小化、PRIME 的优化循环不同,效用只涉及 SVD 与向量内积,可离线、端侧计算。第三,理论保证与经验外推清晰分离:命题 1-2 只对线性合并(Task Arithmetic)给出可分离上界,但实验证明同一分数迁移到 TIES/DARE/TSV/Iso-C 及三种合并空间仍普遍有效(如语言 TSV 全空间 R=64 从 78.3 提到 81.4)。第四,三个反直觉发现支撑设计:最优方向集通常不是前缀(视觉任务 88% 的选中集非前缀);预算不必花完(满预算 R=112 时平均只用 61.5/112,省下 45% 反而再涨 $+3.19$);净效用与任务难度显著相关(Pearson $-0.78$),赋予指标可解释性。
实验结果
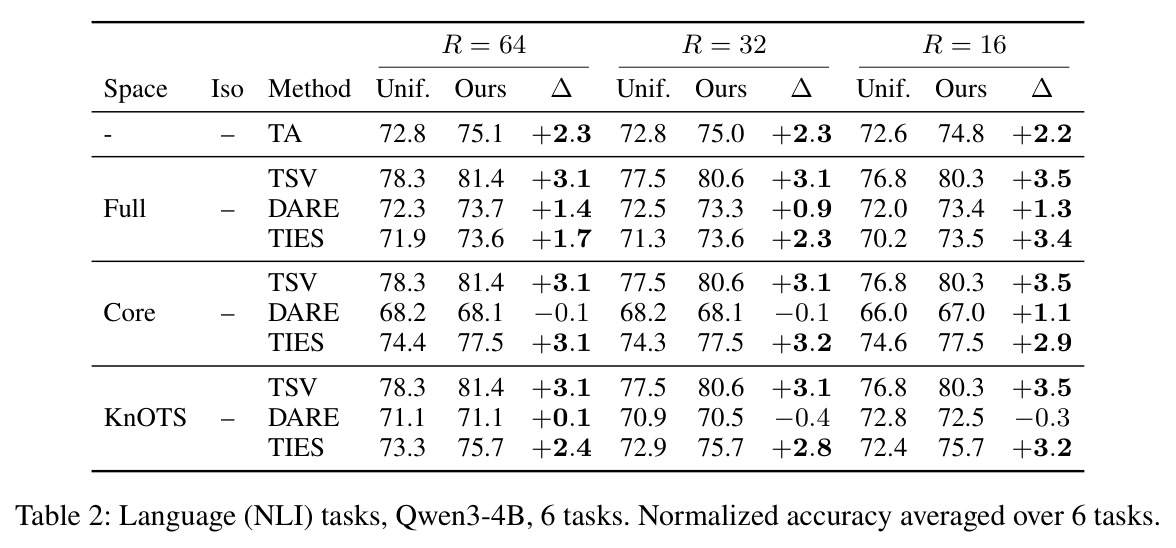
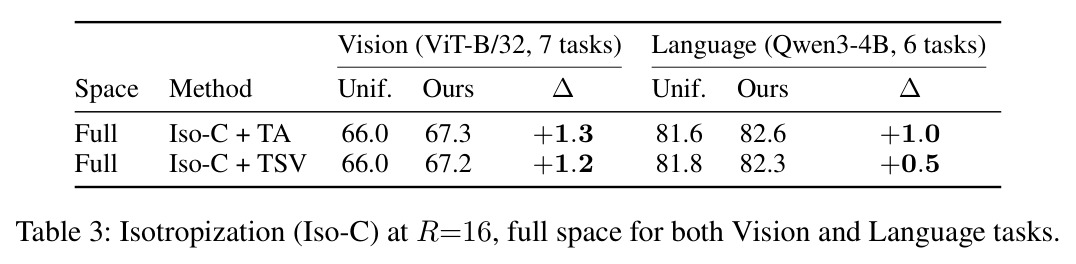
视觉(ViT-B/32 七任务,Table 1):3 空间×4 方法全部超越均匀分配;DARE 全空间 R=64 提升最大(63.5→67.3,$+3.8$),TA 全空间 R=64 +3.4(63.5→66.9),TSV 仅 +0.3~+0.8。语言(Qwen3-4B 六 NLI 任务,Table 2):TSV 获益最大(R=16:76.8→80.3,$+3.5$),TIES 全空间从 +1.7(R=64)扩到 +3.4(R=16:70.2→73.5),TA 稳定 +2.2~+2.3,例外:DARE 在 Core/KnOTS 空间 −0.1~−0.4。平均视觉 +2.1%、语言 +2.2%,预算越紧提升越大;叠加 Iso-C 也全为正(Table 3:视觉 +1.3/+1.2、语言 +1.0/+0.5)。预算分析(Table 4):满预算 R=112 每层只用 61.5/112 个方向(45% 未花),66.94 对均匀花满的 63.75(+3.19)。选择结构(Figure 3):视觉 88% 选中集非前缀,最强方向仅 12.8% 被保留、最弱 75.8%,语言 64.5% 非前缀。分配(Figure 4):高层及 v_proj、out_proj 得更多秩;净效用与任务难度相关(Figure 5):MATH 七主题 Pearson −0.78。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视觉 7 任务合并(Task Arithmetic,全空间,R=64,ViT-B/32) | 归一化准确率(%) | 66.9 | 63.5(均匀秩分配) | +3.4 |
| 视觉 7 任务合并(DARE,全空间,R=64,ViT-B/32) | 归一化准确率(%) | 67.3 | 63.5(均匀秩分配) | +3.8(全文最大单点提升) |
| 语言 6 NLI 任务合并(TSV,全空间,R=16,Qwen3-4B) | 归一化准确率(%) | 80.3 | 76.8(均匀秩分配) | +3.5 |
| 语言 6 NLI 任务合并(TIES,全空间,R=16,Qwen3-4B) | 归一化准确率(%) | 73.5 | 70.2(均匀秩分配) | +3.4 |
| 满预算 R=112(Task Arithmetic,视觉,仅保留正效用方向) | 归一化准确率(%) | 66.94(每层仅用 61.5/112 个方向,45% 预算未花) | 63.75(均匀分配花满全部预算) | +3.19 |
| 全部合并方法 × 空间平均(视觉 / 语言) | 绝对提升(%) | 视觉 +2.1 / 语言 +2.2 | 均匀秩分配 | 平均 +2.1~+2.2,最高 +3.8 |
局限与改进
作者承认两点局限:净效用仅对线性合并(Task Arithmetic)有推导保证,用于 TIES/DARE/TSV 属于经验外推、分解不再精确;$\lambda$ 未调参,若能访问验证集调 $\lambda$ 还能继续涨点。我的补充观察:(1) 输入几何用 $G_i \approx \kappa_i \Delta W_i^\top\Delta W_i$ 代理是很强的假设——协方差信息完全来自适配器权重,'适配器作用强'被默认等价于'输入方差大',方向可能失真;(2) 推导中对各层 Jacobian 范数近似相等、并用 Cauchy-Schwarz 放缩层间交叉项,层敏感度差异大时会引入偏差;(3) TIES 与 DARE 因算子依赖采样级剪枝率只能做逐层局部预算,全局分配对这两个方法失效;(4) 实验限于 7 个视觉分类与 6 个 NLI 分类任务,未覆盖生成式任务;(5) $\alpha\in\{0,1\}$ 的切换依赖异质性 $h$ 的经验判断,缺乏一般性准则。
独立分析的弱点
第一,Gram 代理几何:$x^\top G_i x \approx \kappa_i\|\Delta W_i x\|^2$ 把输入几何完全绑定在适配器自身权重上,当适配器欠拟合或任务输入分布与微调数据漂移时,打分会系统性偏置,改进方向是像 ACE-Merging 那样从更新免费估计协方差,或引入少量无标注代理数据校准。第二,$\lambda$ 与 $\alpha$ 都是启发式:中位数比值没有优化目标支撑,$\alpha$ 只有两档硬切换,可用排序稳定性或自监督代理任务在无标签数据上自校准。第三,对 TIES/DARE 只能逐层局部分配,浪费了全局预算视角,应为这些算子推导算子特定的效用函数(作者也把这点列为未来方向)。第四,扩展性:成对重叠 $V_j^\top V_i$ 的计算是 $O(M^2 r^2 d_{in})$,适配器库达到数百个时需要随机投影或聚类分块等近似。第五,评测面窄:全部为分类/NLI 式任务,指令跟随、代码、数学等生成任务的秩需求结构可能不同,结论外推存疑。
未来方向
作者明确提出的方向:为特定非线性合并算子定制净效用推导以进一步涨点;在有验证集时调 $\lambda$。基于成果可延伸的工作:(1) 把'预算不必花完'与'非前缀选择'两个发现形式化,替代所有现有 SVD 合并方法的前缀截断规则,成为新基线;(2) 系统研究净效用作为任务难度与适配器质量的免费诊断信号(Figure 5 的 $-0.78$ 相关值得放大验证);(3) 与 merge-friendly 训练(LoRI)、端侧持续合并(K-Merge)、顺序合并(Merge before Forget)结合,在存储预算下做动态适配器库管理;(4) 接入混合秩服务系统,让净效用决定每个请求的秩档位,降低解码延迟;(5) 在更大基座与上百适配器场景下验证近似谱方法的扩展性,并覆盖生成式任务重估结论。
复现评估
复现条件较好。视觉实验直接使用 KnOTS(Stoica et al. 2024)公开的 ViT-B/32 LoRA 检查点(HuggingFace collection:hoffman-lab/knots-model-merging-with-svd);语言实验需自训 6 个 NLI 适配器,配置完整公开(Table 5:Qwen3-4B-Instruct、PEFT、rank 16、$\alpha=16$、dropout 0.1、目标模块 $W_q/W_k/W_v/W_o$、AdamW 学习率 $3\times10^{-5}$、6% warmup、batch 1、最多 10 epoch、早停耐心 3 次评估)。代码基于 github.com/apanariello4/core-space-merging 改造,但论文未声明发布官方实现,Algorithm 1(SVD+打分+top-K)需自行实现,逻辑简单、约百行量级。算力需求低:方法本身只需 QR/SVD 与内积,无前向传播,单张 H100 主要用于训练语言适配器与跑评测。总体复现难度中等偏低,成本集中在语言侧训练。
论文图表
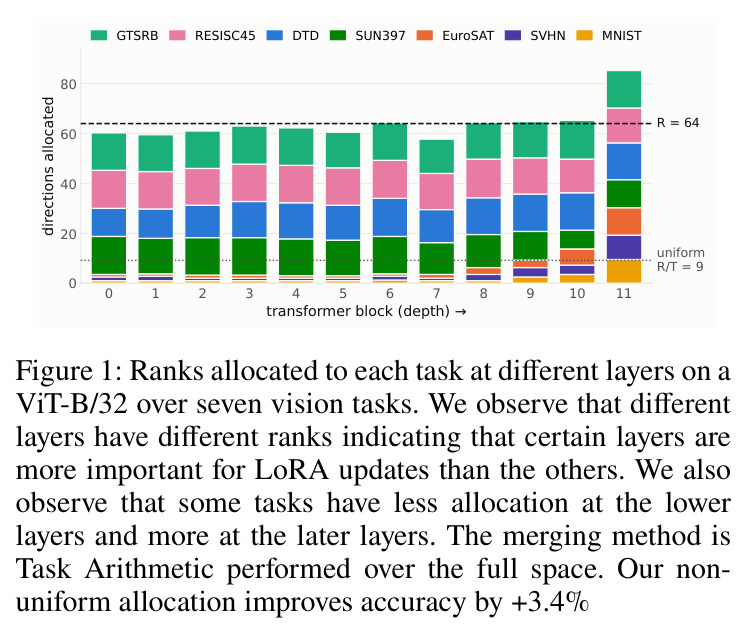
七条曲线(GTSRB、RESISC45、DTD、SUN397、EuroSAT、SVHN、MNIST)展示 Task Arithmetic 合并时各任务在 ViT-B/32 十二个 transformer block 上的秩分配。R=64 的非均匀分配显示:不同层的秩差异显著,部分任务低层分配少、高层分配多;作为对比,R/T=9 的均匀分配是一条水平线。这一非均匀分配带来 +3.4% 的平均性能提升。
这是全文的立论图:它用可视化证据直接否定了'每层每任务秩应当均匀'的行业默认假设,是动机部分最直观的支撑,也预告了方法输出的形态。
伪代码:输入任务更新、干扰系数 $\lambda$、全局预算 $R_G = L\cdot R$ 与合并算子;对每层计算所有任务 $\Delta W$ 的 SVD(QR 实现)、计算任务尺度 $w_l^i = \sum_n \sigma^4$、计算 $V_j^\top V_i$ 重叠并按公式 (8) 算效用;选出 top-$R_G$ 个正分数方向;重构 $K_l^i$ 并调用 Merge 输出。
方法的可执行规格。配合复杂度分析(每适配器 $O(r^2(d_{in}+d_{out}))$,排序 $O(C\log C)$),读者可直接据此实现,也是复现章节的核心依据。