度量检查器:面向GPU内核基准判题器的变异分析方法 Measuring the Checker: Mutation Analysis for GPU-Kernel Benchmark Oracles
用变异分析给GPU内核基准判题器定标,官方检查漏检16.9%的可测故障
前置知识
变异分析
软件工程经典技术:向程序注入大量微小确定性故障(如把 + 改成 -、删掉一个边界守卫)生成「突变体」,然后用测试套件去「击杀」它们。一个测试套件的质量 = 它能检测出的突变比例,从而把「测试好不好」从观点变成可测量的数字。
本文把这套机制从传统精确 oracle 迁移到浮点容差判决的 GPU 内核基准上,击杀率就是全文的核心度量。
容差数值判定
PyTorch 的 allclose 判定:当 $|f(x)-\hat f(x)| \le atol + rtol\,|f(x)|$ 时认为两个实现一致。KernelBench 取 $atol=rtol=10^{-2}$,只抽五次随机输入。误差小于这条线就「看不见」,故称分级 oracle 而非精确匹配。
容差盲区(小误差被 $atol+rtol|f|$ 吸收)是论文两大失效机制之一,几乎所有结论都围绕这条容差线展开。
CUDA 执行模型
GPU 内核按 grid/block/thread 三级组织,同 block 内线程通过共享内存协作并用 $\text{syncthreads}()$ 屏障同步;grid 尺寸常用 ceil 除法算出以覆盖尾部元素。边界守卫、同步屏障、归约累加都是常见 bug 高发点。
论文的六类故障家族(边界、同步、索引、精度等)全部对应 CUDA 特有的代码结构,理解突变规则需要这些概念。
浮点非结合性
fp32 加法不满足结合律 $(a+b)+c \ne a+(b+c)$,累加顺序不同的两个「都正确」的内核会产生合法的数值分歧,且输入越极端分歧越大。这为测试输入的激进度设置了一个客观上界。
论文实测出「有效性天花板」:越过它,更狠的输入会拒绝正确内核,检测率是假检测。这是区别于传统变异测试的关键约束。
研究动机
KernelBench 式基准用少量随机输入加宽松容差来裁决 LLM 生成内核的对错:提交需在五次种子下满足 $\text{allclose}(f(x),\hat f(x); atol{=}rtol{=}10^{-2})$。这个裁决如今承载三重负载——公开排行榜排名、生成内核进入生产实验的闸门、以及 Kevin 等 RL 系统的奖励信号。检查器弱会静默失效:一个返回全零的 softmax 内核在 $d=393{,}216$ 的归约问题上能通过全部官方检查,因为参考输出每元素均值仅 $2.5\times10^{-6}$,而 $atol=10^{-2}$ 是信号的四千倍。社区已经注意到问题:KernelBench-Verified 加了四个隐藏输入分布和更紧容差,The Correctness Illusion 手工植入 9 个 bug 并提出模糊测试方案,robust-kbench 硬化了形状与计时方法——但这些都只是「打补丁」,没有一个能回答维护者真正的问题:我的补丁覆盖了哪些故障、还漏掉什么?用十个手工 bug 验证一个协议几乎说明不了问题。
本文的目标是本文的目标是把软件工程五十年前解决的测量问题引入内核基准:将变异分析改造成 GPU 内核判题器的充分性度量。具体做法是向 188 个 KernelBench 问题的门控验证 CUDA 实现中,用确定性规则注入 10,303 个可编译故障(其中 7,384 个配有独立击杀见证),任何测试协议都按「它能检测出的故障比例」打分。在此度量之上完成三件事:量化官方检查的漏检率及其按故障家族的分布结构;在各自发布参数下审计 KernelBench-Verified 等现有补丁的实际贡献;证明该度量能反向指导测试套件合成与 LLM 测试生成器的知识注入。全部产物以 KernelBench-M 名义发布。
与已有工作不同的是,现有工作全部是补丁式加固,没有工具度量判题器本身;而经典变异测试也无法直接搬用,因为该域有四个独有障碍,本文的切入角度就是逐一攻克:(C1) 判决是分级的数值比较而非精确匹配,容差盲区随归约规模增长——$d=64$ 时最大不可检相对误差为 0.39,$d=393{,}216$ 时达 $2.5\times10^{3}$;(C2) 合法输入有上界,两个正确的 fp32 内核因累加顺序合法不一致,符号混合输入缩放 300 倍就能把正确内核推出容差,而先前工作没有一个设有有效性门;(C3) 分母必须挣得——等价突变和 oracle 瞎突变会同等稀释所有协议的得分,信息量为零;(C4) 成本——标准 torch extension 路径编译一个突变约 200 秒,一万个突变需要 GPU 年。同期做程序变体测试增强的 EvalPlus、GateTruth 等都不面对分级 oracle,因而从不需要处理盲区与天花板。
核心方法
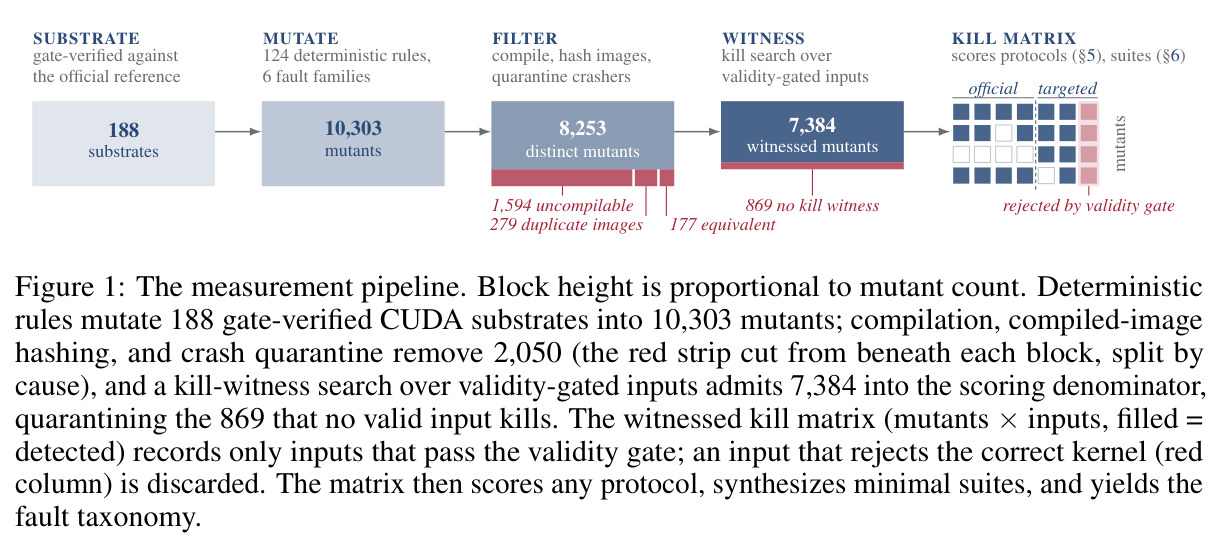
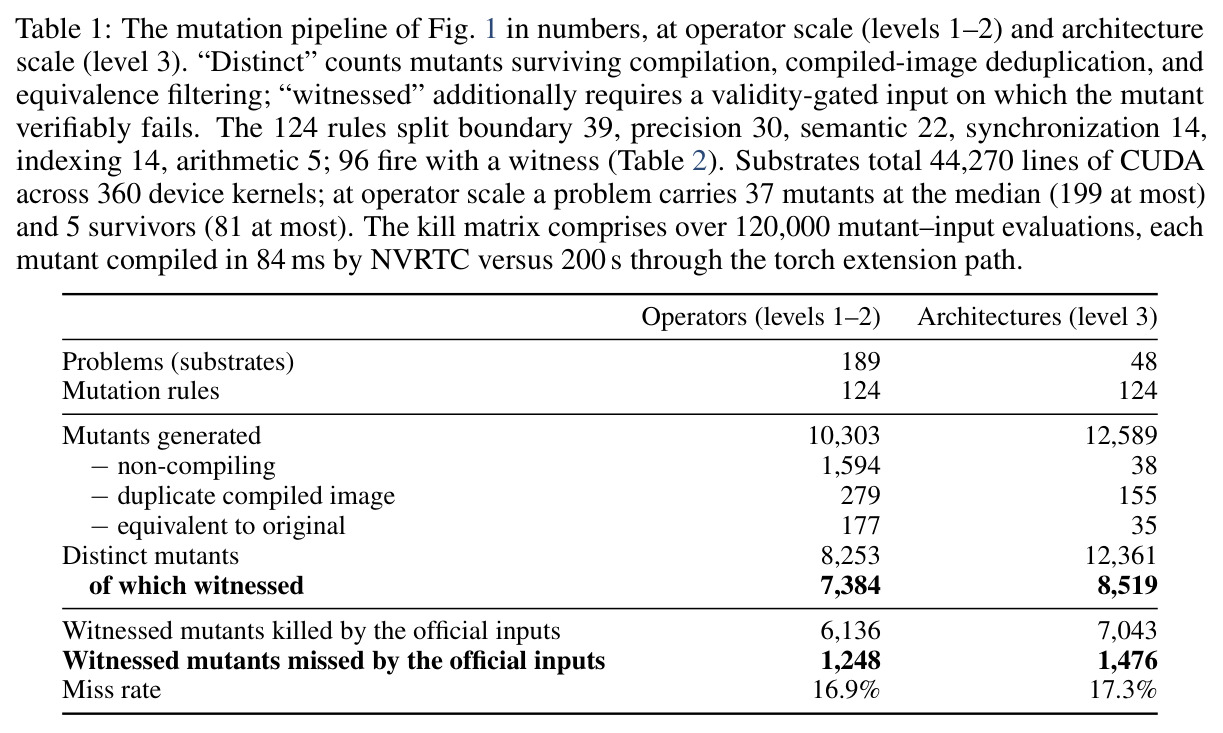
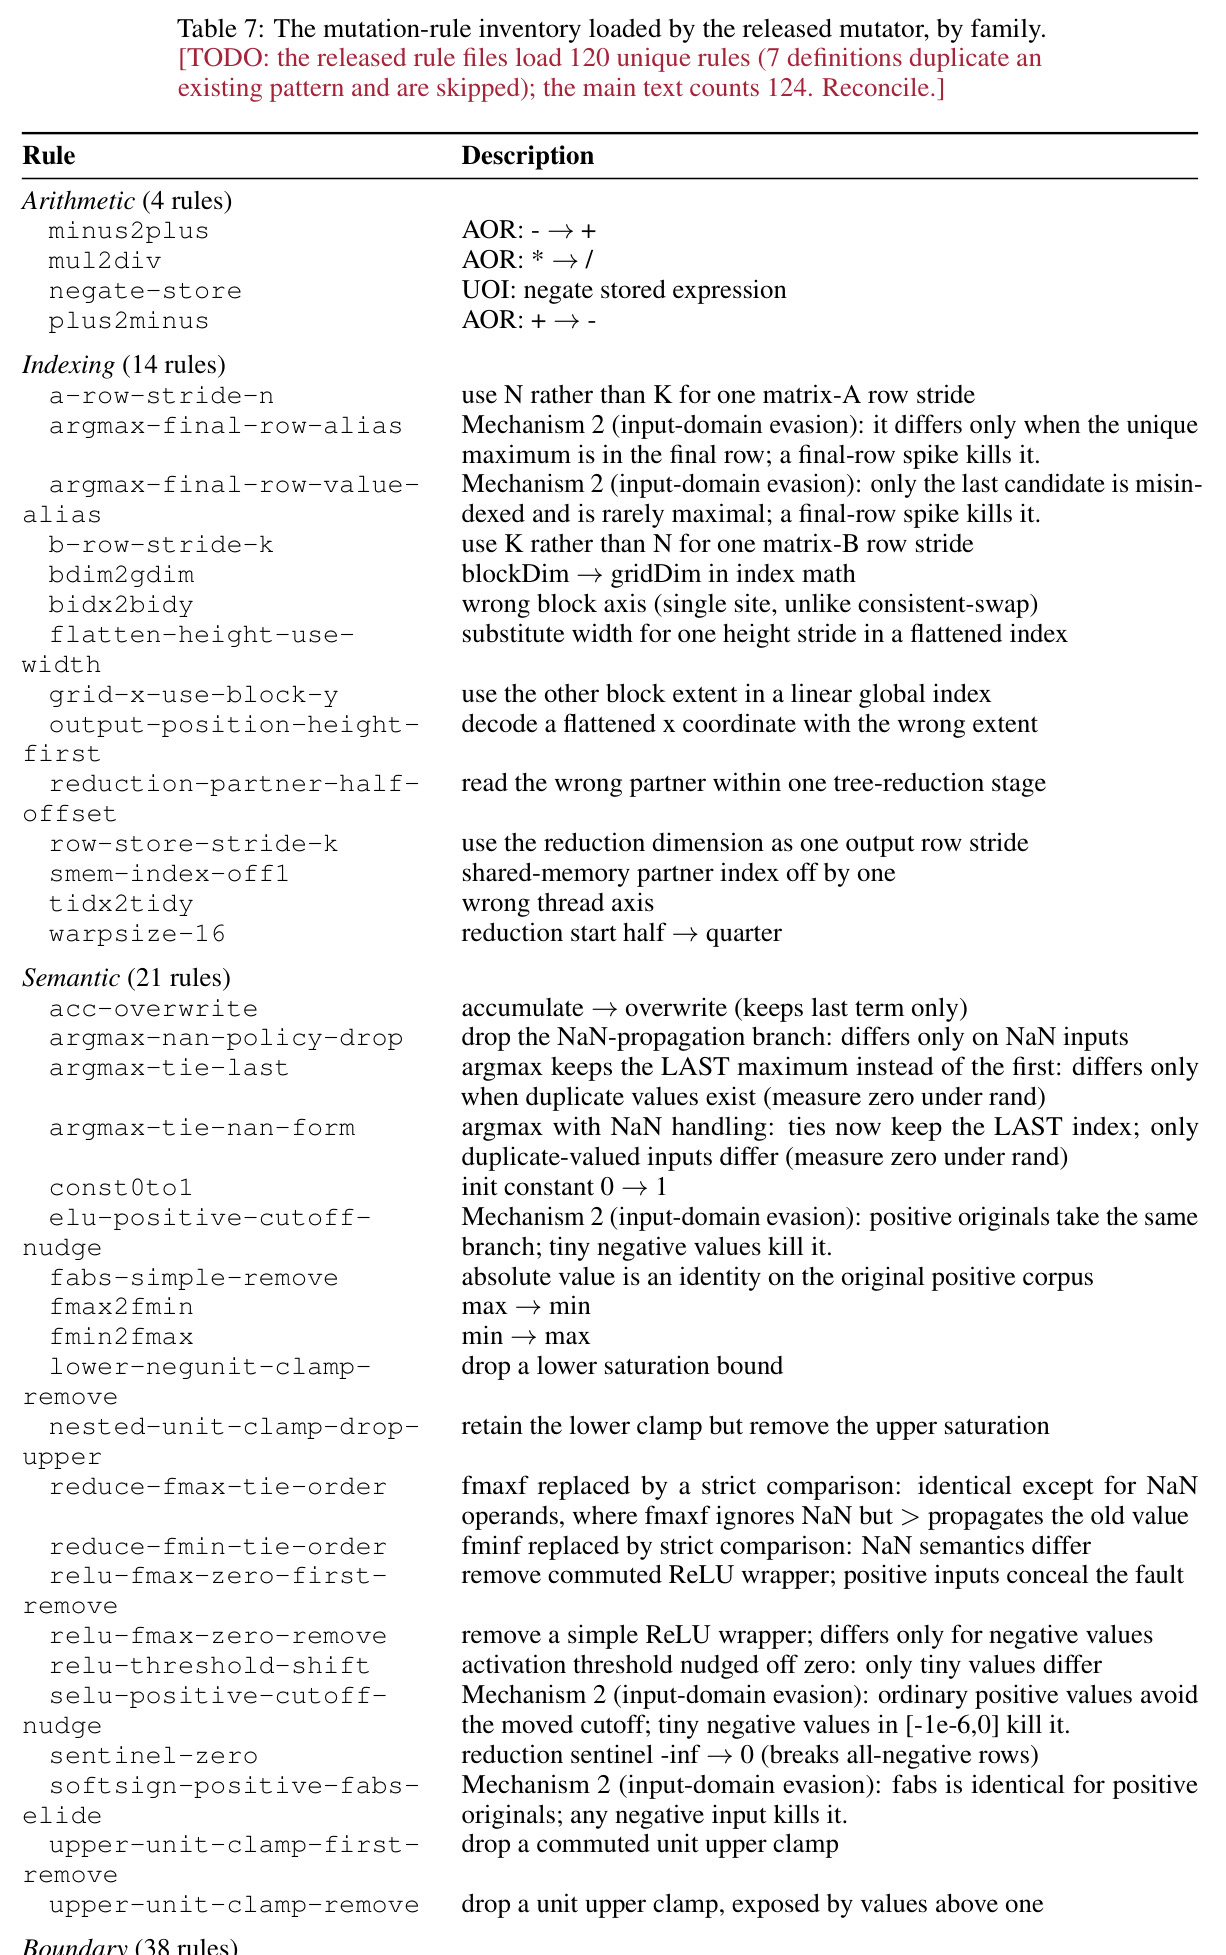
直觉:与其争论检查器好不好,不如向被测系统注入大量已知故障,看检查器能抓到多少。技术路线是一条五段流水线(Fig. 1):(1) 基底——为 188 个 KernelBench 问题维护 LLM 撰写、经自动门控(与官方 PyTorch 参考在全部输入套件上比对,能拒掉真实错误如 L1 范数把 mean 写成 sum)验证的正确 CUDA 实现,共 44,270 行、360 个 device 内核;(2) 变异——124 条确定性规则跨 6 个家族(算术/索引/语义/边界/同步/精度)注入 10,303 个突变;(3) 过滤——NVRTC 编译剔除 1,594 个不可编译突变,编译产物哈希去重 279 个,崩溃隔离再剔除 177 个等价体,得 8,253 个行为可区分突变;(4) 见证——仅在通过有效性门的输入上做击杀搜索,7,384 个突变获得独立见证;(5) 打分——任一协议的得分即其在 7,384 个见证突变上的击杀比例,全程超 120,000 次突变–输入评估。
核心创新是三个适配分级数值 oracle 的机制。其一,见证分母:突变只有在配有一个具体、通过有效性门、且能在其上验证失败的输入时才进入任何协议的得分分母,其余一律隔离——这杜绝了等价突变与不可见突变同等稀释所有协议分数的经典缺陷,也是先前工作(最多 10 个手工种子 bug)从未做到的。其二,有效性天花板:实测 fp32 累加非结合性造成的合法分歧,把「输入可以多凶」变成一个可测边界(符号混合输入缩放 $s\ge 300$ 就会拒绝正确内核),越过天花板买来的检测率是假检测——重建的模糊测试方案误杀正确内核 107 次正是反面教材。其三,NVRTC 运行时编译把单突变编译从约 200 秒压到 84 毫秒(500 倍加速),使万级突变乘输入的击杀矩阵(12 万次评估)在约 30 GPU 小时内可负担。度量之上还能合成:对击杀矩阵做贪心集合覆盖即得最小测试套件。
方法步骤详情
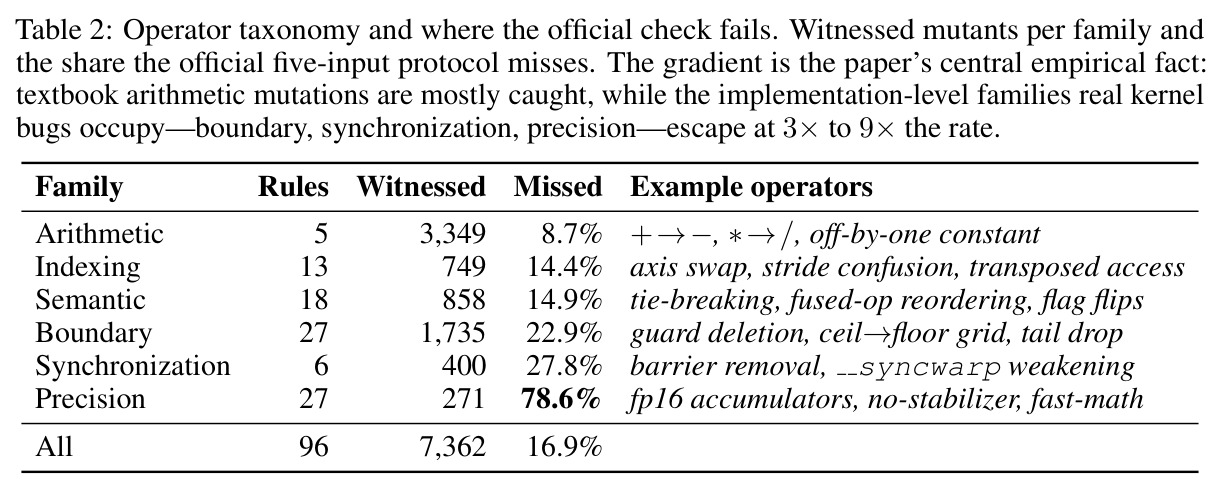
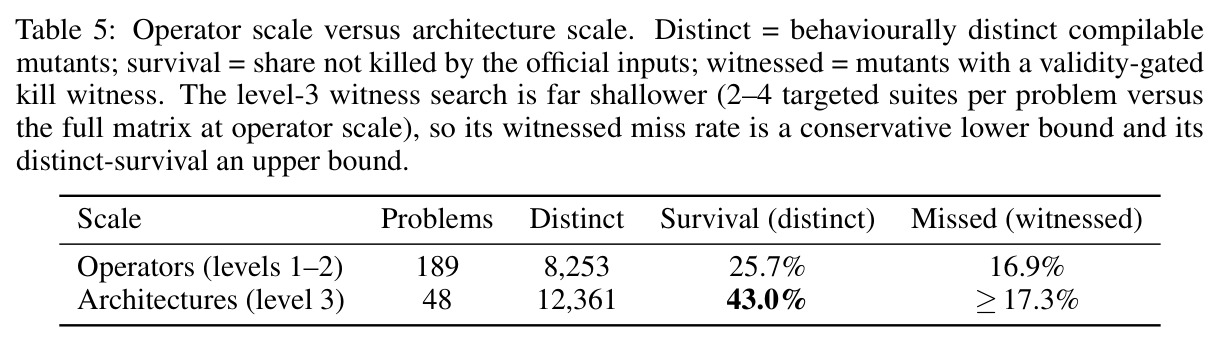
第一步,构建基底:LLM 撰写每个问题的 CUDA 实现,自动门控将其与官方参考在全部套件上比对(作为变异靶,oracle 仍是基准自己的参考)。第二步,变异:124 条规则(算术 5、索引 14、语义 22、边界 39、同步 14、精度 30)每处匹配生成一个突变,共 10,303 个;算子级每问题中位 37 个突变、5 个幸存者(最多 199 和 81)。第三步,过滤:NVRTC 拒 1,594 个,编译镜像哈希去重 279 个(GPU 版 Trivial Compiler Equivalence),微输入探针+看门狗+fork 级隔离处理崩溃与挂起,177 个等价体被剔除,剩 8,253 个。第四步,见证搜索:只在通过有效性门(不拒绝正确内核)的输入上找击杀见证,得 7,384 个见证突变,其余 869 个隔离。第五步,打分与审计:官方五种子协议击杀 6,136(83.1%)、漏 1,248(16.9%);再按统一分母审计 KernelBench-Verified 与重建的 CI 式 fuzzer。第六步,合成:对矩阵做贪心集合覆盖得最小套件,并做知识阶梯实验测试生成器。第七步,扩展到 48 个整架构(level 3),12,361 个可区分突变、8,519 个见证突变。
技术新颖性
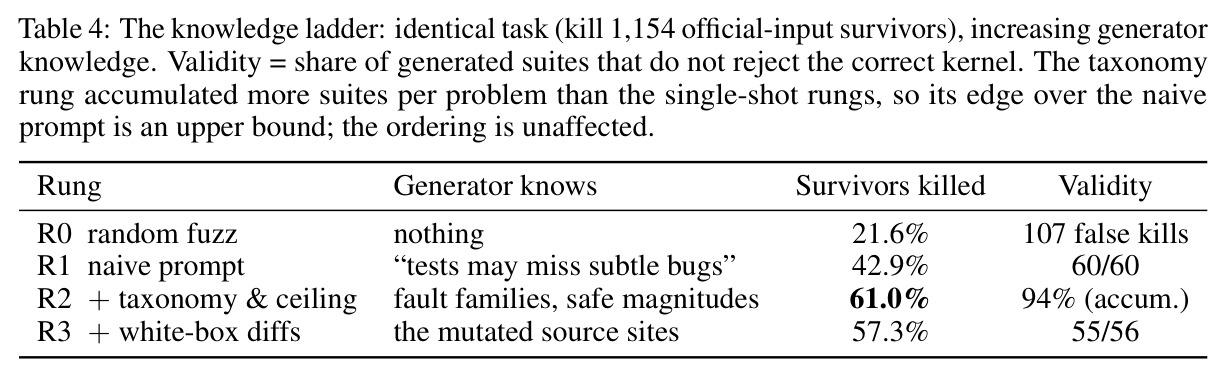
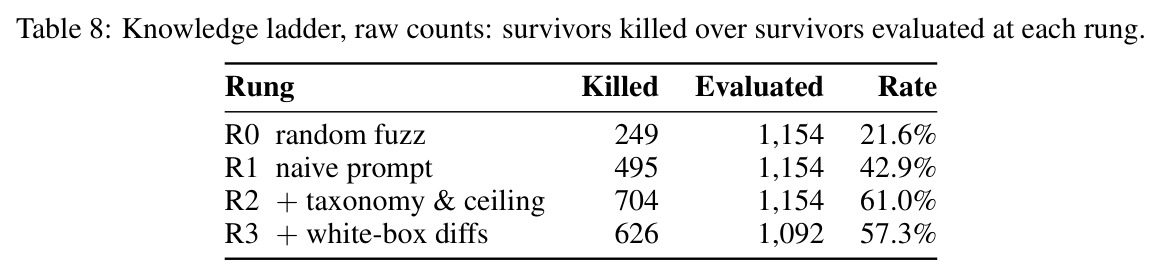
相比既有工作的本质区别:KernelBench-Verified、The Correctness Illusion、robust-kbench 都是补丁或攻击判题器,无一测量判题器;EvalPlus 等增强 Python 基准面对精确 oracle,不需要处理容差盲区与浮点有效性。本文的技术新颖性在于:把变异分析的击杀率改造成带见证分母的充分性度量,使比较性断言(协议 A 漏了协议 B 能抓的故障)与存在性断言(该协议漏了这些可证可测的故障)都可计算;有效性天花板把「用更狠的输入」从启发式变成硬约束;由度量导出的六家族故障分类学成为可迁移知识——知识阶梯实验显示给测试生成器分类学(击杀率 61.0%)优于给它看具体突变的白盒 diff(57.3%),度量的抽象比原始实例更值钱。MUPPET 用同样的变异机制找性能加速,方向相反;「变异分析 × 内核基准 oracle 审计」的组合此前不存在。
实验结果
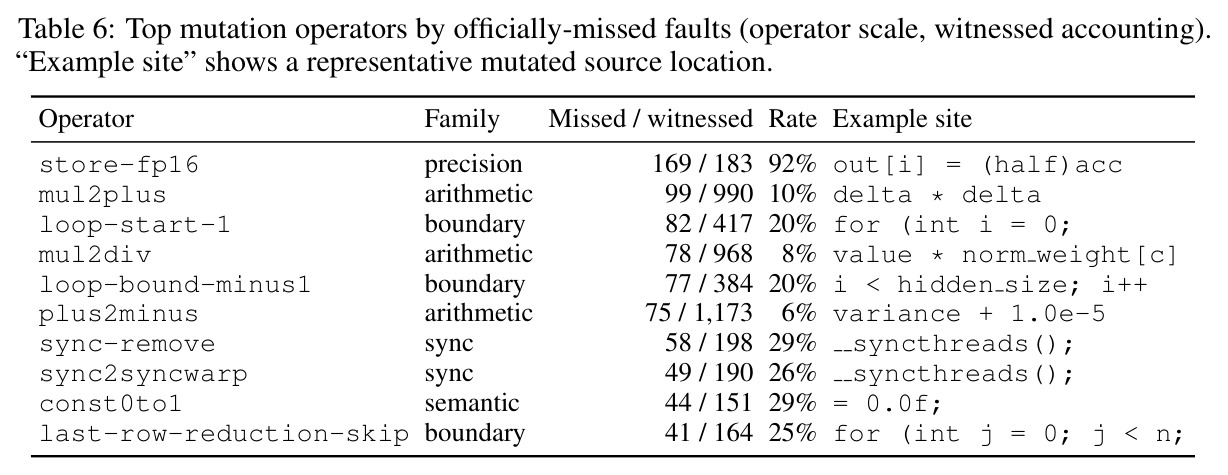
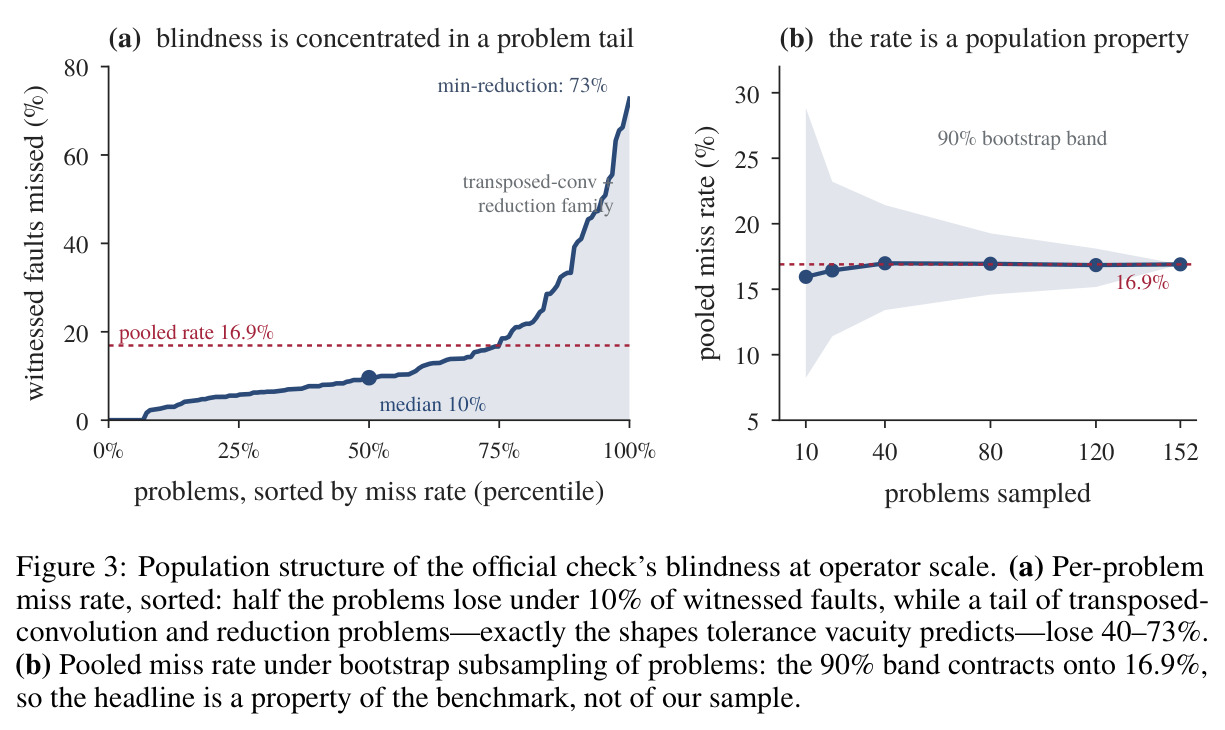
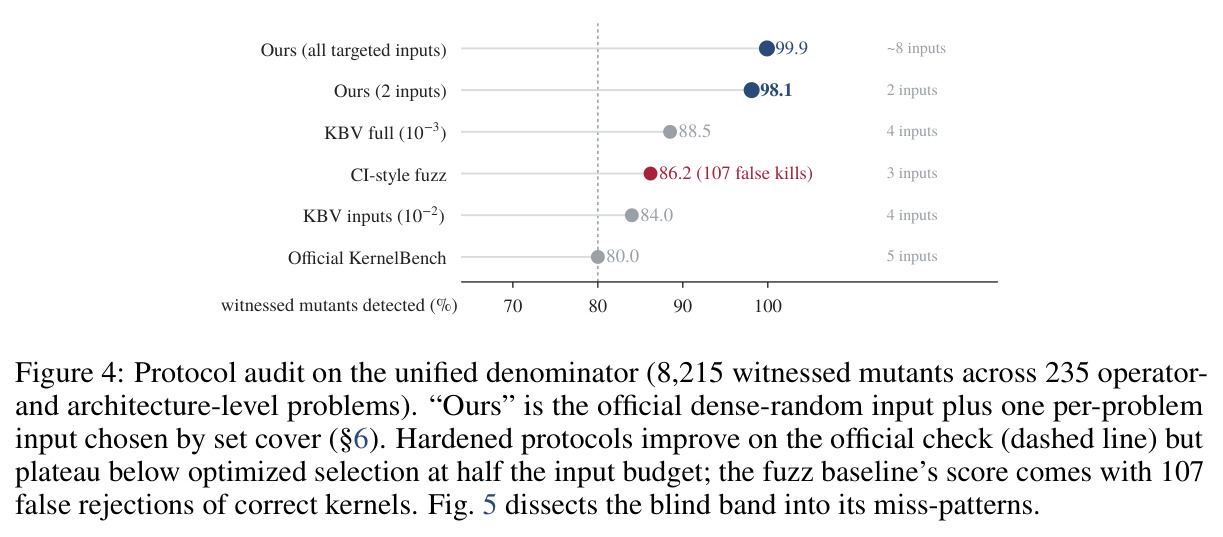
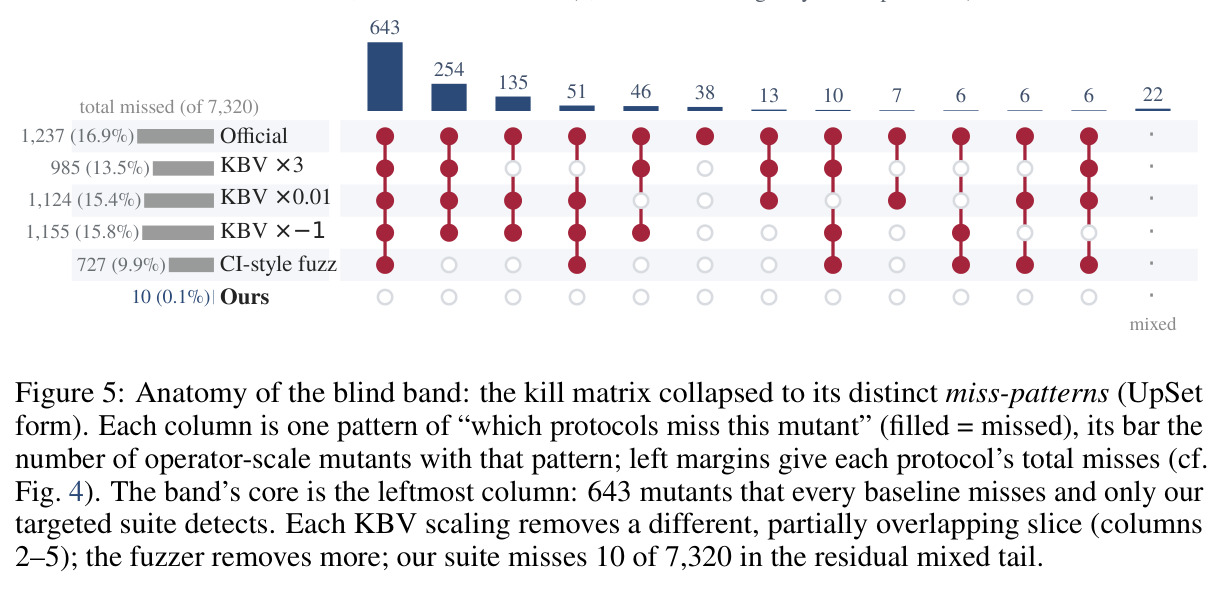
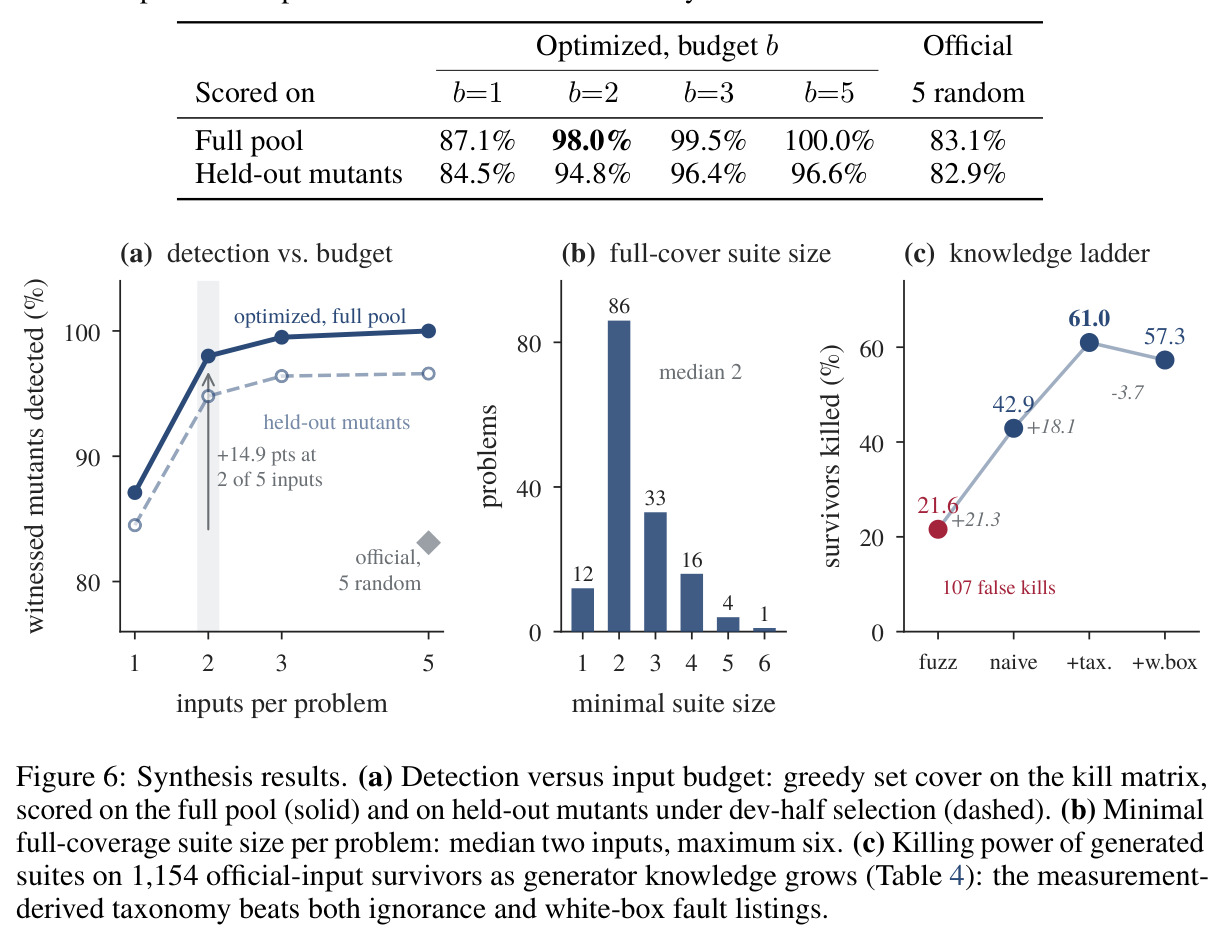
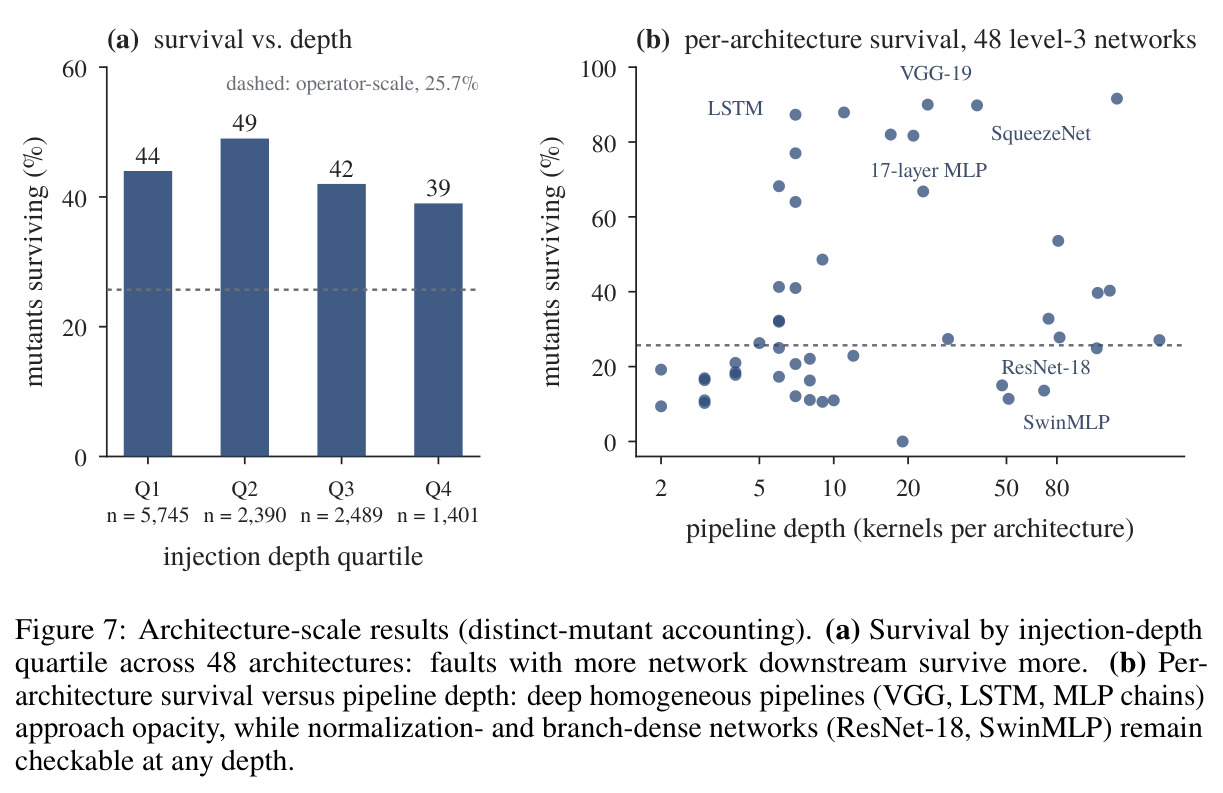
(1) 官方检查充分度:在 7,384 个见证突变中击杀 6,136、漏 1,248,漏检率 16.9%(约六分之一);bootstrap 重采样证明这是总体性质(90% 置信带随问题数从 [8,29]% 收缩到 16.9%),但按问题高度右偏——中位问题漏 10%,转置卷积/归约尾部分问题漏 40–73%。(2) 家族梯度:算术突变仅漏 8.7%(3,349 个见证),精度突变漏 78.6%(271 个,store-fp16 达 92%)、同步 27.8%(400 个)、边界 22.9%(1,735 个)。(3) 机制:容差盲区随归约规模增长,softmax 贡献 28 个容差盲幸存者而结构相同的 log-softmax 只有 9 个;90 个突变只有稠密随机输入能杀,靶向输入是互补而非替代。(4) 审计:统一分母(235 问题、8,215 个见证突变)上官方 80.0%,KBV 完整 88.5%(+4.0 来自隐藏分布、+4.5 来自 $10^{-3}$ 紧容差),重建 CI 式 fuzzer 86.2% 但误杀正确内核 107 次;KBV 常数缩放对形状/索引家族按构造不可达。(5) 合成:集合覆盖每问题 2 输入达 98.0%(held-out 94.8%),5 输入 100%,官方 5 随机仅 83.1%。(6) 知识阶梯:R0 随机模糊 21.6% → R1 朴素提示 42.9% → R2 分类学 61.0%,R3 白盒 diff 57.3%。(7) 整架构:48 网络、12,361 个可区分突变,见证漏检 ≥17.3%,可区分幸存上界 43.0%(算子级 25.7% 的 1.7 倍);VGG-19/SqueezeNet 幸存 90%、LSTM 77–87%、17 层 MLP 82%,而 ResNet-18(51 内核)仅 11%、SwinMLP(71 内核)14%;两个问题(48 Mamba2ReturnY、45 UNetSoftmax)被证明不可裁决——官方 fp32 参考对 fp64 自身分别越界 352 与 9,379 处(后者最大偏差 0.74)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 官方判题器充分度(算子级 188 问题) | 见证突变击杀率 | 83.1%(击杀 6,136/7,384,漏检 16.9%) | 无——这是该域首个 oracle 强度测量 | 从「观点」变为带 90% bootstrap 置信带的测量 |
| 判题器审计(统一分母:235 问题、8,215 见证突变) | 检测率 | 99.9%(全部靶向输入)/ 98.1%(每问题 2 输入) | 官方 80.0%;KBV 完整 88.5%;CI 式模糊 86.2%(误杀正确内核 107 次) | 约 +20 点且零误杀;并把 KBV 的 +8.5 分解为 +4.0 分布 +4.5 容差 |
| 最小套件合成(level 1/2 见证池) | 见证突变检测率 | 98.0%(每问题 2 输入;held-out 94.8%);5 输入 100% | 官方 5 随机输入 83.1% | 一半输入预算下 +14.9 点,中位全覆盖仅需 2 输入 |
| LLM 测试生成(击杀 1,154 个官方输入幸存者) | 幸存者击杀率 | 61.0%(R2:分类学+天花板知识) | R0 随机模糊 21.6%;R1 朴素提示 42.9%;R3 白盒 diff 57.3% | 约为模糊基线的 3 倍;分类学优于具体故障本身 |
| 整架构检查(48 个 level-3 网络) | 见证漏检率 / 可区分幸存率 | ≥17.3% / 43.0%(12,361 个可区分突变) | 算子级 16.9% / 25.7% | 量化深度×同质性使检查恶化 1.7 倍;发现 2 个不可裁决问题 |
局限与改进
作者明言:充分性相对故障模型而言,124 条规则在朴素基底上无法表达张量核心路径、双缓冲流水线、部分 warp 级惯用语及多位点交互故障;度量只许可比较性与存在性断言,不能证明通过检查的内核正确,他们也从未如此使用。范围上,基底是 LLM 撰写并门控的(非从真实提交采样),实验仅限一代 GPU(H100)与固定 $10^{-2}$ 容差(§5 单独隔离了改容差的效应);level-3 见证搜索比算子级浅(每问题 2–4 套件 vs 全矩阵),故 17.3% 是单侧下界、43.0% 是上界。我的补充观察:现实性探针在 60 个问题上只发现 3 个真实 bug,样本太小,「故障家族≈真实 bug 分布」仍是待验证假设;附录 Table 7 自标注规则数 120 与正文 124 未对齐,提示规则工程的人工痕迹;869 个未见证突变被隔离在分母外,若其中藏有新型可测故障会系统性低估漏检率。
独立分析的弱点
弱点一:变异规则与真实 LLM 错误的同构性证据薄弱——现实性探针仅 3 个 bug(其中 2 个落入边界/守卫与累积/语义家族),建议扩大探针规模,或直接对公开排行榜提交与 RL 训练产物做变异标注与覆盖分析。弱点二:869 个未见证突变与 177 个等价突变被隔离后不再进入任何比较,但「oracle 瞎」与「真等价」未逐一裁决,未来可用差分测试或符号执行把两类归因清楚。弱点三:有效性天花板在单一 GPU 代与固定容差下测量,fp32 累加行为随架构、驱动、张量核心路径而变,天花板需要在线重测机制而非一次性常数。弱点四:套件合成的 held-out 检测仍有约 3 点泛化缺口(98.0%→94.8%),且按问题选输入依赖已有击杀矩阵,对全新问题冷启动无解,可探索跨问题迁移的输入先验。弱点五:两个不可裁决问题是从 50 个 level-3 中发现的——其他基准(TritonBench、MLPerf 子集等)很可能藏有同类问题,值得把 fp64 自检裁决流程做成独立审计工具。
未来方向
作者提出的方向:把击杀率作为奖励训练学习型测试生成器——分类学知识是这些提示阶梯的「可信下限」,学习型生成器只会更好;KernelBench-M 的定位是让下一次对内核基准的补丁「带着测得的覆盖度而非口头断言发布」。基于成果可延伸:把有效性门与裁决流程推广到其他数值基准和 RL 训练回路(奖励信号实时度规);在线变异——训练过程中周期性注入小规模突变子集监控判题器漂移;自动容差设计——在盲区下界与天花板上界之间优化 $(atol, rtol)$ 曲线,替代一刀切的 $10^{-2}$;跨 GPU 代(A100/H100/B200)复测两大机制的稳定性;把等价突变检测从编译镜像哈希扩展到数值等价的统计检验;以及用测得分类学反向约束代码生成模型——在解码或验收时拒绝易写入 store-fp16、删同步等高危模式的内核。
复现评估
复现条件很好:作者以 KernelBench-M 发布全部产物——124 条变异规则(附录 B 全量列表)、门控 CUDA 基底、带见证套件的逐突变击杀记录、dev/test 划分(各问题突变按 id 哈希 50/50),以及能从发布的 JSON 汇总再生成击杀矩阵、协议审计与集合覆盖套件的流水线脚本与出图脚本。算力需求温和:单张 H100 80GB(驱动 535.161.08),PyTorch 2.7.1(CUDA 12.6 构建)+ NVRTC 12.6,整个测量活动约 30 GPU 小时——关键是 NVRTC 路径把每突变编译压到 84ms,使万级突变可行。LLM 产物(基底、靶向套件)均通过自动门控/有效性门验证,生成过程用 Codex CLI 一次性采样并附完整提示词(附录 C)。主要门槛是一块 H100 级 GPU 与 CUDA 环境;读懂规则定义需要内核开发经验,但流水线完全脚本化,复现主要数字不需要手工操作。
论文图表
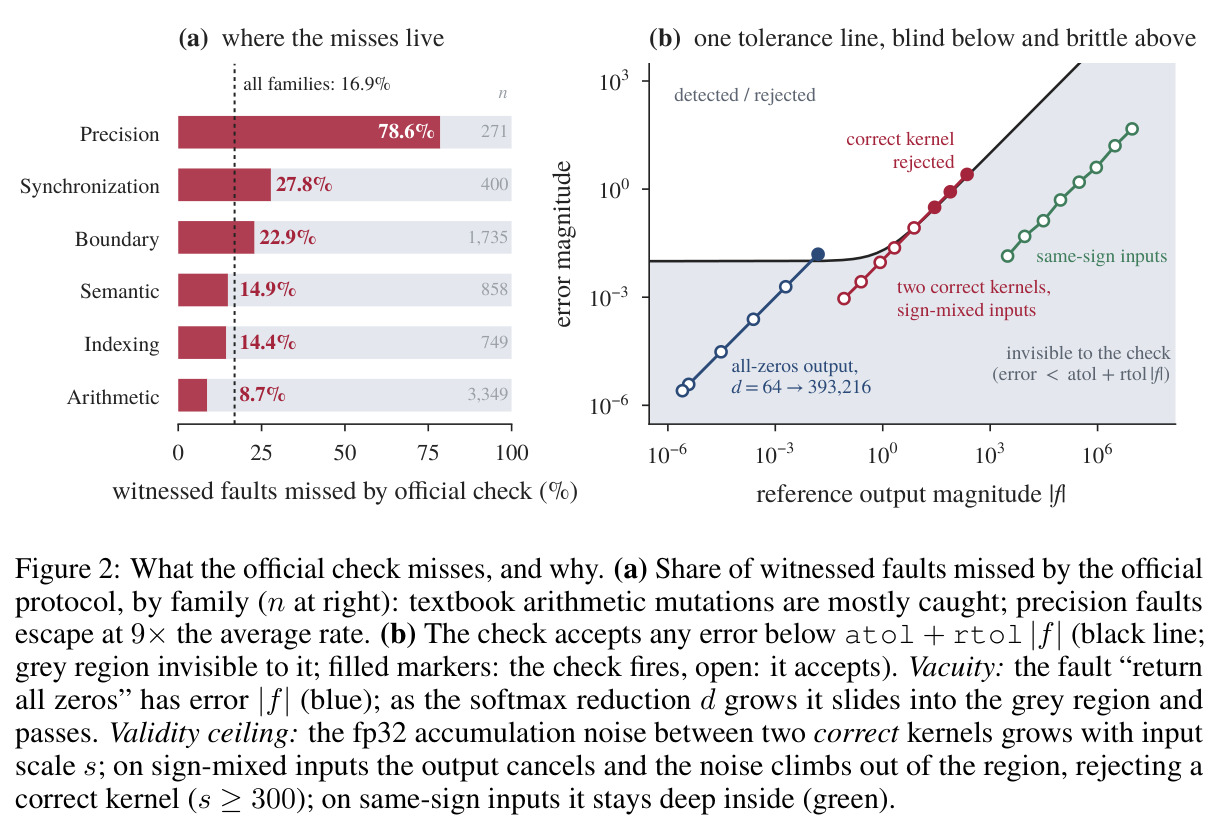
左图:各家族被官方协议漏检的见证突变占比(全体 16.9%,精度 78.6%、同步 27.8%、边界 22.9%、语义 14.9%、索引 14.4%、算术 8.7%)。右图:容差判决线 $atol+rtol|f|$——盲区之下(全零输出、随归约规模 d=64→393,216 滑入灰色区域)和天花板之上(符号混合输入 s≥300 拒绝正确内核)分别是两种失效机制。
一张图同时呈现论文的两大机制(容差空洞性与有效性天花板)和中心经验事实(家族梯度),是理解「为什么官方检查弱」的核心。
优化套件在各输入预算 b=1/2/3/5 的检测率:全池 87.1%/98.0%/99.5%/100.0%;held-out(按 id 哈希 50/50 dev/test 划分、只在 dev 半选输入)84.5%/94.8%/96.4%/96.6%。官方 5 随机输入对应 83.1%/82.9%。
同时给出合成套件的上限性能与泛化缺口(约 3 点),证明所选输入捕捉的是故障家族而非记忆了个例。