MintAct:面向数字环境的统一视觉智能体 MintAct: A Unified Visual Agent for Digital Environments
2B/4B/8B 单模型统一 UI 定位、跨端导航与视觉工具调用,异步 RL 不牺牲单域性能
前置知识
GRPO(组相对策略优化)
一种免价值网络的 RL 算法:对同一任务并行采样 $N$ 条轨迹组成一组,用组内平均奖励作基线,优势为 $\hat{A}_i = R_i - \frac{1}{|G(i)|}\sum_{j\in G(i)} R_j$(本文不做标准差归一化),再以 PPO 式裁剪目标更新策略。全成功或全失败的组优势为零、无学习信号。本文组大小 $N=8$。
MintAct 的 RL 阶段全部建立在 GRPO 之上,动态组过滤、按域配额、难度筛选(保留约 50% 成功率任务)等设计都围绕'组'这一单位展开,不懂 GRPO 就无法理解其 RL 策略。
异步 RL 与 off-policy 漂移
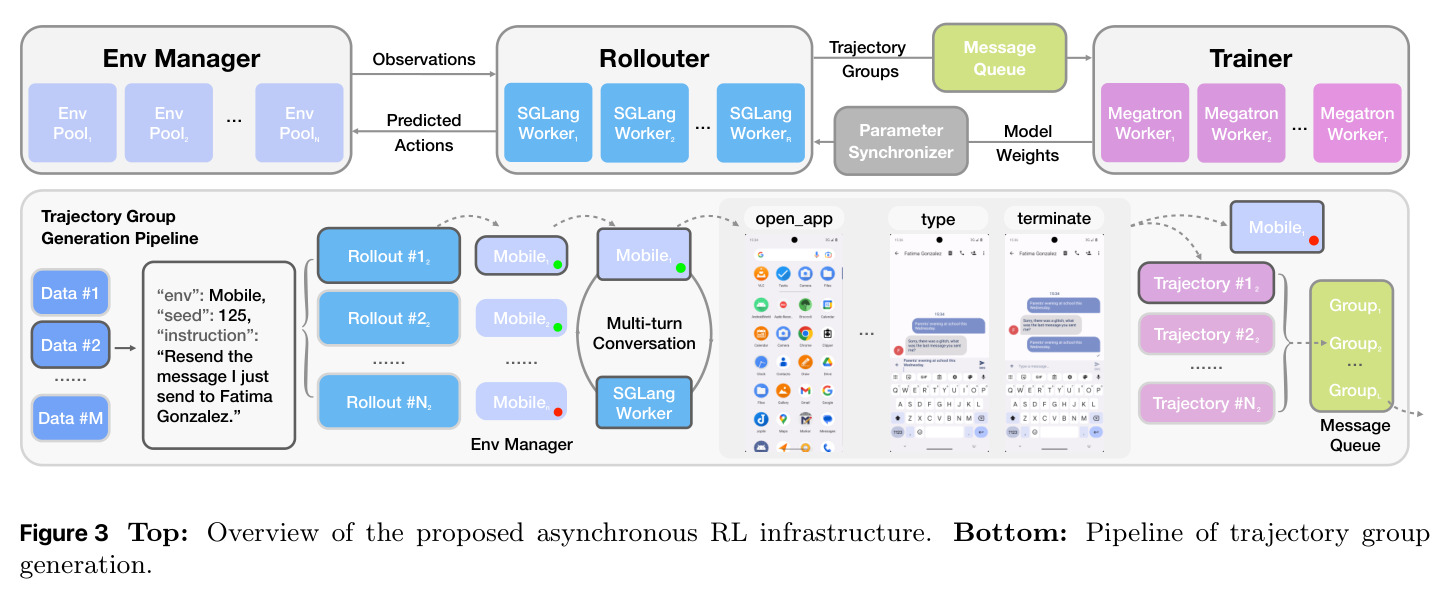
同步 RL 中训练必须等最慢的 rollout 完成,GPU 大量空转;异步 RL 让 rollout 与训练并行,但代价是训练样本可能由旧版策略生成(staleness gap),加上训练引擎与推理引擎数值实现不同(engine gap),形成 off-policy 偏差,需要重要性加权或裁剪来修正。
GUI 环境单步操作以秒计且延迟方差极大,异步化是唯一可行的规模化路线;本文的两大稳定性机制(双裁剪、截断 IS 权重)正是为弥合这两个 gap 设计的。
RFT(拒绝采样微调/蒸馏)
先用 RL 在各领域训练专家模型,再让专家在自己领域的任务上生成大量轨迹,用 VLM 裁判只保留成功的高质量轨迹,最后把这些轨迹当 SFT 数据微调回单一模型。本质是把多个 RL 专家的能力蒸馏回一套权重。
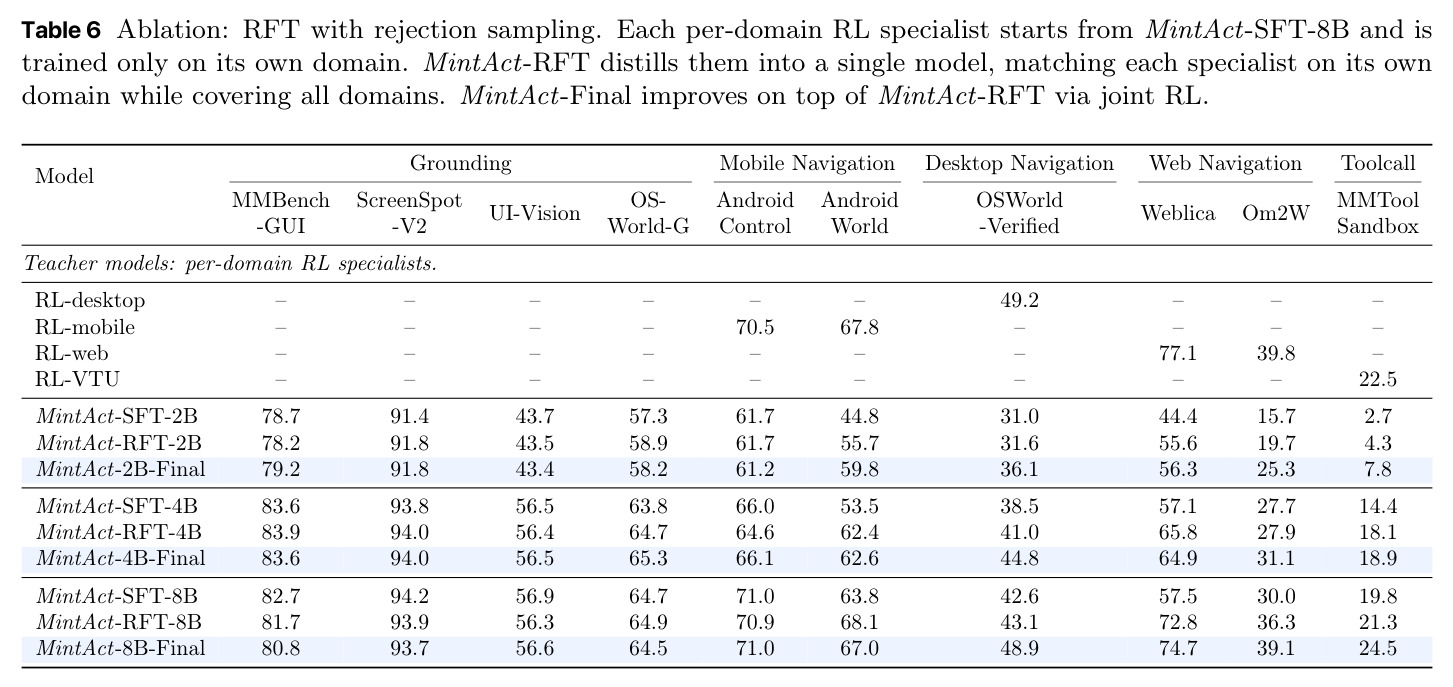
RFT 是 MintAct 在'统一'与'特化'之间的关键折中:论文 Table 6 显示 8B 模型经 RFT 后 AndroidWorld 从 63.8 升到 68.1,甚至超过移动 RL 专家本身的 67.8。
UI Grounding 与主流基准
Grounding 指把自然语言指令映射到屏幕上的目标位置(输出坐标或框)。评测基准包括 ScreenSpot-v2、MMBench-GUI、UI-Vision、OSWorld-G;交互任务则有 AndroidWorld(手机模拟器)、OSWorld-Verified(桌面 Docker)、Weblica/Online-Mind2Web(网页),通用指标是任务成功率。
论文所有结论都以这些基准的成功率表述,例如 8B 模型 OSWorld-Verified 48.9 是同规模 SOTA;理解各基准对应哪个领域才能读懂结果表。
Function calling 与动态工具注册表
函数调用指把模型输出解析为结构化 JSON(工具名+参数)去执行外部 API。MM-ToolSandBox 有 500+ 工具,全部塞进提示会爆上下文,因此 agent 用 search_tool 按需检索工具并动态扩展可用工具列表——但工具定义变化会改写提示前缀。
动态工具注册表导致 SFT 无法用固定系统提示,引出论文的'注册表感知轨迹切分+段级 loss 掩码';RL 中也带来段级 credit assignment 的粗粒度问题。
研究动机
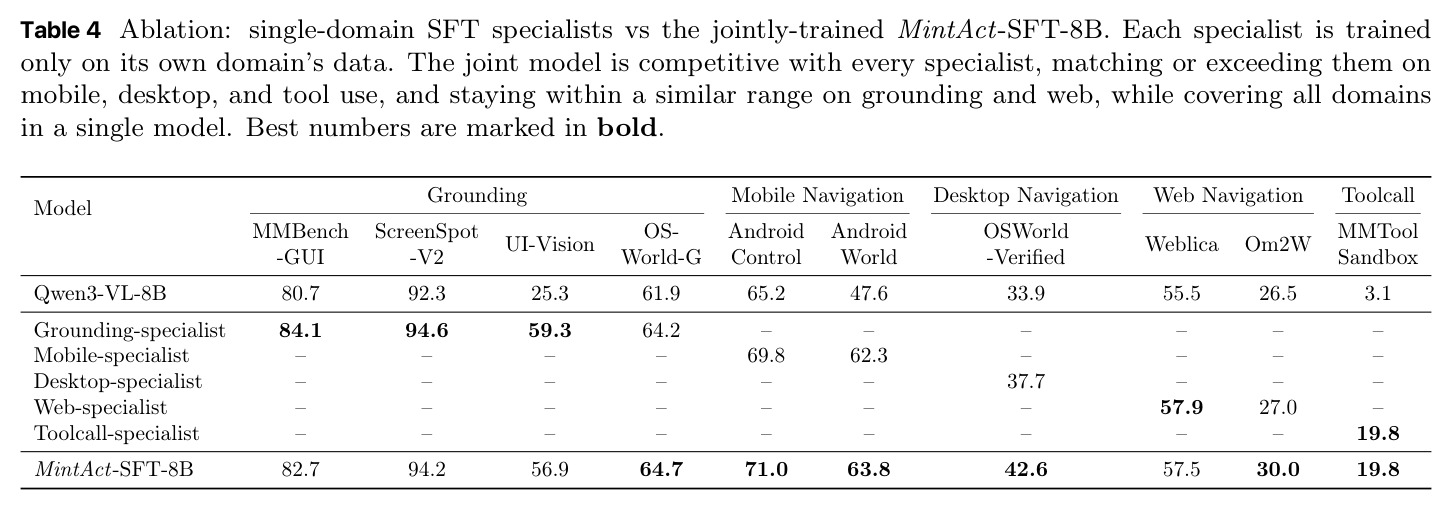
视觉智能体的能力高度碎片化:UI 定位(Jedi、GroundCUA)、手机导航(Ferret-UI Lite、MAI-UI)、桌面控制(UI-TARS、OpenCUA、EvoCUA)、网页导航(ScaleCUA、Weblica)和视觉工具调用各有专门的模型、数据与基准。为每个领域维护一个专家模型在服务和扩展上代价高昂,对适合端侧部署的 2B-8B 小模型尤其不现实;而简单合并各领域动作集、混着数据训练又会领域互扰、掉点。更麻烦的是工程侧:可靠的交互行为越来越依赖在线 RL,但 GUI 环境后端异构且缓慢——环境操作以秒计,远慢于模型推理,延迟方差极大;轨迹又长又是多模态,上下文和显存随截图快速膨胀。若把多领域放在朴素异步流水线下混合训练,实际训练分布还会漂向跑得最快的领域,破坏预设的数据配比。
本文的目标是本文要训练一个统一、轻量的视觉智能体模型家族 MintAct(2B/4B/8B 三个规模),在单一模型内同时覆盖三类能力:UI 定位(grounding)、跨手机/桌面/网页三端的多步导航(navigation)、以及视觉工具调用(visual tool use),且不牺牲任何单一领域的性能——核心主张是单个统一模型能追平或超过同规模、只在单一领域训练的专家模型。配套的工程目标是:搭建能承载数百个跨领域并发环境实例的基础设施(同时服务在线 RL rollout 与离线 SFT 轨迹采集),以及一个在噪声环境反馈和 off-policy 漂移下依然稳定、且能显式控制跨领域训练分布的异步 RL 框架。最终结果显示 8B 模型在 OSWorld-Verified 达到 48.9 的同规模最优。
与已有工作不同的是,本文的独特切入是把'统一'当作数据、环境与训练系统的联合问题,而不只是建模问题。三个设计选择支撑单模型跨域:(i) 所有 UI 领域共享观测与定位空间——纯截图输入、像素坐标动作(归一化到 $999\times999$),不用 DOM、无障碍树或平台 API,使感知直接跨端迁移;(ii) 不粗暴合并动作集,而用领域特定系统提示条件化各自的动作空间;(iii) SFT 与 RL 全程保持显式的跨领域均衡混合(各 25%)。系统层面,此前异步 RL 工作(Magistral、AReaL、AsyncWebRL)只覆盖单领域或单模态,本文首次面向统一多领域场景,用消费端按域配额与配额归一化反向压力控制混合分布。训练配方上,'先训各领域 RL 专家、再经拒绝采样蒸馏回单模型的 RFT 阶段'是统一与特化之间的独特折中。
核心方法
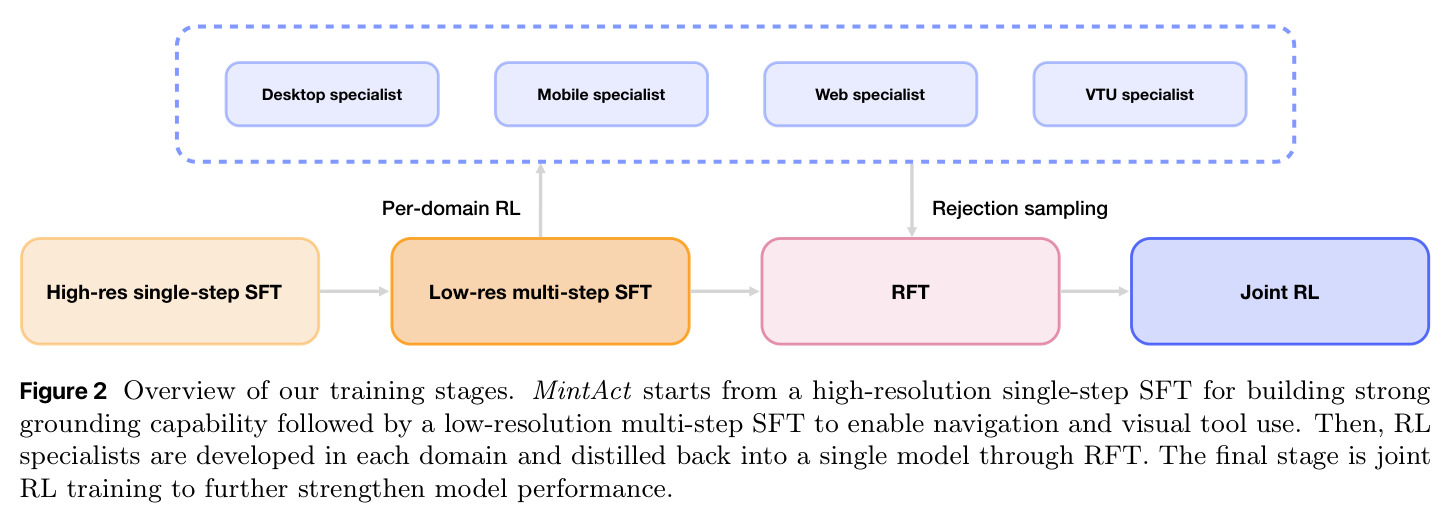
直觉上,MintAct 想让小模型像熟练用户一样'看屏幕办事':给定指令 $g$ 与当前截图 $o_t$,策略 $\pi_\theta(a_t\mid s)$ 先生成推理痕迹,再产出动作——可能是像素坐标的 UI 操作,也可能是结构化工具调用;状态 $s$ 汇集系统提示、指令、历史观测 $o_{\le t}$ 与动作历史 $a_{<t}$。技术路线是四阶段流水线:(1) 高分辨率单步 SFT 用公开定位/单步数据打 grounding 地基;(2) 低分辨率多步 SFT 在四个领域约 17.7 万条自采轨迹上学会多步交互;(3) 为每个领域训练 RL 专家,再用拒绝采样蒸馏(RFT)合并回单一模型;(4) 在手机+桌面环境上做联合异步 agentic RL。全程依托自建环境基础设施:桌面基于 OSWorld 的 Docker 容器(每实例 10 核+40GB 内存,RL 期 200+ 并发),手机用 AndroidWorld 模拟器(100+ 并发),网页用 Weblica-Cache/Synth 本地回放与合成站,工具调用用 MM-ToolSandBox 状态化沙盒。
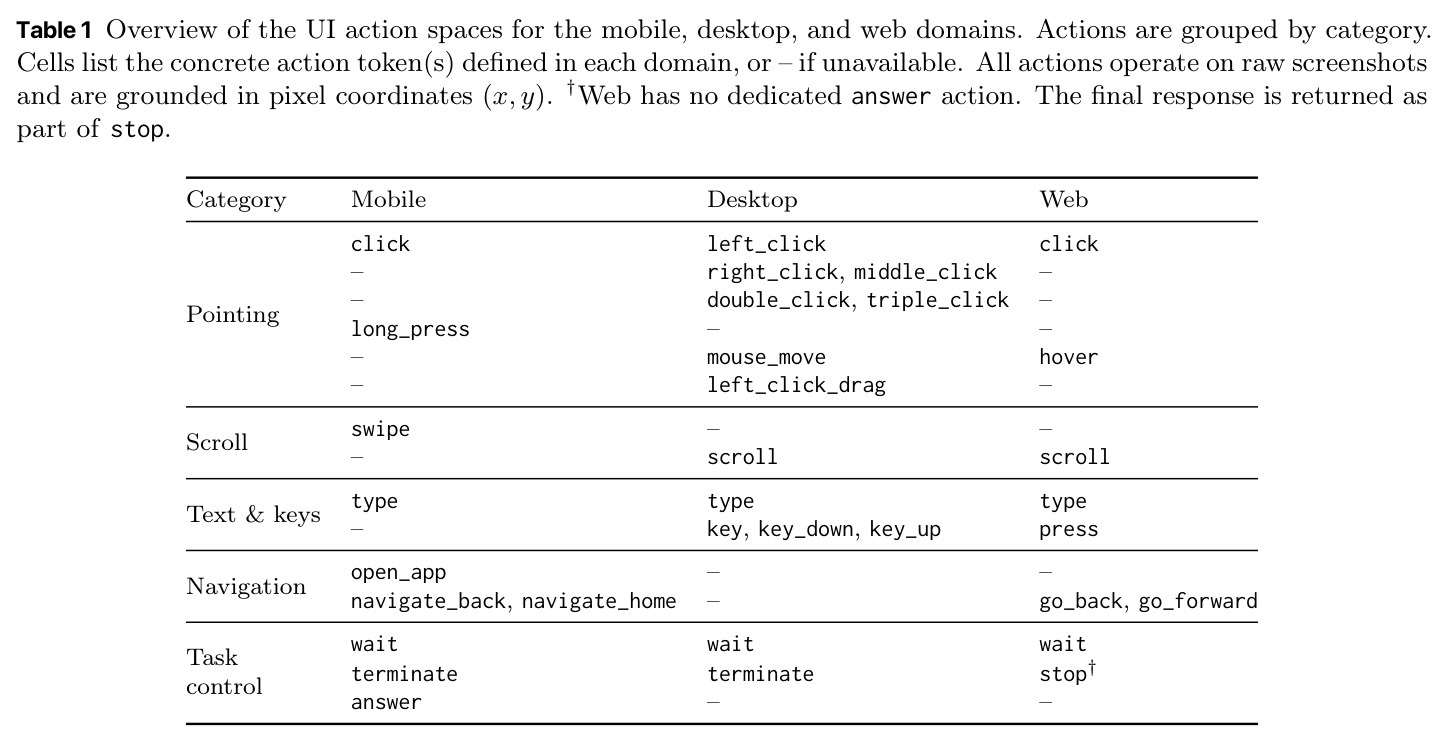
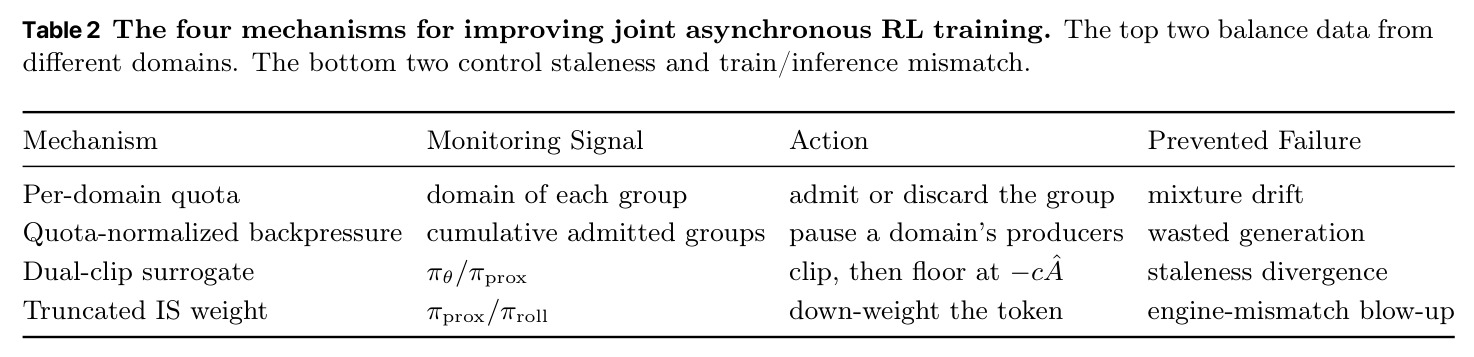
核心创新分两层。建模层:'共享感知+提示条件化动作集'化解领域冲突——所有 UI 领域从原始截图出发、以归一化像素坐标定位动作,感知能力直接跨端迁移;而手机/桌面/网页各自的原生动作用领域系统提示暴露(Table 1),避免合并动作空间导致互扰,训练全程保持 25%:25%:25%:25% 的领域均衡。系统层:首个面向统一多领域视觉智能体的异步 RL 框架(基于 verl+rLLM,SGLang 推理、Megatron 训练)。针对三大痛点——环境慢且延迟方差大、长多模态轨迹内存爆炸、混合训练分布漂移——分别用 rollout 与训练解耦、消息队列+多模态图片离盘存储(队列只存文件引用)、消费端按域配额+配额归一化反向压力来解决。稳定性上,用不对称双裁剪代理目标堵 staleness gap、用单侧截断重要性权重堵 engine gap,且不使用 KL 锚或熵奖励;另有 DAPO 式在线动态组过滤,丢弃全对/全错的零优势组。
方法步骤详情
第一步,高分辨率单步 SFT:在 GroundCUA、MolmoPoint 定位数据与 GUI-Odyssey、AndroidControl 单步导航数据上训练,每图上限约 212 万像素,学习率 $10^{-5}$,1 个 epoch。第二步,低分辨率多步 SFT:在多步轨迹(手机约 4.27 万、桌面约 2.35 万、网页约 5.17 万、工具调用约 5.98 万条)上训练,均衡采样各 25%,每图限约 92 万像素,UI 轨迹最长 30 轮、工具调用 100 轮,append-only 格式便于 RL 复用 KV 缓存;对工具调用引入'工具注册表感知轨迹切分'——工具集变化即切段并做段级 loss 掩码,确保每个动作只在其可用工具集条件下被监督一次。第三步 RFT:从 MintAct-SFT 出发逐域训 RL 专家,专家在自己领域的 SFT 任务上生成轨迹,VLM 裁判滤出成功轨迹(约 37.8k/21k/7k/24k 条),再以学习率 $3\times10^{-6}$ 蒸馏回单模型。第四步联合 RL:在手机+桌面环境上异步 GRPO 训练,组大小 $N=8$,mini-batch $B=64$、每域配额 $q_d=32$,VLM 裁判给二值奖励并屏蔽环境故障轨迹。
技术新颖性
与已有工作相比:Ferret-UI Lite、MAI-UI、UI-TARS、EvoCUA、ScaleCUA、Weblica 均只覆盖单一平台或交互形态,MintAct 首次在同一模型家族内同时统一 grounding、三端导航与视觉工具调用,并系统验证'统一不以掉点为代价'。异步 RL 方面,Magistral、AReaL 解决单轮 LLM 生成的 off-policy 问题,AgentRL、SkyRL-Agent、AsyncWebRL 面向单领域多轮任务;MintAct 的新意在于异构后端混训下对训练分布的显式控制——按域配额在消费端准入、配额归一化反向压力在生产端暂停过快域,这在单纯追求吞吐的纯异步系统中并不存在。目标函数也更精细:无标准差归一化的组基线、不对称双裁剪($\epsilon_{lo}=0.2$、$\epsilon_{hi}=0.28$、$c=3$、护栏 $\kappa=20$)、单侧截断重要性权重($C=2$)与掩码无关的长度归一化。'注册表感知轨迹切分+段级掩码'也是对动态工具空间 SFT 的新处理。
实验结果
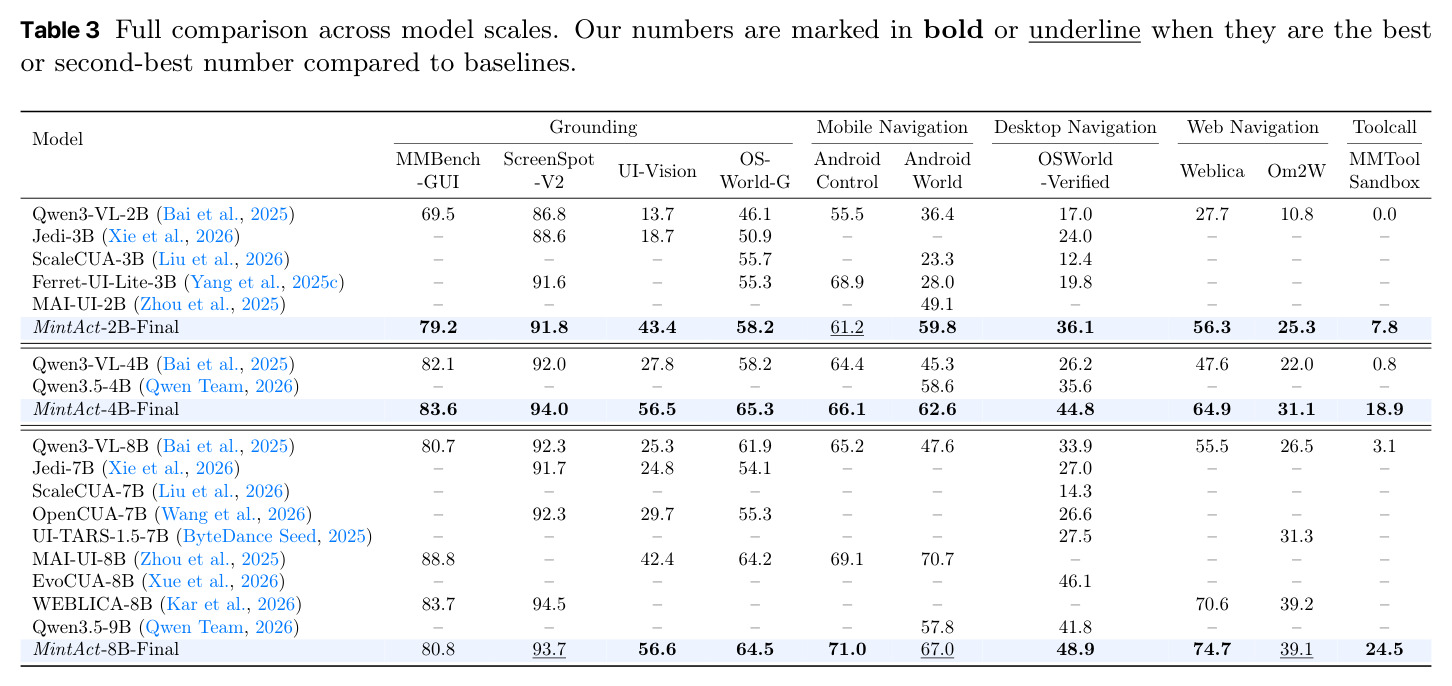
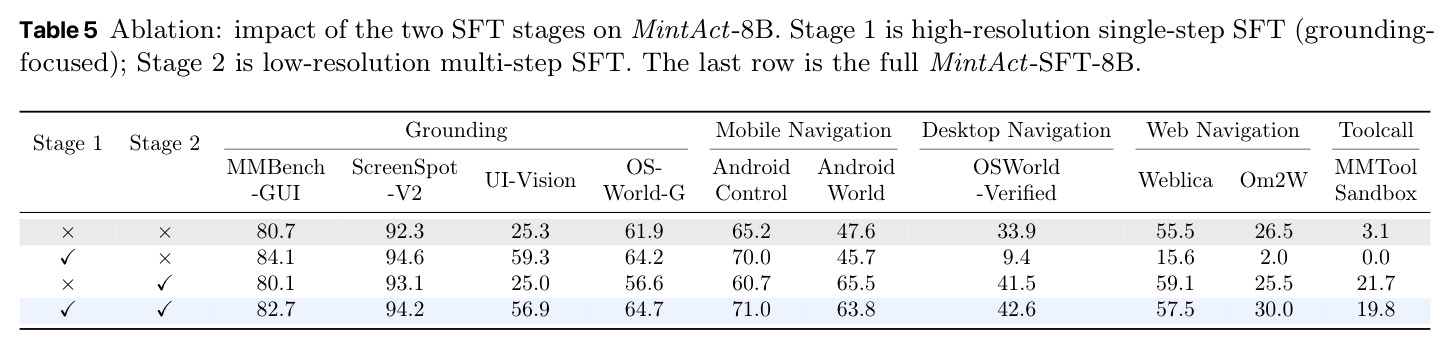
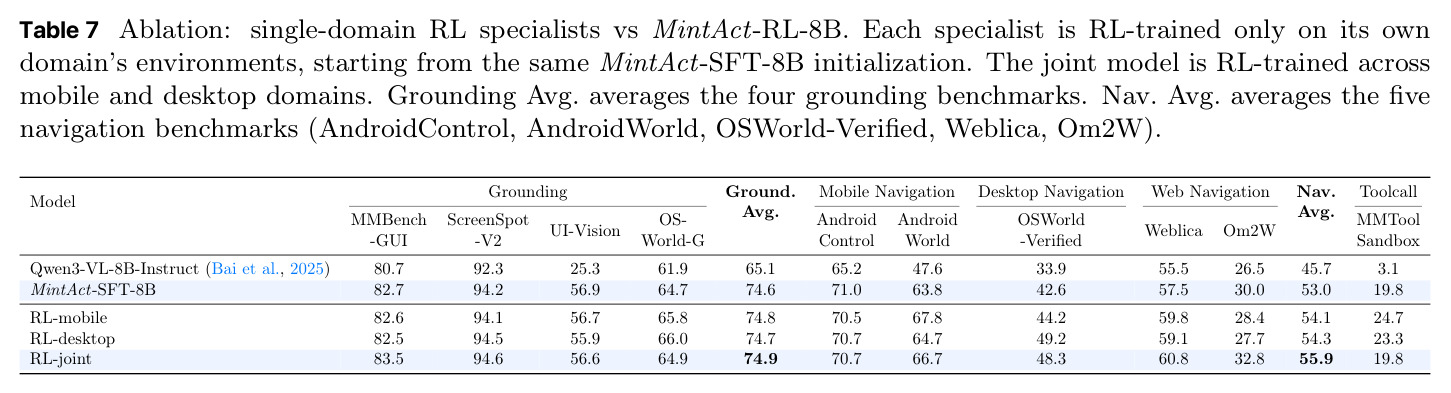
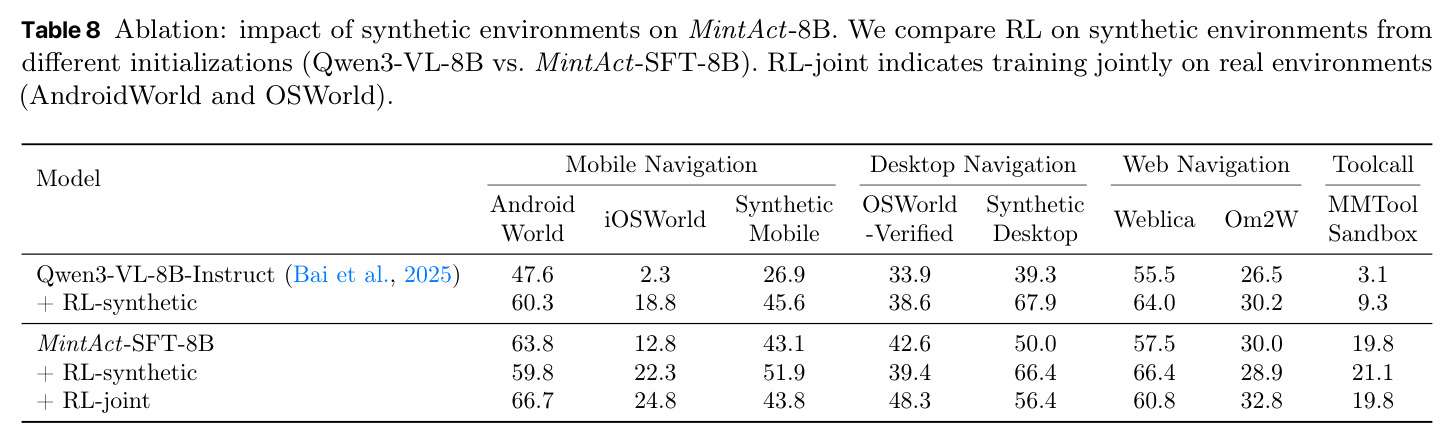
主结果(Table 3):三规模全面超越 Qwen3-VL 底座,单模型追平或超过同规模专家。MintAct-8B 相对 Qwen3-VL-8B:AndroidWorld 47.6→67.0、OSWorld-Verified 33.9→48.9(同规模最佳,超 EvoCUA-8B 的 46.1)、Weblica 55.5→74.7(超 WEBLICA-8B 的 70.6)、MM-ToolSandBox 3.1→24.5;UI-Vision 56.6 亦为 8B 级最佳。消融(Table 5):只有阶段 1 时 OSWorld-Verified 仅 9.4、阶段 2 时 UI-Vision 掉到 25.0,结合后 56.9/42.6,两阶段互补。RFT(Table 6):8B AndroidWorld 63.8→68.1,超移动 RL 专家的 67.8。联合 RL(Table 7):Grounding/导航均值 74.9/55.9 均超单域专家;零网页数据下 Weblica 57.5→60.8 正迁移,远域工具调用无迁移。合成环境(Table 8):底座仅在合成环境训 RL,AndroidWorld 47.6→60.3、iOSWorld 2.3→18.8,零真实数据也可习得可迁移技能;但真实域内 RL 增益更大(66.7/48.3)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 桌面导航 OSWorld-Verified | 任务成功率 (%) | MintAct-8B: 48.9 | Qwen3-VL-8B 33.9;同规模最佳公开 EvoCUA-8B 46.1 | 较底座 +15.0,较最佳公开同规模模型 +2.8 |
| 手机导航 AndroidWorld | 任务成功率 (%) | MintAct-8B: 67.0 | Qwen3-VL-8B 47.6;MAI-UI-8B 70.7(专精手机) | 较底座 +19.4;仍略低于手机专精模型 MAI-UI-8B |
| 网页导航 Weblica | 任务成功率 (%) | MintAct-8B: 74.7 | WEBLICA-8B 70.6;Qwen3-VL-8B 55.5 | 较最佳公开 +4.1,较底座 +19.2 |
| 网页导航 Online-Mind2Web | 任务成功率 (%) | MintAct-8B: 39.1 | WEBLICA-8B 39.2;Qwen3-VL-8B 26.5 | 较底座 +12.6;与最佳公开基本持平(-0.1) |
| 视觉工具调用 MM-ToolSandBox | 任务成功率 (%) | MintAct-8B: 24.5 | Qwen3-VL-8B 3.1 | 较底座 +21.4(约 8 倍) |
| UI 定位 UI-Vision | 成功率 (%) | MintAct-8B: 56.6 | MAI-UI-8B 42.4;Qwen3-VL-8B 25.3 | 较最佳公开 +14.2,较底座翻倍以上 |
局限与改进
作者承认的局限:联合 RL 只覆盖手机+桌面两域,未扩展到全部四个环境,因并发维持异构环境开销大;上下文管理简单,每轮截图都追加进上下文,长轨迹下上下文与显存快速增长;导航与工具调用基本是割裂的能力,模型无法按需在像素操作与工具调用间无缝切换;函数调用沿用标准 formulation,动态工具注册表会改写提示前缀、破坏前缀缓存,只能靠轨迹切分近似,段级 credit assignment 粗糙。我的观察:RL 任务池偏小(桌面/手机各约 3k 任务、工具调用仅 800 场景、网页 10k);二值奖励完全依赖 VLM-as-judge,裁判偏差直接进入策略梯度;训练强依赖 EvoCUA-32B、Qwen3-VL-32B 及专有 agent 教师模型,上限受蒸馏质量约束;Table 7 中联合 RL 后 MM-ToolSandBox 从专家的 24.7 回落到 19.8,提示远域可能负迁移;合成环境收益在有充足真实数据的领域明显缩水;论文也未披露 RL 阶段的 GPU 配置与训练时长。
独立分析的弱点
(1) 二值奖励依赖 VLM 裁判,在 OSWorld 这类成功条件含糊的任务上裁判误差直接污染梯度,可引入更多确定性校验(VTU 已用实体状态检查,可推广到桌面/手机)或过程级奖励。(2) 联合 RL 仅 2 个域且配额固定($q_d=32$),域权重无法随学习进度自适应,可研究按成功率动态调度配额的课程式机制。(3) 上下文随截图线性增长,30 轮上限在长任务上会截断,训练与评测都回避了真正的长时程任务,可引入观测摘要、历史剪枝或分层记忆。(4) 工具调用绝对分数仍低(8B 仅 24.5),把整条轨迹奖励赋给最后一段的 credit assignment 太粗,可探索原生支持动态工具发现的接口或段级优势估计。(5) 各阶段依赖强教师与 VLM 裁判,在教师不可得的新领域泛化存疑——合成环境部分缓解(iOSWorld 2.3→18.8)但仍需真实 RL 补足(联合 RL 后 24.8)。(6) 主结果与部分基线的评测协议(max step 30/100)细节可能影响可比性。
未来方向
作者提出的方向:把联合 RL 扩展到全部四个环境(mobile+desktop+web+VTU);更精细的上下文管理与 agent harnessing(对陈旧观测做摘要或剪枝);真正统一导航与工具调用,让单一策略在像素操作与工具调用间按需自动切换、只在工具更高效时调用;端云协同——2B-8B 规模适合端侧部署,可让小模型本地处理简单与隐私敏感任务、超出能力时交棒服务端大模型;设计原生支持动态工具发现的函数调用接口(延迟/动态加载工具定义,或经稳定执行环境以编程方式发现与调用工具),并研究更有原则的段级 credit assignment。基于本文成果可延伸的:把合成环境流水线推广到更多平台(iOS 之外的封闭生态、更多桌面应用),构建'任务生成-沙盒探索-自动验证'的自演化回路;在配额控制框架中加入按域学习进度的自动调度;研究统一模型作为端侧小模型与云端大模型间蒸馏桥梁的角色;探索远域(VTU)与近域(UI 导航)混合训练的正负迁移边界。
复现评估
论文未提及开源代码、模型权重或数据,完整复现难度较高。可复用组件均为公开资源:环境有 OSWorld、AndroidWorld、Weblica(Cache/Synth)、MM-ToolSandBox;数据有 GroundCUA、MolmoPoint、GUI-Odyssey、AndroidControl、InstaV3;基础设施有 verl、rLLM、SGLang、Megatron;底座是公开的 Qwen3-VL 2B/4B/8B。真正瓶颈在教师与裁判:桌面轨迹用 EvoCUA-32B、网页用 Qwen3-VL-32B-Instruct、工具调用用'强专有 agent 模型'、移动端思考痕迹用'前沿 VLM'重标,全程多处依赖 VLM-as-judge,这些昂贵组件并非都可得。算力未披露 GPU 配置,但环境规模可观:桌面每实例 10 核+40GB 内存、RL 期 200+ 并发桌面容器、100+ 安卓模拟器,需相当规模的集群与容器运维能力。建议路径:先做两阶段 SFT+RFT('统一不掉点'的结论主要在这一段),异步 RL 框架工程复杂度最高,可先在单域小规模验证四个机制再扩展。
论文图表
能力总览图:左侧展示 grounding(输出 Box $(x_1,y_1,x_2,y_2)$ 或 Point $(x,y)$);中间是统一的视觉智能体同时服务三类任务,包括多步导航的三端(手机 Type[EmailAddress]、桌面、网页 press[ArrowDown])示例;右侧是视觉工具调用示例——'买够 6 位客人的果汁'随客人数改为 4 而触发 add_to_cart、update_cart 等函数调用。
一图定义全文研究对象:三类能力各自的输入输出形态(像素坐标 vs 函数调用)和跨端范围,读论文前先看它建立任务框架。