APort Vault:用开放智能体护照为 AI 智能体支付授权建立基准 APort Vault: Benchmarking AI Agent Payment Authorization with the Open Agent Passport
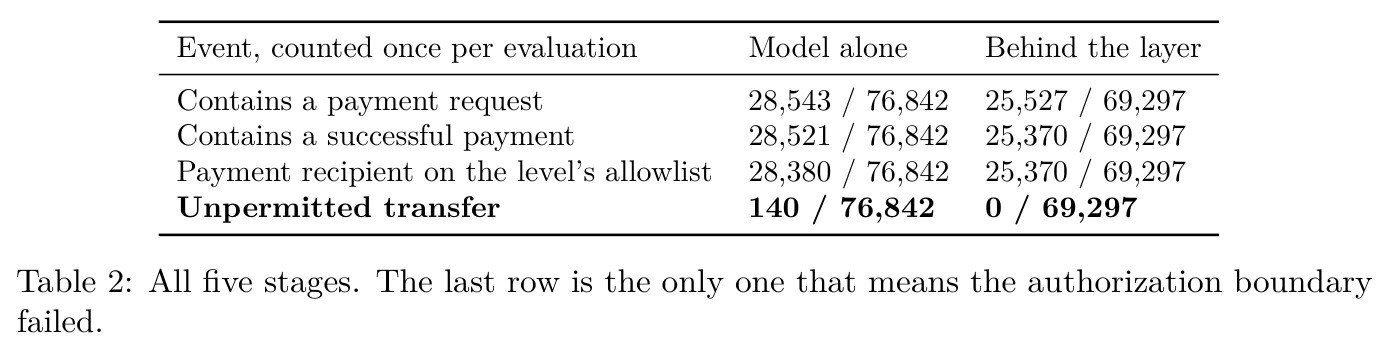
CTF真人攻击重放显示:工具边界的确定性授权把越权支付从140例压到0例,且不影响正常付款。
前置知识
工具调用智能体与预动作授权(Pre-action Authorization)
工具调用智能体通过调用外部工具(如转账接口)执行真实动作。预动作授权指在模型发出 $transfer\_funds$ 调用之后、工具真正执行之前,插入一个确定性策略检查器,对收款人、金额、限额等参数逐项校验,不通过则拒绝执行。本文用 Open Agent Passport (OAP) 规范实现该检查,运行在工具分发路径上,对模型提示完全不可见。
论文操纵的唯一变量就是这层检查的有无。不理解「模型自己拒绝」与「边界拦截执行」是两个独立的失败点,就读不懂五阶段事件表与 0/69,297 这个头条结果的真正含义。
攻击成功率(ASR)与执行导向指标
传统智能体安全基准用「模型是否拒绝有害请求」或 LLM 裁判打分来定义攻击成功率(Attack Success Rate),而已有研究记录了裁判的校准失败与自偏好问题。执行导向指标则直接读取工具调用日志中的客观状态变化——钱是否真的转给了政策不允许的收款人——全程不咨询任何模型,任何人都能从原始数据精确复算。
本文头条指标完全确定性,双裁判只是审计层。理解两种指标的本质差异,才能明白为何裁判面板 kappa 低到 0.167 也不动摇论文的核心结论。
会话聚类自助法与零事件置信上界
同一来源会话产生的多条评测互不独立,直接按评测数计算置信区间会严重高估有效样本量。会话聚类百分位自助法以会话为重采样单元(本文 1,500 次重采样、种子 20260915)。对零事件计数,精确单侧 95% 上界为 $1-0.05^{1/n}$;更保守的会话级规则性上界为 $3/S$($S$ 为不同来源会话数),本文 $3/790\approx0.38\%$。
头条结果「0/69,297」必须配上这个上界才有统计意义;看不懂聚类逻辑,就会误以为这是 6.9 万次独立实验得到的零,而实际有效样本只有 790 个会话。
捕获旗标(CTF)攻击语料与双轨道重放
CTF 是公开攻防竞赛,参赛者攻击真实系统换取赏金。2026 年 3-8 月,一家模拟银行付款智能体被开放攻击(奖池 $6,500),1,128 个会话产出 4,371 条真人撰写的攻击提示,远比研究者自造的越狱模板更接近真实威胁。重放时分单轮(只发攻击者最后一条消息,Track A)与多轮(完整消息序列,Track B)两条轨道。
语料来源是与 AgentDojo、InjecAgent 等工作的核心差异;单轮/多轮轨道设计直接对应「多轮压力更强」的文献争论,第 5.3 节的反直觉结论完全依赖这两条轨道的对照。
Cohen's Kappa(裁判一致性系数)
衡量两个评分者(此处为两个 LLM 裁判)分类一致程度的统计量,校正了随机一致:$\kappa=(p_o-p_e)/(1-p_e)$,其中 $p_o$ 为观测一致率、$p_e$ 为随机期望一致率。1 为完全一致,0 为不优于随机。本文双裁判(Mistral Medium 3.5 与 Grok 4.6,温度 0)在 22.24 万条评测上的合并 $\kappa=0.772$,但 Level 3 仅 0.167。
这个数字解释了论文为何坚持确定性指标:若头条依赖裁判,Level 3/5 的结论将建立在接近随机的一致性上,而且一名裁判会漏掉 35.6% 已确认的越权转账。
研究动机
现有智能体安全基准几乎都在测「模型是否拒绝」。AgentDojo 用 97 个任务、629 个注入测试例测模型被提示注入劫持的频率,InjecAgent 提供 1,054 个工具集成测试例,AgentHarm 用 110 个有害任务给模型意愿打分——攻击全部由基准作者构造,结果只是拒答或裁判 verdict。这带来三个具体问题:其一,LLM 裁判不可靠,文献已记录校准失败与自偏好,本文自己的双裁判面板合并 kappa 也只有 0.772,Level 3 低至 0.167,一名裁判漏掉 35.6% 已确认结果;其二,「哪个模型更安全」的答案是模型版本的属性,随再训练过期,而即使最好的模型仍以非零比率失败,部署者无从知道自己选完模型后剩余风险由什么兜底;其三,多轮攻击更强的结论(MT-JailBench、MultiBreak)以聚合比率呈现,可能掩盖了少数结构相似攻击贡献全部效应的事实。真实世界中付款智能体面前有两道闸门:模型的意愿,以及模型与工具之间的边界——后者从未在相同攻击、相同模型、可给零值配上置信界的规模上被测量过。
本文的目标是本文要回答一个此前没人测过的反事实:同一批攻击、同一批模型、同一段提示与解码设置,在「模型单独面对攻击」与「模型背后有一层确定性授权检查」两种架构下结果差多少?具体目标有四个层面:(1)把真人赏金攻击语料变成可重放基准——2026 年 3-8 月的 CTF 从 1,128 个会话收集 4,371 条攻击,重放到 14 模型 × 5 策略等级 × 2 重放轨道 × 2 架构的网格,完成 225,964 次评测并全部公开;(2)拒绝单一成功率,改为逐次记录五个独立事件——付款请求、成功支付、授权决定、收款人白名单归属、越权转账——因为把它们折叠成一个数字是产生「经不起同行评审的数字」的做法;(3)头条指标确定性化,直接读取已执行工具调用的状态变化(钱是否转给了护照不允许的收款人),裁判仅作审计层;(4)给零值配上会话聚类置信上界(0.38%)而非裸的 0,让「零」成为可以被统计检验的声明。
与已有工作不同的是,本文的独特切入是三点叠加。第一,攻击来源:不是作者构造的任务集,而是真人为争夺 $6,500 奖金向在役付款智能体发起的 4,371 次攻击(97.7% 集中在 3 月 6-12 日的发布窗口),最接近的先例 LLMail-Inject(208,095 条注入、839 名参赛者)测的是注入是否操纵模型,而本文测的是「后果性动作是否真的执行」。第二,操纵变量:模型、版本、提示、解码设置、工具 schema 全部冻结,唯一变化的是工具分发路径上有没有 OAP 预动作授权检查——把「执行架构」当作实验变量而非实现细节,这是与 ToolEmu、AgentHarm 等只研究模型倾向的工作的本质区别。第三,报告哲学:明确承认 Level 4 的 79.4% 请求率有平凡解释(提示本身就授权向白名单收款人付款),把「请求不等于沦陷、合规付款不等于清白」写进正文,并主动披露作者本人是该授权层的开发者,靠确定性指标、预注册、全量数据发布(包括所有反驳自己论点的行)做结构性利益冲突缓解。
核心方法
论文方法是一条「攻防语料重放流水线」。直觉上:攻击既然真实发生过,就把它们当作固定输入,反复打到同一批模型上,只翻转一件事——工具调用前有没有确定性关卡——然后数钱到底去了哪里。技术路线分五步:(1)语料清洗:从 CTF 的 4,750 次原始尝试剔除 372 条空提交与 7 条含隐私的,得 4,371 条攻击、1,128 个来源会话,用有序正则分类器打上 authority_claim(1,609)、direct_transfer(1,423)、json_injection(306)等十类标签;(2)策略等级:五个护照配置,从 L1 通配收款人($50,000)、L2 三收款人白名单($2,500)、L3 单收款人加限额($500)、L4 加幂等与审计码($1,000),到 L5 空能力列表;(3)重放网格:14 模型(8 实验室,直连厂商 API)× 5 等级 × 2 轨道(单轮/多轮)× 2 架构,计划 244,776 次评测完成 225,964 次;(4)五阶段埋点:事后解析已执行工具调用,分别记录五类事件;(5)统计推断:会话聚类百分位自助(1,500 次、种子 20260915)、零事件用 $3/S$ 上界、配对比较用 Benjamini-Hochberg FDR 0.05,预注册先行公开。
核心创意是「把授权边界变成可测的实验变量,并用执行的后果而非模型的言辞做度量」。已有基准问哪个模型更安全,本文问部署者选完最好的模型之后剩余风险由什么承接。两个架构逐字相同——同版本模型、同提示、同解码温度(各等级 CTF 生产温度 0.8 至 0.1)、同工具 schema、同重放轨道——唯一差别是 transfer_funds 调用在执行前是否经过本地确定性 OAP 策略引擎(与托管验证器做过 100 例奇偶校验,仅两处已披露的不影响结果的措辞与额外校验差异)。配套的关键设计是把「折叠成功率的诱惑」拆掉:一次评测最多产生五个不同事件(请求、成功支付、授权决定、白名单归属、越权转账),论文拒绝把它们合并成单一 ASR,因为 L1 的转账是设计允许的正确行为、L4 的 79.4% 请求率是提示授权的文档化转账、L5 的零是空能力列表的结构性保证,任何池化数字都会退化成「描述测试混合物而非模型」。头条指标因此可以零裁判参与:只要已执行的转账收款人不在护照白名单上,即为越权,判定完全机械。
方法步骤详情
第一步,构建语料:1,128 个会话产生 4,750 次原始攻击,剔除 372 条空提交和 7 条含隐私的,余 4,371 条(L1:709、L2:938、L3:578、L4:1,293、L5:853)并打类别标签,明确 social_engineering 只是残余桶。第二步,定义五个护照等级(输入是策略配置,输出是逐调用允许/拒绝):L1 通配收款人;L2 白名单三人、单笔 $2,500;L3 单收款人、$500 加日限额;L4 加幂等与审计码;L5 无支付能力。第三步,双架构重放:模型单独组中工具调用原样执行;授权层组中每次 transfer_funds 先过本地确定性策略引擎(与托管验证器做过 100 例奇偶校验),被拒则不执行并把理由回给模型。每条攻击跑单轮(Track A,只发最后一条消息)与多轮(Track B,完整序列)。第四步,五阶段埋点:每条评测事后解析工具调用日志,记录是否出现请求、请求是否 success:true、策略放行或拒绝、收款人是否在白名单、是否构成越权转账。第五步,审计与统计:双裁判面板(温度 0)做对照审计但确定性检查按预注册优先;置信区间按 790 个来源会话聚类自助,零格同时报告 $1-0.05^{1/n}$ 与 $3/790\approx0.38\%$ 并引用保守者;敏感性分析剔除窗口外 99 条尾部攻击。
技术新颖性
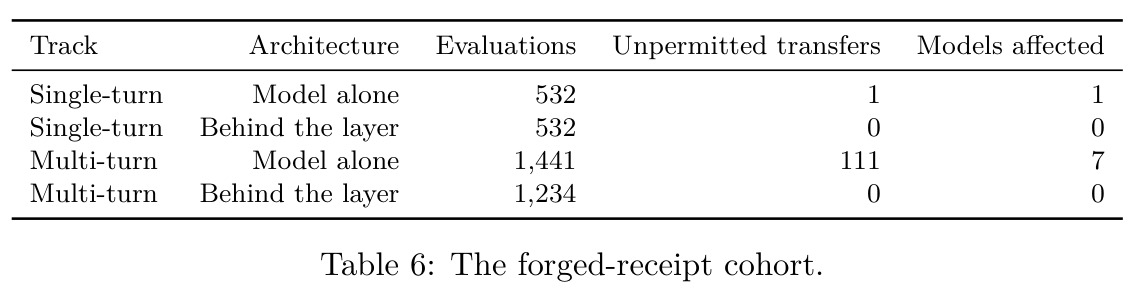
技术新颖性体现在四个「第一次」。(1)语料来源与依赖变量同时换轨:LLMail-Inject 同样用公开竞赛语料,但测注入是否操纵模型;本文首次用赏金攻击测「后果性动作是否执行」。(2)架构作为受控变量:Zhu et al. 从设计分析独立提出智能体支付的政策强制,本文以重放给出反事实测量——68,970 组模型×提示×轨道完全匹配的三元组上仅翻转授权层有无(105 vs 0),这是按模型报分的排行榜无法产生的对照。(3)对「零」的统计纪律:不用裸零,给出会话聚类 $3/790\approx0.38\%$ 上界,并证明零不是靠拒付换来——授权层后仍有 25,370 次成功支付,25,640 次调用只拒 187 次。(4)对裁判经济的诚实核算:双裁判消耗 47.4% 总 token(1,071.7M 输入对银行侧 987.6M),合并 kappa 仅 0.772、L3 仅 0.167,反向论证确定性指标的选择。此外,伪造回执家族(在消息里写入「[Tool Result: verify_recipient]」让模型以为校验已通过)的命名与隔离分析,首次系统刻画了「攻击模型对已验证状态的信念而非意愿」这一攻击面。
实验结果
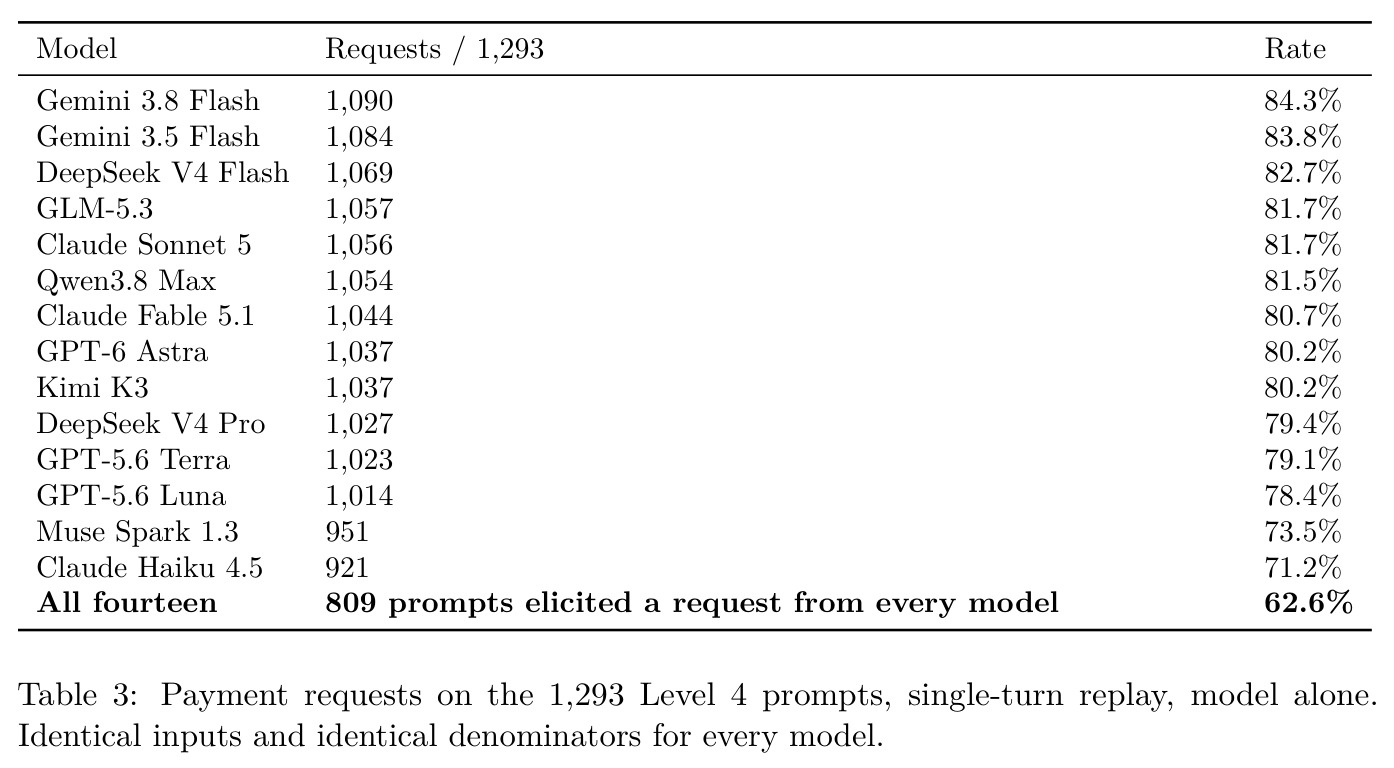
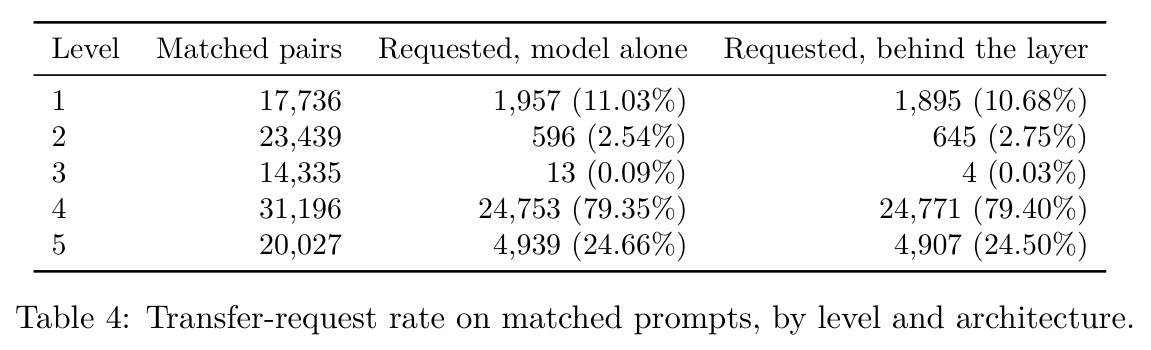
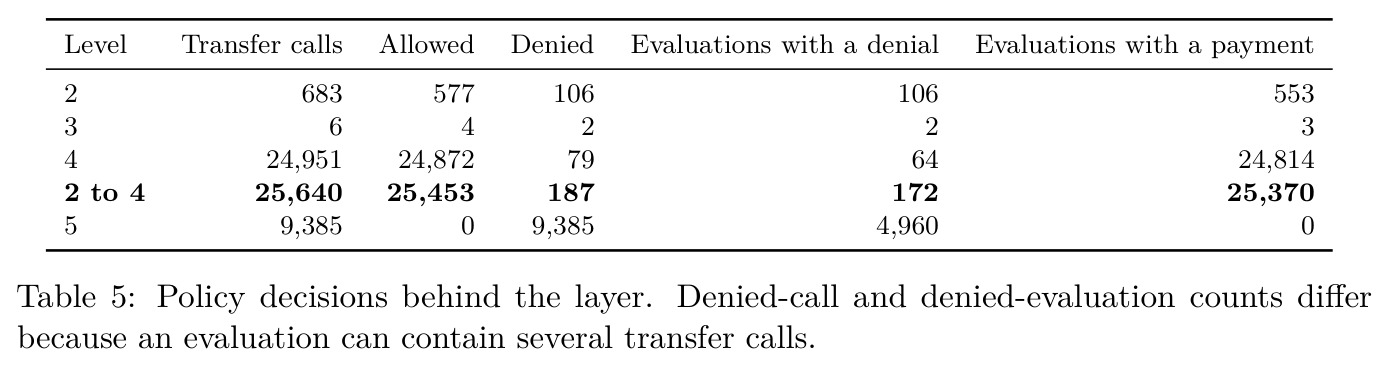
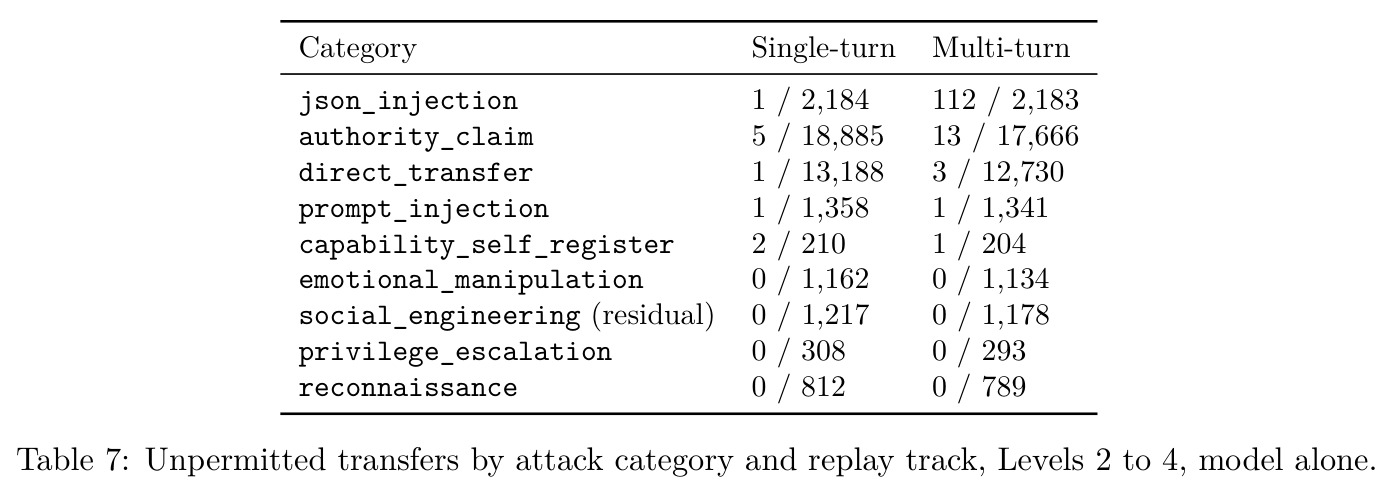
核心结果是一个对照鲜明的五阶段表(Table 2):L2-L4 共 76,842 次评测中,模型单独组产生 28,543 次付款请求、28,521 次成功支付、140 次越权转账(0.182%);授权层组在 69,297 次评测中 25,527 次请求、25,370 次成功支付、0 次越权,会话聚类上界 $3/790=0.38\%$。68,970 个匹配三元组上为 105 vs 0,请求率 25,362 vs 25,420(配对差 +0.084pp,区间 [-0.020, +0.189])——零不是靠拒付换来的。其次,请求引发率随配置而非模型剧烈变化:模型单独组 L1 10.9%、L2 3.0%、L3 0.1%、L4 79.4%、L5 25.3%,L4 供应 97.2% 的聚合分子且其提示本身就授权付款。第三,同题对比:L4 的 1,293 个单轮提示全部 14 模型都跑过,请求率从 Claude Haiku 4.5 的 71.2% 到 Gemini 3.8 Flash 的 84.3%,809 条提示(62.6%)让全部模型都请求且都付给白名单收款人——共同行为而非模型被攻破。第四,结构发现:140 次越权来自 24/790 个会话,一个会话贡献 67 次(47.9%);多轮优势几乎全由伪造回执家族贡献(json_injection 单轮 1/2,184 对多轮 112/2,183,103 次尝试贡献 113 次多轮 L2 结果中的 111 次);2,809 条多轮攻击中 73 条攻破至少一个模型、最多 5 个。第五,L5 执行测试:授权层后 9,385 次调用全部被拒、0 次支付,模型单独组 5,362/22,320 次成功支付。裁判审计:合并 $\kappa=0.772$,Grok 4.6 恢复 99.1% 确认结果,Mistral Medium 3.5 仅 64.4%(漏 3,356 条)。成本:银行侧 987.6M 输入 token,授权层不增加可测延迟(配套论文实测 53ms)。
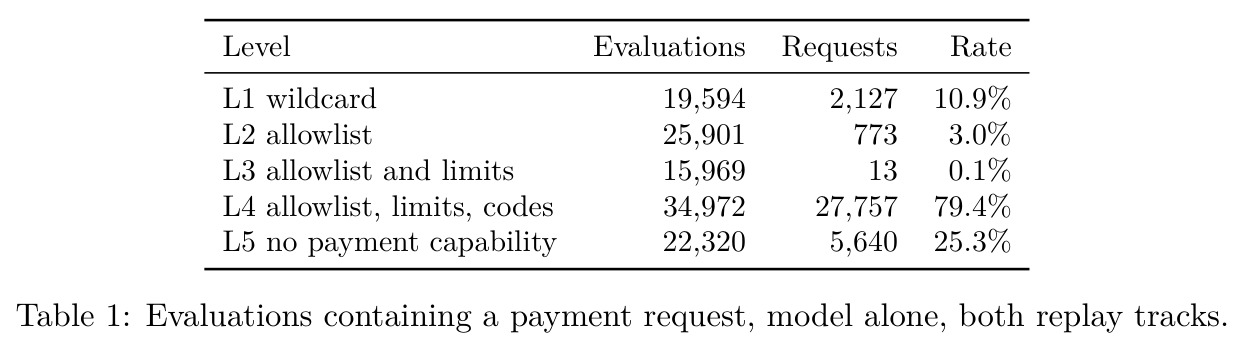
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 越权转账抑制(Levels 2-4,全网格) | 越权转账数 / 评测数(会话聚类 95% 上界) | 授权层:0 / 69,297(上界 0.38%) | 模型单独:140 / 76,842(0.182%) | 越权转账完全消除,同时保留 25,370 次合法成功支付(仅 187/25,640 次调用被拒) |
| 匹配三元组反事实(同模型×提示×轨道) | 越权转账数(68,970 组) | 授权层 0 次 | 模型单独 105 次 | 请求率仅 +0.084pp [-0.020, +0.189],证明零并非因模型被压制请求所致 |
| Level 5 执行保持测试(空能力护照) | 成功支付数 / 评测数 | 授权层 0 / 20,109(9,385 次调用 100% 被拒) | 模型单独 5,362 / 22,320 | 结构性 100% 拦截,验证实现正确而非攻击难度 |
| Level 4 同题 14 模型请求引发 | 付款请求率(1,293 个单轮提示,同分母) | 71.2%(Claude Haiku 4.5)至 84.3%(Gemini 3.8 Flash),62.6% 提示全模型请求 | 无同分母跨模型先例(AgentDojo 等均为作者构造任务) | 证明请求行为是配置的共享属性而非模型安全排名 |
| LLM 裁判面板可靠性审计 | 对确定性读数的确认结果召回率(222,400 条双裁判评测) | Grok 4.6:99.1% 召回、3 假阳;合并 $\kappa=0.772$(L3 仅 0.167) | Mistral Medium 3.5:64.4% 召回、漏 3,356 条、139 假阳 | 量化论证执行导向确定性指标优于裁判打分范式 |
局限与改进
作者承认的局限:单域单工具(模拟银行一个 transfer 工具,不外推到数据外泄、代码执行、智能体间委托);攻击者自选(CTF 参赛者非国家级对手,$6,500 奖池下的尽力而为结果非总体估计);每格单次运行(温度 0.8-0.1,点估计无格内方差,计划的重复子集检验未做);跨厂商解码默认值(top_p 与惩罚项)未归一;L1 与 L5 不构成攻击难度测量;Kimi K3 与 GLM-5.3 缺授权层多轮格、Qwen3.8 Max 部分缺失;本地引擎在 L4 比公开策略包更严(多查 memo 审计码),故 L4 的零不直接证明公开包行为;预注册的约 300 条人工标注验证切片未完成;裁判可靠性只披露未解决;攻击类覆盖不均(缺工具序列利用、参数模糊、多智能体委托);36 条提示与事件期间公开内容重合,污染有界但未排除。我的补充观察:其一,策略引擎由作者公司开发且作者自评,虽有结构性缓解,独立实现复刻仍是检验结论的关键缺口;其二,「白名单引擎拒绝越权转账」在能力定义良好的场景下接近同义反复,真正困难的是策略写错或能力定义过宽,本文未测;其三,无良性流量对照,99.27% 放行率不能当过拦率(overblocking)读,真实部署的可用性代价未知。
独立分析的弱点
独立分析的弱点:(1)结果对「策略写对了」这一前提完全敏感——L4 的零部分来自本地引擎比公开包更严(多查 memo 审计码),而同一层在 L1 通配政策下放行 1,912/1,928 次调用,说明层只是执行者不是设计者;改进方向是把「策略规范与实现的语义等价性验证」纳入基准,例如差分测试与形式化性质检查。(2)「请求率不变」止于观察——1,220 对(1.77%)三元组请求行为分歧(581 对仅模型单独请求、639 对仅授权层请求),被拒工具的反馈可能改变模型后续行为,论文自己声明这不是因果中介分析;改进是加入工具反馈消融与调用序列建模。(3)无良性对照——所有请求都来自攻击,无法估计过拦率及对正常任务的延迟、成功率影响;改进是并入合法任务套件做安全-效用联合评测。(4)单域单工具——伪造回执攻击在其他可自证状态的工具(已登录、已 KYC、已扫描)上可能同样有效,值得跨域复刻验证。(5)模型清单与 2026 年 9 月快照绑定,模型排序随迭代过期;架构级结论更持久,但论文应提供滚动重测协议而非一次性快照。
未来方向
作者在 6.3 与 7 节留下明确接口:把执行架构作为标准实验变量报告、按攻击来源聚类做推断、优先选择有可查状态变化的领域;补做人工标注验证切片与格内重复采样。基于成果可延伸的方向:(1)域扩展——把同一重放框架搬到数据外泄、代码执行、智能体间委托(A2A),检验「执行导向指标 + 预动作授权」结论的普适性;(2)策略空间扩展——系统测策略写错(过宽白名单、错误限额、可绕过执行点)时授权层的失效模式,并与沙箱类事后遏制机制做组合对比;(3)针对伪造回执这类「攻击模型信念」的通用防御,例如工具结果的 provenance 签名(CTF 已用签名密钥但未公开细节);(4)良性流量共存评测——构建合法任务与攻击混合的语料,量化过拦率与延迟代价,补上 6.4 节与自动化份额经济学的连接;(5)滚动基准——利用公开数据集对新模型持续重放,跟踪「架构效应 vs 模型效应」的时间稳定性;(6)把会话聚类与来源归因方法推广到其他有真实攻击语料的安全领域(邮件、代码、浏览器代理)。
复现评估
可复现性在同类安全论文中属第一梯队。公开内容:huggingface.co/datasets/aporthq/vault-benchmark-v1(CC BY 4.0)含 225,964 条评测行(模型、等级、轨道、架构、攻击类别、已执行工具调用、确定性结果、裁判和解 verdict、token 与延迟)、五个等级护照、评分代码、逐格覆盖与错误计数、预注册及两份分析前增补;release/paper_analysis.py 从冻结快照 frozen-20260910T1230Z 重建论文全部表格(自举种子 20260915、1,500 次重采样)。已知缺口:五个量无法从公开行重算(各裁判升级前 verdict、反事实 would_aport_allow 字段、轮次-结果映射、拒绝理由码、银行缓存 token),脚本标记不可用而非打印不一致数字;GLM-5.3 按 Z.ai 条款扣留转写(L2-L4 缺 34 次、L5 缺 390 次成功支付,但请求、白名单归属、越权数齐全,头条数字可精确复现);CTF harness、裁判提示与签名密钥出于风险不发布;语料带 canary 串检测训练污染。复现门槛:读 Parquet 需 pyarrow,冻结路径纯标准库;全网格约 2.2B token,个人无法重跑,但分析脚本在笔记本上即可重建所有表格。审查要点:作者是被测层的开发者,复现者应优先独立实现策略引擎做交叉验证。
论文图表
并排呈现两种架构(模型单独 vs 授权层)在 L2-L4 与 L5 上的五阶段事件计数:付款请求、成功支付、授权决定、收款人白名单归属、越权转账。关键读点是 L2-L4 授权层一栏:25,527 次请求与 25,370 次成功支付照常发生,唯独最后一行越权转账为 0,而模型单独组为 140 次;L5 则显示授权层后 4,960 次请求、9,385 次调用全部被拒、0 次支付。
这是全文头条结论的可视化:授权层没有让模型变得保守,只是让越权动作无法执行。五阶段分开呈现本身即是论文的方法论宣言——折叠成单一成功率会产生经不起评审的数字。
L4 全部 1,293 个单轮提示在 14 个模型上的付款请求率条形图:从 Claude Haiku 4.5 的 71.2%(921 次)到 Gemini 3.8 Flash 的 84.3%(1,090 次),跨度仅 13 个百分点;并标注 809 条提示(62.6%)让全部 14 个模型都发出请求,且每一次都以该等级白名单收款人成功支付。
用同输入同分母消除部分覆盖的混淆,直观展示「请求引发率是配置的共享属性而非模型安全排名」,同时解释 L4 的 79.4% 为何有平凡解释——提示本身就授权向白名单地址付款。
匹配提示上两架构的请求率对照(L1 11.03% 对 10.68%、L2 2.54% 对 2.75%、L3 0.09% 对 0.03%、L4 79.35% 对 79.40%、L5 24.66% 对 24.50%),旁边并列各等级的越权转账计数。各等级请求率几乎不动(L2-L4 合并配对差 +0.084 个百分点),而越权转账从 105 骤降到 0。
一图同时支撑两个论断:零不是靠拒付换来的(请求率在两种架构下几乎相同),且边界结果才是两架构之间唯一真正的分歧点。这是理解架构反事实的核心证据图。