面向在线策略蒸馏的教师-学生差异校准 Calibrating Teacher--Student Discrepancy for On-Policy Distillation
用正负特权探测教师自偏差区间,只把超出区间的师生差异作为蒸馏信号
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
知识蒸馏的一种范式:由学生模型自己对每个问题采样生成轨迹,再让更强的教师模型在同一批轨迹上逐 token 评分,用教师与学生 token 级对数似然之差作为密集监督信号更新学生。相比在教师生成的固定数据上训练的离线(off-policy)蒸馏,OPD 避免了固定数据分布与学生演化分布的失配;相比只给稀疏结果奖励的 RLVR,OPD 在整条轨迹上都有逐 token 引导,已被 Qwen3 等推理模型的大规模后训练采用。
本文全部讨论都建立在 OPD 的目标函数之上,Cal-OPD 就是对其 token 级优势信号做校准,不理解 OPD 就无法理解改进对象与实验对照。
token 级似然差与策略梯度
设学生生成的轨迹为 $y=(y_1,\dots,y_T)$,教师与学生在同一前缀 $y_{0$ 提升该 token 概率,反之降低。
这正是被校准的对象。论文证明该信号里混有教师自身的噪声,Cal-OPD 的核心工作就是把 $A^{\mathrm{OPD}}_t$ 分解为有用残差与教师自偏差两部分。
特权信息与特权蒸馏
特权信息指只在训练时提供给教师、推理时学生拿不到的信息,如参考解答、标准答案、提示。特权蒸馏让教师在看到这些信息的条件下提供监督,本意是让教师更强。但已有研究表明特权上下文会引发信息不对称效应、走捷径行为,甚至降低思维模型性能——因为教师的似然分布被上下文改变了,并不等于学到了更多可迁移知识。
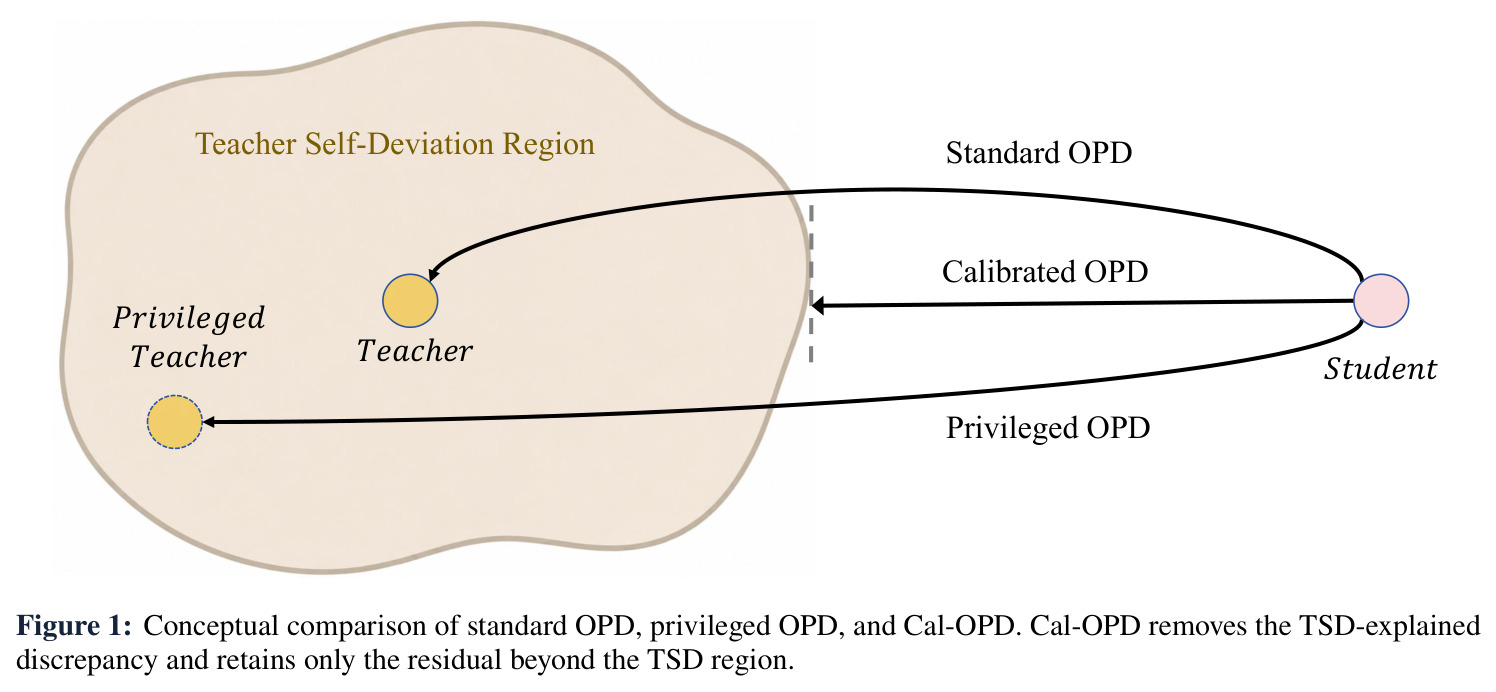
特权 OPD 会放大教师自偏差(TSD),是本文问题最严重的场景;而 Cal-OPD 反其道而行,把特权信息从监督信号变成测量教师稳定性的探针。
长思维链与响应长度膨胀
思维模型在数学等任务上会生成数千到上万个 token 的长推理链。OPD/RL 训练中一个常见病理是响应长度持续膨胀:模型学会用更啰嗦、更多自我检查的表达来降低损失,导致训练与推理成本上升,且未必提升正确率。监控平均响应长度与学生熵是判断训练是否健康的常用手段。
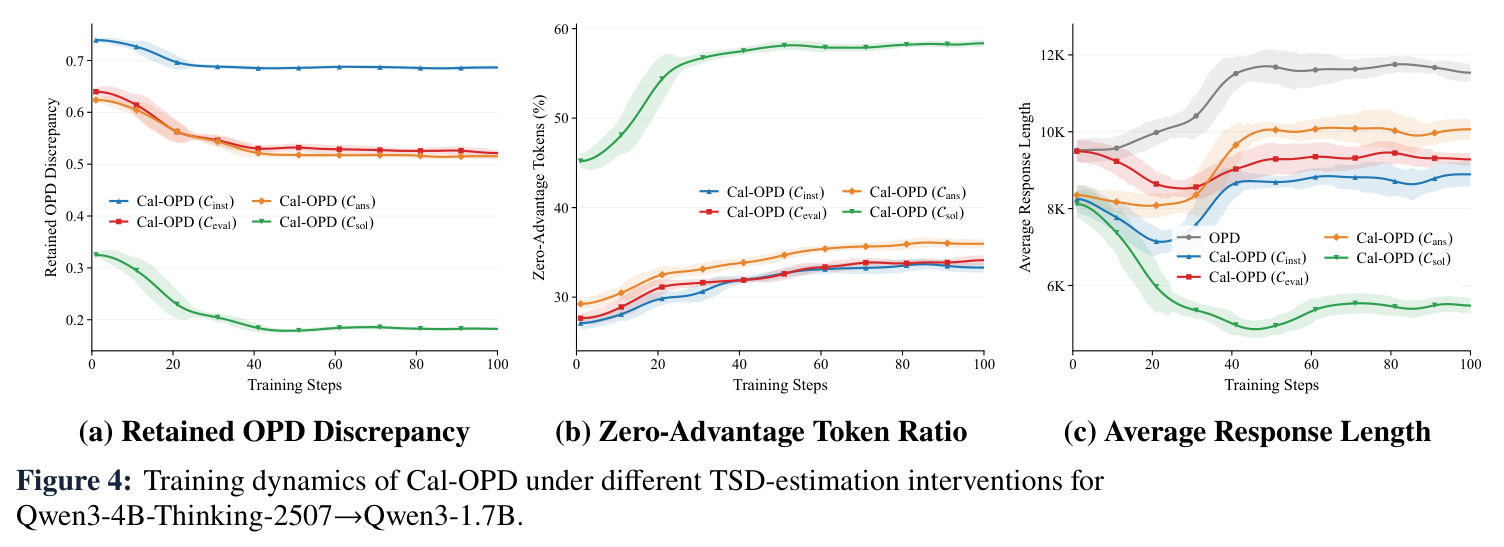
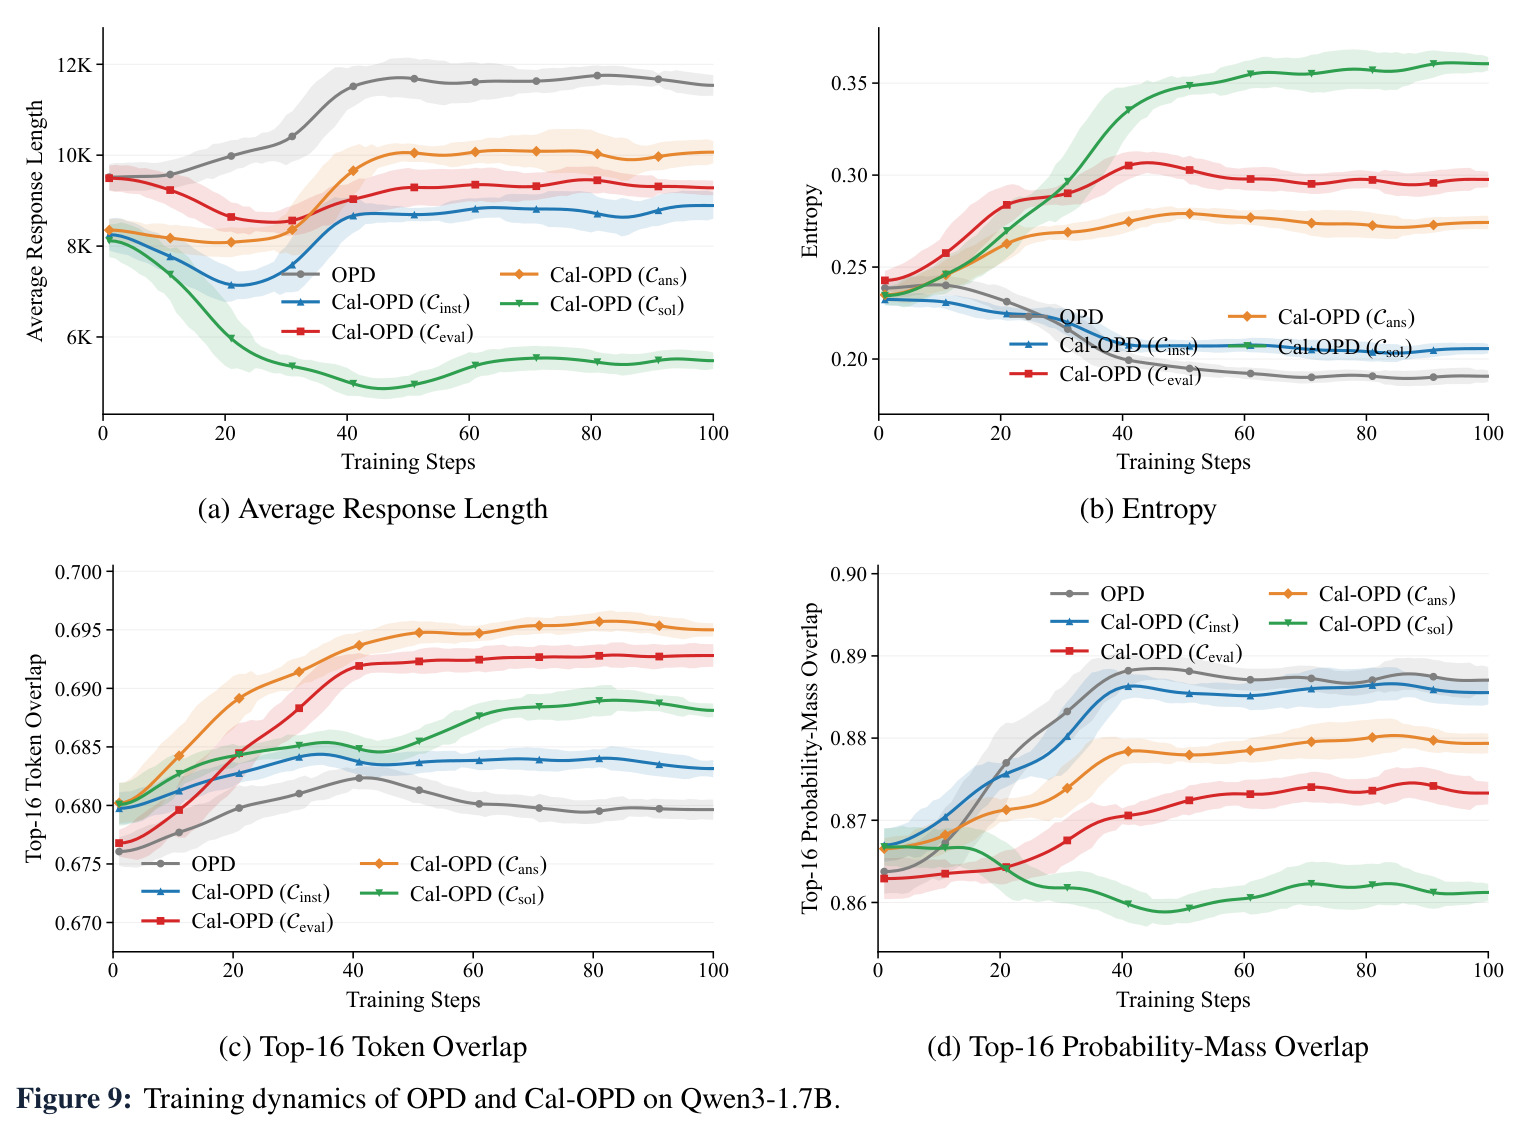
实验显示标准 OPD 把平均响应长度从约 9.8K 推高到 11.8K token,而 Cal-OPD 反而降到 9.3K 并带来约 1.26 倍训练提速,这是论文的重要卖点,需要此背景才能体会。
研究动机
在线策略蒸馏(OPD)默认教师对每个学生 token 给出的对数似然 $\ell^T_t$ 是逐点等可靠的参考,但事实并非如此。论文用 Qwen3-1.7B 作学生、Qwen3-8B 作教师,在 DAPO-17k 的 6,528 个问题上对约 6,000 万个响应 token 做受控重评分实验:保持学生轨迹逐字不变,只在教师侧插入不同上下文,测量教师似然的移动。结果发现,即使插入与任务完全无关的指令("请仔细推理"对"请快速作答"),在阈值 $\tau=0.01$ 下仍有 20.2% 和 25.8% 的 token 出现显著似然漂移,二者并集覆盖 29.8% 的 token,与提供真实答案(29.4%)或评价反馈(29.1%)的效果相当;若给教师完整参考解答,受影响 token 进一步扩大到 39.6%。更关键的是,这种漂移对语义极性不敏感:把答案级特权从"正确答案"换成"错误答案",两个方向相反的干预在联合显著 token 上的方向一致率仍达 88.7%、共享偏差占比 74.7%,说明漂移主要由上下文本身而非其中的"知识"驱动。这些漂移(作者称为 Teacher Self-Deviation, TSD)混在教师-学生差异中被标准 OPD 无差别学习;特权 OPD 给教师加参考解答会进一步放大 TSD,导致 30B→4B 配置中学生反而从 66.6 掉到 64.0,比不蒸馏还差 2.6 分。
本文的目标是论文的目标是把 OPD 的逐 token 优化信号拆成两部分:教师自偏差可解释的部分(TSD-explained)与真正反映能力差距的校准残差,然后只学习后者。形式化地,将原始差异分解为 $A^{\mathrm{OPD}}_t = A^{\mathrm{Cal}}_t + A^{\mathrm{TSD}}_t$,其中 $A^{\mathrm{Cal}}_t$ 仅保留落在教师自偏差区间之外的差异。具体量化目标有三:其一,通过实证刻画 TSD 的发生位置、语义敏感性和 token 形态分布,证明它不是可靠的知识信号;其二,设计一个只需两次额外教师前向就能估计自偏差区间的校准机制,使特权信息只用于测量而非直接监督;其三,在多个模型规模的六个数学推理基准上验证:即使只保留原差异的 52–65%,Cal-OPD 仍应稳定超过标准 OPD 及其五个变体,同时抑制标准 OPD 观察到的响应长度膨胀(从约 9.8K 膨胀到 11.8K token)。
与已有工作不同的是,已有工作也质疑过教师监督的可靠性,但切入点不同:EOPD 用教师熵衡量不确定性,Uni-OPD 用结果级顺序一致性校准教师边际,Position-Weighted OPSD 按推理位置加权,BRTS 按正确率与学生对齐度筛选教师轨迹,Ding & Zhang 揭示 OPD 监督中存在规模相关的噪声。这些方法要么用不确定性、结果、位置等代理量,要么做硬性 token 过滤,都没有把"教师似然在受控上下文干预下的变化"显式建模为一个有限干预近似下的自偏差区间,并用它来校准差异。本文的独特之处有二:第一,把 TSD 当作可测量的区间 $\hat{R}^T_t$ 而非逐 token 权重或阈值,用一正一负两个语义相反的特权干预从上下两侧夹逼教师的漂移范围;第二,彻底反转特权信息的角色——特权 OPD 把参考解答喂给教师让学生直接模仿,结果学到更多上下文噪声,Cal-OPD 却用同样的特权提示去探测教师哪里不稳定,再把被这种不稳定覆盖的差异归零,只蒸馏区间之外的残差。
核心方法
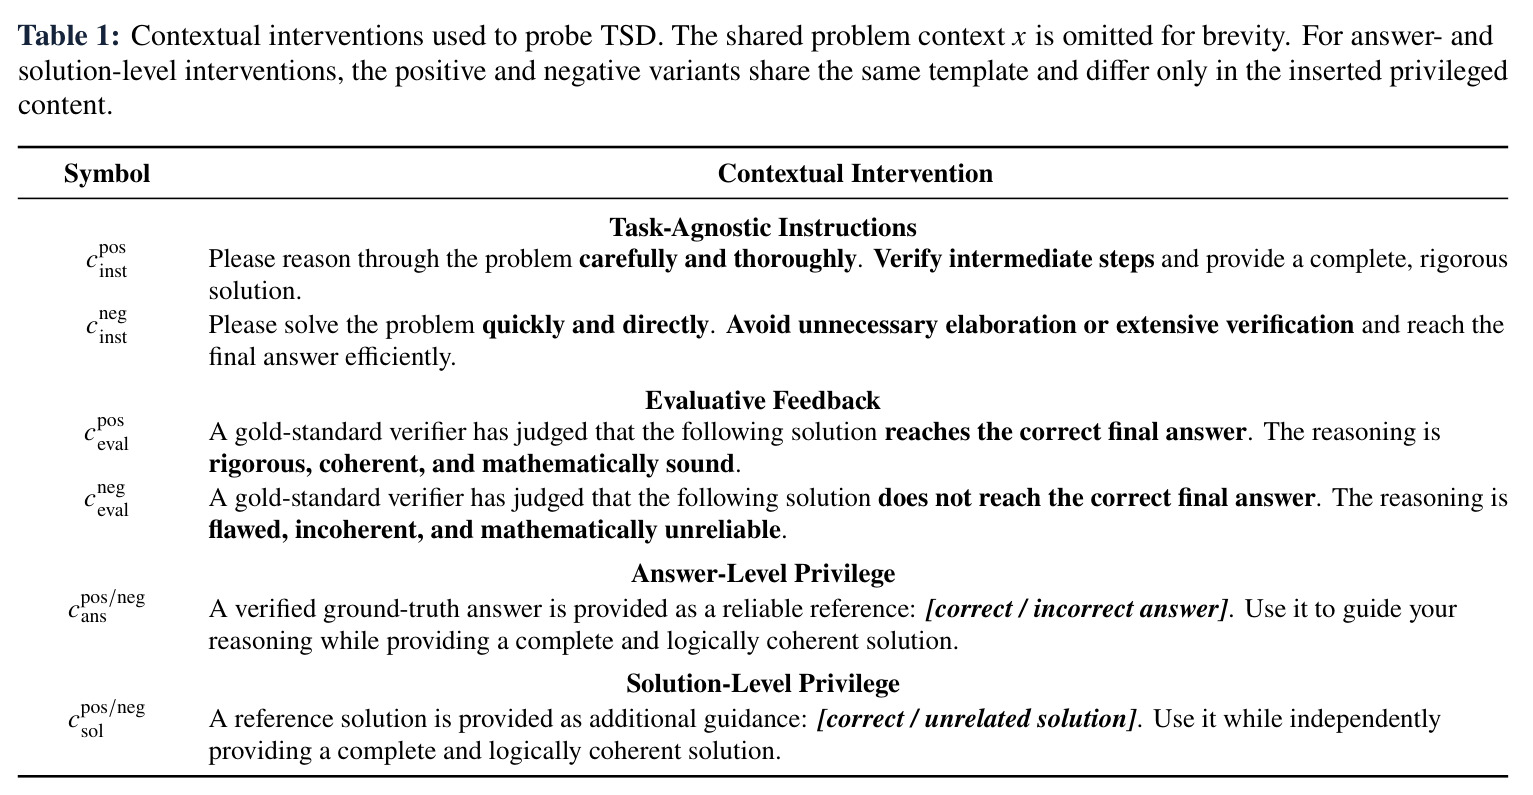
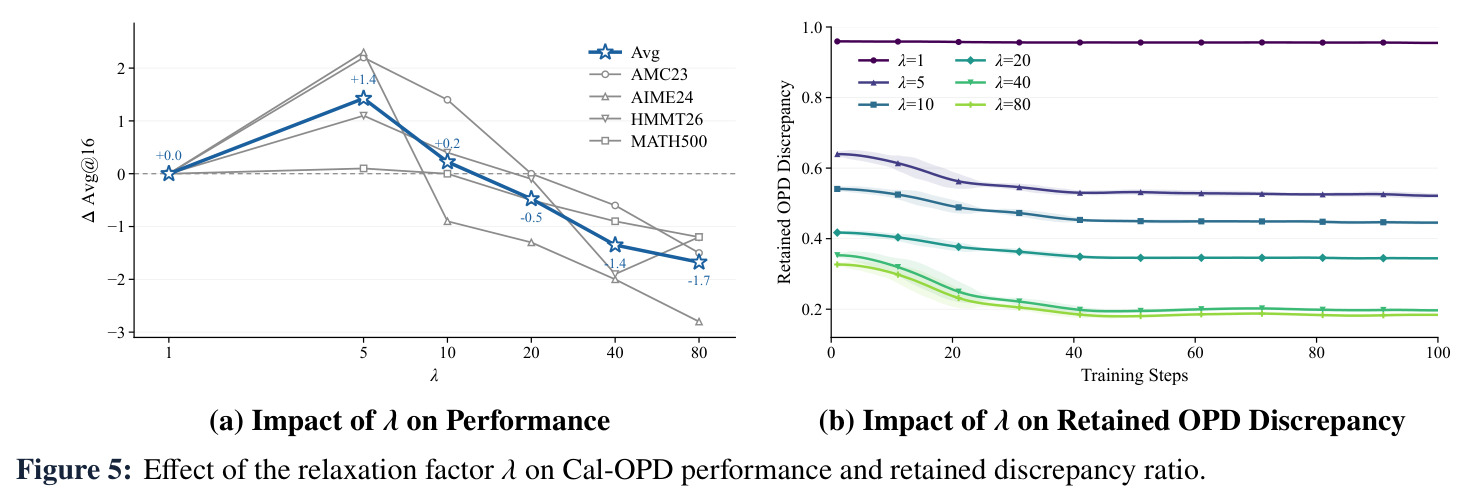
直觉上,如果教师对同一个学生 token 的打分会因为一句与解题无关的上下文而摆动 $\pm\delta$,那么师生之间小于 $\delta$ 的差异很可能只是教师自己的抖动,不值得学;只有超出摆动范围的差异才反映真实能力差距。技术路线上,Cal-OPD 对每个学生生成的 token 做四步处理:第一步,学生照常 on-policy 采样轨迹,计算原始差异 $A^{\mathrm{OPD}}_t=\ell^T_t-\ell^S_t$;第二步,对教师做两次额外前向,分别插入正、负语义的评价反馈干预("金标准验证者判定推理严谨正确" vs "判定推理有误不可靠"),得到似然变化 $\Delta^{\mathrm{pos}}_t$ 与 $\Delta^{\mathrm{neg}}_t$;第三步,取 $\hat{d}^{\downarrow}_t=\max(0,-\Delta^{\mathrm{pos}}_t,-\Delta^{\mathrm{neg}}_t)$ 与 $\hat{d}^{\uparrow}_t=\max(0,\Delta^{\mathrm{pos}}_t,\Delta^{\mathrm{neg}}_t)$,乘以松弛因子 $\lambda\ge 1$ 得到自偏差区间 $\hat{R}^T_t=[\ell^T_t-\lambda\hat{d}^{\downarrow}_t,\ \ell^T_t+\lambda\hat{d}^{\uparrow}_t]$;第四步,用软校准的铰链形式 $A^{\mathrm{Cal}}_t=[L^T_t-\ell^S_t]_+ + [\ell^S_t-U^T_t]_+$ 计算校准优势($[z]_+=\max(z,0)$)——学生似然落在区间内时信号归零,落在区间外时只保留超出最近边界的部分——再用标准 OPD 的 REINFORCE 损失优化。训练时取 $\lambda=5$,最终只保留约 52–65% 的原始差异作为优化信号。
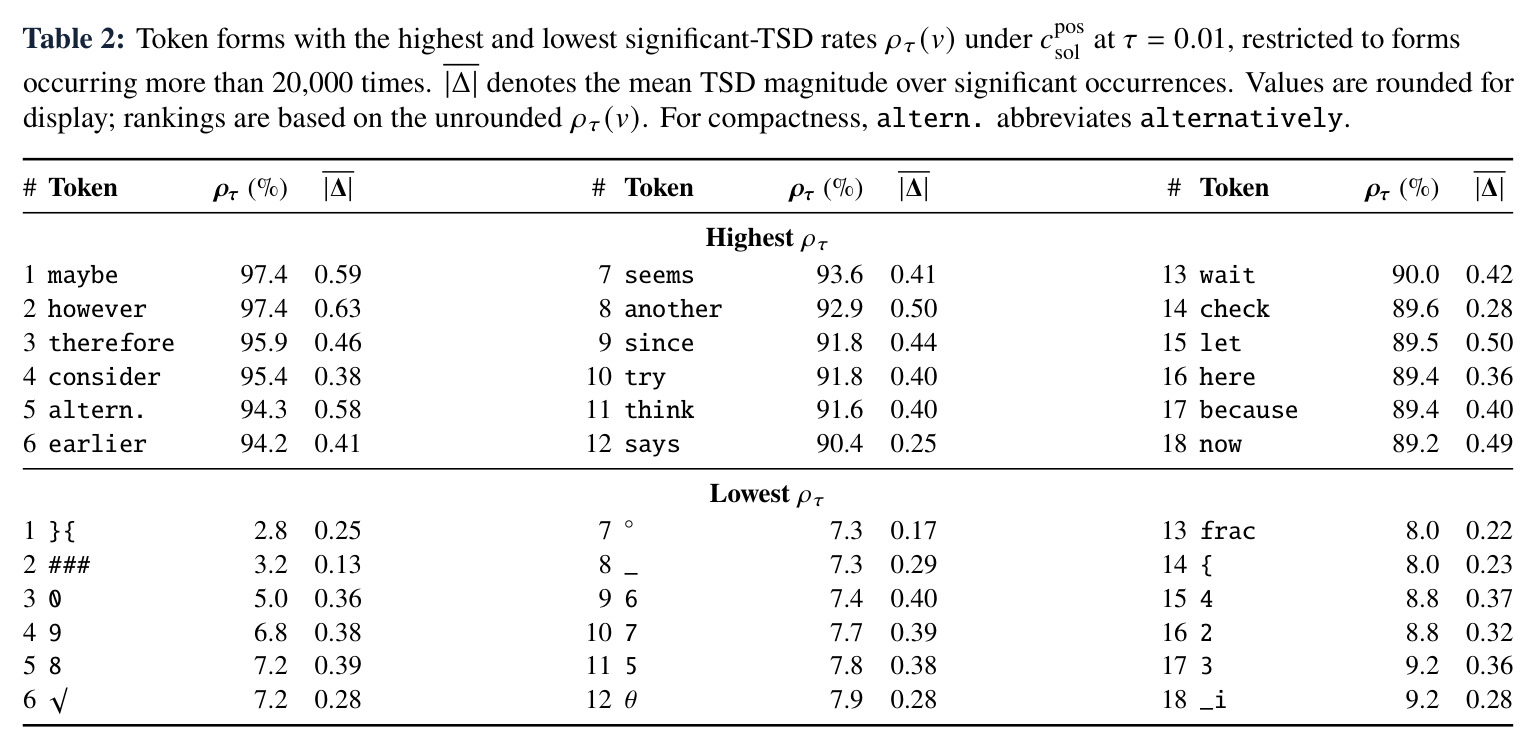
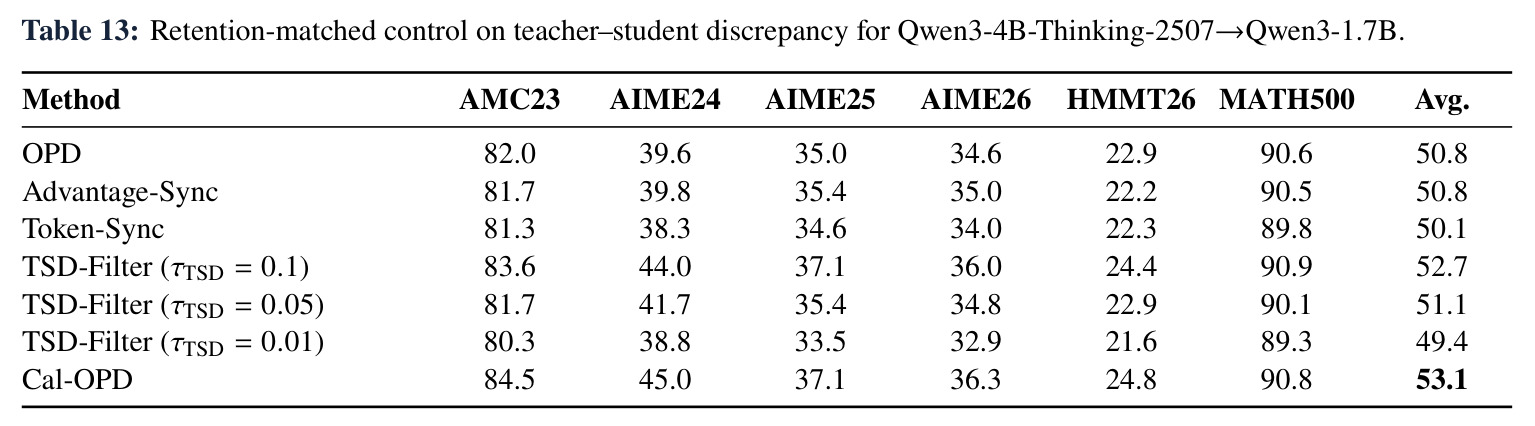
核心创新是把"教师似然的不稳定性"从被忽视的噪声变成被显式测量并从监督信号中扣除的对象,与已有方法的本质区别有三层。第一层是差异归因:标准 OPD 把全部 $A^{\mathrm{OPD}}_t$ 归因为师生能力差距,而本文用干预实验证明其中相当一部分(最终过滤掉 35–48%)由教师自身上下文敏感性造成,且这部分漂移在不提供任何任务知识时就会出现(任务无关指令并集覆盖 29.8% 的 token)、对语义极性不敏感(反转答案正确性方向一致率仍有 88.7%)、集中在 maybe/however/therefore 等表面形式 token(显著率超 89%,数字与数学符号低于 9.3%),因此不能当知识来学。第二层是特权信息的用法:特权 OPD 直接把参考解答条件进教师让学生模仿,结果把更大的上下文诱导偏差一并蒸给学生(30B→4B 掉到 64.0);Cal-OPD 用语义相反的特权提示互为对照,从上下两侧夹逼漂移区间,特权信息只用于测量教师、从不直接监督学生。第三层是软校准而非硬过滤:不像阈值过滤那样把高 TSD token 整个丢弃,而是保留区间之外的残差,A.9 的保持率匹配对照(Advantage-Sync 50.8、Token-Sync 50.1、TSD-Filter 最高 52.7,均低于 Cal-OPD 的 53.1)证明增益来自"保留哪部分差异"而非"删掉多少信号"。
方法步骤详情
完整流程(以 Qwen3-4B-Thinking-2507→Qwen3-1.7B、$C_{\mathrm{eval}}$ 干预、$\lambda=5$ 为例)。步骤一,数据与轨迹:用 Qwen3-235B-A22B-Instruct-2507 为 DAPO-17K 生成并过滤出 15,560 个带验证参考解的问题(覆盖率 90.18%),学生每步对 256 个问题各采样 1 条轨迹(温度 1.0、top-$p$ 1.0、最大 16,384 token)。步骤二,原始差异计算:教师与学生分别对每个学生 token 计算对数似然,得到 $\ell^T_t$、$\ell^S_t$ 与 $A^{\mathrm{OPD}}_t$,教师只输出 top-16 token 的对数概率。步骤三,TSD 探测:教师额外做两次前向,输入分别为问题加正向评价反馈("验证者判定推理严谨、连贯、数学上可靠")与负向评价反馈("判定推理有缺陷、不连贯、不可靠"),学生轨迹与被评 token 保持逐字不变,得到 $\Delta^{\mathrm{pos}}_t$、$\Delta^{\mathrm{neg}}_t$。步骤四,区间估计与校准:计算 $\hat{d}^{\downarrow}_t$、$\hat{d}^{\uparrow}_t$,乘 $\lambda=5$ 得 $[L^T_t,U^T_t]$,再由铰链公式得 $A^{\mathrm{Cal}}_t$;训练早期保留差异比例约 65%,随训练降至 52%,零优势 token 比例从 27% 升到 34%。步骤五,优化:把 $A^{\mathrm{Cal}}_t$ 代入带 stop-gradient 的 OPD 损失,用 AdamW(学习率 $1\times10^{-6}$、余弦调度、梯度裁剪 1.0、权重衰减 0.01)训练 100 步,全部实验基于 verl 框架在 8 张 NVIDIA H20(4 卡学生、4 卡教师)上完成。评测在 AMC23、AIME24/25/26、HMMT26、MATH500 六个基准上按每题 16 次采样平均(Avg@16),温度 0.6、top-$p$ 0.95、最大 20,480 token。
技术新颖性
技术新颖性体现在四个方面。其一,概念贡献:首次把"教师似然在受控上下文干预下的变化"命名为 Teacher Self-Deviation,并给出可操作的区间估计 $\hat{R}^T_t(\mathcal{C})=[\ell^T_t-\hat{d}^{\downarrow}_t,\ \ell^T_t+\hat{d}^{\uparrow}_t]$,明确指出它只是底层真实自偏差区域 $\mathcal{R}^T_t$ 的有限干预近似。其二,实证方法学:用约 6,000 万 token 的重评分实验(同一学生轨迹在 9 种教师上下文下重算似然)系统证明 TSD 无需任务知识即可出现、对正确性反转不敏感、按 token 形态高度结构化(表面词与数学符号的显著率相差近一个数量级,top-24 与 bottom-24 的均值相差 11–18 倍),这组证据对蒸馏社区有独立价值。其三,算法设计:与熵加权(EOPD)、结果校准(Uni-OPD)、阈值丢弃(TSD-Filter)不同,Cal-OPD 是保留残差的软校准,连续保留区间外的全部差异而非二值地丢 token,保持率匹配对照证明这是增益来源。其四,系统发现:揭示特权 OPD 与过强校准($C_{\mathrm{sol}}$)是两种相反的失败模式——前者"过度自信捷径坍缩"(学生熵降到约 0.25、概率质量重叠升至 0.880),后者"信号坍缩"(熵升到 0.36、响应缩到 5.5K token),为后续方法设计划出了清晰边界。
实验结果
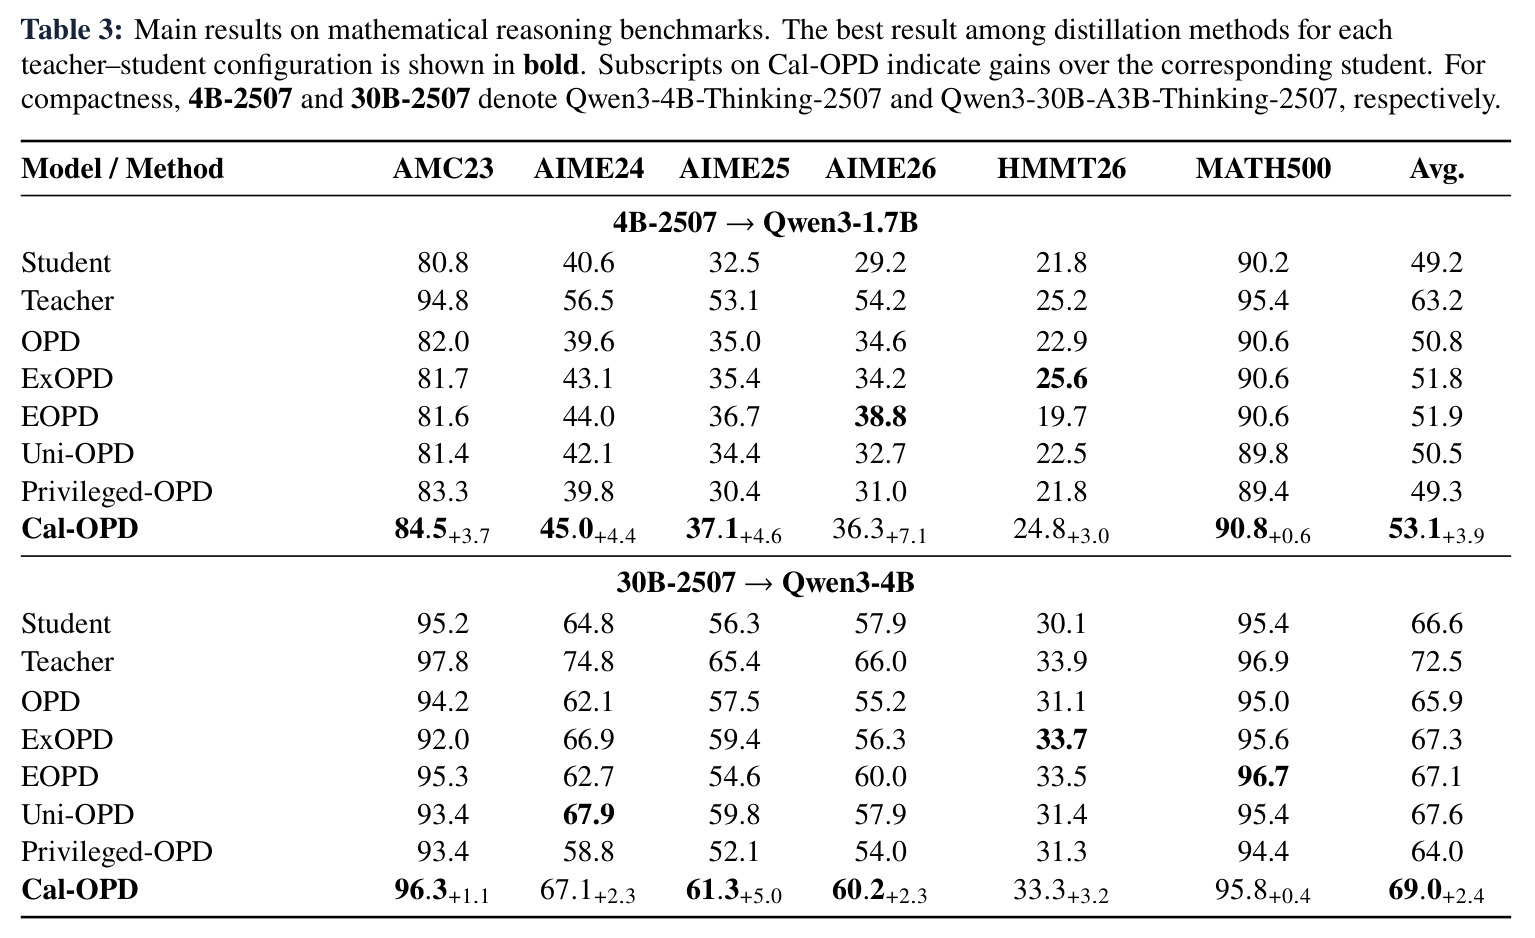
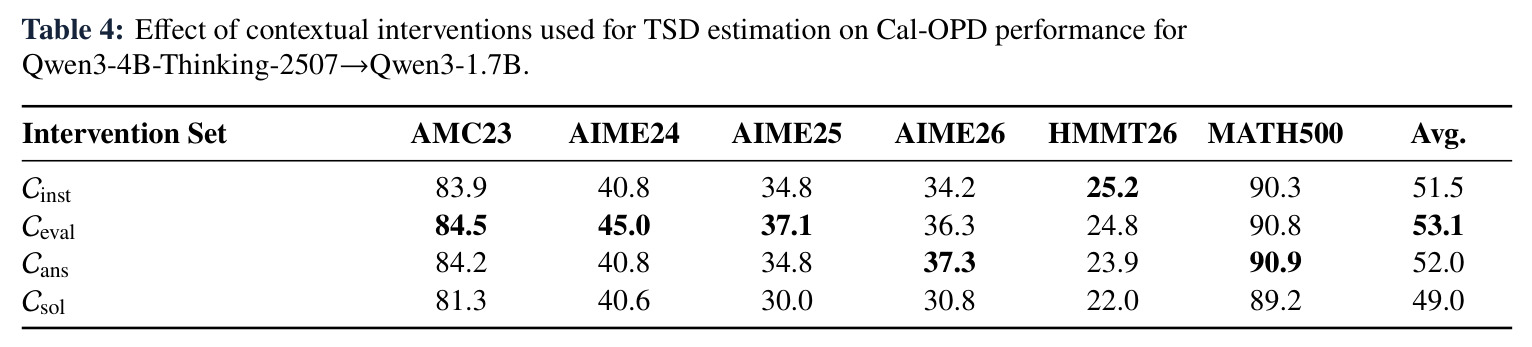
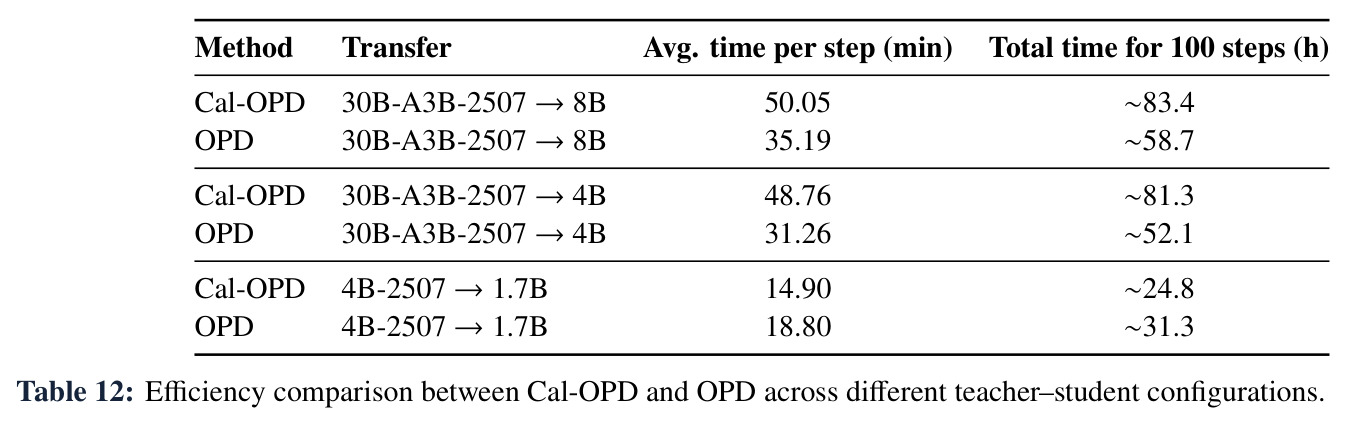
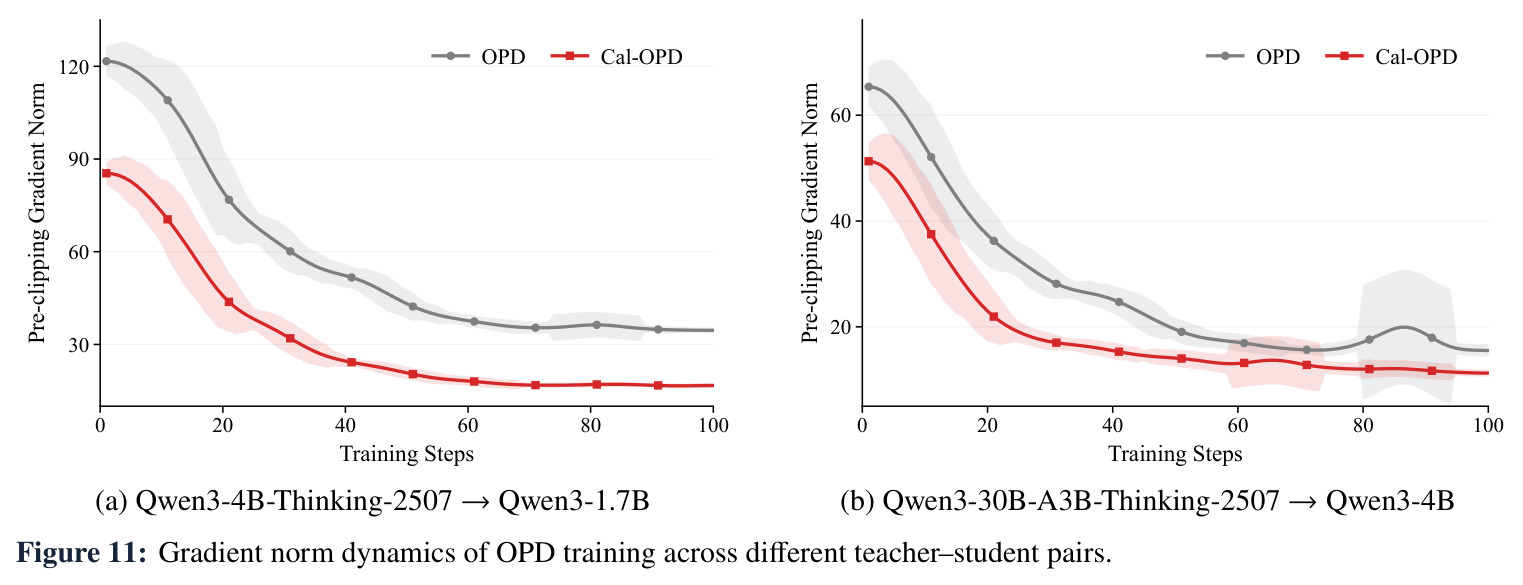
主实验(Table 3,Avg@16):4B-Thinking-2507→1.7B 上,Cal-OPD 六基准平均 53.1,比学生基线 49.2 高 3.9,比标准 OPD 50.8 高 2.3,超过所有基线(ExOPD 51.8、EOPD 51.9、Uni-OPD 50.5、Privileged-OPD 49.3),AIME26 提升最大(36.3 对学生 29.2,+7.1);30B-A3B→4B 上,Cal-OPD 平均 69.0,比学生 66.6 高 2.4,比 OPD 65.9 高 3.1(ExOPD 67.3、EOPD 67.1、Uni-OPD 67.6、Privileged-OPD 64.0),AIME25 提升 +5.0(61.3 对 57.5)。标准 OPD 在大配置下甚至把学生从 66.6 拉低到 65.9,特权 OPD 在两个配置中最差(49.3/64.0),印证原始差异并非越多越有益;Cal-OPD 在 12 个基准-配置对中 7 次登顶。消融一(Table 4):干预集合 $C_{\mathrm{eval}}$ 最优(53.1),$C_{\mathrm{ans}}$ 52.0,$C_{\mathrm{inst}}$ 校准太弱、保留近 70% 差异(51.5),$C_{\mathrm{sol}}$ 过度过滤、只剩约 20% 差异(49.0)。消融二(Figure 5):$\lambda=5$ 最优(保留约 52%),$\lambda=80$ 时保留约 20%、比 $\lambda=1$ 低 1.7 分。消融三(Table 13):保持率匹配下 Advantage-Sync 50.8、Token-Sync 50.1、TSD-Filter($\tau_{\mathrm{TSD}}=0.1$)52.7,均不及 Cal-OPD 53.1,排除"增益只是信号衰减"。训练动态(Figure 4/9):保留差异比从 65% 降至 52%,零优势 token 比例从 27% 升至 34%;OPD 平均响应从 9.8K 膨胀到 11.8K,Cal-OPD 终点仅 9.3K,且保持更高学生熵(约 0.30 对 0.25)与更高 top-16 token 重叠(升至约 0.693),只是概率质量重叠低于 OPD,说明它覆盖更多教师支持的模式而非死记单一主模式。效率(Table 12):4B→1.7B 时 Cal-OPD 每步 14.90 分钟反比 OPD 18.80 快约 1.26 倍(轨迹更短抵消两次教师前向开销);教师大得多时更慢(30B→4B:48.76 对 31.26 分钟/步)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理六基准平均(Qwen3-4B-Thinking-2507→Qwen3-1.7B) | Avg@16 准确率 | 53.1 | 标准 OPD 50.8(最强基线 EOPD 51.9;学生基线 49.2) | 较 OPD +2.3,较学生 +3.9,较最强基线 +1.2 |
| 数学推理六基准平均(Qwen3-30B-A3B-Thinking-2507→Qwen3-4B) | Avg@16 准确率 | 69.0 | 标准 OPD 65.9(最强基线 Uni-OPD 67.6;学生基线 66.6) | 较 OPD +3.1,较学生 +2.4,较最强基线 +1.4 |
| AIME26(4B→1.7B) | Avg@16 准确率 | 36.3 | OPD 34.6,学生 29.2 | 较 OPD +1.7,较学生 +7.1(单基准最大提升) |
| AIME25(30B→4B) | Avg@16 准确率 | 61.3 | OPD 57.5,学生 56.3 | 较 OPD +3.8,较学生 +5.0 |
| 训练效率(4B→1.7B,100 步) | 每步墙钟时间 | 14.90 分钟/步(总计约 24.8 小时) | OPD 18.80 分钟/步(约 31.3 小时) | 约 1.26 倍提速(更短轨迹抵消两次教师前向) |
| 优化信号质量(校准后) | 保留的教师-学生差异比例 | 52–65%($\lambda=5$,随训练从 65% 降至 52%) | 标准 OPD 100% 无差别学习 | 过滤 35–48% 的 TSD 分量后性能反而全面更优 |
局限与改进
作者承认的局限:其一,TSD 区间只是有限干预近似,两个探测提示无法穷尽教师的上下文敏感性,需要松弛因子 $\lambda$ 补偿,而 $\lambda$ 纯靠经验选择——$\lambda=5$ 最优,$\lambda=80$ 时保留约 20% 差异、性能比 $\lambda=1$ 低 1.7 分,方法对超参敏感;其二,解级别干预 $C_{\mathrm{sol}}$ 会把含任务相关成分的 TSD 一并滤掉(平均 49.0,甚至低于标准 OPD 的 50.8),校准强度与信息保留之间缺乏自动权衡机制;其三,实验只覆盖数学推理和 Qwen3 家族内部蒸馏,未验证代码、智能体等其他领域或跨家族蒸馏。我自己的观察:第一,每个 token 两次额外教师前向的成本在教师远大于学生时不可忽略(30B→4B 每步 48.76 对 31.26 分钟,总时间 81.3 对 52.1 小时,多约 56%),论文的 1.26 倍提速只在师生规模接近时成立;第二,Cal-OPD 的 top-16 概率质量重叠低于 OPD,100 步窗口内无碍,但更长期的分布匹配效应未验证;第三,评价反馈模板的具体措辞可能影响区间宽度,论文未做模板鲁棒性消融;第四,训练数据与评测同为数学竞赛题,存在领域内泄漏风险;第五,TSD 分析基于 Qwen3 系教师的重评分,教师家族泛化性仍属假设。
独立分析的弱点
第一,双探测区间估计偏粗糙:仅用一正一负两个提示的极值定义 $\hat{d}^{\downarrow}_t$、$\hat{d}^{\uparrow}_t$,再统一乘固定 $\lambda=5$,没有逐 token 的不确定性量化。改进方向:对同一 token 用多提示或 dropout 采样估计漂移方差,把 $\lambda$ 换成分位数校准或可学习参数。第二,计算开销结构性偏向教师:开销集中在教师前向,教师越大越亏(30B→4B 慢 56%)。改进方向:离线一次性统计各 token 形态/位置/推理阶段的 TSD 分布,在线用查表近似,或只对高 TSD 风险 token 做探测,把两次前向摊薄为摊销成本。第三,域外有效性未知:数学推理中表面词与符号 token 泾渭分明,代码生成中注释、格式 token 是否承载同样 TSD 尚不清楚。改进方向:先在目标域重跑第 2 节的干预分析确认 TSD 结构,再套用校准。第四,与廉价基线对比不足:Table 2 已表明 TSD 高度集中在 maybe/however 等表面词上,但论文未测试"直接把这些形态 token 的优势置零"这种近乎零成本的基线。第五,评价反馈模板隐含"存在金标准验证者"的假设,在缺少可靠验证器的开放任务(写作、对话)中如何构造正负干预是未解问题;且 100 步训练窗口较短,也未测试与 RLVR 结果奖励联合时的互补性。
未来方向
作者方向:结论指向"有效蒸馏取决于识别哪些差异值得学",可延伸到更可靠的 TSD 区间估计(更多样化的探测干预、自适应 $\lambda$)、非数学领域验证,以及把校准思想推广到其他逐 token 蒸馏目标。基于本文成果可延伸的方向:其一,与 RLVR 融合——把 $A^{\mathrm{Cal}}_t$ 作为密集奖励与可验证结果奖励加权组合,兼得密集引导与结果正确性,尤其适合特权 OPD 失效的高难竞赛题;其二,自蒸馏场景——OPSD 类方法用特权自教师时同样面临上下文诱导偏差,Cal-OPD 的探测机制可直接移植;其三,把 TSD 当作教师选择与数据质量指标——训练前用小规模干预分析评估候选教师的稳定性,选 TSD 最低的教师或在 token 形态层面对齐师生;其四,理论化——建立"有限干预下 TSD 区间以概率 $1-\delta$ 覆盖真实漂移"的保证,推导 $\lambda$ 与覆盖率的解析关系,替代手调;其五,方向性利用——高 TSD 的表面词 token 恰是文风载体,可以反向地只对它们做校准或放松校准,实现能力蒸馏与风格迁移的解耦控制;其六,把 TSD 区间与奖励模型的置信区间结合,构建统一的不确定性感知后训练框架。
复现评估
复现条件相当好。模型全部公开(Qwen3-1.7B、Qwen3-4B-Thinking-2507、Qwen3-8B、Qwen3-30B-A3B-Thinking-2507、Qwen3-235B-A22B-Instruct-2507);训练集 DAPO-17K 公开,参考解生成与学生轨迹采集流程在附录 A.2 完整给出(含系统提示、温度、长度上限、15,560 对的过滤标准与 6,528 条分析轨迹);四种干预的完整模板印在 Table 1,负向答案与负向解答的构造规则(等位数错误答案、长度差小于 10% 的他题解答)也写明;实现基于开源 verl 框架,共享与方法特定超参完整列于 Table 10/11(学习率 $1\times10^{-6}$、100 步、每步 256 轨迹、教师 top-16 logprobs、损失裁剪 10、Cal-OPD 用 $C_{\mathrm{eval}}$ 与 $\lambda=5$)。算力为 8 张 NVIDIA H20(4 卡学生 4 卡教师)跑 100 步:4B→1.7B 约 25 小时、30B→4B 约 81 小时,中等规模实验室可负担;TSD 分析需对约 6,000 万 token 做 9 种上下文重评分,可按比例缩减。论文未给出开源代码链接,复现需自行在 verl 中实现校准损失,难度中等:熟悉 RL 训练框架的团队约需一至两周;关键坑点包括师生分卡部署的吞吐、top-16 logprob 截断带来的似然误差,以及评测协议(温度 0.6、top-$p$ 0.95、Avg@16、最大 20,480 token)的严格对齐。
论文图表
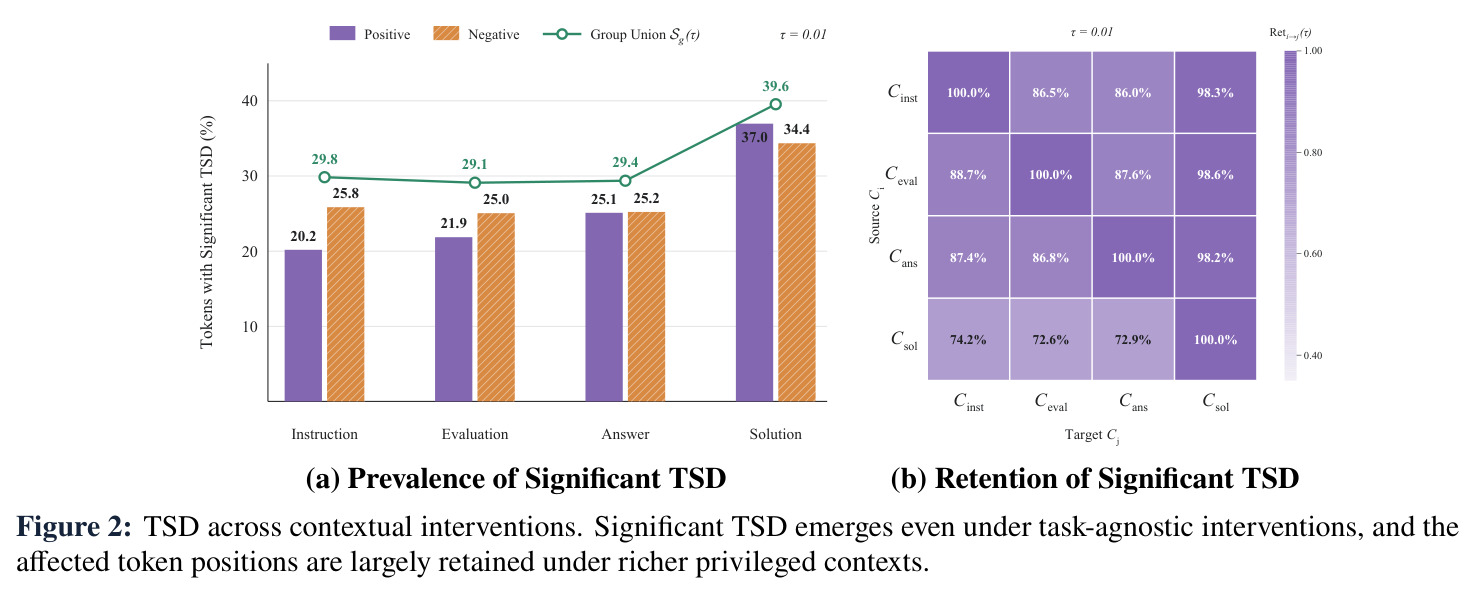
左图 (a) 报告各干预组在 $\tau=0.01$ 下诱发显著 TSD 的 token 比例:任务无关指令并集 29.8%(正 20.2%/负 25.8%),评价反馈 29.1%,答案级特权 29.4%,解级特权扩至 39.6%。右图 (b) 是保留矩阵:解级特权保留了 98.3%/98.6%/98.2% 来自指令/评价/答案级的显著 TSD 位置,反向保留只有 74.2%/72.6%/72.9%。
证明 TSD 无需任务知识就会出现、特权上下文只是扩大既有受影响集合而非创造新模式——这是"TSD 不是知识信号"这一核心论证的实证基石。
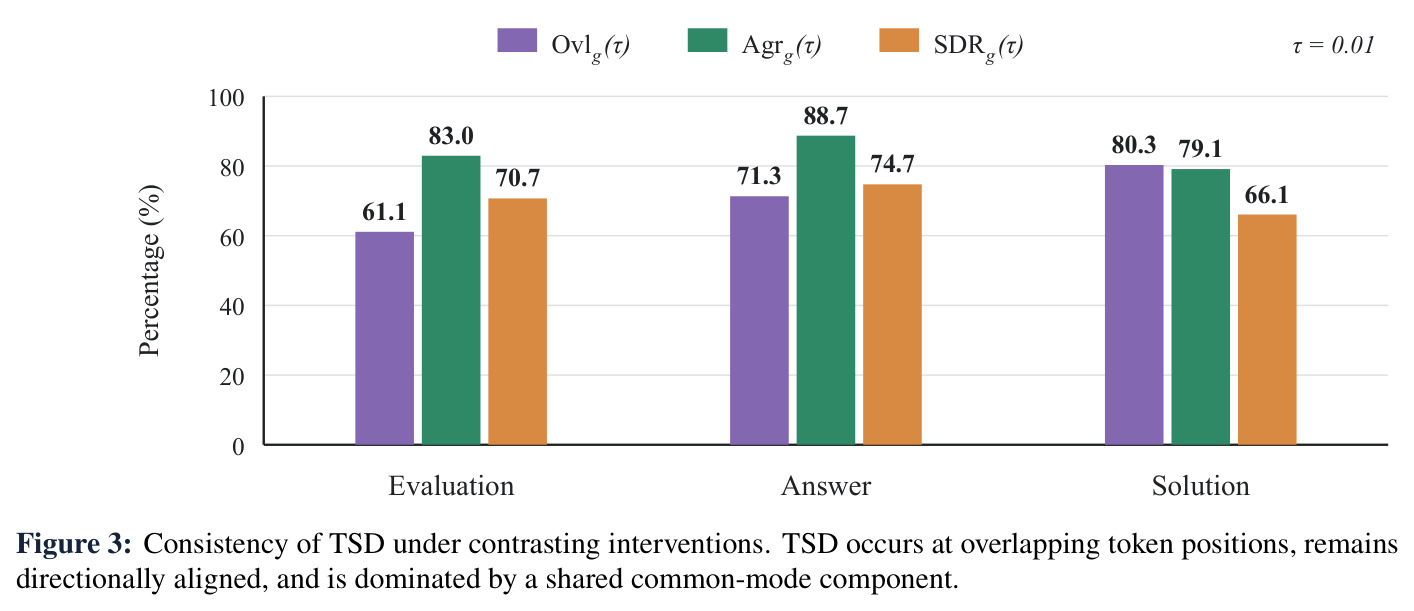
对评价、答案、解三组的正负干预对比计算三项指标:位置重叠率、方向一致率与共享偏差比(SDR)。文中给出的关键数值:反转答案正确性仍有 88.7% 方向一致、74.7% 共享偏差比;解级干预位置重叠最高(80.3%)但共享偏差比最低(66.1%)。
说明 TSD 对语义极性与正确性不敏感、由共同模式成分主导,直接支撑"教师似然漂移不能当可靠知识蒸馏"的判断,是动机部分最关键的统计证据。
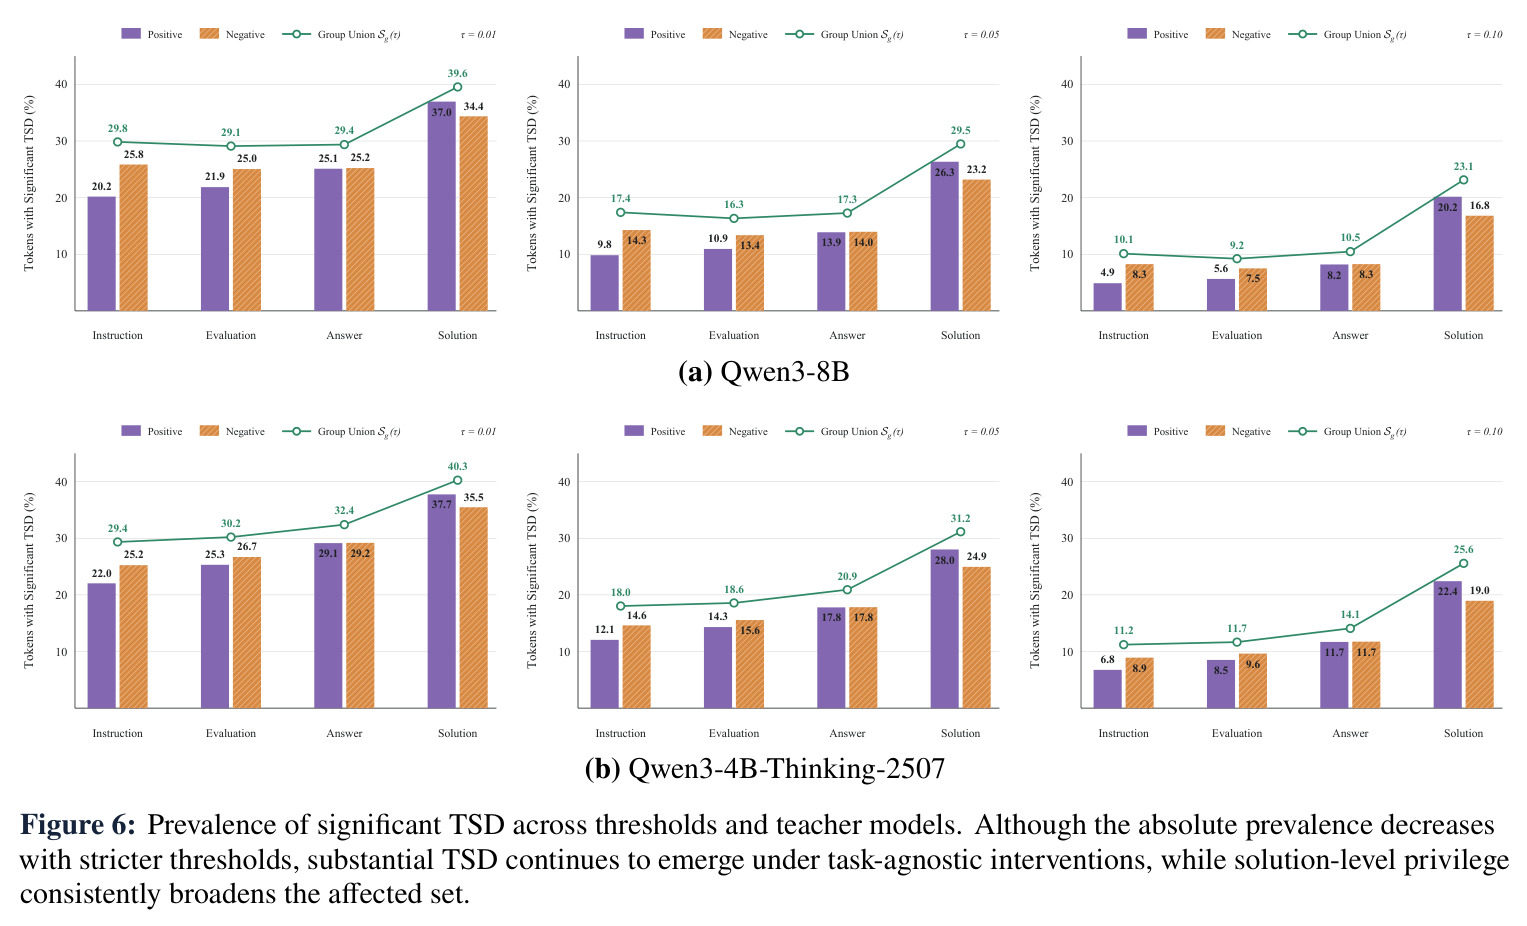
在 $\tau\in\{0.01,0.05,0.10\}$ 与 Qwen3-8B、Qwen3-4B-Thinking-2507 两个教师下重复主文的显著 TSD 比例分析:阈值加严后绝对比例下降但相对格局不变,例如 Qwen3-8B 指令并集从 29.8% 降到 10.1%,与评价反馈(29.1%→9.2%)始终相当,解级特权始终最高。
附录鲁棒性验证,确认 TSD 的核心结论不依赖特定显著性阈值或教师规模。
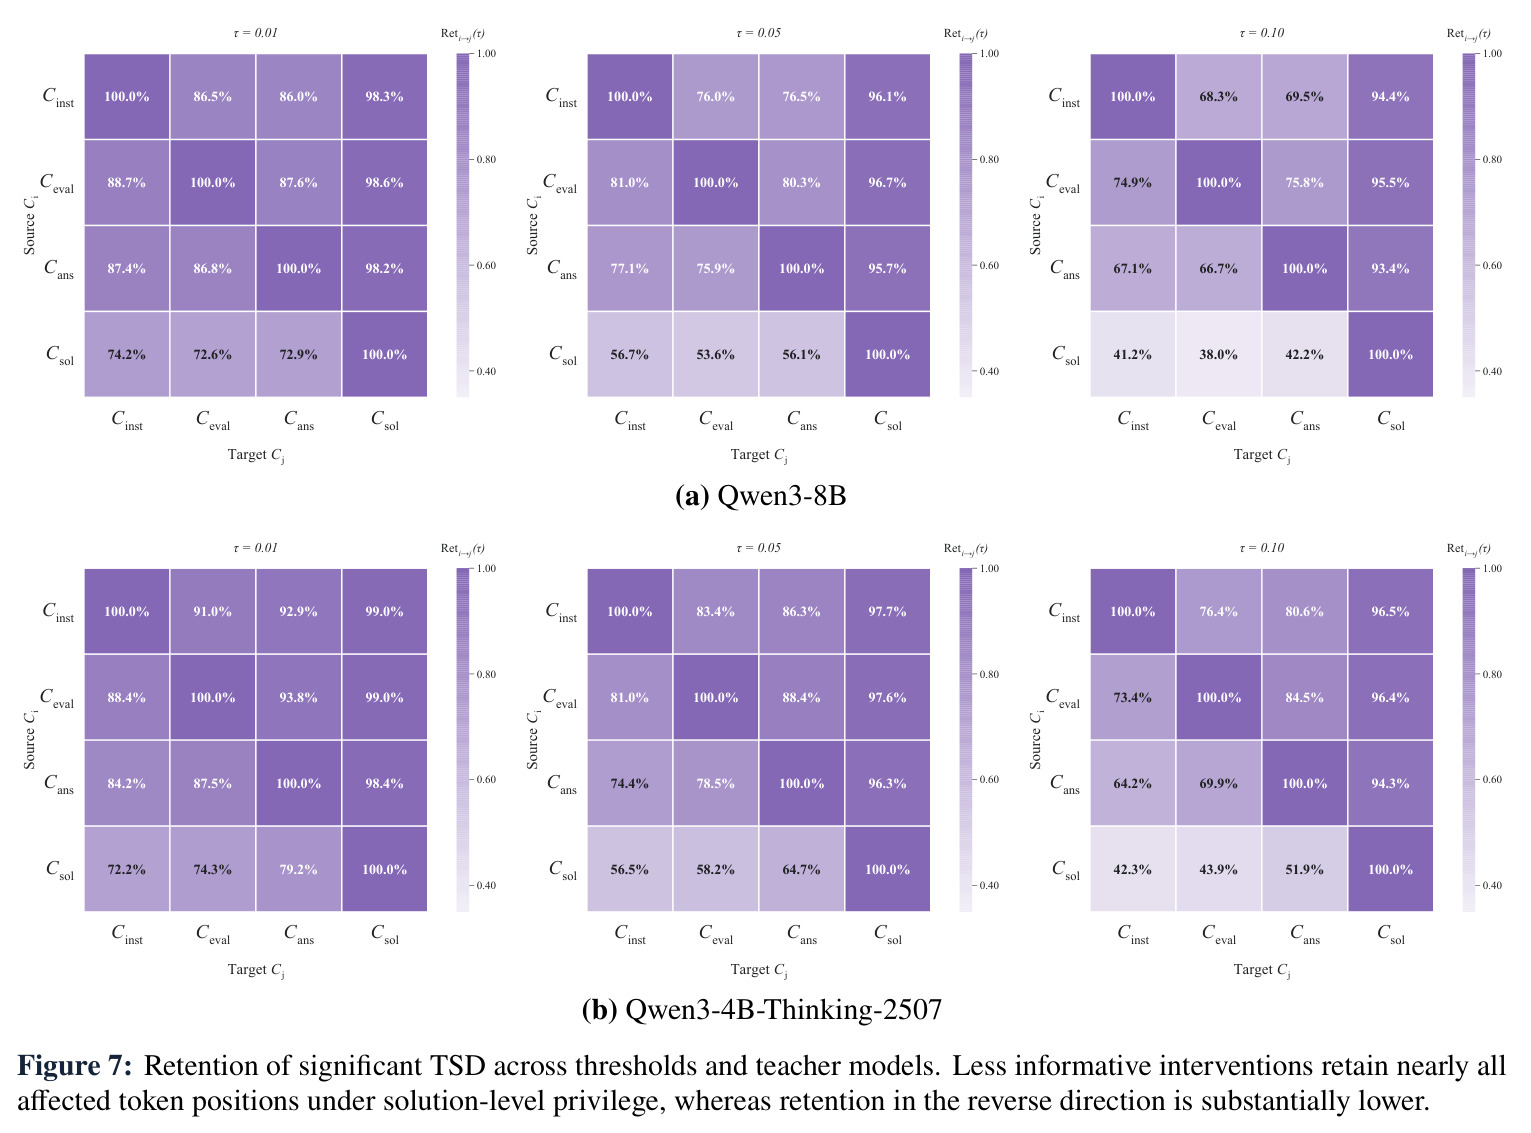
保留矩阵在三个阈值与两个教师下的扩展:即使 $\tau=0.10$,指令/评价/答案级 TSD 位置在解级特权下的保留率仍不低于 93.4%(Qwen3-8B)与 94.3%(Qwen3-4B-Thinking-2507),反向保留明显更低且随阈值加严而下降。
强化"更丰富的特权上下文主要扩展既有敏感位置"这一不对称性结论,是 Figure 2(b) 的跨阈值、跨尺度版本。
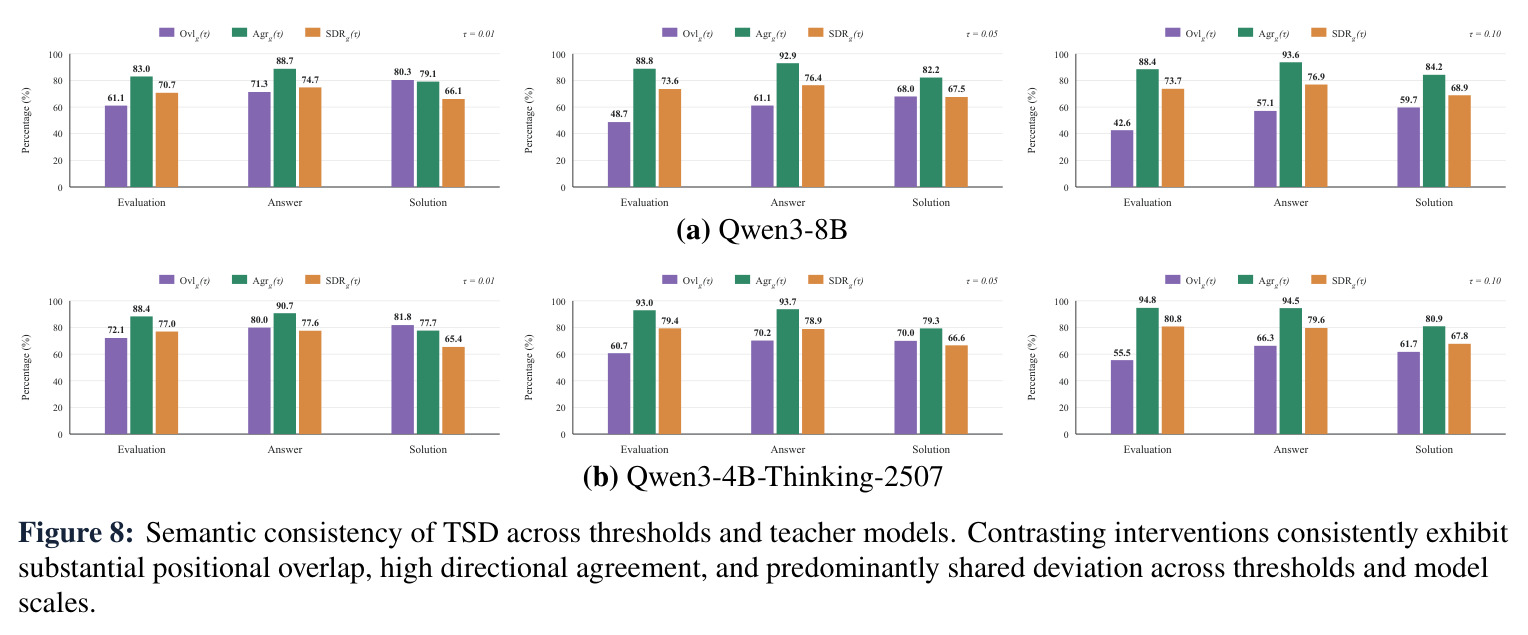
三个阈值 × 两个教师下的重叠率/方向一致率/共享偏差比:阈值加严使重叠下降但方向一致率保持很高,$\tau=0.10$ 时答案级一致率达 93.6%(Qwen3-8B)与 94.5%(Qwen3-4B),对应 SDR 为 76.9% 与 79.6%;解级始终呈高重叠、低 SDR 的模式。
证明"TSD 对干预语义不敏感"的结论跨阈值、跨教师尺度稳定,是主文 Figure 3 的可靠性背书。
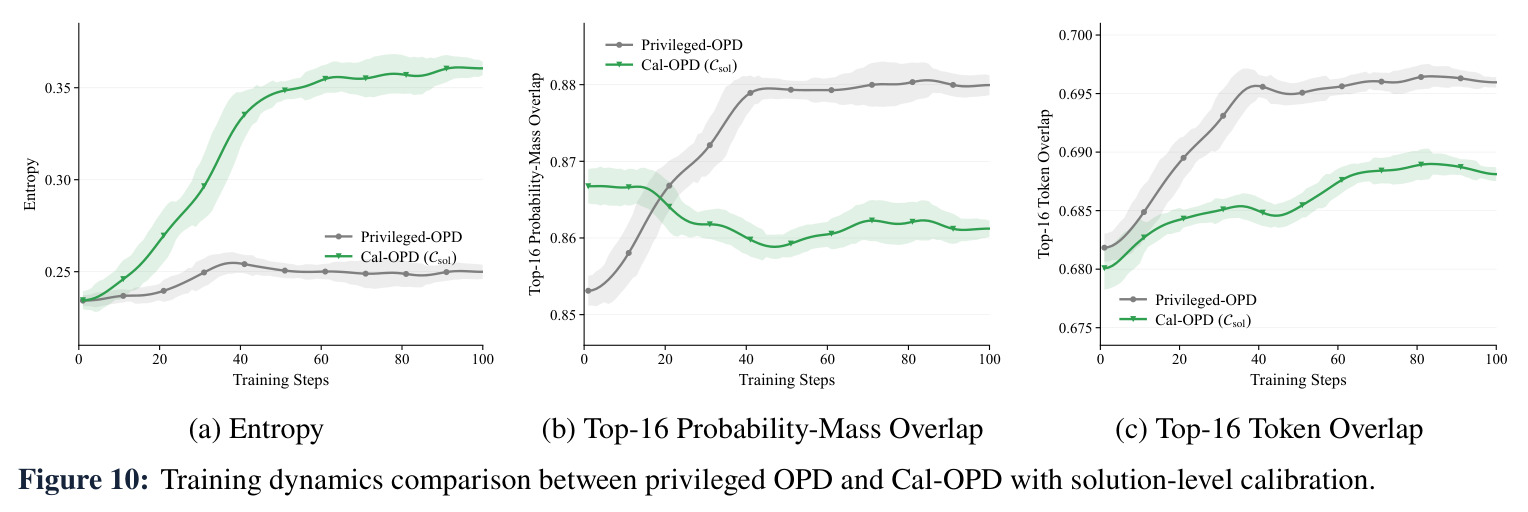
对比特权 OPD 与 $C_{\mathrm{sol}}$ 校准的 Cal-OPD 三条曲线:前者学生熵稳定在约 0.25、top-16 概率质量重叠升至约 0.880(学生过度自信、集中于狭窄 token 集);后者熵升到约 0.36、概率质量重叠降至约 0.859(无法匹配无特权教师)。
精确区分两种相反的失败模式——特权 OPD 的"过度自信捷径坍缩"与 $C_{\mathrm{sol}}$ 的"信号坍缩",对理解特权信息该不该直接蒸非常有说服力。