面向分解式AI评估的预测驱动平滑与验证 Prediction-Powered Smoothing and Validation for Disaggregated AI Evaluation
用小区域估计跨领域借力,同时改进AI分解式评估的估计精度与模型验证
前置知识
有限总体抽样与HT估计量
把评估集(如benchmark全部9,324道题或一段时间内的68,371条对话)视为固定的有限总体,目标是每个领域的真实均值 $\theta_i = \frac{1}{N_i}\sum_{j\in U_i} y_{ij}$。按已知入样概率 $\pi_{ij}$ 抽取概率样本后,Horvitz–Thompson估计量 $\hat{\theta}^{HT}_i = \frac{1}{N_i}\sum_{j\in S_i} w_{ij}y_{ij}$($w_{ij}=1/\pi_{ij}$)在重复抽样下无偏,且随标签增多设计一致地收敛到真值。
本文所有估计量都以设计无偏、设计一致的HT为参照基线,验证得分与方差 $d_i$ 也建立在其抽样性质上;不理解有限总体视角,就无法理解文中"覆盖率"与"去偏"的确切含义。
预测驱动推断(PPI)与GREG估计量
PPI利用记录在全部N个单元上的辅助变量 $f_{ij}$(如LLM裁判打分):$\hat{\theta}^{PPI}_i = \frac{1}{N_i}\sum_{j\in U_i} f_{ij} + \frac{1}{N_i}\sum_{j\in S_i} w_{ij}(y_{ij}-f_{ij})$,用抽样标签的加权误差修正预测的系统性偏差,等价于调查统计中的差异估计量。GREG/PPI++进一步把校正斜率换成加权回归系数 $\hat{\lambda}$,辅助弱时 $\hat{\lambda}\to 0$ 自动退回HT。
本文的PP-S就是把GREG估计作为小区域模型的输入;实验反复展示PPI在弱辅助下反而恶化(RMSE 0.106 vs HT 0.082),理解其失灵条件是读懂结果的关键。
Fay–Herriot小区域模型
面向"总体样本大、单领域样本少"的领域级(area-level)贝叶斯模型:$z_i|\theta_i \sim N(\theta_i, d_i)$,$\theta_i = x_i^\top\beta + v_i$,$v_i\sim N(0,\sigma^2)$。后验均值是精度加权折中 $\gamma_i z_i + (1-\gamma_i)x_i^\top\beta$,权重 $\gamma_i=\sigma^2/(\sigma^2+d_i)$:领域直接估计噪声 $d_i$ 越大,越依赖回归部分借力。
PP-S与PP-TS都是在Fay–Herriot框架上改造(换输入、加分类学多层随机效应),收缩权重公式直接解释了平滑在稀疏领域收益最大的现象。
设计式交叉验证(DB-CV)
在概率样本内部按领域分层切成K折(每折仍是概率样本),候选估计量在K-1折上拟合、与留出折的加权HT估计比较得CV得分;再对折级偏倚与样本级偏倚做校正,得到去偏得分 $S^{deb}_i(M) = S^{adj}_i(M) - d_i + 2\,\mathrm{Cov}(\hat{\theta}^{HT}_i,\hat{\theta}^{M}_i)$。
模型型估计量用偏差换方差,必须按总误差(MSE)比较,而信息准则需要似然且无法给HT、PPI这类直接估计量打分;DB-CV是本文验证流程的核心工具。
研究动机
AI系统越来越多地需要分解式评估:同一个模型在不同任务类型(如Open LLM Leaderboard的34种任务类型)或不同对话类型×不同LLM的部署流量(如PRISM的63个领域)上表现差异很大,单一总分掩盖异质性。但穷举评估代价高昂——在HELM上完整评估一个LLM约需9,337美元API费用,开放式任务还要专家人工评分,因此评估只能建立在标签样本上。现有直接估计量(HT、PPI、GREG)只使用本领域自身的标签,方差按 $n_i^{-1}$ 缩放,在标签稀少的领域非常不精确。更糟的是,部署流量中被人工复评的对话往往由投诉、flag或审核员注意触发,这种非概率样本会引入无法仅凭标签检测的偏差:作者在PRISM上模拟"被用户拒绝的回答以约2倍概率入选"的抽样并当作随机样本估计,均值偏差与典型线上自愿调查样本相当、且不随预算增长而消失,名义95%区间的实际覆盖率远低于名义水平——这是Meng所谓Big Data Paradox的实例,PPI也无法修复。
本文的目标是本文要把分解式AI评估做成"估计+验证"的一体化工作流,并统一benchmark评估与部署流量监控这两个此前分开发展的场景。估计端:在有限总体抽样框架下让估计量跨领域借力,提升每个领域均值 $\theta_i$ 的点估计精度,并给出接近名义覆盖率的区间,尤其在标签稀少的领域。验证端:为"该用哪个估计量"提供形式化答案——模型选择被Fogliato等列为开放问题,信息准则需要似然且无法给直接估计量打分,交叉验证在此前只被用来调参。作者希望在只有单一概率样本、无oracle的条件下,用设计式交叉验证得分公平比较直接估计量与平滑估计量:既要像独立验证样本一样选出好候选,又要准确报告所选估计量的真实误差,让分析者能判断抽样预算是否足够。
与已有工作不同的是,论文的独特切入是把"预测驱动"与"小区域估计"两条统计线索缝合起来。PPI/PPI++(及调查统计中对应的差异/GREG估计量)只做单元级辅助修正,属于直接估计量,不跨领域共享信息;而近期AI评估中的经验贝叶斯/层级收缩模型(Fogliato 2024a、Herlihy 2024、Li & Ignatiadis 2025)只在HT输入上收缩,没有结合单元级辅助,也缺少形式化验证手段。作者指出辅助信息其实可以在两个层面各司其职:单元层面通过GREG降低直接估计方差 $d_i$,领域层面作为链接模型协变量 $x_i$ 决定收缩目标;并把AI评估固有的任务分类学(如5个benchmark嵌套34种任务类型)建模成多层随机效应。验证上,他们不沿用Dong & Li (2026)的保守偏倚界(实验中导致所有成对比较弃权),而是导出近似无偏得分。"借力结构必须按数据验证"这一立场是连接估计与验证两半篇的全文逻辑。
核心方法
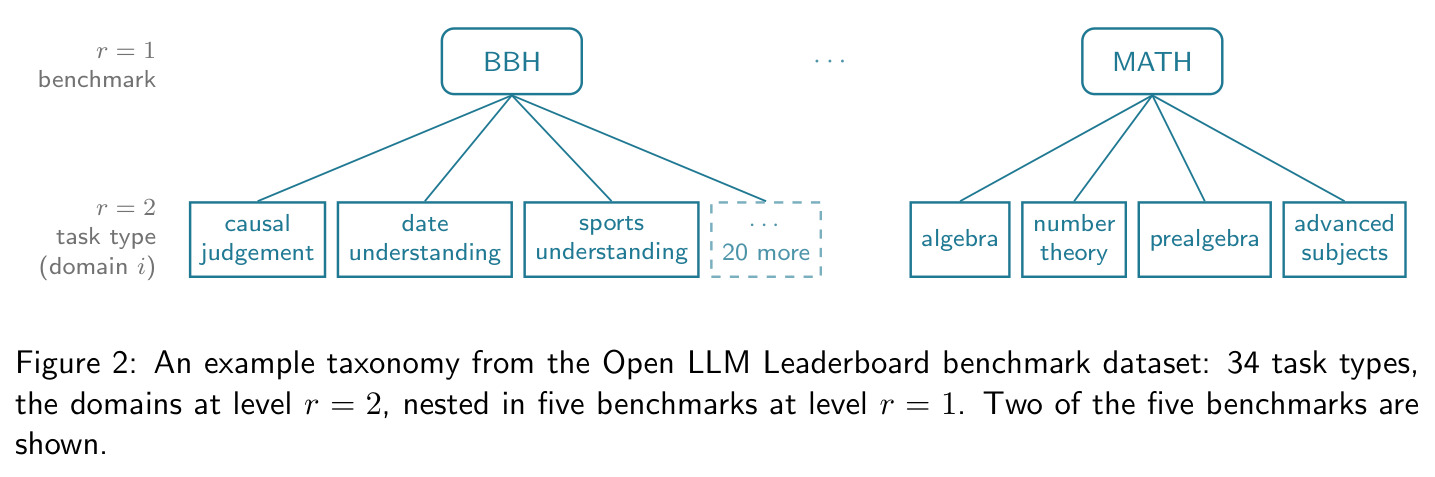
直觉:单个领域的标签太少,但把几十个领域的直接估计放在一起看,领域均值之间存在可学的结构——它们随任务难度、benchmark归属平滑变化。技术路线分两条腿。估计端:先用单元级辅助变量(LLM裁判打分、历史模型答案、历史难度)算出每个领域的GREG估计及其方差 $d_i$;再把这些直接估计当作带噪声的观测,拟合贝叶斯Fay–Herriot模型,即预测驱动平滑PP-S:$z_i \sim N(\theta_i, d_i)$,$\theta_i = x_i^\top\beta + v_i$;若领域嵌套在分类学中(34种任务类型嵌套5个benchmark),把单一随机效应换成各层随机效应之和 $\sum_r v^{(r)}_{a_r(i)}$,得到PP-TS,越邻近的领域借力越强,无用层级的方差会被自动估到近零。验证端:把样本按领域分层切成K=5折,比较7个候选估计量的CV得分,用去偏修正 $S^{deb}_i(M)=S^{adj}_i(M)-d_i+2\,\mathrm{Cov}$ 选出赢家并报告其误差。
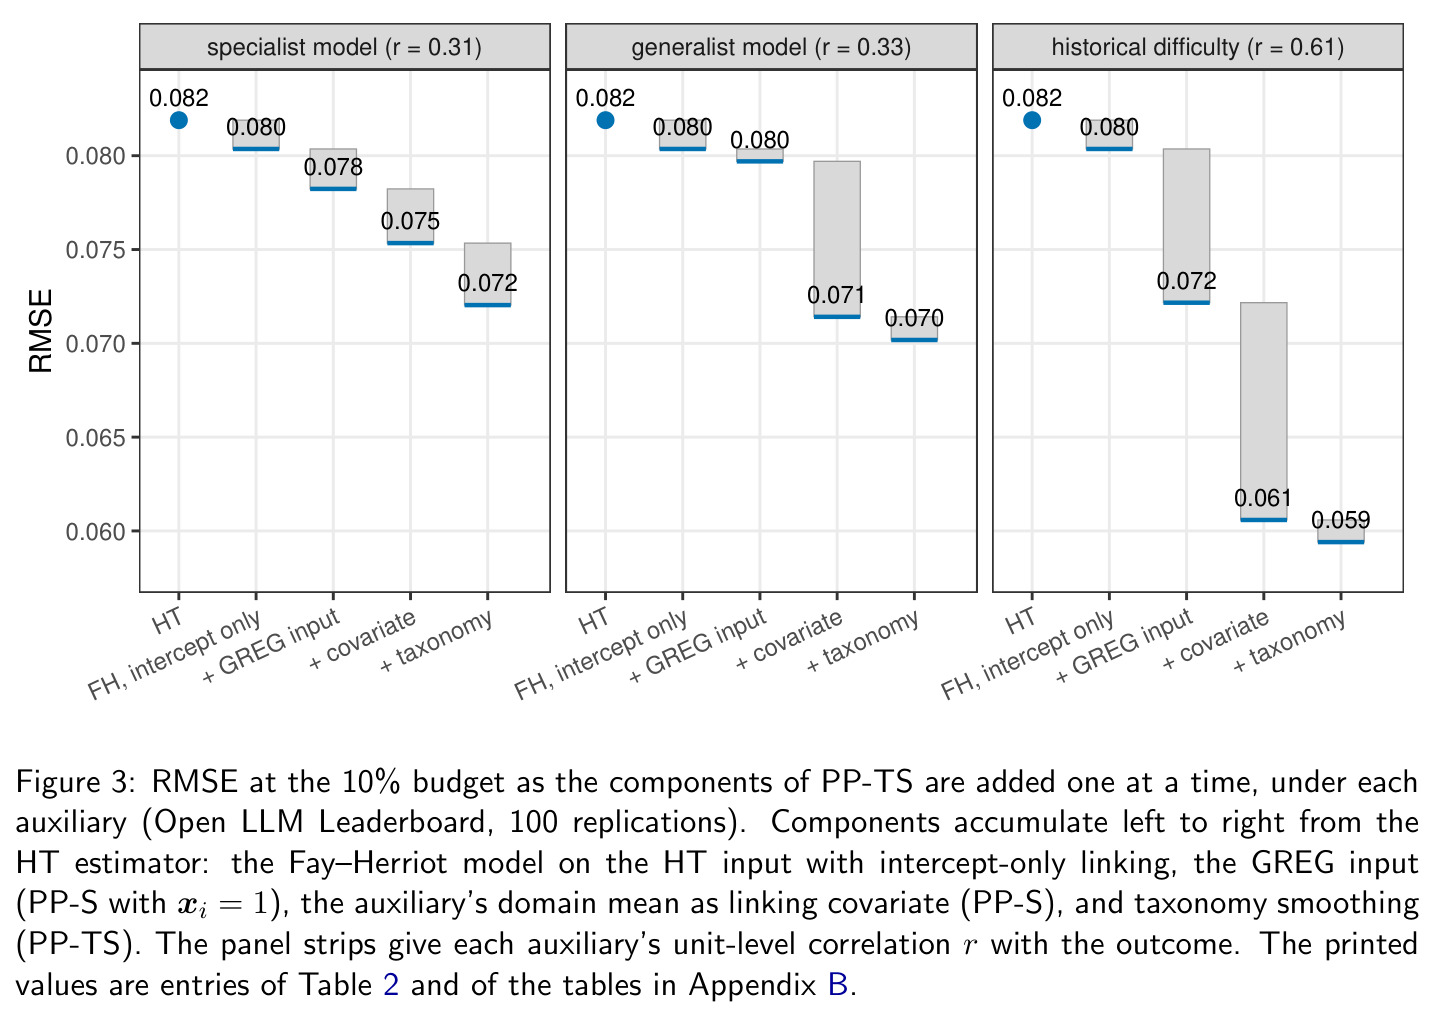
核心创新是"输入替换+两层辅助+结构化借力+可验证"的组合。其一,把Fay–Herriot的输入从HT换成GREG估计:GREG的校正斜率 $\hat{\lambda}$ 在辅助弱时趋于零以保护估计、在辅助强时大幅压低 $d_i$,使平滑作用在更精确的输入上——这解释了PP-S全面优于直接用HT的经典FH。其二,辅助在两个层面互不可替代地起作用:单元级修正降低 $d_i$,领域级均值作为 $x_i$ 改善收缩目标;实验显示两个单元级相关性几乎相同的弱辅助(r=0.31 vs 0.33),其领域均值对RMSE的贡献差别巨大,说明辅助的领域级价值无法由单元级精度预判。其三,PP-TS用报告分类学的多层随机效应表达"分类学上越近的领域越相似",每层方差由数据估计。与已有工作的本质区别:先前收缩模型不结合单元级辅助、先前PPI不跨领域借力,本文第一次把两者级联成统一的两阶段估计量,并配上无需oracle即可自证的去偏CV得分。
方法步骤详情
第一步,定义总体与目标:把评估集视为有限总体 $U$(benchmark的9,324道题或68,371条对话),报告维度切成 $m$ 个领域,目标为 $\theta_i=\frac{1}{N_i}\sum_{j}y_{ij}$。第二步,抽样:以领域为层、按 $N_i$ 比例分配做分层简单随机抽样(实验取10%预算,100次重复)。第三步,直接估计:计算各领域HT估计 $\hat{\theta}^{HT}_i$ 与方差 $d_i$(含有限总体修正)。第四步,GREG:在标注单元上对 $y$ 关于辅助 $f$ 做加权最小二乘得斜率 $\hat{\lambda}$,计算 $\hat{\theta}^{GREG}_i$ 及其方差。第五步,平滑:以GREG估计为输入拟合PP-S(平坦先验的贝叶斯推断),有分类学时用PP-TS(diffuse normal+inverse-gamma先验),以后验均值为点估计、credible interval为区间。第六步,验证:分层切成K=5折,每个候选留一折拟合,计算调整CV得分并加去偏项(GREG用残差二元方差估计、平滑模型用后验方差一阶近似),按流量份额加权汇总到RMSE尺度,选出得分最低者并报告误差。
技术新颖性
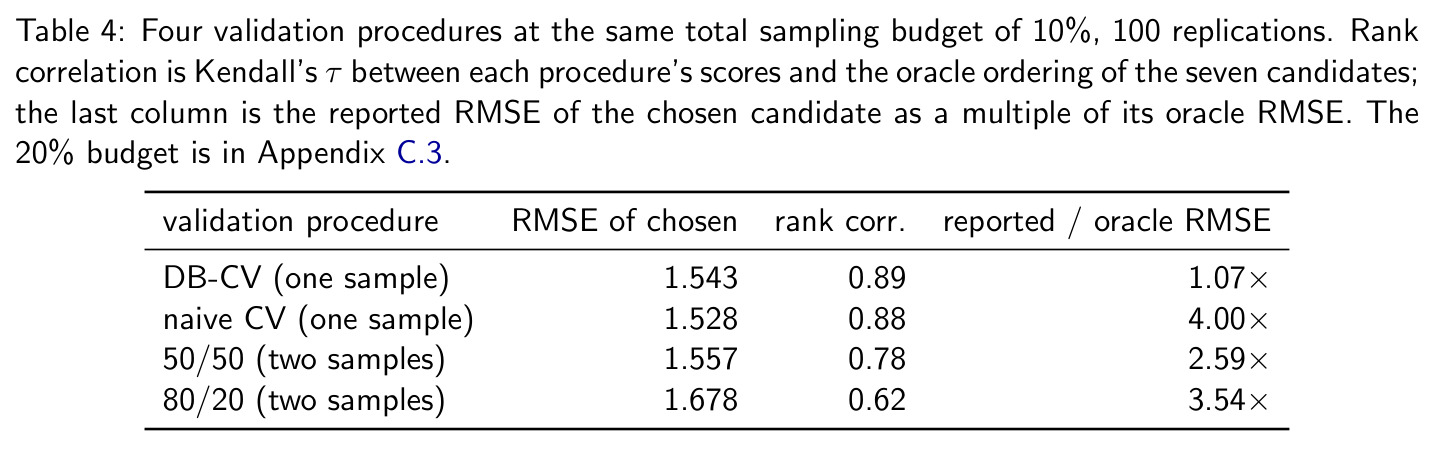
技术新颖性体现在四处。第一,PP-S把调查统计学中Gao & Wakefield (2024)的smoothed model-assisted估计量思想系统化并首次引入AI评估语境,实现PPI++/GREG与Fay–Herriot的级联——此前PPI类方法从不跨领域借力,收缩模型从不以GREG为输入。第二,PP-TS把AI评估的任务分类学显式建模为多层随机效应,推广了多重Fay–Herriot(Torabi & Rao 2014等),且各层方差 $\sigma_r^2$ 自适应估计,无用层级自动消失。第三,验证端对DB-CV的改进是实质性贡献:用近似无偏得分替换Dong & Li (2026)的保守偏倚界,并闭式导出各候选与HT的协方差(平滑模型用后验方差做一阶近似);原方法在PRISM上因界太保守全部弃权,改进后报告误差仅为oracle的1.07倍。第四,把benchmark评估与部署流量监控统一为同一个有限总体估计问题,本身是概念层面的贡献。
实验结果
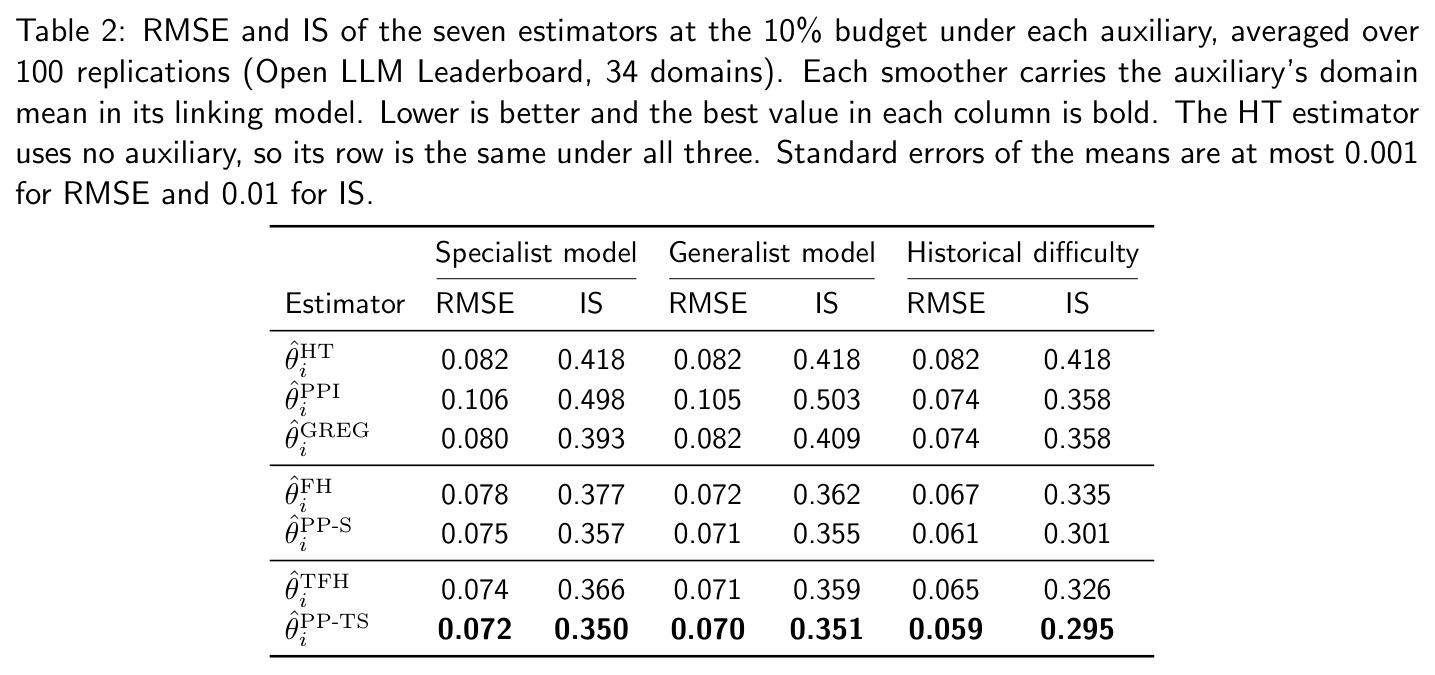
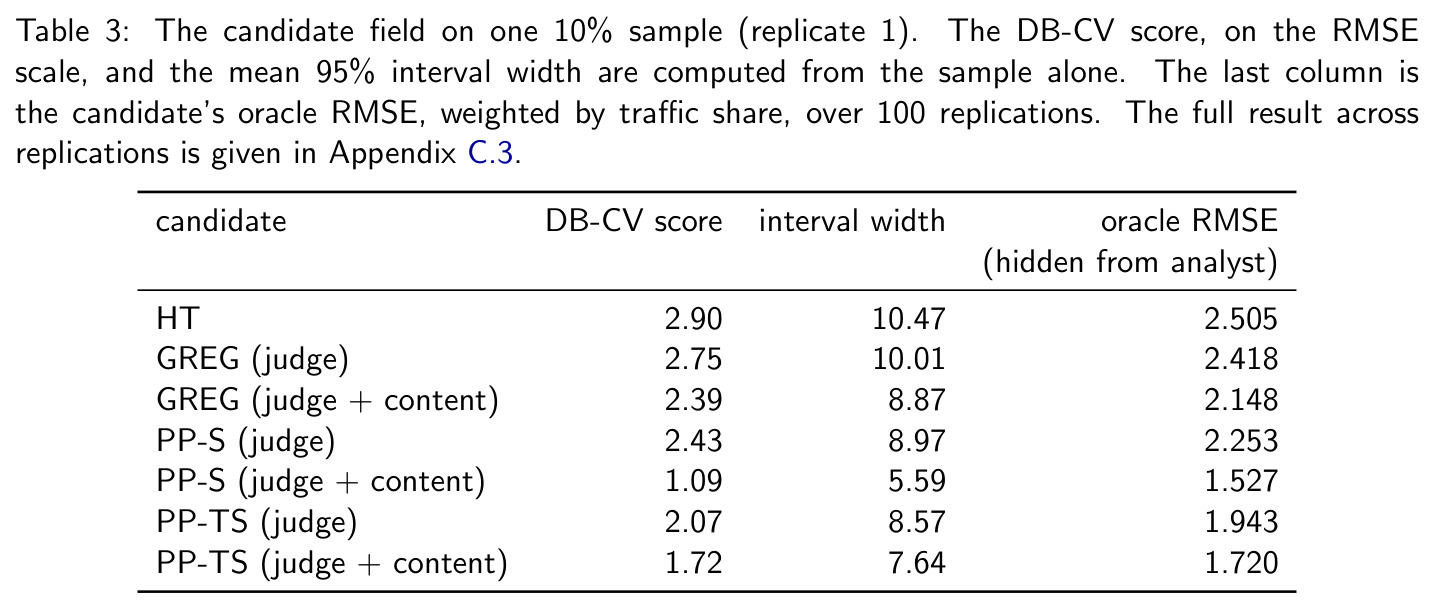
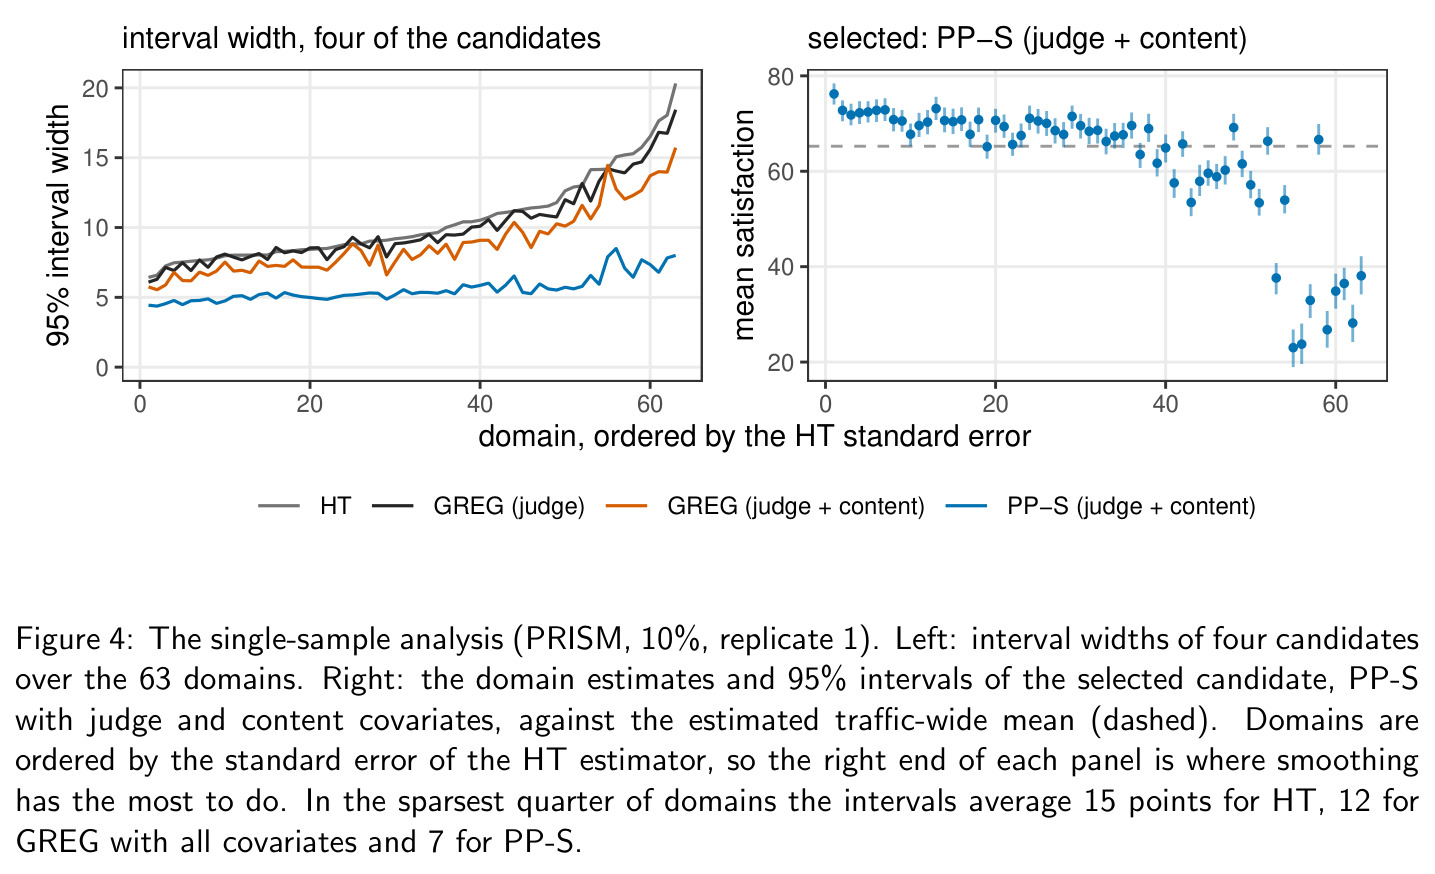
benchmark研究(Open LLM Leaderboard,评估phi-4在34个任务类型上的准确率,10%预算932标签约27个/领域,100次重复):三种辅助下PP-TS全部最优。历史难度辅助(单元级相关0.61)下RMSE从HT的0.082降到PP-S的0.061、PP-TS的0.059(降约28%),区间分数IS从0.418降到0.295;弱辅助下PPI(RMSE 0.105–0.106)反而比HT差,GREG靠把斜率调到约1/3保住HT水平,PP-S/PP-TS仍显著改进(specialist下0.075/0.072)。所有估计量覆盖率在0.93–0.95。组件分解(Figure 3)显示:单纯收缩几乎无增益,最大增益来自领域级协变量,分类学再吸收specialist不均匀的领域误差。PRISM研究(63领域,10%预算6,837标签,judge为gpt-5-nano,单元级相关0.40、领域均值相关0.93):DB-CV选出PP-S(judge+content),7个候选得分排序与oracle RMSE完全一致,其oracle RMSE 1.527对HT的2.505;最稀疏四分位领域区间宽HT约15点、PP-S仅7点。验证对比(Table 4):DB-CV报告误差仅为oracle的1.07倍(naive CV 4.00倍、50/50拆分2.59倍),Kendall τ=0.89最高,选择质量与花双倍样本的50/50拆分相当。
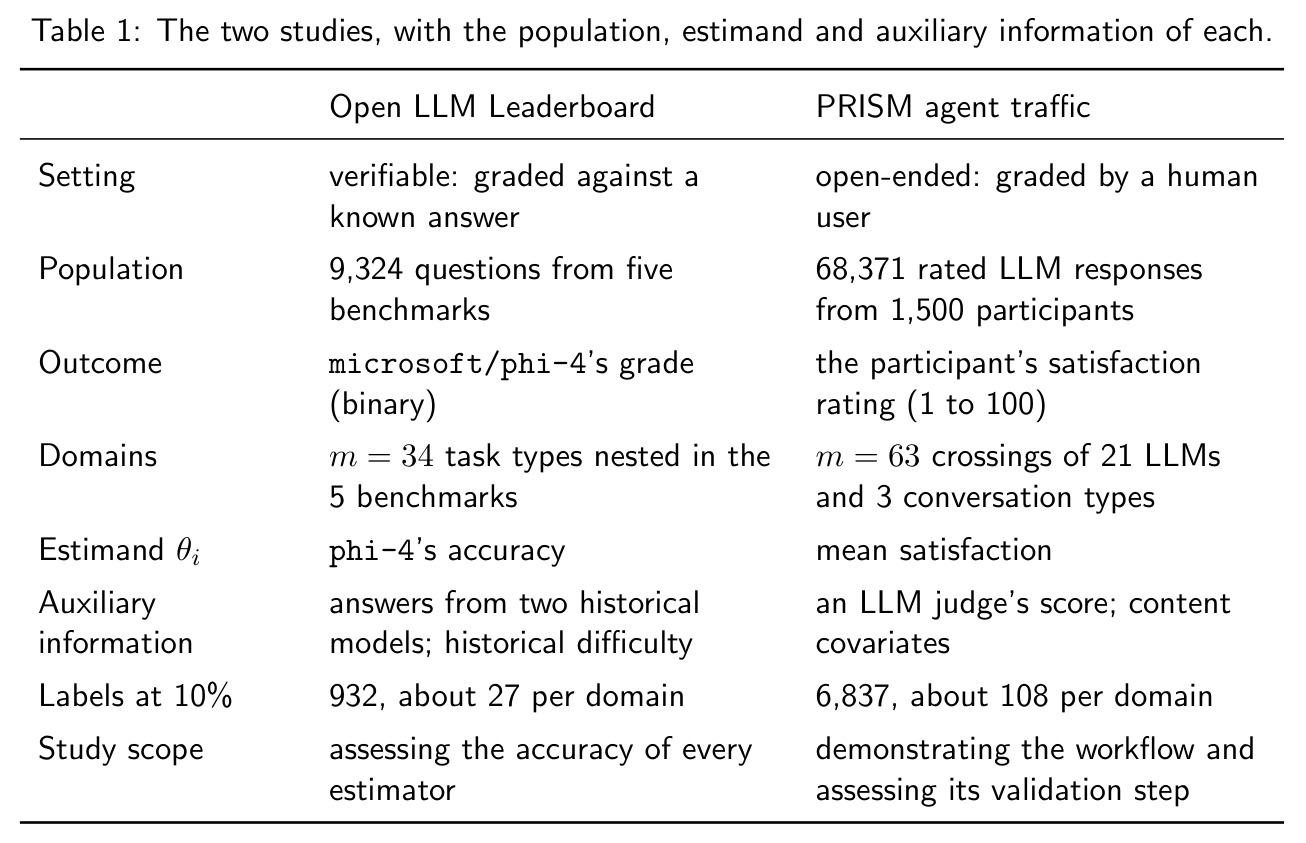
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Open LLM Leaderboard 34个任务类型准确率估计(历史难度辅助) | 加权RMSE(100次重复均值) | PP-TS 0.059(PP-S 0.061) | HT 0.082(PPI 0.074,GREG 0.074) | PP-TS较HT降低约28%,较最强直接估计量降低约20% |
| Open LLM Leaderboard 区间估计 | 区间分数 IS(α=0.05,越小越好) | PP-TS 0.295 | HT 0.418 | 降低约29%,同时覆盖率保持在0.93–0.95 |
| PRISM 63领域满意度均值估计(单样本工作流) | oracle RMSE(流量份额加权) | DB-CV选中的PP-S(judge+content) 1.527 | HT 2.505 | 降低约39%;DB-CV得分排序与oracle完全一致 |
| 验证程序的误差校准(PRISM,10%总预算) | 报告RMSE / oracle RMSE(100次重复) | DB-CV 1.07×(Kendall τ=0.89) | naive CV 4.00×,50/50双样本2.59×,80/20为3.54× | 误差高估从约4倍降至7%,且单样本达到双样本的选择质量 |
局限与改进
作者承认的局限:Fay–Herriot的抽样模型是小领域最薄弱处的中心极限近似,链接模型误设的代价也恰好集中在最需要借力的小领域(虽然 $d_i\to 0$ 时设计一致性保证收敛到直接估计);零标签领域的评估何时可靠仍是开放问题;DB-CV的协方差公式依赖方差参数已知时的后验方差与一阶近似。我的补充观察:外部效度仅由两个数据集支撑,评估对象只有phi-4的准确率与PRISM满意度两个指标;分类学需要人工预先指定,层级结构错误的影响未做压力测试;PP-S的后验区间是贝叶斯式构造,其频率覆盖率0.93–0.95仍系统性略低于名义0.95;LLM judge本身的调用成本未纳入抽样预算的权衡,且judge单元级相关仅0.40,说明弱辅助场景下流程对内容协变量的依赖上升;100次重复×多候选×5折的贝叶斯重拟合虽算力不大,但对更大规模领域数的扩展性未验证。
独立分析的弱点
第一,链接模型是线性的:领域均值与协变量的关系若呈非线性(如任务难度与通过率的饱和关系),线性 $x_i^\top\beta$ 会系统性把估计收缩向错误方向,可改用高斯过程、BART等非参链接,而DB-CV框架天然支持比较这类候选。第二,分类学结构由人工指定:若基准的分类学本身不合理,PP-TS的层随机效应会编码错误的邻接关系,虽然 $\sigma_r^2\approx 0$ 能自保,但"从数据中学习领域邻接结构"(图结构先验、谱聚类初始化)是明确的改进方向。第三,PPI在弱辅助下RMSE恶化约29%(0.106 vs 0.082),说明从业者若无验证工具很容易误选估计量——本文的DB-CV恰是解药,但论文没有展示"用DB-CV在多种辅助变量之间做选择"的实验,这是最自然的补充。第四,评估对象单一(phi-4准确率、满意度一个指标),对更强模型、上百个领域的极端稀疏场景,收缩行为与覆盖率未做规模敏感性分析。第五,去偏得分依赖K=5折与各候选的闭式协方差,遇到自适应或黑箱估计量需要换数值协方差估计,稳健性待检验。
未来方向
作者明确提出的方向:零样本/无标签领域评估——只要领域级协变量可得,平滑模型可直接外推其性能,但何时可靠待研究;把开放式任务的评分者分歧按调查测量误差理论纳入不确定性(Hansen et al. 1961传统),使区间反映"评分是主观判断"这一事实;用概率样本校准部署系统产生的大规模非概率样本(如被flag的对话),抵御选择偏倚;更广泛地深化AI评估与调查方法学的整合。基于本文成果可延伸的:把DB-CV与自适应抽样(Wu et al. 2026)结合,让"选估计量"与"选下一批标注单元"联合优化;把分类学随机效应推广到一般图结构先验;在多模型排行榜场景对"模型×领域"矩阵做二维平滑;系统研究judge质量、领域数、预算三者的联合缩放规律,产出抽样预算规划指南;把整套估计+验证工作流封装为评估平台组件,自动输出模型选择与校准的误差报告。
复现评估
复现条件相当好。代码完整开源(github.com/sho-kawano/disagg-ai-eval),论文中每张图和表都可复现;仓库附带处理好的Open LLM Leaderboard题×模型表(整理自Wu et al. 2026的公开数据,原始终榜记录散落在数千个文件中,这个整理本身就有价值),以及流量研究使用的预计算LLM judge分数和冻结的judge prompt,避免了复现judge调用。PRISM数据集公开在Hugging Face(HannahRoseKirk/prism-alignment)。计算需求低:领域数仅34/63,Fay–Herriot类贝叶斯模型规模很小,单台CPU机器即可完成100次重复×7候选×5折的全部实验。难点不在算力而在统计实现细节:需正确处理分层抽样权重、含有限总体修正的方差估计、PP-TS的先验设定与MCMC收敛诊断;对有调查统计或贝叶斯层级模型经验的团队,复现难度中等偏低;论文以均值并给出标准误上限(RMSE标准误≤0.001)报告,便于逐表核对。
论文图表
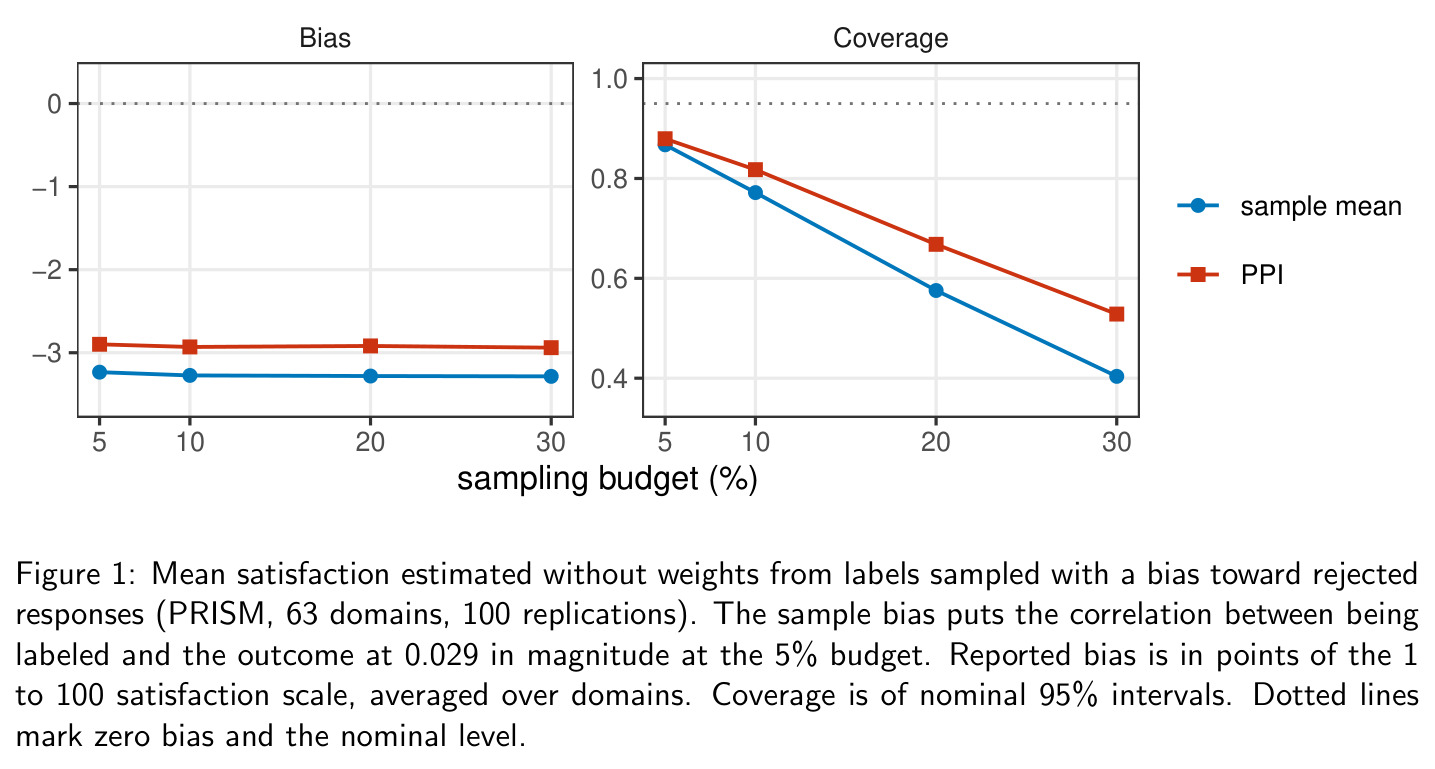
在PRISM的63个领域上模拟非概率抽样——被参与者拒绝的回答以约2倍概率被抽中——再不加权地用样本均值估计平均满意度:左图显示偏差(1–100满意度量表上的点数,按领域平均)在5%–30%预算下持续存在且不随预算收敛到零,量级与典型线上自愿调查样本相当;右图显示名义95%区间的实际覆盖率远低于0.95,样本均值和PPI都救不回来。
这张图是全文动机的实证支柱:它证明抽样设计错误引入的偏差既无法靠加大预算消除、也无法靠PPI修正,从而论证概率样本是一切有效不确定性量化的前提,为后文所有方法奠定边界条件。