别屏蔽环境:观察监督改变强化学习智能体的探索方式 Don't Mask the Environment: Observation Supervision Changes How Agents Explore Under RL
SFT时取消对环境观察的损失掩码,零成本让GRPO后智能体探索更强、pass@k更高
前置知识
SFT 损失掩码(loss mask)
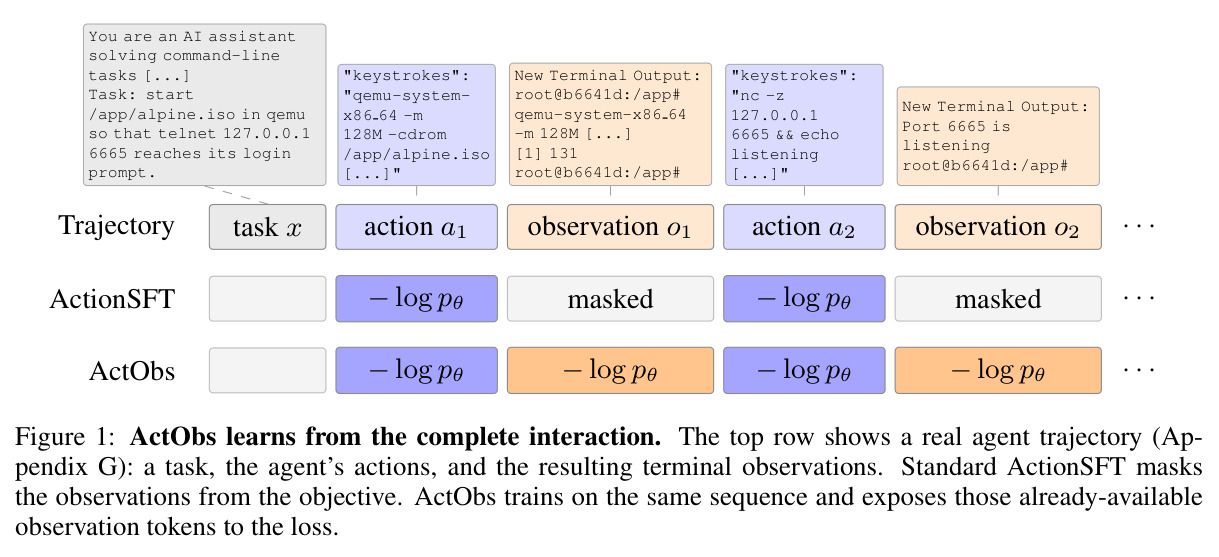
监督微调把整条序列喂给语言模型做 next-token 预测,但只对被掩码选中的 token 计算交叉熵并回传梯度;prompt 通常被 mask,智能体训练管线的惯例是只保留助手生成的动作 token、屏蔽环境观察。掩码是纯数据侧选择,不改变模型结构、数据量或前向计算。
ActObs 的全部改动就是打开观察 token 的掩码,理解掩码机制才能理解论文'零成本、一行改动'的主张及其对照设计。
pass@k 与无偏估计
对每个任务采样多次后,用 Chen et al. (2021) 的组合无偏估计量计算'k 次尝试内至少一次成功'的概率。k=1 反映单次可靠性,k 越大越依赖策略分布的宽度(还有多少合理动作保有一定概率)而非峰值。
论文所有结论都以 pass@k 曲线表达,pass@1 与 pass@16 的分化是核心证据,不看懂 pass@k 就无法理解'用单次可靠性换采样上限'的权衡。
GRPO 与 RLVR
GRPO(DeepSeekMath 提出)对同一 prompt 采样一组 rollout,用组内平均奖励作基线计算优势并做策略梯度更新,免去价值网络;RLVR 指用可验证奖励(单元测试、任务验证器)驱动 RL。本文 RL 阶段即 GRPO,二值奖励,每任务 16 条 rollout。
'SFT 初始化不同、GRPO 配方完全相同'是全文实验设计的基础,所有差异都被归因到初始化上。
策略熵与熵坍缩
策略在 token 级输出分布的不确定性。RLVR 训练中熵通常随奖励上升而下降(熵坍缩),概率集中到少数高奖励路径,常提升 pass@1 却缩小大 k 下的可解任务集合(Yue et al. 2025、Wu et al. 2025 等的发现)。
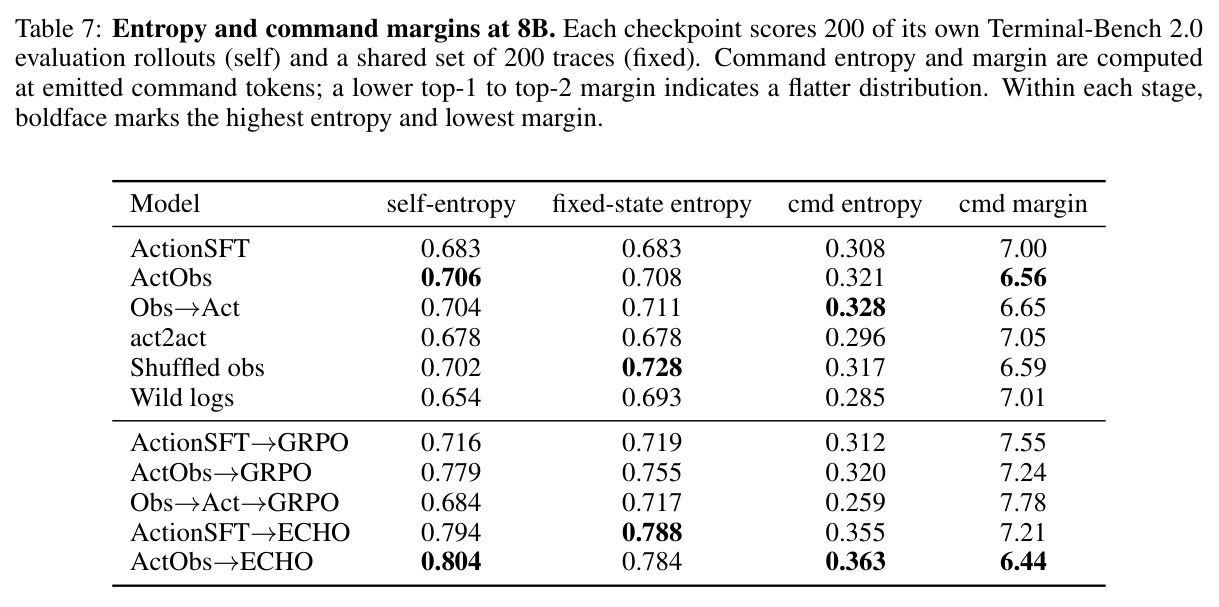
ActObs 的机制解释核心:它在 RL 中保留更多熵、更少坍缩,从而扩大重复采样能覆盖的任务范围。
KL 散度(策略位移)
度量两个分布差异的量 $D_{\mathrm{KL}}(p \Vert q) = \sum_i p_i \log(p_i / q_i)$。本文在固定 200 条共享轨迹的动作 token 上计算 $\mathrm{KL}(\pi_{\mathrm{init}} \Vert \pi_{\mathrm{final}})$,衡量 RL 端点相对其 SFT 初始化移动了多远。
'ActObs 位移更小'是解释其保留熵并获得高 pass@k 的关键观测之一,没有这个度量就无法理解'更少策略移动'的论断。
世界模型(world model)
学习预测环境对动作的响应(下一状态)的模型,传统上用于规划、想象式 rollout 或表征学习;在文本智能体中即预测下一观察文本 $p_\theta(o_t \mid h_t, a_t)$。
ActObs 本质是把'免费的文本世界模型信号'注入 SFT,与 ECHO、Early Experience、Qwen-AgentWorld 等一系列工作的异同对比都围绕这个概念展开。
研究动机
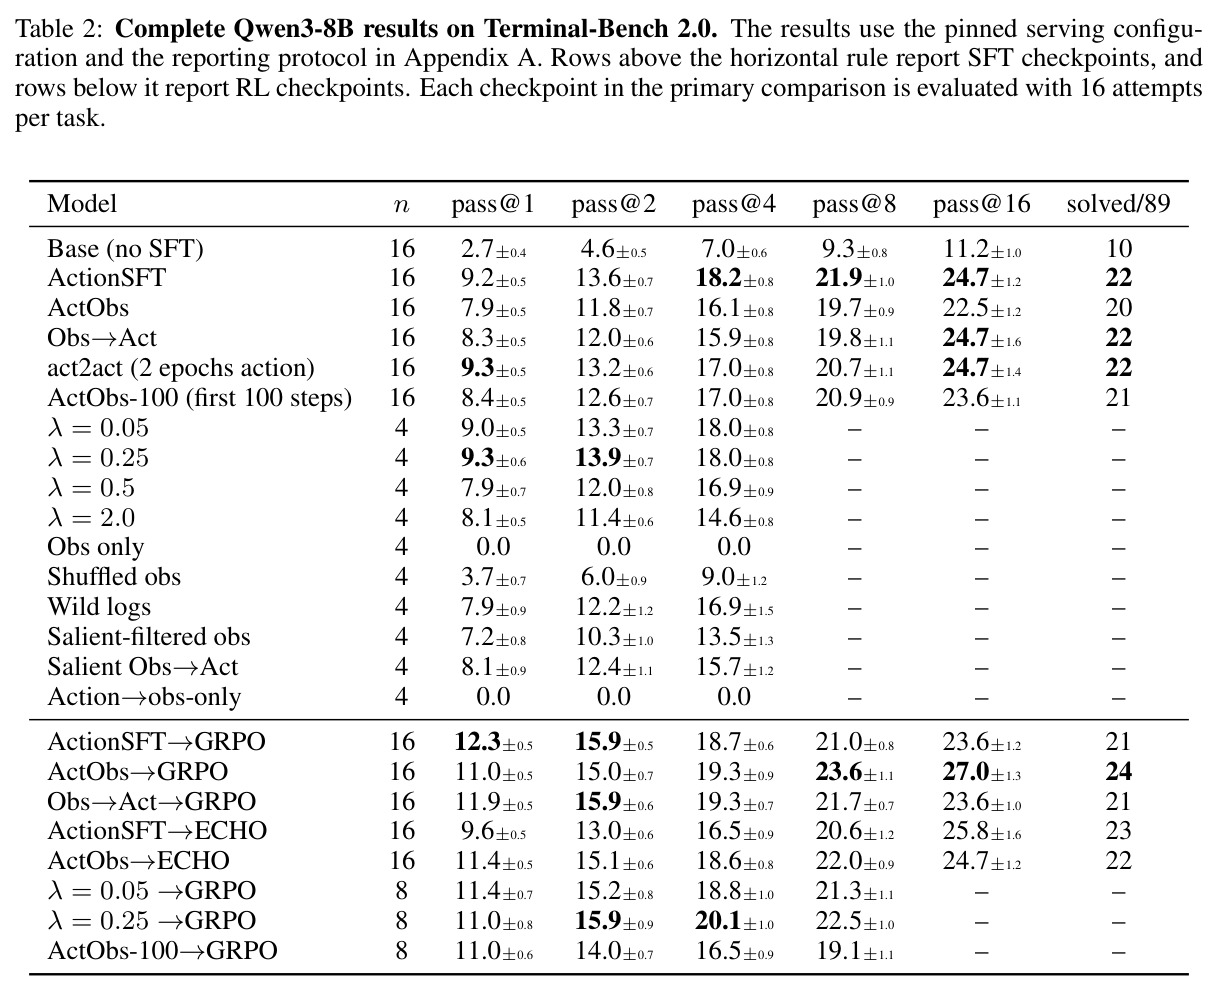
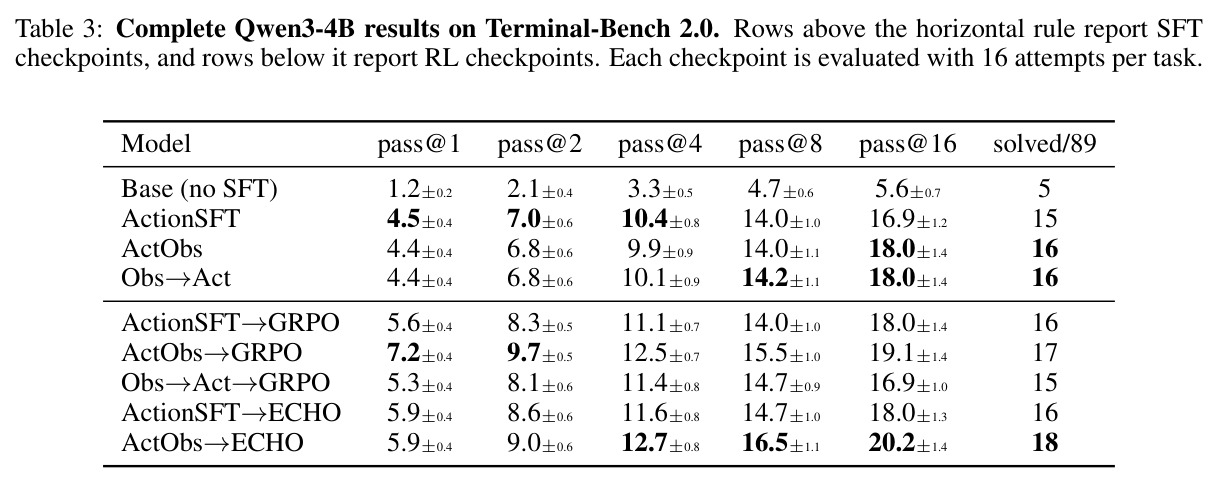
主流语言智能体训练管线(AgentTuning、Agent-FLAN、FireAct 等)在对多轮轨迹做 SFT 时有一个几乎从未被质疑的惯例:损失只施加在智能体自己生成的动作 token 上,环境返回的观察(如终端输出)只作为上下文参与注意力,却从不作为预测目标。这看起来理所当然——部署时策略只产出动作而不产出环境输出——但它隐含一个未经检验的假设:读懂环境反馈有用,学会预测它没用。当 SFT 只是后续 RL 的初始化时,问题被放大:论文实测 ActionSFT 之后模型对终端反馈的预测能力甚至低于未微调的 base 模型,说明单边监督造成了对动作模仿的'单边特化',覆盖了预训练中关于动作后果的知识。更麻烦的是,这一缺陷完全无法从 SFT 后的基准分数看出:三种初始化在 Terminal-Bench 2.0 上 pass@1 几乎持平(4B 为 4.4–4.5%),但经过完全相同的 GRPO 后却分化出 29% 的相对差距(pass@1 5.6% vs 7.2%)。'当下表现相近'掩盖了'下游可学习性'的巨大差异。
本文的目标是论文要回答一个具体问题:把专家轨迹中本来就存在的观察 token 纳入 SFT 损失(即 ActObs),能否为后续强化学习提供一个更好的初始化?作者希望在不增加任何数据、参数、序列长度、前向传播次数,也不改动 RL 算法的前提下,仅通过修改损失掩码来隔离'观察监督'这一个变量,并系统量化其对三件事的影响:一是 GRPO 后在同一评测(Terminal-Bench 2.0,89 个任务)各采样预算 k 下的 pass@k;二是向训练全程未见过的跨域任务(aider-polyglot 的 225 个多语言代码编辑任务)的迁移能力;三是机制层面——SFT 检查点的梯度几何、RL 过程中的熵动力学与策略位移,从而解释'为什么 SFT 分数相同、RL 结局不同'。
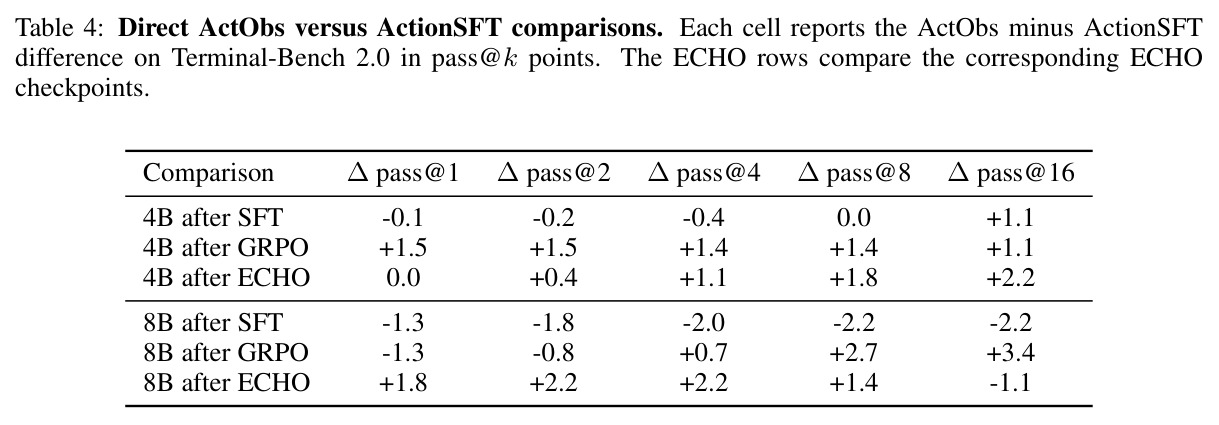
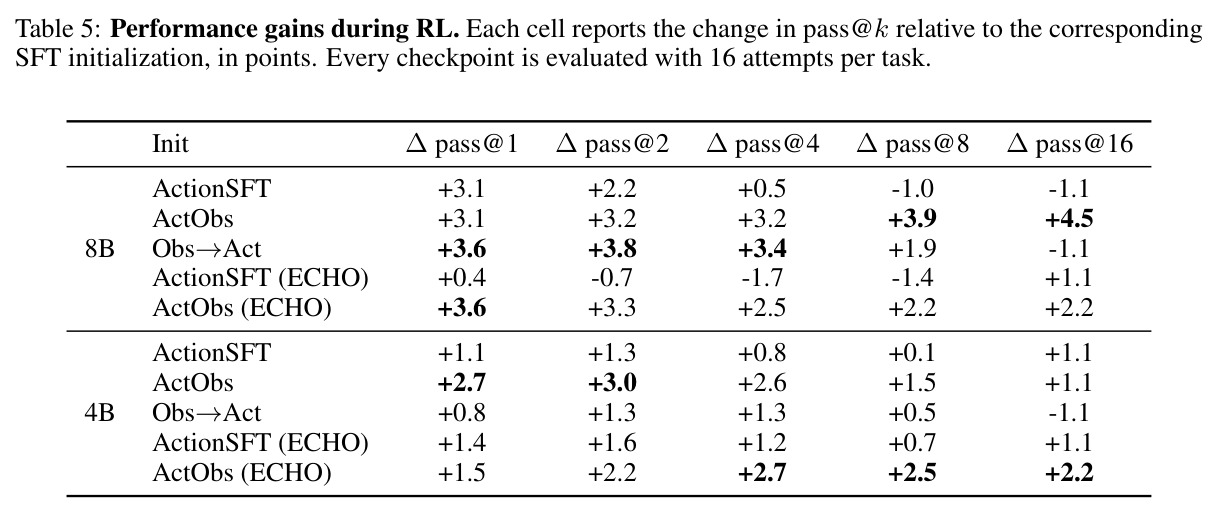
与已有工作不同的是,本文的独特之处在于把干预点放在所有世界模型工作都忽略的一个'一行代码'的选择上。与 Early Experience(先收集新转移再顺序训练)、SPA(自博弈插入状态描述)、From Word to World / Qwen-AgentWorld(世界模型预热)等需要额外数据、额外阶段或推理时模拟器的方法不同,ActObs 只是把同一批专家轨迹中已有的观察 token 取消 mask;与 ECHO、PaW、TAPO 在 RL 内部加观察预测损失不同,它的监督只发生在 SFT,且与 ECHO 可叠加。论文还设计了关键的时序对照 Obs→Act:先一整个 epoch 只学观察、再一整个 epoch 只学动作,观察监督总量与 ActObs 相同,结果 pass@16 落后 2.2(4B)到 3.4(8B)个点,证明起作用的不是'见过观察'而是'动作与观察联合优化'。再配合梯度余弦/范数比诊断、固定状态熵探针、推理温度匹配等归因实验,把'初始化如何塑造 RL 探索'这个抽象问题落到了损失掩码这一可操作的旋钮上。
核心方法
直觉上,一条成功的智能体轨迹同时记录了两件对齐的事:专家做了什么、环境随后变成什么样。预测观察 $o_t$ 必须隐式回答'动作 $a_t$ 对环境产生了什么影响',因此同一条轨迹可同时充当模仿样本与状态转移样本。技术上,设轨迹 $\tau = (x, a_1, o_1, \ldots, a_T, o_T)$,$A$、$O$ 为动作与观察 token 下标集合,ActObs 最小化 $$\mathcal{L}_\lambda(\theta) = -\frac{\sum_{i \in A} \log p_\theta(y_i \mid y_{<i}) + \lambda \sum_{i \in O} \log p_\theta(y_i \mid y_{<i})}{|A| + \lambda |O|},$$ 其中 $\lambda = 0$ 退化为 ActionSFT,默认 $\lambda = 1$,prompt 始终 mask,分母保持单样本损失量级不变。训练语料为 Nemotron-Terminal-Corpus 合成部分的 5 万条多轮终端轨迹(0.71B token,DeepSeek-V3.2 生成,观察占约 45%),微调 Qwen3-4B/8B 一个 epoch(781 步、batch 64、峰值学习率 $10^{-5}$);随后统一跑 GRPO 135 步(2,392 个 Endless Terminals 容器任务,与 SFT 语料不相交,二值验证器、每任务 16 条 rollout、学习率 $10^{-6}$)。整个方法在实现上只是 label mask 的改动。
核心思想是:部署时永远不生成的观察 token,恰恰是最便宜、最免费的世界模型监督信号。这与直觉相反——既然模型从不输出观察,为什么要学预测它?论文的回答是,预测 $p_\theta(o_t \mid h_t, a_t)$ 迫使共享参数表征'动作的后果',而选择下一个动作用的正是同一套表征,因此后果建模能反过来塑造决策表示,防止 SFT 单边坍缩到动作模仿。与已有方法的本质区别有三:其一,它复用已有 token,不加新转移、新阶段、推理时模拟器;其二,监督发生在 SFT 而非 RL——ECHO 是在 GRPO 中对策略自己的 rollout 加权重 0.05 的下一观察预测损失,ActObs 与其正交且收益可叠加(在 8 个评测工作点中领先或持平 7 个);其三,动作与观察必须联合优化——Obs→Act 时序对照证明,同样的观察监督量分开训练就完全不复现收益。这把'世界模型帮助智能体'从需要额外基建的重型方案,简化为损失函数里的一行改动。
方法步骤详情
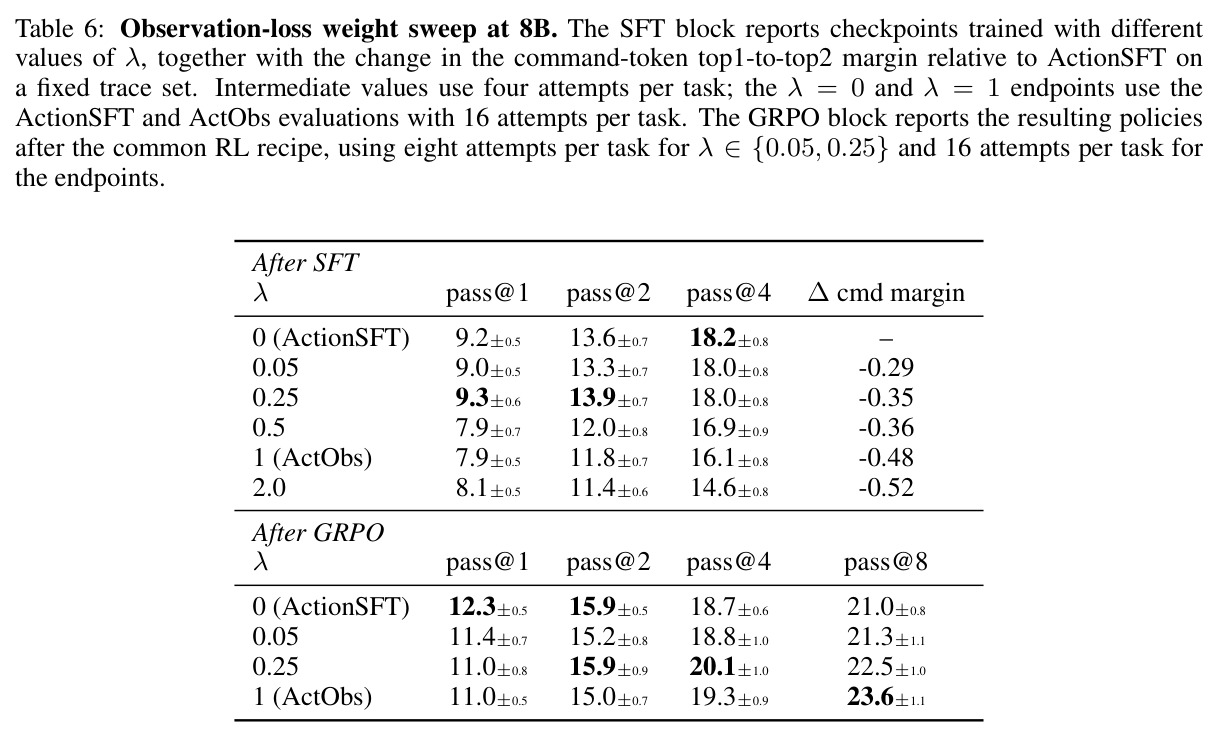
方法分六步。第一步,把轨迹 tokenize 为 $y_{1:N}$,划分动作/观察 token 集合 $A$、$O$,prompt 始终 mask。第二步,按式 (1) 训练三个 SFT 初始化:ActionSFT($\lambda=0$)、ActObs($\lambda=1$)、Obs→Act(先观察后动作的时序对照),外加消融:act2act、ActObs-100(仅前 100 步开观察损失)、shuffled obs(观察与错误动作配对)、wild logs(无关生产日志)、salient-filtered(只保留'重要'行)。第三步,对每个初始化用完全相同的 GRPO 配方训练 135 步,并用 ECHO 复跑作为'观察感知 RL'对照。第四步,在 Terminal-Bench 2.0(89 任务、16 attempts/任务)与 aider-polyglot(225 任务、4 attempts)上用无偏估计量计算 pass@k,20,000 次 bootstrap 给标准误。第五步,机制探针:SFT 中在 256 条 held-out 轨迹上分别计算动作/观察梯度并记录余弦相似度与范数比;RL 端点测自熵、固定状态熵与端点 KL;观察交叉熵按位置和内容分桶。第六步,扫描 $\lambda \in \{0, 0.05, 0.25, 0.5, 1, 2\}$。
技术新颖性
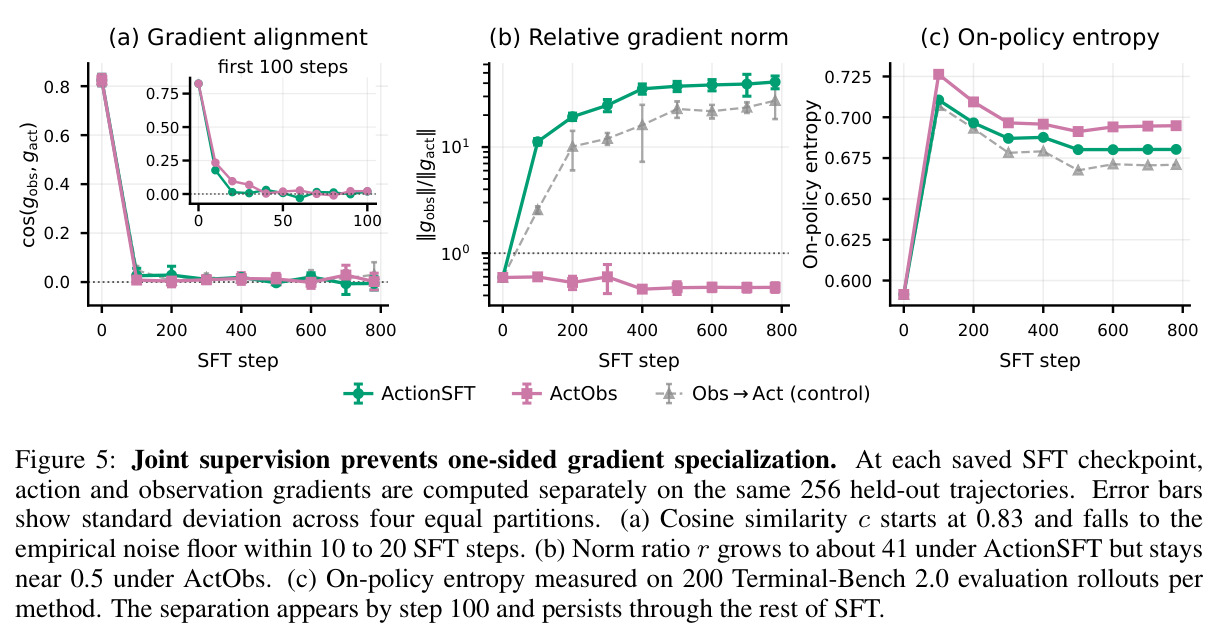
新颖性不在新损失本身,而在三点。第一,问题重定义:以往把'SFT→RL 迁移差'归因于数据量、过拟合或 RL 算法,本文证明仅'是否监督观察 token'就足以在 SFT 分数完全持平时,让 GRPO 后 pass@16 差 3.4 个点(8B:27.0 vs 23.6),把干预点从 RL 侧(clipping、熵正则、pass@k 目标)提前到 SFT 损失掩码。第二,机制证据链完整:动作与观察梯度的余弦相似度从 0.83 在 10–20 步内跌到噪声底,此后 ActionSFT 的 $r = \|g_{\mathrm{obs}}\| / \|g_{\mathrm{act}}\|$ 涨到约 41——动作方向已近平稳而正交的观察方向残留陡峭梯度无人优化;ActObs 把 $r$ 压在 0.5 左右,持续消耗式 $g_{\mathrm{obs}} = r\|g_{\mathrm{act}}\| c\, \hat{g}_{\mathrm{act}} + r\|g_{\mathrm{act}}\|\sqrt{1-c^2}\, \hat{g}^{\perp}_{\mathrm{act}}$ 中的正交分量。第三,严格排除法:时序对照、乱序观察(pass@1 掉到 3.7%)、无关日志、obs-only(解 0 题)、act2act(无法恢复)等一组对照,把'必须联合、必须真实配对、必须全程监督'三个必要条件钉死,这在同类研究中少见。
实验结果
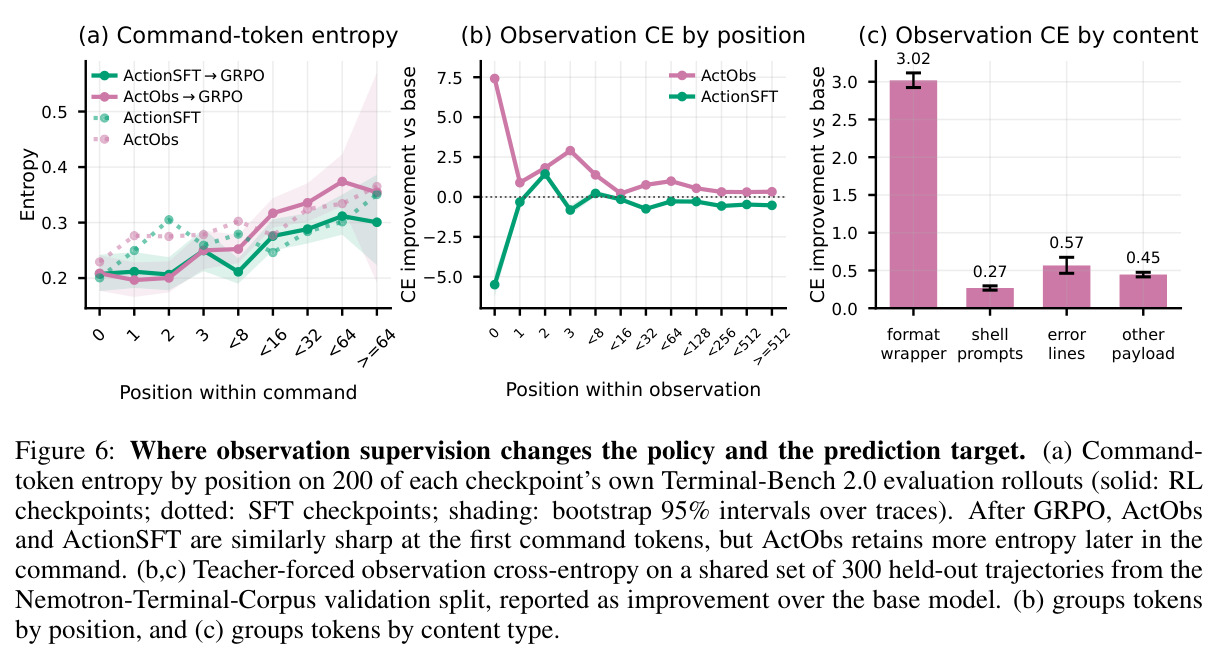
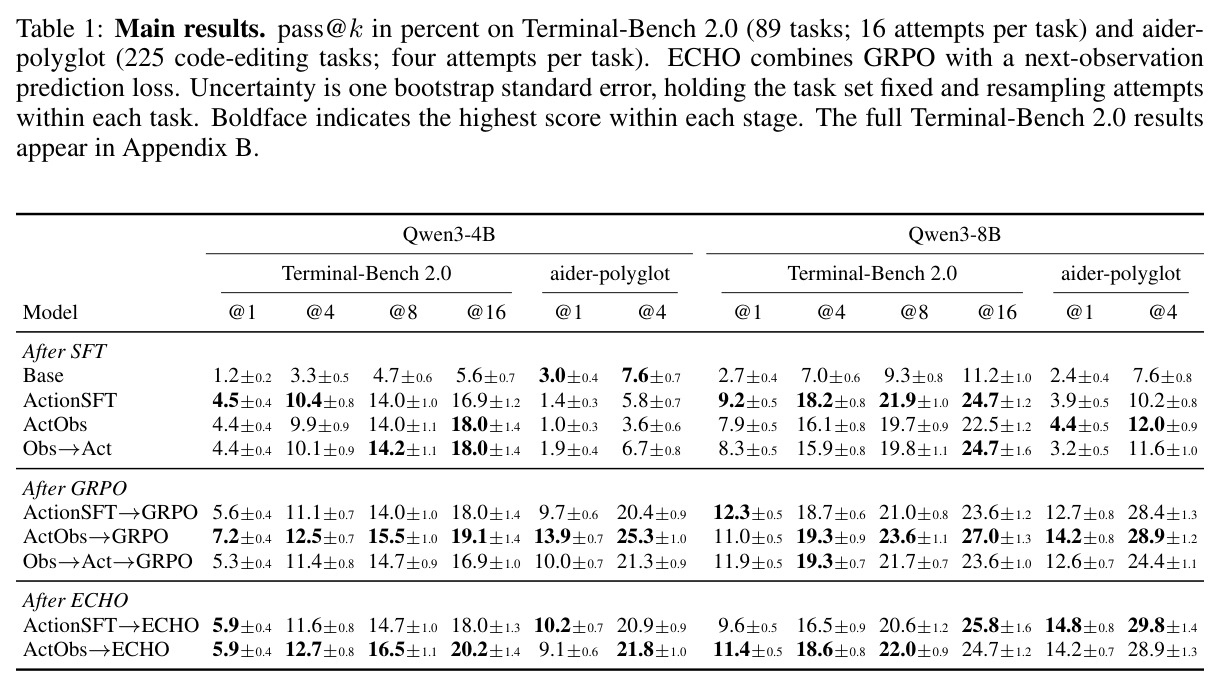
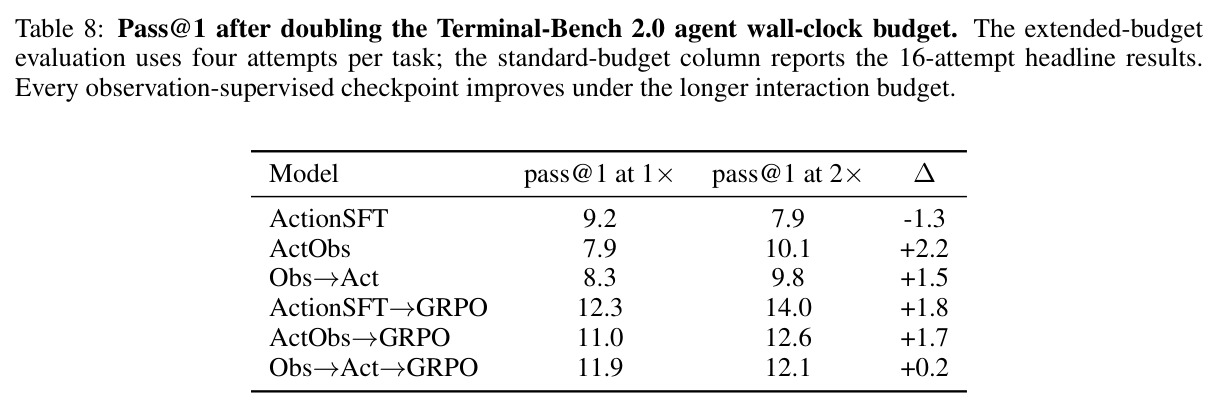
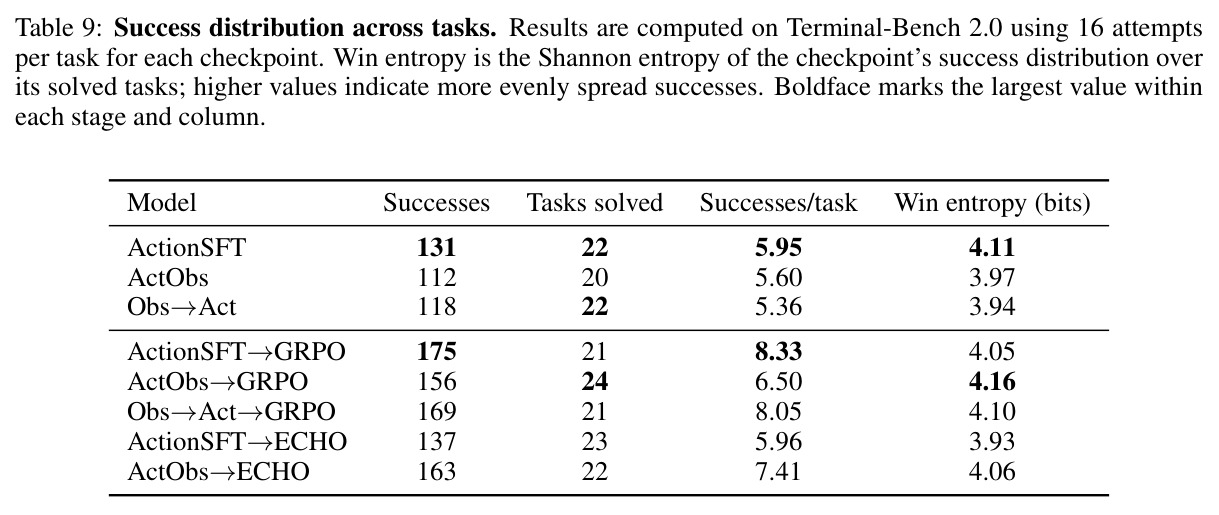
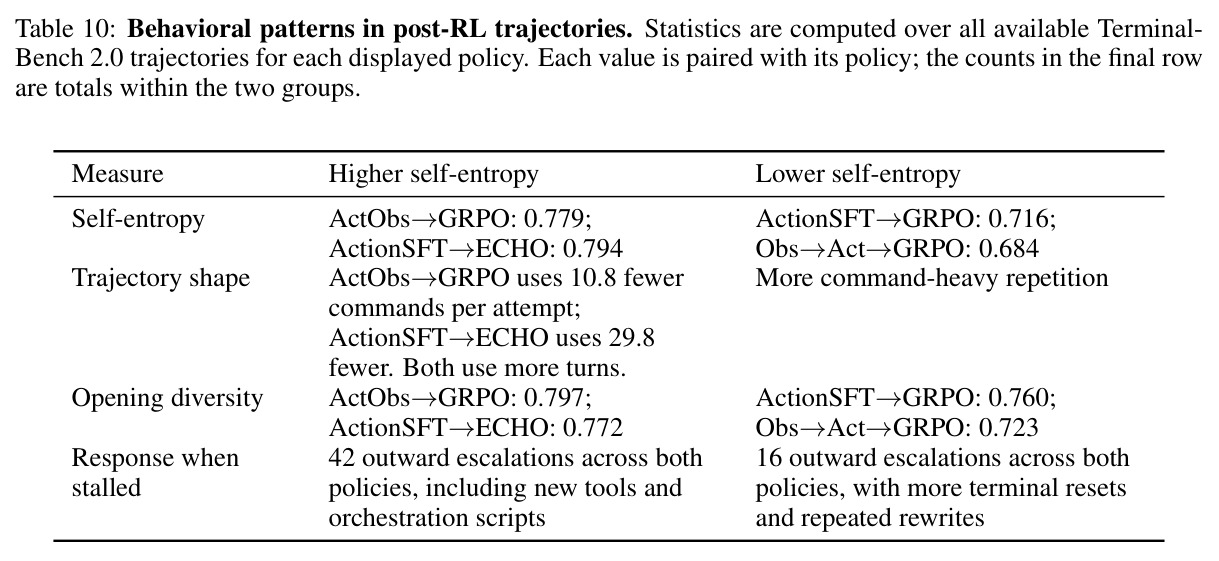
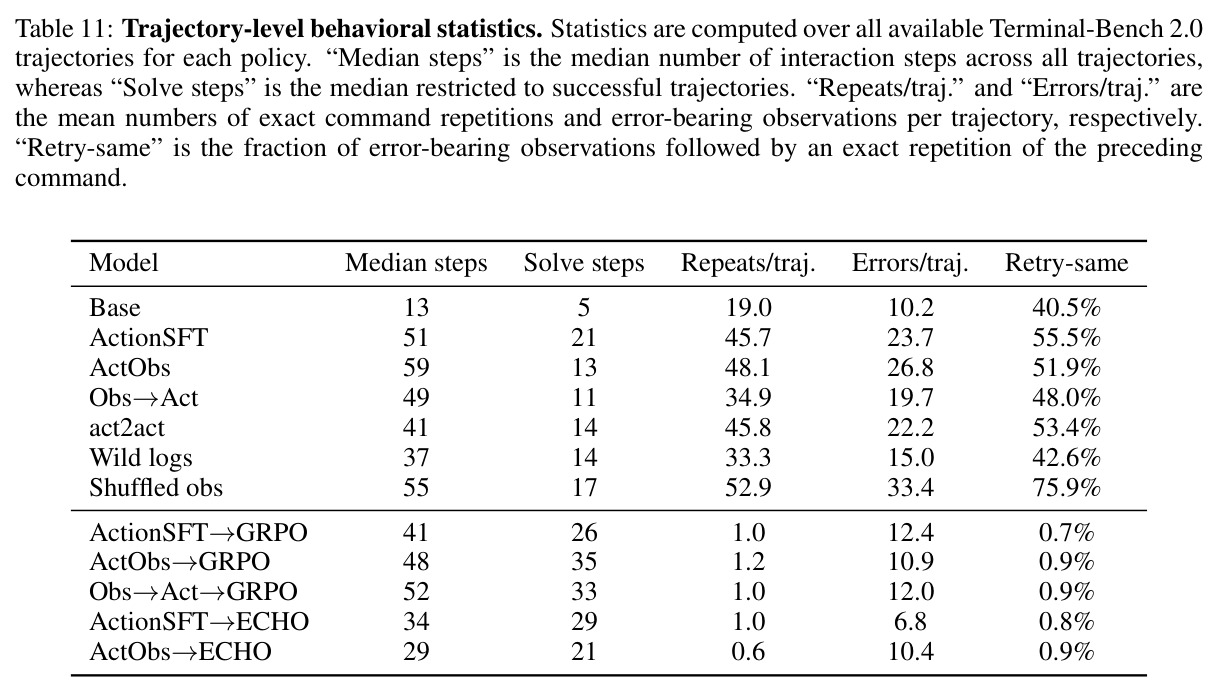
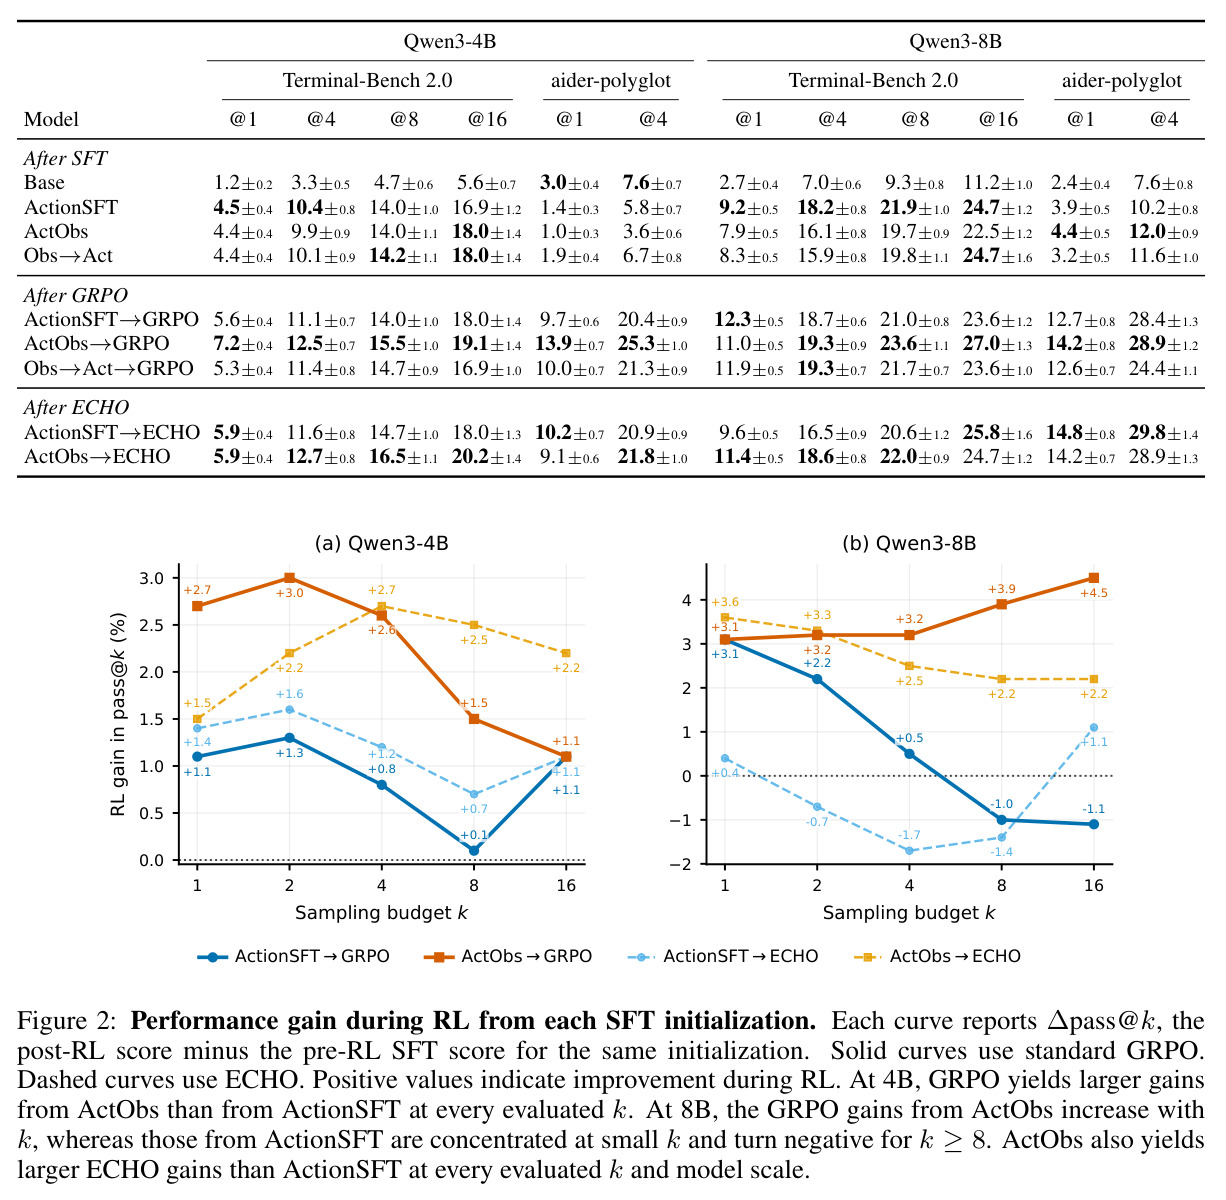
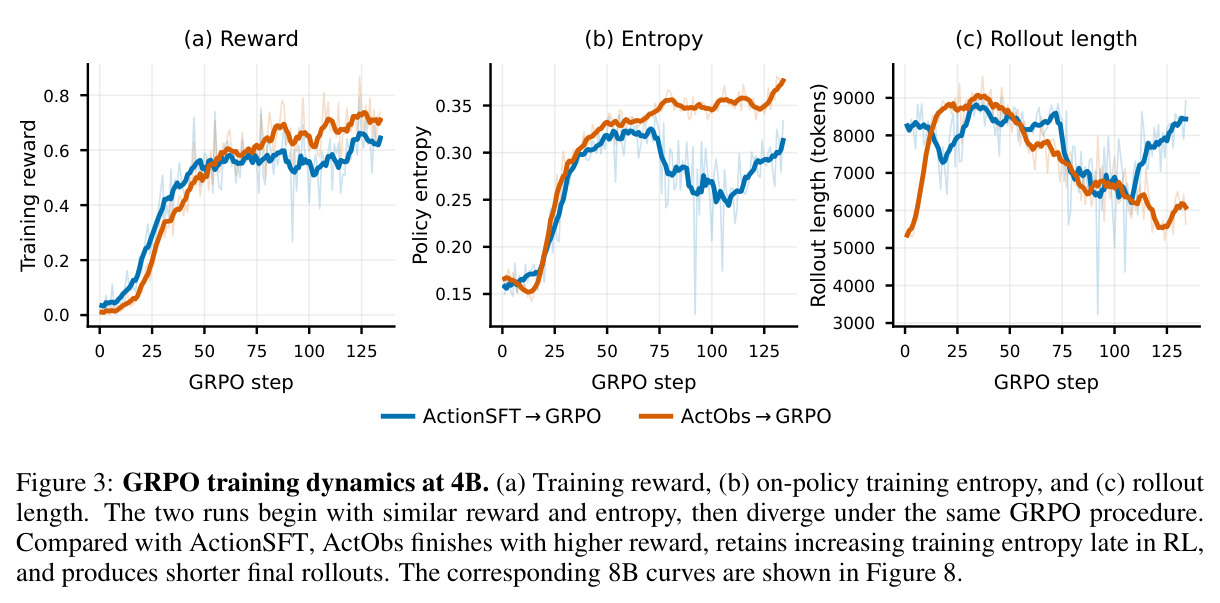
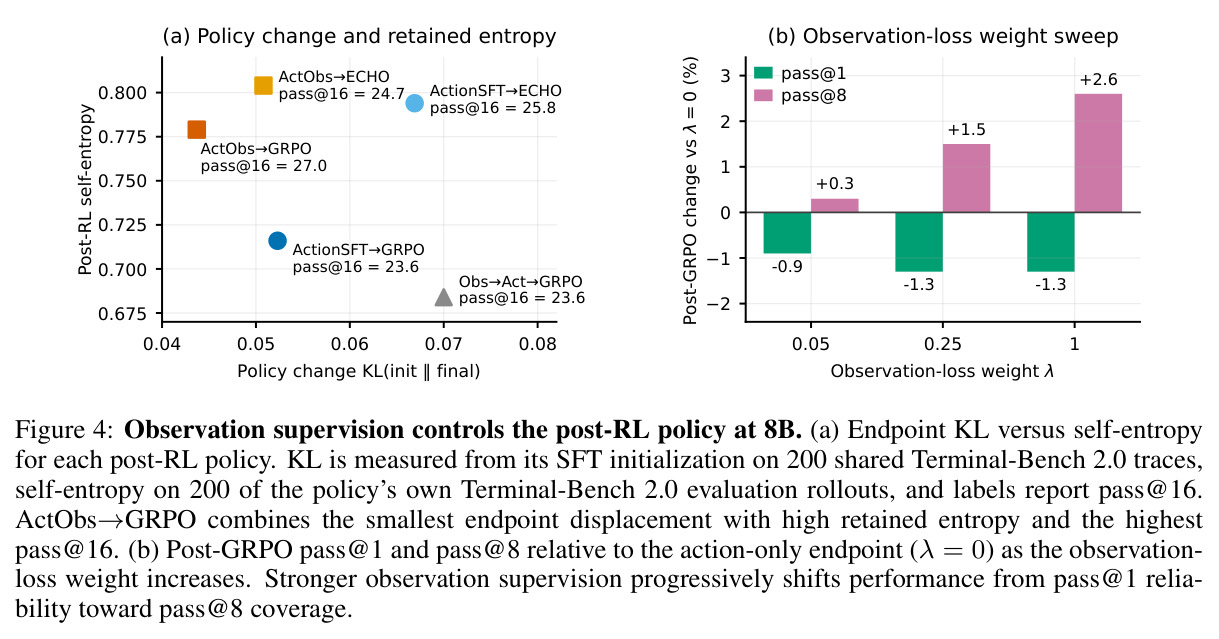
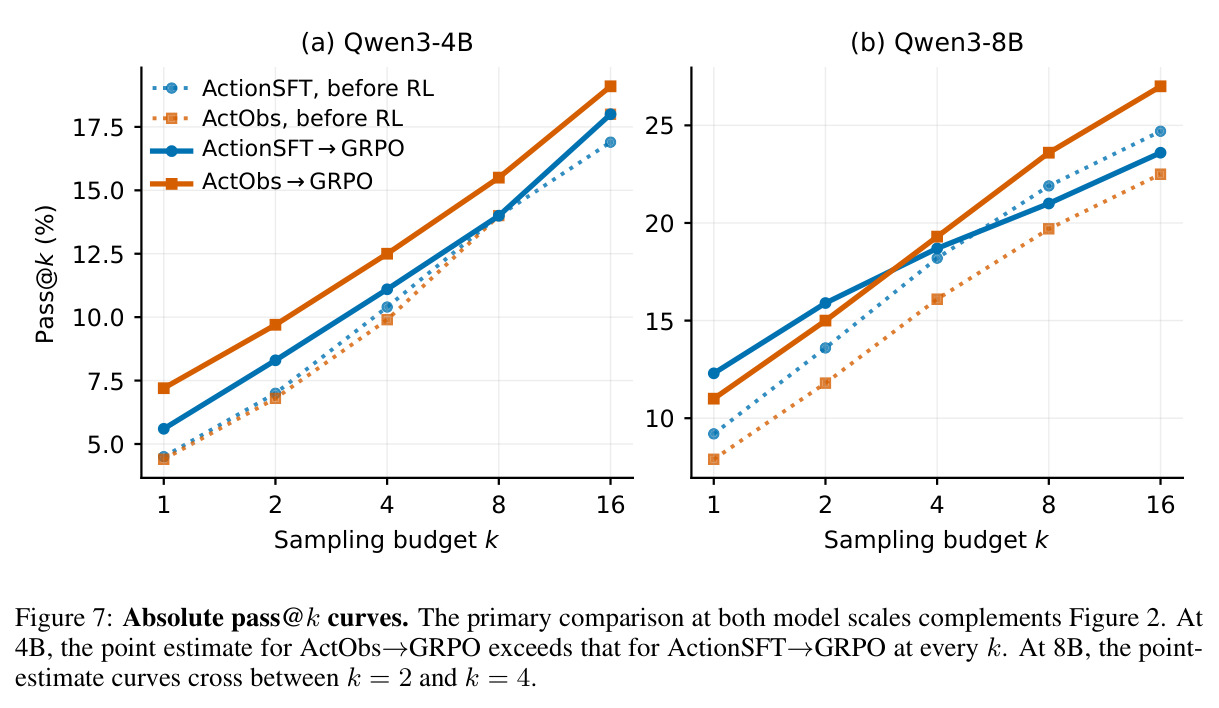
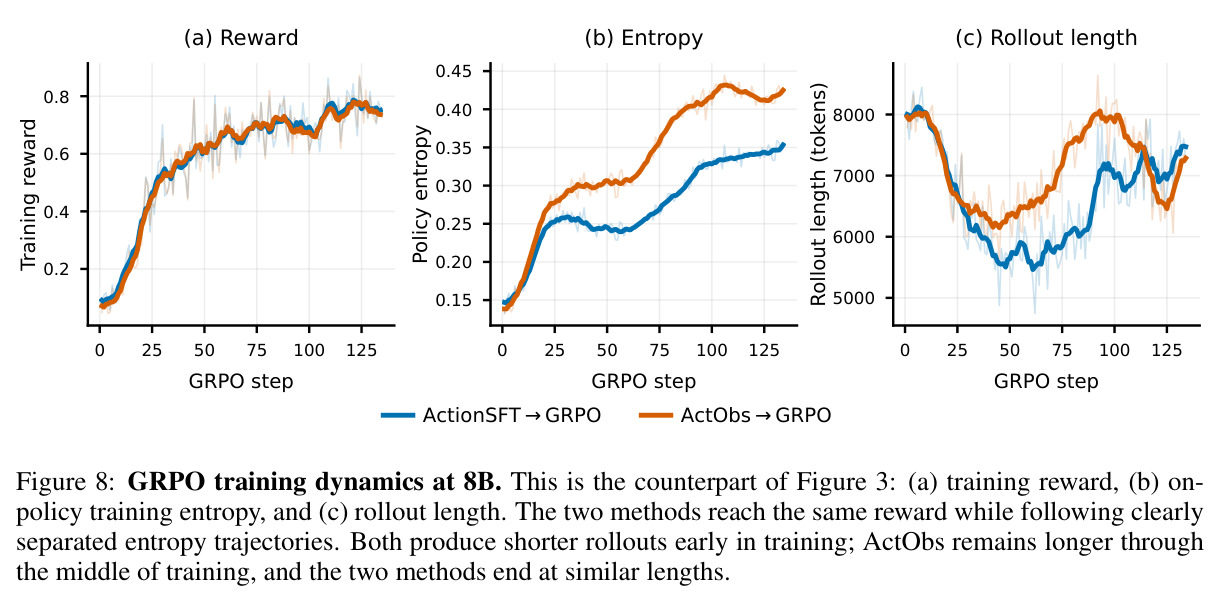
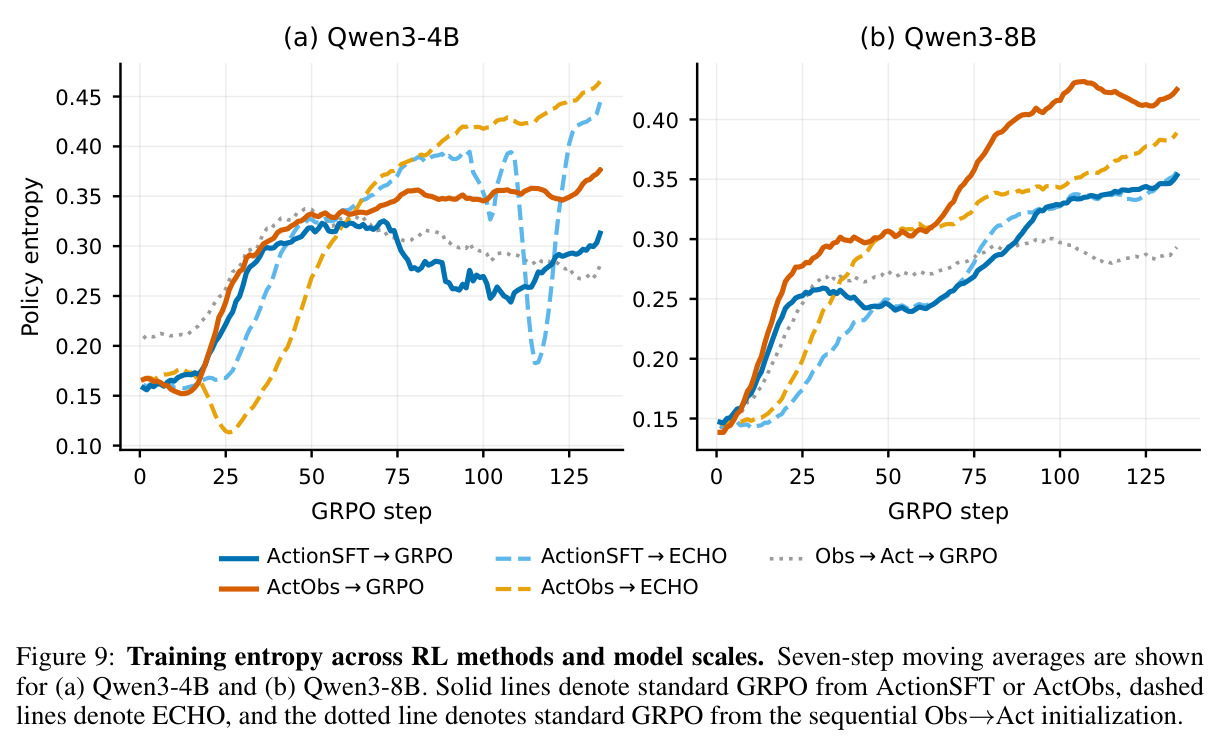
主要结果分四层。其一,主基准 Terminal-Bench 2.0:SFT 后三种初始化几乎持平(pass@1 均约 4.4%),但相同 GRPO 后分化——4B 的 ActObs→GRPO 全曲线领先,pass@1 7.2% 对 5.6%(相对 +29%);8B 呈交叉模式,pass@1 让 1.3 点,但 pass@16 领先 3.4 点(14%),任务覆盖 24 比 21 题,并独家解出三个其他策略全败的任务。其二,跨域:在未见过的 aider-polyglot 上,4B pass@1 领先 4.2 点(相对 +43%),而其 SFT 起点(1.0%)反而更弱,8B 同样领先。其三,换用观察感知 RL(ECHO)后仍在 8 个工作点中领先或持平 7 个;等量观察监督的时序对照不复现收益。其四,机制:ActObs 的 GRPO 训练熵更高、8B 端点自熵 0.779 对 0.716;把基线推理温度升至 0.64 匹配熵后 pass@k 变化不足 0.7 点,排除推理随机性解释。消融显示错误配对的观察使 pass@1 跌至 3.7%、只学观察解 0 题、仅前 100 步监督则 pass@8 只剩 19.1 对 23.6。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 2.0(89 任务,OOD 终端任务)@ Qwen3-4B | pass@1(16 attempts/任务) | 7.2% | ActionSFT→GRPO 5.6% | +1.6 个百分点(相对 +29%) |
| Terminal-Bench 2.0 @ Qwen3-8B | pass@16 | 27.0% | ActionSFT→GRPO 23.6% | +3.4 个百分点(相对 +14%),且任务覆盖 24/89 vs 21/89 |
| Terminal-Bench 2.0 @ Qwen3-4B | pass@16 | 19.1% | ActionSFT→GRPO 18.0% | +1.1 个百分点(全采样预算均领先;相对 +6%) |
| aider-polyglot(225 个跨域多语言代码编辑任务)@ Qwen3-4B | pass@1 | 13.9% | ActionSFT→GRPO 9.7% | +4.2 个百分点(相对 +43%);pass@4 亦 +4.9 点(相对 +24%) |
| aider-polyglot @ Qwen3-8B | pass@1 | 14.2% | ActionSFT→GRPO 12.7% | +1.5 个百分点(相对 +12%) |
| Terminal-Bench 2.0 @ Qwen3-8B(ECHO 观察感知 RL) | pass@8 | 22.0%(ActObs→ECHO) | ActionSFT→ECHO 20.6% | +1.4 个百分点(相对约 +7%;8 个工作点中 7 个领先或持平) |
局限与改进
作者承认的局限:8B 上以牺牲单次可靠性为代价(pass@1 11.0% vs 12.3%),收益集中在重复采样场景;高熵既不充分也不必要——ECHO 端点熵最高(0.794–0.804)但 pass@16 不及 ActObs→GRPO,说明'保留熵'只是相关解释而非完整因果;$\lambda$ 最优值依赖下游采样预算,部署需按预算调参。我的补充:其一,实验域窄——只有终端与代码编辑两类纯文本观察任务,语料全由 DeepSeek-V3.2 合成、观察带固定'New Terminal Output:'包裹符,能否推广到 GUI 截图、网页 DOM 等异构观察未知;其二,统计力有限——89/225 任务上 1–2 个点的差距与 bootstrap 标准误相比不算悬殊(如 4B pass@16 +1.1±1.4/1.2),且未见多 seed 重复;其三,基线覆盖窄——未与 RL 侧熵保持手段(clip-higher、熵奖励、pass@k 训练目标)正面对比,'改 SFT 优于改 RL'未被证明;其四,GRPO 仅 135 步、训练任务通过率已近 0.9 饱和,更长训练下结论是否保持存疑;此外论文未提及代码与 checkpoint 开源。
独立分析的弱点
独立分析的弱点与改进方向:(1)pass@1 换 pass@k 的权衡在单次调用昂贵的生产场景(执行有真实代价、输出需人工审核)是真实成本。改进:把 $\lambda$ 作为可调度参数,按任务难度或采样预算动态选择检查点,或训练推理时可调分布锐度的策略头。(2)机制解释停留在描述层面——梯度正交化说明 ActionSFT 没优化观察方向,但缺因果证据证明'保留观察预测能力'本身(而非并行变化)带来探索优势。改进:SFT 后对观察预测相关参数做定向破坏/恢复的干预实验再跑 GRPO。(3)观察监督的价值可能被格式稀释:wrapper 前缀位置的交叉熵增益最大,若语料观察格式更多样、噪声更大,效果可能不同。改进:在多格式、多环境语料上重复梯度诊断。(4)均匀加权 $\lambda=1$ 对 8B pass@1 已有害,全局单一权重次优。改进:按 token 信息量加权观察,或对观察损失做退火。(5)只验证了 GRPO 与二值奖励。改进:在 PPO、RLOO、best-of-n 蒸馏等优化器和稠密奖励下检验普适性。
未来方向
作者提出或暗示的方向:理解 $\lambda$ 连续控制'单次可靠性 vs 重复采样上限'权衡的机制,找到按预算自适应设权重的原则;ActObs 与 RL 内观察预测(ECHO)收益可叠加,两阶段观察监督的最优调度值得探索。可延伸方向:(1)多模态智能体——把'取消观察 mask'用于 GUI 截图、网页结构、API 响应等观察流,检验世界模型信号是否跨模态成立;(2)把观察预测残差当作'RL 就绪度'诊断指标——ActionSFT 的观察交叉熵低于 base 是下游失败前兆,可用于早停、检查点选择或数据配比调整;(3)与探索感知微调、posterior behavioral clipping 等显式控制支撑集的方法结合,观察监督可能是获得宽支撑集的最廉价途径;(4)在长 horizon、稀疏奖励任务(SWE-bench、多步运维)上验证,因为参数级探索(如成功案例中 QEMU 内存参数 $-m$ 从 128M 到 1024M 逐个扫描)在这类任务上价值最高;(5)理论上把 SFT 初始化的支撑集宽度与 RLVR 的 pass@k 上界联系起来;(6)观察 token 的内容感知加权与课程式监督(先 wrapper 后 payload)。
复现评估
论文为 preprint under review,未提到开源代码与 checkpoint,这是最大复现风险。数据与模型均公开:SFT 语料 Nemotron-Terminal-Corpus、RL 环境 Endless Terminals、评测 Terminal-Bench 2.0 与 aider-polyglot、底座 Qwen3-4B/8B 均可获取;方法实现成本极低——只是 label mask 一行改动。算力方面:SFT 仅 0.71B token 单 epoch,8×A100 上数小时量级;大头在 RL 与评测——GRPO 135 步覆盖 2,392 个容器化任务、每任务 16 rollouts,评测每个检查点需在 89 任务×16 attempts 的容器环境跑完,论文用单节点 8×A100 vLLM(12 并发、40,960 上下文),单次完整评测预计数百 GPU 时。可复现性设计属上乘:附录 A 给出完整服务配置与 20,000 次 bootstrap 统计协议,附录 B–F 提供全部消融矩阵与行为统计;主要缺口是多 seed 缺失。总体难度中等偏高——难在评测与算力,不在方法本身。
论文图表