VākQA:泰卢固语口语事实型问答的基准与评测研究 VākQA: A Benchmark and Evaluation Study for Telugu Spoken Factoid Question Answering
首个泰卢固语口语问答基准,验证LLM裁判可靠性并系统评测语言、模态与级联误差
前置知识
口语问答(Spoken Question Answering, SQA)
输入是语音而非文本的问答任务:系统需要先理解口语信号(可能经 ASR 转录或直接端到端),再给出直接答案。与文本 QA 相比,语音引入说话人、口音、同音词等声学与语言学变异,识别错误会直接改变问题或答案的含义。
本文的全部设计都围绕『语音输入给 QA 带来什么额外困难』展开,理解 SQA 与文本 QA 的差异是读懂其数据构建与实验配置的前提。
LLM-as-a-Judge
用一个(通常更强的)大语言模型替代人工或词面指标来为模型输出打分:把问题、参考答案、候选答案一起给裁判模型,让它按量规输出分数。优点是能容忍改写和语义等价,缺点是裁判自身有偏差、跨语言表现不一致。
本文的核心贡献之一就是量化 LLM 裁判在泰卢固语 QA 中的可靠性,并据此选定 Gemini 作为所有主实验的评测裁判。
ASR→MT 级联误差
先把语音用自动语音识别(ASR)转成文字,再用机器翻译(MT)翻译到另一语言的流水线。前端 ASR 的识别错误(WER 衡量)会传播并被 MT 放大(BLEU/ChrF++ 衡量),导致下游任务性能逐级衰减,即误差复利。
论文用 2×2 的 ASR×MT 配置(M1–M4)定量展示了这种复利效应:QA 分数从 3.63 一路降到 2.44,这是其级联分析结论的基础。
Krippendorff's α
衡量多个评分者之间一致性的统计量,取值从 -1 到 1,通常 α>0.8 视为可靠。它优于简单百分比一致性之处在于能对缺失数据和不同量标做校正,常用于标注质量评估。
本文以 5 名泰卢固语母语者的人工评分(剔除离群项后 $\alpha=0.836$)作为金标准,所有自动评测方法的可靠性都相对这个金标准度量。
WER 与 BLEU/ChrF++
WER(词错误率)$\mathrm{WER}=(S+D+I)/N$ 用替换、删除、插入次数除以参考词数来评估 ASR 质量;BLEU 和 ChrF++ 分别基于 n-gram 精确率和字符级匹配评估 MT 质量,越高越好。
论文用这些组件级指标把端到端 QA 分数的下降精确分解到 ASR 和 MT 各阶段,是读懂 Table VII 与级联实验的钥匙。
Spearman ρ、Kendall τ 与一致性界限(LoA)
Spearman $\rho$ 和 Kendall $\tau$ 度量两组评分的秩相关;一致性界限(Limits of Agreement)取差异的均值 ±1.96 倍标准差,源自 Bland-Altman 分析,用于判断新测量方法与金标准是否可互换。
论文同时用这三种统计量审计裁判模型:相关性高不代表无偏,正是 LoA 分析揭示了 Gemini 裁判对低分宽松、对高分严格的非均匀性。
研究动机
问答技术随大语言模型快速进步,但资源高度集中于英语等高资源语言,口语场景的鸿沟更明显:Spoken SQuAD 用 TTS 合成语音叠加在 SQuAD 文本上,ODSQA 基于朗读语音构建中文开放域资源,SD-QA 覆盖 5 种语言 24 种方言却沿用 TyDi QA 式的段落抽取任务,ViSQA 用同样的 TTS 合成做越南语——它们都不是原生口语问答,而语音的采集方式、是否需要段落、转录如何处理都会塑造模型犯的错误。对泰卢固语而言,虽有文本问答数据集 TeQuAD,语音版本完全空白。口语输入引入文本不具备的声学变异:论文举例泰卢固语『paṇḍu(水果)』被听成音近的『paṇḍuga(节日)』,问题含义随之改变,模型把邦果答成邦节日 Bathukamma。评测可靠性同样存疑:EM 和 F1 对改写极度脆弱,BertScore、BLEURT、ORCA 等模型指标主要面向英语、无法不经微调直接用于泰卢固语,而现有印度语系 QA 数据集几乎全部只用 EM/F1,从无人研究 LLM 裁判在此场景是否可信,尽管已有工作表明 LLM 裁判跨语言、跨任务表现不一致。
本文的目标是本文的目标是构建并公开首个泰卢固语口语事实型问答基准 VākQA:包含 2,001 条事实型问答对、2.53 小时真实语音音频、泰卢固语转录与人工英语翻译,参考答案经人工验证,覆盖科学(27%)、常识(23%)、政治(16%)、历史(13%)、文化(12%)、地理(10%)六个领域。在此基准上系统回答两个问题。第一,自动评测在泰卢固语口语 QA 中是否可靠:以 5 名母语者对 400 个候选答案的人工评分(1–5 分量规,剔除离群项后 $\alpha=0.836$)为金标准,对比 Gemini 与 Gemma-3 三个变体作为裁判,以及 EM、F1、BLASER-2.0。第二,在验证过的评测设置下评测专有与开放权重模型:沿输入语言(泰卢固语/英语)、输入模态(语音/文本)、ASR→MT 级联(2 种 ASR × 2 种 MT 共 4 种配置)与模型规模/阵营四个维度逐一隔离变量,并给出六领域细粒度表现,区分『模型缺知识』与『有知识但无法在某语言中取用』两种失败模式。
与已有工作不同的是,本文的独特切入点在于三件事的首次组合。第一,问题直接来自真实口语交互而非翻译或合成:数据源自泰卢固语 YouTube 问答/选择题频道的原生口语内容,同时提供原声、泰卢固语转录和人工英语翻译,而现有 SQA 数据集多为『文本 QA + 合成语音』,作者强调口语基准不是简单给文本挂上音频。第二,首次为泰卢固语构建 SQA 基准,把语音变异引入此前只有纯文本 TeQuAD 的泰卢固语 QA。第三,首次系统量化 LLM-as-a-judge 在泰卢固语 QA 中的可靠性——作者指出绝大多数印度语系 QA 数据集仍用 EM/F1,没有任何工作研究 LLM 裁判在该场景的可靠性。此外,本文在同一基准上同时隔离输入语言、输入模态、ASR→MT 级联误差与领域四个因素,并用同一问题在双语间的成对比较来区分『缺知识』与『有知识但取不出』两种失败模式,这种评测归因设计是此前任何口语基准都未同时尝试的。
核心方法
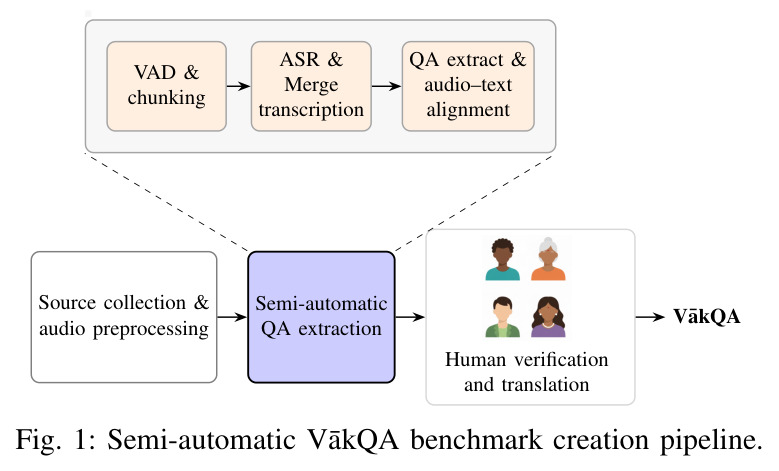
直观地说,作者想回答『当问题以泰卢固语语音形式到达模型时会发生什么』。技术路线分三步。第一步构建数据:从六个领域的 YouTube 问答频道收集视频,用 Pyannote VAD 检测非静音区并切成 7 秒、2 秒重叠的块;每块用微调的 Seamless-large-v2(约 900 小时泰卢固语数据训练)转录,合并成整段文本后由 Gemini 逐字提取问答对;再用 whisper-timestamped 配合 IndicWhisper 计算词级时间戳,以模糊匹配(Levenshtein ≥85%)修正每条 QA 的音频边界。第二步人工验证与翻译:5 名标注者核对转录与音频一致,并人工翻译全部问答对为英语,得到 2,001 条双语口语问答、2.53 小时音频。第三步双轨评测:先以 100 题 × 4 模型 = 400 个候选答案、5 名母语者按 1–5 量规评分($\alpha=0.836$)为金标准校准自动评测,选定 Gemini 裁判;再在 S1(语音)、O1/O2(金标文本)、A1/A2(ASR)、O3/O4(金标→MT)、M1–M4(级联)等配置上评测 Gemini 与 7 个开放权重模型。
核心创新是『半自动构建 + 裁判先行校准』的基准方法论。与已有工作的本质区别有三点。其一,问答对挖掘自真实的口语测验内容:VAD 切块 → 微调 ASR 转录 → Gemini 逐字抽取 → 词级时间戳模糊对齐的流水线,让每条 QA 同时带有天然口语音频、泰卢固语转录和人工英语翻译,保留口语的文化特异性,而非像 Spoken SQuAD/ViSQA 那样把文本 QA 套上 TTS 语音。其二,把评测可靠性本身作为研究对象:以 5 名母语者 400 条人工评分(剔除 20 个跨 1–5 的离群项后 $\alpha=0.836$)为金标准,用 Spearman $\rho$、Kendall $\tau$、平均误差 ME 与 ±1.96 SD 一致性界限逐一审计裁判与词面指标,发现 Gemini 裁判 $\rho=0.86$ 最高但对低分宽松、对高分严格,而 EM/F1 的 $\rho$ 仅 0.37/0.49。其三,用同一问题跨配置的成对比较区分失败模式:O1→O2 显示 18.8% 问题因英译丢失辖域而变差,O1→S1 显示 21.2% 因声学混淆而变差,O1→A1 显示 11.9% 因 ASR 误识而变差。
方法步骤详情
流水线分五步。步骤一,源采集与预处理:从六类 YouTube 问答频道筛选视频,要求问答在音频中清晰分离;Pyannote VAD 检出非静音区并切成 7 秒块(2 秒重叠),保留原始时间戳。步骤二,半自动 QA 抽取:每块输入微调的 Seamless FT 泰卢固语 ASR 得到转录,合并成完整文本后由 Gemini 逐字提取问答对。步骤三,音频-文本对齐:另用 whisper-timestamped + IndicWhisper 计算词级时间戳,将 QA 文本与词序列做模糊匹配(Levenshtein ratio ≥85%),修正每条 QA 音频片段的精确边界。步骤四,人工验证与翻译:5 名标注者核对转录与音频一致,并把全部 2,001 条 QA 人工翻译为英语;产物含 2.53 小时音频,平均问题 7.2 词(英语 9.9 词)、答案 2.4 词。步骤五,评测校准与基准测试:抽样 100 题,由 Gemini 与 Gemma-3(4B/12B/27B)生成候选答案构成 400 个三元组,5 名母语者按 1–5 量规评分,剔除 20 个离群项后 $\alpha=0.836$;据此以 $\rho$、$\tau$、ME、MAE 与 LoA 对比各裁判及 EM、F1、BLASER-2.0,选定 Gemini 为主裁判;最后在九种配置上评测 8 个模型并逐题成对比较归因。
技术新颖性
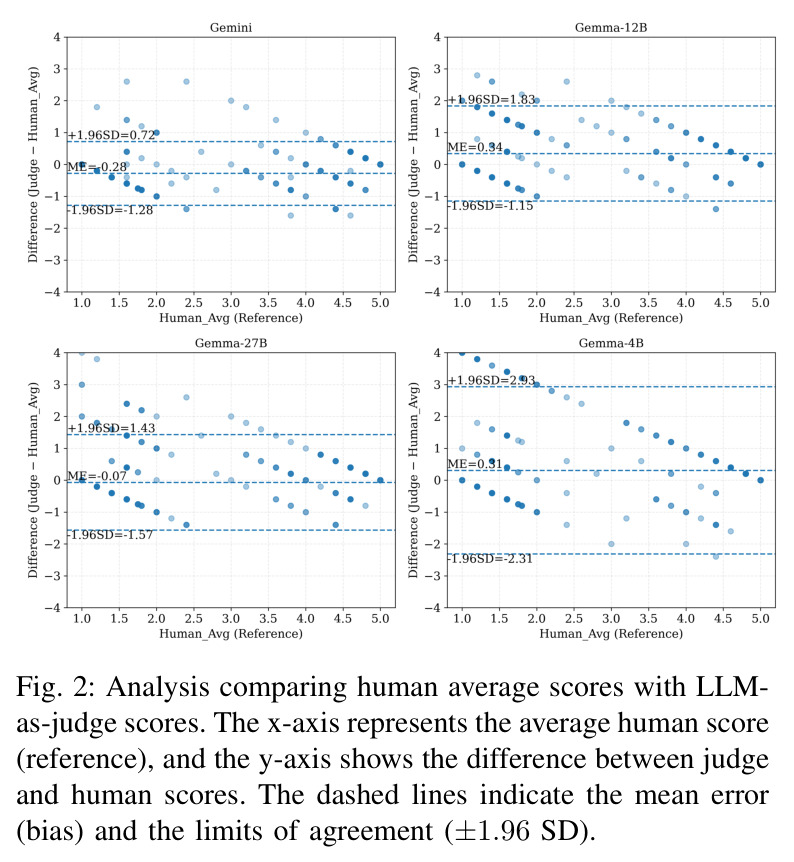
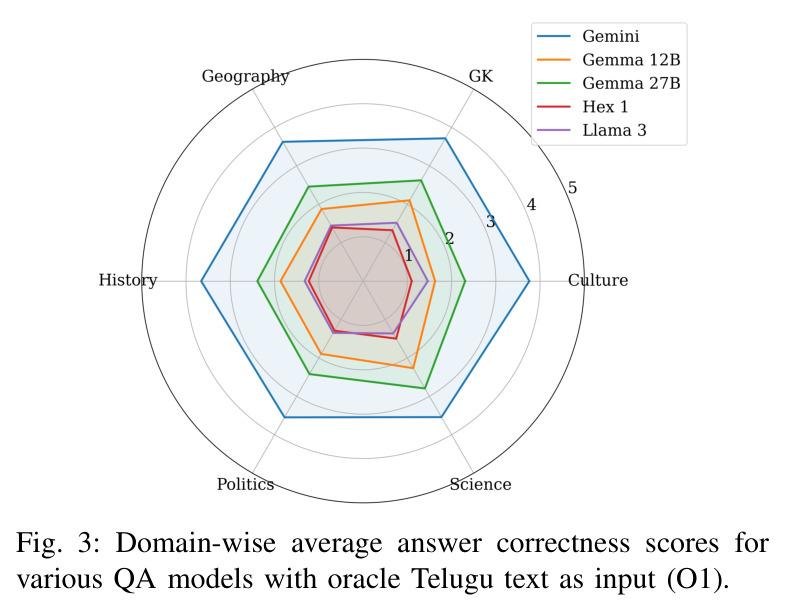
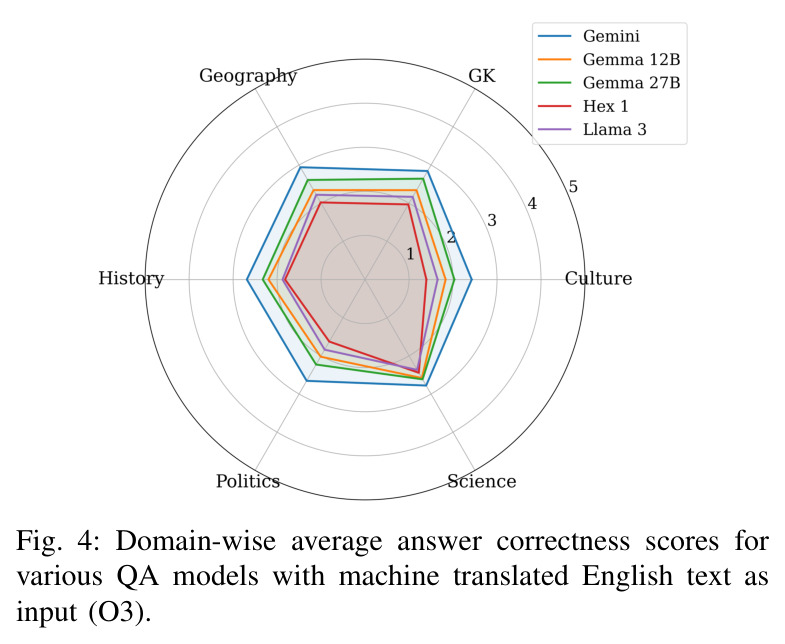
技术新颖性体现在四个层面。数据层面,这是第一个泰卢固语口语 QA 基准,且是少见的『原生口语问答』数据——问题来自真实口语测验而非朗读文本或 TTS 合成,同时附带人工双语翻译,为跨语言对照提供金标准。评测层面,首次在泰卢固语 QA 中系统审计 LLM 裁判:不止报告相关性,还用 Bland-Altman 式偏差分析(Fig. 2)揭示 Gemini 裁判的非均匀严格性(ME=-0.28,LoA -1.28~0.72),并发现开放权重裁判会系统性惩罚语义正确但词面不同的泰卢固语答案,如把正确的『mārci 23(3 月 23 日)』打 1 分。归因层面,2×2 的 ASR×MT 级联设计(M1–M4)配合组件级指标(Seamless FT ASR WER 30.25、金标→Seamless MT BLEU 37.22、级联后 32.18)把端到端 QA 分数从 3.63 到 2.51 的下降逐阶段分解。分析层面,六领域雷达图(Fig. 3/4)揭示文化领域对翻译最敏感(3.76→2.42)而地理最稳健(O3 下最强 2.94),为低资源 QA 的领域偏差提供细粒度证据。
实验结果
论文有四组核心发现。第一,评测可靠性:以 5 名母语者对 400 个候选答案的评分为金标准($\alpha=0.836$),Gemini 裁判与人类最接近($\rho=0.86$,$\tau=0.77$,MAE=0.46,LoA -1.28~0.72),Gemma-12B/27B 次之(0.81/0.80),4B 最差(0.57);EM、F1、BLASER-2.0 的 $\rho$ 仅 0.37/0.49/0.36。换 Gemma-12B 裁判后,2,001 条答案中 46.23% 得分变差、21.14% 变好。第二,专有 vs 开放权重:金标泰卢固语文本 O1 下 Gemini 得 3.63(std 1.71),最强开放权重 Gemma-27B 仅 2.55,Sarvam-m 1.98,Llama-3.1-8B、Hex-1、Qwen-3-4B 均低于 1.5(最低 1.17)。第三,语言与模态代价:换英语输入(O2 3.52)使 18.8% 问题变差;语音输入(S1 3.28)使 21.2% 变差,如『水果』被听成音近的『节日』,答案由芒果错成 Bathukamma。第四,级联误差复利:Seamless FT ASR WER 30.25,级联使 MT BLEU 从 37.22 降至 27.95,QA 分数从 3.63 经 2.74 降至 2.44–2.80。领域层面,翻译后文化跌幅最大(3.76→2.42),地理升至最强(2.94)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 自动评测 vs 人工评分(泰卢固语 QA 答案正确性) | Spearman ρ | Gemini-as-a-judge 0.86(τ=0.77,MAE=0.46) | EM 0.37;F1 0.49;BLASER-2.0 0.36 | 相关性提升约 +0.37~+0.50,且偏差分析显示其 LoA 最窄(-1.28~0.72) |
| 金标泰卢固语文本输入问答(O1) | Gemini 裁判 1–5 分(mean) | Gemini QA 模型 3.63(std 1.71) | 最强开放权重 Gemma-3-27B 2.55(1.79) | +1.08 分,开放权重阵营其余模型均 ≤2.01 |
| 泰卢固语直接语音输入问答(S1) | Gemini 裁判 1–5 分 | 3.28(1.84) | 同模型文本输入 O1 3.63(1.71) | -0.35;逐题看 21.2% 变差、13.1% 变好、65.7% 不变 |
| 级联 ASR→MT 英语输入问答(M1:Seamless FT ASR→Seamless MT) | Gemini 裁判 1–5 分 | 2.51(1.82) | 金标泰卢固语文本 O1 3.63 | -1.12;四种级联配置 M1–M4 均在 2.44–2.80,误差逐级复利 |
| 泰卢固语 ASR 转录 | WER(越低越好) | Seamless FT 30.25(CER 10.12) | IndicWhisper 35.23(CER 22.38) | WER 降低 4.98 个百分点 |
| 泰→英机器翻译 | BLEU(越高越好) | 金标文本→Seamless MT 37.22(ChrF++ 60.12) | ASR 级联后(Seamless FT ASR→Seamless MT)32.18;IndicWhisper→Seamless MT 27.95 | 级联 ASR 使 BLEU 下降 5.04–9.27,证实误差跨阶段传播 |
局限与改进
作者明确承认三点局限。其一,YouTube 音频的理想处理应是忠实转录式翻译而非澄清式改写,但忠实翻译会引入辖域歧义——E3 案例中泰卢固语物主代词 mana(我们的)隐含印度范围,英译后变成全局指代,模型把『我国第一颗卫星』答成 Sputnik 而非 Aryabhata,这一矛盾没有解决。其二,Gemini 裁判虽最可靠但严格性非均匀:对低质量答案更宽松、对高质量答案更严格(ME=-0.28),限制了细粒度比较。其三,部分科学与地理参考答案是英语音译词,论文未检验裁判对英语音译与泰卢固语原生写法是否一致打分。我的补充观察:人工校准只覆盖 100 题、400 个三元组,且评分者包含论文合作者,可能存在利益相关偏置;直接语音输入仅测试了 Gemini 一个模型,缺少开放权重语音模型的对照(作者也指出目前不存在开放权重泰卢固语语音 LLM);ASR/MT 系统各只有两三种,误差复利结论对其他系统的普适性有限;数据集中保留了 6 条(泰)与 8 条(英)长描述性答案,作者明知其会扭曲 EM/F1 却原样保留;平均答案仅 2.4 词的事实型短答案设定也无法反映推理型或长答案 QA 的表现。
独立分析的弱点
独立分析有五点弱点。第一,裁判单点依赖与自我评测风险:所有主表结果都由 Gemini 打分,而 Gemini 同时是被评测的 QA 模型之一;论文虽证明 Gemini 裁判与人类最相关,却未用第二裁判(如 Gemma-27B)交叉验证主要排序是否稳定,应报告多裁判集成结果。第二,人工校准集小且来源单一:400 个三元组的候选答案全部来自 Gemini 与 Gemma-3 家族,裁判可靠性结论对 Sarvam-m、Llama 等其他模型家族的答案分布外推性未知。第三,语音链路只有专有模型可测:S1 配置下没有开放权重基线,『语音使 21.2% 问题变差』无法区分是语音接口的普遍代价还是 Gemini 特有行为。第四,错误分析以轶事为主:E4/E5 的声学混淆案例很生动,但缺少混淆类型的量化统计,如同音词错误在全部 ASR 错误中的占比及其与 QA 退化的相关强度,应对 ASR 错误做类型学标注并与逐题退化对齐。第五,六领域划分较粗且边界主观(文化 vs 历史 vs 常识),『文化最难、科学最易』的结论对划分方式可能敏感,可用细粒度主题标注做敏感性分析。
未来方向
作者未设专门的未来工作章节,但结论与讨论中隐含三条方向:构建能识别泰卢固语语义等价的可靠裁判(小型开放权重裁判连『数字 vs 拼写日期』的等价都判不出,训练泰卢固语专用裁判或奖励模型是直接延伸);在保留文化语义的前提下消解翻译辖域歧义(如 mana 案例);统一音译词与原生词的评分口径。基于本文成果还可延伸:其一,把 2.53 小时、平均 4.55 秒的事实型短问题扩展到生成式、多跳与对话式问题,突破短答案局限;其二,训练开放权重的泰卢固语(或印度语系)端到端语音 LLM,填补作者指出的空白,使 S1 配置在模型阵营内可比;其三,把本文的裁判审计协议(人工金标 + $\rho$/$\tau$/ME/LoA)作为标准流程推广到其他低资源语言的 QA 评测;其四,利用数据集自带的词级时间戳与双语对照,自动关联 ASR 错误类型与下游 QA 失败,把轶事分析升级为系统性归因;其五,探索语音输入下的检索增强——把参考音频或转录作为上下文,检验能否缓解声学混淆导致的语义漂移;其六,在现有六领域上引入跨文化对照(如把文化域问题平行译入其他印度语言),研究文化知识是语言绑定还是可迁移。
复现评估
复现条件总体较好。最关键的资产——数据集已在 HuggingFace 公开(hf.co/datasets/Bhavanaakkiraju/VakQA),含 2,001 条问答、2.53 小时音频、泰卢固语转录与人工英语翻译。流水线各组件均为公开模型:Pyannote VAD、Seamless-large-v2、IndicWhisper、Seamless MT、IndicTrans2;最大算力门槛是把 Seamless 微调成 Seamless FT 需约 900 小时泰卢固语语音数据(均可公开获取),单张 A100 级别可完成。问答抽取与裁判打分调用 Gemini API 会产生少量费用。人工环节是外部复现者最难对齐的部分:需要 5 名泰卢固语母语标注者完成转录验证、翻译与 400 条评分,人力成本高。若跳过数据构建与人工校准、直接用发布数据集和 Gemini 裁判,单机加 API 即可复现 Table V–VII 的主要数字,难度中低;若连裁判校准也独立复现,则成本显著上升。论文未附带代码仓库,流水线需按正文描述自行实现,好在每步参数(7 秒块、2 秒重叠、Levenshtein ≥85%)都写得很具体。
论文图表
数据集统计表:共 2,001 题(泰/英各 2,001 条),总音频 2.53 小时,平均音频长 4.55 秒,平均每题词数泰卢固语 7.2、英语 9.9,平均答案词数均为 2.4。
它界定了基准的规模与难度上限:短问题、短答案的事实型设定解释了为何 EM/F1 等词面指标会大面积失灵,也是评估基准代表性(是否覆盖足够语言现象)的基础。
人工与 LLM 裁判共用的 1–5 分评分量规:1=完全不相关,2=方向对但严重错误,3=部分正确/漏关键细节,4=基本正确有小错,5=完全正确。
整篇论文的评测体系都建立在这个量规上——人工金标准用它,四个 LLM 裁判也用同一量规打分,理解它才能理解分数的含义与可比性。
以人工评分为金标准对比各评测方法:Gemini 裁判 ρ=0.86、τ=0.77、MAE=0.46 最优;Gemma-3-12B/27B 的 ρ=0.81/0.80,4B 仅 0.57;EM、F1 的 ρ 只有 0.37/0.49,BLASER-2.0 为 0.36。
这是论文第一个核心结论的数据支撑:它量化证明了泰卢固语 QA 中词面指标不可靠、裁判模型的选择至关重要,为后续所有实验选用 Gemini 裁判提供了正当性。
七个失败/成功案例(E1–E7),全部用拉丁转写的泰卢固语原文加英文释义呈现:E1 显示正确但更详细的答案被 EM/F1 判 0 分;E2 显示 Gemma-12B 裁判把正确的『3 月 23 日』打 1 分;E3 显示英译丢失 mana(我们的)的辖域导致 Aryabhata 变 Sputnik;E4 显示语音中水果被听成节日;E5 显示 ASR 把金钱癣问题变成无关句子使答案由真菌变热量;E6/E7 展示文化域翻译失败与科学域英译反而受益。
这是论文最直观的部分:每一条实验结论(词面指标失灵、裁判敏感、翻译歧义、声学混淆)都对应一个具体案例,是把抽象数字变成可感知机制的关键。
主结果表:9 种输入配置(S1 语音、O1/O2 金标文本、A1/A2 ASR 文本、O3/O4 金标→MT、M1–M4 级联)× 8 个 QA 模型的 1–5 分成绩。Gemini 全线领先:O1 3.63 最高,语音 S1 3.28,级联 M3 2.44 最低;开放权重中 Gemma-27B 最好(O1 2.55),Qwen-3-4B 最差(1.17)。
论文的核心实证贡献都浓缩在这张表里:模型阵营差距、语言代价、模态代价与级联误差复利四大结论全部由它的数字支撑,是必读的主表。
逐题成对比较表:相对 O1 基线,换裁判为 Gemma-12B 使 46.2% 变差;换 ASR 转录(A1)使 11.9% 变差、83.3% 不变;换英语输入(O2)使 18.8% 变差;换语音输入(S1)使 21.2% 变差,各因素的不变比例均在 64.7%–83.3%。
它把平均分差异分解为逐题的分布变化,回答了『退化是普遍的还是集中在少数难题上』——这是平均分表格无法提供的归因视角,也支撑了区分失败模式的方法论。
组件级指标表:Seamless FT ASR WER 30.25/CER 10.12,IndicWhisper WER 35.23/CER 22.38;MT 方向金标文本→Seamless MT BLEU 37.22/ChrF++ 60.12 最佳,级联 ASR 后 BLEU 降至 27.95–32.18。
它提供了把 QA 端到端分数损失分解到 ASR、MT 各阶段的量化证据链:没有这张表,『级联误差复利』就只是 QA 分数的间接推断。