自进化搜索索引(Self-Index) Self-Evolving Search Index
索引通过诊断-修订-验证闭环自主进化,无需人工干预即适配任意语料与检索器
前置知识
索引键(Index Key)
检索系统中,文档并不直接参与匹配,而是由一组代表它的“键”参与匹配——键可以是原文、伪查询、场景描述、摘要等任意文本表示。给定查询 $q$,检索器对文档 $d$ 的打分为 $s(q,d)=\max_{k\in K(d)} \mathrm{rel}(q,k)$,即取该文档所有键中与查询相关度的最大值,全部文档的键集合构成整个索引 $\mathcal{K}$。
SELF-INDEX 的优化对象就是索引键:诊断、修订、验证的全部操作都落在键上,而不是模型参数或语料本身;理解“键 + max 打分”才能明白什么叫“选择性修订”,以及为何不需要调聚合权重。
稀疏检索与稠密检索
稀疏检索以词项为维度表示文本,经典代表 BM25 基于词频与逆文档频率做词面匹配打分;稠密检索用神经编码器(如 BGE-Large、Qwen3-Embedding-8B)把文本映射为低维向量,用余弦相似度度量语义相关性。两者对“什么样的索引键算好键”偏好不同:稀疏检索偏爱查询词面覆盖,稠密检索偏爱语义贴近。
论文的核心论点是“没有一种固定索引策略在所有检索器上都好”,所有主实验正是在 BM25、BGE-Large、Qwen3-Emb-8B 三种检索器上验证自进化能否自动适配每种环境。
nDCG@10
归一化折损累计增益,是排序质量的标准指标:按相关性从高到低排序后,位置 $i$ 的得分按 $1/\log_2(1+i)$ 折扣累加,再除以理想排序得分归一化,@10 表示只统计前 10 个结果。数值越高说明把相关文档排得越靠前。
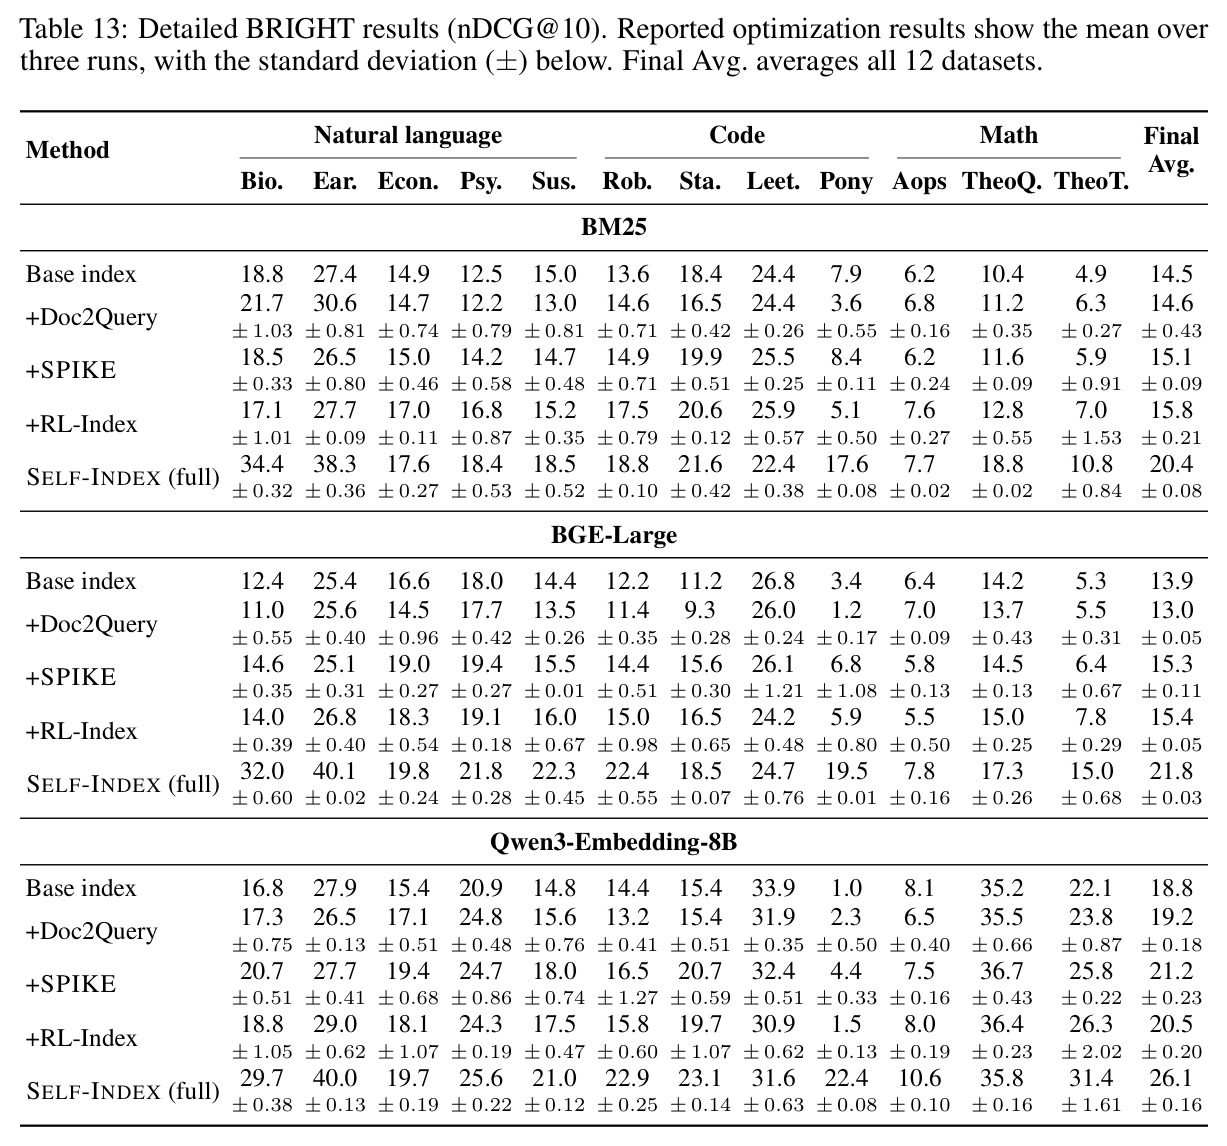
论文所有检索实验(BRIGHT 的 12 个数据集和表格检索)的主指标都是 nDCG@10(0–100 尺度、三次运行均值),解读各项增益都必须以它为准。
伪相关反馈(Pseudo-Relevance Feedback)
一种无需人工标注的相关性反馈技术:先执行一次检索,把排在前列的结果默认当作相关,用它们(或它们的统计特征)作为反馈信号来改写查询或文档表示,代表工作有 Rocchio 算法与相关性模型(Lavrenko & Croft)。
SELF-INDEX 的 Self-Diagnosis 明确受其启发——把检索结果(哪些键被一起检索、频率如何)当作免费的诊断信号,这是整个框架“零标注进化”的根基。
LLM-as-judge(LLM 评判)
用 LLM 按给定评分标准给候选文本打分,替代人工评估。本文的 Faithfulness 与 Answerability 检查都采用 0–3 分制、阈值 2(文档能满足键所表达的信息需求即通过),判官与优化器共用同一骨干模型 Qwen3.6-35B-A3B。
SELF-INDEX 的两道质量门控(生成键是否忠实于源文档、模拟查询能否被源文档回答)都依赖 LLM 评判,理解其打分机制才能看懂验证环节如何过滤坏修订。
Jaccard 相似度
两个集合交集大小除以并集大小的相似度:$\mathrm{Jac}(A,B)=|A\cap B|/|A\cup B|$,本文用于比较两条查询词集之间的词面重叠程度。
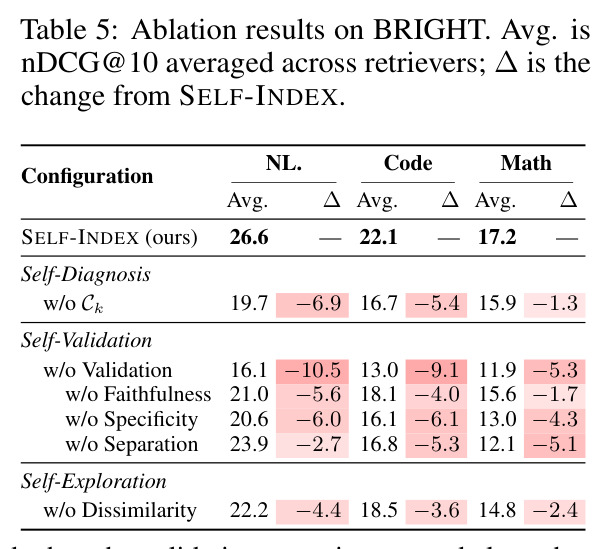
Query Simulator 用 Jaccard < 0.8 的 Dissimilarity 过滤器保证新生成的探索查询与已用查询词面不重复;消融显示去掉它,三类语料的平均 nDCG@10 各下降 2.4–4.4 点。
研究动机
检索质量高度依赖索引如何把文档“暴露”给检索器,而什么样的索引表示是好表示,取决于检索环境:语料类型(自然语言、代码、数学、表格)与检索器类型(稀疏/稠密)都会改变偏好——同一策略在一个环境有效,在另一个环境可能失效甚至有害。例如本文实验中,Doc2Query 在 BM25 的表格检索上把平均 nDCG@10 从 33.2 提到 37.0,却在 BGE + 代码语料上把 13.9 拉低到 13.0。现有索引优化方法(Doc2Query 伪查询、SPIKE 场景、EnrichIndex 补充表示)都依赖人工预定义的固定策略;策略失灵时,要么人工重新设计策略,要么像 RL-Index 那样重新收集相关性标注数据并再训练,然后把修订后的策略无差别地重刷全库索引。随着新的检索短板不断出现,这套“人工诊断—改策略—全库重建”的循环必须反复执行,人力与算力成本成为索引进化的核心瓶颈。
本文的目标是本文的目标是让索引在零人工干预下自我进化:给定任意语料和检索器,索引应能(1)从检索结果中自动定位是哪些文档的哪些键造成了检索短板;(2)只针对这些键做修订,而不是重建整个索引;(3)每条修订先经过验证、确认有效后再写回索引,坏修订不许入库;(4)超越“只能响应已收到的查询”的被动模式,主动探索语料中潜在的、尚未被覆盖的检索需求并据此继续进化。最终衡量标准是在自然语言、代码、数学、表格四类语料与三种检索器的全部组合上持续提升 nDCG@10,并把检索增益转化为搜索代理的答案准确率、更低的在线成本,以及代理记忆系统更好的信息利用率。
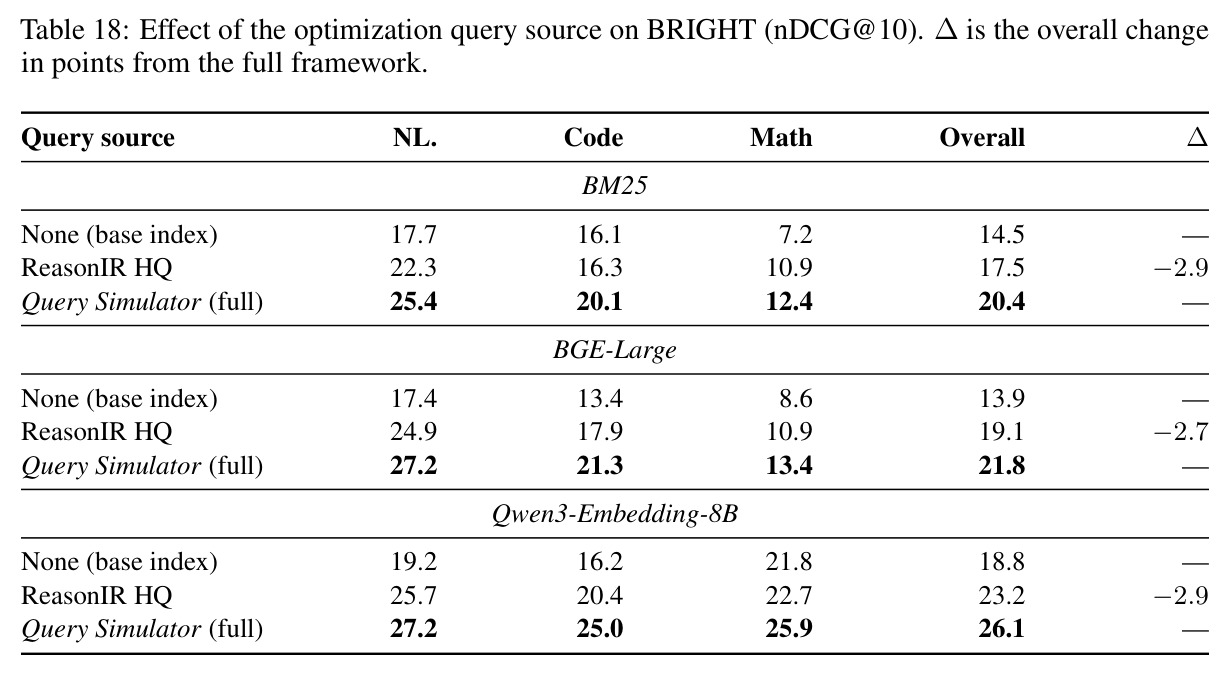
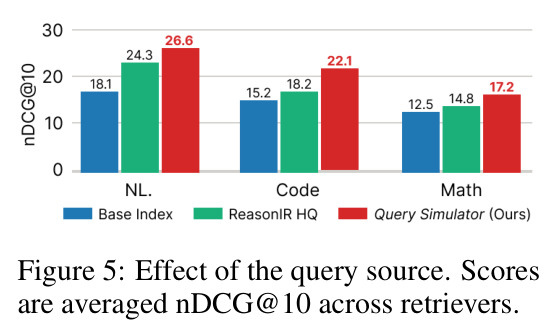
与已有工作不同的是,本文的独特切入是把“自进化”(self-evolving)范式从模型与智能体迁移到索引这一长期被忽视的对象上。此前自进化工作(R-Zero、Absolute Zero、Dr. Zero 等)都在进化模型或 agent 本身,索引始终被视为静态产物。与既有索引优化方法的本质差异有三:其一,RL-Index/AutoIndex 学习的是“策略”,需要相关性标注且全库统一应用;SELF-INDEX 直接从检索结果出发改“键”,不依赖任何标注。其二,诊断信号来自键与键之间的共检索画像——一种跨查询统计的结构化伪相关反馈,而非简单的检索失败标志。其三,引入 Query Simulator 主动生成多样化查询,把被动的“哪里疼治哪里”升级为主动的全域体检,这是已有索引优化方法完全没有的组件;消融显示即便换成现成的 ReasonIR HQ 查询池,同一个优化器也会少赚约 2.7–2.9 个 nDCG 点,说明主动探索本身就是贡献。
核心方法
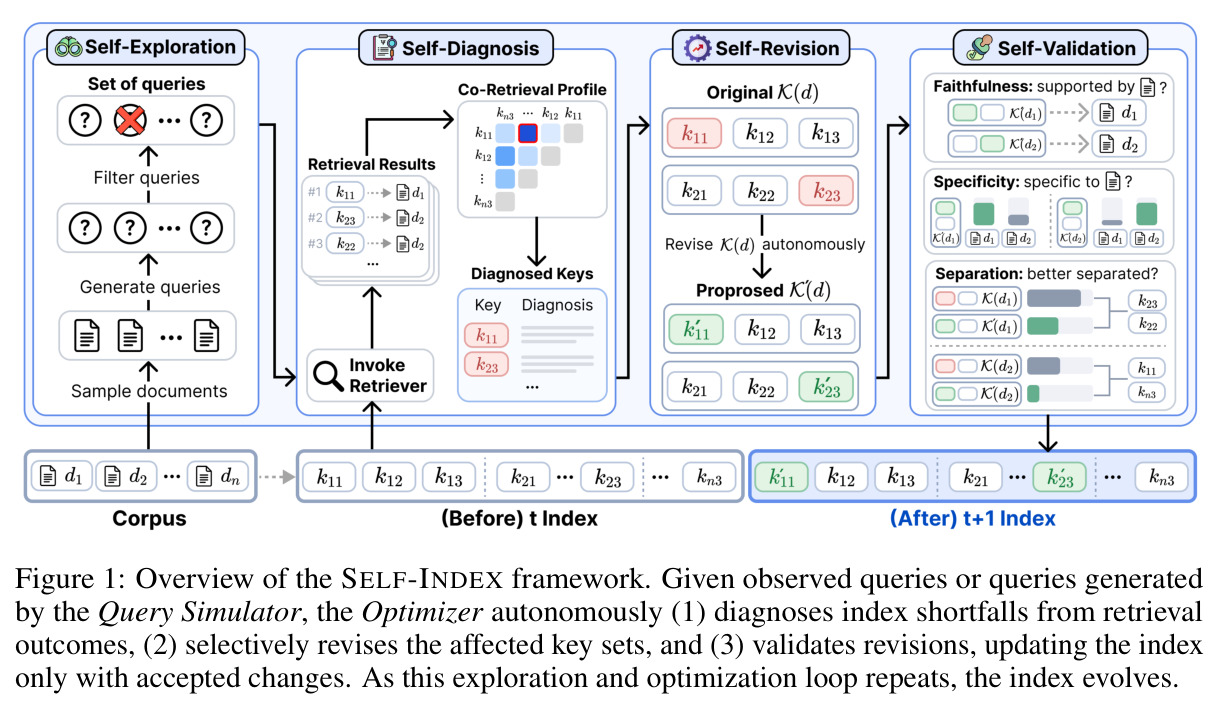
直觉上,SELF-INDEX 把索引变成一个会“自查、自改、自审”的活系统:它观察自己的检索行为,发现问题就动手改,改完还要通过三道质检才能上线。技术路线:索引建模为文档键集合的并集 $\mathcal{K}=\bigcup_{d\in\mathcal{D}} K(d)$,检索打分用 max 聚合 $s(q,d)=\max_{k\in K(d)}\mathrm{rel}(q,k)$,免去 SPIKE 等方法需要的权重调参;每篇文档的原文固定为一个不可修改、不参与验证的键。Optimizer 每轮接收一批查询 $\mathcal{Q}$,依次执行 Self-Diagnosis(检索 top-30 个键、构造共检索画像、LLM 诊断短板)、Self-Revision(整组改写被诊断的 $K(d)$ 得到提案 $K'(d)$)、Self-Validation(忠实性/特异性/分离性三准则过滤),通过的修订写回索引进入下一轮。Query Simulator 在语料上均匀采样文档,两阶段生成查询(先抽象底层信息需求、再以“没读过文档的用户”口吻写查询),经 Answerability 判分与 Jaccard<0.8 去重后交给 Optimizer。主实验每个数据集跑 20 轮、每轮 128 条查询(共 2,560 条)、每文档键数上限 10,优化器与模拟器都用 Qwen3.6-35B-A3B。
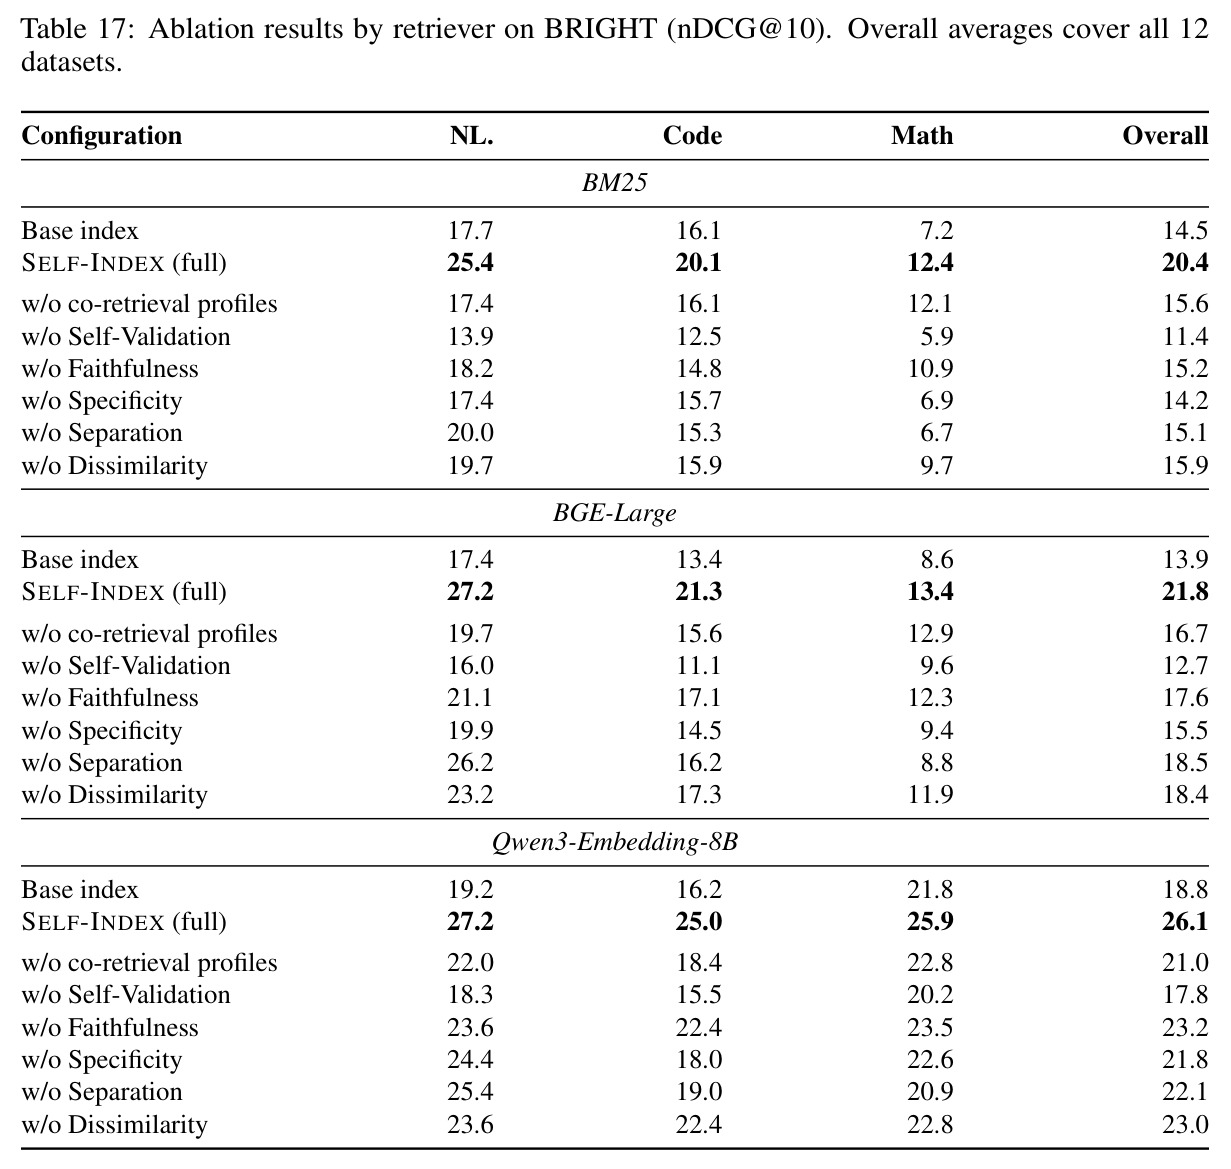
核心创新是把“检索结果本身”当作免费的、无标注的监督信号来驱动索引进化,并用验证门控保证只接受好的修订。与已有方法的本质区别:(1)Doc2Query/SPIKE/EnrichIndex 是一次性、全库、固定策略的索引构建——所有文档被同一套生成规则处理,策略好不好全看运气;SELF-INDEX 的修订由每个文档的实际检索表现触发,哪里有短板改哪里。(2)RL-Index 学习策略需要相关性标注;SELF-INDEX 的诊断信号来自共检索画像 $C_k$——记录键 $k$ 在整批查询中与哪些其他文档的键被共同检索及频次,为 LLM 提供“这个键是否把源文档与其他易混淆文档区分开”的结构化证据。(3)三准则验证把经典检索理论(Salton 的好键标准:忠实、特异、可区分)落成可计算的过滤器,其中 Specificity 与 Separation 直接复用检索器的 rel 函数、无需额外 LLM 调用;消融证明没有这道门控、接受全部提案时,nDCG 会跌破不优化的基线——“敢于改”必须配上“严格验”。
方法步骤详情
完整流程六步。第 0 步初始化:每文档 $K_0(d)=\{d\}$,原文是第一个且唯一固定的键。第 1 步查询供给:Query Simulator 均匀采样 $n$ 篇文档;对每篇先做一次 LLM 调用抽象其解决的底层问题(禁止出现文档专有名词),再做一次调用基于抽象写 $m$ 条查询——第二次调用看不到原文,从机制上减少词面复制;每条候选查询需通过 Answerability 判分(≥2/3)且与已用及已接受查询的 Jaccard 相似度 <0.8 才保留。第 2 步 Self-Diagnosis:对每条查询检索 top-$K$=30 个键;为每个被检索键 $k$ 构造共检索画像 $C_k$;LLM 收到“文档原文 + 当前键 + 各键画像 + 命中该文档的查询及得分”,输出 JSON 格式的诊断(哪个键/键组、什么原因)与修订指导,若无短板则不动该文档。第 3 步 Self-Revision:由被诊断键集合 $F_d$ 的画像支撑构造竞争键集 $C_d=\bigcup_{k\in F_d}\mathrm{supp}(C_k)$;LLM 把 $K(d)$ 作为整组修订——保留仍有效的键、改写或删除诊断出的键、新增若干新键,要求用“检索者会用的语言”书写、每键覆盖其他键没有的需求。第 4 步 Self-Validation:对 $K'(d)\setminus\{d\}$ 中全部生成键(含保留键)逐一验证——Faithfulness:LLM judge 按 0–3 打分,≥2 通过;Specificity:以键为查询检索,要求比源文档更相关的其他文档数小于 $K$,即 $\left|\{d'\in\mathcal{D}\setminus\{d\}:\mathrm{rel}(k',d')\ge\mathrm{rel}(k',d)\}\right|<K$;Separation:新键与竞争键的最大相关度 $P_{k'}=\max_{e_k\in C_d}\mathrm{rel}(k',e_k)$ 必须低于当前键组的 $P_d$。第 5 步更新:若至少一条新提出的键通过全部准则,则 $K(d)\leftarrow\{d\}\cup\text{通过的生成键}$(总数 ≤10),否则整组放弃;更新后的索引作为下一轮输入,循环 20 轮。
技术新颖性
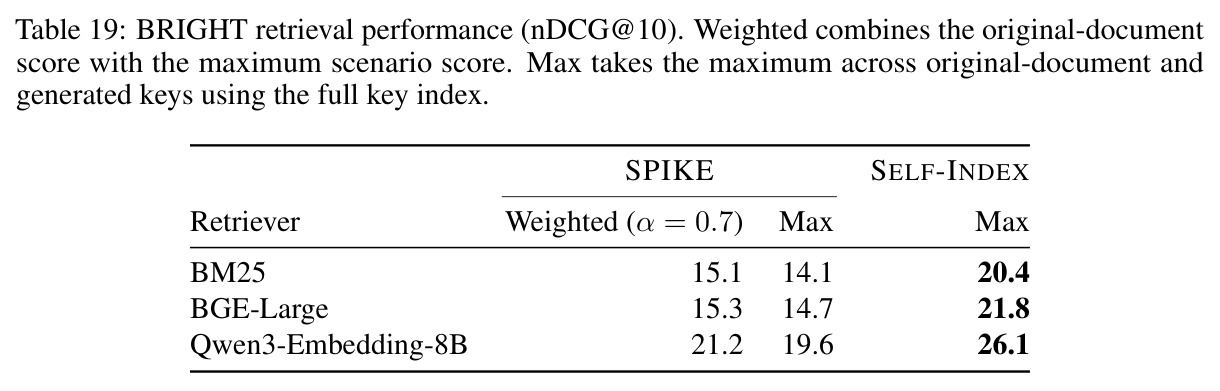
技术新颖性体现在五个层面。(1)范式层:首次把自进化框架应用于索引优化——此前自进化只用于推理模型(R-Zero、Absolute Zero)或智能体(Dr. Zero),索引始终是静态产物,本文让索引本身成为进化主体。(2)信号层:共检索画像把伪相关反馈从“查询改写”搬到“索引诊断”,利用跨查询共现统计判断键的区分力,是一个可复用的零标注诊断原语;消融显示去掉它,自然语言域平均 nDCG@10 掉 6.9 点。(3)机制层:三准则验证是框架安全性的关键——去掉整个验证环节,平均 nDCG@10 从 NL 26.6/Code 22.1/Math 17.2 分别跌至 16.1/13.0/11.9,全面低于不优化的基线。(4)工程层:max 聚合替代加权组合,把 SPIKE 也换成 max 后其分数从 15.1/15.3/21.2 降到 14.1/14.7/19.6,而 SELF-INDEX 保持 20.4/21.8/26.1,证明增益不来自聚合技巧。(5)探索层:两阶段查询生成(先抽象后书写)加词面去重,使模拟查询在 ReasonIR HQ 真实查询池之上再高约 2.7–2.9 点 nDCG,验证了“主动探索优于现成查询源”这一设计判断。
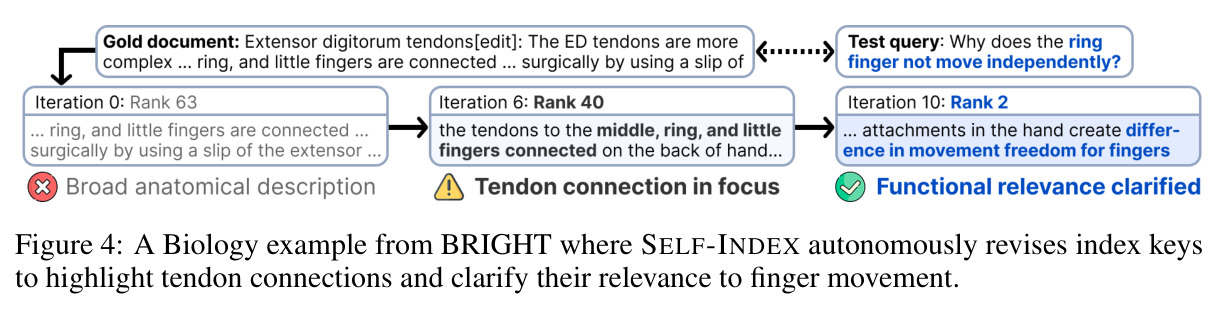
实验结果
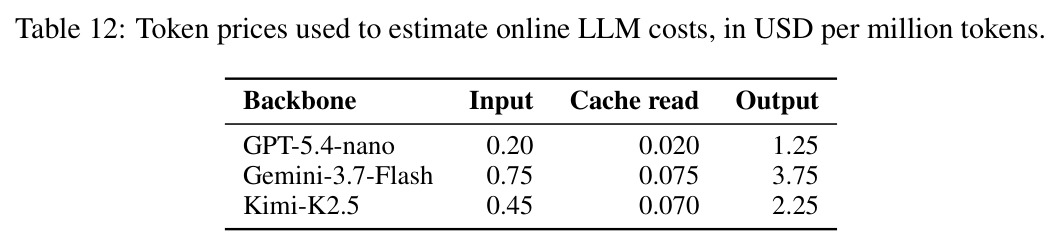
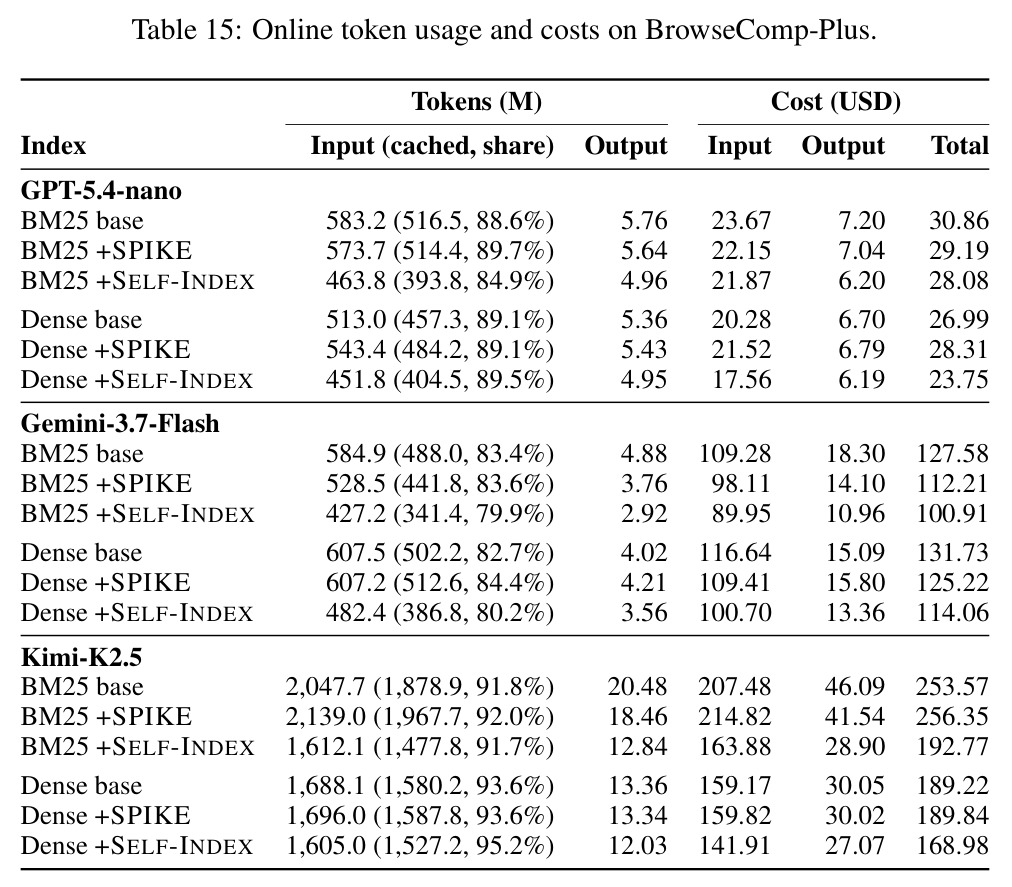
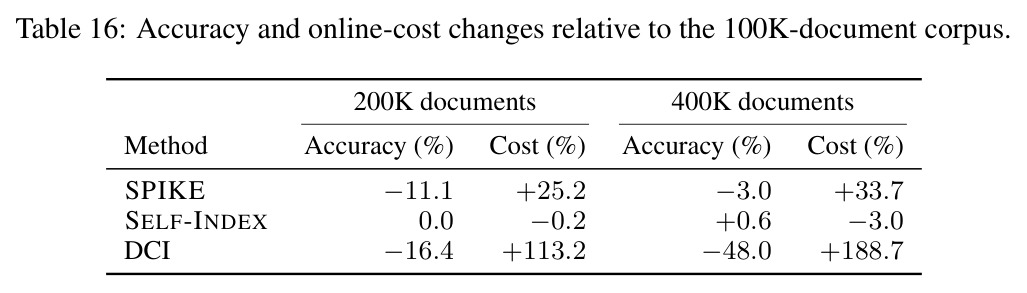
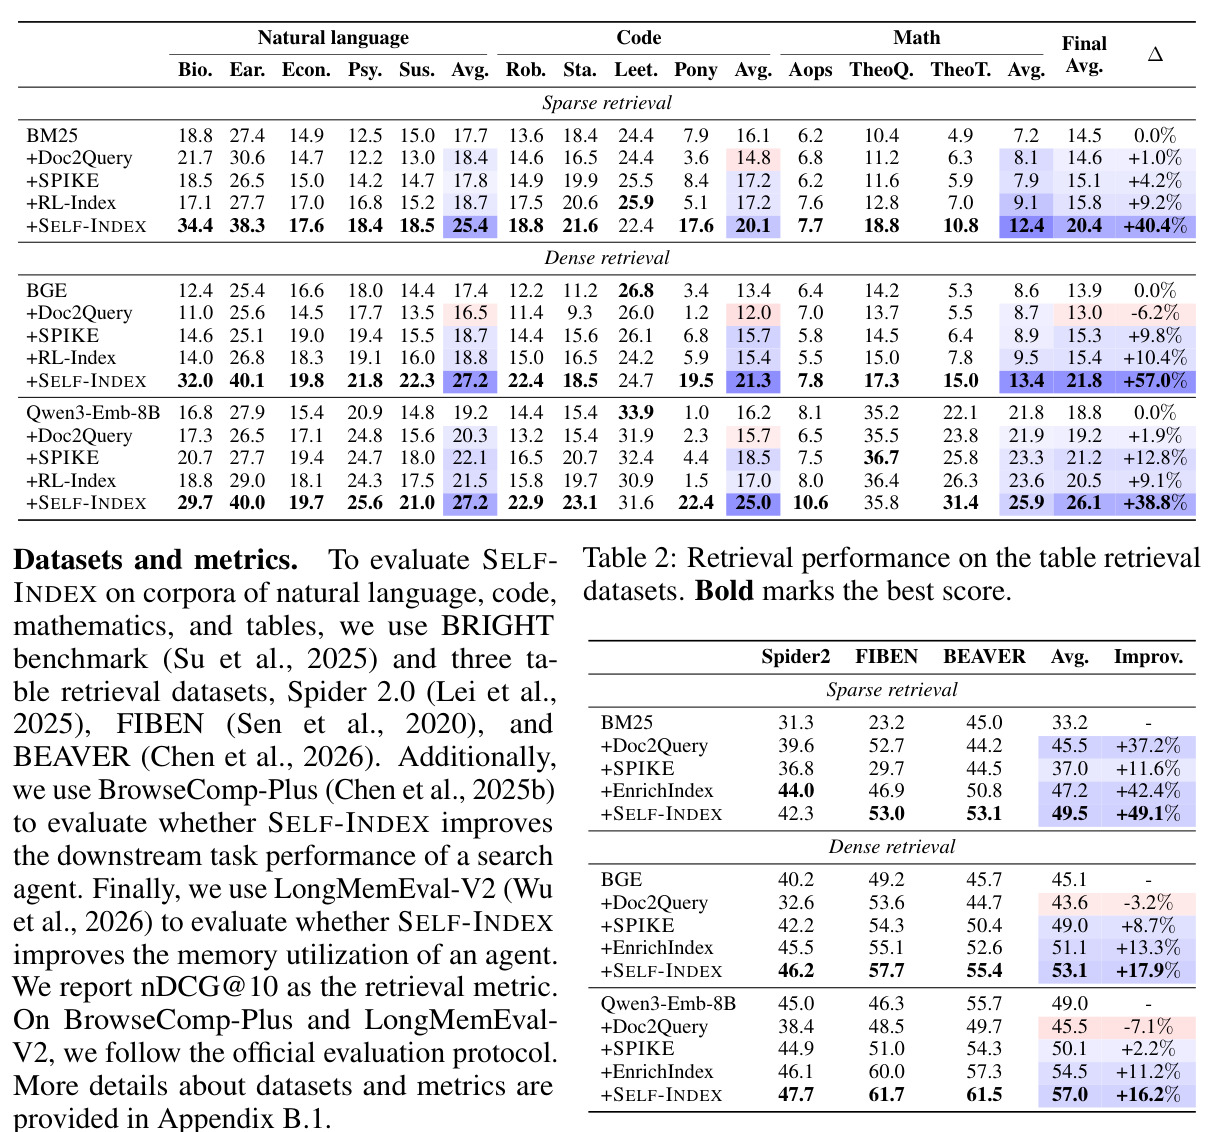
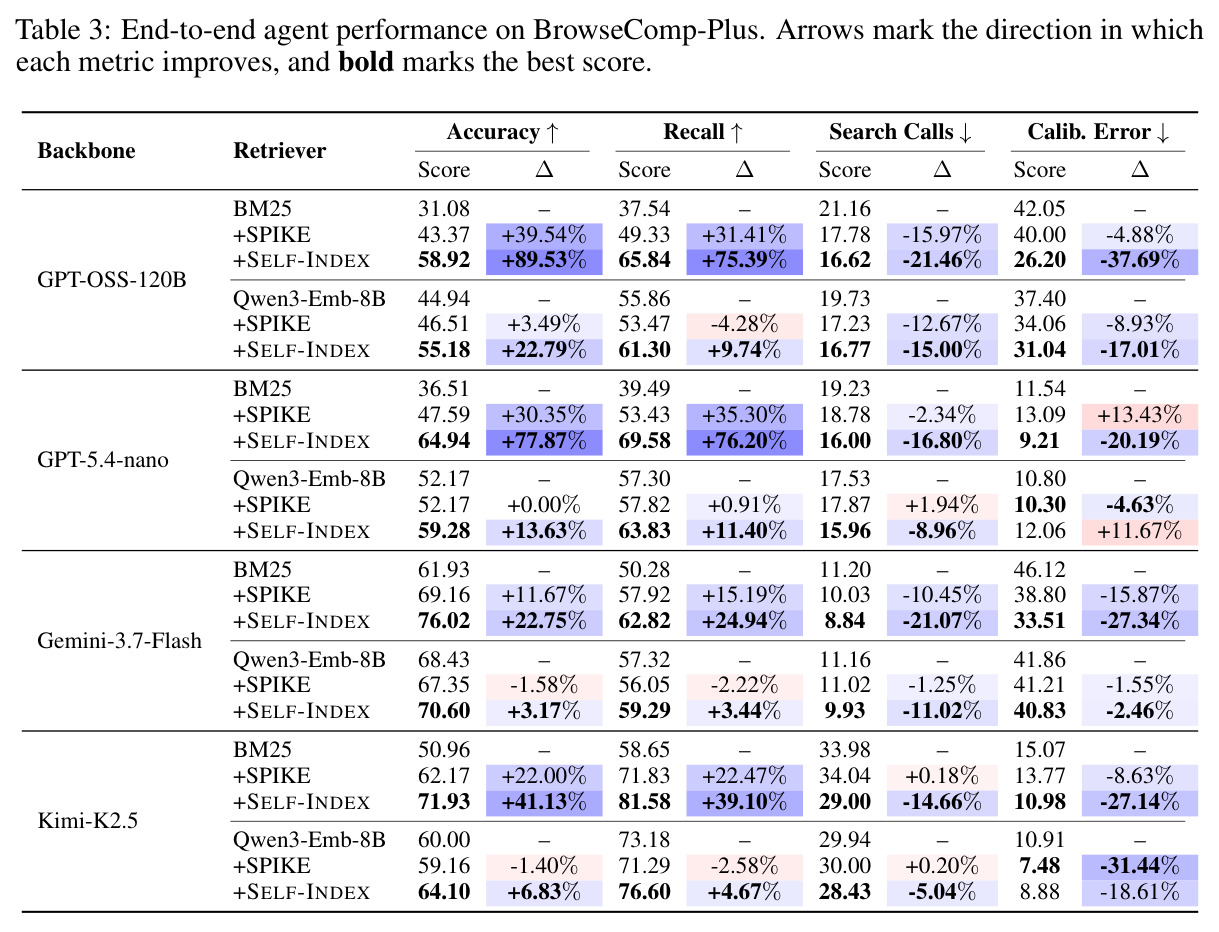
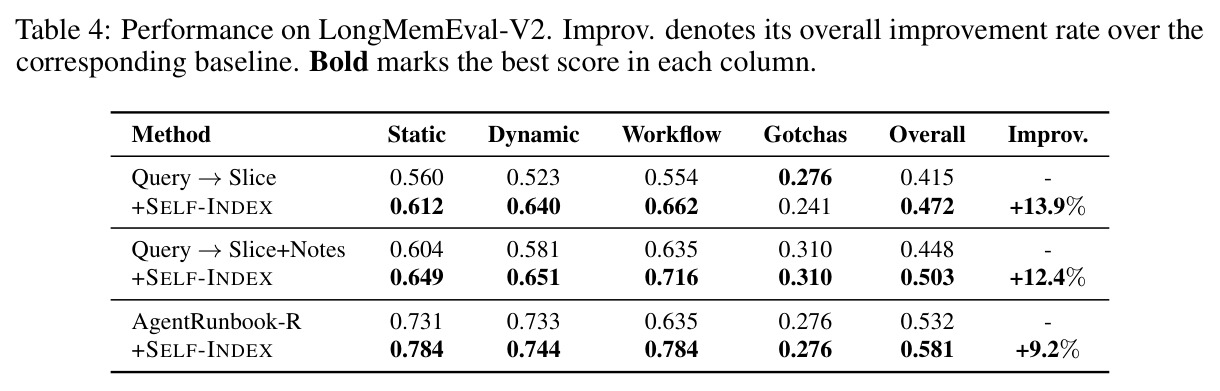
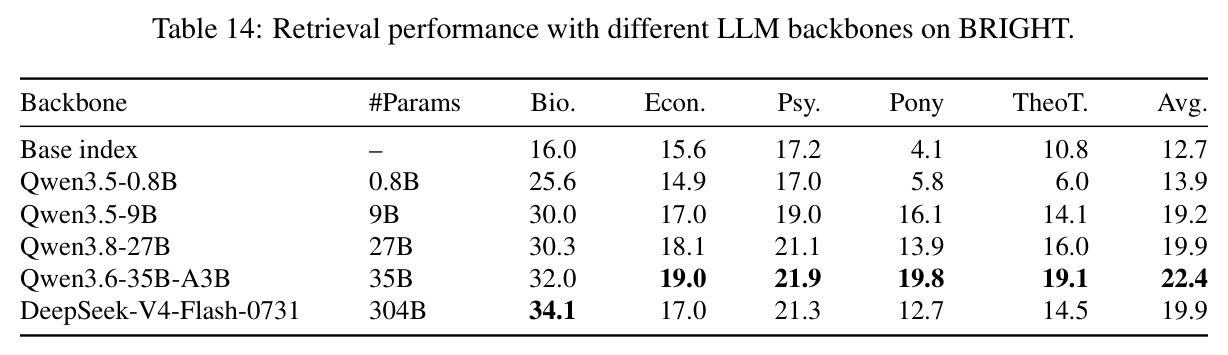
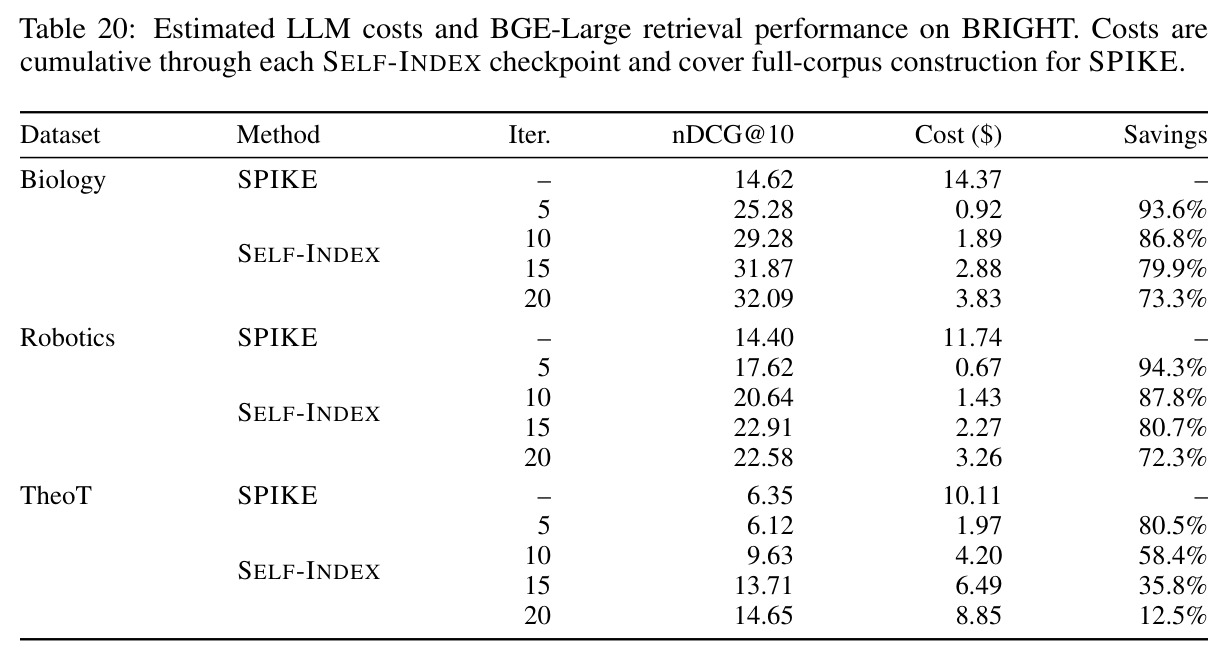
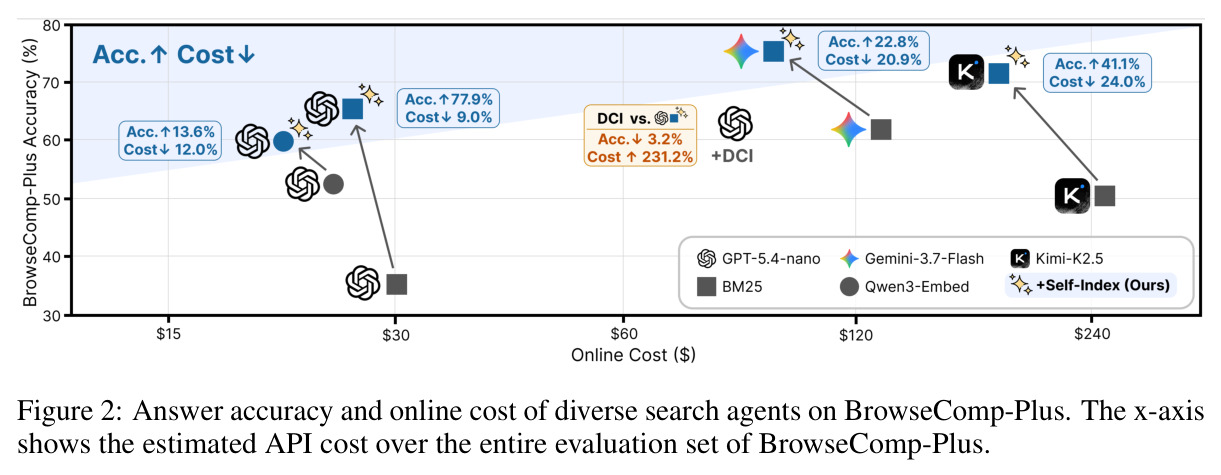
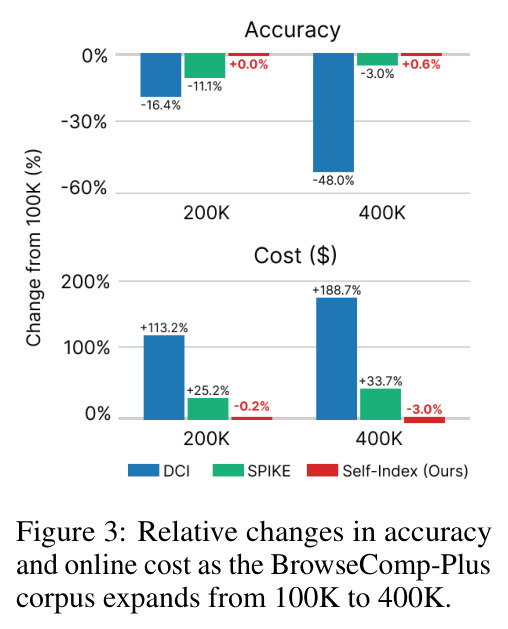
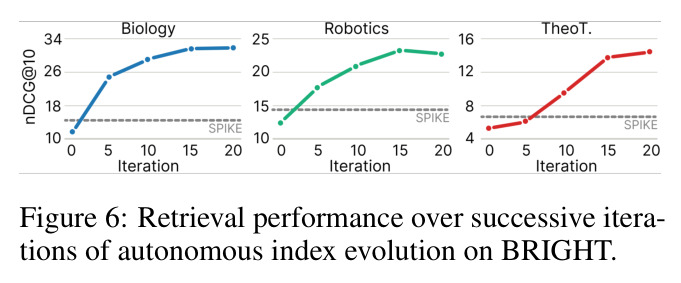
按实验逐一展开核心发现。(1)BRIGHT 检索(1,384 查询、12 数据集、nDCG@10 三次运行均值):SELF-INDEX 在全部 3 个检索器、3 类语料上的平均分都是第一。BM25:14.5→20.4(+40.4%),远超最强基线 RL-Index 的 15.8(+9.2%);BGE-Large:13.9→21.8(+57.0%),而 Doc2Query 反而退到 13.0(-6.2%);Qwen3-Emb-8B:18.8→26.1(+38.8%)。单域最大增益出现在 Biology(BM25 18.8→34.4)、Earth Science(27.4→38.3)与 Pony 代码语料(7.9→17.6);数学域增益较小(Qwen3-Emb 的 TheoremQA-Question 35.2→35.8 几乎持平)。(2)表格检索(Spider 2.0/FIBEN/BEAVER 平均):BM25 33.2→49.5(+49.1%,胜过 EnrichIndex 的 47.2);BGE 43.6→53.1(+17.9%);Qwen3-Emb-8B 49.0→57.0(+16.2%)。(3)搜索代理(BrowseComp-Plus 830 题):8 个“骨干×检索器”设置全部同时提升答案准确率与证据召回并减少搜索调用——GPT-OSS-120B+BM25 准确率 31.08→58.92(+89.53%)、搜索调用 21.16→16.62(-21.46%)、校准误差 42.05→26.20(-37.69%);GPT-5.4-nano+BM25 36.51→64.94(+77.87%);Kimi-K2.5+BM25 50.96→71.93(+41.13%)。成本方面 GPT-5.4-nano+BM25 全集 API 花费从 30.86 降到 28.08 美元,且“弱模型+SELF-INDEX”可追平免索引的 DCI 方法用同一模型的准确率、成本还更低。(4)语料扩展鲁棒性:从 10 万扩到 40 万文档,SELF-INDEX 准确率 +0.6%、成本 -3.0%;SPIKE 成本 +33.7%,DCI 准确率 -48.0%、成本 +188.7%。(5)代理记忆(LongMemEval-V2 451 题):Query→Slice 0.415→0.472(+13.9%)、Slice+Notes 0.448→0.503(+12.4%)、AgentRunbook-R 0.532→0.581(+9.2%),静态/动态/工作流能力一致提升,Gotchas 无提升(0.276→0.241)。(6)消融:验证环节最关键(去掉后全面低于基线);共检索画像在自然语言域贡献 -6.9 点;三条验证准则各自去掉都降 1.3–6.9 点;去 Dissimilarity 过滤掉 2.4–4.4 点。(7)离线效率:Biology 上第 5 轮即达 25.28(累计 $0.92),已超过 SPIKE 全库构建的 14.62($14.37);20 轮后 32.09($3.83),成本仅为 SPIKE 的约 27%。(8)骨干影响:0.8B 骨干平均仅 13.9、9B 达 19.2、35B-A3B 达 22.4,而 304B 反而回落到 19.9——参数量不是唯一决定因素。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BRIGHT 推理密集检索(BM25,12 数据集平均) | nDCG@10 | 20.4 | 基线索引 14.5;最强基线 RL-Index 15.8 | 较基线 +40.4%,较最强基线高 4.6 个点 |
| BRIGHT 推理密集检索(BGE-Large) | nDCG@10 | 21.8 | 基线索引 13.9;SPIKE 15.3;RL-Index 15.4 | 较基线 +57.0%(Doc2Query 为 -6.2%) |
| BRIGHT 推理密集检索(Qwen3-Embedding-8B) | nDCG@10 | 26.1 | 基线索引 18.8;SPIKE 21.2 | 较基线 +38.8% |
| 表格检索(Spider 2.0/FIBEN/BEAVER,BM25) | nDCG@10 平均 | 49.5 | 基线索引 33.2;EnrichIndex 47.2 | 较基线 +49.1%,超 EnrichIndex 2.3 个点 |
| 搜索代理端到端问答(BrowseComp-Plus,GPT-OSS-120B+BM25) | 答案准确率 | 58.92 | 基线索引 31.08;SPIKE 43.37 | 较基线 +89.53%,搜索调用同时减少 21.46% |
| 搜索代理端到端问答(BrowseComp-Plus,GPT-5.4-nano+BM25) | 答案准确率 | 64.94 | 基线索引 36.51 | 较基线 +77.87%,在线成本降至 28.08 美元(原 30.86) |
| 代理记忆利用(LongMemEval-V2,Query→Slice) | 答案准确率 | 0.472 | 0.415 | +13.9%(另两种记忆系统分别 +12.4%、+9.2%) |
局限与改进
作者承认与可观察到的局限。其一,Gotchas 能力不升反降(0.276→0.241),作者解释这类问题更依赖记忆系统如何把过往交互加工成内容,而 SELF-INDEX 只动检索键——这暴露了方法边界:检索质量并非所有下游失败的瓶颈。其二,强检索器+强语料域的增益有限:Qwen3-Emb-8B 在 TheoremQA-Question/Theorem 上基线已 35.2/22.1,进化后 35.8/31.4,前者几乎原地踏步;方法主要在基线弱的地方发力。其三,数学语料上的离线成本优势缩水:TheoremQA-Theorem 上 20 轮花费 $8.85,相对 SPIKE 的 $10.11 仅省 12.5%,且第 15→20 轮 nDCG 只从 13.71 升到 14.65,边际收益递减明显。其四,进化质量强依赖骨干 LLM:0.8B 模型在 Economics/Psychology/TheoremQA-Theorem 上反而低于基线,304B 模型(19.9)不如 35B-A3B(22.4),选型需要试错。其五,超参数(20 轮、每轮 128 查询、键上限 10、阈值 0.8 与 2 分)未系统消融;评估全部在学术基准完成,真实生产环境(亿级文档、查询分布漂移、多语言)未验证;Faithfulness 与 Answerability 的判官与优化器同模型,存在自我偏好风险;索引进化是离线批处理,未涉及在线持续进化。
独立分析的弱点
独立分析的弱点及改进方向。(1)诊断盲区:Self-Diagnosis 只覆盖“被检索到的键”——从未被检索的文档只有空画像,得不到诊断与修订机会,长尾/冷启动文档可能永远沉底;改进方向是引入覆盖率目标,主动为零检索文档采样查询(探索-利用平衡)。(2)自我验证的循环性:判断器与优化器同一骨干,模型偏见会被双重放大,论文未测试异构模型交叉验证;改进方向是用不同家族的 LLM 或纯检索信号做交叉验证。(3)检索器耦合:Specificity/Separation 用当前检索器的 rel 函数计算,进化结果与该检索器绑定,换检索器理论上要重新进化(论文对每个“语料×检索器”对单独跑 20 轮);改进方向是多检索器联合验证或蒸馏出检索器无关的键。(4)离线成本随语料线性增长且数学域性价比低:论文最大只验证到 40 万文档量级,亿级语料不可行;改进方向是文档聚类采样、按诊断置信度分层分配预算、把优化器蒸馏成小模型。(5)缺乏停止准则与在线机制:固定 20 轮在部分域明显浪费(TheoT 后 5 轮仅 +0.94 点却花 $2.36);查询分布随时间漂移时离线进化会过时;改进方向是基于改进饱和度的早停加在线增量进化。(6)键间干扰未建模:max 聚合下单个泛化过强的键可能遮蔽其他键的贡献,虽有保留键重验证,但缺少显式去冗余约束;改进方向是引入键间相似度正则或学习型聚合。
未来方向
未来研究方向。作者提出的延伸:(1)把 SELF-INDEX 推广到更多“有效支持用户”的检索场景(结论章展望),即让真实用户反馈参与索引进化;(2)继续扩展 Query Simulator 的探索覆盖。基于成果的自然延伸:(3)在线/流式自进化——让索引随真实用户查询持续进化,把搜索代理的检索轨迹作为查询源(比模拟查询的分布更真实),形成 agent 与索引的共进化闭环;(4)与策略学习结合——用 RL-Index 式强化学习把 SELF-INDEX 的诊断-修订模式蒸馏为固定策略以降低成本,或用其生成的(语料、查询、修订)三元组训练小型优化器;(5)跨域/跨检索器迁移——研究一个环境学到的键风格能否零样本迁移到新环境,减少每对组合重跑 20 轮的开销;(6)多模态索引——把记忆条目中的图片、表格、轨迹状态纳入键进化(LongMemEval-V2 实验已触及多模态历史);(7)理论化——形式化三准则与 nDCG 增益的关系、分析进化过程的收敛性与稳定性;(8)安全审计——LLM 生成的键可能虚构或泄露文档内容,生产部署需要溯源与幻觉检测层。
复现评估
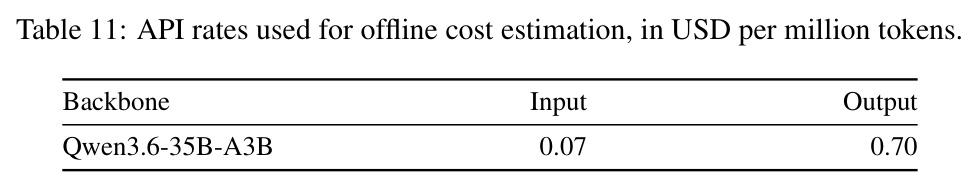
复现评估:摘要处标注 [CODE],代码开源。整体可复现性较高:(1)方法完全由 prompt 编排、无需训练,附录 A 给出全部 6 个 prompt(Self-Diagnosis、Self-Revision、Faithfulness 判官、文档抽象、查询书写、Answerability 判官)全文与 3 个伪代码(算法 1–3);(2)超参完整:键上限 10、每轮 128 查询、检索深度 30、20 轮共 2,560 查询、Jaccard 阈值 0.8、LLM 判分阈值 2/3、竞争键集与评分函数定义齐全;(3)成本透明:主实验骨干 Qwen3.6-35B-A3B($0.07/M 输入、$0.70/M 输出),单个数据集 20 轮离线成本约 $0.9–$8.9,用 API 即可复现单数据集,无需自有 GPU;(4)数据全部公开(BRIGHT、Spider 2.0、FIBEN、BEAVER、BrowseComp-Plus、LongMemEval-V2);(5)基线均以官方实现+同一骨干复现,主结果报告三次运行标准差(SELF-INDEX 各域标准差多在 ±0.1–0.8 内)。风险点:论文使用的部分模型版本较新(Qwen3.6-35B-A3B、GPT-5.4-nano、Gemini-3.7-Flash、Kimi-K2.5、DeepSeek-V4-Flash 等),复现时需确认模型与基准版本的可获取性;搜索代理实验为 830 题×多骨干的在线调用,总花费不低(Kimi-K2.5 单配置超 250 美元)。总体难度中等偏低,主要工作量在工程实现与 LLM API 费用。
论文图表