PANORAMA:基于掩码候选选择的全景接地图像描述 PANORAMA: Panoptic Grounded Captioning via Mask Proposal Selection
把短语接地建模为掩码候选选择,配合人标基准PanoCaps实现密集像素级全场景描述
前置知识
全景分割
把图像所有像素划分到互不重叠的区域:前景物体按实例分割,背景区域(天空、草地、墙面)按语义类别分割,二者统一编码。每个区域是一个掩码,全部掩码的并集近似覆盖整幅图像,同时刻画“是什么”和“在哪里”。
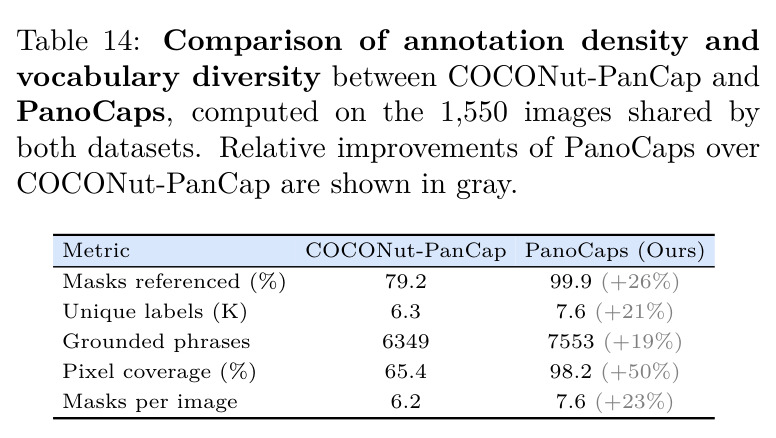
PanoCaps 的标注、99% 像素覆盖率指标和 gPQ 评价都建立在全景掩码之上,不理解 things/stuff 的区分就无法理解任务定义与数据统计。
[SEG] 特殊 token 接地
视觉语言模型生成文本时,每提到一个实体就输出一个特殊 token [SEG],取其在最后一层的隐状态,投影后送入分割模块的掩码解码器直接解码出该短语的掩码。GLaMM、Sa2VA 等主流方法均采用此路线,单个隐向量必须同时编码“指什么”和“边界在哪”。
这是本文要改造的基线范式:PANORAMA 把“用 [SEG] 直接解码掩码”换成“生成候选池再选择”,消融实验正是与该范式做受控对比。
DETR 式集合预测与匈牙利匹配
检测/分割模型输出固定数量的一组查询,每个查询解码出一个候选框或掩码;训练时用匈牙利算法在预测与真值之间做全局最优一对一指派,再对指派上的正样本计算损失,无需锚框与非极大值抑制。SAM 3 的解码器即为此结构。
PANORAMA 的候选池就是 SAM 3 解码器的 200 个查询,训练中的匹配代价函数与消融实验都依赖这一集合预测机制。
可提示分割器(SAM 系列)
在海量数据上预训练的分割模型,接受点、框、文本等提示并输出对应目标的掩码,具备强零样本泛化能力。SAM 3 还支持用名词短语分割所有同类实例,内部含 CLIP 风格文本塔(约 354M 参数)、融合编码器和 DETR 式解码器。
PANORAMA 直接复用 SAM 3 的图像检测器作为候选掩码提供者,并砍掉其文本塔、用概念向量取而代之,不了解其组件就无法看懂接口设计。
LoRA 低秩适配微调
冻结原模型权重,在注意力与 MLP 投影旁路注入低秩分解矩阵 $W + BA$,只训练少量新增参数即可适配下游任务,显著降低显存与训练成本,效果接近全参数微调。
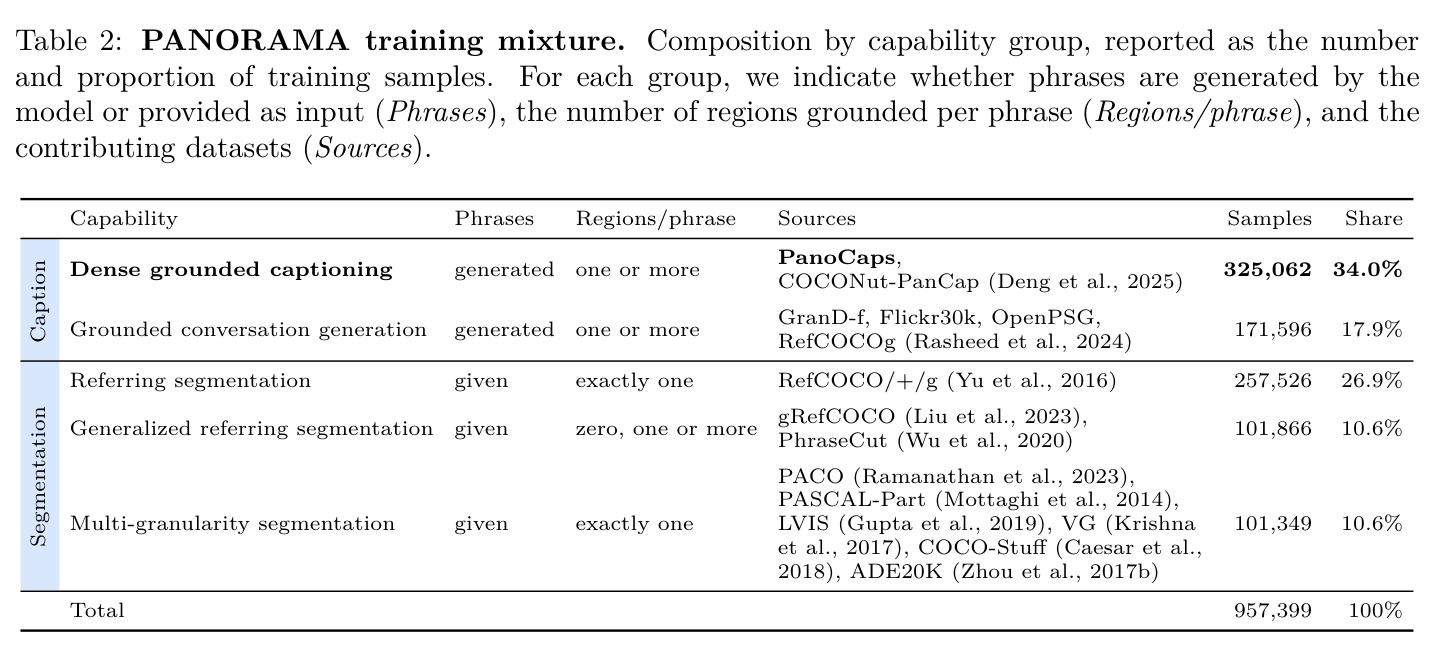
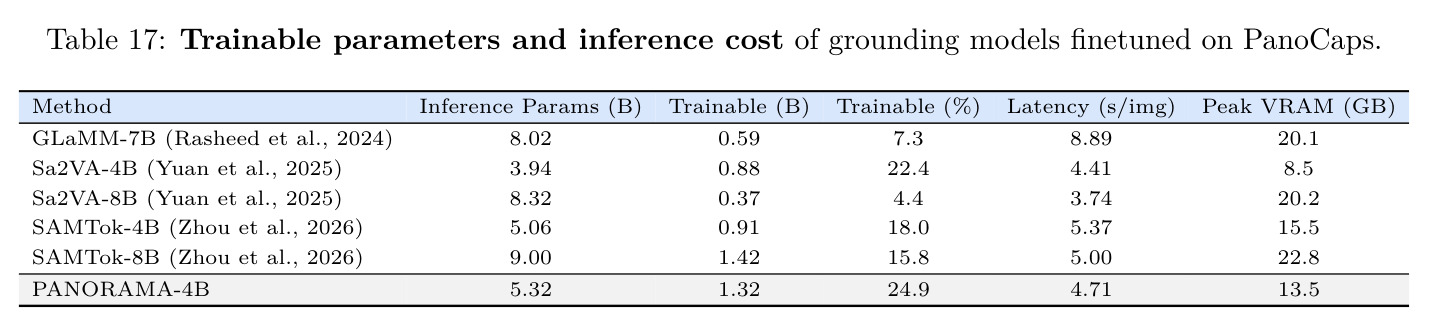
PANORAMA 用 LoRA(rank 256)微调 Qwen3-VL,同时冻结两个视觉编码器与 SAM 3 大部分模块,训练参数仅 1.32B(24.9%),这是其训练成本可控的关键。
短语接地任务族(RES/GRES/GCG)
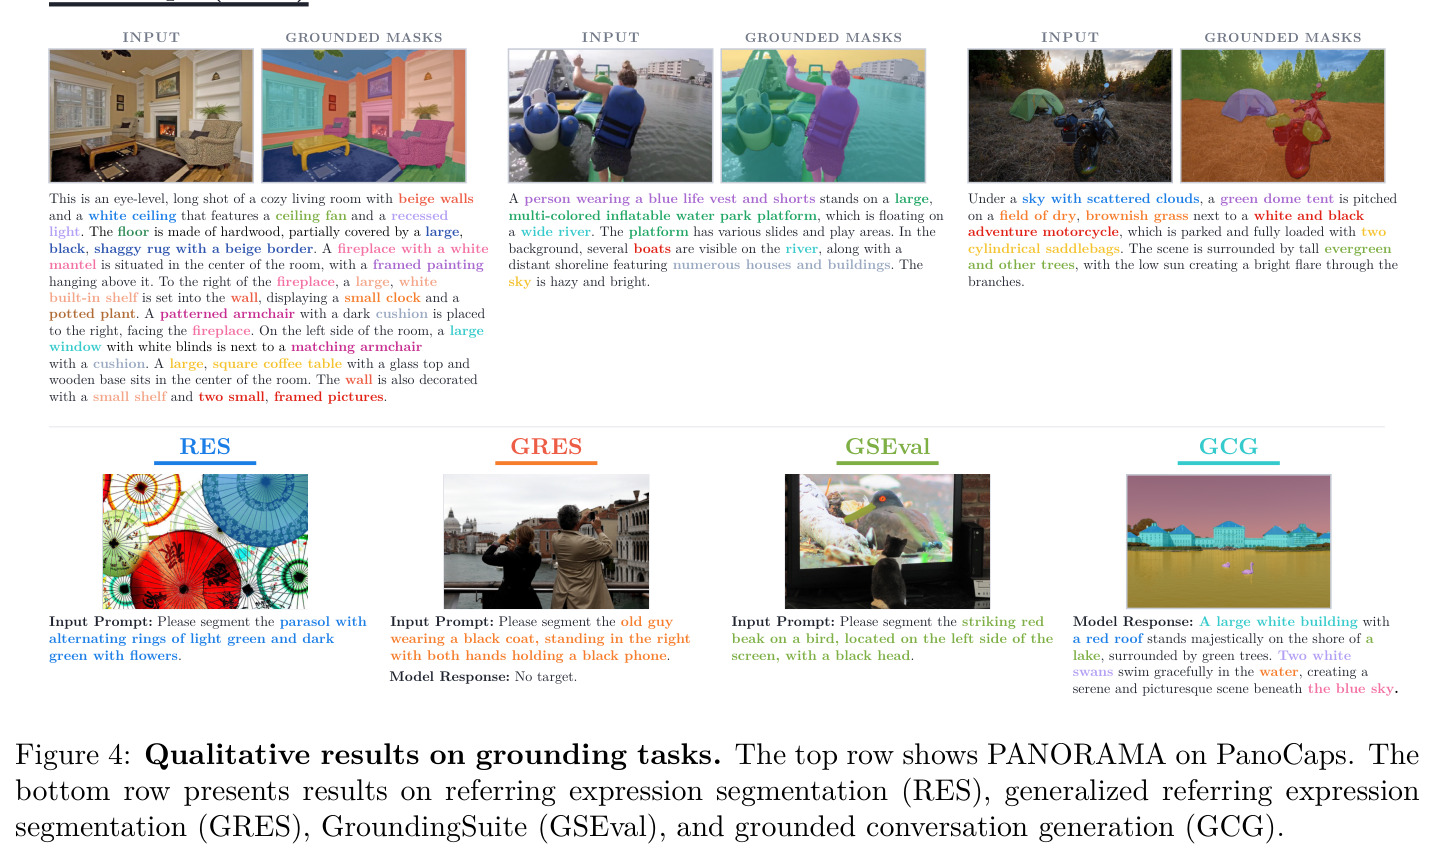
RES(指代表达分割)对给定短语分割单个目标;GRES(广义指代分割)允许目标为零个、一个或多个实例;GCG(接地对话生成)要求模型生成描述并为提到的每个实体配掩码。它们沿“短语是给定还是生成”“目标是一个还是多个”两个轴分布。
论文用统一公式覆盖这些任务,并在 PanoCaps、GCG、RefCOCO、GRES、GroundingSuite 五类基准上评测,不了解任务定义就读不懂实验部分。
研究动机
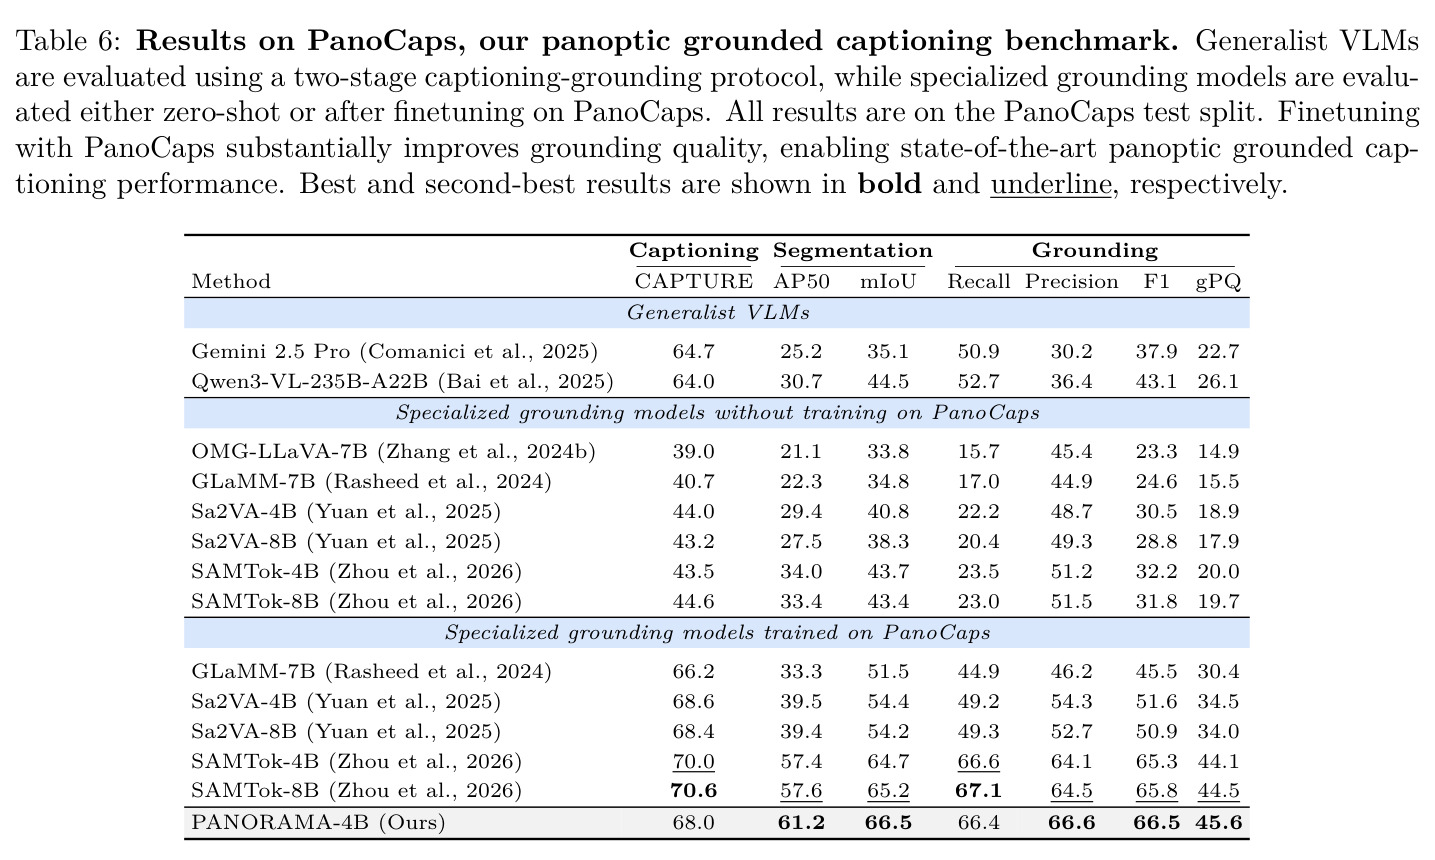
现代视觉语言模型能写出流畅详尽的图像描述,却难以把描述可靠地对应到图像像素上。已有“密集描述+像素接地”的尝试两头落空:自动构造的数据集如 GranD-f 的标注常短到只有一个短语(如 “Snow covered park benches”),大量场景内容未被描述;COCONut-PanCap 虽更密集,但标注缺乏充分人工校验,存在事实错误(把干枯的棕色地面说成 green grass)、指代错位(把蓝色笔接成 “toothbrush”、把钞票接成 “paper”)和噪声掩码,且训练图像局限于 COCO。模型侧,直接用 [SEG] 隐状态解码掩码,把语义识别和边界勾画压在一个为自回归语言生成设计的表示上,导致粗掩码与错配频发。实测差距惊人:在 PanoCaps 上最强通用模型 Gemini 2.5 Pro 的 gPQ 仅 22.7、Qwen3-VL-235B 仅 26.1;零样本专用模型(GLaMM、Sa2VA、SAMTok)召回率只有 15.7–23.5,会漏掉场景中的机器人和笔等关键实体,密集描述与精确接地无人兼得。
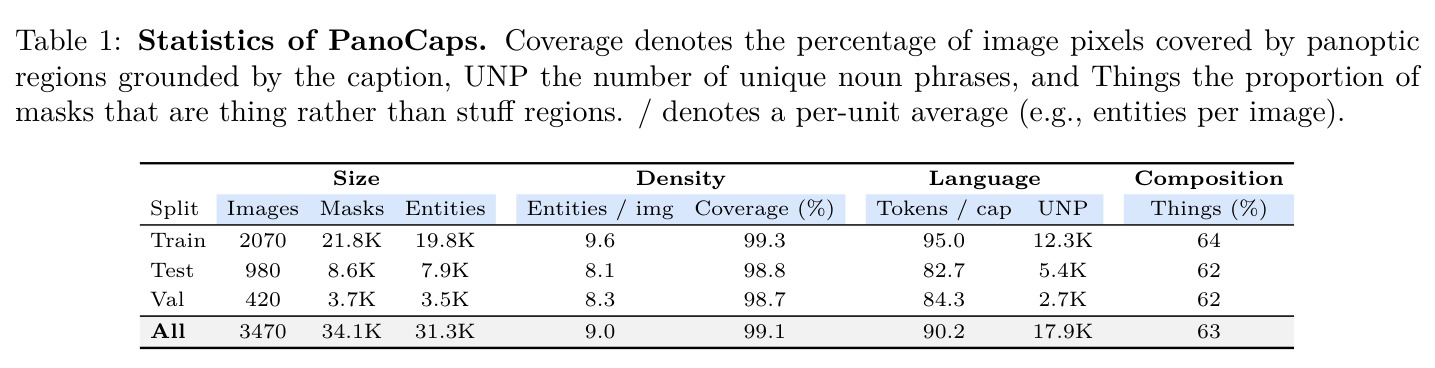
本文的目标是本文要同时解决数据和模型两件事。数据上,构建一个人工书写、经独立校验的全景接地描述基准 PanoCaps:约 3.5K 图像、34.1K 全景掩码、31.3K 接地实体,掩码覆盖率约 99%,每图平均 9 个实体、17.9K 个独特名词短语,短语与掩码逐一显式对齐(9.8% 短语对应多个掩码,12.5% 掩码被多个短语引用),并配套开放文本短语-掩码匹配协议和广义全景质量指标 gPQ。模型上,提出 PANORAMA:在不牺牲语言质量的前提下,为生成描述中的每个短语输出实例级精确掩码,支持单实例与多实例指代,并在 GCG、RES、GRES、GroundingSuite 等相关接地任务上匹配或超越专用模型。
与已有工作不同的是,本文的独特切入有两条线。数据线:此前学界默认“规模换质量”,用自动管线换标注密度;PanoCaps 反其道行之,投入约 1,530 人时(标注约 15 分钟/图、复核约 12 分钟/图)做人工书写与双重校验,证明 2,070 张高质量图胜过 57 倍量的自动数据。模型线:已有工作要么用 [SEG] 直接解码掩码(GLaMM、Sa2VA),要么把掩码离散成 token 自回归生成(SAMTok),要么从与短语无关的图像级候选池选择(GROUNDHOG);PANORAMA 把接地重构为“从短语条件化的候选池中选择”——概念向量先塑造候选池再参与打分,语义识别与边界勾画彻底解耦,无需掩码分词器或专门像素解码器,单个 [SEG] 即可对应多个保留实例的掩码。
核心方法
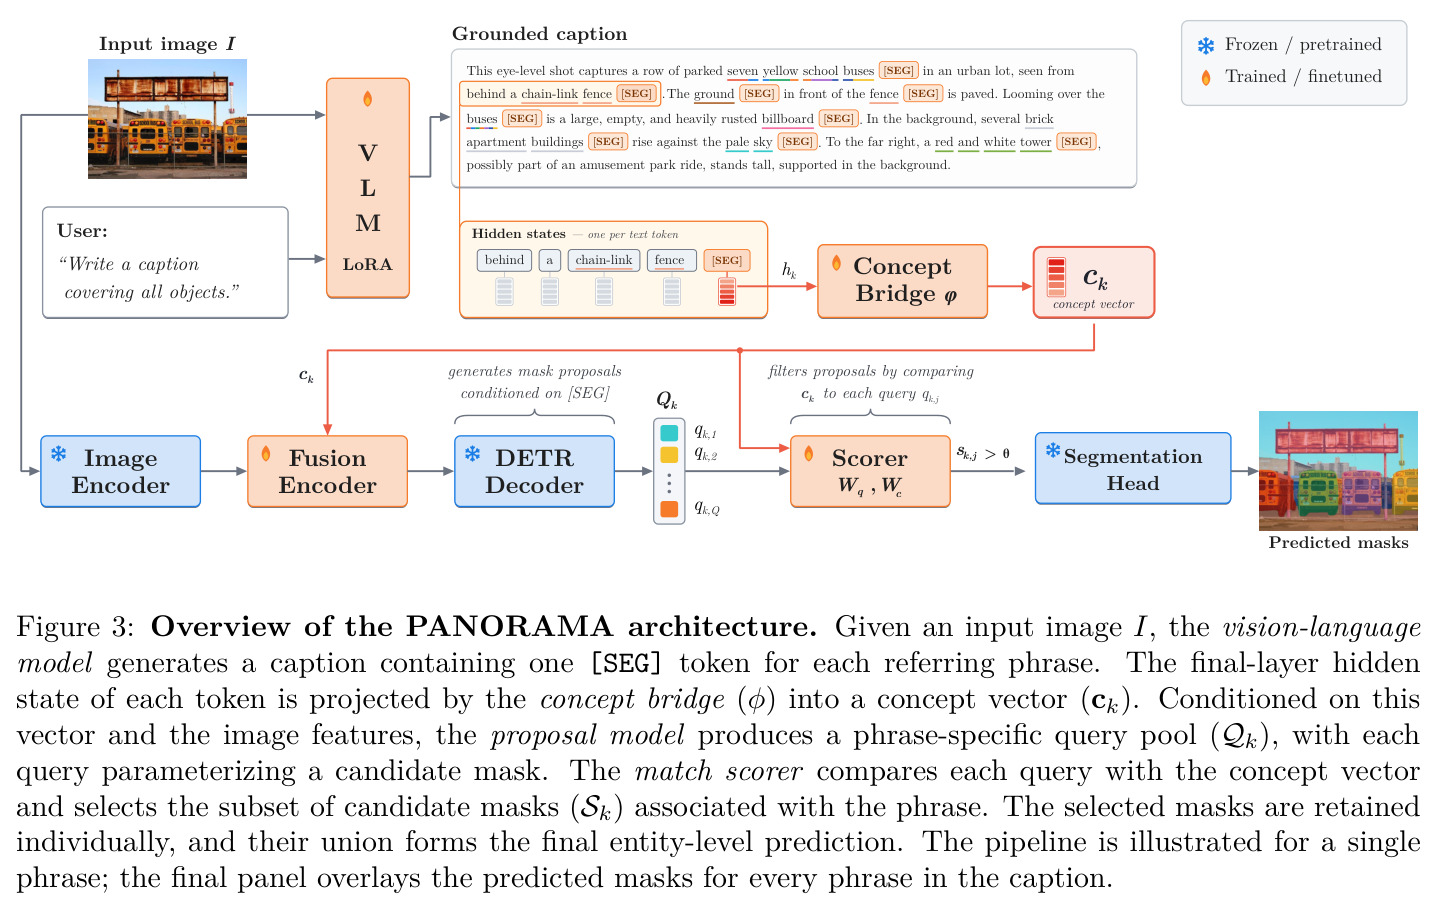
直觉上,让一个自回归语言模型既想清楚“说什么”又亲手画出像素边界是强人所难,更合理的分工是:VLM 负责决定指代对象(语义),预训练分割器负责勾画边界(空间),一个轻量打分器把两者连起来。技术上,PANORAMA 基于 Qwen3-VL(4B 主模型、2B 消融),生成形如 “a
brown dog
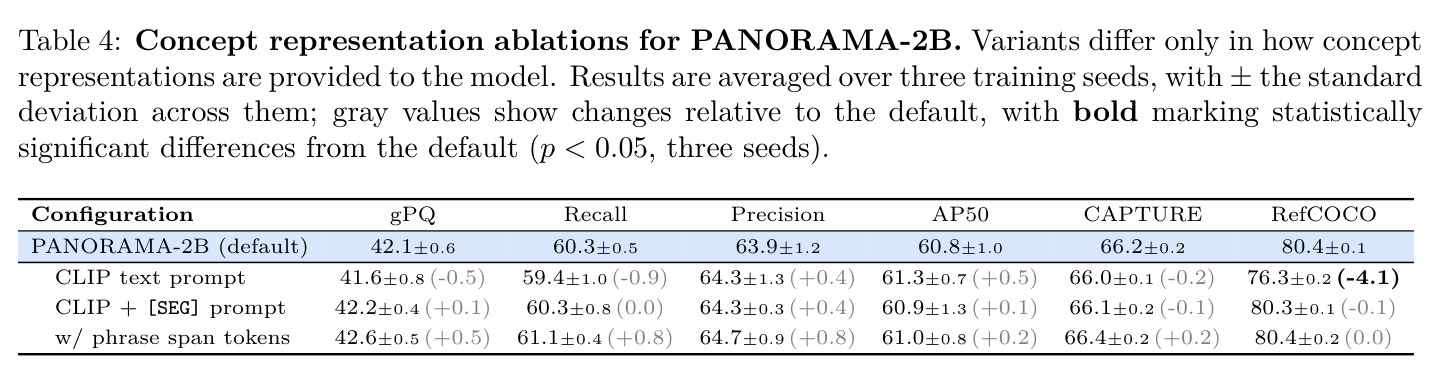
[SEG] chasing ...” 的描述;每个 [SEG] 的末层隐状态 $h_k$ 经概念桥 $\phi$ 投影为 256 维概念向量 $c_k \in \mathbb{R}^{256}$;SAM 3 的融合编码器通过交叉注意力把 $c_k$ 注入图像特征,DETR 式解码器输出 $Q=200$ 个查询的短语专属候选池,分割头将每个查询解码为候选掩码;打分器对每个查询与概念向量做投影点积过 sigmoid,阈值 0.5 筛出该短语的掩码集合。训练在 957K 样本的混合数据上进行,四个损失联合优化,语言与分割端到端对齐,全程 16 张 H100 约 5–7 小时。核心创新是“短语条件化候选池 + 显式选择目标”的接地接口。已有方法中 [SEG] 表示必须同时编码指代身份与空间范围;PANORAMA 让概念向量只负责“指什么”,SAM 3 负责“边界长什么样”,打分器负责对齐,三者解耦。与 GROUNDHOG 的图像级固定候选池不同,候选池在生成阶段就被概念向量引导,聚焦于短语所指实体;与直接解码相比,选择机制天然输出集合,可以是一个、多个或零个掩码,且保留每个实例的独立掩码而非把多实例糊成一团。训练时打分器与描述生成联合优化:匈牙利匹配代价 $C(i,j) = 1 - \mathrm{Dice}(m_{k,j}, g_{k,i}) - \lambda s_{k,j}$($\lambda=0.25$)在多个候选掩码重叠相近时,优先把正样本指派给打分器已认可的候选,形成表征空间的正向循环。附加巧思:用 [SEG] 投影表示同时承担 SAM 3 文本塔的条件化与打分两个角色,省去 354M 参数和逐短语文本编码。
方法步骤详情
第一步(描述生成):Qwen3-VL 自回归生成自由格式全场景描述,每个可接地短语用
...
包裹并跟随一个 [SEG],无可接地内容的表述不输出 [SEG]。第二步(概念投影):取第 $k$ 个 [SEG] 的末层隐状态 $h_k$,经可学习投影 $\phi$ 得到 $c_k \in \mathbb{R}^{256}$。第三步(候选生成):SAM 3 融合编码器以 $c_k$ 为单 token 提示与图像特征交叉注意力,DETR 解码器输出 $Q=200$ 个查询的池 $Q_k$,分割头将每个查询解码为候选掩码 $m_{k,j}$。第四步(选择与输出):打分器计算 $s_{k,j} = \sigma(\psi_q(q_{k,j}), \psi_c(c_k))$,推理时以阈值 $\theta=0.5$ 独立筛选得 $S_k$,选中掩码上采样二值化,保留实例、按评测需要取并集;图像骨干特征全短语共享。第五步(训练):按 $C(i,j) = 1 - \mathrm{Dice}(m_{k,j}, g_{k,i}) - \lambda s_{k,j}$($\lambda=0.25$)匈牙利匹配,优化 $\mathcal{L} = \mathcal{L}_{text} + \mathcal{L}_{sel} + \mathcal{L}_{mask} + \mathcal{L}_{sem}$:文本交叉熵、sigmoid focal 选择损失(0.5)、BCE+Dice 掩码损失(2.0/0.5)与辅助语义损失;LoRA rank 256、lr $4\times10^{-5}$、1 epoch、批 128、16 张 H100 约 5–7 小时。技术新颖性
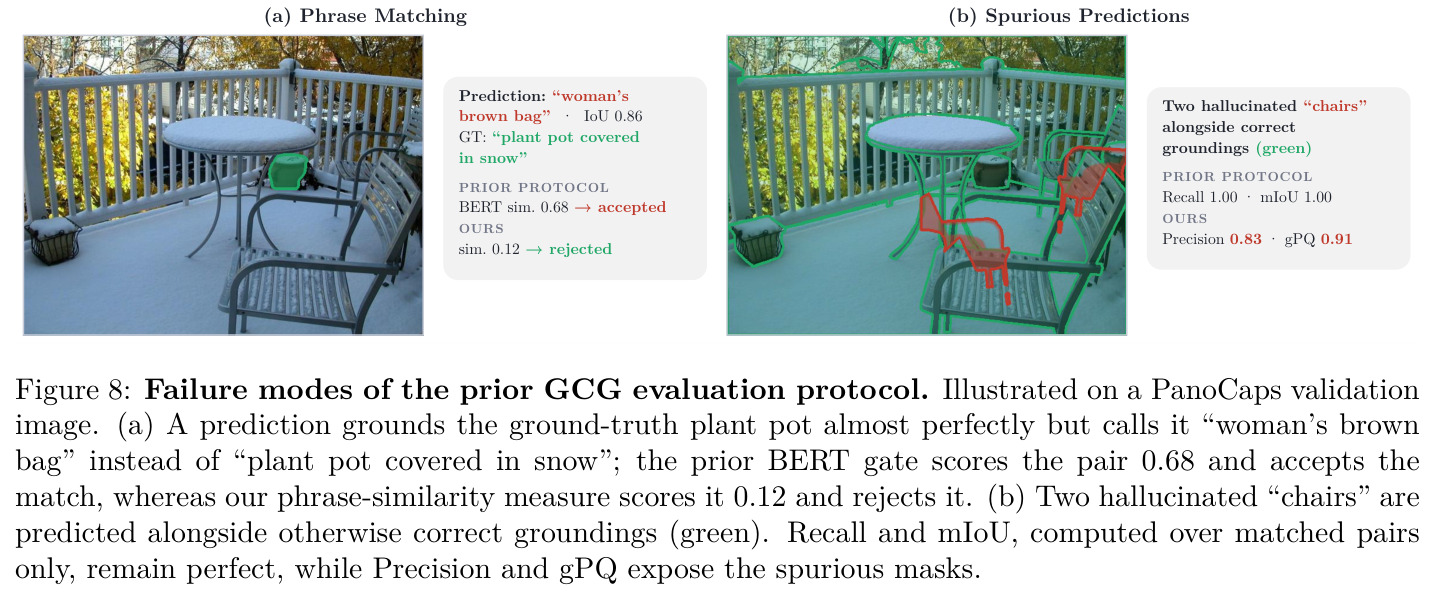
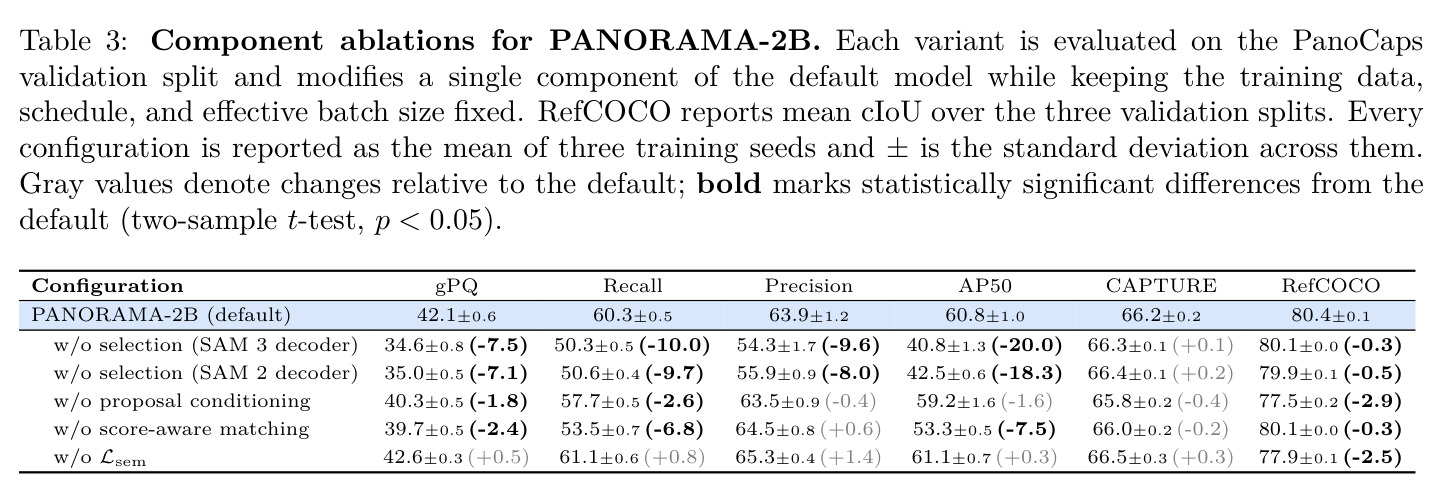
技术新颖性有四点。其一,把接地显式建模为“条件化生成候选 + 学习选择”,在同等数据与训练预算的受控对比下比直接解码高 7.5 gPQ、20.0 AP50(CAPTURE 基本不变),证明语义识别与边界勾画分离本身有价值,而非数据或容量差异。其二,候选池随短语条件化,消融显示移除后 gPQ 降 1.8、RefCOCO 降 2.9,明确区别于 GROUNDHOG 的静态池。其三,单一 [SEG] 通过集合选择支持 1 到 n 个目标:避免 GSVA 式每实例一个 token 的序列膨胀,也避免 SAMTok 式掩码离散码本及其额外训练阶段,同时保留逐实例掩码。其四,性能主要来自学习 VLM 与分割器的接口(融合编码器、打分器、概念桥)而非适配分割器本身——冻结整个 SAM 3 或解冻 DETR 解码器与掩码头都不改变结果。评测侧的 gPQ 把 PQ 从固定语义类别扩展到自由短语与分级匹配质量,配套短语相似度(精确/词元/WordNet 同义词/MPNet 嵌入级联)在 BiRD 上与人类判断的 Spearman 相关达 0.72,远超先前 BERT 基线的 0.45。
实验结果
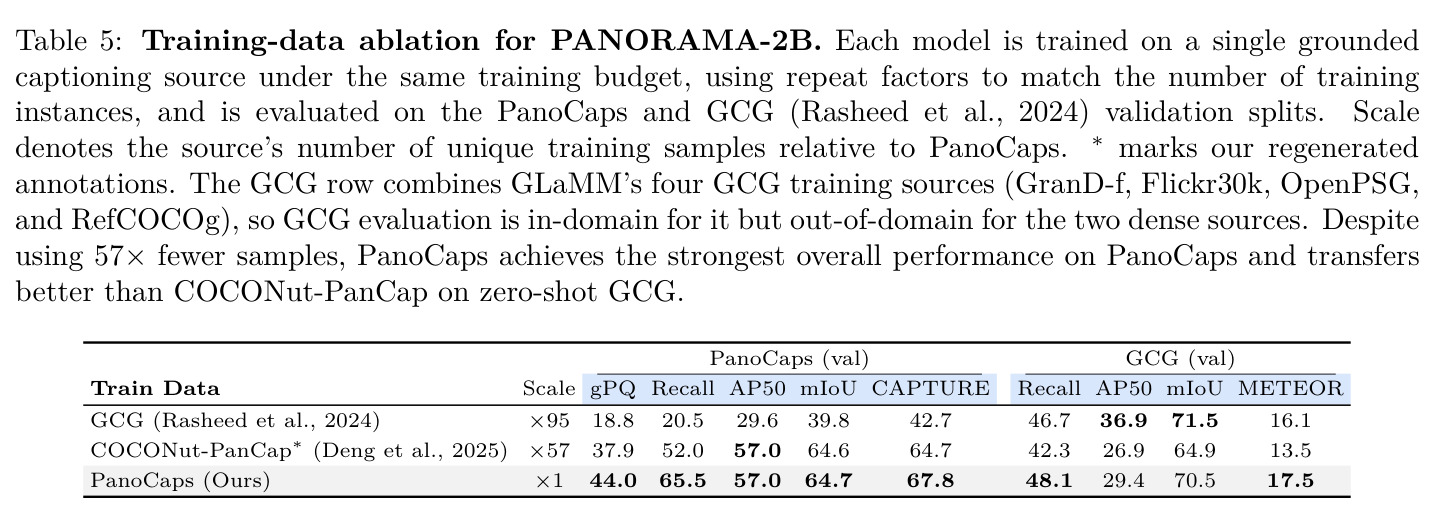
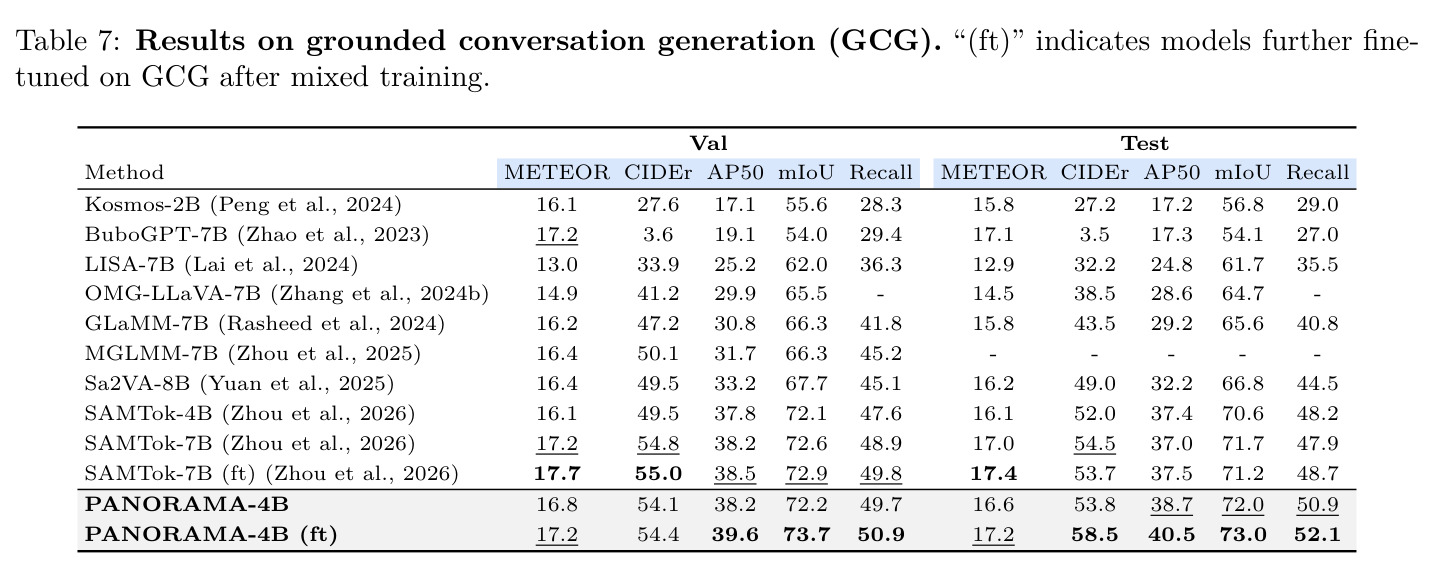
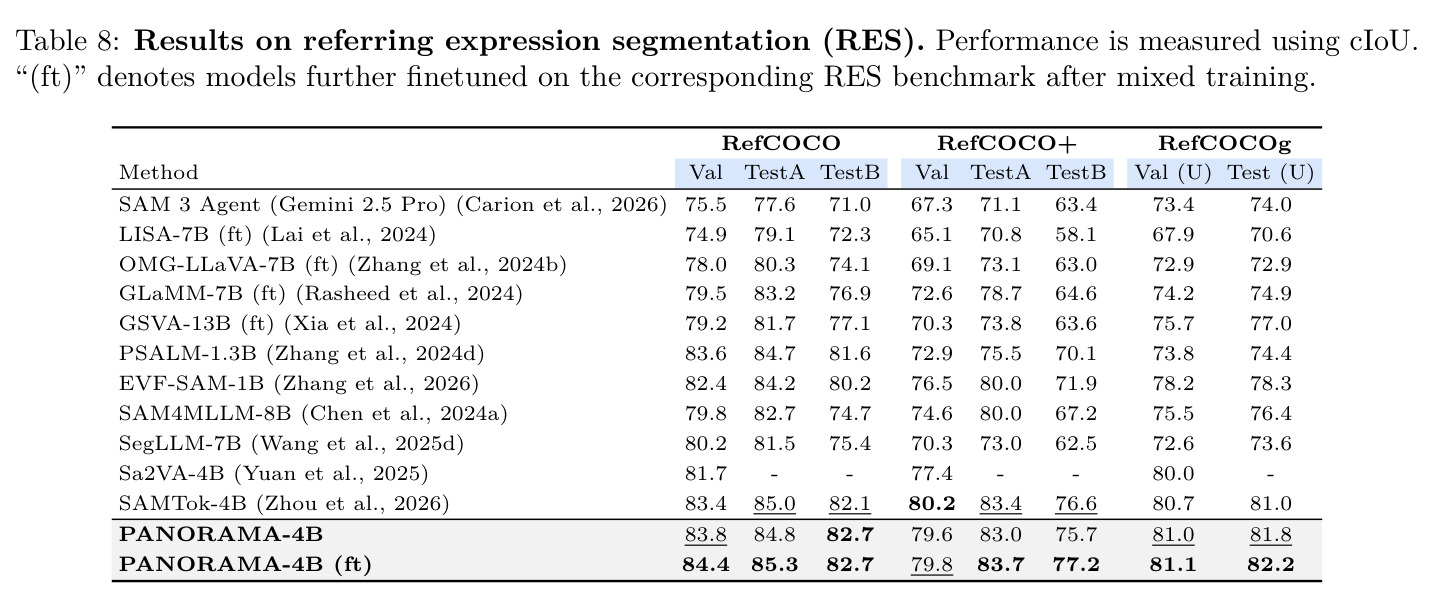
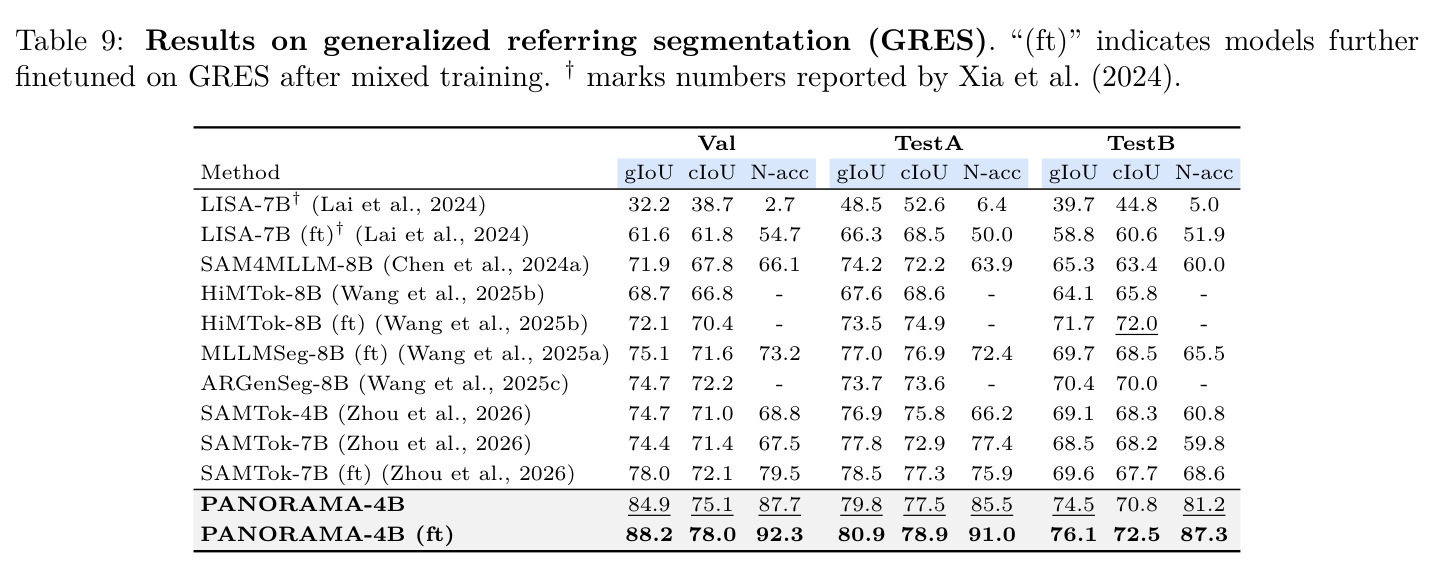
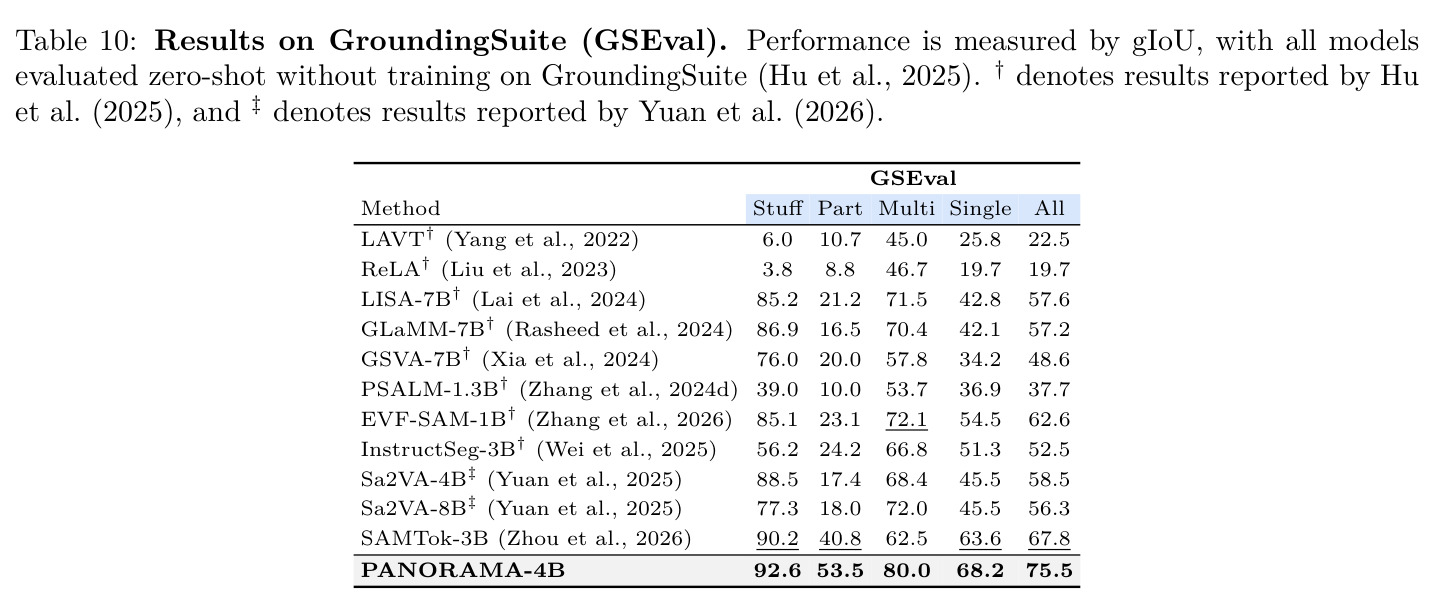
PanoCaps test 上,PANORAMA-4B 取得 gPQ 45.6、AP50 61.2、mIoU 66.5、Precision 66.6、F1 66.5 五项最佳;最强基线 SAMTok-8B 微调后 gPQ 44.5、Recall 67.1、CAPTURE 70.6,纯文本指标仍领先本文(70.6 vs 68.0),但本文在召回相近时精确率与掩码质量更高。零样本专用模型 gPQ 仅 14.9–20.0,通用大模型 Gemini 2.5 Pro / Qwen3-VL-235B 仅 22.7 / 26.1;PanoCaps 微调使各基线 gPQ 提升 15–25 点,说明密集监督是决定性因素。消融(2B 默认 42.1):去掉选择机制降 7.5 gPQ、20.0 AP50(换 SAM 2 解码器仅差 0.4,排除解码器特异性);去掉短语条件化降 1.8 gPQ、2.9 RefCOCO;去掉打分感知匹配降 2.4 gPQ、7.5 AP50;仅用 CLIP 文本提示降 4.1 RefCOCO。数据消融:仅 2,070 张 PanoCaps(比 COCONut-PanCap 少 57 倍)达 44.0 gPQ,高出 6.1,且 GCG 零样本迁移全面更优。迁移能力:GCG 微调后 10 项指标 7 项最佳(test Recall 52.1);RES 微调后 7/8 分割最佳(RefCOCO val 84.4 cIoU),超 SAM 3 Agent 7–12 cIoU;GRES val gIoU 84.9、N-acc 87.7 领先;GroundingSuite 零样本全类别第一,gIoU 67.8→75.5,Part 40.8→53.5、Multi 72.1→80.0。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PanoCaps 全景接地描述(test) | gPQ | 45.6(PANORAMA-4B) | SAMTok-8B(PanoCaps 微调)44.5 | +1.1(五项指标最佳) |
| PanoCaps 全景接地描述(test) | AP50 | 61.2 | SAMTok-8B(微调)57.6 | +3.6 |
| PanoCaps 全景接地描述(test) | gPQ | 45.6 | Qwen3-VL-235B 26.1 / Gemini 2.5 Pro 22.7(两阶段协议) | +19.5 / +22.9 |
| 接地对话生成 GCG(test) | Recall | 52.1(PANORAMA-4B ft) | SAMTok-7B(ft)48.7 | +3.4(10 项指标中 7 项最佳) |
| 指代表达分割 RES(RefCOCO val) | cIoU | 84.4(ft)/ 83.8(零微调) | SAMTok-4B 83.4 | +1.0(8 个分割中 7 个最佳) |
| 广义指代分割 GRES(val) | gIoU | 84.9(零样本) | SAMTok-7B(ft)78.0 | +6.9(N-acc 87.7 vs 79.5) |
| GroundingSuite(零样本) | gIoU(All) | 75.5 | SAMTok-3B 67.8 | +7.7(Part +12.7,Multi +7.9) |
| 组件消融(PanoCaps val) | gPQ | 42.1(默认 2B) | 去掉选择机制(直接解码)34.6 | +7.5(AP50 +20.0) |
| 数据消融(PanoCaps val,等训练预算) | gPQ | 44.0(仅 2,070 张 PanoCaps) | COCONut-PanCap(再生清洗版,57 倍数据)37.9 | +6.1 |
局限与改进
作者承认的局限:模型偶尔遗漏可见区域(如图 1 第 3 行的墙壁插座)、个别描述不精确(如把锅具写成 “lidded pot”);工作只覆盖图像级接地,未涉及区域描述与视频接地;作者提出用 VLM-分割器反馈闭环和强化学习改进。我自己的观察:其一,PanoCaps 仅 3,470 张图(训练 2,070 张)且全为英文,SAMTok 微调后已达 44.5 gPQ,基准饱和风险明显;其二,99% 像素覆盖率的要求可能迫使描述纳入琐碎背景区域,与自然语言习惯有出入;其三,开放文本匹配依赖 MPNet 嵌入阈值 0.5,对语义等价的改写可能误杀,对恰好嵌入接近的错误指代可能放行;其四,4B 主结果来自单次训练,2B 三种子的标准差约 0.6 gPQ,差距在一个标准差内的对比应谨慎解读;其五,推理时每个短语都要独立跑一遍 DETR 解码与打分(图像特征共享但解码不共享),延迟 4.71 s/img,反而慢于 Sa2VA-8B 的 3.74 s,密集长描述下开销不小;其六,通用大模型用两阶段协议评测,其真实上限可能被低估。
独立分析的弱点
第一,接口学习完全依赖 SAM 3 的候选分布:若短语指向候选池外的目标(抽象、关系性或部件级描述),选择无从谈起,且消融显示解冻解码器也无济于事,可引入针对低分短语的掩码精修或回退通道。第二,全局固定阈值 $\theta=0.5$ 对不同粒度实体未必最优:附录 D.2 显示 $\theta=0.3$ 召回升 1.7 但精确率降 3.3,小部件与大背景的得分分布不同,可学习短语自适应阈值。第三,每短语独立解码带来计算冗余,密集描述(每图约 9 短语)下延迟 4.71 s/img,可缓存跨短语共享候选池再做条件化重排。第四,训练混合中 34%(325K 样本)来自 Qwen3-VL-235B 再生的 COCONut-PanCap 标注,再生模型与被评测模型同源,存在自我蒸馏回路的偏置风险,宜用异构模型再生或人工抽检校准。第五,CAPTURE 落后微调基线 2.6 点(68.0 vs 70.6),选择式接口可能轻微挤占语言容量,可在混训中上调纯描述数据比例。第六,辅助语义损失 $\mathcal{L}_{sem}$ 在 PanoCaps 上无益却支撑 RefCOCO 2.5 点,单通道语义掩码与实例选择目标存在张力,可替换为实例中心的辅助头。
未来方向
作者明确提出的方向:一是反馈闭环,让 VLM 根据分割器输出(如发现的遗漏区域)修正描述与掩码,提升覆盖率并减少 “lidded pot” 式错误;二是用强化学习联合优化接地与描述质量;三是扩展到视频接地与区域级描述。基于成果可自然延伸的方向:把概念向量接口接到 SAM 3 被裁掉的视频跟踪模块上,实现时序一致的密集接地描述;将 PanoCaps 协议推广到多语言与 10 倍以上规模,缓解基准饱和;研究选择式接口与其他感知头(深度、3D 包围盒、可供性)的组合,把“语言驱动候选+选择”的范式推广为通用多任务感知接口;引入测试时计算(多轮候选生成与验证、候选池自反思)提升密集接地精度;在具身智能与机器人操作场景验证全景接地描述对下游规划的收益,这正是论文动机部分强调的应用出口。
复现评估
开源程度高:代码、PanoCaps 数据和模型权重发布在项目主页(di.ens.fr/willow/research/panorama/),依赖的 Qwen3-VL、SAM 3、XTuner、LoRA 均公开,基线用官方实现与超参微调。算力门槛明确:主训练 16 张 NVIDIA H100,2B 约 5 小时、4B 约 7 小时(单 epoch、有效批 128、BF16、序列长 8,192);推理单张 A100 中位延迟 4.71 s/img、峰值显存 13.5 GB,优于多数 7–8B 基线。数据方面,PanoCaps 可直接下载,但复现数据集本身成本高昂:约 1,530 人时、每图标注约 15 分钟加复核约 12 分钟、$1.35/图;训练混合中 COCONut-PanCap 需经 Qwen3-VL-235B 再生清洗,有显著 API/算力成本且清洗规则细节不完全确定。统计可靠性:4B 主结果为单次训练,2B 消融提供三种子均值与标准差(gPQ ±0.6、AP50 ±1.0)。总体:有 16 卡资源的团队可复现主结果,小团队可复现 2B 消融与数据集分析,难度中等。
论文图表
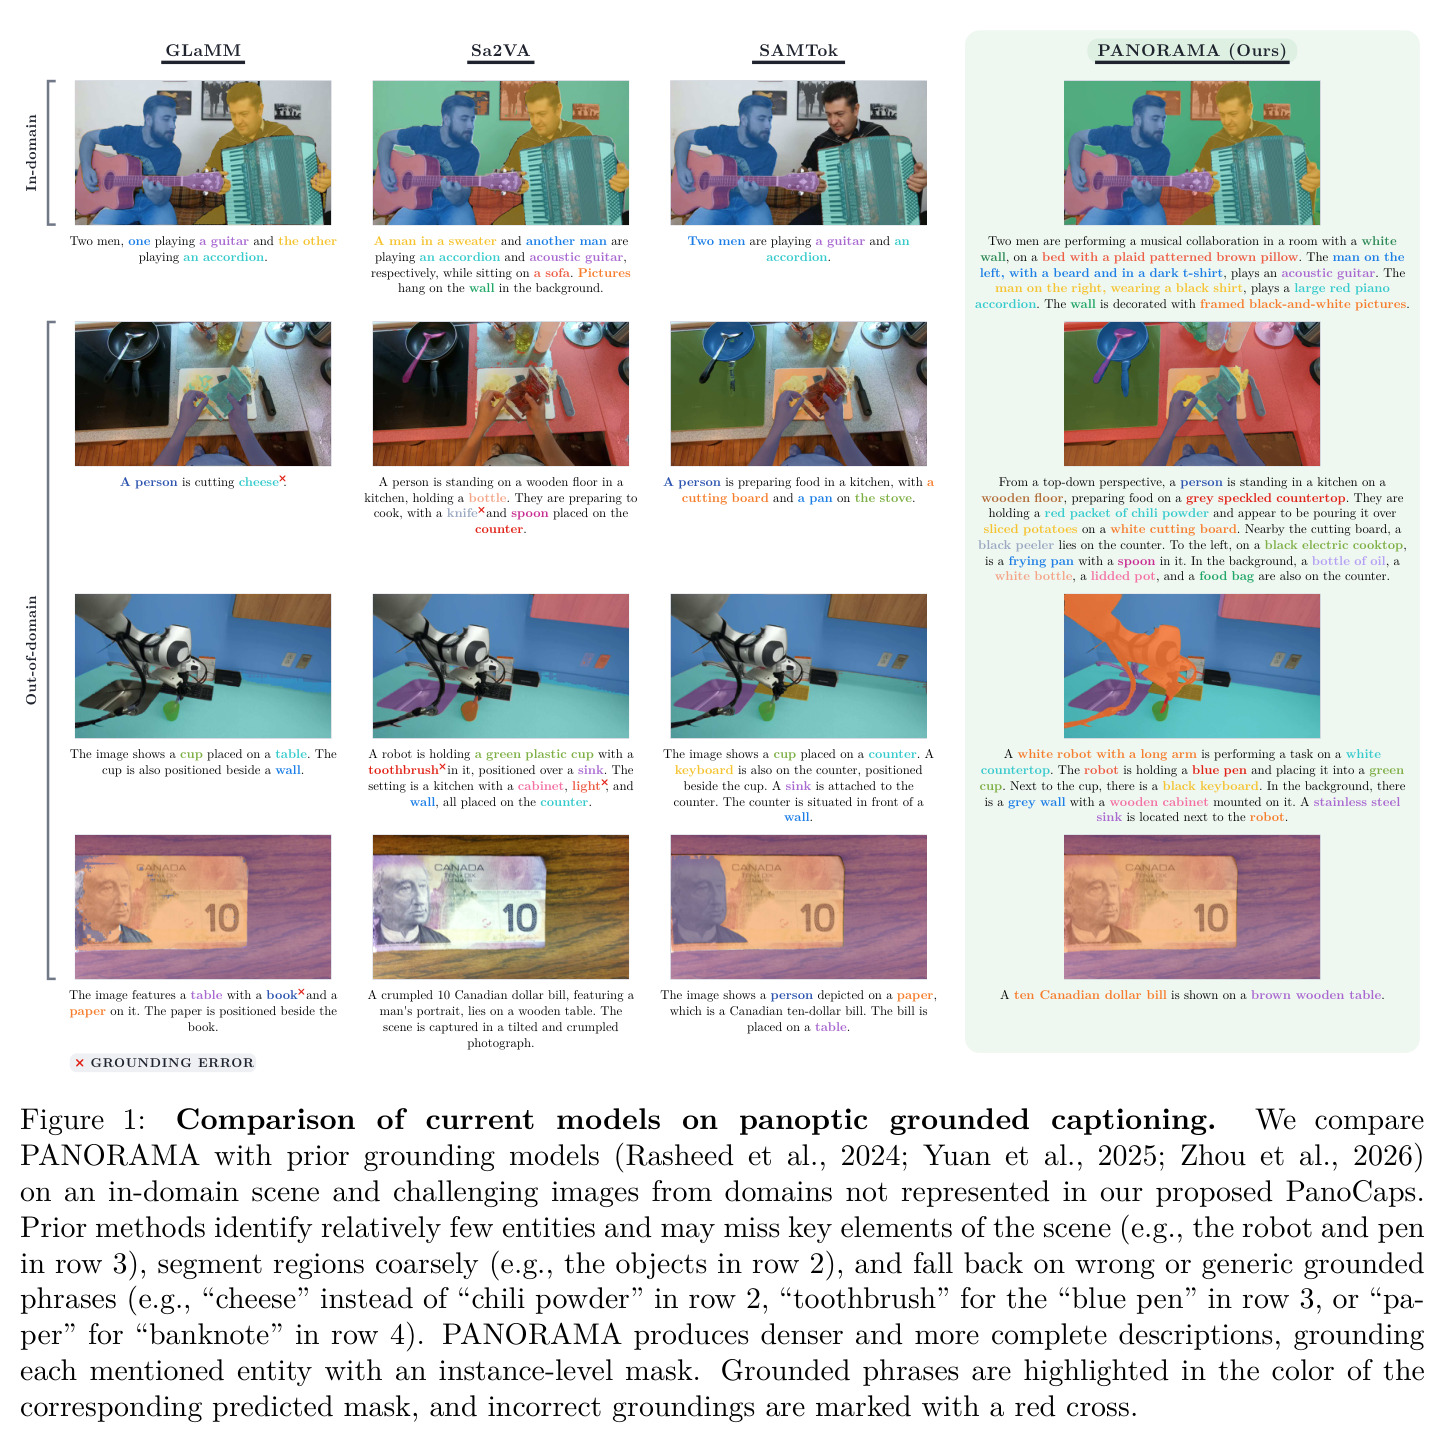
四列对比 GLaMM、Sa2VA、SAMTok 与 PANORAMA 在一个域内场景和三个域外图像(厨房俯拍、机器人操作、钞票)上的接地描述。先前方法实体覆盖少(漏掉机器人和笔)、掩码粗糙(第 2 行的物体)、指代错误(把辣椒粉说成 “cheese”、把蓝笔接成 “toothbrush”、把钞票接成 “paper”,标红叉),PANORAMA 生成更密集完整的描述并为每个实体给出实例级掩码。
一图直观呈现现有方法的三类失败模式(漏实体、粗掩码、错指代)与本文方法的改进,是论文动机的可视化总结,也是理解任务难点的起点。
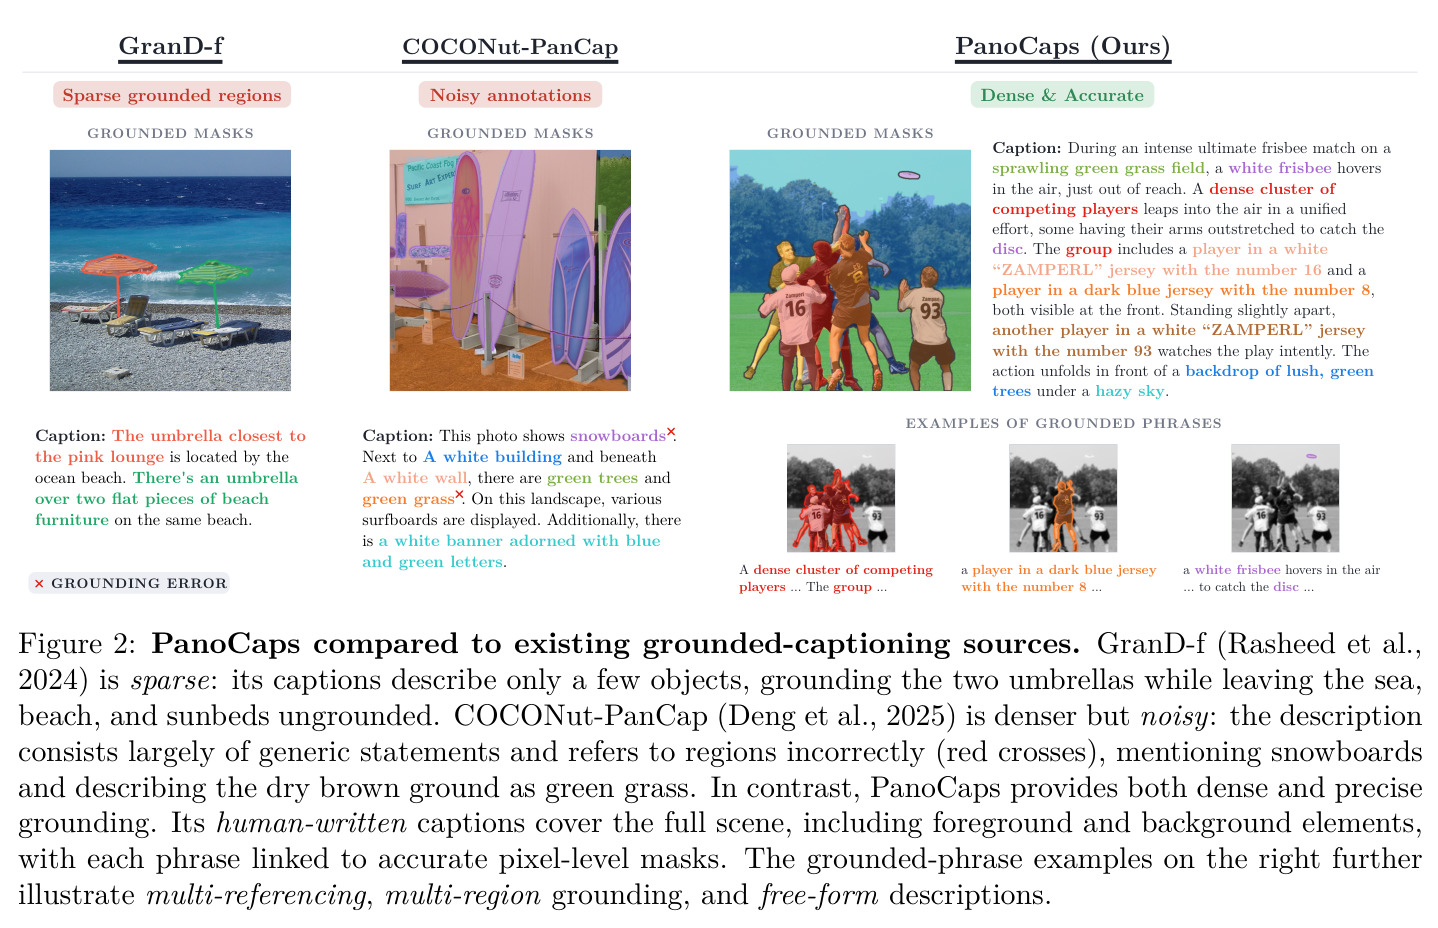
同一张飞盘比赛图上对比三个数据源:GranD-f 稀疏(只标两把伞,海、沙滩、躺椅未接地);COCONut-PanCap 更密但噪声大(说 “snowboards” 与 “green grass” 等错误接地,标红叉);PanoCaps 人工书写的全场景描述覆盖前景与背景,每个短语链到精确掩码,右侧示例还展示多实例指代与多区域接地。
用同一图像的三个标注版本直观证明“密度与质量不可兼得”这一数据瓶颈,是理解 PanoCaps 存在价值的关键图。