基于信息瓶颈的训练自适应卷积稀疏编码鲁棒视觉表示 Training-Adaptive Convolutional Sparse Coding via Information Bottleneck for Robust Visual Representation
把稀疏系数λ变成可学习变量,用信息瓶颈权衡压缩与保留,鲁棒性大幅提升
前置知识
卷积稀疏编码(CSC)
卷积稀疏编码把输入信号 $X$ 表示为一组卷积字典 $D$ 与稀疏系数图 $T$ 的卷积和 $X = D * T$,并通过求解 $T^* = \arg\min_T \tfrac{1}{2}\|X - D * T\|_2^2 + \lambda\|T\|_1$ 得到稀疏表示。与普通稀疏编码不同,字典以卷积方式在图像上滑动,天然保留平移结构;$\ell_1$ 项负责压缩抑制冗余,重建项负责保真,稀疏系数 $\lambda$ 控制两者的平衡。
本文的全部创新都围绕 CSC 目标中的 λ 展开:把它从训练前手工固定的超参数变成与网络联合学习的可微变量,因此必须先理解 CSC 的目标函数、各项含义以及 λ 在其中的角色。
信息瓶颈原理(IB)
信息瓶颈主张好的表示 $T$ 应当在保留与目标变量 $Y$ 相关信息的同时尽量压缩输入 $X$ 的信息,目标为 $\min_p \; I(T;X) - \beta\, I(T;Y)$,其中 $I(\cdot;\cdot)$ 是互信息,$\beta>0$ 权衡压缩与充分。深度网络的逐层前向传播可以看作对输入信息的渐进压缩变换。
本文的理论主线就是把 CSC 的稀疏系数 λ 与 IB 目标中的权衡系数 β 对应起来,用 IB 视角解释 λ 的学习动态、层间分布以及鲁棒性来源,读懂这条线索才能理解论文的叙事逻辑。
FISTA 与深度模型展开(unrolling)
FISTA 是求解 $\ell_1$ 正则化问题的加速近端梯度算法:每步先做梯度步 $U = Y - \nabla f(Y)/L$,再做软阈值 $\mathcal{S}_{\lambda/L}(U)$,并用 Nesterov 外推加速收敛。深度模型展开把固定次数的优化迭代写成网络的若干层,使字典、步长等参数能端到端训练。
本文正是把 FISTA 展开成 TA-CSC 层来构建网络前向,并通过对展开后的迭代关于 λ 求导实现稀疏系数的联合学习,不熟悉展开范式就看不懂方法结构。
超梯度(hypergradient)与软阈值的不可导性
当内层优化过程依赖某个外层变量(这里是 λ)时,任务损失对 λ 的梯度需要先把梯度对中间迭代量再求导,得到 $\partial\mathcal{L}/\partial\lambda$,即梯度的梯度。软阈值 $\mathcal{S}_\tau(u)=\mathrm{sign}(u)\max(|u|-\tau,0)$ 在 $|u|=\tau$ 处不可导,需借助次梯度处理。
λ 藏在软阈值的阈值 $ au=\lambda_n/L_n$ 里,作者通过递推式 (11)-(13) 从零初始化逐迭代计算 $\partial T_n/\partial\lambda_n$,才让 λ 可以反向传播,这是方法成立的技术关键。
CIFAR-10-C / ImageNet-C 常见损坏基准
Hendrycks 与 Dietterich 提出的鲁棒性基准:在测试集上叠加高斯噪声、散粒噪声、脉冲噪声、模糊、天气等常见损坏,每种损坏含 5 个强度等级,报告各等级平均准确率,用以衡量模型在分布偏移下的可靠性。
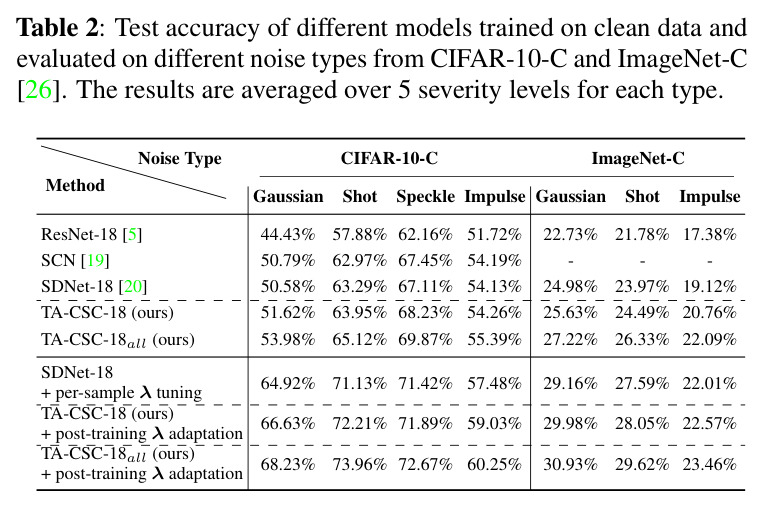
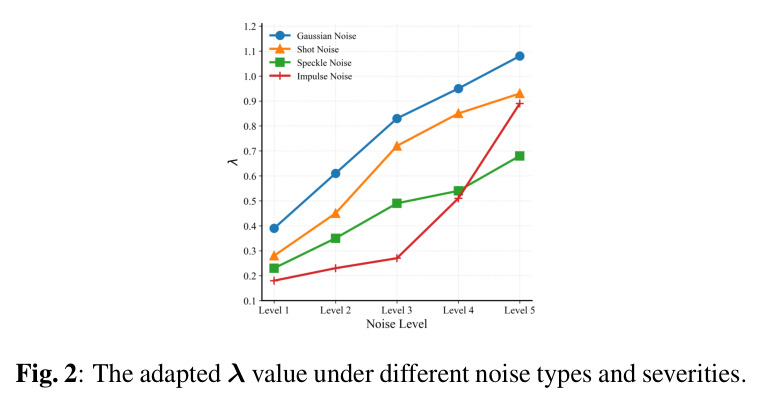
本文的鲁棒性实验(Table 2)和免标签后训练 λ 自适应(Fig. 2)都以该基准为测试床,理解其设置(噪声类型 × 5 个 severity 取平均)才能正确解读实验数字。
研究动机
现代深度网络(ResNet、Swin Transformer、VMamba 等)只优化最终任务损失,对中间表示的信息含量没有任何显式控制,容易出现两类失衡:一是信息退化,即 $I(Y; f_{\theta_1}(X)) \ge \cdots \ge I(Y; T)$ 中任务关键信息在层层传播中被丢弃;二是信息冗余,即 $I(X; f_{\theta_1}(X)) \ge \cdots \ge I(X; T)$ 中与任务无关的输入信息被大量保留。冗余表示在输入受扰动时特别脆弱:ResNet-18 在 CIFAR-10 干净测试集上准确率高达 95.54%,但在 CIFAR-10-C 高斯噪声下骤降到 44.43%。卷积稀疏编码(CSC)通过 $\ell_1$ 项提供了显式的冗余抑制机制,但现有方法(SCN、SDNet 等)把稀疏系数 λ 当作训练前手工固定的超参数:单一固定 λ 无法适配不同深度层的压缩需求,也无法随数据分布变化自动调整,在损坏输入下学到的压缩强度不再合适,导致 IB 意义上的压缩-充分平衡次优。
本文的目标是本文的目标是构建训练自适应的卷积稀疏编码框架 TA-CSC:让稀疏系数 λ 成为与卷积字典 $D$、网络参数 $ heta$ 一起被联合学习的可微变量,从信息瓶颈角度为每一层提供显式的压缩-保留控制——λ 大则抑制冗余成分、表示更紧凑,重建项与任务损失则保证任务相关信息不丢失。在此基础上,作者进一步解决分布偏移问题:当输入被腐蚀或发生偏移时,干净数据上学到的 λ 不再合适,因此设计一种免标签的后训练策略,只用少量(默认 100 个)无标签损坏样本调整 λ,主网络参数全部冻结,以极低成本提升模型在 CIFAR-10-C、ImageNet-C 等损坏数据上的鲁棒性。最终在 CIFAR-10、CIFAR-100 与 ImageNet-1K 上同时取得更优的干净数据精度和显著更强的抗噪鲁棒性。
与已有工作不同的是,已有把 CSC 引入深度网络的工作各有着力点但都没动 λ:ML-CSC 建立卷积网络与稀疏编码的联系;Res-CSC/MSD-CSC 解释多层 CSC 与残差网络的等价性;CSC-CTRL 用 CSC 构建自编码器;SCN 用监督任务损失端到端训练稀疏编码网络;SDNet 通过可微优化层集成 CSC 提升鲁棒性——但它们都把 λ 当作预先选定的超参数。本文的独特切入是把 λ 本身变成学习对象:一方面在 FISTA 展开迭代中推导关于 λ 的超梯度递推,使这个藏在不可导软阈值里的系数能够随任务损失反向传播;另一方面从 IB 原理论证 λ 与 $\beta$ 的角色对应,为学 λ 提供理论叙事。再进一步,作者提出冻结 $\theta$、只调 λ 的免标签后训练,把压缩强度变成部署后可按输入分布重新标定的旋钮,与 SDNet 需要逐样本调 λ 的做法形成鲜明对比。
核心方法
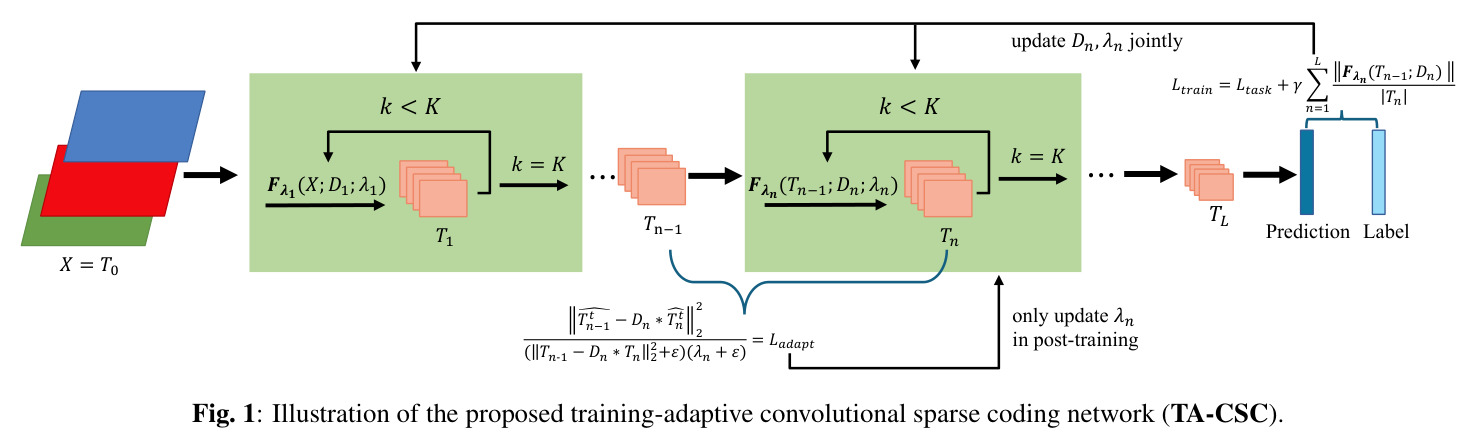
直觉上,网络每一层都在做保多少信息的决策:压得太狠丢任务信息,压得太松留冗余、遇扰动即崩。TA-CSC 把这一决策显式参数化:以 ResNet-18 为骨干,用 CSC 目标 $T^* = \arg\min_T \tfrac{1}{2}\|X - D * T\|_2^2 + \lambda\|T\|_1$ 替换卷积层,并把 FISTA 迭代展开固定次数(默认 $K=2$)作为前向计算,得到 TA-CSC-18(仅替换第一层卷积)与 TA-CSC-18all(替换全部卷积层)。技术路线分三步:前向按 $U_n^{(k)} = Y_n^{(k-1)} - \tfrac{1}{L_n}\nabla f(Y_n^{(k-1)})$、$T_n^{(k)} = \mathcal{S}_{\lambda_n/L_n}(U_n^{(k)})$ 加 Nesterov 外推迭代;λ 经 Softplus 参数化保证非负,用递推超梯度反向传播;最后以 $\mathcal{L}_{train} = \mathcal{L}_{task} + \gamma\sum_n \|F_{\lambda_n}(T_{n-1}; D_n)\|_1 / |T_n|$($\gamma=0.001$)联合训练 $\theta$ 与所有 $\lambda_n$,任务项鼓励保留、$\ell_1$ 项鼓励压缩,二者竞争实现 IB 权衡。
核心创新是把 CSC 的稀疏系数 λ 解释为信息瓶颈目标中的权衡系数 β 并让其可学习。IB 目标 $\min I(T;X) - \beta I(T;Y)$ 中 β 控制压缩与保留的折中;CSC 里 λ 扮演同样角色:$\ell_1$ 项促进紧凑,重建项与任务损失保证充分。与 SCN、SDNet 等固定 λ 的本质区别在于:λ 直接出现在软阈值 $\mathcal{S}_\tau(u)=\mathrm{sign}(u)\max(|u|-\tau,0)$ 的阈值 $\tau=\lambda_n/L_n$ 中,决定哪些系数被置零。作者推导出完整超梯度递推:$\partial U_n^{(k-1)}/\partial\lambda_n = \left(I - \tfrac{1}{L_n}(D_n)^T * D_n\right) * \partial Y_n^{(k-1)}/\partial\lambda_n$,再由外推式 (13) 补上 $Y_n$ 对 λ 的依赖,从 $\partial T_n^{(0)}/\partial\lambda_n = 0$ 出发即可完整计算 $\partial T_n/\partial\lambda_n$,链式传回任务损失,经 $\lambda_n \leftarrow \mathrm{Softplus}(\lambda_n - \eta\nabla_{\lambda_n}\mathcal{L}_{train})$ 更新,每层由此获得独立、可解释的压缩旋钮。
方法步骤详情
第一步,前向稀疏推断:第 $n$ 层从 $T_n^{(0)}=0$、$t_n^{(1)}=1$ 出发做 $K=2$ 次 FISTA 迭代——梯度步 $U_n^{(k)} = Y_n^{(k-1)} - \tfrac{1}{L_n}(D_n)^T * (D_n * Y_n^{(k-1)} - T_{n-1})$,软阈值 $T_n^{(k)} = \mathcal{S}_{\lambda_n/L_n}(U_n^{(k)})$,Nesterov 外推 $Y_n^{(k)} = T_n^{(k)} + \tfrac{t_n^{(k)}-1}{t_n^{(k+1)}}(T_n^{(k)} - T_n^{(k-1)})$,输出稀疏表示 $T_n$ 交给下一层。第二步,超梯度计算:按式 (11)-(13) 以零初始化递推出各迭代的 $\partial T_n^{(k)}/\partial\lambda_n$,与 $\partial\mathcal{L}_{task}/\partial T_n$ 链式相乘得到 $\nabla_{\lambda_n}\mathcal{L}_{train}$。第三步,联合训练:总损失 $\mathcal{L}_{task} + \gamma\sum_n \|F_{\lambda_n}(T_{n-1};D_n)\|_1/|T_n|$,λ 经 Softplus 更新保持非负。第四步,免标签后训练:冻结 $\theta$,用 100 个无标签损坏样本计算相对重建误差 $R_n$(式 17),最小化 $\mathcal{L}_{adapt} = \sum_n R_n/(\lambda_n + \epsilon)$ 只更新 λ(可同步用损坏批次更新 BN 统计),分母使 λ 增大后压缩推力自动减弱,收敛到与损坏分布匹配的压缩强度。
技术新颖性
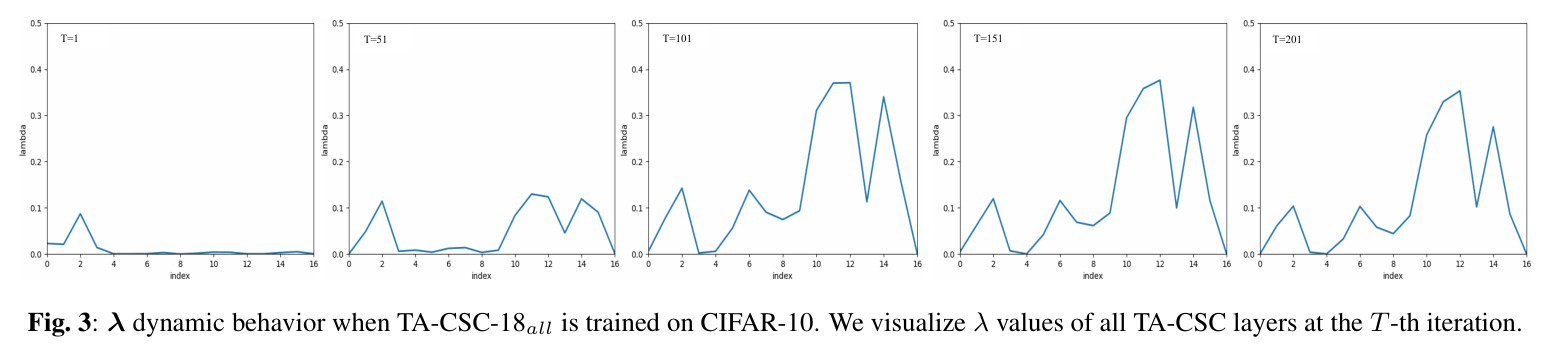
技术新颖性体现在三处。第一,λ 可微化:此前 SCN、SDNet 等 CSC 网络把稀疏系数当作训练前选定的标量,本文首次推导 FISTA 展开关于 λ 的超梯度递推(式 11-13),把不可导软阈值中的参数纳入端到端反向传播,并用 Softplus 保证非负性。第二,IB 视角的可解释压缩:把 λ 与 IB 的 $\beta$ 等同起来,训练动态中观察到拟合-压缩两阶段转变与四个压缩周期(对应 ResNet 四个 stage 的通道宽度扩展),浅层 λ 小、近任务层 λ 大,为每层该压多少提供了显式、可量化的指示器,而非黑盒隐式正则。第三,免标签后训练自适应:式 (17)(18) 构造仅依赖观测信号与稀疏重建的相对重建误差损失,使模型部署后无需损坏样本标签即可重新标定压缩强度;Table 2 显示该策略超过 SDNet-18 的逐样本 λ 调优(如 CIFAR-10-C 高斯噪声 68.23% 对 64.92%),说明对自适应模型重估压缩强度比调固定模型的稀疏系数更有效。
实验结果
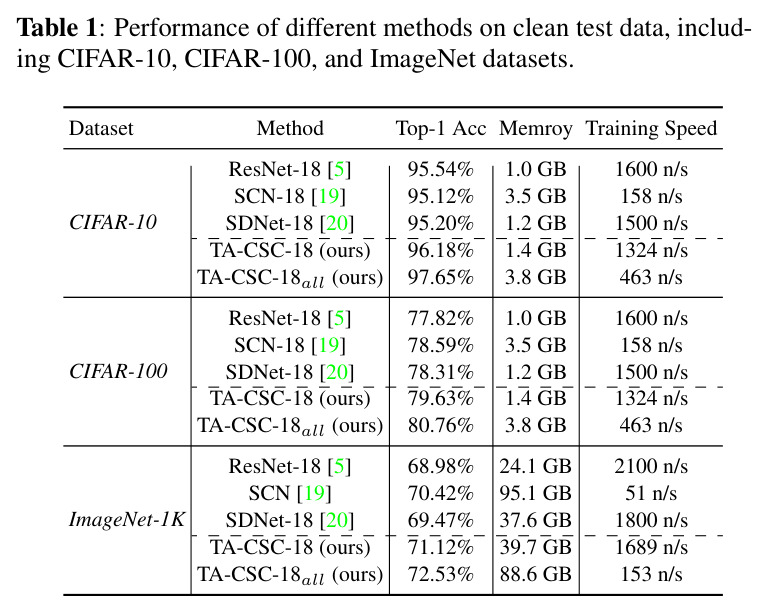
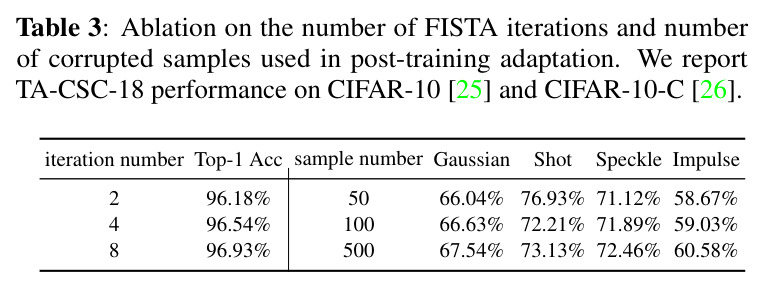
干净数据上(Table 1),TA-CSC-18all 在 CIFAR-10 达 97.65%、CIFAR-100 达 80.76%、ImageNet-1K 达 72.53%,比 ResNet-18 的 95.54%、77.82%、68.98% 分别高 2.1、2.9、3.6 个百分点,也超过 SCN(95.12%/78.59%/70.42%)与 SDNet-18(95.20%/78.31%/69.47%)。鲁棒性上(Table 2,5 个 severity 平均),CIFAR-10-C 高斯噪声下 ResNet-18 仅 44.43%,TA-CSC-18all 无后训练已达 53.98%,加免标签后训练跃升至 68.23%,超过 SDNet-18 逐样本 λ 调优的 64.92%;TA-CSC-18 从 51.62% 升至 66.63%,散粒、斑点、脉冲及 ImageNet-C(27.22%→30.93%)趋势一致。Fig. 2 显示 λ 随损坏强度单调增大,即输入冗余越多压缩越强。Fig. 3 揭示训练中 λ 先小后大、出现四个压缩周期,对应 ResNet 四个 stage 的宽度扩展,且浅层 λ 小、深层 λ 大。Table 3 消融:FISTA 迭代 2/4/8 次对应干净精度 96.18%/96.54%/96.93%;后训练样本 50/100/500 对应高斯噪声 66.04%/66.63%/67.54%,收益递减,故默认 2 次迭代、100 个样本。代价:ImageNet 上 TA-CSC-18all 需 88.6 GB 显存、153 n/s 吞吐(ResNet-18 为 24.1 GB、2100 n/s)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CIFAR-10 图像分类(干净测试集) | Top-1 准确率 | TA-CSC-18all 97.65% | ResNet-18 95.54% | +2.11 pp |
| CIFAR-100 图像分类(干净测试集) | Top-1 准确率 | TA-CSC-18all 80.76% | ResNet-18 77.82% | +2.94 pp |
| ImageNet-1K 图像分类(干净测试集) | Top-1 准确率 | TA-CSC-18all 72.53% | ResNet-18 68.98% | +3.55 pp |
| CIFAR-10-C 高斯噪声鲁棒性(5 强度平均) | Top-1 准确率 | TA-CSC-18all + 后训练 λ 自适应 68.23% | ResNet-18 44.43% | +23.80 pp |
| CIFAR-10-C 脉冲噪声鲁棒性(5 强度平均) | Top-1 准确率 | TA-CSC-18all + 后训练 λ 自适应 60.25% | ResNet-18 51.72% | +8.53 pp |
| ImageNet-C 高斯噪声鲁棒性(5 强度平均) | Top-1 准确率 | TA-CSC-18all + 后训练 λ 自适应 30.93% | ResNet-18 22.73% | +8.20 pp |
局限与改进
作者在结论中坦承两点:一是实验主要局限于 ResNet 架构与图像分类任务,未验证 TA-CSC 在检测、分割、生成等其他视觉任务上的有效性;二是 λ 与信息压缩的联系主要依靠经验证据(λ 动态可视化、层间分布分析),缺乏严格理论证明,稀疏编码与 IB 目标之间的理论关系仍是开放问题。我自己的观察还有几点:第一,计算与显存代价高昂,ImageNet 上 TA-CSC-18all 需 88.6 GB 显存、吞吐降到 153 n/s(ResNet-18 为 24.1 GB、2100 n/s),即便较省的 TA-CSC-18 也达 39.7 GB、1689 n/s,限制实际部署;第二,Table 2 只覆盖高斯、散粒、斑点、脉冲四类加性噪声,未报告模糊、天气等 CIFAR-10-C 其余损坏类型,鲁棒性结论外推范围有限;第三,后训练自适应隐含损坏样本与目标偏移同型的假设,对训练时未见过类型的损坏是否有效未验证;第四,$\gamma=0.001$ 全局固定且未做敏感性消融,压缩项对超参的依赖程度不明。
独立分析的弱点
弱点一:展开 FISTA 带来数倍开销。Table 1 显示 TA-CSC-18all 在 CIFAR 上吞吐从 ResNet 的 1600 n/s 降到 463 n/s、显存 3.8 GB 对 1.0 GB,ImageNet 上更达 88.6 GB、153 n/s。改进方向:减少展开迭代并用蒸馏补偿、共享或低秩化字典、对 CSC 层做量化,或让展开次数可学习。弱点二:超梯度递推需存储各迭代中间量,随迭代数 $K$ 线性增长;Table 3 显示 $K=8$ 仅多 0.75 pp(96.93% 对 96.18%),说明梯度链路效率有限,可探索隐函数定理或不动点梯度避免逐迭代反传。弱点三:免标签后训练只更新 λ 与 BN 统计,当损坏改变的是语义本身而非仅冗余量时,调压缩强度无法恢复判别信息,且式 (18) 的相对重建误差准则在极端损坏下可能失灵;可补充熵最小化或自训练伪标签作为额外信号。弱点四:鲁棒性评估局限于加性噪声类型与分类任务,缺乏与对抗训练、AugMix、去噪泛化等专门鲁棒方法的正面对比,当前优势可能部分来自隐式正则而非 IB 机制本身,需要更细的对照实验分离因素。
未来方向
作者明确提出三个方向:把 TA-CSC 推广到更多样化的视觉任务与分布偏移场景;建立稀疏编码与信息瓶颈目标之间更严格的理论联系;探索超越 CSC 架构的更通用自适应压缩机制。基于本文成果还可延伸:其一,把可学习 λ 引入 ViT、Mamba 等架构的 token 剪枝或注意力稀疏化,检验 IB 驱动的逐层压缩是否跨架构成立;其二,把免标签后训练扩展为测试时自适应(TTA),用熵或重建一致性在线更新 λ,应对连续分布漂移;其三,利用 λ 的可解释性做部署监控——λ 分布异常即可指示输入分布变化,发展为免费的分布偏移检测器;其四,在线性网络或高斯假设下证明 $\lambda^*$ 与互信息 $I(T;X)$ 的定量关系,补齐理论短板;其五,与对抗训练、随机平滑等证书防御结合,探究显式稀疏压缩能否提供可证明的鲁棒界。
复现评估
复现条件总体明确但缺开源代码。有利因素:数据集全部公开(CIFAR-10/100、ImageNet-1K、CIFAR-10-C/ImageNet-C);关键超参完整——每层展开 2 次 FISTA 迭代、$\gamma=0.001$、后训练用 100 个无标签损坏样本、λ 经 Softplus 参数化;训练配置明确(CIFAR 单张 RTX 2080Ti、batch 128;ImageNet 4 张 RTX 3090、batch 512);Table 3 消融便于核对实现。不利因素:未提及代码开源;式 (11)-(13) 的超梯度递推与 FISTA 初始化细节实现容易出错,需要较强的优化算法与 PyTorch 自定义 autograd 功底;字典 $D$ 与各层 λ 的初值未说明;TA-CSC-18all 中替换全部卷积层的做法(下采样、残差连接如何与 CSC 层对接)描述较简略。总体评估:单卡即可复现 CIFAR 规模实验,ImageNet 全量训练需多卡与高显存(39.7-88.6 GB 暗示需梯度检查点或混合精度),复现难度中上。
论文图表