CERA-MoA:路由机制与持续学习智能体的协同演化混合专家框架 CERA-MoA: Co-Evolving Routing Mechanisms with Continually Learning LLM Agents
路由器与智能体在强化学习闭环中共同进化,用隐状态熟悉度评分实现自适应路由与能力分化。
前置知识
Mixture-of-Agents (MoA)
样本级的多智能体协作范式:多个独立 LLM 智能体各自对同一 query 生成回答,再由聚合器(多数投票、加权投票或裁判模型)整合出最终答案。与 token 级 Mixture-of-Experts (MoE) 不同,MoE 在模型内部路由隐藏向量,而 MoA 在语义/样本层面协调多个自主模型。
本文的研究对象就是 MoA:它把 MoA 从'静态编排固定能力模型'升级为'路由器与智能体共同训练进化',理解 MoA 的协作结构(路由-生成-聚合)是读懂系统设计的起点。
LoRA(低秩适配)
参数高效微调方法:冻结基座模型权重,只为每层 attention/MLP 注入低秩分解矩阵 $\Delta W = BA$(秩 $r \ll d$)参与训练。本文用 $r=16, \alpha=32$,让 4 个智能体以 4 个独立 LoRA 适配器共享同一 4B 基座,总显存占用仅约 4.4B 参数。
理解同基座多智能体的部署方式(homogeneous 设置)以及为什么多智能体 rollout 的显存开销可控;异构设置(三个不同基座模型)的对比也依赖这一概念。
DAPO 与 GSPO
两种面向 LLM 的强化学习技术。DAPO 去掉价值网络,对同一条 query 采样的一组(本文 $G=8$ 条)回答做组内归一化优势 $\hat{A}=(R-\mu)/(\sigma+10^{-4})$,并配合动态采样;GSPO 把重要性采样比率从 token 级改为序列级平均 $\rho=\exp(\frac{1}{S}\sum_t \log\frac{\pi_\theta(y_t|\cdot)}{\pi_{\theta_{old}}(y_t|\cdot)})$,稳定长思维链训练。
本文智能体策略更新用的正是 DAPO+GSPO 组合(式 7-12),公式细节直接影响对训练流程和稳定性设计的理解。
UCB 探索(Upper Confidence Bound)
多臂老虎机中的经典探索策略:给每个臂的估值加上正比于 $\sqrt{\log T/(n+1)}$ 的不确定性加成,采样次数 $n$ 越少的臂加分越高,从而避免'饿死'长期未被选中的选项。本文路由分 $s_i(q)=f_i(q)+c_{\text{ucb}}\frac{\log T}{n_i+1}+w_{\text{ent}}\bar{H}_i$ 沿用了同一思想。
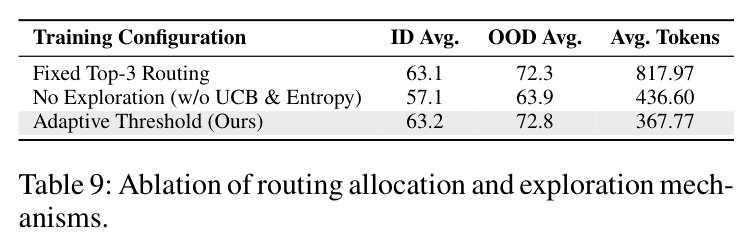
训练期路由排序用 UCB 项防止某些智能体收不到训练样本;消融实验(无探索时路由塌缩到单一 agent、ID 掉到 57.1)表明这是系统成立的关键机制。
中层隐状态与 t-SNE
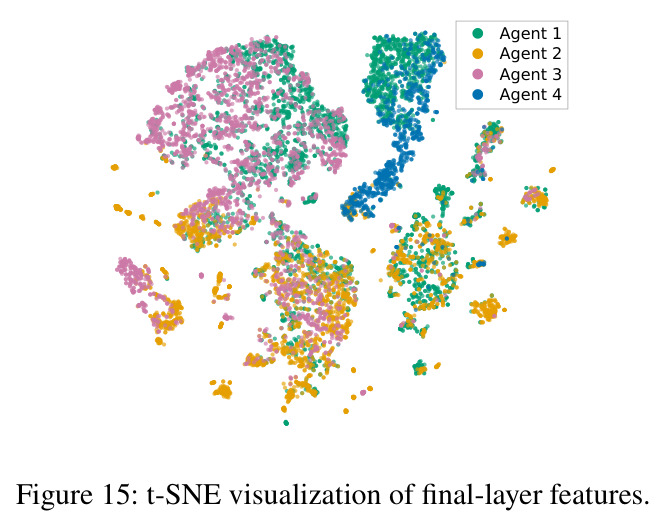
LLM 每层都输出隐藏状态;研究表明(Skean et al. 2025)中间层保留更宽泛的结构化语义,而末层表征被'下一个词预测'任务主导、易互相纠缠。t-SNE 是把高维向量投影到二维的降维可视化方法,用于观察向量是否形成可分离的聚类。
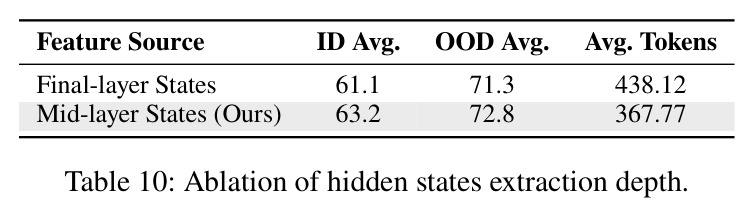
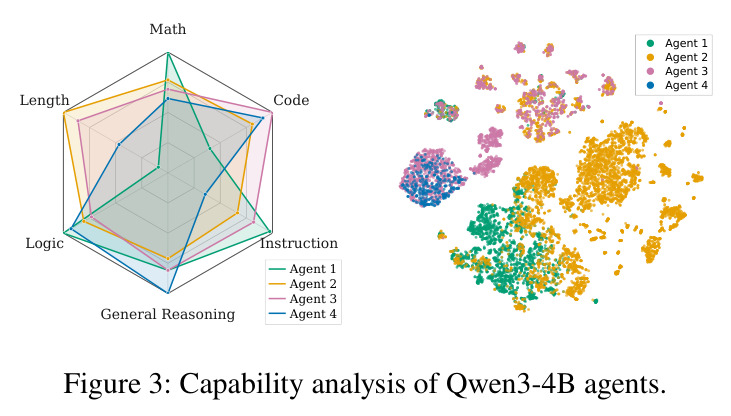
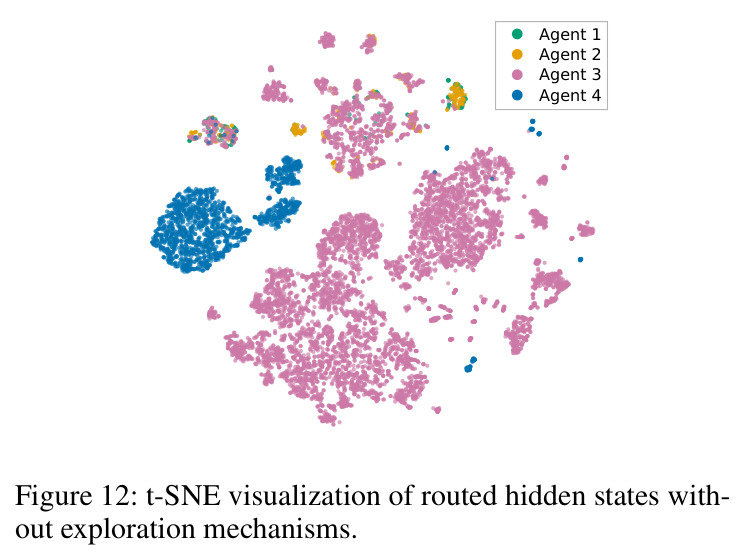
熟悉度估计器的整个设计建立在'中层隐状态是好的语义特征'之上(取第 $\lfloor L/2\rfloor$ 与 $\lfloor 3L/4\rfloor$ 层拼接);论文用 t-SNE 图证明按 agent 分化的语义簇确实存在,以及末层特征为何更差。
研究动机
当前多智能体系统的发展分裂成两条互不相通的路线。第一条是编排优化:用多臂老虎机(如 LinUCB)、背包预算分配或对比学习评分器(如 RouteMoA)在固定能力的模型池里挑选 agent,这些方法默认候选模型在编排训练期间保持静止。第二条是智能体微调:MAPoRL 在辩论框架里、AT-GRPO 在预定义树状 MoA 结构里用强化学习训练 agent,但训练数据靠人工划分或均匀分配。这种割裂在持续学习场景下集中爆发:智能体策略在 post-training 阶段不断演化,静态路由器的评分很快过时——一个训练初期擅长数学的 agent 经过若干轮 RL 更新后能力边界完全改变,路由器却无从感知;反过来,由于训练样本没有按能力定向分配,几个 agent 接收几乎同质的训练数据,最终都停留在'什么都会一点'的同质通才状态,无法形成互补的领域专长,MoA 范式宣称的性能上限因此被白白浪费。
本文的目标是本文要构建一个路由器与智能体共同进化的闭环系统,具体目标有三。其一,路由器必须在智能体能力持续漂移的情况下实时、低成本地评估'这条 query 现在最适合交给谁',且评估本身不能依赖昂贵的外部裁判模型或完整的生成 rollout。其二,在推理时要按能力覆盖动态决定激活几个 agent,而不是机械地固定 top-k,从而在任务性能与多智能体推理开销之间取得细粒度权衡。其三、也是最有野心的一条:训练期就把'哪个 agent 应该接收哪条训练样本'交给路由器决定,让频繁解出某类问题的 agent 在未来自动获得更多语义相似的问题,从而在无人工角色指定、无 prompt 人设工程的前提下,自发涌现出领域专长分化。
与已有工作不同的是,本文的独特切入是把'评分器怎么学'和'训练数据怎么分'这两件事合并进同一个训练回路。技术上最大的差异化在于熟悉度的定义方式:不直接回归绝对奖励(奖励会随策略更新剧烈震荡,无法充当稳定监督),而是把奖励信号转译成固定参考空间里的几何距离——每个 agent 配一个正交初始化且永久冻结的目标头充当锚点,可训练的预测头根据跨智能体相对优势被'拉近'或'有界推开',熟悉度 $f_i(q)=\exp(-\lambda d_i(q))$ 随之平滑演化。配合累积阈值路由(按熟悉度之和是否达到 $\tau$ 决定激活数量,而非固定 top-k),系统同时解决了'评得准'与'用得省';而'训练期数据分配本身就是路由行为'这一闭环设计,是静态编排与固定工作流微调两条老路都不具备的性质。
核心方法
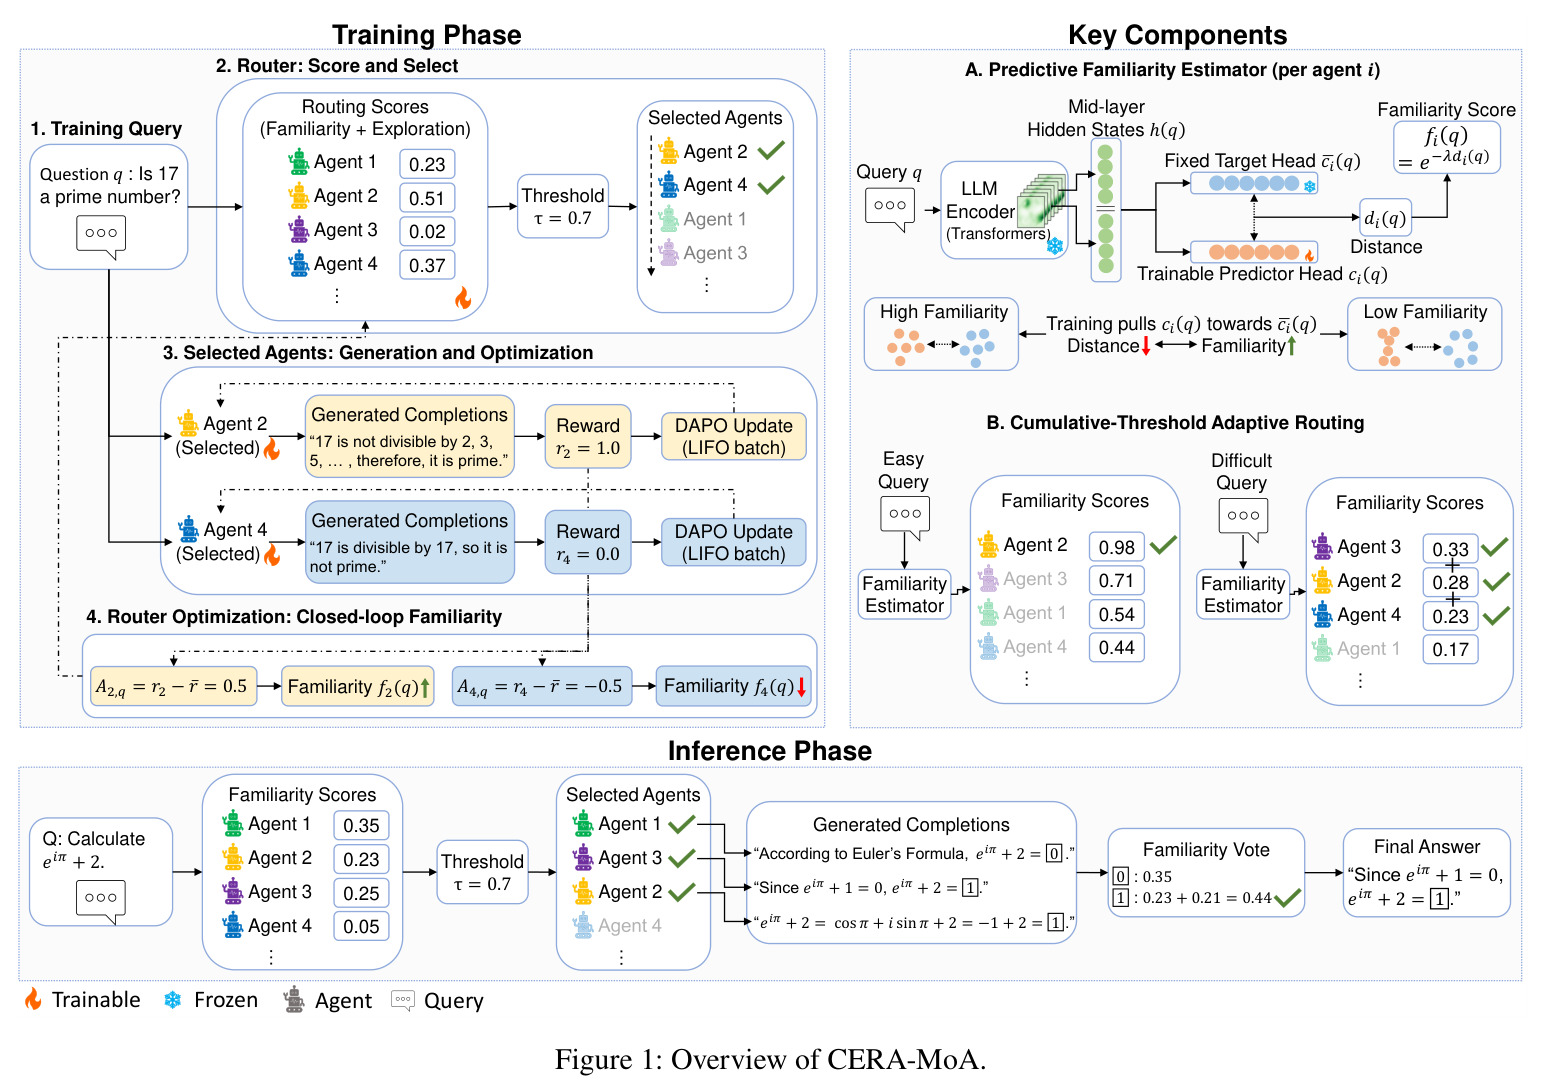
CERA-MoA 由三部分组成:参数化路由器 $D_\psi$、$N$ 个持续学习的智能体策略 $\{A_{\theta_i}\}_{i=1}^N$ 和投票聚合器 $S$。直觉上路由器像一个'教练兼领队':训练时先看题(不看任何 agent 的答案)就判断哪个 agent 大概率擅长,只激活最小的胜任子集去生成和更新;同时记录谁的表现超出同伴平均水平,据此调整对它的熟悉度评分,使下次同类题更倾向找它,于是被频繁选中的 agent 越来越专、评分器也越来越准。技术路线:query 先过路由器自己的冻结骨干网络,取第 $\lfloor L/2 \rfloor$ 与 $\lfloor 3L/4 \rfloor$ 层隐状态拼接为语义表示 $h(q)\in\mathbb{R}^{2H}$;每个 agent 的可训练预测头 $g_i$ 与冻结目标头 $\bar{g}_i$ 把 $h(q)$ 投影后计算归一化距离 $d_i(q)$,经指数衰减得到熟悉度 $f_i(q)$;被激活的 agent 用 DAPO+GSPO 做组归一化强化学习更新;路由器则用跨 agent 相对优势 $A_{i,q}$ 以推拉式损失只更新预测头 $g_i$。推理时关闭全部探索项,按熟悉度累积阈值激活最小子集,最后对确定性任务做熟悉度加权多数投票。
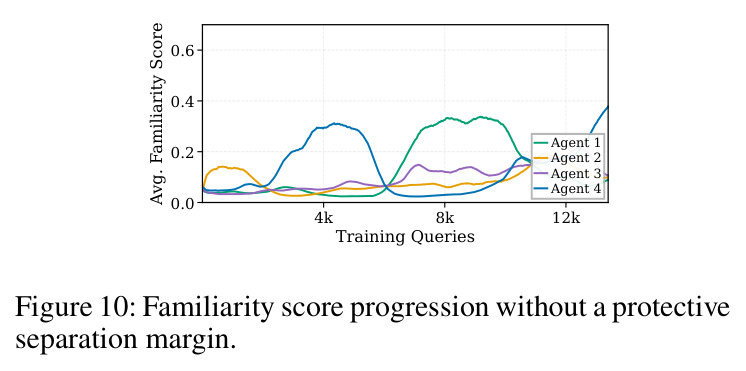
核心创新是把奖励监督转译为'固定参考空间中的几何兼容性信号'。预测头 $g_i$ 可训练,目标头 $\bar{g}_i$ 在不同 agent 间正交初始化并永久冻结——它不编码任何语义原型或能力标签,只提供稳定锚点。当 agent $i$ 的平均奖励高于同组均值($A_{i,q}\ge 0$)时,损失项 $A_{i,q}d_i(q)$ 把预测头拉向锚点、熟悉度上升;反之用铰链项 $|A_{i,q}|\max(0,\, m-d_i(q))$ 推开,但排斥距离被硬性截断在 $m$。这个 margin 是几何层面的关键保护:若无界排斥,负优势的大梯度会把投影距离推到极端,使指数型熟悉度 $\exp(-\lambda d)$ 永久塌缩为零——附录消融(Figure 10)证实去掉 margin 后所有 agent 的熟悉度剧烈震荡且完全无法增长。与已有方法的本质区别在于:RouteMoA 等评分器假设候选模型静态,MAPoRL/AT-GRPO 等在预定义工作流内用手工划分数据训练;而 CERA-MoA 的评分器与智能体策略同步共演化,训练期 query 分配与推理期 query 路由由同一套熟悉度信号统一驱动。
方法步骤详情
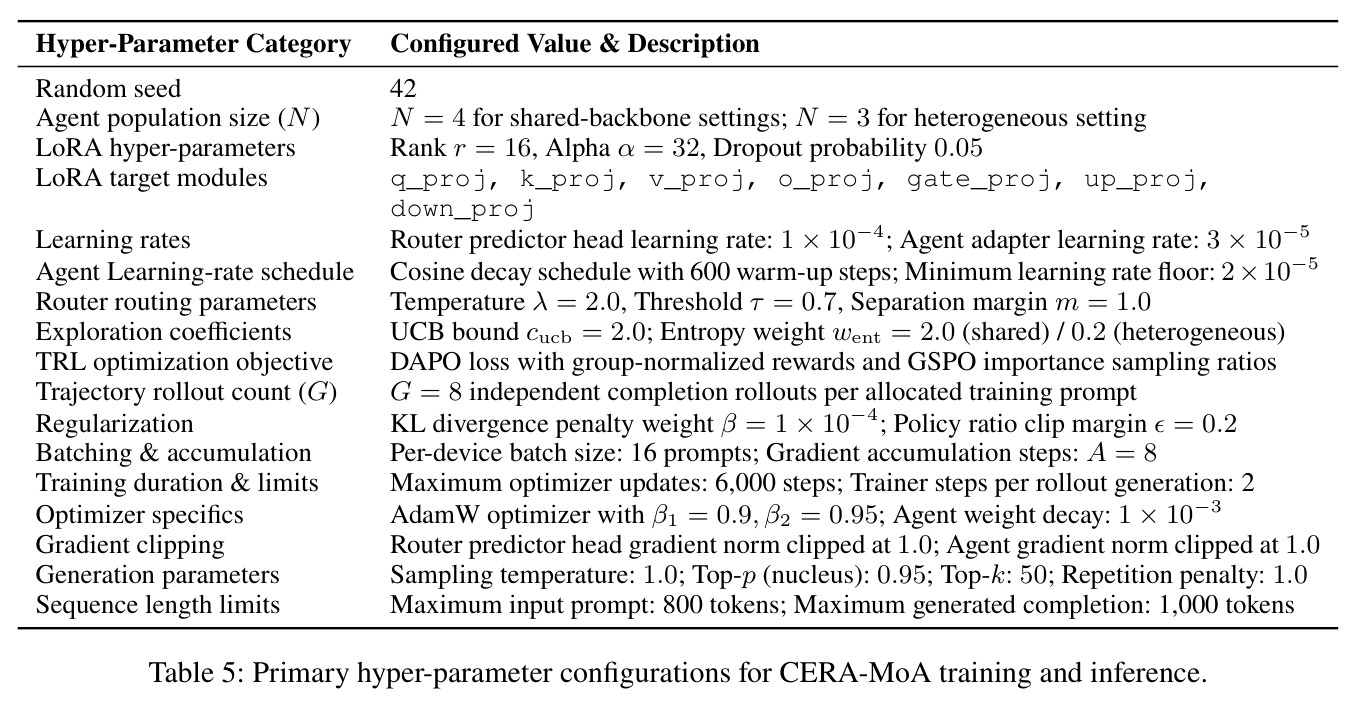
完整流程分六步。(1)特征提取:query $q$ 经路由器冻结骨干做单次部分前向,取第 $\lfloor L/2 \rfloor$ 和 $\lfloor 3L/4 \rfloor$ 层的最终非填充隐状态拼接成 $h(q)$,实测每次仅 11.87ms。(2)熟悉度估计:每个 agent 配一个 MLP 头 $\text{Linear}(2H,512)\to\text{SiLU}\to\text{Linear}(512,256)$,投影到单位超球面后计算 $d_i(q)=\frac{g_i(h(q))}{\|g_i(h(q))\|_2}-\frac{\bar{g}_i(h(q))}{\|\bar{g}_i(h(q))\|_2}$,再得 $f_i(q)=\exp(-\lambda d_i(q))$,温度 $\lambda=2.0$。(3)探索增强路由:路由分 $s_i(q)=f_i(q)+c_{\text{ucb}}\frac{\log T}{n_i+1}+w_{\text{ent}}\bar{H}_i$ 只用于排序防饥饿,激活判据严格只看熟悉度:按 $s$ 降序找最小前缀子集 $S_q$ 使 $\sum_{i\in S_q}f_i(q)\ge\tau=0.7$,若全体之和仍不达标则激活所有 agent;query 随后推入各激活 agent 的 LIFO 缓冲。(4)智能体优化:缓冲攒满 16 条微批后,每条 query 采 $G=8$ 条轨迹,用 DAPO 组归一化优势 $\hat{A}^{(g)}_{i,q}=\frac{R(q,a^{(g)})-\mu_{i,q}}{\sigma_{i,q}+10^{-4}}$、GSPO 序列级重要性比 $\rho^{(g)}_{i,q}$、clip $\epsilon=0.2$、token 级 KL 惩罚 $\beta=10^{-4}$ 更新策略 $\theta_i$。(5)路由器优化:$A_{i,q}=\bar{r}_{i,q}-\frac{1}{|S_q|}\sum_{j\in S_q}\bar{r}_{j,q}$(solo 激活时 $A=\bar{r}$),按推拉损失更新 $g_i$,骨干与 $\bar{g}_i$ 永不更新;$m=1.0$ 满足 $\sum_i\exp(-\lambda m)\le\tau$,保证无人胜任的难题自然触发全员激活兜底。(6)推理聚合:确定性任务按最终答案分组做熟悉度加权投票 $\hat{y}=\arg\max_y\sum_{i:\text{ans}(a_i)=y}f_i(q)$,并输出胜出组中熟悉度最高 agent 的完整推理轨迹;开放式任务直接输出 $\arg\max_i f_i(q)$ 的回答。
技术新颖性
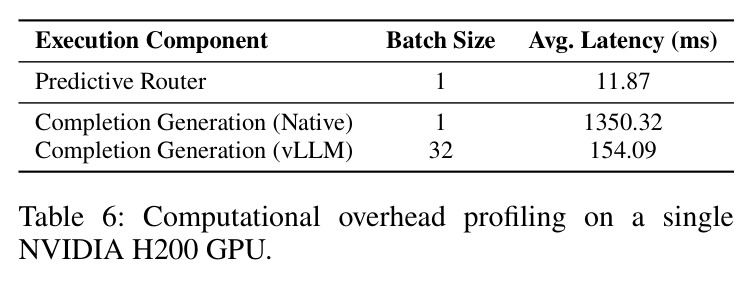
技术新颖性体现在四个层面。第一,评分效率:现有动态路由要么依赖外部裁判 LLM,要么需要完整 rollout 才能判断能力,本文只用单次部分前向提取中层隐状态即可评分,实测 11.87ms/query,不足原生生成时间(1350.32ms)的 1%;并引用 Skean et al. 2025 论证中层表征比被下一词预测主导的末层保留更多可分离语义(末层消融损失约 2.1 个 ID 点且 token 暴涨到 438.12)。第二,激活机制:用'累积熟悉度是否覆盖阈值'替代固定 top-k,激活的 agent 数量随题目难度自适应伸缩,是对性能-开销权衡更细粒度的控制。第三,共演化闭环:路由器更新(评分器追踪能力漂移)与智能体更新(定向数据分配驱动专长分化)互为因果、同步推进,这是首个把'给谁训练什么样本'与'推理时该问谁'统一起来的 MoA 框架。第四,margin 有界排斥的几何设计有明确的形式化动机(保证 $\sum_i\exp(-\lambda m)\le\tau$ 的阈值一致性),理论约束与工程稳定性结合得干净利落。
实验结果
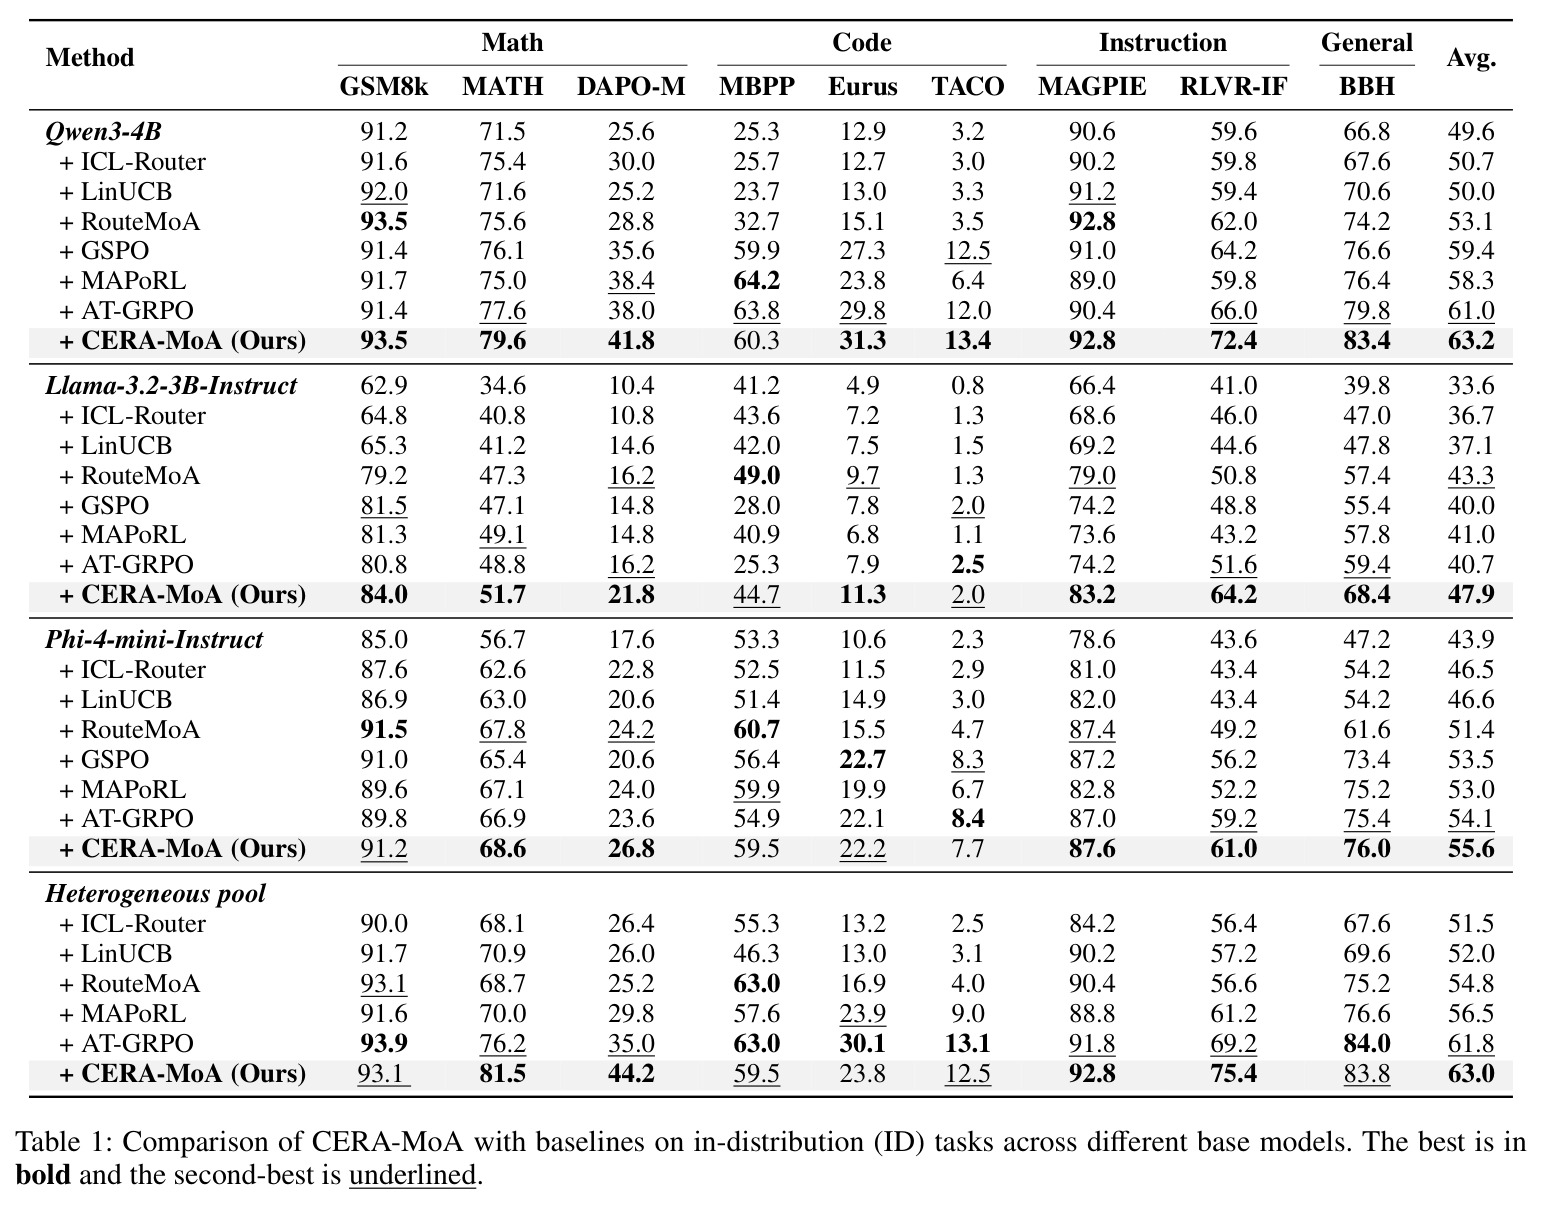
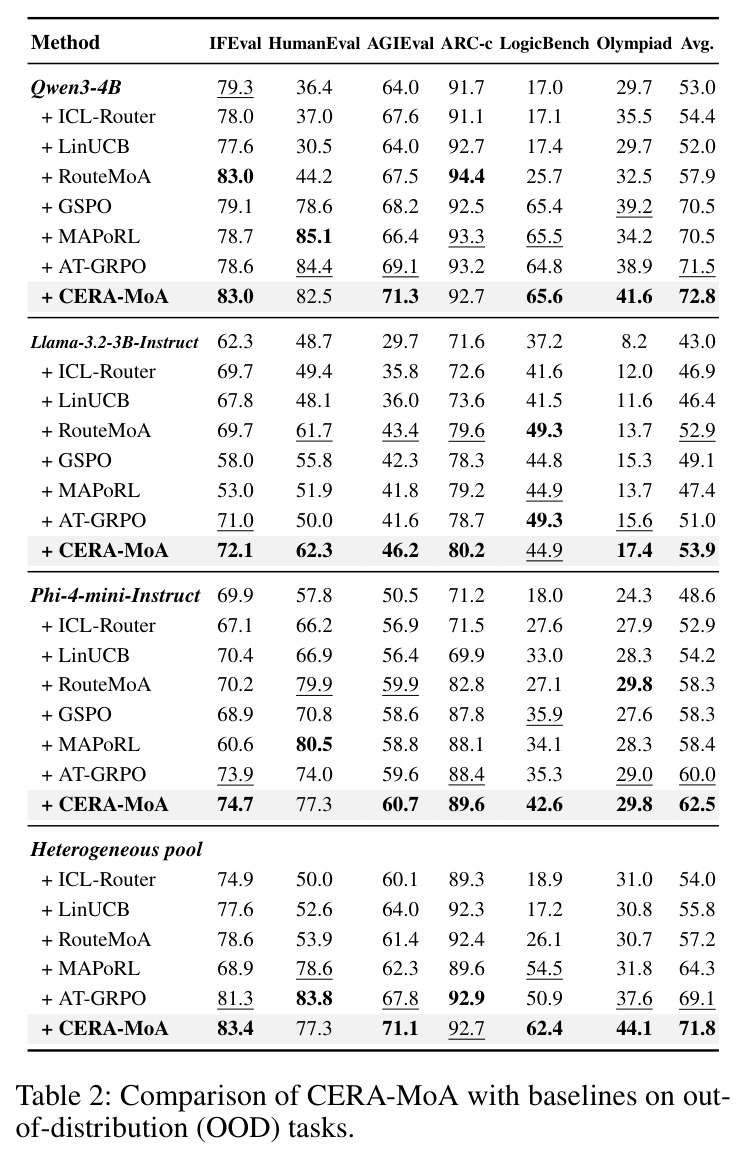
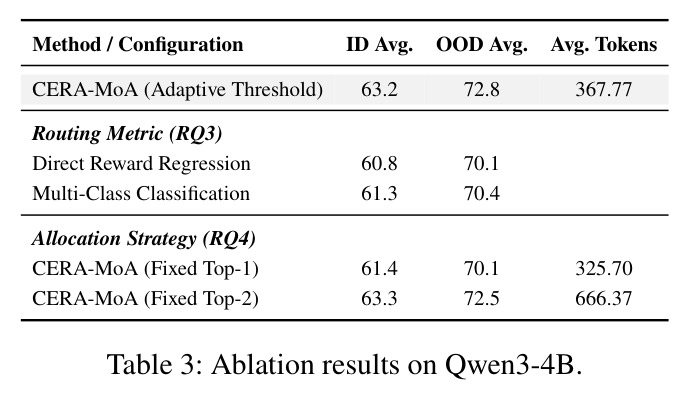
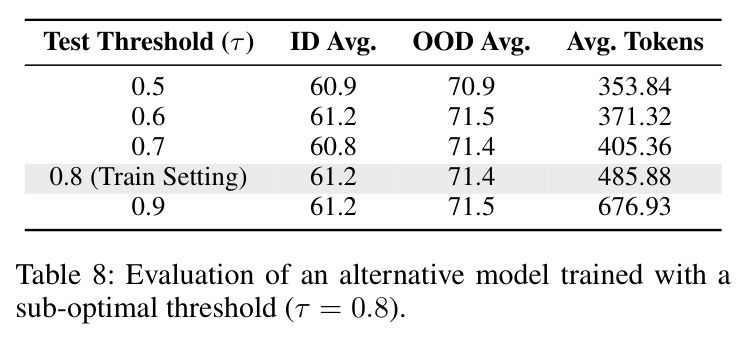
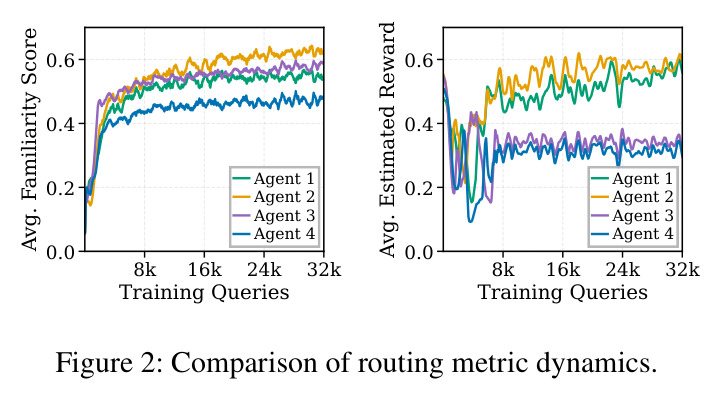
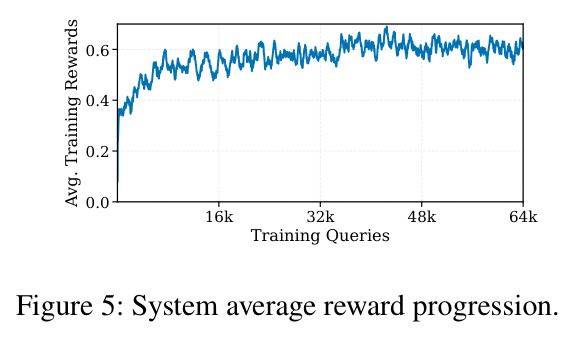
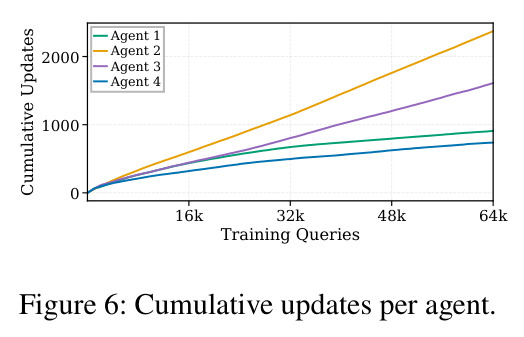
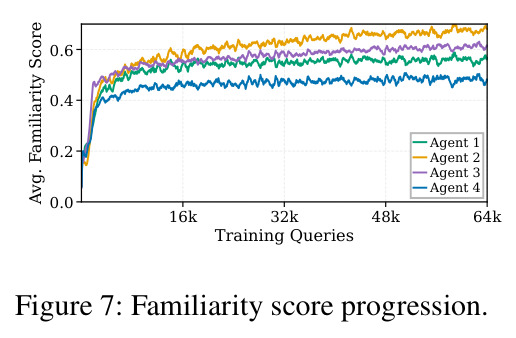
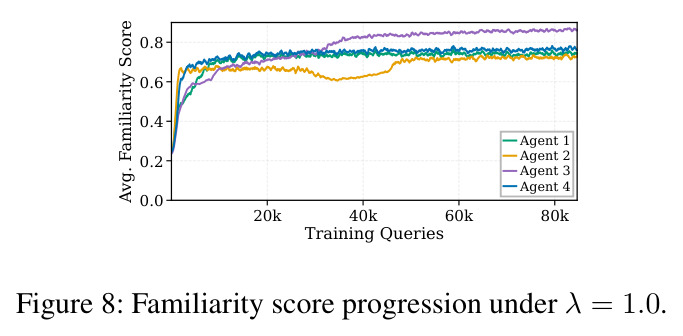
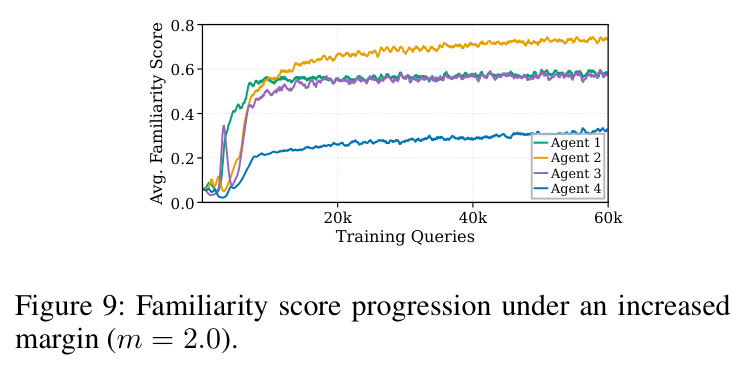
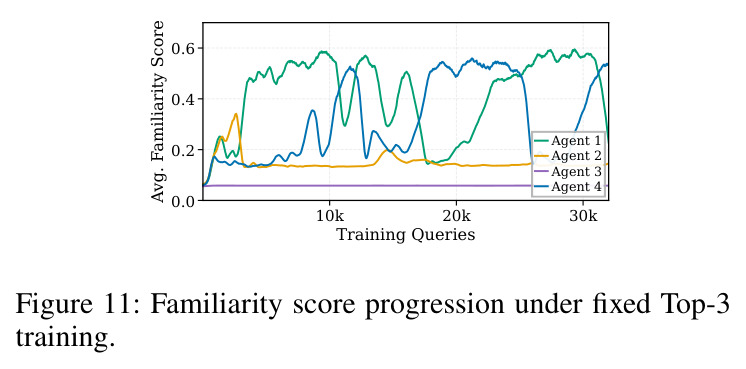
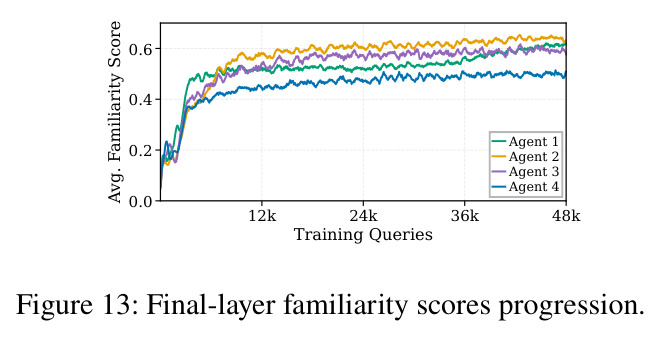
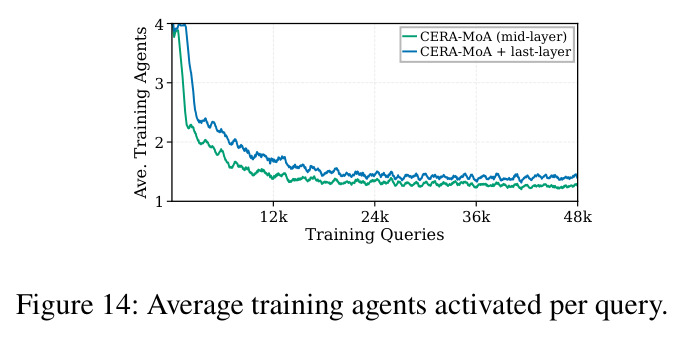
核心结果分五块。(1)同分布 9 基准:Qwen3-4B 平均从 49.6 提升到 63.2(+13.6),超过最强固定工作流微调基线 AT-GRPO 的 61.0;其中 RLVR-IF 72.4(AT-GRPO 66.0)、DAPO-MATH 41.8、MATH 79.6、GSM8k 93.5、BBH 83.4 均为全场最佳。Llama-3.2-3B 从 33.6 提到 47.9,领先 RouteMoA 的 43.3 达 4.6 点;Phi-4-mini 从 43.9 提到 55.6(超 AT-GRPO 54.1)。异构池(Qwen3-4B+Llama-3.2-3B+Phi-4-mini)ID 平均 63.0 超 AT-GRPO 61.8,MATH 81.5、DAPO-M 44.2、RLVR-IF 75.4 优势显著。(2)OOD 6 个未见基准:Qwen3-4B 平均 72.8 超 AT-GRPO 71.5,IFEval 83.0、HumanEval 82.5、AGIEval 71.3、LogicBench 65.6、OlympiadBench 41.6;Llama 53.9、Phi 62.5、异构 71.8 均排第一,说明习得的专长分化能迁移到训练分布之外。(3)路由指标消融(RQ3):直接奖励回归 60.8、奖励驱动多分类 61.3(ID)均明显低于熟悉度方案的 63.2;Figure 2 显示奖励估计在训练中剧烈震荡而熟悉度平滑收敛,印证相对几何信号更适应持续学习动态。(4)激活策略消融(RQ4):自适应阈值平均生成 367.77 tokens,比固定 Top-2(666.37)省约 45% 且性能持平(63.2 vs 63.3);Top-1 虽只花 325.70 tokens 但掉到 61.4,证明单 agent 无法独立解决复杂题。(5)专长涌现(RQ5):四个 Qwen3-4B agent 在零角色 prompt 下自发分化——Agent 2 凭长思维链成为主力推理引擎(累计更新最多),Agent 1 补位简洁数学与逻辑、Agent 3 专注代码、Agent 4 负责通用推理,t-SNE 显示各 agent 的 query 形成清晰分离的语义簇。敏感性方面:$\lambda=1.0$ 使 ID 掉到 55.3,$m=2.0$ 掉到 59.2,去掉探索项掉到 57.1 且路由塌缩到单一 agent,用 $\tau=0.8$ 训练的模型峰值只有 61.2,固定 Top-3 训练把 token 成本推高到 817.97。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 同分布 9 基准平均(Qwen3-4B) | 平均准确率 | 63.2 | AT-GRPO 61.0(基座模型 49.6) | +2.2 vs 最强基线;+13.6 vs 基座 |
| OOD 6 基准平均(Qwen3-4B) | 平均准确率 | 72.8 | AT-GRPO 71.5(基座模型 53.0) | +1.3 vs 最强基线;+19.8 vs 基座 |
| 同分布 9 基准平均(Llama-3.2-3B-Instruct) | 平均准确率 | 47.9 | RouteMoA 43.3(基座 33.6) | +4.6 vs 最强基线;+14.3 vs 基座 |
| 同分布 9 基准平均(Phi-4-mini-Instruct) | 平均准确率 | 55.6 | AT-GRPO 54.1(基座 43.9) | +1.5 vs 最强基线;+11.7 vs 基座 |
| 异构模型池(Qwen3-4B + Llama-3.2-3B + Phi-4-mini) | ID 平均 / OOD 平均 | 63.0 / 71.8 | AT-GRPO 61.8 / 69.1 | +1.2 / +2.7 |
| 推理开销:自适应阈值 vs 固定 Top-2 路由 | 平均生成 tokens/query | 367.77 | 固定 Top-2:666.37 | 降低约 45%,性能基本持平(ID 63.2 vs 63.3) |
| 路由延迟 vs 单智能体完整生成 | 单 query 平均延迟 (ms, 单卡 H200) | 11.87 | 原生自回归生成 1350.32(vLLM batch=32 为 154.09) | 不足原生生成时间的 1% |
局限与改进
作者在附录 F 中承认两点局限。其一,熟悉度估计只看初始用户 prompt,路由天然面向单轮交互或固定轨迹生成;在迭代软件开发、多智能体辩论等多轮 agentic 工作流中,所需专长会随上下文漂移,现有机制无法逐步追踪(作者称结构上可直接扩展到对每轮更新后的上下文提取中层隐状态)。其二,聚合协议在开放式生成任务上退化:确定性任务用熟悉度加权投票,但 MBPP/HumanEval 这类代码合成任务直接输出最熟悉 agent 的单一回答,放弃了多候选互补的优势。我自己的观察还有几点:所有评测都是答案可验证的任务(数学/代码/约束遵循/选择题),开放式写作、对话等软任务上'专长分化'是否成立未验证;涌现分工的粒度基本是数据域的镜像(四个训练域对应四类专长),域内更细粒度分工能否涌现未知;探索系数($c_{\text{ucb}}=w_{\text{ent}}=2.0$,异构时 0.2)、$\lambda$、$m$ 等超参相当敏感,迁移到新场景需要重新调参;训练与测试阈值必须匹配(用 $\tau=0.8$ 训练的模型无论怎么测都劣于默认配置);此外框架隐含 rich-get-richer 风险——早期偶然占优的 agent 会吸走更多样本,论文靠 UCB 缓解但未讨论分工锁死在次优状态时的逃脱机制。
独立分析的弱点
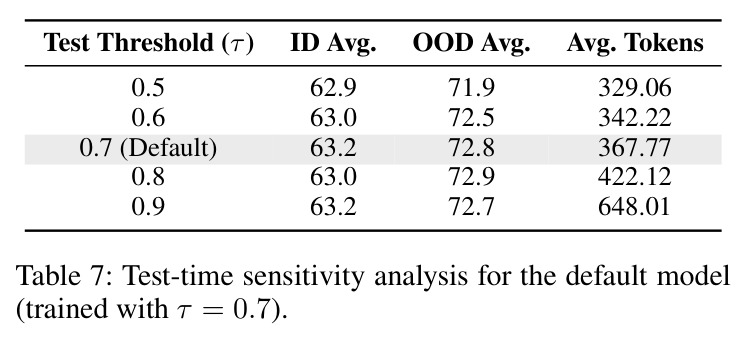
独立分析出的弱点与对应改进方向:(1)富者愈富的专长锁定:Agent 2 因早期长链推理占优吸走多数 query,其余 agent 依赖 UCB 才免于饥饿;若早期优势来自噪声而非真实能力,分工可能锁死在次优状态。改进:引入专长熵正则,或周期性对低样本 agent 强制投放校准探针题以'重探'真实能力。(2)只有相对信号、缺乏绝对校准:熟悉度是几何相对量,$\tau$ 的语义随任务分布漂移(测试时 $\tau$ 从 0.7 调到 0.9,token 成本从 367.77 涨到 648.01 而收益趋零)。改进:并联一个轻量绝对难度/能力头,用双信号共同决定激活数量。(3)单轮 prompt 级路由:多轮场景失效,改进是每轮对更新后的上下文重新提取中层隐状态做逐步 competence tracking(作者也指出此扩展结构直接)。(4)开放式聚合薄弱:直接输出最熟悉 agent 的回答浪费了集合多样性,改进是接入 LLM meta-thinker 做生成式合成(作者确认架构兼容)。(5)规模外推未知:全部实验在 3B-4B 模型上,30B+ 模型的中层表征是否同样保留可分离语义、LoRA 低秩更新是否足以支撑深度分化,均需验证。(6)LIFO 缓冲只保留近期样本,本质是在线学习;若数据流非平稳,长期训练后旧专长可能被冲淡,论文未评估训练后期的稳定性与遗忘曲线。
未来方向
作者明确提出的方向:把单轮语义路由扩展到多轮交互与多智能体辩论,以支持迭代式问题求解;把熟悉度加权投票升级为更高级的答案聚合机制,例如自适应 meta-thinker 来合成多个被激活专家的答案;对每轮更新后的完整上下文做持续 competence 跟踪。基于成果可自然延伸的研究:一是理论侧,为路由器-智能体共演化建立收敛性/稳定性分析,解释 margin $m$、温度 $\lambda$ 与阈值 $\tau$ 的耦合条件(论文已给出 $\sum_i\exp(-\lambda m)\le\tau$ 的一致性约束,可进一步推广);二是与 token 级 MoE/LoRA 混合专家结合,构建样本级+token 级双层路由;三是在线流式部署场景中让 $T$、$n_i$ 随持续到来的 query 更新,研究非平稳分布下的专长维护与灾难性遗忘;四是把'定向数据分配诱导分化'的思想迁移到课程学习、数据挑选与模型合并领域;五是利用熟悉度阈值做测试时扩展(test-time scaling)的预算控制器——把 $\tau$ 直接映射为 token 预算,实现性能-成本的可调度权衡。
复现评估
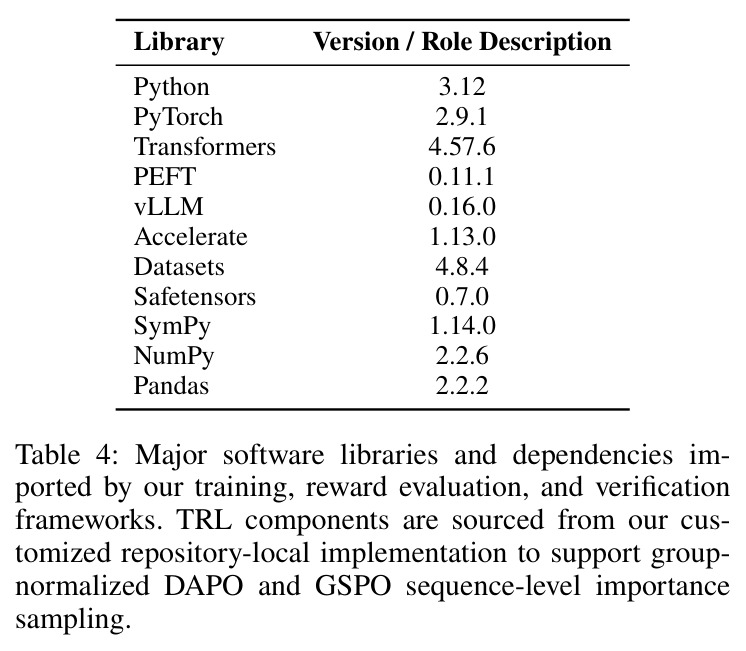
复现资料非常齐全:附录 A 给出完整算法伪代码与头结构(MLP 维度、正交初始化、LIFO 缓冲逻辑);附录 B 列出全部超参(seed 42、LoRA $r=16/\alpha=32$/dropout 0.05、agent 学习率 $3\times10^{-5}$ 余弦衰减含 600 步 warmup、router 头 $1\times10^{-4}$、$\lambda=2.0$、$\tau=0.7$、$m=1.0$、$G=8$、KL $\beta=10^{-4}$、clip $\epsilon=0.2$、最多 6000 优化步、输入上限 800 token、生成上限 1000 token);附录 C 给出四类任务的奖励公式(含线性长度惩罚与分步得分);附录 D 精确列出 32,000 条训练语料的来源构成(MATH 5000、DAPO-MATH-17k 5000、GSM8K 1200、Eurus-2-Code 7000、TACO 2437、MBPP 163、MAGPIE-IF 1400、RLVR-IFEval 5000、BBH 4800,固定 seed 确定性采样);附录 B.1 给出软硬件栈(4×H200 141GB、96 核 Xeon、PyTorch 2.9.1、vLLM 0.16.0、bfloat16)与算力估计:每 1000 优化步(16000 条 query、$G=8$)约需 1 个 H200 GPU 天。短板是正文未提供开源代码仓库链接,DAPO+GSPO+共定位 vLLM 的训练循环需要自行搭建(TRL 组件为作者魔改的本地实现),复现工程量中等偏上。共享骨干+4 个 LoRA 的设置总参数量仅约 4.4B,单张 A100/H100 小规模复现可行;异构设置需 3 张卡隔离各基座。总体评价:数据与配方透明,算力门槛较高,代码需自实现。
论文图表
四个任务族(数学推理、通用推理、代码生成含函数调用与标准输入输出两种接口、开放式指令遵循)的零-shot prompt 模板原文,输入只含原始问题与统一的输出格式要求(如 Answer: \boxed{XX}),没有任何角色人设或行为提示。
证明实验严格执行'零角色 prompt'设计,排除人为 prompt 工程对专长涌现的干扰,使 RQ5 的结论可信。