RayOrch:面向基础模型数据准备的血缘受控多粒度数据流编程与执行系统 RayOrch: Programming and Executing Lineage-Controlled Multi-Grain Dataflows for Foundation-Model Data Preparation
把父子血缘做成运行时状态:跨父混批调度的同时保住按序重构、按父完成与失败隔离
前置知识
结构血缘(lineage)
血缘指记录每条数据的来源与变换历史。本文的"结构血缘"特指运行时在线维护的控制状态:一次展开物化的具体子节点集合、每个子节点所属的直接父节点及其不可变零基序号、以及各节点的终态结论。它不是事后审计用的溯源记录,也不是 Ray 的任务重算谱系,而是直接驱动调度、完成判定与失败抑制的活状态。
RayOrch 的全部创新都建立在"血缘是运行时一等状态"这一前提上,不理解它就无法理解跨父批次与按序重构为何能兼得。
1:N 可变基数扇出(fan-out)
一个输入项产出数量不定、顺序确定的子项序列:一份 PDF 产出页,一页产出区域,一段视频产出片段、帧或音频段。子项数量由输入内容决定且分布长尾——论文语料中单个 PDF 从 1 页到 427 页不等。GPU 阶段希望把不同父的就绪子项混进同一批次以提高利用率,这是效率与结构之间的张力来源。
论文要解决的核心问题就是这种扇出的高效且正确执行,MinerU 和视频流水线实验全部围绕它展开。
shuffle / 再分组屏障(regrouping barrier)
在扁平记录系统中做扇出后,要把散落各处的子结果按父重组,通常需要一次全局 groupby+sort(类似 MapReduce 的 shuffle 阶段)。这是一道同步屏障:所有无关的父必须互相等待,重组完成后下游才能开始,形成端到端耗时的"尾巴"。
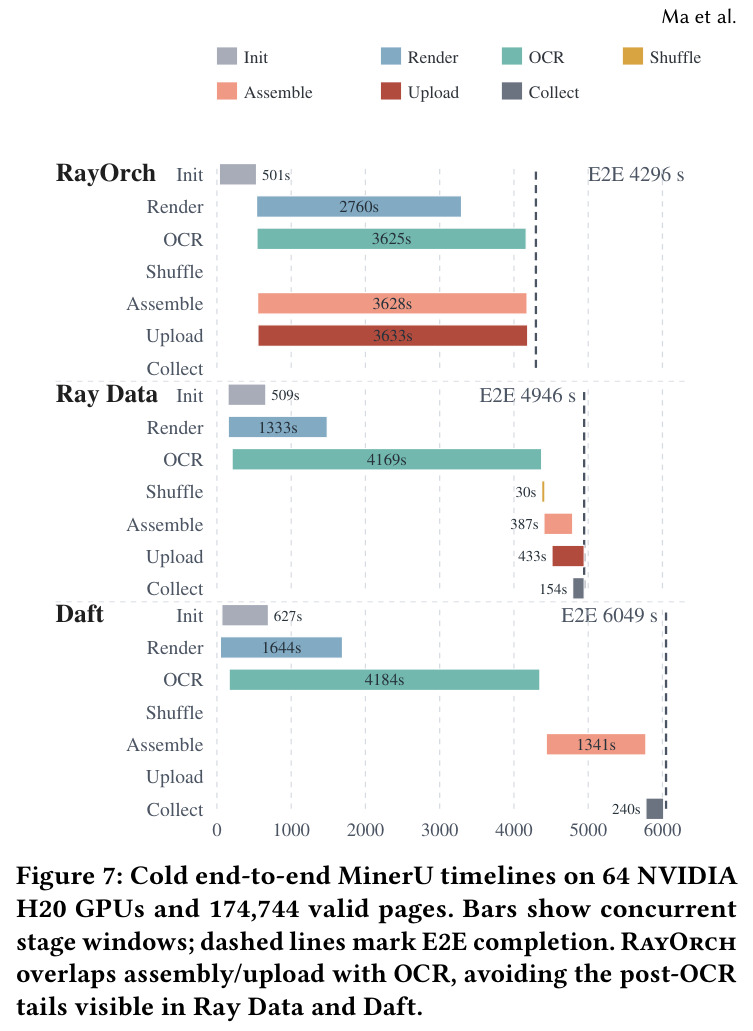
Ray Data 与 Daft 基线的性能劣势(post-OCR 尾巴)正是这个屏障造成的,Figure 7 的时间线对比是理解论文收益机制的关键。
Grain 与生成号栅栏(generation fence)
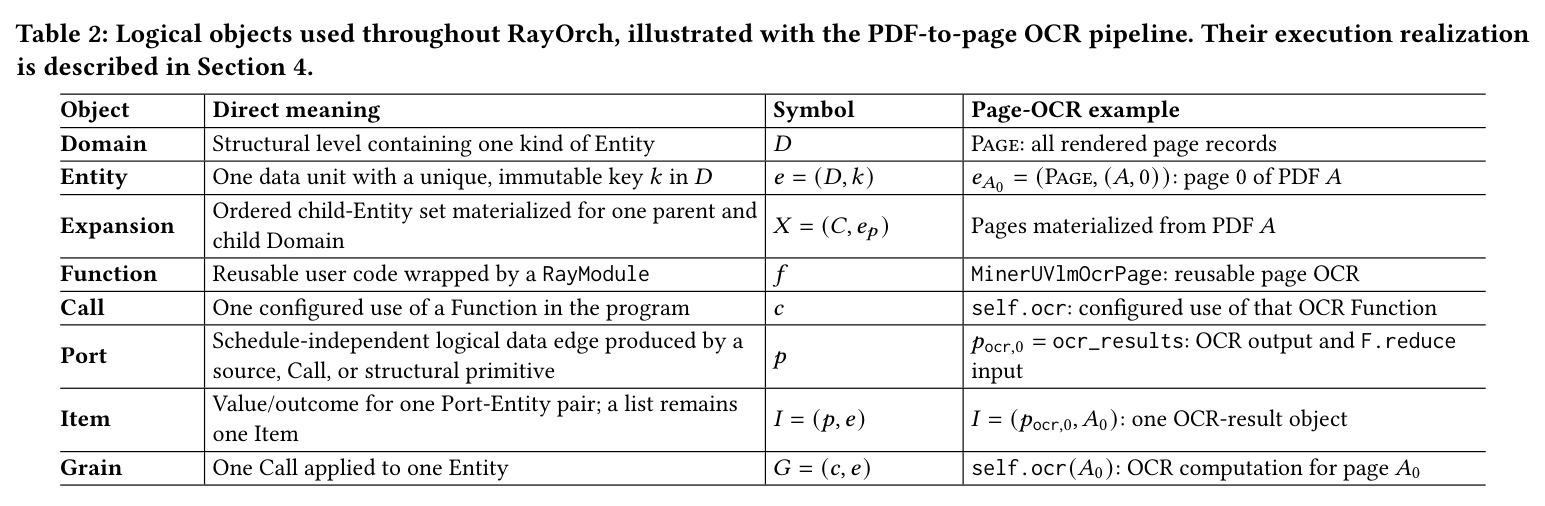
Grain 是"一次配置化的 Call 应用到一个 Entity",是调度、重试和提交的最小单元。每次物理尝试带有递增的生成号(attempt number)。提交门规定:报告只有在 Grain 仍在飞行(in-flight)且生成号与当前尝试一致时才被接受,接受即封存并原子发布终态事实,从而在重试和 actor 替换后拒绝陈旧或重复的报告。
这是 RayOrch 保证失败恢复正确性的核心机制,公式 (3) 的提交条件是全文形式化语义的基石。
强扩展性(strong scaling)
固定输入规模不变、不断增加计算资源(GPU 数量),观察处理时间能降低多少。理想情况是 N 倍 GPU 带来 N 倍加速(线性扩展);实际系统因通信、同步和调度开销通常低于理想值,加速比与理想值之比衡量系统效率。
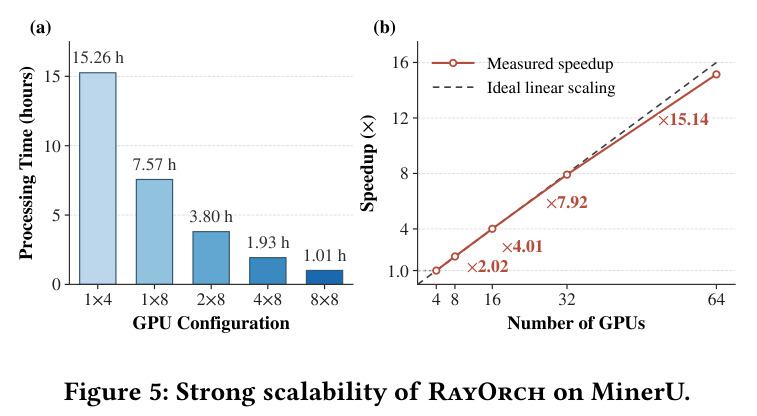
论文的主要评估维度:MinerU 负载从 4 GPU 到 64 GPU 达到 15.14× 加速,即理想线性的 94.6%,这是最有说服力的系统指标。
研究动机
基础模型的数据准备流水线会反复改变处理单元:一份 PDF 依次产出页、版面区域、表格,一段视频产出片段、帧和音频段,每个阶段的最优并行粒度都不同。论文用真实语料量化了这种扇出的长尾性:MinerU 工作负载中 3,689 个 PDF 共含 174,744 个有效页,每个 PDF 的页数在 1 到 427 之间剧烈波动;视频工作负载中 27,091 个视频切出 104,952 个片段,多数父很短、少数父极大。这带来一个结构性矛盾:GPU 推理阶段(如 MinerU 的 1.2B 参数 VLM OCR 模型逐页识别)希望把来自不同父的就绪子项混进同一批次以提高利用率;但系统又必须把每个结果按声明顺序归还给直接父、判定一个父的全部子项何时到达终态以便释放下游组装,并在失败时把影响圈在最小范围。现有系统二选一都付代价:粗粒度函数把整份文档当黑盒任务,隐藏了页级并行,无法单独调度子项或形成跨父模型批次;Ray Data 的 flat_map 和 Daft 的 explode 虽暴露子项并行,却把"孩子属于谁、排第几、是否全部完成"当成应用数据,应用必须自己维护计数、做全局 groupby+sort+reduce 重建结构,在子阶段之后引入 shuffle 再分组屏障,而且运行时无法感知哪些兄弟计算因同父失败已注定无效,只能白白执行。
本文的目标是RayOrch 的目标是让分布式数据流系统在跨父混合批次调度细粒度工作的同时,自动保留按父完成、按序重构和失败隔离所需的结构信息,而不把这些正确性关键逻辑推给应用。具体拆成四件事:其一,提供一个 Torch 风格的编程模型,让用户声明"有序、可变基数的父到子展开"(F.expand)和配套的"子到父按序汇聚"(F.reduce),由编译器静态校验配对与 Domain 兼容性,而不是靠应用字段约定;其二,运行时物化并维护每次展开的结构血缘——具体子集合、每个孩子的直接父与不可变零基序号、各项终态——作为驱动调度与完成判定的在线控制状态;其三,用每个 Call 独立的 FIFO 就绪队列做跨父混合批调度,物理批次可任意组队但不改变成员与重构顺序;其四,引入类型化的父域失败抑制:一次 Call×父作用域内的失败在派发前拦下未派发的兄弟计算,同时不影响无关父。最终在 MinerU、Docling 文档流水线和 Qwen2.5-VL-7B 视频流水线上验证端到端收益与到 64 GPU 的近线性扩展。
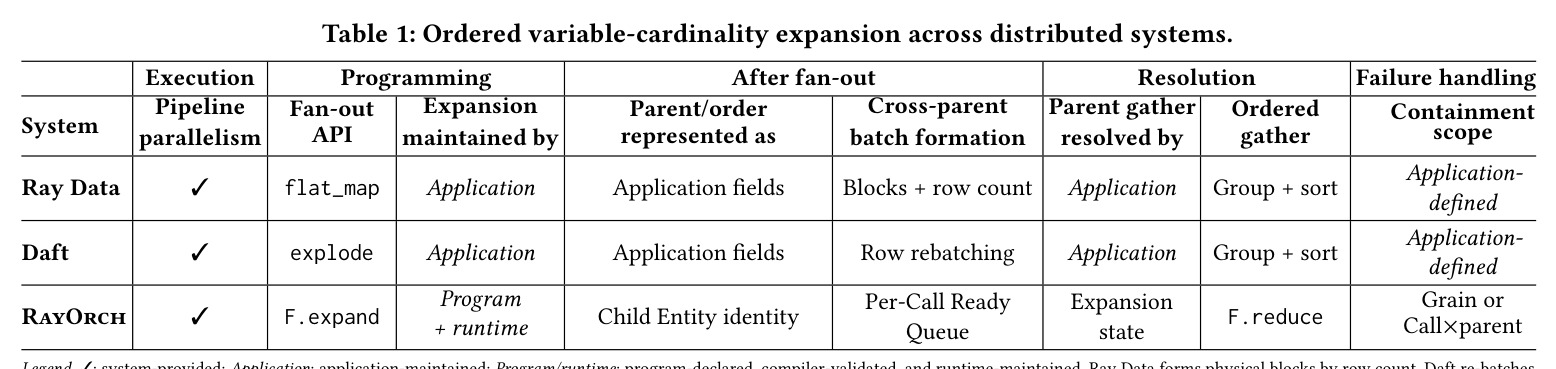
与已有工作不同的是,本文的独特切入是把"结构"与"执行"彻底分离:结构血缘成为运行时一等状态,物理批次保持瞬时可丢弃。已有表示各只捕捉问题的一面。Spark、Dask、Ray 提供分布式集合与任务图,Ray Data 和 Daft 增加了流水线执行与改基数算子,但当应用通过扁平集合表达扇出时,父键和序号只是普通字段——运行时不解释其结构含义,具体成员和终局都是应用数据,不驱动下游就绪判定或汇聚解析。与 Titian 这类事后数据溯源不同,RayOrch 的血缘是在线的控制状态,直接决定调度、按父完成和失败抑制;与 Naiad 及流式系统用事件时间、水位线、逻辑时间戳刻画进度不同,这里的进度坐标是"一次物化展开的具体有序子序列"。因此在被评估的 Ray Data 与 Daft 流水线中,重建都不可避免地在子阶段后引入 shuffle 或再分组屏障,而 RayOrch 用声明的展开-汇聚对加运行时维护的血缘状态,让按父本地完成即可释放下游,Table 1 从六个维度系统对比了这一差异。
核心方法
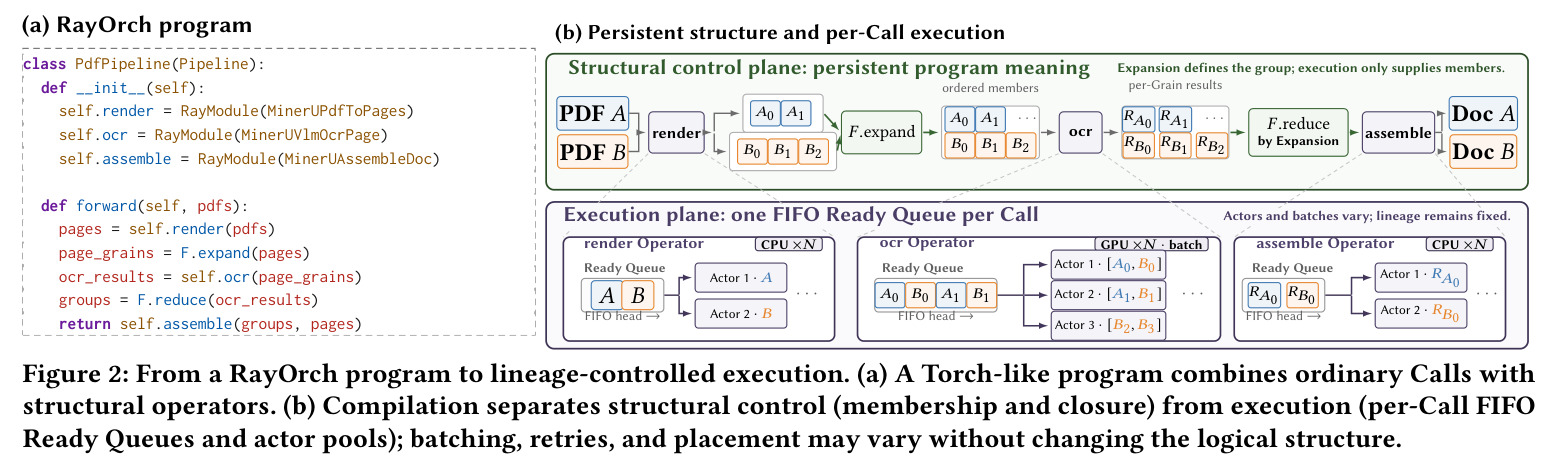
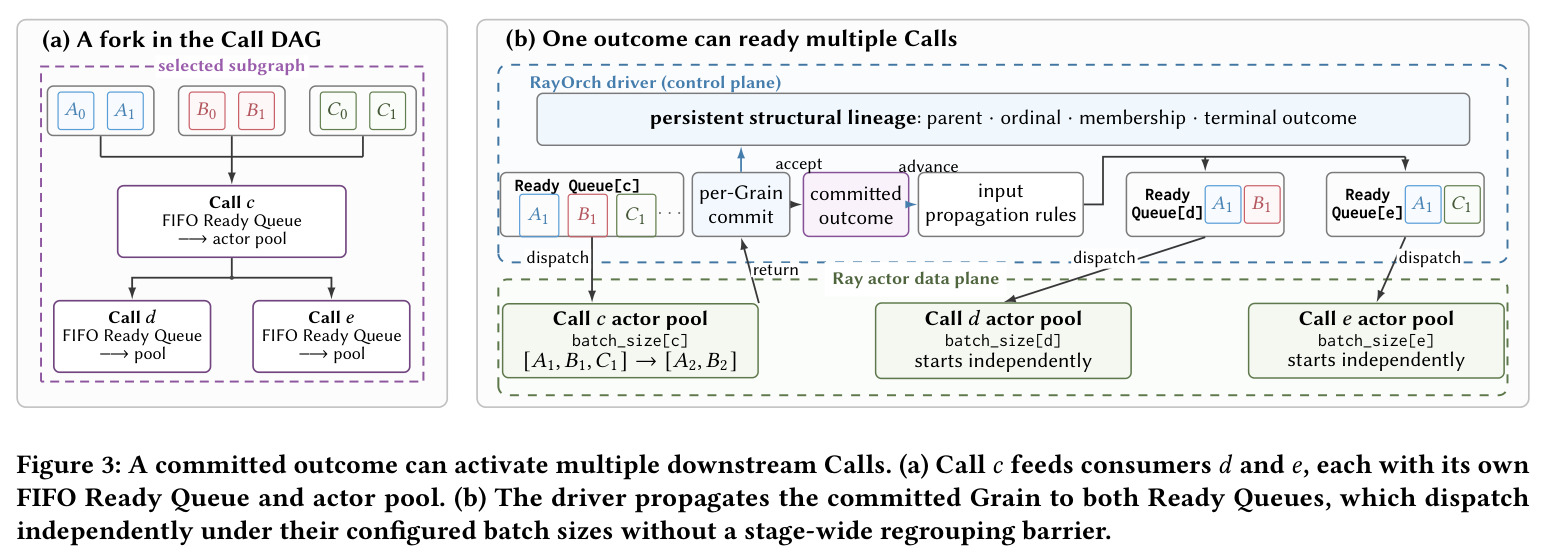
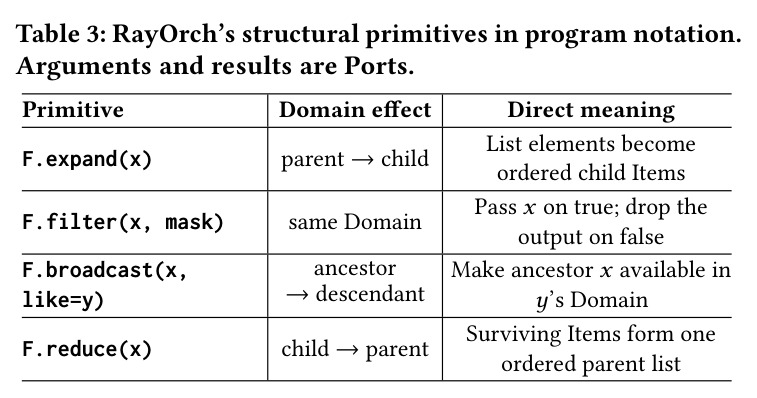
直觉先行:把"哪些子项属于哪个父、各自排第几、何时到达终态"从应用数据提升为运行时持续维护的结构状态,之后物理执行怎么变化——批次怎么拼、actor 怎么换、重试几次——都不影响逻辑结果。技术路线分四层。编程模型层:类 Torch 的 Pipeline/RayModule 接口,forward 里写 render → F.expand → ocr → F.reduce → assemble 这样的组合;结构原语共四个(F.expand、F.filter、F.broadcast、F.reduce),F. 前缀与用户函数区分。编译层:把符号 DSL 降低为不可变图,静态检查无环性、Domain 兼容性和每对 expand–reduce 的匹配,非法跨域用法在执行前报错,运行时因此消费的是声明的关系而非从负载推断的谱系。运行时层:每个配置化的 Call 对应一个带 FIFO 就绪队列的 CPU/GPU actor 池;运行时为每个父实体物化 Expansion 并发布不可逆的终态事实;调度器从就绪队列做弹性预留或父绑预留,组成可跨父混合的瞬时物理批次。提交与恢复层:报告只有在 Grain 仍在飞行且生成号匹配时才被接受,接受即封存并原子发布终态;类型化 GroupFailure 安装 Call×父抑制屏障,恢复走独立优先队列精确重放。整个语义契约归结为公式 (4):任何合法物理调度的最终 Items 及其血缘序完全相同。
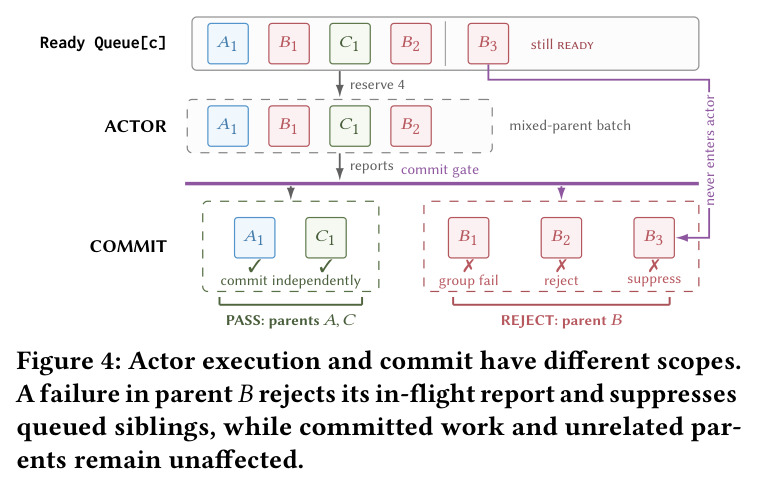
核心创新:把每次物化展开的结构事实(成员、序号、终态)变成调度器消费的一等状态,而把批次组成降级为纯执行选择。与 Ray Data/Daft 的本质区别在于:那边扇出后父/序是应用字段,"父是否完成"要靠应用数数、全局 groupby+sort 重建,批次边界成了事实上的分组单位;RayOrch 里 F.reduce 依据声明的成员和不可变序号直接发射父结果,论文强调"一个物理批次永远不可能定义半个文档"——批次只决定哪些就绪 Grain 共享一次尝试。由此三个能力自然涌现:其一,完成的父立即推进下一阶段,不等无关父,RayOrch 的组装/上传窗口因此能与 OCR 完全重叠;其二,失败可以精确圈定在 Call×父作用域——类型化 GroupFailure 在派发前抑制就绪兄弟、拒绝在飞兄弟、不碰已提交兄弟,无关父和队列保持活跃;其三,生成号栅栏让 actor 替换与重试安全,陈旧或重复报告被原子拒绝。FIFO 就绪队列被明确定位为"准入队列而非分组操作":Grain 输入就绪即入队,下游 Call 只在上游结果提交后才收到条目,这既不同于流式系统的窗口/水位线进度模型,也不同于以批次为单位的组语义。
方法步骤详情
第一步,用户以 Torch 模块风格声明程序:__init__ 里把 MinerU 的 PDF 渲染、1.2B 参数 VLM 页级 OCR、文档组装包装成 RayModule;forward 里写 pages=self.render(pdfs)、page_grains=F.expand(pages)、ocr_results=self.ocr(page_grains)、groups=F.reduce(ocr_results)。F.expand 把每个 PDF Item 的页列表物化为有序 Page Entity,OCR Call 为每页建一个 Grain,F.reduce 按声明序重建文档级 Item。第二步编译:检查无环性、Domain 兼容性、expand–reduce 配对,生成含 Calls、Ports、Domains、消费者和预索引结构效应的不可变图。第三步运行时血缘:为子域 $C$ 与父实体 $e_p$ 创建 Expansion $X=(C,e_p)$ 记录有序子 Entity;每个对象恰好发布一个不可逆终态事实——Entity 发 $\textit{Published}(e,o)$($o$ 为不可变序号),Item 发 $\textit{Present}(v)\mid\textit{Dropped}\mid\textit{Failed}\mid\textit{Suppressed}$,Expansion 发 $\textit{Succeeded}(\langle e_0,\ldots,e_{m-1}\rangle)\mid\textit{Dropped}\mid\textit{Failed}$;输入传播优先级固定:失败或被抑制的输入使输出被抑制,未决输入等待,必需输入被丢弃则输出丢弃。第四步调度:每微批每 Call 一条 FIFO 就绪队列;弹性预留以 $O(B)$ 取出至多 $B$ 条可跨父混批的条目,父绑预留则取队首就绪父的至多 $B$ 个兄弟;Grain 生命周期 $\textit{waiting}\to\textit{ready}\to\textit{in-flight}\to\textit{sealed}$,重试走 in-flight→ready。第五步提交与失败:$\textit{Accept}(r,G)\iff \textit{phase}(G)=\textit{IN-FLIGHT}\ \wedge\ r.\textit{grain}=G\ \wedge\ r.\textit{generation}=\textit{generation}(G)$,接受即封存并原子发布;类型化 RecordFailure 终结单个 Grain,未类型化异常是可重试换 actor 的物理失败;类型化 GroupFailure 抑制同 Call 同父的未派发兄弟,恢复用独立优先队列重插精确 Grain 组。
技术新颖性
技术新颖性可从四个维度看。抽象层面:论文把"多粒度数据流"形式化为有限无环 Domain 树上成对的有序可变基数展开与父域汇聚,使其成为可静态检查的契约(编译器验证配对与域兼容),这在数据准备系统里是新的;Table 1 显示 Ray Data 和 Daft 在扇出后都退回"应用维护字段 + group + sort + 应用定义失败语义"。状态层面:结构血缘被明确定义为"供在线调度与完成判定用的控制状态",区别于事后溯源(Titian 在 Spark 里记录数据级 provenance)和 Ray 的任务重算谱系。执行层面:FIFO 就绪队列加弹性/父绑双预留策略,把"跨父混批"与"成员/顺序不变"解耦,父完成即可本地释放下游,无需 stage 级屏障——Figure 7 显示 RayOrch 的组装/上传窗口与 OCR 重叠而基线有 post-OCR 尾巴。可靠性层面:生成号栅栏的提交门与双轨类型化失败(RecordFailure 管单 Grain、GroupFailure 管 Call×父)把"重试/actor 替换"与"逻辑失败"分开,配合公式 (4) 的调度不变性契约给出可证明的端到端语义。工程上它是 Ray 之上的薄 Python 层,不侵入 Ray 内核,负载值经 Ray 对象存储交换而句柄和引用永远不进入 Grain 的逻辑身份,这种克制让系统易于迁移和审计。
实验结果
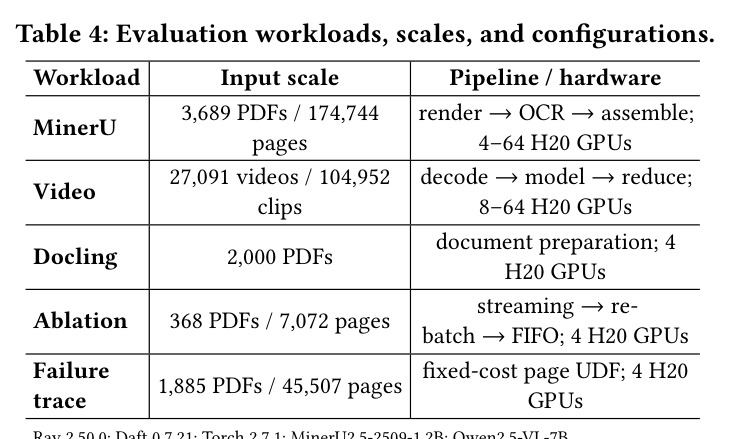
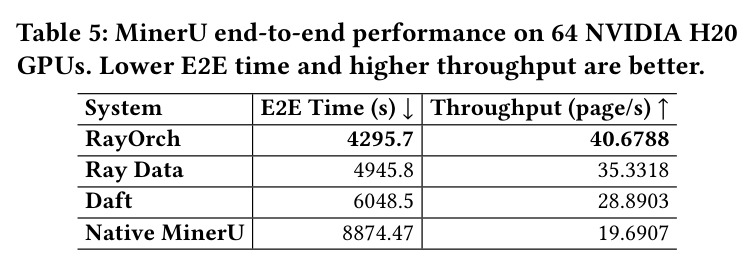
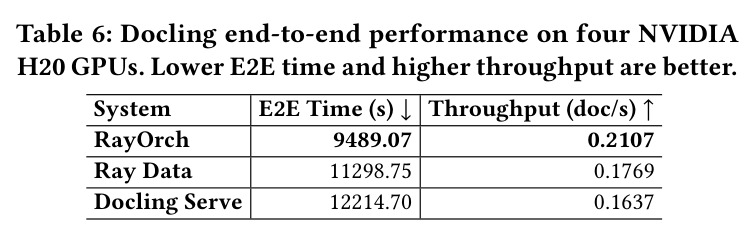
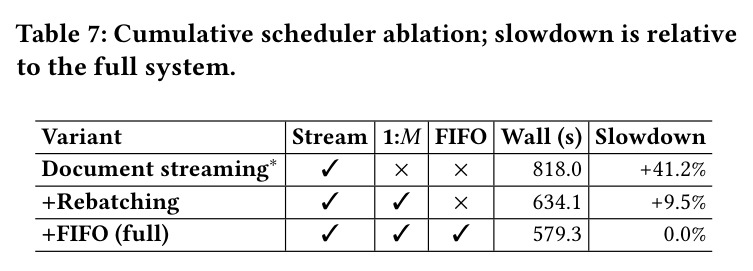
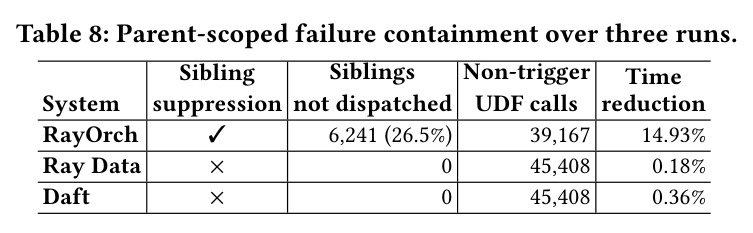
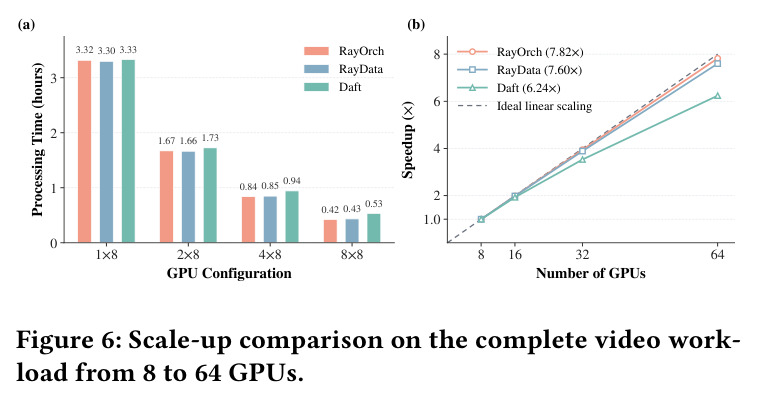
评估在 NVIDIA H20 GPU 上覆盖五个工作负载(Ray 2.50.0、Daft 0.7.21、MinerU2.5-2509-1.2B、Qwen2.5-VL-7B),逐项看。RQ1:MinerU(3,689 PDF/174,744 页)从 4 GPU 的 15.26 小时降到 64 GPU 的 1.01 小时,8/16/32 GPU 分别加速 2.02×/4.01×/7.92×,64 GPU 达 15.14×(理想线性的 94.6%);固定 64 GPU 下 RayOrch 4,295.7 秒(40.6788 页/s),比 Ray Data 4,945.8 秒快 13.1%、比 Daft 6,048.5 秒快 29.0%、比原生 MinerU 8,874.47 秒快 51.6%,吞吐分别高 15.1%/40.8%/106.6%。视频负载(27,091 视频/104,952 片段)8 GPU 时三者持平(3.32/3.30/3.33 小时),64 GPU 时 RayOrch 0.42 小时(7.82×)领先 Ray Data(0.43 h,7.60×)和 Daft(0.53 h,6.24×)。Docling(2,000 PDF,4 GPU)RayOrch 9,489.07 秒(0.2107 doc/s),比 Ray Data 快 16.0%、比 Docling Serve 12,214.70 秒快 22.3%。RQ2:RayOrch 的 OCR 窗口(3,625 s)与组装(3,628 s)、上传(3,633 s)完全并发,E2E 4,295.7 秒;基线则有 post-OCR 尾巴(Ray Data 组装 387 s+上传 433 s+收集 154 s;Daft 组装 1,341 s)。RQ3:血缘与提交固定时,流式 818.0 s(+41.2%)→+1:1:M 重批 634.1 s(+9.5%)→+FIFO 全系统 579.3 s,FIFO 额外省 54.8 s(8.6%)。RQ4:对占文档 5.25%、页数 51.9% 的 99 个最大父的第 0 页注入失败(18 次运行全部产出预期健康输出),RayOrch 使 6,241 个就绪兄弟(毒父兄弟的 26.5%)不进 UDF,非触发调用从 45,408 降到 39,167,成对时间降 14.65–15.24%(均值 14.93%),而 Ray Data/Daft 仅 0.18%/0.36%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MinerU PDF 解析(64 GPU 端到端) | E2E 时间 (s) / 吞吐 (页/s) | 4,295.7 s / 40.6788 页/s | Ray Data 4,945.8 s / 35.3318 | E2E 快 13.1%,吞吐高 15.1% |
| MinerU PDF 解析(vs Daft,64 GPU) | E2E 时间 (s) | 4,295.7 s | Daft 6,048.5 s | 快 29.0%,吞吐高 40.8% |
| MinerU PDF 解析(vs 原生 MinerU,64 GPU) | E2E 时间 (s) | 4,295.7 s | Native MinerU 8,874.47 s | 快 51.6%,吞吐高 106.6% |
| MinerU 强扩展(4→64 GPU) | 处理时间加速比 | 15.26 h → 1.01 h,15.14×(理想线性的 94.6%) | 理想线性 16× | 接近线性扩展 |
| 视频流水线强扩展(8→64 GPU) | 处理时间加速比 | 0.42 h,7.82× | Ray Data 0.43 h(7.60×);Daft 0.53 h(6.24×) | 最高加速比且绝对时间最短 |
| Docling 文档解析(4 GPU) | E2E 时间 (s) / 吞吐 (doc/s) | 9,489.07 s / 0.2107 doc/s | Ray Data 11,298.75 s;Docling Serve 12,214.70 s | 快 16.0% / 22.3% |
| 调度器消融(368 PDF / 7,072 页,4 GPU) | 墙钟时间 (s) | +FIFO 全系统 579.3 s | 仅 1:1:M 重批 634.1 s;纯流式 818.0 s | FIFO 额外省 54.8 s(8.6%) |
| 父域失败注入(1,885 PDF / 45,507 页,4 GPU) | 被抑制兄弟数 / 成对时间降幅 | 6,241 个兄弟被抑制(26.5%),时间降 14.93% | Ray Data / Daft 抑制 0 个,时间仅变 0.18% / 0.36% | 唯一能在运行时拦下注定无效计算的系统 |
局限与改进
作者明确划定的边界:系统只覆盖有限、无环、层级 1:1:M 的数据流,不支持一般 join、跨微批的窗口和反馈边;有序汇聚只在源微批内保证;类型化失败要求 UDF 显式抛出类型化异常,未类型化异常退化为物理重试而非逻辑抑制;评估限定三类流水线家族与 H20 GPU 一种硬件,批大小、actor 数等关键超参的人工配置敏感性未系统报告。我的补充观察:其一,失败收益的量级强依赖长尾结构——6,241 个被抑制兄弟出现在"99 个最大父占 51.9% 页数"的极端分布下,语料分布更均匀时收益会明显缩水;其二,driver 集中持有全部血缘元数据、编译计划和 ObjectRef,在数亿页级语料下的内存占用与单点故障风险文中未评估;其三,语义契约只承诺结构与终态不变,若 UDF 对批形状、输入顺序或随机性敏感则 payload 也不保证,正确性责任仍部分落在用户身上;其四,失败注入实验用固定 50 毫秒的页 UDF,真实重 UDF(秒级 VLM 推理)下抑制节省的相对比例会被稀释;其五,视频实验显示 8 GPU 时三者几乎持平,说明收益主要在大规模与长尾场景,小规模部署吸引力有限。
独立分析的弱点
第一,表达力天花板:不支持 join、跨微批窗口和反馈,意味着多轮自举式数据生成(生成→评分→再生成)必须绕出系统,F.broadcast 等对齐变体只能覆盖有限的祖先传值需求。改进方向是把 F.* 原语扩展到受控环或与通用 dataflow 层组合。第二,driver 中心化:编译计划、血缘元数据和待决 ObjectRef 都在 driver 进程,可按 Domain 分片血缘并将终态事实外置到预写日志,实现多 driver 或租约化架构。第三,调度策略静态二选一:弹性预留与父绑预留是配置项而非自适应决策,面对混合长尾语料时可依据在线估计的子数分布自动切换,或对超大父做子数感知的公平配额,缓解 FIFO 队头阻塞。第四,类型化失败依赖 UDF 自觉抛异常:脏输入若不抛类型化异常就只会触发无谓的物理重试,可在运行时加统计离群检测作为兜底抑制,把"毒输入"的判定从显式异常扩展到输出质量信号。第五,消融空间未覆盖:批大小(失败实验固定 48)、预留策略、长尾偏度等对性能的影响没有系统扫描,工程落地需要类似 Trident 的自动配置调优。
未来方向
作者从限制反推的方向:扩展结构模型以支持更一般的关系(join、窗口、反馈),把有序汇聚从源微批推广到任意范围,并加强恢复语义与血缘状态自身的规模。基于本文成果可延伸的研究:其一,增量重算与血缘复用——语料更新时只重算受影响的子树,不可逆终态事实天然支持增量 diff 和缓存失效判定;其二,成本感知调度——把 VLM OCR 等重 UDF 的代价模型接入预留策略,联合优化 GPU 利用率与父完成时延,并与弹性伸缩结合;其三,贯通"准备→选择→训练"链路,与 Mixtera、Data-Juicer、Modyn 等数据平面打通,让血缘支撑训练数据溯源、质量回归和审计合规;其四,把类型化失败推广为质量门控,例如低置信 OCR 区域触发受控降级路径而非整父失败;其五,支持流式或无限源,与事件时间/水位线进度模型对接,服务在线数据管道与持续预训练场景。
复现评估
复现条件相当好。代码已开源(github.com/OpenDCAI/RayOrch),实现是 Ray 2.50.0 之上的 Python 层,接口是 Torch 风格的 Pipeline/RayModule,用户无需触碰 Ray 内核;模型全部公开:MinerU2.5-2509-1.2B 与 Qwen2.5-VL-7B,基线 Ray Data/Daft 版本明确。工作负载规模写得很具体(3,689 PDF/174,744 页、27,091 视频/104,952 片段、2,000 PDF),但语料本身的来源与获取方式未说明,复现需自备 PDF/视频。算力门槛分层明显:完整强扩展实验需要 64 块 H20,个人和多数实验室难以复现;但最能体现设计思想的消融(Table 7)和失败注入(Table 8)都只需 4 GPU,失败实验甚至用固定 50 毫秒 UDF,单机多卡即可重跑。整体难度评级中等偏易:主要工程量在数据准备(文档质量会影响页数分布从而改变长尾特性)和不同卡型(如 A100/A10)下的性能折算,系统本身的安装与二次开发门槛不高。
论文图表
三联动机图。(a) PDF A 只有 2 页、PDF B 有 48 页、视频 C 有 120 个片段,扇出基数输入相关且长尾,多数父很短、少数父巨大;(b) 扁平系统(Ray Data/Daft)靠全局 groupby+sort+reduce 重建结构,A 和 C 必须等待 B 完成,下游 actor 空闲,还要再分组才能进入页→区域、片段→帧/音频等下一粒度;(c) RayOrch 让运行时持有血缘(父、序号、成员、完成状态),配合每 Call FIFO 就绪队列,已完成的父 A、C 立即继续推进而无需等待 B。
一张图同时讲清了问题的长尾本质、现有扁平系统为何互相耦合、以及 RayOrch 的解法直觉,是全文的路线图。