凝视作为共同基础确立的证据:MapTask 与 MUNDEX 跨语料库分析 Gaze as Evidence for Common Grounding: A Cross-Corpus Analysis of MapTask and MUNDEX
将两个对话语料库的注视标注统一映射,发现注视模式与共识建立方向性一致但效应小
前置知识
共同基础(Common Ground)
语用学核心概念:对话双方在交互中不断积累并维护的相互知识集合。Clark 的 grounding 理论认为,双方不能默认理解已达成,而要通过持续互动(确认、修正、点头、注视等证据)逐步确立彼此的理解。注视行为正是这种证据之一:看向任务材料、看向对方或移开视线,都可能传递理解状态的信息。
本文的全部问题就是:注视能否作为共同基础确立过程的可观测证据,这是理解研究设计与结论的前提。
HCRC MapTask 语料库与透视主义标签
1991 年发布的英语对话语料库:giver 持完整地图,引导 follower 在缺口地图上画路线,双方信息不对称。语料含视频编码的注视标注(up/down/off 三类)与地标指称标注。本文使用其中 46 段双人注视齐全的对话(31 段有眼神接触 ec、15 段无 nc),并采用 Li et al. (2026a) 的透视主义标注——指称表达式只有在说话者与听者都解析到同一地标时才算“对齐(aligned)”。
它是两个分析对象之一,其 aligned/pending 标签定义直接决定了窗口级检验的正负类划分。
Mann–Whitney U 检验与秩双列相关
一种非参数检验:不假设正态分布,把两组样本混合后按秩次比较,检验两组分布是否系统偏移。效应量用秩双列相关 $r$ 表示,取值 −1 到 1,反映正类窗口特征值整体高于或低于负类的程度。本文对每个特征做此检验,并用 Benjamini–Hochberg 方法校正多重比较得到 $q$ 值。
论文核心表格(Table 1)的 $\Delta$、$r$、$q$ 全部来自这套检验,不熟悉它就看不懂效应的方向和大小。
聚类稳健 GEE
广义估计方程:在逻辑回归框架下对重复测量数据建模,通过指定聚类结构(如同一对话、同一被试组)修正标准误,处理窗口之间的非独立性问题。本文分别用对话聚类和被试组聚类做敏感性分析,并使用偏差缩减(bias-reduced)标准误,因为被试在多段对话中重复出现。
这是判断“哪些关联在被试重复出现后仍然显著”的关键证据,直接决定结论的稳健性。
持续时间加权香农熵
把每个窗口内三个注视类别的时长占比 $q_k$ 代入 $H = -\sum_k q_k \log_2 q_k$ 得到的离散度指标:注视均匀散布在多个目标上时熵高,长时间锁定单一目标时熵低。本文用它刻画注视的“游移程度”,作为理解/协调状态的候选特征。
熵是全文最强的链内发现(对齐瞬间说话者熵显著下降),也是预测模型结构特征组的核心成员。
研究动机
在信息不对称的合作对话中(MapTask 里 giver 引导 follower 画路线、MUNDEX 里 explainer 教 explainee 玩桌游),双方无法默认彼此理解一致,必须通过持续互动确立共同基础。注视是这一过程的可观测线索:已有研究(Boyle et al. 1994 发现地图差异地标上 follower 更常抬头看 partner;Nakano et al. 2003 发现注视模式随对话行为变化)都局限于单一语料库内。问题在于:各语料库用自有的视频注视标注体系(MapTask 的 up/down/off、MUNDEX 的 EX/EE/TABLE/AWAY),类别名和任务语境都不同,导致“注视与理解状态的关系”这一结论无法跨任务比较;而眼动追踪坐标虽然精细但采集昂贵,绝大多数现成语料只有廉价的视频行为类别标注,此前缺乏一个把它们统一起来的表示。
本文的目标是本文要回答三个递进问题:(1) 能否把 MapTask 和 MUNDEX 两套异构注视标注映射进一个共享的 partner/task/away 词汇表,使跨语料库比较成为可能?(2) 在这个统一表示下,“指称对齐”(MapTask)与“理解判断”(MUNDEX)两种不同的 grounding 度量是否与注视特征呈现方向一致的联系——即对齐/理解时更多任务注视、更少 partner 注视、更低熵和更少转移?(3) 这些特征在按对话/解释者分组的交叉验证下是否携带可泛化的预测信号?以及在同一说话者的指称链上,指称从未对齐变为对齐的瞬间注视是否发生系统变化?
与已有工作不同的是,本文的独特切入有三点。第一,不追求眼动坐标的精细度,而是把“视频编码的离散行为类别”作为一等公民,设计共享词汇表让廉价易得的现成标注可以跨语料复用——这直接扩大了可分析语料的范围。第二,利用 MapTask 的透视主义标注(说话者和听者各自的地标解析分别记录,二者一致才算 aligned),把注视对齐到“双方视角达成一致的时刻”,而非仅说话者单方面的指称行为,这是以往 MapTask 注视研究没有的 grounding 度量。第三,显式地把“谁在主导任务”纳入分析:分层检验 giver 与 follower、explainer 判断与 explainee 自评,发现关联集中在任务主导者身上,这一角色视角此前未被系统检验。
核心方法
直觉上,论文把“两个人协作时眼睛往哪看”变成一组可计算的数字,再问这些数字能不能区分“双方理解一致”和“理解未定”的时刻。技术路线分四步:(1) 表示统一——把 MapTask 的 up/down/off 和 MUNDEX 的 EX/EE/TABLE/AWAY 都映射为 partner/task/away,丢弃非正时长事件、消解时间重叠,按指称窗口或判断时刻切窗并施加 30% 注视覆盖率过滤,得到 MapTask 5,144 个指称窗口与 MUNDEX 807 个判断窗口;(2) 特征工程——从每个窗口算出六组特征:原始比例(7/8 维)、结构组(覆盖率+转移数+熵,13/14 维)、时间动态(21 维/人)、转移二元组(6 维/人)、协调组(6 维联合特征)和派生比值(9 维);(3) 关联检验——Mann–Whitney U + 秩双列 $r$ + BH 校正 + 聚类稳健 GEE;(4) 预测与链分析——逻辑回归分组交叉验证做特征组消融,另做说话者内部“未对齐→对齐”的配对比较。
核心创新是“共享离散词汇表 + 透视主义对齐标签”的组合。与已有工作的本质区别在于:过去的注视-grounding 研究(Boyle 1994、Nakano 2003、Wang 2026 等)都在单一语料库内定义和使用自家标注,结论无法迁移;本文把两套本体映射到一个词汇表,第一次让“任务注视多=理解对齐”这类断言可以跨任务、跨语言(英语/德语)、跨 grounding 度量(指称对齐 vs 理解判断)检验收敛性。其次,MapTask 侧用透视主义标签把 aligned 定义为说话者与听者解析到同一地标,注视窗口因此对齐到“双方达成一致的时刻”。第三,结论姿态克制:效应小且依赖推断单元,论文因此把注视定位为“参与协调的线索之一”,应与语言内容和任务状态共同建模,而不是单独的强证据。
方法步骤详情
步骤一:数据准备。MapTask 取双人注视标注齐全的 46 段对话(31 ec、15 nc),按对话、角色、地标匹配透视主义标签,过滤覆盖率低于 30% 的窗口,得到 5,144 个指称窗口(3,807 aligned、1,261 pending、76 misunderstood)。MUNDEX 取 26 次双人互动,EX 判断与 EE 自评各为独立观察,过滤后剩 807 窗口(360 UND、199 PART_UND、151 NON_UND、97 MISUND)。步骤二:特征计算。每窗口输出原始比例、结构组(覆盖率、转移数、熵 $H=-\sum_k q_k\log_2 q_k$)、时间动态(注视段数、切换率、首/主/末标签等 21 维/人)、转移二元组(如 task→partner 比例)、协调组(约 10Hz 联合采样的共同注视、互补注视等)和派生比值(partner/task 比、engagement 等),共约 60 维。步骤三:统计检验。二分类对比用 Mann–Whitney U 与秩双列 $r$(BH 校正得 $q$),稳健性用对话聚类和被试组聚类的 GEE。步骤四:链内分析。在同一对话同一地标的指称链上,配对比较说话者“最后一次未对齐提及”与“其后首次对齐提及”的注视(189 对,45 对话),用配对 Wilcoxon、BH 校正和对话聚类 bootstrap 置信区间。步骤五:预测。标准化特征+平衡类权重的逻辑回归,MapTask 按对话 10 折、MUNDEX 按解释者 5 折分组交叉验证,逐组消融,另跑 30 次重洗分区评估增益稳定性。
技术新颖性
新颖性体现在三个层面。表示层:共享 partner/task/away 词汇表是一个可复用的“接口”,任何带视频编码注视标注的语料都能接入,作者明确把它定位为可推广的基础设施而非一次性处理,这比提出某个单一模型更有长期价值。证据层:首次在两个异构 grounding 度量(参考对齐 vs 理解四分评级)上展示方向性收敛,并用角色分层把效应定位到任务主导者(giver 六个特征显著,最大 $|r|$ 为 .086;follower 接近零,最大 $|r|$ 为 .043),比笼统的“注视与理解相关”更精细。方法层:链内配对分析捕捉到对齐时刻说话者熵显著下降($dz=-.20$,$q=.044$),并透明报告推断单元敏感性(对话级聚合后 $q=.20$)与预测增益的分区依赖性,这种诚实的统计实践在同类语用学实证工作中少见。
实验结果
关联方向在两库完全一致:正类(MapTask 对齐、MUNDEX 理解)窗口任务注视更高、partner 注视更低,熵和转移数偏向负类。MapTask 四大效应:说话者任务注视 $\Delta=.033, r=.058$、partner 注视 $\Delta=-.029$、熵 $\Delta=-.046$、转移数 $\Delta=-.091$,Mann–Whitney 全部 $p<.001$;对话聚类 GEE 下任务/partner 注视失守($q=.091$),熵和转移存活。MUNDEX 效应更大:EX 任务注视 $\Delta=.105, r=.181$(GEE 后 $q=.001$)、EX partner 注视 $r=-.172$($q=.028$)、EE 熵/转移 $q=.039$。角色分层:giver 指称中六个特征显著(最大 $|r|=.086$),follower 近零($|r|=.043$);EX 判断最大 $|r|=.206$ 高于 EE 自评 .151。眼神接触层效应全面更强(最大 .078),nc 层无一显著。链分析:对齐率从首次提及 .30 升至二次 .59、四次及以上 .85;189 对同说话者配对中说话者熵显著下降($dz=-.20, q=.044$),但对话级聚合后不显著($q=.20$)且集中在六个被试组中的两个。预测:MapTask 最优 macro-F1 .532(结构+时间组,超控制组 .472 达 .060),MUNDEX 最优 .564(原始比例组,超控制组 .544 仅 .020;多数类基线 .425/.356);30 次重洗分区中两组各 27 次最优,但 MapTask 增益在 .015–.070 间波动。
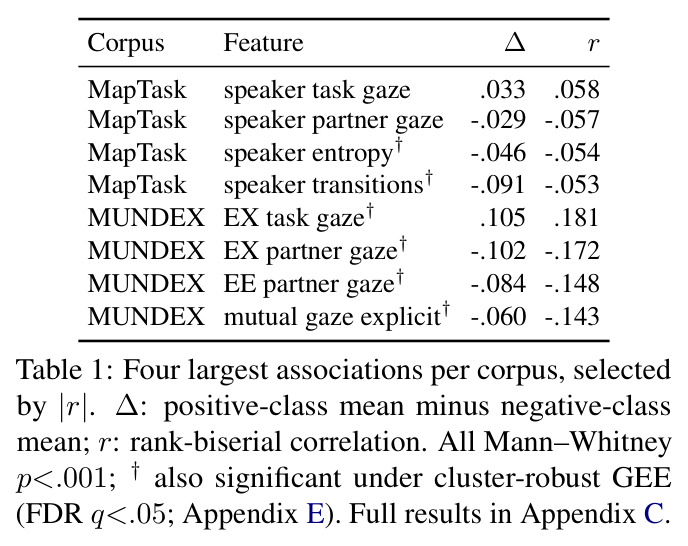
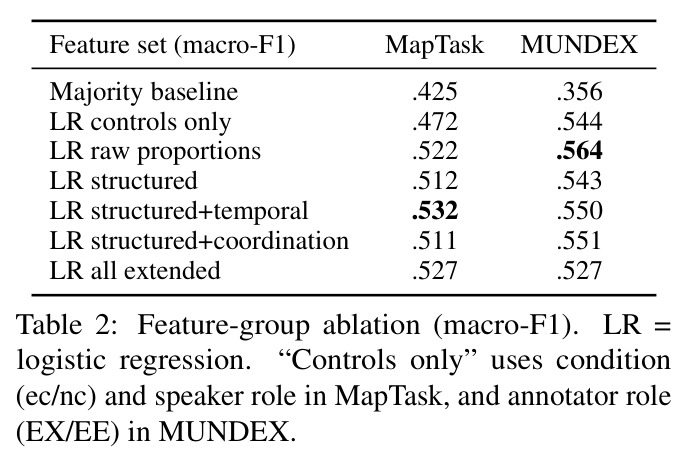
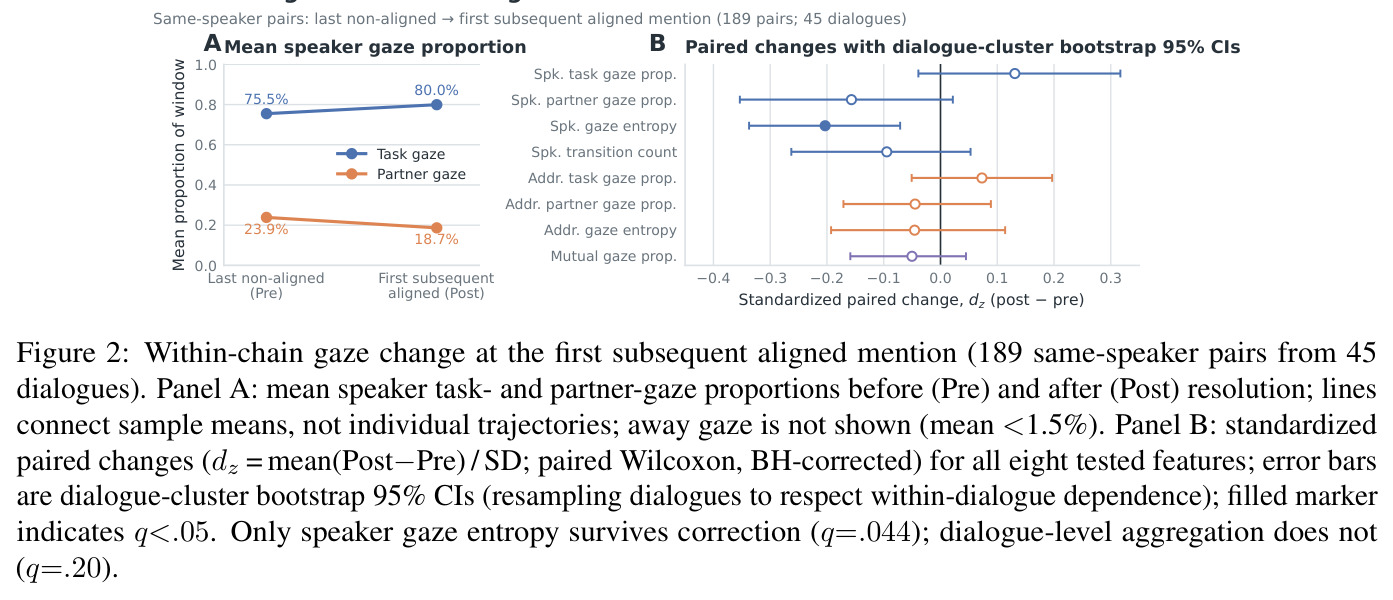
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MapTask 指称对齐预测(aligned vs 非对齐,按对话分组 10 折交叉验证) | macro-F1 | .532(结构+时间动态特征组,30 次重洗中 27 次为最优组) | 多数类 .425;仅控制特征(条件 ec/nc+角色).472 | 较控制组 +.060(分区波动 .015–.070,均值 .038) |
| MUNDEX 理解判断预测(UND vs 非理解,按解释者分组 5 折交叉验证) | macro-F1 | .564(原始比例特征组,29/30 分区增益为正) | 多数类 .356;仅控制特征(注释者角色 EX/EE).544 | 较控制组 +.020(最大 .027);结构组 .543 未超角色控制 .544 |
| 窗口级关联检验(MUNDEX EX 任务注视 × UND 判断) | 秩双列相关 $r$ | .181(最强单特征关联,$\Delta=.105$,GEE 后 $q=.001$) | MapTask 同类最强特征 $r=.058$(GEE 后 $q=.091$) | 效应约为 MapTask 的 3 倍,且经被试组聚类后仍显著 |
局限与改进
作者承认的局限很密集:效应量小(汇总最大 $|r|$ 为 .058/.181);被试重复出现——MapTask 24 名被试构成六个通过共享成员相连的小组,9 个解释者中 8 人出现在三次互动里,以组/解释者为 GEE 聚类后 MapTask 无特征存活,链内熵下降集中在两个组;预测增益依赖分区(MapTask .015–.070);三个注视类别无法指明看的是哪个具体地标,共享类别名不等于跨任务功能等价(MUNDEX 中移开视线还与话题转换相关);up→partner 映射只在有眼神接触时字面成立;MUNDEX 混合自评与他评,807 行中 271 行来自重建的双视角链接、135 个完整配对中 44 个标签不一致;覆盖率过滤不均衡(两个解释者占了 149 个被排除窗口中的 139 个);仅覆盖英语/德语两种面对面的不对称任务。我补充一点:预测模型完全没有语言特征(词汇熵、对话行为、任务状态),无法回答“注视在语言信号之外还有多少增量”,而这恰是“值得共同建模”这一结论的关键前提;因果方向也未检验——注视变化可能是理解的结果而非证据。
独立分析的弱点
第一,无语言基线对照:模型只比较“控制组(条件+角色)”与“控制+注视”,若加入词频、词汇熵或对话行为特征,注视增益可能进一步缩水;改进方向是做层级消融(语言基线→+注视→+交互项),直接检验注视的增量贡献。第二,MUNDEX 的结构组 .543 未超过纯角色控制 .544,说明该语料库的预测信号可能被角色变量吸收;改进方向是 EX/EE 分层建模或带被试随机效应的混合效应模型。第三,二值化丢弃了 PART_UND 等有序信息,四分评级本可用序数逻辑回归保留更多监督信号。第四,窗口以指称表达式为中心,但注视可能先于言语(Hanna & Brennan 2007 显示注视先于消歧点);改用提前/滞后时间窗或逐时间点分析能捕捉时间结构。第五,纯观测设计无法确立因果:可在具身或虚拟代理环境中操纵对方注视做干预实验,或用时序先行检验区分“注视引导理解”与“理解引导注视”。第六,两库仅有 46+26 个交互单元、被试高度重叠,统计功效天然受限,收集新被试或跨语料库合并推断才是根治之道。
未来方向
作者提出的方向:把共享 partner/task/away 表示应用到更多带视频注视标注的语料库,降低跨语料比较的搭建成本;将注视与词汇内容、对话行为、任务状态共同建模并检验更细粒度的指称对象与对话行为,以区分任务一般模式与任务特异行为;检验特征×角色交互(目前 MapTask $q=.064$ 未过校正);在其它任务结构(非面对面对称任务、具身协作)和其它多模态预测源上复测。基于成果可延伸的方向:把这套注视特征作为评估视觉-语言模型共同基础追踪能力的探针(呼应 Li et al. 2026b 的 VLM 评测);在实时对话系统中把低熵/高任务注视用作“理解顺畅”的在线信号来触发澄清请求;与少量眼动追踪子集对齐以校准类别标注的可靠性;用多任务层次贝叶斯模型合并两库做部分池化估计,缓解小组结构带来的功效不足。
复现评估
复现条件非常好。数据全部公开:MapTask 的注视、时序与地标指称标注来自 NXT 2.1 版(CC BY 4.0),透视主义标签来自 GMMT 数据集(CC BY 4.0),MUNDEX 标注在 Zenodo v0.7(CC BY 4.0);作者还公开了处理好的注视特征表和全部分析代码。无需任何 GPU——全部模型是标准化特征的逻辑回归与非参数检验,普通笔记本分钟级可跑完。主要难点不在算力而在细节:窗口切分、覆盖率过滤、重叠消解的具体规则在附录 A,特征定义在附录 B,需仔细对照实现;MUNDEX 音视频未发布,无法从头复现其标注,只能用现成标注;GEE 与偏差缩减标准误依赖特定统计实现,需注意版本。总体复现难度低,适合作为多模态对话统计分析的入门练手项目。
论文图表
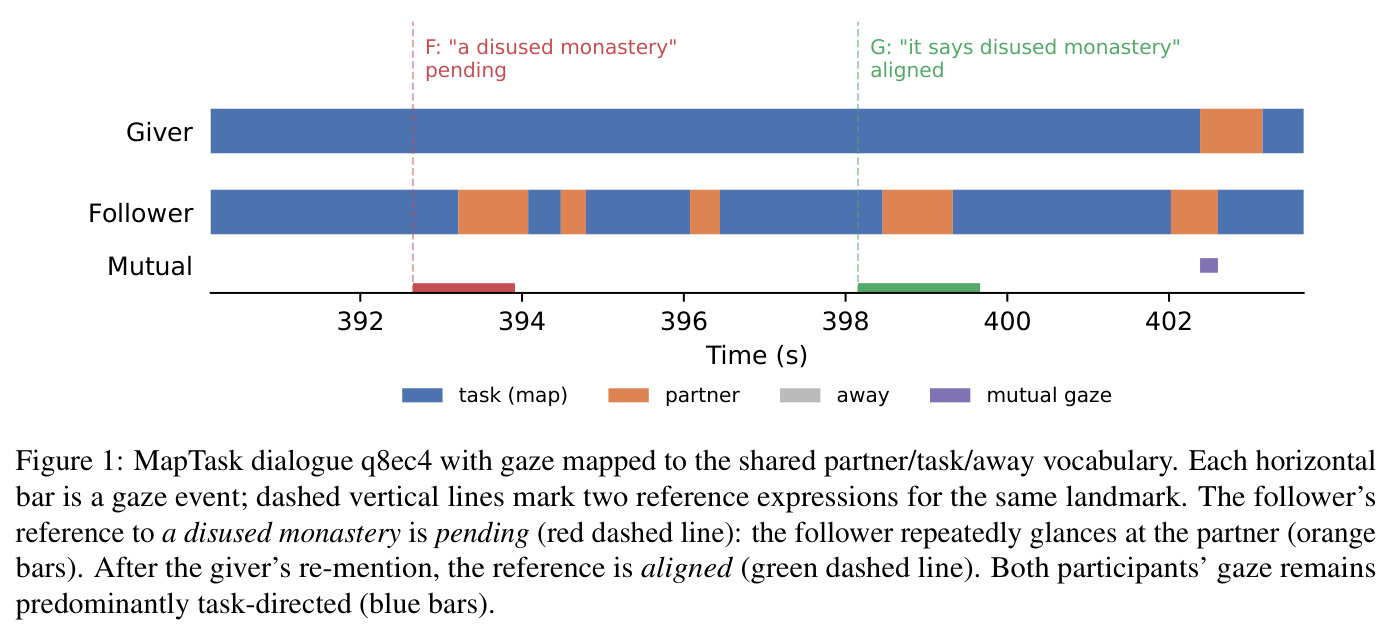
展示一段真实 MapTask 对话(q8ec4)的双人注视时间线:每条水平条是一个注视事件,蓝色为任务(地图)注视、橙色为 partner 注视,另有绿色互视;两条虚线竖线标记对同一地标“disused monastery”的两次指称。follower 首次提及时处于 pending 状态并反复瞥向 partner(橙色条),giver 重提后指称变为 aligned,双方注视都以任务为主。
这是理解共享 partner/task/away 词汇表和 aligned/pending 标签如何落到真实对话上的最快入口,把方法的核心表示与“注视围绕未对齐指称更偏向 partner”的直觉具象化,是全文的封面级示例。