EventEgoHands++:基于真实数据集的事件相机第一人称3D手部网格重建 EventEgoHands++: Event-based Egocentric 3D Hand Mesh Reconstruction with Real Dataset
实例级手部检测+可见性自适应注意力,首次在真实事件数据上实现第一人称双手3D网格重建
前置知识
事件相机(Event Camera)
一种仿生异步传感器,每个像素独立监测亮度变化,只有变化超过阈值时才输出事件 $(x, y, t, p)$,其中 $p$ 是正/负极性。它具有微秒级时间分辨率、约120dB的高动态范围和低功耗特性,静止场景不产生数据,因此天然适合高速运动与极端光照环境。
本文的输入不是RGB图像而是事件流,整套方法(LNES表示、背景事件抑制、检测器输入适配)都围绕如何从稀疏异步事件中分离手部信号展开;理解事件相机的"只感知变化"特性也是理解其失败案例(手静止时漏检)的关键。
MANO 参数化手部模型
业界标准的可微分统计手部模型,把手部网格编码为低维参数:姿态向量 $\theta \in \mathbb{R}^{45}$(15个关节各3个轴角)、形状向量 $\beta \in \mathbb{R}^{10}$(PCA系数),配合全局平移 $t \in \mathbb{R}^3$ 和旋转 $R \in \mathbb{R}^3$,即可解码出778个网格顶点 $V \in \mathbb{R}^{778 \times 3}$ 和20个关节 $J \in \mathbb{R}^{20 \times 3}$。
本文网络的最终输出就是左右手的MANO参数,训练损失中的 $\mathcal{L}_{MANO}$ 直接监督这些参数,评估指标MPVPE也基于其解码出的网格顶点计算;不熟悉MANO就无法理解模型输出与监督信号的设计。
第一人称(Egocentric)视觉
相机佩戴在穿戴者头部(眼镜、头显等),视角随头部运动而变化。相比固定第三人称机位,它提供跟随人体移动的灵活性,是AR/VR和人机交互的自然形态;代价是头部运动导致全场景运动模糊或(事件相机下)全屏背景事件,且手部频繁进出视野、可见性不断变化。
"手可能只有一只在视野内甚至都不在"是本文方法设计的直接动因:前作无法区分左右手、总输出两只手的问题,正是egocentric场景的典型痛点,理解这一场景特性才能理解Adaptive Attention的动机。
LNES 事件表示
Locally-Normalized Event Surfaces(EventHands提出),将一段时间窗口内的事件累积为2通道(正/负极性各一通道)的伪图像,并对每张事件图做局部时间归一化加权,从而在压缩为单帧的同时保留事件之间的相对时间顺序信息。
本文以LNES把原始事件流转为 $I \in \mathbb{R}^{2 \times H \times W}$ 的事件帧,作为Hand Detector和重建网络的统一输入格式;论文选择它的理由是时间加权能保留时序信息,这直接影响重建质量。
Self-Attention 与 Cross-Attention
Transformer的核心操作。Self-attention让同一特征图内的所有空间位置互相聚合信息,用于建模单只手内部的空间关系;Cross-attention则用一只手的特征图作为query、另一只手的作为key和value,实现双手之间的双向信息交换,用于学习双手相对位置和协作姿态(如指尖相对、传递物体)。
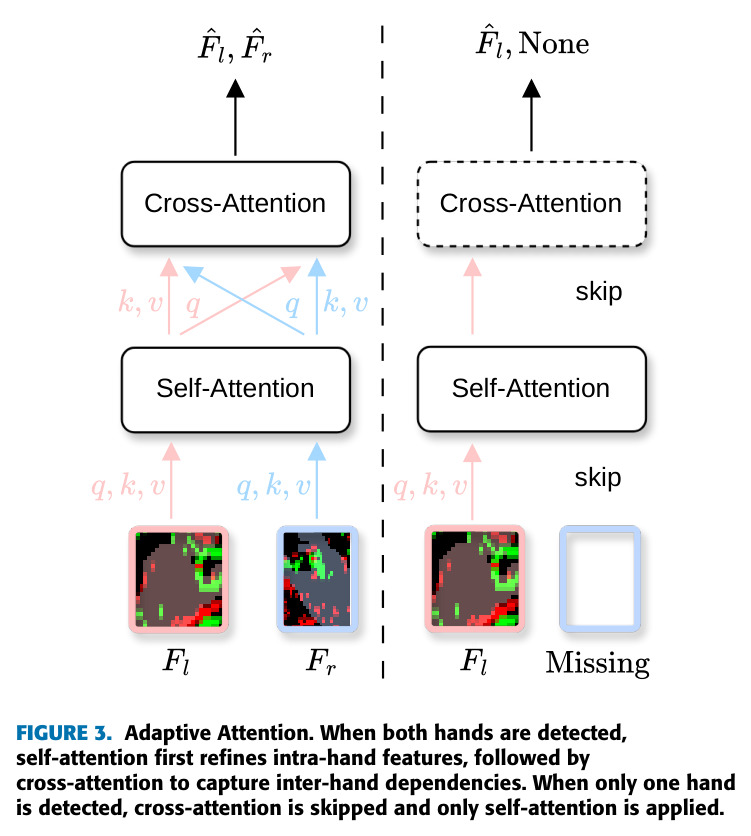
本文的核心创新Adaptive Attention本质上就是按检测结果动态"开关"这两种操作:双手可见时先self后cross,单手时只self,无手时全部跳过,理解这两种注意力是看懂公式 (1)-(4) 的前提。
MPJPE / MPVPE 与 PCK-AUC 指标
MPJPE(Mean Per Joint Position Error)与MPVPE(Mean Per Vertex Position Error)分别计算预测关节/网格顶点与真值的平均3D欧氏距离(毫米),本文计算前先做腕部对齐以消除全局平移影响。PCK/AUC则在0-100mm阈值范围内统计关键点正确百分比曲线下面积,R-AUC与RR-AUC分别以各自手腕、右腕为参考衡量单手姿态与双手相对构型。
论文全部定量结论都用这套指标表达,且R-AUC与RR-AUC的分工(单手精度vs双手相对位置)恰好对应两个组件各自的贡献,看懂指标才能读懂消融实验的设计逻辑。
研究动机
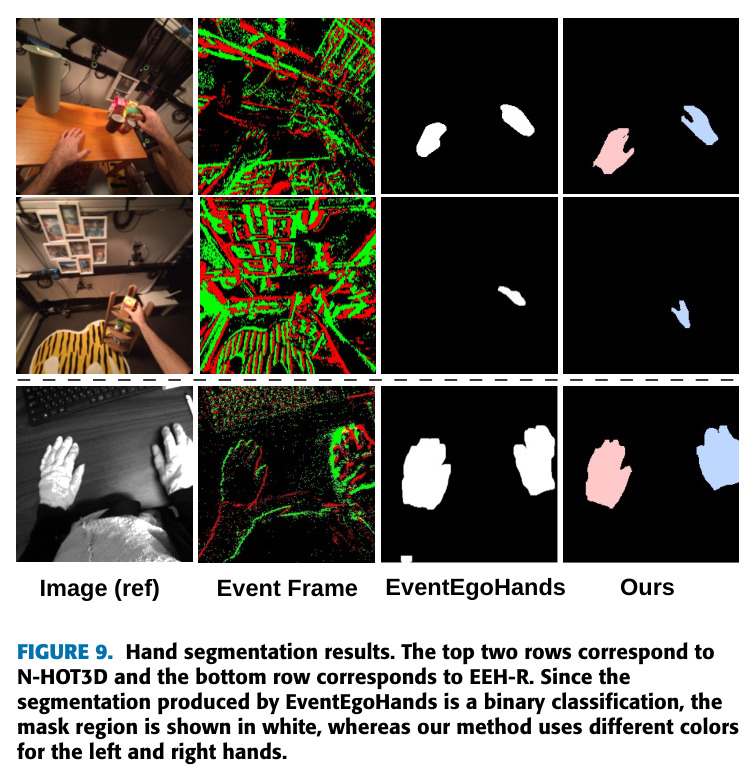
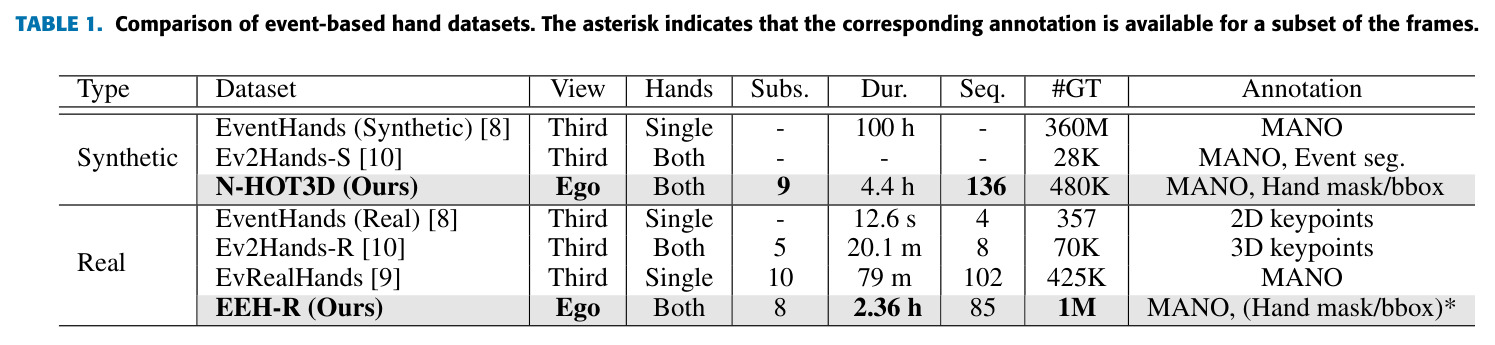
基于RGB/深度相机的第一人称手部重建在两类场景系统性失效:穿戴者头部快速运动带来的运动模糊,以及低光照环境。事件相机以高动态范围和高时间分辨率解决了感知层问题,但在第一人称设定下引入了新难题——穿戴者自身运动使整个视野的亮度变化都产生事件,海量背景事件淹没手部信号。作者的前作EventEgoHands(ICIP 2025)用二值手部分割滤除背景事件,首次证明了该任务可行,但遗留三个根本缺陷:其一,二值mask无法区分左右手,模型无论实际有几只手在视野内都强制重建两只手,在egocentric视频中手频繁离开视野的情况下产生无效输出,并破坏双手相对位置估计;其二,其交叉注意力无条件地在两个手分支间执行,即使某只手根本不存在也强制进行特征交换,这种固定的注意力通路无法适应持续变化的手部可见性;其三,全部实验仅在合成事件数据上进行,而真实传感器的事件密度、时间分布与噪声特性与仿真差异显著,尤其是低光场景——恰恰是采用事件相机的核心动机——在真实数据上的效果从未被验证,因为此前不存在任何真实的第一人称事件手部数据集(Table 1显示现有真实数据集EventHands-Real仅12.6秒、Ev2Hands-R为20分钟、EvRealHands为79分钟,且全部是第三人称固定机位)。
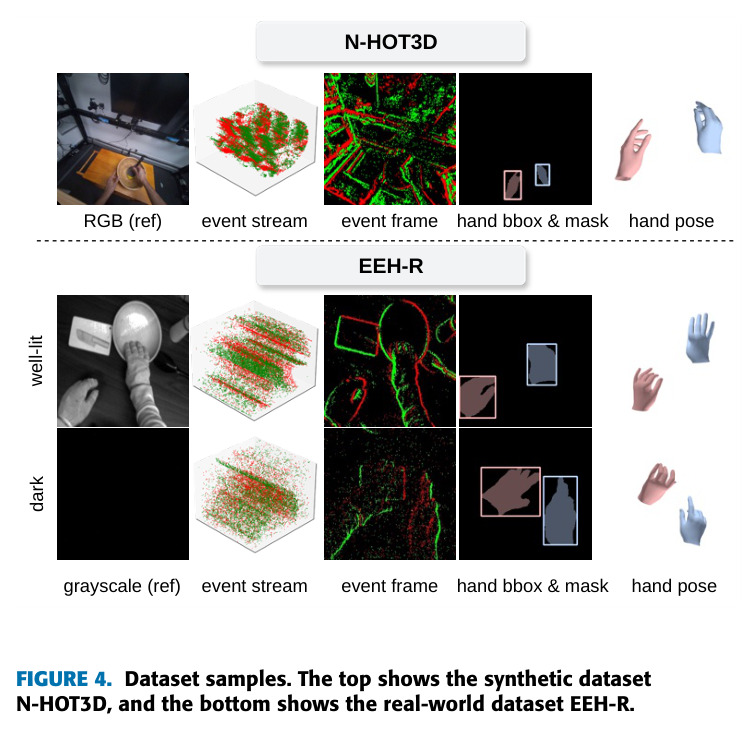
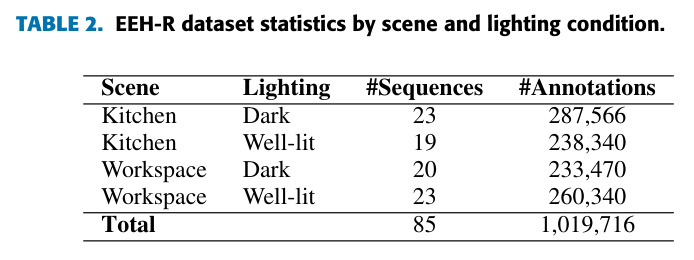
本文的目标是本文的目标是构建一个仅依赖事件数据、能显式处理手部可见性与左右手身份的第一人称3D手部网格重建框架,并首次在真实事件数据上完成验证。目标可拆解为四点:第一,在提取阶段引入实例级Hand Detector,同时预测左右手的边界框和分割mask,确保每只手只在真实出现时才被定位和识别,从源头解决"无中生有"的幻影手问题;第二,在重建阶段设计Adaptive Attention,根据检测结果得到的可见性指示器动态决定self-attention与cross-attention是否执行,只在双手确实可见时才学习手间交互,单手时独立重建,无手时直接跳过;第三,在数据层面双线并进:将合成数据集N-HOT3D扩展至约48万标注帧(精修分割mask、新增边界框标注、明确划分协议),并新构建首个也是最大的真实世界事件第一人称手部数据集EEH-R,包含约100万标注帧、2.36小时录制,覆盖明亮(平均457 lux)与黑暗(平均3.5 lux)两种光照及厨房、工作台两类场景;第四,在两个数据集上与EventHands、Ev2Hands、EventEgoHands等基线全面对比,并通过消融实验逐一验证各组件的贡献。
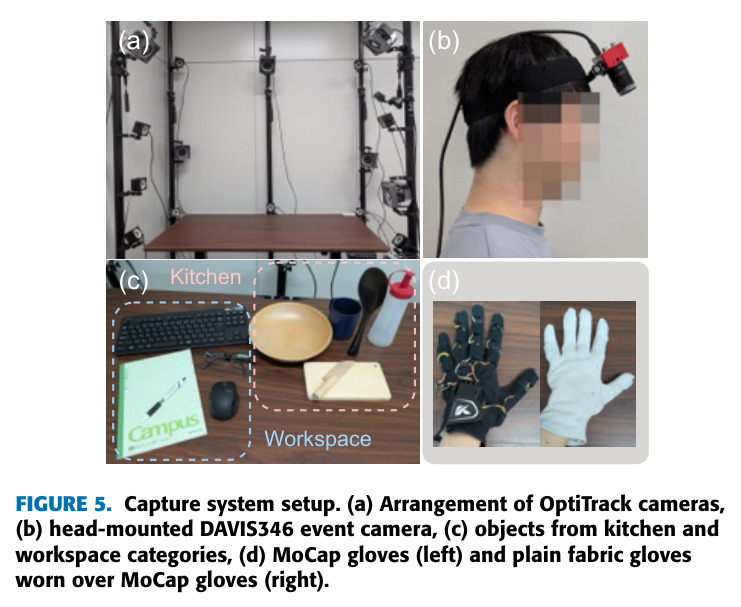
与已有工作不同的是,本文的独特切入角度有三层。方法论上,与前作"先粗分割、再无条件交互"的管线不同,本文把"手是否可见"提升为一等控制信号:检测器输出的置信度直接决定注意力操作本身是否执行,而不是在注意力内部对缺失手做掩码。作者明确对比了masked attention替代方案——对不存在的手mask所有token后注意力计算仍会执行,其输出会污染已检测手的特征,还白白消耗算力;而Adaptive Attention从计算图层面完全跳过不存在的手,一举解决特征破坏与冗余计算两个问题。数据层面,此前所有真实事件手部数据集均为第三人称固定机位且规模有限(Table 1),EEH-R以头戴DAVIS346相机+IMU动捕手套+OptiTrack的采集方案,首次提供含黑暗条件的第一人称双手真值,直接填补了benchmark空白。实验洞察层面,作者用Fig 6系统性揭示了合成与真实数据的域差:N-HOT3D每帧事件数远多于EEH-R,且事件在帧内时间分布集中在开头而非均匀分布,这为社区理解"仿真事件为什么不能直接迁移"提供了具体证据,也为后续sim-to-real研究树立了分析范式。
核心方法
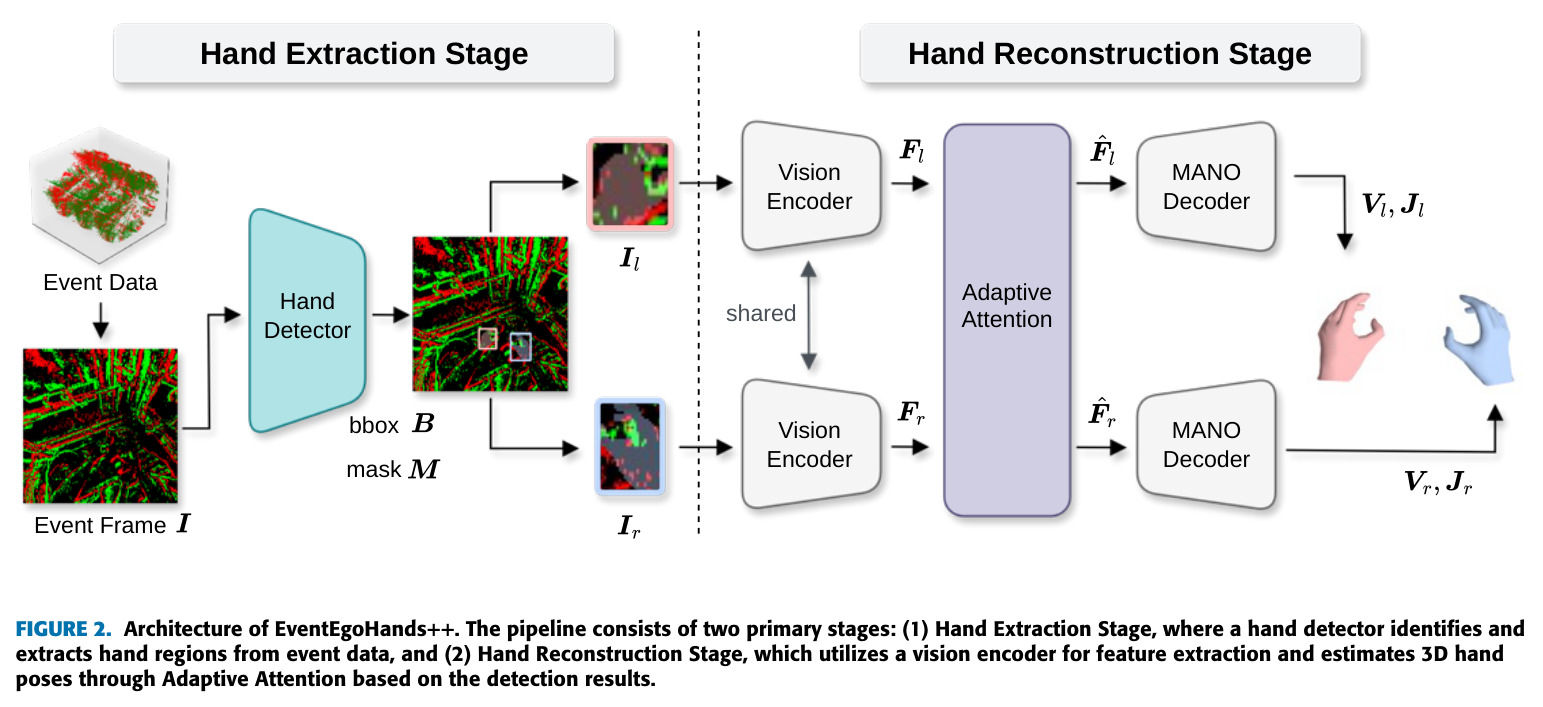
方法直觉:戴在头上的事件相机里,背景因头部运动持续产生事件噪声,手部只是其中一小撮信号;而任意时刻手可能一只在、两只在、或都不在。因此正确的流程是先"找到并认出手"(在哪、是左手还是右手、是否可信),把每只手区域的事件单独抠出来,再"各修各的、必要时互通信息"地重建3D网格。技术上分为两阶段:手部提取阶段以LNES事件帧 $I \in \mathbb{R}^{2 \times H \times W}$ 为输入,用基于YOLO26的Hand Detector输出实例级边界框 $B=\{b_i\}_{i=1}^{N}$($b_i=(x_i, y_i, w_i, h_i) \in \mathbb{R}^4$)和掩码 $M \in \mathbb{R}^{N \times H \times W}$,按左右手标签选出 $M^l$、$M^r$,经 $7 \times 7$ 核膨胀后与事件帧逐元素相乘得到 $I^l, I^r \in \mathbb{R}^{2 \times H \times W}$;手部重建阶段用共享权重的EfficientNetV2-S编码器分别提取特征图 $F^l, F^r$($1280 \times 7 \times 7$),经Adaptive Attention按可见性指示器 $m_l, m_r \in \{0,1\}$ 选择self/cross attention组合进行精炼,再经注意力池化和线性层回归MANO参数,由MANO模型解码出20个关节位置与778个顶点。整个系统用四项加权损失端到端训练,检测器与重建网络分别训练,全部实验在单卡RTX 6000 Ada上完成,整体推理速度达39.87 FPS(双手)。
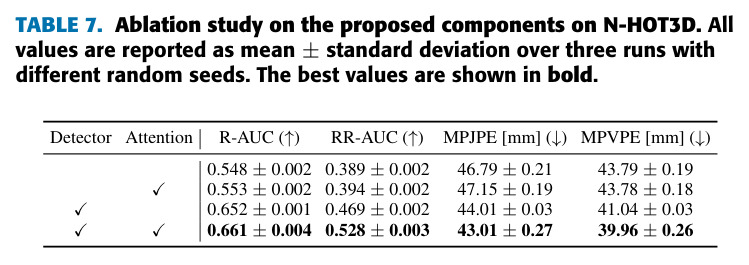
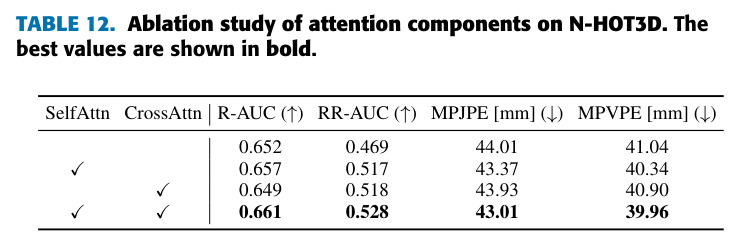
核心创新是Adaptive Attention:用检测置信度作为显式控制信号,动态切换注意力操作本身而非在注意力内部做掩码。设 $m_l, m_r \in \{0,1\}$ 为左右手可见性指示,三种条件下行为不同:双手可见($m_l=m_r=1$)时先各自做self-attention精炼手内特征 $\bar{F}^h = \text{SelfAttn}_h(F^h)$,再做双向交叉注意力 $\hat{F}^l = \text{CrossAttn}(\bar{F}^l, \bar{F}^r)$、$\hat{F}^r = \text{CrossAttn}(\bar{F}^r, \bar{F}^l)$ 学习相对位置与协作;单手可见($m_l+m_r=1$)时完全跳过cross-attention,仅对检测到的手做self-attention;双手均不可见时跳过后续全部处理。与masked attention的本质区别在于:后者即使mask掉缺失手的全部token,注意力计算依然执行,其输出会破坏已检测手的特征且浪费算力;前者从计算图层面跳过不存在的手。第二个关键创新是把实例分割框架(YOLO26联合预测bbox与mask)引入事件手部提取,替代前作的U-Net二值mask估计——作者指出mask-only预测不稳定,联合学习bbox使定位更鲁棒,且天然给出左右手身份。消融(Table 7)证明两者互补分工:Hand Detector主导整体精度(R-AUC 0.548提升至0.652),Adaptive Attention主导双手相对位置(RR-AUC 0.469提升至0.528,相对提升12.6%)。
方法步骤详情
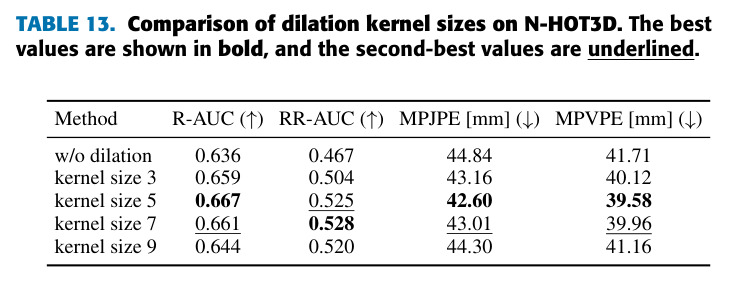
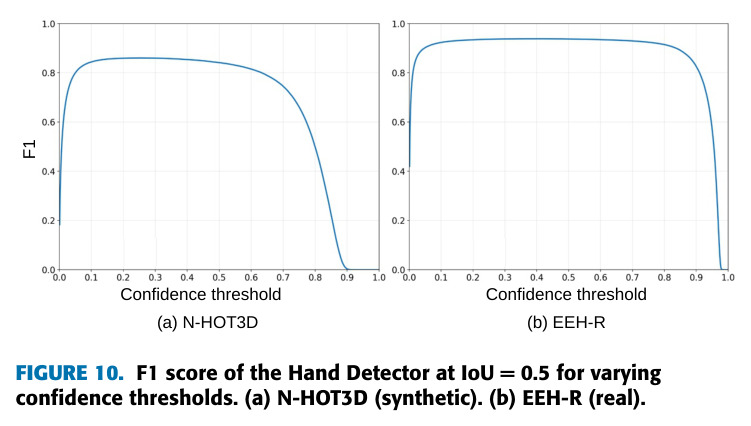
完整流程分七步。第一步,原始事件流经LNES表示转为2通道事件帧 $I \in \mathbb{R}^{2 \times H \times W}$,中心裁剪并缩放至 $224 \times 224$。第二步,Hand Detector(YOLO26,加载预训练权重并把输入通道适配为LNES两通道)输出各实例的bbox、mask、左右手标签 $c$ 与置信度 $s$;同一只手出现多次检测时取最高置信度;置信度阈值N-HOT3D设0.5、EEH-R设0.8,据此得到可见性指示器 $m_l, m_r$。第三步,用左右手各自的mask(经 $7 \times 7$ 核一次膨胀以补偿分割残缺)从事件帧中提取手区事件 $I^h = I \odot M^h$。第四步,共享EfficientNetV2-S编码器(ImageNet-1K预训练,20.2M参数)分别编码出 $1280 \times 7 \times 7$ 的特征图 $F^l, F^r$。第五步执行Adaptive Attention:$m_l=m_r=1$ 时先 $\bar{F}^h=\text{SelfAttn}(F^h)$ 再双向交叉注意力交换手间信息;$m_l+m_r=1$ 时仅对可见手做self-attention;$m_l=m_r=0$ 时跳过该样本。第六步,精炼特征经注意力池化得到特征向量,由线性层映射到MANO参数空间($\theta \in \mathbb{R}^{45}$、$\beta \in \mathbb{R}^{10}$、$t \in \mathbb{R}^3$、$R \in \mathbb{R}^3$),MANO模型解码出 $J \in \mathbb{R}^{20 \times 3}$ 与 $V \in \mathbb{R}^{778 \times 3}$。第七步训练:总损失 $\mathcal{L}_{hand} = \lambda_\gamma \mathcal{L}_{joints} + \lambda_\delta \mathcal{L}_{interhand} + \lambda_\epsilon \mathcal{L}_{vertices} + \lambda_\zeta \mathcal{L}_{MANO}$,其中 $\mathcal{L}_{joints} = \frac{1}{N_J}\sum_i \|\hat{J}_i - J_i\|_1$,$\mathcal{L}_{interhand} = \frac{1}{N_J}\sum_i \| (\hat{J}^{left}_i - \hat{J}^{right}_i) - (J^{left}_i - J^{right}_i) \|_2$,$\mathcal{L}_{vertices} = \frac{1}{N_V}\sum_i \|\hat{V}_i - V_i\|_1$,$\mathcal{L}_{MANO} = \|\hat{\theta} - \theta\|_2 + \|\hat{\beta} - \beta\|_2$;权重 $\lambda_\gamma=2.0, \lambda_\delta=1.0, \lambda_\epsilon=2.0, \lambda_\zeta=1.0$;重建网络用AdamW(学习率 $2.0\times10^{-5}$,30 epochs,batch 32),检测器用Adam(学习率 $1.0\times10^{-3}$,100 epochs,batch 64)。
技术新颖性
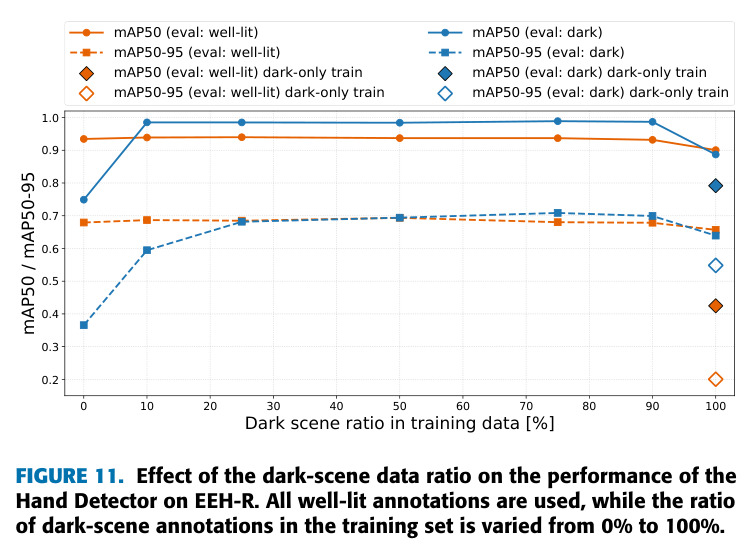
新颖性体现在四个层面。第一,这是首个显式建模"手可见性+左右手身份"的事件第一人称重建框架:第三人称方法(EventHands、EvRealHands)假设手始终在场,前作用二值mask回避了实例区分,本文把检测置信度变成注意力调度的控制信号,这在事件手部重建领域是新的设计模式。第二,Adaptive Attention的"操作切换"而非"分数掩码"实现上很轻量,但有明确的理论动机(避免特征污染与冗余计算),且消融显示其收益集中在RR-AUC、与检测器的收益(R-AUC与整体精度)正交,证明两个组件是分工互补而非简单叠加。第三,Hand Detector具有即插即用的通用性:Table 8显示将其接入EventHands、Ev2Hands、EventEgoHands三种现有方法后,R-AUC与RR-AUC一致提升(如EventEgoHands从0.417升至0.437),说明"事件数据先抠手区"是可复用的通用组件,而非绑定特定架构的技巧。第四,EEH-R的采集方案含工程创新:16-IMU动捕手套外套普通布手套,兼顾精准关节真值与事件数据中自然的织物纹理外观;OptiTrack 16相机(6台PrimeX22+10台PrimeX13)提供全局定位,平均标定误差低于0.1972 mm;标注策略高效——明亮场景用SAM3自动生成198,410帧mask,黑暗场景仅手工标注1,000帧,Fig 11证明黑暗标注占比达到25%即性能饱和,混合监督策略大幅降低了标注成本。
实验结果
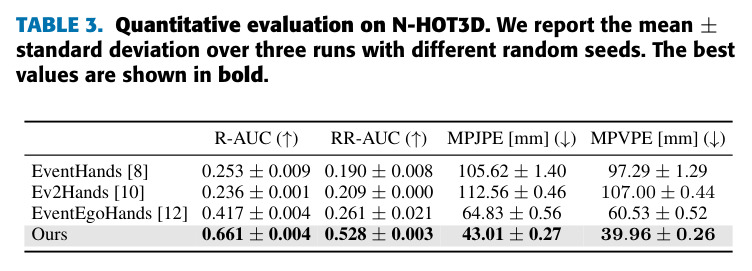
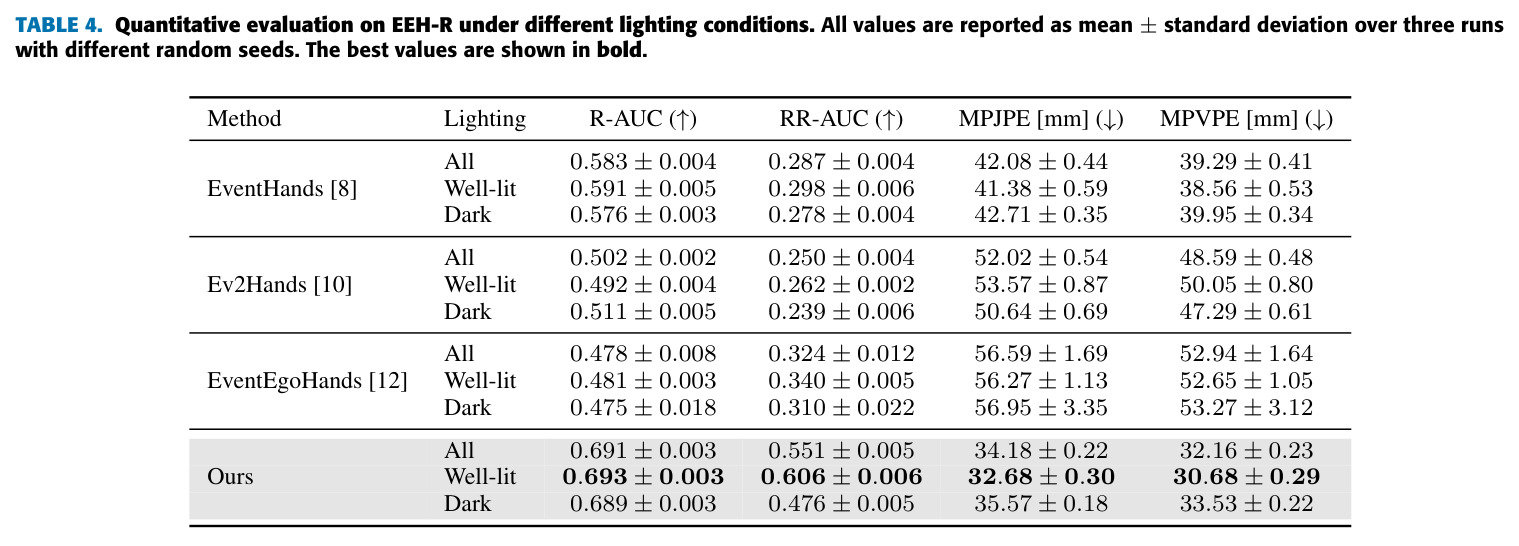
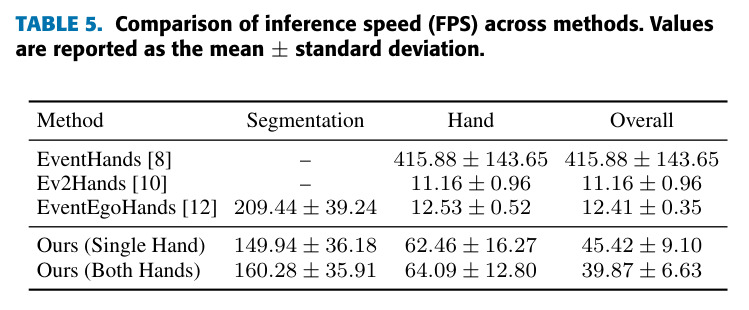
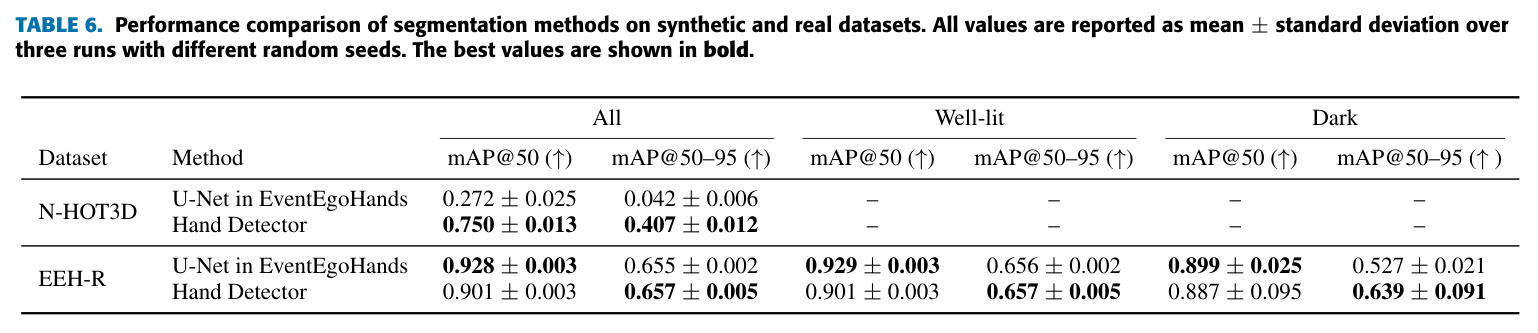
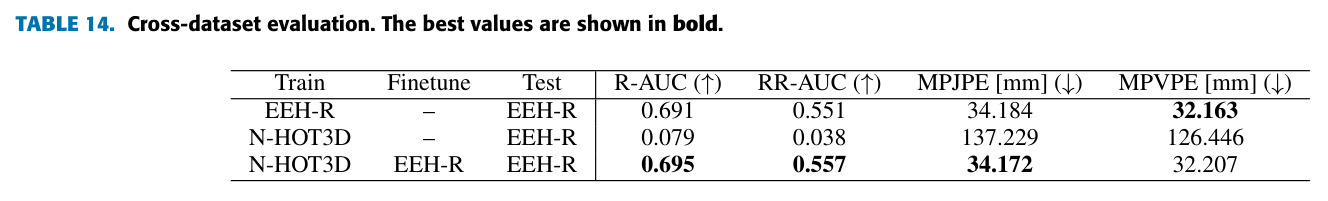
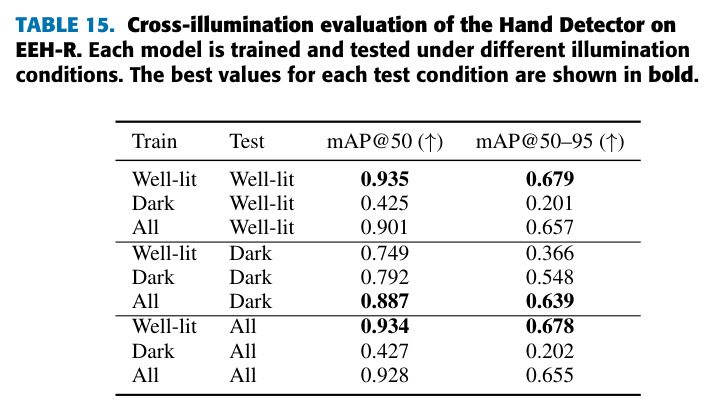
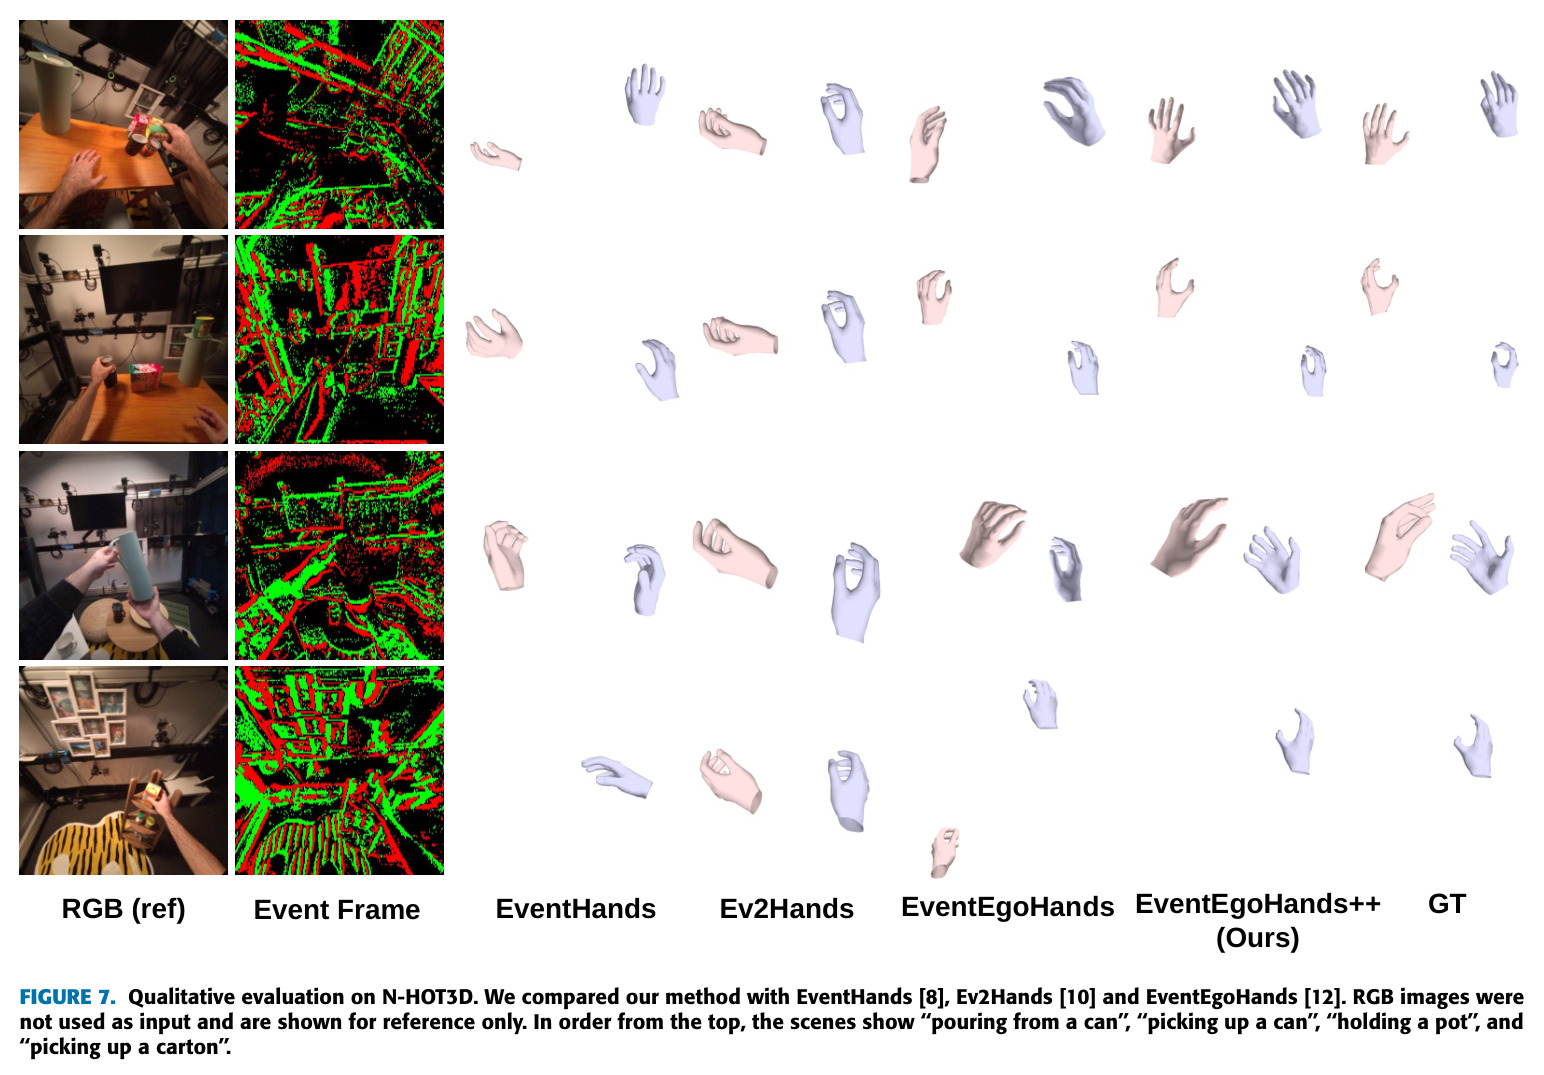
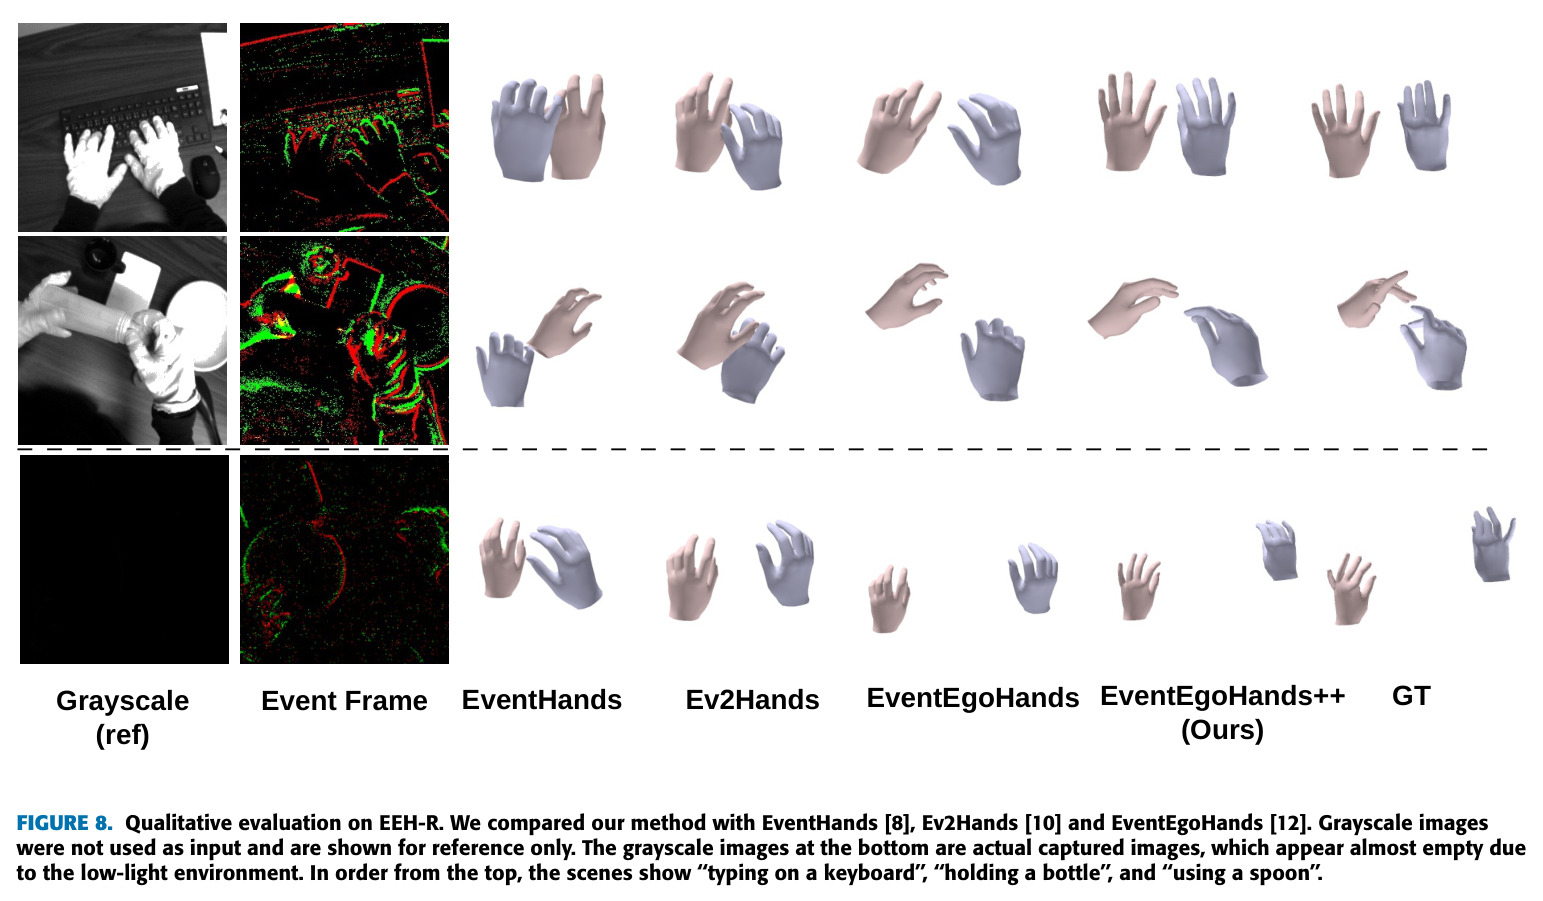
核心发现按实验逐一分析。(1)合成N-HOT3D定量结果(Table 3):本文R-AUC 0.661、RR-AUC 0.528、MPJPE 43.01 mm、MPVPE 39.96 mm,全面最优;相比最强基线EventEgoHands(64.83/60.53 mm),MPJPE降低21.82 mm(33.7%)、MPVPE降低20.57 mm(34.0%);第三人称方法EventHands(105.62 mm)与Ev2Hands(112.56 mm)差距更大,定性分析(Fig 7)显示它们无法抑制第一人称背景事件,Ev2Hands的点云表示在大事件量下被迫均匀下采样、丢失手部细节,导致双手姿态趋同。(2)真实EEH-R结果(Table 4):本文MPJPE 34.18 mm、MPVPE 32.16 mm(全条件),相比最佳基线EventHands(42.08/39.29 mm)降低7.90 mm(18.8%)与7.13 mm(18.1%);黑暗条件下MPJPE 35.57 mm仅比明亮的32.68 mm高约3 mm,首次实证了事件相机低光优势;有趣的是第三人称基线在此数据集多个指标上反超egocentric前作,作者归因于EEH-R为桌面任务、手占画面比例大且每帧事件数少,场景更接近第三人称设定。(3)速度(Table 5):整体39.87 FPS(双手)/45.42 FPS(单手),比Ev2Hands(11.16)和EventEgoHands(12.41)快约3倍,单手更快是因为跳过了cross-attention。(4)分割性能(Table 6):N-HOT3D上mAP@50从U-Net的0.272提至0.750,mAP@50-95从0.042提至0.407;EEH-R黑暗条件下mAP@50-95达0.639,显著优于U-Net的0.527。(5)消融(Table 7):双组件皆除时MPJPE 46.79 mm仍优于基线64.83,说明帧式联合建模本身有效;仅加检测器RR-AUC为0.469,再加自适应注意力升至0.528。(6)损失消融(Table 9):仅用 $\mathcal{L}_{MANO}$ 时MPJPE高达153.64 mm,四项组合最佳。(7)编码器消融(Table 10):EfficientNetV2-S(20.2M)优于ViT-B(85.8M,MPJPE 47.14 mm)。(8)检测器消融(Table 11):YOLO26以0.750/0.407的mAP和209.54 FPS取得最佳平衡(RF-DETR精度略高但仅68.49 FPS)。(9)跨数据集(Table 14):N-HOT3D直接测EEH-R崩至137.23 mm,但作预训练再微调(34.17 mm)略优于仅EEH-R训练(34.18 mm),证明合成预训练有微弱价值。
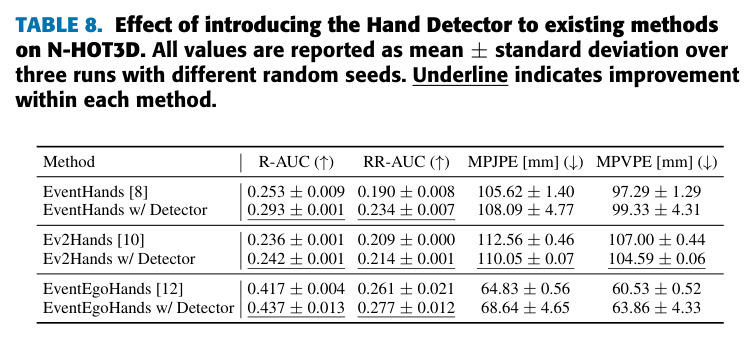
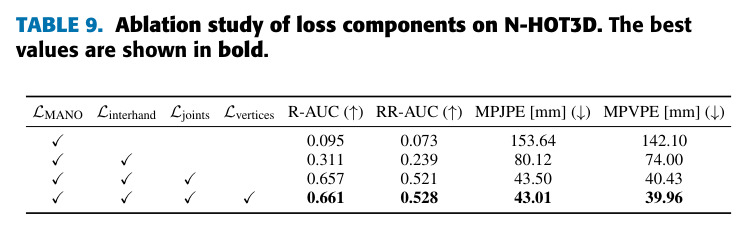
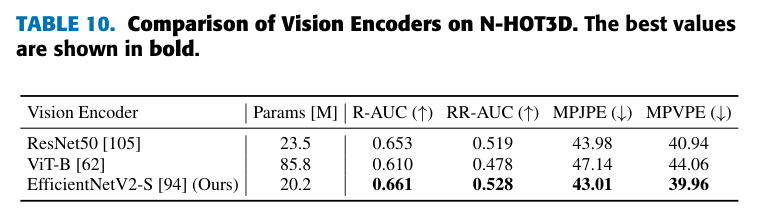
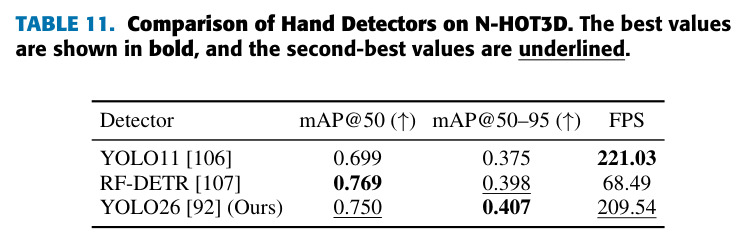
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| N-HOT3D 3D关节估计(合成数据,第一人称双手) | MPJPE (mm) ↓ | 43.01 ± 0.27 | EventEgoHands 64.83 ± 0.56(EventHands 105.62,Ev2Hands 112.56) | 较最佳基线降低 21.82 mm(-33.7%) |
| N-HOT3D 网格顶点估计 | MPVPE (mm) ↓ | 39.96 ± 0.26 | EventEgoHands 60.53 ± 0.52 | 降低 20.57 mm(-34.0%) |
| EEH-R 3D关节估计(真实数据,含3.5 lux黑暗条件) | MPJPE (mm) ↓ | 34.18 ± 0.22(黑暗条件 35.57,明亮 32.68) | EventHands 42.08 ± 0.44(黑暗 42.71,明亮 41.38) | 降低 7.90 mm(-18.8%) |
| EEH-R 网格顶点估计 | MPVPE (mm) ↓ | 32.16 ± 0.23 | EventHands 39.29 ± 0.41 | 降低 7.13 mm(-18.1%) |
| N-HOT3D 手部实例分割/检测 | mAP@50 / mAP@50-95 ↑ | 0.750 / 0.407(YOLO26 Hand Detector) | U-Net(EventEgoHands)0.272 / 0.042 | mAP@50 提升 0.478,mAP@50-95 提升约 9.7 倍 |
| EEH-R 黑暗条件手部分割 | mAP@50-95 ↑ | 0.639 | U-Net 0.527 | +0.112(更严格的IoU阈值下优势明显) |
| 整体推理速度(双手) | FPS ↑ | 39.87 ± 6.63(单手 45.42) | EventEgoHands 12.41 ± 0.35;Ev2Hands 11.16 ± 0.96 | 约 3.2 倍 |
局限与改进
作者承认的局限:EEH-R在受控实验室环境采集,尚未覆盖in-the-wild场景;IMU动捕手套外加布手套改变了手部外观纹理,与裸手存在差距,未来需marker-less动捕。评估协议上存在一个值得注意的盲区:所有关节/顶点指标只统计被检测器成功检测的手,漏检的手被排除在误差聚合之外,这会系统性掩盖最难的帧——黑暗加遮挡下漏检越多,平均误差反而可能越好看。我自己观察到的局限:其一,黑暗条件下RR-AUC(0.476)明显低于明亮条件(0.606),说明低光下双手相对位置估计退化显著,而这恰是交互建模的核心;其二,方法逐帧独立推理、无时序建模,预测轨迹存在时间抖动(Fig 12c),作者承认HaMeR、WiLoR等RGB方法也有同样问题;其三,手部静止时事件稀疏导致漏检(Fig 12b),这是事件相机"只感知变化"的原理性缺陷,低光下更严重;其四,跨数据集实验中N-HOT3D直接迁移到EEH-R的MPJPE高达137.23 mm,暴露合成模型泛化能力有限,且N-HOT3D帧内事件时间分布集中在开头(Fig 6),与真实事件的均匀分布不符;其五,遮挡导致的漏检与指尖重建错误(Fig 12a)未得到处理,而手-物交互恰是该任务的目标场景;其六,检测阈值按数据集经验设定(0.5/0.8),置信度校准缺乏理论依据。
独立分析的弱点
独立弱点分析及改进方向。第一,"静止即失明":事件相机只响应亮度变化,手与头部都静止时事件流枯竭,检测器直接漏检(Fig 12b),这对AR中的稳定持物姿态是致命的。改进方向:自适应延长事件积分窗口、累积历史事件帧,或引入轻量帧间状态记忆(循环隐状态/递归更新)。第二,遮挡失效:手被所持物体遮挡时检测失败或指尖重建错误(Fig 12a),而 manipulation 恰是该任务的目标场景。改进方向:显式建模物体形状与手-物接触,借鉴RGB领域HandOccNet、Harmonious的手物联合特征学习,为物体区域引入独立特征表示。第三,无时序建模导致抖动:逐帧独立预测使腕部轨迹不平滑(Fig 12c),违背手部运动的物理连续性,且事件流的微秒级时间戳天然适合时序利用,目前却被压缩成30 FPS伪帧,信息被浪费。改进方向:采用HaPTIC式时序融合,或直接预测帧间相对变化而非逐帧绝对姿态,迈向4D手部轨迹重建。第四,评估协议盲区:未检测的手不计入MPJPE/MPVPE,会低估端到端系统误差;建议补充检出率与定位误差的联合指标,或对漏检帧施加惩罚项。第五,阈值与误检敏感:false positive会把不存在的手引入重建造成严重伪影(这正是前作的问题,本文靠高阈值缓解但非根治),置信度校准或不确定性估计值得研究。第六,数据采集成本:EEH-R依赖OptiTrack 16相机+IMU手套+DAVIS346,普通实验室难以复制同类数据,限制了数据集扩展速度;可探索用现成RGB大模型在同步灰度帧上做伪标注来降低采集门槛。
未来方向
作者提出的方向:其一,时序/4D重建——利用事件流的高时间分辨率做时间一致性建模,作者点名两条具体路线:HaPTIC式的时序信息融合预测连贯4D手部轨迹,以及跨帧共享注意力并直接估计帧间深度变化而非逐帧绝对值,可同时缓解抖动与稀疏事件问题;其二,手-物交互建模——借鉴RGB方法(HandOccNet、Harmonious feature learning)为手与物体引入不同特征表示,处理遮挡与接触;其三,数据扩展——走向in-the-wild场景,采用marker-less动捕摆脱手套、记录裸手外观。基于其成果可延伸的方向:第四,跨模态蒸馏——EEH-R同时记录了灰度帧与事件流,可用明亮帧上的RGB大模型(HaMeR/WiLoR)蒸馏事件模型,摆脱对MoCap硬件的依赖并扩展到任意场景;第五,更强的sim-to-real——作者已证明N-HOT3D预训练加微调略有增益(34.17 vs 34.18 mm),事件级别的域随机化、事件域翻译等更强域适应手段可能进一步释放48万合成帧的价值;第六,下游应用闭环——RR-AUC衡量的双手相对位置恰是操作识别、手部预测与人机协作所需,可将其作为事件驱动的always-on前端(39.87 FPS、低功耗)接入AR交互管线;第七,机制推广——把Adaptive Attention的可见性条件调度推广到第一人称事件人体姿态估计(EventEgo3D系列)等更广义的多实例重建任务。
复现评估
复现评估:开源情况良好——代码、扩展版N-HOT3D与EEH-R数据集在项目页(ryhara.github.io/EventEgoHandsV2/)公开,EEH-R采集已获庆应义塾大学伦理批准(2025-131)。算力门槛低:全部实验在单卡NVIDIA RTX 6000 Ada完成,重建网络EfficientNetV2-S仅20.2M参数,检测器YOLO26推理约209 FPS,4090级别消费级显卡应可复现训练(重建30 epochs、batch 32;检测100 epochs、batch 64)。复现路径有两条:N-HOT3D路线无需特殊硬件——从公开HOT3D数据取Aria眼镜子集(9名受试者),用开源事件模拟器v2e生成346×260事件,标注完全基于MANO投影,可独立重建;EEH-R路线可直接下载约102万帧数据,但若要自采同类数据则需DAVIS346、OptiTrack 16相机系统、16-IMU动捕手套,硬件成本达数万美元量级。需注意的复现细节:检测置信度阈值随数据集不同(N-HOT3D取0.5、EEH-R取0.8)、mask膨胀核7×7、LNES事件表示、损失权重 $\lambda_\gamma=2.0, \lambda_\delta=1.0, \lambda_\epsilon=2.0, \lambda_\zeta=1.0$、输入224×224。论文所有主结果均报告3个随机种子的均值±标准差,数值可靠性较好。总体判断:用其公开数据复现训练与评估难度中等偏低;完整复现数据采集难度高。
论文图表
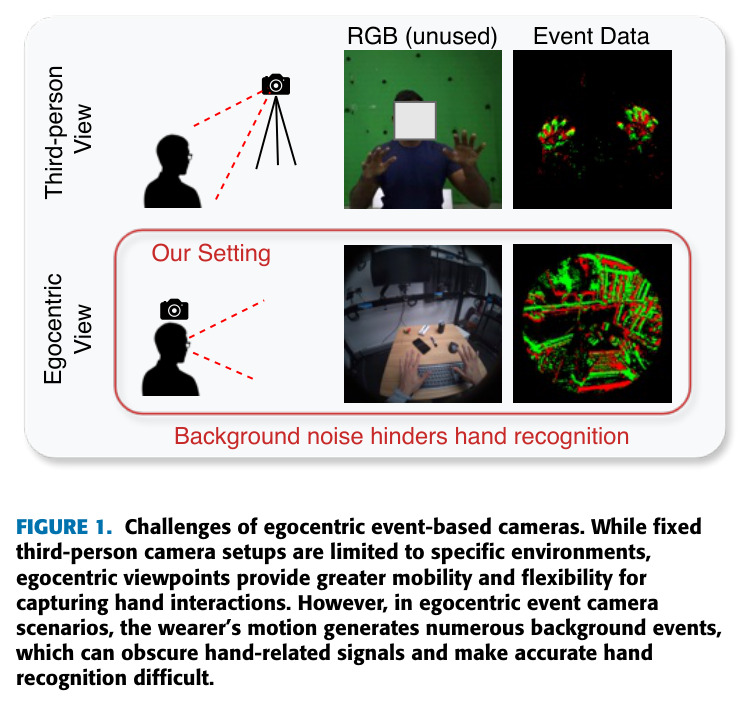
对比图:上半部分展示固定第三人称相机与本文第一人称(头戴)设定的视野差异,下半部分展示第一人称事件数据中穿戴者运动产生的密集背景事件如何淹没手部信号。
一眼讲清任务的 motivation:为什么第一人称事件手部重建难——背景事件噪声。这是全文两个核心组件(检测抠手区、自适应注意力)共同的问题源头。
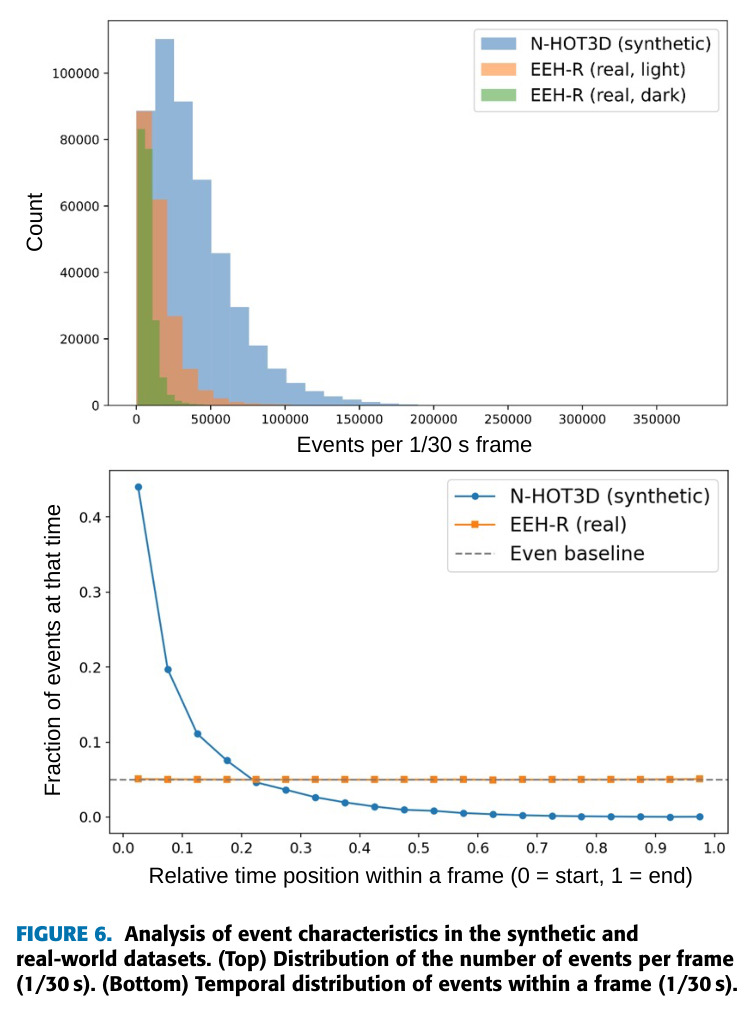
统计对比:上图为每帧(1/30秒)事件数分布,N-HOT3D 事件数明显多于 EEH-R;下图为事件在帧内时间轴上的分布,真实数据近乎均匀而合成数据集中在帧首。
定量揭示了合成与真实数据的域差(事件密度+时间分布),解释了为什么必须构建真实数据集、也解释了跨数据集迁移失败的原因。
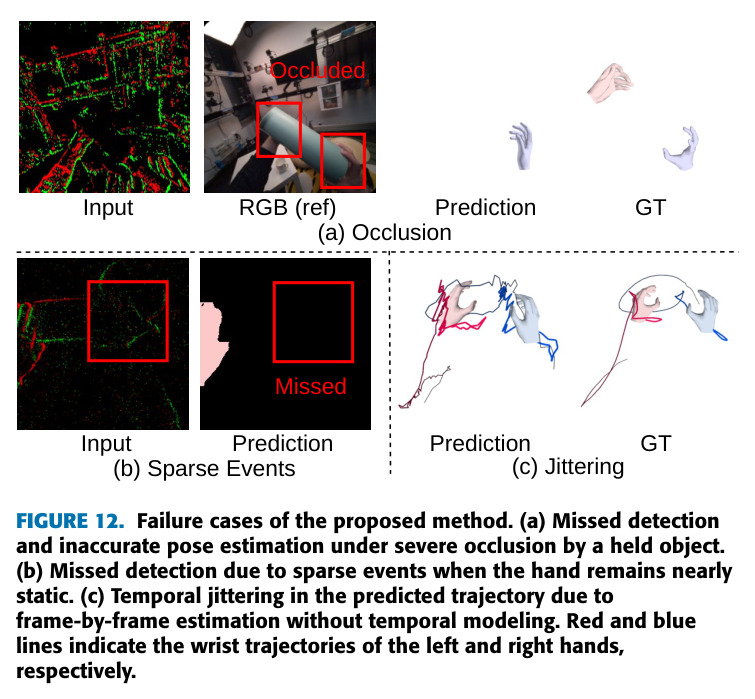
三类失败模式:(a) 手被物体严重遮挡导致漏检与姿态错误;(b) 手近乎静止时事件稀疏导致漏检;(c) 逐帧独立推理导致腕部轨迹抖动、不如真值平滑。
诚实地界定了方法的适用边界(遮挡、静止、时序),这三点直接对应未来工作方向,评估与跟进该工作时必看。