基于图像生成的视觉推理:REIMAGIN 框架 Reasoning with Image Generation
把指令驱动的图像生成模型当作开放式视觉工具,让多模态大模型在像素空间里推理
前置知识
思维链(Chain-of-Thought, CoT)
让大语言模型在给出最终答案前先生成一系列中间推理步骤的技术。模型把复杂问题分解为多步小推理,每步输出作为后续步骤的上下文,从而显著提升数学、逻辑等复杂任务的准确率。本文将其推广到视觉域:中间步骤不限于文字,还可以是生成的图像。
REIMAGIN 的本质就是把 CoT 的中间步骤从纯文本扩展为文本与图像交错,理解 CoT 才能理解它与文本推理基线的对比逻辑和实验设计动机。
多模态大语言模型(MLLM)
能同时处理文本和图像输入的大语言模型,通过视觉编码器把图像转化为 token 与文本共同送入语言模型,可以回答关于图像的问题、执行视觉推理。本文用 Gemini-3.1-Pro、GPT-5 和开源的 Qwen-3.5-27B 作为推理骨干。
整个框架的推理主体就是 MLLM:它既要决定何时调用生成工具、写什么生成指令,又要在下一轮看懂返回的中间图像继续推理。
ReAct 智能体框架
经典的 LLM 智能体范式,把 Reasoning(生成思考理由)和 Acting(执行工具调用)交错进行:每轮模型先写出想法,再输出动作,环境返回观察后进入下一轮,循环直至给出答案。
REIMAGIN 的智能体架构直接构建于 ReAct 之上,论文中的 $\theta_t$(理由)、$\alpha_t$(动作)、$o_i$(输出)三元组正是 ReAct 循环的形式化描述。
Visual Sketchpad(视觉工具基线)
给多模态 LLM 配备一套固定专家视觉工具(裁剪、目标检测、分割、深度估计等)和程序化绘图能力的框架,模型通过调用这些预定义模块辅助推理。其工具只能执行设计者预先实现的窄操作,且依赖人工设计的工具使用示例。
它是本文最主要的对比基线,理解其固定工具箱的特性,才能体会 generate_image 开放式自然语言接口带来的本质优势。
测试时扩展(Test-Time Scaling)
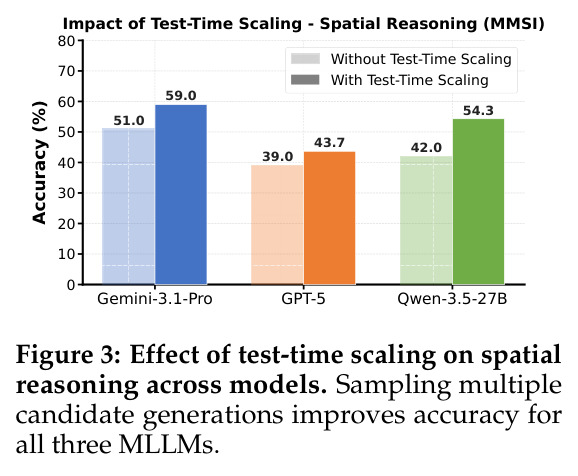
在推理阶段投入额外计算换取更优结果的技术,常见做法是采样多条推理链再投票或择优。本文的变体是:只采样一条推理链,把额外算力花在图像生成上——独立采样 $N$ 张候选图,由 MLLM 选择器挑出最忠实于指令的一张。
这是空间推理任务从 51.0% 提到 59.0% 的关键机制,也是论文核心论断图像质量决定推理上限的最直接证据。
sMAPE(对称平均绝对百分比误差)
回归与计数任务常用的评估指标,定义为 $\mathrm{sMAPE}=100\cdot|y-\hat{y}|/(y+\hat{y})$,其中 $y$ 是真实计数、$\hat{y}$ 是预测计数,数值越低越好,对量纲不敏感。本文六个任务中只有遮挡计数用它代替准确率。
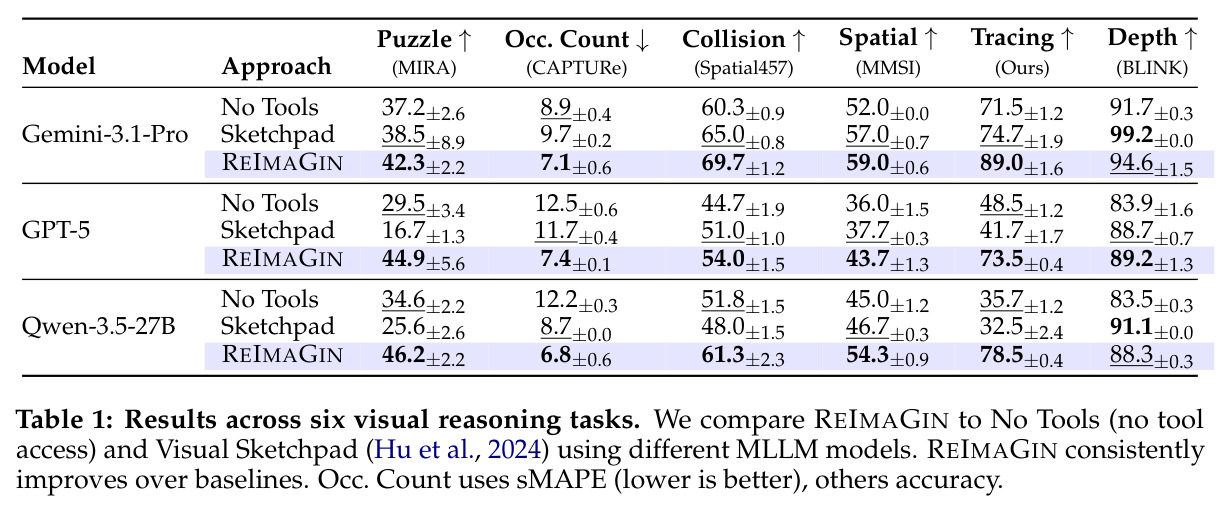
看表1和表2时必须知道该列是越低越好,否则会把 REIMAGIN 的 7.4 对基线 12.5 误读成性能更差。
研究动机
思维链让大语言模型学会把问题拆解成中间步骤,但绝大多数多模态框架仍把推理局限在文本域:先用文字描述图像,再做逻辑处理。这对需要空间或物理直觉的任务并不适用,比如想象遮挡物移除后的样子、从两个互不重叠的视角合成房间俯视图。为弥补这一点,Visual Sketchpad 等工作给多模态 LLM 挂载固定视觉专家工具(裁剪、深度估计、目标检测),但存在两个根本限制:其一,工具能力僵化,只能做预先定义的窄操作,无法完成生成俯视平面图、把虚线变实线这类开放式变换;其二,模型依赖人工为每个任务手写 in-context 示例来教授工具使用策略。论文实测显示,在拼图补全任务上 Sketchpad 配 GPT-5 反而从无工具基线的 29.5% 掉到 16.7%,说明专用工具覆盖不了需要生成能力的任务。
本文的目标是本文的目标是证明:指令微调的图像生成模型可以作为一种通用、灵活的视觉推理机制,取代一整套专用视觉工具。具体做法是把一个自由格式的 generate_image 工具交给多模态智能体,使其能在推理的任意步骤用自然语言发起图像生成,生成结果直接放回上下文继续推理,全程无需任务定制训练。作者在深度感知(BLINK)、拼图补全(MIRA)、遮挡计数(CAPTURE)、碰撞预测(Spatial457)、多视角空间推理(MMSI)和自建的路径追踪六个差异很大的任务上验证同一工具的有效性;同时探索用自动提示优化取代人工设计,让人不再需要为每个任务手写何时生成什么图的策略示例。
与已有工作不同的是,已有工作的切入角度要么是固定功能工具箱(Sketchpad 的检测、分割、深度模块),要么需要任务特定训练或只在单一窄域起作用,再或在不可解释的隐空间中推理。REIMAGIN 的独特之处在于:训练自由、模块化,只调用一个指令跟随式生成模型完成开放式变换;视觉推理发生在可解释的像素空间,人可以直接查看并审计中间图像;同一工具跨六个任务复用。更关键的一个观察是:推理策略完全通过提示传给智能体,因此发现好策略可以归约为优化提示词,这把策略工程变成一个可自动化的搜索问题;而且该方法的能力上限会随底层生成模型的进步自动抬升,不需要重新设计工具集。
核心方法
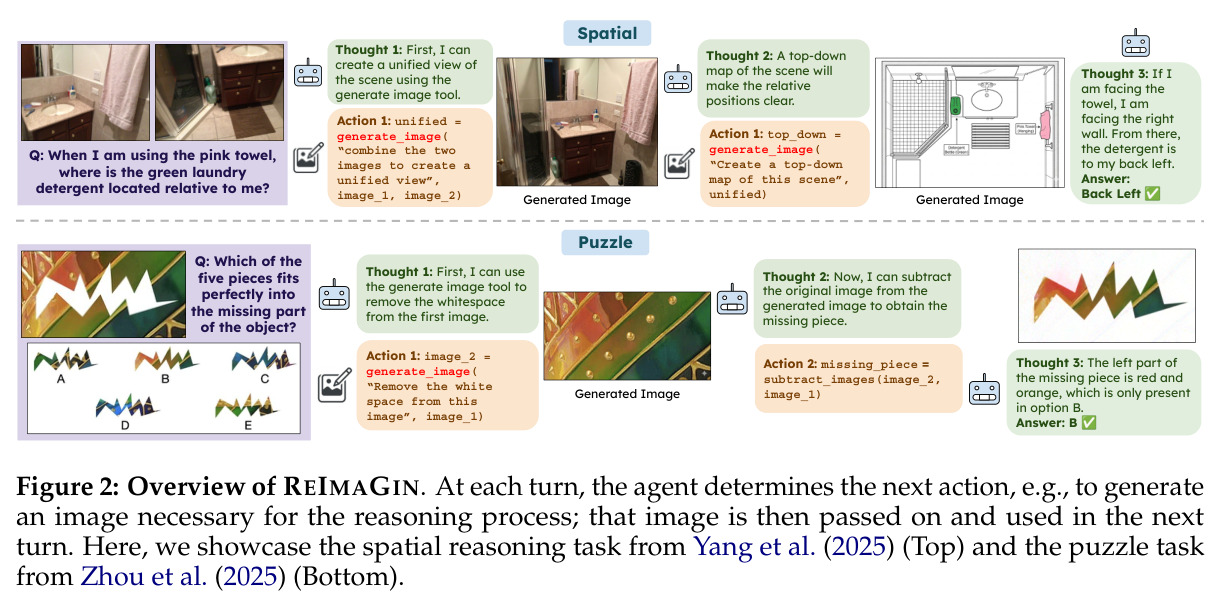
REIMAGIN 建立在 ReAct 框架上。设查询为 $Q$,输入图像为 $V=\{v_1,\dots,v_n\}$,第 $t$ 轮智能体维护上下文 $C_t=\{Q, V, h_1,\dots,h_{t-1}\}$,其中每步历史 $h_i=(\theta_i,\alpha_i,o_i)$ 分别是思维链理由、可执行动作和动作输出。每轮 MLLM 先产生理由 $\theta_t$,再输出一段 Python 程序 $\alpha_t$,程序可调用程序化图像工具(crop、overlay、subtract、numpy 等)以及核心的 generate_image 生成工具;输出 $o_i$(含生成图像)作为新消息追加进上下文,直到出现 TERMINATE 并解析最终答案。由于生成是随机的、任务越难方差越大,框架引入测试时扩展:generate_image 独立采样 $N$ 个候选图像(空间推理任务用 $N=10$),由 MLLM 选择器挑出最忠实于提示的一张返回,接口对智能体完全透明。与主流把额外算力花在多条文本 CoT 投票上不同,这里只采样一条推理轨迹,把算力集中用于提高中间图像质量。
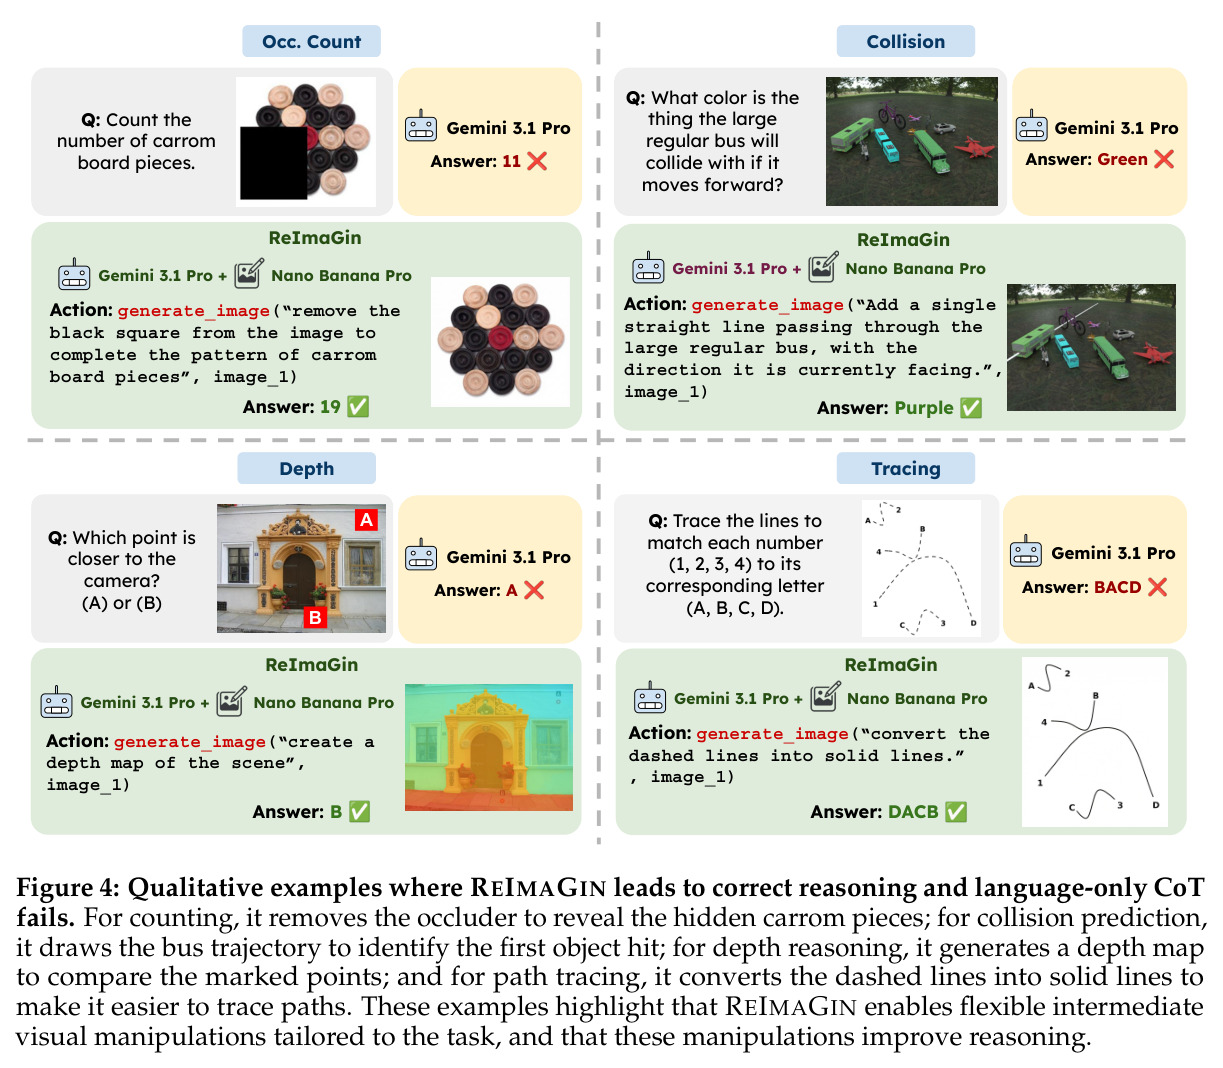
核心洞见是:一个接受自然语言指令的图像生成模型,本身就集成了大量专家视觉工具的能力,还能做以前做不到的开放式变换——去掉遮挡物、把两张不重叠视角合成一张全景俯视图、把虚线描成实线、从移动物体前端画轨迹箭头。与 Sketchpad 每个工具只暴露固定操作的窄而僵不同,generate_image 的能力随自然语言表达力开放,且随生成模型升级自动增强。第二个创新是把视觉推理策略显式建模为提示词:由于策略完全通过工具定义和 in-context 示例传达,发现好策略就等价于搜索好提示。论文据此设计迭代优化循环:提案模型 $A_P$ 依据保留的历史提示及训练集上的成功与失败轨迹生成新候选提示,用开发集分数 $J(p)$ 筛选保留,整个过程中推理智能体 $A_R$ 和图像生成器保持固定不变。
方法步骤详情
方法分三层。第一层是单次推理循环:提示由工具描述、in-context 示例和上下文 $C_t$ 组成;MLLM 生成理由 $\theta_t$,输出 Python 动作 $\alpha_t$;运行时执行程序,生成图像与文本输出追加为下一条用户消息,循环至 TERMINATE 输出答案。例如拼图任务先用 generate_image 去掉留白,再用 subtract_images 减去原图隔离缺失块。第二层是测试时扩展:generate_image 内部独立采样 $N$ 个候选(空间任务 $N=10$),由 Gemini-3.1-Pro 选择器挑出最忠实的一张返回。第三层是自动策略发现:从无策略基线提示出发,每轮在 $|\mathcal{D}_{train}|=50$、$|\mathcal{D}_{dev}|=50$ 样本上评估候选提示,提案智能体 $A_P$ 参考 top-2 提示及成败轨迹提出 5 个新提示,共跑 $R=4$ 轮,每任务发现成本约 214 美元。
技术新颖性
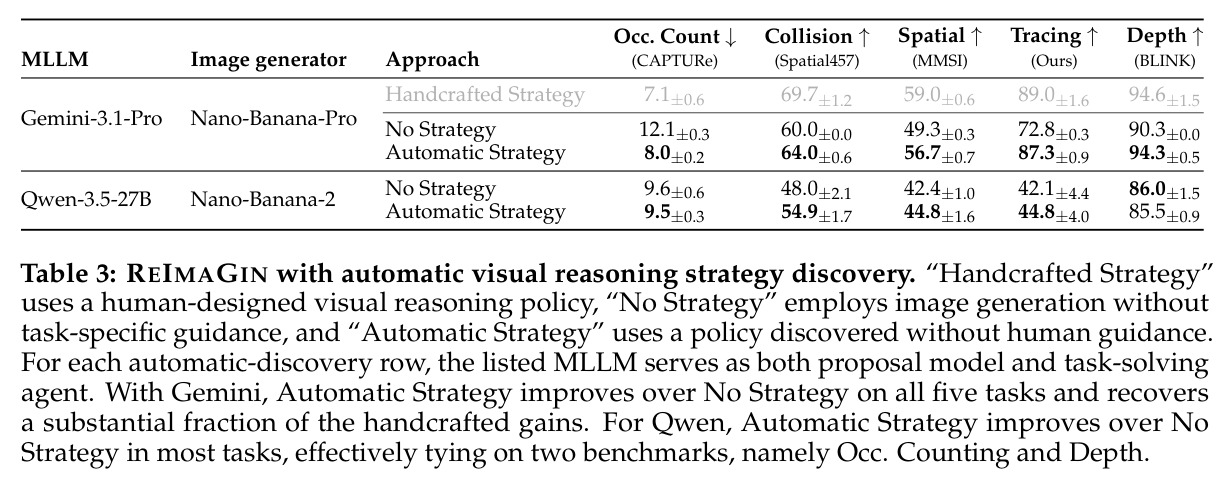
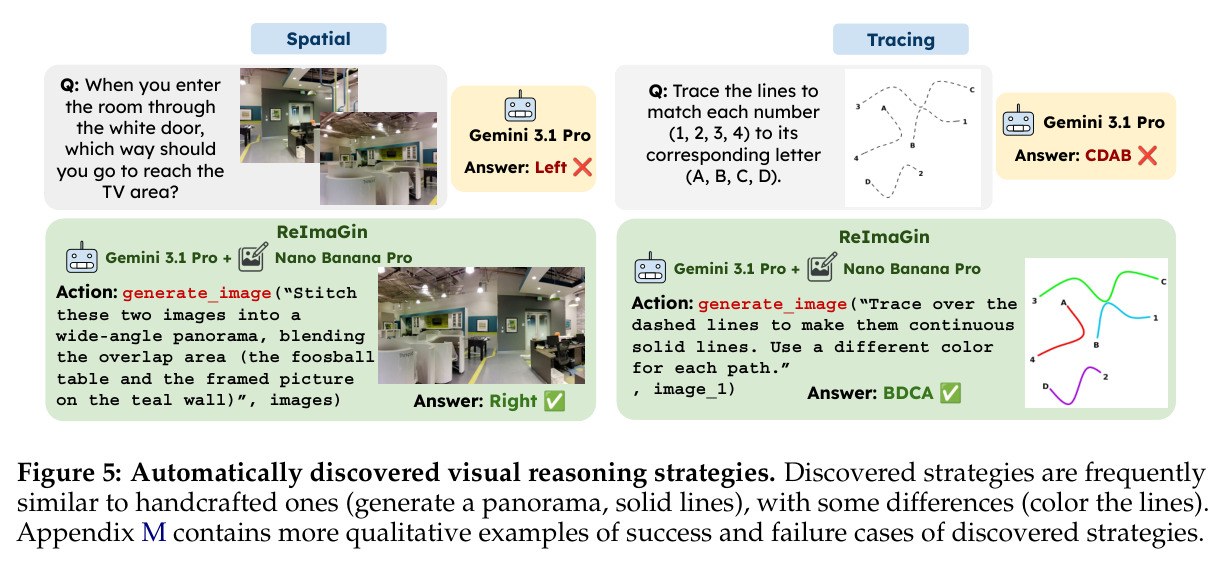
技术新颖性体现在三点。第一,工具层面的范式转换:不新增专家模块,而是用一个通用生成器统一理解、变换、再观察的闭环,生成图像是推理的中间状态而非最终优化目标,这与图像迭代精修一脉的工作有本质区别。第二,策略自动发现:以往 Sketchpad 式框架完全依赖人工设计工具使用策略,本文证明无需任何人类编写的任务策略或推理轨迹,仅凭提示搜索就能发现与人类设计高度一致的策略(如给碰撞任务画箭头、给深度任务生成深度图),且 Gemini 发现的策略零修改迁移到 Qwen-3.5-27B 后仍然有效,说明策略并非对特定模型的过拟合。第三,测试时扩展的新用法:把额外算力投向图像采样与选择而非文本投票,实验证明更忠实的可视化直接转化为更高的下游准确率,且在基线获得同等测试时算力(20 次多数投票)时 REIMAGIN 仍然更优。
实验结果
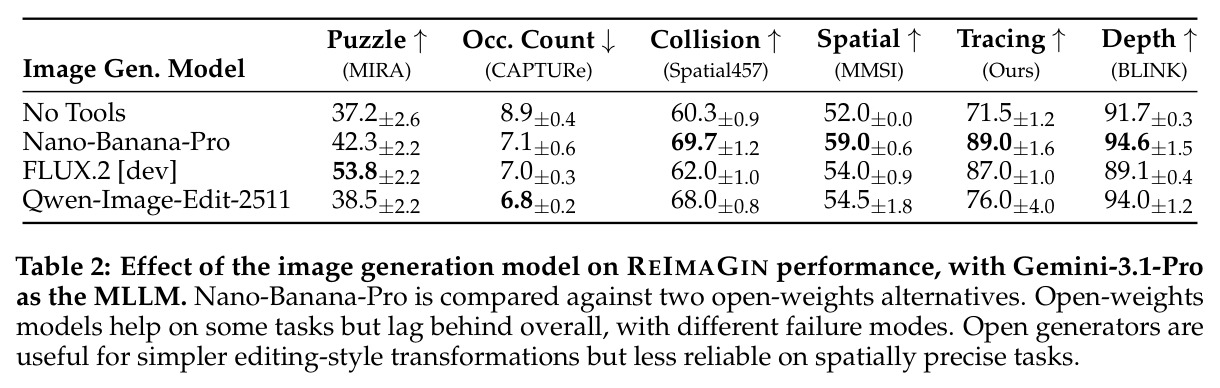
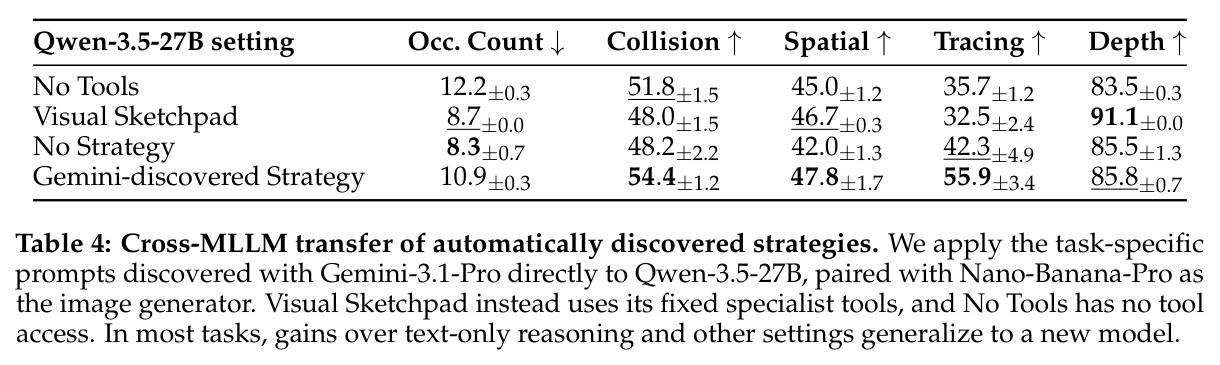
主实验(表1)跨三骨干展开。GPT-5 提升最戏剧化:拼图 44.9% 对无工具 29.5% 和 Sketchpad 16.7%(专用工具反而差于无工具);路径追踪 73.5% 对 48.5%;遮挡计数 sMAPE 从 12.5 降到 7.4,相对改善约 40%。Qwen-3.5-27B 上追踪从 35.7% 跃升至 78.5%。Gemini-3.1-Pro 上碰撞 69.7%、空间 59.0%、追踪 89.0% 全面领先,唯一例外是深度 94.6% 低于 Sketchpad 的 99.2%。测试时扩展(N=10)把 Gemini 空间推理从 51.0% 提到 59.0%、Qwen 从 42.0% 提到 54.3%。表2中开源生成器各有所短:FLUX.2 拼图 53.8% 反超但深度 89.1% 跌破无工具基线,Qwen-Image-Edit 追踪仅 76.0%。表3中自动策略超越无策略(追踪 87.3% 对 72.8%),逼近手工策略的 89.0%;表4证明该策略零修改迁移 Qwen 仍全面超越无工具。120 张生成图审计显示 75% 忠实:忠实时正确率 87%,不忠实降至 43%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 路径追踪 Path Tracing(GPT-5) | 准确率(%,3 seeds 均值) | 73.5 | 无工具 48.5,Visual Sketchpad 41.7 | 较无工具 +25.0 个百分点,较 Sketchpad +31.8 个百分点 |
| 路径追踪 Path Tracing(Qwen-3.5-27B) | 准确率(%) | 78.5 | 无工具 35.7,Sketchpad 32.5 | +42.8 个百分点,超过一倍以上 |
| 遮挡计数 CAPTURE(GPT-5) | sMAPE(%,越低越好) | 7.4 | 无工具 12.5,Sketchpad 11.7 | 相对降低约 40% |
| 拼图补全 MIRA(GPT-5) | 准确率(%) | 44.9 | 无工具 29.5,Sketchpad 16.7 | +15.4 个百分点;Sketchpad 反而退化 12.8 个点 |
| 多视角空间推理 MMSI(Gemini-3.1-Pro) | 准确率(%,含测试时扩展 N=10) | 59.0 | 无工具 52.0,Sketchpad 57.0(20 次多数投票对等算力) | +7.0 与 +2.0 个百分点 |
| 碰撞预测 Spatial457(Gemini-3.1-Pro) | 准确率(%) | 69.7 | 无工具 60.3,Sketchpad 65.0 | +9.4 与 +4.7 个百分点 |
| 相对深度 BLINK(Gemini-3.1-Pro) | 准确率(%) | 94.6 | 无工具 91.7,Sketchpad 99.2 | 唯一例外:超越无工具但落后专用深度估计工具 4.6 个点 |
局限与改进
作者承认的局限包括:深度任务上不敌专用工具(94.6% 对 99.2%),说明存在强专家模型时生成式路线并非总是最优;开源生成器能力不足,FLUX.2 深度 89.1% 甚至低于无工具基线 91.7%,Qwen-Image-Edit 追踪 76.0% 明显落后于 Nano-Banana-Pro 的 89.0%;25% 的生成图像不忠实,且不忠实时正确率从 87% 崩到 43%,生成质量是首要瓶颈;自动策略发现未能复现 MMSI 所需的拼接加俯视复合策略,在需要精细视觉推理策略的任务上与手工策略仍有差距;路径追踪上自动策略额外要求给线上色,因生成更易失败反而略降性能。我的补充观察:所有基准都是多选题或计数这类有唯一答案的封闭任务,缺少开放式任务评估;策略发现每任务约 214 美元且依赖强模型做提案,弱模型自我发现收益有限(Qwen 场景计数与深度仅打平);忠实度选择器本身依赖 Gemini-3.1-Pro,其成本与偏差未被单独消融;每个任务仍需手工策略作为上限参照,并未完全摆脱人工。
独立分析的弱点
第一,生成忠实度是硬瓶颈:75% 忠实率意味着约每四次生成一次出错,而错误图像会系统性把推理带偏(不忠实时正确率仅 43%)。改进方向是在循环内加入验证-重试机制:用几何一致性检查或多次生成交叉验证,自动检测平面图错位等失败并重新采样。第二,MLLM 读图失败被低估:即使图像忠实,模型也可能看错(作者归因于 MLLM 能力上限)。可为智能体补充放大、裁剪标注区域等检查工具,或训练专门的视觉验证头。第三,策略搜索太浅:50 训练样本、4 轮、每轮 5 个候选,对 MMSI 这类需要先拼接全景再生成俯视图的复合策略无能为力。可引入树搜索、扩大样本预算,或让提案模型显式组合已发现的原子策略。第四,成本结构脆弱:每实例 0.12 美元的生成开销叠加 N=10 采样使空间任务生成成本翻十倍,缓存相似提示的生成结果、用小型判别模型替换 MLLM 选择器可显著降本。第五,评估全部是封闭式基准,无法说明该方法在图像编辑辅助、机器人规划等真实开放任务上的表现,也缺少对生成图像引入错误信息(幻觉污染推理)概率的系统度量。
未来方向
作者指出的方向:用更强的图像生成模型直接抬升推理上限,因为生成失败率随生成器能力扩展;改进中间可视化的选择与验证机制;开发更可扩展的推理策略自动发现方法。基于本文成果可自然延伸:把策略发现从提示搜索升级为对工具调用策略的强化学习,让智能体从自身成败中在线学习何时生成什么图;将像素空间推理与隐空间推理结合,兼顾可解释性与效率;扩展到视频时序推理与三维场景,生成中间帧或新视角辅助规划;研究生成图像忠实度的自动度量并用于答案置信度校准;探索生成器与批判器的多智能体协作架构;以及把发现的策略作为训练数据蒸馏进更小的开源模型,降低对闭源 API 的依赖。
复现评估
复现难度中等偏高。六个任务中 BLINK、MIRA、CAPTURE、Spatial457、MMSI 均为公开基准,路径追踪为作者自建,论文标注了代码发布(§ Code),策略发现实现基于 Opik 框架。主要障碍是模型依赖:最优配置需要 Gemini-3.1-Pro(同时充当推理、选择器与提案模型)和 Nano-Banana-Pro 生成器,均为闭源 API;每实例成本约 0.16 美元(推理 0.04 加生成 0.12),策略发现每任务另需约 214 美元的一次性开销。好在论文提供了充分的开源替代路径:Qwen-3.5-27B 骨干配 FLUX.2 或 Qwen-Image-Edit-2511 生成器,虽在深度、追踪等任务有 3 到 13 个点的差距,但结论定性一致。实验报告 3 个种子的均值与标准误,附录公开了全部提示词、发现的策略文本与消融细节,透明度较高;若只需定性复现,用开源模型栈即可在单卡环境完成。
论文图表
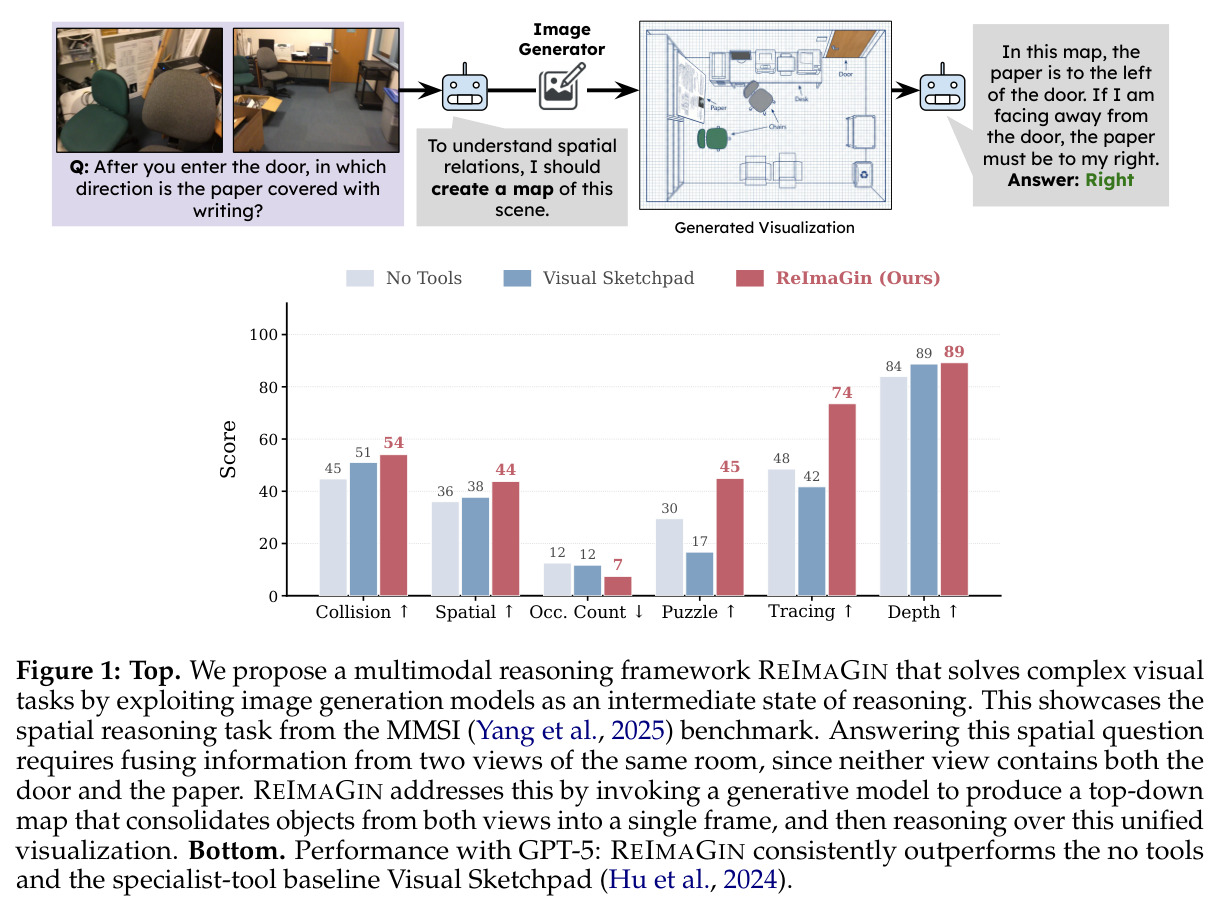
上半部分以 MMSI 空间推理为例演示核心思想:房间两个视角各自只包含门或写字的纸条之一,智能体调用生成模型产出俯视地图,把两个视角的物体合到同一帧后再推理出背对门时纸在右边,答案正确;下半部分柱状图给出 GPT-5 下三种方法在六个任务的成绩,例如追踪任务 REIMAGIN 73.5 对 Sketchpad 41.7、无工具 48.5。
一图看懂论文卖点与量级:直观展示生成中间图像如何解决单视角无法回答的问题,同时用数据说明对两类基线的全面超越,是引导读者理解动机的入口。