函数化器:面向子词分词的无损功能分解 The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
将正字法变化无损分解为PUA操作码前缀,词表最多缩减19.7%
前置知识
子词分词与 BPE(字节对编码)
BPE 从字符级词表出发,迭代地把语料中最高频的相邻符号对合并成新 token,自底向上构建词表;WordPiece 和 Unigram 是其概率化变体。这样常见词成为单个 token,生僻词被拆成多个子词,避免了 OOV 问题。
本文正是在 BPE 词表的构建流程中插入一个预分词步骤,要理解它省下的'词表槽位'是什么、合并耗尽实验为什么能衡量词表冗余,必须先懂 BPE 的合并机制。
Unicode 私有区(PUA, Private Use Area)
Unicode 标准中 U+E000–U+F8FF 这段码点永久保留给私人协议使用,不分配给任何标准字符,保证普通文本不会与之冲突。本文用 U+E000–U+E0FF 编码 0–255 的数值参数(值 = 码点 − 0xE000),用 U+E100–U+EFFF 编码操作码。
Functionalizer 的全部指令都寄居在 PUA 中,这是它能作为普通文本流入标准 BPE 分词器、且不与真实字符混淆的关键编码基础设施。
组合附加符号与 NFC 规范化
é 这类字符可表示为单个预组合码点 U+00E9,或分解为 e 加上组合变音符 U+0301。NFC(Normalization Form C)把组合序列统一为预组合形式。组合记号理论上可以叠加在同一基字符上。
编码阶段要先做 NFC 统一再抽取变音符、序列化为 13 个专用算子,解码阶段再还原;不理解组合记号的双表示性就看不懂可逆性的实现。
困惑度(Perplexity)
语言模型 perplexity 定义为 $\mathrm{PPL}=\exp(-\frac{1}{N}\sum_i \log p(x_i))$,衡量模型对文本的预测不确定性。不同分词器的 token 序列长度不同,token 级 PPL 不可直接比较,需按字符/token 比归一化为字符级 PPL $\\mathrm{PPL}_{char}=\\exp(R_{char/token}\cdot\mathcal{L}_{token})$。
本文下游对比涉及两种序列长度不同的分词器,只有理解字符级归一化的意义,才能看懂 FineWeb-Edu 上 token PPL 从 29.83 降到 22.79 但字符级 PPL 持平这一关键结果。
指令集架构中的操作码/操作数(opcode/operand)
CPU 指令把'做什么'(操作码,如 ADD)和'对谁做'(操作数,如寄存器 A、常数 1)分开编码,例如 ADD A, #1。这样一套指令就能覆盖所有常数,无需为每个值单独实现一条指令。
本文整个框架的设计隐喻直接来自 ISA:基词是操作数、正字法变换是操作码,理解这一分解思想才能把握'功能分解'为何能消除词表冗余。
研究动机
子词分词器(BPE、WordPiece 等)在正字法变体面前面临两难:如果把 hello、Hello、HELLO、Héllo 这类变体当作互不相关的词表条目,词表会急剧膨胀——本文实验显示,在合并候选完全耗尽的无约束条件下,GitHub-Code-Python 语料需要 4,071,598 个词表条目才能完整覆盖,FineWeb-Edu 需要 1,214,684 个,其中大量条目只是大小写或变音符差异的冗余表面形式;同时 Hello 上的梯度更新只能间接惠及 hello,嵌入空间被碎片化。反过来的做法——激进小写化、去变音符等有损规范化——虽然压缩了词表,却永久丢弃了下游模型无法恢复的信息,Héllo 与 hello 将永远无法区分。此外,标准 BPE 会把 Python 代码中的缩进空白切成任意碎块,模型难以学到缩进的算术结构。
本文的目标是论文的目标是走出上述两难,实现'无损的功能分解':不记忆表面变体、也不销毁信息,而是把正字法与结构变化(大小写、组合变音符、字符重复与缩进空白)从语义基座中抽取出来,表示为作用在单一规范形(全小写、去变音符的基词)上的参数化算子前缀,让下游模型共享规范基词的嵌入,同时保证编码完全可逆、解码后能一字不差地恢复原文。量化目标包括:在无约束合并耗尽条件下降低覆盖语料所需的词表规模,在约 98M 参数的 GPT-2 上不劣化字符级困惑度,并验证其对代码语法有效性与生成重复退化的实际影响。整套机制必须免词典、免频率阈值、确定性执行,并可直接嵌入 Hugging Face BPE 等标准分词管线。
与已有工作不同的是,已有工作各有残缺:Bérard 等人(2019)与 Etchegoyhen 和 Gete(2020)的行内大小写标记只处理大小写一维;TokenMonster 的 capcode 标记、Bayram 等人(2025)依赖形态词典、InCa/InDia(Semenov 与 Popel,2025)需要频率表,都不是统一且免查表的方案;Factorizer(Samuel 与 Øvrelid,2023)用 VQ-VAE 学习 3×256 的离散子词码,但是学习型且非双射、不可逆;ByT5 等免分词模型消除表面碎片化的代价是序列大幅膨胀。本文的独特切入是借鉴指令集架构的'操作码/操作数'分解——CPU 不会为每个常数实现一条加法指令,而是分离操作与数据——把大小写、13 种变音符和字符重复统一进一个确定性、规则驱动、完全双射的 PUA 编码体系,并用单字节数值参数显式寻址 piece 内的字符位置。
核心方法
直觉上,Functionalizer 把每个词拆成'数据 + 对数据的变换':hello 是操作数,CAPITALIZE(0) 这样的变换是操作码,就像汇编 ADD A, #1 把指令与常数分离。技术路线上,文本先做 NFC 规范化,再用 LLaMA 风格的正则预分词器切成局部 piece(缩略词、单词、数字、标点、空白块),保证参数寻址不超过 255;随后对每个 piece 抽取组合变音符、定位大写字符位置,生成一串 Unicode 私有区指令——U+E000–U+E0FF 为参数、U+E100–U+EFFF 为算子——接在全小写规范基词之前,再交给 BPE 训练词表。操作码放前缀而非后缀有一个结构性考量:当 neurocomputational 被切成多个 BPE 子词时,前置算子在所有自注意力层中对每个构成子词保持可见,而语义基词仍紧邻其后。默认配置下算子作为独立前缀 token(split_operators=true),代价是序列变长,收益是基词嵌入跨所有变体共享。
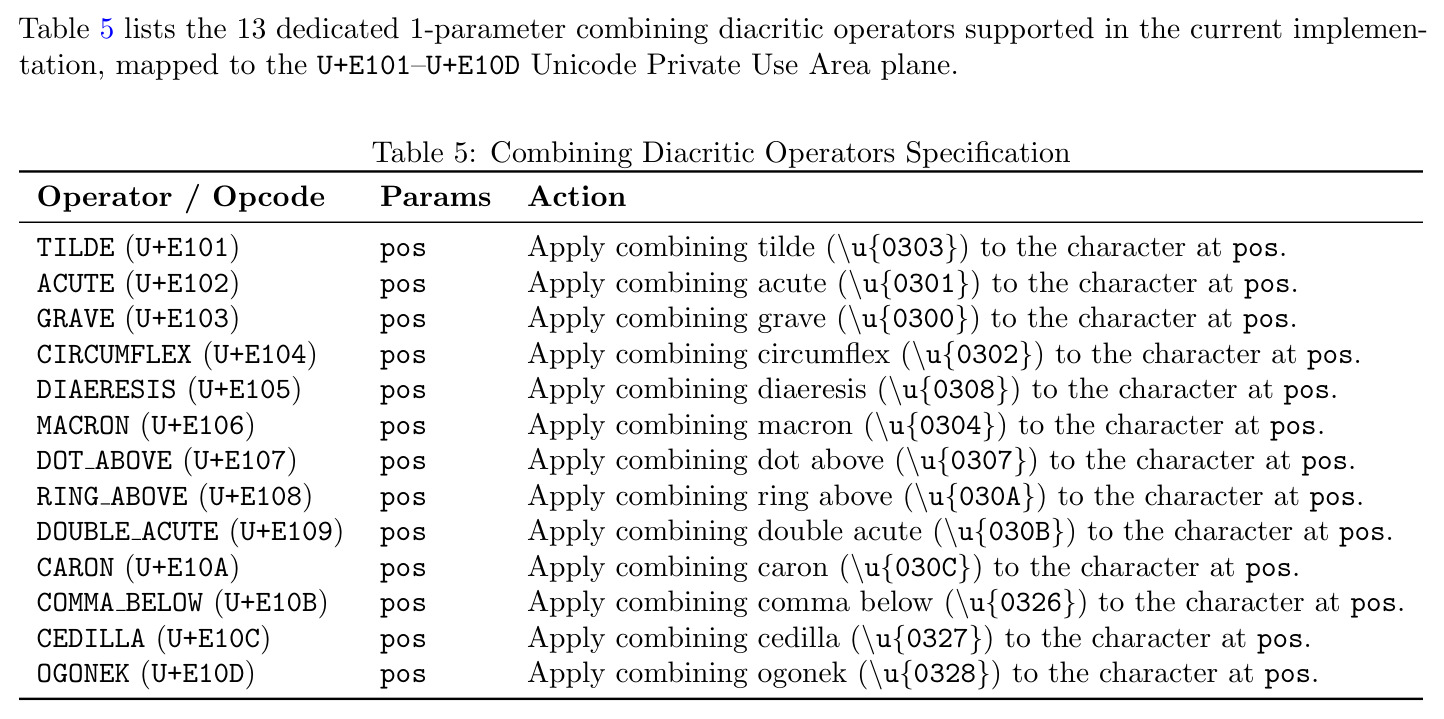
核心创新是'无损功能分解'这一双射框架。与有损规范化不同,所有被抽走的信息都以参数化算子形式保留:CAPITALIZE(U+E100)带 1 个位置参数,恢复任意位置的大写;13 个专用变音符算子(U+E101–U+E10D,覆盖 TILDE、ACUTE、GRAVE 等,完整清单见 Table 5)各带 1 个位置参数;REPEAT(U+E200)带 pos 与 count 把单字符重复参数化;MULTIREPEAT(U+E201)带 start、end、count 把子串重复参数化。数值参数用 U+E000–U+E0FF 编码 0–255(值 = 码点 − 0xE000)。解码按逆序应用算子(重复算子最后执行,位置参数针对重复展开前的 piece),即可精确恢复原文,例如 Héllo 编码为 ACUTE(1)、CAPITALIZE(0) 前缀加 hello,abcabcabc 编码为 MULTIREPEAT(0,3,3) 加 abc。这与 Factorizer 学出的不可逆离散码有本质区别。
方法步骤详情
完整流水线分四步。第一步,对语料做 Unicode NFC 规范化,统一预组合字符(输入:原始文本;输出:规范化文本)。第二步,用 LLaMA 预分词正则(Llama Split)切出缩略词、单词、数字、标点、空白块等局部字符段,建立 pos≤255 的局部坐标系(输出:piece 序列)。第三步,Functionalizer 编码:先把组合变音符抽取并序列化成 13 个变音符算子之一,再扫描定位大写字符生成 CAPITALIZE(pos),随后剥离组合记号、剩余字符小写化,最后把操作码前缀(如 \u{E102}\u{E001}\u{E100}\u{E000})拼在规范基词前;异质大小写的重复串(如 Abcabcabc)回退为不折叠表示。第四步,将带前缀的流送入 BPE:无约束实验用 4096k 词表预算训练到合并候选耗尽,下游实验用 16k 词表;解码时按逆序应用算子恢复变音符与大小写后剥离前缀,实现无损还原。
技术新颖性
技术新颖性体现在三点。其一,统一性:以往方案要么只处理大小写(行内大小写标记)、要么只处理变音符(InCa/InDia 的位置索引变音符)、要么依赖外部词典或频率表(Bayram 等的形态词典、Semenov 与 Popel 的频率表),本文把大小写、13 种变音符、字符与空白重复统一进一个 PUA 操作码/操作数 ISA,数值参数显式寻址 piece 内字符位置,免词典、免频率阈值、纯确定性。其二,双射性:与 Factorizer 用 VQ-VAE 学出的非双射离散码不同,本文是规则驱动的可逆映射,规范化文献(Gorman 与 Pinter,2025)警告的破坏性去变音符问题被彻底规避。其三,工程可嵌入性:编码是标准分词器上游的预分词步骤,可直接用于 Hugging Face BPE/SentencePiece,且支持算子独立(split_operators=true)与融合(false)两种模式,后者呼应 Jain 等人(2023)对融合标记效率的分析。
实验结果
核心发现分三层。词表层(Table 2,每集采样≤10万文档、4096k 词表预算、合并耗尽):所需词表全面下降——Wikitext 106,023→90,531(−14.61%)、Python-Codes 68,471→57,012(−16.74%)、FineWeb-Edu 1,214,684→975,169(−19.72%,峰值)、GitHub-Code-Python 4,071,598→3,356,761(−17.56%),平均降 17.16%,代价是 Chars/Token 下降 12.88%–17.73%。训练层(Table 3,~98M GPT-2、16k 词表、5 种子、5 万步):GitHub-Code-Python 字符级困惑度 1.5697→1.5328,final loss 0.8056→0.6525 且方差从 ±0.0961 收紧至 ±0.0013;FineWeb-Edu 字符级困惑度持平(2.2656 vs 2.2662),token PPL 29.83→22.79 的收益被序列变长抵消。生成层(Table 4,1000 提示、贪心解码):Python 语法成功率 7.70%→9.12%(相对 +18.4%);散文重复 n-gram 66.0%→55.8%,代码 25.5%→17.9%;但空序列从 0.1% 升至 7.1%。
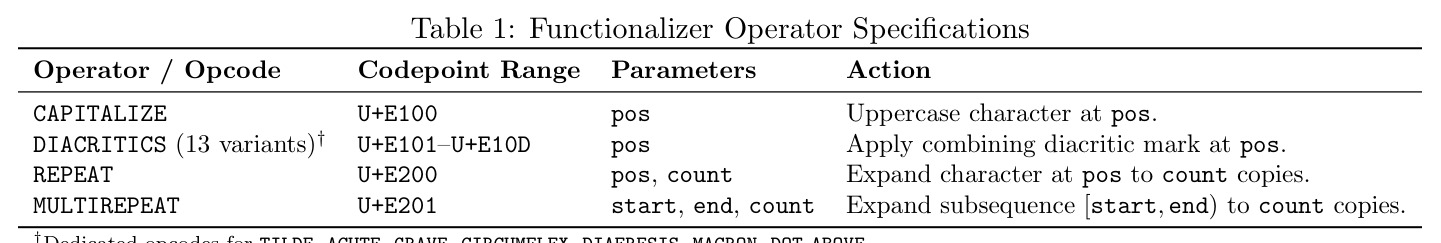
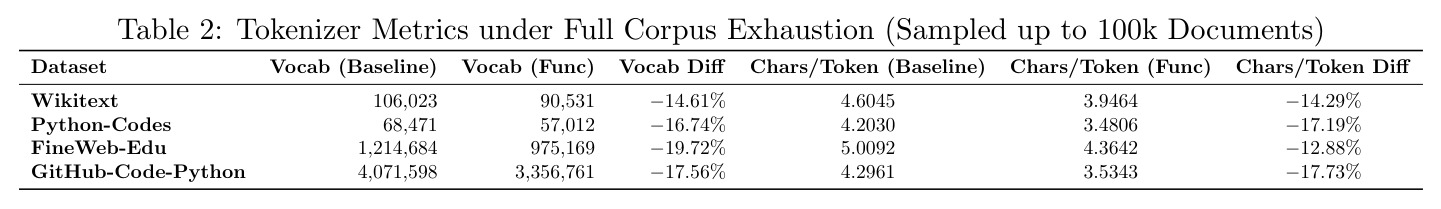
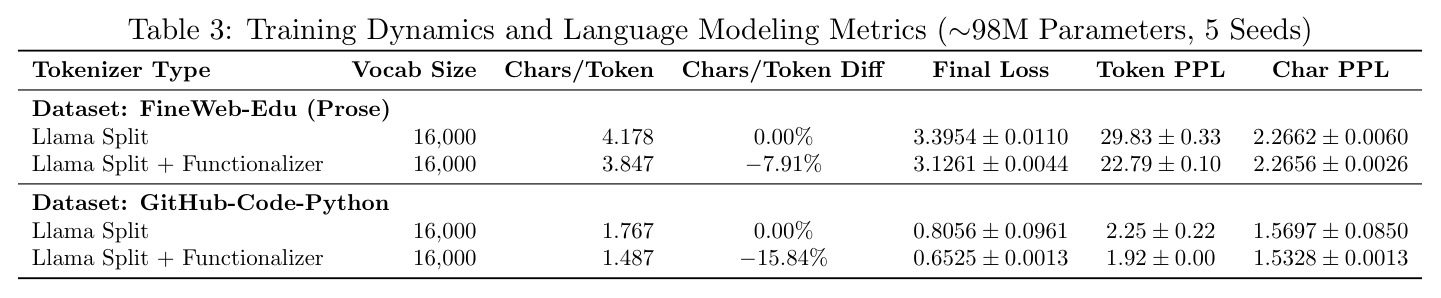
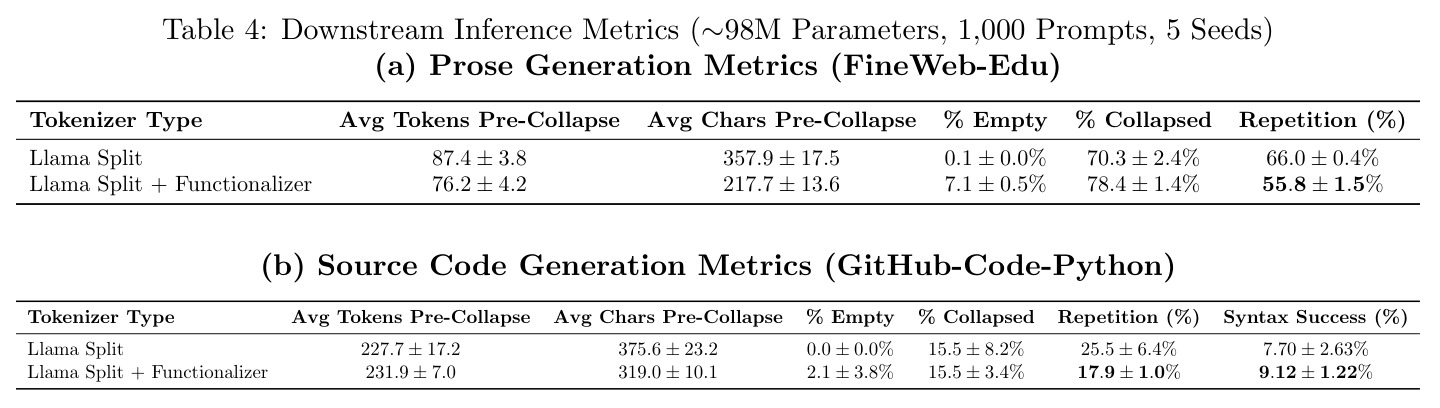
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 词表压缩(FineWeb-Edu,合并候选耗尽) | 实际学习词表条目数 | 975,169 | 1,214,684(Llama Split 基线) | 词表规模减少 19.72%(全数据集峰值) |
| 词表压缩(GitHub-Code-Python,合并候选耗尽) | 实际学习词表条目数 | 3,356,761 | 4,071,598(Llama Split 基线) | 词表规模减少 17.56% |
| Python 代码生成(GitHub-Code-Python,~98M GPT-2,5 种子) | 语法成功率(ast.parse 通过率) | 9.12% ± 1.22% | 7.70% ± 2.63% | 相对提升 18.4%,且跨种子方差显著收紧 |
| 自然语言散文生成(FineWeb-Edu,~98M GPT-2,5 种子) | 重复词 n-gram 比例(n∈{2,3,4} 平均) | 55.8% ± 1.5% | 66.0% ± 0.4% | 降低 10.2 个百分点;代码域从 25.5% 降至 17.9% |
| 代码语言建模(GitHub-Code-Python,~98M GPT-2) | 字符级困惑度 Char PPL | 1.5328 ± 0.0013 | 1.5697 ± 0.0850 | 降低约 2.4%,final loss 同步从 0.8056 降至 0.6525 |
局限与改进
作者承认的局限:下游实验仅在约 98M 参数规模、固定 5 万训练步预算下进行,由于独立前缀导致序列膨胀,Functionalizer 预训练实际处理的原始字节比基线少约 8–16%,表征收益与序列长度差异尚未解耦;独立前缀在小规模模型上引发解码问题,如散文上 7.1% 的空序列与孤立 PUA 控制字符;参数寻址受限于 piece 内 pos≤255,变音符仅覆盖 13 种组合记号;下游评估只测了 CAPITALIZE+变音符+REPEAT 的复合管线,未做分量消融。我自己的观察:其一,16k 词表下 token PPL 从 29.83 降到 22.79 主要反映分词器差异而非模型变好,跨分词器的困惑度天然不可比,字符级归一化虽部分缓解但训练字节数不平等的混杂仍在;其二,9.12% 的语法成功率绝对值仍很低,改进的实际工程意义有待更大规模验证;其三,Chars/Token 恶化(散文 +8.6%、代码 +18.8% 序列长度)会线性推高 KV cache 与注意力计算成本,论文未给出推理吞吐或成本的量化对比。
独立分析的弱点
独立分析出四个弱点。第一,独立前缀 token 的序列开销(散文 +8.6%、代码 +18.8%)直接推高推理 KV cache 与注意力成本,改进方向是论文已提及但未评估的混合融合策略:按词频分层,高频大小写组合(如句号+空格+大写)融合为单一 token,长尾变体保持分解,可在消除常见序列膨胀的同时保留表示共享。第二,实验规模小且算力不等化,98M 模型在小数据上语法成功率的种子方差高达 ±2.63%,结论稳健性不足,改进方向是多十亿参数模型在等化 wall-clock 与字节预算下的重评。第三,空序列/纯算子序列(散文上 7.1%)说明小模型难以控制前缀 token 的生成位置,改进方向是生成期约束解码或前缀掩码,把 CAPITALIZE 等算子的出现限制在合法位置。第四,覆盖面窄:非拉丁文字、13 种之外的变音符、超过 255 字符的 piece 均未处理,改进方向是扩展操作码、引入多字节参数寻址、增加范围/块级大小写(如 [ALL CAPS])算子。
未来方向
作者提出四个方向:多十亿参数架构在等化字符/字节预算与 wall-clock 时间下的重训重评,以分离表征收益与序列长度差异;跨词表频率层级的混合融合阈值基准测试,配合前缀感知注意力优化(框架已部分支持融合配置但未评估);扩展寻址与算子——范围/块级大小写([ALL CAPS])、非拉丁文字、黏着语的形态词元折叠、数字/日期模板;以及分解 CAPITALIZE 与 REPEAT 各自下游贡献的分量消融。基于本文成果还可以延伸:把 opcode/operand 思想推广到其他空白敏感的形式语言(YAML、Makefile 等缩进敏感语言),验证缩进参数化的普适性;与 MorphBPE 等形态感知方法组合,同时处理正字法与形态两个维度;在机器翻译场景验证无损变音符保留对越南语、捷克语等变音符丰富语言的翻译质量影响;以及训练轻量的算子感知解码头,在推理期利用前缀结构做结构约束采样。
复现评估
复现条件相当好。代码全开源:分词器配置、训练脚本、评估管线、数据获取脚本与结果文件在 github.com/connor-makowski/functionalizer,可直接使用的分词器实现在同作者 tokenizers 仓库的 functionalizer 分支,已训练的部分 Functionalizer 模型发布于 Hugging Face 合集 functionalizer-100m。四个评估数据集全部公开:Wikitext、FineWeb-Edu、Python-Codes-25k、GitHub-Code-Python,每集最多采样 10 万文档。算力需求适中:GPT-2 Small(~98M 参数,上下文 512,16k 词表)每配置训练 5 万步、5 个种子,AdamW 学习率 4e-4、有效批量 32,单张高端 GPU 数天内可复现主表;tokenizer 层的合并耗尽实验(4096k 预算)只需常规资源。主要门槛是对齐 tokenizers 库版本与预处理顺序(NFC→Llama Split→Functionalizer),以及贪心解码停止条件等细节。
论文图表
附录 B 的编码实例:Hello → CAPITALIZE(0) + hello(前缀 \u{E100}\u{E000});Héllo → ACUTE(1)、CAPITALIZE(0) + hello;###### → REPEAT(0,6) + #;4 个空格 → REPEAT(0,4) + 空格;abcabcabc → MULTIREPEAT(0,3,3) + abc。
用具体输入输出把抽象的 opcode/operand 编码落到可验证的字节序列,是理解可逆编解码最快的一张表。